Este estudio propone un modelo híbrido de predicción de costos para redes eléctricas que combina cuotas de costos físicos con ajustes dinámicos macroeconómicos y tecnológicos, y una compensación de residuos basada en XGBoost. Alcanzando un MAPE de 2,34 %, equilibra precisión e interpretabilidad, abordando las necesidades de transparencia regulatoria en la fijación de tarifas.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Pronóstico retrospectivo mediante el uso de datos de cuadrícula provincial y un modelo híbrido físico-IA basado en cuotas
En este artículo
Resumen
Resumen
La transición energética global y las continuas reformas del mercado eléctrico exigen que las empresas de redes eléctricas equilibren un suministro de energía confiable con regulaciones tarifarias de transmisión y distribución cada vez más estrictas. Los métodos tradicionales de presupuestación basados en extrapolaciones históricas a menudo no reflejan la base física de las operaciones de los activos, mientras que los modelos de aprendizaje automático basados en datos logran una alta precisión predictiva, pero carecen de la transparencia necesaria para la verificación regulatoria de costos. Para abordar el equilibrio entre precisión en la predicción e interpretabilidad, este estudio propone un modelo híbrido de predicción de costos basado en cuotas de costos. El marco utiliza cuotas operativas estandarizadas como base física para la presupuestación e incorpora un mecanismo dinámico de evolución de cuotas impulsado por condiciones macroeconómicas y progreso tecnológico. Se emplea el algoritmo Extreme Gradient Boosting (XGBoost) para capturar los residuos no lineales que escapan a las estimaciones basadas en cuotas, mientras que SHAP (Shapley Additive exPlanations) se utiliza para interpretar la contribución de los principales factores de costo. El modelo fue evaluado utilizando 16 años de datos operativos anónimos de una red eléctrica provincial en China. Alcanzó un error medio absoluto porcentual (MAPE) del 2,34 %, reduciendo los errores de predicción en un 61,8 %, 46,6 % y 34,1 % en comparación con los modelos SARIMAX, XGBoost independiente y Attention-LSTM, respectivamente. El marco propuesto integra principios de cuotas de costos de ingeniería con inteligencia artificial interpretable, proporcionando tanto predicciones precisas de costos a largo plazo como una herramienta de apoyo a la toma de decisiones transparente para la verificación regulatoria de costos permitidos.
Introducción
La transición energética global está transformando la gestión de activos y las prácticas operativas de las redes eléctricas mediante la integración de generación renovable distribuida, el aumento de eventos climáticos extremos y la amplia implementación de tecnologías IoT, todos los cuales exigen una mayor flexibilidad operativa y recursos de mantenimiento para garantizar la confiabilidad del sistema1,2. Al mismo tiempo, los reguladores de electricidad han reforzado la supervisión de las tarifas de transmisión y distribución mediante marcos como el RIIO del Reino Unido y las revisiones de tasa de retorno de la Comisión Federal Reguladora de Energía de EE. UU., haciendo hincapié en la transparencia en la justificación de costos3. De manera similar, China ha adoptado un mecanismo regulatorio de «costo permitido más retorno razonable», que exige a las empresas eléctricas demostrar vínculos claros entre las actividades de ingeniería y los gastos financieros4. Sin embargo, las empresas eléctricas a menudo carecen de herramientas cuantitativas transparentes que conecten las operaciones físicas de los activos con los pronósticos de costos, lo que limita la eficacia de la verificación regulatoria de costos5.
Los enfoques de predicción existentes tienen limitaciones importantes en este entorno6. Los métodos tradicionales, incluyendo la presupuestación incremental y los modelos basados en ARIMA, asumen patrones históricos relativamente estables y a menudo tienen un desempeño deficiente ante cambios estructurales provocados por fluctuaciones económicas o fenómenos climáticos extremos7. Por el contrario, los modelos modernos de aprendizaje automático, como las arquitecturas LSTM y Transformer, ofrecen una alta precisión predictiva para pronósticos a corto plazo, pero carecen de la interpretabilidad ingenieril necesaria para la toma de decisiones regulatorias8,9. Aunque enfoques recientes de predicción híbrida combinan técnicas estadísticas y de aprendizaje automático, generalmente pasan por alto las cuotas estándar de costos ingenieriles que sustentan los sistemas contables de redes eléctricas10. Para abordar estas limitaciones, este estudio propone un marco de predicción híbrida basado en cuotas que combina la evolución dinámica de cuotas con la corrección de residuos basada en aprendizaje automático, preservando la interpretabilidad ingenieril mientras mejora la precisión de la predicción.
Una importante línea de investigación se deriva de la regulación de incentivos en industrias de monopolio natural, incluyendo el mecanismo RPI-X del Reino Unido y el marco chino de verificación de costos permitidos11. Estos estudios evalúan principalmente la eficiencia operativa mediante el Análisis Envoltura de Datos (DEA) y el Análisis Estocástico de Frontera (SFA)12. Investigaciones previas han examinado las relaciones a largo plazo entre el gasto de capital (CAPEX), el gasto operativo (OPEX) y la eficiencia de costos para respaldar la regulación tarifaria13,14. Si bien estos enfoques proporcionan información valiosa a nivel macroeconómico, sus resultados generalmente se expresan como puntuaciones de eficiencia relativa en lugar de pronósticos monetarios adecuados para la elaboración de presupuestos anuales15,16. Además, los modelos de frontera generalmente suponen estructuras de activos físicos y condiciones operativas relativamente estables, lo que limita su capacidad para captar cambios bruscos en los costos provocados por el envejecimiento de los activos, la sustitución de infraestructuras o un crecimiento rápido de la demanda17,18.
Una segunda línea de investigación se centra en modelos de predicción basados en estadística e inteligencia artificial. En estudios iniciales se emplearon regresión lineal múltiple y modelos autorregresivos integrados de media móvil con variables exógenas (ARIMAX) para la predicción de costos19. Más recientemente, la regresión mediante vectores de soporte, bosques aleatorios, modelos XGBoost, LSTM y Transformer han mejorado sustancialmente el desempeño de las predicciones aprovechando relaciones no lineales y espacios de características de alta dimensionalidad20,21,22. Estos enfoques incorporan frecuentemente indicadores macroeconómicos como la demanda de electricidad, índices de precios al productor (PPI) y variables climáticas23. Sin embargo, los costos operativos de la red eléctrica surgen de actividades de ingeniería, deterioro de activos, programación de mantenimiento y decisiones de gestión, y no únicamente de variables macroeconómicas24. En consecuencia, los modelos puramente basados en datos suelen funcionar como «cajas negras», lo que dificulta explicar los costos pronosticados durante revisiones regulatorias o la verificación de costos permitidos25,26.
La gestión de cuotas de costos de ingeniería ofrece una solución potencial a este desafío27. El sistema de costeo basado en actividades (ABC) ha dependido desde hace tiempo de cuotas operativas estandarizadas para estimar los requisitos de mano de obra, materiales, equipos y mantenimiento en las operaciones rutinarias de la red eléctrica28. Las principales empresas eléctricas chinas han desarrollado bases de datos exhaustivas de cuotas que abarcan actividades de inspección, mantenimiento, pruebas, reparación y reemplazo de equipos. Sin embargo, estas normas de ingeniería se utilizan principalmente para la liquidación de proyectos y auditorías, más que para la previsión dinámica a largo plazo29,30. Además, las normas de cuotas generalmente solo se revisan cada varios años, lo que las hace insuficientemente sensibles a los cambios en los precios de las materias primas, el progreso tecnológico y las prácticas operativas31. La aplicación de sistemas de cuotas en millones de activos distribuidos también plantea importantes desafíos computacionales para la previsión a gran escala32.
A pesar de los avances significativos en la predicción estadística, el aprendizaje automático y la gestión de costos de ingeniería, ningún marco existente integra de forma efectiva las cuotas estándar de costos de ingeniería, el ajuste dinámico de la macroeconomía y el aprendizaje automático interpretable en un modelo unificado de predicción para la verificación regulatoria de costos. Se planteó la hipótesis de que combinar cuotas de costos en evolución dinámica con un aprendizaje residual basado en XGBoost puede mejorar la precisión de la predicción a largo plazo, al tiempo que mantiene la transparencia de ingeniería necesaria para la toma de decisiones regulatorias. Para probar esta hipótesis, se desarrolló un marco híbrido de predicción basado en cuotas que integra modelado físico de costos, mecanismos de ajuste macroeconómico y tecnológico, compensación residual mediante XGBoost e interpretación del modelo basada en SHAP. El enfoque propuesto tiene como objetivo proporcionar tanto predicciones precisas de costos a largo plazo como evidencia transparente para respaldar la verificación de costos permitidos bajo la regulación moderna del mercado eléctrico.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utilizó datos operativos y financieros anonimizados recopilados de una red eléctrica provincial en el este de China. Todos los datos fueron agregados y desidentificados antes del análisis, y no se incluyó ninguna información personal identificable ni datos sensibles a nivel individual. Por lo tanto, no se requirió aprobación ética. El acceso y análisis de los datos cumplieron con las regulaciones aplicables de protección de datos y los acuerdos institucionales que rigen la información del sector eléctrico.
Descripción general del marco de predicción
Para integrar enfoques de predicción basados en la física y en datos, se desarrolló un marco híbrido de predicción que combina cuotas de costos de ingeniería con aprendizaje automático. En lugar de simplemente combinar múltiples algoritmos, el marco sigue el principio de que los modelos físicos establecen la predicción de referencia, mientras que el aprendizaje automático compensa los errores residuales. Este diseño asegura que el proceso de predicción se base en los mecanismos físicos subyacentes a las actividades de producción y operación de la red eléctrica, en lugar de depender únicamente de la extrapolación histórica de costos.
El marco establece primero una asignación jerárquica entre los activos de la red eléctrica, las actividades operativas estandarizadas y las cuentas de costos financieros. Los costos de producción y operación se consideran representaciones monetarias de los recursos consumidos por los activos físicos —incluyendo subestaciones, líneas de transmisión, alimentadores de distribución, dispositivos de medición y equipos digitales de inspección— durante actividades rutinarias como inspección, mantenimiento, pruebas, reparación y reemplazo. Las cuotas de costos sirven como vínculo entre las cargas de trabajo de ingeniería medibles y los gastos financieros correspondientes.
Como se ilustra en la Figura 1, las cuotas de costo funcionan como unidades contables estandarizadas integradas en todo el proceso de operación y mantenimiento de los activos, en lugar de reglas abstractas de asignación financiera. Las cargas de trabajo de los activos a nivel inferior se convierten en cuotas operativas estandarizadas y posteriormente se asignan a categorías de costos, incluyendo mano de obra, materiales, equipos de construcción, servicios subcontratados y suministros de emergencia. Esta asignación jerárquica preserva la interpretabilidad ingenieril y la trazabilidad regulatoria durante todo el proceso de pronóstico, y proporciona la base física para la construcción del modelo estático de cuota de referencia.
Resumen del flujo de trabajo metodológico
El marco de previsión propuesto consta de tres etapas secuenciales: (1) la construcción de una línea de base física utilizando cuotas de carga de trabajo a nivel de activos, (2) la evolución dinámica de las cuotas de costos mediante ajustes macroeconómicos y tecnológicos, y (3) la compensación basada en aprendizaje automático para capturar efectos sistemáticos no lineales. Como se ilustra en Figura 1, el marco establece una asignación jerárquica desde los activos de nivel inferior y las actividades operativas estandarizadas hasta las previsiones de costos de producción y operación. Los detalles de implementación de cada etapa se describen en las siguientes secciones.
Modelo de costo básico físico basado en cargas de trabajo a nivel de activos
La producción y el costo operativo de una red eléctrica, Ctotal, comprenden gastos asociados con múltiples actividades comerciales, incluyendo la operación de subestaciones, el mantenimiento de líneas de transmisión, la gestión de redes de distribución, el servicio al cliente y los sistemas de apoyo. En este estudio, se asume que el costo operativo de referencia está determinado por la carga de trabajo generada por cada actividad operativa estandarizada y su cuota de costo correspondiente.
El costo estático de referencia se calcula como:
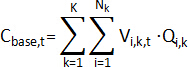 (1)
donde Vi,k,t denota la carga de trabajo asociada con la tarea operativa o el activo i-ésimo dentro de la categoría empresarial k durante el período t, y Qi,k representa el costo unitario estandarizado correspondiente definido por el sistema de cuotas de costos de ingeniería. La categoría empresarial incluye funciones operativas principales como mantenimiento de subestaciones, inspección de líneas de transmisión, operación de redes de distribución y servicio al cliente. La doble sumatoria agrega los costos de todas las actividades operativas estandarizadas para estimar el gasto teórico básico necesario para mantener el funcionamiento normal de la red.
La ecuación (1) establece la relación física entre las cargas de trabajo de ingeniería y los gastos financieros al asociar directamente actividades operativas estandarizadas con cuentas de costos. A diferencia de los modelos puramente estadísticos de pronóstico, esta formulación proporciona una base de ingeniería interpretable que sirve como fundamento para el ajuste dinámico posterior de cuotas y la corrección residual basada en aprendizaje automático. La ecuación fue desarrollada a partir de las prácticas operativas y el sistema de cuotas de costos utilizados por empresas provinciales de redes eléctricas en China. Tabla 1 resume la notación utilizada en la ecuación (1), incluyendo la carga de trabajo (Vi,k,t), el costo unitario estandarizado (Qi,k), el número de tareas operativas (Nk) y el índice de categoría empresarial (k).
Mecanismo dinámico de evolución de cuotas bajo perturbaciones ambientales externas
Las cuotas de coste estandarizadas (Qi,k) proporcionan una referencia físicamente interpretable, pero no tienen en cuenta los cambios en las condiciones macroeconómicas ni el progreso tecnológico. Para mejorar su aplicabilidad a largo plazo, se introdujo un mecanismo de evolución dinámica para ajustar las cuotas de referencia en respuesta tanto a la inflación de precios como a las ganancias de eficiencia impulsadas por la tecnología.
El primer ajuste tiene en cuenta los cambios en los costos de adquisición derivados de la inflación macroeconómica. La operación y el mantenimiento de la red eléctrica dependen en gran medida de materiales en grandes volúmenes, como el cobre, el aluminio y el acero al silicio, cuyos precios están estrechamente relacionados con las fluctuaciones del Índice de Precios al Productor (PPI). Dado que  es un índice con un valor base de 100, primero se convierte en una tasa de inflación estandarizada:
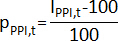 (2)
Sobre esta base, se define la función de corrección de precio  como:
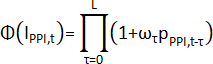 (3)
donde  es un vector de pesos retardados de longitud L que satisface
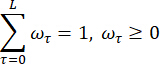
La estructura de rezago representa la transmisión diferida de la inflación macroeconómica a los costos de adquisición dentro de la cadena de suministro de la red eléctrica. Convertir el índice PPI en una tasa de inflación estandarizada conserva el efecto acumulativo de los cambios de precios, al tiempo que evita el sesgo de escala asociado con el uso directo de los valores del índice. Las ecuaciones (2) y (3) se adaptaron a partir de modelos establecidos de ajuste de inflación macroeconómica, con la estructura de rezago calibrada para los ciclos de adquisición del sector eléctrico33,34.
El progreso tecnológico se incorporó mediante un factor de reducción de costos que reflejaba mejoras en la eficiencia operativa derivadas de avances como la inspección mediante vehículos aéreos no tripulados, la robótica inteligente y las tecnologías digitales de mantenimiento. El factor de ajuste tecnológico se define como:
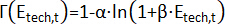 (4)
En esta parte, α y β son coeficientes empíricos de elasticidad estimados a partir de datos históricos de panel mediante mínimos cuadrados no lineales. Para garantizar que el factor de progreso tecnológico represente siempre una reducción razonable en el costo unitario de la cuota, el proceso de estimación de parámetros restringe 0 < Γ(Etech,t) ≤ 1. Cabe señalar que este factor refleja principalmente la mejora de eficiencia a largo plazo derivada del reemplazo por tecnología madura. La ecuación (4) es original de este trabajo, adaptando el concepto de curva de aprendizaje proveniente de la literatura sobre costos de tecnologías energéticas35,36 a las operaciones de mantenimiento de redes. Los costos adicionales que pueden surgir en la etapa inicial de implementación de equipos digitales, como la operación paralela de sistemas antiguos y nuevos, la integración de plataformas, las pruebas de comunicación y el mantenimiento adicional, no se deducen forzosamente de la cuota base; en cambio, se identifican mediante el módulo subsiguiente de compensación de residuos basado en aprendizaje automático:
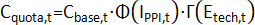 (5)
donde Cbase,t denota el costo estático de referencia calculado a partir de las cargas de trabajo de los activos de nivel inferior y de las cuotas estándar de costos operativos; captura el efecto de transmisión de las fluctuaciones macroeconómicas de precios sobre los materiales, equipos y precios de servicios externos; y Γ(Etech,t) refleja la reducción basada en la eficiencia de los costos unitarios de operación y mantenimiento tras la madurez tecnológica. A través del anterior mecanismo de evolución dinámica, la cuota de referencia ya no permanece en una base contable estática, sino que puede ajustarse adaptativamente ante cambios en los entornos económicos y las condiciones tecnológicas. La ecuación (5) es original de este trabajo y representa la integración novedosa de correcciones por precios y tecnología en el marco de la cuota de referencia.
Captura sistemática de residuos no lineales bajo restricciones de cuota
A pesar de las correcciones evolutivas complejas, el modelo de cuota genera inevitablemente desviaciones sistemáticas al enfrentar interrupciones climáticas impredecibles relacionadas con desastres y directrices políticas repentinas, como el aumento de los costos de manejo de quejas de servicio al cliente durante períodos temporales de reducción de tarifas. Esta desviación forma el término residual en ambos lados de la ecuación:
Rt=Cactual,t-Ccuota,t (6)
Dado que las reglas físicas convencionales no pueden explicar este aspecto, el aprendizaje automático puede abordar estas limitaciones. Para evitar la maldición de la dimensionalidad provocada por características de alta dimensionalidad, este estudio utiliza el algoritmo XGBoost basado en conjuntos de árboles de decisión para modelar la relación no lineal Rt37,38. Se define una matriz de características de fuerte perturbación Xt, que incluye características meteorológicas como los días anuales extremos de congelación Dice y la intensidad de políticas macroeconómicas.
Para un compensador no lineal compuesto por árboles de regresión, la lógica de generación del residuo predicho  puede expresarse como39:
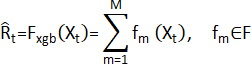 (7)
donde F denota el espacio de todas las estructuras posibles de árboles de clasificación y regresión. Para equilibrar la precisión del ajuste y la prevención del sobreajuste, se construye y minimiza en la m-ésima iteración una función objetivo regularizada que contiene un término de penalización por complejidad estructural:
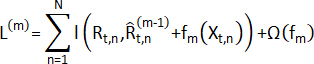 (8)
donde  es una función de pérdida convexa que mide la diferencia entre el residuo verdadero y el residuo predicho. En este artículo se adopta la pérdida de Huber para mejorar la robustez del modelo frente a gastos máximos anómalos. El término de regularización
 se utiliza para restringir la complejidad de la estructura del árbol y se define como:
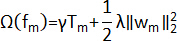 (9)
donde Tm representa el número de nodos hoja en el árbol m-ésimo, wm representa el vector de pesos de las hojas correspondiente, y γ y λ denotan el coeficiente de penalización del número de nodos hoja y el coeficiente de regularización de pesos, respectivamente.
La ecuación final de predicción es:
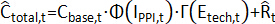 (10)
Ampliado adicionalmente como:
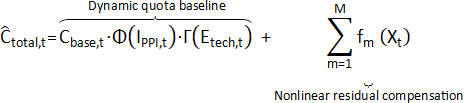 (11)
La fórmula anterior representa matemáticamente la estructura de bucle cerrado del modelo de pronóstico propuesto. La demanda final de costos de producción y operación no es generada directamente por el modelo de aprendizaje automático; en cambio, se obtiene superponiendo la compensación residual no lineal identificada por el módulo de aprendizaje automático sobre la línea base dinámica de cuota. Entre estos componentes, los factores de precio y tecnología reflejan principalmente la evolución dinámica de la línea base de cuota, mientras que los factores difíciles de caracterizar explícitamente mediante reglas, como los impactos climáticos, las perturbaciones políticas y los aumentos repentinos en eventos de reparación, son capturados por el módulo de compensación residual basado en aprendizaje automático. Las ecuaciones (10) y (11) son originales de este trabajo y sintetizan la línea base física con la captura residual basada en aprendizaje automático en un marco unificado de pronóstico.
Figura 2 muestra que los resultados de pronóstico del modelo propuesto exhiben una lógica clara de generación jerárquica. Por un lado, la cuota base proporciona una base física estable, transparente y auditada para la demanda de costos; por otro lado, los ajustes de precios, los efectos tecnológicos y los residuos de choques externos permiten que el modelo se adapte a cambios dinámicos en entornos complejos. En comparación con modelos de caja negra que generan directamente valores predichos, esta estructura de descomposición puede revelar claramente «por qué aumentan o disminuyen los costos», mejorando así la interpretabilidad de los resultados del modelo en la revisión presupuestaria y la regulación de tarifas de transmisión y distribución.
Fuentes de datos y procedimientos de recopilación
Los modelos teóricos deben validarse rigurosamente mediante datos empíricos para demostrar su utilidad práctica. Dado que los datos financieros centrales del sector eléctrico incluyen información sensible relacionada con la operación de infraestructuras nacionales, este estudio extrae datos contables mensuales anónimos y de alta precisión de una red eléctrica provincial típica del este de China, denominada E-Grid para facilitar su referencia, que abarcan 16 años calendario consecutivos desde 2010 hasta 2025. Esta provincia ha experimentado un ciclo económico típico al pasar de un crecimiento impulsado por industrias pesadas tradicionales a una manufactura de alto nivel, con una tasa de crecimiento anual compuesta de la escala de activos de la red del 7,4 %. Por lo tanto, la evolución compleja de su estructura de costos tiene una posible relevancia para otros sistemas de red en rápido desarrollo. Los datos provienen de tres fuentes principales: (1) registros internos de operación y mantenimiento que registran cargas de trabajo a nivel de activos, frecuencias de inspección y eventos de reparación; (2) sistemas contables financieros que proporcionan estados mensuales de costos en mano de obra, materiales, equipos y servicios subcontratados; y (3) bases de datos ambientales externas que incluyen registros meteorológicos de la Administración Meteorológica de China e indicadores macroeconómicos de la Oficina Nacional de Estadísticas.
Control de calidad y tratamiento de datos faltantes
Para más de 130 indicadores iniciales integrados a partir de sistemas múltiples, se implementó un procedimiento riguroso de control de calidad. Los datos faltantes, que representan menos del 3 % del total de observaciones, se manejaron mediante interpolación lineal para variables continuas con tendencias temporales, y mediante imputación por la moda para indicadores categóricos. Los valores atípicos se identificaron utilizando el método del rango intercuartílico (IQR); los valores que excedían 3,0 veces el IQR por encima del tercer cuartil se ajustaron al percentil 99 para preservar la integridad de los datos y mitigar la distorsión por valores extremos.
Consideraciones sobre el tamaño de la muestra
El conjunto de datos comprende 192 observaciones mensuales (enero de 2010 a diciembre de 2025), con 156 observaciones (2010–2022) asignadas para entrenamiento y validación y 36 observaciones (2023–2025) reservadas para pruebas fuera de la muestra. Aunque este tamaño de muestra es relativamente modesto para aplicaciones de aprendizaje profundo, es adecuado para el algoritmo XGBoost, que está diseñado específicamente para funcionar bien con conjuntos de datos tabulares pequeños a medianos mediante sus mecanismos de regularización y poda de árboles. Para mitigar los posibles riesgos de sobreajuste, (1) se emplearon penalizaciones estrictas de regularización (γ = 0,1, λ = 1,0), (2) detención temprana con una tolerancia de 50 rondas y (3) restricciones conservadoras de profundidad de árbol (profundidad máxima = 5). Estas medidas garantizan colectivamente la estabilidad y la capacidad de generalización del modelo a pesar del tamaño limitado de la muestra.
Segmentación de datos e integración heterogénea de múltiples fuentes
Para una prueba rigurosa, los datos desde enero de 2010 hasta diciembre de 2022 se asignaron al intervalo de entrenamiento y validación, que contiene 156 observaciones, utilizado para entrenar los factores de evolución de la cuota y la red residual de compensación de la cuota. El período de enero de 2023 a diciembre de 2025 se reserva como el conjunto de prueba independiente fuera de la muestra, que contiene 36 observaciones. ¿Por qué se selecciona este período como escenario final de prueba? La razón es que estos tres años coincidieron con la aceleración de la construcción de sistemas eléctricos de nuevo tipo, agravada por eventos a gran escala de altas temperaturas relacionados con el fenómeno extremo de El Niño y el crecimiento rápido y desigual de la generación distribuida de energías renovables. La red eléctrica enfrentó una presión sin precedentes en las cadenas de suministro de materiales y en la asignación de mano de obra para reparaciones.
La selección científica y la definición cuantitativa de los factores determinantes de costos son la base para garantizar que la red residual de aprendizaje automático pueda captar eficazmente las fluctuaciones sistemáticas. Basándose en la lógica de gestión de los costos operativos estándar en los sistemas eléctricos, este estudio supera la única dimensión de la previsión financiera tradicional, que depende únicamente de los flujos de efectivo históricos, y en su lugar reconstruye la ingeniería de características a partir de cuatro límites fundamentales: escala de activos físicos, condiciones de operación y mantenimiento, evolución macroeconómica y entorno climático externo, utilizando registros operativos originales y libros contables de sistemas externos. En el proceso real de modelado, para más de 130 indicadores originales resultantes de la integración de sistemas múltiples, este estudio emplea pruebas de correlación de Pearson para eliminar variables redundantes altamente colineales, con un umbral de |r| > 0,85. Con base en el conocimiento previo de expertos senior en redes eléctricas, se seleccionan finalmente 42 características principales de entrada para formar la matriz de características Xt. Para presentar claramente la estructura y distribución subyacentes de los datos del tensor de entrada, Tabla 2 selecciona 12 características principales representativas de las cuatro dimensiones de evaluación anteriores y resume sus estadísticas descriptivas durante el período de observación.
Para ilustrar mejor la base espacial y topológica del sistema de características multifuente, Figura 3 presenta una topología esquemática anonimizada de la red eléctrica provincial objeto de estudio. La figura superpone subestaciones por nivel de voltaje, corredores de transmisión, agrupaciones distribuidas de energías renovables, centros de carga y zonas representativas de perturbaciones ambientales. Esta topología ayuda a explicar por qué los costos de producción y operación se ven afectados conjuntamente por la escala de los activos, la estructura de la red, la intensidad de las reparaciones de emergencia y los impactos climáticos externos. Asimismo, proporciona una base de interpretación espacial para las variables impulsoras de residuos utilizadas en el módulo de compensación XGBoost.
Tabla 2 muestra que las variables explicativas de distintas dimensiones empresariales presentan formas estadísticas claramente diferentes. Las variables de activos físicos que representan dinámicas endógenas del desarrollo empresarial, como la capacidad de subestaciones y la longitud de líneas, tienen desviaciones estándar relativamente estables y valores de asimetría concentrados entre 0,1 y 0,8. Su estructura general de datos se distribuye aproximadamente de forma normal, reflejando objetivamente el atributo de un desarrollo estable de la red eléctrica durante el ciclo de construcción de infraestructuras. En marcado contraste están las variables meteorológicas y de perturbación ambiental externa en la parte inferior de la tabla. Por ejemplo, el número acumulado de días con temperaturas extremas que han alcanzado el nivel de alerta en los últimos 90 días y el índice de impacto por interrupciones en las líneas presentan una asimetría marcadamente positiva, con valores de 2,15 y 2,45, respectivamente. Esta distribución típicamente de cola pesada confirma un punto crítico objetivo que no puede ignorarse en la operación y mantenimiento reales de la red eléctrica: aunque los desastres meteorológicos extremos ocurren con relativa infrecuencia dentro de una escala temporal anual, cuando se desencadenan suelen provocar aumentos exponenciales en la mano de obra de reparación y en el consumo de repuestos. Desde otra perspectiva, la alta no uniformidad y la asimetría de valores extremos en la distribución de estas características multifuente revelan las limitaciones teóricas de los modelos tradicionales de series temporales lineales, como ARIMAX, que se basan en supuestos de normalidad y homocedasticidad al rastrear costos complejos de la red eléctrica. Esto no solo refuerza aún más la racionalidad de introducir un módulo de aprendizaje automático más allá de la base contable física, sino que también proporciona un sólido respaldo estadístico para la selección en este artículo del modelo de árboles XGBoost, capaz de manejar eficientemente distribuciones dispersas de características y mapeos no lineales para aproximar los residuos de costos.
Configuración del sistema de optimización y evaluación de hiperparámetros
Después de determinar el espacio de entrada de características, la configuración de los hiperparámetros del modelo afecta directamente el rendimiento de ajuste de la red de aproximación residual. Dado que la red de compensación XGBoost incluye múltiples parámetros, como la profundidad del árbol (max depth), la tasa de aprendizaje y los términos de penalización de regularización, y estos parámetros presentan interacciones no lineales, la búsqueda convencional por cuadrícula no solo tiene una alta complejidad computacional, sino que también tiende a quedar atrapada en mínimos locales en espacios de alta dimensión. Por lo tanto, este estudio introduce el estimador parzen estructurado en árbol (Tree-structured Parzen Estimator, TPE), un método de optimización bayesiana, en el proceso de ajuste de parámetros. El algoritmo TPE puede guiar dinámicamente las direcciones de muestreo posteriores utilizando la retroalimentación de la función de pérdida obtenida en evaluaciones previas. Al construir una estimación de densidad de kernel posterior (KDE) de la variable objetivo, reduce de forma adaptativa el espacio de búsqueda de parámetros, permitiendo que el modelo se aproxime a la configuración óptima global de hiperparámetros sin incurrir en un alto costo computacional. El objetivo de optimización TPE fue minimizar el RMSE de validación durante 100 iteraciones, con detención anticipada tras 50 rondas sin mejora.
Después de completar la optimización de parámetros en el conjunto de validación interno, para evaluar objetivamente el rendimiento final de cada modelo en el conjunto de prueba fuera de la muestra y cumplir con los requisitos de evaluación cuantitativa de los reguladores para la verificación de costos, este estudio utiliza el error porcentual absoluto medio (MAPE) para cuantificar la desviación relativa en la secuencia predicha. Mientras tanto, para abordar la necesidad práctica de controlar fallos extremos en la predicción de costos durante las operaciones, también se introduce el error cuadrático medio (RMSE) para imponer penalizaciones más severas a los errores mayores. Finalmente, el coeficiente de determinación, R2, cuantifica el poder explicativo general de la regresión en relación con la varianza real del objetivo.
Las definiciones matemáticas de los indicadores son las siguientes:
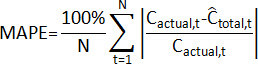 (12)
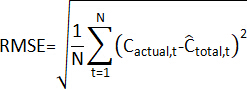 (13)
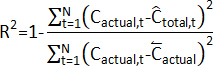 (14)
donde  representa el costo real de producción y operación en el período t,
 representa el costo predicho por el modelo,
 representa el costo real promedio en la muestra de prueba, y N es el número de muestras en el conjunto de prueba.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Comparación panorámica con reducción de dimensionalidad de la precisión de predicción
Cuando todos los modelos optimizados mediante el estimador parzen con estructura de árbol (Tree-structured Parzen Estimator, TPE) se evaluaron en el conjunto de prueba fuera de la muestra de 2023–2025, que incluyó fluctuaciones posteriores a la recuperación pandémica y eventos extremos de alta temperatura, fue posible comparar de forma objetiva el desempeño de los algoritmos de predicción con...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Este estudio demuestra que la integración de cuotas de costos industriales con aprendizaje automático proporciona un marco interpretable y preciso para la previsión de costos a largo plazo en redes eléctricas. Los resultados muestran que las variables relacionadas con el clima, particularmente los días de temperaturas extremadamente altas y los índices de impacto por desconexiones en líneas, son los factores dominantes de los residuos de costos, destacando la creciente influencia de las perturbaciones externas en los gas...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Todos los autores declaran que no tienen conflictos de intereses.
CONTRIBUCIÓN DE LOS AUTORES:
Xiaohui Wang concibió y diseñó el estudio, desarrolló la metodología, realizó el análisis formal y redactó el manuscrito original. Tong Li contribuyó a la curación de datos, implementación de software y validación. Yanchao Lu contribuyó al desarrollo de la metodología, investigación e interpretación de datos. Quanfeng Lv proporcionó recursos, supervisó la adquisición de datos y revisó críticamente el manuscrito. Fan Liu supervisó el proyecto, contribuyó a la conceptualización e interpretación de los resultados, obtuvo financiamiento y revisó críticamente el manuscrito. Todos los autores revisaron y aprobaron la versión final del manuscrito
Agradecimientos
Este trabajo fue apoyado por el Proyecto Tecnológico de la Corporación Estatal de Redes Eléctricas de China, con el nombre de "Investigación sobre Análisis de Asignación de Costos de Producción y Operación y Tecnología de Optimización Asíncrona" (Número de proyecto: 520600250029-183-ZN).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Conjunto de datos anónimos de contabilidad mensual de E-Grid | Red eléctrica provincial del este de China | N/A | Conjunto de datos anónimos mensuales de producción y costos operativos (2010–2025) compuesto por 192 observaciones, incluyendo datos de activos físicos, operación y mantenimiento, macroeconómicos y ambientales. Utilizado para el desarrollo del modelo (156 observaciones) y pruebas fuera de la muestra (36 observaciones). |
| Biblioteca de trazado Matplotlib | Equipo de desarrollo de Matplotlib | 3.5.2 | Utilizada para generar figuras del manuscrito y salidas gráficas, incluyendo gráficos de desempeño del modelo, visualizaciones de topología, diagnósticos de residuos, gráficos radiales y resúmenes visuales relacionados con SHAP. |
| Biblioteca de cálculo numérico NumPy | Desarrolladores de NumPy | 1.22.3 | Utilizada para operaciones numéricas con arreglos, cálculos matriciales y control de reproducibilidad. Se aplicó una semilla aleatoria fija de 42 cuando fue relevante. |
| Biblioteca de manipulación de datos Pandas | Equipo de desarrollo de pandas | 1.4.2 | Utilizada para importación, integración, reestructuración, filtrado y preprocesamiento de datos, incluyendo imputación de valores faltantes, alineación de series temporales y preparación de variables de entrada del modelo. |
| Ambiente de programación Python | Fundación Python Software | 3.9.13 | Ambiente de programación utilizado para implementar todo el flujo de trabajo de pronóstico, incluyendo preprocesamiento de datos, ingeniería de características, entrenamiento del modelo, optimización de hiperparámetros, predicción, pruebas estadísticas y evaluación del desempeño. |
| Biblioteca de aprendizaje automático Scikit-learn | Colaboradores de scikit-learn | 1.0.2 | Utilizada para preprocesamiento de datos, división entre entrenamiento y validación, evaluación de modelos auxiliares y procedimientos estadísticos, incluyendo análisis de correlación de Pearson y cálculo de métricas de desempeño seleccionadas. |
| Biblioteca de cálculo científico SciPy | Colaboradores de SciPy | 1.9.0 | Utilizada para cálculos estadísticos, incluyendo análisis de correlación de Pearson y procedimientos auxiliares para el tratamiento de valores atípicos y winsorización. |
| Implementación del Estimador de Parzen con estructura de árbol | Colaboradores de Optuna | 3.1.0 | Implementación de optimización bayesiana utilizada para ajustar los hiperparámetros de XGBoost, incluyendo profundidad máxima del árbol, tasa de aprendizaje y parámetros de regularización. El Estimador de Parzen con estructura de árbol se implementó mediante el paquete de código abierto Optuna. |
| Biblioteca de software XGBoost | DMLC / Colaboradores de XGBoost | 1.7.1 | Biblioteca de aprendizaje conjunto basada en árboles de decisión utilizada para compensación no lineal de residuos. El modelo implementó una función objetivo regularizada con pérdida Huber y penalizaciones por complejidad del árbol, como se describe en las Ecuaciones 7–9. |
Referencias
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.