Este protocolo describe un flujo de trabajo híbrido cuántico–clásico reproducible para clasificar la enfermedad de Parkinson a partir de grabaciones de voz humanas, incluyendo preprocesamiento de datos, implementación de circuitos cuánticos, entrenamiento de modelos y validación cruzada para replicación independiente.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Un protocolo híbrido cuántico-clásico reproducible para clasificar la enfermedad de Parkinson a partir de grabaciones de voz humana
En este artículo
Resumen
Resumen
La enfermedad de Parkinson es un trastorno neurodegenerativo progresivo para el que los métodos de cribado accesibles y de bajo coste siguen siendo limitados. Las grabaciones vocales sostenidas contienen biomarcadores acústicos medibles asociados a disfonía relacionada con enfermedades que pueden adquirirse sin equipos especializados. Este protocolo describe una red neuronal convolucional híbrida cuántico-clásico de cuatro qubits (QI-HCNN) que combina un circuito cuántico parametrizado con una capa de clasificación clásica superficial para clasificar la enfermedad de Parkinson utilizando características acústicas de voz dimensionalmente reducidas. El protocolo también compara el enfoque propuesto con una red neuronal clásica adaptada en dimensionalidad y clasificadores de árboles potenciados por gradiente entrenados tanto en conjuntos de características reducidas como completos. Utilizando un conjunto de datos de acceso público y desidentificado que comprende 195 grabaciones de voz de 31 individuos, el QI-HCNN logró un área bajo la curva característica de operación del receptor de 0,78 mediante validación cruzada estratificada triple, en comparación con 0,87 para la red neuronal clásica emparejada y 0,94–0,95 para las líneas base potenciadas por gradiente entrenadas en los conjuntos de características reducidas y completas, respectivamente. Un análisis de ablación controlada demostró que una de las dos operaciones de entrelazamiento en el circuito no podía influir en la salida medida por diseño, mientras que la operación restante de entrelazamiento reducía, en lugar de mejorar, el rendimiento de clasificación en comparación con una variante no entrelazada. La validación cruzada agrupada por pacientes mostró además que las estimaciones de rendimiento variaron sustancialmente según los individuos asignados al conjunto de pruebas, reflejando el tamaño limitado de la cohorte. Por tanto, este protocolo proporciona una línea base cuántico-clásica totalmente especificada y reproducible de forma independiente, junto con una evaluación respaldada por datos de las fortalezas y limitaciones del diseño actual del circuito, proporcionando una base metodológica para futuras investigaciones en lugar de apoyar afirmaciones de preparación diagnóstica.
Introducción
La enfermedad de Parkinson es un trastorno neurodegenerativo crónico causado por la pérdida progresiva de neuronas dopaminérgicas en la sustancia negra, que afecta a más de 10 millones de personas en todo el mundo y representa una carga considerable y creciente para la saludpública. La enfermedad produce tanto síntomas motores, como temblores, rigidez y bradicinesia, como síntomas no motores como alteraciones del sueño y anosmia. El diagnóstico clínico se basa principalmente en el examen neurológico utilizando escalas motoras estandarizadas, complementadas, cuando están disponibles, con imágenes por transportador de dopamina; sin embargo, ambos enfoques requieren experiencia especializada e infraestructuras que no son uniformemente accesibles, y la evaluación clínica en etapas tempranas sigue siendosubjetiva 2. Dado que actualmente no existe una terapia modificadora de la enfermedad, la detección precoz es valiosa principalmente porque permite un manejo más temprano de los síntomas y un seguimiento longitudinal. Esta necesidad ha motivado el desarrollo de enfoques de cribado de bajo coste, escalables y no invasivos que pueden complementar, en lugar de reemplazar, la evaluación clínica.
El deterioro vocal es uno de los primeros cambios medibles asociados a la enfermedad de Parkinson y frecuentemente precede a los síntomas motoresevidentes. La fonación sostenida de una vocal sostenida proporciona una señal controlada a partir de la cual se pueden extraer características acústicas, incluyendo jitter, brillo, relación armónico-ruido, entropía de densidad de periodo de recurrencia y análisis de fluctuaciones destendenciadas. Se ha demostrado repetidamente que estas características contienen información diagnósticamente relevante y pueden adquirirse utilizando equipos de grabación de consumo 4,5. Un conjunto de datos de referencia público derivado de dichas grabaciones se ha convertido en un banco de pruebas estándar para esta tarea, y los métodos clásicos de aprendizaje automático aplicados a todo el conjunto de características, incluyendo máquinas de vectores de soporte, bosques aleatorios y árboles con gradiente aumentado, han reportado valores de área bajo la curva de características del receptor que se acercan a 0,99 6,7,8, lo que sugiere que la tarea de clasificación está cerca de resolverse cuando se utilizan el conjunto completo de características y las estrategias adecuadas para manejar el desequilibrio de clases. El aprendizaje automático cuántico ha surgido como un paradigma computacional alternativo para tareas de clasificación biomédica, en el que los circuitos cuánticos parametrizados utilizan superposición y entrelazamiento para representar interacciones de características con relativamente pocos parámetros entrenables, y los gradientes de circuitos pueden calcularse analíticamente usando la regla de desplazamiento de parámetros en lugar de aproximaciones de diferenciasfinitas 9. Sin embargo, muchos estudios publicados que describen redes neuronales "cuánticas" o "inspiradas en cuánticos" para aplicaciones biomédicas implementan arquitecturas completamente clásicas que adoptan formalismos matemáticos inspirados en la cuantía sin ejecutar un circuito cuántico parametrizado real ni en un simulador ni en hardwarecuántico 10. Los desarrollos recientes en la detección de la enfermedad de Parkinson también han incluido arquitecturas híbridas de redes neuronales convolucionales ytransformadores 11, métodos de aprendizaje profundo basados en la atención para imágenes por resonancia magnética (MRI)12, y redes neuronales convolucionales ligeras diseñadas para un diagnóstico computacionalmenteeficiente 13, ilustrando la rápida expansión de los enfoques de inteligencia artificial a través de múltiples modalidades de datos. De forma más amplia, el diagnóstico asistido por ordenador no invasivo se ha extendido con éxito a otras aplicaciones biomédicas, incluyendo las cadenas híbridas de aprendizaje automático y aprendizaje profundo para imagenmédica 14. Las evaluaciones comparativas de arquitecturas de aprendizaje profundo en el mismo conjunto de datos de voz pública demuestran además el fuerte rendimiento alcanzable usando modelos clásicos convencionales de funcionescompletas 15.
Estos desarrollos ponen de manifiesto una necesidad metodológica específica de un modelo reproducible de red neuronal convolucional híbrida cuántico-clásica (QI-HCNN) que (i) ejecute un circuito cuántico paramétrico genuino y totalmente especificado; (ii) se compara usando características de entrada idénticas tanto frente a una red neuronal clásica arquitectónicamente ajustada como a una línea base clásica fuerte; y (iii) se evalúa mediante un protocolo que examina explícitamente las principales fuentes de sesgo en pequeños conjuntos de datos biomédicos, incluyendo el desequilibrio de clases, la confusión demográfica y la fuga de datos a nivel de paciente durante la validación cruzada.
El objetivo general de este protocolo es proporcionar un flujo de trabajo QI-HCNN totalmente reproducible para la clasificación de la enfermedad de Parkinson utilizando grabaciones de voz humana. El protocolo describe un circuito cuántico parametrizado de cuatro qubits que emplea codificación angular, dos capas de entrelazamiento basadas en NOT controlado y una capa variacional entrenóntrica optimizada usando la regla de desplazamiento de parámetros, acoplada a una cabeza de clasificación clásica superficial y aplicada a una representación principal-componente de cuatro componentes de un conjunto de datos público de grabación de voz. El flujo de trabajo especifica, a un nivel suficiente para replicación independiente, todos los procedimientos de preprocesamiento, construcción completa del circuito, configuración clásica de entrenamiento y procedimientos de evaluación, incluyendo comparaciones con una red neuronal clásica adaptada en dimensionalidad, líneas base de árbol con ajuste dimensional y ampliación de gradiente completo, ablaciones controladas por componentes del circuito, validación cruzada agrupada por pacientes para evaluar la sensibilidad de los participantes que no participaron y estadística explícita Pruebas de significado. En lugar de presentar solo resultados favorables, el protocolo está diseñado para informar de forma transparente cuando los componentes individuales del circuito no mejoran de forma medible el rendimiento, proporcionando así un marco metodológico reproducible que puede informar el desarrollo futuro de la arquitectura QI-HCNN para tareas de clasificación biomédica de pequeñas cohortes.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este protocolo utiliza un conjunto de datos de grabación de voz de terceros, desidentificado y disponible públicamente. Los autores no recogieron nuevos datos de sujetos humanos, ni se requirió la aprobación adicional del comité de revisión institucional (IRB) para este estudio. El conjunto de datos descrito en la subsección de Adquisición de Conjuntos de Datos y Manejo de Datos a Nivel de Participante fue recopilado originalmente bajo aprobación ética institucional por Little et al.3, no contiene información directamente identificativa de los participantes (solo identificadores de registro anonimizados) y está disponible públicamente para uso investigador. Confirma, según tus políticas institucionales, si el análisis secundario de este conjunto de datos disponible públicamente requiere revisión ética. En la institución de los autores, se determinó que el análisis secundario retrospectivo de este conjunto de datos totalmente desidentificado y archivado públicamente estaba exento de la revisión completa del IRB.
Adquisición de conjuntos de datos y manejo de datos a nivel de participante
El conjunto de datos de Clasificación de la Enfermedad de Parkinson (UCI Machine Learning Repository, ID de Conjunto de Datos 174), descrito originalmente por Little et al.3, fue descargado. El conjunto de datos contenía 195 registros de fonación vocal sostenida /a/ de 31 individuos (23 diagnosticados con enfermedad de Parkinson y 8 controles sanos; rango de edad, 46–85 años). Como el repositorio no proporciona un DOI versionado, la fecha exacta de descarga se registró y reportó en la Tabla de Materiales. El conjunto de datos se proporcionó como un archivo de valores separados por comas (CSV) (parkinsons.csv). No se requirió descompresión ni conversión de archivos, y el archivo se importaba directamente usando la función read_csv desde la biblioteca Pandas (véase Tabla de Materiales).
Se verificó que el conjunto de datos descargado contenía 195 filas y 24 columnas que comprenden una columna de identificador de registro (formato: phon_R01_S sujeto 
 _ registro), 22 columnas acústicas continuas (Tabla 1) y una columna binaria de etiqueta de clase (estado: 1 = enfermedad de Parkinson; 0 = control sano). La Tabla 1 se utilizó como referencia para todas las características acústicas y categorías de características a lo largo del protocolo.
| Categoría | Características representativas | Importancia clínica |
| Frecuencia fundamental | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | Frecuencia fundamental, media, máxima y mínima de fonación; refleja la estabilidad de la vibración de las cuerdas vocales. |
| Jitter (perturbación en frecuencia) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | Variación de ciclo en ciclo en el periodo de altura, reflejando un control motor laríngeo deteriorado. |
| Shimmer (perturbación de amplitud) | MDVP: Brillo, MDVP: Brillo(dB), Brillo: APQ3, Resplandor: APQ5, MDVP: APQ, Brillo: DDA | Variación de ciclo en ciclo en la amplitud de la señal, reflejando fonaciones entrecortadas o inestables. |
| Medidas de ruido | NHR, HNR | Relación entre el ruido y los componentes armónicos (tonales) de la señal de voz. |
| Dinámica no lineal / escalado fractal | RPDE, D2, DFA, spread1, spread2, PPE | Medidas de dinámica vocal no lineal, periodicidad y correlaciones temporales a largo alcance asociadas a la vibración de las cuerdas vocales. |
Tabla 1: Categorías de características acústicas utilizadas para la clasificación de la enfermedad de Parkinson. Las 22 características acústicas extraídas del conjunto de datos de la Clasificación de la Enfermedad de Parkinson se agrupan en cinco categorías de características: frecuencia fundamental, jitter, brillo, medidas de ruido y dinámica no lineal. Se enumeran características representativas para cada categoría junto con su correspondiente significado clínico. MDVP, Programa de Voz Multidimensional; RAP, perturbación media relativa; PPQ, cociente de perturbación del período de altura; APQ, cociente de perturbación de amplitud; DDP, diferencia de diferencias periodales; DDA, diferencia absoluta media de amplitudes; NHR, relación ruido-armónicos; HNR, relación armónicos-ruido; RPDE, entropía de densidad de periodos de recurrencia; D2, dimensión de correlación; DFA, análisis de fluctuaciones destendenciadas; EPP, entropía del periodo de altura.
Se extraía un identificador de participante para cada grabación analizando la subcadena anterior al guion final en el nombre de la grabación. Por ejemplo, phon_R01_S01_1 y phon_R01_S01_2 fueron asignados al participante S01. Posteriormente se utilizaron identificadores de participantes, en lugar de identificadores de registro, para todos los procedimientos de validación agrupada o de excluir a un participante descritos en la subsección del Protocolo de Evaluación , porque las grabaciones obtenidas del mismo participante están correlacionadas acústicamente. Tras la extracción, se generó e inspeccionó una tabla de frecuencias con los identificadores para confirmar que las 195 grabaciones estaban asignadas exactamente a 31 participantes únicos, que ninguna grabación quedaba sin asignar y que el número de grabaciones por participante coincidía con la documentación del conjunto de datos fuente.
La distribución por clases se tabulaba tanto a nivel de registro (147 registros de enfermedad de Parkinson, 75,4%; 48 registros de control sano, 24,6%) como a nivel de participantes (23 de 31 participantes, 74,2%, diagnosticados con enfermedad de Parkinson). Ambas distribuciones se reportaron porque el desequilibrio a nivel de registro y a nivel de participante no es idéntico e influye en la evaluación posterior.
La ausencia de grupos de Parkinson y controles sanos con edades o sexo coincididos en el conjunto de datos fuente fue documentada como una limitación del estudio y se trasladó a la Discusión porque esta característica refleja la recopilación original de datos y no puede corregirse mediante preprocesamiento posterior.
Pipeline de preprocesamiento
Todos los procedimientos de preprocesamiento se realizaron de forma independiente dentro de cada pliegue de entrenamiento del procedimiento de validación cruzada descrito en la subsección del Protocolo de Evaluación . Tanto los pasos de normalización Min–Max como el análisis de componentes principales (PCA) se ajustaron usando únicamente la partición de entrenamiento de cada pliegue. Las transformaciones ajustadas se aplicaban posteriormente a la partición de prueba correspondiente sin necesidad de reajustar, para evitar la fuga de información desde la partición de prueba hacia los parámetros de preprocesamiento.
Las 22 características acústicas brutas en cada partición de entrenamiento se normalizaron usando un escalador Min–Max con un rango de salida de [0, π]. El escalador ajustado se aplicaba entonces tanto a las particiones de entrenamiento como a las de prueba del pliegue correspondiente (Ecuación 1). La ecuación 1 sigue la formulación estándar de normalización Min–Max y fue definida para el protocolo actual. La normalización Min–Max se realizó usando la clase MinMaxScaler de scikit-learn (versión 1.8.0) con feature_range=(0, π), copy=True y clip=False.
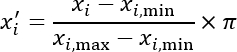 (1)
Se ajustó un modelo PCA con n_components = 4 utilizando únicamente los datos de entrenamiento normalizados. La transformación PCA ajustada se aplicó entonces tanto a las particiones de entrenamiento como a las de prueba. Se registró la proporción de varianza total explicada por los cuatro componentes principales retenidos para cada pliegue. En los análisis aquí presentados, los cuatro componentes principales retenidos explicaron el 81,5% de la varianza total (50,3%, 16,3%, 9,4% y 5,5%, respectivamente). La PCA se realizó usando la clase PCA con n_components=4, svd_solver="full", whiten=False y random_state=42.
Dado que PCA puede generar puntuaciones de componentes de valores negativos, se instaló un segundo escalador Min–Max con un rango de salida de [0, π] usando la partición de entrenamiento transformada en PCA. El escalador ajustado se aplicó posteriormente tanto a las particiones de entrenamiento como a las de prueba. Cualquier valor transformado de partición de prueba que cayera fuera del intervalo [0, π] se recortaba al límite más cercano porque el escalador se había ajustado usando solo la partición de entrenamiento. No había características de varianza cero en el conjunto de datos. La variedad de cada reportaje en las 195 grabaciones fue estrictamente positiva; por lo tanto, no surgió la condición de división por cero. Esto se confirmó verificando que la salida escalada no contenía ni NaN ni valores infinitos.
Los cuatro componentes principales renormalizados se asignaron secuencialmente como ángulos de rotación para los qubits 0, 1, 2 y 3 durante el procedimiento de codificación angular descrito en la subsección Construcción de Circuitos Cuánticos . El primer componente principal se asignó al qubit 0, el segundo al qubit 1, el tercero al qubit 2 y el cuarto al qubit 3. Esto completó la cadena de preprocesamiento y transfirió las características clásicas procesadas al circuito cuántico. Tras el segundo paso de escalado Min–Max, se confirmó que todos los valores de salida estaban dentro del intervalo [0, π]. Los valores de partición de prueba que quedaban ligeramente fuera de este rango debido a redondeos de punto flotante se recortaban al límite más cercano usando la función de recorte de NumPy (versión 2.4.4). Este procedimiento aseguraba que las cuatro entradas de la capa de codificación de ángulos fueran ángulos de rotación válidos dentro del intervalo [0, π].
Construcción de circuitos cuánticos
El circuito de cuatro qubits se construyó utilizando el simulador de vector de estado que se indica en la Tabla de Materiales y la secuencia de puertas descrita a continuación. El Archivo de Codificación Suplementario 1 se utilizó como la implementación completa del circuito ejecutable, incluyendo todas las funciones auxiliares para la construcción de puertas y el cálculo de gradientes de desplazamiento de parámetros. La Figura 1 muestra el flujo de trabajo completo desde el preprocesamiento de grabación de voz a través de las cuatro capas de circuito, la cabeza clásica de postprocesamiento y la clasificación final.
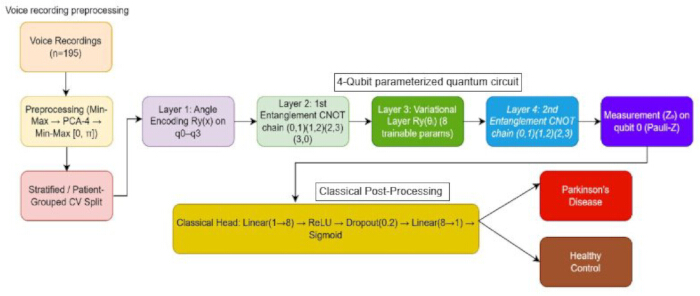
Figura 1. Arquitectura del sistema y flujo de trabajo de circuitos cuánticos. Flujo de trabajo para la clasificación de la enfermedad de Parkinson a partir de grabaciones de voz humana. El diagrama muestra preprocesamiento de grabación de voz, validación cruzada estratificada o agrupada por pacientes, ejecución de circuitos cuánticos parametrizados de cuatro qubits, medición Pauli-Z de un solo qubit en qubit 0, postprocesamiento clásico y clasificación binaria final como enfermedad de Parkinson o control sano. CNOT, compuerta controlada-NOT; PCA, análisis de componentes principales; ReLU, unidad lineal rectificada. Por favor, haz clic aquí para ver una versión ampliada de esta figura.
Un registro de cuatro qubits se inicializaba en el estado base computacional ∣0000.
Para la capa de codificación de ángulos, se aplicó una puerta de rotación Ry (x i) al qubit i, donde i = 0,1,2,3, utilizando los cuatro ángulos producidos por la tubería de preprocesamiento (Ecuación 2). La ecuación 2 describe el procedimiento estándar de codificación angular utilizado en circuitos cuánticos parametrizados, consistente con el marco de aprendizaje de circuitos cuánticos parametrizados de Mitarai et al.9, y se aplicó aquí en la configuración específica de cuatro qubits definida para el protocolo actual.
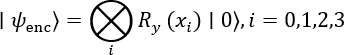 (2)
Para la primera capa de entrelazamiento, se aplicó una cadena circular de compuertas controladas-NO en el siguiente orden control-objetivo: (0,1), (1,2), (2,3) y (3,0).
Para la capa variacional, los ocho parámetros entreenables w0 a w 7 se inicializaron mediante muestreo independiente a partir de una distribución normal con media de 0 y desviación estándar de 0,3. La semilla aleatoria utilizada se registró en la Tabla de Materiales. Los ocho parámetros cuánticos variacionales se inicializaron usando numpy.random.default_rng(42 + fold_index).normal(0, 0,3, tamaño = 8), donde fold_index es el número de plegamiento basado en cero, proporcionando así inicializaciones específicas pero reproducibles. Para cada qubit i = 0,1,2 y 3, se aplicaba una puerta R z(w i), seguida de una puertaR y(w i+4) (Ecuación 3). La ecuación 3 describe una capa cuántica variacional (entrenable) consistente con el marco general de aprendizaje de circuitos cuánticos parametrizados introducido por Mitarai et al.9 y fue instanciada aquí usando la secuencia específica de puertas y parametrización definida para el protocolo actual.
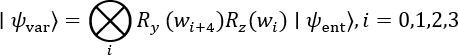 (3)
Para la segunda capa de entrelazamiento, se aplicó una cadena abierta de compuertas controladas-NOT en el siguiente orden de control-objetivo: (0,1), (1,2) y (2,3). Esta cadena no se cerró de nuevo al qubit 0.
El valor esperado del operador de Pauli- solo en el qubit 0,  , se calculó usando un producto interno de vector de estado. La ejecución en circuitos utilizaba un simulador personalizado de vector de estado implementado mediante operaciones estándar de matriz numérica (Archivo de Codificación Suplementario 1; qhcnn.py). Se utilizó la precisión Complex128 (numpy.complex128) en todo el sistema. Los valores esperados se calcularon analíticamente a partir del producto interno del vector de estados; por lo tanto, no se realizó muestreo basado en disparos. No se requería ningún marco de computación cuántica de terceros. Si se hubiera utilizado un simulador basado en muestreo o un dispositivo cuántico en lugar del simulador de vector de estado, se habrían realizado mediciones repetidas en base computacional del qubit 0, y las frecuencias de bits resultantes se habrían convertido en un valor esperado (Ecuación 4). La ecuación 4 es la fórmula estándar de valor esperado de la mecánica cuántica y se aplicó aquí al observable de Pauli de un solo qubit definido para el protocolo actual. Como no se realizó muestreo basado en disparos, no se requirió mitigación de errores de medición. El simulador utilizaba indexación de qubits big-endian, con qubit 0 correspondiente al bit más significativo del índice del vector de estado. Esta convención se tuvo en cuenta explícitamente al construir el observable de Pauli para asegurar que se midiera el valor esperado correcto.
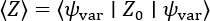 (4)
El gradiente de respecto a cada uno de los ocho parámetros variacionales se calculó usando la regla de desplazamiento de parámetro. El circuito se evaluó dos veces para cada parámetro durante cada cálculo de gradiente, una vez en θ + π/2 y otra en θ - π/2 (Ecuación 5). La ecuación 5 es la regla estándar de desplazamiento de parámetros introducida por Mitarai et al.9 y se aplicó aquí sin modificaciones.
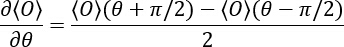 (5)
La segunda capa de entrelazamiento, como se especificó anteriormente, nunca aplicó una puerta controlled-NOT con qubit 0 como objetivo. Debido a que una compuerta controlled-NOT deja sin cambios el estado reducido de su qubit de control, la segunda capa de entrelazamiento no podría alterar , independientemente de los valores de los parámetros entrenables. Para permitir que la segunda capa de entrelazamiento influya en la salida medida en un protocolo modificado, el qubit 0 tendría que incluirse como objetivo, por ejemplo, cerrando la cadena con una puerta controlled-NOT adicional (3,0), o se tendría que medir un observable multiqubit en lugar de un valor esperado de un solo qubit. La segunda capa de entrelazamiento originalmente especificada se mantuvo en este protocolo, y su contribución medida se informó explícitamente en la sección de Resultados en lugar de corregirse silenciosamente, ya que este comportamiento de circuito forma parte de los hallazgos actuales.
Capa clásica de postprocesamiento
La etapa clásica de postprocesamiento consistía en una red neuronal de avance (feed-forward) implementada utilizando las operaciones numéricas estándar basadas en matrices que se enumeran en la Tabla de Materiales. La salida del circuito escalar único,  , se mapeó a ocho unidades ocultas usando una capa totalmente conectada, seguida de una activación de unidad lineal rectificada (ReLU). Durante el entrenamiento, se aplicó una capa de abandono con una probabilidad de retención de 0,8 (tasa de abandono = 0,2). Las ocho unidades ocultas se mapearon entonces a una única unidad de salida usando una segunda capa completamente conectada, y se aplicó una función de activación sigmoide para generar la probabilidad final de clase, ŷ (Ecuación 6). La ecuación 6 define la arquitectura clásica específica de postprocesamiento utilizada en el protocolo actual y comprende operaciones lineales estándar, unidades lineales rectificadas (ReLU) y sigmoides.
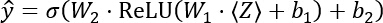 (6)
Las matrices de peso de la primera y segunda capa se inicializaron mediante muestreo independiente desde una distribución normal con media de 0 y desviación estándar de 0,5, mientras que todos los términos de sesgo se inicializaron a 0. La misma instancia generadora de números aleatorios y semilla utilizada para la inicialización de los parámetros variacionales cuánticos también se empleó para la capa clásica para asegurar la reproducibilidad de ejecución a ejecución. Específicamente, las matrices clásicas de pesos se inicializaron usando numpy.random.default_rng(42 + fold_index).normal(0, 0,5, size=...), mientras que todos los términos de sesgo se inicializaron a cero. Se creaba una única instancia generadora de números aleatorios semillada, inicializada con 42 + fold_index, al inicio de cada pliegue de validación cruzada y reutilizada secuencialmente para la inicialización de parámetros cuánticos, inicialización clásica de pesos, barajado en mini-lotes y generación de máscaras de dropout, en lugar de usar flujos semilla independientes separados para cada proceso.
Durante el entrenamiento, el dropout se aplicaba generando una nueva máscara binaria muestreada en cada paso hacia adelante usando la convención de retirada invertida, en la que las unidades supervivientes se escalaban en 1/0,8. Durante la validación y las pruebas, el corte se desactivó completamente y se utilizó la red completa y sin escalar para la inferencia.
El modelo combinado QI-HCNN contenía 33 parámetros entrenables: ocho parámetros variacionales cuánticos del circuito cuántico y 25 parámetros clásicos. El componente clásico comprendía ocho pesos y ocho sesgos en la primera capa completamente conexa, junto con ocho pesos y un sesgo en la segunda capa completamente conexa. Las dimensiones del tensor de peso y polarización eran 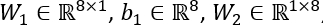 y
 . La capa clásica de postprocesamiento se implementó completamente utilizando operaciones numéricas estándar de matriz sin un marco adicional de aprendizaje automático. Todos los cálculos clásicos se realizaron utilizando aritmética float64 (doble precisión).
Formación en modelos
El circuito cuántico descrito en la subsección de Construcción de Circuitos Cuánticos y la capa clásica de postprocesamiento descrita en la subsección de Capa Clásica de Postprocesamiento se combinaron en un único modelo entrenábil de extremo a extremo. Los 33 parámetros entreenables se optimizaron conjuntamente usando el optimizador Adam con una tasa de aprendizaje inicial de 0,01 y una decaída de pesos, implementada como una penalización L2 de , aplicada solo a las matrices clásicas de pesos. El optimizador Adam se implementaba manualmente usando operaciones numéricas estándar de matriz con los siguientes ajustes: tasa de aprendizaje = 0,01, β1 = 0,9, β2 = 0,999, ∈ = 1 × 10⁻⁸, y decaimiento de pesos = 1 × 10⁻⁴, aplicados solo a las matrices clásicas de pesos y no a los términos de sesgo ni a los parámetros variacionales cuánticos.
Se utilizó la entropía cruzada binaria como función de pérdida. Para el procedimiento de balanceo de clases posterior a la división descrito en la subsección del Protocolo de Evaluación, la contribución a la pérdida de cada muestra de entrenamiento se ponderó por la frecuencia inversa de su clase dentro de la partición de entrenamiento del pliegue actual. Para el protocolo desequilibrado, se asignaron pesos muestrales uniformes. La entropía cruzada binaria se calculó como la pérdida media en todas las muestras dentro de cada mini-lote usando la formulación estándar de entropía cruzada binaria.
El modelo se entrenó durante 30 épocas utilizando mini-lotes de 16 muestras. Las muestras de entrenamiento se barajaban aleatoriamente al inicio de cada época usando numpy.random.default_rng(42 + fold_index).permutación(n) para generar un orden aleatorio de muestras. Cuando el número de muestras de entrenamiento no era divisible de forma uniforme por 16, el minilote final más pequeño se conservaba y procesaba a su tamaño real en lugar de descartarse.
Durante la formación se aplicó un calendario de tasa de aprendizaje por escalones. La tasa de aprendizaje se multiplicaba por 0,7 tras cada 10 épocas completadas, específicamente al inicio de las épocas 11 y 21.
Los gradientes para los ocho parámetros variacionales cuánticos se calcularon usando la regla de desplazamiento de parámetros descrita en la subsección Construcción de Circuitos Cuánticos . Los gradientes para los 25 parámetros clásicos se calcularon usando diferenciación estándar en modo inverso a través de la capa clásica. La salida del circuito cuántico, , y sus gradientes de desplazamiento de parámetros servían como interfaz entre el circuito cuántico y la capa clásica. Los 33 parámetros se actualizaron usando la misma instancia del optimizador Adam.
No se utilizó la parada temprana basada en validación. Cada modelo se entrenó para el calendario fijo de 30 épocas, y se informó que el rendimiento de la partición de prueba se mantenía tras completar la época final. Todos los parámetros del modelo (parámetros variacionales cuánticos, matrices clásicas de pesos y términos de sesgo) se reinicializaban de forma independiente al inicio de cada plegamiento de validación cruzada usando la semilla aleatoria específica del pliegue (42 + fold_index). Los parámetros no se compartían entre pliegues ni corridas de línea base.
El entorno computacional, que incluía procesador, memoria, versiones de software y el tiempo aproximado de entrenamiento del reloj de pared por pliegue, se registró en la Tabla de Materiales.
Protocolo de Evaluación
El rendimiento del modelo se evaluó utilizando procedimientos de validación cruzada tanto a nivel de registro como a nivel de participante, junto con comparaciones de modelos de referencia, análisis de balanceo de clases, experimentos de ablación de circuitos, pruebas de significación estadística y análisis de importancia de características.
Para la evaluación primaria, las 195 grabaciones de voz se particionaron en tres pliegues estratificados usando una semilla aleatoria fija, mientras se mantenía la relación de enfermedad de Parkinson a nivel de registro/control sano del 75,4%/24,6% dentro de cada pliegue. El modelo descrito en las secciones anteriores se entrenó usando dos pliegues y se evaluó en el pliegue restante extendido, y este procedimiento se repitió hasta que cada pliegue sirvió una vez como partición de prueba. Se calcularon la precisión, la exactitud, la recuperación, la puntuación F1 y el área bajo la curva característica de funcionamiento del receptor (AUC–ROC) para cada pliegue y se reportaron como la media ± desviación estándar a lo largo de los tres pliegues. La validación cruzada estratificada principal de tres partes se implementó usando la clase StratifiedKFold con n_splits=3, shuffle=True y random_state=42.
Las predicciones de clase binaria se generaban aplicando un umbral de probabilidad fijo de 0,50 a la probabilidad de clase predicha, ŷ, producida por la capa clásica de postprocesamiento. La precisión, la exactitud, la memoria y la puntuación F1 se calcularon a partir de estas predicciones con umbral, mientras que AUC–ROC se calculó directamente a partir de los valores de probabilidad continua sin umbral. La precisión, el recuerdo y la puntuación F1 se calculaban usando las funciones métricas con zero_division=0, asignando un valor de 0,0 a cualquier métrica indefinida. No se produjo ninguna condición indefinida durante los experimentos reportados.
Los modelos de referencia se evaluaron utilizando las particiones de plegamiento idénticas y la representación idéntica de características preprocesadas de cuatro componentes generadas por la tubería de preprocesamiento. Un perceptrón clásico multicapa que contenía una capa oculta de ocho unidades activadas por ReLU, ajustadas arquitectónicamente al componente clásico del modelo híbrido pero sin el circuito cuántico, fue entrenado usando el optimizador Adam con una penalización L2 de 1 × 10⁻⁴. También se entrenó un clasificador de árbol potenciado por gradiente usando la misma representación de cuatro componentes con 200 árboles, una profundidad máxima de árbol de 3, una tasa de aprendizaje de 0,1 y un ponderado de clase igual a la frecuencia inversa de clase dentro de cada pliegue de entrenamiento. Además, se entrenó un segundo clasificador de árbol potenciado por gradiente usando la representación completa de 22 características generada tras la normalización inicial de Min–Max, sin aplicar PCA ni codificación cuántica de características. Este modelo utilizaba 300 árboles, una profundidad máxima de árbol de 4, una tasa de aprendizaje de 0,05 y la misma estrategia inversa de ponderación de clases con plegado de entrenamiento. La línea base clásica del perceptrón multicapa se implementó usando MLPClassifier con hidden_layer_sizes=(8,), activation="relu", solver="adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0,001, max_iter=500, early_stopping=False, shuffle=True y random_state=42. Se utilizó la inicialización de peso uniforme por defecto de Glorot (Xavier) proporcionada por la implementación. Las líneas base del árbol potenciadas por gradiente se implementaron usando XGBoost 3.3.0 con objetivo = "binario:logístico", eval_metric = "logloss", tree_method = "auto", submuestra = 1.0, colsample_bytree = 1.0, reg_alpha = 0, reg_lambda = 1 y random_state = 42.
Para evaluar el efecto del balanceo de clases post-division, se repitió el procedimiento principal de validación cruzada para el modelo QI-HCNN con la ponderación muestral habilitada. Los pesos de balanceo se calcularon exclusivamente a partir de la partición de entrenamiento de cada pliegue tras la división tren/prueba y no se calcularon desde la partición de prueba correspondiente que se extendió.
Los experimentos de ablación de componentes de circuito se realizaron repitiendo cuatro veces el flujo de trabajo completo de preprocesamiento, entrenamiento y evaluación, modificando solo las dos capas de entrelazamiento del circuito cuántico. Las cuatro variantes de circuito comprendían: (i) el circuito completo que contenía ambas capas de entrelazamiento; (ii) el circuito con la primera capa de entrelazamiento eliminada y la segunda retenida; (iii) el circuito con la primera capa de entrelazamiento conservada y la segunda eliminada; y (iv) el circuito con ambas capas de entrelazamiento eliminadas. Se mantuvieron particiones de plegamiento idénticas, semillas aleatorias y configuraciones de entrenamiento en los cuatro experimentos para que cualquier diferencia de rendimiento observada pudiera atribuirse únicamente a la configuración de capa entrelazada.
Como evaluación de robustez, se realizó una validación cruzada por grupos de participantes dividiendo a los 31 participantes, en lugar de las 195 grabaciones, en cinco grupos de seis a siete participantes cada uno. Durante cada iteración, el modelo se entrenó utilizando grabaciones de participantes de cuatro grupos y se evaluó utilizando grabaciones de participantes del grupo restante, asegurando que ningún participante contribuyera con grabaciones tanto a las particiones de entrenamiento como a las de prueba del mismo pliegue. Se informaron precisión, precisión, recuerdo, puntuación F1 y AUC–ROC como la desviación media ± estándar entre los cinco pliegues agrupados por participantes para el modelo QI-HCNN, el perceptrón multicapa clásico y la línea base aumentada por gradiente de cuatro características. La validación cruzada agrupada por participantes se implementaba usando la clase GroupKFold con n_splits=5, donde los identificadores de participantes servían como variable de agrupación. Como GroupKFold no baraja los grupos, los participantes fueron asignados según el orden determinista por defecto de la implementación, resultando en pliegues que contenían seis o siete participantes cada uno.
La significación estadística se evaluó aplicando pruebas de Wilcoxon con signo pareadas a los valores AUC–ROC por doble obtenidos para la evaluación primaria y los modelos de referencia. Se reportaron valores p exactos y el número correspondiente de observaciones pareadas porque el poder estadístico de esta prueba es limitado cuando solo hay un pequeño número de pliegues disponibles. Se definieron cuatro comparaciones par a pares AUC–ROC a priori: (1) QI-HCNN frente al perceptrón clásico multicapa; (2) QI-HCNN frente a la línea base del árbol potenciado por gradiente emparejado con PCA; (3) el perceptrón clásico multicapa frente a la línea base del árbol potenciado por gradiente adaptado por PCA; y (4) el modelo QI-HCNN desequilibrado frente al modelo QI-HCNN post-balanceado dividido. No se aplicó corrección por comparación múltiple porque los análisis eran exploratorios y el número limitado de pliegues redujo sustancialmente el poder estadístico.
El análisis de importancia de características se realizó utilizando el clasificador de árboles potenciado por gradiente entrenado en la representación completa de 22 características. Se extrajeron puntuaciones de importancia de características basadas en ganancias y se clasificaron para todas las características acústicas originales. Por separado, la PCA se ajustó al conjunto de datos completo solo para fines de reporte y no se utilizó durante la evaluación del modelo. Para cada característica acústica original, se sumaron las cargas absolutas entre los cuatro componentes principales conservados, y las características se clasificaron según estos valores. Se informaron tanto los métodos de clasificación como su solapamiento. Para el análisis de importancia de características basado en ganancias, la implementación del árbol incrementado por gradiente produjo valores únicos de ganancia en coma flotante, y no se produjeron empates. Para las clasificaciones de carga por componentes principales, los empates en los valores absolutos de carga sumados se resolvieron según el orden original de columnas de características en el conjunto de datos.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Todos los valores numéricos reportados en el texto están reconciliados y son idénticos a los presentados en las Figuras 2–8 y las Tablas 2–4. Cada figura se generaba directamente a partir del código proporcionado en el Archivo de Codificación Suplementaria 1 en lugar de prepararse manualmente, asegurando la consistencia entre los valores numéricos reportados y los datos graficados.
Rendimiento de valid...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Este protocolo especifica una arquitectura QI-HCNN totalmente reproducible para la clasificación de la enfermedad de Parkinson a partir de grabaciones de voz, en la que cada puerta, elección de inicialización de parámetro, paso de preprocesamiento y procedimiento de evaluación se describe a un nivel suficiente para su implementación independiente. El circuito propuesto se compara usando características de entrada idénticas y particiones de pliegue de validación cruzada idénticas frente a...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Conflicto de intereses:
Los autores declaran que no tienen intereses financieros o no financieros en competencia relacionados con esta obra.
Agradecimientos
Este trabajo no fue financiado por ninguna agencia u organización, ni técnica ni financieramente. Los autores agradecen a los mantenedores del Repositorio de Aprendizaje Automático de UCI por proporcionar acceso público al conjunto de datos de grabación de voz utilizado en este estudio.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Adam optimizer | Implementación estándar de optimización numérica | Implementación personalizada; NumPy 2.4.4 | Optimización conjunta de parámetros cuánticos y clásicos; Entrenamiento del modelo |
| Implementación de pérdida de entropía cruzada binaria | Implementación personalizada usando NumPy | NumPy 2.4.4; pérdida promediada (reducción media) en cada mini-batch | Función de pérdida de entrenamiento; Entrenamiento del modelo |
| Clasificador de árbol de gradiente impulsado | Biblioteca de impulso de gradiente de código abierto XGBoost | XGBoost 3.3.0; objetivo="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | Líneas base clásicas con características completas y coincidentes con PCA; Protocolo de evaluación |
| Biblioteca de aprendizaje automático | Biblioteca de aprendizaje automático de código abierto scikit-learn | scikit-learn 1.8.0 | Escalamiento Min–Max, análisis de componentes principales, validación cruzada estratificada, validación cruzada agrupada por participantes, línea base de perceptrón multicapa y métricas de evaluación |
| Biblioteca de cómputo numérico | Biblioteca de cómputo numérico de código abierto NumPy | NumPy 2.4.4 | Operaciones de matriz central, simulación de vector de estado y cálculo manual de gradiente |
| Conjunto de datos de clasificación de la enfermedad de Parkinson | Little, McSharry, Roberts, Costello y Moroz; distribuido a través del Repositorio de Aprendizaje Automático UCI | ID de conjunto de datos UCI 174; 195 grabaciones de 31 participantes; consultado el 19 de junio de 2025 | Fuente del conjunto de datos de grabación de voz con vocal sostenida; https://archive.ics.uci.edu/dataset/174 |
| Biblioteca de computación científica | Biblioteca de computación científica de código abierto SciPy | SciPy 1.17.1 | Prueba de significación estadística de rango firmado de Wilcoxon; Protocolo de evaluación |
| Simulador de vector de estado | Simulador de vector de estado personalizado (Archivo de codificación complementario 1; qhcnn.py) | Implementación pura de NumPy; precisión complex128 (doble); no se requiere backend externo | Ejecución del circuito cuántico de cuatro qubits; Construcción de circuito cuántico |
| Biblioteca de datos tabulares | Biblioteca de análisis de datos de código abierto Pandas | Pandas 3.0.2 | Carga de conjuntos de datos, inspección y manipulación tabular |
| Entorno computacional de estación de trabajo | Estación de trabajo CPU local (contenedor Linux alojado en la nube) | CPU x86_64; Ubuntu Linux; Python 3; no se utilizó GPU ni hardware cuántico; tiempo de entrenamiento aproximado en tiempo real de 30–60 segundos por repetición | Entorno computacional utilizado para todo el entrenamiento y la evaluación; simulación de vector de estado basada en CPU; no se requiere GPU ni hardware cuántico |
Referencias
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.