Este estudio investiga la relación entre el lupus eritematoso sistémico y la pérdida gestacional recurrente e identifica a IFI27 como un biomarcador candidato para investigaciones futuras.
Artículo de investigación
La aleatorización mendeliana y la bioinformática identifican a IFI27 como un biomarcador candidato para la pérdida recurrente del embarazo en el lupus eritematoso sistémico
* These authors contributed equally
En este artículo
Resumen
Resumen
El lupus eritematoso sistémico (SLE) se asocia con resultados adversos en el embarazo, pero su relación causal con la pérdida recurrente del embarazo (RPL) y sus características moleculares compartidas aún no están claras. Este estudio integró análisis bidireccionales de aleatorización mendeliana (MR) con dos muestras y bioinformática transcriptómica para investigar esta relación e identificar biomarcadores candidatos compartidos. Se seleccionaron FinnGen y UK Biobank porque proporcionan estadísticas resumidas de estudios de asociación del genoma completo (GWAS) de gran tamaño, no superpuestas y de ascendencia europea. Los genes diferencialmente expresados (DEG) se identificaron a partir de GSE61635 (sangre; |cambio en el log₂| > 1) y GSE165004 (endometrio; |cambio en el log₂| > 0,5) utilizando un valor de P ajustado < 0,05, seguido de enriquecimiento funcional, análisis de interacción proteína-proteína (PPI), selección de genes centrales, regresión mediante el operador de contracción y selección por mínimos absolutos (LASSO), validación externa utilizando GSE50772 y GSE198700, análisis de la curva característica de operación del receptor (ROC) y análisis de enriquecimiento de conjuntos de genes mediante una sola muestra (ssGSEA). Se encontró que el SLE predicho genéticamente se asociaba con un aumento estadísticamente significativo, aunque cuantitativamente modesto, de abortos espontáneos (razón de momios [OR] ponderada por varianza inversa [IVW] = 1,01, intervalo de confianza del 95 % [IC] = 1,00–1,02; P < 0,001). La fuerza del instrumento fue adecuada, y los análisis de sensibilidad no detectaron heterogeneidad importante, pleiotropía direccional ni variantes individuales influyentes. Cincuenta y nueve DEG compartidos se enriquecieron en respuestas inmunitarias antivirales, adhesión celular y procesos relacionados con la apoptosis. IFI27 mostró una sobreexpresión constante en la sangre de pacientes con SLE, pero una subexpresión en el endometrio y las vellosidades coriónicas de RPL, mientras que CXCL11 no tuvo una validación externa consistente. Los análisis retrospectivos de ROC arrojaron áreas bajo la curva (AUC) de 0,822 para SLE y 0,872 para RPL. Las puntuaciones de ssGSEA inferidas computacionalmente mostraron correlaciones entre la expresión de IFI27 y varias firmas de células inmunitarias, incluidas las células T helper 2 (Th2). Estos hallazgos identifican a IFI27 como un biomarcador candidato compartido por el SLE y la RPL; sin embargo, se requieren estudios clínicos y experimentales prospectivos para validar su significado biológico y clínico.
Introducción
El lupus eritematoso sistémico (LES) es una enfermedad autoinmune compleja caracterizada por la afectación multisistémica y una disregulación inmunitaria crónica1. Las alteraciones patológicas en el LES se atribuyen principalmente a respuestas inmunitarias adaptativas alteradas y a la deposición de complejos antígeno–anticuerpo, lo que conduce a lesión tisular mediada por autoinmunidad y daño orgánico2,3. La incidencia mundial del LES es aproximadamente de 5,14 (1,4–15,13) casos por 100 000 personas-año, con una incidencia estimada de 8,82 (2,4–25,99) casos por 100 000 personas-año entre mujeres4. El LES afecta a personas de todas las edades, pero ocurre predominantemente en mujeres en edad reproductiva5,6. Las pacientes embarazadas con LES presentan un mayor riesgo de resultados adversos durante el embarazo, incluyendo abortos de repetición, muerte fetal, parto pretérmino y restricción del crecimiento intrauterino7,8. Se define la pérdida gestacional recurrente (RPL) como dos o más abortos antes de las 20–24 semanas de gestación9. Su prevalencia reportada es de aproximadamente el 2,6 %10, lo que la convierte en una complicación reproductiva clínicamente significativa. Aproximadamente el 20 % de las pacientes embarazadas con LES experimentan aborto espontáneo11, y el LES es reconocido como un factor de riesgo importante para la RPL12. Los mecanismos propuestos incluyen alteraciones hormonales y disregulación inmunitaria. Se han estudiado biomarcadores como los anticuerpos anticardiolipina y el anticoagulante lúpico como posibles predictores de resultados adversos del embarazo en pacientes con LES11. Estos autoanticuerpos pueden unirse a células trofoblásticas placentarias, alterar la señalización, proliferación e invasión del trofoblasto, modular la secreción de hormonas y citocinas, y aumentar la apoptosis, contribuyendo así a resultados gestacionales deficientes13. Además, la beta-2 glicoproteína I (β2-GPI), un antígeno principal en el síndrome antifosfolípido, se expresa en el tejido placentario. La unión de anticuerpos anti-β2-GPI a la β2-GPI inhibe el crecimiento y la diferenciación del trofoblasto, provocando defectos placentarios. Esta interacción también promueve un entorno proinflamatorio caracterizado por la producción de citocinas destructivas y la activación del complemento, lo que contribuye a la trombosis placentaria y al aborto recurrente14,15. Sin embargo, estudios previos a menudo han carecido de análisis exhaustivos de tejidos reproductivos locales, como la decidua, limitando la capacidad de correlacionar biomarcadores sistémicos con cambios patológicos locales. Además, el manejo del embarazo complicado por LES y la prevención de resultados adversos del embarazo siguen siendo desafíos. La susceptibilidad genética contribuye al desarrollo del LES, y también se ha implicado la variación genética en la patogénesis de la RPL16,17. No obstante, si existe una relación causal entre el LES y la RPL, así como los mecanismos moleculares y los genes compartidos que subyacen a su coexistencia, sigue siendo poco claro.
La aleatorización mendeliana (MR) es un enfoque establecido para la inferencia causal que utiliza variantes genéticas como variables instrumentales para estimar los efectos causales de exposiciones sobre resultados de enfermedades18. Al aprovechar la relación entre genotipo y fenotipo, la MR reduce el sesgo por factores de confusión y causalidad inversa en comparación con estudios observacionales convencionales. Paralelamente, los avances en plataformas de microarreglos genómicos y secuenciación de alto rendimiento han permitido que los análisis bioinformáticos identifiquen biomarcadores diagnósticos candidatos y dianas terapéuticas mediante el perfilado transcriptómico. La integración de estos enfoques complementarios podría proporcionar una comprensión más completa de la relación entre el LES y el RPL al combinar evidencia genética causal con patrones de expresión génica asociados a la enfermedad. Por lo tanto, este estudio tuvo como objetivo investigar la posible relación causal entre el LES y el RPL, identificar biomarcadores candidatos y vías biológicas compartidas, y priorizar dianas para futuras validaciones. Para alcanzar estos objetivos, se especificó previamente el siguiente flujo de trabajo analítico: MR bidireccional para evaluar la dirección causal; análisis independientes de expresión génica diferencial seguidos de integración transcriptómica; análisis de redes de interacción proteína-proteína (PPI) y regresión mediante el operador de contracción y selección por mínimos absolutos (LASSO) para la priorización de biomarcadores; validación externa de la expresión y análisis de la curva característica de operación del receptor (ROC); y análisis de enriquecimiento de conjuntos de genes para una sola muestra (ssGSEA) para evaluar las asociaciones con firmas de células inmunitarias. Este flujo de trabajo por etapas se resume en Figura 1.
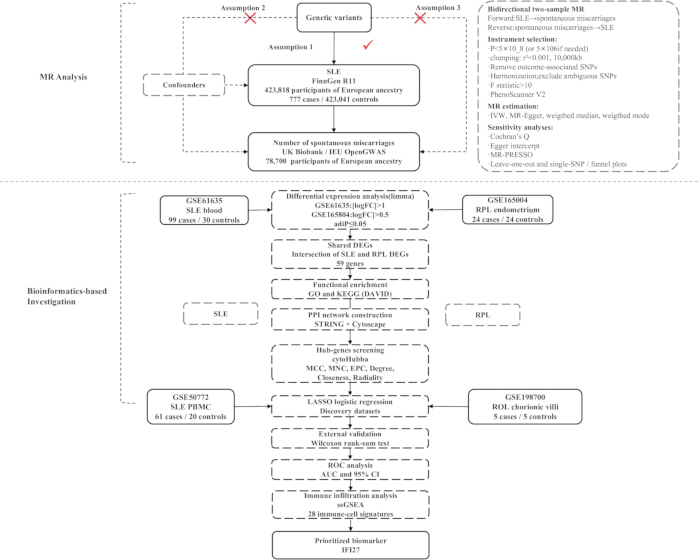
Figura 1. Diseño del estudio y flujo de trabajo analítico.
El panel superior ilustra el análisis de aleatorización mendeliana (MR) bidireccional con dos muestras para evaluar la asociación entre el lupus eritematoso sistémico (SLE) y el número de abortos espontáneos, utilizando estadísticas resumidas de estudios de asociación del genoma completo (GWAS). Se resumen la selección de instrumentos, la agrupación por desequilibrio de ligamiento, los análisis de aleatorización mendeliana (MR) y los análisis de sensibilidad. El panel inferior describe el flujo de trabajo de bioinformática, que incluye el análisis de expresión diferencial, la identificación de genes expresados diferencialmente (DEG) compartidos, el análisis de enriquecimiento funcional, la construcción de redes de interacción proteína-proteína (PPI), la selección de genes centrales (hub genes), la regresión mediante el operador de contracción y selección por mínimos absolutos (LASSO), la validación externa, el análisis de la curva ROC (característica operativa del receptor), el análisis de enriquecimiento de conjuntos de genes mediante una sola muestra (ssGSEA) y la priorización del biomarcador candidato IFI27. IVW, ponderado por varianza inversa; KEGG, Enciclopedia de Genes y Genomas de Kioto; GO, Ontología de Genes. Haga clic aquí para ver una versión más grande de esta figura.
Protocolo
No se requirió aprobación ética para el presente estudio porque solo implicó análisis secundarios de estadísticas resumidas de estudios de asociación del genoma completo (GWAS) y conjuntos de datos transcriptómicos, disponibles públicamente y con identificación eliminada. No se reclutaron nuevos participantes, no se recolectaron especímenes biológicos, ni se accedió a información identificable a nivel individual. Los estudios originales de FinnGen, UK Biobank y Gene Expression Omnibus informaron que se había obtenido aprobación ética y consentimiento informado de acuerdo con los requisitos institucionales, nacionales y específicos de cada base de datos. Todos los conjuntos de datos utilizados en este estudio se accedieron y analizaron de conformidad con las políticas aplicables de uso de bases de datos, condiciones de acceso a los datos y directrices éticas. Los autores no intentaron volver a identificar a ningún participante. Por lo tanto, no se requirió consentimiento informado adicional por escrito para este análisis secundario. El contenido de este estudio incluye dos partes: análisis MR y análisis bioinformático (Figura 1). Este estudio fue completamente computacional y utilizó conjuntos de datos públicos a nivel resumido de GWAS y transcriptómicos. No se utilizaron reactivos ni materiales de laboratorio húmedo.
Análisis de MR
Fuentes de datos, adquisición y preprocesamiento de las estadísticas resumidas de GWAS:
Las estadísticas resumidas de GWAS para el lupus eritematoso se obtuvieron de FinnGen Release 11 (finngen_R11_L12_LUPUS; RRID:SCR_022254), una cohorte finlandesa basada en la población. El fenotipo se definió utilizando el código CIE-10 L93 e incluyó a 423.818 participantes, compuestos por 777 casos y 423.041 controles. El archivo de estadísticas resumidas de FinnGen se descargó del portal público de datos de FinnGen en formato tabular comprimido y se importó a R utilizando la función read_exposure_data() o read_outcome_data() del paquete TwoSampleMR, dependiendo de si el conjunto de datos se utilizó como exposición o resultado. Se conservaron el rsID, cromosoma, posición genómica, alelo efecto, alelo alternativo, frecuencia del alelo efecto, coeficiente beta, error estándar y valor P de asociación.
Se obtuvieron estadísticas resumidas sobre el número de abortos espontáneos del UK Biobank a través del recurso IEU OpenGWAS (ukb-b-419; RRID:SCR_012815), que comprende 78 700 participantes. En el análisis directo, se recuperaron las asociaciones de los polimorfismos de un solo nucleótido (SNP) seleccionados de FinnGen con el resultado utilizando extract_outcome_data(outcomes = "ukb-b-419", proxies = FALSE). En el análisis inverso, se recuperaron los SNP asociados con el lupus eritematoso utilizando extract_instruments(outcomes = "finngen_R11_L12_LUPUS", clump = FALSE), tras lo cual se extrajeron las asociaciones correspondientes de SNP del archivo de estadísticas resumidas del UK Biobank. Las características de los conjuntos de datos GWAS utilizados en los análisis de MR bidireccionales se resumen en Tabla 1.
| Característica | Tamaño de la muestra | Ascendencia | Consortium | Año | Identificador del conjunto de datos de GWAS |
| Lupus eritematoso | 4,23,818 | Europea | FinnGen (RRID: SCR_022254) | 2024 | finngen_R11_L12_LUPUS |
| Número de abortos espontáneos | 78,700 | Europea | UK Biobank (RRID: SCR_012815) | 2018 | ukb-b-419 |
Tabla 1: Estadísticas resumidas de estudios de asociación del genoma completo (GWAS) utilizadas para el análisis de aleatorización mendeliana bidireccional.
La tabla resume los conjuntos de datos de estudios de asociación del genoma completo disponibles públicamente que se utilizaron como fuentes de exposición y resultado para los análisis de aleatorización mendeliana directo e inverso, incluyendo el tamaño de la muestra, la ascendencia, la fuente de los datos, el año de publicación de los datos y el identificador del conjunto de datos.
Se seleccionaron FinnGen y UK Biobank porque proporcionan conjuntos de datos amplios, de acceso público y predominantemente de ascendencia europea, derivados de poblaciones fuente no superpuestas y con cobertura suficiente de variantes para realizar un MR de dos muestras. No se informó superposición entre las muestras de exposición y resultado. Dado que solo se utilizaron datos resumidos, no se accedió a datos genotípicos a nivel individual, no se realizó ninguna normalización adicional a nivel de participantes y los investigadores actuales no excluyeron a ningún participante. Nos basamos en los procedimientos de control de calidad a nivel de muestra y a nivel de variantes implementados por los consorcios originales de GWAS. Durante el presente análisis, se realizó un control de calidad adicional a nivel de variantes mediante filtrado por significancia, agrupamiento por desequilibrio de ligamiento, armonización de alelos, evaluación de la fuerza del instrumento y cribado de pleiotropía, como se describe a continuación.
FinnGen Release 11 informa las posiciones genómicas según GRCh38/hg38, mientras que los conjuntos de datos armonizados de IEU OpenGWAS y el recurso de referencia de desequilibrio de ligamiento utilizan anotaciones de variantes compatibles con GRCh37. Por lo tanto, las variantes de exposición y resultado se emparejaron principalmente mediante rsID estables en lugar de coordenadas cromosómicas-posicionales. No se realizó ninguna coincidencia posicional directa entre ensamblajes. Se excluyeron las variantes sin un rsID inequívoco o con información alélica inconsistente entre conjuntos de datos antes del análisis de MR. Las estadísticas resumidas de FinnGen Release 11 utilizan GRCh38, mientras que los datos de OpenGWAS están armonizados con la convención de secuencia de referencia utilizada para el Build 37. Por ello, el emparejamiento por rsID es importante cuando se combinan ambos recursos.
Diseño del estudio de RM:
Cumplimos estrictamente con las directrices STROBE-RM (Archivo Suplementario 1)19. Se utilizó un diseño de RM bidireccional de dos muestras para evaluar la relación entre el lupus eritematoso predicho genéticamente y el número de abortos espontáneos. En el análisis directo, el lupus eritematoso se consideró la exposición y el número de abortos espontáneos el resultado. En el análisis inverso, se intercambiaron la exposición y el resultado, y se repitió completamente el flujo de trabajo de selección de instrumentos, agrupamiento por desequilibrio de ligamiento, armonización de datos, estimación causal y análisis de sensibilidad. Se utilizaron polimorfismos de nucleótido único (SNP) como variables instrumentales (VI). El flujo de trabajo completo se realizó en el siguiente orden: obtención y formato de las estadísticas resumidas de GWAS; selección de SNP asociados con la exposición; eliminación de variantes duplicadas o anotadas de forma incompleta; agrupamiento por desequilibrio de ligamiento; extracción de las asociaciones correspondientes al resultado; exclusión de SNP directamente asociados con el resultado; armonización de los alelos de exposición y resultado; cálculo de la fuerza del instrumento; detección de fenotipos de confusión potenciales; estimación de los efectos causales; evaluación de la heterogeneidad y la pleiotropía horizontal; detección de valores atípicos mediante la prueba Mendelian Randomization Pleiotropy RESidual Sum and Outlier (MR-PRESSO); y análisis de sensibilidad tipo leave-one-out y por SNP individual. Todos los análisis de RM se realizaron utilizando R versión 4.4.2 (RRID:SCR_001905), TwoSampleMR versión 0.6.6 (RRID:SCR_019010), MRPRESSO versión 1.0 (RRID:SCR_023697) y forestploter versión 1.1.2. El análisis de RM se basó en tres supuestos fundamentales. Primero, según el supuesto de relevancia, los SNP seleccionados deben estar fuertemente asociados con la exposición. Segundo, según el supuesto de independencia, los SNP seleccionados deben ser independientes de los factores que confunden la asociación entre exposición y resultado. Tercero, según el supuesto de exclusión-restricción, los SNP seleccionados deben influir en el resultado únicamente a través de la exposición20 (Figura 1).
Métodos de selección de SNP:
La selección de instrumentos se realizó en el siguiente orden: (1) seleccionar SNP asociados con la exposición con P < 5 × 10⁻⁸; cuando el número de instrumentos fuera insuficiente, utilizar P < 5 × 10⁻⁶; (2) utilizar la función clump_data() para realizar el agrupamiento por desequilibrio de ligamiento con R2 < 0,001 y una distancia genética de 10.000 kb, relajando los criterios a R2 < 0,01 dentro de 5.000 kb solo cuando fuera necesario para conservar un conjunto de instrumentos analizable; (3) filtrar los SNP significativamente asociados con el resultado utilizando un umbral de P = 5 × 10⁻⁵; (4) utilizar la función harmonise_data() para armonizar los alelos de exposición y resultado y excluir variantes palindrómicas u otras ambiguas; (5) calcular la fuerza del instrumento como F = β2/SE2, y excluir SNP con F < 10; y (6) analizar los SNP conservados en PhenoScanner V2 para identificar fenotipos que pudieran confundir la relación entre lupus eritematoso sistémico (LES) y pérdida gestacional21. Los anticuerpos antifosfolípidos (aPL) podrían ser un factor de riesgo compartido entre el LES y el número de abortos espontáneos. Se buscaron individualmente los SNP en PhenoScanner V2. Todos los SNP candidatos se consultaron en PhenoScanner V2 utilizando el catálogo GWAS predeterminado para recuperar todas las asociaciones reportadas en estudios de asociación del genoma completo (GWAS). El umbral de significancia se estableció en P < 1 × 10⁻5, y se utilizó la versión predeterminada del genoma de referencia (GRCh37). Dado que la población del estudio era de ascendencia europea, se activó la búsqueda de variantes sustitutas utilizando el panel de referencia europeo (proxies = "EUR"), con un umbral de desequilibrio de ligamiento de R2 > 0,8 dentro de una ventana de 1.000 kb. Todos los demás parámetros de búsqueda se mantuvieron en sus valores predeterminados. Los SNP que mostraron asociaciones significativas con el factor de confusión preespecificado, anticuerpos antifosfolípidos (aPL), se consideraron potencialmente pleiotrópicos y se excluyeron del conjunto final de variables instrumentales para minimizar la violación del supuesto de exclusión en el análisis de aleatorización mendeliana. Los SNP instrumentales conservados para los análisis de aleatorización mendeliana directo e inverso se enumeran en las Tablas Suplementarias 1 y 2, respectivamente.
Análisis estadístico:
Tras la selección de instrumentos y la armonización de alelos, las estimaciones causales se calcularon utilizando la función mr() en TwoSampleMR. El flujo de trabajo analítico se realizó en el siguiente orden. Primero, se estimó el efecto causal global mediante cuatro métodos de MR: ponderación por varianza inversa (IVW), regresión MR-Egger, mediana ponderada y moda ponderada. Las estimaciones del efecto sobre el número de abortos espontáneos y el LES se presentaron como razones de momios con sus intervalos de confianza del 95 % y valores P correspondientes. El método IVW se designó como análisis principal porque proporciona un alto poder estadístico cuando todos los SNPs incluidos son variables instrumentales válidas y no hay pleiotropía horizontal. Sin embargo, la estimación IVW puede estar sesgada cuando existe pleiotropía horizontal22. La regresión MR-Egger se utilizó principalmente para evaluar inferencias causales en presencia de pleiotropía horizontal potencial23. El enfoque de mediana ponderada requiere que al menos el 50 % del peso analítico provenga de variables instrumentales válidas. Este método es óptimo cuando existe heterogeneidad pero no pleiotropía horizontal24. La moda ponderada identifica grupos de variables instrumentales con efectos causales similares y estima el efecto a partir del grupo más grande25. Las estimaciones del efecto obtenidas mediante los cuatro métodos de MR se presentan en la Figura 2. Segundo, se evaluó la heterogeneidad entre las estimaciones causales específicas de cada SNP mediante la prueba Q de Cochran, implementada a través de la función mr_heterogeneity(). El estadístico Q representa la suma ponderada de los cuadrados de las desviaciones de las estimaciones individuales de SNP respecto a la estimación causal global. Un valor P de la prueba Q < 0,05 se consideró evidencia de heterogeneidad, en cuyo caso se aplicó un modelo IVW de efectos aleatorios. En ausencia de heterogeneidad significativa, se utilizó un modelo IVW de efectos fijos26. Tercero, se evaluó la pleiotropía horizontal direccional mediante la prueba del intercepto MR-Egger, implementada con la función mr_pleiotropy_test(). Un intercepto significativamente diferente de cero con P < 0,05 se consideró evidencia de pleiotropía horizontal direccional. Cuarto, se realizó el procedimiento MR-PRESSO utilizando la función mr_presso() en el paquete MRPRESSO (RRID:SCR_023697) para detectar SNPs con efectos pleiotrópicos atípicos27. Cuando se detectaron valores atípicos, se eliminaron y se repitió el análisis causal utilizando los instrumentos restantes. La prueba global de MR-PRESSO se usó para evaluar la pleiotropía horizontal general, y la prueba de distorsión se consideró al evaluar si la eliminación de los valores atípicos modificaba sustancialmente la estimación causal. Quinto, se realizó un análisis de sensibilidad de tipo leave-one-out (dejar uno afuera) utilizando la función mr_leaveoneout(). En este análisis, cada SNP se excluyó secuencialmente y la estimación causal agrupada se recalculó utilizando los SNPs restantes. Los resultados se visualizaron mediante mr_leaveoneout_plot() para determinar si la asociación global estaba desproporcionadamente influenciada por un solo instrumento. Sexto, se generaron estimaciones específicas individuales para cada SNP utilizando la función mr_singlesnp(). Estas estimaciones se utilizaron para construir gráficos de embudo con mr_funnel_plot() con el fin de evaluar visualmente la asimetría, posiblemente atribuible a pleiotropía horizontal direccional. Se generaron gráficos forestales resumidos mediante forestploter (versión 1.1.2) para mostrar las estimaciones del efecto y los intervalos de confianza obtenidos a partir de los diferentes métodos de MR. El gráfico de dispersión de MR directo, el gráfico forestal específico por SNP, el análisis leave-one-out y el gráfico de embudo se presentan en las Figuras Suplementarias 1–4, respectivamente.
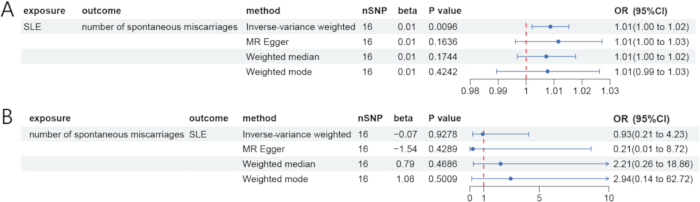
Figura 2. Resultados del análisis de aleatorización mendeliana bidireccional.
(A) Gráfico de bosque del análisis de aleatorización mendeliana (MR) directo con lupus eritematoso sistémico (SLE) como exposición y el número de abortos espontáneos como resultado. (B) Gráfico de bosque del análisis MR inverso con el número de abortos espontáneos como exposición y SLE como resultado. Las estimaciones del efecto se presentan como odds ratios (OR) con intervalos de confianza del 95% (IC) para los métodos ponderados por varianza inversa, MR-Egger, mediana ponderada y modo ponderado. SNP, polimorfismo de un solo nucleótido. Haga clic aquí para ver una versión más grande de esta figura.
Se consideró que había apoyo para una asociación causal cuando la estimación IVW era estadísticamente significativa con P < 0,05, las estimaciones de MR-Egger, mediana ponderada y modo ponderado mostraban direcciones consistentes con la estimación IVW, y los hallazgos no se alteraban sustancialmente debido a heterogeneidad, pleiotropía, MR-PRESSO o análisis de sensibilidad de exclusión uno por uno. Todas las pruebas estadísticas fueron bilaterales.
Análisis de bioinformática
Datos de microarreglos:
Los conjuntos de datos transcriptómicos se obtuvieron de la base de datos Gene Expression Omnibus (GEO; RRID:SCR_005012)28. Se descargaron los archivos de matriz de series procesados, los metadatos de las muestras y los archivos de anotación de la plataforma para GSE61635, GSE165004, GSE50772 y GSE198700. La plataforma, la fuente del tejido, el tamaño de la muestra y la categoría de análisis de cada conjunto de datos se resumen en Tabla 2. Dado que los conjuntos de datos se generaron a partir de diferentes tejidos y plataformas de microarreglos, cada conjunto se preprocesó y analizó de forma independiente. Las matrices de expresión de diferentes conjuntos de datos no se fusionaron directamente, y no se aplicó ninguna corrección de lotes entre plataformas. La integración entre conjuntos de datos se realizó únicamente a nivel de símbolo génico, después de que se completó el análisis de expresión diferencial de forma independiente dentro de cada conjunto de datos de descubrimiento.
| Conjunto de datos GEO | Enfermedad | Plataforma | Tejido (Homo sapiens) | Casos | Controles | Tipo de experimento | Contribuyente | Categoría del conjunto de datos |
| GSE61635 | Lupus eritematoso sistémico (LES) | GPL570 | Sangre total | 99 | 30 | Microarreglo de expresión | Greidinger EL | Conjunto de datos de descubrimiento |
| GSE165004 | Pérdida gestacional recurrente (PGR) | GPL16699 | Endometrio | 24 | 24 | Microarreglo de expresión | Keleş ID29 | Conjunto de datos de descubrimiento |
| GSE50772 | Lupus eritematoso sistémico (LES) | GPL570 | Células mononucleares de sangre periférica (CMSP) | 61 | 20 | Microarreglo de expresión | Kennedy WP30 | Conjunto de datos de validación |
| GSE198700 | Pérdida gestacional recurrente (PGR) | GPL13534 | Vellosidades coriónicas | 5 | 5 | Microarreglo de expresión | Li Y31 | Conjunto de datos de validación |
Tabla 2: Conjuntos de datos transcriptómicos utilizados para los análisis de bioinformática.
La tabla resume los conjuntos de datos transcriptómicos del Gene Expression Omnibus (GEO) incluidos en los análisis de descubrimiento y validación, que incluyen enfermedad, plataforma de microarreglo, origen del tejido, tamaño de la muestra, tipo de experimento, investigador principal del estudio original y categoría del conjunto de datos.
GSE61635 fue generado utilizando la plataforma Affymetrix Human Genome U133 Plus 2.0 Array (GPL570) y comprendió 99 matrices de sangre completa provenientes de pacientes con LES, incluyendo visitas repetidas de algunos pacientes, y 30 matrices de controles sanos independientes. La matriz de expresión depositada había sido sometida a corrección de fondo promedio multimatriz robusta, normalización por cuantiles, resumen de conjuntos de sondas y transformación log2 por parte de los investigadores originales. Por lo tanto, no se realizó ninguna segunda corrección de fondo ni normalización por cuantiles. Los identificadores de los pacientes se extrajeron de los metadatos de GEO y se conservaron para el modelado de medidas repetidas.
GSE165004 fue generado utilizando la plataforma de microarrays Agilent SurePrint G3 Human Gene Expression v2 8×60K (GPL16699). El conjunto de datos completo contenía 24 controles fértiles, 24 pacientes con abortos espontáneos recurrentes (RPL) y 24 pacientes con infertilidad inexplicada. Solo se incluyeron las 24 muestras de RPL y 24 muestras de controles fértiles recolectadas entre los días 19 y 21 del ciclo menstrual; se excluyeron las 24 muestras de infertilidad inexplicada porque estaban fuera de la comparación predefinida29. Se utilizó la matriz de expresión normalizada por el depositante, y no se aplicó ninguna normalización adicional entre matrices después de confirmar distribuciones comparables de las muestras mediante gráficos de caja y gráficos de densidad.
GSE50772 se utilizó como un conjunto de datos independiente para la validación de LES e incluyó muestras de células mononucleares de sangre periférica de 61 pacientes con LES y 20 controles sanos generadas mediante GPL57030. GSE198700 fue generado usando GPL13534 y contiene muestras de vellosidades coriónicas de cinco pacientes con AFR y cinco controles de aborto electivo31. La matriz de expresión depositada se importó en su totalidad y se transformó una vez mediante log2(x + 1), ya que los valores de expresión depositados se proporcionaron en una escala no logarítmica. Esta transformación se aplicó a toda la matriz de expresión antes del control de calidad a nivel de muestra, la anotación de sondas, la resumición a nivel génico, la validación de genes candidatos, el análisis de expresión diferencial, las pruebas de comparación entre grupos y el análisis ROC. Los genes candidatos no se transformaron por separado, y no se realizó ninguna transformación logarítmica adicional durante los análisis de validación posteriores. Para todos los conjuntos de datos, las identidades de las muestras, el estado de la enfermedad, el origen tisular y las etiquetas de grupo se verificaron cruzadamente con los metadatos correspondientes de GEO antes del análisis. El control de calidad incluyó la evaluación de tamaños de biblioteca o distribuciones de expresión, diagramas de caja por muestra, análisis de componentes principales, agrupamiento jerárquico y mapas térmicos de distancias entre muestras. No se excluyeron muestras adicionales tras la evaluación del control de calidad.
Análisis de expresión diferencial:
Los análisis de expresión diferencial se realizaron de forma independiente para GSE61635 y GSE165004 utilizando limma versión 3.60.6 (RRID:SCR_010943). Todas las matrices de expresión se organizaron con los genes en filas y las muestras en columnas. El umbral para la expresión diferencial se estableció en |cambio en el log₂| > 1 para GSE61635 y |cambio en el log₂| > 0.5 para GSE165004, con un valor de P ajustado por Benjamini–Hochberg (BH) < 0.05. Los gráficos de volcan fueron generados utilizando ggplot2 versión 3.5.1 (RRID:SCR_014601). Los mapas de calor de los 50 genes con mayor significancia en la expresión diferencial (DEGs), ordenados según el valor de P ajustado, se generaron utilizando pheatmap versión 1.0.12 (RRID:SCR_016418). Los DEGs comunes se identificaron mediante la intersección de los símbolos oficiales de los genes de las listas significativas de DEGs de SLE y RPL utilizando la función base intersect() de R, y se visualizaron usando ggvenn versión 0.1.16 (RRID:SCR_025300). Los mapas de calor de expresión diferencial, los gráficos de volcan y la intersección de las listas de DEGs de SLE y RPL se presentan en Figura 3.
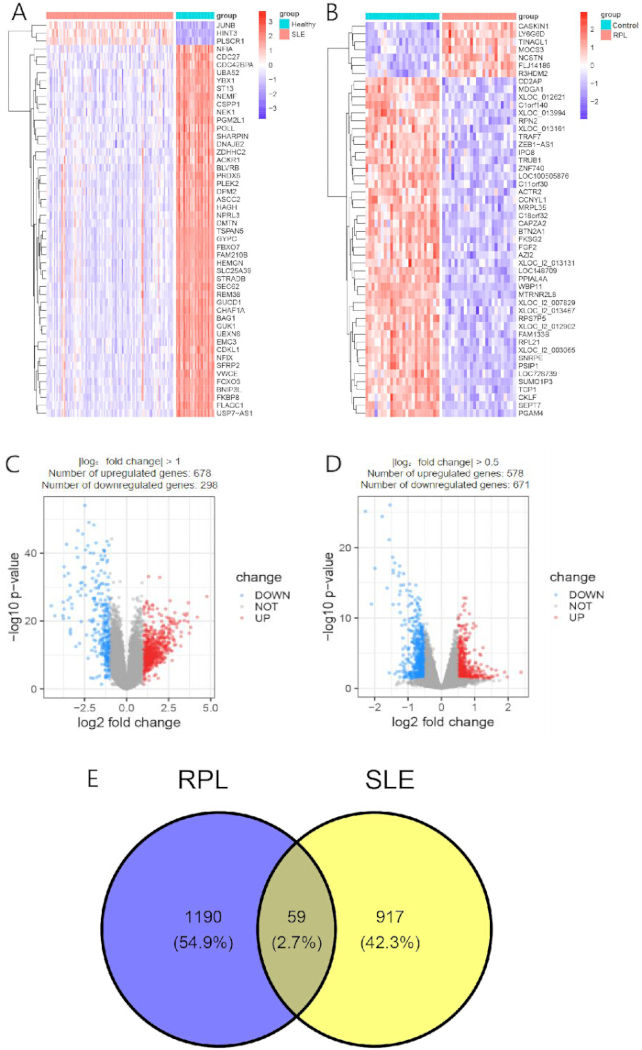
Figura 3. Genes expresados diferencialmente en el lupus eritematoso sistémico y la pérdida gestacional recurrente.
(A) Mapa de calor de los 50 genes expresados diferencialmente (DEG) más significativos entre pacientes con lupus eritematoso sistémico (LES) y controles sanos en GSE61635. (B) Mapa de calor de los 50 DEG más significativos entre pacientes con pérdida gestacional recurrente (PGR) y controles fértiles en GSE165004. (C) Gráfico de volcan para la expresión génica diferencial en GSE61635. (D) Gráfico de volcan para la expresión génica diferencial en GSE165004. (E) Diagrama de Venn que muestra la superposición entre las listas significativas de DEG de los conjuntos de datos de descubrimiento de LES y PGR. DEG, genes expresados diferencialmente. Haga clic aquí para ver una versión más grande de esta figura.
Análisis de enriquecimiento funcional de los DEG en intersección:
Para el análisis a nivel molecular de las funciones de los DEG, se utilizó la herramienta en línea DAVID (versión 2021; RRID:SCR_001881)32 para realizar análisis de enriquecimiento funcional de Ontología Genética (GO) y de vías de la Enciclopedia de Kyoto de Genes y Genomas (KEGG). Se cargaron los símbolos génicos oficiales humanos como tipo de identificador, y se seleccionó Homo sapiens como especie. La población de fondo personalizada consistió en la intersección de todos los genes que superaron la anotación de sondas y el control de calidad y que fueron medibles tanto en GSE61635 como en GSE165004. El umbral mínimo de conteo de genes se estableció en 2, y el valor máximo del puntaje EASE, que representa el valor P exacto de Fisher unilateral modificado por DAVID, se fijó en 0,05. El control de comparaciones múltiples se realizó mediante el procedimiento de Benjamini–Hochberg indicado en la columna «Benjamini» de DAVID. Los términos funcionales se consideraron estadísticamente significativos cuando el puntaje EASE era < 0,05 y el valor P ajustado por Benjamini era < 0,05. Se exportó como un archivo separado por tabulaciones la salida completa de DAVID, incluyendo nombres de términos, conteos de genes, puntajes EASE, valores P ajustados por Benjamini, mapeos de genes de entrada y mapeos de genes de fondo. Se utilizó el sitio web CNSknowall para visualizar los resultados filtrados de DAVID. Los resultados de enriquecimiento de GO y KEGG se presentan en Figura 4A.
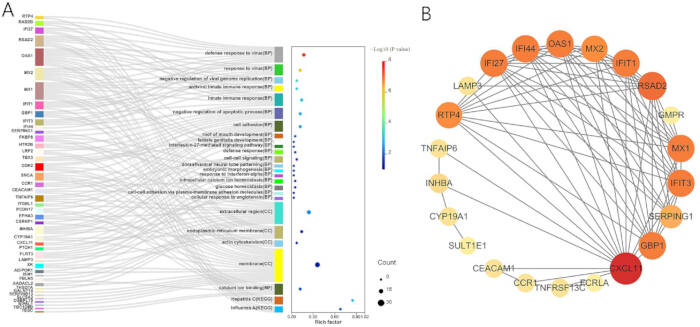
Figura 4. Análisis de enriquecimiento funcional y red de interacción proteína-proteína de los genes diferencialmente expresados compartidos.
(A) Análisis de enriquecimiento de Gene Ontology (GO) y Kyoto Encyclopedia of Genes and Genomes (KEGG) de los 59 genes diferencialmente expresados (DEGs) compartidos. El diagrama de Sankey ilustra las relaciones entre los genes y los términos GO enriquecidos, y el gráfico de burbujas adjunto resume los términos GO y KEGG enriquecidos según el factor de enriquecimiento, el número de genes y la significancia estadística. (B) Red de interacción proteína-proteína (PPI) construida a partir de los 59 DEGs compartidos utilizando STRING y visualizada en Cytoscape. El tamaño y el color de los nodos reflejan la conectividad de la red, y las aristas indican asociaciones proteína-proteína predichas. BP, proceso biológico; CC, componente celular; MF, función molecular. Haga clic aquí para ver una versión más grande de esta figura.
Red de interacciones proteína-proteína e identificación de genes centrales:
Los DEG compartidos se cargaron en STRING versión 11.0 (RRID:SCR_005223)33 seleccionando Homo sapiens como organismo (identificador taxonómico: 9606). Se utilizó la red completa de STRING, permitiendo tanto asociaciones proteicas físicas como funcionales. Se activaron todos los canales de evidencia disponibles, incluyendo evidencia experimental, bases de datos curadas, coexpresión, minería de textos, vecindad genética, fusión génica y co-ocurrencia génica.
Se estableció un puntaje mínimo de interacción requerido de 0,400, lo que corresponde a una confianza media. No se agregaron interactores adicionales de la primera o segunda capa; por lo tanto, la red contenía únicamente proteínas codificadas por los DEG compartidos enviados. Los enlaces de la red se mostraron utilizando el modo de confianza y se exportaron como un archivo de valores separados por tabulaciones que contenía las proteínas que interactúan y los puntajes combinados de STRING. Los puntajes de confianza de STRING representan la confianza en que existe una asociación, y no la magnitud o la fuerza de unión de la interacción.
El archivo de red STRING se importó a Cytoscape versión 3.10.0 (RRID:SCR_003032)34. Se eliminaron los nodos que no tenían ninguna interacción con otra proteína enviada antes del análisis de la topología de la red35. La red restante se trató como una red no dirigida. Se mantuvieron las puntuaciones combinadas de STRING como atributos de los enlaces para la visualización, mientras que los rangos cytoHubba se generaron utilizando las definiciones topológicas predeterminadas sin ponderar. La red de interacción de proteínas resultante se presenta en la Figura 4B.
Los genes centrales se clasificaron utilizando cytoHubba versión 0.1 (RRID:SCR_017677) con seis algoritmos: centralidad de clique máxima (MCC), componente máximo del vecindario (MNC), componente de percolación de aristas (EPC), grado, cercanía y radialidad36. Para cada algoritmo, los genes se ordenaron en orden descendente y se conservaron los 10 primeros genes. Los candidatos a nodos centrales de la red se definieron mediante la intersección estricta de las seis listas de los 10 primeros. Por lo tanto, un gen se conservó como nodo central de la red solo si aparecía entre los 10 primeros genes generados por los seis algoritmos. Los resultados de clasificación y el procedimiento de intersección se exportaron y archivaron. Los 10 genes principales identificados por cada algoritmo de cytoHubba se presentan en Tabla 3.
| Clasificación | Centralidad de Clique Máxima (MCC) | Componente Máximo del Vecindario (MNC) | Componente de Percolación de Aristas (EPC) | Grado | Cercanía | Radialidad |
| 1 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 |
| 2 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 |
| 3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 |
| 4 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 |
| 5 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 |
| 6 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 |
| 7 | MX1 | MX1 | MX1 | MX1 | MX1 | MX1 |
| 8 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 |
| 9 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 |
| 10 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 |
Tabla 3: Los 10 principales genes centrales identificados por seis algoritmos de clasificación cytoHubba.
Los genes expresados diferencialmente compartidos se clasificaron utilizando seis algoritmos de topología de red implementados en el complemento cytoHubba de Cytoscape. Se presentan los 10 primeros genes clasificados generados por cada algoritmo para su comparación entre Centrality de Clique Máxima (MCC), Componente de Vecindad Máxima (MNC), Componente de Percolación de Aristas (EPC), Grado, Cercanía y Radialidad.
Regresión LASSO para la identificación de genes centrales:
Se realizó una regresión logística LASSO independientemente en los conjuntos de datos de descubrimiento de LES y RPL utilizando glmnet versión 4.1-8 (RRID:SCR_015505). La matriz de predicción consistió en los valores de expresión normalizados de los candidatos a núcleo de la red, con muestras en filas y genes en columnas. El estado de la enfermedad se codificó como 1 y el estado de control como 0. Se ajustó un modelo lineal generalizado binomial con una penalización pura LASSO utilizando family = "binomial" y alpha = 1. Las variables predictoras se estandarizaron internamente usando standardize = TRUE, y se incluyó un intercepto. Se generaron asignaciones estratificadas por clase de 10 particiones por separado para los conjuntos de datos de LES y RPL mediante código personalizado en R base. Dentro de cada estrato de estado de enfermedad, los índices de las muestras se permutaron aleatoriamente y se distribuyeron lo más uniformemente posible entre las 10 particiones utilizando sample(rep(seq_len(10), length.out = n)). Se estableció una semilla aleatoria de 123 antes de generar las asignaciones de particiones para cada conjunto de datos, para garantizar la reproducibilidad. Dado que cada grupo de estado de enfermedad contenía más de 10 muestras, cada partición de validación cruzada incluyó tanto casos como controles. Los vectores enteros resultantes (foldid_sle y foldid_rpl) se proporcionaron al argumento foldid de cv.glmnet(), y se utilizaron las mismas asignaciones de particiones para todos los valores de λ evaluados dentro del conjunto de datos correspondiente.
Los modelos se ajustaron utilizando family = "binomial", alpha = 1, nfolds = 10, type.measure = "deviance", standardize = TRUE, intercept = TRUE, nlambda = 100, thresh = 1 × 10⁻7 y maxit = 100000. El parámetro de penalización se seleccionó usando lambda.min, definido como el valor de lambda que produce la desviación binomial mínima media validada mediante validación cruzada. Se registró lambda.1se, el cual es más conservador y se define como el valor más alto de lambda dentro de un error estándar del error mínimo de validación cruzada, como resultado de sensibilidad. El procedimiento LASSO se aplicó por separado a GSE61635 y GSE165004. Los genes con coeficientes distintos de cero en ambos modelos específicos de la enfermedad se definieron como genes candidatos seleccionados por LASSO compartidos. Al introducir el término de regularización L1, el método reduce eficazmente los coeficientes de los genes menos informativos a cero, realizando así una selección de características37. Los perfiles de coeficientes y las curvas de validación cruzada de 10 pliegues para los conjuntos de datos de descubrimiento de SLE y RPL se presentan en la Figura 5.
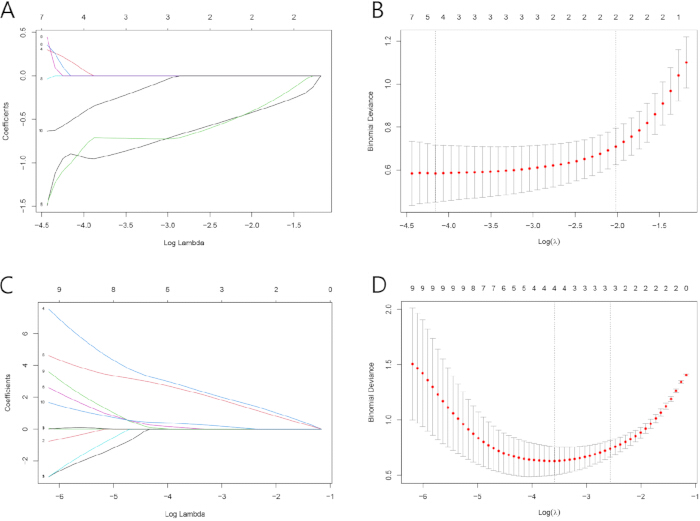
Figura 5. Análisis de regresión mediante el operador de contracción y selección de mínimos absolutos de los genes centrales de la red.
(A) Perfiles de coeficientes generados mediante regresión logística del operador de contracción y selección de mínimos absolutos (LASSO) para el conjunto de datos de descubrimiento de lupus eritematoso sistémico (LES) (GSE61635). (B) Curva de validación cruzada de diez pliegues utilizada para determinar el parámetro de penalización óptimo (λ) para el modelo de LES. (C) Perfiles de coeficientes generados mediante regresión logística LASSO para el conjunto de datos de descubrimiento de aborto recurrente (AR) (GSE165004). (D) Curva de validación cruzada de diez pliegues utilizada para determinar el parámetro de penalización óptimo (λ) para el modelo de AR. Los números a lo largo del eje x superior indican el número de coeficientes de regresión no nulos para cada valor de λ. Las líneas verticales discontinuas indican λ_min y λ_1se. Haga clic aquí para ver una versión más grande de esta figura.
Validación del valor diagnóstico de los genes centrales:
Se evaluaron los patrones de expresión de los genes candidatos seleccionados mediante LASSO en el conjunto de datos independiente de LES GSE50772 y en el conjunto de datos independiente de RPL GSE198700. Los conjuntos de datos externos se utilizaron únicamente después de haber completado la selección de genes candidatos en GSE61635 y GSE165004. No se realizó ninguna selección adicional de características ni ajuste de modelos en los conjuntos de datos de validación. La expresión de los genes candidatos se comparó entre casos y controles utilizando la prueba de suma de rangos de Wilcoxon bilateral. Cuando se analizó más de un gen candidato dentro de un conjunto de datos, los valores de P resultantes se corrigieron mediante el procedimiento de Benjamini–Hochberg. Se consideró que un gen candidato estaba replicado externamente cuando su expresión difería significativamente entre casos y controles tras la corrección por múltiples comparaciones y su dirección era consistente con el conjunto de datos de descubrimiento correspondiente. Los patrones de expresión de los genes candidatos en los conjuntos de datos de descubrimiento y validación se presentan en Figura 6.
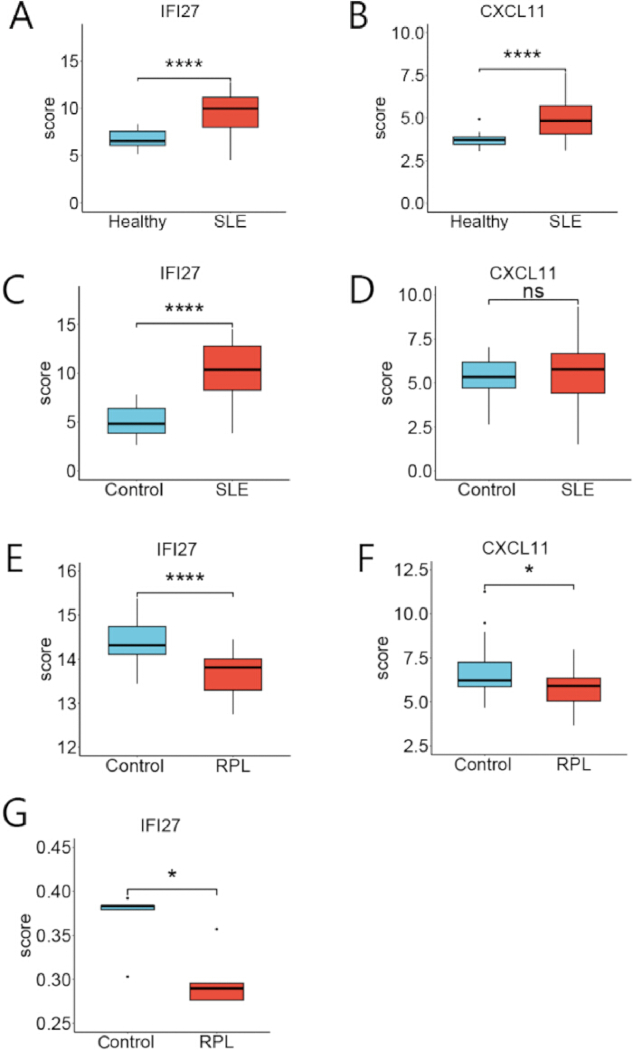
Figura 6. Expresión de IFI27 y CXCL11 en los conjuntos de datos de descubrimiento y validación.
(A,B) Expresión de IFI27 y CXCL11, respectivamente, en el conjunto de datos de descubrimiento de lupus eritematoso sistémico (LES) (GSE61635). (C,D) Expresión de IFI27 y CXCL11, respectivamente, en el conjunto de datos independiente de validación de LES (GSE50772). (E,F) Expresión de IFI27 y CXCL11, respectivamente, en el conjunto de datos de descubrimiento de aborto recurrente (AR) (GSE165004). (G) Expresión de IFI27 en el conjunto de datos independiente de validación de AR (GSE198700). La expresión génica se comparó entre grupos utilizando la prueba de suma de rangos de Wilcoxon bilateral. Los valores de P se ajustaron mediante el método de Benjamini–Hochberg cuando se analizaron múltiples genes candidatos dentro del mismo conjunto de datos. P < 0,05; **** P < 0,0001; ns, no significativo. Haga clic aquí para ver una versión más grande de esta figura.
Se realizaron análisis de características operativas del receptor (ROC) utilizando la versión 1.18.5 de pROC (RRID:SCR_024286)38. Se generaron curvas ROC independientes para cada gen candidato en cada conjunto de datos de descubrimiento. Se calculó el área bajo la curva ROC (AUC) y su intervalo de confianza del 95 % bilateral mediante el método de DeLong. El punto de corte diagnóstico exploratorio se determinó utilizando el índice de Youden máximo. Los intervalos de confianza para el punto de corte, sensibilidad y especificidad se calcularon mediante 2.000 réplicas de remuestreo bootstrap estratificado, con la semilla aleatoria establecida en 123. El AUC se utilizó como una medida independiente del umbral para evaluar la capacidad de discriminación39. Dado que los conjuntos de datos eran retrospectivos y se generaron utilizando diferentes tejidos, plataformas y procedimientos de normalización, los puntos de corte derivados del índice de Youden se calcularon por separado dentro de cada conjunto de datos y se consideraron umbrales exploratorios específicos de cada conjunto. No se consideraron puntos de corte clínicos estandarizados ni se transfirieron directamente entre plataformas. Los resultados externos de ROC representan una validación transcriptómica, no una validación clínica prospectiva. pROC permite calcular intervalos de confianza de DeLong para AUCs y la optimización mediante el índice de Youden a través de coords(), mientras que los intervalos de confianza para las coordenadas de la curva ROC pueden estimarse mediante remuestreo bootstrap estratificado. Las curvas ROC y los resúmenes de la capacidad de discriminación de los genes candidatos en los conjuntos de datos de descubrimiento de SLE y RPL se presentan en la Figura 7.
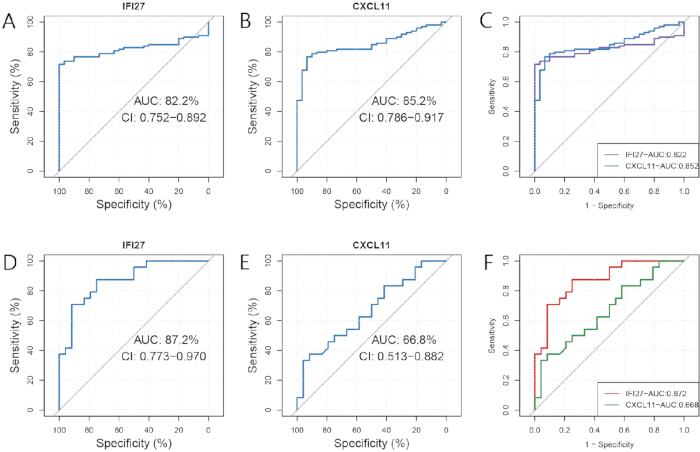
Figura 7. Análisis de características operativas del receptor de los genes candidatos.
(A) Curva de características operativas del receptor (ROC) para IFI27 en el conjunto de datos de descubrimiento de lupus eritematoso sistémico (SLE). (B) Curva ROC para CXCL11 en el conjunto de datos de descubrimiento de SLE. (C) Resumen del desempeño diagnóstico de IFI27 y CXCL11 en el conjunto de datos de descubrimiento de SLE. (D) Curva ROC para IFI27 en el conjunto de datos de descubrimiento de pérdida gestacional recurrente (RPL). (E) Curva ROC para CXCL11 en el conjunto de datos de descubrimiento de RPL. (F) Resumen del desempeño diagnóstico de IFI27 y CXCL11 en el conjunto de datos de descubrimiento de RPL. Los valores del área bajo la curva (AUC) se presentan con intervalos de confianza del 95 % (IC). Haga clic aquí para ver una versión más grande de esta figura.
Infiltración inmune mediante ssGSEA:
Considerando los roles de la disregulación de las células inmunitarias en la patogénesis del LES y el RPL40,41, el enriquecimiento de células inmunitarias se infirió computacionalmente en los conjuntos de datos de descubrimiento GSE61635 y GSE165004. El análisis se realizó por separado dentro de cada conjunto de datos, y los conjuntos de datos no se combinaron. La colección de firmas génicas de células inmunitarias consistió en conjuntos de genes marcadores para 28 poblaciones de células inmunitarias descritas por Charoentong et al.42. La tabla original de firmas génicas complementaria se convirtió en una lista de conjuntos génicos nombrados utilizando los símbolos génicos humanos oficiales. Se eliminaron los símbolos duplicados dentro de cada conjunto génico. Se descartaron los genes ausentes en la matriz de expresión correspondiente, y se excluyeron de ese conjunto de datos los conjuntos génicos que contenían menos de cinco genes coincidentes tras la asignación de identificadores. Se realizó un análisis de enriquecimiento de conjuntos génicos para una sola muestra (ssGSEA) utilizando GSVA versión 1.52.3 (RRID:SCR_021058) y GSEABase versión 1.66.0. En GSVA versión 1.52.3, se requiere un objeto de parámetros específico del método. Se utilizaron los siguientes parámetros: minSize = 5, maxSize = 500, alpha = 0.25, normalize = TRUE y checkNA = "sí.
El parámetro alfa se estableció en 0,25 y se activó la normalización final de la puntuación ssGSEA. Los conjuntos de genes se restringieron a entre 5 y 500 genes tras su coincidencia con la matriz de expresión. Se utilizó la ejecución de un solo hilo para garantizar un cálculo coherente entre sistemas. El parámetro kcdf no se utilizó porque no es un parámetro del procedimiento ssgseaParam() en la versión 1.52.3 de GSVA. ssGSEA produce puntuaciones relativas de enriquecimiento de conjuntos de genes a nivel de muestra, en lugar de recuentos experimentales de células inmunitarias o fracciones celulares absolutas43. El flujo de trabajo de GSVA 1.52.3 requiere un objeto de parámetros específico del método, y los parámetros de ssGSEA incluyen alfa, normalización de puntuación y límites de tamaño del conjunto de genes.
Para cada firma de células inmunitarias, los puntajes de ssGSEA se compararon entre los grupos de enfermedad y control utilizando la prueba de suma de rangos de Wilcoxon bilateral. Los valores de P para las 28 comparaciones de tipos celulares se ajustaron por separado dentro de cada conjunto de datos utilizando el método de Benjamini–Hochberg. Se consideró que las firmas de células inmunitarias con un valor de P ajustado < 0,05 presentaban un enriquecimiento diferencial.
Se calcularon las correlaciones de rangos de Spearman entre la expresión de los genes candidato y la puntuación ssGSEA de cada firma de células inmunitarias dentro de cada conjunto de datos. Los valores P de correlación se ajustaron utilizando el método de Benjamini–Hochberg en todas las combinaciones posibles entre genes candidato y células inmunitarias dentro de ese conjunto de datos. Las correlaciones se consideraron estadísticamente significativas con un valor P ajustado < 0,05. Las matrices de correlación se visualizaron mediante ggcorrplot versión 0.1.4.1, y los gráficos de comparación entre grupos se generaron usando ggplot2 versión 3.5.1.
Se utilizaron las puntuaciones ssGSEA normalizadas en bruto para todas las pruebas estadísticas. Los mapas de calor y las visualizaciones apiladas se usaron únicamente para presentación descriptiva. Las puntuaciones no se describieron como proporciones directas de células inmunitarias, y las asociaciones observadas se interpretaron como correlaciones computacionales en lugar de interacciones célula-gen demostradas experimentalmente. Los perfiles de enriquecimiento de firmas de células inmunitarias, las comparaciones entre grupos y las correlaciones con la expresión de genes candidatos se presentan en la Figura 8.
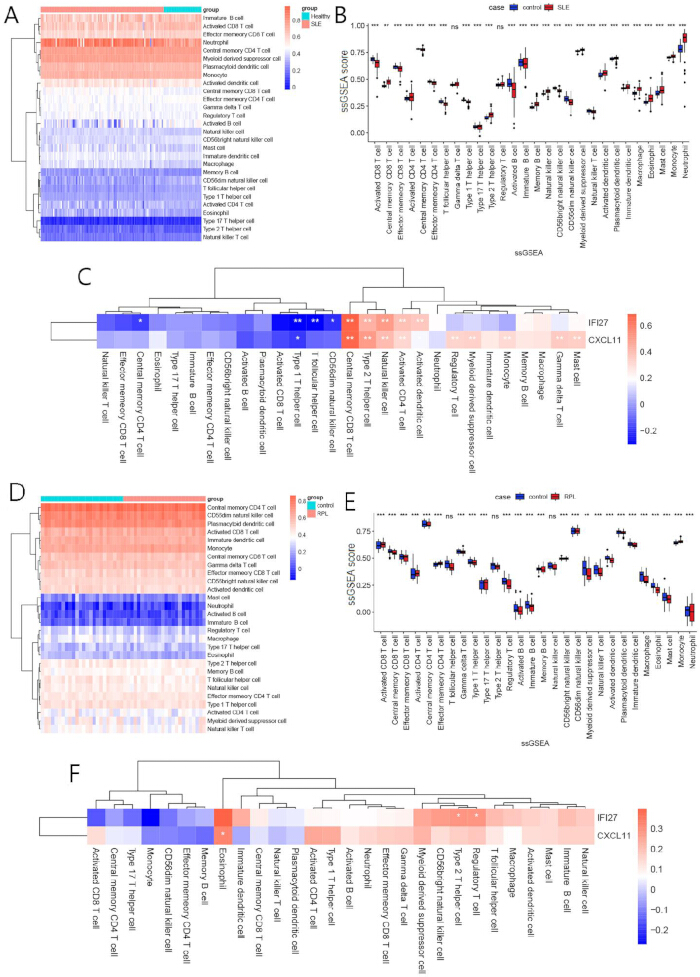
Figura 8. Enriquecimiento de firmas de células inmunitarias y correlaciones con los genes candidatos compartidos en el lupus eritematoso sistémico y la pérdida gestacional recurrente.
(A) Mapa de calor de agrupamiento jerárquico de los puntajes de análisis de enriquecimiento de conjuntos de genes de una sola muestra (ssGSEA) para 28 firmas de células inmunitarias en el conjunto de datos de descubrimiento del lupus eritematoso sistémico (LES). (B) Comparación de los puntajes ssGSEA de firmas de células inmunitarias entre pacientes con LES y controles sanos. (C) Mapa de calor de correlación de Spearman que muestra las asociaciones entre la expresión de IFI27 y CXCL11 y los puntajes ssGSEA de las 28 firmas de células inmunitarias en el conjunto de datos de descubrimiento del LES. (D) Mapa de calor de agrupamiento jerárquico de los puntajes ssGSEA para 28 firmas de células inmunitarias en el conjunto de datos de descubrimiento de la pérdida gestacional recurrente (PGR). (E) Comparación de los puntajes ssGSEA de firmas de células inmunitarias entre pacientes con PGR y controles fértiles. (F) Mapa de calor de correlación de Spearman que muestra las asociaciones entre la expresión de IFI27 y CXCL11 y los puntajes ssGSEA de las 28 firmas de células inmunitarias en el conjunto de datos de descubrimiento de la PGR. Las correlaciones se calcularon mediante la correlación de rangos de Spearman, y los valores de P se ajustaron utilizando el método de Benjamini–Hochberg. P < 0,05; ** P < 0,01; *** P < 0,001; ns, no significativo. Haga clic aquí para ver una versión ampliada de esta figura.
Resultados
Análisis de MR
Tras la selección de instrumentos y la armonización de los datos, se conservaron 16 SNPs para el análisis de MR directo, en el cual el LES se consideró como exposición y el número de abortos espontáneos como resultado. La información detallada sobre las variables instrumentales se proporciona en la Tabla Suplementaria 1. Todos los SNPs conservados presentaron estadísticos F superiores a 10, lo que indica que es poco probable un sesgo por instrumentos débiles. Cada SNP conservado también se analizó mediante PhenoScanner V2, y no se identificó ningún SNP asociado con aPL. El análisis MR-PRESSO no detectó valores atípicos. La prueba Q de Cochran no mostró heterogeneidad significativa entre las estimaciones específicas de los SNPs (Q = 16.12, P = 0.31); por lo tanto, se aplicó un modelo IVW de efectos fijos. La prueba del intercepto de MR-Egger no indicó pleiotropía horizontal direccional (P = 0.69). El análisis IVW mostró una asociación positiva estadísticamente significativa, aunque cuantitativamente modesta, entre el LES predicho genéticamente y el número de abortos espontáneos (razón de momios [OR] = 1.01, intervalo de confianza del 95 % [IC] = 1.00–1.02, P < 0.01; Figura 2A). Las estimaciones del efecto obtenidas mediante regresión MR-Egger (OR = 1.01, IC del 95 % = 1.00–1.03, P = 0.16), el método de mediana ponderada (OR = 1.01, IC del 95 % = 1.00–1.02, P = 0.17) y el método de moda ponderada (OR = 1.01, IC del 95 % = 0.99–1.03, P = 0.42) fueron concordantes en dirección con la estimación IVW, aunque individualmente no alcanzaron significación estadística. El análisis de exclusión secuencial mostró que la exclusión de un solo SNP no alteró sustancialmente la estimación agrupada, y el gráfico en embudo aproximadamente simétrico no mostró evidencia visual de que el resultado estuviera impulsado por una pleiotropía direccional marcada. El gráfico de dispersión correspondiente, el gráfico de bosque específico por SNP, el análisis de exclusión secuencial y el gráfico en embudo se presentan en las Figuras Suplementarias 1–4.
En el análisis MR inverso, se conservaron 16 SNP tras la selección del instrumento, y todos presentaron estadísticos F mayores a 10 (Tabla Suplementaria 2). El análisis MR-PRESSO no identificó valores atípicos. La prueba Q de Cochran no mostró heterogeneidad significativa (Q = 13.41, P = 0.50), y la prueba del intercepto MR-Egger no proporcionó evidencia de pleiotropía horizontal direccional (P = 0.41). La estimación IVW no respaldó una asociación entre el número genéticamente predicho de abortos espontáneos y el riesgo de LES (OR = 0.93, IC 95% = 0.21–4.23, P = 0.93; Figura 2B). En conjunto, los resultados del MR apoyan una asociación modesta en sentido directo, desde el LES genéticamente predicho hacia el número de abortos espontáneos, mientras que el análisis inverso no respaldó una asociación desde el número genéticamente predicho de abortos espontáneos hacia el riesgo de LES.
Análisis de bioinformática
Análisis de expresión diferencial:
El análisis de expresión diferencial de GSE61635 identificó 976 genes expresados diferencialmente (DEG) entre los grupos de lupus eritematoso sistémico (LES) y controles sanos, incluyendo 678 genes sobrerregulados y 298 genes subrregulados (Figura 3C). El análisis de GSE165004 identificó 1.249 DEG entre los grupos de lupus eritematoso cutáneo limitado (RPL) y controles, incluyendo 578 genes sobrerregulados y 671 genes subrregulados (Figura 3D). Los mapas de calor que muestran los 50 DEG más significativos en los dos conjuntos de datos de descubrimiento se presentan en la Figura 3A y la Figura 3B. Además, se identificaron 59 DEG comunes en ambos conjuntos de datos (Figura 3E). Estos DEG compartidos proporcionaron el conjunto de genes utilizado para los análisis posteriores de enriquecimiento funcional y de redes.
Análisis de enriquecimiento funcional de los DEG en intersección:
Los 59 DEG compartidos se sometieron a análisis de enriquecimiento de vías GO y KEGG utilizando DAVID. Dentro de la categoría de proceso biológico, los DEG compartidos mostraron enriquecimiento en respuesta de defensa contra virus, respuesta a virus, regulación negativa de la replicación del genoma viral, respuesta inmune innata antiviral, regulación negativa del proceso apoptótico y adhesión celular. Los términos enriquecidos en componente celular incluyeron región extracelular, membrana del retículo endoplásmico, citoesqueleto de actina y membrana. Entre los términos enriquecidos de función molecular se identificó la unión a ion calcio. El análisis KEGG mostró enriquecimiento en vías relacionadas con la hepatitis C y la influenza A (Figura 4A). Estos hallazgos indican que los DEG compartidos estuvieron predominantemente asociados con procesos biológicos relacionados con la respuesta antiviral e inmunitaria, proporcionando un contexto funcional para los genes comunes a los conjuntos de datos de descubrimiento de LES y RPL.
Red de interacción proteína-proteína e identificación de genes centrales
Los 59 DEG compartidos se cargaron en STRING para construir una red de interacción proteína-proteína (PPI) utilizando una puntuación mínima de confianza de interacción de 0,400. La red resultante contenía 59 nodos y 80 aristas. La red se importó a Cytoscape versión 3.10.0 para su visualización, y se eliminaron los nodos aislados antes del análisis topológico (Figura 4B). La clasificación de los genes centrales se realizó mediante el complemento cytoHubba. Se aplicaron seis algoritmos: centralidad de clique máxima (MCC), componente máximo del vecindario (MNC), componente de percolación de aristas (EPC), grado, cercanía y radialidad. Los mismos 10 genes se identificaron entre los genes mejor clasificados generados por los seis algoritmos: RSAD2, RTP4, IFIT3, IFI27, IFI44, GBP1, MX1, OAS1, IFIT1 y CXCL11 (Tabla 3). Por lo tanto, estos genes se conservaron como candidatos a centros de red para la regresión LASSO subsiguiente.
La regresión LASSO identificó a IFI27 y CXCL11 como genes candidatos compartidos
Los 10 genes centrales candidatos se sometieron a un análisis de regresión LASSO en los conjuntos de datos de descubrimiento de LES y RPL. En el conjunto de datos de LES, cuatro genes conservaron coeficientes distintos de cero en el valor de lambda seleccionado: IFIT3, IFI27, IFI44 y CXCL11, con coeficientes de 2,575, 0,057, 2,359 y 0,307, respectivamente (Figura 5A,B). En el conjunto de datos de RPL, cuatro genes conservaron coeficientes distintos de cero: IFI27, GBP1, OAS1 y CXCL11, con coeficientes de −0,897, 0,167, −1,007 y −0,519, respectivamente (Figura 5C,D). La comparación de los genes seleccionados por los dos modelos específicos de enfermedad identificó a IFI27 y CXCL11 como los genes candidatos compartidos seleccionados por LASSO. Estos dos genes se evaluaron posteriormente en los conjuntos de datos de descubrimiento y de validación externa.
Validación externa de la expresión de IFI27 y CXCL11
Los patrones de expresión de los dos genes candidatos se evaluaron utilizando los conjuntos de datos de validación independientes GSE50772 y GSE198700 obtenidos de la base de datos GEO. En GSE61635, tanto IFI27 como CXCL11 mostraron una regulación positiva significativa en el grupo con LES en comparación con los controles sanos (Figura 6A,B). En el conjunto de datos de validación independiente de LES (GSE50772), IFI27 continuó mostrando una regulación positiva significativa (Figura 6C), mientras que CXCL11 no presentó diferencias significativas entre los grupos (Figura 6D). En el conjunto de datos de descubrimiento de RPL (GSE165004), tanto IFI27 como CXCL11 mostraron una regulación negativa significativa en el grupo con RPL en comparación con los controles (Figura 6E,F). En el conjunto de datos de validación independiente de RPL (GSE198700), IFI27 mantuvo una regulación negativa significativa en el grupo con RPL (Figura 6G), mientras que CXCL11 no fue detectado. En general, IFI27 mostró una expresión diferencial consistente en ambos conjuntos de datos de descubrimiento y validación para LES y RPL. En contraste, CXCL11 no se replicó de manera consistente en los conjuntos de datos de validación externa. Por lo tanto, IFI27 fue priorizado como el biomarcador candidato compartido para los análisis posteriores.
Evaluación exploratoria de la discriminación diagnóstica
Se realizó un análisis de la curva característica de operación del receptor (ROC) para evaluar la capacidad de la expresión de IFI27 y CXCL11 para distinguir muestras de enfermedad de los controles en los conjuntos de datos transcriptómicos retrospectivos analizados. Para el LES, IFI27 arrojó un área bajo la curva ROC (AUC) de 0,822 (IC del 95 % = 0,752–0,892; Figura 7A), mientras que CXCL11 arrojó un AUC de 0,852 (IC del 95 % = 0,786–0,917; Figura 7B). Una comparación de las curvas ROC para los dos genes candidatos en el conjunto de datos de LES se muestra en la Figura 7C. Para el RPL, IFI27 arrojó un AUC de 0,872 (IC del 95 % = 0,773–0,970; Figura 7D), mientras que CXCL11 arrojó un AUC de 0,668 (IC del 95 % = 0,513–0,882; Figura 7E). Una comparación de las curvas ROC para los dos genes candidatos en el conjunto de datos de RPL se muestra en la Figura 7F. IFI27 mostró valores de AUC superiores a 0,80 en ambos conjuntos de datos de enfermedad y demostró una validación externa más consistente que CXCL11 en los conjuntos de datos de expresión. Estos hallazgos respaldan a IFI27 como un biomarcador candidato para su evaluación posterior. Sin embargo, dado que los análisis ROC se realizaron utilizando conjuntos de datos transcriptómicos públicos retrospectivos, los resultados deben interpretarse como evidencia exploratoria de discriminación transcriptómica y no como validación diagnóstica clínica prospectiva.
Evaluación computacional de la infiltración inmunitaria
Se realizó un análisis de ssGSEA para evaluar el enriquecimiento de 28 firmas de células inmunitarias en los conjuntos de datos de descubrimiento GSE61635 y GSE165004. Los mapas térmicos de enriquecimiento de células inmunitarias para los conjuntos de datos de LES y RPL se muestran en el Figura 8A,D, respectivamente, mientras que las comparaciones correspondientes entre grupos de los puntajes de ssGSEA se presentan en la Figura 8B,E. En el conjunto de datos de LES, varias firmas de células inmunitarias difirieron significativamente entre pacientes con LES y controles sanos, incluyendo aquellas que representan células T CD8+, células T CD4+, células B, células dendríticas, células T auxiliares tipo 1 (Th1), células T auxiliares tipo 2 (Th2), células T auxiliares tipo 17 (Th17), células asesinas naturales, macrófagos, eosinófilos, mastocitos, monocitos y neutrófilos (Figura 8B). En el conjunto de datos de RPL, los puntajes de ssGSEA para células T CD8+ activadas, células T CD4+ activadas, células T CD4+ de memoria efectora, células Th17 y monocitos fueron más altos en el grupo con RPL que en el grupo control. En contraste, los puntajes de ssGSEA para células T reguladoras (Treg) y macrófagos fueron más bajos en el grupo con RPL que en el grupo control (Figura 8E). El análisis de correlación mostró que, en el conjunto de datos de LES, la expresión de IFI27 y CXCL11 se correlacionó positivamente con los puntajes de ssGSEA de células T CD4+ activadas, células asesinas naturales, células Th2 y células T CD8+ de memoria central, y se correlacionó negativamente con el puntaje de ssGSEA de células Th1 (Figura 8C). En el conjunto de datos de RPL, la expresión de IFI27 se correlacionó positivamente con los puntajes de ssGSEA de células Treg y células Th2, mientras que la expresión de CXCL11 se correlacionó positivamente con el puntaje de ssGSEA de eosinófilos (Figura 8F).
Disponibilidad de datos:
No se generaron nuevos datos primarios de participantes humanos en este estudio. Todos los análisis se basaron exclusivamente en estadísticas resumidas de estudios de asociación del genoma completo (GWAS) y conjuntos de datos transcriptómicos disponibles públicamente. Las estadísticas resumidas de GWAS para el lupus eritematoso sistémico (SLE) se obtuvieron de FinnGen Release 11 (acceso: finngen_R11_L12_LUPUS). Las estadísticas resumidas sobre el número de abortos espontáneos se obtuvieron del recurso IEU OpenGWAS (acceso: ukb-b-419), que se basa en datos del UK Biobank. Los conjuntos de datos transcriptómicos se obtuvieron del Gene Expression Omnibus (GEO) del Centro Nacional para la Información Biotecnológica (NCBI) bajo los números de acceso GSE61635, GSE165004, GSE50772 y GSE198700. Los conjuntos de datos disponibles públicamente pueden accederse en los siguientes repositorios:
-- FinnGen versión 11: https://r11.finngen.fi/
-- IEU OpenGWAS: https://gwas.mrcieu.ac.uk/
-- Gene Expression Omnibus (GEO): https://www.ncbi.nlm.nih.gov/geo/
Los datos procesados que respaldan los hallazgos de este estudio se incluyen en el artículo y en sus Materiales Suplementarios. No se accedió ni se conservó ningún dato a nivel individual ni ninguna información personal identificable de los participantes. El flujo de trabajo analítico se realizó utilizando software y paquetes disponibles públicamente, tal como se describe en el Protocolo.
Archivo suplementario 1. Lista de verificación STROBE-MR completada.
Lista de verificación completada de Fortalecimiento de la Presentación de Estudios Observacionales en Epidemiología mediante Aleatorización Mendeliana (STROBE-MR) que indica dónde se aborda cada elemento recomendado de presentación en el manuscrito. Haga clic aquí para descargar este archivo.
Figura suplementaria 1. Gráfico de dispersión del análisis de aleatorización mendeliana directa.
Gráfico de dispersión que muestra las asociaciones entre los efectos genéticos de los polimorfismos de nucleótido único (SNP) instrumentales sobre el lupus eritematoso sistémico (LES) y el número de abortos espontáneos. Cada punto representa un SNP, con barras de error horizontales y verticales que indican los errores estándar de las estimaciones del efecto del SNP. Las líneas de regresión corresponden a los métodos de aleatorización mendeliana por ponderación inversa de la varianza, MR-Egger, mediana ponderada y moda ponderada. Haga clic aquí para descargar este archivo.
Figura suplementaria 2. Estimaciones causales específicas de polimorfismos de un solo nucleótido a partir del análisis de aleatorización mendeliana directa.
Gráfico de bosque que muestra la estimación del efecto causal para cada polimorfismo de un solo nucleótido (SNP) instrumental sobre la asociación entre el lupus eritematoso sistémico (LES) y el número de abortos espontáneos. Los puntos negros representan las estimaciones del efecto específicas para cada SNP con intervalos de confianza del 95 %. Los puntos rojos representan las estimaciones del efecto causal global obtenidas mediante los métodos de ponderación por varianza inversa y MR-Egger. La línea vertical punteada indica el efecto nulo. Haga clic aquí para descargar este archivo.
Figura suplementaria 3. Análisis de sensibilidad de exclusión individual en el análisis de aleatorización mendeliana directa.
Gráfico de bosque que muestra los resultados del análisis de sensibilidad de exclusión individual para evaluar la asociación entre el lupus eritematoso sistémico (LES) y el número de abortos espontáneos. Cada punto negro representa la estimación global del efecto causal ponderada por la inversa de la varianza tras la exclusión secuencial de un polimorfismo de un solo nucleótido (SNP) instrumental, con líneas horizontales que indican los intervalos de confianza del 95 % correspondientes. El punto rojo representa la estimación global ponderada por la inversa de la varianza obtenida utilizando todos los SNPs instrumentales. La línea vertical discontinua indica el efecto nulo. Haga clic aquí para descargar este archivo.
Figura suplementaria 4. Gráfico en embudo del análisis de aleatorización mendeliana directa.
Gráfico en embudo que muestra la distribución de las estimaciones del efecto causal específicas para cada SNP en la asociación entre el lupus eritematoso sistémico (LES) y el número de abortos espontáneos. Cada punto representa un polimorfismo de nucleótido simple (SNP) instrumental. Las líneas verticales indican las estimaciones globales del efecto causal obtenidas mediante los métodos ponderados por la inversa de la varianza y MR-Egger. El eje Y representa la inversa del error estándar (1/SE). Haga clic aquí para descargar este archivo.
Tabla suplementaria 1. Polimorfismos de un solo nucleótido instrumentales seleccionados para el análisis de aleatorización mendeliana directa.
La tabla enumera los polimorfismos de un solo nucleótido (SNP) instrumentales utilizados para el análisis de aleatorización mendeliana directa del lupus eritematoso sistémico y el número de abortos espontáneos, incluyendo el gen anotado más cercano, cromosoma, posición genómica, alelo de efecto, frecuencia del alelo de efecto, tamaño del efecto (Beta), error estándar (SE), valor P y estadístico F. Las posiciones cromosómicas se basan en el ensamblaje del genoma de origen utilizado en el estudio de asociación del genoma completo. El estadístico F se calculó como Beta2/SE2. Haga clic aquí para descargar este archivo.
Tabla suplementaria 2. Polimorfismos de un solo nucleótido instrumentales seleccionados para el análisis de aleatorización mendeliana inversa.
La tabla enumera los polimorfismos de un solo nucleótido (SNP) instrumentales utilizados para el análisis de aleatorización mendeliana inversa, en el que el número de abortos espontáneos es la exposición y el lupus eritematoso sistémico es el resultado, incluyendo el gen anotado más cercano, cromosoma, posición genómica, alelo de efecto, frecuencia del alelo de efecto, tamaño del efecto (Beta), error estándar (SE), valor P y estadístico F. Las posiciones cromosómicas se basan en el ensamblaje del genoma de origen utilizado en el estudio de asociación del genoma completo. El estadístico F se calculó como Beta2/SE2. Haga clic aquí para descargar este archivo.
Discusión
Mediante un análisis de MR bidireccional combinado con análisis bioinformáticos multidimensionales, este estudio identificó una asociación causal positiva entre el LES y el AFR al tiempo que realizó una cribado sistemático de biomarcadores transcriptómicos compartidos. Hasta donde sabemos, este es el primer estudio que integra MR bidireccional, análisis transcriptómicos y análisis de infiltración inmunitaria para investigar esta relación. Aunque el tamaño del efecto observado en el MR fue modesto (OR del IVW = 1,01), la asociación fue consistentemente respaldada por múltiples métodos de MR complementarios y análisis de sensibilidad, sin evidencia de heterogeneidad sustancial, pleiotropía horizontal ni valores atípicos influyentes, lo que sugiere que la relación observada es estadísticamente robusta pero cuantitativamente pequeña. Por lo tanto, los hallazgos actuales deben interpretarse como evidencia que apoya una contribución genética modesta del LES a la susceptibilidad al AFR, más que un efecto clínico importante. Al integrar inferencia causal con validación transcriptómica y análisis de infiltración inmunitaria, este estudio proporciona un marco reproducible para priorizar biomarcadores candidatos en trastornos reproductivos inmunitarios complejos. Un estudio realizado en Egipto entre 2007 y 2021, que incluyó a 123 mujeres con LES y un total de 201 embarazos, informó que el 20,4 % de los embarazos en mujeres con LES resultaron en pérdida fetal44. Estudios previos también han sugerido que el LES es un factor de riesgo importante para el AFR, ya que la desregulación inmunitaria puede aumentar la probabilidad de pérdida gestacional12.
Los análisis bioinformáticos revelaron que los 59 genes diferencialmente expresados (GDE) compartidos se enriquecieron principalmente en vías relacionadas con respuestas inmunitarias antivirales, adhesión celular y regulación de la apoptosis. La infección viral podría contribuir a la patogénesis del LES. Los pacientes con LES a menudo presentan disfunción tanto en las respuestas inmunitarias innatas como adaptativas45,46, lo que los hace más susceptibles a las infecciones virales. Esta mayor susceptibilidad podría contribuir a la pérdida gestacional mediante mecanismos como la inflamación placentaria y la lesión de las células placentarias47. Como componente esencial de la placenta, alteraciones en la autofagia y el comportamiento biológico de las células trofoblásticas también se han asociado con la aparición de abortos de repetición (RPL)48,49. En conjunto, estas observaciones sugieren que la desregulación inmunitaria asociada al LES podría influir en los resultados del embarazo al afectar la función de las células trofoblásticas. Análisis adicionales identificaron a IFI27 y CXCL11 como genes centrales candidatos compartidos por el LES y el RPL. Sin embargo, IFI27 fue priorizado para análisis posteriores porque mostró una mayor consistencia biológica en múltiples conjuntos de datos independientes. Aunque ambos genes fueron seleccionados por el modelo LASSO, solo IFI27 mostró una expresión diferencial consistente en los conjuntos de datos de descubrimiento y de validación externa, mientras que CXCL11 no se replicó de forma consistente en los conjuntos de datos de validación. Además, IFI27 mostró una mejor capacidad diagnóstica para el RPL y permaneció significativamente desregulado en conjuntos de datos de sangre y tejidos reproductivos. En conjunto, estos hallazgos respaldan a IFI27 como un biomarcador candidato más robusto que CXCL11, aunque se requiere validación experimental adicional. La validación utilizando el conjunto de datos del LES GSE50772 y el conjunto de datos del RPL GSE198700 demostró que la expresión de IFI27 permaneció consistentemente desregulada en los conjuntos de datos de validación. Es de destacar que IFI27 estuvo sobreexpresado en muestras de sangre de pacientes con LES, lo cual es consistente con estudios previos50, pero se encontró subregulado en muestras de endometrio y vellosidades coriónicas de pacientes con RPL. Este patrón contrastante podría reflejar diferencias entre la desregulación inmunitaria sistémica y el entorno inmunitario local en la interfase materno-fetal en el LES complicado con RPL.
IFI27 es un gen estimulado por interferón que participa en la inmunidad antiviral, la señalización de interferón y las respuestas inmunitarias del huésped tras la infección viral51,52. En el embarazo normal, la expresión de IFI27 aumenta notablemente en las células trofoblásticas53, lo que sugiere un papel fisiológico importante en el mantenimiento de la función trofoblástica. En contraste, nuestros análisis demostraron una expresión reducida de IFI27 en el endometrio y las vellosidades coriónicas de pacientes con aborto de repetición (RPL). Aunque este hallazgo difiere de algunos estudios previos54, debe interpretarse con cautela porque el presente estudio integró conjuntos de datos transcriptómicos derivados de diferentes tejidos, en lugar de muestras emparejadas de madre y feto. Una posible explicación es que la activación crónica sistémica del interferón de tipo I en el lupus eritematoso sistémico (SLE) induzca una señalización persistente de interferón en las células inmunitarias circulantes, mientras simultáneamente promueve la desensibilización del receptor, el agotamiento inmunitario o mecanismos compensatorios de retroalimentación negativa en la interfaz materno-fetal. Alternativamente, la regulación epigenética específica del tejido o las diferencias en la composición celular entre la sangre periférica y los tejidos reproductivos podrían suprimir la expresión local de IFI27 a pesar de la activación sistémica del interferón. Estas hipótesis permanecen especulativas y requieren validación mecanicista mediante el uso de muestras emparejadas de sangre materna, tejido endometrial y muestras de trofoblasto, idealmente a nivel de célula individual, para distinguir los mecanismos reguladores específicos del tejido y del tipo celular55.
El análisis de infiltración inmunitaria indicó diferencias significativas en las firmas de células inmunitarias tanto en el LES como en el AR, caracterizadas principalmente por alteraciones en poblaciones relacionadas con linfocitos T CD4+. La expresión de IFI27 se correlacionó positivamente con el enriquecimiento de células Th2 en ambas enfermedades; sin embargo, estos hallazgos representan correlaciones computacionales derivadas del ssGSEA, y no interacciones biológicas verificadas experimentalmente. Estudios previos han mostrado que la sangre periférica de pacientes con LES contiene proporciones reducidas de células Th1 y Treg, pero proporciones aumentadas de células Th256,57, lo cual es consistente con nuestros hallazgos. Durante el embarazo normal, el equilibrio inmunitario Th1/Th2 en la interfaz materno-fetal se desplaza hacia un estado dominado por Th258. Por lo tanto, la expresión reducida de IFI27 en tejidos reproductivos podría reflejar alteraciones en la homeostasis inmunitaria local asociadas con una tolerancia materno-fetal comprometida, aunque aún debe determinarse experimentalmente si IFI27 regula directamente este proceso.
Se deben reconocer varias limitaciones. Primero, aunque los análisis de MR respaldaron una asociación causal, el efecto genético estimado fue relativamente pequeño, lo que sugiere que el LES representa solo un componente de la patogénesis multifactorial del RPL. Segundo, la integración transcriptómica incluyó conjuntos de datos generados a partir de diferentes tejidos (sangre periférica, endometrio y vellosidades coriónicas), plataformas de microarrays y cohortes independientes, lo cual puede introducir heterogeneidad biológica y técnica a pesar de la validación consistente de IFI27. Tercero, la cohorte de validación externa para las vellosidades coriónicas incluyó un número limitado de muestras, lo que puede haber reducido el poder estadístico y la generalización. Cuarto, debido a que los conjuntos de datos disponibles públicamente contenían información clínica limitada, factores importantes, como la actividad de la enfermedad, el estado de los anticuerpos antifosfolípidos, la exposición a medicamentos, la etapa del embarazo y otras covariables clínicas, no pudieron evaluarse completamente. Por último, aunque el cribado con PhenoScanner minimizó el posible confundimiento por pleiotropía en los análisis de MR, no puede descartarse por completo un confundimiento residual.
Desde una perspectiva traslacional, actualmente IFI27 debería considerarse un biomarcador candidato en lugar de un marcador diagnóstico clínicamente validado. Antes de su implementación clínica, se necesitan estudios prospectivos multicéntricos para validar su desempeño diagnóstico en poblaciones diversas, establecer plataformas de ensayo estandarizadas y umbrales diagnósticos, y determinar cómo la etapa del embarazo, la actividad de la enfermedad y el tratamiento inmunosupresor influyen en la expresión de IFI27. Experimentos funcionales, junto con análisis de transcriptómica espacial y transcriptómica de célula única, también serán esenciales para aclarar si IFI27 contribuye activamente a la regulación inmune materno-fetal o simplemente refleja una activación inmune impulsada por interferón.
Divulgaciones
Conflicto de intereses:
Los autores declaran que no tienen intereses financieros ni no financieros en conflicto.
Agradecimientos
Este trabajo fue apoyado por el Proyecto Clave de Integración de la Medicina Tradicional China y la Medicina Occidental para Enfermedades Graves y Complejas del Departamento Municipal de Medicina Tradicional China de Beijing (2023BJSZDYNJBXTGG-003), el Fondo Científico Público Nacional para la Investigación Básica de Institutos (ZZ16-XRZ-038) y el Proyecto de Promoción de Hospitales Médicos Chinos de Alto Nivel (HLCMHPP2023087). Las fuentes de financiamiento no tuvieron ningún papel en el diseño del estudio, la recopilación de datos, el análisis de datos, la interpretación de datos, la preparación del manuscrito ni en la decisión de enviar el manuscrito para su publicación. Los autores agradecen a los investigadores y participantes del estudio FinnGen, del Biobanco del Reino Unido y del Gene Expression Omnibus (GEO) del Centro Nacional para la Información Biotecnológica por hacer públicamente disponibles sus conjuntos de datos. Los autores también reconocen al consorcio FinnGen, que integra muestras de biobancos finlandeses con datos de registros sanitarios a nivel nacional mediante colaboraciones entre organizaciones de investigación finlandesas, biobancos y socios internacionales.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Colección de 28 firmas génicas de células inmunitarias | Recurso complementario publicado de firmas génicas | Lista complementaria de genes marcadores de células inmunitarias descrita por Charoentong et al. (Referencia 42) | No aplicable RRID: No disponible Propósito / notas: Firmas de células inmunitarias utilizadas para ssGSEA. |
| CNSknowall | plataforma web CNSknowall | Archivos de salida de DAVID | No aplicable RRID: No disponible Propósito / notas: Visualización de los resultados filtrados de enriquecimiento funcional. |
| Estación de trabajo informática | Entorno informático institucional | No aplicable | No aplicable RRID: No aplicable Propósito / notas: Análisis computacionales. |
| Materiales de consumo | No aplicable | No aplicable | No aplicable RRID: No aplicable Propósito / notas: No se utilizaron consumibles para laboratorio húmedo. |
| Cytoscape | Consortium Cytoscape | No aplicable | 3.10.0 RRID: SCR_003032 Propósito / notas: Proteína–visualización y análisis de la topología de redes de interacciones proteicas |
| cytoHubba | Tienda de aplicaciones de Cytoscape | No aplicable | 0.1 RRID: SCR_017677 Propósito / notas: Clasificación de genes centrales mediante MCC, MNC, EPC, Grado, Cercanía y Radialidad. |
| Herramienta de Anotación Funcional DAVID | Institutos Nacionales de Salud / Instituto Nacional del Cáncer | Listas de genes diferencialmente expresados (DEG) y de genes de fondo compartidos cargadas | 2021 RRID: SCR_001881 Propósito / notas: Análisis de enriquecimiento de vías KEGG y ontología genética. |
| Panel de referencia europeo para el desequilibrio de ligamiento | Proyecto 1000 Genomas / IEU OpenGWAS | Panel europeo de la fase 3 (variantes compatibles con GRCh37) | Fase 3 RRID: No reportado Propósito / notas: Equilibrio de ligamiento mediante el procedimiento OpenGWAS/TwoSampleMR. |
| FinnGen | Consorcio FinnGen | finngen_R11_L12_LUPUS | Liberación 11 RRID: SCR_022254 Propósito / notas: Estadísticas resumidas de GWAS para el lupus eritematoso. |
| forestploter | CRAN | No aplicable | 1.1.2 RRID: No disponible Propósito / notas: Visualización de gráficos de bosque de las estimaciones de aleatorización mendeliana. |
| Gene Expression Omnibus (GEO) | Centro Nacional de Información Biotecnológica | GSE61635; GSE165004; GSE50772; GSE198700 | No aplicable RRID: SCR_005012 Propósito / notas: Fuente de los conjuntos de datos transcriptómicos de descubrimiento y validación. |
| Ontología Genética | Consortium de Ontología Genética | términos GO accedidos a través de DAVID | Anotaciones DAVID 2021 RRID: SCR_002811 Propósito / notas: Anotación de proceso biológico, componente celular y función molecular |
| ggcorrplot | CRAN | No aplicable | 0.1.4.1 RRID: No disponible Propósito / notas: Visualización del gen candidato–matrices de correlación de células inmunitarias |
| ggplot2 | CRAN | No aplicable | 3.5.1 RRID: SCR_014601 Propósito / notas: Gráficos de volcán, diagramas de caja y otros gráficos estadísticos. |
| ggvenn | CRAN | No aplicable | 0.1.16 RRID: SCR_025300 Propósito / notas: Visualización de genes diferencialmente expresados compartidos. |
| glmnet | CRAN | No aplicable | 4.1-8 RRID: SCR_015505 Propósito / notas: Regresión logística LASSO y validación cruzada. |
| GSE165004 | NCBI GEO | GSE165004 / GPL16699 | Matriz de series procesada RRID: SCR_005012 Propósito / notas: Conjunto de datos de descubrimiento endometrial RPL |
| GSE198700 | NCBI GEO | GSE198700 / GPL13534 | Matriz de series procesada RRID: SCR_005012 Propósito / notas: Conjunto de datos independiente para la validación de vellosidades coriónicas mediante RPL |
| GSE50772 | NCBI GEO | GSE50772 / GPL570 | Matriz de series procesada RRID: SCR_005012 Propósito / notas: Conjunto de datos de validación independiente de células mononucleares de sangre periférica en lupus eritematoso sistémico. |
| GSE61635 | NCBI GEO | GSE61635 / GPL570 | Matriz de series procesada RRID: SCR_005012 Propósito / notas: Conjunto de datos de descubrimiento en sangre completa de LES |
| GSEABase | Bioconductor | No aplicable | 1.66.0 RRID: No disponible Propósito / notas: Manejo de conjuntos de genes de células inmunitarias para ssGSEA. |
| GSVA | Bioconductor | No aplicable | 1.52.3 RRID: SCR_021058 Propósito / notas: Análisis de enriquecimiento de conjuntos de genes para una sola muestra (ssGSEA). |
| IEU OpenGWAS | Unidad de Epidemiología Integrativa MRC | ukb-b-419; finngen_R11_L12_LUPUS | No aplicable RRID: No reportado Propósito / notas: Recuperación de estadísticas resumidas de GWAS y datos armonizados de asociación genética. |
| Enciclopedia de Kioto de Genes y Genomas (KEGG) | Laboratorios Kanehisa | Vías metabólicas de KEGG accedidas a través de DAVID | Anotaciones DAVID 2021 RRID: SCR_012773 Propósito / notas: Anotación de enriquecimiento de vías |
| limma | Bioconductor | No aplicable | 3.60.6 RRID: SCR_010943 Propósito / notas: Análisis de expresión diferencial. |
| MRPRESSO | Verbanck et al. | No aplicable | 1 RRID: SCR_023697 Propósito / notas: Detección de pleiotropía horizontal y variables instrumentales atípicas. |
| pheatmap | CRAN | No aplicable | 1.0.12 RRID: SCR_016418 Propósito / notas: Mapas de calor de expresión. |
| PhenoScanner V2 | Consortium PhenoScanner | Consultas fenotípicas a nivel de SNP | Versión 2 RRID: No disponible Propósito / notas: Selección de SNPs retenidos para posibles asociaciones con fenotipos de confusión. |
| pROC | CRAN | No aplicable | 1.18.5 RRID: SCR_024286 Propósito / notas: Curvas ROC, AUC, intervalos de confianza de DeLong, puntos de corte del índice de Youden e intervalos de confianza bootstrap. |
| R | Fundación R para la Computación Estadística | No aplicable | 4.4.2 RRID: SCR_001905 Propósito / notas: Entorno de computación estadística. |
| Reactivos | No aplicable | No aplicable | No aplicable RRID: No aplicable Propósito / notas: No se utilizaron reactivos de laboratorio húmedo. |
| STRING | Consortium STRING | Homo sapiens (taxón 9606); puntuación mínima de interacción 0,400 | 11 RRID: SCR_005223 Propósito / notas: Proteína–construcción de redes de interacción de proteínas |
| TwoSampleMR | Unidad de Epidemiología Integradora del MRC | No aplicable | 0.6.6 RRID: SCR_019010 Propósito / notas: Aleatorización mendeliana bidireccional de dos muestras, extracción de datos, armonización, estimación causal y análisis de sensibilidad. |
| UK Biobank | UK Biobank | ukb-b-419 | Conjunto de datos resumen de 2018 RRID: SCR_012815 Propósito / notas: Estadísticas resumidas de GWAS para el número de abortos espontáneos. |
Referencias
- Petri M. Pregnancy and systemic lupus erythematosus. Best Pract Res Clin Obstet Gynaecol. 2020;64:24-30.
- Zhao X, et al. Advances in drug therapy for systemic lupus erythematosus. Curr Med Chem. 2021;28(7):1251-1268.
- Stanescu II, et al. Salivary biomarkers of inflammation in systemic lupus erythematosus. Ann Anat. 2018;219:89-93.
- Tian J, Zhang D, Yao X, Huang Y, Lu Q. Global epidemiology of systemic lupus erythematosus: A comprehensive systematic analysis and modelling study. Ann Rheum Dis. 2023;82(3):351-356.
- Palma Dos Reis CR, et al. Prediction of adverse pregnancy outcomes in women with systemic lupus erythematosus. Clin Rev Allergy Immunol. 2020;59(2):287-294.
- Venne K, Scott S, Bernatsky S, Vinet E. Induced abortions in women with systemic lupus erythematosus. Lupus. 2021;30(4):484-488.
- Kim JW, et al. Lupus low disease activity state achievement is important for reducing adverse outcomes in pregnant patients with systemic lupus erythematosus. J Rheumatol. 2021;48(5):707-716.
- Braga A, et al. Systemic lupus erythematosus and pregnancy: A Portuguese case-control study. Clin Rev Allergy Immunol. 2022;62(2):324-332.
- Dimitriadis E, Menkhorst E, Saito S, Kutteh WH, Brosens JJ. Recurrent pregnancy loss. Nat Rev Dis Primers. 2020;6(1):98.
- Quenby S, et al. Miscarriage matters: The epidemiological, physical, psychological, and economic costs of early pregnancy loss. Lancet. 2021;397(10285):1658-1667.
- Valeff NJ, Ventimiglia MS, Diao L, Jensen F. Lupus and recurrent pregnancy loss: The role of female sex hormones and B cells. Front Endocrinol (Lausanne). 2023;14:1233883.
- Gao R, Zeng X, Qin L. Systemic autoimmune diseases and recurrent pregnancy loss: Research progress in diagnosis and treatment. Chin Med J (Engl). 2021;134(17):2140-2142.
- Pantham P, Abrahams VM, Chamley LW. The role of anti-phospholipid antibodies in autoimmune reproductive failure. Reproduction. 2016;151(5):R79-R90.
- Meroni PL, et al. Updating on the pathogenic mechanisms of antiphospholipid antibody-associated pregnancy loss. Clin Rev Allergy Immunol. 2008;34(3):332-337.
- Blank M, Shoenfeld Y. Antiphospholipid antibody-mediated reproductive failure in antiphospholipid syndrome. Clin Rev Allergy Immunol. 2010;38(2–3):141-147.
- Babker A, et al. Frequency of ACE I/D and PAI-1 4G/5G polymorphisms in women with recurrent pregnancy loss in Sudan. Biomed Pharmacol J. 2025;18(3):1953-1961.
- Babker AM, et al. Detection of human platelet antigen polymorphisms (HPA-1 and HPA-3) and factor XIII mutation in Sudanese women with recurrent pregnancy loss. BMC Res Notes. 2024;17(1):66.
- Grover S, Del Greco MF, Stein CM, Ziegler A. Mendelian randomization. Methods Mol Biol. 2017;1666:581-628.
- Skrivankova VM, et al. Strengthening the reporting of observational studies in epidemiology using Mendelian randomization: The STROBE-MR statement. JAMA. 2021;326(16):1614-1621.
- Emdin CA, Khera AV, Kathiresan S. Mendelian randomization. JAMA. 2017;318(19):1925-1926.
- Burgess S, Thompson SG, CRP CHD Genetics Collaboration. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764.
- Hemani G, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408.
- Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314.
- Hartwig FP, Davey Smith G, Bowden J. Robust inference in summary data Mendelian randomization via the zero modal pleiotropy assumption. Int J Epidemiol. 2017;46(6):1985-1998.
- Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665.
- Verbanck M, Chen CY, Neale B, Do R. Detection of widespread horizontal pleiotropy in causal relationships inferred from Mendelian randomization between complex traits and diseases. Nat Genet. 2018;50(5):693-698.
- Barrett T, et al. NCBI GEO: Archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(Database issue):D991-D995.
- Keleş İD, et al. Gene pathway analysis of the endometrium at the start of the window of implantation in women with unexplained infertility and unexplained recurrent pregnancy loss: Is unexplained recurrent pregnancy loss a subset of unexplained infertility? Hum Fertil (Camb). 2023;26(5):1129-1141.
- Kennedy WP, et al. Association of the interferon signature metric with serological disease manifestations but not global activity scores in multiple cohorts of patients with SLE. Lupus Sci Med. 2015;2(1):e000080.
- Matsumoto Y, et al. Characteristic DNA methylation profiles of chorionic villi in recurrent miscarriage. Sci Rep. 2022;12(1):11673.
- Sherman BT, Lempicki RA. Systematic and integrative analysis of large gene lists using DAVID bioinformatics resources. Nat Protoc. 2009;4(1):44-57.
- Szklarczyk D, et al. STRING v11: Protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607-D613.
- Shannon P, et al. Cytoscape: A software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504.
- Jia P, Zheng S, Long J, Zheng W, Zhao Z. dmGWAS: Dense module searching for genome-wide association studies in protein–protein interaction networks. Bioinformatics. 2011;27(1):95-102.
- Chin CH, et al. cytoHubba: Identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11.
- Mohammadi M. A projection neural network for the generalized Lasso. IEEE Trans Neural Netw Learn Syst. 2020;31(6):2217-2221.
- Kumar R, Indrayan A. Receiver operating characteristic (ROC) curve for medical researchers. Indian Pediatr. 2011;48(4):277-287.
- de Hond AAH, Steyerberg EW, van Calster B. Interpreting area under the receiver operating characteristic curve. Lancet Digit Health. 2022;4(12):e853-e855.
- Xu H, et al. Single-cell transcriptomics reveals CCL3+ classical monocyte subset linked to autoimmune pathogenesis. J Inflamm Res. 2025;18:16273-16291.
- Zych M, et al. Surface immune checkpoints as potential biomarkers in physiological pregnancy and recurrent pregnancy loss. Int J Mol Sci. 2024;25(17):9378.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-262.
- Liu J, Lu J, Wang G, Gu L, Li W. Prognostic characteristics of a six-gene signature based on ssGSEA in sarcoma. Aging (Albany NY). 2024;16(2):1536-1554.
- Mokbel A, et al. Pregnancy outcomes among Egyptian women with systemic lupus erythematosus: A prospective cohort study. Lupus. 2023;32(4):521-530.
- Illescas-Montes R, Corona-Castro CC, Melguizo-Rodríguez L, Ruiz C, Costela-Ruiz VJ. Infectious processes and systemic lupus erythematosus. Immunology. 2019;158(3):153-160.
- Banko A, et al. Epstein-Barr virus infection as a potential indicator of the occurrence and clinical presentation of systemic lupus erythematosus. Front Immunol. 2023;14:1307589.
- Nigro G, et al. Role of infections in recurrent spontaneous abortion. J Matern Fetal Neonatal Med. 2011;24(8):983-989.
- Yang D, et al. YY1-PVT1 affects trophoblast invasion and adhesion by regulating mTOR pathway-mediated autophagy. J Cell Physiol. 2020;235(10):6637-6646.
- Guan D, et al. Immunologic insights in recurrent spontaneous abortion: Molecular mechanisms and therapeutic interventions. Biomed Pharmacother. 2024;177:117082.
- Zhao X, et al. Identification of key biomarkers and immune infiltration in systemic lupus erythematosus by integrated bioinformatics analysis. J Transl Med. 2021;19(1):35.
- Villamayor L, et al. The IFN-stimulated gene IFI27 counteracts innate immune responses after viral infections by interfering with RIG-I signaling. Front Microbiol. 2023;14:1176177.
- Lim FY, et al. High-frequency home self-collection of capillary blood correlates IFI27 expression kinetics with SARS-CoV-2 viral clearance. J Clin Invest. 2023;133(23):e173715.
- Apps R, et al. Genome-wide expression profile of first-trimester villous and extravillous human trophoblast cells. Placenta. 2011;32(1):33-43.
- Li Y, et al. RNA sequencing of decidua reveals differentially expressed genes in recurrent pregnancy loss. Reprod Sci. 2021;28(8):2261-2269.
- Dankers W, et al. Failing maternal-fetal tolerance in SLE (FaMaLE): A prospective cohort study for finding the molecular mechanisms behind pregnancy complications. Lupus Sci Med. 2025;12(1):e001668.
- Xiang S, et al. Imbalance of helper T cell type 1, helper T cell type 2, and associated cytokines in patients with systemic lupus erythematosus: A meta-analysis. Front Pharmacol. 2022;13:988512.
- Tu J, et al. UC-BSC exosomes regulate Th17/Treg balance in patients with systemic lupus erythematosus via miR-19b/KLF13. Cells. 2022;11(24):4123.
- Wang W, et al. T helper (Th) cell profiles in pregnancy and recurrent pregnancy loss: Th1/Th2/Th9/Th17/Th22/Tfh cells. Front Immunol. 2020;11:2025.