Este artículo estudia un algoritmo dinámico de optimización de programación que integra Transformer y el aprendizaje por refuerzo PPO, centrándose en los frecuentes conflictos de recursos y los retrasos en la respuesta durante la programación de actividades sindicales.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Algoritmo de programación dinámica y optimización de recursos para actividades sindicales mediante la integración de Transformer y aprendizaje por refuerzo
En este artículo
Resumen
Resumen
Para abordar el problema de la reducción de la eficiencia organizacional causada por frecuentes conflictos en la asignación de recursos y retrasos en las respuestas de programación al gestionar actividades sindicales, este artículo propone un algoritmo de programación dinámica que integra Transformer y PPO (Optimización de Política Próxima). En la implementación específica, primero se diseña una estructura unificada de modelado de escenarios de programación para convertir los estados de actividades, personal y recursos en entradas tensoriales, logrando así la integración de restricciones multidimensionales. A continuación, se utiliza el mecanismo de atención múltiple del Transformer para codificar la serie temporal de solicitudes históricas de actividades y el estado de los recursos, extraer características espacio-temporales multidimensionales y mejorar la percepción de riesgos de conflicto. Posteriormente, basándose en los resultados de codificación y en la red de estrategias PPO, se generan acciones de programación a partir del estado actual para aumentar la adaptabilidad de la estrategia a entornos complejos. Finalmente, mediante el mecanismo de actualización con poda y corrección de la función de ventaja, se garantiza la estabilidad de la estrategia durante la iteración y se mejora el rendimiento de la programación. Los experimentos han mostrado que, cuando la densidad de tareas es de 1000, el tiempo promedio de decisión del algoritmo de programación es de 0,72 s y su retardo promedio de respuesta es de 1,59 s, lo que indica una alta velocidad de respuesta y eficiencia en la toma de decisiones. En siete tipos de actividades y niveles de complejidad, la tasa de conflicto de recursos oscila entre 0,05 y 0,12; la tasa promedio de utilización de recursos está entre 0,75 y 0,86; y el índice de estabilidad en la programación varía entre 0,8 y 0,91, reduciendo eficazmente los frecuentes conflictos en la asignación de recursos y logrando una alta estabilidad en la programación. Bajo condiciones de alta concurrencia, el índice de equilibrio de recursos y el índice de robustez en la transferencia de estrategias son de 0,88 y 0,85, respectivamente, lo que indica una buena adaptabilidad a cargas de tareas concurrentes.
Introducción
Las actividades sindicales implican la programación compleja de múltiples tareas y recursos, lo que requiere que el sistema cuente con capacidades eficientes de respuesta dinámica1,2. Los requisitos de las actividades cambian con frecuencia, y la distribución del personal y de los recursos de los recintos es compleja, lo que puede provocar fácilmente conflictos de programación y desperdicio de recursos3,4. Captar con precisión el historial de actividades y el estado actualizado de los recursos, así como mejorar la capacidad de identificar y responder a posibles conflictos, es fundamental para aumentar la eficiencia operativa de la organización5,6. La integración de tecnologías avanzadas de modelado de series temporales y algoritmos de aprendizaje por refuerzo puede lograr una comprensión profunda y una optimización inteligente en entornos complejos de programación, ayudando a maximizar la utilización de recursos, acelerar la respuesta en la programación y promover la mejora inteligente de la gestión de actividades sindicales.
Sin embargo, los enfoques de programación existentes en la práctica son en gran parte basados en reglas y estáticos, por lo que no logran adaptarse a los frecuentes cambios en las tareas ni a las fluctuaciones de los recursos, lo que a menudo provoca tiempos de respuesta prolongados y graves conflictos de recursos. En la programación de actividades sindicales, los tipos de tareas son altamente diversos; el uso de recursos está altamente restringido y cambia con frecuencia; y las dependencias entre actividades, así como la competencia entre recursos, constituyen un mapa complejo de programación7,8. En la práctica, no es posible ajustar eficientemente el cronograma de actividades a las ventanas de tiempo disponibles de recursos como personal y lugares9,10, y con frecuencia surgen conflictos, lo que debilita la coherencia general de las operaciones organizativas11,12. El sistema de programación no enfrenta un único objetivo de optimización, sino que debe equilibrar múltiples indicadores dimensionales, como minimizar los conflictos de recursos, maximizar la velocidad de respuesta, la estabilidad de la estrategia de programación y la tasa de finalización de tareas13,14, lo cual presenta características típicas de optimización multiobjetivo. Además, las actividades sindicales presentan fases y ciclos claramente definidos, y las estrategias de programación deben adaptarse dinámicamente a las distintas estructuras de demanda de recursos en las diferentes etapas de las tareas. Los planes estáticos generados una sola vez no pueden soportar un entorno de ejecución con cambios de alta frecuencia15,16. La lógica de programación existente carece de una exploración profunda del comportamiento histórico de las tareas y de los patrones de cambio en el estado de los recursos. Por ello, no es capaz de ofrecer predicciones precisas ni deducciones estratégicas para el futuro17,18. La estrategia de programación del sistema responde lentamente a tareas imprevistas y cambios temporales en los recursos, afectando la sostenibilidad general de la operación19,20. La construcción de un sistema de programación con predictibilidad, flexibilidad y estabilidad se ha convertido en un requisito técnico clave en aplicaciones prácticas. Esto exige que el modelo posea capacidades de percepción de información de alta dimensión, memoria de secuencias y migración de estrategias, y que mantenga una toma de decisiones robusta y un equilibrio de recursos en un entorno multitarea, permitiendo así una coordinación inteligente y óptima de la programación de actividades sindicales.
Numerosos estudios han propuesto diversas soluciones al problema de programación dinámica. Entre ellas, la combinación del aprendizaje profundo y el aprendizaje por refuerzo ha demostrado una fuerte capacidad de adaptación y optimización. Algunos investigadores utilizan LSTM (memoria a corto y largo plazo)21,22 para modelar datos de series temporales y combinan estrategias de aprendizaje por refuerzo para optimizar el comportamiento de programación, logrando ciertos resultados. Otro tipo de investigación emplea un método heurístico basado en un algoritmo voraz, destacando la simplicidad y eficiencia de las decisiones de programación, lo cual resulta adecuado para escenarios con reglas claras23,24. Otros estudios han explorado la aplicación de redes Q profundas (DQN) a la programación, logrando estrategias mejoradas mediante la aproximación de funciones de valor25,26. Sin embargo, estos métodos presentan problemas como la captura insuficiente de dependencias a largo plazo, actualizaciones de estrategias inestables y grandes retrasos en la respuesta cuando enfrentan escenarios complejos y cambiantes de actividades conjuntas, lo que dificulta satisfacer las necesidades de programación de tareas densas y diversas. Por lo tanto, cómo construir un algoritmo de programación con capacidades eficientes de extracción de características y actualización estable de estrategias se ha convertido en un cuello de botella que debe superarse en la investigación actual.
En la investigación sobre planificación en múltiples dominios, la arquitectura Transformer se ha aplicado a diversas tareas de predicción de series temporales y optimización de planificación debido a su mecanismo de autoatención con múltiples cabezales, que captura eficazmente las dependencias temporales a largo plazo27,28. Cuando se combina con el algoritmo PPO en el aprendizaje por refuerzo, la estrategia se actualiza de forma estable y eficiente mediante el recorte de la función objetivo, y este enfoque ha demostrado un buen desempeño en áreas como el control de robots y la fabricación inteligente29,30,31. Algunos estudios han intentado integrar el Transformer con el aprendizaje por refuerzo para la planificación compleja de recursos32. Sin embargo, en la planificación dinámica de actividades sindicales, pocos estudios abordan la combinación de diversos tipos de actividades y restricciones complejas de recursos. Algunas investigaciones han utilizado redes neuronales gráficas para modelar la relación entre recursos y tareas, mejorando así la precisión en la identificación de conflictos33,34. Algunos investigadores han optimizado la planificación de recursos basándose en la computación en el borde para mejorar la eficiencia y el rendimiento del modelo35,36. No obstante, tales métodos aún tienen capacidades limitadas de modelado para el contexto temporal. Con base en esto, en este artículo se propone utilizar un Transformer para codificar secuencias históricas de estados de actividades y recursos, combinado con una red de políticas PPO, con el fin de lograr una alta percepción de los riesgos de conflicto y una actualización estable de las estrategias de planificación para hacer frente a las necesidades cambiantes y complejas de planificación de actividades sindicales.
Estudios más recientes han explorado la optimización de la programación de recursos desde diferentes perspectivas, como la consolidación de máquinas virtuales para mejorar la eficiencia energética en computación en la nube37, algoritmos de autenticación en redes celulares38, consolidación mejorada de máquinas virtuales con migración en vivo para una computación en la nube sostenible39, optimización del tráfico mediante predicción de espera y algoritmos evolutivos40, y almacenamiento en la nube basado en blockchain con optimización mejorada y preservación de la integridad41. Si bien estos trabajos aportan conocimientos valiosos sobre algoritmos de asignación y optimización de recursos, se centran principalmente en infraestructuras en la nube, telecomunicaciones o sistemas de almacenamiento, y no abordan específicamente las restricciones de actividades de múltiples tipos, los conflictos dinámicos entre recursos de personal y lugares, ni los requisitos de programación en tiempo real inherentes a la gestión de actividades sindicales. Esta diferencia subraya aún más la necesidad de un marco de programación dedicado, adaptado al contexto organizativo de las actividades sindicales.
Los métodos existentes de programación para actividades sindicales suelen no captar las dependencias espacio-temporales a largo plazo ni mantener la estabilidad de la política frente a cambios dinámicos, lo que provoca tiempos de respuesta lentos y altos conflictos de recursos. Para abordar estas lagunas de investigación, este estudio propone un modelo de optimización de programación basado en el principio de que la atención múltiple (multi-head) del Transformer puede codificar eficazmente secuencias históricas para la predicción de conflictos, y de que la Optimización de Política Próxima (Proximal Policy Optimization, PPO) con un objetivo recortado garantiza actualizaciones de política estables y adaptables. Específicamente, se aplica el Transformer para codificar secuencias de estados de actividades y recursos, extrayendo características espacio-temporales clave que mejoran la anticipación de conflictos, y se combina con PPO para generar acciones de programación eficientes y realizar actualizaciones estables. Se diseña una matriz de restricciones unificada para mapear actividades, personal y lugares, mejorando así el reconocimiento de dependencias complejas. Las innovaciones principales de este trabajo incluyen: (1) la integración de la codificación temporal y el aprendizaje por refuerzo específicamente para la programación de actividades sindicales; (2) un mecanismo de atención consciente de conflictos que prioriza la percepción de riesgos; y (3) una actualización con poda y corrección de la función de ventaja para garantizar la solidez de la estrategia bajo alta concurrencia. Extensos experimentos realizados bajo diversas densidades y complejidades de tareas validan la superioridad del modelo frente a los métodos existentes en velocidad de respuesta, utilización de recursos y estabilidad, ofreciendo una solución inteligente de programación práctica y escalable para la gestión de actividades sindicales.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Figura 1 muestra la estructura de un sistema de programación de actividades sindicales que integra modelado de series temporales y aprendizaje por refuerzo. La capa de entrada integra horarios de actividades, disponibilidad de recursos e información de ventanas temporales del personal, y construye una matriz multidimensional de relaciones de conflicto entre tareas y recursos mediante el módulo de grafo de restricciones. El transformador realiza una codificación de atención múltiple sobre la secuencia histórica de estados de actividades y recursos, produciendo estados ocultos con dependencias temporales. El módulo de política utiliza los resultados de codificación para generar distribuciones de acciones y estimación de estados, y ejecuta decisiones de programación tras muestrear las acciones. Los resultados de ejecución se retroalimentan al entorno, actualizando el estado de los recursos y generando recompensas inmediatas. Sobre esta base, el módulo de optimización construye una función objetivo con truncamiento, evalúa la función de ventaja y corrige la estimación de la red de valores para limitar la deriva de la política y garantizar actualizaciones estables del comportamiento de programación. Se forma un bucle cerrado de datos entre los módulos para lograr una percepción altamente sensible de los conflictos de recursos y actualizaciones adaptativas de estrategias en entornos dinámicos, mejorando así la capacidad de respuesta inteligente y la eficiencia en la asignación de recursos del sistema de programación de actividades sindicales en escenarios con múltiples tareas y altas restricciones.
Modelado de escenarios para la programación de actividades sindicales
Todas las solicitudes de actividades en el sistema de programación se organizan en secuencias de programación discretas basadas en intervalos de tiempo. Cada actividad se define con horarios claros de inicio y finalización, categorías de recursos, etapas y niveles de prioridad. El estado de uso del sitio se modela como una matriz bidimensional de franjas horarias, donde el eje horizontal representa la unidad de tiempo estandarizada y el eje vertical representa el número de recurso espacial. El estado del recurso se marca como disponible u ocupado, formando un mapa inicial de distribución de recursos con una estructura estática. La información de programación del personal se expande en la dimensión tiempo-identidad para construir un vector continuo de ventanas temporales, cada uno de los cuales registra el estado de inactividad laboral del personal y el número de departamento. Toda la información de entrada se integra en una estructura tensorial tridimensional, donde denota el intervalo de tiempo discreto, denota el número de entidades de recurso y denota el código de atributo de uso del recurso correspondiente (por ejemplo, si está ocupado, el número de actividad, la prioridad de uso, etc.). Esta estructura permite que el sistema de programación lea la configuración de recursos en cualquier momento, garantizando una representación unificada de los diferentes tipos de estado de recursos.
Después de vincular la información de la tarea al modelo, se establece el vector de intensidad de la tarea en función de la prioridad de la actividad y el período de uso del recurso. La combinación de tareas que podría generar un conflicto se marca mediante el método de detección de superposición de ventanas temporales. Las combinaciones en conflicto se convierten en conjuntos de nodos, y se construyen conjuntos de aristas basados en tipos de recursos compartidos y períodos, para representar explícitamente las dependencias implícitas. El grafo de tareas final construido contiene información límite sobre secuencia temporal, superposición de recursos o conflicto de restricciones, proporcionando una base estructural para la detección posterior de conflictos y la generación de estrategias de programación. Esta estructura conserva la naturaleza dinámica de la programación de tareas y los cambios continuos en el estado de los recursos, y permite la percepción en tiempo real de los cambios en las restricciones de programación.
La detección de conflictos utiliza las regiones superpuestas dispersas de las dimensiones de tiempo y recursos en la estructura tensorial como condiciones iniciales para la evaluación. Implementa un procesamiento de codificación estática de relaciones para pares de tareas con objetivos de programación que se superponen. Construye una estructura de grafo G=(V,E,C), donde V representa el conjunto de nodos activos, E representa las aristas generadas en función de los conflictos de recursos, y C es la matriz de codificación de pesos de conflicto para las aristas. La función de peso de conflicto se define de la siguiente forma:
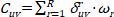 (1)
Entre ellos, Cuv es el peso de conflicto entre las actividades u y v; u, v son los índices de las actividades; R es el número total de tipos de recursos; δuvr ∈ {0,1} indica si las ventanas temporales de las actividades u y v se solapan en el recurso r; ωr es el peso de sensibilidad al conflicto del recurso r. Esta función realiza una suma ponderada de las intensidades de conflicto, considerando las diferencias en la importancia de los conflictos de recursos para los resultados de la programación, al tiempo que conserva una expresión cuantificable de la distribución de la intensidad del conflicto.
La estructura del grafo de conflictos anterior se convierte en una matriz de límites de restricciones mediante una representación de matriz dispersa. Cada elemento de la matriz contiene el grado de conflicto de recursos. La matriz se integra en el proceso de toma de decisiones de planificación para determinar si las tareas pueden programarse en paralelo, mientras que la lógica de protección por acciones se encuentra en la red de políticas. Para hacer frente a la agregación periódica de actividades y a ráfagas de tareas de alta densidad, se implementa un mecanismo de actualización dinámica que supervisa los cambios en el estado de las tareas y modifica el contenido de la matriz en tiempo real conforme los recursos se liberan o añaden, asegurando la continuidad y consistencia del límite de planificación durante toda la evolución de las tareas.
La aplicación de esta estructura de grafo de conflictos permite al sistema de programación modelar visualmente posibles cuellos de botella de recursos y patrones de solapamiento de tareas, mejorando así la eficiencia del análisis de desacoplamiento de la red de decisiones en escenarios de restricciones complejas. El comportamiento de programación ya no depende de la coincidencia lógica basada en reglas. Por el contrario, busca la ruta óptima en el espacio de restricciones, mejorando la capacidad de equilibrar dinámicamente los conflictos locales de recursos con el mapa global de tareas. El sistema puede mantener la estabilidad en la programación y la coherencia de las tareas en un entorno en el que los recursos fluctúan y las tareas se añaden o eliminan con frecuencia.
Figura 2 muestra un diagrama de estructura de red basado en la relación de peso del conflicto de tareas. Cada nodo en la figura representa una tarea por programar, y las líneas entre los nodos indican conflictos en el uso de recursos. El grosor del borde refleja el peso del conflicto. Cuanto más grave sea el conflicto, más gruesa será la línea. El cálculo del peso integra la superposición de recursos y combina la sensibilidad al conflicto de diversos recursos para formar una intensidad compuesta de conflicto entre tareas. La estructura del grafo revela que algunas tareas forman áreas densamente conectadas, lo que indica una competencia significativa por la utilización de recursos. Este tipo de fenómeno de agregación local de conflictos es la fuente principal de cuellos de botella de recursos y retrasos en las tareas durante el proceso de programación, y el algoritmo de programación puede establecer en consecuencia objetivos prioritarios de mediación. La disposición de los nodos emplea una estrategia de diseño basada en fuerzas dirigidas para agrupar automáticamente las tareas con alto nivel de conflicto, permitiendo al sistema de programación identificar grupos clave de tareas y optimizar la distribución de estrategias, mejorando así la coherencia general de la programación y la coordinación de recursos.
Codificación de la secuencia de estados históricos
A partir del grafo de conflictos y la matriz de restricciones construidos, el siguiente paso consiste en codificar las secuencias históricas de actividades y los estados de los recursos, de modo que puedan extraerse los patrones temporales subyacentes a dichas restricciones para la toma de decisiones posterior. La información principal en el escenario de programación consiste en solicitudes de actividades, cambios en el estado de los recursos y registros de retroalimentación sobre las tareas. Esta información constituye múltiples series temporales heterogéneas, correspondientes a atributos tales como los instantes temporales de los eventos, los identificadores de uso de recursos y el estado de ejecución de las actividades. Para unificar la estructura de procesamiento, cada tipo de entrada se codifica como una secuencia de vectores de igual longitud, y se establece un índice temporal unificado para garantizar el alineamiento de estados bajo sincronización temporal. La unidad de entrada en cada momento se representa mediante la concatenación de tres conjuntos de vectores característicos: el vector característico de actividad representa el tipo de tarea, la prioridad y el número de etapa; el vector característico de recurso registra la ocupación actual del recurso, la capacidad restante y la posición de la ventana disponible; el vector característico de retroalimentación describe si la tarea se ejecutó sin interrupciones en el momento anterior, y si ocurrió un conflicto de recursos o un evento de retraso.
Todas las características se transforman linealmente y se proyectan en un mismo espacio dimensional para obtener una matriz de incrustación estandarizada X ∈ ℝT×d, donde T representa el número de pasos temporales y d es la dimensión unificada de la incrustación. Para preservar la estructura temporal, la matriz de entrada se suma elemento a elemento con la matriz de codificación de posición P para formar la entrada sensible a la posición:
Z = X + P (2)
Z es la secuencia de entrada final, que sirve como entrada para el mecanismo de atención subsiguiente. El diseño de codificación de posición utiliza una plantilla fija de funciones seno y coseno para evitar la filtración de información futura y garantizar que se cumplan estrictamente las restricciones causales durante la codificación. La estructura anterior permite que el modelo perciba simultáneamente las características de la tarea, el estado de los recursos y la posición temporal. Cuenta con una base de memoria de estado completa, proporcionando una estructura unificada de alta resolución para el mecanismo de atención subsiguiente.
El módulo de atención procesa la secuencia de entrada para capturar posibles relaciones entre múltiples pasos temporales. Se utilizan múltiples grupos de cabezas de atención para procesar la secuencia por separado, mejorando la sensibilidad del modelo a diferentes tipos de trayectorias de evolución de estado. Cada cabeza de atención genera una matriz de consulta Q, una matriz de claves K y una matriz de valores V a partir de la secuencia de entrada, calcula la matriz de distribución de pesos y genera una representación ponderada. La salida de una atención de una sola cabeza es:
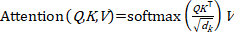 (3)
dk es el número de dimensiones de características por cabeza. En esta fórmula, QK⊤ representa la similitud entre momentos, √dk se utiliza para la estabilidad numérica, y la función softmax garantiza la normalización de los pesos. Diferentes cabezas de atención se centran en distintas combinaciones de pasos temporales, y las dependencias dinámicas que capturan también son diversas, lo que ayuda a revelar reglas implícitas como precursoras de conflictos de tareas, patrones de consumo de recursos y tendencias anómalas de retroalimentación.
Todas las salidas de las cabezas de atención se concatenan y pasan a través de una capa de transformación lineal para generar una secuencia de codificación unificada, que sirve como entrada de estado a la red de generación de estrategias de planificación. Esta secuencia integra la trayectoria del comportamiento de la tarea, las características del cambio de recursos y el impacto de las desviaciones previas de ejecución en la ventana de planificación actual, abordando así eficazmente el problema de la alta dependencia histórica en el comportamiento de planificación y la expresión escasa de características. Se incorporan módulos de conexión residual y normalización de capa en la capa de salida de codificación para mejorar la estabilidad del entrenamiento y las capacidades de retención de expresión de la red profunda.
La secuencia de estados ocultos de salida no solo conserva la información de evolución temporal, sino que también responde a cambios derivados de tareas repentinas o desajustes temporales de recursos, lo que demuestra una gran adaptabilidad. Este diseño estructural evita la definición explícita de reglas, posibilita la modelización estructurada de entornos de programación dinámicos y apoya a los módulos de política posteriores en la generación de soluciones de programación con consistencia global y adaptabilidad local bajo condiciones multiobjetivo.
Generación de estrategias dinámicas de programación
Las secuencias codificadas de estados ocultos, que incorporan tanto las dependencias temporales como la información sobre conflictos de recursos, se introducen luego en la red de políticas para generar acciones de programación que se adaptan al entorno actual. La secuencia de estados ocultos generada por el módulo de codificación se utiliza como entrada para la red de estrategia de programación. El conjunto de vectores de estado en cada momento constituye la expresión actual de la observación del entorno, abarcando la evolución de las características de las tareas, las tendencias de uso de recursos y las trayectorias históricas de retroalimentación. La dimensión de la representación de estado y la longitud de la ventana temporal son fijas, y la continuidad de los cambios de estado se captura mediante un mecanismo de actualización deslizante. Antes de que el vector de estado se envíe a la red de políticas, se normaliza y reorganizan sus características para garantizar que la entrada mantenga una distribución numérica estable en el espacio de alta dimensión, reduciendo así la explosión de gradientes y las fluctuaciones de convergencia.
La estructura de la red de políticas emplea un módulo de salida de doble rama, donde una rama genera la distribución de acciones y la otra produce la estimación de la función de valor de estado. El espacio de acciones comprende todas las tareas programables y los recursos asignables. El mecanismo de selección de candidatos filtra combinaciones ilegales o redundantes de operaciones para formar un conjunto limitado y legal de acciones. La rama de políticas produce una distribución de probabilidad π(at|st), donde at representa la acción de programación en el paso de tiempo, y st es la entrada del estado actual. Se utiliza una estrategia de muestreo gaussiano estandarizado o de muestreo softmax para seleccionar acciones a partir de la distribución para la programación real. La otra salida es la estimación de la función de valor de estado, que representa la expectativa de recompensa a largo plazo en el estado dado y se utiliza para la evaluación y actualización de la política.
En la red de políticas, la capa oculta aplica funciones de activación y normalización por lotes para mejorar la capacidad de expresión no lineal y acelerar la convergencia de la red. En el proceso de toma de decisiones, se consideran factores de atención la prioridad de ejecución, el costo de programación de recursos y el desempeño histórico de diferentes tareas, los cuales se aplican al mecanismo de selección de acciones mediante una matriz de pesos específica para formar un marco de salida de políticas adaptable y ajustable. Este diseño evita la dependencia de reglas fijas, mejorando así la flexibilidad de la estrategia para manejar conflictos repentinos y cuellos de botella estructurales.
La estrategia de programación utiliza un mecanismo de muestreo aleatorio para generar la secuencia de acciones real. En cada ciclo de programación, se selecciona una acción ejecutable a partir de la distribución actual de acciones, y se actualiza el estado de los recursos y la marca del nodo de la tarea. Después de ejecutar la acción, el sistema calcula la recompensa inmediata basándose en los cambios de recursos y los resultados del progreso de la tarea, con el fin de medir el impacto de esta ronda de programación sobre el objetivo general. El diseño de la recompensa considera múltiples dimensiones, incluyendo la tasa de finalización de tareas, la eficiencia en la utilización de recursos y el grado de supresión de conflictos. Esta proporciona retroalimentación al módulo de actualización de la estrategia mediante indicadores integrales.
Todo el proceso de planificación construye una cadena de decisión de Markov y utiliza el método de muestreo de trayectorias empíricas para registrar la secuencia estado-acción-recompensa, denotada como (st, at, rt, st+1). La optimización de la estrategia depende de la construcción de la función de ventaja, donde la estimación de ventaja se define en la siguiente forma:
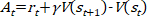 (4)
At representa el valor de ventaja, rt es la recompensa instantánea actual, γ es el factor de descuento de la recompensa, y V(st) y V(st+1) son las salidas de la función de valor de estado en los estados actual y siguiente, respectivamente. La función de ventaja refleja el grado de superioridad de la acción actual en relación con el rendimiento promedio de la estrategia. Se utiliza para guiar la mejora posterior de la estrategia. Si At > 0, significa que la acción actual es mejor que la expectativa promedio, y su probabilidad debe aumentarse; en caso contrario, su tendencia de selección debe reducirse.
Durante el proceso de actualización de la estrategia, para evitar oscilaciones causadas por amplitudes excesivas de actualización, se aplica un mecanismo de truncamiento de la distribución objetivo que limita el rango de cambio entre las estrategias nueva y antigua, manteniendo así la continuidad y estabilidad de la salida de la red. Se establece un acoplamiento estrecho entre la distribución de acciones y la recompensa de retroalimentación, lo que permite que la estrategia responda inmediatamente a cambios en restricciones complejas. Este mecanismo mantiene la estabilidad en la toma de decisiones y una programación racional de recursos en situaciones donde las tareas cambian frecuentemente o hay desajustes repentinos de recursos, evitando eficazmente problemas como asignaciones duplicadas, congestión de recursos o acumulación en colas de tareas. El sistema de programación puede mantener un estado operativo más favorable ante densidades variables de tareas y escasez de recursos, demostrando fuertes capacidades de adaptación.
Iteración de estrategias y mecanismo de actualización estable
Para garantizar que las estrategias de programación generadas permanezcan estables y no se degraden tras múltiples rondas de entrenamiento, en esta sección se introduce un mecanismo de actualización iterativa con recorte y corrección de ventaja. El intervalo de actualización del truncamiento entre las estrategias antigua y nueva se establece, y se utiliza la función objetivo de recorte para limitar la deriva de la estrategia y prevenir choques de programación durante el proceso de actualización de la estrategia. La red de valoración se corrige en combinación con la función de ventaja para mejorar la precisión de la programación a largo plazo.
La distribución de probabilidad de la salida de acciones de la red de políticas es propensa a fluctuaciones drásticas durante las iteraciones continuas de programación, lo que puede provocar un comportamiento inestable o una asignación desordenada de recursos. Para mitigar el impacto de programación causado por la deriva de la política, se diseña un intervalo de actualización truncado para controlar el rango de cambio entre las políticas nueva y antigua, y se construye un término de restricción para perfeccionar la función objetivo. La probabilidad de la política histórica se registra en la ronda de muestreo, y se construye el término de razón junto con la probabilidad de la política actual. El objetivo de actualización de la política se establece como:
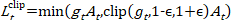 (5)
Aquí, gt = πθ(at|st)/πθold(at|st) denota la razón de probabilidad entre las políticas nueva y antigua; ε es el umbral de recorte que limita el rango de actualización de la política. Cuando la razón excede el límite, se utiliza el valor recortado en su lugar para evitar que la estrategia genere gradientes excesivos a partir de muestras extremas, asegurando que el ajuste de los parámetros de la red permanezca dentro del rango preestablecido. Esta estructura restringe dinámicamente el rango de cambios en la estrategia de salida en cada ronda de planificación, manteniendo la suavidad y consistencia de la salida de la estrategia bajo distribuciones densas de tareas y reduciendo significativamente la tasa de fluctuación del comportamiento de planificación.
La función objetivo de la política se amplía con términos de regularización y recompensa de entropía durante el proceso de actualización para aumentar la diversidad de la distribución de acciones y suprimir la convergencia temprana. Cada ronda de actualización de políticas utiliza múltiples lotes de muestras de trayectorias de experiencia para el entrenamiento progresivo, manteniendo así una amplia cobertura en el espacio de estados. Cuando se compara la distribución de probabilidad de la secuencia de acciones de salida antes y después de la actualización, se calcula la tasa de desviación de la distribución, y un umbral rígido filtra el rango de perturbación aceptable de la política. Este mecanismo proporciona un control de límites para la migración de políticas de programación entre ciclos, suprimiendo así el sobreajuste debido a cambios drásticos en el estado de los recursos.
Las actualizaciones de estrategia dependen de la evaluación del estado proporcionada por la función de valor. Las desviaciones en la estimación del valor del estado pueden afectar directamente la corrección de la función de ventaja, alterando así la dirección de la iteración de estrategia. Para mejorar la precisión de la valoración, se construye un mecanismo de retroceso multiplo en series temporales, y se utiliza el valor acumulado descontado de las recompensas futuras para corregir el valor actual del estado. La recompensa de retroceso adopta la estructura de Estimación Generalizada de Ventaja (GAE, por sus siglas en inglés), que se define como:
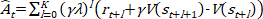 (6)
Ât es el valor de ventaja corregido; λ es el coeficiente de equilibrio de retroceso; rt+l representa la recompensa inmediata del paso (t+l); V(st+l) es el valor de estado producido por la red de valoración. Esta estructura integra retroalimentación inmediata a corto plazo y expectativas de estado a largo plazo para corregir desviaciones en las predicciones de respuesta de la estrategia ante futuros conflictos de recursos, picos de carga y acumulación de tareas. λ controla la profundidad del retroceso y se ajusta automáticamente durante períodos de fluctuaciones drásticas en la dinámica de recursos para mejorar la robustez de la respuesta de la red de valoración ante eventos repentinos.
La estructura dependiente del tiempo a múltiples escalas integrada en la función de ventaja permite que la red de valoración modele tendencias de recursos a largo plazo. Para detectar la desviación en la salida de la política, se utiliza el índice de consistencia del comportamiento de la política para evaluar si la red presenta una respuesta excesiva al error de valoración. Los términos residuales de diferencia de retroalimentación supervisan el comportamiento de actualización de la política, y el objetivo de entrenamiento y la amplitud de actualización del peso de la función de valor se corrigen dinámicamente. La red de valoración y la red de política se optimizan conjuntamente para garantizar que la estimación del valor no se desvíe del objetivo de finalización de la tarea, a la vez que se evita que la programación de alta frecuencia juzgue erróneamente el estado de conflicto de recursos.
Este mecanismo estable de actualización de políticas puede mantener eficazmente la controlabilidad y consistencia de las actualizaciones en el comportamiento de las políticas dentro de un entorno de tareas dinámico de alta dimensión, mejorando la eficiencia en la cobertura de tareas y la flexibilidad en la utilización de recursos, y formando una estructura de programación inteligente de carácter continuamente iterativo. El comportamiento de programación evita caer en optimalidad local durante la evolución a largo plazo y mejora la adaptabilidad general ante cambios en los patrones de tareas y fluctuaciones en los ciclos de recursos.
Figura 3A muestra la tendencia del valor de la función objetivo en función del número de iteraciones de entrenamiento bajo diferentes condiciones de umbral de truncamiento. El eje horizontal representa el número de iteraciones de entrenamiento, y el eje vertical representa el valor numérico de la función objetivo recortada. Se establece ε en 0,1, 0,2 y 0,3, lo que representa distintos grados de intensidad en el control de la deriva de la política. La curva correspondiente a un valor de ε más pequeño presenta menos fluctuaciones, y la función objetivo permanece estable. Cuando ε = 0,1, el valor global de la función objetivo se sitúa entre 0,8 y 1, mostrando la gradualidad y estabilidad de la actualización de la estrategia. Sin embargo, un valor mayor de ε conduce a fluctuaciones más pronunciadas. Cuando ε = 0,3, el valor global de la función objetivo oscila entre 0,65 y 0,95, y la curva de la función objetivo muestra una mayor amplitud de oscilación, reflejando el riesgo de una desviación severa en el proceso de actualización de la estrategia. Cuanto menor sea el umbral, más estable será la estrategia, lo que la hace adecuada para entornos de programación con altas restricciones. Figura 3B muestra los cambios en la estimación de ventaja generalizada bajo diferentes coeficientes de equilibrio de retroceso. Se establece λ en 0,8, 0,9 y 1,0, respectivamente, para controlar la profundidad de retroceso de las recompensas futuras. La curva muestra que cuanto mayor es λ, menor es la fluctuación de la GAE, más suave es la tendencia a largo plazo y más precisamente captura el impacto potencial del comportamiento de programación tras múltiples pasos. La curva con un valor de λ de 0,8 presenta fluctuaciones periódicas pronunciadas, lo que indica que es más sensible a las recompensas inmediatas y más adecuada para tareas a corto plazo y repentinas. En contraste, un valor de λ de 1,0 se centra más en la modelización de tendencias a largo plazo y es adecuado para escenarios de tareas periódicas.
Análisis de complejidad computacional y escalabilidad
La complejidad computacional del marco Transformer-PPO propuesto está determinada por dos componentes principales: el codificador Transformer y la optimización de la política PPO.
Para el codificador Transformer con L capas, H cabezas de atención, dimensión de incrustación d y longitud de la secuencia de entrada T (la ventana temporal histórica), la complejidad temporal por paso hacia adelante es O(L·T2·d + L·T·d2), donde el término T2 surge del mecanismo de autoatención. En la implementación, L = 3, H = 4, d = 128 y T se fija en 100 pasos de tiempo, lo que resulta en una sobrecarga computacional manejable. Para ventanas históricas más largas, el término cuadrático T2 se convierte en el factor dominante; sin embargo, en la práctica, la programación de actividades sindicales generalmente implica horizontes históricos finitos (por ejemplo, ventanas móviles de un trimestre o un año), y la resolución del paso de tiempo puede ajustarse para equilibrar precisión y eficiencia.
Para el componente PPO, la red de política y la red de valor son MLP ligeros (256 y 128 neuronas por capa oculta), cuya complejidad de inferencia es O(d·m), donde m es el número de unidades ocultas, lo cual es despreciable en comparación con el codificador Transformer. La actualización de la política durante el entrenamiento implica múltiples épocas de actualizaciones del gradiente por mini-lotes, con una complejidad de O(B·E·d2), donde B es el tamaño del lote y E es el número de épocas de actualización.
En cuanto a la escalabilidad, el marco presenta tres propiedades favorables. En primer lugar, el mecanismo de atención puede paralelizarse a través de los pasos temporales, lo que permite una aceleración eficiente mediante GPU. En segundo lugar, el tamaño del modelo es independiente del número de actividades o recursos, ya que la matriz de restricciones se construye dinámicamente en cada paso de planificación en lugar de estar integrada como parámetros fijos. Esto permite desplegar el mismo modelo entrenado en uniones de diferentes escalas sin necesidad de reentrenamiento. En tercer lugar, para escenarios de escala extremadamente grande, puede reducirse la longitud de la ventana histórica T y la dimensión de incrustación d como un compromiso, o puede adoptarse la variante de atención dispersa para reducir la complejidad O(T2) a O(T log T) o O(T).
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Datos experimentales
Para evaluar exhaustivamente el rendimiento del algoritmo de programación dinámica Transformer-PPO presentado en este artículo, el experimento utiliza datos de gestión de actividades de un gran sindicato empresarial de los últimos tres años como conjunto de datos de referencia. Este conjunto contiene más de 5.000 registros de actividades, que abarcan diversos tipos, incluyendo reuniones, capacitaciones y entretenimiento, con información de programación para múltiples recursos, ta...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Los resultados experimentales demuestran que el algoritmo propuesto Transformer-PPO supera consistentemente a los métodos de referencia (LSTM-PPO, búsqueda codiciosa y DQN) en todas las métricas de evaluación. El rendimiento superior se puede atribuir a dos factores clave. Primero, el mecanismo de autoatención multi-cabeza del Transformer captura de manera efectiva las dependencias temporales de largo alcance en las secuencias de estados de actividad y recursos, lo que permite la identificación proactiva de posibles conf...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no tienen conflictos financieros de interés.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Lenguaje de programación principal |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Entorno de aprendizaje profundo (implementación de Transformer/PPO) |
| NumPy 1.23 | Desarrolladores de NumPy | https://numpy.org/doc/stable/release/1.23.0-notes.html | Biblioteca para cálculos numéricos |
| Matplotlib 3.5 | Equipo de desarrollo de Matplotlib | https://matplotlib.org/stable/users/installing.html | Visualización de resultados |
| Conjunto de datos de programación de actividades sindicales | Base de datos interna de una empresa colaboradora (anonimizada) | No disponible públicamente debido a un acuerdo de confidencialidad; los investigadores pueden contactar al autor correspondiente para obtener acceso | Más de 5.000 registros de actividades (reuniones, capacitaciones, entretenimiento) de un sindicato de una gran empresa durante tres años |
| NVIDIA A100 GPU | |||
| PyTorch |
Referencias
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.