Este estudio investiga biomarcadores de electroencefalografía para distinguir entre la enfermedad de Alzheimer, la demencia frontotemporal y controles sanos. Los modelos de Bosque Aleatorio que utilizan las características de raíz cuadrada media, densidad espectral de potencia y entropía se interpretaron mediante inteligencia artificial explicable y análisis del tamaño del efecto. La eliminación de las características de entropía con bajo impacto mejoró el rendimiento de la clasificación, alcanzando una precisión del 94 % en la prueba.
Artículo de investigación
Fusión de biomarcadores de electroencefalografía multidominio para la clasificación de la demencia basada en el aprendizaje automático
En este artículo
Resumen
Resumen
La electroencefalografía (EEG) ha sido investigada como un enfoque no invasivo para caracterizar la actividad cerebral en condiciones neurodegenerativas. Este estudio evaluó si biomarcadores multidominio de EEG podían distinguir entre la enfermedad de Alzheimer (AD), la demencia frontotemporal (FTD) y controles sanos (HC). El conjunto de datos de acceso público contenía grabaciones de EEG en estado de reposo con los ojos cerrados de 88 participantes, incluyendo 36 con AD, 23 con FTD y 29 controles sanos. Se extrajeron biomarcadores multidominio de EEG y características demográficas para la clasificación mediante aprendizaje automático. Las características derivadas del EEG incluyeron la raíz cuadrática media (RMS), la densidad espectral de potencia (PSD) y medidas de entropía. Se entrenó un clasificador de Bosque Aleatorio utilizando el conjunto combinado de características e interpretado mediante inteligencia artificial interpretable. Se realizaron análisis de estabilidad de características y del tamaño del efecto de Cohen’s d para evaluar la contribución de las características, seguidos de un análisis de ablación. Las características basadas en entropía mostraron la menor contribución a la clasificación. El modelo multidominio completo alcanzó una precisión del 96 % en el entrenamiento y del 92 % en la prueba. Tras la eliminación de las características de entropía, la precisión en la prueba aumentó al 94 %. Estos resultados describen el rendimiento de clasificación de las características seleccionadas de EEG multidominio y demográficas dentro del marco del Bosque Aleatorio.
Introducción
La enfermedad de Alzheimer (AD) es una afección neurológica progresiva asociada con el deterioro de la función cognitiva y motora. Su prevalencia aumenta considerablemente con la edad, y la demencia es una causa importante de morbilidad y mortalidad entre los adultos mayores1,2,3,4,5. Debido a que el diagnóstico y la clasificación de la enfermedad siguen siendo difíciles, se ha investigado el análisis de las señales cerebrales como un medio para caracterizar los cambios neurofisiológicos asociados con la demencia.
La electroencefalografía (EEG) es un método no invasivo para registrar la actividad eléctrica del cerebro y se ha investigado en la enfermedad de Alzheimer y otros trastornos neurológicos6,7,8,9,10,11. Las señales de EEG reflejan potenciales eléctricos generados por la actividad neuronal y se registran de forma no invasiva desde múltiples ubicaciones en el cuero cabelludo12,13,14. La actividad cerebral se caracteriza comúnmente mediante las bandas de frecuencia delta, theta, alpha, beta y gamma15. Se ha asociado la enfermedad de Alzheimer con una desaceleración del EEG, una reducción en la complejidad de la señal y una sincronización alterada16. Los análisis espectrales han mostrado un aumento en la actividad delta y theta junto con una disminución en la actividad alpha y beta en individuos con EA en comparación con controles sanos17,18,19. Estudios previos de clasificación mediante EEG han reportado un alto rendimiento para distinguir la EA de controles sanos (CS) y la demencia frontotemporal (DFT) de CS. En contraste, la discriminación entre EA y DFT generalmente ha sido más difícil10,11.
Se han utilizado métodos de aprendizaje automático para identificar patrones en señales de EEG asociadas con enfermedades neurológicas20,21. Por lo tanto, la extracción de características es un componente importante de la clasificación basada en EEG. Estudios previos han investigado características espectrales, temporales, de complejidad y de conectividad funcional en combinación con modelos de aprendizaje automático3,15,22,23. Las características espectrales son particularmente relevantes porque cuantifican los cambios dependientes de la frecuencia en la actividad cerebral, incluyendo la reducción de la actividad alfa y el aumento de la actividad theta reportados en la EA23,24,25,26.
Varios estudios basados en EEG han evaluado diferentes combinaciones de características, clasificadores y estrategias de validación. El análisis basado en la conectividad se ha utilizado para distinguir entre AD, FTD y controles sanos (HC), con un rendimiento de clasificación informado que varía según la comparación y el procedimiento de selección de características27. También se han evaluado características basadas en Fourier para diferenciar entre AD, deterioro cognitivo leve (MCI) y controles sanos, aunque las limitaciones incluyeron un procesamiento previo limitado y un posible sobreajuste asociado con la estrategia de validación28. Las medidas de complejidad no lineal del EEG han mostrado un potencial discriminativo para la clasificación de AD, con algunas que alcanzan alta precisión, sensibilidad y especificidad, aunque su aplicabilidad a la discriminación de MCI y de las etapas de la enfermedad sigue siendo limitada21.
También se han investigado métodos de aprendizaje profundo basados en representaciones temporales y frecuenciales del EEG para la clasificación multiclase de AD, MCI y HC29. Aunque se ha informado un alto rendimiento de clasificación, las limitaciones incluyen cohortes pequeñas o seleccionadas, desequilibrio entre clases, gravedad heterogénea de la enfermedad, falta de validación externa y una interpretabilidad reducida del modelo29. La estrategia de validación también es un aspecto metodológico importante. Enfoques independientes de los participantes han demostrado que la validación cruzada convencional a nivel de época puede sobreestimar el rendimiento cuando épocas del mismo participante aparecen tanto en los conjuntos de entrenamiento como de prueba30. Esta limitación es particularmente relevante al comparar resultados de clasificación entre estudios que utilizan esquemas de validación diferentes.
También se han evaluado medidas de complejidad y conectividad utilizando clasificadores de máquinas de vectores de soporte, mostrando la conectividad basada en fase y la entropía multiescala distintos niveles de rendimiento discriminativo31,32. Otros estudios que utilizan características derivadas de Fourier y de wavelets han reportado un rendimiento variable en las comparaciones entre AD, MCI y HC, siendo en general más difícil la clasificación multiclase que la binaria14. Los enfoques basados en entropía y sincronía también han demostrado capacidad de discriminación entre grupos con AD y controles, aunque las características de la población control pueden afectar el tamaño del efecto observado2.
El presente estudio evalúa un conjunto de características multidominio que incluye la raíz cuadrada media (RMS), la densidad espectral de potencia (PSD) y medidas de entropía extraídas de las bandas de frecuencia del EEG, junto con la edad como variable demográfica. RMS representa la amplitud de la señal dentro de cada banda de frecuencia, mientras que PSD representa la potencia en el dominio de la frecuencia. La entropía se incluye como una medida de la complejidad de la señal. Estas características proporcionan descripciones complementarias de la actividad del EEG y se evalúan mediante un clasificador de bosque aleatorio. El estudio analiza además la importancia de las características, la estabilidad de las características, la inteligencia artificial interpretable y el análisis del tamaño del efecto para evaluar la contribución relativa de las características extraídas. El presente estudio investiga la eficacia de las características multidominio del EEG, incluyendo medidas basadas en espectros, en el dominio temporal y en la complejidad, para distinguir entre la enfermedad de Alzheimer (AD), la demencia frontotemporal (FTD) y controles sanos (HC) mediante el uso de aprendizaje automático. También examina qué características de las bandas de frecuencia del EEG contribuyen más fuertemente a la clasificación al utilizar medidas de densidad espectral de potencia (PSD), raíz cuadrada media (RMS) y entropía. Además, el estudio compara las contribuciones de las características basadas en potencia, incluyendo PSD y RMS, con las de las características basadas en entropía, y evalúa la contribución de la edad al modelo de clasificación.
Protocolo
Se muestra un esquema general del flujo de trabajo de preprocesamiento del EEG, extracción de características y clasificación en la Figura 1. Los materiales y el software utilizados en el estudio se enumeran en la Tabla de Materiales.
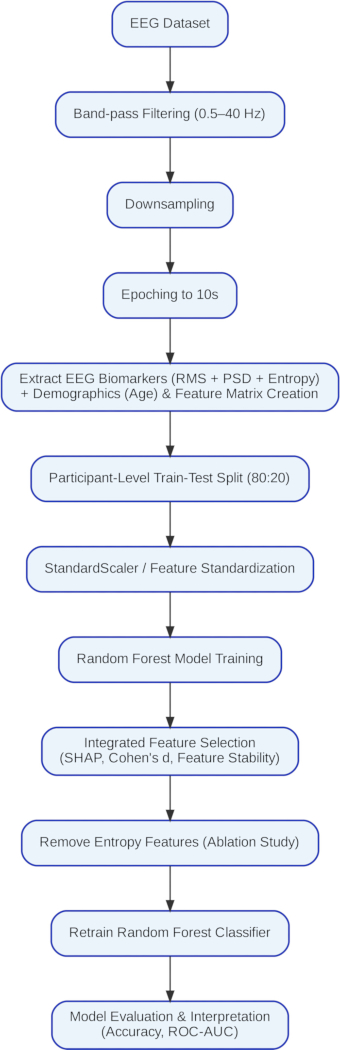
Figura 1: Flujo de trabajo del preprocesamiento de EEG, extracción de características y clasificación. Descripción esquemática del flujo de trabajo del estudio, que incluye verificación de los datos de EEG, filtrado paso banda y re-referenciación, extracción de las características de raíz media cuadrática (RMS), densidad espectral de potencia (PSD) y entropía, incorporación de la edad, división entre conjuntos de entrenamiento y prueba, desarrollo del modelo de Bosque Aleatorio, análisis de estabilidad de características, análisis SHAP, análisis del tamaño del efecto d de Cohen, selección integrada de características, ablación de características de entropía, reentrenamiento del modelo y evaluación del rendimiento. Haga clic aquí para ver una versión más grande de esta figura.
1. Adquisición de datos
El conjunto de datos de EEG en estado de reposo de acceso público se obtuvo del repositorio OpenNeuro (conjunto de datos ds004504, versión 1.0.9)33. Se verificaron las etiquetas de los participantes y la información demográfica. El conjunto de datos comprendía 88 participantes, incluyendo 36 con enfermedad de Alzheimer (AD), 23 con demencia frontotemporal (FTD) y 29 controles sanos (HC).
2. Importación de la grabación de EEG
Para cada participante, la grabación de EEG se cargó utilizando la biblioteca MNE-Python. Cada archivo de EEG se verificó para confirmar que era accesible, que podía importarse correctamente y que contenía un identificador válido del participante. Se excluyeron las grabaciones con archivos faltantes o dañados. En esta etapa se mantuvo la frecuencia de muestreo original del EEG de 500 Hz. Las señales se submuestrearon para reducir la carga computacional, preservando toda la información clínicamente relevante del EEG para este estudio.
3. Filtrado de paso de banda
Las grabaciones continuas de EEG se filtraron utilizando un filtro de paso de banda de cuarto orden con una frecuencia de corte baja de 0,5 Hz y una frecuencia de corte alta de 40 Hz.
4. Referenciación promedio común y epoquetización
Se aplicó la referenciación promedio común (CAR) a las grabaciones de EEG filtradas. En cada muestra de tiempo, se calculó la señal promedio a través de todos los canales de EEG disponibles y se restó de cada canal. Las señales de EEG referenciadas se conservaron para análisis posteriores. Cada grabación de EEG referenciada se dividió en épocas de duración fija utilizando la función make_fixed_length_epochs() en MNE-Python. Se utilizó una duración de época de 10 s con superposición de 0 s.
5. Validación de épocas
Para cada participante, solo se conservaron épocas completas de 10 s. Cualquier segmento restante de EEG más corto de 10 s al final de una grabación fue descartado. Cada época conservada se utilizó posteriormente como una muestra individual para la extracción de características.
6. Preparación de características
Aunque los datos del Mini-Mental State Examination (MMSE) estaban disponibles en el conjunto de datos original, se excluyeron del presente análisis. Las características extraídas del EEG se combinaron con la información demográfica de los participantes, incluyendo la edad y las etiquetas diagnósticas, obtenidas del archivo de metadatos participants.csv. El identificador del participante se utilizó como clave común, y solo se conservaron aquellos participantes que tenían registros de características del EEG e información demográfica correspondiente.
La matriz de características multidominio incluyó cinco características de raíz cuadrada media (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms y gamma_rms), cinco características de densidad espectral de potencia (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd y gamma_psd) y cinco características de entropía (delta_entropy, theta_entropy, alpha_entropy, beta_entropy y gamma_entropy). La edad se incluyó como una variable demográfica complementaria. Dado que las distribuciones de edad pueden diferir entre los grupos diagnósticos, no se pudo descartar por completo un sesgo demográfico. El grupo diagnóstico, definido como AD, HC o FTD, se asignó como etiqueta objetivo.
7. Preprocesamiento de datos y partición en conjuntos de entrenamiento y prueba
Durante el preprocesamiento, las grabaciones se submuestrearon de 500 Hz a 250 Hz para reducir los requisitos computacionales, manteniendo al mismo tiempo la información de frecuencia de EEG de interés.
El conjunto de datos se dividió en subconjuntos de entrenamiento (80 %) y prueba (20 %) a nivel de sujeto utilizando una estrategia de división agrupada. Las predicciones a nivel de sujeto se obtuvieron posteriormente mediante votación mayoritaria a través de las épocas predichas pertenecientes a cada participante. La evaluación principal utilizó una división agrupada de entrenamiento-prueba a nivel de sujeto para evitar que épocas del mismo participante aparecieran en ambos subconjuntos. Las predicciones a nivel de sujeto se obtuvieron mediante votación mayoritaria a través de las épocas predichas pertenecientes a cada participante. El conjunto de datos se examinó en busca de valores faltantes, y las observaciones faltantes se eliminaron o imputaron según correspondiera. Las etiquetas diagnósticas se codificaron. Un StandardScaler se ajustó con los datos de entrenamiento y luego se aplicó tanto a los conjuntos de datos de entrenamiento como de prueba.
8. Desarrollo del modelo de bosque aleatorio
Se inicializó un clasificador de bosque aleatorio utilizando 80 árboles, una profundidad máxima de árbol de 10, un máximo de cuatro características, un mínimo de cinco muestras por hoja y un estado aleatorio de 42. El clasificador se entrenó utilizando el conjunto de datos de entrenamiento estandarizado.
9. Evaluación del modelo
Se predijeron las etiquetas de clase para ambos conjuntos de datos, de entrenamiento y de prueba. Se construyó una matriz de confusión, y se calcularon la exactitud, la precisión, la recuperación y la puntuación F1 junto con el informe de clasificación. Se registraron las exactitudes de entrenamiento y de prueba.
Para la evaluación por participante, asegúrese de que todas las épocas de un participante determinado se asignen exclusivamente al subconjunto de entrenamiento o al de prueba. Se entrenó el clasificador de bosque aleatorio utilizando los mismos hiperparámetros que en el análisis principal.
10. Validación cruzada
Como procedimiento adicional de evaluación del modelo, se realizó una validación cruzada estratificada de cinco pliegues utilizando shuffle = True y random_state = 30. Se calcularon la precisión media y la desviación estándar a través de los cinco pliegues. Este análisis se consideró por separado de la evaluación principal por sujeto con conjunto de reserva.
11. Análisis de estabilidad de características
La estabilidad de las características se evaluó repitiendo el entrenamiento del bosque aleatorio 10 veces utilizando semillas aleatorias del 0 al 9. En cada ejecución, se registraron la precisión en el conjunto de prueba y las puntuaciones de importancia de las características. Se calcularon la media y la desviación estándar de la puntuación de importancia de cada característica a lo largo de las 10 ejecuciones, y los predictores se clasificaron según su estabilidad. Este análisis se utilizó para evaluar la consistencia de los rankings de características, y no para sustituir la evaluación principal a nivel de sujeto.
12. Análisis de inteligencia artificial interpretable
Se aplicó el TreeExplainer de SHAP al modelo de bosque aleatorio entrenado. Se calcularon los valores de SHAP para estimar la contribución de cada característica a las predicciones del modelo. Se calculó el valor absoluto medio de SHAP para cada característica, y las características se ordenaron según sus contribuciones SHAP. Se identificaron las características con valores de SHAP consistentemente bajos y se compararon con los resultados de los análisis de estabilidad de características y de d de Cohen. Las características que mostraron contribuciones consistentemente bajas se seleccionaron para la ablación subsiguiente y el reentrenamiento del modelo.
13. Análisis del tamaño del efecto estadístico
Se calculó la d de Cohen para cada biomarcador de EEG en las comparaciones de AD versus HC, AD versus FTD y FTD versus HC. Las magnitudes del tamaño del efecto se interpretaron utilizando umbrales de 0,20 para un efecto pequeño, 0,50 para un efecto medio y 0,80 para un efecto grande.
14. Selección integrada de características
Se compararon los resultados del análisis de importancia de características del bosque aleatorio, el análisis SHAP y el análisis de d de Cohen. Los predictores que mostraron consistentemente baja importancia de característica, baja contribución SHAP y tamaños del efecto pequeños se identificaron como candidatos para su eliminación.
15. Ablación de características
Se evaluaron las características de entropía en un análisis exploratorio de ablation, y se construyó una matriz reducida de características que contenía RMS, PSD y edad. Se entrenó nuevamente el clasificador de bosque aleatorio utilizando los mismos hiperparámetros. Se repitieron el entrenamiento del modelo, la prueba, la validación cruzada y el análisis de la curva característica de operación del receptor (ROC) utilizando el conjunto reducido de características.
16. Análisis de ROC
Las probabilidades de clase se obtuvieron a partir del clasificador de Bosque Aleatorio optimizado. Se generaron curvas ROC multiclase utilizando un enfoque de uno contraversus-estrategia de reposo. Se calcularon los valores del área bajo la curva (AUC) específicos para cada clase y el AUC promedio.
17. Comparación del rendimiento
Se comparó el rendimiento del modelo de características completo con el del modelo de características reducido obtenido tras la ablación de características por entropía.
Resultados
El modelo de bosque aleatorio alcanzó una precisión del 96 % en el entrenamiento y del 92 % en las pruebas. El puntaje F1 promedio macro fue del 92 %, mientras que el puntaje F1 promedio ponderado también fue del 92 %, lo que indica un rendimiento comparable entre las tres clases, mientras que el puntaje F1 promedio ponderado fue asimismo del 92 %. El rendimiento de clasificación fue más alto para la clase de enfermedad de Alzheimer (AD), mientras que la clase de demencia frontotemporal (FTD) mostró un rendimiento comparativamente menor, como se presenta en Tabla 1.
Se utilizó el análisis de características operativas del receptor (ROC) para evaluar la separación de clases a través de diferentes umbrales de clasificación. Como se muestra en Figura 2, el área bajo la curva ROC (AUC) superó 0,98 para las tres clases, lo que indica una alta separabilidad entre los grupos de AD, FTD y controles sanos (HC).
Se realizó un análisis SHAP utilizando TreeExplainer para evaluar las contribuciones de las características al modelo de clasificación de bosque aleatorio. El gráfico de barras resumen de la Figura 3 mostró la contribución relativa de la densidad espectral de potencia (PSD), la raíz media cuadrática (RMS), la entropía y las características demográficas. Las características con valores SHAP absolutos más altos contribuyeron más fuertemente a las predicciones del modelo, mientras que las características relacionadas con la entropía mostraron contribuciones comparativamente bajas.
Se realizó un análisis de estabilidad de características repitiendo el entrenamiento de Bosque Aleatorio a través de las semillas aleatorias especificadas. Se registraron la precisión en la prueba y las puntuaciones de importancia de las características en cada ejecución, y se calcularon la media y la desviación estándar de la importancia de las características. El modelo alcanzó una precisión media de clasificación del 95 % en este análisis, con una desviación estándar de 0,17 %. Estas ejecuciones repetidas se utilizaron principalmente para evaluar la consistencia de los rankings de características y se consideraron por separado de la evaluación principal de retención a nivel de sujeto. La edad ocupó un lugar destacado en el análisis de estabilidad de características, como se muestra en Tabla 2. Las características theta_psd y theta_rms también obtuvieron un alto ranking, mientras que alpha_psd, alpha_rms, beta_psd y beta_rms mostraron una importancia moderada.
Se calculó la d de Cohen para evaluar la magnitud de las diferencias entre grupos, como se presenta en la Tabla 3. La atenuación en la banda alfa (alpha_rms, d = 0.97; alpha_psd, d = 0.87) y el aumento en la actividad theta (theta_rms, d = 0.72) mostraron las diferencias más grandes reportadas entre participantes con AD y controles sanos. Estos hallazgos fueron consistentes con la desaceleración cortical reportada en estudios de EEG sobre demencia34. Las características basadas en entropía mostraron tamaños del efecto comparativamente menores. Las comparaciones entre AD y FTD produjeron predominantemente tamaños del efecto pequeños a moderados.
Las características de la banda alfa mostraron tamaños del efecto grandes para la DA-versus-HC y FTD-versus-Comparaciones HC. Para AD versus HC, los tamaños del efecto reportados fueron −0,87 para alpha_psd y −0,97 para alpha_rms. Para FTD versus HC, la atenuación en la banda alfa fue de −0.73. La característica theta_psd mostró un tamaño del efecto de 0,61 para AD versus HC, mientras que theta_rms mostró un tamaño del efecto de 0,72. Se observaron diferencias menores para AD versus Trastorno frontotemporal
Las características en la banda beta mostraron predominantemente tamaños del efecto grupal pequeños a moderados. Los tamaños del efecto para beta_psd fueron de −0,35 para EA versus SC y de −0,41 para EA versus DFT, mientras que beta_rms mostró principalmente efectos pequeños. Las características en la banda gamma mostraron efectos moderados en algunas comparaciones. El tamaño del efecto para gamma_psd fue de 0,47 para DFT versus SC y de 0,20 para EA versus SC, mientras que gamma_rms mostró un tamaño del efecto de 0,50 para DFT versus SC.
Delta PSD y RMS mostraron pequeños tamaños del efecto positivos para el TEA versus HC (0,29 y 0,34, respectivamente) y FTD versus HC (0,25 y 0,25, respectivamente). Tamaños del efecto para AD versus FTD estuvieron cercanos a cero. La entropía delta mostró tamaños del efecto pequeños en las tres comparaciones (0,08, 0,20 y −0,11).
Los análisis de estabilidad de características, SHAP y tamaño del efecto indicaron contribuciones comparativamente bajas por parte de las características de entropía. En consecuencia, se realizó un análisis de ablación excluyendo las características de entropía y conservando RMS, PSD y la edad. Tras la ablación de características, el modelo de bosque aleatorio alcanzó una precisión del 96 % en el entrenamiento y del 94 % en las pruebas. Este resultado se interpretó como una comparación exploratoria dentro del marco evaluado de selección de características. La precisión, recuperación, puntuación F1 y soporte para las clases DA, CH y TFD se presentan en Tabla 4.
El rendimiento antes y después de la ablación de la característica de entropía se compara en la Tabla 5. La precisión en las pruebas aumentó del 92 % al 94 % tras eliminar la entropía. Los cambios por clase se presentan en la Tabla 6. Para FTD, la precisión aumentó en un 4 %, y el puntaje F1 aumentó en un 2 %. La recuperación (recall) para el grupo HC aumentó en un 4 %, mientras que la precisión disminuyó en un 2 %. Las medidas de rendimiento promedio macro y promedio ponderado aumentaron aproximadamente entre un 1 % y un 2 % tras la ablación de características.
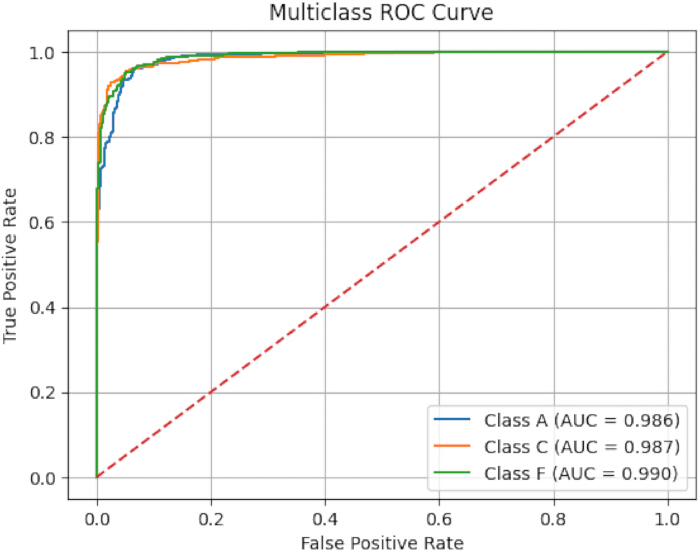
Figura 2: Curvas de característica operativa del receptor para la enfermedad de Alzheimer, demencia frontotemporal y controles sanos. Curvas multiclase de características operativas del receptor (ROC) generadas utilizando el uno-versusestrategia de reposo para la enfermedad de Alzheimer (clase A), la demencia frontotemporal (clase F) y los controles sanos (clase C). Se calculó el área bajo la curva (AUC) para cada clase. Haga clic aquí para ver una versión más grande de esta figura.
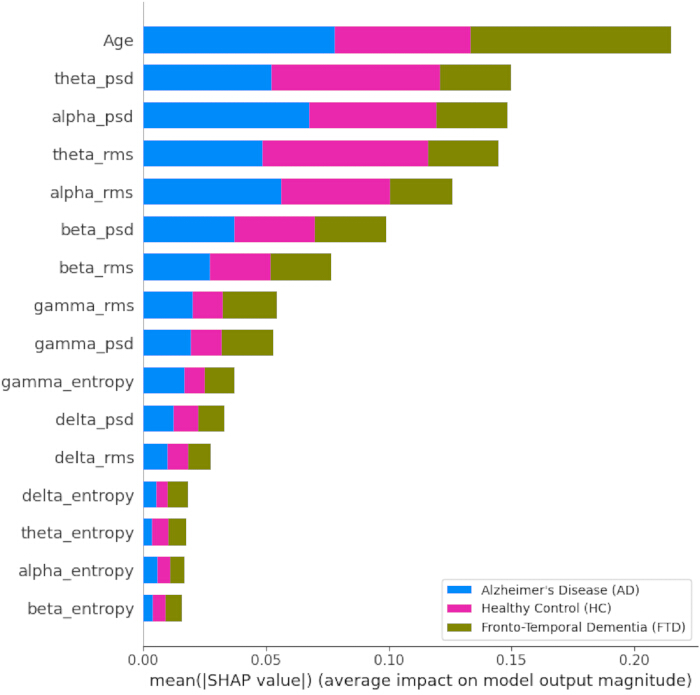
Figura 3: Análisis resumen SHAP del modelo de Bosque Aleatorio entrenado. Gráfico de barras resumen que muestra la contribución relativa de las características derivadas del EEG y las características demográficas al modelo de clasificación de Bosque Aleatorio. Se utilizaron los valores absolutos medios de SHAP para clasificar las contribuciones de las características de raíz cuadrática media (RMS), densidad espectral de potencia (PSD), entropía y edad. Haga clic aquí para ver una versión más grande de esta figura.
| Precisión | Recuperación | Puntuación F1 | Soporte | |
| Alzheimer | 0.92 | 0.95 | 0.94 | 579 |
| Control | 0.93 | 0.92 | 0.93 | 480 |
| Demencia Frontotemporal | 0.93 | 0.87 | 0.9 | 314 |
| Promedio macro | 0.93 | 0.92 | 0.92 | 1373 |
| Promedio ponderado | 0.93 | 0.92 | 0.92 | 1373 |
Tabla 1: Informe de clasificación en los datos de prueba. Precisión, recuperación, puntuación F1 y soporte para las clases de enfermedad de Alzheimer, control sano y demencia frontotemporal en el conjunto de datos de prueba, junto con las medidas de rendimiento promedio macro y promedio ponderado.
| Característica | Media | Desviación estándar |
| Edad | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
Tabla 2: Clasificación de estabilidad de características del modelo de Bosque Aleatorio. Valores medios de importancia de las características y la variabilidad correspondiente obtenidos a partir de entrenamientos repetidos del Bosque Aleatorio utilizando semillas aleatorias del 0 al 9. Las características se clasificaron según su estabilidad a lo largo de las ejecuciones.
| Característica | DA frente a SC | DA frente a DFT | DFT frente a SC |
| PSD delta | 0.293 | -0.069 | 0.253 |
| PSD theta | 0.612 | 0.23 | 0.355 |
| PSD alfa | -0.869 | -0.219 | -0.64 |
| PSD beta | -0.352 | -0.408 | 0.201 |
| PSD gamma | 0.201 | -0.326 | 0.468 |
| Entropía delta | 0.081 | 0.199 | -0.111 |
| Entropía theta | 0.208 | 0.033 | 0.163 |
| Entropía alfa | -0.061 | 0.071 | -0.137 |
| Entropía beta | -0.37 | -0.042 | -0.332 |
| Entropía gamma | -0.338 | 0.047 | -0.391 |
| RMS delta | 0.342 | 0.041 | 0.251 |
| RMS theta | 0.718 | 0.354 | 0.318 |
| RMS alfa | -0.977 | -0.205 | -0.73 |
| RMS beta | -0.494 | -0.365 | 0.015 |
| RMS gamma | 0.187 | -0.33 | 0.5 |
Tabla 3: Comparación del tamaño del efecto mediante d de Cohen entre grupos diagnósticos. Valores de d de Cohen para biomarcadores de EEG en las comparaciones entre enfermedad de Alzheimer versus control sano, enfermedad de Alzheimer versus demencia frontotemporal, y demencia frontotemporal versus control sano.
| Precisión | Recuperación | Puntuación F1 | Soporte | |
| Alzheimer | 0.94 | 0.95 | 0.94 | 579 |
| Control | 0.91 | 0.96 | 0.94 | 480 |
| Demencia Frontotemporal | 0.97 | 0.89 | 0.92 | 314 |
| Promedio macro | 0.94 | 0.93 | 0.93 | 1373 |
| Promedio ponderado | 0.94 | 0.94 | 0.94 | 1373 |
Tabla 4: Informe de clasificación tras la ablación de características. Precisión, recuperación, puntuación F1 y soporte para las clases de enfermedad de Alzheimer, control sano y demencia frontotemporal tras la eliminación de las características de entropía y el reentrenamiento del modelo de bosque aleatorio.
| Métrica | Antes de la ablación | Después de la ablación | Cambio |
| Precisión de entrenamiento | 0.96 | 0.96 | 0% de cambio |
| Precisión de prueba | 0.92 | 0.94 | +2% de mejora |
| Precisión macro | 0.93 | 0.94 | +1% de mejora |
| Recall macro | 0.92 | 0.93 | +1% de mejora |
| Puntuación F1 macro | 0.92 | 0.93 | +1% de mejora |
| Precisión ponderada | 0.93 | 0.94 | +1% de mejora |
| Recall ponderado | 0.92 | 0.94 | +2% de mejora |
| Puntuación F1 ponderada | 0.92 | 0.94 | +2% de mejora |
Tabla 5: Comparación del rendimiento antes y después de la ablación de características. Comparación de las métricas de rendimiento del modelo para el conjunto completo de características multidominio y el conjunto reducido de características obtenido tras la eliminación de las características de entropía.
DISPONIBILIDAD DE LOS DATOS:
El conjunto de datos CSV procesado utilizado para el desarrollo y análisis del modelo se proporciona como Archivo Suplementario 1. El código de preprocesamiento está disponible en un cuaderno de Python en https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, y el código para la construcción del modelo y el análisis está disponible en https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. El conjunto de datos CSV procesado también puede regenerarse utilizando el código de preprocesamiento proporcionado.
| Clase | Métrica | Antes | Después | Cambio |
| Alzheimer | Precisión | 0.92 | 0.94 | 0.02 |
| Recuperación | 0.95 | 0.95 | Sin cambio | |
| Puntaje F1 | 0.94 | 0.94 | Sin cambio | |
| Control | Precisión | 0.93 | 0.91 | −2% |
| Recuperación | 0.92 | 0.96 | 0.04 | |
| Puntaje F1 | 0.93 | 0.94 | 0.01 | |
| FTD | Precisión | 0.93 | 0.97 | 0.04 |
| Recuperación | 0.87 | 0.89 | 0.02 | |
| Puntaje F1 | 0.9 | 0.92 | 0.02 |
Tabla 6: Cambios en el rendimiento por clase antes y después de la ablación de características. Cambios en la precisión, recuperación y puntuación F1 para las clases de enfermedad de Alzheimer, control sano y demencia frontotemporal tras la eliminación de las características de entropía.
Archivo complementario 1: Conjunto de datos de características de EEG a nivel de época procesadas utilizadas para el desarrollo y análisis del modelo. Haga clic aquí para descargar este archivo.
Discusión
Se utilizó un clasificador de bosque aleatorio para clasificar muestras de electroencefalografía (EEG) en los grupos de enfermedad de Alzheimer (AD), demencia frontotemporal (FTD) y controles sanos (HC), empleando características de múltiples dominios, incluyendo densidad espectral de potencia (PSD), raíz media cuadrática (RMS) y medidas de entropía. Se incluyó la edad como una variable demográfica complementaria. Dado que las distribuciones de edad podrían diferir entre los grupos diagnósticos, no se pudo excluir completamente un sesgo demográfico, por lo que el rendimiento informado reflejó la contribución combinada de la información demográfica y electrofisiológica. El análisis examinó la capacidad de las características multidominio de EEG para discriminar entre los grupos AD, FTD y HC, y evaluó la contribución de las características en las bandas delta, theta, alpha, beta y gamma a la clasificación35. Los análisis de estabilidad de características y tamaño del efecto indicaron que las características basadas en la potencia, incluyendo PSD y RMS, contribuyeron más fuertemente que las características basadas en entropía. Los biomarcadores de EEG extraídos también reflejaron patrones asociados con ralentización de los ritmos y disminución de la actividad alfa.
Estudios previos han evaluado características del EEG basadas en entropía, en el DSP y en RMS utilizando diferentes enfoques de aprendizaje automático2,14,27,28,36,37. La entropía se había utilizado para caracterizar la complejidad e irregularidad del EEG, mientras que el DSP se había empleado para cuantificar las características espectrales2,14,27,28,36. El RMS también se había evaluado como una característica por banda de frecuencia37. Utilizando el mismo conjunto de datos subyacente, trabajos anteriores aplicaron una clasificación binaria basada en el DSP con validación leave-one-subject-out33. En cambio, el presente análisis combinó RMS, entropía y DSP a través de las bandas alfa, beta, gamma, theta y delta dentro de un marco de clasificación multiclase. Se evaluó un transformador ligero para EEG en el mismo conjunto de datos utilizando una estrategia de clasificación binaria leave-one-subject-out. Un transformador ligero para EEG evaluado en el mismo conjunto de datos utilizando una estrategia de clasificación binaria leave-one-subject-out reportó una exactitud del 83,28 %. La comparación numérica directa con los resultados presentes debe interpretarse con cautela debido a que la tarea de clasificación y los procedimientos de validación eran diferentes38.
Las características en la banda alfa mostraron los tamaños del efecto más grandes para diferenciar la EA de la CH y la DFA de la CH, y la actividad theta aumentada también contribuyó a la diferenciación de la EA respecto a la CH. Las características en la banda beta mostraron efectos menores entre los grupos, mientras que las características basadas en entropía mostraron una utilidad discriminativa comparativamente limitada. Las características en la banda gamma mostraron efectos moderados en algunas comparaciones, incluyendo DFA versus CH. Estudios previos han reportado una menor potencia alfa y una actividad theta alterada en la EA y en comparaciones diagnósticas relacionadas23,25,39. También se ha descrito que la entropía podría ser un biomarcador potencialmente informativo en enfermedades neurodegenerativas36, lo que indica que su contribución puede variar según el conjunto de datos, la definición de las características y el enfoque analítico.
Las máquinas de vectores de soporte se han utilizado frecuentemente en estudios previos de clasificación de EEG3,21,24,37. El clasificador Bosque Aleatorio utilizado en el presente análisis proporcionó estimaciones de importancia de las características y fue aplicable al conjunto estructurado de características empleado en este estudio40,41. Se obtuvieron precisiones de entrenamiento y prueba del 96 % y del 94 %, respectivamente, tras la ablación de las características de entropía. La eliminación de las características de entropía se asoció con una mejora en el rendimiento del modelo, lo que respalda la menor contribución relativa observada para estas características en los análisis de estabilidad, SHAP y tamaño del efecto. También se han aplicado enfoques de aprendizaje profundo y basados en transformadores a la clasificación de EEG, aunque dichos enfoques generalmente requieren conjuntos de datos más grandes y están diseñados para representaciones de mayor dimensionalidad o secuenciales27,39,42,43,44,45.
Las señales de EEG son ruidosas y no estacionarias, y los modelos basados en árboles de conjunto pueden ofrecer robustez al analizar representaciones estructuradas de características. En el presente estudio, se evaluaron RMS, PSD, entropía y edad como entradas complementarias para el modelo de Bosque Aleatorio. RMS representó la amplitud de la señal dentro de las bandas de frecuencia, PSD representó la potencia espectral y la entropía representó la complejidad de la señal. Los resultados indicaron que PSD y RMS contribuyeron más fuertemente que la entropía a la clasificación dentro del marco evaluado. La edad también contribuyó al modelo, aunque su inclusión introdujo la posibilidad de confusión demográfica. Futuras investigaciones podrían evaluar variables demográficas adicionales y enfoques alternativos de aprendizaje automático o aprendizaje profundo en conjuntos de datos más grandes para evaluar mejor la generalización y el rendimiento de clasificación.
Divulgaciones
No se declararon intereses financieros competitivos conocidos, relaciones personales, relaciones financieras u otras actividades que podrían haber influido en el trabajo reportado en este estudio.
Agradecimientos
Se reconoce el conjunto de datos de EEG de acceso público utilizado en este estudio y las contribuciones de los investigadores que hicieron accesible el conjunto de datos con fines de investigación. No se recibió financiamiento específico de agencias públicas, comerciales o sin fines de lucro.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | Entorno computacional basado en la nube utilizado para ejecutar los cuadernos de análisis | |
| MNE-Python | MNE-Python project | 1.12.1 | Utilizado para el preprocesamiento del EEG, referencia, filtrado y segmentación en épocas |
| NumPy | NumPy project | (2.0.2) | Utilizado para cálculos numéricos y operaciones basadas en matrices |
| Conjunto de datos de EEG de OpenNeuro | OpenNeuro | ds004504, (1.0.9) | Conjunto de datos de EEG en estado de reposo de acceso público que contiene grabaciones de AD, FTD y HC |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Entorno de programación utilizado para el procesamiento de datos y el desarrollo de modelos |
| scikit-learn | scikit-learn project | 1.6.1 | Utilizado para preprocesamiento, división agrupada de datos, clasificación con bosque aleatorio y evaluación del rendimiento |
| SciPy | SciPy project | (1.16.3) | Utilizado para procesamiento de señales y cálculos estadísticos |
| SHAP | SHAP project | 0.52.0 | Utilizado para análisis de inteligencia artificial interpretable con TreeExplainer |
Referencias
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379