Este estudio identifica ocho genes pronósticos relacionados con la catástrofe mitótica (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) en adenocarcinoma pulmonar, establece un modelo de riesgo con un rendimiento predictivo aceptable y revela características distintas del microambiente inmunitario entre los grupos de riesgo.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Identificación de genes pronósticos relacionados con la catástrofe mitótica en el adenocarcinoma de pulmón mediante análisis del transcriptoma
En este artículo
Resumen
Resumen
El adenocarcinoma pulmonar (LUAD), el subtipo de cáncer de pulmón más común, presenta un mal pronóstico. Aunque puede inducirse una catástrofe mitótica en LUAD, lo que conduce a la muerte celular, la importancia pronóstica y biológica de los genes relacionados con la catástrofe mitótica (MCRGs) en esta enfermedad sigue siendo poco clara. Los genes diferencialmente expresados (DEGs) asociados con LUAD se seleccionaron a partir de la cohorte TCGA-LUAD, y los genes superpuestos se definieron mediante la intersección de DEGs con MCRGs. Mediante aprendizaje automático se seleccionaron genes pronóstico candidatos, tras lo cual se construyó un modelo pronóstico multigénico. Se estableció una firma pronóstica de ocho genes candidatos compuesta por PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 y S100B, que mostró una fiabilidad predictiva aceptable en el conjunto de entrenamiento, con áreas bajo la curva (AUC) a 2, 3 y 5 años de 0,723, 0,715 y 0,625, respectivamente (índice C corregido por bootstrap: 0,699, IC del 95 %: 0,657-0,742), así como una validación consistente en GSE31210 (AUC: 0,812, 0,766 y 0,814). Los pacientes de bajo riesgo mostraron resultados de supervivencia significativamente mejores, mayor infiltración inmunitaria, puntuaciones inmunitarias y estromales más altas, inmunopuntajes incrementados y ciclos de inmunidad antitumoral más activos. Se observaron diferencias significativas en la carga mutacional tumoral y en la sensibilidad a fármacos entre los grupos de alto y bajo riesgo. La reacción en cadena de la polimerasa cuantitativa (qPCR) validó los perfiles transcriptómicos de seis genes candidatos relacionados con el desenlace en muestras clínicas. Un nomograma que incorpora la puntuación de riesgo y la etapa clínica mostró un buen desempeño predictivo. Estos hallazgos demuestran que los ocho genes candidatos relacionados con MCRGs tienen un fuerte potencial para predecir los desenlaces en pacientes y estratificar el riesgo en LUAD, con características distintas del microambiente inmunitario entre los grupos de riesgo.
Introducción
El cáncer de pulmón sigue siendo uno de los cánceres más prevalentes y mortales en todo el mundo1,2. El carcinoma de pulmón de células no pequeñas (NSCLC) está dominado por el adenocarcinoma de pulmón (LUAD), que representa aproximadamente el 40 % de todos los casos de cáncer de pulmón3,4. Aunque se han logrado avances significativos en procedimientos quirúrgicos, terapias dirigidas molecularmente, inhibidores de puntos de control inmunitarios y regímenes de combinación, el pronóstico clínico para los pacientes con LUAD sigue siendo desfavorable5,6. Aunque los enfoques diagnósticos basados en patología y en imágenes se utilizan ampliamente en LUAD, tienen limitaciones inherentes para captar la heterogeneidad tumoral y las características moleculares. En contraste, el análisis molecular de tejido tumoral basado en biomarcadores puede proporcionar información más completa sobre la biología tumoral y podría contribuir a la evaluación pronóstica y a estrategias de tratamiento individualizadas7. Por lo tanto, la identificación de biomarcadores moleculares confiables sigue siendo importante para mejorar la predicción del pronóstico y la comprensión biológica del LUAD.
La mitosis, un mecanismo esencial de la replicación celular, garantiza la repartición fiel de los cromosomas replicados entre dos células hijas8. La desregulación de los procesos mitóticos puede promover la proliferación celular descontrolada, la inestabilidad genómica y la progresión tumoral. La catástrofe mitótica (MC) define una vía de muerte celular desencadenada por el fracaso en la finalización de la mitosis, generalmente como resultado de daños en el huso acromático o defectos en los puntos de control del ciclo celular9. A nivel morfológico, la MC se presenta con anomalías celulares que incluyen multinucleación, micronúcleos, configuraciones de huso multipolares y poliploidización10. Como mecanismo para eliminar células con defectos mitóticos graves, la MC puede contribuir a la supresión de la progresión tumoral9. La eliminación de p53 en células de adenocarcinoma pulmonar de células grandes (LUAD) A549 puede inducir catástrofe mitótica y, finalmente, muerte celular11, lo que sugiere un vínculo potencial entre la MC y los procesos celulares relacionados con el LUAD. Sin embargo, la importancia pronóstica y las funciones biológicas de los genes relacionados con la MC (MCRGs) en el LUAD permanecen poco esclarecidas.
En esta investigación, se examinó sistemáticamente la importancia pronóstica y la relevancia biológica putativa de los MCRGs en el LUAD mediante el uso de datos provenientes de TCGA y GEO. Primero, se identificaron los MCRGs candidatos mediante análisis de expresión diferencial y análisis de intersección. Diversos enfoques de aprendizaje automático seleccionaron los genes candidatos y establecieron una firma pronóstica de riesgo, que posteriormente fue validada externamente. Además, se desarrolló un nomograma que incorpora el puntaje de riesgo junto con características clínicas para mejorar la predicción de supervivencia. Asimismo, la caracterización del microambiente inmunitario, la evaluación de mutaciones somáticas y la evaluación de quimiosensibilidad sirvieron para examinar las implicaciones biológicas y la utilidad clínica de los genes identificados. En conjunto, estos hallazgos demuestran el potencial pronóstico de los MCRGs en el LUAD y podrían orientar el desarrollo de biomarcadores y la gestión individualizada.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
El estudio se realizó de acuerdo con la Declaración de Helsinki, y el protocolo fue aprobado por el Comité de Ética del Hospital Torácico de Anhui (K2025-007) el 22 de abril de 2025. Se obtuvo el consentimiento informado de todos los sujetos participantes en el estudio.
Extracción y normalización de datos
Los perfiles transcriptómicos y los conjuntos de datos clínicos correspondientes para LUAD se obtuvieron de las cohortes TCGA y GEO. El conjunto de datos TCGA-LUAD se designó como conjunto de entrenamiento, mientras que GSE72094, GSE31210 y GSE26939 sirvieron como cohortes para validación externa (Tabla 1). Además, se recopilaron 900 MCRG de un estudio previo12 (Tabla Suplementaria 1). Los datos del transcriptoma se anotaron utilizando GENCODE v36 o los archivos de anotación de la plataforma GPL correspondientes. Los IDs de las sondas se convirtieron en símbolos génicos, los genes duplicados se fusionaron utilizando la función avereps y solo se conservaron los genes que codifican proteínas para generar matrices de expresión a nivel génico. Para el conjunto de entrenamiento TCGA-LUAD, se eliminaron los genes con Fragments per kilobase of exon model per million mapped fragments (FPKM) < 1 en más del 50 % de las muestras, y los valores de expresión restantes se transformaron mediante logaritmo base 2 (log2[FPKM+1]). Para las cohortes de validación GEO, se descargaron los datos de expresión en bruto, los IDs de las sondas se asignaron a símbolos génicos utilizando los archivos de anotación de la plataforma correspondiente, y se redujeron múltiples sondas que correspondían al mismo gen promediando sus valores de expresión. Estos conjuntos de datos se transformaron mediante logaritmo base 2 cuando fue necesario. No se aplicó corrección de efectos por lotes entre plataformas distintas de TCGA y GEO, ya que adoptamos una estrategia de estandarización por cohorte para garantizar una comparabilidad relativa. Específicamente, tanto para las cohortes de entrenamiento como de validación, los valores de expresión génica se centraron y escalaron (transformación de puntuación z) utilizando la media y la desviación estándar de cada conjunto de datos individualmente. Luego, se utilizaron los mismos coeficientes de regresión de Cox derivados del conjunto de entrenamiento para calcular las puntuaciones de riesgo en todas las cohortes. Para mantener la aplicabilidad clínica y evitar el sobreajuste a cualquier conjunto de validación, se empleó la puntuación de riesgo mediana de la cohorte de entrenamiento como un punto de corte fijo para estratificar a los pacientes en grupos de alto y bajo riesgo en todas las cohortes externas de validación. Se extrajo información clínica, incluyendo edad, sexo, estadio patológico, estadio Tumor-Nódulo-Metástasis (TNM), tipo histológico, tiempo de supervivencia, estado de supervivencia y tipo de tejido, cuando estuvo disponible. El punto final fue la supervivencia global (OS). Se excluyeron las muestras con información incompleta de supervivencia o con un tiempo de supervivencia < 30 días. El tiempo de supervivencia se convirtió en años, y el estado de supervivencia se codificó como 0 para vivo y 1 para muerto.
Identificación y análisis funcionales de genes candidatos
El paquete Limma identificó genes diferencialmente expresados (DEGs) entre muestras tumorales y normales de adenocarcinoma pulmonar (LUAD) en el conjunto de entrenamiento13. Los DEGs se definieron mediante los siguientes criterios: |log2FC| > 0,5 y valor p ajustado < 0,05. Posteriormente, se utilizó el algoritmo de agrupamiento difuso mfuzz del paquete de R ClusterGVis para dividir los DEGs en grupos de expresión distintos. Se realizó un análisis de Ontología Genética–Proceso Biológico (GO-BP) sobre los cinco genes representativos principales de cada grupo, basándose en sus puntuaciones de pertenencia. Se obtuvo un conjunto de genes comunes mediante la intersección de los DEGs con los MCRGs. Un análisis de enriquecimiento funcional mediante Ontología Genética/Enciclopedia de Kyoto de Genes y Genomas (GO/KEGG) evaluó la relevancia biológica de los genes que se solapaban. Las redes de interacción proteína-proteína (PPI) se obtuvieron a partir de la base de datos STRING14. Solo se conservaron las interacciones con puntuaciones de confianza > 0,7 para mejorar la fiabilidad de la red.
Selección de genes pronósticos
Se utilizó el paquete Survival para realizar un análisis de regresión de Cox univariado con el fin de identificar genes probables asociados con la supervivencia global en LUAD15. Los genes con un valor de p < 0,05 se consideraron indicadores pronósticos potenciales. La cohorte de entrenamiento TCGA-LUAD incluyó a 500 pacientes con datos completos de supervivencia, entre los cuales 216 (43,2 %) presentaron eventos de muerte durante el seguimiento. La proporción de genes candidatos (n = 108) respecto a eventos (n = 216) fue aproximadamente de 1:2, lo cual es aceptable para el análisis de regresión de Cox. Posteriormente, el análisis de regresión mediante el operador de contracción y selección de la mínima absoluta (LASSO) y el modelo de potenciación extrema del gradiente (XGBoost) seleccionaron aún más las características. Se construyeron modelos de riesgos proporcionales de Cox con family = "cox" mediante la función cv.glmnet del paquete glmnet. El parámetro de regularización óptimo se identificó utilizando validación cruzada de 10 pliegues, donde el valor λ.min representó el error mínimo de validación cruzada, seleccionándose como el valor óptimo de λ. Se extrajeron los genes con coeficientes de regresión distintos de cero como características candidatas. Para el modelo XGBoost, el tiempo de supervivencia y el estado de supervivencia se combinaron como la variable resultado, asignándose valores positivos a los eventos de muerte y valores negativos a los casos censurados. Los parámetros se establecieron como objective = "survival: cox" y eval_metric = "cox-nloglik", con 100 iteraciones y una tasa de aprendizaje de 0,1. Tras el entrenamiento del modelo, se calcularon las puntuaciones de importancia de los genes utilizando los valores de ganancia de características. Se conservaron los 20 genes principales tras ordenar las puntuaciones de importancia en orden descendente, con el fin de reducir la dimensionalidad de las características y la complejidad del modelo. Los genes que coincidieron entre los resultados de LASSO y XGBoost se identificaron como genes pronósticos candidatos.
Construcción y evaluación de un modelo pronóstico
Se desarrolló un modelo pronóstico mediante análisis de regresión de Cox multivariante de los genes candidatos identificados. Los puntajes de riesgo se calcularon individualmente de la siguiente manera:
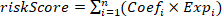 .
donde Coefi se refiere al coeficiente para el gen i, y Expi indica el valor correspondiente de expresión génica. Posteriormente, los individuos se dividieron en dos grupos: alto riesgo y bajo riesgo, utilizando la puntuación media de riesgo como punto de corte. Luego, se generaron curvas de característica operativa del receptor (ROC) dependientes del tiempo. Para evaluar el potencial de sobreajuste, se realizó una validación interna mediante bootstrap con 1.000 iteraciones de remuestreo para calcular el índice C corregido por sesgo y las AUC dependientes del tiempo con intervalos de confianza del 95 %. Se generaron curvas de calibración para evaluar la concordancia entre las probabilidades de supervivencia predichas y observadas a los 2, 3 y 5 años. Además, se realizó un análisis de curva de decisión (DCA) utilizando el paquete ggDCA en R para evaluar el beneficio clínico neto del modelo en los puntos temporales de 2, 3 y 5 años, cuantificando el valor potencial de la puntuación de riesgo en la toma de decisiones clínicas a través de diferentes probabilidades umbral. Las diferencias de supervivencia entre los grupos estratificados por riesgo y entre otras categorías clínicas se compararon mediante curvas de supervivencia de Kaplan-Meier (KM) con prueba logarítmica de rango. Además, para esclarecer las contribuciones individuales de cada gen al rendimiento del modelo, se empleó el análisis de explicaciones aditivas de Shapley (SHAP) para interpretación explicativa a posteriori.
Desarrollo y validación externa del nomograma
Las relaciones entre las puntuaciones de riesgo calculadas y diversas características clínicas (incluyendo género, edad y estadio TNM) se examinaron mediante pruebas de suma de rangos de Wilcoxon o pruebas de Kruskal-Wallis para evaluar la aplicabilidad clínica del modelo. Para determinar si la puntuación de riesgo actuaba como un factor pronóstico independiente, se incorporaron variables clínicas junto con la puntuación de riesgo en un modelo de regresión de Cox multivariante. Luego, se construyó un nomograma pronóstico que combinaba los factores de riesgo clínicos independientes (por ejemplo, estadio) y la puntuación genética de riesgo mediante el paquete regplot de R, con el fin de individualizar las predicciones de probabilidad de supervivencia. Se utilizaron curvas de calibración para evaluar la concordancia entre la probabilidad de supervivencia predicha por el nomograma y los resultados reales de supervivencia. Finalmente, la capacidad predictiva definitiva y la generalización del sistema de nomograma integrado se validaron rigurosamente mediante curvas ROC dependientes del tiempo y análisis exhaustivos de subgrupos clínicos KM en las cohortes.
Análisis de infiltración inmunitaria y subtipos inmunitarios
Se utilizó CIBERSORT, mediante la matriz de firmas génicas de leucocitos (LM22), para estimar las proporciones relativas de 22 tipos de células inmunitarias y evaluar la infiltración de células inmunitarias en pacientes con adenocarcinoma pulmonar (LUAD). Las relaciones entre los niveles de expresión génica pronóstica y la infiltración inmunológica se evaluaron mediante análisis de correlación de Spearman. Los puntajes inmunitario, estromal, de pureza tumoral y de ESTIMATE se obtuvieron mediante el algoritmo ESTIMATE, y el test de Wilcoxon evaluó las diferencias entre los grupos de riesgo. Los pacientes con LUAD se asignaron a seis subtipos inmunitarios utilizando el paquete ImmuneSubtypeClassifier16. Además, se utilizó la prueba de Wilcoxon para comparar las distribuciones de subtipos inmunitarios entre los grupos de riesgo.
Análisis de puntos de control inmunitarios, inmunofenopuntuación y ciclo de inmunidad contra el cáncer
En este estudio, la prueba de suma de rangos de Wilcoxon se utilizó para evaluar 21 genes de puntos de control inmunitario17 en grupos estratificados por riesgo, con el objetivo de caracterizar el paisaje inmunitario del LUAD. La correlación de Spearman vinculó los genes pronóstico candidatos con los genes de puntos de control inmunitario. Para evaluar las diferencias en la respuesta a los inhibidores de puntos de control inmunitario (ICIs) en pacientes con LUAD con distintos niveles de riesgo, se obtuvieron datos de puntuación inmunofenotípica (IPS) para tratamientos anti-PD-1 y anti-CTLA-4 del Atlas del Inmunoma del Cáncer (TCIA)18, y se utilizó la base de datos Tracking Tumor Immunophenotype (TIP)19 para evaluar la actividad del ciclo cáncer-inmunidad, comparando las puntuaciones correspondientes entre los grupos de riesgo.
Análisis de mutaciones somáticas y sensibilidad a fármacos
La herramienta de mutaciones de TCGA recuperó perfiles de mutaciones somáticas para los casos de TCGA-LUAD con el fin de investigar la variación en los patrones de mutación entre los grupos de riesgo. El paquete maftools procesó y visualizó los datos de mutación. Se determinaron los niveles de carga mutacional tumoral (TMB) para cada muestra y se compararon entre las dos categorías de riesgo. Se realizó un análisis de sensibilidad farmacogenómica utilizando el paquete pRRophetic según la base de datos Genómica de la Sensibilidad a Fármacos en el Cáncer (GDSC)20. Se predijeron valores de concentración inhibitoria media (IC50) para fármacos anticancerígenos en cada paciente con LUAD, y las diferencias entre los grupos de riesgo se cuantificaron mediante la prueba de suma de rangos de Wilcoxon.
Evaluación de los niveles de expresión de genes pronósticos
Cada conjunto de datos sirvió para evaluar los niveles de transcripción de genes candidatos seleccionados relacionados con el resultado. Para vincular la expresión génica con el pronóstico del paciente, los puntos de corte óptimos se determinaron mediante la función surv_cutpoint del paquete de R survminer. En función de estos umbrales, los casos de LUAD se clasificaron en subgrupos de alta y baja expresión para el posterior análisis de supervivencia.
Además, se obtuvieron cinco pares de tumores de ADLC y tejidos normales adyacentes del Hospital del Tórax de Anhui, y posteriormente se realizó la validación mediante qPCR. Cada participante proporcionó consentimiento informado por escrito. Se seleccionaron seis genes pronósticos candidatos (PDGFB, LDHA, ZEB2, FKBP4, DMD y S100B) para la validación mediante qPCR. El ARN se extrajo de muestras de tejido homogenizadas utilizando un reactivo de extracción de ARN, seguido de extracción con cloroformo y precipitación con isopropanol. El espectrofotómetro permitió medir la concentración y pureza del ARN. La validación por qPCR de los seis genes pronósticos candidatos se realizó mediante una mezcla maestra de PCR basada en SYBR Green en un sistema de PCR en tiempo real: desnaturalización inicial a 95 °C durante 30 s, seguida de 40 ciclos de 95 °C durante 20 s, 55 °C durante 20 s y 72 °C durante 20 s. La expresión relativa se calculó y normalizó respecto a la gliceraldehído-3-fosfato deshidrogenasa (GAPDH) utilizando la técnica de 2-ΔΔCt. Los detalles de todos los reactivos e instrumentos se proporcionan en la Tabla de Materiales.
Análisis estadístico
Los análisis estadísticos se realizaron utilizando software de cálculo y graficación estadística. La red de interacciones proteína-proteína se visualizó mediante software de análisis de redes. Tras la evaluación de la normalidad, se utilizó la prueba t de Student para variables continuas con distribución normal y la prueba U de Mann-Whitney para aquellas con distribución no normal.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Identificación del gen candidato y análisis funcional
Se detectó un total de 4,915 DEG, incluyendo 2,485 DEG hacia abajo y 2,430 DEG hacia arriba (Figura 1A). El análisis de agrupamiento por módulos funcionales clasificó estos DEG en seis módulos de expresión (C1-C6), entre los cuales los módulos C1, C2, C3 y C5 mostraron una expresión relativamente más alta en las muestras tumorales (Figura 1B). La anotación funciona...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
El CAPE es una de las principales formas de cáncer de pulmón y continúa representando una carga considerable para la salud pública21. La MC es un proceso relacionado con la muerte celular que puede contribuir a la eliminación de células con anomalías mitóticas severas y a la supresión de la progresión tumoral22. Por lo tanto, explorar el posible papel de los GMRC en el CAPE podría ayudar a identificar biomarcadores pronósticos y mejorar la comprensión de la biología del CAP...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores declaran que no existen conflictos de intereses.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| ClusterGVis | CRAN | versión 0.1.2 | Clustering y visualización de expresión génica |
| Cytoscape | Consortium Cytoscape | versión 3.9.1 | Visualización de redes de interacción de proteínas RRID:SCR_003032 |
| CFX384 Real-Time Quantitative Fluorescent PCR System | Bio-Rad | CFX384 Touch | reactivo de qPCR |
| DMD-primer | Tsingke | N/A | Forward: 5’-GCTCAACCATCGATTTGCAGCC-3’ Reverse: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| FKBP4-primer | Tsingke | N/A | Forward: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Reverse: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Herramienta en línea | Obtención del conjunto de datos externo de validación de LUAD RRID:SCR_005012 |
| GAPDH-primer | Tsingke | N/A | Forward: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Reverse: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | versión 4.1-8 | Selección de características en regresión LASSO RRID:SCR_015505 |
| LDHA-primer | Tsingke | N/A | Forward: 5’-GGATCTCCAACATGGCAGCCTT-3’ Reverse: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | versión 3.60.6 | Detección de genes diferencialmente expresados (DEG) RRID:SCR_010943 |
| maftools | Bioconductor | versión 2.20.0 | Visualización de datos de mutación somática RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Predicción de valores de IC50 de fármacos RRID:SCR_024417 |
| PDGFB-primer | Tsingke | N/A | Forward: 5’-GAGATGCTGAGTGACCACTCGA-3’ Reverse: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | reactivo de qPCR |
| Software R | Foundation R | versión 4.2.2 | Análisis bioinformático |
| regplot | CRAN | versión 1.1 | Creación de gráficos de líneas |
| survival | CRAN | versión 3.8-3 | Análisis de supervivencia y regresión de Cox RRID:SCR_021137 |
| STRING | Consortium STRING | Herramienta en línea | Análisis de redes de interacción de proteínas RRID:SCR_005223 |
| S100B-primer | Tsingke | N/A | Forward: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Reverse: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | versión 0.5.0 | Representación y optimización de curvas de supervivencia RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | reactivo de qPCR |
| TCGA | NCI | Herramienta en línea | Adquisición de datos transcriptómicos y clínicos de LUAD RRID:SCR_003193 |
| ZEB2-primer | Tsingke | N/A | Forward: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Reverse: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Referencias
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Reimpresiones y permisos
Este artículo ha sido publicado
Video próximamente