Este estudio presenta un marco ligero para reducir las alucinaciones en modelos grandes de lenguaje mediante verificación a nivel de afirmación y umbral estadístico adaptativo. Al corregir selectivamente afirmaciones no respaldadas utilizando inferencia del lenguaje natural, el enfoque mejora la precisión factual manteniendo una baja latencia de respuesta y una eficiencia práctica en la implementación.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Verificación de afirmaciones impulsada por NLI adaptativa con modelado de decisiones estadísticas para la reducción de alucinaciones de baja latencia en modelos de lenguaje extensos
En este artículo
Resumen
Resumen
Los modelos lingüísticos grandes (LLM) presentan una tendencia crítica a generar salidas lingüísticamente fluidas pero factualmente incorrectas, un fenómeno denominado alucinación, que supone riesgos graves en aplicaciones que requieren alta precisión. Las estrategias actuales de mitigación, incluyendo la generación aumentada con recuperación y el muestreo de autoconsistencia, o bien introducen una latencia sustancial durante la inferencia o dependen de infraestructuras externas de conocimiento, lo que limita su aplicabilidad en implementaciones en tiempo real. Este artículo propone un marco ligero de verificación de afirmaciones en dos pasos que descompone las respuestas del LLM en afirmaciones factuales atómicas y verifica independientemente cada afirmación extraída frente a una referencia generada por separado mediante un estímulo aislado de recuperación factual. Aunque el generador y el verificador comparten el mismo modelo lingüístico subyacente, separar la generación de respuestas de la recuperación factual reduce el condicionamiento directo de la respuesta y mitiga el sesgo de confirmación durante la verificación, utilizando inferencia lingüística natural (NLI), y aplica un umbral estadístico adaptativo —definido como τ = µ + kσ sobre la distribución de puntuaciones de confianza NLI— para corregir selectivamente solo las afirmaciones contradictorias. A diferencia de métodos previos basados en NLI que dependen de límites de decisión fijos, el marco propuesto adapta dinámicamente su umbral de verificación a la distribución de confianza de cada respuesta, mostrando un rendimiento consistente en las pruebas evaluadas sin necesidad de reentrenar el modelo. Evaluado en TruthfulQA y FEVER, el marco reduce la tasa de alucinación del 28 % al 9 % en TruthfulQA —una reducción relativa del 67,9 %—, con un aumento adicional de solo 160 ms de latencia respecto al LLM de referencia, superando además a SelfCheckGPT y FActScore en precisión de detección de alucinaciones. Estos resultados indican que el marco puede ofrecer un equilibrio favorable entre fiabilidad factual y latencia de respuesta en las pruebas evaluadas, aunque se requiere una validación adicional en distintos dominios y entornos de implementación.
Introducción
Los modelos de lenguaje grandes (LLMs) han surgido como componentes fundamentales de los sistemas modernos de inteligencia artificial, demostrando una capacidad notable en una amplia gama de tareas de lenguaje natural, incluyendo la generación de texto, la respuesta a preguntas, la sumarización y el razonamiento complejo.1Su capacidad para producir respuestas fluidas y contextualmente coherentes ha acelerado su adopción en áreas de alto impacto, como el apoyo a la toma de decisiones clínicas, el análisis jurídico, la ingeniería de software y la tecnología educativa.2Sin embargo, una limitación crítica y persistente socava su fiabilidad en estos contextos: la alucinación, fenómeno en el cual los modelos generan respuestas lingüísticamente fluidas pero factualmente incorrectas, infundadas o completamente inventadas³. Estudios empíricos reportan tasas de alucinación que van desde el 15 % hasta más del 40 %, dependiendo de la tarea y del modelo, y hasta sistemas de última generación como GPT-4 presentan inconsistencias factuales medibles cuando se evalúan en dominios específicos.2,3. Esta limitación plantea riesgos graves en aplicaciones que requieren precisión, donde las salidas erróneas pueden provocar desinformación, diagnósticos incorrectos o toma de decisiones defectuosa4. Las alucinaciones surgen fundamentalmente de la naturaleza probabilística del modelado del lenguaje: los modelos lingüísticos grandes (LLM) generan tokens prediciendo continuaciones estadísticamente probables de secuencias de entrada, en lugar de recuperar o razonar sobre conocimientos factuales verificados5Como consecuencia, las salidas generadas pueden incluir afirmaciones verosímiles pero inexactas, introducir aserciones no respaldadas o confundir conceptos semánticamente relacionados pero factualmente distintos.6.
Las estrategias de mitigación existentes abordan este problema mediante varios paradigmas, cada uno con limitaciones notables. La generación aumentada por recuperación (Retrieval-Augmented Generation, RAG) reduce la alucinación al fundamentar las respuestas en documentos recuperados externamente, pero introduce una sobrecarga significativa de latencia, requiere acceso a bases de conocimiento mantenidas y sigue siendo vulnerable a fallos de recuperación en dominios especializados o con pocos recursos7,8,9.
Aunque el generador de respuestas y el generador de referencias se instancian utilizando el mismo modelo subyacente GPT-3.5 Turbo, operan bajo objetivos de activación y contextos de ejecución diferentes. El generador de respuestas produce una respuesta sin restricciones a la consulta del usuario, mientras que el generador de referencias realiza una tarea aislada de recuperación de hechos sin acceso a la respuesta generada previamente. Esta separación reduce los efectos directos de condicionamiento de la respuesta y limita el sesgo de confirmación durante la verificación de afirmaciones. Por lo tanto, el marco trata a la referencia generada como independiente desde un punto de vista procedimental, más que estadísticamente independiente.
Investigaciones recientes también han explorado estrategias de decodificación ligeras para reducir las alucinaciones en la generación de texto sin depender de recuperación externa ni verificación repetida. Un enfoque representativo es la Decodificación mediante Contraste de Capas (DoLA), que mejora la veracidad contrastando representaciones de capas intermedias y finales del transformador durante la decodificación. A diferencia de los marcos de verificación posterior a la generación, estos métodos intervienen directamente durante la generación de tokens y, por lo tanto, optimizan una etapa diferente del proceso de generación del lenguaje. Estas estrategias complementarias demuestran que la mitigación de alucinaciones puede lograrse ya sea durante la decodificación o mediante verificación posterior a la generación, ofreciendo cada enfoque compensaciones distintas en términos de sobrecarga computacional, complejidad de implementación y fiabilidad factual.
Los métodos de autoconsistencia mejoran la fiabilidad factual mediante el muestreo de múltiples respuestas y la selección de la salida más frecuente o coherente, pero su costo computacional aumenta linealmente con el número de muestras, lo que los hace inadecuados para implementaciones sensibles a la latencia8. Los enfoques de refinamiento iterativo, que revisan repetidamente las salidas mediante bucles de retroalimentación interna, reducen progresivamente las tasas de error, pero amplían considerablemente el tiempo de inferencia con cada paso adicional9. Los métodos de verificación basados en inferencia natural (NLI) ofrecen una alternativa más específica al evaluar la implicación semántica entre afirmaciones generadas y textos de referencia, pero las implementaciones existentes dependen de umbrales de decisión fijos que no logran adaptarse a diferentes distribuciones de confianza, dominios o comportamientos del modelo10,11. En conjunto, estos enfoques imponen una sobrecarga computacional inaceptable, dependen de infraestructuras externas o carecen de la adaptabilidad necesaria para una implementación generalizada. Se proporciona una comparación de las características principales de estos enfoques de verificación de alucinaciones en la Tabla Suplementaria 1.
Este artículo propone un marco ligero de verificación en dos pasos, diseñado para reducir las alucinaciones en las salidas de los modelos lingüísticos grandes (LLM) manteniendo una baja latencia de respuesta. En la primera etapa, el LLM genera una respuesta inicial, que luego se descompone en afirmaciones factuales atómicas. En la segunda etapa, cada afirmación se verifica mediante inferencia del lenguaje natural (NLI) frente a una referencia factual generada por separado mediante un proceso aislado de razonamiento que no accede a la respuesta original generada, y un umbral de confianza derivado estadísticamente rige la decisión de aceptar o corregir a nivel de afirmación. Las principales contribuciones de este trabajo son las siguientes: (1) Una tubería de verificación a nivel de afirmación en dos pasos que separa la generación de respuestas de la validación factual, permitiendo una evaluación independiente y específica de cada afirmación atómica sin necesidad de recuperación externa o regeneración completa de la respuesta; (2) Un mecanismo adaptativo de umbralización estadística basado en la distribución de las puntuaciones de confianza de NLI (τ = µ + kσ), que determina dinámicamente los límites de aceptación y corrección en lugar de depender de reglas de decisión fijas, mejorando la robustez en diferentes distribuciones de confianza; (3) Una estrategia de corrección selectiva que limita la regeneración únicamente a aquellas afirmaciones clasificadas como contradictorias, reduciendo sustancialmente la carga computacional en comparación con enfoques de remuestreo completo de la respuesta o refinamiento iterativo; (4) Una evaluación empírica en un conjunto de pruebas centrado en alucinaciones, que demuestra que el marco propuesto reduce las tasas de alucinación del 28 % al 9 % manteniendo la latencia de respuesta dentro de límites prácticos para su implementación.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio no involucró participantes humanos, animales, especímenes biológicos ni datos de pacientes. Por lo tanto, no se requirió aprobación ética institucional ni consentimiento informado.
Descripción general del diseño del estudio
Se implementó un marco de verificación en dos etapas para mejorar la fiabilidad factual de las salidas de modelos grandes de lenguaje (LLM). El procedimiento consistió en la generación de respuestas, extracción de afirmaciones, construcción aislada de referencias, verificación basada en inferencia de lenguaje natural (NLI), toma de decisiones estadística adaptativa, corrección selectiva y ensamblaje final de la respuesta. El marco se evaluó utilizando los conjuntos de datos de referencia TruthfulQA y FEVER.
Flujo de trabajo general
Consulta del usuario → Generación de respuesta inicial → Extracción de afirmaciones → Generación independiente de referencias → Verificación mediante inferencia lingüística natural → Cálculo del umbral estadístico → Corrección de afirmaciones → Respuesta final verificada. El flujo general del marco adaptativo de verificación de afirmaciones se ilustra en Figura 1.
Preparación del conjunto de datos
Se descargó y preparó el conjunto de datos TruthfulQA12, que contiene 817 preguntas orientadas a hechos, para su evaluación. El conjunto de datos FEVER13 comprende 185.445 afirmaciones anotadas etiquetadas como Apoyadas, Refutadas o Información Insuficiente; para la evaluación se utilizaron los datos de desarrollo etiquetados con sus campos de afirmación, evidencia y etiqueta de referencia. Cada afirmación se evaluó frente a su evidencia proporcionada, mientras que la etiqueta original de FEVER se conservó como resultado de referencia para verificación. El conjunto de datos FEVER, que contiene pares de afirmación-evidencia para verificación de hechos, fue obtenido y preprocesado. Las preguntas y afirmaciones de entrada se convirtieron en un formato de texto estandarizado. Se eliminaron entradas duplicadas y muestras incompletas antes del experimento. TruthfulQA se dividió en subconjuntos de validación y prueba. Aproximadamente el 20 % de las muestras de TruthfulQA (164 preguntas) se utilizó para ajustar el umbral, mientras que las 653 preguntas restantes se reservaron para la evaluación del rendimiento. Para FEVER, las afirmaciones proporcionadas por el conjunto de referencia se utilizaron directamente como unidades de verificación y no pasaron por el procedimiento de generación de respuestas y extracción de afirmaciones aplicado a TruthfulQA. Las características de los conjuntos de datos de referencia utilizados para el desarrollo y evaluación del marco se resumen en Tabla 1.
Generación de la respuesta inicial
Cada consulta se envió al modelo de lenguaje base. Las respuestas se generaron utilizando un muestreo por núcleo con una temperatura de 0,7 y un top-p de 0,9. La longitud máxima de salida se limitó a 256 tokens. Las respuestas generadas se almacenaron sin ningún tipo de postprocesamiento o modificación manual. El texto generado se envió directamente a la etapa de extracción de afirmaciones.
Extracción de afirmaciones
Cada respuesta generada se descompuso en afirmaciones fácticas independientemente verificables. Se utilizó una plantilla estructurada de descomposición para identificar afirmaciones atómicas. Las declaraciones compuestas se separaron en unidades fácticas mínimas. Se eliminaron opiniones subjetivas, expresiones estilísticas y elementos conversacionales irrelevantes. Cada afirmación extraída se almacenó como una unidad de verificación independiente.
Ejemplo:
Respuesta original:
Marie Curie fue una física y química de origen polaco que realizó investigaciones pioneras sobre la radiactividad.
Afirmaciones extraídas: (1) Marie Curie nació en Polonia; (2) Marie Curie fue física y química; (3) Marie Curie realizó investigaciones sobre la radiactividad.
Construcción de referencias aisladas:
Para cada afirmación extraída, se generó una referencia fáctica independiente. El modelo verificador recibió únicamente la consulta original del usuario. Se restringió el acceso a la respuesta generada original para evitar sesgos de confirmación. Se utilizó una indicación de recuperación fáctica para fomentar respuestas concisas y basadas en evidencia. Las referencias generadas se almacenaron para su verificación posterior.
Verificación de inferencia del lenguaje natural
Cada par de afirmación y referencia se envió a un modelo preentrenado de inferencia lingüística natural (NLI). El modelo NLI clasificó la relación como: implicación, neutral o contradicción. Se registraron las probabilidades de confianza para las tres clases. Se asignó una puntuación de verificación con signo: valor positivo para la implicación, cero para neutral o un valor negativo para la contradicción. Se recopilaron todas las puntuaciones de verificación para el cálculo del umbral.
Cálculo adaptativo del umbral estadístico
La confianza en la verificación generada por el modelo de inferencia natural (NLI) varía considerablemente entre las respuestas, ya que diferentes consultas producen distintas cantidades de afirmaciones, niveles de complejidad semántica y distribuciones de confianza. Un umbral global fijo asume que todas las respuestas siguen un perfil de confianza similar, lo cual rara vez se observa en la práctica. Para acomodar esta variabilidad, el marco propuesto estima el límite de decisión individualmente para cada respuesta utilizando la media y la desviación estándar de sus puntuaciones de verificación. La media refleja el nivel general de confianza de la respuesta, mientras que la desviación estándar captura la dispersión de los valores de confianza entre las afirmaciones extraídas. Esta formulación adaptativa permite que el criterio de aceptación se ajuste a la incertidumbre específica de cada respuesta, en lugar de depender de un único umbral para todas las entradas.
Se calcularon la media (µ) y la desviación estándar (σ) de todas las puntuaciones de verificación con signo.
El umbral de decisión adaptativo se calculó como:

donde τ representa el umbral adaptativo, µ denota la puntuación media de verificación, σ denota la desviación estándar, y k representa el parámetro de sensibilidad.
El parámetro de sensibilidad se inicializó en 0,7. Las afirmaciones clasificadas como implicación con puntuaciones mayores o iguales que +τ fueron aceptadas. Las afirmaciones clasificadas como contradicción con puntuaciones menores o iguales que −τ fueron marcadas para corrección. Las afirmaciones con puntuaciones dentro del intervalo (−τ, +τ) se mantuvieron como neutrales.
Corrección selectiva de reclamaciones
Una afirmación fue enviada para corrección solo cuando el modelo de INL clasificó el par afirmación-referencia como una Contradicción, y su puntuación de verificación firmada correspondiente cumplía con el criterio del umbral adaptativo si ≤ -τ. Por lo tanto, la decisión de corrección quedó determinada conjuntamente por la etiqueta de clase del INL y el umbral estadístico específico de la respuesta. Las afirmaciones clasificadas como Implicación con si ≥ τ fueron aceptadas, mientras que las afirmaciones que caían dentro del intervalo -τ < si < τ se consideraron neutrales y se mantuvieron sin corrección. Este criterio combinado aseguró que la corrección se aplicara únicamente a afirmaciones que mostraran tanto contradicción semántica como evidencia negativa de verificación suficientemente fuerte.
Reconstrucción de la respuesta
Las afirmaciones aceptadas y corregidas se organizaron en su secuencia original. Se restablecieron los límites de las oraciones para mantener la legibilidad. Se aplicaron ajustes gramaticales menores cuando fue necesario. La salida ensamblada se almacenó como la respuesta verificada final.
Evaluación del rendimiento
El marco se evaluó utilizando cuatro métricas: (1) Precisión: la proporción de respuestas que permanecieron factualmente correctas tras la verificación; (2) Puntaje F1: la media armónica entre la precisión y la exhaustividad en la detección de alucinaciones; (3) Latencia de la respuesta: el tiempo total de procesamiento desde el envío de la consulta hasta la generación de la respuesta verificada; (4) Tasa de alucinaciones
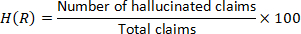
La latencia se reportó como el tiempo medio de ejecución en mediciones repetidas. Debido a que no se conservaron los valores individuales de latencia por ejecución, no se calcularon las desviaciones estándar ni los intervalos de confianza.
Evaluación de la corrección específica del conjunto de referencia
Para TruthfulQA, la respuesta final verificada se comparó con las referencias de respuestas validadas por humanos del benchmark y con las listas de respuestas incorrectas. Se consideró correcta una respuesta cuando sus afirmaciones fácticas eran coherentes con la información de la respuesta aceptada y no contenía contenido correspondiente a los patrones de respuestas incorrectas identificados. Para FEVER, cada afirmación en la salida final se evaluó en comparación con su evidencia asociada y la anotación original de FEVER; las afirmaciones respaldadas se consideraron verificadas fácticamente, mientras que las refutadas se contabilizaron como incorrectas. Los casos de No hay suficiente información se mantuvieron como indeterminados en lugar de considerarlos como evidencia fáctica positiva. Las decisiones resultantes a nivel de afirmación se agruparon en cada benchmark para calcular la Precisión y la Tasa de Alucinaciones informadas.
Ambiente experimental
El marco se implementó utilizando Python 3.9. Las operaciones de procesamiento de datos se realizaron usando bibliotecas de análisis numérico y tabular. El modelo NLI operó en modo de inferencia sin ajuste fino adicional. Los experimentos se ejecutaron en una estación de trabajo equipada con un procesador Intel Core i5, 16 GB de RAM y un sistema operativo de 64 bits. Todas las evaluaciones se realizaron utilizando una configuración de inferencia de un solo paso para garantizar un funcionamiento de baja latencia. Todos los experimentos se llevaron a cabo utilizando configuraciones idénticas de hardware y software para asegurar una evaluación consistente entre conjuntos de datos y métodos básicos.
Resultado esperado
El protocolo está diseñado para generar decisiones de verificación a nivel de afirmación identificando afirmaciones potencialmente no respaldadas y reenviando selectivamente las afirmaciones fuertemente contradictorias para su corrección. La salida esperada es una respuesta verificada con menos inconsistencias factuales y un sobrecoste de procesamiento adicional limitado, sujeto al rendimiento observado durante la evaluación experimental.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Generación de la respuesta inicial
El modelo de lenguaje de referencia generó respuestas fluidas y contextualmente relevantes para preguntas de ambos conjuntos de datos de referencia. Sin embargo, un examen detallado reveló afirmaciones infundadas e inexactas desde el punto de vista factual en varias respuestas. En el conjunto de datos TruthfulQA, el sistema de referencia presentó una tasa de alucinaciones del 28 %, mientras que se observó una tasa de alucinaciones del 26 % en...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
El marco propuesto mejoró el desempeño en la verificación de hechos, evitando al mismo tiempo el muestreo repetido y la recuperación externa. En TruthfulQA, la tasa de alucinaciones disminuyó del 28 % en el modelo LLM de referencia al 9 % con el marco completo, mientras que la precisión aumentó de 0,72 a 0,87. En FEVER, la tasa de alucinaciones bajó del 26 % al 10 %, con un aumento en la precisión de 0,74 a 0,89. Estas comparaciones deben interpretarse dentro de los contextos experimentales y las implementaciones utiliza...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Agradecimientos
Los autores desean expresar su sincera gratitud a su institución por proporcionar el entorno académico y los recursos computacionales necesarios para llevar a cabo esta investigación. Los autores también reconocen a los desarrolladores y mantenedores de los conjuntos de datos de referencia públicos utilizados en este estudio, que permitieron una evaluación integral del marco propuesto. Se agradece a colegas y revisores sus comentarios constructivos, que ayudaron a mejorar la calidad y claridad de este trabajo. Los autores reconocen además a la comunidad de investigación de código abierto por proporcionar las bibliotecas y herramientas de software que facilitaron la experimentación, el análisis de datos y la visualización de resultados. Sus esfuerzos continuos han avanzado significativamente la investigación en procesamiento del lenguaje natural e inteligencia artificial confiable. Los autores declaran que no recibieron apoyo financiero externo ni fondos para esta investigación.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Conjunto de datos de referencia FEVER | Tarea compartida FEVER (Thorne et al.) | https://fever.ai/dataset/fever.html | Conjunto de datos público de verificación de hechos compuesto por pares de afirmaciones y evidencias, utilizado para evaluación |
| GPT-3.5 Turbo (modelo lingüístico grande B10+2:12:12 | OpenAI | Identificación del modelo: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Utilizado tanto como generador de respuestas como generador de referencias independiente, accedido mediante la API de OpenAI |
| NumPy | Desarrolladores de NumPy (código abierto) | https://numpy.org/ | Biblioteca de cálculo numérico utilizada para cálculos estadísticos, incluyendo la media y la desviación estándar de las puntuaciones de verificación NLI |
| Openai (biblioteca cliente de Python) | OpenAI | https://github.com/openai/openai-python | Biblioteca cliente de Python utilizada para enviar indicaciones y recuperar respuestas de GPT-3.5 Turbo |
| pandas | Equipo de desarrollo de pandas (código abierto) | https://pandas.pydata.org/ | Biblioteca de análisis de datos tabulares utilizada para el preprocesamiento de conjuntos de datos y el manejo de resultados |
| Modelo de clasificación preentrenado de Inferencia del Lenguaje Natural (NLI) | Repositorio de modelos de Hugging Face (modelo basado en la arquitectura DeBERTa-v3-large de Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Utilizado en modo inferencia, sin ajuste fino, para clasificar cada par afirmación-referencia como implicación, neutralidad o contradicción |
| Python | Python Software Foundation | Versión 3.9; https://www.python.org/downloads/release/python-390/ | Lenguaje de programación principal utilizado para implementar el marco de verificación |
| SciPy | Desarrolladores de SciPy (código abierto) | https://scipy.org/ | Biblioteca de computación científica utilizada para apoyar el análisis estadístico de los resultados experimentales |
| Transformers (biblioteca Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | Biblioteca de Python utilizada para cargar y ejecutar el modelo NLI preentrenado |
| Conjunto de datos de referencia TruthfulQA | Originalmente publicado por Lin, Hilton y Evans | https://github.com/sylinrl/TruthfulQA | Conjunto de datos de referencia público compuesto por 817 preguntas orientadas a hechos, utilizado para ajuste de umbrales y evaluación |
| Computadora de estación de trabajo | No especificado en el manuscrito (por favor confirme el fabricante/modelo) | Procesador Intel Core i5; 16 GB de RAM; sistema operativo de 64 bits | Hardware utilizado para ejecutar todos los experimentos bajo configuraciones idénticas |
| Nota: Todas las URL enumeradas anteriormente fueron verificadas y confirmadas como activas a la fecha de elaboración de esta tabla. |
Referencias
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Reimpresiones y permisos
Este artículo ha sido publicado
Video próximamente