Este artículo propone un modelo novedoso, redes neuronales graficas con atención lineal de ranura con compuerta para recomendación basada en sesiones, que adopta una atención lineal de ranura con compuerta basada en un grafo de sesión construido de forma dual. Este modelo mejora la precisión y eficiencia de las recomendaciones y supera al estado del arte en tres conjuntos de datos públicos.
Artículo de investigación
Redes Neuronales Gráficas de Atención Lineal con Ranuras Puerta para Recomendaciones Basadas en Sesiones
En este artículo
Resumen
Resumen
Los sistemas de recomendación basados en sesiones (SBR, por sus siglas en inglés) tienen como objetivo predecir el siguiente elemento con el que un usuario probablemente interactúe, basándose en la secuencia de comportamientos dentro de la sesión actual. Enfoques recientes que aprovechan el mecanismo de atención del modelo Transformer (por ejemplo, GC-SAN) han demostrado un rendimiento superior frente a los métodos tradicionales; sin embargo, presentan una carga computacional elevada y una complejidad espacial considerable debido al costo cuadrático de la autoatención. Para abordar estas limitaciones, se propone un modelo novedoso denominado GSLA4Rec (redes neuronales gráficas con atención lineal basada en ranuras con compuerta para recomendaciones basadas en sesiones), que integra la atención lineal con un mecanismo de compuerta aprendible y una estrategia de actualización de memoria basada en ranuras, inspirada en la atención con ranuras con compuerta. Específicamente, GSLA4Rec construye inicialmente dos grafos: un grafo de sesión para capturar las transiciones entre elementos dentro de la sesión y un grafo global de vecinos para codificar señales colaborativas entre sesiones, modelando así información de contexto local y global. El enfoque propuesto se centra en el mecanismo de atención lineal con ranuras y compuerta, que (1) emplea unidades de compuerta para suprimir el ruido proveniente de interacciones irrelevantes o redundantes en sesiones largas, (2) utiliza unidades de ranura para almacenar y actualizar dinámicamente representaciones compactas de la sesión, reduciendo la sobrecarga de memoria, y (3) sustituye la autoatención por atención lineal para lograr una complejidad temporal lineal. En conjunto, estos componentes mejoran significativamente la precisión predictiva y la eficiencia del modelo para capturar los intereses cambiantes de los usuarios. Experimentos exhaustivos en múltiples conjuntos de datos públicos de referencia, incluyendo Diginetica, Tmall y NowPlaying, demuestran que GSLA4Rec supera consistentemente a los métodos SOTA de SBR en rendimiento de recomendación, lo que valida la efectividad del mecanismo GSLA.
Introducción
Con el rápido desarrollo de los servicios en línea (como el comercio electrónico, las plataformas de videos cortos y los flujos de noticias), el problema de la sobrecarga de información se ha vuelto cada vez más destacado y grave. Los sistemas de recomendación1,2 ofrecen servicios personalizados y precisos de difusión de información mediante el análisis profundo de los datos de comportamiento de los usuarios. Sin embargo, en muchas aplicaciones prácticas caracterizadas por acceso anónimo, usuarios no registrados, protección de la privacidad y breves duraciones de interacción, los métodos tradicionales de recomendación, como el filtrado colaborativo3 y la factorización de matrices4,5, limitan considerablemente la aplicabilidad de los algoritmos de recomendación. Para abordar estos desafíos, ha surgido el SBR6,7,8,9. El SBR se centra en los datos de secuencia de interacción dentro de la sesión actual del usuario para predecir el siguiente punto de interés potencial. Este paradigma no solo evita la dependencia de datos históricos a largo plazo de los usuarios, sino que también capta con agudeza los cambios dinámicos de interés a corto plazo, mostrando así un valor único de aplicación en escenarios como el comercio electrónico, los videos cortos, la recomendación de música, entre otros.
Los primeros métodos se basaban principalmente en cadenas de Markov5,10,11,12 para modelar las probabilidades de transición entre elementos en secuencias de sesiones. Aunque estos métodos podían capturar dependencias secuenciales de primer orden, la caracterización de dependencias complejas de orden superior y de la dinámica no lineal de los intereses del usuario sigue siendo limitada, lo que restringe la eficacia del modelo en escenarios complejos. Con el desarrollo de la tecnología de aprendizaje profundo13,14, los métodos basados en redes neuronales se han aplicado ampliamente en la recomendación basada en sesiones (SBR). GRU4REC15 fue el primero en aplicar redes neuronales recurrentes14 (RNNs) a la recomendación basada en sesiones, capturando eficazmente las dependencias temporales en las secuencias; NARM16 mejoró aún más la capacidad de extraer los intereses principales de los usuarios mediante la integración de mecanismos de atención con RNNs; STAMP17 utilizó perceptrones multicapa (MLPs) combinados con mecanismos de atención para centrarse en capturar los intereses a corto plazo de los usuarios. Si bien estos métodos lograron cierto progreso en el modelado de secuencias, aún enfrentaban desafíos como la dificultad para manejar dependencias a largo plazo y la sensibilidad al ruido.
En los últimos años, las redes neuronales graficas (Graph Neural Networks, GNNs)18,19,20,21 han aportado una nueva perspectiva a la tarea SBR. Modelos como SR-GNN22 modelan explícitamente relaciones complejas de transición mediante la construcción de un grafo de sesión (SG), logrando mejoras sustanciales en la precisión de recomendación. Sin embargo, la mayoría de los métodos basados en GNNs existentes realizan la construcción del grafo y el paso de mensajes dentro de sesiones individuales, careciendo de una utilización efectiva de la información de correlación global entre elementos. Para abordar este problema, GCE-GNN23 integra semántica global y grafos de sesión mediante un mecanismo de autoatención para ponderar de forma adaptativa la importancia de los elementos, construyendo un grafo global de vecindad (NGG), logrando mejoras considerables en el rendimiento. No obstante, los métodos existentes basados en GNNs aún enfrentan dos cuellos de botella principales: primero, la complejidad del mecanismo de autoatención crece cuadráticamente con la longitud de la sesión, lo que provoca una sobrecarga computacional sustancial al procesar sesiones largas; segundo, las GNNs tradicionales carecen de la capacidad de regular dinámicamente la importancia de los elementos durante la agregación de información, dificultando la distinción entre comportamientos ruidosos y críticos, lo cual afecta la calidad de la representación.
Para abordar estos desafíos, este artículo propone una red neuronal gráfica con atención lineal basada en ranuras con compuerta para recomendación basada en sesiones (GSLA4Rec): (1) Diseñar un mecanismo de ranuras con compuerta que filtre ruido mediante compuertas y almacene información semántica clave en ranuras de sesión, mejorando la robustez del modelo y reduciendo la sobrecarga de almacenamiento; (2) Introducir el mecanismo de atención lineal que reduce la complejidad computacional de O(N2) a O(N) donde N es la longitud de la sesión), manteniendo al mismo tiempo la capacidad de modelar dependencias a larga distancia; (3) Realizar experimentos exhaustivos en tres conjuntos de datos públicos de referencia (Diginetica, Tmall y NowPlaying), mostrando que GSLA4Rec supera significativamente a los métodos SOTA existentes, demostrando especialmente ventajas claras en escenarios de sesiones largas y escasas.
Protocolo
Experiencia de recomendación basada en sesiones
La recomendación basada en sesiones puede examinarse desde tres perspectivas: SBR, aprendizaje del contexto global y GSLA (véase la Tabla de materiales). En este estudio no participaron personas ni animales. Todos los conjuntos de datos experimentales utilizados en este trabajo están disponibles públicamente y se han presentado como Archivo complementario: GSLA4Rec. zip.
Recomendación basada en sesiones
La recomendación basada en sesiones (SBR) era un sistema de inteligencia artificial que interactuaba con los usuarios mediante diálogos naturales de múltiples turnos para comprender dinámicamente las preferencias de los usuarios y ofrecer recomendaciones personalizadas. SBR evolucionó desde métodos tradicionales hasta enfoques basados en aprendizaje profundo y enfoques híbridos, y luego avanzó hacia soluciones basadas en modelos de lenguaje grandes (LLM).
Recomendación tradicional basada en sesiones
El SBR tradicional solía representarse mediante métodos basados en cadenas de Markov y filtrado colaborativo. El primero generaba recomendaciones mediante la descomposición de matrices de transición probabilísticas específicas del usuario. Por ejemplo, Guy Shani24 propuso un método de recomendación basado en procesos de decisión de Markov que producía recomendaciones al descomponer matrices correspondientes; Wanrong Gu25 mejoró el rendimiento de las recomendaciones integrando cadenas de Markov con intervalos de tiempo de compra. Este último generaba recomendaciones extrayendo relaciones secuenciales ocultas entre elementos interactivos adyacentes mediante factorización matricial. Por ejemplo, Sarwar B1 calculó la similitud entre elementos basándose en comportamientos históricos de los usuarios (como calificaciones y clics) para recomendar elementos que coincidieran con preferencias anteriores de los usuarios. Si el usuario A gustaba del elemento a, y el elemento c era muy similar a a, el sistema recomienda c a A; Rendle S5 propuso FPMC, un modelo de recomendación secuencial que combina la factorización matricial con cadenas de Markov, para capturar relaciones secuenciales ocultas entre elementos interactivos adyacentes. Sin embargo, este SBR tradicional se centraba en las relaciones secuenciales entre elementos adyacentes, lo que dificultaba modelar relaciones de dependencia complejas.
Recomendación basada en sesiones mediante aprendizaje profundo
La recomendación basada en sesiones con aprendizaje profundo ha evolucionado a través de etapas que incluyen Redes Neuronales Convolucionales (CNN)26,27,28,29, RNN y GNN. La RBS basada en CNN utilizó operaciones como la convolución y el agrupamiento (pooling) para aprender representaciones de cada contexto de sesión, que luego se emplearon para recomendaciones posteriores. Caser30 convirtió los L elementos más recientes con los que un usuario había interactuado en vectores de d dimensiones mediante una capa de incrustación (embedding), formando una matriz de incrustación tratada como una «imagen» mapeada en el tiempo y en el espacio latente. Luego utilizó tres filtros convolucionales de patrones secuenciales —a nivel de punto, a nivel de unión sin salto y a nivel de unión con un salto— para aprender patrones secuenciales y mejorar el rendimiento de la RBS. Tuan et al.31 modelaron uniformemente flujos de clics de sesión y características de contenido mediante núcleos convolucionales 3D para formar representaciones conjuntas espacio-temporales y de contenido.
Las RNN eran una clase de arquitecturas de redes neuronales diseñadas específicamente para procesar datos secuenciales. La idea principal consistía en capturar dependencias temporales mediante estructuras recurrentes, como las redes de memoria a corto y largo plazo (LSTM)13 y las unidades recurrentes con puertas (GRU)32, y se utilizaron ampliamente en campos como el procesamiento del lenguaje natural (NLP)33, el reconocimiento de voz34, la traducción de textos35, los viajes36,37, la delincuencia38, y la predicción de tendencias futuras39 (por ejemplo, tráfico40, mercados bursátiles41,42 y meteorología43). GRU4Rec, propuesto por Hidasi et al., fue un hito en la investigación de SBR, ya que introdujo por primera vez las RNN en SBR y capturó los patrones de comportamiento secuencial de los usuarios mediante GRU para lograr recomendaciones personalizadas.
Las GNNs44 demostraron un gran poder expresivo al modelar relaciones complejas dentro de datos con estructura de grafo, y algunos investigadores introdujeron las GNNs para modelar transiciones complejas dentro o entre sesiones. Dependiendo de las distintas arquitecturas de modelos de GNNs, los métodos basados en GNNs para SBR se clasificaron generalmente en redes neuronales de grafos con puertas (GGNNs, por sus siglas en inglés)45, redes de convolución de grafos (GCNs, por sus siglas en inglés)46 y redes de atención de grafos (GATs, por sus siglas en inglés)47. SR-GNN fue el primero en aplicar las GNNs al SBR representando secuencias de sesiones como grafos dirigidos y utilizando GGNNs para capturar relaciones complejas de transición entre elementos dentro de las sesiones, combinado con mecanismos de atención para obtener la representación final de la sesión, mejorando así el rendimiento de las recomendaciones. Chen L48 propuso un marco de GNNs de múltiples vistas que combina atributos estructurados y palabras clave no estructuradas para modelar asociaciones de productos multidimensionales, mejorando la precisión del SBR. Driss E49 diseñó un sistema innovador de recomendación de sesiones que adopta redes neuronales de cápsulas de grafos para capturar características complejas de los elementos y mejorar la precisión de predicción en el SBR.
Las técnicas de aprendizaje profundo mencionadas anteriormente habían enriquecido el alcance de la investigación en SBR y mejorado efectivamente el rendimiento, pero aún presentaban ciertas limitaciones, manifestadas principalmente en: 1) Para elementos recién emergentes o sesiones muy dispersas, era difícil para los modelos realizar predicciones precisas debido a la falta de contexto global; 2) No podían aprovechar los patrones globales contenidos en todas las sesiones históricas.
Recomendación híbrida basada en sesiones
La recomendación híbrida basada en sesiones integró las fortalezas de diferentes técnicas, como el filtrado colaborativo, el aprendizaje profundo y los mecanismos de atención, para mejorar el rendimiento de la recomendación basada en sesiones (SBR). GC-SAN50 incorporó un mecanismo de autoatención basado en SR-GNN para capturar mejor la información de interacción de elementos importantes dentro de una sesión. FGNN51 agregó además información de elementos vecinos mediante un mecanismo de atención de múltiples cabezas para aprender múltiples relaciones del elemento objetivo. SR-HetGNN52 pertenecía a la recomendación basada en sesiones con grafos heterogéneos; mediante la introducción de elementos de múltiples tipos (usuario, elemento, sesión) y aristas multi-relacionales (clic, compra, co-ocurrencia, asociación de atributos), construyó una red de conocimiento global, superando la limitación de secuencias simples de elementos, y se ha convertido en un método importante para modelar el comportamiento de usuarios anónimos y las asociaciones de intereses entre sesiones en los últimos años. KGSR-SAP53 construyó un grafo de conocimiento conectando elementos mediante aristas de múltiples relaciones para describir diversas interacciones usuario-elemento, resolviendo así el problema de pérdida de información que ocurre cuando el grafo global solo contiene aristas de un tipo (interacción usuario-elemento). Wang ZH54 propuso DiffSBR, un modelo de recomendación de sesiones basado en difusión. Este modelo genera preferencias confiables para el siguiente elemento mediante la simulación de eliminación de ruido, mejorando así la modelización de secuencias dinámicas de clics de usuarios. Qiao ST55 desarrolló un marco de recomendación basada en sesiones que combina el aprendizaje de intenciones multi-vista y la alineación con modelos lingüísticos grandes (LLM). Este marco explora la intención implícita del usuario desde diversas perspectivas y aprovecha los modelos lingüísticos para alinear características semánticas, mejorando así el rendimiento de la recomendación.
Contexto global
Para superar la limitación de «ver las sesiones de forma aislada», los investigadores comprendieron que podía utilizarse información global para mejorar la capacidad de representación de la sesión actual, con el fin de resolver problemas como la escasez de datos, el arranque en frío y la brecha semántica en los sistemas tradicionales de recomendación basados en sesiones (SBR). Al mismo tiempo, al construir el contexto global, era necesario integrar la información global en una sola sesión minimizando al mismo tiempo la interferencia de ruido. CSRM56 optimizó la representación a nivel de sesión mediante la integración de información colaborativa entre la sesión actual y sesiones vecinas, utilizando un codificador de memoria externa (OME) para extraer la intención colaborativa a partir de dicha información. CA-TCN57 propuso un modelo de red convolucional temporal con percepción inter-sesiones, construyendo grafos globales y grafos de contexto de sesión para simular el impacto de las interacciones entre sesiones sobre los elementos y las sesiones, mientras que la red convolucional temporal (TCN) amplía el campo receptivo mediante convoluciones dilatadas, con un número de capas que cubre secuencias de longitud exponencial (campo receptivo = ), resolviendo así el problema de la desaparición del gradiente en las RNN. Chen58 propuso un método SBR basado en redes neuronales de hipergrafos (SR-HGNNs), que integra propagación de orden mixto (bajo y alto orden) y mecanismos de atención para resolver el problema de sobre-suavizado de las GNN tradicionales en sesiones cortas y distinguir la importancia de diferentes órdenes de propagación, pudiendo capturar con mayor precisión las dependencias y evitar interferencias de ruido. GCE-GNN utilizó pares de elementos coocurrentes de múltiples órdenes para construir un grafo ponderado no dirigido, contando las frecuencias de coocurrencia de elementos para reflejar su importancia dentro de la sesión; AGNN-GC59 utilizó las relaciones de transición entre elementos a través de sesiones para construir un grafo colaborativo global, calculando las probabilidades de transición entre elementos en el grafo global para reflejar los cambios de interés dentro de la sesión; DA-GCN60 utilizó el camino más corto para actualizar la matriz de adyacencia y construir un grafo ponderado dinámico, calculando la frecuencia de coocurrencia en el grafo global y la distancia del camino entre elementos. Inspirados en los estudios anteriores, en este trabajo se propone construir un grafo global mediante un método basado en vecinos, es decir, utilizando el coeficiente de similitud de Jaccard para calcular sesiones similares, lo cual no solo aprovecha la información global, sino que también filtra el ruido (eliminando elementos irrelevantes), logrando así el objetivo de construir con precisión el contexto global y sentar una base sólida para el algoritmo SBR posterior.
Atención lineal con ranura gobernada
Los transformadores tradicionales61 presentaron una alta complejidad espaciotemporal debido a la necesidad de operaciones de atención completamente conectadas a lo largo de toda la secuencia de la siguiente manera:
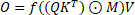 (1)
Donde Q, K, V ∈ RN×d eran transformaciones lineales de los elementos de entrada, M = {Mij = 1 si i ≥ j, de lo contrario −∞} era la máscara causal para evitar la filtración de información futura, ⊙ denotaba el producto elemento a elemento, y f denotaba la función de activación softmax.
Para lograr la atención lineal62, la idea más directa fue eliminar la función de activación softmax. Sin embargo, si la función de activación softmax se eliminara directamente, la atención lineal definitivamente provocaría algunos problemas potenciales: la pérdida del poder expresivo potente de las redes neuronales y la incapacidad para resolver problemas complejos del mundo real.
Atención lineal con ranura y control de memoria limitada
Suponiendo que se debía mantener la función de activación softmax, K y V se comprimieron por separado en K̃, Ṽ ∈ Rm×d. Desde la perspectiva de la red de memoria, K̃ y Ṽ tenían ranuras de memoria cuya longitud aumenta con la secuencia, es decir, el número de ranuras m = N. Si m era fijo, la linealización era obviamente posible. Inspirado en el Control de Memoria Acotada63, se requería que cada token en los elementos de entrada con una longitud de N se escribiera de forma competitiva en m ranuras.
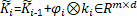 ,
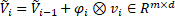 ,
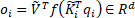 (2)
Donde f era la función de activación softmax y φi era el vector para controlar la entrada efectiva para controlar el valor clave ki de la siguiente manera.
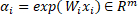 ,
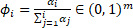 (3)
Aquí, (φi)j representaba la intensidad de escritura del token iésimo en el ranura jésima, y se obtuvo utilizando una función softmax acumulativa.
Para lograr un cálculo lineal eficiente, la fórmula (2) se reescribió como la fórmula (4), que calcula οi a partir de qi, ki y vi (Ec. 4) mediante {οi|i=1T, qi, ki, vi)|i=1T} y adoptó un cálculo secuencial de dos pasos:
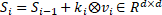 ,
 (4)
Por lo tanto, las operaciones de SLA podrían deducirse:
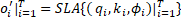 ,
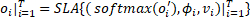 (5)
Donde oi′ ∈ ℝm, οi ∈ ℝd. Por lo tanto, el SLA podría obtener un entrenamiento por fragmentos eficiente en cuanto al hardware y con tiempo lineal64.
Atención lineal con ranura con compuerta
La atención lineal por ranuras con control de memoria limitada podría reducir la complejidad computacional y espacial. Sin embargo, la acumulación de información también podría introducir ruido en la interacción de la sesión, por lo que el decaimiento dependiente de los datos era muy importante para retener y olvidar información selectivamente, y este mecanismo selectivo había sido revisado recientemente en modelos recientes de espacio de estado selectivo65. GSLA con dependencia de los datos podría expresarse como:
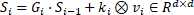 ,
 (6)
Aquí las compuertas de decaimiento se parametrizaron mediante una forma de producto externo Gi = αi ⊗ βi, αi, βi ∈ [0,1]d. En lo que sigue, GSLA también podría escribirse en la siguiente forma equivalente estableciendo típicamente βt = 1 y utilizando la multiplicación matricial como en64:
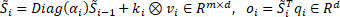 (7)
Donde αi y ki denotaban por separado la puerta de olvido y la puerta de entrada, las dos puertas podían acoplarse como ki = 1 − αi, inspirado en la literatura sobre RNN con puertas. Era evidente que GSLA podía formularse con un cálculo secuencial de dos pasadas, como se muestra en la Ecuación (8). La estructura de segundo orden permitía un entrenamiento paralelo por bloques para mejorar la eficiencia del entrenamiento, y la inserción de la operación softmax en medio de la estructura de segundo orden potenciaba la capacidad de modelado de la memoria de ranuras finitas.
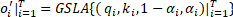 ,
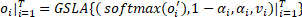 (8)
Transformación de los datos de la sesión
Definición del problema
Sea la secuencia de sesión dada S = {v1s, v2s, ⋯, vns}, donde vis denota el i-ésimo elemento clicado. Al analizar el comportamiento del usuario respecto a los clics dentro de esta secuencia, el sistema predijo el siguiente elemento en el que el usuario podría estar interesado, vn+1s.
Construcción del gráfico
Construcción del grafo de sesiones
Para una sesión S = {v1s, v2s, ⋯, vns}, se construyó un grafo dirigido Gs = (Vs, εs), donde Vs era el conjunto de elementos de la sesión dada S, y εs = {eijlocal|vi, vj, vi, vj ∈ Vs} era el conjunto de aristas de la sesión dada S. ε(vi-1s, vis) representaba los elementos clicados consecutivamente en esta sesión. La arista eijlocal podía dividirse en cuatro tipos: ein, eout, ein-out, eself. Dado que el mismo elemento podría aparecer repetidamente en la secuencia, se contaba el valor ponderado de cada arista.
La sesión actual s = [v1, v2, v4, v2, v3] fue convertida en un SG, como se muestra en la Figura 1A.
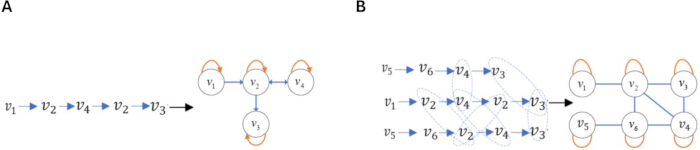
Figura 1: Transformar elementos interactivos en estructuras de grafos. (A) Ilustración de la construcción del grafo de sesión (SG) mediante la transformación de una sesión en un grafo. (B) Ilustración de la construcción del grafo global de vecinos (NGG) mediante la combinación de múltiples sesiones en un grafo. Esta figura fue elaborada por los autores utilizando Visio con elementos completamente personalizados. No se utilizaron recursos gráficos externos con derechos de autor, por lo que no fue necesario obtener ninguna licencia adicional de terceros. Los derechos de autor de la figura pertenecen a los autores y se ajustarán a las normas de derechos de autor de la revista tras su aceptación. Haga clic aquí para ver una versión más grande de esta figura.
Construcción del grafo global de vecinos
Basándose en la sesión actual S, se construyó el NGG correspondiente Gg = (Vg, εg) para enriquecer el aprendizaje de representación de la sesión actual de manera inter-sesiones. Vg era el conjunto de elementos que contenía todos los elementos en Gg, y εg = {eijglobal|vi, vj, vi, vj ∈ Vg} era el conjunto de aristas de Gg. ε(vi-1g, vig) representaba los elementos que interactuaban directamente vi-1g y vig en el NGG Gg. Este proceso constaba de dos pasos: adquisición de la sesión vecina y construcción del NGG.
Adquisición de la sesión vecina
A lo largo de todo el conjunto de datos, se buscaron las sesiones con el número máximo de elementos coocurrentes con la sesión actual. Se seleccionaron las primeras N sesiones con los conteos más altos de coocurrencia para construir un conjunto de sesiones vecinas candidatas S. Posteriormente, se utilizó el coeficiente de similitud de Jaccard para calcular la similitud entre la sesión actual cu y una sesión Sr ∈ S del conjunto candidato S, como se muestra en la Ecuación (9).
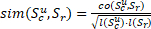 (9)
Aquí, co(Scu, Sr) denotaba el número de elementos que aparecen conjuntamente en Scu y Sr, mientras que l(Scu) y l(Sr) representaban respectivamente las longitudes de Scu y Sr, y Scu y Sr denotaban la sesión actual y una sesión vecina. Las sesiones con similitud por debajo de un umbral determinado (que puede establecerse como un hiperparámetro) se eliminaron, y las sesiones restantes constituyeron el conjunto de sesiones vecinas Ns para la sesión actual.
Construcción del grafo global de vecinos
Basándose en el conjunto de sesiones vecinas Ns, se construyó el NGG, como se ilustra en la Figura 1B. Durante la construcción de la matriz de adyacencia, si dos elementos (vi, vj) tenían una interacción, la entrada correspondiente Aij se establecía en 1; de lo contrario, se establecía en 0. Además, las interacciones entre los elementos se procesaron como no dirigidas y se les asignaron bucles propios, seguido de la normalización, como se muestra en la Tabla 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tabla 1: Matriz de adyacencia normalizada del grafo global de vecinos. La tabla presenta la matriz de adyacencia normalizada que describe las conexiones ponderadas entre los nodos en el grafo global de vecinos construido.
Diseño de un algoritmo de recomendación basado en sesiones
Esta sección detalla el modelo innovador propuesto GSLA4Rec, que mejoró el rendimiento de SBR mediante la introducción del mecanismo GSLA en la representación conjunta de características de SG y NGG.
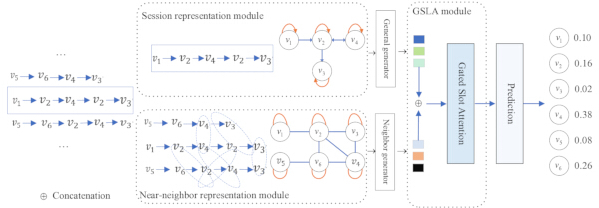
Figura 2: Marco GSLA4Rec. Este marco integró el aprendizaje de la estructura de grafos de sesión y de grafo global vecino, filtró el ruido de interacción mediante un mecanismo de compuerta, equilibró almacenamiento y eficiencia con un mecanismo de ranuras de memoria y capturó la relevancia de los elementos mediante un mecanismo de atención lineal para predecir la preferencia del usuario en el siguiente clic. Esta figura fue elaborada por los autores mediante Visio con elementos completamente personalizados. No se utilizaron recursos gráficos externos con derechos de autor, por lo que no fue necesario ningún permiso adicional de terceros. Los derechos de autor de la figura pertenecen a los autores y se ajustarán a las normas de derechos de autor de la revista tras su aceptación. GSLA4Rec representa redes neuronales gráficas con atención lineal con compuerta y ranuras para SBR. Haga clic aquí para ver una versión más grande de esta figura.
Figura 2 presenta el marco de GSLA4Rec, que comprendía cuatro componentes principales: 1) Representación de elementos a nivel de sesión. Utilizaba un modelo de GNN en SG para aprender embeddings de elementos a nivel de sesión dentro de la sesión actual; 2) Representación de elementos a nivel global de vecinos. Aprendía embeddings de elementos a nivel global en todas las sesiones empleando una GRU para incorporar recursivamente los embeddings de vecinos de cada elemento basándose en NGG; 3) GSLA. Modelaba la preferencia del usuario en la sesión actual mediante la agregación de las representaciones de elementos aprendidas tanto a nivel de sesión como a nivel global; 4) Capa de predicción. Generaba las probabilidades predichas sobre los elementos candidatos. Los cuatro componentes se presentan en detalle a continuación.
Representación de la sesión
En SBR, comprender los comportamientos de interacción de los usuarios era fundamental. Con este fin, se construyeron un SG y un NGG para el aprendizaje de representación de sesiones, con el objetivo de comprender de manera integral los comportamientos de interacción de los usuarios y capturar así la intención más auténtica de estos.
Representación del elemento a nivel de sesión
Basado en el SG de la Figura 1A, se empleó un método de atención en grafo bidireccional ponderado (WBGAT) para extraer las características del SG. Este método introdujo pesos en las aristas y la direccionalidad de los elementos (vecinos entrantes y vecinos salientes) basándose en el mecanismo estándar de GAT, logrando así reforzar las aristas importantes y capturar dependencias bidireccionales, lo que permitió abordar las limitaciones del GAT tradicional respecto a las relaciones asimétricas entre elementos y la intensidad de sus interacciones. El proceso de cálculo fue el siguiente:
Primero, cálculo de los pesos de normalización del grado interno del elemento.
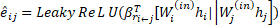 (10)
donde eij indicaba el peso de primer orden del vecino entrante de las características del elemento j respecto al elemento i,  era la relación entre el elemento i y el elemento j, β* ∈ ℝd eran los vectores de peso, hi y hj eran respectivamente la representación del elemento i y del elemento j, Wi(in) ∈ ℝd*d y Wj(in) ∈ ℝd*d eran parámetros entrenables, || representaba la operación de concatenación. Para distinguir diferentes relaciones de grado entrante, se entrenaron dos vectores de peso, denominados rin y rin-self. Se utilizó LeakyReLU como función de activación.
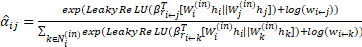 (11)
Para hacer comparables los coeficientes entre diferentes elementos, los pesos de atención se normalizaron mediante la función softmax. Donde Ni(in) era el conjunto de vecinos entrantes de primer orden del elemento i,  era el peso del vecino entrante del borde dirigido (i←j) en SG, este método permitió al modelo aprender las correlaciones entre características de los elementos mientras conservaba la información inherente de la intensidad de conexión de la estructura del grafo, tomando el logaritmo de los pesos de los bordes y sumándolos a la puntuación de atención original eij.
Segundo, cálculo de los pesos de normalización del grado de salida del ítem.
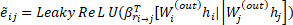 (12)
donde ẽij indicaba el peso de primer orden de las características del elemento j hacia el elemento i,  era la relación entre el elemento i y j, y se entrenaron dos vectores de peso, denominados rout y rout-self.
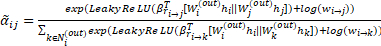 (13)
Donde Ni(out) era el conjunto de vecinos de primer orden de salida del elemento i,  era el peso del vecino de salida del borde dirigido (i→j) en SG.
Tercero, agregación de información. La incorporación actualizada del elemento podría obtenerse tras ponderar y sumar las incorporaciones de grado entrante y grado saliente de primer orden del elemento i.
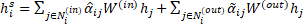 (14)
Donde  y α̃ij denotaban respectivamente los pesos de grado entrante y grado saliente del elemento i, y
 denotaba la representación actualizada del elemento i.
Representación global del elemento vecino
Investigaciones recientes coincidieron en que la construcción de un grafo global podría mejorar la representación de los datos y, por ende, el rendimiento del SBR, lo cual era indudable. Sin embargo, la mejora global de los datos también podría introducir información irrelevante, como ruido. En el modelo propuesto, para lograr una ampliación global de los datos mientras se minimiza al máximo el ruido, se construyó un grafo global de vecinos cercanos.
Basado en el NGG de la Figura 1B y la matriz de adyacencia normalizada de la Tabla 1, la sesión actual y sus sesiones vecinas se transformaron en un NGG, y se aplicó un método de GGNNs45 para extraer características del NGG. El proceso de aprendizaje de los vectores de elementos en el NGG se muestra en la Ecuación (15).
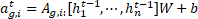
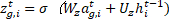
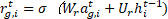
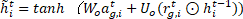
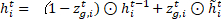 (15)
W ∈ ℝd×2d denotaba los pesos de control, zg,i y rg,i representaban la puerta de actualización y la puerta de reinicio, respectivamente. [h1t-1, ⋯, hnt-1] representaba la lista de todos los vectores de elementos en la sesión s. σ(x) = 1/(1 + e-x) era la función sigmoide logística, ⊙ denotaba la multiplicación elemento a elemento, y hi ∈ ℝd representaba el vector tras la actualización con puertas. La matriz de adyacencia As ∈ ℝn×n indicaba la conectividad entre los elementos en sesiones adyacentes, y As,i: ∈ ℝ1×n representaba un bloque de columna de As correspondiente al elemento vs,i en la matriz de adyacencia. Para la sesión actual s = [v1, v2, v4, v2, v3], el NGG y la matriz de adyacencia normalizada se mostraban en la Figura 1B y en la Tabla 1, respectivamente.
Representación del elemento
La representación del ítem se obtuvo sumando el vector del ítem a nivel de sesión y el vector del ítem a nivel global del vecino, como se muestra en la Ecuación (16):
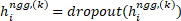
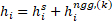 (16)
Donde se utilizó la eliminación (dropout) en las representaciones de elementos vecinos a nivel global para aliviar el sobreajuste.
Atención lineal con ranura de compuerta
La atención lineal con ranura controlada (GSLA) en este artículo integra la atención lineal con un control de memoria acotada y un mecanismo de compuerta dependiente de los datos. Por un lado, heredó el mecanismo de ranura de memoria finita del modelo de controlador basado en atención (ABC), que comprime los pares clave-valor, que originalmente crecían con la longitud de la secuencia, en un número fijo de ranuras, y cada ranura se actualiza mediante escritura competitiva, abordando así el problema de complejidad computacional de la atención global del transformador. Por otro lado, introdujo un mecanismo de compuerta de granularidad fina similar al de GLA, en el que los datos de entrada ajustan dinámicamente la proporción de retención de la información histórica mediante una compuerta de olvido αi, resolviendo el problema de ruido causado por la falta de un mecanismo de olvido en ABC.
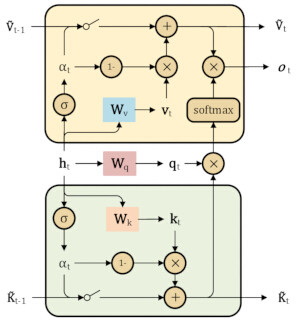
Figura 3: Diagrama esquemático de GSLA. El vector de entrada se asignó al vector de consulta, vector de palabras clave y vector de valores, respectivamente, y luego se procesó mediante atención lineal con control de memoria limitada y un mecanismo de compuerta dependiente de los datos para obtener el vector de consulta actualizado, vector de palabras clave, vector de valores y vector de salida. Esta figura fue dibujada por los autores mediante Visio con elementos completamente personalizados. No se utilizaron recursos gráficos externos con derechos de autor, por lo que no fue necesario ningún permiso adicional de copyright de terceros. El copyright de la figura pertenece a los autores y cumplirá con las normas de copyright de la revista tras su aceptación. GSLA representa la atención lineal con ranuras y compuerta. Haga clic aquí para ver una versión más grande de esta figura.
Como se implementó específicamente en la Figura 3, el vector de entrada se mapeó por separado en el vector de consulta, el vector clave y el vector de valores64:
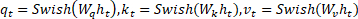 (17)
Donde Wq, Wk, Wv ∈ ℝd×d representaban las matrices de pesos de transformación correspondientes a la consulta, la clave y el valor, respectivamente, y ht denotaba el vector de incrustación en el paso temporal t de la secuencia de entrada de la sesión. La función Swish se definía como Swish(x) = x · σ(x) y era una función de activación con autoguía, donde σ era la función sigmoide; esta superó a la función de activación ReLU tradicional en múltiples tareas de aprendizaje profundo.
GSLA utilizó una puerta de olvido αi y una puerta de entrada 1 − αi, dependiendo de los datos de entrada, para actualizar dinámicamente la información en el iº espacio de memoria. El proceso fue el siguiente64:
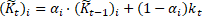 (18)
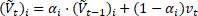 (19)
Aquí, K̃t y Ṽt representaban las ranuras del vector clave y las ranuras del vector de valor en el paso de tiempo t, mientras que K̃t-1 y Ṽt-1 representaban las ranuras del vector clave y las ranuras del vector de valor en el paso de tiempo t−1. La puerta de olvido αi = σ(Wαht)1/τ, donde Wα ∈ ℝd era la matriz de pesos de transformación, σ era la función sigmoide y τ era el coeficiente de amortiguación (normalmente establecido en 8), se utilizaba para controlar la suavidad de la puerta de olvido. Esto permitía a GSLA ajustar suavemente la tasa de olvido de la información histórica: cuanto mayor fuera αi, más dependería GSLA de la información histórica; cuanto menor fuera αi, más se centraría GSLA en la entrada actual.
Los ranuras de vector clave K̃t y las ranuras de vector de valor Ṽt en el paso t-ésimo se escribieron en forma matricial, como se muestra65 en las Ecuaciones (20) y (21):
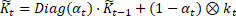 (20)
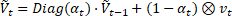 (21)
Luego, se utilizó la GSLA con propiedades de segundo orden (véase la Ecuación (8)) para calcular la salida oi |i=1T en cada paso de tiempo i ∈ [1, …, T]. Se aplicó una transformación lineal a la salida de cada paso de tiempo para obtener el resultado h̃t. Finalmente, se calculó el valor promedio de las representaciones de todos los elementos en la secuencia de sesión para generar el vector de sesión S̃e con actualizaciones dinámicas de la memoria:
 (22)
 (23)
Aquí, ot representaba la salida de Gated-Slot en el paso de tiempo t, h̃t indicaba el resultado de aplicar una transformación lineal sobre ot. S̃e indicaba el valor promedio de h̃t en todos los pasos de tiempo.
Capa de predicción
A partir de la representación de sesión obtenida S̃e y del embedding inicial del elemento i, se realizó una operación de producto punto para calcular la puntuación de cada elemento candidato hi. Posteriormente, se utilizó la función softmax para obtener las probabilidades de recomendación del elemento candidato i:
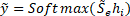 (24)
Aquí, ỹ representaba las probabilidades de recomendación del elemento candidato, hi denotaba el vector del elemento candidato, y se utilizó la función de pérdida de entropía cruzada para el entrenamiento del modelo.
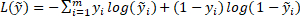 (25)
Aquí, y fue la representación codificada one-hot de la verdad fundamental.
Resultados
Conjuntos de datos y preprocesamiento
En los experimentos, se seleccionaron tres conjuntos de datos públicos de SBR derivados de datos reales de transacciones en escenarios prácticos de aplicación para evaluar el rendimiento del modelo: Diginetica, extraído del concurso CIKM Cup 2016, que contiene registros de transacciones y clics de usuarios; Tmall, que proviene de registros de usuarios en la plataforma Tmall y documenta comportamientos de navegación y compra; y Nowplaying, que incluye registros musicales sobre el historial de reproducción de usuarios en plataformas de música. Estos conjuntos de datos se utilizaron ampliamente en investigaciones de SBR y permitieron evaluar de forma integral la eficacia y aplicabilidad del modelo.
En la etapa de preprocesamiento de datos, los conjuntos de datos fueron estandarizados para garantizar la consistencia en la calidad de los datos. Específicamente, se eliminaron todas las sesiones con una duración menor a 2, y se descartaron los elementos que aparecían menos de 5 veces. Además, para cada sesión S = {v1, v2, ..., vn}, se generaron múltiples subsecuencias para el entrenamiento y la prueba del modelo. Estas subsecuencias tenían la forma: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Tras completar el preprocesamiento mencionado, se realizaron análisis estadísticos sobre los conjuntos de datos, cuya información detallada se presenta en Tabla 2.
| Conjunto de datos | Diginetica | Tmall | Nowplaying |
| haga clic | 982961 | 818479 | 1367963 |
| entrenamiento | 719470 | 351268 | 825304 |
| prueba | 60858 | 25898 | 60417 |
| elementos | 43097 | 40728 | 60417 |
| long. prom. | 5.12 | 6.69 | 7.42 |
Tabla 2: Descripción del conjunto de datos. La tabla resume las estadísticas de los conjuntos de datos Diginetica, Tmall y Nowplaying, incluyendo los números de clics, muestras de entrenamiento y prueba, elementos y longitud promedio de sesión.
Configuraciones experimentales
Configuración de parámetros
Para garantizar la imparcialidad del experimento, se adoptaron métodos de preprocesamiento para procesar tres conjuntos de datos, mientras se preestablecían los parámetros del modelo GSLA4Rec. Para los conjuntos de datos Diginetica y Nowplaying, el tamaño del lote se estableció en 150, y en 300 para el conjunto de datos Tmall. Los parámetros de este modelo se inicializaron utilizando una distribución gaussiana con media 0 y desviación estándar 0,1, y la dimensión se fijó en 100; el optimizador utilizado fue Adam con una tasa de aprendizaje inicial establecida en 0,001, la tasa de aprendizaje se multiplicó por 0,1 cada 3 épocas, el entrenamiento se realizó durante un total de 30 épocas en la GPU NVIDIA TITAN V y PyTorch 1.11.0 con cu113 (consulte Tabla de materiales) para tomar el mejor valor, el umbral para filtrar sesiones vecinas se estableció en 0,5, y en el experimento se aplicó regularización L2. Para cada conjunto de datos, se seleccionó el último 10 % de los datos ordenados por tiempo de transacción como conjunto de prueba, y el 10 % restante y el 80 % se seleccionaron aleatoriamente como conjuntos de validación y entrenamiento, respectivamente. El número de ranuras de memoria en GSLA se estableció en un valor dentro de {0, 1, 2, 3, 4, 5}.
Métricas de evaluación
En este artículo se adoptaron P@N (Precisión@N, N = 10/20) y MRR@N (Rango Recíproco Medio@N, N = 10/20). P@N se utilizó para medir la proporción de recomendaciones correctas entre los primeros N resultados de recomendación; MRR@N se utilizó para calcular el rango recíproco promedio de los proyectos correctos; cuanto mayor sea el valor de MRR, mejor será el rendimiento de clasificación.
Analizar el rendimiento
La efectividad del modelo GSLA4Rec se evaluó frente a modelos de referencia que representan diferentes etapas del desarrollo tecnológico. En una etapa temprana, se utilizaron métodos de aprendizaje automático para la SBR, por ejemplo, FPMC5 se empleó para predecir el efecto secuencial basándose en cadenas de Markov. Posteriormente, con el avance de la inteligencia artificial, el aprendizaje profundo se aplicó ampliamente a la SBR; por ejemplo, GRU4Rec10 se basó en redes neuronales recurrentes (RNNs), modelando la SBR mediante la superposición de múltiples capas de GRUs y diseñando funciones de pérdida especializadas para optimizar la SBR. NARM16 introdujo mecanismos de atención (AM) para captar los intereses principales de los usuarios y generar una representación final integrada del siguiente elemento recomendable. STAMP17 empleó perceptrones multicapa mejorados con AM para capturar simultáneamente el interés general y el interés inmediato de los usuarios. En años recientes, las redes neuronales en grafos también se han utilizado ampliamente en la SBR debido a su potente capacidad de aprendizaje sobre datos no euclidianos. Por ejemplo, SR-GNN22 aplicó por primera vez las GNNs a la SBR, obteniendo relaciones complejas de transición entre elementos mediante GGNNs y centrándose en los intereses inmediatos de los usuarios mediante AM. GCE-GNN23 utilizó GATs para obtener relaciones de transferencia de elementos en contextos locales y globales, y generó representaciones de sesiones mediante RPE y AM suave. S2-DHCN66 transformó los datos de sesión en hipergrafos y grafos de líneas, y aprovechó el aprendizaje auto-supervisado para mejorar la SBR.
Recientemente, se ha adoptado un enfoque integral para mejorar el rendimiento de SBR. Por ejemplo, GC-SAN50 combinó redes neuronales gráficas (GNN) con redes de autoatención multicapa para mejorar el rendimiento de recomendación mediante la modelación de dependencias a corto y largo plazo; TASRec67 incorporó información temporal mediante la construcción de una secuencia de instantáneas dinámicas de grafos en diferentes marcas de tiempo; CT-GNN68 utilizó GNN con información temporal combinada para aprender información adicional sobre las asociaciones temporales entre elementos; CORE69 fusionó la información de coocurrencia y la información temporal de los elementos para obtener la representación final de la sesión; RESTC70 propuso patrones de interacción espacio-temporal inspirados en las propiedades de uniformidad y alineación del aprendizaje contrastivo; COTRec66,71 adoptó aprendizaje auto-supervisado en dos vistas de grafos de sesión y coentrenamiento para resolver la escasez de datos en SBR; RAIN71 aprovechó el enmascaramiento de aristas y la reconstrucción estructural, y entrenó conjuntamente un indicador de aristas para identificar y eliminar explícitamente las aristas ruidosas, lo que mejoró significativamente la precisión y robustez de SBR.
| Conjuntos de datos | Diginetica | Tmall | Nowplaying | ||||||||||
| Clasificación de método | Métricas | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Aprendizaje automático | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| Aprendizaje profundo | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| Aprendizaje profundo | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| Aprendizaje profundo | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| GNN | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| GNN | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| GNN | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNN+Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNN+Att | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNN+Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNN+Tem | CORE | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNN+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNN+COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNN+ReStr | RAIN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNN+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| DE | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| valor p | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Tinferencia | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
Tabla 3: Comparación de rendimiento en tres conjuntos de datos. La tabla compara GSLA4Rec con métodos de recomendación basados en aprendizaje automático, aprendizaje profundo, redes neuronales grafos (GNN), mecanismos de atención, métodos temporales y otros en los conjuntos de datos Diginetica, Tmall y Nowplaying, utilizando P@10, P@20, MRR@10 y MRR@20. También se reportan la desviación estándar (SD) y los valores p para GSLA4Rec.
Con el fin de verificar el rendimiento del modelo GSLA4Rec y eliminar la aleatoriedad en la mejora del rendimiento provocada por factores aleatorios, se realizaron múltiples experimentos de agrupamiento y análisis estadístico sobre el conjunto de prueba. Específicamente, el conjunto de prueba se dividió en grupos de 150 sesiones por lote, repitiéndose 30 veces mediante el método de semilla aleatoria. Se calcularon los resultados promedio y el consumo de tiempo de todos los experimentos agrupados como el rendimiento y el tiempo de inferencia del modelo GSLA4Rec, respectivamente. Se calcularon la desviación estándar (DE) y la prueba estadística de significancia t del modelo GSLA4Rec para verificar aún más la estabilidad y certeza de la mejora en el rendimiento del modelo GSLA4Rec. Tabla 3 presenta el rendimiento, la DE, el valor p y Tinference del modelo de recomendación propuesto, GSLA4Rec, en comparación con los modelos básicos en los tres conjuntos de datos. Los números subrayados indican el mejor método de referencia, y el modelo con mejor rendimiento correspondiente a cada métrica de evaluación se marca en negrita y negro.
Métodos de recomendación basados en aprendizaje automático: En tareas SBR, el método tradicional FPMC mostró el peor desempeño, principalmente porque los modelos de cadenas de Markov no lograron capturar patrones de transición complejos entre elementos. 2) Métodos de recomendación basados en aprendizaje profundo: Modelos como GRU4REC, NARM y STAMP emplearon enfoques de modelado de secuencias y lograron ciertas mejoras de desempeño. Entre ellos, NARM y STAMP demostraron mejores resultados de recomendación que GRU4REC, principalmente porque NARM introdujo un mecanismo de atención para capturar los intereses principales de los usuarios. 3) Métodos de recomendación basados en GNN: La adopción de GNN en SBR trajo mejoras de desempeño notables. Por ejemplo, SR-GNN, que fue pionero en convertir secuencias de sesiones en estructuras de grafos para capturar información estructural espacial de los elementos, superó a los métodos de aprendizaje profundo representados por STAMP con una mejora del 0,36–4,64 %, demostrando la ventaja espacial de las estructuras de grafos en el procesamiento de datos secuenciales. S2-DHCN adoptó una convolución de hipergrafo de doble canal para capturar dependencias de orden superior entre elementos y combinó un aprendizaje contrastivo auto-supervisado para mejorar las representaciones, abordando la limitación de las GNN tradicionales que solo modelan relaciones por pares y contienen información insuficiente; su desempeño superó a los métodos de aprendizaje profundo representados por STAMP en un 1,30–7,04 %. GCE-GNN, al integrar eficazmente información de sesiones individuales y sesiones globales, superó a los métodos de aprendizaje profundo representados por STAMP en un 1,46–7,60 % y superó a SR-GNN en un 0,88–5,85 %, lo que indica que los métodos de estructura de grafos que incorporan información contextual global pueden mejorar significativamente el desempeño de SBR. 4) Métodos de recomendación basados en GNN + mecanismo de atención: TASRec buscó capturar con mayor precisión las preferencias a corto y largo plazo en las secuencias de comportamiento de los usuarios mediante la introducción de un mecanismo sensible al tiempo; su desempeño superó a los métodos de aprendizaje profundo en un 0,73–5,91 % y al modelo SR-GNN en un 0,30–2,31 %, pero quedó por debajo del modelo GCE-GNN en un 0,59–3,84 %. GC-SAN combinó estructuras de grafos convertidas a partir de secuencias de sesiones con mecanismos de autoatención multi-cabeza para capturar con éxito dependencias locales y a largo plazo dentro de las sesiones; su desempeño fue comparable o ligeramente superior al del modelo SR-GNN, pero fue inferior tanto al modelo TASRec como al GCE-GNN. Esto sugirió que la introducción de mecanismos de atención puede mejorar eficazmente el desempeño de SBR, aunque la mejora es menos significativa que la lograda con información global, reafirmando la importancia de la información contextual global. 5) Métodos de recomendación basados en GNN + codificación temporal: CT-GNN fue el primero en combinar estructuras de grafos con codificación temporal para capturar simultáneamente la «estructura espacial» y la «dinámica temporal», superando al modelo GC-SAN en un 0,55–3,82 %. CORE capturó preferencias a largo plazo e intenciones a corto plazo mediante el análisis estadístico de frecuencias de co-ocurrencia de elementos a partir de sesiones globales y diseñó un ponderado de posición temporal para sesiones actuales, respectivamente, y fusionó esta información de co-ocurrencia y temporal para obtener la representación final de la sesión; su desempeño superó al modelo TASRec en un 0,25–9,58 % y al modelo GC-SAN en un 0,67–11,56 %, mostrando una mejora significativa del 3,64–5,74 % frente al modelo GCE-GNN en el conjunto de datos Tmall. RESTC introdujo un modelo de aprendizaje contrastivo basado en GNN espacio-temporales para abordar problemas en las GNN tradicionales, como centrarse únicamente en estructuras de grafos espaciales, ignorar la información temporal y la fusión espacio-temporal insuficiente; su desempeño superó al modelo CORE en un 0,39–3,31 % y al modelo GCE-GNN en un 0,28–7,56 %, lo que indica que tanto la codificación temporal como el aprendizaje contrastivo mejoran eficazmente el desempeño de SBR. RAIN utilizó técnicas de enmascaramiento de aristas y reconstrucción estructural para entrenar conjuntamente un indicador de aristas con el fin de identificar y eliminar explícitamente aristas ruidosas, logrando un desempeño cercano al del modelo RESTC.
El modelo propuesto, GSLA4Rec, integró información contextual global y un mecanismo de atención lineal con ranuras controladas para capturar eficazmente la información contextual de los usuarios, al tiempo que filtraba el ruido y reducía la complejidad computacional. Demostró mejoras de rendimiento en todos los conjuntos de datos, superando al segundo modelo de referencia con mejor desempeño, el modelo RESTC, en un 0,54–2,31 % y al modelo GCE-GNN en un 0,83–10,18 %. Esto fue particularmente notable al manejar dependencias secuenciales en escenarios de sesiones largas en SBR (específicamente, mejoras del 10,18 % y del 4,73 % en comparación con GCE-GNN y del 1,44 % y del 2,31 % en comparación con RESTC en los conjuntos de datos Tmall y Nowplaying, respectivamente). En resumen, el modelo propuesto GSLA4Rec incorporó una construcción eficiente de grafos para capturar los contextos del usuario y filtrar el ruido; su rendimiento superó consistentemente al estado del arte (SOTA) en todos los conjuntos de datos.
Analizar la eficiencia
Como se muestra en la Figura 4, los resultados experimentales en el conjunto de datos Diginetica mostraron que el GSLA4Rec propuesto alcanzó una velocidad de entrenamiento más rápida que los modelos de referencia en cuanto al tiempo de entrenamiento por época, con todos los experimentos ejecutándose en una GPU NVIDIA TITAN V y consumiendo aproximadamente 9300 MB de memoria. Los modelos basados en aprendizaje profundo, incluidos STAMP, NARM y GRU4Rec, se ejecutaron eficientemente pero ofrecieron el rendimiento más débil; los modelos TASRec y GC-SAN, basados en GNN y el mecanismo de autoatención, mejoraron el rendimiento, aunque sufrieron un tiempo de ejecución significativamente alto. Aunque S2-DHCN y CORE, basados en GNN, implicaron un ligero aumento en el tiempo de cálculo, el rendimiento general mostró una mejora notable, especialmente el modelo GSLA4Rec propuesto, que exhibió una mejora sustancial en el desempeño. La razón principal fue que el modelo GSLA4Rec invirtió menos tiempo en la construcción del grafo que los modelos de referencia; además, empleó un mecanismo de atención lineal con puerta de dos pasadas y ranuras de memoria fijas m, lo que resultó en una complejidad temporal lineal O(Ldm). Este diseño fue significativamente más eficiente que la autoatención estándar O(L2d), al tiempo que conservó una fuerte capacidad de memoria mediante la lectura de ranuras mejorada con softmax. Realizar experimentos de prueba de rendimiento en el conjunto de prueba para sincronizar el tiempo de inferencia estadística, como se muestra en la última fila de la Tabla 3, demostró la ventaja de eficiencia del modelo GSLA4Rec, evitando la situación de "alta precisión falsa pero no disponible" y logrando verdaderamente un equilibrio entre efectividad y eficiencia.
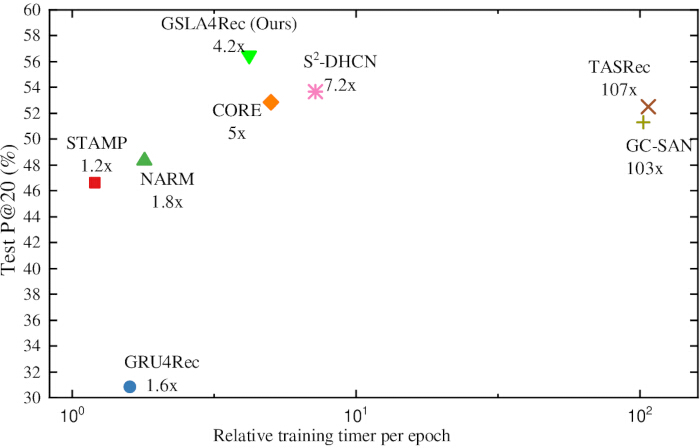
Figura 4: Rendimiento durante el tiempo de ejecución de GSLA4Rec en Diginetica. La figura mostró que nuestro modelo propuesto GSLA4Rec y los modelos de referencia se ejecutaron en una GPU NVIDIA TITAN V utilizando Diginetica para el tiempo de entrenamiento relativo por época, y GSLA4Rec logró una velocidad de entrenamiento más rápida que los modelos de referencia. Esta figura fue elaborada por nosotros mismos mediante OriginPro con elementos completamente personalizados. No se utilizaron recursos gráficos externos con derechos de autor, por lo tanto, no fue necesario ningún permiso adicional de derechos de autor de terceros. Los derechos de autor de la figura pertenecen a los autores y se ajustarán a las normas de derechos de autor de la revista tras su aceptación. GSLA4Rec representa redes neuronales gráficas con atención lineal con ranuras y compuertas para SBR. Haga clic aquí para ver una versión más grande de esta figura.
En resumen, la eficiencia del modelo propuesto GSLA4Rec con atención de ranura con compuerta de complejidad lineal superó consistentemente al estado del arte (SOTA) en todos los conjuntos de datos. En particular, GSLA4Rec logró mejoras significativas en el rendimiento en escenarios de recomendación de sesiones largas en los conjuntos de datos Tmall y Nowplaying, y mostró una capacidad superior para modelar dependencias secuenciales.
Análisis de experimentos de ablación
Impacto de SG, NGG y GSLA
Para evaluar el impacto del SG, el NGG, el mecanismo de compuerta, las ranuras de memoria y la atención lineal en el SBR actual, se realizaron estudios de ablación en los conjuntos de datos Diginetica, Tmall y Nowplaying. GSLA4Rec‑NotSG excluyó la codificación de características del SG mientras conservaba la codificación del NGG, GSLA4Rec‑NotNGG descartó la codificación del NGG y realizó la extracción de características únicamente basándose en el SG, GSLA4Rec‑NotGM eliminó únicamente el mecanismo de compuerta dentro de GSLA, GSLA4Rec‑NotMS eliminó únicamente las ranuras de memoria de GSLA, y GSLA4Rec‑NotLA omitió únicamente el módulo de atención lineal en GSLA.
| Conjunto de datos | Diginetica | Tmall | Nowplaying | |||
| Métricas | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
Tabla 4: Rendimiento de los experimentos de ablación de GSLA4Rec. La tabla muestra el rendimiento de ablación de GSLA4Rec tras eliminar componentes individuales del modelo en los conjuntos de datos Diginetica, Tmall y Nowplaying, evaluado mediante P@20 y MRR@20.
Tabla 4 mostró los resultados del estudio de ablación en diferentes conjuntos de datos; en todos los casos, las métricas de rendimiento disminuyeron en comparación con el modelo completo. La disminución del rendimiento al eliminar la codificación del grafo global de sesiones de vecinos cercanos (GSLA4Rec-NotNGG) fue mayor que al eliminar la codificación de características del grafo de sesiones (GSLA4Rec-NotSG). La eliminación de cualquier submódulo en GSLA provocaría una degradación del rendimiento, que se clasificó de mayor a menor según la atención lineal, las ranuras de memoria y el mecanismo de compuerta. La razón era que la importancia de cada elemento en SBR era definitivamente distinta, y existía la necesidad de una memoria asociativa entre los elementos. Se podía observar que GSLA era una parte clave del modelo presentado en este artículo.
Impacto de diferentes métodos de agregación
Para evaluar el impacto de diferentes métodos de agregación de información en el rendimiento del modelo GSLA4Rec, se investigaron los siguientes tres métodos clásicos de agregación de información: 1) Agrupamiento promedio: realizar una operación de agrupamiento promedio sobre los vectores generados por el SG y el NGG; 2) Concatenación de vectores: concatenar los vectores generados por el SG y el NGG; 3) Suma de vectores: sumar los vectores generados por el SG y el NGG. Los resultados se muestran en la Tabla 5. GSLA4Rec con suma de vectores (Vec-Sum) logró el mejor rendimiento en Diginetica, Tmall y Nowplaying. Por el contrario, el agrupamiento promedio produjo resultados pobres en todos los conjuntos de datos. El rendimiento inferior de la agregación por promedio y de la agregación por concatenación podría deberse a un sobreajuste causado por un exceso de parámetros, lo que degradó el rendimiento general del modelo.
| Conjunto de datos | Diginetica | Tmall | Nowplaying | |||
| Métricas | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Media-Promedio | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| Concatenación de vectores | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| Suma de vectores | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
Tabla 5: Efectos de diferentes métodos de agregación. La tabla compara los efectos del agrupamiento promedio, la concatenación de vectores y la suma de vectores en el rendimiento de GSLA4Rec en los conjuntos de datos Diginetica, Tmall y Nowplaying utilizando P@20 y MRR@20.
Análisis de la configuración de hiperparámetros
Efectos de diferentes tamaños de ranuras de memoria
Las ranuras de memoria almacenaban información de pasos temporales anteriores, lo cual era particularmente importante para tareas con dependencias temporales. Esta sección investigó el impacto de los tamaños de ranuras de memoria m = [0, 1, 2, 3, 4, 5] en el rendimiento de SBR. Los resultados experimentales, mostrados en la Tabla 6, indicaron que cuando el tamaño de las ranuras de memoria m se estableció en 3, las métricas P@20 y MRR@20 tuvieron un rendimiento óptimo en los tres conjuntos de datos. Esto sugirió que un tamaño moderado de ranuras de memoria mejoró efectivamente la precisión de recomendación y la calidad de clasificación del modelo; con tamaños más pequeños, las ranuras tenían dificultades para memorizar información histórica suficiente y se centraban más en los intereses a corto plazo de los usuarios, mientras que cuando el tamaño de las ranuras de memoria aumentaba a 4 o más, el modelo almacenaba información histórica excesiva, lo que provocaba una dependencia excesiva de intereses pasados y descuidaba información de entrada actual más relevante, degradando así el rendimiento de recomendación.
| Conjunto de datos | Diginetica | Tmall | Nowplaying | |||
| Métricas | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53,40 | 17,60 | 38,05 | 15,65 | 22,55 | 7,40 |
| GSLA4Rec-m1 | 55,43 | 18,92 | 41,55 | 17,12 | 25,60 | 8,43 |
| GSLA4Rec-m2 | 56,02 | 19,35 | 42,90 | 18,25 | 26,62 | 8,95 |
| GSLA4Rec-m3 | 56,47 | 19,98 | 43,60 | 19,96 | 27,10 | 9,32 |
| GSLA4Rec-m4 | 53,96 | 19,25 | 43,06 | 19,09 | 26,34 | 8,35 |
| GSLA4Rec-m5 | 52,18 | 18,03 | 42,12 | 17,56 | 24,86 | 8,85 |
Tabla 6: Efectos de diferentes tamaños de ranuras de memoria. La tabla informa el rendimiento de GSLA4Rec con distintas configuraciones de ranuras de memoria (m0–m5) en los conjuntos de datos Diginetica, Tmall y Nowplaying utilizando P@20 y MRR@20.
Efectos de diferentes proporciones de dropout
Para prevenir el sobreajuste, se introdujo la regularización por abandono aleatorio (dropout). Antes de sumar el vector de elementos a nivel de sesión y el vector de elementos a nivel global de los vecinos, las salidas de las neuronas fueron descartadas aleatoriamente en el vector de elementos a nivel global de los vecinos hingg,(k) para mejorar la robustez y la capacidad de generalización del modelo GSLA4Rec.
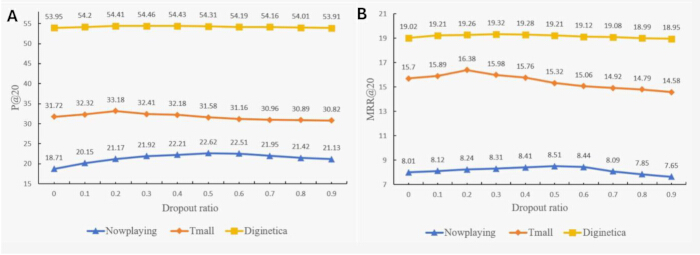
Figura 5: Rendimiento de GSLA4Rec con diferentes proporciones de dropout. (A) P@20 y (B) MRR@20 de GSLA4Rec con diferentes proporciones de dropout en los conjuntos de datos Nowplaying, Tmall y Diginetica. El rendimiento aumentó inicialmente y luego disminuyó conforme aumentó la proporción de dropout, lo que demuestra la robustez y capacidad de generalización del modelo. GSLA4Rec, redes neuronales graficas con atención lineal de ranuras con compuerta para recomendación basada en sesiones (SBR). Esta figura fue elaborada por los autores utilizando OriginPro con elementos completamente personalizados. No se utilizaron recursos gráficos externos con derechos de autor; por lo tanto, no se requirió ninguna licencia adicional de derechos de autor de terceros. Los derechos de autor de la figura pertenecen a los autores y cumplirán con las normas de derechos de autor de la revista tras su aceptación. Haga clic aquí para ver una versión más grande de esta figura.
Figura 5A–B mostró el impacto de diferentes proporciones de exclusión (dropout) en la ecuación (16) sobre el rendimiento del modelo. Los resultados experimentales indicaron que el modelo funciona deficientemente cuando la proporción de exclusión es baja; sin embargo, a medida que aumenta dicha proporción, el rendimiento del modelo mejora gradualmente hasta alcanzar un nivel óptimo. Específicamente, la proporción óptima de exclusión fue de 0,3 en el conjunto de datos Diginetica, 0,2 en el conjunto de datos Tmall y 0,5 en el conjunto de datos Nowplaying. Cuando la proporción de exclusión superó estos valores óptimos, el rendimiento del modelo comenzó a disminuir, principalmente porque la exclusión excesiva de neuronas impidió que el modelo aprendiera eficazmente características importantes a partir de los datos de sesión.
Efectos de diferentes tamaños de incrustación
Para minimizar la carga computacional lo más posible mientras se mantiene un rendimiento óptimo del modelo, se investigó el impacto de diferentes dimensiones de incrustación d en el desempeño del modelo GSLA4Rec. Como se muestra en Figura 6A–B, en tres conjuntos de datos públicos —Diginetica, Tmall y Nowplaying—, el modelo GSLA4Rec tuvo un bajo desempeño cuando la dimensión de incrustación d era de 10 a 40; sin embargo, el rendimiento del modelo aumentó rápidamente conforme el valor de d creció. Las métricas de desempeño tendieron a estabilizarse cuando el valor de d se encontraba entre 80 y 120, y posteriormente el desempeño decayó al seguir aumentando d, posiblemente debido al sobreajuste provocado por una dimensión de incrustación demasiado grande. Por lo tanto, la dimensión del vector de incrustación de elementos se estableció finalmente en 100.
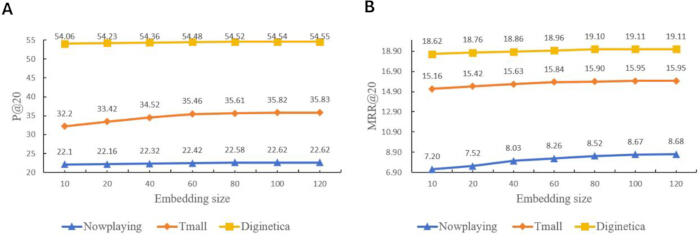
Figura 6: Rendimiento de GSLA4Rec con diferentes tamaños de incrustación. (A) P@20 y (B) MRR@20 de GSLA4Rec con diferentes tamaños de incrustación en los conjuntos de datos Nowplaying, Tmall y Diginetica. El rendimiento del modelo aumentó progresivamente con el incremento del tamaño de incrustación y finalmente alcanzó una meseta. GSLA4Rec, redes neuronales graficas con atención lineal de ranuras con compuerta para recomendación basada en sesiones (SBR). Esta figura fue elaborada por los autores utilizando OriginPro con elementos completamente personalizados. No se utilizaron recursos gráficos externos con derechos de autor; por lo tanto, no se requirió ninguna licencia adicional de derechos de autor de terceros. Los derechos de autor de la figura pertenecen a los autores y cumplirán con las normas de derechos de autor de la revista tras su aceptación. Haga clic aquí para ver una versión más grande de esta figura.
Efectos de diferentes duraciones de sesión
Se sabía bien que la duración de cada sesión varía entre los tres conjuntos de datos reales de SBR (Diginetica, Tmall y Nowplaying). Para verificar la robustez del modelo GSLA4Rec en comparación con los modelos de referencia en sesiones de diferente duración, todas las sesiones de Diginetica y Tmall se dividieron en tres grupos: grupo corto (S), grupo medio (M) y grupo largo (L), con longitudes de 1 a 6, 7 a 12 y mayores de 12, respectivamente. Se utilizó MRR@20 para verificar el rendimiento de los métodos en lugar de P@20, ya que el MRR puede reflejar mejor la calidad del ordenamiento de los resultados correctos. Figura 7A–B indicaron que el modelo GSLA4Rec superó al modelo de referencia basado en secuencias NARM, al modelo de referencia basado en GNNs SR-GNN, al modelo de referencia basado en GNNs con aprendizaje contrastivo S2-DHCN y al modelo de referencia espaciotemporal RESTC en sesiones de diferentes longitudes. Al mismo tiempo, también se observó que el rendimiento de todos los métodos disminuía al aumentar la longitud de la secuencia, ya que las transiciones de elementos a largo alcance dificultaban la captura de las preferencias de los usuarios; sin embargo, el modelo propuesto GSLA4Rec presentó la velocidad de descenso más lenta en comparación con los modelos de referencia, ya que el mecanismo de ranura con compuerta podía filtrar elementos irrelevantes, y el rendimiento de GSLA4Rec superó al del modelo NARM en 6,3 y 8,85 en los grupos largos de Diginetica y Tmall, respectivamente.
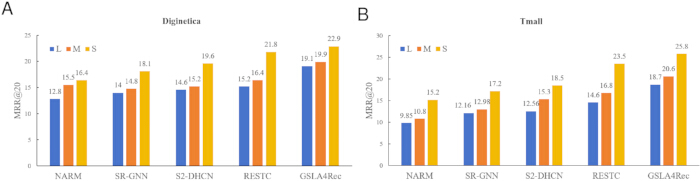
Figura 7: Rendimiento de GSLA4Rec bajo diferentes longitudes de sesión. Rendimiento de GSLA4Rec y modelos básicos bajo distintos grupos de longitud de sesión en los conjuntos de datos de (A) Diginetica y (B) Tmall, evaluado utilizando MRR@20. Los grupos de longitud de sesión se denotan como L, M y S. GSLA4Rec, redes neuronales graficas con atención lineal de ranuras con compuerta para recomendación basada en sesiones (SBR). Esta figura fue elaborada por los autores utilizando OriginPro con elementos completamente personalizados. No se utilizaron recursos gráficos externos con derechos de autor; por lo tanto, no se requirió ninguna licencia adicional de derechos de autor de terceros. Los derechos de autor de la figura pertenecen a los autores y cumplirán con las normas de derechos de autor de la revista tras su aceptación. Haga clic aquí para ver una versión más grande de esta figura.
Conclusión
Este artículo propone una red de atención lineal global con ranuras controladas por contexto para SBR. Al combinar SG y NGG, e introducir un mecanismo de atención lineal con ranuras controladas, este método permite enfocarse en los elementos clave de la secuencia de sesión, capturar dependencias a corto y largo plazo, reducir eficazmente el ruido y disminuir la complejidad computacional. Los resultados experimentales confirman que este método muestra una excelente precisión y eficiencia en la recomendación en tres conjuntos de datos públicos, destacando especialmente en tareas de modelado de dependencias a largo plazo.
DISPONIBILIDAD DE LOS DATOS:
Tres conjuntos de datos públicos comunes (Diginetica, Tmall y Nowplaying, cuyas URL pueden encontrarse en la Tabla de Materiales) que respaldan los hallazgos de este estudio están disponibles abiertamente en Internet. Al mismo tiempo, se han presentado tres conjuntos de datos públicos ampliamente utilizados y el código fuente de este trabajo como Carpeta Suplementaria: GSLA4Rec.zip. Haga clic aquí para descargar este archivo.
Discusión
Compared with baselines, the GSLA4Rec model achieves dual improvements in performance and efficiency for three core reasons. First, applying gating mechanisms to NGG alleviates data sparsity and filters noise effectively. Second, the memory slots mechanism balances storage capacity and efficiency via hyperparameter m adjustment. Third, the linear attention mechanism computes item correlations at an O(N) complexity, far lower than the O(N2)61. The GSLA4Rec model overly relies on users' interaction sequences and ignores the multimodal properties of items48. Meanwhile, the NGG construction uses a fixed Jaccard threshold without dynamic adjustment function, and the memory slots m cannot achieve adaptive adjustability65.
The GSLA4Rec model, which builds SG&NGG and adopts gated-slot linear attention, especially fits anonymous session recommendation39 across e-commerce and online streaming platforms. In e-commerce platforms, this model recommends matching products to users by capturing their browsing, clicking, or adding behaviors to their shopping cart, without relying on user characteristic attributes. The datasets Diginetica and Tmall used in this paper are e-commerce recommendation datasets. For short-video and music streaming platforms, this method analyzes users' playback sequences to infer their implicit preferences, updates content summaries to retain users, and extends viewing time. The dataset Nowplaying used in this paper is the music recommendation dataset.
There are alternative solutions that can replace the gated slot linear attention architecture. The emerging Mamba65 based state space model, as an alternative, has the characteristics of selective state storage space and linear computational complexity, balancing linear complexity and long sequence fitting ability, and combined with the LLM55 enhancement framework, it extracts the users' implicit intent from the original interaction log, thereby achieving good recommendation performance and efficiency. Future work can optimize GSLA4Rec from multiple perspectives: building dynamic NGG to replace fixed Jaccard filtering, implementing variable memory slots to automatically match sessions of different lengths, and incorporating user multimodal information to improve recommendation accuracy. In addition, with the help of LLM-augmented models55, users' implicit intentions can be mined from interaction sequences, and noisy conversation data can be filtered more accurately72.
Divulgaciones
Los autores declaran que no tienen intereses financieros competitivos conocidos ni relaciones personales que pudieran haber influido en el trabajo reportado en este artículo.
Agradecimientos
El autor agradece a los revisores sus comentarios y sugerencias reflexivos durante el proceso de revisión, y al profesor Jiang Nan, mi director de tesis doctoral, por su cuidadosa orientación. Este estudio fue apoyado en parte por la Fundación Nacional de Ciencias de China bajo la subvención n.º 6217072713 y la subvención n.º 62061019, y por temas de investigación abiertos en parte por el Sistema de Sensores No Tripulados y Tecnología de Inteligencia Artificial del Centro de Investigación de Ingeniería de la Provincia de Jiangxi en 2025, y en parte por el Laboratorio Clave de la Provincia de Jiangxi de Materiales Electrónicos Avanzados y Dispositivos (n.º 2024SSY03012).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | NONE | CUDA 11.3 es una versión de la plataforma y modelo de programación de computación paralela lanzada por NVIDIA en 2021, diseñada para mejorar el rendimiento y la flexibilidad de desarrollo de aplicaciones aceleradas por GPU. |
| Diginetica | Diginetica | NONE | Diginetica es el conjunto de datos oficial de la competición CIKM (Conferencia Internacional sobre Recuperación de Información) Cup 2016, que se utilizó en la competición algorítmica CIKM para resolver el problema de recuperación personalizada de productos en comercio electrónico con contexto de búsqueda. Actualmente se ha convertido en el conjunto de datos de referencia más utilizado en el campo de la Recomendación Basada en Sesiones (SBR). |
| Nowplaying | Zenodo | NONE | Es un conjunto de datos a gran escala de comportamiento de escucha musical construido a partir de la extracción de tuits con la etiqueta «#nowplaying», utilizado principalmente en investigaciones sobre recomendación en conversaciones musicales, recomendación sensible al contexto y análisis de correlación de sentimientos. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | NONE | OriginPro es un software científico comercial profesional para gráficos y análisis de datos desarrollado por OriginLab Corporation, comúnmente utilizado para crear gráficos de nivel académico, estadísticas de datos, ajuste de curvas, procesamiento de señales, etc. En este artículo se utiliza OriginPro para elaborar gráficos comparativos experimentales, gráficos de líneas y gráficos de barras. |
| PyTorch 1.11.0 | PyTorch Foundation | NONE | PyTorch es un framework de aprendizaje profundo de código abierto para aprendizaje automático y aprendizaje profundo, lanzado por Facebook en 2016. Implementa principalmente diferenciación automática e introduce grafos de computación dinámicos para hacer la construcción de modelos más flexible. |
| TITAN V GPU | NVIDIA | NONE | NVIDIA TITAN V es una tarjeta gráfica insignia lanzada por NVIDIA a finales de 2017, dirigida principalmente a los campos de computación de alto rendimiento e inteligencia artificial. |
| Tmall | Tmall | NONE | Proveniente de la competición de recomendación Alibaba Tmall IJCAI 2015, Alibaba Tianchi publicó registros reales anonimizados de Tmall en línea. Es uno de los tres conjuntos de datos estándar en el campo de SBR (Diginetica, Yoocoose, Tmall) y el conjunto de evaluación preferido para escenarios de comercio electrónico chinos. |
| visio 2021 | Microsoft | NONE | Visio es un software de dibujo vectorial desarrollado por Microsoft, utilizado para crear diagramas de estructura de modelos, diagramas de flujo, diagramas de marcos, diagramas de topología de red en artículos científicos y para generar ilustraciones vectoriales para publicaciones. |
Referencias
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.