Este protocolo describe la generación de un conjunto de datos basado en condiciones meteorológicas y la evaluación sistemática de modelos de aprendizaje automático, aprendizaje profundo e híbridos para predecir la atenuación atmosférica en comunicaciones ópticas en espacio libre bajo diversas condiciones ambientales iraquíes, incluyendo tormentas de polvo, niebla, lluvia y nieve.
Artículo de investigación
El aprendizaje automático supera al aprendizaje profundo en la predicción de la atenuación atmosférica en comunicaciones ópticas de espacio libre bajo condiciones meteorológicas iraquíes
En este artículo
Resumen
Resumen
Los sistemas de comunicaciones ópticas en espacio libre ofrecen gran ancho de banda, mayor seguridad y funcionamiento sin licencia, pero se ven altamente afectados por la degradación del rendimiento debido a la atenuación atmosférica causada por dispersión y absorción. La predicción precisa de la atenuación es aún más importante en Irak, donde el entorno es cálido, polvoriento, neblinoso y lluvioso de forma aleatoria. El objetivo de este estudio es evaluar el rendimiento de técnicas de aprendizaje automático, aprendizaje profundo y modelos híbridos para predecir la atenuación atmosférica en sistemas de comunicación óptica en espacio libre bajo diferentes condiciones climáticas iraquíes. Se creó un conjunto de datos sintético de 1500 muestras utilizando modelos físicos de propagación bien establecidos para cinco regímenes meteorológicos: cielo despejado, niebla, lluvia, tormentas de polvo y nieve. Se evaluaron sistemáticamente quince modelos predictivos, compuestos por seis técnicas de aprendizaje automático (Bosque Aleatorio [RF], Gradiente Extremo Mejorado, Máquina de Gradiente Mejorado Ligero, Regresión por Vectores de Soporte, Regresión Lineal y Vecinos más Cercanos K), seis arquitecturas de aprendizaje profundo (Perceptrón Multicapa, Red Neuronal Profunda, Memoria a Largo y Corto Plazo [LSTM], Red Neuronal Convolucional Unidimensional [CNN], CNN–LSTM y Red Basada en Atención) y tres enfoques híbridos. Los resultados mostraron que RF tuvo el mejor desempeño (R2 = 0.9654, error cuadrático medio = 1,324 dB/km) en comparación con los enfoques de aprendizaje profundo (mejor R2 = 0,7766) y métodos híbridos (mejor R2 = 0,9571). La importancia de las características se analizó mediante explicaciones aditivas de Shapley, encontrándose que la concentración de polvo (67,3 %) y la visibilidad (21,2 %) fueron los factores más influyentes. Aunque RF resultó tener tiempos sustancialmente más rápidos de entrenamiento e inferencia, pruebas estadísticas revelaron que no hubo diferencia significativa entre RF y el enfoque híbrido de mejor desempeño (p = 0,083). Se demuestra que las técnicas convencionales de aprendizaje automático son altamente eficientes para la estimación de la atenuación atmosférica en sistemas de comunicación FSO bajo condiciones ambientales adversas, en concordancia con teorías físicas de propagación ampliamente conocidas. Sin embargo, enfatizamos que estas conclusiones se basan en datos sintéticos y deben validarse mediante mediciones atmosféricas reales antes de poder utilizarse en sistemas FSO operativos.
Introducción
Las redes de comunicación óptica en espacio libre (FSO) generalmente ofrecen mayor capacidad y mejor seguridad, pero la atenuación atmosférica debida a la dispersión y absorción es un factor limitante importante para la distancia de comunicación1. En este trabajo presentamos un análisis detallado de enfoques basados en aprendizaje automático, aprendizaje profundo e híbridos2 para evaluar la atenuación de la señal FSO en el entorno desafiante de Irak, con altas temperaturas, tormentas de polvo y lluvias irregulares.
Los sistemas de comunicación por FSO han surgido como una de las soluciones prometedoras para la conectividad inalámbrica de alta capacidad de transmisión3 con tasas de datos superiores a 100 Gbps en distancias que van desde cientos de metros hasta varios kilómetros4. Los enlaces FSO operan en el espectro visible e infrarrojo, a diferencia de los sistemas convencionales de radiofrecuencia, y ofrecen beneficios como operación sin licencia, inmunidad a la interferencia electromagnética, mayor seguridad mediante una baja divergencia del haz y una gran capacidad de ancho de banda5. Estas características hacen que el FSO sea una tecnología atractiva para aplicaciones de backhaul, enlaces entre edificios, redes de recuperación ante desastres y conectividad de última milla en situaciones donde la implementación de fibra óptica resulta prohibitivamente costosa6. Sin embargo, la comunicación mediante dispersión, desviación del haz y absorción7,8 depende en gran medida de las condiciones ambientales en cuanto a disponibilidad y rendimiento. Este desafío constituye una de las principales limitaciones de los sistemas de comunicación óptica en espacio libre. Las condiciones meteorológicas provocan amplias variaciones en los niveles de atenuación (dB/km). En condiciones de cielo despejado, la atenuación puede ser inferior a 0,5 dB/km, mientras que la niebla densa puede hacer que la atenuación alcance valores ≥50 dB/km a 1550 nm (utilizando el modelo de niebla de Kim, que predice valores de atenuación hasta 50 dB/km para una visibilidad inferior a 50 m a 1550 nm)9,10, y la lluvia intensa puede provocar atenuaciones de hasta 20–30 dB/km dependiendo de la intensidad de la precipitación (predicción según el modelo de Carbonneau)11. Por lo tanto, se requiere una predicción precisa de la atenuación para el diseño confiable de enlaces, la planificación de redes y estrategias de transmisión adaptativas. Los métodos convencionales se basan en modelos físicos de propagación, como el modelo de Kim para la niebla12, el modelo de Carbonneau para la lluvia13 y la teoría de dispersión de Mie para partículas de aerosol14. Sin embargo, aunque estos modelos proporcionan una buena base teórica, a menudo dependen de parámetros atmosféricos precisos que no siempre están disponibles en la práctica, y frecuentemente no consideran las interacciones complejas entre múltiples fenómenos meteorológicos concurrentes15.
La extrema variabilidad ambiental en Irak presenta desafíos significativos para la implementación de sistemas de comunicación óptica en espacio libre. Las condiciones de transmisión se ven aún más complicadas por la escasez de lluvias y episodios aislados de niebla, mientras que las temperaturas invernales pueden descender por debajo del punto de congelación y las temperaturas estivales pueden superar los 50 °C16. En espectros habitualmente utilizados, como 1550 nm en longitudes de onda normales, las tormentas de polvo, conocidas localmente como "al-haboob", pueden reducir la visibilidad a menos de 100 metros, provocando valores de atenuación superiores a 20 dB/km17. Para que los sistemas FSO se puedan implementar con éxito en Irak y otras naciones del Medio Oriente, es necesario desarrollar modelos de predicción confiables capaces de estimar con precisión el rendimiento del sistema bajo estas diversas condiciones ambientales18.
Los nuevos avances en el aprendizaje automático presentan sustitutos viables para las técnicas convencionales de modelado basadas en la física. La capacidad de las técnicas de aprendizaje automático para aprender directamente correlaciones no lineales complejas entre la atenuación y los factores atmosféricos permite detectar interacciones sutiles que los modelos analíticos tradicionales podrían pasar por alto19. En diversas tareas de predicción climatológica, los métodos de bosque aleatorio (RF) y de incremento de gradiente han demostrado un rendimiento sólido20. De manera similar, las técnicas de aprendizaje profundo han tenido un éxito notable en el procesamiento del lenguaje natural, la visión por computadora y la predicción de series temporales21. Sin embargo, estos enfoques están poco explorados para la predicción de la atenuación en sistemas ópticos de comunicación en espacio libre (FSO), especialmente con conjuntos de datos limitados y condiciones meteorológicas altamente variables22. Para cubrir esta brecha, este trabajo presenta una investigación exhaustiva de los enfoques de aprendizaje automático, aprendizaje profundo e híbridos para predecir la atenuación de señales FSO en condiciones atmosféricas iraquíes. Esto se logra mediante la construcción de un conjunto de datos sintéticos bien diseñado, basado en modelos físicos de propagación ampliamente conocidos23. Planteamos la hipótesis de que, para conjuntos de datos ambientales tabulares de tamaño moderado con pocas variables predictoras dominantes, el rendimiento predictivo de los métodos de ensamble basados en árboles superará al de arquitecturas complejas de aprendizaje profundo. Los objetivos principales son (1) establecer una metodología de referencia para la comparación de métodos de predicción en un entorno de simulación controlado, (2) identificar las mejores estrategias algorítmicas para predecir la atenuación atmosférica y (3) evaluar la importancia de las variables y la interpretabilidad del modelo para obtener información sobre los factores ambientales que más afectan la atenuación. En este trabajo se utilizan datos sintéticos, pero se sientan las bases para una validación posterior con mediciones experimentales del mundo real, lo cual se prevé para trabajos futuros. Además, se incorporan análisis de importancia de variables e interpretabilidad del modelo para determinar los factores ambientales más influyentes en la atenuación.
Protocolo
Este estudio no involucró participantes humanos ni animales vertebrados, ni muestreo de tejidos. Todos los datos utilizados para esta investigación fueron generados sintéticamente empleando modelos físicos de propagación y parámetros meteorológicos de acceso público. Por lo tanto, no se requirió aprobación ética por parte de una Junta de Revisión Institucional (IRB) ni de un Comité Institucional para el Cuidado y Uso de Animales (IACUC).
Generación del Conjunto de Datos Basada en la Teoría Física de Propagación. El conjunto de datos fue construido para simular condiciones atmosféricas horarias durante un año calendario completo (2024) en condiciones atmosféricas iraquíes, destinado a un sistema de comunicación óptica en espacio libre. Creamos una base de datos sintética con 1.500 muestras por hora.
Primero, las condiciones meteorológicas se asignaron aleatoriamente según tendencias regionales: cielo despejado (54,3%), polvo (24,9%), niebla (10,5%), lluvia (7,4%) y nieve (2,8%). Segundo, se aplicó el modelo físico de atenuación correspondiente a cada muestra según la condición meteorológica, es decir, la ley de Beer-Lambert para cielo despejado, el modelo de Kim para niebla, la teoría de Carbonneau para lluvia y la teoría de dispersión de Mie para tormentas de polvo. Tercero, los parámetros del sistema FSO se establecieron de la siguiente manera: potencia de transmisión de 20 dBm, longitud de onda de 1550 nm, distancia de transmisión de 3 km, apertura de transmisión de 2,5 cm y apertura receptora de 20 cm. Cuarto, se calculó la atenuación en dB/km para cada muestra. Finalmente, el conjunto completo de datos se dividió aleatoriamente en 1.200 muestras de entrenamiento (80%) y 300 muestras de prueba (20%). Las condiciones simuladas incluyen altas concentraciones de polvo asociadas con tormentas de arena, tormentas de lluvia y cambios de temperatura desde −4,89 °C hasta 47,99 °C. Las condiciones meteorológicas y las distribuciones de parámetros se seleccionaron según los registros climáticos de Irak del período 2020–2024. Los cinco regímenes meteorológicos (cielo despejado, niebla, lluvia, tormentas de polvo y nieve) se eligieron porque cubren todo el espectro de condiciones atmosféricas que afectan la atenuación FSO en Irak, siendo las tormentas de polvo especialmente frecuentes en Oriente Medio. Los datos históricos de meteorología recopilados en diversas regiones de Irak se utilizaron para crear la distribución de probabilidad de cada condición meteorológica. La distribución resultante fue la siguiente: 54,3% de cielo despejado (estado predominante), 24,9% de polvo (que representa el problema de tormentas de arena en Irak), 10,5% de niebla (frecuente en los inviernos del norte de Irak), 7,4% de lluvia (cantidades bajas de precipitación típicas de Irak) y 2,8% de nieve (ocasional en zonas montañosas del norte). Los parámetros meteorológicos relevantes se modelaron utilizando distribuciones de probabilidad para cada condición meteorológica de la siguiente manera: la temperatura se modeló mediante una distribución normal (media 28,55±11,18 °C) entre −4,89 °C y 47,99 °C según los extremos estacionales de Irak; la humedad se modeló mediante una distribución uniforme (media 42,01±25,56%) desde 0% hasta 100%; la visibilidad se modeló mediante una distribución log-normal entre 0,05 km y 29,99 km (media 13,10±10,91 km) para tener en cuenta los frecuentes eventos de baja visibilidad durante las tormentas de polvo; la concentración de polvo se modeló mediante una distribución exponencial entre 0 y 4,96 mg/m3 (media 0,74±1,30 mg/m3), con mayores probabilidades para concentraciones bajas y colas largas para eventos extremos de polvo.
El sistema de comunicación fue diseñado con una potencia de transmisión de 20 dBm, una longitud de onda de 1550 nm, una distancia de transmisión de hasta 3 km, una apertura de transmisión de 2.5 cm y una apertura receptora de 20 cm para compensar la pérdida por divergencia. Los parámetros del sistema FSO se dividieron en dos grupos: parámetros fijos que no cambiaron para ninguna de las muestras y parámetros variables que se modificaron durante la generación del conjunto de datos. Para las 1.500 muestras, los siguientes parámetros se mantuvieron constantes: potencia de transmisión (20 dBm), longitud de onda de operación (1550 nm), apertura de transmisión (diámetro de 2.5 cm, eficiencia de 0.7) y apertura receptora (diámetro de 20 cm, eficiencia de 0.7). Estos parámetros se fijaron porque corresponden a las especificaciones físicas del hardware del sistema FSO y no varían con las condiciones meteorológicas. El conjunto de datos se creó con 1500 muestras, variando los siguientes parámetros: temperatura (de −4.89°C a 47.99°C), humedad (de 0% a 100%), visibilidad (de 0.05 km a 29.99 km), concentración de polvo (de 0 a 4.96 mg/m3) y condición meteorológica (cielo despejado, niebla, lluvia, polvo, nieve). Estos parámetros se modificaron según distribuciones de probabilidad derivadas de registros climáticos de Irak correspondientes a los años 2020–2024. Para cada muestra, el valor de atenuación (dB/km) se calculó utilizando el modelo físico de atenuación correspondiente, de acuerdo con la combinación específica de condiciones meteorológicas y parámetros variables.
La atenuación física se modeló utilizando el modelo de Carbonneau para la lluvia, la ley de Beer-Lambert para condiciones despejadas, la teoría de dispersión de Mie para el polvo y el modelo de Kim para la niebla24. La ley de Beer-Lambert se aplica a condiciones de cielo despejado, donde la atenuación está dominada por la dispersión y absorción moleculares, que disminuyen exponencialmente con la distancia25. El coeficiente de extinción α a 1550 nm se debe a la dispersión de Rayleigh por las moléculas del aire y a la absorción por los gases atmosféricos26. El modelo de Kim es un modelo específico para la niebla que relaciona la atenuación con la visibilidad mediante coeficientes empíricos derivados de las distribuciones del tamaño de las gotas de niebla. El exponente dependiente de la longitud de onda q tiene en cuenta la dispersión de Mie27. El parámetro principal del modelo de Carbonneau es la tasa de precipitación R, ya que la atenuación por lluvia depende del tamaño y la densidad de las gotas de lluvia, y los coeficientes se derivan empíricamente a 1550 nm y se calibran específicamente para longitudes de onda ópticas28. La teoría de dispersión de Mie es aplicable a condiciones de polvo, dado que el tamaño de las partículas de polvo (0.1–100 μm de radio) es comparable a la longitud de onda (1550 nm), y el índice de refracción complejo m = 1.55–0.005i para el polvo del Medio Oriente incluye tanto dispersión como absorción29. Los siguientes modelos físicos de atenuación se implementaron con sus respectivas ecuaciones y configuraciones de parámetros.
Para condiciones de cielo despejado, se utilizó la ley de Beer-Lambert:
Aclear = 10×log₁₀(e(α×d)) (1)
donde α es el coeficiente de extinción (variado mediante una distribución normal centrada en 0,02 dB/km con una variación de ±0,005 dB/km a 1550 nm en condiciones claras), y d es la distancia de transmisión (fijada en 3 km). Para condiciones de niebla, se implementó el modelo de Kim utilizando la ecuación:
Afog = 10×ln(10)/V×(λ/550)−q (2)
donde V es la visibilidad en kilómetros (varía de 0,05 km a 10 km), λ es la longitud de onda en nanómetros (fijada en 1550 nm) y q es el coeficiente de distribución del tamaño de partículas calculado como: q = 1,6 para V>50 km, q = 1,3 para 6<V<50 km, q = 0,585×V(1/3) para 1 <V<6 km, q = 0 para 0,5<V<1 km y q = 0,5 para V<0,5 km. Para condiciones de lluvia, se utilizó el modelo de Carbonneau:
Arain=0.023×R0.93 (3)
donde R es la tasa de lluvia en mm/h (varió entre 0,25 y 50 mm/h según los registros pluviométricos de Irak). Se utilizó la relación de eficiencia de extinción para las condiciones de tormenta de polvo mediante la dispersión de Mie:
Adust=10×log₁₀(e(τ×L)) (4)
donde τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r es el radio de la partícula (0,1–100 μm según la composición del polvo iraquí), Qext es la eficiencia de extinción calculada utilizando la teoría de Mie, λ=1550 nm, m=1,55–0,005i es el índice de refracción complejo para el polvo del Oriente Medio, y N(r) es la distribución del tamaño de partículas modelada mediante una distribución log-normal con un radio medio geométrico de 2,5 μm y una desviación estándar de 2,0. El modelo de atenuación se implementó para condiciones de nieve de la siguiente manera:
Asnow = 0.1×S0.75 (5)
donde S es la tasa de nevada en mm/h (0,5–15 mm/h). Esta ecuación empírica se seleccionó con base en los trabajos existentes en la literatura30, donde se desarrollaron modelos de atenuación para la propagación óptica a través de la nieve utilizando la teoría de dispersión de Mie aplicada a las distribuciones del tamaño de los copos de nieve. La ecuación es válida para tasas de caída de nieve entre 0,5 y 15 mm/h y asume condiciones de nieve seca con diámetros típicos de copos de 1–10 mm. El coeficiente 0,1 y el exponente 0,75 se obtuvieron mediante ajuste de curvas a cálculos de dispersión de Mie30 para nieve a 1550 nm. No realiza ajustes para nieve húmeda ni precipitación combinada, que pueden tener propiedades de atenuación variables, aunque ofrece una estimación razonable para nieve seca. Debido a que este enfoque es computacionalmente eficaz, frecuentemente citado en publicaciones sobre comunicaciones ópticas en espacio libre (FSO) y adecuado para las condiciones de nieve previstas en el norte de Irak (región del Kurdistán en enero y febrero), fue seleccionado para esta investigación. Mediante el uso de Numpy para cálculos numéricos, todos los modelos se implementaron en Python 3.9. Se aplicó el modelo correspondiente a la condición meteorológica elegida aleatoriamente y a los datos ambientales muestreados para calcular el valor de atenuación de cada muestra. La distribución meteorológica obtenida incluyó 814 condiciones de cielo despejado (54,27 %), 375 eventos de polvo (25,00 %), 157 eventos de niebla (10,47 %), 111 eventos de lluvia (7,40 %) y 43 eventos de nieve (2,87 %).
El examen de la información meteorológica histórica recopilada de estaciones meteorológicas iraquíes en varias regiones (Bagdad, Basora, Mosul y Ramadi) entre 2020 y 2024 se utilizó para establecer las proporciones de las situaciones meteorológicas. Los datos originales fueron suministrados por el Ministerio de Transporte de Irak y la Organización Meteorológica y Sismológica de Irak (IMOS, por sus siglas en inglés). Los datos incluían registros meteorológicos diarios que registraban las condiciones atmosféricas actuales para cada día. Entre las características específicas extraídas de estos registros se encontraban la temperatura (mínima, máxima y media diarias), la humedad relativa, la visibilidad, la cantidad de precipitación y la ocurrencia de tormentas de polvo. Una parte de los datos de IMOS está disponible a través del portal de datos abiertos del gobierno iraquí (https://www.motrans.gov.iq/); sin embargo, los registros específicos utilizados en este estudio no se almacenan públicamente en un repositorio central. La información climática empleada para calcular los porcentajes de las condiciones meteorológicas y los valores de los parámetros se resume en la Tabla 1. Los días con cielo despejado se definieron como días sin precipitación, con visibilidad mayor a 10 km y sin actividad de polvo, representando el 54,27 % de los 1.825 días registrados. Los días con tormenta de polvo (incluyendo tormenta de polvo completa (visibilidad < 1 km) y tormenta de polvo parcial (visibilidad entre 1 y 10 km)) representaron el 22,08 % del total. Los días nublados se definieron como días sin precipitación ni actividad de polvo, pero con visibilidad ≤ 10 km debido a la nubosidad, y representaron el 15,34 % del total. Los días lluviosos se definieron como días con cualquier cantidad de precipitación registrada, independientemente de la visibilidad o la actividad de polvo, y representaron el 8,27 % del total. < 1 km) y polvo suspendido (visibilidad de 1–5 km)) representaron el 25,00 % de los días, lo que indica la alta frecuencia de eventos de tormentas de arena en el clima árido y semiárido de Irak. Los días con visibilidad inferior a 1 km causados por la suspensión de gotas de agua (excluyendo la reducción de visibilidad inducida por polvo) se clasificaron como días de niebla. El porcentaje de días de niebla fue del 10,47 %, y estos días fueron principalmente en invierno en las regiones del norte de Irak. Días de lluvia, días con precipitación medible >0,1 mm, fueron del 7,40 %, lo que es consistente con el bajo promedio de precipitaciones anuales en Irak, de 150–200 mm por año. Los días con nieve (días con acumulación de precipitación congelada) representaron el 2,87 % de los días y se limitaron a las zonas montañosas del norte (región de Kurdistán) en enero y febrero. Estas proporciones se utilizaron posteriormente como pesos de probabilidad para el muestreo aleatorio en la generación del conjunto de datos. Por lo tanto, el conjunto de datos sintético refleja la frecuencia real de cada condición meteorológica en el entorno iraquí.
Consideraciones sobre el sesgo en la generación de datos sintéticos
Se tomaron varias medidas para reducir el posible sesgo:
(1) Seleccione la distribución: Se utilizaron las propiedades estadísticas de los datos climáticos originales para seleccionar las distribuciones de probabilidad. La temperatura presentaba una distribución normal con una media y una desviación estándar según lo registrado por el IMOS. La humedad presentaba una distribución uniforme en todo el rango observado (0-100%). Se asumió que la visibilidad seguía una distribución log-normal para tener en cuenta la frecuente ocurrencia de eventos de baja visibilidad durante las tormentas de polvo. La concentración de polvo seguía una distribución exponencial, en la que había mayores probabilidades a bajas concentraciones y colas largas en eventos extremos de polvo31. Esto era consistente con la frecuencia observada de eventos de polvo en Irak32.
(2) Proporciones de condiciones meteorológicas: El análisis de los registros de IMOS para el período 2020–2024, que comprende 1.825 observaciones diarias en las cuatro regiones, arrojó las siguientes proporciones: 54,3 % de cielo despejado, 24,9 % de polvo, 10,5 % de niebla, 7,4 % de lluvia y 2,8 % de nieve. Se consideraron días con cielo despejado aquellos sin precipitación, con visibilidad >10 km y sin actividad de polvo. Los días con tormentas de polvo incluyeron tanto tormentas completas (visibilidad <1 km) como polvo suspendido (visibilidad entre 1 y 5 km). Un día de niebla se definió como un día en que la visibilidad fue inferior a 1 km y la causa fue la suspensión de gotas de agua (no polvo). Los días de lluvia se definieron como días con precipitación medible >0,1 mm. Los días de nieve se definieron como días con precipitación congelada acumulada33.
(3) Rangos de parámetros: Los rangos de parámetros se basaron en los valores extremos observados en los registros de IMOS: la temperatura varió desde −4.89 °C (Mosul, invierno) hasta 47.99 °C (Basra, verano), la visibilidad varió desde 0,05 km (tormentas de polvo severas) hasta 29,99 km (condiciones claras), y la concentración de polvo varió desde 0 hasta 4,96 mg/m3 (según la concentración máxima de polvo observada durante eventos severos de haboob)34.
(4) Supuestos de independencia: Se asumió que los parámetros ambientales se muestrearon de forma independiente, lo cual es una simplificación de las condiciones del mundo real en las que las variables atmosféricas están correlacionadas (por ejemplo, una alta concentración de polvo suele correlacionarse con baja visibilidad). Con el fin de proporcionar un entorno de simulación controlado para la comparación metódica de modelos, se adoptó este supuesto de independencia 35. Las consecuencias de estos supuestos se analizan en la Discusión.
(5) División estratificada: La división entre conjuntos de entrenamiento y prueba se realizó de forma estratificada según la categoría de condición meteorológica (cielo despejado, niebla, lluvia, polvo, nieve) para garantizar que la proporción de cada condición meteorológica en los conjuntos de entrenamiento y prueba correspondiera a la distribución del conjunto de datos original. De este modo, el conjunto de prueba no queda desequilibrado respecto a condiciones meteorológicas raras (especialmente nieve con un 2,87 %)36.
Reconocimiento de la generación determinista de objetivos
Es importante señalar que el buen rendimiento predictivo observado aquí puede deberse en parte al aprendizaje o aproximación por parte del modelo de las ecuaciones físicas deterministas utilizadas para generar los valores objetivo sintéticos37. A diferencia de las mediciones experimentales del mundo real, que contienen ruido de medición, errores instrumentales y fenómenos físicos no modelados, el conjunto de datos sintético proporciona una relación limpia y libre de ruido entre las variables de entrada y el objetivo de atenuación. Esto se debe a que los valores de atenuación se calcularon directamente a partir de modelos físicos de propagación (ley de Beer-Lambert, modelo de Kim, modelo de Carbonneau y teoría de dispersión de Mie) basados en los parámetros de entrada. Por lo tanto, las métricas cuantitativas de rendimiento (R2, RMSE, MAE) representan el desempeño sobre datos sintéticos derivados de ecuaciones y no deben interpretarse como el rendimiento esperado sobre datos observacionales o experimentales con ruido. Los resultados deben considerarse principalmente como una evaluación comparativa de metodologías de modelado en un entorno de simulación controlado38.
Conjunto completo de características para el entrenamiento del modelo
El conjunto de datos de entrenamiento tenía 10 características de entrada para el entrenamiento del modelo:
1. Temperatura (°C)
2. Humedad (%)
3. Visibilidad (km)
4. Concentración de polvo (mg/m3)
5. Tasa de precipitación (mm/h)
6. Tasa de precipitación de nieve (mm/h)
7. Velocidad del viento (m/s)
8. Presión atmosférica (hPa)
9. Mes (numérico, 1–12)
10. Estación (codificada como variables ficticias: primavera, verano, otoño, invierno)
Aclaración importante: Las condiciones meteorológicas (cielo despejado, niebla, lluvia, polvo, nieve) se utilizaron como una variable categórica para la estratificación durante la división del conjunto de datos y no se incluyeron como características de entrada para ningún modelo. El análisis SHAP incluye únicamente las 10 características enumeradas anteriormente. La variable estacional se codificó mediante variables ficticias (4 categorías: primavera, verano, otoño, invierno), y para el análisis SHAP, las contribuciones de las variables estacionales codificadas se sumaron a través de las estaciones para producir un único valor de contribución estacional. Este valor combinado representa la contribución total de todas las variables relacionadas con la estación al pronóstico de atenuación. Antes de crear la figura resumen, se identificaron las cuatro columnas estacionales codificadas mediante variables ficticias, y sus valores SHAP se sumaron para cada muestra. Este método garantiza que el uso que hace el modelo de la estación como variable categórica compuesta sea coherente con el análisis SHAP.
Los principales factores ambientales que afectaron directamente la atenuación óptica mediante mecanismos físicos fueron las características 1–6. La inclusión de las características 7 y 8 (velocidad del viento y presión) como factores meteorológicos complementarios podría tener un impacto indirecto sobre la atenuación, al influir en la estabilidad del aire y en la dispersión de aerosoles. Con el fin de considerar las variaciones estacionales en las condiciones atmosféricas, se incluyeron las características 9–10 (mes y estación) como descriptores temporales. El valor de atenuación (dB/km) se utilizó como variable objetivo para todos los modelos. Las estadísticas clave del conjunto de datos incluyeron temperatura (28,55°C ± 11,18°C), humedad (42,01% ± 25,56%), visibilidad (13,10 ± 10,91 km; rango: 0,05–29,99 km), concentración de polvo (0,74 ± 1,30 mg/m3; máximo: 4,96 mg/m3), atenuación (4,80 ± 7,20 dB/km; rango: 0,09–50,93 dB/km), rango de operación (5,74 ± 1,97 km) y relación señal-ruido (64,88 ± 15,07 dB). El rango de operación y la relación señal-ruido se calcularon a partir de los valores de atenuación utilizando ecuaciones estándar de presupuesto de enlace FSO.
Cálculo del rango de operación
El Rango de Operación (en km) se calculó utilizando la ecuación del presupuesto de enlace:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
donde: Prx = potencia recibida (ajustada a la sensibilidad mínima de −30 dBm); Ptx = potencia de transmisión (fija en 20 dBm); Gt = ganancia del transmisor (calculada a partir de los tamaños de apertura); Gr = ganancia del receptor (calculada a partir de los tamaños de apertura); λ = longitud de onda (1550 nm); R = alcance en km; A = atenuación atmosférica en dB/km (calculada a partir de los modelos físicos).
Ganancias del transmisor y del receptor: La ganancia del transmisor (Gt) se calculó como: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. La ganancia del receptor (Gr) se calculó como: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. La abertura de transmisión tenía un diámetro de 2.5 cm, con una eficiencia de 0.7. La abertura receptora tenía un diámetro de 20 cm, con una eficiencia de 0.7. La ecuación se resolvió iterativamente para R a fin de determinar la distancia máxima de enlace alcanzable para cada valor de atenuación.
Cálculo de la relación señal-ruido
La RSE (relación señal-ruido) en dB se calculó utilizando la ecuación:
SNR=Prx−10×log₁₀(kTB)−NF (7)
donde: Prx = potencia recibida en dBm (calculada a partir del presupuesto de enlace); k = 1.38×10⁻23 J/K (constante de Boltzmann); T = 290 K (temperatura del receptor); B = 109 Hz (ancho de banda del receptor, 1 GHz); NF = 3 dB (figura de ruido del receptor). El nivel de ruido se calculó como:
10 × log10(kTB) ≈ −84 dBm (8)
Para cada muestra, después de calcular la atenuación A utilizando el modelo físico apropiado, se determinó el Rango de Operación resolviendo el presupuesto de enlace para R, y se calculó la relación señal-ruido (SNR) a partir de la potencia recibida resultante Prx a ese rango.
Valores del Rango de Operación según las Condiciones Meteorológicas: El rango de operación varió según las condiciones meteorológicas: cielo despejado (7,12 ± 1,85 km), niebla (5,81 ± 1,92 km), nieve (5,42 ± 1,56 km), lluvia (3,81 ± 0,98 km) y polvo (3,72 ± 1,08 km). No se aplicó un margen de 3 dB en los cálculos actuales; el rango de operación representa el rango máximo teórico sin margen del sistema. El rango de operación informado (5,74 ± 1,97 km) es la media general en todas las condiciones meteorológicas39.
Distancia de transmisión fija: La distancia de transmisión en los modelos de atenuación física se estableció en 3 km. Esta es la distancia del enlace para la cual se realizaron los cálculos de atenuación. El rango de operación informado es la distancia máxima teórica calculada mediante la ecuación del presupuesto de enlace, que puede diferir de la distancia de transmisión fija de 3 km. Los valores de atenuación específicos según el clima se registraron para condiciones despejadas (0,27±0,06 dB/km), niebla (1,88±1,92 dB/km), nieve (6,45±2,54 dB/km), lluvia (13,58±6,32 dB/km) y polvo (13,10±7,32 dB/km). Todos los valores cuantitativos informados en este manuscrito se presentan como media ± desviación estándar (DE), salvo que se indique lo contrario40.
Se informa un R2 de validación cruzada de 0,960±0,007 para el bosque aleatorio. En ciertos casos, como la temperatura (−4,89 a 47,99 °C), la visibilidad (0,05 a 29,99 km), la concentración de polvo (0 a 4,96 mg/m3) y la atenuación (0,09 a 50,93 dB/km), el rango (mínimo a máximo) se indica verbalmente. El conjunto de datos se dividió en subgrupos para pruebas (300 muestras; 20 %) y entrenamiento (1.200 muestras; 80 %). Se utilizó muestreo aleatorio estratificado para realizar la división entre entrenamiento y prueba. Para asegurar que el porcentaje de cada condición meteorológica en el conjunto de entrenamiento (80 %) y el conjunto de prueba (20 %) coincidiera con la distribución del conjunto de datos original, se aplicó estratificación basada en la categoría de condición meteorológica (cielo despejado, niebla, lluvia, polvo y nieve). En particular, 1.200 (80 %) de las 1.500 muestras se asignaron al conjunto de aprendizaje y 300 (20 %) al conjunto de prueba. Las muestras se seleccionaron al azar para cada categoría de condiciones meteorológicas manteniendo las proporciones originales: de las 814 muestras de cielo despejado (54,27 %), 651 se asignaron al entrenamiento y 163 a la prueba; de las 375 muestras de polvo (25,00 %), 300 al entrenamiento y 75 a la prueba; de las 157 muestras de niebla (10,47 %), 126 al entrenamiento y 31 a la prueba; de las 111 muestras de lluvia (7,40 %), 89 al entrenamiento y 22 a la prueba; de las 43 muestras de nieve (2,87 %), 34 al entrenamiento y 9 a la prueba. El muestreo aleatorio dentro de cada estrato se realizó utilizando una semilla aleatoria de 42 para garantizar la reproducibilidad. Este enfoque estratificado se eligió para evitar una representación desequilibrada de las condiciones meteorológicas raras (especialmente la nieve con un 2,87 %) en el conjunto de prueba, lo cual podría llevar de otro modo a una evaluación poco confiable del rendimiento para dichas condiciones.
Evaluación del modelo de aprendizaje automático
Se evaluaron seis métodos de aprendizaje automático, incluyendo Regresión por Vectores de Soporte (SVR) con un kernel de función de base radial (C = 100), K-Vecinos Más Cercanos (KNN; k = 10, con ponderación por distancia), RF (200 árboles, profundidad máxima = 20), Potenciación Extrema del Gradiente (XGBoost; 200 estimadores, profundidad máxima = 10, tasa de aprendizaje = 0.1), Máquina de Potenciación del Gradiente Ligera (LightGBM; 200 estimadores, profundidad máxima = 10, tasa de aprendizaje = 0.1) y regresión lineal básica. Para todos los modelos de aprendizaje automático y aprendizaje profundo, se realizó ajuste de hiperparámetros en los parámetros más críticos, mientras que se mantuvieron los valores predeterminados para los parámetros no especificados. Para los modelos de aprendizaje automático, los siguientes parámetros se ajustaron explícitamente mediante búsqueda en cuadrícula con validación cruzada de 5 pliegues sobre el conjunto de entrenamiento: 1) Bosque Aleatorio: número de árboles (probados: 50, 100, 150, 200, 250) y profundidad máxima (probada: 10, 15, 20, 25, sin límite), seleccionándose los valores óptimos de 200 árboles y profundidad 20. 2) XGBoost: número de estimadores (probados: 100, 150, 200, 250), profundidad máxima (probada: 6, 8, 10, 12) y tasa de aprendizaje (probada: 0.05, 0.1, 0.2), seleccionándose 200 estimadores, profundidad 10 y tasa de aprendizaje 0.1. 3) LightGBM: se utilizaron rangos idénticos de ajuste, resultando en 200 estimadores, profundidad 10 y tasa de aprendizaje 0.1. 4) SVR: se ajustó el parámetro de regularización C (probado: 1, 10, 50, 100) y el coeficiente del kernel gamma (probado: ‘scale’, ‘auto’, 0.1, 0.01), seleccionándose C = 100 y kernel RBF. 5) KNN: se ajustó el número de vecinos k (probado: 3, 5, 7, 10, 15), seleccionándose k = 10 y habilitándose la votación ponderada por distancia.
Todos los demás parámetros para estos modelos se dejaron en sus valores predeterminados según lo definido en scikit-learn (véase la Tabla de materiales para la versión; por ejemplo, Bosque aleatorio: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). Para los modelos de aprendizaje profundo, la arquitectura (número de capas y unidades por capa) y la tasa de abandono (20 %) se ajustaron manualmente mediante experimentación iterativa sobre el conjunto de validación, mientras que el optimizador (Adam), la tasa de aprendizaje inicial (0,001), la paciencia del detención anticipada (20 épocas) y los parámetros de reducción de la tasa de aprendizaje (factor 0,5, paciencia 10) se establecieron según las prácticas estándar en la literatura y se mantuvieron fijos en todos los experimentos de aprendizaje profundo.
Fuentes de datos climáticos
Se utilizó la información meteorológica histórica recopilada de estaciones meteorológicas iraquíes en varios lugares (Bagdad, Basora, Mosul y Ramadi) entre 2020 y 2024 para calcular las proporciones de los estados climáticos y las distribuciones de las variables. Los datos brutos fueron proporcionados por el Ministerio de Transporte de Irak y por la Organización Meteorológica de Irak y Sismología (IMOS). Los datos incluyeron registros diarios que detallaban el estado atmosférico predominante en cada día. Las variables específicas obtenidas de estos registros incluyeron temperatura (mínima, máxima y media diaria), humedad relativa, visibilidad, cantidad de lluvia y ocurrencias de tormentas de polvo. Los datos de IMOS están parcialmente disponibles a través del portal de datos abiertos del gobierno iraquí (https://www.motrans.gov.iq/), aunque los registros específicos utilizados en este estudio no están archivados públicamente en un repositorio centralizado. Se proporciona un resumen de los datos climáticos empleados para determinar las proporciones de las condiciones meteorológicas y los rangos de los parámetros en Tabla 1.
Se utilizó una validación cruzada de cinco pliegues en el conjunto de entrenamiento (1.200 muestras) para ajustar los hiperparámetros y estimar el rendimiento de todos los modelos de aprendizaje automático. Todas las variables de entrada (temperatura, humedad, visibilidad, concentración de polvo, tasa de lluvia, tasa de nieve, velocidad del viento, presión) se escalaron mediante estandarización (normalización Z-score): x_scaled = (x − μ)/σ, donde μ y σ son la media y la desviación estándar del conjunto de entrenamiento. Se realizó la estandarización dentro de cada pliegue de validación cruzada utilizando únicamente las estadísticas del pliegue de entrenamiento para evitar fugas de datos. Los modelos basados en árboles (Bosque Aleatorio, XGBoost, LightGBM) son invariantes a la escala, pero se aplicó la misma estandarización para mantener la coherencia entre todos los modelos de aprendizaje automático. Para los modelos de aprendizaje profundo se utilizó la normalización min-máx: x_scaled = (x−x_min)/(x_max−x_min), que escala las características al intervalo [0, 1] según los valores mínimos y máximos del conjunto de entrenamiento. Las entradas acotadas permiten una convergencia más rápida de las redes neuronales, razón por la cual se eligieron. El conjunto de prueba se escaló utilizando los parámetros obtenidos del conjunto de entrenamiento, y no se utilizó para selección de modelos ni ajuste de hiperparámetros.
Se registraron métricas completas de rendimiento, incluyendo el coeficiente de determinación de prueba (R2), el error cuadrático medio (RMSE), el error absoluto medio (MAE), el R2 de validación cruzada y el tiempo de entrenamiento. Los tiempos de entrenamiento para todos los modelos de aprendizaje automático y aprendizaje profundo se reportan en segundos (s) para los modelos más rápidos (Regresión Lineal, KNN, SVR, Bosque Aleatorio, XGBoost, LightGBM) y en minutos (min) para los modelos más lentos (arquitecturas de aprendizaje profundo). Todos los modelos se entrenaron en el mismo entorno computacional para garantizar una comparación justa41.
El tiempo de entrenamiento se midió utilizando el módulo de tiempo de Python, es decir, el tiempo real transcurrido desde el inicio hasta el final de la función de ajuste del modelo, excluyendo el tiempo necesario para la carga y el preprocesamiento de los datos. El tiempo de entrenamiento para un modelo de aprendizaje profundo es el tiempo necesario para completar todas las épocas hasta el detención anticipada. Esto incluye la propagación hacia adelante, la propagación hacia atrás y las comprobaciones de validación. Todos los experimentos se realizaron con el sistema ejecutando ningún otro proceso computacionalmente intensivo para obtener mediciones de tiempo consistentes. Los tiempos corresponden al promedio de 5 ejecuciones independientes (desviaciones estándar)42.
Evaluación del modelo de aprendizaje profundo
Se evaluaron seis arquitecturas de aprendizaje profundo utilizando aceleración mediante GPU, incluyendo un perceptrón multicapa (MLP; 64-32-16), una red neuronal profunda (DNN) con normalización por lotes (128-64-32-16), una red neuronal de memoria a corto y largo plazo (LSTM; 64-32 unidades, longitud de secuencia = 10), una red neuronal convolucional unidimensional (1D-CNN), un modelo híbrido CNN-LSTM y una red basada en mecanismos de atención. Todos los modelos de aprendizaje profundo se implementaron utilizando TensorFlow con la API de Keras y se ejecutaron con aceleración mediante GPU (véase la Tabla de Materiales para las versiones de hardware y software). La arquitectura 1D-CNN constó de tres capas convolucionales (64, 128 y 256 filtros, tamaño del núcleo 3, activación ReLU, padding=’same’), dos capas MaxPooling1D (tamaño del grupo 2), una capa GlobalAveragePooling1D, una capa densa con 128 unidades y activación ReLU, una capa Dropout (0,2) y una capa de salida densa (1 unidad, activación lineal), con un total aproximado de 245 000 parámetros entrenables. La arquitectura híbrida CNN-LSTM aceptó secuencias de entrada de 10 pasos temporales con 5 características, utilizando dos capas Conv1D (64 y 128 filtros, tamaño del núcleo 3, ReLU, padding=’same’), una capa MaxPooling1D (tamaño del grupo 2), dos capas LSTM (64 y 32 unidades, return_sequences=False), capas Dropout (0,2), una capa densa (32 unidades, ReLU) y una capa de salida densa (1 unidad, activación lineal), con un total aproximado de 198 000 parámetros entrenables. La red basada en atención utilizó un mecanismo de atención de múltiples cabezas con 4 cabezas (dimensiones de clave y valor de 64), en la que la entrada se proyectó a 64 dimensiones, seguida de atención de producto escalar (fórmula: Attention(Q, K, V) = softmax(QKT/√d_k)V), conexiones residuales, normalización de capa, una red de alimentación directa (128→64 unidades), agrupamiento promedio global, Dropout (0,2), una capa densa (32 unidades, ReLU) y una capa de salida densa (1 unidad, activación lineal), con un total aproximado de 167 000 parámetros entrenables43.
Todos los modelos utilizaron parada temprana (paciente = 20), reducción de la tasa de aprendizaje (factor = 0,5, paciente = 10), dropout (20 %) y el optimizador Adam (tasa de aprendizaje = 0,001). Para todos los modelos de aprendizaje profundo, el tamaño del lote se estableció en 32 muestras, el número máximo de épocas de entrenamiento fue de 200 con parada temprana (paciente = 20, restaurando los mejores pesos), y la función de pérdida fue el error cuadrático medio (MSE). La división entre entrenamiento y validación fue la siguiente: de las 1.200 muestras originales de entrenamiento (tras la división 80/20 entre entrenamiento y prueba), el 80 % (960 muestras) se usaron para entrenamiento y el 20 % (240 muestras) para validación. Se estratificó la división entre entrenamiento y validación según la condición meteorológica para conservar la distribución. El conjunto de validación se utilizó únicamente para la parada temprana, la disminución de la tasa de aprendizaje y la monitorización del sobreajuste; nunca se empleó para la selección del modelo ni para el ajuste de hiperparámetros más allá de estos procedimientos automatizados. No se reservó un conjunto de validación independiente para los modelos de aprendizaje automático; en su lugar, se utilizó una validación cruzada de cinco pliegues sobre las 1.200 muestras de entrenamiento para ajustar los hiperparámetros y estimar el rendimiento44.
Justificación para la evaluación de las arquitecturas LSTM y CNN–LSTM
El conjunto de datos principal consiste en muestras de clima generadas de forma independiente, pero también evaluamos arquitecturas LSTM y CNN–LSTM por las siguientes razones: (1) las condiciones atmosféricas del mundo real están autocorrelacionadas en el tiempo y probar modelos basados en secuencias nos permite determinar si capturar tales dependencias podría mejorar la precisión de las predicciones; (2) investigaciones recientes en predicción atmosférica han demostrado el valor potencial de arquitecturas secuenciales para modelar la evolución temporal de parámetros meteorológicos34; (3) probar una amplia gama de arquitecturas asegura una comparación exhaustiva de enfoques metodológicos, lo cual es una contribución clave de este estudio; y (4) la arquitectura híbrida CNN–LSTM combina la extracción de características espaciales con modelado temporal, lo que podría ser beneficioso para capturar las interacciones complejas entre múltiples variables atmosféricas45.
Formato de datos para la entrada del modelo secuencial
Para las arquitecturas secuenciales (LSTM y CNN-LSTM), los datos de entrada se reorganizaron a partir de muestras independientes en pseudo-secuencias utilizando un enfoque de ventana deslizante. En particular, las 1.200 muestras de entrenamiento se agruparon primero en categorías de condiciones meteorológicas para preservar la coherencia física. Dentro de cada categoría meteorológica, las muestras se ordenaron según sus marcas de tiempo generadas (observaciones simuladas por hora para el año calendario 2024). Luego, se aplicó una ventana deslizante de longitud 10 para producir secuencias de entrada de 10 pasos de tiempo consecutivos (cada uno con 5 características: temperatura, humedad, visibilidad, concentración de polvo y tasa de precipitación) para predecir la atenuación en el 11º paso de tiempo. Este método conserva el orden temporal de las observaciones simuladas, permitiendo al mismo tiempo que los modelos secuenciales aprendan las dependencias temporales. La estructura del conjunto de prueba fue la misma, excepto que se utilizó el mismo tamaño de ventana y conjunto de características. Reconocemos que esta estructuración pseudo-secuencial es una simplificación metodológica y no refleja las dinámicas temporales del mundo real. Hemos reconocido esto como una limitación en la sección de Discusión.
Evaluación de enfoques híbridos
Se examinaron tres enfoques híbridos. El primer enfoque fue un conjunto de votación que promedió las predicciones de los modelos de Bosque Aleatorio, XGBoost y Red Neuronal Profunda utilizando pesos iguales (a cada modelo se le asignó un peso de 1/3), con la predicción final calculada como:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
Se eligió un peso igual para evitar la introducción de hiperparámetros adicionales y para evaluar el rendimiento base del conjunto sin sesgo hacia ningún modelo individual. El segundo enfoque empleó un ensamblaje con metaaprendiz Ridge. Los aprendices base fueron Bosque Aleatorio, XGBoost y una Red Neuronal Profunda (basada en Atención). El procedimiento de ensamblaje constó de dos etapas: primero, cada aprendiz base se entrenó con el conjunto completo de entrenamiento de 1.200 muestras utilizando validación cruzada de 5 pliegues para generar predicciones fuera del pliegue, creando así una nueva matriz de metacaracterísticas de tamaño 1.200×3 (una predicción por modelo base por muestra). Segundo, se entrenó un metaaprendiz de regresión Ridge (parámetro de regularización L2 alpha=1,0) con estas metacaracterísticas, utilizando los valores originales de atenuación como objetivo, para aprender los pesos óptimos de combinación de los aprendices base. La predicción final del ensamblaje fue:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
donde los pesos w fueron aprendidos por el metaaprendiz Ridge. El tercer enfoque fue una red neuronal basada en principios físicos que combinó el 70 % de las predicciones de la red neuronal con el 30 % del modelo de Kim para muestras de condiciones de neblina. La combinación se realizó mediante un promedio ponderado fijo utilizando la siguiente fórmula:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
donde ŷneural es la salida de la red neuronal basada en atención, y ŷKim es la atenuación calculada a partir del modelo de niebla de Kim en función de la visibilidad de entrada. Para muestras sin niebla, la parte física se estableció en 0, y el modelo se ejecutó como una red neuronal pura. Los pesos (70 % neuronal y 30 % física) se fijaron según experimentación preliminar en el conjunto de validación (no en el conjunto de prueba), en la cual probamos combinaciones de pesos de 90:10, 80:20, 70:30, 60:40 y 50:50. Se eligió la división 70:30 porque proporcionó el mejor valor de R2 en validación y aún mantenía una restricción física suficiente del modelo de Kim para regular las predicciones y evitar resultados físicamente inverosímiles, especialmente en condiciones de niebla, donde el modelo de Kim ofrece límites teóricos establecidos de atenuación.
Análisis de importancia y capacidad de interpretación de características
Se utilizó el modelo de bosque aleatorio con importancia de características basada en la impureza (reducción de la varianza) para extraer todos los 10 rangos de importancia de las características de entrada. El análisis mostró que la concentración de polvo (67,3 %) y la visibilidad (21,2 %) fueron los predictores más importantes, explicando conjuntamente el 88,5 % de la importancia predictiva total. La tercera característica más importante fue la tasa de lluvia (6,0 %), seguida de la velocidad del viento (2,1 %), la temperatura (1,5 %), la humedad (0,9 %), el mes (0,5 %), la estación (0,3 %), la tasa de nevada (0,1 %) y la presión atmosférica (0,1 %). Los bajos puntajes de importancia para las características temporales (mes y estación) indican que la variación estacional en la atenuación atmosférica se captura principalmente mediante parámetros ambientales subyacentes, y no únicamente mediante patrones basados en el tiempo.
Se realizó un análisis SHAP (Shapley Additive exPlanations) para evaluar las relaciones entre los factores ambientales y la atenuación. La implementación de SHAP utilizada fue el módulo TreeExplainer de la biblioteca SHAP, que está específicamente optimizado para modelos basados en árboles, incluyendo Random Forest, XGBoost y LightGBM (véase la Tabla de Materiales para la versión). La configuración del análisis SHAP fue la siguiente: se introdujo el modelo Random Forest entrenado en el TreeExplainer, el cual calculó los valores SHAP mediante el enfoque de atribución de características interventiva (marginal), basado en la esperanza condicional de la salida del modelo. Se calcularon valores SHAP para las 300 muestras del conjunto de prueba, generando una matriz de tamaño 300 × 10 (un valor SHAP por característica por muestra). Para cada característica, el valor SHAP representó su contribución a la predicción en relación con la línea base (la predicción promedio del modelo). Los valores SHAP negativos indicaron una reducción; mientras que los valores SHAP positivos indicaron que la característica aumentó la predicción de atenuación. La magnitud del valor SHAP indicó la intensidad de la contribución. La distribución de los valores SHAP para cada característica (mediante gráficos de abeja), la dirección de la influencia (la correlación entre los valores de las características y los valores SHAP) y los rangos de importancia de las características se visualizaron todos mediante gráficos resumen. Se utilizaron las funciones de graficación integradas de la biblioteca SHAP —shap.summary_plot() para el gráfico de abeja y shap.bar_plot() para la importancia global de las características— para crear todas las visualizaciones SHAP.
Manejo de variables codificadas en una sola clase: Primero, se utilizaron cuatro columnas binarias (primavera, verano, otoño e invierno) para codificar la variable estación. Con el fin de crear un único valor de contribución de «estación» por muestra para el análisis SHAP, se combinaron las contribuciones de estas cuatro variables codificadas en una sola clase sumando los valores SHAP para cada categoría estacional. Para lograr esta agrupación, se identificaron todas las columnas que correspondían a los grupos estacionales codificados en una sola clase, se extrajeron sus valores SHAP para cada muestra y luego se sumaron elemento por elemento. Los valores SHAP combinados resultantes representan la contribución general de la estación a la predicción de atenuación. Este método permite una única fila de «estación» en el gráfico resumen SHAP y garantiza coherencia con el uso que hace el modelo de la estación como una variable categórica compuesta. Dado que el valor combinado ofrece una representación más comprensible de la contribución total de la estación, los valores SHAP de la estación no se mostraron por separado para cada categoría estacional.
Resultados
Las características del conjunto de datos sintético se resumen en la Figura 1A–F. El conjunto de datos incluyó condiciones de cielo despejado, polvo, niebla, lluvia y nieve (Figura 1A), con muestras distribuidas entre temporadas cálidas-secas y frías-húmedas (Figura 1B) y períodos diurnos y nocturnos (Figura 1C). Las distribuciones de temperatura, humedad y visibilidad bajo diferentes condiciones meteorológicas se muestran en la Figura 1D–F.
Los modelos de aprendizaje automático demostraron un rendimiento predictivo sólido en la estimación de la atenuación atmosféricaFigura 2A–D; Tabla 3). RF obtuvo el mejor rendimiento general entre los modelos evaluados, con un valor de R de prueba2 de 0.9654 y un RMSE de 1,324 dB/km (Figura 2A; Tabla 3). RF explicó el 96,54 % de la variación observada manteniendo un valor inferior a 1,5 Error de predicción en dB/km. XGBoost también tuvo un buen desempeño (Figura 2C), seguido de LightGBM (Figura 2B). La solidez del modelo fue respaldada mediante validación cruzada de cinco pliegues, con RF alcanzando un coeficiente R de validación cruzada2 de 0,960 ± 0.007 (Figura 2D). En contraste, K-Vecinos Más Cercanos mostró signos de sobreajuste, con un R de entrenamiento2 de 1.000 y una prueba R2 de 0.7341, mientras que la Regresión Lineal alcanzó un rendimiento predictivo moderado (Figura 2A; Tabla 3).
El análisis de la importancia de las características de las 10 características de entrada mencionadas anteriormente se muestra en la Figura 3A. Las puntuaciones de importancia relativa se clasifican de la siguiente manera: concentración de polvo (67,3 %), visibilidad (21,2 %), tasa de lluvia (6,0 %), velocidad del viento (2,1 %), temperatura (1,5 %), humedad (0,9 %), mes (0,5 %), estación (0,3 %), tasa de nevada (0,1 %) y presión (0,1 %). La variable «condición meteorológica» se utiliza para la estratificación del conjunto de datos, pero no se incluye en el análisis de importancia de las características porque es una variable compuesta categórica que representa varios parámetros físicos subyacentes, y su efecto queda capturado por las características ambientales individuales. Los análisis de importancia y de interpretabilidad de las características identificaron las variables ambientales más estrechamente asociadas con la atenuación (Figura 3A,B). La concentración de polvo (67,3 %), la visibilidad (21,2 %) y la tasa de lluvia (6,0 %) representaron colectivamente el 94,4 % de la importancia predictiva total (Figura 3A). El análisis SHAP demostró además que un aumento en la concentración de polvo y una disminución en la visibilidad estaban asociados con predicciones mayores de atenuación (Figura 3B).
Los modelos de aprendizaje profundo mostraron un rendimiento predictivo inferior al de los enfoques de aprendizaje automático (Figura 4A–D). El modelo de aprendizaje profundo con mejor desempeño, la red basada en atención, alcanzó un valor de R2 de 0,7766 y un RMSE de 3,362 dB/km (Figura 4A). Las arquitecturas recurrentes mostraron un rendimiento particularmente deficiente, con ambos modelos LSTM y CNN–LSTM produciendo valores de R2 cercanos a cero y valores de RMSE superiores a 7,19 dB/km (Figura 4B). El rendimiento relativamente bajo de las arquitecturas LSTM y CNN-LSTM (R2 = 0,0110 y 0,0109, respectivamente; RMSE = 7,193 dB/km y 7,196 dB/km) puede explicarse parcialmente por la naturaleza pseudo-secuencial de los datos de entrada, que no captura completamente la verdadera dinámica temporal de las condiciones atmosféricas.
A diferencia de las aplicaciones de series temporales reales, donde las dependencias secuenciales son fuertes y bien definidas, nuestro conjunto de datos consistía principalmente en muestras independientes con un orden temporal impuesto artificialmente. El bajo rendimiento predictivo de estas arquitecturas sugiere que la información temporal extraída mediante el enfoque de ventana deslizante fue insuficiente o no representativa de la evolución atmosférica real (Figura 4C). Esto respalda nuestra conclusión de que, para conjuntos de datos de esta naturaleza, enfoques más simples de aprendizaje automático son más adecuados que modelos complejos de aprendizaje profundo basados en secuencias. El rendimiento de validación de todas las arquitecturas de aprendizaje profundo se resume en la Figura 4D.
El rendimiento de los enfoques de aprendizaje automático, aprendizaje profundo y métodos híbridos se resume en la Figura 5A,B y en la Tabla 3. Entre los métodos híbridos, el ensamblaje de votación alcanzó un valor de R2 de 0,9340 y un RMSE de 1,827 dB/km (Figura 5A,B; Tabla 3). La combinación de modelos mediante aprendiz meta con regresión ridge logró un R2 de 0,9571 y un RMSE de 1,473 dB/km (Figura 5A,B; Tabla 3), acercándose al rendimiento del bosque aleatorio (RF), aunque requirió tiempos de entrenamiento considerablemente más largos. La red neuronal informada por física alcanzó un R2 = 0,8269 y un RMSE = 2,960 dB/km (Figura 5A,B; Tabla 3) y tuvo un mejor desempeño que los modelos de aprendizaje profundo, aunque no tan bueno como los mejores enfoques de aprendizaje automático. La comparación estadística entre los modelos de RF y el ensamblaje por combinación indicó que no hubo diferencia significativa en el rendimiento predictivo (Tabla 3; prueba t pareada: t = −1,74, p = 0,083). Por lo tanto, aunque el RF obtuvo el valor numérico de R2 más alto, la diferencia respecto al mejor enfoque híbrido no fue estadísticamente significativa.
En general, los resultados respaldan la hipótesis de que los enfoques de aprendizaje automático pueden predecir con precisión la atenuación atmosférica bajo condiciones climáticas iraquíes. El bosque aleatorio (RF) logró consistentemente el rendimiento predictivo más alto (Figura 2A,B; Tabla 3), mientras que los análisis de importancia de características y SHAP identificaron la concentración de polvo y la visibilidad como los factores ambientales dominantes que influyen en la atenuación (Figura 3A,B).
Declaración sobre los datos de validación: Todas las evaluaciones del modelo se realizaron con el conjunto de datos sintéticos descrito en la sección Métodos. No se utilizaron datos experimentales u observacionales sobre atenuación atmosférica en la validación del modelo. El conjunto de datos sintéticos se creó empleando modelos físicos de propagación bien conocidos (ley de Beer-Lambert, modelo de Kim, modelo de Carbonneau y teoría de dispersión de Mie) con parámetros meteorológicos seleccionados a partir de distribuciones de probabilidad basadas en registros climáticos de Irak. Como se indicó en la sección Métodos, el alto rendimiento predictivo podría reflejar en parte el aprendizaje del modelo o su aproximación a las ecuaciones físicas deterministas utilizadas para generar los valores objetivo. Por lo tanto, las métricas cuantitativas de rendimiento (R2, RMSE, MAE) representan el desempeño sobre datos sintéticos derivados de ecuaciones y deben interpretarse como comparaciones relativas entre metodologías de modelado en un entorno de simulación controlado, y no como garantías absolutas de rendimiento para sistemas FSO operativos. Este enfoque proporciona un entorno controlado para la evaluación comparativa de metodologías de modelado predictivo (como se enumeran en Tabla 2), pero no sustituye la validación con mediciones reales de atenuación FSO bajo condiciones climáticas reales en Irak.
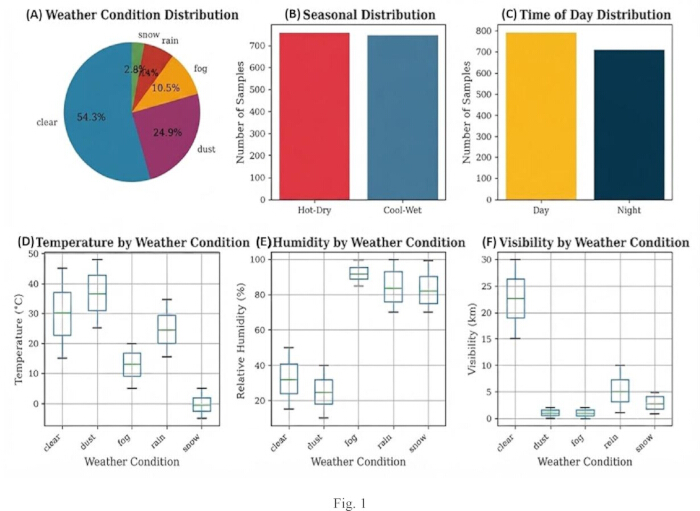
Figura 1: Características del conjunto de datos sintético y variables ambientales utilizadas para la modelización de la atenuación atmosférica. (A) Distribución de las condiciones meteorológicas representadas en el conjunto de datos, incluyendo situaciones de cielo despejado, polvo, niebla, lluvia y nieve. (B) Distribución estacional de las muestras durante los períodos cálidos-secos y fríos-húmedos. (C) Distribución de las muestras recolectadas durante condiciones diurnas y nocturnas. (D) Distribuciones de temperatura para cada condición meteorológica. (E) Distribuciones de humedad para cada condición meteorológica. (F) Distribuciones de visibilidad para cada condición meteorológica. Los diagramas de caja muestran la mediana (línea central), el rango intercuartílico (caja) y los valores mínimo y máximo (bigotes). La temperatura se reporta en °C, la humedad en % y la visibilidad en km. Haga clic aquí para ver una versión ampliada de esta figura.
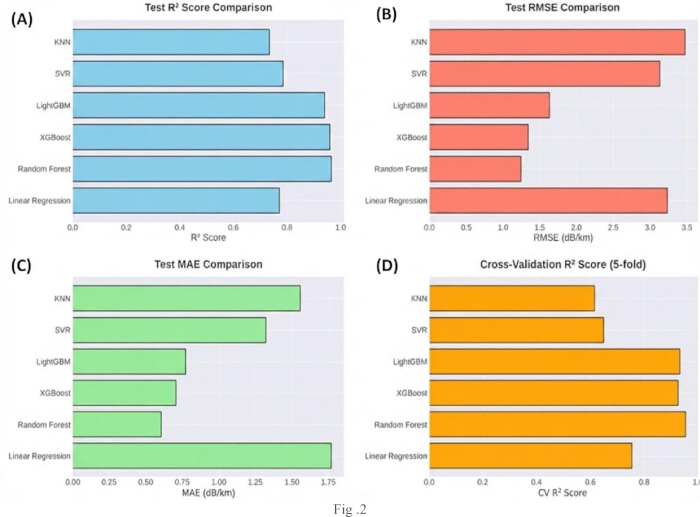
Figura 2: Comparación del rendimiento de modelos de aprendizaje automático para la predicción de atenuación atmosférica. (A) Puntuaciones del coeficiente de determinación (R2) en la prueba para los modelos de aprendizaje automático evaluados, incluyendo Regresión Lineal, Bosque Aleatorio, Potenciación Extrema del Gradiente (XGBoost), Máquina de Potenciación Ligera del Gradiente (LightGBM), Regresión por Vectores de Soporte (SVR) y K-Vecinos Más Cercanos (KNN). (B) Valores de error cuadrático medio (RMSE) en la prueba para cada modelo de aprendizaje automático. (C) Valores de error absoluto medio (MAE) en la prueba para cada modelo de aprendizaje automático. (D) Puntuaciones del coeficiente de determinación (R2) obtenidas mediante validación cruzada de cinco particiones. Valores más altos de R2 y valores más bajos de RMSE y MAE indican un mejor rendimiento predictivo. RMSE y MAE se reportan en dB/km. Haga clic aquí para ver una versión más grande de esta figura.
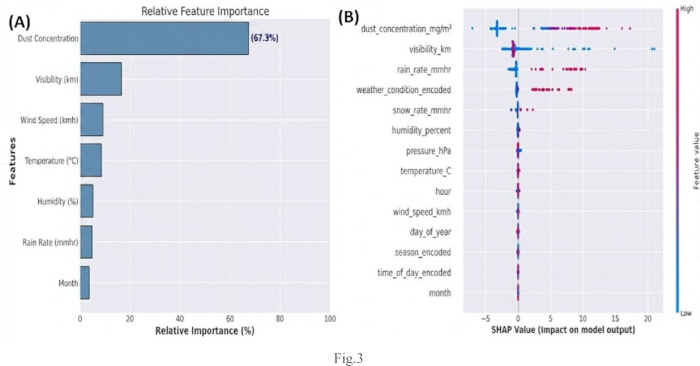
Figura 3: Análisis de importancia de características e interpretabilidad del modelo para la predicción de atenuación atmosférica. (A) Clasificación relativa de la importancia de las características basada en la impureza del modelo Random Forest, que muestra la contribución de las 10 variables ambientales y temporales a la predicción de atenuación. La característica más influyente fue la concentración de polvo (67,3 %), seguida por la visibilidad (21,2 %), la tasa de lluvia (6,0 %), la velocidad del viento (2,1 %), la temperatura (1,5 %), la humedad (0,9 %), el mes (0,5 %), la estación (0,3 %), la tasa de nevada (0,1 %) y la presión atmosférica (0,1 %). La importancia relativa es un porcentaje de la importancia total del modelo. (B) Gráfico resumen de SHapley Additive exPlanations (SHAP) que ilustra el impacto de características individuales en las predicciones del modelo. La matriz SHAP se calculó para 300 muestras del conjunto de prueba (300 × 10 características). Para la variable estación codificada con one-hot (originalmente cuatro columnas binarias: primavera, verano, otoño, invierno), los valores SHAP se combinaron sumando las cuatro categorías para producir un único valor de contribución de ‘estación’ por muestra. Cada punto representa una muestra, y la escala de colores indica el valor de la característica, que varía desde bajo (azul) hasta alto (rojo). Los valores SHAP positivos indican un aumento en la atenuación predicha, mientras que los valores SHAP negativos indican una disminución en la atenuación predicha. Haga clic aquí para ver una versión más grande de esta figura.
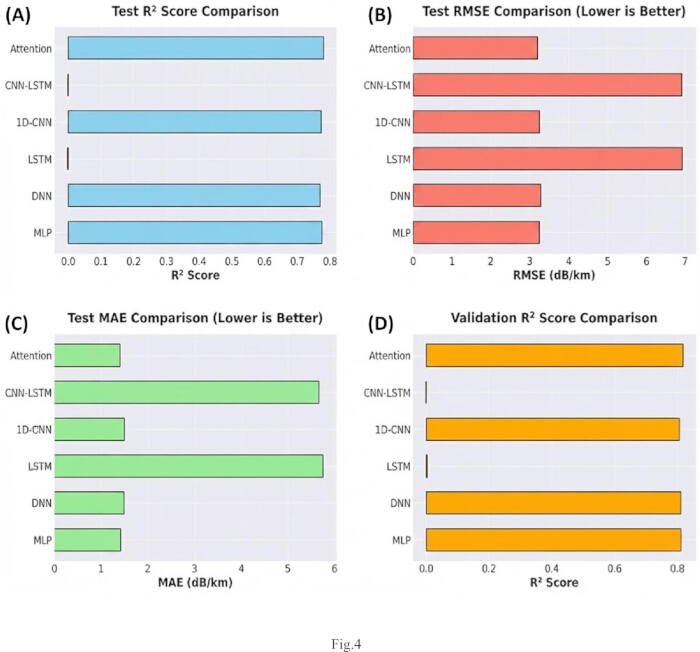
Figura 4: Comparación del rendimiento de modelos de aprendizaje profundo para la predicción de atenuación atmosférica. (A) Prueba del coeficiente de determinación (R2) puntuaciones para las arquitecturas de aprendizaje profundo evaluadas, incluyendo Perceptrón Multicapa (MLP), Red Neuronal Profunda (DNN), Memoria a Largo y Corto Plazo (LSTM), red neuronal convolucional unidimensional (1D-CNN), Red Neuronal Convolucional–Memoria a Largo y Corto Plazo (CNN–LSTM) y modelos basados en atención.B) Valores de error cuadrático medio (RMSE) de prueba para cada modelo de aprendizaje profundo.C) Valores de error absoluto medio (MAE) en la prueba para cada modelo de aprendizaje profundo. (D) Coeficiente de determinación en la validación (R2) puntuaciones para los modelos de aprendizaje profundo evaluados. Mayor R2 valores más bajos de RMSE y MAE indican un mejor rendimiento predictivo. El RMSE y el MAE se informan en dB/km. Haga clic aquí para ver una versión más grande de esta figura.
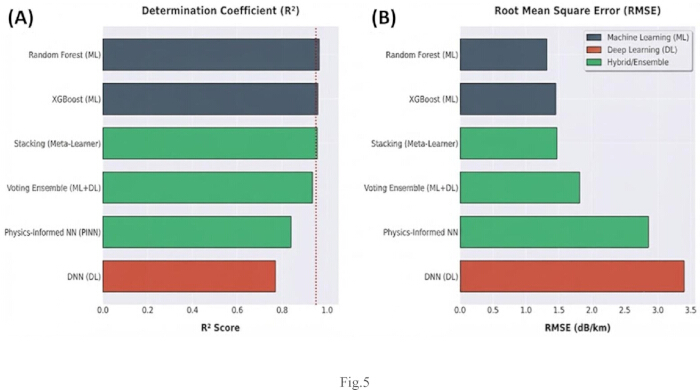
Figura 5: Rendimiento comparativo de modelos de aprendizaje automático, aprendizaje profundo y modelos híbridos para la predicción de atenuación atmosférica. (A) Valores del coeficiente de determinación (R2) para representativos enfoques de aprendizaje automático, aprendizaje profundo y métodos híbridos, incluyendo Bosque Aleatorio, Potenciación Extrema del Gradiente (XGBoost), Red Neuronal Profunda (DNN), Ensemble de Votación, Apilamiento y modelos de Redes Neuronales Influidas por la Física. (B) Valores del error cuadrático medio (RMSE) para los mismos modelos. Los modelos están codificados por colores en tres categorías: aprendizaje automático (ML), aprendizaje profundo (DL) y técnicas híbridas o de conjunto. Un mejor rendimiento predictivo se indica mediante valores más altos de R2 y valores más bajos de RMSE. El RMSE se expresa en dB/km. Haga clic aquí para ver una versión más grande de esta figura.
| Condición climática | Proporción | Rango de temperatura | Rango de humedad | Rango de visibilidad | Rango del parámetro principal |
| Cielo despejado | 54,27% (814 muestras) | −4,89 a 47,99°C | 0–100% | >10 km | — |
| Polvo | 25,00% (375 muestras) | 10–45°C | 10–60% | 0,05–5 km | Polvo: 0–4,96 mg/m3 |
| Niebla | 10,47% (157 muestras) | −5 a 20°C | 70–100% | 0,05–1 km | — |
| Lluvia | 7,40% (111 muestras) | 5–30°C | 60–100% | 1–10 km | Lluvia: 0,25–50 mm/h |
| Nieve | 2,87% (43 muestras) | −10 a 5°C | 50–100% | 0,5–5 km | Nieve: 0,5–15 mm/h |
Tabla 1: Medidas de rendimiento de los modelos de aprendizaje automático para predecir la atenuación atmosférica.
| Modelo | R2 del test | RMSE (dB/km) | MAE (dB/km) | R2 CV | Tiempo de entrenamiento (s) |
| Bosque aleatorio | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| Regresión por vectores de soporte (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| Regresión lineal | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-vecinos más cercanos (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
Tabla 2: Evaluación comparativa de modelos específicos de aprendizaje profundo, híbridos y de aprendizaje automático.
| Modelo | Categoría | R2 de prueba | RMSE (dB/km) | Clasificación |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Ensemble por Apilamiento | Híbrido | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Ensemble por Votación | Híbrido | 0.934 | 1.827 | 5 |
| Red Neuronal con Información Física | Híbrido | 0.8269 | 2.96 | 6 |
| Atención | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
Tabla 3: Comparación de la eficiencia computacional (entrenamiento e inferencia) de cada modelo evaluado.
DATOS DISPONIBILIDAD:
El conjunto de datos sintético completo de 1.500 muestras con todas las variables de entrada (temperatura, humedad, visibilidad, concentración de polvo, tasa de lluvia, tasa de nieve, velocidad del viento, presión atmosférica, mes, estación y condición meteorológica) y la variable objetivo (atenuación en dB/km) se proporciona como archivo complementario junto con este manuscrito en https://doi.org/10.5281/zenodo.21792999. El conjunto de datos está formateado de modo que cada muestra tenga una fila, incluyendo todas las variables calculadas (rango de operación y SNR).
También se prevé proporcionar como archivo complementario el código completo de implementación, que incluye: scripts de generación de datos (implementaciones de modelos físicos); funciones para el preprocesamiento y escalado de características; todas las implementaciones de modelos de aprendizaje automático; todas las implementaciones de modelos de aprendizaje profundo; scripts para evaluación y visualización; y procedimientos de ajuste de hiperparámetros y validación cruzada.
Datos climáticos de origen: Los datos climáticos utilizados para definir las distribuciones de datos sintéticos se obtuvieron de la Organización Meteorológica de Irak y Sismología (IMOS) y del Ministerio de Transporte de Irak, correspondientes al período 2020–2024. Un resumen de los datos climáticos empleados para determinar las proporciones de condiciones meteorológicas y los rangos de parámetros se proporciona en la Tabla Suplementaria 1. Los registros específicos de IMOS utilizados en este estudio no están archivados públicamente en un repositorio centralizado, pero pueden solicitarse directamente a IMOS. Las estadísticas resumidas y las distribuciones de probabilidad derivadas se incluyen en los materiales suplementarios para permitir la reproducibilidad.
Información del repositorio: El código fuente y el conjunto de datos se han depositado en un repositorio público (Zenodo) con https://doi.org/10.5281/zenodo.21792999.
Discusión
Con el fin de predecir la atenuación atmosférica en sistemas de comunicación por fibra óptica libre (FSO) que operan bajo condiciones climáticas iraquíes, en el presente estudio se evaluaron técnicas de aprendizaje automático, aprendizaje profundo y métodos híbridos. Dado que los efectos atmosféricos siguen siendo uno de los principales problemas que afectan el rendimiento y la disponibilidad del enlace, evaluaciones recientes han destacado la creciente importancia de los modelos predictivos para sistemas FSO21. Los resultados mostraron que los enfoques clásicos de aprendizaje automático, particularmente RF y XGBoost, ofrecieron una alta precisión predictiva y, en algunos casos, superaron numéricamente a los métodos de aprendizaje profundo y híbridos. Sin embargo, las pruebas estadísticas no mostraron una diferencia significativa (p=0.083) entre RF y el mejor conjunto híbrido (Stacking), lo que indica que ambos enfoques pueden alcanzar resultados similares con este conjunto de datos. Nuestros hallazgos indican que los métodos de conjunto basados en árboles siguen siendo altamente eficaces para datos ambientales tabulares con tamaños de muestra moderados y un número reducido de variables predictoras dominantes. El análisis de la importancia de las características mostró que la concentración de polvo y la visibilidad fueron los principales factores que determinaron la atenuación, explicando conjuntamente la mayor parte del poder predictivo. Este hallazgo concuerda con investigaciones previas que muestran la influencia importante de la niebla, el polvo, los aerosoles y la contaminación atmosférica en la propagación de la señal óptica22,23,24,25. Se han reportado hallazgos similares en aplicaciones de monitoreo ambiental, donde los modelos de aprendizaje automático suelen beneficiarse de conjuntos de datos que contienen un número reducido de variables altamente informativas26,27,28,29,30,31,32. El análisis SHAP mejoró aún más la interpretabilidad del modelo al cuantificar la influencia de cada parámetro ambiental individual en las predicciones de atenuación.
El menor rendimiento de los modelos de aprendizaje profundo puede atribuirse a varios factores. El tamaño del conjunto de datos fue relativamente modesto para entrenar arquitecturas neuronales complejas (en https://doi.org/10.5281/zenodo.21792999), y las variables ambientales mostraron una importancia de características altamente concentrada. Estudios previos han demostrado que los métodos de aprendizaje profundo generalmente se benefician de conjuntos de datos grandes, estructuras jerárquicas de características y representaciones no lineales complejas33,34,35,36,37. En contraste, el conjunto de datos de atenuación utilizado en este estudio contenía un número limitado de predictores dominantes y carecía de las dependencias temporales necesarias para arquitecturas recurrentes. El bajo rendimiento de los modelos LSTM y CNN–LSTM sugiere que los mecanismos de aprendizaje secuencial podrían no aportar beneficios sustanciales para esta aplicación.
La predominancia de la concentración de polvo (67,3 %) y la visibilidad (21,2 %) como predictores de atenuación atmosférica puede atribuirse a varios factores. Primero, la dispersión y absorción moleculares a 1550 nm quedan eclipsadas por la dispersión de Mie provocada por las partículas de polvo. En la teoría de Mie, la eficiencia de extinción Q_ext es muy sensible a la concentración de partículas, y la atenuación aumenta casi linealmente con la concentración de polvo en el régimen de concentración moderada a alta. Segundo, Irak sufre tormentas de polvo frecuentes (25,00 % de los días en nuestros registros climáticos), lo que provoca valores de atenuación de 4 a 30 dB/km. Esto contrasta con la niebla (10,47 %, 0,5 a 10 dB/km) y la lluvia (7,40 %, 2 a 25 dB/km). La mayor variabilidad en la atenuación por polvo genera señales más fuertes que los modelos pueden aprender. Tercero, la distribución exponencial de la concentración de polvo (0,4 a 4,96 mg/m3) produce un amplio rango de valores de atenuación. La cola larga correspondiente a eventos extremos de polvo genera valores altos de atenuación, que son importantes para una predicción precisa. Cuarto, el modelo de dispersión de Mie presenta una dependencia más simple (aproximadamente lineal) respecto a la concentración de polvo, lo cual es más fácil de aproximar para modelos basados en árboles en comparación con la relación más compleja entre visibilidad y atenuación por niebla en el modelo de Kim. Quinto, este hallazgo tiene una importancia práctica, ya que las tormentas de polvo son una de las condiciones ambientales más desafiantes para la comunicación por fibra óptica libre (FSO) en Oriente Medio. La predicción precisa durante los eventos de polvo es esencial para el funcionamiento confiable del sistema.
Los hallazgos impulsan la investigación en comunicaciones por FSO al proporcionar orientación práctica sobre la selección de algoritmos para la predicción de atenuación atmosférica. La previsión precisa de la atenuación es esencial para la planificación de redes, la gestión adaptativa de enlaces y la implementación confiable de sistemas de comunicación óptica en entornos desafiantes, como el Medio Oriente23,28,30,36. Además, la metodología podría aplicarse a otros problemas de predicción ambiental que involucren la propagación del aire, el monitoreo atmosférico y la evaluación del rendimiento de redes ópticas38,39,40. Conjuntos de datos más amplios del mundo real, técnicas avanzadas de aprendizaje conjunto, marcos de aprendizaje por transferencia o arquitecturas más complejas basadas en principios físicos son algunos otros métodos para examinar esta idea41,42,43,44,45.
Alcance de las conclusiones y cuestiones de generalizabilidad
Las conclusiones de este trabajo se basan principalmente en un conjunto de datos sintéticos generado a partir de modelos físicos de propagación bien establecidos (ley de Beer-Lambert, modelo de Kim, modelo de Carbonneau y teoría de dispersión de Mie). Este enfoque metodológico conlleva algunas implicaciones para el alcance y la generalización de nuestros hallazgos:
Conclusiones a partir de datos simulados: (1) Clasificación comparativa del rendimiento de los enfoques de aprendizaje automático, aprendizaje profundo e híbridos para la predicción de atenuación atmosférica. (2) Identificación de la concentración de polvo y la visibilidad como los predictores ambientales dominantes de la atenuación óptica bajo las condiciones modeladas. (3) Ventaja en eficiencia computacional de los métodos basados en ensambles de árboles frente a las arquitecturas de aprendizaje profundo. (4) Interpretabilidad de la importancia de las características y de los análisis SHAP para explicar las predicciones del modelo.
Conclusiones que requieren confirmación en el mundo real: (1) Los valores absolutos de R2 y RMSE obtenidos por los modelos evaluados dependen de las características específicas del conjunto de datos sintético y podrían reflejar que los modelos han aprendido las ecuaciones físicas deterministas utilizadas para generar los valores objetivo. (2) Aún queda por demostrar que el mejor modelo, Bosque Aleatorio, pueda aplicarse a condiciones atmosféricas reales desconocidas. (3) Es necesario realizar una validación en campo para que los hallazgos sean aplicables a unidades operativas de FSO instaladas en Irak. (4) Es necesario confirmar que las clasificaciones identificadas de importancia de características sean robustas bajo condiciones de medición en campo.
Es importante distinguir entre el rendimiento en datos sintéticos derivados de ecuaciones y el rendimiento en datos observacionales o experimentales con ruido. El conjunto de datos sintéticos proporciona una relación limpia y libre de ruido entre las características de entrada y el objetivo de atenuación, lo cual puede producir indicadores de rendimiento predictivo más altos que los que pueden obtenerse con datos del mundo real que contienen ruido de medición, errores instrumentales y fenómenos físicos no modelados. Recomendamos que los trabajos futuros se dirijan a obtener mediciones reales de atenuación en enlaces de comunicación por fibra óptica (FSO) bajo condiciones climáticas iraquíes, para validar los resultados presentados en este estudio y evaluar la verdadera generalización de las metodologías propuestas.
Implicaciones de los datos sintéticos para la generalización del modelo
Las implicaciones del uso de datos sintéticos en este estudio deben considerarse cuidadosamente en cuanto a la generalización de los modelos:
Ventajas del enfoque sintético El conjunto de datos es físicamente consistente y se basa en marcos teóricos establecidos mediante el uso de modelos físicos de propagación reconocidos. Los parámetros meteorológicos se extrajeron de registros meteorológicos de Irak para que el conjunto de datos refleje las propiedades estadísticas de las condiciones climáticas reales en Irak. Además de evitar las variables de confusión de las mediciones de campo (como errores de medición, calibración del equipo o registros de datos insuficientes), este entorno controlado permite un examen metódico de las metodologías de modelado.
Limitaciones para la generalización El conjunto de datos sintético tiene limitaciones para capturar la complejidad completa de la atenuación atmosférica real, incluyendo: (1) la interacción de múltiples fenómenos atmosféricos que ocurren simultáneamente; (2) el comportamiento no lineal y no estacionario de los parámetros atmosféricos; (3) la variabilidad climática a largo plazo no capturada por las distribuciones de muestreo; (4) efectos microclimáticos localizados que pueden afectar significativamente la propagación en sistemas FSO; y (5) el ruido y la incertidumbre inherentes a la recopilación de datos en condiciones reales.
Consideraciones sobre el sesgo en la generación de datos sintéticos. El supuesto de muestreo independiente de los parámetros ambientales (véase Métodos) es una simplificación excesiva de las condiciones del mundo real, donde las variables atmosféricas tienden a estar correlacionadas (por ejemplo, altas concentraciones de polvo suelen correlacionarse con baja visibilidad). Se adoptó un supuesto de independencia para crear un entorno de simulación controlado que permitiera una comparación sistemática de modelos. Sin embargo, este método podría no capturar toda la complejidad de las interacciones entre los parámetros atmosféricos. Empleamos un método de división estratificada (manteniendo las proporciones de las condiciones meteorológicas en los conjuntos de entrenamiento y prueba) para minimizar la posibilidad de una representación desequilibrada de condiciones raras en el conjunto de prueba (notablemente nieve con un 2,87 %).
Generación determinista del objetivo: El alto rendimiento predictivo observado en este estudio puede explicarse parcialmente por el aprendizaje, por parte de los modelos, de las ecuaciones físicas deterministas utilizadas para generar los valores objetivo. En contraste, los datos experimentales del mundo real contienen ruido de medición, errores instrumentales y fenómenos físicos no modelados que hacen que la predicción sea más difícil. Por lo tanto, las métricas cuantitativas de rendimiento (R2, RMSE, MAE) deben interpretarse como comparaciones relativas entre metodologías en un entorno de simulación controlado, y no como garantías absolutas de rendimiento para sistemas operativos de FSO.
Por lo tanto, aunque los resultados comparativos sobre la clasificación del rendimiento de los modelos probablemente sean robustos (debido a la coherencia física de los datos sintéticos), las métricas absolutas de rendimiento (R2, RMSE, MAE) no deben considerarse indicativas del rendimiento esperado en sistemas FSO operativos. Es necesario evaluar la generalización del modelo a entornos del mundo real mediante mediciones experimentales de atenuación atmosférica obtenidas bajo diversas condiciones climáticas en Irak.
Existen algunas limitaciones que es importante tener en cuenta. Primero, en lugar de utilizar observaciones de campo, el estudio se basó en un conjunto de datos sintéticos generado mediante modelos físicos de propagación bien conocidos. Como se mencionó anteriormente, las métricas cuantitativas de rendimiento (R2, RMSE, MAE) no deben interpretarse como garantías absolutas de desempeño para sistemas FSO operativos, sino como comparaciones relativas entre enfoques en un entorno de simulación controlado. Segundo, los modelos tradicionales frente a los de aprendizaje profundo podrían no haber sido capaces de aprender representaciones robustas de las características debido al tamaño del conjunto de datos. Tercero, otros indicadores de rendimiento de FSO, como la disponibilidad de la conexión, los errores de apuntamiento y el desvanecimiento inducido por la turbulencia, no se consideraron, priorizándose en su lugar la predicción de atenuación. Cuarto, las proporciones de condiciones meteorológicas se calcularon a partir de registros históricos entre 2020 y 2024, lo cual podría no reflejar con precisión las variaciones anuales en los patrones climáticos de Irak. Quinto, la estructura de datos de entrada pseudo-secuencial de los modelos CNN–LSTM y LSTM constituye una simplificación metodológica que podría no capturar adecuadamente la dinámica temporal de aplicaciones del mundo real. Estas limitaciones deben tenerse en cuenta al evaluar los resultados, ya que podrían afectar la generalización de los hallazgos.
Prioridad recomendada: Verificación en el mundo real. La recopilación y análisis de mediciones reales de atenuación FSO bajo condiciones meteorológicas iraquíes es la vía más importante de trabajo futuro. Esto debería incluir: (1) instalar bancos de pruebas FSO en diversas regiones de Irak (por ejemplo, Bagdad, Basora, Mosul, Ramadi) para registrar variaciones climáticas regionales; (2) utilizar instrumentos calibrados en los sitios FSO para medir simultáneamente parámetros atmosféricos (temperatura, humedad, visibilidad, concentración de polvo); (4) documentar la atenuación durante eventos meteorológicos extremos (tormentas de polvo, niebla densa, lluvias intensas); (5) hacer públicos los datos recopilados para permitir la reproducibilidad y la investigación comparativa; y (3) continuar con el monitoreo durante al menos un ciclo anual completo para capturar las fluctuaciones estacionales. Una validación práctica como esta ofrecería la oportunidad de evaluar la generalización del modelo y mejorar las técnicas predictivas desarrolladas en esta investigación.
Para validar y mejorar los modelos generados, la investigación futura debería centrarse en incorporar mediciones reales de FSO obtenidas en condiciones climáticas iraquíes. Investigaciones adicionales podrían examinar estrategias de aprendizaje por transferencia que aprovechen conjuntos de datos atmosféricos relevantes, programas de aprendizaje en línea que se adapten a condiciones ambientales cambiantes, y estrategias híbridas de experimentación y simulación que combinen datos medidos con modelos físicos. Asimismo, investigaciones adicionales sobre inteligencia artificial interpretable y enfoques avanzados de aprendizaje basados en la física podrían arrojar más luz sobre los mecanismos subyacentes a la atenuación en el aire y fortalecer la resiliencia de los sistemas de predicción futuros.
Divulgaciones
Conflicto de intereses: Los autores declaran que no tienen conflictos de intereses.
Agradecimientos
Los autores declaran que no se recibió financiamiento externo para esta investigación. Agradecemos al Centro Internacional de Investigación Aplicada y Teórica (IATRC), Bagdad Quarter, Irak.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Kit de herramientas CUDA | NVIDIA Corporation | 11.8 | Biblioteca de aceleración GPU para el entrenamiento de aprendizaje profundo |
| cuDNN | NVIDIA Corporation | 8.6.0 | Biblioteca de redes neuronales profundas acelerada por GPU |
| GPU (unidad de procesamiento gráfico) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | Utilizado para el entrenamiento de aprendizaje profundo acelerado por GPU |
| CPU (unidad central de procesamiento) | Intel Corporation | Core i9-13900K, 24 núcleos/32 hilos | Procesador de estación de trabajo para todo el entrenamiento y evaluación de modelos |
| Memoria del sistema (RAM) | n/a | 64 GB DDR5, 5200 MHz | Memoria de la estación de trabajo |
| API Keras | Código abierto (parte de TensorFlow) | incluido con TensorFlow 2.11.0 | API de alto nivel para aprendizaje profundo utilizada en todas las arquitecturas de DL |
| LightGBM | Código abierto (Microsoft) | 3.3.5 | Marco de impulso de gradiente |
| NumPy | Código abierto (NumFOCUS) | 1.23.5 | Biblioteca de cálculo numérico |
| Sistema operativo | Canonical Ltd. | Ubuntu 22.04 LTS | Sistema operativo de la estación de trabajo |
| Python | Python Software Foundation | 3.9 | Lenguaje de programación utilizado para toda la generación de datos y modelado |
| scikit-learn | Código abierto | 1.2.2 | Biblioteca de aprendizaje automático (RF, SVR, KNN, regresión lineal, validación cruzada, escalado) |
| SHAP (Explicaciones Aditivas de Shapley) | Código abierto | 0.41.0 | Biblioteca de interpretabilidad de modelos, módulo TreeExplainer |
| TensorFlow | Código abierto (Google) | 2.11.0 | Marco de trabajo de aprendizaje profundo utilizado en las seis arquitecturas de DL |
| XGBoost | Código abierto | 1.7.5 | Biblioteca de impulso extremo de gradiente |
Referencias
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.