Aquí presentamos un protocolo para enriquecer el ADN mitocondrial a partir de óvulos humanos individuales utilizando la Exonucleasa V y preparar bibliotecas de secuenciación dúplex para la detección altamente precisa de variantes del ADN mitocondrial mediante plataformas de secuenciación compatibles con Illumina.
Artículo de método
Protocolo para la secuenciación dúplex de ADN mitocondrial en ovocitos humanos individuales
En este artículo
Resumen
Resumen
Los ovocitos están densamente empaquetados con mitocondrias, orgánulos productores de energía que contienen su propio genoma, el ADN mitocondrial (ADNmt). Cada célula contiene múltiples copias de ADNmt, con un número de copias que varía entre los tipos de tejidos. Los ovocitos poseen el número más alto de copias de ADNmt, conteniendo cientos de miles de moléculas de ADNmt por célula. Dado que las mitocondrias se heredan exclusivamente a través de la línea materna, la detección precisa de variantes del ADNmt es esencial para estudios sobre herencia, envejecimiento y enfermedad. La presencia de múltiples copias de ADNmt permite que moléculas silvestres y mutantes coexistan dentro de la misma célula, una condición conocida como heteroplasmia, en la cual pueden ocurrir variantes de baja frecuencia y de novo a frecuencias inferiores al 1 %. La secuenciación convencional de nueva generación (NGS) carece de la precisión suficiente para distinguir de manera confiable estas variantes raras de los errores introducidos durante la preparación de la biblioteca y el secuenciamiento. Aquí presentamos un protocolo para enriquecer el ADNmt a partir de ovocitos humanos individuales utilizando Exonucleasa V para eliminar el ADN lineal, seguido de la preparación de bibliotecas de secuenciación dúplex para un análisis altamente preciso del ADNmt. Este flujo de trabajo permite el secuenciamiento corregido de errores de ovocitos individuales, facilitando la detección confiable de variantes de ADNmt de baja frecuencia y el análisis de la heteroplasmia y la mutagénesis de novo. El protocolo proporciona un enfoque reproducible para investigar la variación del genoma mitocondrial en ovocitos individuales utilizando plataformas de secuenciación compatibles con Illumina.
Introducción
Las mitocondrias desempeñan funciones fundamentales en procesos celulares esenciales, como la producción de energía, la apoptosis, la señalización y la homeostasis del calcio1. Poseen su propio genoma, el ADN mitocondrial (ADNmt), una molécula circular bicatenaria de aproximadamente 16,6 kb de longitud en los mamíferos. Aunque la mayoría de los genes mitocondriales ancestrales se transfirieron al genoma nuclear durante la endosimbiosis, el ADNmt conserva 37 genes que codifican 13 polipéptidos de la fosforilación oxidativa (OXPHOS), 22 ARN de transferencia (ARNt) y dos ARN ribosomales (ARNr)2. Las mutaciones en el ADNmt pueden alterar la expresión génica y la función mitocondrial, y pueden provocar trastornos graves3. Dado que las mitocondrias se heredan exclusivamente a través de la línea materna, el ADNmt del ovocito desempeña un papel fundamental en la fertilización, el desarrollo embrionario y la salud de la descendencia4. Por consiguiente, la detección y caracterización de mutaciones en el ADNmt y sus frecuencias son de gran interés. Por ejemplo, comprender la mutagénesis en la línea germinal asociada al envejecimiento y a las enfermedades es un requisito importante para desarrollar estrategias terapéuticas contra la infertilidad femenina.
A diferencia del ADN nuclear, el ADN mitocondrial (ADNmt) está presente en múltiples copias por célula, desde cientos hasta miles de copias en células somáticas, dependiendo del tipo de tejido, y superando las 100.000 copias en ovocitos maduros4. Este alto número de copias de ADNmt hace que los ovocitos sean especialmente adecuados para investigar la mutagénesis mitocondrial a nivel de célula individual. Sin embargo, detectar mutaciones de novo en el ADNmt, particularmente aquellas presentes en frecuencias muy bajas, sigue siendo un desafío, ya que las tasas de error de la secuenciación convencional de nueva generación (NGS) superan las frecuencias de muchas variantes reales5. Por lo tanto, se requieren métodos de secuenciación con corrección de errores para distinguir mutaciones genuinas de los artefactos introducidos durante la preparación de bibliotecas, la amplificación y la secuenciación. Uno de estos métodos es la secuenciación en dúplex (DS)6,7. En DS, los fragmentos de ADN se ligaron a adaptadores que contienen etiquetas moleculares aleatorizadas de doce nucleótidos en doble cadena antes de la amplificación. Estos identificadores moleculares únicos etiquetan cada molécula original de ADN en ambos extremos, permitiendo agrupar en familias las lecturas de secuenciación derivadas de la misma cadena molde, basándose en la secuencia compartida de la etiqueta. Se genera una secuencia consenso de cadena simple (SSCS) a partir de cada familia de lecturas, tras lo cual se combinan las SSCS complementarias derivadas del dúplex de ADN original para producir una secuencia consenso en dúplex (DCS). Solo se consideran mutaciones verdaderas aquellas variantes detectadas en la mayoría de las lecturas dentro de ambas SSCS complementarias y confirmadas en la DCS resultante, lo que permite alcanzar tasas de error varias órdenes de magnitud más bajas que las de los métodos convencionales de NGS8. Esta estrategia es particularmente ventajosa para detectar variantes de ADNmt de baja frecuencia y heteroplasmia en células individuales.
Una limitación importante de la mayoría de los protocolos publicados de secuenciación dúplex es el requisito de cantidades relativamente grandes de ADN de entrada durante la preparación de la biblioteca, lo que hace que estos métodos no sean adecuados para aplicaciones con una sola célula6,7,9. El objetivo general de este protocolo es permitir una secuenciación dúplex altamente precisa del ADN mitocondrial (ADNmt) a partir de óvulos humanos individuales, mediante un flujo de trabajo optimizado para el enriquecimiento del ADNmt, la preparación de la biblioteca y la secuenciación. Para minimizar la secuenciación de segmentos nucleares de ADN mitocondrial (NUMTs) y mejorar la eficiencia de secuenciación, este protocolo incluye un paso de enriquecimiento basado en la exonucleasa V que digiere selectivamente el ADN lineal mientras preserva el ADNmt circular. El flujo de trabajo resultante proporciona un enfoque práctico para la detección precisa de variantes del ADNmt en óvulos individuales, y es adecuado para estudios que investiguen la heteroplasmia, la mutagénesis de novo, el envejecimiento y las enfermedades mitocondriales.
Protocolo
La recolección y el procesamiento de ovocitos humanos fueron aprobados por la Comisión de Ética de la Universidad Johannes Kepler de Linz (Número de aprobación: 1293/2020). Realice todos los procedimientos de acuerdo con las directrices institucionales, incluido el consentimiento informado, la anonimización de muestras y todas las regulaciones aplicables sobre el uso de tejido humano.
NOTA: Aunque este protocolo se describe para ovocitos humanos, adapte los cebadores específicos de la especie para aplicar el procedimiento a otras especies. Utilice material desechable de baja retención de ADN (por ejemplo, tubos y puntas de pipeta) durante todo el protocolo para minimizar la pérdida de muestra. Realice todos los pasos hasta la primera purificación en el tubo original de recolección de ovocitos de baja retención. No agite las muestras con vórtex, ya que este procedimiento podría dañar las cadenas de ADN. En su lugar, mezcle los componentes de la reacción mediante pipeteo suave o agitación suave del tubo, seguido de una breve centrifugación. Siempre que sea posible, realice el aislamiento de ADN, la preparación del sobrenadante maestro y el montaje de reacciones en estaciones de trabajo dedicadas para reacción en cadena de la polimerasa (PCR) o en áreas de laboratorio físicamente separadas para minimizar la contaminación.
1. Preparación de tampones y reactivos
- Prepare el tampón de lisis de ovocitos (OLB), tampón TE de 10 mM Tris-HCl, tampón TElow, y tampón Tris-NaCl de 10 mM según la Tabla 1, combinando los volúmenes especificados de las soluciones madre y llevando cada solución al volumen final indicado con agua de grado para biología molecular. Aliquote 1 mL de los tampones preparados, almacene los alícuotas a 4°C y úselos dentro de 1 año.
Tabla 1: Composición de los tampones utilizados a lo largo del protocolo. Composiciones de los tampones y concentraciones finales para la preparación de Tris-HCl 10 mM, tampón TE, tampón TElow, Tris-NaCl 10 mM y tampón de lisis de ovocitos (OLB). Prepare todos los tampones utilizando agua de grado para biología molecular. Ajuste el pH de las soluciones stock de Tris-HCl y EDTA antes de la preparación del tampón, si es necesario, según las recomendaciones del fabricante. El OLB se suplementa con proteinasa K termolábil inmediatamente antes de la lisis de la muestra, como se describe en el protocolo. Haga clic aquí para descargar este archivo.
2. Recolección de ovocitos individuales
NOTA: Los ovocitos humanos utilizados en este protocolo se obtuvieron de pacientes programadas para inyección intracitoplasmática de espermatozoides (ICSI) en el Kinderwunsch Zentrum (centro de fertilidad) del Hospital Universitario Kepler, Linz, Austria. Los protocolos de estimulación ovárica se basaron en la respuesta ovárica predicha de la paciente, y las dosis se ajustaron según las características individuales, incluyendo la edad, los niveles de la hormona antimülleriana (AMH) y el peso corporal, de acuerdo con las recomendaciones de la Sociedad Europea de Reproducción Humana y Embriología (ESHRE)10. La supresión hipofisaria se logró mediante protocolos que utilizaban agonistas o antagonistas de la hormona liberadora de gonadotropinas (GnRH), combinados con estimulación con gonadotropinas para promover la maduración folicular. El crecimiento folicular se monitoreó regularmente mediante ecografía transvaginal antes de inducir la ovulación. Posteriormente, los ovocitos se recuperaron mediante aspiración folicular transvaginal, y se recolectó el líquido folicular que contenía los complejos cumulus–ovocito (COC)11. Solo estuvieron disponibles para investigación los ovocitos inmaduros o no fertilizados que no podían utilizarse en el tratamiento ICSI de la paciente y que de otro modo habrían sido descartados, tras obtener el consentimiento informado. Se contactó preferentemente a pacientes con recuentos más altos de folículos antrales (AFC) para la donación de ovocitos, ya que era más probable que produjeran ovocitos inmaduros o no fertilizados adecuados para la investigación. Todos los procedimientos realizados antes de la selección de ovocitos para investigación deben cumplir con las regulaciones nacionales que rigen la fertilización in vitro y el uso de tejido humano. Manipule todos los materiales en condiciones estériles dentro de una cabina de flujo laminar. Asegúrese de que todos los materiales y medios de cultivo certificados por la CE que entren en contacto directo con los ovocitos sean estériles, previamente calentados a 37 °C y mantenidos a un pH de 7,20–7,40.
- Recoger los COC del líquido folicular y transferirlos a 750 µL de medio de cultivo GM501 bajo aceite mineral estéril tras la hiperestimulación ovárica controlada y la recuperación transvaginal de ovocitos.
- Eliminar las células del cumulus que rodean la zona pelúcida (ZP) mediante digestión enzimática con hialuronidasa. Incubar los ovocitos en 500 µL de hialuronidasa GM501 (80 U/mL) durante 30–60 s a 37°C, seguido de tres lavados en 750 µL de medio de cultivo GM501. Retirar cuidadosamente cualquier célula del cumulus remanente mediante pipetas de desnudación.
- Para ovocitos en telofase I (TI) o metafase II (MII), abrir la ZP mediante una serie de pulsos láser adyacentes al cuerpo polar y extraer el primer cuerpo polar utilizando micromanipuladores. Ajustar la configuración del láser según el grosor de la ZP (1–3 pulsos; duración del pulso, 1,5–2,6 ms; diámetro del punto, 16–20 µm). Utilizar el láser para eliminar cualquier célula del cumulus remanente, minimizando así la contaminación del ovocito con ADN de células somáticas.
- Transferir cada ovocito individualmente a 2–3 µL de solución salina tamponada con fosfato (PBS) 1× en un tubo de baja unión de 200 µL. Congelar inmediatamente el tubo a −20°C. Para almacenamiento a largo plazo, transferir los ovocitos congelados a −80°C.
NOTA: Tras el descongelamiento, realizar el resto del protocolo de forma continua y sin interrupciones hasta completar el primer paso de amplificación. - Para monitorear posibles contaminaciones con ADN ambiental durante todo el protocolo, incluir un control negativo compuesto por 2 µL de PBS 1× sin ovocito durante la preparación de la biblioteca (paso 4 en adelante). Procesar el control negativo de forma idéntica a todas las muestras de ovocitos. No debe observarse ADN detectable en el control negativo en ninguna etapa del protocolo.
3. Síntesis de adaptadores
NOTA: Prepare los adaptadores antes de comenzar la preparación de la biblioteca. Almacene los adaptadores sintetizados a −80 °C durante hasta 3 meses. Prepare alícuotas para evitar ciclos repetidos de congelación y descongelación, y no vuelva a congelar los adaptadores después de descongelarlos. Todas las secuencias de oligonucleótidos utilizadas en este protocolo se enumeran en Tabla 2.
Tabla 2: Oligonucleótidos y cebadores utilizados a lo largo del protocolo. La tabla enumera todos los oligonucleótidos utilizados para la síntesis de adaptadores, la amplificación de la biblioteca, la reacción en cadena de la polimerasa cuantitativa (qPCR), la cuantificación de la biblioteca y la estimación del enriquecimiento del ADN mitocondrial (mtDNA), junto con sus secuencias, métodos de purificación, cantidades suministradas o concentraciones stock recomendadas y el fabricante. La secuencia del oligonucleótido portador mostrada es la secuencia de ejemplo utilizada en este protocolo. El asterisco (*) dentro de las secuencias de los cebadores denota un enlace fosforotioato. Los nucleótidos aleatorios (N) en el adaptador mws55 representan el identificador molecular único (UMI), mientras que Y denota la base pirimidínica degenerada (C o T). A menos que se indique lo contrario, los oligonucleótidos se sintetizaron utilizando la purificación estándar por desalinización. Haga clic aquí para descargar este archivo.
- Preparar una alícuota de etanol al 96% (EtOH) y almacenarla a −20°C para pasos posteriores de purificación. Preparar EtOH al 80% recién antes de su uso.
- Mezclar 20,5 µL de cada uno de los oligonucleótidos 100 µM mws51_short y 100 µM mws55 en un tubo de baja adsorción de 200 µL para obtener un volumen total de 41 µL (2.000 pmol de cada oligonucleótido).
- Incubar los oligonucleótidos combinados a 95°C durante 5 min en un termociclador con la tapa ajustada a 110°C. Iniciar el cronómetro una vez que la muestra alcance 95°C, apagar el termociclador después de 5 min y dejar los tubos dentro del termociclador durante 1 h para permitir un enfriamiento lento hasta temperatura ambiente (RT) y la hibridación (“adaptador hibridado”).
- Preparar una Mezcla Maestra de Extensión combinando 1× tampón NEB Buffer 2 (5,6 µL de stock 10×), 3,5 mM de desoxinucleótidos trifosfato (dNTPs; 5,6 µL de stock 10 mM), 11,5 U de fragmento Klenow (2,3 µL de stock 5 U/µL) y 2,5 µL de agua grado biología molecular hasta un volumen final de 16 µL.
- Retirar 1 µL del adaptador hibridado preparado en el paso 3.3, diluirlo 1:20 en tampón TElow, etiquetar la alícuota como “hibridado” y almacenarla a 4°C para electroforesis en gel de agarosa.
- Añadir 16 µL de la Mezcla Maestra de Extensión a los 40 µL restantes de oligonucleótidos hibridados y mezclar completamente.
- Incubar la reacción a 37°C durante 1 h con la tapa del termociclador ajustada a 47°C.
- Purificar los oligonucleótidos extendidos mediante precipitación con EtOH. Añadir 28 µL de acetato de amonio (NH4OAc) a la mezcla de reacción de 56 µL y mezclar completamente.
- Transferir toda la reacción a un tubo de baja adsorción de 1,5 mL y añadir 168 µL de EtOH al 96% enfriado con hielo.
- Invertir el tubo varias veces e incubar a −20°C durante 30 min para precipitar el ADN.
- Preparar 1 mL de EtOH fresco al 80% y enfriarlo a −20°C. Pre-enfriar la centrífuga a 4°C.
- Centrifugar a 14.000 × g durante 30 min.
- Retirar cuidadosamente el sobrenadante sin perturbar el precipitado. Añadir 1 mL de EtOH al 80% enfriado con hielo sin mezclar ni invertir el tubo.
- Centrifugar a 14.000 × g durante 5 min.
- Eliminar todo el EtOH residual y secar al aire el precipitado de ADN durante 10–15 min, hasta que no quede líquido visible y el precipitado aparezca transparente. No secar en exceso los oligonucleótidos.
- Rehidratar el precipitado en 41 µL de agua grado biología molecular.
- Retirar 1 µL, diluirlo 1:20 en tampón TElow, etiquetar la alícuota como “extendido” y almacenarla a 4°C.
- Preparar una Mezcla Maestra de Restricción combinando 47 µL de agua grado biología molecular, 1× tampón CutSmart (10 µL de stock 10×) y 15 U de HpyCH4III (3 µL de stock 5 U/µL) hasta un volumen final de 60 µL.
- Añadir 60 µL de la Mezcla Maestra de Restricción a 40 µL de oligonucleótidos purificados y mezclar completamente.
- Incubar la reacción a 37°C durante 16 h con la tapa del termociclador ajustada a 47°C.
- Preparar 6,5 mL de EtOH fresco al 80% y enfriarlo a −20°C. Pre-enfriar la centrífuga a 4°C.
- Transferir los adaptadores digeridos a un tubo de baja adsorción de 1,5 mL y añadir 900 µL de agua grado biología molecular.
- Añadir 500 µL de NH4OAc y mezclar completamente.
- Dividir la solución en seis alícuotas de 250 µL en tubos de baja adsorción de 1,5 mL. Añadir 500 µL de EtOH al 96% enfriado con hielo a cada tubo.
- Invertir los tubos varias veces e incubar a −20°C durante 30 min para precipitar el ADN.
- Centrifugar a 14.000 × g durante 30 min. Retirar cuidadosamente el sobrenadante sin perturbar el precipitado. Añadir 1 mL de EtOH al 80% enfriado con hielo a cada tubo sin mezclar ni invertir. Centrifugar a 14.000 × g durante 5 min.
- Eliminar todo el EtOH residual y secar al aire los precipitados de adaptador.
- Rehidratar cada precipitado en 6,7 µL de tampón Tris-NaCl y reunir las seis suspensiones para obtener un volumen final de 41 µL. Retirar 1 µL, diluirlo 1:10 en tampón TElow, etiquetar la alícuota como “cortado” y almacenarla a 4°C.
- Preparar alícuotas del stock de adaptador y almacenarlas a −80°C. Medir la concentración del adaptador y determinar las relaciones de absorbancia A260/280 y A260/230 de la alícuota “cortado” mediante un espectrofotómetro. Se espera una concentración de adaptador de 30–50 µM, con una relación A260/280 de >1,7 y una relación A260/230 de >1,9.
- Correr las alícuotas “hibridado”, “extendido” y “cortado” en un gel de agarosa al 2% a 125 V durante 45 min para verificar la formación del adaptador y la digestión completa con la enzima de restricción (Figura 1).
NOTA: La alícuota “hibridado” debe contener dos bandas que representan las fracciones hibridadas y no hibridadas. Se espera que el adaptador hibridado migre aproximadamente a 90 pb y conste de una región de 13 pb de doble cadena con un extremo sobresaliente de cadena sencilla de 68 nt, mientras que los oligonucleótidos no hibridados migran aproximadamente a 60 pb. Tras la extensión, el adaptador consta de una región de 37 pb de doble cadena con un extremo sobresaliente en forma de Y de 44 nt y se espera que migre aproximadamente a 110 pb. Tras la digestión con enzima de restricción, se elimina un fragmento de 8 pb del adaptador. Deben observarse tres bandas: una banda predominante a aproximadamente 100 pb (adaptador final) y dos bandas débiles a aproximadamente 60 pb (oligonucleótidos no hibridados restantes) y 8 pb (fragmento de restricción).
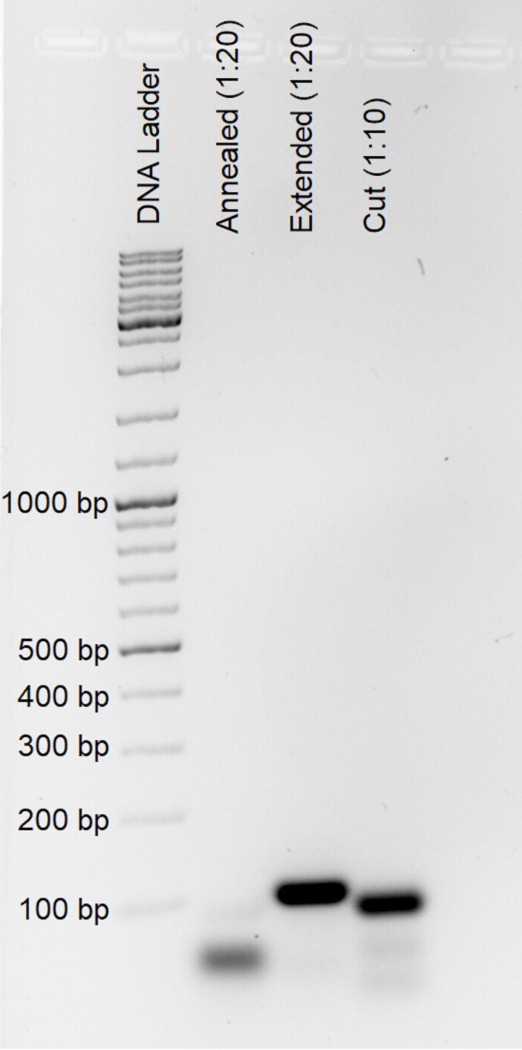
Figura 1. Análisis representativo del tamaño de fragmentos de productos intermedios y adaptadores finales de secuenciación en dúplex. Se analizaron alícuotas recolectadas durante la síntesis de adaptadores tras el apareamiento de oligonucleótidos ("apareados", diluidos 1:20), la extensión por rellenado ("extendidos", diluidos 1:20) y la digestión con la enzima de restricción HpyCH4III ("cortados", diluidos 1:10) mediante electroforesis en gel de agarosa al 2 % para verificar la formación correcta de los adaptadores de secuenciación en dúplex. Haga clic aquí para ver una versión más grande de esta figura.
4. Lisado de ovocito individual
- Prepare el OLB suplementado con proteinasa K termolábil (OLB+) añadiendo 1 µL de proteinasa K termolábil (0,120 U/µL) a 99 µL de OLB para obtener una concentración final de proteinasa K de 0,0012 U/µL.
- Descongele los ovocitos a temperatura ambiente. Inmediatamente, añada 4 µL de OLB+ a cada ovocito. Enjuague varias veces las paredes del tubo con el tampón de lisis para asegurar la transferencia completa del ovocito al tampón y evitar que la muestra se adhiera a la pared del tubo.
- Mezcle bien la muestra, centrifugue brevemente para recoger el contenido en el fondo del tubo e incube a 37°C durante 16 h en un termociclador con la temperatura de la tapa ajustada a 47°C.
NOTA: No se realiza ninguna evaluación independiente de la lisis de los ovocitos antes de la fragmentación. Una incubación de 16 h bajo las condiciones de lisis especificadas es generalmente suficiente para lograr la lisis completa de un solo ovocito. Sin embargo, la cantidad de ADN recuperado puede variar debido a pérdidas de muestra durante el manejo y a las diferencias en el número de copias de ADN mitocondrial entre ovocitos. - Inactive la proteinasa K termolábil incubando las muestras a 55°C durante 15 min en un termociclador con la temperatura de la tapa ajustada a 75°C.
NOTA: Complete el procedimiento posterior sin interrupciones tras la lisis y la inactivación de la proteinasa K, a menos que un paso posterior del protocolo indique explícitamente un punto de pausa.
5. Digestión con exonucleasa V
- Deje que las muestras se equilibren a temperatura ambiente (TA) antes de continuar.
- Prepare una mezcla maestra de Exonucleasa V combinando 4 µL de cloruro de magnesio 25 mM (MgCl₂), 1 µL de Tris-HCl 10 mM, 1 µL de trifosfato de adenosina 10 mM (ATP) y 1 µL de Exonucleasa V (stock de 10 U/µL) para obtener un volumen final de 7 µL.
- Prepare una solución de trabajo de ribonucleasa A (RNasa A) al 1 mg/mL diluyendo 1 µL de stock de RNasa A al 10 mg/mL con 99 µL de agua de grado para biología molecular. Añada aproximadamente 0,1 µL de la solución de RNasa A diluida a cada muestra de ovocito lisado.
NOTA: Utilice una pipeta adecuada para este paso. Al procesar múltiples muestras simultáneamente, puede utilizarse una pipeta multicanal adecuada, siempre que se tomen precauciones para evitar la contaminación cruzada entre muestras. Dado que la precisión de la pipeta puede disminuir al dispensar volúmenes tan pequeños con una pipeta multicanal, inspeccione cuidadosamente todos los canales. Alternativamente, sumergir brevemente la punta de la pipeta en la solución de RNasa A diluida es suficiente para transferir aproximadamente 0,1 µL. Pequeñas desviaciones respecto a este volumen no afectan el rendimiento del protocolo. Verifique previamente el volumen transferido aproximado utilizando una pipeta de canal único. - Añada 7 µL de la mezcla maestra de Exonucleasa V a cada muestra de ovocito lisado y mezcle completamente. Incube las muestras a 37°C durante 1 h en un termociclador con la tapa ajustada a 47°C.
- Añada 38 µL de tampón TE a cada muestra para obtener un volumen final de reacción de aproximadamente 51 µL. Inactive las enzimas por calor incubando las muestras a 70°C durante 30 min en un termociclador con la tapa ajustada a 75°C.
- Proceda inmediatamente a la preparación de la biblioteca.
6. Fragmentación
- Fragmentar el ADN hasta un tamaño promedio de fragmento de aproximadamente 550 pares de bases (pb) mediante sonicación.
NOTA: Este protocolo describe la fragmentación del ADN utilizando un instrumento de ultrasonicación enfocada Covaris M220, denominado en adelante sonicator; sin embargo, también pueden utilizarse sistemas equivalentes. Dado que las muestras contienen restos celulares además de ADN tras la lisis, optimice las condiciones de fragmentación para el instrumento específico y el tipo de muestra con el fin de obtener una distribución relativamente estrecha de tamaños de fragmento centrada alrededor del tamaño deseado. - Transferir todo el volumen de la muestra (aproximadamente 51 µL) a un tubo de ultrasonicación enfocada de 50 µL.
- Fragmentar el ADN durante 70 s utilizando un factor de trabajo del 10 %, una potencia incidente máxima de 75 W y 200 ciclos por ráfaga a 20 °C.
- Transferir inmediatamente cada muestra fragmentada (aproximadamente 50 µL) desde el tubo de fragmentación a un tubo de baja retención de 200 µL, ya que los tubos de fragmentación no son de baja retención. El tubo original de recolección de ovocitos puede reutilizarse para este propósito. Inspeccionar la tapa del tubo de fragmentación en busca de líquido residual y recuperar cualquier muestra restante para maximizar el rendimiento.
- Proceder inmediatamente a la reparación de extremos y adición de cola A.
7. Reparación de extremos y adición de bases A
- Prepare una mezcla maestra de Reparación de Extremos/Adición de Cola A que contenga 7 µL de tampón de reacción de preparación de extremos y 3 µL de mezcla enzimática de preparación de extremos.
- Añada 10 µL de la mezcla maestra de Reparación de Extremos/Adición de Cola A a cada muestra para obtener un volumen final de reacción de 60 µL. Mezcle bien pipeteando arriba y abajo 10 veces.
- Incube las muestras a 20°C durante 30 min con la tapa del termociclador apagada, seguido de una incubación a 65°C durante 30 min con la temperatura de la tapa ajustada a 75°C.
- Proceda inmediatamente a la ligación del adaptador.
8. Ligadura de adaptadores
- Prepare una mezcla maestra de ligación que contenga 30 µL de mezcla de ligación y 1 µL de potenciador de ligación.
- Deshiele un alícuota del adaptador sintetizado y dilúyalo 1:4000 en tampón Tris-NaCl.
- Añada 1,5 µL del adaptador diluido a cada muestra de ADN con extremos reparados y cola de A. Añada 31 µL de la mezcla maestra de ligación y mezcle bien.
- Incube las muestras a 20°C durante 15 min. Añada 1 µL del adaptador diluido a cada muestra para obtener un volumen final de reacción de 93,5 µL. Mezcle bien e incube a 4°C durante 16 h.
- Proceda inmediatamente a la purificación.
9. Purificación del ADN con adaptadores ligados
- Deje que las perlas magnéticas y el tampón TElow se equilibren a temperatura ambiente durante al menos 30 min. Durante este tiempo, prepare EtOH fresco al 80%. Prepare una solución de oligonucleótido portador añadiendo 1 µL del oligonucleótido portador (secuencia no representada en el genoma humano; véase Tabla 2) a 99 µL de tampón TElow para obtener una concentración final de 1 nM.
- Transfiera 74,8 µL de perlas magnéticas, correspondientes a una relación perla-muestra de 0,8×, a un tubo de baja unión de 1,5 mL. Añada todo el volumen de 93,5 µL de ADN ligado con adaptadores y mezcle completamente.
- Incube la mezcla perla-muestra a temperatura ambiente durante 15 min. Tras 7,5 min, mezcle suavemente la suspensión y centrifugue brevemente el tubo.
- Centrifugue brevemente el tubo, colóquelo en un soporte magnético e incube durante 5 min para permitir la separación completa de las perlas. Retire cuidadosamente y deseche el sobrenadante transparente, luego cierre inmediatamente el tubo.
- Añada 400 µL de EtOH al 80%, incube durante 30 s y elimine el EtOH. Añada 200 µL de EtOH al 80%, incube durante 30 s y elimine el EtOH.
- Retire el tubo del soporte magnético y centrifúguelo brevemente. Vuelva a colocar el tubo en el soporte magnético, elimine cualquier resto de EtOH y seque las perlas al aire durante menos de 5 min.
- Añada 50 µL de tampón TElow suplementado con oligonucleótidos portadores. Retire el tubo del soporte magnético y resuspenda completamente las perlas mediante pipeteo.
- Incube la suspensión a temperatura ambiente durante 5 min, mezclando ocasionalmente. Centrifugue brevemente el tubo, devuélvalo al soporte magnético e incube durante 5 min adicionales.
- Durante los últimos 5 min de la primera separación magnética, prepare un nuevo tubo de baja unión de 1,5 mL que contenga 40 µL de perlas magnéticas. Transfiera 50 µL del eluato al tubo preparado para realizar la segunda purificación con una relación perla-muestra de 0,8×.
- Mezcle completamente e incube a temperatura ambiente durante 15 min. Tras 7,5 min, mezcle suavemente la suspensión y centrifugue brevemente el tubo.
- Coloque el tubo en el soporte magnético e incube durante 5 min para permitir la separación completa de las perlas. Retire cuidadosamente y deseche el sobrenadante transparente, luego cierre inmediatamente el tubo.
- Añada 400 µL de EtOH al 80%, incube durante 30 s y elimine el EtOH. Añada 200 µL de EtOH al 80%, incube durante 30 s y elimine el EtOH.
- Retire el tubo del soporte magnético y centrifúguelo brevemente. Devuelva el tubo al soporte magnético, elimine cualquier resto de EtOH y seque las perlas al aire durante menos de 5 min.
- Añada 15,5 µL de Tris-HCl a cada muestra. Retire el tubo del soporte magnético y resuspenda completamente las perlas mediante pipeteo.
- Incube la suspensión a temperatura ambiente durante 5 min, mezclando ocasionalmente. Centrifugue brevemente el tubo, devuélvalo al soporte magnético e incube durante 5 min adicionales.
- Transfiera 15 µL del eluato a un nuevo tubo de baja unión de 200 µL. Retire 1 µL del eluato y dilúyalo 1:10 en Tris-HCl para análisis de PCR cuantitativa (qPCR) en attomoles y de enriquecimiento de ADN mitocondrial (mtDNA).
10. Estimación en attomoles
NOTA: Determine la cantidad aproximada de ADN ligado a adaptadores para ajustar la cantidad de ADN de entrada y el número de ciclos utilizados en las PCR de amplificación e indexación posteriores. Debido a que la cantidad de muestra es limitada, las mediciones directas de concentración pueden no ser confiables; por lo tanto, estime la cantidad de ADN mediante qPCR. Analice los productos de amplificación mediante electroforesis en gel de agarosa para evaluar la distribución de tamaños de fragmentos y detectar dímeros residuales de adaptadores. Los valores de Cq pueden variar según los reactivos y el instrumento de PCR en tiempo real utilizados. Los ajustes en los valores de Cq basados en la detección de dímeros de adaptadores, así como en las cantidades de ADN de entrada y en el número de ciclos de PCR en etapas posteriores, se basan principalmente en observaciones empíricas y pueden requerir optimización para cada preparación individual de bibliotecas.
- Prepare una mezcla maestra de qPCR en atómol que contenga 5 µL de la mezcla de reacción 2× KAPA HiFi HotStart (en adelante denominada mezcla de PCR de alta fidelidad 2×), 1 µL del cebador universal Dual-NEBNext para Illumina (10 µM; en adelante denominado cebador universal de biblioteca), 1 µL del cebador mws20 (10 µM), 0,5 µL de EvaGreen 20× y 0,5 µL de agua grado biología molecular por reacción.
- Añada 8 µL de la mezcla maestra a cada pocillo designado de una placa de 96 pocillos compatible con qPCR. Añada 2 µL de la muestra diluida 1:10 para obtener un volumen final de reacción de 10 µL.
- Selle la placa y centrifúguela brevemente antes de colocarla en el instrumento de PCR en tiempo real.
- Realice la qPCR utilizando las siguientes condiciones de termociclado: 45 s a 98°C, seguidos de 45 ciclos de 15 s a 98°C, 30 s a 65°C y 45 s a 72°C.
- Determine el ciclo de cuantificación (Cq) estableciendo el umbral de fluorescencia en 1.000 unidades de fluorescencia relativa (RFU).
NOTA: Seleccione un umbral de fluorescencia compatible con el instrumento de PCR en tiempo real y utilice el mismo umbral en todos los experimentos para permitir la comparación de los valores de Cq. - Se pare los productos de amplificación de qPCR en un gel de agarosa al 1,5 % a 125 V durante 40 min.
- Inspeccione el gel en busca de dímeros de adaptador residuales. Los dímeros de adaptador migran aproximadamente a 130 pb (Figura 2).
- Si se observan dímeros de adaptador, ajuste el valor de Cq utilizando el factor de corrección de Cq en atómol (ACF) apropiado mostrado en Figura 2. Seleccione el ACF según la intensidad de la banda de dímero de adaptador observada en el gel de agarosa, utilizando como referencia los ejemplos representativos de la Figura 2. Un valor de Cq en atómol corregido con ACF entre 22 y 26 es óptimo; sin embargo, valores <29 generalmente son aceptables.
NOTA: En lugar de corregir el valor de Cq, puede realizarse una purificación adicional cuando sea necesario; sin embargo, esto podría provocar una pérdida sustancial de la biblioteca. Las muestras con bandas intensas de dímeros de adaptador suelen asociarse con valores altos de Cq en qPCR en atómol, lo que indica una baja cantidad de ADN inicial. Las muestras con valores de Cq ≥29 generalmente producen tamaños de familia grandes y profundidades bajas de secuenciación de ADN mitocondrial (<100×) y, por lo tanto, podrían excluirse del secuenciamiento. Dado que los valores de Cq dependen del instrumento de PCR en tiempo real y de las condiciones del ensayo, establezca valores de corte específicos del laboratorio al implementar este protocolo.
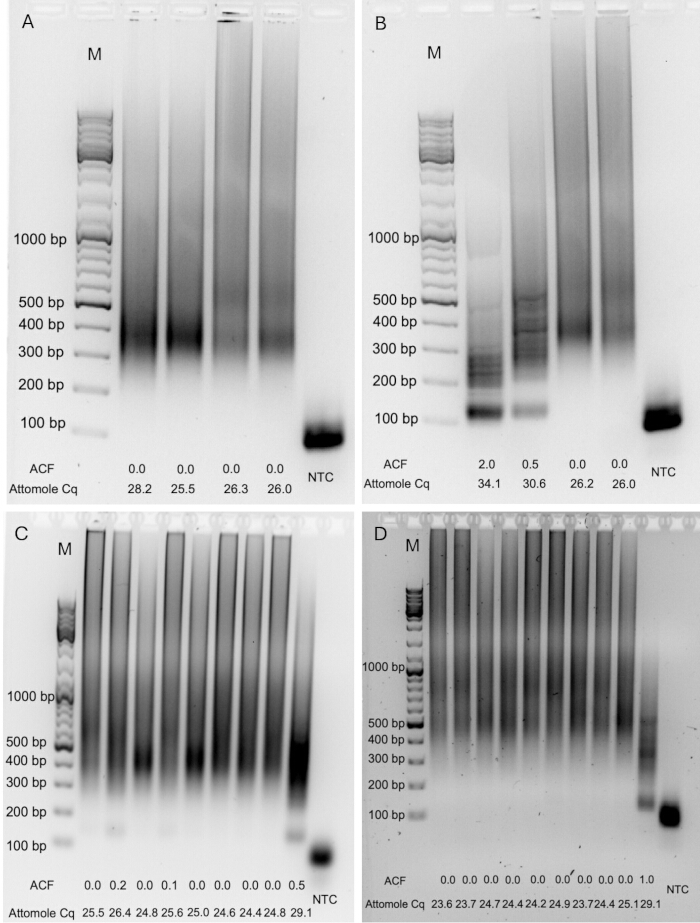
Figura 2. Productos representativos de PCR cuantitativa en attomoles (qPCR) utilizados para estimar la cantidad de biblioteca y detectar dímeros de adaptador/primer. Los productos amplificados de qPCR en attomoles se analizaron mediante electroforesis en gel de agarosa al 1,5 % para evaluar la distribución del tamaño de los fragmentos y detectar dímeros residuales de adaptador/primer. (A–D) Ejemplos representativos que muestran bibliotecas con diferentes cantidades de ADN ligado a adaptador y distintos niveles de dímeros de adaptador/primer. Se muestra el factor de corrección de ciclos cuantitativos en attomoles (ACF) y el ciclo cuantitativo (Cq) sin corregir correspondiente para cada muestra. M, marcador de tamaño de ADN; NTC, control sin molde. Haga clic aquí para ver una versión más grande de esta figura.
11. Estimación del enriquecimiento de ADN mitocondrial (opcional)
NOTA: Estime el enriquecimiento del ADN mitocondrial (ADNmt) mediante qPCR utilizando cebadores dirigidos al gen mitocondrial ND6 y a los elementos nucleares Alu. Calcule la diferencia en los valores de Cq entre las dianas nucleares y mitocondriales para estimar el enriquecimiento del ADNmt. Utilice el valor absoluto de Cq de la diana mitocondrial para estimar la cantidad de ADNmt en la muestra. Los valores de Cq pueden variar según los reactivos, los materiales desechables y el instrumento de PCR en tiempo real utilizados. Ajuste las secuencias de los cebadores para otras especies. Consulte publicaciones anteriores para cebadores específicos de ratón y macaco12,13. Este paso es opcional y proporciona una estimación aproximada del enriquecimiento de ADNmt antes del secuenciamiento.
- Prepare mezclas maestras separadas para los dianas mitocondriales y nucleares. Para cada reacción, combine 5 µL de Mezcla PowerUp SYBR Green 2×, 0,4 µL de cada cebador del par de cebadores respectivo (10 µM cada uno) y 2,1 µL de agua grado biología molecular.
- Añada 8 µL de la mezcla maestra apropiada a cada pocillo designado de una placa de 96 pocillos compatible con qPCR. Añada 2 µL de la muestra diluida 1:10 para obtener un volumen final de reacción de 10 µL.
- Selle la placa y centrifúguela brevemente antes de colocarla en el instrumento de PCR en tiempo real.
- Realice la qPCR utilizando las siguientes condiciones de ciclado térmico: 2 min a 95°C, seguidos de 45 ciclos de 15 s a 95°C, 20 s a 56°C y 30 s a 72°C.
- Determine el Cq ajustando el umbral de fluorescencia a 100 RFU.
NOTA: Seleccione un umbral de fluorescencia compatible con el instrumento de PCR en tiempo real y utilice el mismo umbral en todos los experimentos para permitir la comparación de los valores de Cq. Correlacione los valores de Cq con las eficiencias de enriquecimiento derivadas del secuenciamiento y utilice estos valores como referencia para preparaciones posteriores de bibliotecas. - Calcule el ΔCq asociado al enriquecimiento restando el Cq de la diana nuclear del Cq de la diana mitocondrial (CqmtDNA − CqnDNA). Una vez que estén disponibles los datos iniciales de secuenciamiento, genere una curva estándar específica del laboratorio para estimar la proporción de lecturas de secuenciamiento derivadas de mtDNA.
NOTA: Si aún no están disponibles los datos de secuenciamiento, se puede utilizar la Ecuación 1 para obtener una estimación aproximada del porcentaje esperado de lecturas de secuenciamiento derivadas de mtDNA, usando una curva estándar de ejemplo generada a partir de siete bibliotecas de ovocitos (ΔCq = −0,8, 16,83 %; ΔCq = −2,1, 33,62 %; ΔCq = −3,0, 45,57 %; ΔCq = −3,9, 60,34 %; ΔCq = −5,0, 77,98 %; ΔCq = −6,2, 89,25 %; ΔCq = −8,4, 95,09 %). Se debe alcanzar un valor de ΔCq <−1 para asegurar una eliminación eficiente del ADN nuclear. Las eficiencias de enriquecimiento más bajas pueden compensarse asignando lecturas de secuenciamiento adicionales para obtener una profundidad de secuenciamiento de mtDNA suficiente; sin embargo, esto podría aumentar la contaminación por segmentos de ADN mitocondrial nuclear (NUMT). Dado que la relación entre ΔCq y el contenido de mtDNA depende de los reactivos, materiales de consumo, instrumentación y condiciones experimentales, la Ecuación 1 debe considerarse como un ejemplo de calibración, y siempre que sea posible se deben establecer curvas estándar específicas del laboratorio.
mtDNA estimado (%) = −11,006 × ΔCq + 13,776 (1)
12. Amplificación de la biblioteca
NOTA: Realice la primera amplificación en dos pasos consecutivos de PCR. Realice la primera PCR utilizando un cebador único para generar una amplificación lineal. Posteriormente, agregue el segundo cebador para permitir una amplificación exponencial durante la segunda PCR.
- Determine la cantidad de ADN de entrada para la primera PCR de amplificación utilizando los resultados de la qPCR en attomoles.
- Para bibliotecas de óvulos individuales, utilice muestras con un valor Cq en la qPCR de attomoles típicamente mayor de 22. Si una muestra tiene un valor Cq más bajo, dilúyala hasta alcanzar un valor Cq de aproximadamente 22 según la Tabla 3. Las bibliotecas con valores Cq ≥29 generalmente producen tamaños grandes de familias y profundidades bajas de secuenciación del ADN mitocondrial, por lo que no se recomiendan para la preparación ni secuenciación posteriores de bibliotecas.
- Prepare una mezcla maestra de amplificación que contenga 20 µL de mezcla de PCR de alta fidelidad 2× y 4 µL del cebador mws20 (10 µM) por reacción.
- Añada 24 µL de la mezcla maestra de amplificación a 14 µL de la muestra diluida.
- Realice la PCR de amplificación lineal utilizando las siguientes condiciones de ciclado térmico: 45 s a 98°C, seguidos de 12 ciclos de 15 s a 98°C, 30 s a 60°C y 45 s a 72°C, seguidos de 2 min a 72°C.
- Añada 4 µL del cebador universal de biblioteca (10 µM) y mezcle bien.
- Realice la PCR de amplificación exponencial utilizando las siguientes condiciones de ciclado térmico: 45 s a 98°C, seguidos de 9 ciclos de 15 s a 98°C, 30 s a 65°C y 45 s a 72°C, seguidos de una extensión de 2 min a 72°C.
NOTA: Tras completar la primera amplificación, las muestras pueden almacenarse a 4°C y el protocolo puede reanudarse más tarde si es necesario. Realice todos los pasos anteriores, desde la lisis del óvulo hasta la primera amplificación, sin interrupciones. - Añada 10 µL de agua de grado para biología molecular a cada muestra.
- Purifique el ADN amplificado utilizando 40 µL de perlas magnéticas (0,8× el volumen de la muestra), siguiendo el segundo procedimiento de purificación con perlas magnéticas descrito en los pasos 9.9–9.15. Lave las perlas dos veces con 200 µL de EtOH al 80%, eluya el ADN en 15,5 µL de Tris-HCl y transfiera 15 µL del eluato a un nuevo tubo de baja unión de 200 µL.
NOTA: Este es un punto adecuado para detenerse. Almacene el ADN purificado a 4°C o continúe inmediatamente con la indexación.
Tabla 3: Factores de dilución y factores de corrección correspondientes del ciclo de cuantificación (Cq) en reacción en cadena de la polimerasa cuantitativa (qPCR) utilizados para estandarizar la cantidad de ADN en la primera reacción en cadena de la polimerasa (PCR) de amplificación de la biblioteca. Las muestras con valores de Cq en qPCR en attomoles por debajo del valor objetivo se diluyeron con agua de grado para biología molecular antes de la primera PCR de amplificación. El valor de Cq corregido se obtuvo sumando el factor de corrección de dilución apropiado al valor de Cq medido experimentalmente y se utilizó posteriormente para determinar el número de ciclos de PCR de indexación y la profundidad de secuenciación objetivo (Tabla 4). Los volúmenes de muestra y de agua producen un volumen final de entrada de 14 µL para la primera PCR de amplificación. El asterisco (*) indica que el factor de corrección de dilución indicado debe sumarse al valor de Cq en qPCR en attomoles medido experimentalmente para obtener el Cq corregido. Los factores de corrección se determinaron empíricamente para este procedimiento. Haga clic aquí para descargar este archivo.
13. Indexación
- Determine el número de ciclos de PCR de indexación utilizando el valor de Cq de qPCR en attomoles corregido por dímeros y dilución según la Tabla 4.
- Prepare una mezcla maestra de indexación que contenga 25 µL de mezcla de PCR de alta fidelidad 2× y 10 µL de un par de cebadores duales únicos 10 µM para cada muestra.
- Añada 35 µL de la mezcla maestra de indexación a 15 µL de cada muestra amplificada.
- Realice la PCR de indexación utilizando las siguientes condiciones de ciclado térmico: 45 s a 98°C, seguidos del número adecuado de ciclos compuestos por 15 s a 98°C, 30 s a 65°C y 45 s a 72°C, seguidos de una extensión final a 72°C durante 2 min.
- Purifique las bibliotecas indexadas utilizando 40 µL de perlas magnéticas (0,8× el volumen de la muestra). Lave las perlas dos veces con EtOH al 80 % y eluya el ADN en 21 µL de tampón TElow.
- Transfiera el eluato a un tubo de baja unión para ADN.
- Mida la concentración de ADN utilizando un ensayo de ADN de alta sensibilidad Qubit o un ensayo fluorométrico equivalente.
- Almacene las bibliotecas a 4°C antes de la secuenciación o a −80°C para almacenamiento a largo plazo.
NOTA: Este es un punto seguro para detenerse.
Tabla 4: Números de ciclos de reacción en cadena de la polimerasa (PCR) de indexación y profundidad objetivo de secuenciación determinados a partir del ciclo de cuantificación (Cq) de la reacción en cadena de la polimerasa cuantitativa (qPCR) corregido en attomoles. El valor de Cq corregido incorpora el valor de Cq de qPCR en attomoles medido experimentalmente junto con cualquier factor de corrección aplicable por dímero de adaptador (Figura 2) y el factor de corrección por dilución (Tabla 3). El valor de Cq corregido se utilizó para determinar tanto el número de ciclos de PCR de indexación como el número recomendado de lecturas de secuenciación emparejadas asignadas a cada biblioteca para su agrupación. Las asignaciones objetivo de lecturas de secuenciación sirven como una guía inicial y pueden requerir una optimización específica del laboratorio según el instrumento de PCR en tiempo real, la plataforma de secuenciación, la estrategia de multiplexación y los requisitos experimentales. Haga clic aquí para descargar este archivo.
14. Control de Calidad
- Evalúe la calidad de la biblioteca, la distribución del tamaño de los fragmentos y la presencia de dímeros residuales de adaptador o cebadores mediante un Bioanalyzer, TapeStation o un instrumento equivalente para análisis de fragmentos de ácidos nucleicos. El tamaño de los fragmentos debe oscilar aproximadamente entre 300 y 1.000 pb. Se aceptaron generalmente picos residuales pequeños (<5% de la intensidad de fluorescencia de la muestra [RFU] en el trazado del Bioanalyzer) (Figura 3A–D). Los dímeros residuales de adaptador o cebadores aparecieron como picos distintos alrededor de 70–150 pb (Figura 3E–H). La concentración final de la biblioteca debe ser al menos de 5 ng/µL. Consulte el Archivo Suplementario 1 (Guía de solución de problemas) si no se cumplen alguno de estos criterios de calidad.
- (Opcional) Si se detectan dímeros de adaptador o cebadores (Figura 3E–H), ajuste el volumen de la biblioteca a 50 µL con agua de grado para biología molecular, agregue 40 µL de perlas magnéticas (0,8× volumen de la muestra) y realice una purificación adicional. Lave las perlas dos veces con EtOH al 80% y eluya la biblioteca purificada en 21,5 µL de tampón TElow.
- (Opcional) Repita el análisis de control de calidad (Paso 14.1) para confirmar la eliminación completa de los dímeros de adaptador y cebadores.
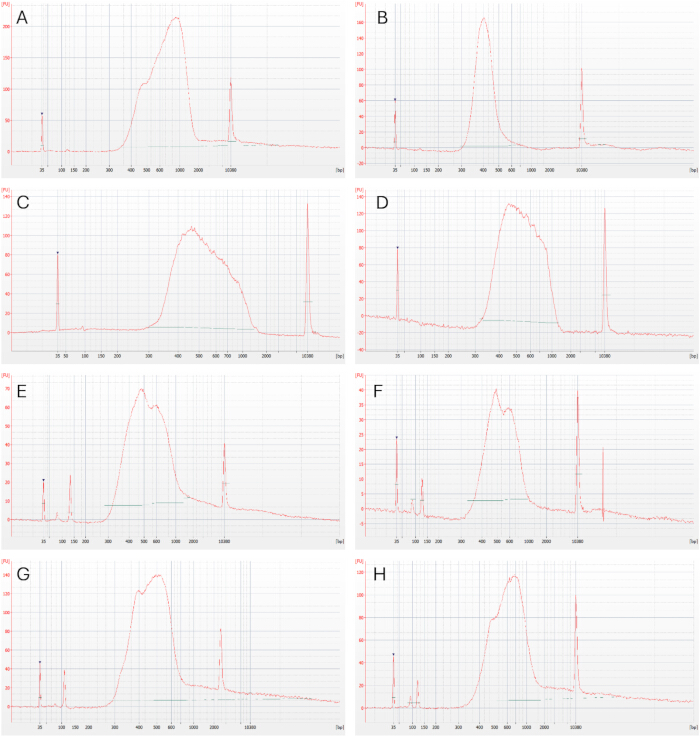
Figura 3. Análisis representativo de fragmentos de bibliotecas de secuenciación con índices. Electroferogramas representativos generados mediante análisis de fragmentos en el Bioanalyzer que muestran la calidad de las bibliotecas tras la PCR de indexación. (A–D) Bibliotecas con distribución de tamaño de fragmentos esperada (aproximadamente 300-1000 pb) y sin dímeros de adaptador/primer detectables, adecuadas para secuenciación sin purificación adicional. (E–H) Bibliotecas que contienen dímeros residuales de adaptador y/o de primer que requieren una purificación adicional con perlas magnéticas antes de la secuenciación. Los picos en aproximadamente 35 pb y 10.380 pb corresponden a los marcadores internos inferior y superior, respectivamente. Haga clic aquí para ver una versión más grande de esta figura.
15. Agrupación y secuenciación
- Mida la concentración de cada biblioteca indexada utilizando un ensayo de cuantificación de bibliotecas basado en qPCR compatible con bibliotecas preparadas para Illumina, como el Collibri Library Quantification Kit, según el protocolo del fabricante. Diluya cada biblioteca 1:100,000 en el tampón de dilución de bibliotecas suministrado y analice cada muestra en al menos duplicado; se recomienda realizar mediciones por triplicado. Analice los patrones por triplicado.
- Calcule el valor medio del ciclo de cuantificación (Cq) para cada muestra y patrón. Genere una curva patrón a partir de los valores medios de Cq de los patrones y calcule la concentración de cada biblioteca según las instrucciones del fabricante.
- Combine las bibliotecas según el número previsto de lecturas emparejadas determinado a partir del valor de Cq en attomoles corregido por dímero de adaptador y dilución obtenido en el Paso 10 y las asignaciones indicadas en Tabla 4.
NOTA: La proporción de mezcla depende del valor de Cq corregido de cada biblioteca de ovocito y del número objetivo correspondiente de lecturas emparejadas. Los valores en la Tabla 4 son aproximados y pueden variar entre diferentes instrumentos de PCR en tiempo real. Establezca valores específicos para su laboratorio para obtener un rendimiento óptimo. - Calcule la fracción relativa de mezcla para cada biblioteca dividiendo su número objetivo de lecturas emparejadas entre la suma de las lecturas objetivo asignadas a todas las bibliotecas. Determine la cantidad requerida de cada biblioteca multiplicando esta fracción por la cantidad molar total del grupo final, luego calcule el volumen correspondiente de la biblioteca a partir de su concentración molar medida. Combine los volúmenes calculados para generar el grupo final.
- Secuencie las bibliotecas combinadas utilizando una plataforma de secuenciación Illumina o cualquier otra plataforma compatible con las secuencias de adaptador de Illumina. Utilice una configuración de lectura emparejada con una longitud mínima de lectura de 2 × 150 pb. Se recomiendan lecturas más largas, como 2 × 250 o 2 × 300 pb, ya que mejoran la capacidad de identificar y filtrar lecturas derivadas de segmentos nucleares más cortos de ADN mitocondrial (NUMTs).
- Secuencie las bibliotecas combinadas, por ejemplo, en una plataforma Illumina NovaSeq 6000 utilizando química de secuenciación por síntesis de dos canales con un Kit de Reactivos SP v1.5 (500 ciclos) y una configuración de lectura emparejada de 2 × 250 pb, incluyendo un control interno de PhiX al 5%. Cargue la biblioteca y realice la secuenciación según las instrucciones del fabricante. El rendimiento representativo de la secuenciación debe alcanzar ≥75% de bases con una puntuación de calidad ≥Q30 y ≥60% de agrupamientos que pasen el filtro.
16. Análisis bioinformático
NOTA: El siguiente flujo de trabajo describe el análisis de datos en Galaxy utilizando las herramientas de análisis Du Novo8,14,15. El análisis también puede realizarse utilizando una instalación local de Du Novo u otro software desarrollado para datos de secuenciación dúplex.
- Cargue los archivos FASTQ de lecturas emparejadas desmultiplexados, generados mediante BCL Convert o una herramienta equivalente de desmultiplexado, en una instalación local de Galaxy o en una instancia pública de Galaxy14.
- Evalúe la calidad de las lecturas de secuenciación utilizando FastQC (versión Galaxy 0.72+galaxy1). Revise, como mínimo, los módulos Calidad de Secuencia por Base, Contenido de GC por Secuencia y Contenido de Adaptadores.
- Genere secuencias de consenso de cadena sencilla (SSCS) y secuencias de consenso de doble cadena (DCS) a partir de los archivos FASTQ desmultiplexados mediante la tubería Du Novo (versión Galaxy 3.0.2). Utilice un tamaño mínimo de familia de tres lecturas para la formación de SSCS y llame un nucleótido de consenso cuando esté presente en al menos el 70 % de las lecturas15. Active la corrección de errores en códigos de barras con hasta tres desajustes. Consulte el tutorial de Du Novo de la Galaxy Training Network para obtener instrucciones detalladas sobre el uso de la tubería16.
- Utilice Sequence Content Trimmer (versión Galaxy 0.2.3) para eliminar las bases representadas por “NRYSWKMBDHV” y descarte lecturas más cortas que 10 pb.
- Recorte los primeros 10 nucleótidos del extremo 5′ de cada DCS utilizando FASTQ Trimmer (versión Galaxy 1.1.5) para reducir el sesgo asociado con la reparación de extremos. Alinee las lecturas DCS recortadas con el genoma de referencia humano, como GRCh38.p14 que contiene la Secuencia de Referencia de Cambridge revisada (rCRS; NC_012920.1), utilizando BWA-MEM (versión Galaxy 0.7.17.1).
NOTA: Pueden utilizarse otros ensamblajes del genoma humano, incluyendo T2T-CHM13v2.0 o ensamblajes más recientes. - Filtre los archivos BAM utilizando BAMTools Filter BAM datasets on a variety of attributes (versión Galaxy 2.5.2+galaxy1). Mantenga lecturas con una calidad de alineamiento >20 que se ubiquen en chrM, representen alineamientos primarios, estén emparejadas, estén correctamente emparejadas y tengan una lectura emparejada alineada. Estos criterios reducen los alineamientos potenciales derivados de NUMT17.
- Desplace las lecturas hacia la izquierda utilizando Bam Left Align (versión Galaxy 1.3.1). Recorte las regiones superpuestas de lecturas DCS emparejadas utilizando BAMUtil clipOverlap (versión Galaxy 1.0.15+galaxy1).
- Llame variantes de nucleótido único (SNV) e inserciones/eliminaciones (indels) utilizando Call variants with LoFreq (versión Galaxy 2.1.5+galaxy2) con los parámetros predeterminados.
- Excluya lecturas DCS emparejadas que contengan más de dos variantes, cuando estén presentes, para reducir la posible contaminación por NUMT. Las muestras con enriquecimiento eficiente de ADNmt generalmente carecen de lecturas derivadas de NUMT detectables; sin embargo, una depleción insuficiente de ADN nuclear puede dar lugar a secuencias derivadas de NUMT.
- Revise cada biblioteca en busca de posible contaminación cruzada entre muestras utilizando diferencias en la secuencia de ADNmt específicas del donante, incluyendo variantes fijas y heteroplasmias de alta frecuencia. Si se detecta contaminación cruzada, aplique las precauciones descritas en Archivo Suplementario 1 (Guía de Resolución de Problemas). Si la distribución del tamaño de fragmentos excede el rango recomendado o el tamaño promedio de fragmento es >900 pb, realice una purificación doble con selección por tamaño según se describió previamente18.
- Realice análisis posteriores de las variantes detectadas de acuerdo con los objetivos del estudio.
- Incluya únicamente muestras con una profundidad media de secuenciación mitocondrial DCS de ≥100× para el análisis posterior. No se aplicaron umbrales mínimos fijos para el recuento de lecturas emparejadas ni para el rendimiento de SSCS o DCS.
Resultados
Las bibliotecas de secuenciación por duplicado se prepararon a partir de ovocitos humanos que representaban diferentes etapas de maduración, incluyendo ovocitos en la etapa de vesícula germinativa (GV), metafase I (MI), MII, etapa de pronúcleo (0PN) y ovocitos TI. Las bibliotecas preparadas con éxito se secuenciaron en una plataforma Illumina NovaSeq 6000 utilizando una celda de flujo SP con lecturas apareadas de 2 × 250 pb. El análisis de datos se realizó en Galaxy utilizando la tubería Du Novo para la agrupación de familias de lecturas y la generación de lecturas de consenso8,14,15. Las métricas representativas de secuenciación para las bibliotecas procesadas con éxito se resumen en la Tabla Suplementaria 1, mientras que las muestras que produjeron resultados subóptimos durante la preparación de las bibliotecas y que fueron excluidas de la secuenciación se resumen en la Tabla Suplementaria 2.
Se realizaron varios pasos de control de calidad durante la preparación de la biblioteca para evaluar la cantidad de ADN ligado a adaptadores, el enriquecimiento de ADN mitocondrial, la concentración de la biblioteca y la distribución del tamaño de los fragmentos. El primer paso de control de calidad fue el ensayo de qPCR en attomoles, que se utilizó para estimar la cantidad de ADN ligado a adaptadores (Figura 4A,B). El valor de ciclo de cuantificación (Cq) calculado se ajustó cuando se detectaron dímeros de adaptador o cebadores mediante electroforesis en gel de agarosa de los productos de amplificación de qPCR (Figura 2A–D). Los dímeros de adaptador o cebadores se observaron típicamente en muestras con valores de Cq más altos, lo que indica menores cantidades de ADN ligado a adaptadores. Utilizando las condiciones descritas en este protocolo, se obtuvo un valor medio ajustado de Cq en qPCR en attomoles de 25,8 (Tabla Suplementaria 1). En función del valor de Cq corregido, se ajustó la cantidad de ADN para la primera PCR de amplificación según el esquema de dilución mostrado en la Tabla 3. Las muestras con valores de Cq corregidos ≥22 se utilizaron sin dilución, mientras que las muestras con valores de Cq corregidos <22 se diluyeron antes de la amplificación. Este ajuste se realizó para optimizar el tamaño de la familia de lecturas y reducir el número de lecturas de secuenciación necesarias. Las muestras con valores de Cq corregidos >28 generalmente produjeron familias de lecturas más grandes (tamaño medio de la familia, 21,8), lo que resultó en menos DCS y una profundidad media de secuenciación de ADN mitocondrial de <200× (Tabla Suplementaria 1). Ajustar el valor de Cq corregido a 22–28 dio como resultado un tamaño medio de familia de 7,91, cercano al tamaño de familia de aproximadamente seis reportado previamente como óptimo para la secuenciación en dúplex6,7. Sin embargo, tamaños de familia más grandes pueden ser ventajosos para muestras con entradas muy bajas, como óvulos individuales, ya que pueden aumentar la profundidad de secuenciación.
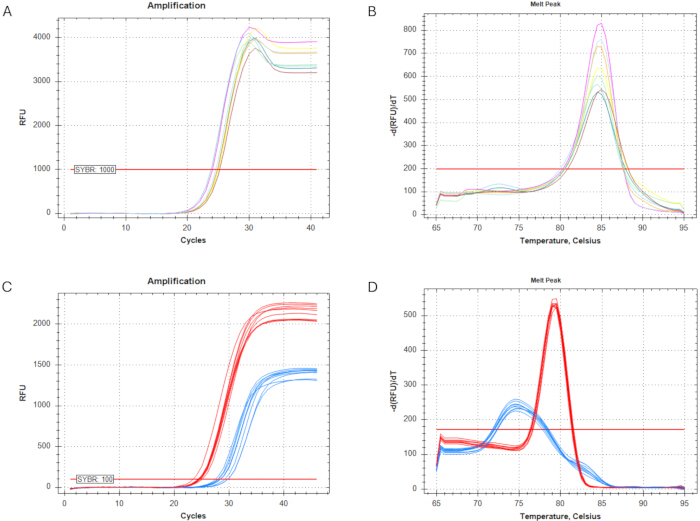
Figura 4. Ensayos de PCR cuantitativa (qPCR) utilizados para la cuantificación de bibliotecas y la estimación del enriquecimiento de ADN mitocondrial (ADNmt). El ADN ligado a adaptadores purificado se diluyó 1:10 antes del análisis de qPCR. (A) Curvas de amplificación del ensayo de qPCR en attomoles utilizado para estimar la cantidad de ADN ligado a adaptadores. El umbral de fluorescencia se estableció en 1.000 unidades de fluorescencia relativa (UFR). (B) Análisis de la curva de disociación del ensayo de qPCR en attomoles. (C) Curvas de amplificación del ensayo de qPCR para la estimación del enriquecimiento de ADNmt. El umbral de fluorescencia se estableció en 100 UFR. La amplificación del blanco mitocondrial, subunidad 6 de la deshidrogenasa NADH (ND6), se muestra en rojo, y la amplificación del blanco nuclear, elemento repetitivo Alu, se muestra en azul. (D) Análisis de la curva de disociación de los productos de qPCR mitocondrial y nuclear. Haga clic aquí para ver una versión más grande de esta figura.
Antes de la agrupación de bibliotecas, todas se analizaron mediante un Bioanalyzer o TapeStation para evaluar la distribución del tamaño de fragmentos y detectar dímeros residuales de adaptadores o cebadores. En la Figura 3A–H se muestran ejemplos representativos de bibliotecas óptimas y de bibliotecas que contienen dímeros residuales de adaptadores o cebadores. Los dímeros de adaptadores o cebadores aparecieron como picos de aproximadamente 70–150 pb (Figura 3E–H); cuando se detectaron, las bibliotecas se sometieron a una purificación adicional con perlas magnéticas antes de la secuenciación. Dado que se omitió intencionalmente la selección por tamaño para minimizar la pérdida de muestra, las bibliotecas secuenciadas tuvieron un tamaño mediano de inserción de 275 pb (Tabla Suplementaria 1).
El enriquecimiento de ADN mitocondrial se estimó mediante qPCR utilizando loci diana mitocondriales y nucleares, lo que permitió predecir la proporción de lecturas de secuenciación que se esperaba que se alinearan con el genoma mitocondrial (Figura 4C,D). Los valores promedio de Cq fueron 25,2 para el blanco mitocondrial y 29,7 para el blanco nuclear (Tabla suplementaria 1), lo que corresponde a un ΔCq medio (CqmtDNA − CqnDNA) de −4,5. En promedio, el 67,5 % de las lecturas de secuenciación de extremos emparejados se alinearon con el genoma de referencia mitocondrial. Tanto la estimación de enriquecimiento de ADNmt como el valor de Cq corregido en attomoles obtenido por qPCR se consideraron durante la agrupación de las bibliotecas. A las bibliotecas con valores de Cq corregidos más altos y un enriquecimiento más eficiente de ADNmt se les asignó proporcionalmente un menor número de lecturas de secuenciación según el esquema de asignación de secuenciación mostrado en Tabla 4, con el fin de promover una salida equilibrada de secuenciación entre las muestras.
Basándose en los valores corregidos de Cq de qPCR en attomoles, se asignó un promedio de 4 millones de lecturas apareadas por biblioteca (Tabla 4). Debido a una generación ineficiente de cúmulos, se obtuvo un promedio de 1,3 millones de lecturas apareadas por biblioteca tras el secuenciamiento; sin embargo, este rendimiento de secuenciamiento fue suficiente para el análisis posterior de secuenciación en dúplex (Tabla Suplementaria 1). La alineación de las DCS a la secuencia de referencia mitocondrial produjo una profundidad mediana de secuenciamiento de 567× a lo largo del genoma mitocondrial (Figura 5A,B,D; Tabla Suplementaria 1). En promedio, se generaron 344.554 SSCS y 96.322 DCS por biblioteca (Tabla Suplementaria 1). Las bibliotecas resultantes tuvieron un tamaño medio de familia de lecturas de 8,32, observándose generalmente tamaños de familia más grandes en aquellas bibliotecas con valores corregidos más altos de Cq de qPCR en attomoles (Figura 5C,E; Tabla Suplementaria 1). Estos resultados son coherentes con los obtenidos en un estudio previo realizado a densidad óptima de cúmulos, en el que se alcanzó una profundidad mediana de secuenciamiento de mtDNA de 1.440×19.
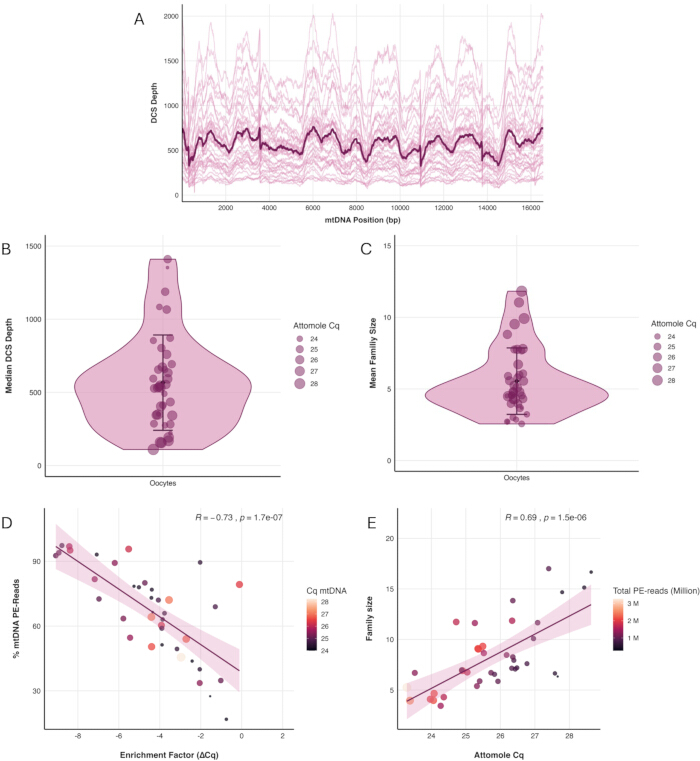
Figura 5. Rendimiento de secuenciación de bibliotecas de secuenciación dúplex de ovocitos individuales. (A) Profundidad de la secuencia de consenso dúplex (DCS) a lo largo del genoma mitocondrial. Las líneas delgadas representan bibliotecas individuales, y la línea gruesa representa la profundidad media de todas las bibliotecas. (B) Distribución de la profundidad mediana de DCS para bibliotecas individuales. (C) Distribución del tamaño medio de la familia DCS para bibliotecas individuales. En (B) y (C), cada punto representa una biblioteca, y el color del punto indica el ciclo de cuantificación (Cq) de la qPCR en attomoles. (D) Correlación de Pearson entre la estimación de enriquecimiento de mtADN (ΔCq) y la proporción de lecturas de secuenciación alineadas al genoma de referencia mitocondrial. (E) Correlación de Pearson entre el valor de Cq de la qPCR en attomoles y el tamaño medio de la familia DCS. En (D) y (E), cada punto representa una biblioteca; el color del punto indica el valor de Cq de la qPCR en attomoles, y el tamaño del punto representa el número total de lecturas emparejadas obtenidas para esa biblioteca. n = 39 bibliotecas. Haga clic aquí para ver una versión ampliada de esta figura.
Tabla suplementaria 1. Métricas de secuenciación y calidad de bibliotecas para bibliotecas óptimas de secuenciación dúplex de ovocitos humanos. Esta tabla resume las métricas de calidad de bibliotecas previas a la secuenciación, mediciones de reacción en cadena de la polimerasa cuantitativa (qPCR), rendimiento de secuenciación y resultados del análisis de secuenciación dúplex para bibliotecas que superaron el control de calidad y se incluyeron en análisis posteriores. Los parámetros reportados incluyen la etapa de desarrollo del ovocito, resultados de qPCR de enriquecimiento de ADN mitocondrial (mtDNA), mediciones de qPCR en attomoles, factor de corrección de dímero de adaptador (ACF), número de ciclos de PCR de indexado, profundidad intencionada de secuenciación de extremos emparejados, concentración de la biblioteca, rendimiento de secuenciación, enriquecimiento de mtDNA, conteos de lecturas de secuencia de consenso de cadena sencilla (SSCS) y secuencia de consenso dúplex (DCS), estadísticas de tamaño de familia, profundidad de secuenciación y distribuciones de tamaño de inserción. Los identificadores de muestra se anonimizaron antes del análisis. Los números intencionados de lecturas de extremos emparejados se asignaron según el valor corregido del ciclo de cuantificación (Cq) de la qPCR en attomoles (Tabla 4). Haga clic aquí para descargar este archivo.
Tabla suplementaria 2. Métricas de calidad previas al secuenciamiento para bibliotecas de ovocitos humanos subóptimos excluidas de los análisis de secuenciamiento dúplex posteriores. Esta tabla resume los resultados del control de calidad previos al secuenciamiento para bibliotecas que no cumplieron con los criterios de inclusión en los análisis de secuenciamiento posteriores. Los parámetros reportados incluyen identificador de la muestra, etapa de desarrollo del ovocito, resultados de la reacción en cadena de la polimerasa cuantitativa (qPCR) para enriquecimiento de ADN mitocondrial (mtDNA), factor de corrección de dímeros de adaptador (ACF), ciclo de cuantificación qPCR corregido en attomoles (Cq), número de ciclos de la reacción en cadena de la polimerasa (PCR) de indexación y concentración de la biblioteca medida mediante el ensayo de ADN de alta sensibilidad Qubit. Las bibliotecas fueron excluidas según los criterios de control de calidad descritos en el protocolo. Haga clic aquí para descargar este archivo.
Archivo suplementario 1. Guía de solución de problemas para la preparación de bibliotecas de secuenciación dúplex de ADN mitocondrial de un solo ovocito. Este archivo suplementario proporciona recomendaciones para la solución de problemas en pasos críticos del protocolo, incluyendo la prevención de la pérdida de muestras, la preparación y evaluación de la calidad de los adaptadores, la purificación con perlas magnéticas, el control de calidad de la biblioteca, el rendimiento de la secuenciación, la contaminación entre muestras y la contaminación por segmentos nucleares de ADN mitocondrial (NUMT). La guía complementa el protocolo principal y debe consultarse cuando las métricas de calidad de la biblioteca o el rendimiento de la secuenciación se encuentren fuera de los rangos recomendados. Haga clic aquí para descargar este archivo.
Discusión
Las variantes de ADNmt identificadas en ovocitos reflejan una combinación de mutagénesis de novo, cambios en la heteroplasmia a través de generaciones y los efectos del envejecimiento y las enfermedades sobre la línea germinal femenina. Este protocolo describe un método para enriquecer el ADNmt a partir de ovocitos individuales, seguido de la preparación de una biblioteca de secuenciación duplex y la secuenciación, lo que permite la detección y análisis altamente precisos de mutaciones en el ADNmt. A pesar del alto número de copias de ADNmt presente en los ovocitos, este flujo de trabajo requiere la preparación de una biblioteca completa de secuenciación a partir de una sola célula. Por consiguiente, es esencial un manejo cuidadoso de las muestras durante todo el procedimiento, tal como se detalla en el Archivo Suplementario 1 (Guía de Resolución de Problemas). A pesar del manejo cuidadoso de las muestras, aproximadamente el 5 % de las preparaciones de bibliotecas pueden fallar debido a la pérdida del ovocito durante las etapas iniciales de manipulación o a la pérdida de la muestra durante la preparación de la biblioteca.
El control de calidad durante y después de la preparación de la biblioteca es esencial para verificar la ligación exitosa de los adaptadores, evaluar el enriquecimiento del ADN mitocondrial, optimizar la cantidad de ADN para la amplificación, detectar la presencia de adaptadores residuales o dímeros de cebadores, y determinar si se requieren pasos adicionales de purificación o amplificación. El uso del mismo instrumento de qPCR en tiempo real durante la preparación de bibliotecas proporciona condiciones de reacción consistentes y mejora la comparabilidad, reproducibilidad y fiabilidad de las mediciones utilizadas para el control de calidad posterior y la optimización del protocolo. Los números de ciclos de PCR para la amplificación y la indexación de la biblioteca descritos en este protocolo podrían requerir ajustes cuando se utilicen instrumentos, enzimas o reactivos diferentes. El paso inicial de amplificación se divide en una fase de amplificación lineal que utiliza un solo cebador, seguida de una amplificación exponencial tras la adición del segundo cebador. Esta estrategia minimiza la probabilidad de que los errores introducidos durante el primer ciclo de amplificación se propaguen a niveles en los que resulte difícil distinguirlos de mutaciones reales del ADN. Los números de ciclos recomendados se seleccionaron para lograr un tamaño óptimo de familia de lecturas para el análisis de secuenciación en duplex; sin embargo, podrían requerir optimización dependiendo de la cantidad y calidad del ADN de entrada. Las muestras con menor cantidad de ADN de entrada podrían necesitar ciclos adicionales de amplificación, mientras que las muestras con mayor cantidad de ADN de entrada podrían requerir menos ciclos para evitar la sobre-amplificación y preservar la complejidad de la biblioteca.
Aunque este protocolo se demuestra utilizando ovocitos humanos individuales, el flujo de trabajo no se limita a muestras humanas. Anteriormente hemos aplicado el mismo enfoque para investigar la mutagénesis en la línea germinal de ratones y macacos12,13, lo que indica que la preparación de bibliotecas de secuenciación dúplex es aplicable a ovocitos de múltiples especies tras la optimización de las secuencias de cebadores específicas de cada especie y, cuando sea necesario, de otros parámetros experimentales. A pesar de la amplia aplicabilidad de la secuenciación dúplex, el procedimiento de enriquecimiento de ADN mitocondrial y preparación de bibliotecas descrito aquí no es fácilmente transferible a células somáticas individuales, ya que sus números de copias de ADNmt son típicamente varios órdenes de magnitud más bajos que los de los ovocitos, lo que limita la cantidad de ADN de entrada disponible para la preparación de la biblioteca. Sin embargo, se pueden generar bibliotecas de secuenciación dúplex a partir de muestras masivas de células somáticas cuando se combinan con un enriquecimiento optimizado de ADNmt antes de la preparación de la biblioteca. Otra limitación de la secuenciación dúplex es el requisito de fragmentación del ADN, que puede introducir errores artificiales, particularmente cerca de los extremos de los fragmentos. En consecuencia, las bases situadas en los extremos de los fragmentos suelen excluirse de los análisis posteriores, y la detección y caracterización de inserciones y deleciones también pueden verse afectadas por el proceso de fragmentación. Los avances recientes en tecnologías de secuenciación de lectura larga, particularmente los desarrollados por Oxford Nanopore Technologies, podrían eventualmente permitir la secuenciación altamente precisa de moléculas completas de ADN mitocondrial sin fragmentación. Sin embargo, lograr la precisión necesaria para la detección confiable de mutaciones actualmente depende del análisis de moléculas de ADN nativas, no amplificadas. Dado que la cantidad de ADN presente en un solo ovocito es insuficiente para estos enfoques, su aplicación a este tipo de muestra es actualmente poco práctica.
En comparación con los enfoques utilizados en estudios previos, incluyendo la PCR de rango largo y la secuenciación convencional masivamente paralela20,21,22, este protocolo ofrece varias ventajas. Cada paso de amplificación conlleva el riesgo de introducir mutaciones artificiales que pueden dificultar la detección de variantes de baja frecuencia, lo que a menudo requiere umbrales de frecuencia de alelo menor de al menos el 1%. Por el contrario, la tasa de error sustancialmente más baja lograda mediante la secuenciación en dúplex mejora la precisión en la identificación de mutaciones y supera a la de los enfoques convencionales de secuenciación5. En consecuencia, este método proporciona un marco más confiable para detectar y cuantificar mutaciones raras en el ADN mitocondrial. Mediante este flujo de trabajo, previamente demostramos que, a diferencia de la mayoría de los tejidos somáticos, los óvulos evitan en gran medida la acumulación relacionada con la edad de mutaciones en el ADN mitocondrial19. Si este efecto protector aparente se mantiene en estados patológicos que alteran el microentorno ovárico, como la endometriosis, y que comprometen la calidad del óvulo, sigue siendo desconocido y requiere una investigación adicional.
Divulgaciones
Los autores declaran que no tienen intereses en conflicto.
Agradecimientos
Agradecemos sinceramente al equipo del Centro de Fertilización In Vitro del Hospital Universitario Kepler de Linz por su apoyo en la recolección de ovocitos. También agradecemos a N. Stoler y A. Nekrutenko por desarrollar la instancia de análisis de secuenciación en dúplex en Galaxy y por brindar orientación sobre el análisis de datos. Este trabajo fue financiado por la Becas Schrödinger del Fondo Científico de Austria (FWF) (DOI: 10.55776/J4096; BA) y por el Proyecto Independiente del FWF (DOI: 10.55776/P36928; BA). KDM recibió apoyo, en parte, por la subvención R01GM116044 de los Institutos Nacionales de Salud y por el Fondo de Dotación de la Cátedra Willaman del Colegio Eberly de Ciencias de la Universidad Estatal de Pensilvania.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| 96 pares de cebadores con índices duales únicos | New England Biolabs | E6440S/L | Pares únicos de cebadores con doble índice para la indexación en PCR |
| Etanol absoluto, grado biología molecular, 96 % | Fisher BioReagents | 15518181 | Preparar etanol al 80% fresco con agua de grado para biología molecular |
| Agarosa, baja electroendosmosis | Biozym | 840000 | Para la preparación de geles de agarosa al 1,5 % y al 2 % |
| Solución de acetato de amonio, 5 M | Thermo Fisher Scientific | J60688.AD | Utilizado para la precipitación con etanol |
| ATP, 10 mM | New England Biolabs | P0756S/L | Utilizado para la digestión con Exonucleasa V |
| Instrumento de electroforesis automatizado | Agilent Technologies | G2992AA | Se utilizó el Agilent 2100 Bioanalyzer, que ya no está disponible; puede usarse un 4150 TapeStation o un instrumento equivalente para el análisis de fragmentos de ácidos nucleicos. |
| Kit de ADN de alta sensibilidad para Bioanalyzer | Agilent Technologies | 5067-4626 | Para la evaluación del tamaño de la biblioteca y de los dímeros de adaptador/iniciador |
| Oligonucleótido vehículo | Integrated DNA Technologies (IDT) | Síntesis personalizada | Secuencia no complementaria con el genoma humano. En la Tabla 2 se proporciona una secuencia de ejemplo. Preparar una solución stock de 100 nM y diluir hasta una concentración final de 1 nM. |
| Sistema de Detección de PCR en Tiempo Real CFX96 Touch | Bio-Rad | 12011319 | El instrumento utilizado en este estudio ya no se fabrica; puede utilizarse un instrumento CFX Opus 96 o un equipo equivalente de PCR en tiempo real, aunque los valores de Cq pueden variar. |
| Collibri Library Quantification Kit | Invitrogen | A38524100 | Para la cuantificación de bibliotecas indexadas antes de la agrupación |
| Medio para la eliminación de células del cumulus que contiene hialuronidasa (80 U/mL) | Gynemed | 4 HY 0010 | GM501 Hialuronidasa |
| tubo PCR de baja retención de ADN, 200 µL | Corning | PCR-02-L-C | Tubo Axygen de Máxima Recuperación |
| tubo de baja retención de ADN, 0,5 mL | Biozym | 710136 | |
| Tubo de baja retención de ADN, 1,5 mL | Biozym | 710176 | |
| Fragmento Grande (Klenow) de la ADN Polimerasa I (5 U/µL) | New England Biolabs | M0210S/L | Utilizado durante la extensión del adaptador |
| Mezcla de dNTP (dATP, dCTP, dGTP y dTTP en concentraciones equimolares), 10 mM | New England Biolabs | N0447S/L | Utilizado durante la extensión del adaptador |
| EDTA, 0,5 M (pH 8,0) | Fisher BioReagents | 10628203 | Componente de los tampones TE y TElow |
| colorante EvaGreen, 20× | Biotium | 31077-T | Utilizado en qPCR de attomoles |
| Exonucleasa V (RecBCD), 10 U/µL | New England Biolabs | M0345S/L | Utilizado para la digestión de ADN lineal |
| Peine de altura fija | Bio-Rad | 1704446EDU | Para electroforesis en gel de agarosa |
| Instrumento de ultrasonicación enfocada | Covaris | 500295 | ultrasonificador enfocado M220 |
| tubo de ultrasonido enfocado 50 µL | Covaris | 520166 | microTUBE-50 AFA con tapón de rosca de fibra |
| Colorante para carga de geles, 6×× | Thermo Fisher Scientific | R1161 | TriTrack DNA Loading Dye |
| GM501 Aceite mineral | Gynemed | 4 MO 0100 | Utilizado para cubrir el medio de recolección de ovocitos con el fin de prevenir la evaporación y mantener condiciones de cultivo estériles y estables, incluyendo temperatura, osmolaridad y pH, durante la manipulación de los ovocitos |
| Mezcla de PCR de alta fidelidad, 2× | KAPA Biosystems | KK2602 | KAPA HiFi HotStart ReadyMix |
| Kit de ensayo fluorométrico de ADN de alta sensibilidad | Invitrogen | Q32854 | Kit de ensayo Qubit de ADN bicatenario de alta sensibilidad |
| enzima de restricción HpyCH4III (5 U/µL) | New England Biolabs | R0618S/L | Utilizado para la digestión de restricción con adaptadores |
| Centrífuga de laboratorio, refrigerada | Eppendorf | 5406000313 | Debe soportar 14 000 × g en 4 °C |
| Sistema láser para la apertura de la zona pelúcida | Vitrolife | 19310/0146 | Utilizado para la extracción del cuerpo polar |
| Kit de preparación de bibliotecas | New England Biolabs | E7645S/L | Kit de preparación de bibliotecas de ADN NEBNext Ultra II; incluye reactivos para reparación de extremos/adición de cola A y ligación |
| Solución de cloruro de magnesio, 25 mM | New England Biolabs | B9021S/L | Utilizado para la digestión con Exonucleasa V |
| Reactivo de purificación con perlas magnéticas | Beckman Coulter | A63881 | AMPure XP Perlas |
| Soporte magnético | Invitrogen | 12-321-D | Para la separación con perlas magnéticas |
| Micromanipulador | Luigs & Neumann GmbH | SM II/2 | Utilizado para la eliminación del cuerpo polar |
| Microscopio | Olympus | IX51 | Utilizado para la extracción del cuerpo polar |
| Agua de grado biología molecular | Thermo Fisher Scientific | 327290010 | Utilizado para la preparación de reactivos y diluciones |
| Medio de cultivo de ovocitos | Gynemed | 4 GM 501H-20 | Medio de cultivo GM501 |
| placa de PCR, de 96 pocillos | Biozym | AF4TI-0960-C | Pocillos transparentes, marco transparente, perfil bajo, con faldón |
| Sello para placa de PCR | Bio-Rad | MSB1001B | Compatible con el instrumento de PCR en tiempo real |
| Solución salina tamponada con fosfato (PBS), 20× | Cell Signaling Technology | 9808S | Diluir hasta 1× con agua de grado biología molecular |
| Pipetas para la manipulación y transferencia del cúmulo–complejos de ovocitos (COCs) y ovocitos | CooperSurgical | MXL3-150 (150 µm) | Utilizado para la eliminación mecánica de las células del cúmulo y la transferencia de COCs y ovocitos. Consulte el sitio web del fabricante para obtener tamaños adicionales de pipetas. |
| Fuente de alimentación para electroforesis en gel | Bio-Rad | 1645050 | Fuente de alimentación PowerPac Basic |
| PowerUp SYBR Green Master Mix, 2× | Applied Biosystems | 15350929 | Utilizado para ensayos de qPCR mitocondrial y nuclear |
| Fluorómetro Qubit | Invitrogen | Q33238 | Se utilizó el fluorómetro Qubit 1, que ya no se fabrica; puede usarse una versión más reciente o un instrumento fluorométrico equivalente para la cuantificación de ácidos nucleicos. |
| RNasa A, 10 mg/mL | Thermo Fisher Scientific | 10753721 | Diluir a 1 mg/mL antes de usar |
| Espectrofotómetro | Thermo Fisher Scientific | NDULTRAGL | Se utilizó el instrumento NanoDrop OneC, que ya no está disponible; puede usarse una versión más reciente o un espectrofotómetro microvolumétrico equivalente. |
| Colorante SYBR Safe para geles de ADN | Invitrogen | S33102 | Para electroforesis en gel de agarosa |
| Ciclador térmico | Bio-Rad | 1861096 | Ciclador térmico T100 |
| Proteinasa K termolábil (0,120 U/µL) | New England Biolabs | P8111S/L | Utilizado para la lisis de ovocitos individuales |
| Tris-acetato-EDTA (TAE), 50× | Fisher Scientific | BP1332-1 | Diluir hasta 1× para electroforesis en gel de agarosa |
| Tris-HCl (pH 8,0), 1 M | Fisher BioReagents | 10336763 | Utilizado para la preparación de reactivos y diluciones |
| Tween 20 | Fisher BioReagents | 11417160 | Componente del tampón de lisis de ovocitos |
| Escalera universal de ADN | Thermo Fisher Scientific | SM0333 | GeneRuler DNA Ladder lista para usar (100–1 000 pb |
| Wide Mini-Sub Cell GT Cell | Bio-Rad | 1704468EDU | Para electroforesis en gel de agarosa |
| Bandeja de gel UV-transparente Wide Mini-Sub Cell GT (15 × 7 cm | Bio-Rad | 1704426 | Para electroforesis en gel de agarosa |
Referencias
- Dyall SD, Brown MT, Johnson PJ. Ancient invasions: from endosymbionts to organelles. Science. 2004;304:253-257. doi:10.1126/science.1094884.
- Pakendorf B, Stoneking M. Mitochondrial DNA and human evolution. Annu Rev Genomics Hum Genet. 2005;6:165-183. doi:10.1146/annurev.genom.6.080604.162249.
- Ng YS, Turnbull DM. Mitochondrial disease: genetics and management. J Neurol. 2016;263:179-191. doi:10.1007/s00415-015-7884-3.
- Shoubridge EA, Wai T. Mitochondrial DNA and the mammalian oocyte. In: St John JC, editor. Current Topics in Developmental Biology. Vol. 77: The Mitochondrion in the Germline and Early Development. San Diego (CA): Academic Press; 2007. p. 87-111. doi:10.1016/S0070-2153(06)77004-1.
- Fox EJ, Reid-Bayliss KS, Emond MJ, Loeb LA. Accuracy of next generation sequencing platforms. Next Gener Seq Appl. 2014;1:1000106. doi:10.4172/jngsa.1000106.
- Kennedy SR, et al. Detecting ultralow-frequency mutations by Duplex Sequencing. Nat Protoc. 2014;9:2586-2606. doi:10.1038/nprot.2014.170.
- Schmitt MW, et al. Detection of ultra-rare mutations by next-generation sequencing. Proc Natl Acad Sci U S A. 2012;109:14508-14513. doi:10.1073/pnas.1208715109.
- Stoler N, et al. Family reunion via error correction: an efficient analysis of duplex sequencing data. BMC Bioinformatics. 2020;21:96. doi:10.1186/s12859-020-3419-8.
- Abascal F, et al. Somatic mutation landscapes at single-molecule resolution. Nature. 2021;593:405-410. doi:10.1038/s41586-021-03477-4.
- The ESHRE Guideline Group on Ovarian Stimulation, Ata B, Bosch E, Broer S, Griesinger G, Grynberg M, et al. ESHRE guideline: ovarian stimulation for IVF/ICSI: an update in 2025. Hum Reprod. 2026;41:498-514. doi:10.1093/humrep/deag018.
- The ESHRE Working Group on Ultrasound in ART, et al. Recommendations for good practice in ultrasound: oocyte pick up. Hum Reprod Open. 2019;2019:hoz025. doi:10.1093/hropen/hoz025.
- Arbeithuber B, et al. Age-related accumulation of de novo mitochondrial mutations in mammalian oocytes and somatic tissues. PLoS Biol. 2020;18:e3000745. doi:10.1371/journal.pbio.3000745.
- Arbeithuber B, et al. Advanced age increases frequencies of de novo mitochondrial mutations in macaque oocytes and somatic tissues. Proc Natl Acad Sci U S A. 2022;119:e2118740119. doi:10.1073/pnas.2118740119.
- The Galaxy Community. The Galaxy platform for accessible, reproducible, and collaborative data analyses: 2024 update. Nucleic Acids Res. 2024;52:W83-W94. doi:10.1093/nar/gkae410.
- Stoler N, Arbeithuber B, Guiblet W, Makova KD, Nekrutenko A. Streamlined analysis of duplex sequencing data with Du Novo. Genome Biol. 2016;17:180. doi:10.1186/s13059-016-1039-4.
- Nekrutenko A, Stoler N. Calling very rare variants. Galaxy Training Network. Available from: https://training.galaxyproject.org/training-material/topics/variant-analysis/tutorials/dunovo/tutorial.html. Accessed July 25, 2026.
- Barnett DW, et al. BamTools: a C++ API and toolkit for analyzing and managing BAM files. Bioinformatics. 2011;27:1691-1692. doi:10.1093/bioinformatics/btr174.
- Illumina. Double sided size selection and bead clean up. Illumina Knowledge Base. Available from: https://knowledge.illumina.com/library-preparation/general-library-prep/library-preparation-general-library-prep-reference_material-list/000006157. Accessed July 25, 2026.
- Arbeithuber B, et al. Allele frequency selection and no age-related increase in human oocyte mitochondrial mutations. Sci Adv. 2025;11:eadw4954. doi:10.1126/sciadv.adw4954.
- Mertens J, et al. Mitochondrial DNA variants segregate during human preimplantation development into genetically different cell lineages that are maintained postnatally. Hum Mol Genet. 2022;31:3629-3642. doi:10.1093/hmg/ddac059.
- Mertens J, et al. Children born after assisted reproduction more commonly carry a mitochondrial genotype associating with low birthweight. Nat Commun. 2024;15:1232. doi:10.1038/s41467-024-45446-1.
- Van Der Kelen A, et al. The interplay between mitochondrial DNA genotypes, female infertility, ovarian response, and mutagenesis in oocytes. Hum Reprod Open. 2025;2025:hoae074. doi:10.1093/hropen/hoae074.
Reimpresiones y permisos
Este artículo ha sido publicado
Video próximamente