Este protocolo propone FedMediFormer-XAI, un marco multimodal de inteligencia para la diabetes que respeta la privacidad mediante el aprendizaje federado, transformadores multimodales, aumento basado en difusión, recomendación personalizada de fármacos basada en grafos e inteligencia artificial explicable, para la predicción precisa, la toma de decisiones transparente y la gestión personalizada de la diabetes.
Artículo de método
FedMediFormer-XAI: Transformadores multimodales federados con aumento por difusión y recomendación de fármacos basada en grafos para la diabetes
En este artículo
Resumen
Resumen
El manejo de la diabetes enfrenta varios obstáculos, como datos fragmentados de atención médica, preocupaciones sobre la privacidad, baja explicabilidad y la falta de orientación terapéutica personalizada. Este trabajo de investigación presenta FedMediFormer-XAI, un marco unificado y adecuado que incorpora aprendizaje federado, transformadores multimodales, aumento de datos basado en difusión, Redes Neuronales de Grafos (GNNs) para recomendación de fármacos e Inteligencia Artificial Explicable (XAI) para inteligencia en diabetes. El sistema utiliza diversos tipos de datos sanitarios, por ejemplo, registros clínicos, indicadores de salud poblacional, datos de monitoreo continuo de glucosa, imágenes de fondo de retina, mediciones de sensores portátiles e información farmacológica. Para generar muestras sintéticas y abordar el desequilibrio de clases, se emplean modelos de difusión, y se utilizan arquitecturas de transformadores multimodales para aprender las relaciones entre fuentes de datos muy diferentes. El aprendizaje federado permite el entrenamiento colaborativo de modelos de manera que se preserve la privacidad, sin compartir datos brutos de pacientes. El componente de GNN captura interacciones entre pacientes y fármacos, así como entre fármacos, para recomendaciones personalizadas de medicamentos. Métodos de explicabilidad como SHapley Additive exPlanations (SHAP), visualización de la atención, Gradientes Integrados y razonamiento contrafactual proporcionan interpretaciones transparentes de los resultados de predicción y recomendación. En la implementación representativa, el marco propuesto alcanzó una precisión del 94,2 %, una exactitud del 93,1 %, una recuperación del 92,8 %, una puntuación F1 del 92,9 %, un Coeficiente de Correlación de Matthews (MCC) de 0,88 y un Área Bajo la Curva ROC (AUC-ROC) de 0,96. El módulo de recomendación basado en grafos alcanzó una precisión = 0,89, recuperación = 0,84 y una Ganancia Acumulada Descontada Normalizada (NDCG) = 0,91. El protocolo proporciona un enfoque estructurado para integrar datos sanitarios heterogéneos mediante transformadores multimodales, aprendizaje federado, aumento basado en difusión, recomendación basada en grafos e inteligencia artificial explicable. Los resultados computacionales reportados demuestran el potencial del marco para la predicción de diabetes y la recomendación personalizada de medicamentos, mientras que el diseño federado apoya el manejo descentralizado de datos. Se requiere una evaluación clínica prospectiva multicéntrica para establecer la utilidad clínica, la generalización y la aplicabilidad en el mundo real.
Introducción
La diabetes mellitus se encuentra entre las principales enfermedades metabólicas crónicas que afectan a la humanidad y representa un importante problema de salud pública, ya que sigue aumentando, junto con sus efectos a largo plazo y los enormes costos del tratamiento de los pacientes1,2. Según un informe, actualmente hay más de 537 millones de adultos viviendo con diabetes en todo el mundo, y se espera que esta cifra aumente significativamente en las próximas décadas3. Si los niveles elevados de azúcar en sangre no se controlan, la persona sufrirá las complicaciones más graves, como enfermedad coronaria4, daño renal5, daño nervioso6, pérdida de la visión7 y accidente cerebrovascular8. Por lo tanto, reconocer la enfermedad en su etapa más temprana, monitorear regularmente la condición del paciente y brindarle formación mediante enfoques médicos avanzados son pasos necesarios para ayudar a los pacientes a llevar una vida más saludable y, al hacerlo, reducir los gastos del sistema sanitario estatal9,10.
Hoy en día, el uso de historiales clínicos electrónicos (EHR), dispositivos portátiles, sistemas de monitoreo continuo de glucosa (CGM), tecnologías de imágenes retinianas y aplicaciones móviles para la salud está extendiéndose rápidamente, generando grandes volúmenes de datos sanitarios heterogéneos que pueden analizarse11. Estas diversas herramientas de recopilación de datos pueden proporcionar información variada sobre el cuerpo humano, su capacidad de funcionar en diferentes etapas de una enfermedad, la forma en que el paciente responde a distintos tipos de tratamiento y cómo se comporta en la vida real12. La inteligencia artificial (AI) ha demostrado ser la mejor solución para procesar datos altamente complejos, predecir la diabetes, monitorear la enfermedad y asistir a los médicos en decisiones clínicas13. Además, los algoritmos de aprendizaje automático, incluyendo bosques aleatorios, máquinas de vectores de soporte y métodos de potenciación del gradiente, han dado excelentes resultados en la evaluación del riesgo de diabetes14. Más recientemente, las arquitecturas de aprendizaje profundo han permitido la extracción automática de características y mejorado el rendimiento predictivo en diversas aplicaciones sanitarias15.
Mediante el uso de métodos de aprendizaje multimodal, la inteligencia sobre la diabetes se ha mejorado considerablemente al integrar registros clínicos estructurados, mediciones fisiológicas, imágenes de retina e indicadores conductuales en un único marco predictivo16. Al utilizar múltiples fuentes de información, los modelos multimodales pueden identificar patrones que no son visibles cuando cada modalidad se examina por separado17. Recientemente, los modelos basados en transformadores han aprendido de manera muy efectiva las dependencias de largo alcance y las relaciones contextuales a partir de diversos tipos de datos sanitarios18. Sin embargo, problemas como clases desequilibradas, datos faltantes, heterogeneidad de los datos y generalización limitada aún impiden el uso generalizado de sistemas de inteligencia artificial multimodal en entornos clínicos19.
A pesar de estos avances, muchos sistemas existentes de inteligencia para la diabetes aún dependen de marcos de aprendizaje centralizados que requieren inherentemente consolidar datos de pacientes de diferentes instituciones en un solo repositorio20. Métodos como estos ya están generando controversias sobre la privacidad del paciente, la custodia de los datos, la ciberseguridad y el cumplimiento normativo21. De hecho, debido a consideraciones legales y éticas, a menudo se restringe la capacidad de los proveedores de atención médica para compartir datos sensibles de los pacientes22. En este contexto, el aprendizaje federado se está convirtiendo en una solución viable, ya que permite entrenar un modelo colaborativo sin compartir los datos reales de los pacientes23. A través de la optimización descentralizada y la agregación segura de parámetros, el aprendizaje federado posibilita análisis médicos protegidos por privacidad aprovechando conocimientos provenientes de conjuntos de datos distribuidos geográficamente24. Sin embargo, la sobrecarga de comunicación, la heterogeneidad entre clientes y la estabilidad de convergencia aún representan problemas importantes en escenarios federados de atención médica25.
Otra desventaja más de los sistemas de inteligencia para la diabetes actualmente en uso es la falta de transparencia y apoyo para la terapia personalizada. Muchos modelos de aprendizaje profundo se comportan como cajas negras, lo cual representa un problema para los clínicos que desean comprender el razonamiento detrás de las predicciones y recomendaciones26. Los métodos de inteligencia artificial explicable (XAI), como SHAP, gradientes integrados, visualización de la atención y razonamiento contrafactual, están demostrando tener un gran potencial para aumentar la transparencia del modelo y la confianza del clínico27. Además, las redes neuronales en grafos (GNN) se han convertido en las herramientas más avanzadas para capturar las interacciones entre paciente-medicamento y medicamento-medicamento, lo que resulta en recomendaciones de fármacos personalizadas y evaluación de la seguridad medicamentosa28. Los nuevos modelos de difusión también han introducido soluciones para generar datos sanitarios sintéticos auténticos y abordar el desequilibrio de clases29.
Los transformadores, el aprendizaje federado, la generación sintética de datos basada en difusión, las redes neuronales gráficas y la inteligencia artificial explicable han demostrado resultados prometedores en aplicaciones sanitarias; sin embargo, su integración dentro de un marco unificado y reproducible de inteligencia para la diabetes sigue siendo limitada. Los enfoques existentes suelen abordar estos componentes de forma independiente, centrándose en el aprendizaje que preserva la privacidad sin recomendaciones personalizadas de tratamiento, en la predicción multimodal sin entrenamiento descentralizado, o en la explicabilidad sin sistemas de apoyo a la toma de decisiones clínicas basados en grafos. Aunque los modelos de difusión pueden ayudar al equilibrio de clases y las arquitecturas transformadoras pueden aprender relaciones entre diversas modalidades sanitarias heterogéneas, los protocolos estandarizados para integrar estas tecnologías complementarias siguen siendo escasos. Por tanto, este trabajo presenta un protocolo metodológico unificado que combina la predicción multimodal, la ampliación basada en difusión, la optimización federada, la recomendación personalizada de fármacos basada en grafos y la inteligencia artificial explicable dentro de un flujo de trabajo reproducible, a la vez que proporciona una base para futuras validaciones clínicas y su traslación.
A diferencia de estudios que suponen la disponibilidad de conjuntos de datos multimodales a nivel de paciente, este protocolo integra conjuntos de datos públicos heterogéneos sin realizar coincidencias directas de pacientes. Se entrenan modelos independientes específicos para cada modalidad por cada fuente de datos, y los embeddings de características latentes se combinan mediante un mecanismo de atención cruzada entre modalidades. Este diseño preserva el rigor metodológico al tiempo que permite la integración de conocimiento multimodal a través de diversos repositorios de atención médica.
El protocolo propuesto está destinado principalmente al desarrollo metodológico y a entornos de inteligencia artificial para la atención sanitaria distribuida, en los que existen fuentes de datos heterogéneas disponibles en distintos repositorios o instituciones, y en los que se restringe la centralización directa de los datos. En la implementación actual, los conjuntos de datos específicos de cada modalidad son independientes y no están emparejados por paciente; por lo tanto, la integración multimodal se realiza a nivel de representación aprendida, en lugar de mediante una correspondencia directa a nivel de paciente. La aplicación práctica requeriría datos de pacientes multimodales adecuadamente vinculados, definiciones coherentes de preprocesamiento y resultados en todos los centros participantes, una infraestructura computacional adecuada y el cumplimiento de los requisitos éticos, de privacidad y normativos aplicables.
Este artículo presenta FedMediFormer-XAI, un marco transformador multimodal federado que permite obtener inteligencia sobre la diabetes preservando la privacidad, mediante funciones de predicción, recomendación y explicabilidad integradas en un único entorno. Este marco integra la ampliación de datos basada en difusión para abordar el desequilibrio de clases, el aprendizaje transformador multimodal para la predicción de diabetes, el aprendizaje federado para el desarrollo colaborativo de modelos, la recomendación personalizada de fármacos basada en redes neuronales gráficas y métodos de inteligencia artificial explicativa para apoyar decisiones clínicas de manera transparente. La arquitectura general y el flujo de trabajo del marco propuesto FedMediFormer-XAI se ilustran en Figura 1.
Las principales contribuciones del marco propuesto FedMediFormer-XAI se resumen a continuación: (1) Se presenta un protocolo unificado que integra el aprendizaje federado, transformadores multimodales, aumento de datos basado en difusión, recomendación personalizada de medicamentos mediante redes neuronales gráficas e inteligencia artificial explicable dentro de un único flujo de trabajo reproducible para la inteligencia en diabetes. (2) Se desarrolla una estrategia de aprendizaje federado que preserva la privacidad, permitiendo el entrenamiento colaborativo del modelo en clientes sanitarios distribuidos simulados sin compartir datos brutos de pacientes. (3) Se introduce una arquitectura de transformador multimodal para aprender conjuntamente representaciones complementarias a partir de registros clínicos estructurados, datos de monitoreo continuo de glucosa, imágenes de fondo de retina e indicadores de salud poblacional. (4) Se incorpora la generación sintética de datos basada en difusión para reducir el desequilibrio de clases y mejorar la robustez del modelo, al tiempo que se preservan las características estadísticas de los datos originales de entrenamiento. (5) Se emplea un módulo de aprendizaje en grafos heterogéneos basado en GraphSAGE para modelar las relaciones entre pacientes y medicamentos, así como entre medicamentos, con el fin de recomendar tratamientos personalizados y realizar clasificaciones de tratamientos considerando posibles interacciones. (6) Se integran múltiples técnicas de inteligencia artificial explicable, incluyendo SHapley Additive exPlanations (SHAP), Gradientes Integrados, visualización de la atención y explicaciones contrafactuales, con el objetivo de mejorar la transparencia del modelo y proporcionar resultados de predicción y recomendación interpretables. (7) Se proporciona un protocolo de validación exhaustivo, que incluye evaluación predictiva, evaluación del aprendizaje federado, evaluación de recomendaciones, análisis de explicable, evaluación centrada en clínicos, validación externa y evaluación de reproducibilidad.
Protocolo
Todos los conjuntos de datos utilizados en este estudio se obtuvieron de repositorios públicos y contenían información de pacientes desidentificada. Estos incluyeron el Conjunto de Datos de Diabetes de los Indios Pima, el Conjunto de Datos de Indicadores de Salud sobre la Diabetes del CDC, el Conjunto de Datos OhioT1DM, el Conjunto de Datos de Detección de Ceguera APTOS 2019, el Conjunto de Datos de Reseñas de Medicamentos y el Conjunto de Datos de Interacciones entre Fármacos. No se realizó reclutamiento directo de pacientes, intervención, recolección de muestras ni acceso a información médica personal identificable. El estudio se limitó a un análisis secundario de conjuntos de datos públicos y anonimizados para el desarrollo y validación metodológicos, y se llevó a cabo de acuerdo con los requisitos institucionales para el uso de dichos datos. La evaluación centrada en el ser humano descrita en este protocolo está destinada a una implementación futura y no se realizó en el presente estudio. Los investigadores que realicen esta evaluación deben obtener la aprobación correspondiente del Comité Institucional de Ética, obtener el consentimiento informado por escrito de todos los participantes y cumplir con los requisitos institucionales aplicables, los acuerdos de uso de datos y las regulaciones nacionales.
1. Configurar el entorno computacional
- Instale Python 3.11 como entorno principal de programación. Instale PyTorch 2.3 y TensorFlow 2.15 para el desarrollo y entrenamiento de modelos de aprendizaje profundo. Instale la biblioteca Transformers (v4.45) para implementar arquitecturas basadas en transformadores.
- Instale PyTorch Geometric (v2.5) para facilitar la construcción y el entrenamiento de redes neuronales gráficas. Instale SHAP (v0.47) y Captum (v0.8) para realizar análisis de explicabilidad y atribución de características.
- Instale NumPy, Pandas y Scikit-learn para cálculos numéricos, preprocesamiento de datos y utilidades de aprendizaje automático. Instale OpenCV y Matplotlib para tareas de procesamiento y visualización de imágenes. Instale NetworkX para construir y analizar gráficos de interacciones medicamentosas.
- Instale el CUDA Toolkit y los controladores de GPU NVIDIA compatibles para habilitar la computación acelerada por hardware. Configure una GPU NVIDIA RTX 4090 con al menos 32 GB de memoria del sistema. Establezca la semilla aleatoria en 42 para el entrenamiento, validación y pruebas, a fin de garantizar resultados reproducibles. Verifique las instalaciones y la compatibilidad de las bibliotecas de software utilizadas. Registre las versiones del software, las especificaciones del hardware y los parámetros de configuración del modelo empleados en el análisis.
2. Preparar y preprocesar conjuntos de datos
- Descargue y organice los conjuntos de datos clínicos, fisiológicos, de imágenes y farmacológicos necesarios en repositorios específicos por modalidad y verifique su integridad. Confirme las características del conjunto de datos, los objetivos de predicción y los niveles de integración según se especifica en Tablas 1 y 2. El flujo de trabajo se ilustra en Figura 2.
- Elimine registros duplicados, inválidos, inconsistentes o con variables esenciales faltantes. Divida cada conjunto de datos aplicable en subconjuntos independientes por paciente: entrenamiento (70%), validación (15%) y prueba (15%). Ajuste la imputación mediana, la normalización Min-Máx y la codificación categórica utilizando únicamente el subconjunto de entrenamiento, y aplique las transformaciones ajustadas sin cambios a los subconjuntos de validación y prueba. Realice la generación de datos sintéticos únicamente en el subconjunto de entrenamiento. Verifique la partición y la prevención de fugas de datos de acuerdo con Tabla Suplementaria 1.
- Importe los datos de glucosa, ingesta alimenticia, dosis de insulina, actividad física y sueño. Estandarice las marcas de tiempo, alinee los eventos a intervalos regulares, interpole linealmente los valores de glucosa no registrados, divida los registros continuos en ventanas de longitud fija y aplique normalización z-score para generar las entradas del transformador temporal.
- Cargue las imágenes del fondo de ojo y elimine archivos dañados o ilegibles, duplicados, imágenes con etiquetas faltantes y aquellas con artefactos severos o visibilidad insuficiente del campo retiniano.
- Redimensione las imágenes conservadas a 224 × 224 píxeles, normalice las intensidades de los píxeles al rango [0, 1] y aplique la ecualización adaptativa del histograma con límite de contraste (CLAHE).
- Aumente las imágenes de entrenamiento mediante rotación aleatoria dentro de ±15°, volteo horizontal con probabilidad de 0.5, zoom aleatorio dentro del rango de 0.9–1.1× y ajuste de brillo dentro de ±20%. No aplique aumentación estocástica a las imágenes de validación ni de prueba. Almacene las imágenes procesadas para el entrenamiento del Transformador de Visión.
- Integre las representaciones específicas de cada modalidad según la estrategia de integración de conjuntos de datos resumida en Tabla 2. No realice coincidencias directas a nivel de paciente entre repositorios independientes cuando no estén disponibles identificadores comunes de pacientes.
- Almacene cada conjunto de datos público como un conjunto de datos independiente y específico por modalidad, ya que los identificadores de pacientes no se comparten entre repositorios.
- Entrene extractores de características específicos por modalidad de forma independiente utilizando los conjuntos de datos correspondientes: (a) Registros clínicos → codificador TabTransformer; (b) Indicadores de salud poblacional → codificador TabTransformer; (c) Monitoreo continuo de glucosa → Transformador Temporal; (d) Imágenes del fondo de ojo → Transformador de Visión; (e) Datos farmacológicos → módulo GraphSAGE
- Extraiga incrustaciones latentes de características de forma independiente de cada modalidad. Fusione únicamente las incrustaciones latentes aprendidas mediante el módulo propuesto de fusión con atención cruzada-modal, en lugar de combinar registros brutos de pacientes.
- Asegúrese de que no se realice ninguna coincidencia artificial de pacientes entre conjuntos de datos públicos independientes. Mantenga particiones independientes de entrenamiento, validación y prueba para cada conjunto de datos durante todo el preprocesamiento, aumentación y desarrollo del modelo.
- Almacene las representaciones de características multimodales fusionadas para predicciones posteriores, aprendizaje federado, explicabilidad y recomendación personalizada de fármacos (Figura 2).
3. Realizar la ampliación de datos basada en difusión
- Aplique una ampliación basada en difusión a conjuntos de datos clínicos y de salud poblacional estructurados en formato tabular utilizando TabDDPM. Genere muestras sintéticas exclusivamente a partir de la partición de entrenamiento preprocesada para evitar fugas de información. Configure el modelo según la Tabla Suplementaria 2.
- Entrene TabDDPM durante un máximo de 500 épocas utilizando el optimizador Adam (tasa de aprendizaje = 1 × 10⁻4; tamaño de lote = 256). Aplique detención anticipada si la pérdida en validación no mejora al menos en 0,001 durante 20 épocas consecutivas. Genere muestras sintéticas para clases subrepresentadas.
- Evalue la calidad de los datos sintéticos mediante estadísticos de Kolmogorov-Smirnov (KS), divergencia de Jensen-Shannon, distancia de Wasserstein, análisis de correlación por característica y rendimiento en clasificación posterior. Compare las distribuciones de características originales y sintéticas utilizando superposición de histogramas, estimación de densidad de kernel y coeficientes de correlación por pares.
- Acepte muestras sintéticas únicamente cuando las distribuciones de características por clase permanezcan consistentes con los datos de entrenamiento originales (prueba KS, p > 0,05; divergencia de Jensen-Shannon < 0,10) y no contengan valores clínicos irreales. Combine las muestras aceptadas con el conjunto de datos de entrenamiento original para generar un conjunto de datos equilibrado por clases. El flujo de trabajo de ampliación se muestra en la Figura 3.
- Valide los datos sintéticos volviendo a entrenar el modelo de predicción de diabetes utilizando los conjuntos de entrenamiento original y aumentado. Compare la exactitud, la puntuación F1, el coeficiente de correlación matemática (MCC) y el AUC-ROC para evaluar los cambios en la generalización del modelo y el sesgo distribucional.
4. Desarrollar el modelo transformador multimodal
Configure el transformador multimodal con codificadores específicos para cada modalidad para datos clínicos estructurados, secuencias de monitoreo continuo de glucosa (CGM) e imágenes de fondo de ojo, como se ilustra en la Figura 4. Integre las representaciones resultantes utilizando atención cruzada entre modalidades para la predicción de diabetes y la recomendación personalizada de fármacos basada en grafos.
- Desarrollar el Codificador Clínico
- Inicialice la arquitectura del codificador TabTransformer. Ingrese variables clínicas normalizadas e indicadores de salud poblacional. Genere representaciones de características contextuales utilizando mecanismos de atención del transformador.
- Configure el codificador TabTransformer con 32 variables clínicas estructuradas, una dimensión de incrustación de 128, cuatro capas del transformador, ocho cabezales de atención, una dimensión de alimentación directa de 512, una tasa de abandono (dropout) de 0,20 y activación mediante la Unidad Lineal de Error Gaussiana (GELU).
- Aprenda incrustaciones clínicas latentes que capturen las relaciones entre los atributos del paciente. Almacene las incrustaciones clínicas resultantes para su integración multimodal.
- Desarrollar el Codificador de Monitoreo Continuo de Glucosa
- Inicialice el codificador del transformador temporal. Introduzca secuencias de monitoreo continuo de glucosa y mediciones fisiológicas. Utilice mecanismos de autoatención para codificar las dependencias temporales.
- Configure el transformador temporal con una longitud de secuencia de 96 pasos temporales, un intervalo de muestreo de 15 min, una dimensión de incrustación de 128, cuatro capas del transformador, ocho cabezales de atención, codificación posicional sinusoidal y una tasa de abandono (dropout) de 0,20.
- Produzca incrustaciones secuenciales que reflejen la dinámica glucémica del paciente. Mantenga las incrustaciones temporales listas para el siguiente proceso de fusión.
- Desarrollar el Codificador del Transformador de Visión
- Inicialice la arquitectura del Transformador de Visión. Ingrese imágenes preprocesadas del fondo de ojo. Divida las imágenes en fragmentos de tamaño fijo.
- Configure el Transformador de Visión con una resolución de imagen de entrada de 224 × 224 píxeles, un tamaño de fragmento de 16 × 16 píxeles, una dimensión de incrustación de 768, 12 bloques del transformador, 12 cabezales de atención y una tasa de abandono (dropout) de 0,10.
- Genere representaciones de características a nivel de fragmento. Obtenga características visuales que indiquen patologías retinianas y biomarcadores relacionados con enfermedades. Mantenga las incrustaciones de imagen para la fusión multimodal.
- Realizar la Fusión Cruzada de Modalidades
- Extraiga las representaciones latentes de los codificadores clínico, de CGM y del Transformador de Visión, y proyecte cada una en un espacio latente común de 256 dimensiones mediante proyecciones lineales independientes seguidas de Normalización por Capas.
- Concatene los tokens de modalidad proyectados, agregue incrustaciones aprendibles del tipo de modalidad y aplique atención multi-cabezal cruzada entre modalidades para permitir el intercambio de información entre las representaciones clínicas, de CGM y retinianas. Configure el bloque de atención con ocho cabezales, un espacio de modelo de 256 dimensiones, una capa de alimentación directa de 1.024 dimensiones, activación GELU, abandono (dropout) de 0,10, conexiones residuales y Normalización por Capas.
- Aplique promedio (mean-pooling) a cada grupo de tokens específico de modalidad y concatene las representaciones resultantes. Proyecte el vector concatenado de 768 dimensiones a una representación unificada multimodal de 512 dimensiones, y conserve los pesos de atención y las representaciones fusionadas para análisis posteriores de explicabilidad y ablación.
- Transfiera la representación unificada a los módulos de predicción de diabetes y de recomendación de fármacos basados en GraphSAGE. Mantenga las particiones originales específicas de cada modalidad para entrenamiento, validación y prueba durante todo el proceso de fusión, sin emparejamiento artificial a nivel de paciente entre los conjuntos de datos independientes.
- Configure el transformador multimodal según los parámetros del modelo resumidos en Supplementary Table 3.
5. Configurar el aprendizaje federado
- Configure el marco de aprendizaje federado para permitir el entrenamiento colaborativo de modelos entre instituciones sanitarias distribuidas geográficamente sin intercambiar datos a nivel de paciente. Realice la optimización local del modelo en cada institución participante utilizando los datos disponibles localmente. Comparta únicamente los parámetros del modelo protegidos con el servidor central de agregación. Preservar la privacidad del paciente mientras se posibilita el desarrollo colaborativo de modelos multimodales.
- Separe los conjuntos de datos multimodales y distribúyalos entre múltiples clientes federados para simular el escenario de diferentes instituciones de salud colaborando sin compartir sus datos.
- Configure la red de aprendizaje federado con 10 clientes hospitalarios participantes, un servidor central de agregación, cinco épocas locales por ronda de comunicación, 100 rondas de comunicación, una fracción de participación de clientes del 80 %, selección aleatoria de clientes en cada ronda de comunicación y un mínimo de ocho clientes participantes por ronda.
- Asigne a cada cliente un conjunto de datos perteneciente a una institución determinada, de modo que los datos permanezcan locales y confidenciales. Particione los datos multimodales de entrenamiento entre 10 clientes hospitalarios simulados utilizando una estrategia no independiente e idénticamente distribuida (no IID) basada en Dirichlet. para generar distribuciones de clases heterogéneas, composiciones demográficas y tamaños de conjuntos de datos de clientes.
- Utilice una semilla aleatoria fija para garantizar la reproducibilidad. Verifique las distribuciones resultantes a nivel de cliente y conserve estas particiones durante todo el entrenamiento federado. Mantenga los conjuntos de datos de validación y prueba independientes de las particiones de los clientes.
- Inicialice cada cliente local con los parámetros del modelo global recibidos desde el servidor central de agregación. Entrene el transformador multimodal local durante cinco épocas utilizando los datos de entrenamiento locales del cliente. Optimice el modelo local utilizando el optimizador AdamW con una tasa de aprendizaje de 1 × 10⁻4.
- Calcule las actualizaciones de los parámetros del modelo local tras finalizar el entrenamiento local. Proteja los parámetros del modelo local antes de transmitirlos al servidor central de agregación. Transmita los parámetros del modelo local protegidos al servidor central de agregación para su agregación global.
- Reciba los parámetros del modelo protegidos de todos los clientes hospitalarios participantes. Verifique la integridad de las actualizaciones del modelo recibidas antes de la agregación. Agregue los pesos del modelo local utilizando el algoritmo de promediado federado (FedAvg). Actualice el transformador multimodal global utilizando los parámetros del modelo agregados.
- Redistribuya los parámetros actualizados del modelo global a los clientes hospitalarios participantes. Repita los procedimientos de entrenamiento local y agregación global hasta completar 100 rondas de comunicación o hasta que se cumpla el criterio de convergencia predefinido.
- Proteja los parámetros del modelo transmitidos utilizando el mecanismo especificado de agregación segura y cifrado AES-256. Autentique los clientes participantes mediante certificados digitales.
- Establezca canales de comunicación cifrados utilizando el Protocolo de Capa de Transporte Seguro (TLS) 1.3. Mantenga únicamente los parámetros agregados del modelo global tras la finalización de cada ronda de comunicación.
- Evalúe la privacidad y la seguridad mediante evaluaciones de exposición de datos brutos, compartición no autorizada, inferencia de membresía e inversión del modelo. Para la inferencia de membresía, compare el AUC-ROC del ataque con la línea base aleatoria (0,50); evalúe la inversión utilizando el índice de similitud estructural (SSIM) y la relación pico señal-ruido (PSNR) para imágenes de retina y el error normalizado de reconstrucción para características numéricas.
- Verifique la agregación segura confirmando que el servidor no pueda acceder a las actualizaciones individuales de los clientes sin agregar. Verifique la protección mediante AES-256/TLS 1.3 y confirme que no se produzcan transmisiones de actualizaciones del modelo sin cifrar.
- Comparar métricas de privacidad entre configuraciones federadas y centralizadas cuando sea aplicable y reportar las métricas especificadas en Tabla suplementaria 4.
- Estime la complejidad computacional del entrenamiento del transformador local como O(N × L × d2), donde N representa el número de muestras, L representa el número de capas del transformador y d representa la dimensión del embedding.
- Estime la complejidad computacional de la agregación federada como O(K × P) por ronda de comunicación, donde K representa el número de clientes participantes y P representa el número de parámetros entrenables del modelo.
- Intercambie únicamente los parámetros protegidos del modelo entre los clientes participantes y el servidor central de agregación durante cada ronda de comunicación. Calcule la sobrecarga de comunicación en función del tamaño del modelo, el número de clientes participantes y la cantidad de rondas de comunicación.
- Compare el costo computacional del intercambio de parámetros con el costo estimado de transferir los conjuntos de datos multimodales correspondientes en el ámbito sanitario. Configure el marco de aprendizaje federado según los parámetros resumidos en Tabla suplementaria 4. El flujo de trabajo del aprendizaje federado y el proceso de agregación de parámetros se ilustran en Figura 5.
6. Construya el módulo de recomendación personalizada de medicamentos
- Importe los datos farmacológicos, de medicación, tratamiento del paciente e interacciones medicamentosas al entorno computacional. Construya un grafo heterogéneo de atención médica que contenga nodos de pacientes, medicamentos, enfermedades, pruebas de laboratorio y factores de riesgo clínicos.
- Defina las relaciones entre paciente-enfermedad, paciente-medicamento, enfermedad-medicamento, interacción medicamento-medicamento y paciente-laboratorio como aristas del grafo. Verifique la estructura del grafo y elimine relaciones duplicadas, inválidas o desconectadas antes del entrenamiento del modelo.
- Represente los nodos de pacientes mediante edad, sexo, índice de masa corporal (IMC), HbA1c, glucosa sanguínea, presión arterial y duración de la diabetes. Represente los nodos de medicamentos mediante clase del fármaco, mecanismo de acción, dosis, frecuencia de administración y efectos adversos conocidos.
- Represente los nodos de enfermedad mediante gravedad de la enfermedad, etapa de la enfermedad y complicaciones asociadas. Codifique los atributos categóricos y normalice las características continuas de los nodos antes del entrenamiento de GraphSAGE.
- Inicialice los embeddings de los nodos utilizando las características preprocesadas de los nodos. Muestree hasta 25 nodos vecinos para cada nodo objetivo durante la agregación de vecindad. Agregue las representaciones de los nodos vecinos utilizando la agregación por media. Actualice los embeddings del nodo objetivo usando las representaciones agregadas de la vecindad.
- Aplique la función de activación lineal rectificada (ReLU) después de cada capa de GraphSAGE. Normalice los embeddings resultantes de los nodos. Repita el procedimiento de agregación de vecindad en tres capas de GraphSAGE.
- Configure el modelo GraphSAGE con una dimensión oculta de 256, una dimensión de embedding de 128, tres capas de GraphSAGE, un tamaño de muestreo de vecinos de 25, una tasa de abandono (dropout) de 0,30, una tasa de aprendizaje de 1 × 10⁻4, un tamaño de lote de 512 y un máximo de 100 épocas de entrenamiento. Optimice el modelo utilizando el optimizador Adam.
- Calcule el embedding específico del paciente a partir del modelo GraphSAGE entrenado. Calcule embeddings para los medicamentos candidatos. Determine puntajes de adecuación entre la representación del paciente y las representaciones de los medicamentos candidatos. Ordene los medicamentos candidatos según sus puntajes de adecuación predichos.
- Identifique y elimine medicamentos contraindicados o potencialmente inseguros utilizando la información disponible sobre interacciones medicamentosas. Devuelva los cinco medicamentos elegibles mejor clasificados como las recomendaciones personalizadas Top-5.
- Entrene el modelo de recomendación utilizando la función de pérdida de Clasificación Personalizada Bayesiana (BPR). Optimice el objetivo de clasificación para asignar puntajes más altos a medicamentos clínicamente apropiados que a medicamentos candidatos menos adecuados.
- Identifique nodos vecinos influyentes y relaciones del grafo clínicamente relevantes que contribuyan a cada recomendación de medicamento. Calcule puntajes de atribución de características para las características relacionadas con el paciente, la enfermedad, el laboratorio y los medicamentos que contribuyen a la recomendación.
- Genere explicaciones basadas en grafos visuales que muestren las relaciones que contribuyen a cada recomendación personalizada de medicamento. Configure el modelo de recomendación GraphSAGE según los parámetros resumidos en Tabla Suplementaria 5. El flujo de trabajo de recomendación personalizada de fármacos basado en grafos se ilustra en Figura 6.
7. Realizar la evaluación de interpretabilidad
- Realizar el análisis SHAP
- Cargue el transformador multimodal entrenado y el conjunto de datos de prueba reservado en el entorno computacional.
- Inicialice el explicador SHAP utilizando el modelo de predicción entrenado y una muestra de fondo de 100 muestras de entrenamiento, seleccionadas exclusivamente del conjunto de datos de entrenamiento mediante muestreo aleatorio estratificado según la clase de resultado de diabetes. Mantenga la distribución aproximada de clases de la partición completa de entrenamiento en la muestra de fondo, y utilice una semilla aleatoria fija de 42 para garantizar la reproducibilidad en la selección de la muestra. Calcule los valores SHAP para las muestras de prueba seleccionadas.
- Calcule la importancia global de las características a partir de los valores absolutos de SHAP, genere visualizaciones globales y locales de SHAP, y conserve los valores calculados para análisis cuantitativos y estadísticos posteriores.
- Realizar el análisis de gradientes integrados
- Seleccione muestras representativas correctamente clasificadas y mal clasificadas del conjunto de datos de prueba reservado. Defina entradas de referencia específicas por modalidad antes de calcular los gradientes integrados. Utilice una referencia cero para las características numéricas normalizadas de datos clínicos y CGM, representando una contribución nula de la característica normalizada, y utilice una imagen de referencia con valores cero para la entrada normalizada de imagen retiniana.
- Calcule las puntuaciones de atribución de gradientes integrados usando 100 pasos de interpolación entre la referencia y la entrada original. Normalice las puntuaciones de atribución resultantes para permitir la comparación entre características y modalidades. Genere visualizaciones de atribución para identificar las características clínicas, temporales y de imagen influyentes que contribuyen a las predicciones individuales del modelo.
- Realizar la visualización de la atención
- Extraiga las matrices de atención de las capas del transformador entrenado para muestras representativas de prueba. Calcule los pesos medios de atención a través de las cabezas de atención correspondientes. Genere mapas de calor de atención para visualizar las interacciones multimodales entre representaciones clínicas, temporales y de imagen retiniana. Identifique las características clínicas, temporales y retinianas dominantes que reciben altos pesos de atención durante la predicción.
- Extraiga los pesos de atención del transformador multimodal entrenado para una muestra de prueba reservada seleccionada aleatoriamente y visualice las distribuciones correspondientes de atención clínica, temporal de CGM, espacial retiniana y multimodal.
- Generar explicaciones contrafácticas
- Seleccione registros representativos de pacientes del conjunto de datos de prueba reservado. Defina rangos y restricciones clínicamente permisibles para las características modificables del paciente antes de generar muestras contrafácticas. Restrinja las características continuas al rango observado en los datos de entrenamiento, y restrinja las características categóricas a categorías válidas observadas en los datos de entrenamiento. No modifique características demográficas inmutables, incluyendo edad y sexo.
- Genere muestras contrafácticas modificando mínimamente solo las características modificables permitidas, preservando al mismo tiempo las restricciones clínicas y del dominio de características predefinidas. Rechace las contrafácticas que contengan valores fuera del rango observado en los datos de entrenamiento, estados categóricos inválidos o modificaciones en características inmutables. Identifique las modificaciones más pequeñas y clínicamente plausibles en las características necesarias para alterar el resultado predicho.
- Informe las características modificadas, los valores originales, los valores contrafácticos y los cambios correspondientes en las predicciones del modelo. El flujo de trabajo de evaluación de explicabilidad se ilustra en Figura 7, mientras que las salidas representativas de visualización de atención y explicaciones contrafácticas se presentan en Figura Suplementaria 1.
- Evaluar la calidad de la explicación
- Calcule la fidelidad para cuantificar el acuerdo entre las explicaciones generadas y el comportamiento del modelo de predicción. Calcule la estabilidad generando repetidamente explicaciones bajo pequeñas perturbaciones de entrada y comparando los patrones de atribución resultantes. Evalúe la consistencia comparando las explicaciones generadas para muestras de prueba clínicamente similares.
- Calcule la dispersión determinando el número o proporción de características que contribuyen significativamente a cada explicación. Evalúe la completitud para determinar si las características atribuidas explican adecuadamente la salida correspondiente del modelo. Evalúe la sensibilidad midiendo los cambios en las puntuaciones de atribución tras perturbaciones controladas de las características de entrada.
- Calcule la infidelidad para cuantificar el desacuerdo entre las atribuciones de características y los cambios observados en las predicciones del modelo. Registre todas las métricas cuantitativas de explicabilidad para análisis estadísticos posteriores.
- Realizar validación clínica prospectiva
- Para futuras validaciones clínicas prospectivas, obtenga la aprobación del comité ético institucional correspondiente antes de reclutar expertos clínicos. Tras obtener la aprobación ética, reclute a 12 clínicos compuestos por seis endocrinólogos, tres especialistas en diabetes y tres farmacólogos clínicos, y obtenga el consentimiento informado de todos los participantes antes de iniciar la evaluación.
- Seleccione aleatoriamente predicciones del modelo representativas y sus explicaciones correspondientes para la evaluación clínica. Presente las explicaciones seleccionadas de forma independiente a cada clínico participante utilizando un formato estandarizado de evaluación.
- Solicite a cada clínico que evalúe la utilidad, relevancia clínica, interpretabilidad y confiabilidad de la explicación utilizando una escala Likert de cinco puntos. Registre las calificaciones anónimas de los clínicos y calcule el acuerdo entre evaluadores y las medidas estadísticas correspondientes según se especifica en el Paso 7.7.
- Realizar el análisis estadístico
- Evalue la distribución de las puntuaciones de evaluación cuantitativas antes de seleccionar la prueba estadística de comparación. Aplique una prueba t pareada a mediciones pareadas con distribución normal o la prueba de rangos con signo de Wilcoxon a mediciones pareadas con distribución no normal, según corresponda.
- Calcule kappa de Fleiss para cuantificar el acuerdo entre evaluadores entre los clínicos participantes. Calcule intervalos de confianza del 95 % para las métricas principales de explicabilidad y evaluación clínica. Establezca el umbral de significancia estadística en p < 0,05.
- Informe las estadísticas de prueba calculadas, los intervalos de confianza y los valores p junto con los resultados de evaluación correspondientes. Evalúe y reporte las métricas de explicabilidad según los criterios resumidos en Tabla Suplementaria 6.
8. Evaluar el rendimiento del modelo
- Compare FedMediFormer-XAI con Regresión Logística, Bosque Aleatorio, XGBoost, TabTransformer, Transformador de Visión, Transformador Temporal y el transformador multimodal centralizado utilizando exactitud, precisión, exhaustividad, puntuación F1, coeficiente de correlación matemática (MCC) y AUC-ROC.
- Realice cada evaluación de referencia utilizando la misma estrategia predefinida de entrenamiento, validación y prueba para garantizar una comparación consistente con el marco propuesto.
- Repita la evaluación del modelo en ejecuciones experimentales independientes y registre las métricas de rendimiento obtenidas en cada ejecución. Calcule la media, la desviación estándar (DE) y el intervalo de confianza del 95 % (IC) para Exactitud, Precisión, Exhaustividad, Puntuación F1, MCC y AUC-ROC. Reporte los resultados de rendimiento como media ± DE junto con el IC del 95 % correspondiente.
- Evalue la normalidad de las diferencias emparejadas de rendimiento entre FedMediFormer-XAI y cada modelo de referencia. Aplique una prueba t emparejada a mediciones emparejadas con distribución normal y la prueba de rangos con signo de Wilcoxon a mediciones emparejadas con distribución no normal. Establezca el umbral de significancia estadística en p < 0,05.
- Reporte las estadísticas de prueba correspondientes, valores p e intervalos de confianza del 95 % para cuantificar la significancia estadística e incertidumbre de las diferencias de rendimiento observadas.
- Obtenga un recuento de todas las rondas de comunicación hasta que los modelos converjan finalmente. Observe el desempeño del modelo global durante el entrenamiento federado. Estudie cómo cambia la convergencia a lo largo del tiempo en las rondas de comunicación.
- Verifique qué tan bien funciona la agregación de parámetros. Examine cómo el aprendizaje descentralizado influye en el rendimiento predictivo. Realice una comparación entre los resultados del aprendizaje federado y el aprendizaje centralizado.
- Evalue la convergencia federada a través de las rondas de comunicación y compare el rendimiento predictivo federado y centralizado. Evalúe las recomendaciones de medicamentos utilizando Precisión@5, Exhaustividad@5 y NDCG@5.
- Genere muestras negativas—muestras de medicamentos del grupo de fármacos candidatos elegibles seleccionando medicamentos que no se observan como interacciones positivas entre paciente y medicamento para el paciente correspondiente. Excluya todas las interacciones positivas conocidas y todos los medicamentos contraindicados del grupo de muestreo negativo. Mantenga una relación fija de muestreo negativo a positivo de 1:1 para el entrenamiento de recomendaciones y utilice una semilla aleatoria fija de 42 para una selección reproducible de muestras negativas.
- Establezca el conjunto de elementos relevantes para cada paciente exclusivamente a partir de los datos de evaluación retenidos. Defina el conjunto de elementos relevantes Ru para el paciente u como el conjunto de medicamentos que cumplen con los criterios positivos de paciente–medicamento en los registros reales retenidos. No utilice predicciones del modelo para construir Ru. Elimine los medicamentos contraindicados del conjunto de recomendaciones candidatas antes de la clasificación.
- Genere los cinco medicamentos elegibles con mayor puntuación para cada paciente de evaluación. Calcule Precisión@5 como la proporción de los cinco medicamentos recomendados que pertenecen al conjunto de elementos relevantes Ru del paciente. Calcule Exhaustividad@5 como la proporción de medicamentos relevantes del paciente recuperados entre las cinco recomendaciones. Calcule NDCG@5 utilizando la relevancia graduada de los medicamentos recomendados, asignando mayor relevancia a los medicamentos clínicamente apropiados y relevancia cero a los medicamentos no relevantes. Agregue las métricas para todos los pacientes de evaluación y reporte la media de Precisión@5, Exhaustividad@5 y NDCG@5.
- Construya la verdad fundamental de recomendación antes de la evaluación del modelo y mantenga las interacciones entre paciente y medicamento retenidas separadas de los datos de entrenamiento de recomendación. No utilice interacciones de medicamentos del conjunto de prueba, etiquetas del conjunto de prueba ni información de tratamientos futuros durante el entrenamiento de GraphSAGE, el muestreo negativo ni la clasificación de candidatos.
- Mida la Fidelidad para verificar qué tan bien coinciden las explicaciones con el comportamiento del modelo. Evalúe la estabilidad de las explicaciones mediante múltiples exámenes. Juzgue la Comprensibilidad según criterios orientados al médico.
- Investigue qué tan consistentes son las explicaciones en diferentes tipos de datos. Confirme el valor clínico de las explicaciones generadas. Las métricas de evaluación utilizadas en todo el estudio se resumen en Tabla Suplementaria 7.
9. Realizar la validación prospectiva del clínico
- Realice una validación prospectiva por clínicos tras obtener la aprobación ética correspondiente y el consentimiento informado, siguiendo los procedimientos de reclutamiento, evaluación, recopilación de datos y análisis estadístico descritos en los pasos 7.6–7.8. El diseño de validación clínica prospectiva, incluyendo la composición de los participantes, los criterios de evaluación, las condiciones de comparación y los análisis estadísticos previstos, se resume en la Tabla Suplementaria 8.
10. Realice la validación y la evaluación de la reproducibilidad
- Realice estudios de ablación eliminando sistemáticamente componentes individuales del marco completo de FedMediFormer-XAI, manteniendo las mismas particiones del conjunto de datos, procedimientos de preprocesamiento, configuraciones de entrenamiento y criterios de evaluación. Evalúe el modelo completo y las configuraciones sin aumento por difusión, aprendizaje federado, recomendación de fármacos basada en GraphSAGE y fusión multimodal.
- Compare las configuraciones ablatadas con el marco completo de FedMediFormer-XAI utilizando Exactitud, Precisión, Exhaustividad, puntuación F1, MCC y AUC-ROC. Cuantifique el cambio en cada métrica de rendimiento para determinar la contribución de cada componente del marco. Compare los resultados de validación con los resultados de prueba interna para evaluar la generalización. Realice pruebas de significación estadística para determinar la fiabilidad de las diferencias de rendimiento observadas.
- Evalue la generalización del marco utilizando un conjunto de datos externo e independiente cuando esté disponible un conjunto de datos con variables de entrada compatibles y definiciones de resultados. Aplique los mismos procedimientos de preprocesamiento y evaluación utilizados para el conjunto de datos de prueba interno, y compare las métricas de rendimiento resultantes con los resultados de la prueba interna.
- Realice análisis de significación estadística a través de ejecuciones experimentales repetidas. Evalúe la normalidad de las diferencias de rendimiento emparejadas antes de la prueba estadística. Aplique una prueba t pareada a mediciones emparejadas con distribución normal y la prueba de rangos con signo de Wilcoxon a mediciones emparejadas con distribución no normal. Establezca el umbral de significación estadística en p < 0,05.
- Calcule la media y el intervalo de confianza del 95 % para Exactitud, Precisión, Exhaustividad, puntuación F1, MCC y AUC-ROC. Reporte las estadísticas de prueba correspondientes, valores p e intervalos de confianza para las comparaciones principales del modelo. Documente todos los parámetros del modelo, procedimientos de preprocesamiento, configuraciones de entrenamiento y protocolos de evaluación necesarios para reproducir los experimentos reportados.
- Guarde el código fuente, archivos de configuración, scripts de evaluación y especificaciones de modelos entrenados utilizados en los experimentos reportados. Mantenga registros detallados del entrenamiento del modelo, configuraciones experimentales, semillas aleatorias y resultados de evaluación.
- Verifique la integridad y consistencia de los materiales disponibles para la reproducibilidad. Asegúrese de que los métodos y materiales documentados proporcionen información suficiente para la reproducción independiente del flujo de trabajo experimental.
- Resuma los recursos de reproducibilidad y los procedimientos de validación utilizados en el estudio en Supplementary Table 9. Documente el procedimiento del estudio de ablación y los criterios de evaluación para evaluar la contribución de los componentes principales del marco.
Resultados
Análisis del rendimiento predictivo
FedMediFormer-XAI demostró un mejor rendimiento predictivo en comparación con los modelos de referencia unimodales y convencionales evaluados. La ampliación basada en difusión mejoró la representación de las clases minoritarias, y el rendimiento predictivo resultante se resume en la Tabla 3. La evaluación con ejecuciones repetidas mostró un rendimiento predictivo estable en todos los modelos evaluados. FedMediFormer-XAI alcanzó el rendimiento general más alto, con una exactitud del 94,20 ± 0,34 % (IC del 95 %: 93,78–94,62), una precisión del 93,10 ± 0,30 % (IC del 95 %: 92,73–93,47), una recuperación del 92,80 ± 0,28 % (IC del 95 %: 92,45–93,15) y una puntuación F1 del 92,90 ± 0,28 % (IC del 95 %: 92,55–93,25). El modelo obtuvo un coeficiente de correlación de Matthews (MCC) de 0,88 ± 0,02 (IC del 95 %: 0,86–0,90) y un AUC-ROC de 0,96 ± 0,01 (IC del 95 %: 0,95–0,97). El transformador multimodal centralizado ofreció el segundo mejor rendimiento general, mientras que los modelos de aprendizaje automático unimodales y convencionales mostraron un rendimiento predictivo comparativamente más bajo. Estos resultados indican que el aprendizaje de representaciones multimodales, combinado con la optimización federada, proporciona un mejor rendimiento y mayor estabilidad en la clasificación de la diabetes.
Estudio de ablación
Se utilizó una ablación por componentes para evaluar la contribución del aumento por difusión, el aprendizaje federado, la recomendación de fármacos basada en GraphSAGE y la fusión multimodal. El marco completo FedMediFormer-XAI alcanzó una exactitud de 94,20 ± 0,34 %, una precisión de 93,10 ± 0,30 %, un valor de recuperación de 92,80 ± 0,28 %, una puntuación F1 de 92,90 ± 0,28 %, un coeficiente de correlación Matthew (MCC) de 0,88 ± 0,02 y un AUC-ROC de 0,96 ± 0,01 en cinco ejecuciones independientes. La eliminación del aumento por difusión redujo la exactitud a 91,80 ± 0,42 %, lo que corresponde a una disminución de 2,40 puntos porcentuales, mientras que la puntuación F1 y el AUC-ROC disminuyeron a 90,30 ± 0,38 % y 0,94 ± 0,01, respectivamente. Esta reducción indica la contribución del aumento basado en difusión a la representación de las clases minoritarias y a la robustez predictiva.
La eliminación del aprendizaje federado dio como resultado una precisión del 93,10 ± 0,37 %, lo que representa una disminución de 1,10 puntos porcentuales en comparación con el marco completo. La precisión, recuperación, puntuación F1, MCC y AUC-ROC también se redujeron a 92,20 ± 0,34 %, 91,80 ± 0,32 %, 92,00 ± 0,33 %, 0,86 ± 0,02 y 0,95 ± 0,01, respectivamente. Esta comparación demuestra la contribución de la configuración federada al rendimiento predictivo.
La eliminación del componente de recomendación personalizada de fármacos basado en GraphSAGE provocó un cambio comparativamente pequeño en el rendimiento de la predicción de diabetes, con una precisión que disminuyó a 93,80 ± 0,35 % y una puntuación F1 a 92,60 ± 0,30 %. Los valores correspondientes de MCC y AUC-ROC fueron 0,87 ± 0,02 y 0,96 ± 0,01, respectivamente. Este resultado indica que GraphSAGE contribuye principalmente a la recomendación personalizada de medicamentos, más que a determinar directamente el rendimiento de la clasificación de la diabetes.
La mayor reducción se observó cuando se eliminó la fusión multimodal. La precisión disminuyó a 87,60 ± 0,55 %, lo que representa una disminución de 6,60 puntos porcentuales, mientras que la precisión, recuperación, puntuación F1, MCC y AUC-ROC disminuyeron a 86,80 ± 0,51 %, 85,90 ± 0,54 %, 86,30 ± 0,52 %, 0,76 ± 0,03 y 0,91 ± 0,01, respectivamente. Este hallazgo demuestra la importancia de modelar conjuntamente la información complementaria procedente de modalidades clínicas, de CGM y retinianas.
Análisis del aprendizaje federado
El marco del aprendizaje federado permitió el entrenamiento colaborativo del modelo en clientes distribuidos, manteniendo al mismo tiempo un manejo descentralizado de los datos clínicos brutos. Durante el entrenamiento, el modelo local de cada cliente se ajustó individualmente y se combinó mediante el método de promediado federado. Tras 100 rondas de comunicación, el modelo global convergió, y su rendimiento predictivo se mantuvo consistente con el aprendizaje centralizado. El marco del aprendizaje federado demostró una convergencia estable a lo largo de las rondas de comunicación, a pesar de las distribuciones heterogéneas de los datos entre los clientes. El intercambio protegido de parámetros preservó el manejo descentralizado de los datos, mientras que el modelo global mantuvo un rendimiento predictivo competitivo en comparación con la línea base centralizada. Tabla 4 compara las implementaciones centralizada y federada. El aprendizaje federado requirió un tiempo adicional de entrenamiento debido a la sobrecarga de comunicación, aunque mantuvo un rendimiento predictivo comparable al del aprendizaje centralizado.
Análisis del rendimiento a nivel de conjunto de datos
Para evaluar la generalización en diferentes modalidades sanitarias, se evaluó el rendimiento en cada conjunto de datos por separado. El modelo multimodal FedMediFormer-XAI mostró un rendimiento sólido y generalmente competitivo en todos los conjuntos de datos evaluados. Alcanzó una precisión del 91,8 %, 93,1 %, 92,4 % y 94,2 % en los conjuntos de datos Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM y APTOS 2019, respectivamente. Aunque el conjunto de datos APTOS 2019 obtuvo una precisión ligeramente mayor (94,7 %) y una exactitud (93,9 %) superiores al modelo multimodal, el enfoque multimodal propuesto mantuvo un rendimiento competitivo en todos los conjuntos de datos y alcanzó un AUC-ROC de 0,96, comparable al AUC-ROC más alto a nivel de conjunto de datos. Los resultados generales a nivel de conjunto de datos se presentan en la Tabla 5. Para conjuntos de datos individuales, el análisis de imágenes de retina logró el mejor rendimiento cuando se utilizó de forma aislada, mientras que la fusión multimodal produjo predicciones más estables y equilibradas.
Análisis de recomendación personalizada de medicamentos
El componente de recomendación basado en redes neuronales gráficas se evaluó utilizando información sobre la eficacia de los medicamentos y datos de interacciones entre fármacos, clasificando los medicamentos candidatos según las puntuaciones aprendidas de adecuación paciente-medicamento y excluyendo combinaciones contraindicadas durante la generación de recomendaciones. El uso del formato de grafo heterogéneo y la modelización de las interacciones paciente-medicamento y medicamento-medicamento pudieron realizarse exhaustivamente, apoyando así la selección personalizada de medicamentos y la evaluación de seguridad. El modelo de recomendación GraphSAGE capturó eficazmente las relaciones complejas entre pacientes, enfermedades, hallazgos de laboratorio y medicamentos. Las recomendaciones personalizadas mostraron un alto desempeño en la clasificación, manteniendo al mismo tiempo explicaciones clínicamente significativas mediante el análisis del entorno del grafo y la atribución de características.
Según la Tabla 6, el módulo de recomendación personalizada de medicamentos se evaluó utilizando Precision@5, Recall@5 y NDCG@5. Estas métricas cuantifican la relevancia y la calidad del ordenamiento de las cinco principales recomendaciones personalizadas de medicamentos generadas por el módulo de recomendación basado en GraphSAGE. El sistema de recomendación alcanzó un buen desempeño en el ordenamiento, con una precisión = 0,89, recuperación = 0,84 y NDCG = 0,91.
Análisis de explicabilidad
El marco incorpora SHAP, gradientes integrados, visualización de la atención y explicaciones contrafácticas para apoyar la interpretación de predicciones multimodales. SHAP se utilizó para cuantificar las contribuciones a nivel de característica, los gradientes integrados para atribuir las predicciones a las características de entrada, la visualización de la atención para examinar el enfoque del modelo a través de las modalidades, y las explicaciones contrafácticas para identificar los cambios en las características asociados con predicciones alternativas. Figura 8 presenta un gráfico resumen representativo derivado del modelo FedMediFormer-XAI entrenado, mientras que Figura 9 presenta visualizaciones representativas de la atención extraídas del transformador entrenado. Estas figuras representan salidas obtenidas a partir de la evaluación del modelo, no ilustraciones esquemáticas de la arquitectura propuesta.
En Figura 8, se presentan las clasificaciones a nivel agregado de la importancia de las características. Las características con valores absolutos de SHAP más altos tuvieron una mayor influencia en las predicciones del modelo y también se alinearon bien con el conocimiento clínico existente.
Figura 9 presenta visualizaciones representativas de la atención extraídas directamente del modelo entrenado FedMediFormer-XAI para una muestra de prueba retenida seleccionada al azar. Las visualizaciones incluyen la atención a características clínicas, la atención temporal del MCG, la atención espacial de la retina y la atención cruzada entre las tres modalidades. La visualización de la atención demostró además la asignación aprendida por el modelo de atención a través de múltiples modalidades. La muestra seleccionada mostró una atención relativamente mayor a HbA1c, duración de la diabetes y edad entre las características clínicas, mientras que el mapa de atención del MCG resaltó varios períodos con variabilidad glucémica prominente. El mapa de atención retiniana identificó regiones específicas de la imagen que contribuyen a la representación del modelo, y la matriz de atención cruzada mostró patrones de atención tanto intra-modal como inter-modal. Como se muestra en Figura 9, los mapas de atención derivados del modelo representativos resaltan patrones glucémicos temporales seleccionados, variables clínicas influyentes y regiones de imágenes retinianas relevantes desde el punto de vista diagnóstico en una muestra de prueba retenida.
Resultados de la evaluación centrada en el ser humano
Se diseñó un protocolo prospectivo de evaluación centrada en el ser humano para evaluar la confianza del clínico, la interpretabilidad, la facilidad de uso, la utilidad clínica y la relevancia de las explicaciones bajo condiciones de solo predicción y de predicción más explicación. La evaluación propuesta involucrará a endocrinólogos, especialistas en diabetes y farmacólogos clínicos, con la aprobación correspondiente del Comité Institucional de Ética y el consentimiento informado. Dado que esta evaluación está destinada a una implementación prospectiva futura, en el presente protocolo no se informan las puntuaciones de resultados a nivel de clínico.
Tabla 7 resume el diseño propuesto para la evaluación prospectiva por parte del clínico y los criterios predefinidos para evaluar los efectos de las explicaciones sobre la confianza del clínico, la interpretabilidad y la utilidad percibida. La evaluación prospectiva comparará las valoraciones de los clínicos sobre las predicciones del modelo con y sin explicaciones complementarias, utilizando criterios predefinidos de escala Likert. El marco propuesto para la evaluación prospectiva centrada en el ser humano de la explicabilidad se presenta en la Figura 10
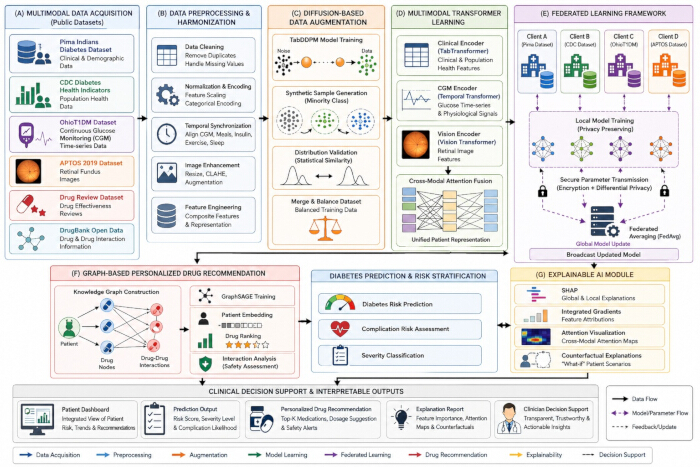
Figura 1: Arquitectura general del marco FedMediFormer-XAI. Descripción esquemática del marco FedMediFormer-XAI, que muestra la adquisición y preprocesamiento de datos multimodales, la ampliación basada en difusión, el aprendizaje específico de modalidad mediante transformadores, el entrenamiento federado del modelo, la recomendación personalizada de medicamentos basada en GraphSAGE y el análisis de explicabilidad. El marco genera predicciones de diabetes, recomendaciones personalizadas de medicamentos y salidas del modelo interpretables. Haga clic aquí para ver una versión más grande de esta figura.
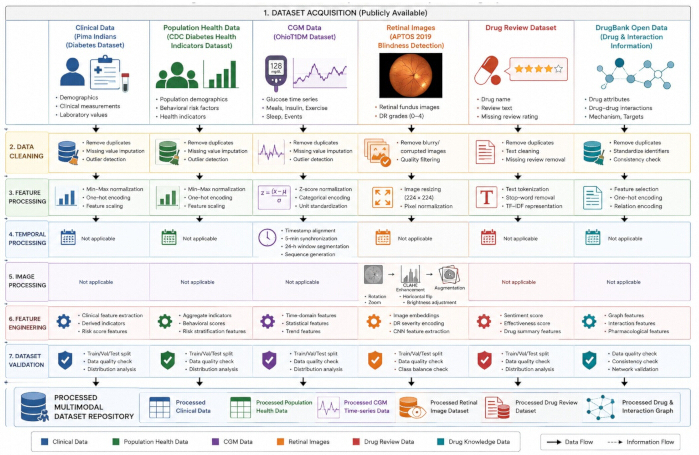
Figura 2: Adquisición y procesamiento previo de la canalización de conjuntos de datos multimodales. Flujo esquemático para la adquisición y el preprocesamiento de los conjuntos de datos multimodales utilizados en FedMediFormer-XAI. Los datos clínicos y de salud poblacional, los registros de CGM, las imágenes retinianas y la información farmacológica pasan por control de calidad específico por modalidad, preprocesamiento, normalización, codificación y aumento antes de convertirse en representaciones listas para el modelo para análisis posteriores. Haga clic aquí para ver una versión más grande de esta figura.
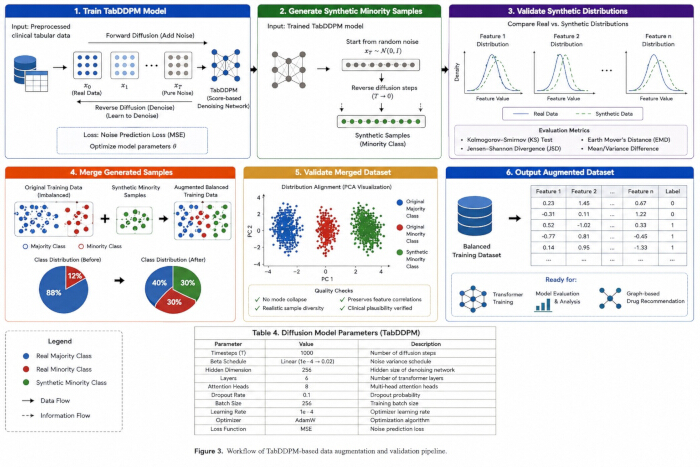
Figura 3: Flujo de trabajo para la ampliación de datos basada en difusión. Flujo de trabajo esquemático para la ampliación basada en difusión de datos tabulares estructurados mediante TabDDPM. Las muestras generadas pasan por evaluaciones de calidad y similitud de distribución antes de integrarse con los datos de entrenamiento originales para mejorar el equilibrio de clases. Haga clic aquí para ver una versión más grande de esta figura.
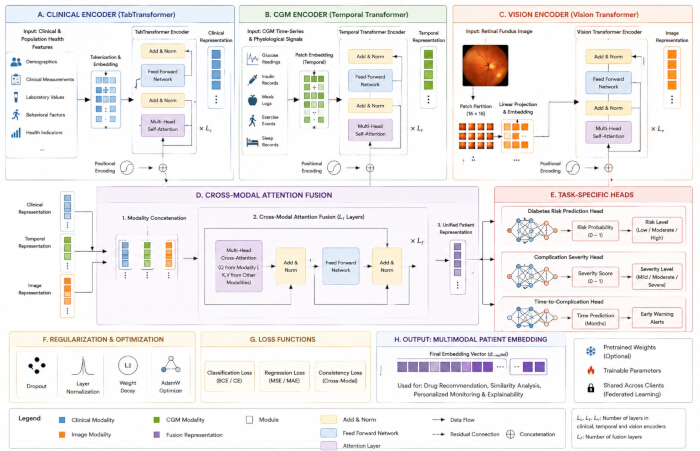
Figura 4: Arquitectura del marco propuesto del transformador multimodal. Arquitectura esquemática que comprende (A) un codificador TabTransformer para datos clínicos, (B) un codificador transformador temporal para datos de CGM y (C) un codificador Vision Transformer para imágenes de retina. (D) Las representaciones específicas de cada modalidad se integran mediante atención cruzada para generar una representación multimodal unificada. (E) Cabezas de predicción específicas para cada tarea generan las salidas del modelo. (F) Los componentes de regularización y optimización apoyan el entrenamiento del modelo, y (G) las pérdidas de clasificación, regresión y consistencia cruzada guían el proceso de optimización. La representación multimodal resultante permite tareas de predicción, recomendación y explicabilidad posteriores. Haga clic aquí para ver una versión más grande de esta figura.
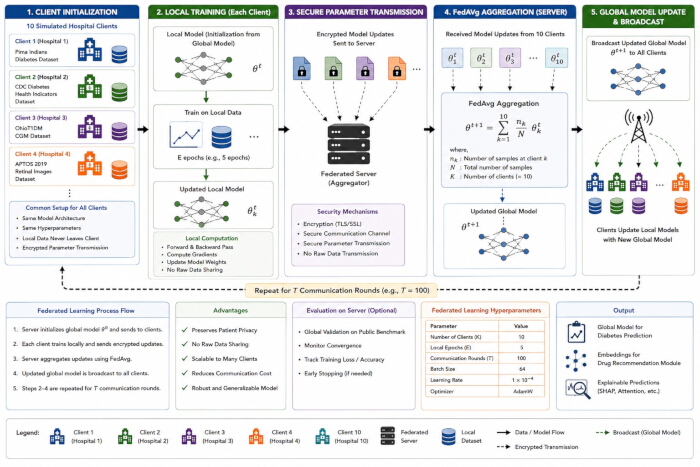
Figura 5: Marco de comunicación del aprendizaje federado. Flujo esquemático del entrenamiento federado entre clientes hospitalarios distribuidos. Los modelos multimodales locales se entrenan utilizando datos específicos de cada cliente, y las actualizaciones protegidas del modelo se transmiten a un servidor central para el promedio federado. El modelo global agregado se redistribuye entre los clientes para rondas posteriores de comunicación. El marco también ilustra el intercambio seguro de parámetros y la evaluación de los requisitos de privacidad, comunicación y capacidad computacional. Haga clic aquí para ver una versión más grande de esta figura.
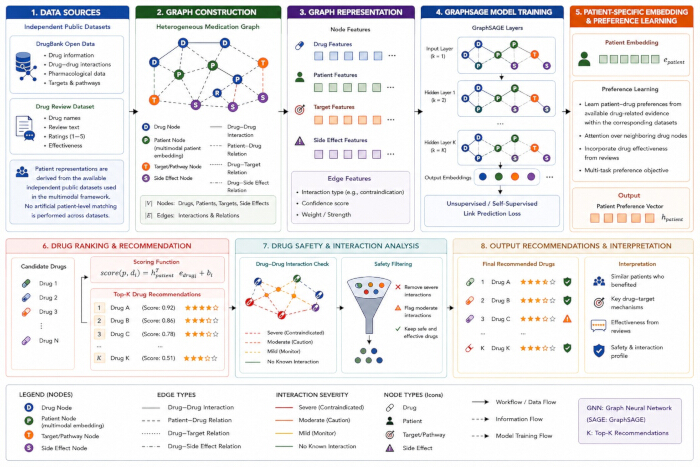
Figura 6: Flujo de trabajo para recomendación personalizada de fármacos basado en grafos. Flujo de trabajo esquemático para la recomendación personalizada de fármacos basada en GraphSAGE. Los datos farmacológicos y de representación del paciente se organizan en un grafo heterogéneo que incluye entidades y relaciones relevantes en el ámbito sanitario. GraphSAGE aprende representaciones de pacientes y fármacos, que se utilizan para calcular puntuaciones de adecuación entre paciente y fármaco y ordenar los medicamentos candidatos. Las combinaciones de fármacos contraindicadas o inseguras se filtran antes de generar las recomendaciones finales Top-K, con información basada en grafos que apoya la interpretación de dichas recomendaciones. Haga clic aquí para ver una versión más grande de esta figura.
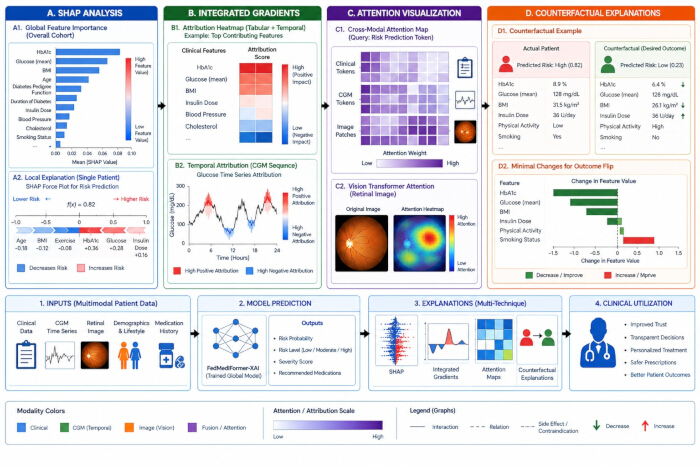
Figura 7: Marco de evaluación de explicabilidad. Resumen esquemático del flujo de trabajo de explicabilidad. (A) El análisis SHAP evalúa las contribuciones de características globales y locales; (B) Los gradientes integrados proporcionan explicaciones basadas en atribuciones; (C) la visualización de la atención identifica características influyentes e interacciones entre modalidades; y (D) el análisis contrafactual identifica cambios en las características asociados con predicciones alteradas. Las salidas de explicación resultantes apoyan la interpretación de las predicciones del modelo y las recomendaciones personalizadas. Haga clic aquí para ver una versión más grande de esta figura.
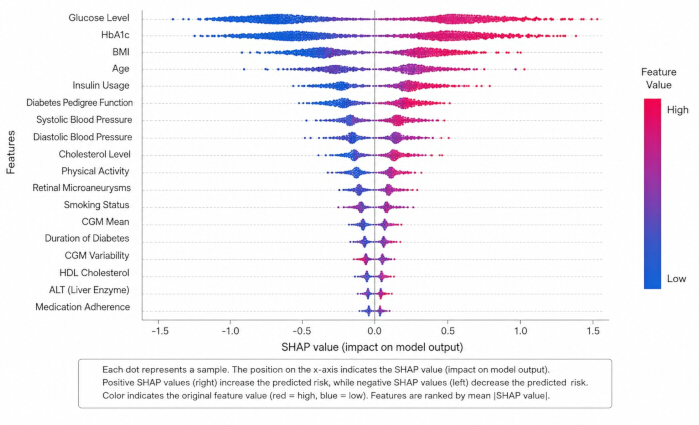
Figura 8: Análisis representativo de la importancia de características derivado del modelo SHAP generado por el modelo entrenado FedMediFormer-XAI. El gráfico resumen de SHAP muestra la distribución de los valores SHAP en todas las muestras evaluadas, con las características ordenadas según su contribución media absoluta SHAP. Los valores SHAP positivos indican contribuciones hacia un mayor riesgo predicho de diabetes, mientras que los valores negativos indican contribuciones hacia un menor riesgo predicho. El color representa el valor correspondiente de la característica, siendo los valores más altos de la característica de color rojo y los más bajos de color azul. El gráfico representa una salida real de explicabilidad derivada del modelo, no una ilustración esquemática. Haga clic aquí para ver una versión más grande de esta figura.
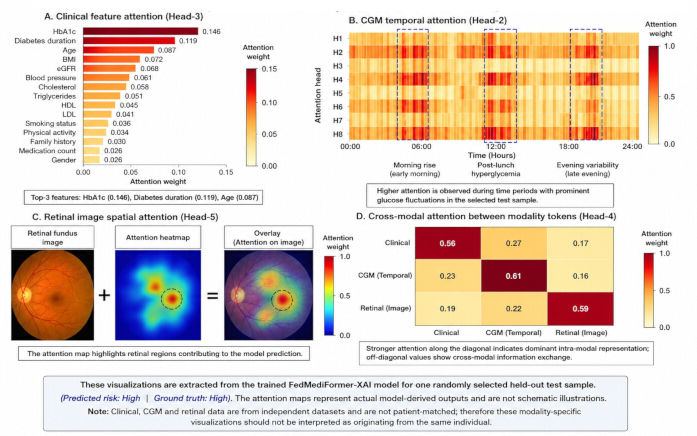
Figura 9: Salidas representativas de atención generadas por el modelo entrenado FedMediFormer-XAI para una muestra de prueba excluida seleccionada al azar. (A) Atención a las características clínicas obtenida de una cabeza de atención del transformador multimodal, que muestra los pesos relativos de atención asignados a las características clínicas. (B) Atención temporal a lo largo de la secuencia de CGM, que ilustra los periodos de tiempo que reciben mayor atención del modelo. (C) Atención espacial para la imagen de fondo de retina, que incluye la imagen original, el mapa de calor de atención y la superposición de atención. (D) Atención cruzada entre los tokens clínicos, de CGM y de modalidad retiniana, que muestra el ponderado de información intra-modal e intermodal. Las visualizaciones mostradas son salidas derivadas del modelo generadas por el modelo entrenado. Los pesos de atención se muestran para la muestra de prueba seleccionada y deben interpretarse como patrones de atención del modelo, no como medidas independientes de causalidad clínica. Haga clic aquí para ver una versión más grande de esta figura.
| Conjunto de datos | Tipo de datos | Muestras/Registros | Características/Contenido | Propósito | Disponibilidad pública |
| Pima Indians Diabetes Dataset | Tabular clínico | 768 pacientes | 8 variables clínicas | Predicción del riesgo de diabetes | Público |
| CDC Diabetes Health Indicators | Salud poblacional | 253.680 registros | Indicadores demográficos, estilo de vida y de salud | Análisis del riesgo poblacional | Público |
| OhioT1DM Dataset | Serie temporal de CGM | 12 sujetos | Glucosa, insulina, comidas, ejercicio, sueño | Modelado temporal de la diabetes | Público |
| APTOS 2019 Blindness Detection | Imágenes de retina | 3.662 imágenes | Fotografías de fondo de ojo con etiquetas de gravedad | Análisis de retinopatía diabética | Público |
| Drug Review Dataset | Farmacológico | 215.063 reseñas | Eficacia del fármaco, calificaciones, reseñas | Recomendación de medicamentos | Público |
| DrugBank Open Data | Grafo de conocimiento de fármacos | Miles de fármacos | Interacciones entre fármacos, dianas, vías metabólicas | Construcción de grafos | Público/Acceso académico |
Tabla 1: Características del conjunto de datos. Resumen de los conjuntos de datos disponibles públicamente utilizados en este estudio, que incluye el tipo de conjunto de datos, tamaño de la muestra, modalidad de los datos, contenido de las características, propósito previsto y disponibilidad.
| Conjunto de datos | Modalidad | Objetivo de predicción | Nivel de fusión |
| Pima Indians Diabetes | Clínica | Clasificación de diabetes | Incrustación de características |
| CDC Diabetes Health Indicators | Salud poblacional | Predicción de riesgo de diabetes | Incrustación de características |
| OhioT1DM | Monitoreo continuo de glucosa | Predicción de tendencia glucémica | Incrustación de características |
| APTOS 2019 | Imágenes de fondo de retina | Análisis de retinopatía diabética | Incrustación de características |
| Drug Review + DrugBank | Farmacológica | Recomendación de fármacos | Incrustación de grafos |
Tabla 2: Estrategia de integración de conjuntos de datos multimodales. Resumen de los conjuntos de datos utilizados para la inteligencia multimodal de la diabetes, que incluye la modalidad de datos, el objetivo de predicción y el nivel en el que se integran las representaciones específicas de cada modalidad. Los datos clínicos, de salud poblacional, de monitoreo continuo de glucosa y de imágenes retinianas se representan como incrustaciones de características, mientras que la información farmacológica se integra mediante incrustaciones de grafos para la recomendación personalizada de fármacos.
| Modelo | Precisión, media ± DE (IC del 95%) | Exactitud, media ± DE (IC del 95%) | Sensibilidad, media ± DE (IC del 95%) | Puntuación F1, media ± DE (IC del 95%) | MCC, media ± DE (IC del 95%) | AUC-ROC, media ± DE (IC del 95%) |
| Bosque aleatorio | 83,60 ± 0,74 (82,68–84,52) | 82,70 ± 0,60 (81,96–83,44) | 81,90 ± 0,56 (81,21–82,59) | 82,30 ± 0,56 (81,61–82,99) | 0,67 ± 0,03 (0,63–0,71) | 0,88 ± 0,01 (0,87–0,89) |
| XGBoost | 85,30 ± 0,71 (84,42–86,18) | 84,70 ± 0,60 (83,96–85,44) | 83,80 ± 0,56 (83,11–84,49) | 84,20 ± 0,56 (83,51–84,89) | 0,70 ± 0,03 (0,66–0,74) | 0,90 ± 0,01 (0,89–0,91) |
| TabTransformer | 87,50 ± 0,52 (86,85–88,15) | 87,00 ± 0,60 (86,26–87,74) | 86,20 ± 0,56 (85,51–86,89) | 86,60 ± 0,56 (85,91–87,29) | 0,75 ± 0,03 (0,71–0,79) | 0,92 ± 0,01 (0,91–0,93) |
| Transformador de visión | 88,80 ± 0,50 (88,18–89,42) | 88,20 ± 0,60 (87,46–88,94) | 87,60 ± 0,56 (86,91–88,29) | 87,90 ± 0,56 (87,21–88,59) | 0,78 ± 0,03 (0,74–0,82) | 0,93 ± 0,01 (0,92–0,94) |
| Transformador temporal | 87,20 ± 0,51 (86,57–87,83) | 86,60 ± 0,60 (85,86–87,34) | 85,90 ± 0,56 (85,21–86,59) | 86,20 ± 0,56 (85,51–86,89) | 0,74 ± 0,03 (0,70–0,78) | 0,91 ± 0,01 (0,90–0,92) |
| CNN-LSTM | 86,90 ± 0,58 (86,18–87,62) | 86,30 ± 0,60 (85,56–87,04) | 85,60 ± 0,55 (84,92–86,28) | 85,90 ± 0,56 (85,21–86,59) | 0,73 ± 0,03 (0,69–0,77) | 0,91 ± 0,01 (0,90–0,92) |
| Transformador multimodal centralizado | 91,30 ± 0,12 (91,15–91,45) | 90,70 ± 0,60 (89,96–91,44) | 90,10 ± 0,56 (89,41–90,79) | 90,40 ± 0,56 (89,71–91,09) | 0,83 ± 0,03 (0,79–0,87) | 0,95 ± 0,01 (0,94–0,96) |
| FedMediFormer-XAI | 94,20 ± 0,34 (93,78–94,62) | 93,10 ± 0,30 (92,73–93,47) | 92,80 ± 0,28 (92,45–93,15) | 92,90 ± 0,28 (92,55–93,25) | 0,88 ± 0,02 (0,86–0,90) | 0,96 ± 0,01 (0,95–0,97) |
Tabla 3: Rendimiento de predicción de diabetes. Rendimiento predictivo comparativo de FedMediFormer-XAI y modelos básicos de aprendizaje automático y aprendizaje profundo utilizando métricas de exactitud, precisión, recuperación, puntuación F1, MCC y AUC-ROC.
| Métrica | Aprendizaje centralizado | Aprendizaje federado |
| Precisión (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| Preservación de la privacidad | No | Sí |
| Compartición de datos brutos requerida | Sí | No |
| Rondas de comunicación | N/A | 100 |
| Tiempo de entrenamiento (horas) | 4.8 | 5.6 |
| Cumplimiento normativo | Moderado | Alto |
Tabla 4: Rendimiento del aprendizaje federado frente al centralizado. Comparación de las implementaciones de aprendizaje centralizado y federado en cuanto al rendimiento predictivo, requisitos de intercambio de datos brutos, rondas de comunicación y tiempo de entrenamiento.
| Conjunto de datos | Precisión (%) | Exactitud (%) | Recuperación (%) | AUC-ROC |
| Conjunto de datos de diabetes de Pima Indians | 91.8 | 90.5 | 89.8 | 0.93 |
| Indicadores de salud de diabetes del CDC | 93.1 | 92.2 | 91.6 | 0.95 |
| Conjunto de datos OhioT1DM | 92.4 | 91.8 | 91.1 | 0.94 |
| Detección de ceguera APTOS 2019 | 94.7 | 93.9 | 93.5 | 0.96 |
| Fusión multimodal (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Tabla 5: Resultados a nivel de conjunto de datos. Análisis del rendimiento en conjuntos de datos individuales y configuraciones de fusión multimodal. Los resultados ilustran la contribución de diferentes modalidades de datos al rendimiento predictivo general.
| Métrica | Valor |
| Precisión@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| Precisión en la Detección de Interacciones entre Fármacos | 0.95 |
| Cobertura de Recomendación | 0.88 |
| Rango Recíproco Medio (MRR) | 0.86 |
| Puntuación de Cumplimiento de Seguridad | 0.94 |
Tabla 6: Rendimiento de la recomendación personalizada de medicamentos. Evaluación de la recomendación personalizada de medicamentos basada en grafos mediante métricas de clasificación, precisión en la detección de interacciones, cobertura de recomendaciones y evaluación de la seguridad medicamentosa.
| Criterio de evaluación | Diseño de evaluación propuesto |
| Confianza del clínico | Evaluación mediante escala Likert de cinco puntos |
| Interpretabilidad | Evaluación mediante escala Likert de cinco puntos |
| Relevancia clínica | Evaluación mediante escala Likert de cinco puntos |
| Utilidad de la explicación | Evaluación mediante escala Likert de cinco puntos |
| Utilidad percibida | Evaluación mediante escala Likert de cinco puntos |
| Acuerdo entre evaluadores | Kappa de Fleiss, que se calculará tras la evaluación prospectiva |
| Comparación estadística | Prueba estadística pareada, según corresponda tras la recolección de datos |
| Participantes | 12 clínicos, sujetos a aprobación ética y consentimiento informado |
| Estado de la evaluación | Evaluación prospectiva/futura |
Tabla 7: Criterios propuestos de evaluación centrados en el ser humano. Marco de evaluación prospectivo centrado en el clínico propuesto para evaluar la utilidad, relevancia clínica, interpretabilidad, confiabilidad y usabilidad de las explicaciones de FedMediFormer-XAI. La evaluación incluye una evaluación estandarizada mediante una escala Likert de cinco puntos, acuerdo entre evaluadores utilizando kappa de Fleiss, comparación estadística de las condiciones de predicción solamente y predicción más explicación, e intervalos de confianza del 95 %. La evaluación por parte del clínico debe realizarse únicamente tras obtener la aprobación del comité ético institucional correspondiente y el consentimiento informado.
Tabla suplementaria 1: Estrategia de validación del conjunto de datos. Se implementaron partición del conjunto de datos, procedimientos de validación, estrategias de equilibrio de clases y medidas de control de calidad para garantizar la reproducibilidad y una evaluación confiable del modelo. Haga clic aquí para descargar este archivo.
Tabla suplementaria 2: Parámetros del modelo de difusión. Configuración de los ajustes para el modelo de difusión TabDDPM, incluyendo parámetros de entrenamiento, configuraciones de optimización, dimensiones latentes, estrategia de programación de ruido y especificaciones para la generación de muestras sintéticas. Haga clic aquí para descargar este archivo.
Tabla suplementaria 3: Configuración del transformador multimodal. Configuración de la arquitectura del transformador multimodal, que incluye los codificadores clínicos, temporales y de imagen, las dimensiones de incrustación y fusión, las cabezas de atención, el optimizador, la tasa de aprendizaje, el tamaño del lote, las épocas de entrenamiento, el criterio de detención temprana y la pérdida combinada de entrenamiento. Haga clic aquí para descargar este archivo.
Tabla suplementaria 4: Configuración del aprendizaje federado. Parámetros utilizados para el entrenamiento federado con preservación de privacidad, incluyendo el número de hospitales participantes, rondas de comunicación, épocas de entrenamiento local, tasa de participación de los clientes, algoritmo de agregación, optimizador, tasa de aprendizaje, método de encriptación, protocolo de comunicación y política de intercambio de datos brutos. Haga clic aquí para descargar este archivo.
Tabla suplementaria 5: Configuración de GraphSAGE. Configuración del módulo heterogéneo de recomendación personalizada de medicamentos basado en GraphSAGE, que incluye el tipo de grafo, dimensiones ocultas y de incrustación, número de capas del grafo, tamaño de muestreo del vecindario, optimizador, tasa de aprendizaje, tamaño del lote, épocas de entrenamiento, pérdida de clasificación personalizada bayesiana y número de recomendaciones principales de medicamentos. Haga clic aquí para descargar este archivo.
Tabla suplementaria 6: Métricas de evaluación de la explicabilidad. Métricas cuantitativas y centradas en el ser humano utilizadas para evaluar la explicabilidad del marco FedMediFormer-XAI. Las métricas evalúan la fidelidad, estabilidad, consistencia, dispersión, completitud, sensibilidad, infidelidad, acuerdo entre evaluadores y la calidad percibida por los clínicos de las explicaciones. Haga clic aquí para descargar este archivo.
Tabla suplementaria 7: Métricas de evaluación. Se utilizan métricas predictivas, de aprendizaje federado, de recomendación y de explicabilidad para evaluar el rendimiento, la robustez, la calidad del ordenamiento y la interpretabilidad del marco. Haga clic aquí para descargar este archivo.
Tabla suplementaria 8: Diseño de la evaluación centrada en el ser humano. Diseño del estudio de evaluación centrado en el clínico, que incluye grupos de participantes, condiciones de evaluación, criterios de valoración y procedimientos de análisis estadístico. Haga clic aquí para descargar este archivo.
Tabla suplementaria 9: Activos para la reproducibilidad. Resumen de los conjuntos de datos, especificaciones de implementación, archivos de configuración, procedimientos de evaluación, documentación y registros experimentales necesarios para respaldar la reproducibilidad del marco propuesto FedMediFormer-XAI. Haga clic aquí para descargar este archivo.
Discusión
Interpretación de los hallazgos clave
Los resultados representativos muestran que es posible combinar el aprendizaje multimodal basado en transformadores, el aprendizaje federado, la ampliación basada en difusión, la recomendación de fármacos basada en redes neuronales gráficas y la inteligencia artificial interpretable en un marco unificado de inteligencia para la diabetes. Al integrar registros clínicos, indicadores de salud poblacional, datos de monitoreo continuo de glucosa, imágenes de fondo de retina e información farmacológica, el marco propuesto FedMediFormer-XAI demostró un rendimiento predictivo sólido al tiempo que apoya el desarrollo de modelos interpretables y descentralizados. El método de aprendizaje multimodal extrajo características informativas de diferentes modalidades sanitarias, lo que condujo a una mejor predicción de la diabetes y recomendaciones personalizadas de tratamiento.
Ventajas del aprendizaje federado
Una contribución importante del marco propuesto es la integración del aprendizaje federado para permitir la creación colaborativa de modelos de forma descentralizada. El aprendizaje federado difiere de los métodos tradicionales de aprendizaje centralizado al permitir que múltiples instituciones participen en el entrenamiento del modelo sin compartir directamente los datos originales de los pacientes. Los hallazgos clave mostraron que el aprendizaje federado mantuvo una precisión predictiva comparable a la del aprendizaje centralizado, al tiempo que permitió el manejo descentralizado de los datos. Esta característica es particularmente relevante en escenarios de atención médica donde el intercambio de datos está limitado por políticas institucionales y requisitos de privacidad.
Análisis de explicabilidad
La evaluación de explicabilidad encontró que el análisis SHAP, los gradientes integrados, la visualización de la atención y las explicaciones contrafactuales pueden producir todos ellos información clínicamente significativa sobre el comportamiento del modelo. Las explicaciones globales y locales coincidieron ampliamente, desde una perspectiva clínica, en los principales predictores (es decir, mediciones de glucosa, índice de masa corporal, edad, patrones de administración de insulina y anomalías retinianas). Las visualizaciones de atención también mostraron que la arquitectura transformadora se centró en características temporales y de imágenes clínicamente relevantes. Estos enfoques mejoran la transparencia al proporcionar interpretaciones complementarias de las predicciones del modelo y las contribuciones de las características.
Análisis de recomendación personalizada de medicamentos
Proponemos un modelo de recomendación basado en GNN que, además de modelar las relaciones entre pacientes y medicamentos y entre medicamentos, proporciona recomendaciones personalizadas de fármacos. De hecho, la topología del grafo heterogéneo facilitó tanto el dominio de los patrones de eficacia del tratamiento como la consideración de la seguridad medicamentosa. Los excelentes resultados en la recomendación de medicamentos obtenidos en este estudio ilustran las capacidades de los métodos de aprendizaje basados en grafos para desarrollar sistemas de inteligencia en diabetes más allá de la predicción de enfermedades, hacia un soporte terapéutico personalizado.
Evaluación centrada en el ser humano
El marco incorpora un protocolo prospectivo de evaluación centrada en el ser humano para evaluar los efectos de la explicabilidad en la confianza del clínico, la interpretabilidad, la usabilidad y la utilidad clínica percibida. La evaluación propuesta comparará condiciones de solo predicción y de predicción más explicación, utilizando criterios de evaluación estandarizados. La implementación futura de esta evaluación, tras la aprobación correspondiente del Comité de Ética Institucional y el consentimiento informado, proporcionará evidencia empírica sobre la aceptación por parte de los clínicos y la utilidad práctica de las explicaciones generadas.
Pasos críticos para una implementación exitosa y reproducible
Varias etapas del protocolo propuesto requieren atención especial para garantizar la reproducibilidad. La preprocesamiento y partición del conjunto de datos debe mantener la separación a nivel de paciente y evitar fugas de datos, mientras que las distribuciones no IID especificadas de los clientes deben conservarse durante el aprendizaje federado. La fusión multimodal debe mantener las dimensiones latentes definidas, la configuración de atención, los embeddings por tipo de modalidad, la normalización y la proyección final. La ampliación basada en difusión debe utilizar parámetros consistentes de preprocesamiento y entrenamiento, mientras que la recomendación basada en GraphSAGE debe mantener representaciones consistentes de paciente-fármaco, cribado de interacciones, definiciones de elementos relevantes y criterios de clasificación Top-K. El análisis de explicabilidad debe utilizar muestras fijas de fondo para SHAP, referencias fijas para Gradientes Integrados, procedimientos establecidos de extracción de atención y restricciones de contrafactuales permitidas clínicamente. Las versiones del software, las semillas aleatorias, las configuraciones del modelo, las particiones del conjunto de datos y los parámetros de evaluación deben documentarse para minimizar la variación dependiente de la implementación.
Limitaciones
Se deben considerar varias limitaciones al interpretar los hallazgos de este estudio. En primer lugar, el marco fue desarrollado y evaluado utilizando conjuntos de datos disponibles públicamente, los cuales pueden no representar completamente la diversidad de las poblaciones de atención médica del mundo real y de los entornos clínicos. En segundo lugar, aunque el aprendizaje federado fue evaluado utilizando clientes hospitalarios simulados, no se realizó una validación a gran escala que involucrara instituciones de atención médica independientes. En tercer lugar, el aprendizaje federado introduce una sobrecarga adicional de comunicación y cálculo que podría afectar la escalabilidad en entornos con recursos limitados. Por último, las técnicas de explicabilidad empleadas en este estudio son principalmente métodos de interpretación post hoc y podrían no capturar completamente el comportamiento del modelo complejo.
El protocolo de validación centrado en el ser humano propuesto contempla un panel inicial de 12 expertos clínicos compuesto por endocrinólogos, especialistas en diabetes y farmacólogos clínicos. Este tamaño muestral tiene como finalidad una evaluación preliminar de la usabilidad y la interpretabilidad, más que una validación clínica definitiva. El panel de expertos relativamente pequeño podría limitar el poder estadístico y la generalización. Por lo tanto, estudios prospectivos futuros deberían incluir cohortes más amplias de médicos en múltiples centros que representen diversos entornos y especialidades clínicas.
Una limitación clave del marco propuesto es que las modalidades clínicas, de monitoreo continuo de glucosa (CGM), de imágenes retinianas y relacionadas con medicamentos se derivan de conjuntos de datos públicos independientes, en lugar de registros multimodales emparejados por paciente. En consecuencia, el componente de fusión cruzada de modalidades debe interpretarse como un marco metodológico para integrar representaciones complementarias de modalidades, y no como evidencia derivada de mediciones multimodales simultáneas en los mismos pacientes. Las diferencias en las características de la población, protocolos de adquisición, distribuciones de características y definiciones de enfermedad entre los conjuntos de datos originales pueden introducir discrepancias en las distribuciones y limitar el grado en que las relaciones cruzadas entre modalidades representan asociaciones reales a nivel individual. Aunque el protocolo evita explícitamente el emparejamiento artificial a nivel de paciente entre conjuntos de datos independientes, este diseño limita la evaluación directa de las interacciones multimodales específicas de cada paciente y puede afectar la generalización clínica. Por lo tanto, el desempeño multimodal reportado no debe interpretarse como equivalente a una validación en una cohorte prospectiva, multimodal y emparejada por paciente. Estudios futuros deben validar el marco utilizando conjuntos de datos más grandes y recolectados de forma independiente, que contengan información clínica, de CGM, retiniana y de tratamiento sincronizada procedente de los mismos pacientes.
Solución de problemas y modificaciones del protocolo
Varias consideraciones prácticas pueden afectar la implementación del protocolo propuesto. El desequilibrio de clases puede reducir el rendimiento predictivo cuando las clases minoritarias están subrepresentadas; este desafío puede mitigarse mediante estrategias de aumento basadas en difusión y de remuestreo. La presencia de valores faltantes y formatos de datos inconsistentes puede afectar la estabilidad del modelo y debe abordarse mediante procedimientos rigurosos de preprocesamiento. La convergencia del aprendizaje federado puede volverse inestable cuando los conjuntos de datos de los clientes presentan una heterogeneidad considerable; ajustar las épocas de entrenamiento local, las tasas de aprendizaje y las frecuencias de agregación puede mejorar la estabilidad. Las limitaciones de hardware también pueden afectar la eficiencia del entrenamiento, especialmente al procesar grandes conjuntos de datos multimodales y arquitecturas basadas en transformadores. En tales casos, reducir el tamaño del lote o la complejidad del modelo puede mejorar la viabilidad computacional sin comprometer la reproducibilidad.
Direcciones futuras
Las investigaciones futuras podrían centrarse en la integración de tecnologías de gemelos digitales para la simulación personalizada de enfermedades y la planificación de tratamientos. Los modelos fundamentales entrenados con grandes conjuntos de datos sanitarios multimodales podrían mejorar aún más el aprendizaje de representaciones y la generalización del modelo. Las técnicas de explicabilidad causal podrían ofrecer una comprensión más profunda de los mecanismos de las enfermedades y los efectos de los tratamientos, más allá de las explicaciones basadas en correlaciones. Además, los enfoques de aprendizaje por refuerzo podrían apoyar la optimización adaptativa de tratamientos y estrategias dinámicas de recomendación de medicamentos. Estos avances podrían mejorar aún más la utilidad clínica y las capacidades de personalización de los sistemas de inteligencia para la diabetes. Asimismo, las predicciones y recomendaciones de medicamentos generadas por inteligencia artificial deben considerarse herramientas de apoyo a la toma de decisiones, y no como sustitutos del juicio clínico profesional. La supervisión humana adecuada sigue siendo esencial para la implementación responsable y ética de los sistemas de inteligencia artificial en el ámbito sanitario.
Conclusión
FedMediFormer-XAI proporciona un marco reproducible que integra aprendizaje multimodal, entrenamiento federado, recomendación personalizada de fármacos y explicabilidad para la inteligencia en diabetes. Los resultados representativos respaldan la viabilidad del flujo de trabajo propuesto, aunque se requiere una validación adicional mediante conjuntos de datos multimodales emparejados con pacientes, entornos clínicos más amplios y evaluación prospectiva por parte de médicos antes de su implementación clínica.
Divulgaciones
Los autores declaran que no tienen intereses financieros competitivos, conflictos de intereses ni relaciones personales que pudieran haber influido en el trabajo reportado en este estudio. Las herramientas de inteligencia artificial se utilizaron únicamente para ayudar con el perfeccionamiento del lenguaje, la organización del manuscrito, el formato y la edición durante la preparación de este artículo. Todo el contenido científico, el diseño del estudio, la metodología, el análisis de datos, la interpretación de resultados y las conclusiones fueron desarrollados, verificados y aprobados por los autores. Los autores asumen toda la responsabilidad sobre la exactitud, integridad y originalidad del trabajo presentado en este manuscrito.
Agradecimientos
Los autores agradecen a los desarrolladores y mantenedores de los conjuntos de datos de acceso público y los recursos de software de código abierto utilizados en este estudio.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Cifrado AES | NIST | AES-256 | Cifrado de parámetros del modelo protegidos / en reposo en el aprendizaje federado |
| Conjunto de datos APTOS 2019 para la detección de ceguera | Kaggle/APTOS | Lanzamiento de 2019 | Conjunto de datos de imágenes de fondo de retina; disponible públicamente y desidentificado; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captado | Meta AI | Versión 0.8 | Interpretabilidad del modelo y análisis de atribución |
| CUDA Toolkit | NVIDIA | Versión 12.2 | Cómputo acelerado por GPU |
| Conjunto de datos de indicadores de salud de la diabetes (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | Lanzamiento de 2015 | Indicadores de salud poblacional; disponibles públicamente y desidentificados; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Conjunto de datos para la detección de retinopatía diabética | Kaggle | Liberación pública | Conjunto de datos de imágenes de retina; disponible públicamente y desidentificado; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Certificados digitales | - | - | Autenticación del cliente en el aprendizaje federado |
| Conjunto de datos de interacciones medicamentosas | Kaggle | Liberación pública | Datos de gráficos de interacciones medicamentosas; disponibles públicamente y desidentificados; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Conjunto de datos de revisión de medicamentos | Repositorio de Aprendizaje Automático de UCI | Conjunto de datos 462 | Conjunto de datos sobre eficacia y reseñas de medicamentos; disponible públicamente y desidentificado; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Desarrolladores de Matplotlib | Versión 3.9 | Visualización |
| Conjunto de datos de diabetes MTS | Kaggle | Liberación pública | Conjunto de datos de sensores portátiles / predicción de diabetes; disponible públicamente y desidentificado; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | Desarrolladores de NetworkX | Versión 3.3 | Construcción y análisis del grafo de interacciones medicamentosas |
| NumPy | Desarrolladores de NumPy | Versión 1.26 | Cálculo numérico |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Entrenamiento e inferencia del modelo; al menos 32 GB de memoria del sistema |
| Conjunto de datos OhioT1DM | Ohio University | Liberación pública | Conjunto de datos de monitoreo continuo de glucosa; disponible públicamente y desidentificado; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | Fundación OpenCV | Versión 4.10 | Procesamiento de imágenes |
| Pandas | PyData | Versión 2.2 | Procesamiento y preprocesamiento de datos |
| Conjunto de datos de diabetes en indios Pima | Repositorio de Aprendizaje Automático de UCI | Conjunto de datos 34 | Conjunto de datos para la predicción clínica de diabetes; disponible públicamente y desidentificado; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Fundación Python Software | Versión 3.11 | Entorno de programación principal |
| PyTorch | Meta AI | Versión 2.3 | Desarrollo y entrenamiento de modelos de aprendizaje profundo |
| PyTorch Geometric | Equipo PyG | Versión 2.5 | Construcción y entrenamiento de redes neuronales gráficas |
| Scikit-learn | Desarrolladores de Scikit-learn | Versión 1.5 | Utilidades y evaluación del aprendizaje automático |
| Mecanismo de agregación segura | - | - | Agregación protegida de parámetros locales de modelos en el aprendizaje federado |
| SHAP | Desarrolladores de SHAP | Versión 0.47 | IA explicable y análisis de atribución de características |
| TensorFlow | Versión 2.15 | Desarrollo y entrenamiento de modelos de aprendizaje profundo | |
| Transformadores | Hugging Face | Versión 4.45 | Implementación de una arquitectura basada en transformadores |
| Capa de Seguridad de Transporte | IETF | TLS 1.3 | Canal de comunicación cifrado para el intercambio federado de parámetros |
| Estación de trabajo | Genérico | - | Entorno computacional; al menos 32 GB de memoria del sistema |
Referencias
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.