Este estudio integra un experimento de escenario y electroencefalogramas para examinar cómo el marco de referencia del rol de experto y acompañante se asocia con la confianza en diferentes contextos de tareas médicas.
Artículo de método
Encuadre de roles y confianza en la IA médica: evidencia a partir de un experimento de escenario y EEG
En este artículo
Resumen
Resumen
La inteligencia artificial médica en línea ha evolucionado desde herramientas analíticas de fondo hasta interfaces de servicio orientadas al paciente, lo que convierte la confianza calibrada en un problema cada vez más importante de diseño y gobernanza. Basándose en la teoría de la congruencia de roles, este estudio examinó cómo el encuadre del rol de experto y de compañero se asocia con la confianza en diferentes contextos de tareas médicas. El estudio 1 utilizó un experimento por escenarios 2 (rol: experto frente a compañero) × 2 (tarea: consulta de enfermedad frente a consulta de salud) (N = 300). El encuadre como experto aumentó la percepción de profesionalismo, mientras que el encuadre como compañero incrementó la presencia social; ambas percepciones se asociaron independientemente con la confianza general cuando se introdujeron simultáneamente. La asociación indirecta a través del profesionalismo estuvo condicionada por el contexto de la tarea, pero una comparación directa mediante bootstrap no mostró diferencias significativas entre los dos índices de mediación moderada para la confianza general. Los diagnósticos de medición indicaron una superposición sustancial entre el profesionalismo percibido y la confianza cognitiva, así como entre la presencia social y la confianza afectiva, lo que requiere una interpretación cautelosa. El estudio 2 comparó enunciados con encuadre de experto y de compañero utilizando EEG en 39 observaciones pareadas. El encuadre como experto se asoció con una mayor ERS de theta frontal-medial y un ΔPLV de theta FCz-F6 menos negativo tras la corrección de la línea base, mientras que a nivel de condición no se observaron diferencias confiables en la tasa de confianza, el tiempo de respuesta ni la tasa de respuestas omitidas. Estos hallazgos de EEG son correlatos exploratorios a nivel de proceso, no una validación neural del modelo indirecto condicional. En conjunto, las señales de rol parecen moldear evaluaciones no excluyentes orientadas a la competencia y a la relación. El diseño del rol debe favorecer una dependencia calibrada mediante límites de capacidad, comunicación de incertidumbre, advertencias basadas en riesgos y escalonamiento adecuado, en lugar de simplemente maximizar la confianza.
Introducción
La inteligencia artificial médica ahora abarca aplicaciones de back-end, como el reconocimiento de imágenes, el análisis de patología y el descubrimiento de fármacos, así como interfaces de servicio orientadas al paciente. Los análisis del sector proyectan un crecimiento continuo del mercado de inteligencia artificial en salud hasta 20331. Los modelos de lenguaje grandes permiten que los sistemas de inteligencia artificial médica respondan preguntas de salud, interpreten resultados de pruebas, resuman información y proporcionen recomendaciones en lenguaje natural2. Este cambio transforma la relación del usuario con la tecnología. Una herramienta analítica de back-end es evaluada por clínicos y organizaciones, mientras que una interfaz orientada al paciente debe comunicar su función, evidencia, incertidumbre y límites a los usuarios. La inteligencia artificial médica puede presentarse como un asistente diagnóstico, una interfaz de médico de familia o un compañero de gestión de la salud, y cada una de estas formas puede influir en cómo los usuarios entienden la identidad del servicio del sistema. A medida que estos sistemas participan cada vez más en la consulta sobre enfermedades y en la gestión diaria de la salud, la confianza trasciende una simple actitud hacia la tecnología. Afecta si los usuarios revelan información, consideran creíbles las recomendaciones, interactúan con el sistema y actúan conforme a las orientaciones de salud. Por lo tanto, la confianza es una preocupación central en el diseño y la gobernanza de las plataformas de salud digital.
La capacidad técnica por sí sola no determina si los usuarios consideran que la inteligencia artificial (IA) médica es creíble y aceptable. Las revisiones sobre agentes conversacionales en atención sanitaria muestran que su implementación depende de la calidad de la interacción, la relevancia clínica, la transparencia y las condiciones de despliegue3. Trabajos recientes sobre evidencia creíble para la IA médica argumentan asimismo que el rendimiento del modelo es insuficiente a menos que las afirmaciones estén respaldadas por evidencia adecuada para el uso previsto4. La transparencia es esencial porque los pacientes deben poder identificar los límites de las capacidades, la incertidumbre y la base de una recomendación, en lugar de inferir la fiabilidad únicamente a partir de un lenguaje fluido5. La investigación en sistemas de información enmarca de manera similar la adopción del diagnóstico asistido por IA como un problema de configuración de la confianza, en el que la interpretabilidad, la protección de la privacidad y las señales de la interfaz moldean conjuntamente la aceptación6. Estas consideraciones son importantes para las interfaces basadas en modelos de lenguaje. La fluidez puede hacer que una respuesta sea fácil de entender, pero sin resolver si el sistema posee conocimientos clínicos, si su recomendación se aplica a las circunstancias del usuario o cuándo es necesario derivar al paciente a un profesional sanitario calificado. La pregunta relevante no es solo si la IA médica puede producir una respuesta, sino si los usuarios pueden evaluarla con un nivel adecuado de confianza.
La confianza en la inteligencia artificial (IA) médica es sensible al contexto de la tarea. La investigación sobre la resistencia a la IA médica muestra que los usuarios pueden rechazar las recomendaciones algorítmicas en decisiones de alto riesgo porque consideran que un algoritmo no puede tener en cuenta su singularidad7. Sin embargo, esta resistencia no es universal. La investigación sobre la apreciación de algoritmos indica que las personas pueden preferir el juicio algorítmico cuando las tareas son objetivas y las reglas están más claras8. En la consulta médica en línea, la personalización y el cuidado en los consejos generados por IA afectan la confianza y la aceptación9. Estudios de elección discreta que comparan consultas convencionales, digitales y basadas en IA encuentran asimismo que las preferencias y las expectativas de confianza varían según el formato10. El trabajo conjunto entre humanos y IA también puede reducir la resistencia mediante la transferencia de confianza desde la experiencia humana hacia una configuración de servicio asistida por IA11. Por lo tanto, la confianza en la IA médica se desarrolla a través de la interacción entre el riesgo percibido, las exigencias de la tarea, el estilo de comunicación y la evaluación del sistema. La consulta por enfermedad pone de relieve la incertidumbre, la posible pérdida, las consecuencias diagnósticas y los costos del error. En cambio, la consulta sobre salud con mayor frecuencia aborda aspectos como la dieta, el ejercicio, el sueño, la adherencia y la gestión preventiva, donde la interacción sostenida y la accesibilidad relacional pueden tener un peso mayor. En consecuencia, una misma señal de interfaz puede interpretarse de manera diferente cuando un usuario busca ayuda para una posible enfermedad frente a la gestión a largo plazo de su salud.
La configuración del rol es una característica de interfaz mediante la cual se pueden comunicar estas expectativas. La IA médica puede presentarse como un experto que enfatiza la autoridad profesional, el razonamiento estructurado, los límites clínicos y la evidencia de capacidades, o como un compañero que destaca la empatía, la tranquilidad, el apoyo social y la continuidad. Esta distinción está relacionada con la competencia y la calidez, las dos dimensiones de la percepción social, pero no se trata simplemente de elegir entre un sistema competente y uno cálido12. El estilo de comunicación y la configuración de la agencia influyen en las evaluaciones de los agentes conversacionales13. En aplicaciones médicas móviles, las señales sociales y las preocupaciones sobre la privacidad afectan conjuntamente la confianza y la intención de comportamiento14. Las señales antropomórficas en agentes conversacionales de atención médica pueden aumentar la presencia social, la confianza y la aceptación, aunque también podrían generar expectativas que excedan las capacidades del sistema15. La investigación sobre equipos humano-IA muestra además que la calidez y la competencia predicen diferentes formas de receptividad16. En tareas de alto riesgo, la confianza depende de la adecuación entre el rol del equipo, el contexto de la tarea y la violación del desempeño17. La coherencia entre el rol social de un chatbot y su desempeño también afecta la construcción y la recuperación de la confianza18. Por lo tanto, las señales de experto y de compañero hacen que diferentes estándares evaluativos sean más evidentes, en lugar de simplemente cambiar el tono de la conversación.
Quedan dos vacíos. En primer lugar, la investigación no ha explicado cómo cambia la relevancia de las señales orientadas a la competencia y a la relación según las demandas de la tarea médica. Las revisiones sobre la confianza humana en la IA enfatizan la dependencia del contexto, pero no aclaran cómo operan las señales de experto y de compañero en consultas relacionadas con enfermedades y con salud19. En segundo lugar, los estudios sobre la confianza en la IA médica se basan en autoinformes, lo que proporciona evidencia limitada sobre el procesamiento asociado a la evaluación basada en roles. La privacidad, la transparencia, la rendición de cuentas y el sesgo también restringen la interpretación de las señales de rol en la interfaz20,21. Para abordar estos vacíos, este estudio se basa en la teoría de la congruencia de roles, que explica la evaluación mediante la alineación entre las señales de rol y las demandas relevantes del contexto22. El estudio 1 utiliza un experimento aleatorizado de escenarios 2 (rol: experto frente a compañero) × 2 (tarea: consulta por enfermedad frente a consulta por salud) (N = 300) para examinar el marco de rol, el contexto de la tarea y asociaciones indirectas paralelas a través de la percepción de profesionalismo y presencia social. El estudio 2 utiliza un experimento independiente de EEG con un diseño intra-sujetos (N = 39) para comparar la actividad en la banda theta en respuesta a afirmaciones enmarcadas como de experto y de compañero. El estudio 1 evalúa asociaciones conductuales y moderación contextual; el estudio 2 proporciona una comparación exploratoria a nivel de procesamiento, más que una validación neural del modelo indirecto condicional.
Marco teórico y desarrollo de hipótesis
Enfoque del rol en la IA médica
La inteligencia artificial médica opera en entornos de alto riesgo que implican riesgo de enfermedad, recomendaciones de tratamiento, responsabilidad legal y límites éticos23. Por lo tanto, la definición del rol es importante porque el lenguaje de interfaz puede hacer que los límites de capacidad, evidencia y responsabilidad sean más o menos evidentes para los usuarios. La investigación sobre transparencia también enfatiza que los sistemas de inteligencia artificial médica deben comunicar los límites de sus capacidades y sus bases de evidencia5. Las respuestas con estilo de experto transmiten competencia mediante terminología formal, razonamiento estructurado, declaraciones de límites y recomendaciones de acción, mientras que las respuestas con estilo de compañero transmiten apoyo relacional mediante empatía, tranquilización y lenguaje colaborativo. Estas señales no son meramente decorativas en la interfaz: moldean los criterios que los usuarios aplican al evaluar un sistema24,25. La antropomorfización puede provocar respuestas sociales, pero también puede generar expectativas irreales y difuminar los límites de responsabilidad26,27. La investigación sobre equipos humano-IA y chatbots indica además que la calidez, la competencia, la adecuación del rol al contexto y la coherencia entre el rol social y el desempeño influyen en la aceptación y la confianza16,17,18. En este estudio, la congruencia de rol se refiere a la alineación entre las señales transmitidas por una respuesta de IA y las exigencias evaluativas evidentes en la tarea de consulta22.
Doble vía de confianza: profesionalismo percibido y presencia social
Se infiere la congruencia de rol a partir de la interacción observada entre rol y tarea, en lugar de medirla como un constructo subjetivo independiente. Por lo tanto, la interpretación está ligada a la interacción experimental y no implica que los participantes informaran conscientemente una sensación de adecuación al rol. La confianza implica juicios cognitivos sobre competencia y fiabilidad, así como juicios afectivos sobre seguridad relacional y comodidad28,29,30. En el uso de inteligencia artificial médica, los usuarios evalúan tanto si el sistema puede apoyar una decisión sanitaria como si la interacción con él resulta suficientemente segura y accesible. La presentación como experto debería hacer más evidente la evaluación orientada a la competencia. Evidencia procedente de investigaciones sobre sistemas de apoyo a la toma de decisiones clínicas indica que las explicaciones y la información sobre el razonamiento del sistema afectan la confianza y la dependencia31. En consultas sanitarias en línea, también se asocian la personalización y la atención con la confianza y la aceptación9. La profesionalidad percibida refleja una evaluación orientada a la competencia, relevante para la confianza25. La investigación sobre consultas sanitarias en línea identifica asimismo la credibilidad de la fuente como un factor relevante para la aceptación de sugerencias sanitarias por parte de los usuarios32. Por consiguiente, el presente estudio evalúa si la presentación como experto se asocia con una mayor profesionalidad percibida.
H1: Los roles de acompañamiento generan una profesionalidad percibida menor en comparación con las inteligencias médicas artificiales de estilo experto.
El marco de acompañamiento debería hacer que la evaluación relacional sea más evidente. La presencia social se refiere a la calidad interpersonal percibida en la interacción mediada, más que a la creencia de que el sistema es humano33. Está asociada con la calidad de la interacción, la confianza y la aceptación en servicios en línea y agentes conversacionales de salud15,34.
La presencia social puede reducir el costo psicológico de la autorrevelación y favorecer el intercambio de información durante una consulta en línea32. Por lo tanto, el presente estudio evalúa si el marco de acompañamiento se asocia con una mayor presencia social.
H2: Los roles de experto generan una menor presencia social en comparación con las IA médicas de estilo compañero.
La profesionalidad percibida y la presencia social se consideran asociaciones paralelas y no excluyentes con la confianza. La dependencia adecuada en automatización de alto riesgo depende de las capacidades del sistema, sus límites y los requisitos de la tarea, más que de maximizar únicamente la confianza35.
H3: La profesionalidad percibida y la presencia social predicen positivamente la confianza cuando se modelan simultáneamente.
Efecto moderador del contexto de la tarea
Las mismas señales de rol pueden tener un peso psicológico diferente en diversas tareas médicas. La adecuación entre tarea y tecnología proporciona una justificación contextual para examinar si las señales de rol coinciden con los requisitos de la tarea36. La consulta por enfermedad implica mayor incertidumbre, riesgo de pérdida y costos por errores, lo que hace especialmente relevantes la profesionalidad, la precisión y límites claros7,37. Por lo tanto, las señales de experto deberían estar más estrechamente alineadas con estas exigencias que las señales de compañero. La consulta sobre salud se centra en la gestión a largo plazo de la salud, la persistencia conductual y la continuidad de la interacción. Las revisiones sobre sistemas de apoyo a la toma de decisiones clínicas basados en inteligencia artificial y agentes conversacionales para la salud enfatizan la importancia de la información contextual, la capacidad de acción, la interacción y las condiciones de implementación3,38,39.
Este estudio predice que la diferencia entre experto y acompañante en la profesionalidad percibida será mayor en la consulta por enfermedad que en la consulta por salud. No considera una interacción no significativa en la presencia social como evidencia de invariancia. La hipótesis se propone de la siguiente manera:
H4: El contexto de la tarea modera significativamente el impacto de los roles de experto sobre la profesionalidad percibida. El impacto es mayor en la consulta de enfermedad que en la consulta de salud.
Protocolo
Resumen de la investigación
El estudio se llevó a cabo de acuerdo con la Declaración de Helsinki y fue aprobado por el Comité de Ética de la Universidad Huaqiao (M2025021), que incluyó tanto el experimento en escenario en línea como el experimento de EEG. Todos los participantes dieron su consentimiento informado y recibieron una compensación al finalizar.
Este artículo contiene dos estudios complementarios (véase Figura 1). El estudio 1 es un experimento aleatorizado de escenarios 2 × 2 que estima los efectos del marco de rol y del contexto de la tarea, evalúa la estructura de medición y prueba asociaciones indirectas condicionales paralelas a través de la profesionalidad percibida y la presencia social. El estudio 2 es un experimento de EEG intra-sujeto que compara la actividad en la banda theta bajo enunciados enmarcados como de experto y de acompañante, y se interpreta como una comparación exploratoria a nivel de proceso. Los estudios proporcionan evidencia conductual y neural a diferentes niveles; no se tratan como un único mecanismo progresivo.
Estudio 1: Experimento de escenario
Participantes y diseño
El estudio 1 utilizó un diseño entre sujetos balanceado 2 × 2 con marco de rol (experto frente a compañero) y contexto de tarea (consulta de enfermedad frente a consulta de salud). El cálculo original con G*Power asumió un efecto medio en el ANOVA global (f = 0,25), α = ,05 y potencia = ,80, e indicó un mínimo de 128 participantes40. Dado que este cálculo no se adaptó a efectos indirectos condicionales, se informa como la base original de reclutamiento y no como evidencia de potencia para la mediación moderada. Con N = 300 y cuatro celdas balanceadas, un análisis de sensibilidad indicó una potencia del 80 % para detectar una interacción de f = 0,162 (η2 parcial = ,026) con α = ,05.
Además, realizamos un análisis post hoc de potencia basado en simulaciones para los índices de moderación-mediación utilizando el conjunto de datos del cuestionario de SPSS con 300 casos. La simulación generó 1 000 muestras balanceadas 2 × 2 a partir del modelo con mediadores paralelos ajustado, mediante el remuestreo de los residuos empíricos; cada conjunto de datos simulado utilizó 500 intervalos de confianza bootstrap percentil basados en el remuestreo de casos. Las probabilidades estimadas de que el intervalo de confianza excluyera el cero fueron de 0,698 para el índice de profesionalismo, 0,157 para el índice de presencia social y 0,279 para la diferencia directa entre ambos índices. Este análisis está condicionado a los coeficientes observados, las distribuciones de residuos y la especificación del modelo, y no constituye una justificación a priori del tamaño muestral. El análisis completo de potencia post hoc basado en simulaciones se presenta en Supplementary Table S1.
Se reclutaron trescientos participantes a través de Credamo y se asignaron aleatoriamente a cuatro condiciones (n = 75 por celda). La muestra incluyó 109 hombres (36,3 %) y 191 mujeres (63,7 %); el 43,7 % tenía entre 21 y 30 años, el 41,3 % tenía entre 31 y 40 años, y el 69,7 % poseía un título universitario. Se completaron todos los ítems requeridos del cuestionario. No se utilizó ningún ítem específico para verificar la atención ni se estableció un criterio de exclusión basado en el tiempo de finalización preregistrado, y no se excluyó a ningún participante. El tiempo mediano de finalización fue de 268 s (rango = 67-1.894 s). Un análisis post hoc de robustez que excluyó las respuestas por debajo del percentil cinco del tiempo de finalización (<125 s; n conservado = 285) evaluó la sensibilidad ante respuestas inusualmente rápidas. Las estadísticas detalladas de verificación de la manipulación y los análisis de sensibilidad respecto al tiempo de finalización se informan en la Tabla Suplementaria S2.
Estímulos experimentales y procedimiento
Los materiales de estímulo consistieron en una introducción al escenario de la tarea y una respuesta de diálogo con un médico de inteligencia artificial, formando cuatro conjuntos experimentales completos. El escenario de consulta por enfermedad pedía a los participantes imaginar episodios recurrentes de opresión en el pecho y palpitaciones nocturnas, así como preocupación sobre si se requería atención hospitalaria inmediata. El escenario de consulta de salud pedía a los participantes imaginar que se encontraban en buen estado de salud general y que buscaban un plan personalizado de alimentación y ejercicio. Cada categoría de tarea estuvo representada por un escenario; por lo tanto, las conclusiones se limitan a estos dos escenarios y no pueden generalizarse a todas las consultas médicas por enfermedad o de salud.
Las cuatro capturas de pantalla del cuestionario utilizaron el mismo icono y mostraron el nombre del sistema, Medical AI (DiagnosPro), manteniendo así la identidad mostrada constante en todas las condiciones. Las respuestas enmarcadas como de experto utilizaron análisis estructurado, declaraciones de riesgo o evidencia, lenguaje directivo y recomendaciones explícitas de acción. Las respuestas enmarcadas como de acompañamiento utilizaron empatía, tranquilización, redacción colaborativa y sugerencias flexibles. Por lo tanto, la manipulación representó un conjunto de señales comunicativas e informativas congruentes con el rol; no aisló el enmarque del rol de la especificidad, la capacidad de acción, la certeza, el detalle médico o el apoyo emocional. El nombre compartido DiagnosPro también pudo haber transmitido una señal de experto en todas las condiciones. El conjunto completo de estímulos se proporciona en Supplementary File 1.
Primero, los participantes leyeron el formulario de consentimiento informado y luego se les asignó aleatoriamente a una de cuatro condiciones experimentales. Después de leer el escenario y el estímulo del diálogo, completaron el cuestionario basado en sus respuestas. El cuestionario comenzó con comprobaciones de manipulación, seguidas de medidas de profesionalismo percibido, presencia social, confianza y datos demográficos. El procedimiento duró aproximadamente 15 min.
Todas las escalas utilizaron una puntuación tipo Likert de 7 puntos, donde 1 representaba totalmente en desacuerdo y 7 totalmente de acuerdo. La profesionalidad percibida se midió con tres ítems: «Esta inteligencia artificial médica es capaz de proporcionar asesoramiento médico», «Esta inteligencia artificial médica parece muy profesional» y «Esta inteligencia artificial médica es una experta en el campo médico» (α = .883)41. La presencia social se midió con tres ítems: «En la interacción con esta inteligencia artificial médica, sentí un trato humano», «La interacción con esta inteligencia artificial médica me hizo sentir cercanía» y «Esta inteligencia artificial médica pareció sociable durante la interacción» (α = .932)42. La confianza cognitiva comprendió tres ítems: «Puedo confiar en esta inteligencia artificial médica porque tiene las habilidades necesarias para ofrecer asesoramiento», «Tengo confianza en la precisión del asesoramiento proporcionado por esta inteligencia artificial médica» y «Esta inteligencia artificial médica tiene la suficiente capacidad para manejar mi problema de salud» (α = .837). La confianza afectiva comprendió tres ítems: «Esta inteligencia artificial médica me hace sentir calidez y cuidado», «Depender de esta inteligencia artificial médica me hace sentir seguro porque parece preocuparse por mi salud» y «Creo que esta inteligencia artificial médica no haría intencionadamente nada perjudicial para mí» (α = .700). La confianza general fue el promedio de los seis ítems de confianza (α = .784). Estas mediciones se analizaron como resultados orientados a la competencia, interpersonales, de confianza cognitiva, de confianza afectiva y de confianza general, más que como constructos mutuamente excluyentes.
El análisis se llevó a cabo en cuatro pasos. Primero, un análisis factorial confirmatorio comparó el modelo propuesto de cuatro factores con alternativas de dos y un factor; se examinaron la fiabilidad compuesta, la varianza extraída promedio, las correlaciones latentes y las razones heterotrait-monotrait. Segundo, modelos factoriales completos 2 x 2 estimaron los efectos principales y de interacción para la profesionalidad percibida, la presencia social, la confianza cognitiva, la confianza afectiva y la confianza general, con medias de celdas, intervalos de confianza y η2 parcial. Las medias marginales estimadas y los intervalos de confianza del 95 % se muestran en Figura 2. Tercero, el Modelo 7 de PROCESS 4.2 beta incluyó simultáneamente la profesionalidad percibida y la presencia social como mediadores paralelos, con 5 000 muestras bootstrap percentil43. La definición del rol se codificó como 1 = experto y 2 = acompañante, y el contexto de la tarea se codificó como 1 = consulta de enfermedad y 2 = consulta de salud. Un bootstrap de re-muestreo común contrastó directamente los dos índices de mediación moderada. Cuarto, la confianza cognitiva y la confianza afectiva se analizaron por separado como resultados exploratorios. Dado que los mediadores y los resultados se midieron simultáneamente, las estimaciones se interpretan como asociaciones indirectas compatibles con la mediación, más que como mecanismos psicológicos causales.
Estudio 2: Experimento de EEG
Participantes
El estudio 2 reclutó a 40 participantes. Se excluyó a un participante porque los ensayos contaminados por artefactos superaron el 30 % en al menos una condición experimental, quedando 39 participantes en los análisis finales de EEG. Este criterio aseguró que cada participante incluido aportara al menos el 70 % de los ensayos en cada condición. Todos los participantes proporcionaron consentimiento informado por escrito y recibieron compensación tras el experimento. La información demográfica no pudo vincularse con todos los registros de EEG conservados y, por lo tanto, no se resume para la muestra final de EEG.
Estímulos y procedimiento experimentales
El experimento se realizó en un laboratorio estándar de EEG utilizando un diseño intra-sujetos, con estímulos presentados en E-Prime 2.1. Se instruyó a los participantes para que imaginaran interactuar con un sistema de inteligencia artificial médica y evaluaran su confianza en el sistema para cada escenario de consulta médica. El experimento manipuló el rol percibido del sistema de inteligencia artificial médica, incluyendo variantes de tipo experto y de tipo compañero.
Se elaboraron un total de 40 estímulos con oraciones en chino. La condición de tipo experto contenía 20 estímulos que comenzaban con «experto en IA médica», mientras que la condición de tipo compañero contenía 20 estímulos paralelos que comenzaban con «compañero de IA médica». Los escenarios médicos abarcaban tanto funciones profesionales de diagnóstico, como preguntar sobre la historia clínica, analizar informes de exámenes, evaluar datos de frecuencia cardíaca, interpretar pruebas genéticas, juzgar el riesgo de enfermedad y recomendar planes de tratamiento, como funciones de apoyo en la gestión de la salud, tales como mostrar preocupación por el estado físico, preguntar sobre la calidad del sueño, aliviar la ansiedad, registrar datos de salud, fomentar el cumplimiento del tratamiento y ofrecer consejos diarios para la salud. Por lo tanto, las condiciones también diferían en contenido semántico y complejidad; no se contaba con ninguna coincidencia independiente de estímulos ni prueba previa.
Antes del experimento formal, los participantes completaron un bloque de práctica breve. Cada ensayo comenzaba con una cruz de fijación de 500 ms, seguida de un intervalo en blanco aleatorizado de 300–500 ms y un enunciado de IA médica presentado durante 1.600 ms. A continuación, los participantes emitían un juicio binario de confianza a su propio ritmo, presionando la tecla F para indicar confianza o la tecla J para indicar falta de confianza (véase Figura 3). Los enunciados enmarcados como de experto y como de compañero se presentaron en orden aleatorio. Los registros de la tarea E-Prime indicaron 80 ensayos formales por registro de tarea: 40 ensayos de experto y 40 ensayos de compañero, en los que cada uno de los 20 enunciados únicos por rol se presentó dos veces.
Datos de la tarea conductual
Los datos de la tarea conductual fueron utilizables para 38 de los 39 participantes en la muestra final de EEG; el registro de la tarea E-Prime de un participante no era utilizable. Por lo tanto, los análisis conductuales utilizaron N = 38. Los resultados conductuales detallados y el desglose de la muestra se proporcionan en la Tabla Suplementaria S3. La confianza se codificó como una respuesta con la tecla F; las respuestas con la tecla J indicaron desconfianza. Las respuestas en blanco o con un tiempo de respuesta registrado de 0 ms se codificaron como datos faltantes. La tasa de confianza se calculó entre los ensayos respondidos, y el tiempo de respuesta se resumió a partir de los ensayos respondidos. Los datos neuronales disponibles para el análisis contenían medidas agregadas por condición, pero no índices de EEG a nivel de ensayo ni identificadores verificados que vincularan cada registro conductual con su registro de EEG; por lo tanto, no se estimó ningún modelo mixto a nivel de ensayo de EEG y juicios de confianza.
Registro y análisis de EEG
Se utilizó el gel electrolítico conductor Quik-Gel para mantener la impedancia entre el electrodo y la piel por debajo de 5 kOhm. FCz fue la referencia en línea predeterminada del dispositivo, y la frecuencia de muestreo fue de 1.000 Hz. La re-referenciación fuera de línea respecto al promedio de las apófisis mastoides bilaterales se realizó mediante la función integrada de re-referenciación de CURRY; FCz se conservó y se reconstruyó automáticamente en relación con la nueva referencia, sin utilizar ningún comando o script personalizado de reconstrucción. El procesamiento posterior fuera de línea se realizó en MATLAB R2020b con EEGLAB44 e ICLabel45. Los datos se submuestrearon a 500 Hz y se filtraron con un paso de banda de 0,1 a 40 Hz. Los canales defectuosos y los segmentos de datos gravemente contaminados se identificaron y eliminaron mediante inspección visual; no se aplicó interpolación automatizada ni umbral automatizado de rechazo de segmentos. Luego se utilizó la implementación predeterminada de runica de EEGLAB (ICA Infomax), y se eliminaron los componentes cuando ICLabel asignaba una probabilidad de al menos 0,70 a una clase de artefacto (por ejemplo, actividad ocular, muscular, cardíaca, de ruido de línea o de ruido de canal). Se excluyeron los participantes con más del 30 % de ensayos contaminados por artefactos en cualquiera de las condiciones, asegurando así una retención de al menos el 70 % de los ensayos en cada condición. Los periodos abarcaban desde −1.000 hasta 1.996 ms. Para el análisis de conectividad funcional, los datos preprocesados se submuestrearon adicionalmente a 250 Hz, y se excluyeron los electrodos periféricos, incluidos P7, P8, F7 y F8, antes de la estimación de la sincronía de fase.
Se ha asociado la actividad theta registrada en sitios frontales medios del cuero cabelludo con cálculos realizados ante demandas de control cognitivo46. También se ha relacionado la sincronización de fase en la banda theta entre electrodos frontales mediales y laterales con la coordinación durante el procesamiento relacionado con el control47. En particular, se ha observado un aumento de la sincronización de fase en la banda theta entre sitios como FCz y F6 tras la detección de conflicto o error48. Dado que estas medidas del cuero cabelludo no son exclusivamente específicas para el control cognitivo, se consideran aquí como indicadores convergentes del proceso, más que como lecturas directas de un único mecanismo cognitivo.
Primero, se cuantificó la sincronización relacionada con eventos en la banda theta frontal-medial (SRE) en la banda de 4–8 Hz dentro de la ventana postestímulo de 800–1.000 ms. La SRE se calculó mediante análisis tiempo-frecuencia, con el cambio de potencia relativa computado respecto a la línea base preestímulo de −500 a −200 ms. Los valores positivos indican un aumento de potencia (sincronización), mientras que los valores negativos indican una supresión de potencia (desincronización). Segundo, se estimó la conectividad funcional tras un nuevo submuestreo de los datos preprocesados a 250 Hz y la exclusión de electrodos periféricos, incluidos P7, P8, F7 y F8. Se aplicó una transformada de Fourier de corta duración (STFT) antes de calcular el valor de bloqueo de fase en la banda theta entre FCz y F6. El cambio en el VBP corregido por línea base (ΔVBP) se calculó respecto a la línea base preestímulo de −600 a −200 ms. El VBP crudo está comprendido entre 0 y 1; por lo tanto, los valores negativos de ΔVBP indican una disminución respecto a la línea base, y no un bloqueo de fase negativo. Estas medidas en el cuero cabelludo se interpretan como patrones exploratorios asociados con el procesamiento relacionado con el control y la coordinación prefrontal; no identifican directamente un proceso cognitivo específico ni una fuente neural determinada.
Resultados
Estudio 1: Resultados del escenario-experimento
Modelo de medición. El modelo de cuatro factores se ajustó mejor que las alternativas de dos y un factor, pero el ajuste absoluto fue mixto: χ2(48) = 223,93, p < ,001; CFI = ,935; TLI = ,911; RMSEA = ,111; SRMR = ,140. Las cargas estandarizadas oscilaron entre ,382 y ,937. La fiabilidad compuesta fue de ,886 para la profesionalidad percibida, ,932 para la presencia social, ,840 para la confianza cognitiva y ,709 para la confianza afectiva; los valores correspondientes de AVE fueron ,722, ,821, ,636 y ,474. La validez discriminante fue limitada: los valores de HTMT fueron ,935 entre profesionalidad percibida y confianza cognitiva, y ,926 entre presencia social y confianza afectiva. Por lo tanto, los hallazgos del proceso condicional se interpretan con cautela, y los análisis de confianza específicos por dimensión son exploratorios (Tabla 1).
Comprobaciones de manipulación. Los participantes del grupo con marco de experto (n = 150, M = 5,57, DT = 1,18) calificaron a la IA médica como más parecida a un experto que los participantes del grupo con marco de compañero (n = 150, M = 3,21, DT = 1,76). Debido a que las varianzas diferían, F = 47,42, p < ,001, se utilizó la prueba de Welch, t(259,90) = 13,63, p < ,001, diferencia media = 2,36, IC del 95 % [2,02, 2,70]. Los participantes del grupo con condición de enfermedad (n = 150, M = 2,51, DT = 1,53) dieron calificaciones más bajas en orientación hacia la salud preventiva que los participantes del grupo con condición de salud (n = 150, M = 5,98, DT = 1,22), F = 10,96, p = ,001; t de Welch (284,11) = −21,70, p < ,001, diferencia media = −3,47, IC del 95 % [−3,79, −3,16]. Los grados de libertad de Welch no son iguales a N − 2 cuando las varianzas son desiguales; todos los análisis utilizaron N = 300.
Estadísticas descriptivas por condición experimental. Para el encuadre de experto, la enfermedad y la consulta de salud produjeron medias de profesionalismo percibido de 5,69 (DE = 0,83) y 5,85 (DE = 0,63), medias de presencia social de 4,28 (DE = 1,54) y 4,25 (DE = 1,64), y medias de confianza general de 5,45 (DE = 0,86) y 5,28 (DE = 0,87), respectivamente. Para el encuadre de compañero, las medias correspondientes para enfermedad y salud fueron 4,52 (DE = 1,47) y 5,25 (DE = 0,94) para profesionalismo percibido, 5,68 (DE = 1,07) y 5,93 (DE = 0,74) para presencia social, y 5,30 (DE = 1,02) y 5,61 (DE = 0,64) para confianza general. Tabla 2 informa todos los intervalos de confianza específicos por condición y las pruebas factoriales completas.
Resultados factoriales completos. La profesionalidad percibida mostró un efecto principal de la definición del rol, F(1, 296) = 56.92, p < .001, η2 parcial = .161, un efecto principal del contexto de la tarea, F(1, 296) = 14.37, p < .001, η2 parcial = .046, y una interacción rol × tarea, F(1, 296) = 5.89, p = .016, η2 parcial = .020. La presencia social mostró un efecto principal de la definición del rol, F(1, 296) = 105.57, p < .001, η2 parcial = .263, pero ni el efecto principal de la tarea, F(1, 296) = 0.59, p = .442, ni la interacción, F(1, 296) = 0.84, p = .359, fueron significativos. Este último resultado indica que no se detectó moderación; no establece equivalencia entre tareas. Para la confianza cognitiva, la interacción rol × tarea fue significativa, F(1, 296) = 5.60, p = .019, η2 parcial = .019; la interacción correspondiente no fue significativa para la confianza afectiva, F(1, 296) = 3.48, p = .063, η2 parcial = .012. La confianza general no mostró un efecto principal de la definición del rol, F(1, 296) = 0.81, p = .369, ni un efecto principal de la tarea, F(1, 296) = 0.55, p = .459, pero la interacción rol × tarea fue significativa, F(1, 296) = 5.78, p = .017, η2 parcial = .019. En la consulta sobre enfermedad, la confianza general no difirió entre la definición de compañero y la de experto, diferencia media = −0.15, EE = 0.14, t(296) = −1.06, p = .288, IC del 95 % [−0.42, 0.13]. En la consulta sobre salud, la confianza general fue mayor bajo la definición de compañero, diferencia media = 0.33, EE = 0.14, t(296) = 2.34, p = .020, IC del 95 % [0.05, 0.60].
Asociaciones condicionales indirectas paralelas. Cuando se introdujeron simultáneamente la profesionalidad percibida y la presencia social, ambas mostraron una asociación positiva con la confianza general: b = 0.4872, SE = 0.0258, p < .001, IC del 95% [0.4294, 0.5460], y b = 0.3293, SE = 0.0208, p < .001, IC del 95% [0.2762, 0.3829], respectivamente. La asociación directa del marco de rol no fue significativa, b = 0.0119, SE = 0.0680, p = .861, IC del 95% [−0.1071, 0.1361]. Las asociaciones indirectas de la profesionalidad fueron −0.5695 en la consulta por enfermedad, IC bootstrap del 95% [−0.7687, −0.3851], y −0.2923 en la consulta por salud, IC bootstrap del 95% [−0.4288, −0.1634]. Las asociaciones indirectas de la presencia social fueron 0.4625 en la consulta por enfermedad, IC bootstrap del 95% [0.3165, 0.6091], y 0.5532 en la consulta por salud, IC bootstrap del 95% [0.3855, 0.7383] (Tabla 3). El índice de mediación moderada a través de la profesionalidad percibida fue 0.2772, IC bootstrap del 95% [0.0594, 0.5035], mientras que el índice a través de la presencia social fue 0.0907, IC bootstrap del 95% [−0.0984, 0.3008]. El contraste directo bootstrap entre los índices no fue significativo, diferencia = 0.1864, IC bootstrap del 95% [−0.0856, 0.4447]. Por lo tanto, los resultados apoyan la moderación contextual de la asociación indirecta con la profesionalidad, pero no establecen una moderación contextual estadísticamente diferente entre las dos asociaciones.
Análisis exploratorios de dimensiones de confianza. Para la confianza cognitiva, el contraste entre los índices de moderación-mediación de profesionalismo y presencia social fue positivo, diferencia = 0,3707, IC bootstrap del 95 % [0,0493, 0,6996]. Para la confianza afectiva, el contraste correspondiente no fue respaldado, diferencia = 0,0022, IC bootstrap del 95 % [−0,3421, 0,3127]. Ambos mediadores mantuvieron asociaciones positivas con ambas dimensiones de confianza, lo que indica efectos cruzados en lugar de efectos exclusivos. Dados los valores altos de HTMT, estos resultados no deben interpretarse como una separación definitiva de los mecanismos cognitivos y afectivos.
Potencia post hoc de mediación moderada. Bajo el modelo ajustado y los supuestos de remuestreo de residuos, la probabilidad estimada de que el intervalo de confianza percentil-bootstrap excluyera cero fue de 0,698 para el índice de profesionalismo, 0,157 para el índice de presencia social y 0,279 para su diferencia directa (1.000 simulaciones; 500 remuestras bootstrap por simulación). Estas estimaciones basadas en el diseño observado explican por qué el índice de profesionalismo apoyado y el contraste directo no significativo no deberían interpretarse como evidencia concluyente de una moderación contextual diferente.
Robustez del tiempo de finalización. Excluyendo las 15 respuestas por debajo de 125 s, quedaron 285 casos. La interacción de confianza general siguió siendo significativa, p = .029; el índice de profesionalismo siguió estando respaldado, IC bootstrap del 95 % [0,0242, 0,4827]; y el contraste entre los índices de mediación moderada siguió siendo no significativo, IC bootstrap del 95 % [−0,1027, 0,4506]. Las conclusiones principales no dependieron del 5 % más rápido de las respuestas.
Estudio 2: resultados de EEG
ERS theta frontomedial. En la muestra analítica final (N = 39), el ERS theta en la ventana de 4–8 Hz, 800–1.000 ms fue mayor bajo el marco de presentación de expertos (M = 0,2948, DE = 0,8218) que bajo el marco de presentación de compañeros (M = −0,0422, DE = 1,2155), diferencia media = 0,3369, IC del 95 % [0,0125, 0,6614], t(38) = 2,10, p = ,042, dz de Cohen = 0,337, η2 parcial = ,104. El valor p ajustado con el método de Holm para los dos resultados emparejados de EEG reportados fue ,042. Esta diferencia indica un procesamiento diferencial en la banda theta durante esta ventana de la tarea; sin embargo, el ERS theta por sí solo no identifica un proceso psicológico específico.
Cambio en la PLV de teta corregida respecto a la línea base en FCz-F6 (ΔPLV). En la muestra analítica final (N = 39), la ΔPLV de teta fue menos negativa bajo el marco de referencia de expertos (M = −0.0111, DE = 0.0546) que bajo el marco de referencia del acompañante (M = −0.0350, DE = 0.0473), diferencia media = 0.0239, IC del 95 % [0,0058, 0,0420], t(38) = 2,68, p = ,011, dz de Cohen = 0,429, η2 parcial = ,159. El valor p ajustado con el método de Holm en los dos resultados emparejados de EEG reportados fue ,022. Este patrón representa una disminución menor en la consistencia de la fase de teta respecto a la línea base bajo el marco de referencia de expertos; sin embargo, por sí solo no establece un mayor control prefrontal ni un mecanismo cognitivo específico (véase Figura 4 y Tabla 4).
Resultados de la tarea conductual. En los 38 registros de tareas analizados, la tasa de respuesta de confianza fue del 83,1 % (DE = 15,8 %) bajo el marco de experto y del 82,4 % (DE = 17,5 %) bajo el marco de compañero, diferencia media = 0,7 puntos porcentuales, IC 95 % [−0,9, 2,4], t(37) = 0,91, p = ,371, dz = 0,147. Los tiempos medios de respuesta fueron 828,7 ms (DE = 204,6) y 826,1 ms (DE = 208,9), respectivamente, diferencia media = 2,5 ms, IC 95 % [−14,0, 19,1], t(37) = 0,31, p = ,758, dz = 0,050. Las tasas de respuestas faltantes fueron del 6,3 % (DE = 7,4 %) y del 5,2 % (DE = 6,3 %), respectivamente, diferencia media = 1,1 puntos porcentuales, IC 95 % [−1,0, 3,1], t(37) = 1,05, p = ,302, dz = 0,170.
Declaración de disponibilidad de datos:
Los datos anonimizados del cuestionario del Estudio 1, los archivos de EEG preprocesados y los archivos de salida agregados de EEG que respaldan el Estudio 2 están disponibles públicamente en el Open Science Framework (OSF) en https://doi.org/10.17605/OSF.IO/JKSP7. Los materiales suplementarios incluyen los estímulos experimentales completos (Archivo Suplementario 1), comprobaciones de manipulación, análisis conductuales adicionales, análisis post hoc de potencia y información metodológica de apoyo.
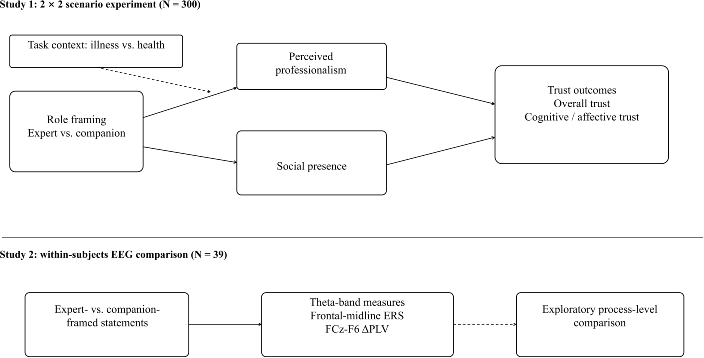
Figura 1. Marco de investigación. El estudio 1 es un experimento de escenarios 2 × 2 (N = 300) que examina el marco del rol, el contexto de la tarea y asociaciones indirectas paralelas a través del profesionalismo percibido y la presencia social. El estudio 2 proporciona una comparación exploratoria mediante electroencefalograma de declaraciones enmarcadas desde la perspectiva de experto y de compañero (N = 39); no prueba directamente el modelo indirecto condicional. Haga clic aquí para ver una versión más grande de esta figura.
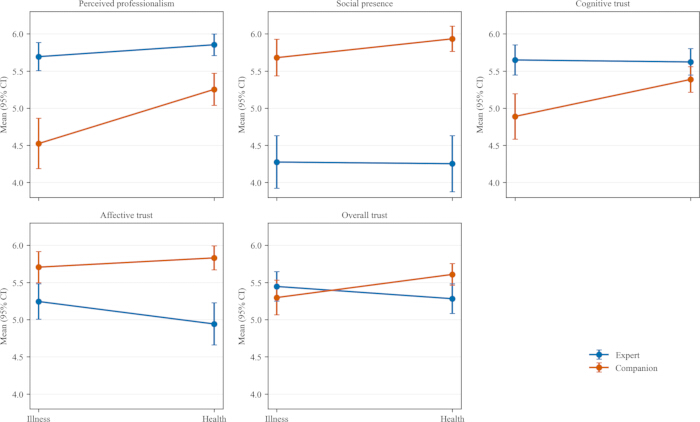
Figura 2. Gráficos de marco del rol × contexto de la tarea para la profesionalidad percibida, presencia social, confianza cognitiva, confianza afectiva y confianza general. Los puntos muestran las medias de las celdas y las barras de error indican los intervalos de confianza del 95 % (n = 75 por celda). Haga clic aquí para ver una versión más grande de esta figura.
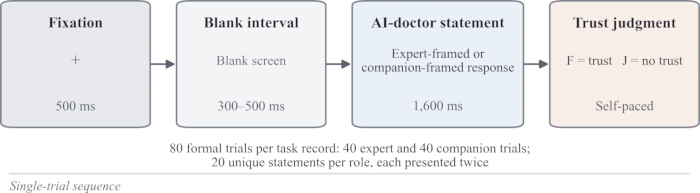
Figura 3. Secuencia por ensayo individual en el Estudio 2. Cada ensayo constaba de una fijación de 500 ms, un intervalo en blanco aleatorizado de 300–500 ms, una declaración del médico IA enmarcada como experto o compañero de 1.600 ms y un juicio binario de confianza a ritmo propio. Los registros de la tarea E-Prime indicaron 80 ensayos formales por registro de tarea, con 40 ensayos por condición de enmarque de rol y dos presentaciones de cada una de las 20 declaraciones únicas por condición. Haga clic aquí para ver una versión más grande de esta figura.
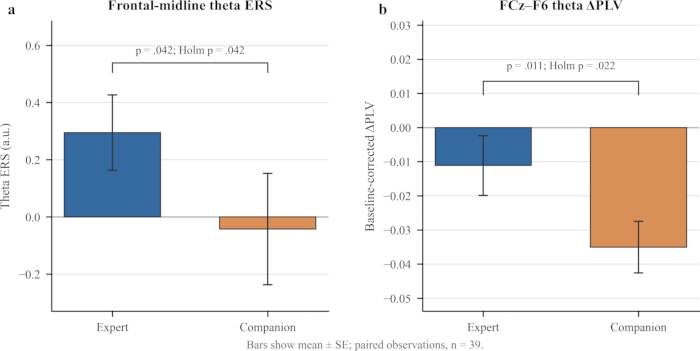
Figura 4. Efectos del encuadre del rol de la IA médica sobre la sincronización relacionada con eventos de theta frontal-medial y el valor de bloqueo de fase de theta FCz-F6. (A) Sincronización relacionada con eventos de theta en la región frontal-medial. (B) Cambio en el valor de bloqueo de fase de theta FCz-F6 corregido respecto a la línea base (ΔAPLV); valores negativos indican una disminución respecto a la línea base preestímulo. Las barras muestran la media ± EE para n = 39. Las pruebas t pareadas arrojaron p = .042 para la ERS de theta y p = .011 para el ΔAPLV; los valores de p ajustados mediante el método de Holm para estos dos resultados reportados fueron .042 y .022, respectivamente. Abreviaturas: Haga clic aquí para ver una versión más grande de esta figura.
Tabla 1: Diagnósticos del modelo de medición para el Estudio 1. La tabla presenta las cargas estandarizadas, alfa de Cronbach, fiabilidad compuesta, varianza promedio extraída, correlaciones latentes y valores HTMT para la profesionalidad percibida, presencia social, confianza cognitiva y confianza afectiva. N = 300. El modelo de cuatro factores se ajustó mejor que las alternativas, pero el RMSEA y el SRMR indicaron un ajuste absoluto débil y dos valores HTMT superaron 0,90. Abreviaturas: CR = fiabilidad compuesta; AVE = varianza promedio extraída; HTMT = razón heterotrait-monotrait. Haga clic aquí para descargar esta tabla.
Tabla 2: Estadísticas descriptivas de cuatro condiciones y pruebas factoriales completas 2 × 2 para el Estudio 1. Las entradas de las celdas indican n, media, desviación estándar e intervalo de confianza del 95 %; las pruebas factoriales indican F, p y η2 parcial. N = 300; n = 75 por celda. El marco de rol se codificó como 1 = experto y 2 = compañero; el contexto de la tarea se codificó como 1 = enfermedad y 2 = consulta de salud. Los coeficientes y los intervalos de confianza son no estandarizados. Haga clic aquí para descargar esta tabla.
Tabla 3: Asociaciones indirectas condicionales paralelas en el Estudio 1. N = 300. La definición del rol se codificó como 1 = experto y 2 = compañero; el contexto de la tarea se codificó como 1 = consulta de enfermedad y 2 = consulta de salud. Se introdujeron simultáneamente la profesionalidad percibida y la presencia social. Las estimaciones son no estandarizadas, y los intervalos de confianza percentil-bootstrap utilizaron 5.000 remuestras. La tabla incluye asociaciones indirectas condicionales, ambos índices de mediación moderada y su contraste directo mediante bootstrap. El contraste directo entre los dos índices de mediación moderada para la confianza general fue de 0,1864, IC del 95 % [-0,0856, 0,4447]. Haga clic aquí para descargar esta tabla.
Tabla 4: Resultados de EEG pareados en el Estudio 2. N = 39 observaciones apareadas en la muestra analítica final. La tabla muestra las medias por condición, las diferencias medias apareadas, los intervalos de confianza del 95 % y las pruebas apareadas t pruebas, Cohen’s dz, η parcial2y valores p ajustados con Holm para la ERS de theta frontal-medial y el ΔPLV de theta en FCz-F6 corregido respecto a la línea base. La corrección de Holm cubre únicamente los dos resultados de EEG pareados reportados y no reconstruye ninguna búsqueda más amplia no documentada sobre electrodos, bandas o ventanas temporales. Haga clic aquí para descargar esta tabla.
Archivo suplementario 1: Estímulos experimentales utilizados en el Estudio 1. El archivo contiene el texto completo de las respuestas de la IA médica enmarcadas por expertos y enmarcadas por compañeros utilizadas en los escenarios de consulta de enfermedad y consulta de salud. Se proporcionan tanto el chino original como la traducción al inglés.Haga clic aquí para descargar este archivo.
Tabla suplementaria S1. Análisis de potencia basado en simulaciones post hoc para el modelo de mediación moderada. Haga clic aquí para descargar este archivo.
Tabla suplementaria S2. Estadísticas de verificación de manipulación y análisis de sensibilidad del tiempo de finalización para el Estudio 1. Haga clic aquí para descargar este archivo.
Tabla suplementaria S3. Resultados de la tarea conductual, contabilización de la muestra y estadísticas descriptivas para el Estudio 2. Haga clic aquí para descargar este archivo.
Discusión
Implicaciones teóricas
Los dos estudios proporcionan evidencia a diferentes niveles. El estudio 1 identifica asociaciones entre roles y tareas, así como asociaciones indirectas paralelas, en un experimento aleatorizado basado en escenarios, mientras que el estudio 2 ofrece una comparación exploratoria a nivel de procesos mediante EEG. Por lo tanto, los estudios respaldan una explicación limitada de la evaluación basada en roles, en lugar de un único mecanismo progresivo. Los hallazgos extienden la teoría de la congruencia de roles al ámbito de la inteligencia artificial médica, al considerar la congruencia como la alineación entre las señales de rol y las demandas evaluativas relevantes para la tarea22. Esta interpretación se diferencia del contenido competencia-calidez y del ajuste entre tarea y tecnología. Los hallazgos sobre la aversión y la apreciación hacia los algoritmos pueden entenderse como evaluaciones sensibles al contexto acerca de si las señales de rol y capacidad se ajustan a la tarea49,50.
Los resultados también respaldan asociaciones paralelas y no excluyentes entre la definición del rol, la profesionalidad percibida, la presencia social y la confianza. Dado que la profesionalidad se solapa con la confianza cognitiva y la presencia social se solapa con la confianza afectiva, las evidencias apoyan un contenido evaluativo diferenciado, pero no dos mecanismos claramente separados. La interacción entre rol y tarea en la profesionalidad percibida es coherente con la explicación propuesta de congruencia de rol. Las evidencias respaldan una moderación contextual de la asociación con la profesionalidad, pero no establecen mecanismos contextuales estadísticamente asimétricos ni invariancia en la vía de la presencia social.
Los hallazgos de EEG ofrecen una perspectiva exploratoria a nivel de procesos. Las declaraciones enmarcadas por expertos se asociaron con patrones distintos en la banda theta, pero las condiciones también diferían en contenido semántico y complejidad, y a nivel de condición no se observó ninguna diferencia confiable en la confianza. Por lo tanto, las mediciones de EEG no establecen un mecanismo distinto de control cognitivo o de confianza. Los hallazgos neuronales deben considerarse como generadores de hipótesis. El estudio 2 no manipuló el contexto de la tarea, ni midió la profesionalidad percibida o la presencia social, ni vinculó los índices de EEG a nivel de ensayo con los juicios de confianza; por consiguiente, los resultados de EEG complementan, en lugar de validar, el modelo indirecto condicional.
Los hallazgos son compatibles con una dependencia adecuada, más que máxima. La dependencia del sistema automatizado debe calibrarse según las capacidades, límites y requisitos de la tarea35. Trabajos relacionados describen mecanismos cognitivos adaptativos que podrían respaldar una confianza y dependencia calibradas51. La perspectiva NeuroIS apoya el uso de medidas neuronales como complemento de la evidencia conductual al examinar procesos con resolución temporal52. Estudios previos de fMRI también muestran que la actividad neuronal durante los juicios de confianza en línea varía según los objetivos y contextos53.
Implicaciones de gestión
Para las plataformas médicas en línea, la implicación práctica es una dependencia calibrada en lugar de una simple maximización de la confianza. Las señales de rol deben ajustarse a las exigencias de la tarea y combinarse con la comunicación de incertidumbre, límites explícitos de capacidad, advertencias basadas en riesgos y derivación a clínicos calificados.
En módulos de alto riesgo que implican diagnóstico, interpretación de resultados anormales, asesoramiento médico o triaje, las señales orientadas a la competencia pueden ayudar a los usuarios a reconocer los límites de la evidencia y de la acción sin conferir una autoridad infundida. En módulos de menor urgencia, como dieta, ejercicio, sueño, adherencia y apoyo emocional, las señales orientadas a la relación pueden favorecer la participación sin generar una falsa tranquilidad o una antropomorfización inapropiada.
El diseño del rol debe ser modular y basado en escenarios, en lugar de un ajuste de personalidad fijo. La configuración del rol debe integrarse con explicaciones, avisos de privacidad, etiquetas de riesgo y mecanismos de escalación. La investigación sobre gobernanza enfatiza que la transparencia, la responsabilidad, la gestión de sesgos y la privacidad deben diseñarse conjuntamente, para que señales creíbles del rol en la interfaz no oculten riesgos en el sistema interno6,20,21.
Limitaciones de la investigación y direcciones futuras
El estudio 1 es un experimento de escenario en lugar de una consulta real. Las condiciones no se probaron previamente de forma independiente en cuanto a longitud, frecuencia de palabras, legibilidad, precisión, capacidad de acción, valencia emocional, activación, riesgo, familiaridad o complejidad. Los estudios futuros deben utilizar múltiples escenarios, nombres de sistemas neutros, estímulos emparejados por contenido, manipulación independiente o mediciones separadas en el tiempo, y efectos aleatorios a nivel de participante y de estímulo.
El estudio 2 proporcionó evidencia de EEG a nivel de procesos, pero la vinculación demográfica final de 39 personas fue incompleta, las frases de EEG no se emparejaron ni se probaron previamente de forma independiente según la longitud de la oración, frecuencia de palabras, legibilidad, valencia emocional, activación, riesgo percibido, familiaridad y complejidad, y las etiquetas explícitas de roles podrían haber generado características de demanda. El presente estudio utilizó el valor de bloqueo de fase corregido respecto a la línea base (ΔPLV) como medida predefinida de conectividad funcional. Aunque el índice ponderado de retraso de fase (wPLI) es menos sensible a la conducción volumétrica, no se incluyó en la tubería de análisis original. Los estudios futuros deberían examinar si los hallazgos actuales se replican utilizando wPLI u otras medidas complementarias de conectividad. Las salidas neuronales disponibles están agrupadas por condición y no pueden vincularse a juicios de confianza a nivel de ensayo; por lo tanto, no se estimó un modelo mixto de EEG-comportamiento a nivel de ensayo. Además, el PLV del cuero cabelludo también es sensible a los efectos de referencia común y de conducción volumétrica. Estas limitaciones implican que los hallazgos neuronales deben considerarse exploratorios y no deben interpretarse como evidencia de un mecanismo único de control cognitivo o de confianza.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Durante la elaboración de este trabajo, los autores utilizaron ChatGPT para mejorar el lenguaje. Después de usar esta herramienta/servicio, los autores revisaron y editaron el contenido según fue necesario y asumen total responsabilidad por el contenido de la publicación.
Agradecimientos
Este proyecto de investigación fue apoyado por los Proyectos Generales Financiados por el Fondo Nacional de Ciencias Sociales, RPC (Número de subvención 22BGL006).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Plataforma en línea de encuestas Credamo | Credamo (Jianshu), China | No aplicable | Plataforma en línea para cuestionarios, asignación aleatoria y reclutamiento de participantes utilizada en el Estudio 1. |
| Función de re-referenciación CURRY | Compumedics Neuroscan, EE. UU. | Versión no especificada | Re-referenciación fuera de línea integrada, desde la referencia en línea FCz hasta el promedio de las mastoides bilaterales; FCz se reconstruyó automáticamente con respecto a la nueva referencia. |
| Capuchón de electrodos EEG, de 64 canales | Compumedics Neuroscan (Compumedics Limited), Australia | Número de modelo/catálogo no especificado | Capuchón de electrodos Ag/AgCl de 64 canales utilizado para la grabación continua de EEG. |
| EEGLAB | Swartz Center for Computational Neuroscience, Universidad de California en San Diego, EE. UU. | versión 2023.0 | Entorno de MATLAB utilizado para el preprocesamiento de EEG y el análisis de componentes independientes. |
| E-Prime | Psychology Software Tools, Inc., EE. UU. | versión 2.1 | Presentación de estímulos y recopilación de respuestas en el Estudio 2. |
| G*Power | Universidad Heinrich Heine de Düsseldorf, Alemania | versión 3.1.9.7 | Cálculo inicial a priori del tamaño de la muestra, análisis de sensibilidad a interacciones y análisis de potencia posterior basado en modelos para el Estudio 1. |
| IBM SPSS Statistics | IBM Corp., EE. UU. | versión 27 | Entorno estadístico utilizado para ejecutar la macro PROCESS. |
| ICLabel | Swartz Center for Computational Neuroscience, Universidad de California en San Diego, EE. UU. | versión 1.7 | Complemento de EEGLAB utilizado para clasificar componentes independientes artifactual. |
| MATLAB | The MathWorks, Inc., EE. UU. | versión R2020b | Entorno informático utilizado para el procesamiento y análisis de EEG. |
| Macro PROCESS para SPSS | Andrew F. Hayes, Canadá | versión 4.2 beta | Modelo 7 con profesionalismo percibido y presencia social introducidos simultáneamente como mediadores paralelos, utilizando 5.000 muestras bootstrap percentiladas en el Estudio 1. |
| Gel conductor electrolítico Quik-Gel | Compumedics Neuroscan (Compumedics Limited), Australia | Número de catálogo no especificado; 32 oz | Gel conductor utilizado para reducir la impedancia entre el electrodo y la piel durante la grabación de EEG. |
| Amplificador EEG SynAmps2 | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; número de catálogo no especificado | Amplificador EEG de 64 a 256 canales configurado para grabación de 64 canales. |
Referencias
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.