Este estudio computacional presenta un flujo de trabajo con reconocimiento de compartimentos para evaluar transcriptomas públicos de virus respiratorios, demostrando que las respuestas del huésped en la nariz y la sangre muestran una concordancia limitada a nivel de genes, pero generan módulos específicos de compartimento reproducibles y biológicamente interpretables en diferentes conjuntos de datos independientes, comparaciones clínicas, recuperación longitudinal y análisis de robustez.
Artículo de investigación
Evaluación comparativa basada en compartimentos de transcriptomas de virus respiratorios para módulos de respuesta del huésped en sangre y mucosa nasal: un estudio computacional
En este artículo
Resumen
Resumen
Los transcriptomas virales respiratorios públicos son valiosos para estudiar las respuestas del huésped, pero las diferencias en la fuente del tejido, la definición de los controles y el diseño del estudio pueden dificultar los análisis agrupados. Desarrollamos un flujo de trabajo computacional sensible a los compartimentos para determinar si se puede identificar una actividad reproductible en la respuesta del huésped preservando el contexto biológico nasal y sanguíneo. La cohorte pediátrica pareada GSE117827 sirvió como conjunto de datos de referencia, compuesta por transcriptomas de hisopados nasales y de sangre completa provenientes de infecciones sintomáticas por picornavirus, infecciones sintomáticas por virus respiratorio sincitial, detección asintomática de picornavirus y controles negativos para virus. Tras el filtrado según el Comité de Nomenclatura Genética HUGO (HGNC), se analizaron 27.685 genes. Se definieron módulos separados de 50 genes codificantes de proteínas para las muestras nasales y sanguíneas a partir de las respuestas positivas más altas, y se bloquearon antes de la evaluación externa. Los efectos a nivel génico en la nariz y en la sangre fueron casi independientes (coeficiente de Pearson r = 0,015), y los módulos compartieron seis genes con superposición en el rango exploratorio (índice de Jaccard = 0,064). No obstante, el módulo nasal separó las infecciones de los controles en cohortes independientes de las vías respiratorias superiores, con áreas bajo la curva de la característica operativa del receptor (AUROC) de 0,749, 0,693 y 0,609, mientras que el módulo sanguíneo alcanzó valores de AUROC de 0,832, 0,924 y 0,870 en cohortes sanguíneos externos. En datos longitudinales de infección natural, las puntuaciones emparejadas disminuyeron desde la enfermedad aguda hasta el alta, con deltas pareados de 0,436 para las muestras nasales y 0,330 para la sangre. Tres conjuntos de datos adicionales de referencia, que comprenden 666 muestras externas, junto con controles nulos de genes aleatorios, análisis de tamaño de módulos, estabilidad mediante bootstrap, correlaciones con programas marcadores y partición de varianza, definieron la robustez y las limitaciones del flujo de trabajo. El conjunto de 33 ácidos ribonucleicos mensajeros (ARNm) de Pandya siguió siendo más eficaz para la discriminación entre infecciones virales y bacterianas, mientras que el módulo sanguíneo también aumentó en la neumonía bacteriana. Estos hallazgos respaldan el uso de módulos específicos de compartimento como puntuaciones reutilizables de actividad en la respuesta del huésped para la comparación de cohortes y el seguimiento de la recuperación, en lugar de biomarcadores universales aplicables a todos los tejidos o clasificadores independientes de patógenos.
Introducción
Las firmas transcriptómicas del huésped se utilizan ampliamente para clasificar síndromes infecciosos y comparar las respuestas inmunitarias entre patógenos1,2,3,4,5. Los virus respiratorios suelen activar genes estimulados por interferón (ISG), mediadores inflamatorios y vías de presentación de antígenos que se superponen6,7,8,9,10. Estudios recientes emparejados y longitudinales también muestran que las respuestas sistémicas y locales en las vías respiratorias pueden diferir en cuanto a su momento, composición celular y magnitud11. Este aspecto va más allá de la influenza, el virus respiratorio sincitial (VRS), el rinovirus y el SARS-CoV-2. El metapneumovirus humano sigue siendo una causa importante de enfermedades respiratorias, aunque su literatura sobre respuestas del huésped e intervenciones aún está en desarrollo12,13. Estas observaciones en infecciones por virus respiratorios resaltan aún más las diferencias entre las respuestas del huésped locales en las vías respiratorias y sistémicas14. Por lo tanto, para los estudios computacionales sobre virus y huésped, la pregunta práctica no es solo si existe una respuesta, sino si es posible reutilizar datos públicos mediante un flujo de trabajo transparente que conserve el contexto tisular y produzca puntuaciones de respuesta del huésped reproducibles.
La mayoría de los conjuntos de datos transcriptómicos públicos de virus respiratorios no fueron diseñados para inferencias limpias entre virus o entre tejidos. La fuente del tejido, el momento, la gravedad, la edad, la definición del control y la plataforma suelen variar conjuntamente. Los conjuntos de datos de expresión de alto rendimiento también son vulnerables a variaciones técnicas no deseadas y a variaciones a nivel de estudio15,16. Por lo tanto, un análisis agrupado puede recuperar una firma fuerte de interferón o inflamatoria mientras oculta su origen. Las muestras nasales capturan la biología inmune epitelial y mucosal, mientras que la sangre completa refleja las respuestas sistémicas de los leucocitos. Tratar estos compartimentos como intercambiables facilita el cálculo de una puntuación, pero dificulta su interpretación.
Construimos el análisis en torno a GSE117827, una cohorte apareada de nariz-sangre del mismo estudio, en lugar de la colección de descubrimiento disponible más grande17. La cohorte es pequeña, pero reduce los factores de confusión entre estudios al comparar los tamaños del efecto nasales y sanguíneos. Incluye infección sintomática por picornavirus, infección sintomática por VSR, detección asintomática de picornavirus y controles negativos para virus. Por lo tanto, la utilizamos únicamente como un ancla para módulos específicos de compartimentos separados. La pertenencia a los módulos se bloqueó antes de las pruebas externas. La estabilidad de la selección basada en la cohorte pequeña se examinó mediante remuestreo bootstrap estratificado, genes nulos aleatorios y análisis de sensibilidad del tamaño de los módulos.
Agregamos una capa de evaluación comparativa con bacterias y comparadores no infecciosos. GSE63990 contiene muestras de sangre completa de enfermedad respiratoria aguda etiquetadas como virales, bacterianas o no infecciosas18. GSE40012 contiene neumonía grave adquirida en la comunidad, síndrome de respuesta inflamatoria sistémica (SIRS) y controles sanos19. Estas cohortes permiten evaluar si un módulo refleja una actividad general de respuesta del huésped o una especificidad según la clase de patógeno. GSE53543 se analizó por separado como una referencia de perturbación ex vivo con células mononucleares de sangre periférica (PBMC) inducida por rinovirus. Este conjunto mide la capacidad de respuesta de los leucocitos ante un estímulo controlado, pero no es equivalente a una infección natural.
Nuestra premisa es deliberadamente conservadora. No intentamos demostrar una firma antiviral universal a partir de datos públicos heterogéneos. En cambio, nos preguntamos si un flujo de trabajo consciente del compartimento puede generar puntuaciones de módulo que sigan siendo útiles tras pruebas externas. El uso previsto es complementario a los clasificadores diagnósticos como el de Pandya de 33 ARNm. Estos módulos califican la actividad de respuesta del huésped en la nariz y la sangre a través de cohortes, recuperación y gradientes de síntomas. No están diseñados para asignar la clase de patógeno.
Protocolo
Este estudio reanalizó datos desidentificados y de acceso público, y no implicó nueva reclutación, intervención ni recolección de muestras. Por lo tanto, no se requirió aprobación ética institucional ni nuevo consentimiento informado para el presente análisis secundario. La aprobación ética y el consentimiento informado para los estudios originales fueron reportados por los generadores de datos respectivos.
Diseño del estudio y lógica del flujo de trabajo
Realizamos un estudio bioinformático retrospectivo con datos públicos utilizando conjuntos de datos depositados en el Gene Expression Omnibus20,21. No se generaron nuevas muestras de pacientes, experimentos de cultivo celular, modelos animales ni validaciones en laboratorio. El flujo de trabajo utilizó un diseño basado en anclaje inicial. GSE117827 se empleó para la estimación del tamaño del efecto, la construcción de módulos, la concordancia entre compartimentos y el análisis del gradiente de síntomas. Los conjuntos de datos independientes se introdujeron únicamente después de que se hubiera fijado la pertenencia a los módulos. El flujo de trabajo comprendió el anclaje por pares de compartimentos, la asignación HGNC y el filtrado de genes que codifican proteínas, la construcción independiente de módulos nasales y sanguíneos, la validación con tejidos homólogos y longitudinal, la comparación clínica y los análisis de robustez. Los análisis confirmatorios incluyeron pruebas fijas con tejidos homólogos y análisis longitudinales. Los análisis de solapamiento génico, gradiente de síntomas, programas marcadores y varianza fueron exploratorios o descriptivos.
Cohorte de referencia y contraste principal
GSE117827 contiene perfiles de expresión de hisopados nasales y sangre completa de 26 niños: 9 casos sintomáticos con picornavirus, 5 detecciones asintomáticas de picornavirus, 6 casos sintomáticos con VSR y 6 controles asintomáticos negativos para virus17. Dos casos de VSR carecían de muestras de sangre. Por lo tanto, el diseño completo de referencia incluyó 50 muestras, y el contraste principal entre infectados y controles incluyó 40 muestras tras excluir las detecciones asintomáticas de picornavirus de la construcción del módulo. Para el contraste principal, las muestras sintomáticas con picornavirus y las muestras sintomáticas con VSR se etiquetaron como infectadas, y las muestras asintomáticas negativas para virus se etiquetaron como controles. Las detecciones asintomáticas de picornavirus no se consideraron controles porque la detección viral sin síntomas es biológicamente distinta de la salud negativa para virus. Estas muestras se excluyeron de la construcción del módulo y posteriormente se utilizaron para un análisis de gradiente de síntomas.
Mapeo de sondas y preprocesamiento
GSE117827 fue perfilado en GPL23126. Los identificadores de grupos de transcritos se asociaron a símbolos génicos utilizando el archivo de anotación Clariom D Human na36, hg38 distribuido a través de la plataforma GEO GPL24539. Solo se conservaron los símbolos aprobados por HGNC22. Se eliminaron las sondas de control, las sondas ERCC, los grupos de transcritos sin mapear y los símbolos no aprobados. Los múltiples grupos de transcritos que se mapearon al mismo símbolo aprobado se combinaron mediante la expresión mediana. Tras el filtrado y la combinación, quedaron disponibles 27.685 genes para el análisis de anclaje. Se aplicó una transformación log₂(x + 1) únicamente cuando el percentil 95 de la matriz de expresión superó 50, lo que indicaba una escala de intensidad sin transformar. Se eliminaron los genes con más del 20 % de valores ausentes; los valores ausentes restantes se sustituyeron por la mediana dentro del gen. A continuación, cada gen se estandarizó en todas las muestras de ese conjunto de datos como z = (x − media)/desviación estándar muestral (ddof = 1). A los genes con varianza cero se les asignó un valor estandarizado de 0. La construcción de módulos se limitó a las entradas clasificadas como genes codificantes de proteínas en el conjunto completo de HGNC.
Análisis del tamaño del efecto y construcción de módulos
Los compartimentos nasales y sanguíneos se analizaron por separado. Las muestras virales sintomáticas se compararon con los controles negativos para virus mediante diferencias medias estandarizadas de Hedges g y pruebas de Welch bilaterales23. Hedges g se calculó como la diferencia media entre infectados y controles dividida por la desviación estándar agrupada, multiplicada por la corrección para muestras pequeñas 1 − 3/(4df − 1), donde df = ninfected + ncontrol − 2. Las pruebas de Welch se realizaron considerando varianzas desiguales. Las tasas de falsos descubrimientos de Benjamini–Hochberg se calcularon para todos los genes analizados dentro de cada compartimento24. Dado que ningún gen codificante de proteína cumplió la combinación estricta preestablecida de FDR < 0,05 y Hedges g > 0,8 en la pequeña cohorte de anclaje, los genes con efecto positivo se ordenaron primero por valor de P de Welch bilateral ascendente y luego por Hedges g descendente, utilizando el símbolo del gen como criterio determinista final para desempatar. Los 50 genes principales formaron cada módulo primario. Se eligió un tamaño de módulo de 50 genes a priori como una medida moderada que conserva la amplitud biológica limitando al mismo tiempo la pérdida de genes ausentes entre plataformas. Este tamaño de módulo no se ajustó según AUROC externo. Los análisis de sensibilidad con 10, 25, 50, 100 y 200 genes arrojaron el mismo resultado cualitativo de separación del anclaje. El objetivo fue la reproducibilidad a nivel de módulo, no el descubrimiento de genes individuales.
Concordancia entre compartimentos
Las estimaciones de Hedges g en mucosa nasal y sangre se alinearon por gen y se compararon mediante correlaciones de Pearson y Spearman. La superposición entre los 50 principales módulos nasales y los 50 principales módulos sanguíneos se resumió mediante el recuento de superposición y el índice de Jaccard. Los genes superpuestos se interpretaron como candidatos exploratorios de superposición de rangos entre compartimentos, más que como biomarcadores conservados validados.
Validación externa con tejidos coincidentes
La validación mediante puntuaciones de módulos utilizó conjuntos de datos públicos independientes con grupos de origen interpretables. La validación en vías respiratorias superiores incluyó muestras de lavado nasal de RSV del conjunto GSE41374 y los conjuntos de datos de SARS-CoV-2 GSE152075 y GSE156063. La validación en sangre incluyó GSE171110 y dos unidades del conjunto GSE38900 normalizadas por separado: GPL10558 (36 muestras; 28 de RSV y 8 controles) y GPL6884 (138 muestras; 107 de RSV y 31 controles). Para cada conjunto de datos externo, las sondas se asignaron a símbolos HGNC, y los símbolos duplicados se redujeron mediante la expresión mediana. Se aplicaron dentro de cada conjunto de datos las mismas reglas de transformación, filtrado de valores ausentes, imputación mediana y estandarización por gen mediante z, que se utilizaron para el conjunto de datos de referencia. Se calculó una puntuación de módulo como la media no ponderada de los valores de expresión estandarizados para los genes del módulo representado. Se informaron el AUROC, la precisión media y el FDR del test de Welch como métricas de portabilidad, no como estimaciones del rendimiento diagnóstico clínico.
Grandes conjuntos de datos de referencia clínica y perturbación ex vivo
Se utilizaron dos conjuntos de datos de sangre completa como referencias clínicas en lugar de cohortes de descubrimiento. En GSE63990, las muestras se asignaron según los metadatos depositados sobre el estado de infección a infección respiratoria viral (n = 117), infección respiratoria bacteriana (n = 73) o enfermedad no infecciosa (n = 90); se excluyeron las muestras que no tenían una de estas etiquetas inequívocas18. En GSE40012, los campos de diagnóstico depositados se asignaron a neumonía por influenza A (n = 39), neumonía bacteriana sin influenza (n = 61), SIRS sin neumonía (n = 40), controles sanos (n = 36) o neumonía bacteriana/influenza mixta (n = 14)19. Las muestras de neumonía bacteriana/influenza mixta fueron descritas pero excluidas de los contrastes binarios de referencia.
GSE53543 contiene 196 perfiles de PBMC ex vivo de 98 individuos. Cada individuo aportó una muestra solo con medio y una muestra expuesta al rinovirus 16 durante 24 h; los identificadores de los sujetos confirmaron 98 pares completos. La evaluación principal informó el AUROC entre las 98 muestras estimuladas y las 98 no estimuladas, ya que el AUROC es una métrica de separación por rangos. El emparejamiento de sujetos se mantuvo en los metadatos y se utilizó en un análisis de sensibilidad pareado de las diferencias de puntuación. Este experimento se analizó por separado de la infección clínica natural y no se utilizó para respaldar afirmaciones diagnósticas clínicas.
Se descargaron matrices crudas de series GEO para GSE63990, GSE40012 y GSE53543. Se utilizó GPL571 para GSE63990, GPL6947 para GSE40012 y GPL10558 para GSE53543. Las sondas se asignaron a símbolos aprobados por HGNC, y las asignaciones duplicadas se redujeron mediante la expresión mediana. Se utilizaron matrices normalizadas depositadas. La regla general del percentil 95 activó la transformación log₂(x + 1) únicamente para matrices en una escala no logarítmica. GSE53543 ya estaba transformado con log₂, normalizado por invariancia de rango y ajustado por el día de procesamiento por los investigadores originales, por lo que no se aplicó ninguna transformación logarítmica adicional. Tras eliminar los genes con más del 20 % de valores ausentes e imputar mediante la mediana los valores faltantes restantes, cada gen se estandarizó mediante z en todas las muestras dentro de su conjunto de datos. La capa de referencia contenía 470 muestras clínicas de sangre total y 196 muestras de PBMC ex vivo.
Comparación de referencia mediante firmas
Los módulos nasales y sanguíneos de referencia se compararon frente a tres conjuntos de referencia no ponderados. El conjunto oficial de 33 ARNm de Pandya se transcribió de la Tabla Suplementaria 1 del informe original del clasificador5. El comparador de Andres-Terre constaba de 33 genes orientados a interferón, curados a partir de la firma multiviral reportada3. El comparador Hallmark incluía un subconjunto de 33 genes centrales de interferón-alfa asociado al conjunto MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE25,26. Las listas completas de genes para los tres conjuntos de referencia se proporcionan en Datos Suplementarios 1. Estas puntuaciones de referencia no recrean los clasificadores ponderados originales. Para cada conjunto de datos, se calculó una puntuación como la media no ponderada de las puntuaciones z por gen disponibles; se requirió al menos la presencia de tres genes representados, y se informó el número de genes representados. Las comparaciones de referencia fueron: viral frente a bacteriano, viral frente a no infeccioso, viral frente a bacteriano-o-no infeccioso, viral frente a sano/control, y bacteriano frente a sano/control, siempre que los grupos requeridos estuvieran disponibles. El AUROC y la precisión media se interpretaron como métricas de comparación. Los valores P del test de Welch se ajustaron mediante el procedimiento de Benjamini–Hochberg en todas las combinaciones válidas de conjunto de datos-comparación-módulo en la tabla de comparación.
Validación longitudinal independiente
Los conjuntos de datos pareados agudo-frente-a-alta GSE97741 y GSE97742 se utilizaron únicamente para la validación longitudinal27. Las muestras etiquetadas como infección única por VSR (RSVsi) o rinovirus (hRV) en los metadatos depositados conformaron el análisis principal; las coinfecciones por VSR (RSVco) se incluyeron solamente en los resultados suplementarios. Las etiquetas de agudo y de alta se extrajeron de los títulos de las muestras. Las muestras se emparejaron por conjunto de datos, compartimento, grupo viral e identificador del sujeto, y solo se conservaron los sujetos con ambos puntos temporales. El grupo combinado principal comprendió 38 pares de RSVsi y 30 pares de hRV (68 pares por compartimento).
No se utilizó selección de genes, refinamiento de módulos ni ajuste de umbrales con GSE97741 o GSE97742. Estos conjuntos de datos se reservaron para validación externa. Los identificadores de sondas se asociaron a símbolos HGNC aprobados, y los símbolos duplicados se redujeron mediante la expresión mediana. Se aplicó la misma regla de transformación logarítmica al percentil 95, filtro de valores ausentes, imputación mediana y procedimientos de estandarización por gen z por conjunto de datos antes de calcular los puntajes fijos de los módulos de GSE117827.
Para cada tejido y módulo, las puntuaciones agudas y de alta se emparejaron por sujeto y grupo viral. Se calculó la diferencia entre aguda y de alta para cada par. El coeficiente dz de Cohen se calculó como la media de las diferencias emparejadas dividida por su desviación estándar muestral. Se presentaron pruebas t emparejadas bilaterales y pruebas de rangos con signo de Wilcoxon bilaterales, junto con el área bajo la curva ROC (AUROC) para la separación de las puntuaciones aguda y de alta. Se calcularon los valores FDR de Benjamini–Hochberg en las 20 pruebas t emparejadas válidas en la salida longitudinal completa (dos conjuntos de datos, dos fuentes de módulos y cinco resúmenes preespecificados por grupo viral).
Análisis del gradiente de síntomas y análisis post hoc
Después de que se fijó la pertenencia a los módulos, las detecciones de picornavirus asintomáticas retenidas en GSE117827 se utilizaron únicamente para el análisis del gradiente de síntomas. La puntuación clínica ordinal fue 0 para los controles negativos al virus, 1 para las detecciones asintomáticas de picornavirus y 2 para la infección sintomática. La correlación de Spearman evaluó la tendencia ordinal, mientras que la prueba de Kruskal-Wallis evaluó las diferencias generales entre los tres grupos. Las pruebas post hoc de Mann-Whitney U bilaterales compararon los tres pares de grupos. Se aplicó la corrección de Benjamini-Hochberg por separado dentro de cada compartimento a su familia de tres comparaciones por pares.
Enriquecimiento funcional
Los genes de los módulos nasales y sanguíneos se analizaron con Enrichr mediante gseapy utilizando las bibliotecas MSigDB Hallmark 2020, Reactome 2022 y GO Biological Process 2023.25,26,28,29,30,31. Enrichr utilizó su marco estándar de sobre-representación basado en la prueba exacta de Fisher. Ajuste de Benjamini-Hochberg informado por la biblioteca P valores < 0,05 se consideraron significativos. Los ocho términos más significativos por módulo en las tres bibliotecas consultadas fueron ordenados por valor de ajuste P valor. Los resultados de enriquecimiento se utilizaron únicamente para interpretación.
Análisis de robustez, programa de marcadores y varianza
Los análisis de robustez evaluaron si los resultados dependían del tamaño del módulo o de la selección aleatoria. Se evaluaron tamaños de módulos de 10, 25, 50, 100 y 200 genes. Para el análisis nulo de genes aleatorios, el universo elegible comprendió los genes codificadores de proteínas HGNC representados en la matriz GSE117827 procesada. Se seleccionaron quinientos conjuntos de 50 genes sin reemplazo, utilizando una semilla aleatoria de NumPy de 20260622. La reselección bootstrap se limitó a los 1.000 genes codificadores de proteínas con efecto positivo clasificados más alto en el análisis original de anclaje para cada compartimento. En cada remuestreo, los genes codificadores de proteínas positivos se ordenaron por valor P de Welch bilateral ascendente y luego por diferencia media descendente. Se seleccionaron los 50 genes superiores. La estabilidad génica se calculó como el número de selecciones dividido por 100. Se mostraron los 20 genes con la frecuencia de selección más alta en cada compartimento.
Las puntuaciones de los programas marcadores se utilizaron como herramientas descriptivas en lugar de estimaciones de fracción celular. Se evaluaron seis programas curados: epitelial (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), monocito/macrófago (LYZ, LST1, S100A8, S100A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), neutrófilo (S100A8, S100A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/plasmocito (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1), e interferón mieloide (SIGLEC1, IFI27, IFI44L, ISG15, MX1, OAS1, RSAD2, IFIT3). Cada puntuación de programa se calculó como la media de las puntuaciones z por gen disponibles, requiriéndose al menos tres genes representados. Los valores P de Spearman se ajustaron utilizando el procedimiento de Benjamini–Hochberg en toda la familia de correlaciones entre conjunto de datos, módulo y programa. Se calculó eta al cuadrado unidireccional como la suma de cuadrados entre grupos dividida por la suma total de cuadrados para cada par módulo-factor. Las filas que carecían del factor relevante se excluyeron de ese cálculo. Este análisis fue descriptivo y no realizó ajustes por factores mutuamente correlacionados.
Reproducibilidad
Todos los análisis se realizaron utilizando flujos de trabajo por script en Python 3.12.13, con los paquetes de software y versiones indicados en la Tabla de materiales. Los procedimientos aleatorizados utilizaron una semilla fija de 20260622. Las matrices de expresión públicas de GEO se procesaron utilizando una estructura de proyecto consistente que separaba las entradas crudas, los datos procesados, los resultados estadísticos, las tablas y las figuras. Se conservaron las definiciones de módulos, los registros de curación de muestras, las estimaciones del tamaño del efecto, las estadísticas de validación, los resultados de enriquecimiento, los análisis de robustez y los datos fuente de las figuras para facilitar la verificación independiente. El código de análisis, las especificaciones de dependencias y los datos derivados de apoyo están disponibles según se describe en la declaración de disponibilidad de datos.
Resultados
La evaluación por etapa de anclaje separó los efectos génicos específicos de tejido de los efectos génicos pan-tejido
La matriz de anclaje curada GSE117827 contenía 27.685 genes aprobados por HGNC. El contraste principal nasal incluyó 15 muestras de individuos infectados sintomáticos y 6 muestras de control negativas al virus; el contraste sanguíneo incluyó 13 muestras de individuos infectados sintomáticos y 6 controles (Tabla 1). Dado que esta pequeña cohorte no puede sustentar un descubrimiento estable a nivel de un solo gen, se utilizó como anclaje por compartimentos apareados. La estabilidad se evaluó a nivel de módulo mediante remuestreo bootstrap, pruebas nulas con genes aleatorios, validación externa y análisis de sensibilidad al tamaño de los módulos.
| Origen | Grupo | Condición | Contraste principal | n |
| Sangre | RSV | Infectado | Sí | 4 |
| Sangre | Picornavirus asintomático | Secundario | No | 5 |
| Sangre | Picornavirus sintomático | Infectado | Sí | 9 |
| Sangre | Control negativo para virus | Control | Sí | 6 |
| Nasal | RSV | Infectado | Sí | 6 |
| Nasal | Picornavirus asintomático | Secundario | No | 5 |
| Nasal | Picornavirus sintomático | Infectado | Sí | 9 |
| Nasal | Control negativo para virus | Control | Sí | 6 |
Tabla 1: Diseño del ancla GSE117827 tras la curación del contraste principal. Distribución de muestras entre los compartimentos sanguíneo y nasal en el conjunto de datos de anclas pareadas tras la curación del contraste principal. Las muestras de virus respiratorio sincitial (VRS) sintomáticas y las de picornavirus sintomáticas se clasificaron como infectadas e incluyeron en el contraste principal, mientras que los controles negativos para virus se clasificaron como controles e incluyeron en el contraste principal. Las muestras de picornavirus asintomáticas se designaron como secundarias y se excluyeron de la construcción del módulo; solo se utilizaron en el análisis exploratorio del gradiente de síntomas. Dos casos de VRS carecían de muestras sanguíneas, lo que resultó en cuatro muestras de VRS en sangre y seis en nasales.
Entre los 27.685 genes compartidos, las estimaciones de Hedges g en nariz y sangre presentaron una correlación casi nula (Pearson r = 0,015; Figura 1). Este resultado se obtuvo dentro de un solo estudio y está menos expuesto a diferencias entre estudios que una comparación agrupada entre cohortes. La densa nube central muestra que la mayoría de los genes no se expresaron de manera similar en ambos compartimentos. Los genes superpuestos resaltados fueron excepciones situadas en la parte superior de ambas listas de clasificación. Este patrón respalda la construcción separada de módulos para nariz y sangre.
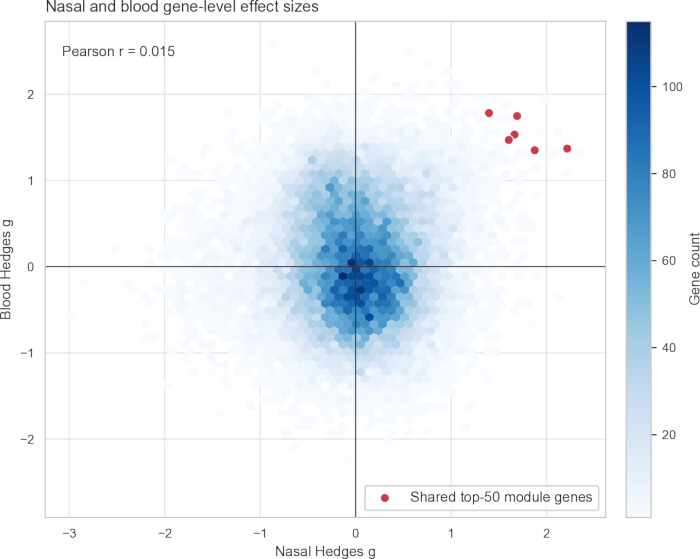
Figura 1. Tamaños del efecto a nivel génico en la nariz y la sangre en la cohorte ancla pareada GSE117827. Los valores de Hedges g comparan la infección sintomática con controles negativos al virus para 27.685 genes. Las estimaciones nasales (15 infectados, 6 controles) se muestran en el eje x, y las estimaciones sanguíneas (13 infectados, 6 controles) en el eje y. El sombreado de los hexágonos indica el número de genes por casilla. Los puntos rojos indican los seis genes compartidos entre los módulos principales 50 de la nariz y la sangre. Pearson r = 0,015. Haga clic aquí para ver una versión más grande de esta figura.
La construcción de módulos produjo una pequeña superposición centrada en interferón
Los 50 módulos principales nasales y sanguíneos compartieron seis genes: ISG15, ACRBP, IFIT1, RSAD2, CCRL2 y XAF1 (índice de Jaccard = 0,064; Tabla 2; Figura 2). ISG15, IFIT1, RSAD2 y XAF1 son compatibles con la biología antiviral relacionada con interferón32,33,34. CCRL2 se interpreta mejor en el contexto de la migración inflamatoria de leucocitos35. ACRBP no tiene un papel antiviral establecido. Se informa sobre los seis genes por transparencia, pero no se afirma que ninguno sea un biomarcador cruzado entre tejidos validado. Sus valores de FDR individuales por gen no fueron significativos en la cohorte ancla pequeña. Por lo tanto, la principal inferencia se basa en la validación a nivel de módulo bloqueado, no en la lista de superposición.
| Gen | Hedges nasal g | FDR nasal | Hedges sanguíneo g | FDR sanguíneo | Interpretación |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.442 | Gen antiviral estimulado por interferón; solapamiento exploratorio |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | Sin función antiviral establecida; retenido por transparencia |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.442 | Gen antiviral estimulado por interferón; solapamiento exploratorio |
| RSAD2 | 1.663 | 0.213 | 1.532 | 0.442 | Gen antiviral estimulado por interferón; solapamiento exploratorio |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.442 | Contexto inflamatorio de migración de leucocitos; no específico de virus |
| XAF1 | 1.603 | 0.226 | 1.47 | 0.442 | Factor de apoptosis vinculado a interferón; solapamiento exploratorio |
Tabla 2: Solapamiento exploratorio completo entre los módulos nasales y sanguíneos mejor clasificados. Los seis genes compartidos se presentan junto con los valores de Hedges g nasales y sanguíneos y los valores de FDR por gen. Los seis genes se consideran candidatos exploratorios de solapamiento por rango porque los valores de FDR por gen no fueron significativos en la pequeña cohorte de referencia. Se incluye ACRBP por transparencia, a pesar de carecer de un papel antiviral establecido. Ninguno de los seis genes se presenta como un biomarcador universal validado; la evidencia principal se basa en la validación externa a nivel de módulo.
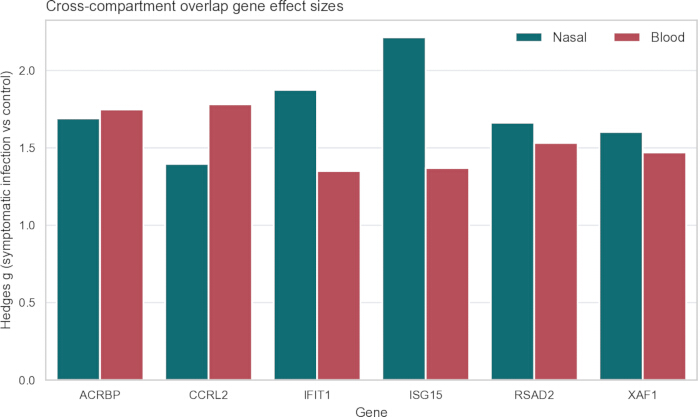
Figura 2. Tamaños del efecto de los seis genes exploratorios de superposición nasal-sanguínea. Vallas nasales y sanguíneas g se muestran estimaciones para ACRBP, CCRL2, IFIT1, ISG15, RSAD2 y XAF1 en GSE117827. Los valores positivos indican una expresión mayor en la infección sintomática que en los controles negativos para el virus. Se muestra la superposición completa por transparencia; los valores de FDR para genes individuales no fueron significativos, y estos genes no se presentan como biomarcadores universales validados. Haga clic aquí para ver una versión más grande de esta figura.
El enriquecimiento funcional proporcionó una verificación biológica del contenido de los módulos
Ambos módulos mostraron enriquecimiento en vías de interferón y antivirales, aunque difirieron en la composición génica y en la intensidad del enriquecimiento (Figura 3). Se muestran los ocho términos más significativos por módulo. Para el módulo nasal, los términos principales incluyeron la respuesta al interferón gamma de Hallmark (valor P ajustado = 2,23 × 10⁻24), la respuesta al interferón alfa de Hallmark (valor P ajustado = 1,40 × 10⁻22), la señalización de interferón alfa/beta de Reactome (valor P ajustado = 3,64 × 10⁻19) y la respuesta de defensa frente al virus de GO (valor P ajustado = 5,47 × 10⁻15). El módulo sanguíneo mostró la misma biología general, pero con menor intensidad de enriquecimiento: respuesta al interferón alfa (valor P ajustado = 3,87 × 10⁻6), señalización de interferón alfa/beta de Reactome (valor P ajustado = 5,70 × 10⁻6), respuesta al interferón gamma (valor P ajustado = 8,89 × 10⁻6) y respuesta de defensa frente al virus (valor P ajustado = 1,07 × 10⁻4). Estos resultados respaldan la coherencia biológica sin implicar una clasificación idéntica de los genes en los compartimentos.
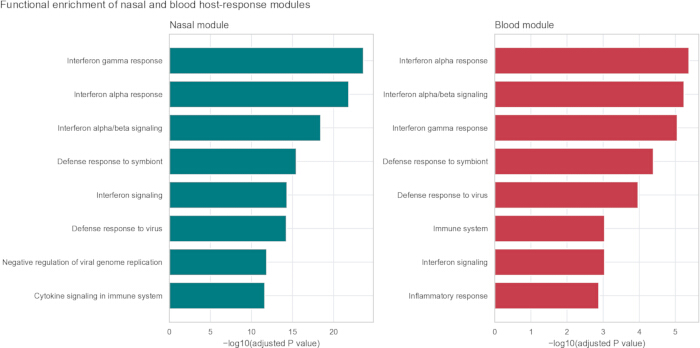
Figura 3. Términos de enriquecimiento seleccionados para los módulos nasales y sanguíneos. Se realizó un análisis de sobre-representación utilizando Enrichr con Hallmark 2020, Reactome 2022 y GO Biological Process 2023. Se muestran los ocho términos con los valores de P ajustados por Benjamini–Hochberg más pequeños para cada módulo. La longitud de las barras representa −log10(valor de P ajustado). Los paneles izquierdo y derecho muestran los módulos nasales y sanguíneos, respectivamente. Los términos se muestran en minúsculas iniciales. El análisis de enriquecimiento no alteró la pertenencia a los módulos. Haga clic aquí para ver una versión más grande de esta figura.
Los módulos bloqueados se probaron en una validación externa con tejidos coincidentes
El módulo nasal bloqueado alcanzó valores de AUCOR de 0,749 en GSE41374, 0,693 en GSE152075 y 0,609 en GSE156063 (Tabla 3; Figura 4). El módulo sanguíneo bloqueado alcanzó valores de AUCOR de 0,832 en GSE171110, 0,924 en la unidad GSE38900 GPL10558 y 0,870 en la unidad GPL6884. No se incluye el rendimiento interno del ancla porque está sesgado optimistamente por diseño. Los AUCOR externos se consideran resúmenes de portabilidad. Estos no establecen la sensibilidad clínica, especificidad ni idoneidad para el diagnóstico.
| Cohorte | Muestra/virus | Módulo | n positivos | n negativos | Genes representados | AUROC | Precisión media | FDR del test de Welch |
| GSE152075 | SARS-CoV-2 vías respiratorias altas | Nasal | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 vías respiratorias altas | Nasal | 93 | 100 | 49 | 0.609 | 0.551 | 1.38 × 10⁻² |
| GSE171110 | SARS-CoV-2 sangre total | Sangre | 44 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE38900-GPL10558 | RSV sangre total | Sangre | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE38900-GPL6884 | RSV sangre total | Sangre | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | RSV lavado nasal | Nasal | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
Tabla 3: Validación externa del puntaje del módulo emparejado con tejido. El módulo nasal bloqueado se probó en GSE41374, GSE152075 y GSE156063, y el módulo sanguíneo bloqueado se evaluó en GSE171110 y en las plataformas GSE38900 GPL10558 y GPL6884. La tabla muestra los números de muestras positivas y negativas, los genes del módulo representados, el área bajo la curva (AUROC), la precisión media y el FDR del test de Welch. No se incluye el rendimiento del ancla interno. El AUROC y la precisión media se presentan como resúmenes de portabilidad y no como estimaciones del rendimiento diagnóstico clínico.
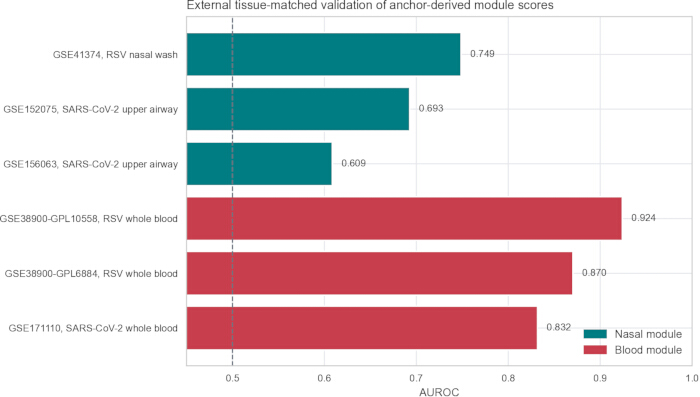
Figura 4. Portabilidad de los puntajes de módulos emparejados por tejido externo. Se muestran los AUROC para el módulo nasal en GSE41374 (76 RSV, 10 controles), GSE152075 (430 SARS-CoV-2, 54 controles) y GSE156063 (93 SARS-CoV-2, 100 controles), y para el módulo sanguíneo en GSE171110 (44 SARS-CoV-2, 10 controles), GSE38900-GPL10558 (28 RSV, 8 controles) y GSE38900-GPL6884 (107 RSV, 31 controles). Los puntajes son medias no ponderadas de los valores z por gen representados. La línea discontinua indica AUROC = 0,5. Los valores son resúmenes de portabilidad, no estimaciones diagnósticas clínicas. Haga clic aquí para ver una versión más grande de esta figura.
La validación longitudinal evaluó si las puntuaciones disminuyen durante la recuperación
Los conjuntos de datos complementarios GSE97741/GSE97742 proporcionaron un entorno de validación independiente mediante infección natural, con muestras agudas y de alta de niños hospitalizados27. Estas muestras no se utilizaron como datos de descubrimiento de controles sanos. Se emplearon para evaluar si las puntuaciones de los módulos derivadas de los anclajes disminuyeron desde la enfermedad aguda hasta el alta.
Para el grupo preespecificado combinado de infección única por VSR y rinovirus, se analizaron 68 sujetos apareados en cada tejido (Tabla 4; Figura 5). El módulo sanguíneo disminuyó desde la enfermedad aguda hasta el alta en sangre (delta medio = 0,330; Cohen dz = 0,740; FDR del test apareado = 1,98 × 10⁻7; AUROC = 0,765). El módulo nasal también disminuyó en las muestras nasofaríngeas (delta medio = 0,436; Cohen dz = 0,477; FDR del test apareado = 3,06 × 10⁻4; AUROC = 0,679). Las trayectorias apareadas y sus errores estándar muestran que la disminución a nivel grupal no fue impulsada por unos pocos valores extremos no apareados.
| Conjunto de datos | Origen de la muestra | Módulo | Tejido coincidente | n pares | Delta medio agudo-de alta | Cohen dz | AUROC | FDR del test pareado |
| GSE97741 | Sangre | Sangre | Sí | 68 | 0.330 | 0.740 | 0.765 | 1.98 × 10⁻⁷ |
| GSE97741 | Sangre | Nasal | No | 68 | 0.479 | 0.721 | 0.755 | 3.19 × 10⁻⁷ |
| GSE97742 | Nasofaríngeo | Sangre | No | 68 | 0.361 | 0.914 | 0.845 | 9.42 × 10⁻¹⁰ |
| GSE97742 | Nasofaríngeo | Nasal | Sí | 68 | 0.436 | 0.477 | 0.679 | 3.06 × 10⁻⁴ |
Tabla 4: Validación longitudinal independiente agudo-frente-a-alta. La tabla muestra el número de pares completos, la diferencia media entre la puntuación aguda y la de alta, el Cohen dz, el AUROC y el FDR del test pareado para los módulos fijos en GSE97741 y GSE97742. Un delta positivo indica una puntuación del módulo más alta durante la enfermedad aguda. Los valores de FDR del test pareado son los valores P ajustados mediante el método de Benjamini–Hochberg del test t pareado bilateral, calculados en los 20 test t pareados válidos del resultado longitudinal completo.
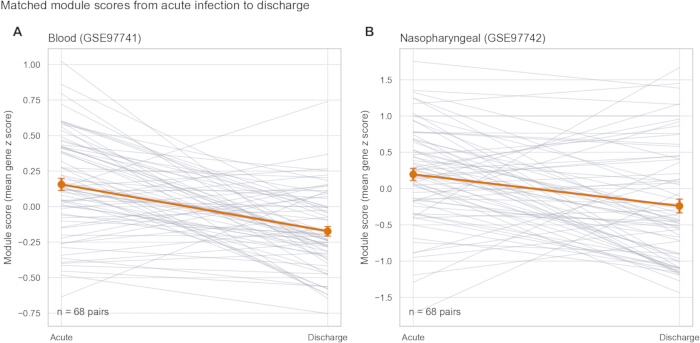
Figura 5. Cambios emparejados en las puntuaciones de los módulos desde la enfermedad aguda hasta el alta. (A) Puntuaciones de los módulos sanguíneos en sangre total (GSE97741). (B) Puntuaciones de los módulos nasales en muestras nasofaríngeas (GSE97742). Cada panel contiene 68 pares completos de sujetos: 38 infecciones simples por VSR y 30 infecciones por rinovirus. Líneas delgadas conectan las mediciones emparejadas por sujeto. Los puntos naranjas indican las medias del grupo, y las barras de error naranjas indican el error estándar de la media. Se realizaron pruebas t pareadas bilaterales y pruebas de rangos con signo de Wilcoxon; se aplicó la corrección FDR de Benjamini–Hochberg en las 20 pruebas t pareadas longitudinales válidas. Haga clic aquí para ver una versión más grande de esta figura.
Las pruebas entre compartimentos revelaron un matiz útil. El módulo sanguíneo aplicado a muestras nasofaríngeas produjo un AUROC de 0,845, aunque los tamaños del efecto individuales en la nariz y la sangre mostraron una concordancia débil en el grupo de referencia. El examen de las trayectorias emparejadas mostró una disminución constante de las puntuaciones, en lugar de una distribución de etiquetas invertida. Por lo tanto, el resultado no constituye evidencia de que los mismos genes individuales dominen en ambos tejidos. Indica que un programa interferónico/inflamatorio coordinado puede resumirse mediante conjuntos de genes diferentes pero parcialmente redundantes. La especificidad del compartimento es más marcada a nivel de clasificación de genes y no es absoluta a nivel de vías o puntuaciones.
Las detecciones asintomáticas excluidas evaluaron el comportamiento del gradiente de síntomas
Las detecciones asintomáticas de picornavirus en GSE117827 se excluyeron de la construcción del módulo para evitar su inclusión en el grupo control principal. Este grupo excluido proporcionó entonces una verificación biológica. En ambos compartimentos, las puntuaciones del módulo aumentaron a través de los grupos ordenados de controles negativos para virus, detección asintomática de picornavirus e infección sintomática (Figura 6A,B).
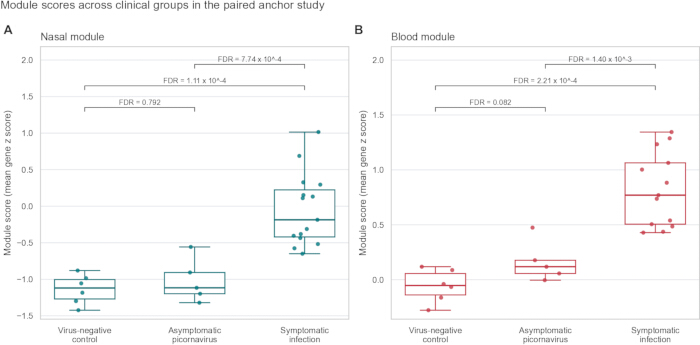
Figura 6. Puntuaciones del módulo a lo largo del gradiente de síntomas excluidos. (A) Módulo nasal: 6 controles negativos para virus, 5 detecciones asintomáticas de picornavirus y 15 infecciones sintomáticas. (B) Módulo sanguíneo: 6 controles negativos para virus, 5 detecciones asintomáticas de picornavirus y 13 infecciones sintomáticas. Los puntos representan muestras individuales. Las líneas centrales indican las medianas; los cuadros abarcan del percentil 25 al 75; y los bigotes se extienden hasta los valores más extremos dentro de 1,5 veces el rango intercuartílico. Las etiquetas muestran comparaciones posteriores de Mann-Whitney U bilaterales con corrección de Benjamini-Hochberg en tres comparaciones por compartimento. Haga clic aquí para ver una versión más grande de esta figura.
El módulo nasal se correlacionó con la puntuación ordinal de los síntomas (rho de Spearman = 0,818, P = 3,28 × 10⁻7; Kruskal-Wallis P = 1,57 × 10⁻4). El módulo sanguíneo mostró un gradiente similar (rho = 0,861, P = 6,89 × 10⁻8; Kruskal-Wallis P = 1,92 × 10⁻4). Tras la corrección dentro de cada familia de tres comparaciones, la infección sintomática difirió de los controles y de las detecciones asintomáticas en ambos compartimentos. Las detecciones asintomáticas no difirieron de los controles negativos al virus (FDR nasal = 0,792; FDR sanguíneo = 0,082). Por lo tanto, los módulos reflejaron con mayor claridad la actividad de la respuesta del huésped sintomática que la detección viral por sí sola.
Los puntos de referencia clínicos definieron el límite entre la respuesta del huésped y la especificidad del patógeno
Los puntos de referencia clínicos definieron la distinción entre la actividad de la respuesta del huésped y la clasificación del patógeno (Tabla 5; Figura 7). En GSE63990, el módulo nasal produjo AUROCs de 0,782 para enfermedad viral frente a bacteriana y de 0,791 para enfermedad viral frente a no infecciosa. El módulo sanguíneo produjo AUROCs de 0,678 y 0,753, respectivamente. El comparador de ARNm de 33 genes de Pandya tuvo un mejor desempeño, con AUROCs de 0,867 y 0,852, respectivamente. Este resultado era esperable en un conjunto diseñado para discriminación entre viral y no viral, y muestra que los módulos ancla no deben presentarse como clasificadores diagnósticos sustitutivos.
| Conjunto de datos | Contraste | Nasal de referencia | Sangre de referencia | Pandya 33 mRNA | ISG de Andres-Terre | Interferón-alfa característico |
| GSE63990 | Viral frente a bacteriano | 0.782 | 0.678 | 0.867 | 0.833 | 0.831 |
| GSE63990 | Viral frente a no infeccioso | 0.791 | 0.753 | 0.852 | 0.851 | 0.848 |
| GSE40012 | Neumonía viral frente a bacteriana | 0.755 | 0.789 | 0.893 | 0.867 | 0.872 |
| GSE40012 | Neumonía viral frente a SIRS | 0.897 | 0.907 | 0.985 | 0.965 | 0.956 |
| GSE40012 | Neumonía viral frente a sano | 0.804 | 0.986 | 0.923 | 0.906 | 0.891 |
| GSE40012 | Neumonía bacteriana frente a sano | 0.476 | 0.917 | 0.465 | 0.391 | 0.378 |
| GSE53543 | PMBC estimulados ex vivo con rinovirus frente a no estimulados | 1 | 0.957 | 1 | 1 | 1 |
Tabla 5: Referencia de AUROC para módulos ancla y conjuntos de respuesta del huésped de referencia. GSE63990 y GSE40012 son cohortes clínicas de sangre completa. GSE53543 es un experimento de perturbación de PBMC ex vivo que involucra a 98 sujetos apareados y se informa por separado de las cohortes clínicas naturales. Los conjuntos de referencia se puntuaron como promedios de genes no ponderados en lugar de como sus clasificadores ponderados originales. Los valores de AUROC se reportan como métricas de referencia y no como estimaciones del desempeño diagnóstico clínico.
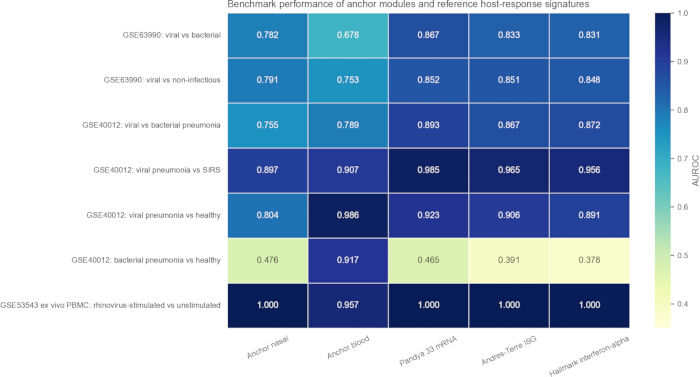
Figura 7. Evaluación de AUROC de los módulos ancla y conjuntos de respuesta del huésped de referencia. Las filas representan contrastes preespecificados en GSE63990, GSE40012 y GSE53543; las columnas representan los dos módulos ancla y tres conjuntos de referencia no ponderados. GSE53543 se etiqueta como PBMC estimulados ex vivo con rinovirus frente a no estimulados y se presenta por separado de los cohortes clínicos naturales. El comparador Hallmark se etiqueta como interferón-alfa de Hallmark. Los valores en las celdas indican AUROC utilizados para la evaluación de métodos y no deben interpretarse como estimaciones del rendimiento diagnóstico clínico. Haga clic aquí para ver una versión más grande de esta figura.
GSE40012 precisó aún más este límite. El comparador Pandya alcanzó valores de AUROC de 0,893 para neumonía viral frente a neumonía bacteriana y de 0,985 para neumonía viral frente a SIRS. El módulo sanguíneo diferenció la neumonía por influenza A de los controles sanos (AUROC = 0,986) y de SIRS (AUROC = 0,907), pero también separó la neumonía bacteriana de los controles sanos (AUROC = 0,917). Por lo tanto, el módulo sanguíneo mide una actividad inflamatoria sistémica generalizada y asociada a interferón. No es específico de virus, y una puntuación alta no puede asignar la clase de patógeno.
En el conjunto de referencia ex vivo de PBMC GSE53543 independiente, el módulo nasal y los comparadores de interferón alcanzaron un AUROC de 1.000 para los PBMC estimulados con rinovirus frente a los PBMC con medio únicamente; el módulo sanguíneo alcanzó un AUROC de 0.957. Los 98 sujetos contribuyeron con condiciones apareadas. Este resultado controlado respalda la respuesta de los programas puntuados a la estimulación con rinovirus. No estima el rendimiento diagnóstico clínico.
Las pruebas de robustez evaluaron el tamaño del módulo, alternativas aleatorias y estabilidad de la selección
La separación de los anclajes permaneció sin cambios a través de los 10, 25, 50, 100 y 200 genes mejor clasificados (Figura 8A). Estas AUROC internas no constituyen una validación externa, pero indican que el resultado cualitativo no dependió de elegir exactamente 50 genes. En 500 conjuntos aleatorios de 50 genes, las medianas de AUROC bajo la hipótesis nula fueron 0.489 para la muestra nasal y 0.705 para la sanguínea; los percentiles 99 correspondientes fueron 0.722 y 0.872 (Figura 8B). Los módulos observados superaron estas distribuciones nulas. Las frecuencias de selección mediante bootstrap se distribuyeron de forma dispersa, en lugar de concentrarse en una única lista invariable (Figura 8C). Este hallazgo refleja directamente el pequeño tamaño de la muestra de anclaje. Apoya la existencia de una señal agregada estable, aunque advierte contra considerar cada gen seleccionado como fijo.
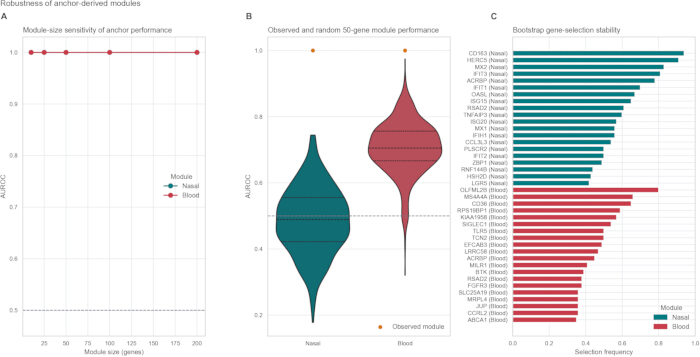
Figura 8. Análisis de robustez según tamaño del módulo, genes aleatorios y bootstrap. (A) AUROC del ancla en módulos de tamaño 10, 25, 50, 100 y 200 genes; estos valores representan verificaciones internas de sensibilidad. (B) Distribuciones de AUROC a partir de 500 conjuntos aleatorios de 50 genes codificadores de proteínas, seleccionados sin reemplazo entre los genes representados en GSE117827 (semilla = 20260622). Los puntos naranjas indican los AUROC observados de los módulos. Las líneas horizontales dentro de cada violín indican el percentil 25, la mediana y el percentil 75. (C) La reselección mediante bootstrap se limitó a los 1.000 genes codificadores de proteínas con efecto positivo mejor clasificados en el análisis original del ancla para cada compartimento. Las barras muestran los 20 genes con mayor frecuencia de selección por compartimento; la frecuencia de selección se calculó como el número de selecciones dividido por 100. Haga clic aquí para ver una versión más grande de esta figura.
Los análisis de programas marcadores y de varianza aclararon qué miden las puntuaciones
En los conjuntos GSE40012, GSE53543 y GSE63990, ambos módulos se correlacionaron de manera más consistente con el programa de interferón mieloide (Figura 9A). Las correlaciones del módulo nasal fueron 0.812, 0.878 y 0.882; las correlaciones del módulo sanguíneo fueron 0.517, 0.843 y 0.774. La partición de la varianza fue descriptiva (Tabla 6; Figura 9B). Para el módulo sanguíneo, la condición y el grupo detallado explicaron más varianza (eta al cuadrado = 0.282 y 0.250, respectivamente) que el conjunto de datos (0.066), el tipo de muestra (0.026) o el grupo de origen (0.025). Para el módulo nasal, el grupo detallado y la condición también explicaron más varianza que el conjunto de datos, el tipo de muestra o el grupo de origen. Por lo tanto, la condición biológica y el grupo detallado representaron fracciones mayores de la varianza de las puntuaciones del módulo que el conjunto de datos o el tipo de muestra, aunque los efectos no nulos del conjunto de datos y de la composición siguen siendo una limitación del reuso masivo de datos públicos.
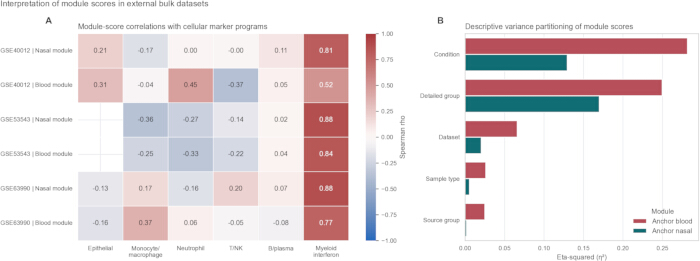
Figura 9. Correlaciones entre marcadores y programas, y partición descriptiva de la varianza. (A) Correlaciones de Spearman entre las puntuaciones de módulos y las puntuaciones de seis programas de marcadores en GSE40012, GSE53543 y GSE63990. Los programas requerían al menos tres genes representados. Los valores de P se ajustaron en todas las correlaciones entre conjunto de datos, módulo y programa. Las celdas vacías indican combinaciones no disponibles o no estimables tras cumplir los requisitos de genes y muestras. (B) Eta al cuadrado unidireccional (η2; suma de cuadrados entre grupos / suma total de cuadrados) para la condición, grupo detallado, conjunto de datos, tipo de muestra y grupo de origen. El análisis incluyó 934 puntuaciones de módulos sanguíneos y 1.469 puntuaciones de módulos nasales, y es descriptivo, no causal. Haga clic aquí para ver una versión más grande de esta figura.
| Módulo | Factor | Eta al cuadrado | n muestras |
| Sangre de referencia | Condición | 0.282 | 934 |
| Sangre de referencia | Grupo detallado | 0.25 | 934 |
| Sangre de referencia | Conjunto de datos | 0.066 | 934 |
| Sangre de referencia | Tipo de muestra | 0.026 | 934 |
| Sangre de referencia | Grupo de origen | 0.025 | 934 |
| Nasal de referencia | Grupo detallado | 0.17 | 1469 |
| Nasal de referencia | Condición | 0.13 | 1469 |
| Nasal de referencia | Conjunto de datos | 0.021 | 1469 |
| Nasal de referencia | Tipo de muestra | 0.006 | 1469 |
| Nasal de referencia | Grupo de origen | 0.002 | 1469 |
Tabla 6: Partición descriptiva de la varianza de las puntuaciones de los módulos. Se incluye una fila para cada par módulo-factor, con el valor correspondiente de eta al cuadrado y el tamaño de la muestra. El eta al cuadrado se calculó como la suma de cuadrados entre grupos dividida por la suma total de cuadrados tras excluir las filas con puntuaciones de módulo o factor faltantes. Los factores se evaluaron individualmente; por lo tanto, el análisis es descriptivo, no ajusta por factores mutuamente correlacionados y no debe interpretarse de forma causal.
Disponibilidad de datos:
Todos los conjuntos de datos transcriptómicos analizados en este estudio están disponibles públicamente en el Gene Expression Omnibus bajo los números de acceso GSE117827, GSE41374, GSE152075, GSE156063, GSE171110, GSE38900, GSE97741, GSE97742, GSE63990, GSE40012 y GSE53543. Los datos derivados del análisis que sustentan las figuras y tablas principales, así como el código de análisis, están disponibles a solicitud razonable al autor correspondiente. En este estudio no se utilizaron datos a nivel de participantes restringidos ni recién generados.
Discusión
La lección principal es operativa: comience con el compartimento muestreado, no con la matriz agrupada más grande. GSE117827 es pequeño, pero su diseño pareado permite una comparación directa entre nariz y sangre dentro de un mismo estudio. La correlación casi nula del efecto a nivel génico muestra que una lista de rangos pan-tisular agrupada ocultaría una estructura compartimental considerable. Por lo tanto, los módulos separados representaron un diseño más justificable. Su rendimiento externo y longitudinal respalda una actividad de respuesta del huésped reproducible a nivel de módulo, no una lista universal de genes.
La portabilidad a nivel de gen y a nivel de módulo es diferente. El módulo sanguíneo funcionó bien en muestras longitudinales de nasofaringe (AUROC 0,845), a pesar de la débil concordancia entre los tamaños de efecto individuales nasales y sanguíneos. Las trayectorias emparejadas no mostraron inversión de etiquetas. Una explicación más probable es la redundancia de vías: la actividad interferónica e inflamatoria coordinada puede resumirse mediante diferentes subconjuntos de genes en diferentes compartimentos6,7,8,9,10,11,32,33,34. Por ello, describimos los módulos como dependientes del compartimento, en lugar de exclusivos del compartimento. Los rangos exactos difieren, pero un componente compartido a nivel de vía permanece detectable. Los perfiles masivos también mezclan cambios en la expresión con cambios en la composición celular. Las correlaciones entre marcadores y programas pueden señalar este problema, pero no pueden proporcionar mecanismos resueltos a nivel celular36,37.
Los puntos de referencia clínicos definen un segundo límite. Los comparadores de 33 ARNm de Pandya y del interferón fueron más eficaces para la discriminación entre infecciones virales y bacterianas. Los módulos de referencia responden a una pregunta diferente: ¿con qué intensidad expresa una muestra un programa de respuesta aguda del huésped? El módulo sanguíneo también aumentó en la neumonía bacteriana. Por lo tanto, debe interpretarse como una puntuación general de actividad inflamatoria sistémica/interferónica, y no como un clasificador específico de virus. Una puntuación alta puede apoyar la comparación entre cohortes, el seguimiento de la respuesta o la descripción del estado inflamatorio, pero no puede identificar el patógeno. La creciente importancia clínica de virus como el metapneumovirus humano refuerza aún más la necesidad de una validación diversa en cuanto a patógenos y adecuada al tejido, en lugar de extrapolar a partir de un conjunto limitado de virus12,13.
Los seis genes superpuestos son exploratorios. ISG15, IFIT1, RSAD2 y XAF1 tienen funciones vinculadas plausiblemente a interferón32,33,34; CCRL2 está asociado con la migración de leucocitos inflamatorios35; ACRBP no tiene una interpretación antiviral establecida. El pequeño tamaño de la cohorte y los valores FDR no significativos para cada gen impiden afirmaciones más contundentes. La innovación metodológica radica en otro aspecto: un ancla emparejada dentro del mismo estudio, módulos específicos de compartimentos fijos, pruebas externas con tejidos emparejados, análisis de recuperación emparejado, comparación con parámetros clínicos de referencia, y verificaciones explícitas de aleatoriedad, tamaño, remuestreo, marcadores y varianza. Esta jerarquía de evidencia proporciona un marco conservador para interpretar los resultados.
Aún quedan varias limitaciones. La cohorte de referencia contiene solo 15 muestras nasales infectadas y 6 controles, así como 13 muestras sanguíneas infectadas y 6 controles. Los resultados del análisis de arranque (bootstrap) confirman que la pertenencia individual de los genes no es completamente estable. Se combinaron los casos sintomáticos de VSR y picornavirus, por lo que los efectos del anclaje no son específicos de un virus. Las cohortes externas difieren en edad, plataforma, gravedad, momento de la toma de muestras y definición de los controles. GSE53543 es un estudio de perturbación apareado ex vivo. GSE63990 y GSE40012 proporcionan comparadores clínicos útiles, pero no incluyen muestreo apareado de nasofaringe y sangre. La carga viral, la duración de los síntomas, la necesidad de oxígeno y la gravedad no estuvieron disponibles de forma consistente. Un diseño prospectivo más robusto recolectaría hisopados nasales y muestras sanguíneas de los mismos participantes en puntos temporales coincidentes, con mediciones de carga viral y síntomas, comparadores bacterianos y virus negativos sintomáticos, y validación con resolución a nivel celular11,14,36,37.
En conclusión, los transcriptomas públicos actuales respaldan módulos reproducibles de actividad de la respuesta del huésped en tejidos nasales y sanguíneos cuando se conserva el contexto tisular. No respaldan una firma génica pan-tisular intercambiable. El anclaje emparejado mostró poca concordancia a nivel génico, mientras que las puntuaciones de módulo bloqueado se transfirieron dentro de tejidos coincidentes y disminuyeron durante la recuperación. La respuesta del módulo sanguíneo en neumonía bacteriana y el mejor desempeño del clasificador establecido para distinguir virus de bacterias definen su uso previsto: estos módulos describen la actividad de la respuesta del huésped y permiten la comparación transparente de cohortes; no son clasificadores independientes de patógenos. El código de análisis y los datos derivados están disponibles según se describe en la declaración de disponibilidad de datos, para facilitar la verificación independiente y la reutilización del flujo de trabajo.
Divulgaciones
Los autores declaran no tener conflictos de intereses financieros ni no financieros relacionados con este trabajo.
Agradecimientos
Los autores agradecen a los investigadores y participantes de los estudios públicos de GEO reanalizados en este trabajo. Ninguna persona adicional cumplió con los criterios para la autoría. Esta investigación no recibió ninguna subvención específica de ninguna agencia financiadora en los sectores público, comercial o sin fines de lucro.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Conjunto de genes estimulados por interferón multipatógeno de Andres-Terre | Andres-Terre et al. | Comparador de 33 genes; Datos Suplementarios 1 | Comparador orientado al interferón sin ponderar, curado a partir de la firma multipatógeno reportada; la lista completa de genes se proporciona en los Datos Suplementarios 1. |
| Enrichr | Laboratorio Ma'ayan | Accedido el 18 de agosto de 2026; RRID:SCR_001575 | Recurso de sobre-representación de conjuntos de genes al que se accedió mediante gseapy. |
| Gene Expression Omnibus | Centro Nacional de Información Biotecnológica | GEO; RRID:SCR_005012 | Repositorio público de transcriptomas utilizado para acceder a los conjuntos de datos analizados. |
| Gene Ontology | Consortium de Gene Ontology | Proceso Biológico GO 2023; RRID:SCR_002811 | Biblioteca de anotación funcional utilizada a través de Enrichr. |
| GPL10558 | NCBI GEO | GPL10558 | Plataforma para GSE53543 y la unidad de validación GSE38900 de 36 muestras. |
| GPL23126 | NCBI GEO | GPL23126 | Plataforma de expresión para GSE117827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Anotación Clariom D Humano na36, hg38 utilizada para la asignación de grupos de transcritos en GSE117827. |
| GPL571 | NCBI GEO | GPL571 | Anotación de plataforma aplicada a GSE63990. |
| GPL6884 | NCBI GEO | GPL6884 | Plataforma para la unidad de validación de sangre completa de 138 muestras de GSE38900 frente al VSR. |
| GPL6947 | NCBI GEO | GPL6947 | Anotación de plataforma aplicada a GSE40012. |
| GSE117827 | NCBI GEO | GSE117827 | Conjunto de datos principal ancla de hisopado nasal y sangre completa emparejados. |
| GSE152075 | NCBI GEO | GSE152075 | Conjunto de datos externo de validación de vías respiratorias superiores frente al SARS-CoV-2. |
| GSE156063 | NCBI GEO | GSE156063 | Conjunto de datos externo de validación de vías respiratorias superiores frente al SARS-CoV-2. |
| GSE171110 | NCBI GEO | GSE171110 | Conjunto de datos externo de validación de sangre completa frente al SARS-CoV-2. |
| GSE38900 | NCBI GEO | GSE38900; GPL10558 y GPL6884 | Validación externa de sangre completa frente al VSR analizada como unidades de plataforma de 36 y 138 muestras normalizadas por separado. |
| GSE40012 | NCBI GEO | GSE40012 | Referencia clínica de neumonía por influenza A, neumonía bacteriana, SIRS y controles sanos. |
| GSE41374 | NCBI GEO | GSE41374 | Conjunto de datos externo de validación de lavado nasal frente al VSR. |
| GSE53543 | NCBI GEO | GSE53543 | Referencia de perturbación ex vivo de PBMC con rinovirus emparejada, que incluye 98 sujetos y 196 muestras. |
| GSE63990 | NCBI GEO | GSE63990 | Referencia clínica de sangre completa frente a infecciones virales, bacterianas y no infecciosas. |
| GSE97741 | NCBI GEO | GSE97741 | Conjunto de datos de validación longitudinal de sangre completa aguda frente al alta. |
| GSE97742 | NCBI GEO | GSE97742 | Conjunto de datos de validación longitudinal de nasofaringe aguda frente al alta. |
| gseapy | Desarrolladores de gseapy | Versión 1.3.1 | Interfaz de Python utilizada para consultar Enrichr. |
| Recurso de símbolos génicos HGNC | Comité de Nomenclatura Genética HUGO | Accedido el 18 de agosto de 2026; RRID:SCR_002827 | Recurso de normalización de símbolos génicos aprobados y clasificación de codificación proteica. |
| Matplotlib | Equipo de desarrollo de Matplotlib | Versión 3.11.1 | Generación de figuras. |
| Conjuntos de genes MSigDB Hallmark | Instituto Broad | Hallmark 2020; RRID:SCR_016863 | Biblioteca de enriquecimiento Hallmark a la que se accedió a través de Enrichr. |
| Conjunto de genes de respuesta al interferón-alfa MSigDB Hallmark | Instituto Broad | HALLMARK_INTERFERON_ALPHA_ RESPONSE; subconjunto principal de 33 genes en Datos Suplementarios 1 | Comparador sin ponderar de interferón-alfa; el subconjunto exacto se proporciona en Datos Suplementarios 1. |
| NumPy | Desarrolladores de NumPy | Versión 2.5.2 | Cálculo numérico y muestreo aleatorio con semilla. |
| pandas | Equipo de desarrollo de pandas | Versión 3.0.5 | Procesamiento de datos tabulares. |
| Conjunto de 33 ARNm de respuesta del huésped de Pandya | Pandya et al. | Tabla Suplementaria 1; Datos Suplementarios 1 | Conjunto oficial de 33 genes puntuado como comparador sin ponderar. |
| Python | Fundación Python Software | Versión 3.12.13 | Entorno de análisis computacional. |
| Reactome | Reactome | Reactome 2022; RRID:SCR_003485 | Biblioteca de enriquecimiento de vías a la que se accedió a través de Enrichr. |
| scikit-learn | Desarrolladores de scikit-learn | Versión 1.9.0 | Cálculos de AUROC y precisión media. |
| SciPy | Desarrolladores de SciPy | Versión 1.18.0 | Pruebas de Welch, t pareada, Wilcoxon, Mann–Whitney y correlación. |
| Seaborn | Equipo de desarrollo de Seaborn | Versión 0.13.2 | Gráficos estadísticos. |
| statsmodels | Desarrolladores de statsmodels | Versión 0.14.6 | Utilidades estadísticas. |
Referencias
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.