Este trabajo de investigación presentó un enfoque, FusionNetX, mediante el enriquecimiento de la capacidad de fusión de características de DenseNet121 y EfficientNetB7 para la clasificación de tumores cerebrales en cinco conjuntos de datos disponibles públicamente, con aumento de datos, preprocesamiento y personalización del modelo híbrido (fusión intermedia), logrando resultados que oscilan entre 98,77 % y 99,89 %, superando a otros métodos en múltiples parámetros de evaluación.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de método
FusionNetX: Un modelo de fusión de características profundas que aprovecha la RM y el aprendizaje profundo para la detección mejorada de tumores cerebrales
En este artículo
Resumen
Resumen
Los tumores cerebrales se consideran una de las enfermedades más mortales del mundo, y su diagnóstico erróneo pone en peligro la vida de los pacientes y reduce la tasa de supervivencia. La resonancia magnética (MRI) junto con técnicas basadas en aprendizaje profundo, especialmente redes neuronales convolucionales, es fundamental para superar este obstáculo, ya que permite un examen más detallado de la estructura interna del cerebro y ofrece capacidades sobresalientes de aprendizaje y predicción. La necesidad de un diagnóstico preciso del tumor en el cerebro sigue siendo significativa. Por lo tanto, se propone un modelo mejorado de aprendizaje profundo basado en fusión de características (FusionNetX) que aprovecha las fortalezas de dos modelos preentrenados, DenseNet121 y EfficientNetB7, mediante hiperparámetros de ajuste fino personalizados, que incluyen capas entrenables y no entrenables. El modelo propuesto FusionNetX se aplicó a cinco conjuntos de datos de tumores cerebrales disponibles públicamente: Br35H, Figshare, Sartaj, Masoud y Balanced Brain Tumor. Se aplicaron algunos pasos de preprocesamiento para mejorar la calidad de las imágenes y abordar el sobreajuste mediante el redimensionamiento y la ampliación de datos. Utilizando diversas métricas de evaluación del rendimiento, como precisión, pérdida, valor predictivo positivo, valor predictivo negativo, tasa de verdaderos positivos, tasa de verdaderos negativos, puntuación F1, tasa de falsos negativos y tasa de falsos positivos, se encontró que el modelo propuesto FusionNetX alcanzó una precisión del 99,33 % para Br35H, del 99,13 % para Figshare, del 99,89 % para Masoud, del 99,19 % para BBT-Dataset y del 98,77 % para Sartaj. Además, los cinco conjuntos de datos de tumores cerebrales se evaluaron mediante fusión tardía y fusión basada en atención para demostrar la importancia del modelo propuesto FusionNetX, y los resultados fueron sustancialmente mejores, con mejoras del 0,3 % al 1,9 % en todos los conjuntos de datos. Asimismo, se calculó la curva de característica operativa del receptor, y los resultados de diversas métricas de evaluación del rendimiento indican que el modelo propuesto FusionNetX puede detectar y predecir con precisión tumores cerebrales y ayudar a los profesionales de la salud a tomar decisiones oportunas.
Introducción
El cáncer es la enfermedad más mortal en el cuerpo humano en la actualidad debido a su gravedad y tasa de crecimiento, mientras que múltiples enfermedades cancerosas, como tumores cerebrales, cáncer de mama, nódulos pulmonares, cáncer de riñón y otras, se encuentran en el cuerpo humano, provocando un aumento en la tasa de mortalidad. El cáncer se desarrolla cuando las células o tejidos del cuerpo de una persona se multiplican de manera anormal. Cuando el cáncer metastatiza, puede dañar otros órganos humanos y volverse más peligroso1. Dado que el cerebro controla todas las funciones corporales, cualquier daño en él puede tener consecuencias de gran alcance para todo el organismo. Por eso los tumores cerebrales o el cáncer son tan letales para los seres humanos2. Además, los tumores cerebrales se dividen en dos categorías principales: benignos y malignos. «Benigno» significa básicamente no canceroso; es simplemente un problema en el cerebro que puede corregirse modificando el entorno. Pero en el caso de la malignidad, se considera peligroso debido a su naturaleza metastásica, que permite que células o tejidos anormales se desplacen hacia otras partes del cuerpo o desde ellas, afectando también a otros órganos y aumentando así la probabilidad de cáncer en el organismo3.
Además, según la Asociación Estadounidense de Tumores Cerebrales y la Organización Mundial de la Salud (OMS), los tumores hipofisarios, los meningiomas y los gliomas son las tres categorías principales de cánceres cerebrales4. Los gliomas se originan a partir de células gliales, que nutren a las neuronas en el cerebro. Los tumores hipofisarios comienzan en la glándula pituitaria, situada en la base del cerebro y responsable de diversas funciones corporales; por otro lado, los tumores meningioma se originan en las meninges, que protegen las membranas que rodean el cerebro y la médula espinal. Asimismo, se utilizan comúnmente múltiples modalidades de imágenes médicas para examinar las partes internas del cuerpo con fines diagnósticos, incluyendo rayos X, tomografías computarizadas (TC) e imágenes por resonancia magnética (IRM)5,6. Cada modalidad de imagen tiene sus propias ventajas y desventajas. La IRM es una modalidad de imagen que proporciona imágenes detalladas de los tejidos blandos y células del cuerpo, especialmente en el cerebro. El cáncer implica tejidos o células anormales en el cuerpo, y la IRM ofrece imágenes detalladas de estas anomalías, lo que la convierte en una modalidad de imagen más útil para diagnosticar tumores cerebrales o cáncer. Además, la IRM es más segura que otras modalidades de imagen porque no produce radiación dañina durante los exámenes de la anatomía interna del cuerpo.
Además, muchas metodologías computacionales también se emplean para abordar los desafíos diagnósticos asociados con los tumores cerebrales, incluyendo el aprendizaje automático (ML), el procesamiento de imágenes (IP) y el aprendizaje profundo (DL), y cada enfoque se aplica a imágenes obtenidas mediante modalidades de imagen para diagnosticar el cáncer7. Estos enfoques aprenden los patrones y estructuras ocultos de diferentes objetos en las imágenes para diagnosticar el cáncer mediante la identificación de patrones en la región afectada. Cada enfoque computacional tiene sus propias ventajas y desventajas en el proceso de diagnóstico. Los enfoques basados en ML e IP extraen características elaboradas manualmente, lo que en su mayoría conduce a predicciones inexactas y errores de diagnóstico, especialmente en conjuntos de datos más grandes8. Para superar los problemas relacionados con la extracción de características elaboradas manualmente, las personas están migrando hacia modelos basados en aprendizaje profundo, comúnmente denominados modelos basados en redes neuronales convolucionales (CNN), que aprenden y extraen automáticamente las mejores características de las imágenes para diagnosticar con precisión los tumores. Los enfoques basados en DL ahora se utilizan comúnmente en imágenes médicas para diagnosticar enfermedades en el cuerpo humano, especialmente para la detección temprana y precisa de tumores cerebrales, cáncer de mama, cáncer de pulmón y otras enfermedades, debido a su capacidad para aprender y extraer patrones complejos en datos a gran escala, produciendo resultados más precisos9. El principal problema que enfrenta un modelo de DL es el consumo elevado de recursos y el muestreo de datos, lo cual se supera mediante otro enfoque basado en aprendizaje profundo denominado aprendizaje por transferencia10 (TL), en el que se utilizan modelos previamente entrenados para diagnosticar la enfermedad, ahorrando tiempo y recursos. El diagnóstico temprano y preciso de problemas de salud es posible gracias a modelos previamente entrenados, que ya han aprendido características básicas relacionadas con la textura, el color, los bordes y otros aspectos a partir de un conjunto de datos amplio. Estos modelos pueden transferirse luego a un nuevo conjunto de datos nunca antes visto, aprovechando el modelo y añadiendo hiperparámetros, así como capas entrenables y no entrenables11. Se ha realizado una cantidad significativa de investigación sobre la clasificación de tumores cerebrales, y Tabla 112,13,14,15,16,17,18,19,20,21,22,23 presenta los detalles de esta investigación, incluyendo los enfoques, conjuntos de datos y resultados. Sin embargo, ninguna investigación ha empleado hasta ahora una metodología que combine dos modelos de aprendizaje por transferencia para una extracción robusta de características y ajuste de técnicas de regularización para garantizar un entrenamiento y prueba fluidos. Una evaluación exhaustiva de la metodología propuesta proporciona información sobre el rendimiento del modelo en diferentes características de tumores cerebrales.
| Ref | Enfoque | Muestras de datos | Resultados | Limitaciones |
| 12 | CNN personalizada | Br35H | Precisión = 97,45%, | Todavía existe la necesidad de mejorar los resultados; en lugar de usar una CNN creada por uno mismo, es mejor utilizar un modelo CNN preexistente con modificaciones. |
| Pérdida = 0,1141%, | ||||
| Recuperación = 98,09%, | ||||
| Puntuación F1 = 97,69%, | ||||
| Precisión = 97,29%, | ||||
| Br35H aumentado | Precisión = 98,99%, | |||
| Precisión = 98,90%, | ||||
| Pérdida = 0,0570%, | ||||
| Recuperación = 98,91%, | ||||
| Puntuación F1 = 99,04% | ||||
| 13 | Modelo DNN de fusión de características | Br35H | Precisión = 98,22%, | Todavía existe la necesidad de mejorar los resultados, y en lugar de usar un modelo personalizado, aún se requiere utilizar un modelo preexistente para la fusión de características. |
| FNR = 1,77%, | ||||
| Sensibilidad = 98,2%, | ||||
| Puntuación F1 = 98%, | ||||
| Especificidad = 98%, | ||||
| Figshare | Precisión = 98,01%, | |||
| Sensibilidad = 96,03%, | ||||
| Puntuación F1 = 96%, | ||||
| Especificidad = 98,67%, | ||||
| FNR = 3,96% | ||||
| 14 | AlexNet con SGD | Br35H | Precisión = 98,79%, | Aún se requieren algunas mejoras en los resultados, y también necesitamos probar modelos más avanzados basados en CNN con diferentes muestras de datos. |
| MCR = 1,20%, | ||||
| Sensibilidad = 98,98%, | ||||
| Especificidad = 98,58%, | ||||
| Puntuación F1 = 98,82% | ||||
| 15 | InceptionV3 | Figshare | Precisión = 98,89%, | Los autores utilizaron el conjunto de datos Figshare, que tiene tres clases de tumores; en lugar de clasificarlos, determinan si existe o no un tumor, y aún se requieren mejoras en los resultados, así como la categorización de las clases de tumores. |
| SensibilidadB = 95,28%, | ||||
| SensibilidadM = 94,47% | ||||
| 16 | ResNet50 optimizada | Figshare | Precisión = 99,03%, | Se necesitan calcular otros parámetros de evaluación del rendimiento, junto con algunas mejoras adicionales en los resultados. |
| Recuperación = 99%, | ||||
| Puntuación F1 = 99% | ||||
| 17 | Res-BRNet | Br35H | Precisión = 98,22%, | Todavía se requiere mejorar los resultados. |
| Sensibilidad = 98,11%, | ||||
| Precisión = 98,22%, | ||||
| Figshare | Puntuación F1 = 98,41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Precisión = 99,18%, | Hay una ligera mejora en los resultados y se necesita probar más conjuntos de datos relacionados con tumores cerebrales. |
| Recuperación = 99,11%, | ||||
| Puntuación F1 = 99,08, | ||||
| Precisión = 99,07%, | ||||
| Sartaj | Precisión = 97,24%, | |||
| Recuperación = 97,58%, | ||||
| Puntuación F1 = 97,28%, | ||||
| Precisión = 97,06%, | ||||
| 19 | CNN-SVM | Brats | Precisión = 98,02%, | Se necesita aplicar algunos modelos preexistentes junto con SVM, y aún se requiere mejorar los resultados. |
| Puntuación F1 = 98,31%, | ||||
| Precisión = 98,09%, | ||||
| Sensibilidad = 98,53%, | ||||
| Especificidad = 97,30%, | ||||
| Sartaj | Precisión = 96,83%, | |||
| Precisión = 95,36%, | ||||
| Sensibilidad = 94,73%, | ||||
| Especificidad = 97,56%, | ||||
| Puntuación F1 = 95% | ||||
| 20 | EfficientNetB3 ajustada finamente | Figshare | Precisión = 98,70% | Se necesita que las variantes mencionadas anteriormente de EfficientNetB3 mejoren los resultados. |
| Sartaj | Precisión = 97,50% | |||
| 21 | InceptionV4 | Masoud | Precisión = 98,7%, | Se requieren algunas mejoras en los resultados utilizando más conjuntos de datos. |
| Precisión = 99%, | ||||
| Sensibilidad = 98%, | ||||
| Especificidad = 99%, | ||||
| Puntuación F1 = 99,1% | ||||
| 22 | VGG16 | Masoud | Precisión = 98% | Se necesitan mejoras en los resultados mediante la evaluación de más modelos de redes neuronales profundas. |
| 23 | MFR-CNN | Masoud | Precisión = 94%, | Es una arquitectura compleja utilizada en esta solución propuesta. |
| Recuperación = 96%, | ||||
| Puntuación F1 = 96%, | ||||
| Precisión = 96%, |
Tabla 1: Un examen comparativo de los trabajos de investigación más recientes. La tabla resume las investigaciones existentes, junto con sus enfoques, muestras de datos, resultados y limitaciones. Haga clic aquí para descargar esta tabla.
Tabla 1 revisa los enfoques existentes, destacando sus limitaciones para mejorar los resultados y la necesidad de utilizar modelos de aprendizaje profundo preexistentes al evaluar su rendimiento frente a diversos parámetros estadísticos, todo dentro de un marco eficiente que obtiene un mejor desempeño en diferentes conjuntos de datos de tumores cerebrales.
Objetivos del estudio y enunciado del problema
La interpretación manual requiere mucho tiempo y presenta variabilidad entre observadores; por lo tanto, la categorización rápida y precisa de tipos de tumores cerebrales a partir de resonancia magnética es fundamental para la toma de decisiones clínicas. La mayoría de los enfoques de aprendizaje profundo para la clasificación automatizada de tumores cerebrales actuales se basan en una única red base o en una fusión simple a nivel de decisión, lo que no aprovecha completamente las representaciones de características complementarias provenientes de múltiples arquitecturas preentrenadas, y a menudo se validan únicamente en un solo conjunto de datos, lo que limita la confianza en su generalización.
Este proyecto de investigación tiene como objetivo desarrollar y proporcionar un método completo y preciso para diagnosticar cánceres cerebrales en cerebros humanos mediante un marco de aprendizaje profundo de doble estructura (EfficientNetB7 y DenseNet121) que aprovecha representaciones de características complementarias para permitir una clasificación robusta de tumores cerebrales a partir de imágenes de resonancia magnética. También evalúa la robustez del marco en múltiples conjuntos de datos públicos e independientes. Este enfoque puede ayudar a radiólogos y paramédicos a diagnosticar tumores cerebrales de forma rápida y eficaz, salvando vidas al permitir el reconocimiento y la clasificación.
Para resolver un problema de investigación específico y alcanzar los objetivos de este proyecto de investigación, a continuación se presentan las preguntas de investigación y la contribución para abordar dichas preguntas: 1) ¿Es la fusión a nivel de características (intermedia) de dos redes troncales previamente entrenadas mejor que las técnicas de fusión a nivel de decisión (tardía) y basadas en atención para la clasificación de tumores cerebrales? 2) ¿Proporcionará el sistema propuesto un rendimiento de clasificación consistente en múltiples conjuntos de datos de resonancias magnéticas de tumores cerebrales adquiridos de forma independiente?
El alcance de este estudio se limita a la clasificación a nivel de imagen (corte de RMN 2D), utilizando cinco conjuntos de datos públicos de resonancias magnéticas de tumores cerebrales (Br35H, Figshare, Sartaj, Masoud y BBT-Dataset); evaluados de forma independiente, sin comparación entre conjuntos de datos; y empleando la arquitectura específica, la tubería de preprocesamiento y la configuración experimental descritas en la sección de metodología. El estudio no incluye validación a nivel de paciente ni pruebas en un entorno clínico de implementación.
Las principales contribuciones de este trabajo de investigación son las siguientes: 1) La contribución principal de este trabajo de investigación consiste en utilizar modelos previamente entrenados duales para una mejor extracción de características, incluyendo DenseNet121 y EfficientNetb7 con hiperparámetros optimizados. 2) Una arquitectura de modelo innovadora con una técnica avanzada de regularización integrada con características concatenadas provenientes de un modelo previamente entrenado dual, para un rendimiento robusto. 3) Se aplicó una estrategia efectiva de aumento de datos para incrementar la diversidad de las muestras de entrenamiento y así aprender características más genéricas y específicas, superando los problemas de sobreajuste. 4) El rendimiento del modelo propuesto se evaluó en cinco conjuntos de datos diferentes y de acceso público sobre tumores cerebrales, centrándose en diversos parámetros estadísticos de evaluación, incluyendo exactitud, tasa de clasificación errónea, precisión, valor predictivo negativo, sensibilidad, especificidad, puntuación F1, tasa de falsos negativos y tasa de falsos positivos.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
La enfermedad más amenazante en el mundo es el tumor cerebral. Un diagnóstico preciso puede beneficiar la supervivencia de los pacientes. Sin embargo, existe la necesidad de un sistema diagnóstico exacto que pueda detectar tumores cerebrales en una etapa temprana. Para abordar este problema, se ha propuesto una técnica más confiable para detectar con precisión tumores cerebrales en sus etapas iniciales, utilizando un mecanismo híbrido de aprendizaje profundo dual con hiperparámetros optimizados y capas ajustadas finamente basadas en los modelos DenseNet121 y EfficientNetB7. El enfoque propuesto toma imágenes de resonancia magnética 2D como entrada y genera una predicción de presencia o ausencia de tumor para el conjunto de datos de clasificación binaria Br35H, y la categorización del tumor para otros cuatro conjuntos de datos de clasificación multiclase. Por lo tanto, esta sección demuestra los pasos principales del enfoque propuesto, desde la recolección de datos hasta la salida final, incluyendo la adquisición de datos, el preprocesamiento de datos, la división de datos, la selección del modelo, la extracción de características, la predicción del tumor y la evaluación del modelo propuesto, como se muestra en Figura 1.
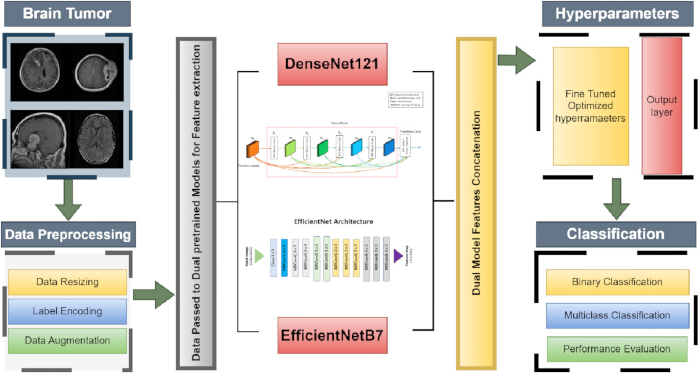
Figura 1: Flujo de trabajo de la metodología propuesta. Este diagrama muestra la arquitectura general del modelo propuesto, incluyendo la adquisición y el preprocesamiento de datos; dos modelos previamente entrenados para la extracción de características; la concatenación de sus características; y el ajuste fino de hiperparámetros para la clasificación y tipo de tumor. Haga clic aquí para ver una versión más grande de esta figura.
Adquisición de datos
En cualquier investigación experimental, el primer paso es la adquisición de datos. Para ello, se han seleccionado cinco conjuntos de datos diferentes disponibles públicamente, incluyendo Br35H24, Figshare25, Sartaj26, Masoud27 y el conjunto de datos basado en imágenes de resonancia magnética de tumores cerebrales de la biblioteca de código abierto Kaggle28, que ya han sido utilizados por muchos investigadores para el diagnóstico de detección de tumores cerebrales. El conjunto de datos Br35H tiene 3.000 imágenes que comprenden dos clases: imágenes de cerebro sanas y no sanas (con tumor), con 1.500 imágenes en cada clase, mientras que el conjunto de datos Figshare comprende 3.064 imágenes, divididas en tres grupos según el tipo de tumor: 1.426 imágenes de glioma, 708 imágenes de meningioma y 930 imágenes de tumores pituitarios. El conjunto de datos Sartaj tiene 3.264 imágenes categorizadas en cuatro clases de tumores: gliomas (926 imágenes), meningiomas (937 imágenes), tumores pituitarios (901 imágenes) y sin tumor o saludables (500 imágenes). Además, el conjunto de datos Masoud también comprende cuatro clases diferentes de tumores, y sus imágenes fueron tomadas de los tres conjuntos de datos anteriormente mencionados, con un total de 7023 imágenes, que se categorizan además en glioma (con 1621 imágenes), meningioma (con 1645 imágenes), pituitario (con 1757 imágenes) y saludable o sin tumor (con 2000 imágenes). El último conjunto de datos seleccionado es un conjunto de datos basado en imágenes de resonancia magnética, que también comprende cuatro clases con un total de 5248 imágenes, que se dividen además en tipos de tumores, incluyendo 1312 imágenes de glioma, 1312 imágenes de meningioma, 1312 imágenes de pituitario y 1312 imágenes de cerebro sano o sin tumor, que ya están divididas equitativamente según los tipos de tumor y se considera un conjunto de datos equilibrado.
Preprocesamiento de datos
Después de la adquisición de datos, el siguiente paso es el preprocesamiento, que es esencial para obtener mejores resultados y resulta más útil para los enfoques computacionales a fin de extraer y aprender las mejores características a partir de los datos, produciendo resultados más precisos. El primer paso aplicado fue el cambio de tamaño de las imágenes. Se seleccionaron cinco conjuntos de datos disponibles públicamente con diferentes clases y tamaños de imagen, incluso dentro del mismo conjunto de datos, para distintas clases de tumores, y todos fueron redimensionados uniformemente a 224 x 224 para mejorar la interpretación y el aprendizaje del modelo. Además, se aplicó aumentación de datos a todos los conjuntos de datos generando muestras adicionales desde diferentes ángulos, mejorando así la extracción de características y el aprendizaje por parte de los modelos de aprendizaje profundo (DL). Para ello, se aplicó un rango de rotación del 7 % a todas las imágenes, rotándolas hasta 7 grados. Asimismo, se aplicó un desplazamiento aleatorio del 5 % a todas las imágenes en sentido horizontal y vertical, con un desplazamiento del 5 % en altura y anchura respecto a las imágenes originales. A continuación, las imágenes se acercaron (zoom) en un 10 % respecto a las imágenes originales, y finalmente, todas las imágenes se voltearon horizontal y verticalmente. La razón principal para realizar la aumentación de datos29 es superar el sobreajuste y mejorar la generalización de los modelos mediante el entrenamiento con diversas versiones transformadas de las muestras de datos originales. Antes de dividir los conjuntos de datos en entrenamiento y validación, se aplicó codificación de etiquetas, lo cual es más útil para calcular la pérdida durante el entrenamiento y la validación, además de hacer que las muestras de datos sean más adecuadas para que los modelos procesen correctamente las etiquetas. Adicionalmente, el conjunto de datos se dividió en conjuntos de entrenamiento y validación, con una proporción del 80 % para entrenamiento y del 20 % para validación30, y Tabla 2 muestra la distribución general de las muestras de datos y sus proporciones de entrenamiento y validación.
| Conjunto de datos | Clases de tumor | Imágenes totales | Imágenes de entrenamiento | Imágenes de validación |
| Br35H | Sano | 1500 | 1200 | 300 |
| Tumor | 1500 | 1200 | 300 | |
| Imágenes totales | 3000 | 2400 | 600 | |
| Figshare | Glioma | 1426 | 1141 | 285 |
| Meningioma | 708 | 566 | 142 | |
| Pituitario | 930 | 744 | 186 | |
| Imágenes totales | 3064 | 2451 | 613 | |
| Sartaj | Glioma | 926 | 741 | 185 |
| Meningioma | 937 | 749 | 188 | |
| Sin tumor | 500 | 400 | 100 | |
| Pituitario | 901 | 721 | 180 | |
| Imágenes totales | 3264 | 2611 | 653 | |
| Masoud | Glioma | 1621 | 1297 | 324 |
| Meningioma | 1645 | 1316 | 329 | |
| Sin tumor | 2000 | 1600 | 400 | |
| Pituitario | 1757 | 1405 | 352 | |
| Imágenes totales | 7023 | 5618 | 1405 | |
| Conjunto de datos equilibrado de tumores cerebrales (BBT-Dataset) | Glioma | 1312 | 1050 | 262 |
| Meningioma | 1312 | 1050 | 262 | |
| Sin tumor | 1312 | 1050 | 262 | |
| Pituitario | 1312 | 1050 | 262 | |
| Imágenes totales | 5248 | 4200 | 1048 |
Tabla 2: Distribución del conjunto de datos. La tabla muestra estadísticas por clase sobre el número total de imágenes, así como las cantidades de imágenes de entrenamiento y validación en los conjuntos de datos de tumores cerebrales..
El conjunto de datos Br35H consta de 3000 imágenes, de las cuales 2400 se seleccionaron para entrenamiento y 600 para validación. El conjunto de datos Figshare comprende 3064 imágenes. De todas las imágenes, 2451 se seleccionaron para entrenamiento y las restantes 613 para validación. El conjunto de datos Sartaj tiene un total de 3264 imágenes, de las cuales 2611 se utilizaron para entrenamiento y las restantes 653 para validación. El conjunto de datos Masoud tiene un total de 7023 imágenes; de estas, 5618 se utilizaron para entrenamiento y las restantes 1405 para validación. El conjunto de datos BBT tiene un total de 5248 imágenes. De todas las imágenes, 4200 se consideraron para fines de entrenamiento, mientras que las otras 1048 imágenes restantes se consideraron para fines de validación. Además, Figura 2 a continuación ilustra las diversas imágenes de tumores cerebrales.
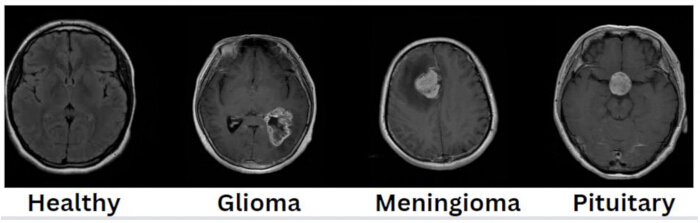
Figura 2: Imágenes de tumores cerebrales, incluyendo tipos de tumores. El conjunto de datos contiene cuatro imágenes de tejido cerebral sano y tres imágenes tumorales: glioma, meningioma e hipófisis. Haga clic aquí para ver una versión más grande de esta figura.
Modelo propuesto
Tras la etapa de preprocesamiento, el siguiente paso consiste en proponer un modelo de entrenamiento eficaz únicamente para la clasificación de tumores cerebrales. Para ello, se ha propuesto un modelo eficiente de entrenamiento, diseñado específicamente para clasificar tumores cerebrales. En este sentido, se presenta un modelo novedoso y eficiente basado en fusión híbrida de características previamente entrenado, que incluye DenseNet12131,32 y EfficientNetB733, los cuales se utilizaron para extraer características de las imágenes; posteriormente, dichas características extraídas se concatenaron y se introdujeron en diferentes hiperparámetros ajustados finamente, incluyendo capas entrenables y no entrenables, con el fin de diagnosticar tumores cerebrales con precisión. Este enfoque se ha implementado en cinco conjuntos de datos diferentes disponibles públicamente, que fueron discutidos en las secciones relacionadas anteriores. Además, el modelo DenseNet121 fue desarrollado por Gao Huang y sus colaboradores en 2017 y consta de 121 capas. El objetivo principal de este modelo fue centrarse en maximizar el reuso de características y evitar el problema del gradiente que desaparece34. Las capas de este modelo están organizadas en bloques densos, cada uno compuesto por múltiples capas convolucionales que extraen y aprenden características. Cada capa toma el mapa de características de todas las capas anteriores como entrada, y su salida se conecta con las salidas de esas capas y se transmite como entrada a las capas siguientes dentro del mismo bloque de manera feed-forward. Además, se añaden capas de transición entre los bloques densos, cada una compuesta por una capa convolucional 1 × 1, una capa de normalización por lotes (BatchNormalization) y capas de agrupamiento promedio (pooling) de 2 × 2, que reducen el mapa de características para controlar la complejidad del modelo. Asimismo, se añade una capa final con una función de activación SoftMax (AF) antes de una capa de agrupamiento promedio global para la clasificación. El diseño fundamental del modelo DenseNet121 se muestra en Figura 334 a continuación.
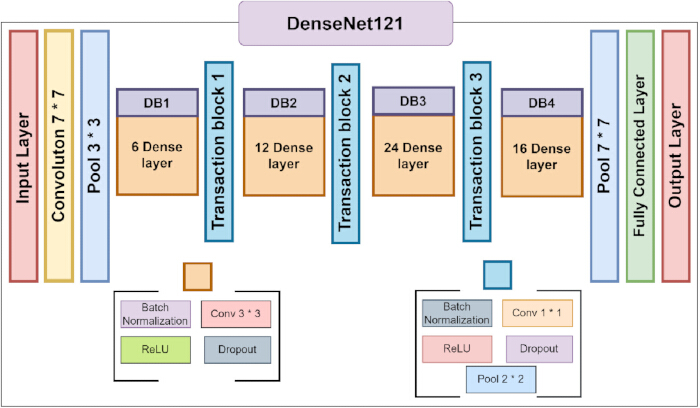
Figura 3: Detalle arquitectónico de DenseNet12134. Esta figura muestra el detalle arquitectónico del modelo DenseNet121, incluyendo todos los bloques densos y de transición. Haga clic aquí para ver una versión más grande de esta figura.
Además, el modelo EfficientNetB7 fue inventado por Tan y Lee en 2019. Pertenece a la familia EfficientNet, con variantes desde B0 hasta B7, y su objetivo principal es superar a otros modelos utilizando menos parámetros y menor potencia de procesamiento. La anchura del modelo (número de canales por capa), profundidad (número de capas) y resolución pueden ajustarse mediante escalado compuesto, que es la característica principal del modelo. Además, este modelo consta de bloques MBConv (convolución con cuello de botella invertido móvil), que incluyen una capa de expansión convolucional de 1 × 1 encargada de ampliar los canales, una convolución separable por profundidad responsable de aplicar la convolución a cada canal por separado, y una capa de proyección convolucional de 1 × 1 que reduce el número de canales al original. Asimismo, cada bloque MBConv incluye bloques de Compresión y Excitación (Squeeze and Excitation, SE)35, que recalibran las características por canal, ayudando a la red a enfocarse en las más importantes. Además, en lugar de la función sigmoide o cualquier otra FA, se utiliza la función Swish, que tiene un mejor desempeño que ReLU al permitir valores negativos, lo cual favorece el flujo del gradiente. Por otra parte, se añade una capa de salida final con una FA SoftMax antes de una capa de agrupamiento promedio global para fines de clasificación. Figura 435 muestra el diseño básico del modelo EfficientNetB7, mientras que Figura 5 muestra la arquitectura del modelo recomendada.
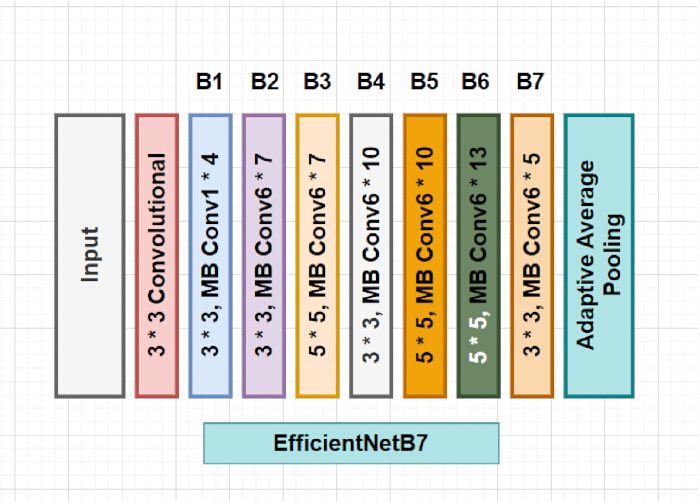
Figura 4: Detalle arquitectónico de EfficientNetB735. Esta figura muestra el detalle arquitectónico del modelo EfficientNetB7, incluyendo todos los bloques convolucionales invertidos de cuello de botella móviles. Haga clic aquí para ver una versión más grande de esta figura.
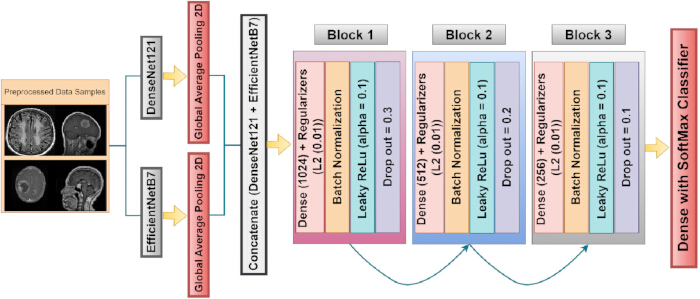
Figura 5: Arquitectura propuesta del modelo híbrido fusionado. La arquitectura propuesta ilustra cómo las imágenes preprocesadas se envían al extractor de características, que consta de tres bloques personalizados con diferentes hiperparámetros, seguidos por una capa de salida. Haga clic aquí para ver una versión más grande de esta figura.
Además, primero se extrajeron características de los modelos previamente entrenados DenseNet121 y EfficientNetB7. Los pesos actualizados de los modelos previamente entrenados se cargaron en los modelos entrenados, y se congelaron las capas base no entrenables de los modelos para evitar que el modelo se volviera a entrenar. Esto debería ayudar al modelo a conservar sus mejores conocimientos previos, adaptarlos a la luz de nuevas muestras de datos para mejorar la convergencia y centrarse en las capas adicionales para entrenarlas y extraer características avanzadas. Las ecuaciones 1 y 2 siguientes muestran el funcionamiento de los modelos DenseNet121 y EfficientNetB7.
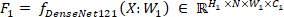 (1)
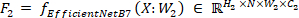 (2)
Las ecuaciones 1 y 2 anteriores muestran el funcionamiento del modelo previamente entrenado en cuanto a la extracción de características; F1 denota los mapas de características de salida producidos por el modelo DenseNet121 previamente entrenado y F2 denota los mapas de características de salida producidos por el modelo EfficientNetB7 previamente entrenado al aplicar procesamiento a las imágenes de entrada, representadas por X. Además, W1 y W2 son los parámetros entrenables o pesos asociados con los primeros bloques y capas de los modelos DenseNet121 y EfficientNetB7, respectivamente. Asimismo, ∈ RN ×H1×W1×C1 y ∈ RN ×H2×W2×C2 representan la dimensionalidad de los mapas de características de salida de los modelos DenseNet121 y EfficientNetB7, respectivamente, con dimensiones de H1 ×N×W1×C1 y H2 ×N×W2×C2, donde N representa el tamaño del lote de imágenes, que se consideró igual a 16. Además, H1×W1 representa la altura y anchura de las imágenes, respectivamente, para el modelo DenseNet121, y H2×W2 representa la altura y anchura de las imágenes para el modelo EfficientNetB7, seleccionadas con tamaños de 224 × 224. C1 y C2 representan el canal de color para los modelos DenseNet121 y EfficientNetB7, respectivamente. Tras obtener los mapas de características de salida del modelo, con 2560 canales de EfficientNetB7 y 1024 de DenseNet121, se aplica la capa de agrupamiento promedio global 2D36 a los mapas de características de salida para reducir la dimensión espacial mediante el cálculo del promedio de todas las dimensiones espaciales en un único vector, lo cual resulta más conveniente para transmitirlo a la siguiente capa y así mejorar la extracción de características y el reconocimiento de patrones en términos de características interpretables.
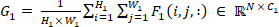 (3)
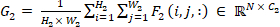 (4)
Las ecuaciones anteriores 3 y 4 muestran el funcionamiento de la capa de agrupamiento promedio global 2D aplicada a los modelos DenseNet121 y EfficientNetB7, respectivamente, donde  y
 muestran el procedimiento de normalización de la suma mediante la división entre el número total de ubicaciones espaciales para ambos modelos, asegurando que la salida agrupada sea un promedio y no una suma simple.
 y
 representan la sumatoria a través de las dimensiones espaciales de los mapas de características, mientras que i y j simplemente indican la iteración sobre la altura y el ancho, respectivamente, para sumar los mapas de características en ambos modelos. Además, F1(i, j, :) y F2(i, j, :) representan los valores de los mapas de características en posiciones espaciales específicas (i, j) a través de todos los canales para los modelos DenseNet121 y EfficientNetB7, respectivamente. Esta operación de agrupamiento agrega información espacial en una representación más compacta y precisa, conservando las características más importantes de cada imagen. Además, las salidas de las capas de agrupamiento promedio global se concatenan para producir un único vector de características para cada muestra, lo cual se utiliza frecuentemente para fusionar características de diferentes modelos y mejorar el rendimiento aprovechando las fortalezas de ambos; la ecuación 5 muestra cómo funciona este proceso.
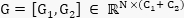 (5)
La ecuación 5 anterior muestra el procedimiento de concatenación de dos vectores de características de modelos diferentes [G1, G2], donde G1 representa el vector de características del modelo DenseNet121 y G2 representa el vector de características del modelo EfficientNetB7, mientras que la forma del vector de características concatenado se representa mediante RN ×(C1+ C2), donde N es el tamaño del lote, que representa el número de muestras que se procesan en paralelo, y (C1+ C2) es el número total de características obtenidas de los modelos 1 y 2, respectivamente, que suman aproximadamente 3584, las cuales se procesan en paralelo, y el vector de características de salida concatenado se representa mediante G. Además, se han añadido tres bloques diferentes para modificar el modelo fusionado con el fin de extraer características más complejas, mejorar la generalización y prevenir el sobreajuste, todo ello para obtener resultados más precisos y eficientes. Cada bloque está compuesto por una capa densa con un número distinto de neuronas: el primer bloque tiene 1024 neuronas en su capa densa, lo que permite capturar una amplia gama de características y patrones más genéricos en los datos; el segundo bloque tiene 512 neuronas en su capa densa, que refinan específicamente las características al reducir la dimensionalidad y centrarse en patrones más específicos. El tercer bloque contiene 256 neuronas en su capa densa, que destilan aún más las características para asegurar que solo las características y patrones más relevantes se transmitan a la capa de salida y realicen una tarea más pertinente. Además, se aplican enfoques de regularización L237 a cada capa densa en cada bloque para prevenir el sobreajuste mediante la penalización de pesos mayores, lo cual también incrementa la complejidad del modelo. Se introduce asimismo una capa de dropout38 después de cada bloque para ignorar aleatoriamente el 30 %, 20 % y 10 % de las neuronas en los bloques 1, 2 y 3, respectivamente, lo que obliga a las redes a desarrollar características más robustas que no dependan de una única neurona. Además, para estabilizar el proceso de entrenamiento, se aplica una capa de BatchNormalization39 tras cada capa densa, lo que garantiza que las activaciones permanezcan dentro de un rango estable y también ayuda al modelo a evitar problemas como el gradiente que desaparece o el gradiente que explota durante la fase de entrenamiento. Adicionalmente, esta capa de BatchNormalization acelera también el proceso de entrenamiento, permitiendo que el modelo converja más rápidamente al suavizar el paisaje de la función de pérdida, lo que facilita que los optimizadores alcancen mínimos globales. Finalmente, en cada bloque, para generar no linealidad, se utiliza la activación leaky ReLU40, que permite al modelo aprender patrones complejos, y leaky ReLU presenta ventajas frente a otras funciones de activación al garantizar que la neurona no quede inactiva, permitiendo un pequeño gradiente distinto de cero para entradas negativas. Además, la ecuación 6 siguiente muestra el funcionamiento de los diferentes bloques integrados en el modelo híbrido fusionado.
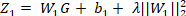 (6)
Después de obtener el vector concatenado, G pasa por la capa densa (totalmente conectada) del bloque 1 con 1024 neuronas, donde la matriz de pesos W1 transforma el vector de entrada G en un vector de salida de 1024 dimensiones y cada elemento del vector de salida es una combinación lineal de las características de entrada. Además, al vector de sesgo b1 se le suma a cada uno de los 1024 elementos del vector de salida, lo que permite al modelo desplazar la salida de las características de entrada de forma independiente. Asimismo, el término de regularización L2: λ||W1||22 penaliza los pesos grandes, lo que desincentiva al modelo a depender excesivamente de una sola neurona, ayudando así a evitar el sobreajuste. Donde la matriz de pesos de una capa determinada es W1 en la red neuronal, mientras que ||W1||22 denota la norma L2 al cuadrado de la matriz de pesos W1 y λ es el parámetro de regularización que controla el grado de regularización aplicado, el cual se ha establecido en 0,1 en todos los bloques. Z1 se convierte en la nueva representación de características tras aplicar la capa densa así como la regularización L2 a la entrada proveniente del vector concatenado G, como se muestra en la ecuación 6.
Después de obtener la salida de la capa densa del bloque 1 como Z1, se aplicó la capa BatchNormalization, que se utilizó para acelerar el proceso de entrenamiento, y la ecuación 7 siguiente muestra cómo funciona.
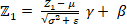 (7)
σ2 representa la varianza de la salida de la última capa Z1 a través del lote, mientras que μ es la media de la salida Z1, que se calcula por separado para cada neurona, siendo 1024 en la primera capa densa. Por otro lado, ε es una constante pequeña que se incorpora para garantizar la estabilidad numérica y evitar la división por cero. La salida normalizada puede ajustarse mediante el modelo al modificar el parámetro de escala aprendible γ, mientras que la salida normalizada puede desplazarse mediante el parámetro de desplazamiento aprendible β. Finalmente, tras aplicar la capa de normalización por lotes (BatchNormalization) a la salida de la capa densa, la salida normalizada Z1 asegura que las activaciones tengan una distribución consistente a través de las diferentes capas, lo que ayuda a estabilizar y acelerar el entrenamiento. Tras la normalización por lotes, la salida normalizada Z1 pasa a través de la función de activación ReLU con fugas (leaky ReLU), que introduce no linealidad en la red y permite aprender patrones complejos en los datos. En lugar de elegir ReLU u otra función de activación, se optó por leaky ReLU, que es una versión modificada de la función ReLU que considera también pequeños valores negativos en lugar de convertirlos en 0 como hace la función de activación ReLU, superando así el problema de la neurona ReLU muerta. La ecuación 8 que aparece a continuación muestra cómo funciona.
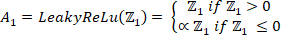 (8)
Donde Z1 pertenece a la salida de la capa de normalización por lotes, que se transmite a Leaky ReLU como entrada para realizar la no linealidad, mientras que ∝ es una constante pequeña que se utiliza para determinar la pendiente de la parte negativa de la función. Además, A1 muestra la salida obtenida tras aplicar la no linealidad. Finalmente, se aplica una capa de dropout a la salida A1 recibida como entrada desde la activación Leaky ReLU, lo cual se muestra en la ecuación 9.
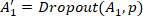 (9)
Donde A1 es la salida original de la función de activación recibida de la última función de activación ReLu, y donde p es la tasa de dropout, que varía entre 0 y 1 y se ha seleccionado como 0,3, 0,2 y 0,1 para tres capas de bloques, respectivamente, con el fin exclusivo de descartar una fracción de neuronas. Además, A1′ muestra la salida modificada tras aplicar la capa de dropout, en la cual algunas neuronas se han establecido en 0. La principal ventaja de utilizarla es prevenir problemas de sobreajuste, así como reducir la co-adaptación. Asimismo, la salida del bloque1 A1′ se transfiere al siguiente bloque nuevamente para extraer características más abstractas, aplicando los mismos parámetros que en el bloque 1, con la diferencia de contar con 512 neuronas en la capa densa en lugar de 1024 y una tasa de dropout de 0,2 en lugar de 0,3; las demás secuencias operativas son idénticas, tal como se describe en las ecuaciones 10 a 13 siguientes.
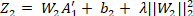 (10)
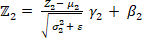 (11)
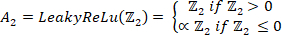 (12)
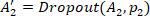 (13)
Después de obtener la salida del bloque 1 como A1′, que pasa por la capa densa (totalmente conectada) del bloque 2 con 512 neuronas, donde la matriz de pesos W2 transforma el vector de entrada A1′ en un vector de salida de 512 dimensiones, y cada elemento del vector de salida es una combinación lineal de las características de entrada. Además, al sesgo b2 se le suma a cada uno de los 512 elementos del vector de salida, lo que permite al modelo desplazar la salida de las características de entrada de forma independiente. Asimismo, se aplica regularización L2, donde: λ||W2||22 penaliza los pesos grandes, lo cual sirve para mitigar el sobreajuste al impedir que el modelo dependa excesivamente de alguna neurona particular en este bloque específico. Aquí, W2 es la matriz de pesos de una capa determinada en la red neuronal, mientras que λ es el parámetro de regularización que controla el grado de regularización aplicado, establecido en 0,1. Z2 se convierte en la nueva representación de características tras aplicar la capa densa y la regularización L2 a la entrada procedente del bloque 1, como se muestra en la ecuación 10.
Además, se aplicó la capa de normalización por lotes al nuevo atributo Z2, lo cual se utilizó para acelerar el proceso de entrenamiento; σ22 representa la varianza a través del lote, mientras que μ2 es la media de la salida Z2. Aunque ε es una constante pequeña incorporada para garantizar la estabilidad numérica, γ es un parámetro de escala aprendible que permite al modelo modificar la salida normalizada, y β es un parámetro de desplazamiento aprendible que permite al modelo trasladar la salida normalizada. Finalmente, tras aplicar la capa de normalización por lotes, que se muestra en la ecuación 11, la salida normalizada Z2 pasó a través de la función de activación ReLU con fugas, lo cual introdujo no linealidad en la red, como se muestra en la ecuación 12. Donde Z2 corresponde a la salida de la capa de normalización por lotes, que se introduce como entrada en ReLU con fugas para generar la no linealidad. Mientras tanto, A2 muestra la salida obtenida tras aplicar la no linealidad.
Finalmente, se aplica una capa de dropout a la salida A2 recibida como entrada desde la activación Leaky ReLU, lo cual se muestra en la ecuación 13. Donde A2 es la salida recibida de la última función de activación ReLU, y donde p2 es la tasa de dropout, que se ha seleccionado como 0,2 para este bloque, simplemente para descartar una fracción de neuronas. Además, A2′ muestra la salida modificada tras aplicar la capa de dropout, en la cual algunas neuronas se han establecido en 0. Posteriormente, la salida del bloque 2, A2′, se transfiere al tercer bloque nuevamente para extraer características aún más abstractas, aplicando los mismos parámetros que en el bloque 2, con la diferencia de contar con 256 neuronas en la capa densa en lugar de 512 y una tasa de dropout de 0,1 en lugar de 0,2; el resto de las secuencias operativas son iguales, como se describe en las ecuaciones siguientes 14 a 17.
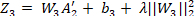 (14)
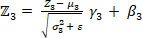 (15)
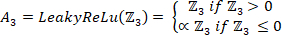 (16)
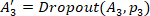 (17)
Después de obtener la salida del bloque 2 como A2′, que pasa por la capa densa (totalmente conectada) del bloque 3 con 256 neuronas, donde la matriz de pesos W3 transforma el vector de entrada A2′ en un vector de salida de 256 dimensiones, y cada elemento del vector de salida es una combinación lineal de las características de entrada. Además, al sesgo b3 se le suma a cada uno de los 256 elementos del vector de salida, lo que permite al modelo desplazar la salida de las características de entrada de forma independiente. Asimismo, se aplica regularización L2, donde: λ||W3||22 penaliza los pesos grandes, lo que desincentiva al modelo a depender excesivamente de una sola neurona, ayudando así a evitar el sobreajuste. Aquí, W3 es la matriz de pesos de una capa particular en la red neuronal, mientras que el grado de regularización empleado está controlado por el parámetro de regularización λ, que se ha establecido en 0,01. Z3 se convierte en la nueva representación de características tras aplicar la capa densa, así como la regularización L2, a la entrada proveniente del bloque 3, como se muestra en la ecuación 14.
Además, se aplicó la capa de normalización por lotes (BatchNormalization) a la nueva característica Z3, la cual se utilizó para acelerar el proceso de entrenamiento; σ32 representa la varianza a través del lote, mientras que μ3 es la media de la salida Z3. Asimismo, ε es una constante pequeña que se añade para garantizar la estabilidad numérica. La salida normalizada puede ajustarse mediante el parámetro de escala aprendible γ3 y desplazarse mediante el parámetro de traslación aprendible β3. Finalmente, tras aplicar la capa de normalización por lotes, que se muestra en la ecuación 15, la salida normalizada Z3 pasa a través de la función de activación ReLU con fugas (leaky ReLU), que introduce no linealidad en la red, como se muestra en la ecuación 16. Aquí, Z3 corresponde a la salida de la capa de normalización por lotes, que se introduce como entrada en Leaky ReLU para generar la no linealidad. Por su parte, A3 muestra la salida obtenida tras aplicar la no linealidad.
Finalmente, se aplica una capa de dropout a la salida A3 recibida como entrada desde la activación Leaky ReLU, lo cual se muestra en la ecuación 17. Donde A3 es la salida recibida de la última función de activación ReLU, y donde p3 es la tasa de dropout, que se ha seleccionado como 0,1 para este bloque, únicamente para anular una fracción de las neuronas. Además, A3′ muestra la salida modificada tras aplicar la capa de dropout, en la cual algunas neuronas se han establecido en 0.
Además, la salida del bloque 3 A3′ pasa a través de la última capa densa con fines de clasificación, con un número K de neuronas que representa el número real de clases en el conjunto de datos, lo cual se describe en la ecuación 18 a continuación.
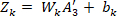 (18)
La matriz de pesos asociada a la capa densa es Wk, que se encarga de transformar el vector de 256 dimensiones A3′ en un vector de k dimensiones, el cual representa las características aprendidas del bloque anterior y se obtiene como salida. Además, bk representa el vector de sesgo que ajusta la predicción para garantizar que la función de activación tenga una salida distinta de cero cuando la entrada es cero, y Zk es la salida de la capa final antes de aplicar la función de activación, generando los logit para cada clase. Finalmente, se ha aplicado un clasificador SoftMax41 que convierte el logit Zk en la probabilidad de cada clase, como se muestra en las ecuaciones 19 y 20.
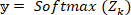 (19)
 (20)
Donde la probabilidad predicha de la clase iª está representada por yi, K es el número de clases, mientras que Zk, i es el logit para la clase iª, y eZk, i es la exponencial del logit de la clase iª. y muestra la distribución de probabilidad de todas las clases posibles y asegura que la suma de las probabilidades sea 1. Tabla 3 a continuación proporciona los detalles de los hiperparámetros utilizados para entrenar el modelo híbrido propuesto, incluyendo los detalles arquitectónicos adoptados para mejorar la reproducibilidad y el rendimiento.
| Parámetros hiper | Modelo propuesto (FusionNetX) |
| Tamaño de la imagen | 224 × 224 |
| Arquitectura del backbone | EfficientNetB7 y DenseNet121 preentrenados como BBA1 y BBA2 |
| Aumento de datos | Rango de rotación = 7, |
| Rango de desplazamiento de ancho/alto hasta 0.05, | |
| Rango de zoom hasta 0.01, | |
| Inversión horizontal/vertical | |
| Relación de división de datos | 80 % para entrenamiento y 20 % para validación mediante muestreo estratificado con un estado aleatorio fijo = 42 |
| Extracción y fusión de características | Se aplica un agrupamiento promedio global en la salida de cada backbone: 2560 para BBA1 y 1024 para BBA2, y se fusionan para obtener vectores de características conjuntas de 3584. |
| Composición del bloque completamente conectado | 3 bloques completamente conectados con 1 capa de salida. Cada bloque contiene regularización L2 (λ=0,01), normalización por lotes, LeakyReLU (α=0,01), dropout de (0,3, 0,2 y 0,1) y dimensiones ocultas de (1024, 512 y 256) respectivamente. No se introducen conexiones de salto adicionales en la cabeza de fusión. |
| Función de activación | Leaky ReLU y SoftMax |
| Optimizador y tasa de aprendizaje | Adam con una tasa fija de 0,00001 sin planificador de tasa de aprendizaje. |
| Función de pérdida | sparse_categorical_crossentropy |
| Tamaño del lote | 16 |
| Épocas | 100 épocas fijas para cada conjunto de datos |
| Plataforma utilizada | Cuaderno de Kaggle con una GPU P100 y 16 GB de VRAM, utilizando las plataformas TensorFlow y Keras. |
Tabla 3: Hiperparámetros utilizados para entrenar el modelo propuesto y detalles arquitectónicos propuestos. Esta tabla proporciona los detalles estructurales y arquitectónicos del modelo propuesto, junto con los parámetros ajustados finamente y el entorno de implementación.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Esta parte detalla los resultados de probar el modelo propuesto de fusión dual en cinco conjuntos de datos de código abierto sobre cánceres cerebrales, incluyendo los conjuntos de datos Br35H, Figshare, Sartaj, Masoud y Balanced Brain Tumor, y su desempeño se evalúa en función de diferentes parámetros estadísticos de evaluación del rendimiento, incluyendo exactitud42,43,44, tasa de clasificación errónea (MCR)45...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Como se concluyó, el modelo propuesto funcionó de la siguiente manera: primero, se eligió un tamaño de imagen de 224 × 224, que es un tamaño moderado para que cualquier modelo de aprendizaje profundo pueda extraer y aprender características adecuadas a partir de las muestras de datos, manteniendo al mismo tiempo toda la información importante; además, se realizó una ampliación de datos, lo cual resulta más beneficioso para diversificar las muestras en múltiples direcciones, lo que desempeña un papel importante para que l...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen nada que revelar y no presentan conflictos de intereses. Además, no se han utilizado herramientas de inteligencia artificial para generar el manuscrito ni las figuras.
Agradecimientos
Los autores agradecen el apoyo brindado por el Proyecto de Apoyo a Investigadores de la Universidad Princess Nourah bint Abdulrahman (PNURSP2026R192), Universidad Princess Nourah bint Abdulrahman, Riad, Arabia Saudita. Los autores también agradecen a los participantes de la investigación y a las instituciones que contribuyeron a este estudio.
Financiamiento:
Este trabajo fue apoyado por la subvención de la Fundación Nacional de Investigación de Corea (NRF) financiada por el gobierno de Corea (MSIT) (n.º RS-2023-00218176) y por el Fondo de Investigación de la Universidad Soonchunhyang. Proyecto de Apoyo a Investigadores de la Universidad Princess Nourah bint Abdulrahman (PNURSP2026R192), Universidad Princess Nourah bint Abdulrahman, Riad, Arabia Saudita.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Conjunto de datos de tumores cerebrales Br35H | Kaggle (colaborador del conjunto de datos) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Conjunto de datos público; clasificación binaria (tumor / sin tumor) 300 imágenes de resonancia magnética |
| Conjunto de datos de tumores cerebrales de Figshare | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Conjunto de datos público; multiclase (glioma, meningioma, tumor pituitario) 3064 imágenes de resonancia magnética |
| Conjunto de datos de resonancia magnética para clasificación de tumores cerebrales de Sartaj | Kaggle (conjunto de datos por Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | Conjunto de datos público; multiclase (glioma, meningioma, sin tumor, tumor pituitario) 3264 imágenes de resonancia magnética |
| Conjunto de datos de resonancia magnética de tumores cerebrales de Masoud | Kaggle (conjunto de datos por Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | Conjunto de datos público; multiclase (glioma, meningioma, sin tumor, tumor pituitario) 7023 imágenes de resonancia magnética |
| BBT-Conjunto de datos (Conjunto de datos de tumores cerebrales) | Kaggle (colaborador del conjunto de datos) | https://doi.org/10.34740/kaggle/dsv/6758053 | Conjunto de datos público; tumor cerebral multiclase balanceado, 5248 imágenes de resonancia magnética |
| Python | Fundación Python | https://www.python.org | Lenguaje de programación, versión 3.10.13 |
| TensorFlow / Keras | Google / desarrolladores de TensorFlow | https://www.tensorflow.org | Entorno de aprendizaje profundo; construcción, entrenamiento y evaluación de modelos, versión 2.15.0 |
| EfficientNetB7 (preentrenado) | Google / Aplicaciones de Keras | https://keras.io/api/applications/efficientnet/ | Modelo base preentrenado en ImageNet; extracción de características |
| DenseNet121 (preentrenado) | Aplicaciones de Keras | https://keras.io/api/applications/densenet/ | Modelo base preentrenado en ImageNet; extracción de características |
| scikit-learn | Desarrolladores de scikit-learn (NumFOCUS) | https://scikit-learn.org | Codificación de etiquetas, división entre entrenamiento y prueba, métricas de evaluación (informe de clasificación, matriz de confusión, ROC/AUC) |
| OpenCV (cv2) | Equipo de OpenCV | https://opencv.org | Carga y redimensionamiento de imágenes |
| NumPy | Desarrolladores de NumPy (NumFOCUS) | https://numpy.org | Computación numérica y operaciones con arreglos |
| pandas | Equipo de desarrollo de pandas (NumFOCUS) | https://pandas.pydata.org | Organización de datos y tabulación de métricas |
Referencias
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.