Este artículo presenta un flujo de trabajo computacional supervisado por humanos para examinar representaciones recurrentes de mujeres en 433 pinturas chinas de exportación de la época Qing. Siete categorías de referencia humana y señales visuales recurrentes caracterizan los patrones dentro del corpus, mientras que los hallazgos se limitan a las imágenes muestreadas y no miden la realidad social Qing ni la recepción histórica.
Artículo de investigación
Identidad femenina e imaginación de clase en las pinturas de exportación chinas de la dinastía Qing: un estudio de interpretación intercultural asistido por inteligencia artificial
En este artículo
Resumen
Resumen
Este estudio examinó las representaciones recurrentes de la identidad femenina y las señales visuales codificadas por clase en un corpus de 433 pinturas chinas de exportación de la dinastía Qing, fechadas entre 1757 y 1911. El flujo de trabajo combinó CLIP ViT-B/32 para etiquetado preliminar, localización asistida por el modelo Segment Anything (SAM), reducción de dimensionalidad y agrupamiento en clústeres, y codificación iconográfica manual realizada por dos codificadores independientes. Las etiquetas de CLIP se utilizaron para la organización inicial, SAM sirvió como ayuda para la localización, y la codificación humana consensuada proporcionó las categorías de referencia. Los resultados agregados identificaron siete categorías basadas en la referencia humana: élite/belleza (n = 112), trabajo (n = 72), doméstica (n = 64), sirvienta (n = 58), ritual/boda (n = 45), mercado (n = 43) y artística (n = 39). Las etiquetas computacionales preliminares coincidieron con las etiquetas de referencia humana en 356 de las 433 pinturas (82,2 %), con una recuperación a nivel de categoría que osciló entre 73,3 % y 88,4 %. Se utilizaron combinaciones recurrentes de vestimenta, entorno espacial, objetos, postura y relaciones sociales representadas para caracterizar los perfiles visuales de estas categorías. La evaluación de los 433 pares de etiquetas generadas por inteligencia artificial y humanos produjo puntuaciones completas a nivel de categoría de precisión, recuperación y puntuación F1, junto con una matriz de confusión que detalla los patrones de clasificación. La validación de clústeres respaldó la solución de agrupamiento seleccionada y demostró una correspondencia entre los clústeres derivados y las categorías de referencia definidas por humanos. En conjunto, las combinaciones recurrentes de vestimenta, entorno espacial, objetos, postura y relaciones sociales indican tipologías pictóricas estructuradas dentro del corpus analizado. Estos hallazgos caracterizan la representación visual en las pinturas chinas de exportación de la dinastía Qing, pero no deben interpretarse como medidas directas del estatus legal, la experiencia vivida, la demanda del mercado o la recepción histórica por parte de extranjeros.
Introducción
Las pinturas chinas de exportación de la dinastía Qing formaron parte de las redes comerciales y culturales que vinculaban a Cantón y otros centros de recolección con compradores euroamericanos desde finales del siglo XVIII1,2,3,4,5. Mercaderes, viajeros, diplomáticos, misioneros y coleccionistas adquirieron estas pinturas como bienes portátiles, recuerdos, fuentes de información visual y representaciones de lugares, ocupaciones, procesos productivos, costumbres y tipos sociales. Por lo tanto, su circulación reflejaba tanto las prácticas de los talleres chinos como las expectativas de los mercados externos.
La demanda extranjera favoreció temas reconocibles, formatos seriados, motivos repetidos y escenas que podían coleccionarse y compararse. Los talleres adaptaron el medio, la escala, la composición y el tema para la venta, mientras que los compradores a menudo preferían representaciones comprensibles de oficios, ceremonias, interiores, jardines, calles y tipos sociales pintorescos. Las versiones repetidas de escenas de talleres de Cantón demuestran aún más cómo los artistas y sus ayudantes adaptaron la iconografía y los recursos pictóricos occidentales para los clientes del extranjero1,2,3,4,5. Aunque la demanda del mercado pudo haber influido en lo que se produjo y conservó, el corpus actual no mide directamente las preferencias o respuestas individuales de los compradores.
Por lo tanto, estas pinturas deben considerarse fuentes selectivas y mediadas, más que registros exhaustivos de la vida cotidiana. Sus escenas pueden idealizar, simplificar, estandarizar o adaptar prácticas sociales mediante convenciones del taller, selección del mercado, adquisición por museos, catalogación y digitalización1,2,3,4,5. La interpretación histórica debe distinguir las características directamente observables en las pinturas de las inferencias acerca de los individuos representados, las condiciones de producción y los significados que los espectadores posteriores atribuyeron a las obras.
Las figuras femeninas ofrecen un medio enfocado para examinar esta distinción. La vestimenta, el peinado, la postura, el entorno espacial, los objetos, las actividades y las relaciones con otras figuras pueden organizar a las mujeres en roles visualmente recurrentes, incluyendo categorías de elite/belleza, doméstica, sirvienta, trabajadora, de mercado, artística y ritual/matrimonio. Estas categorías son descripciones analíticas de patrones pictóricos y, por sí mismas, no establecen rango legal, riqueza, ocupación, etnia, afiliación Banner o Han, carácter moral ni identidad vivida.
La historia del arte digital y la visión por computadora pueden facilitar comparaciones a gran escala de colecciones visuales digitalizadas, al tiempo que permiten un examen crítico de los supuestos integrados en los modelos computacionales6,7. Los modelos de visión–lenguaje pueden ayudar a identificar y organizar motivos visuales recurrentes, aunque el sesgo cultural sigue siendo una limitación importante cuando se aplican vocabularios contemporáneos de modelos a imágenes históricas no occidentales8. Investigaciones computacionales relacionadas sobre la pintura tradicional china demuestran asimismo el valor de combinar la detección cuantitativa de patrones con interpretaciones fundamentadas históricamente9.
Este estudio aborda tres preguntas: (1) ¿Qué categorías de identidad femenina codificadas por humanos y adjudicadas están representadas en el corpus? (2) ¿Qué combinaciones de vestimenta, entorno espacial, objetos, postura y relaciones sociales caracterizan a estas categorías? (3) ¿Cómo varían la precisión general de coincidencia exacta y el recall a nivel de categoría entre las siete categorías? El flujo de trabajo se basa en enfoques computacionales para la pintura tradicional china9, aunque limita sus afirmaciones históricas a las imágenes muestreadas y a los análisis documentados.
La contribución prevista es tanto historiográfica como técnica. La comparación a escala de corpus puede identificar fórmulas pictóricas recurrentes que posteriormente pueden contextualizarse mediante un análisis histórico detallado. Este enfoque puede orientar la investigación sobre género, jerarquía, representaciones de la vida cotidiana y encuentros interculturales sin tratar la frecuencia de las imágenes como evidencia de prevalencia social o la similitud visual como prueba de identidad histórica.
Protocolo
Diseño del estudio y unidad analítica
Cada pintura o registro del catálogo se trató como una unidad analítica. Se utilizó un diseño observacional basado en corpus, que combinó la revisión de metadatos, la organización computacional preliminar, la codificación manual independiente y la interpretación artístico-histórica. El período de estudio se definió entre 1757 y 1911, y los criterios de inclusión y exclusión se aplicaron dentro de este intervalo. Se analizaron obras de arte históricas y sus metadatos asociados del catálogo. Cuando se compararon distribuciones a lo largo de intervalos de tiempo de duración desigual, las frecuencias se normalizaron según la duración del intervalo, considerándose en la interpretación los posibles sesgos de supervivencia y adquisición.
Construcción y selección del corpus
Los registros candidatos se recuperaron de los catálogos de museos citados, archivos digitales y catálogos publicados. Para cada registro candidato, se conservaron la institución, el título, la fecha o el rango de fechas, el soporte, el número de acceso o de catálogo, la URL estable de la fuente, la fecha de recuperación y la declaración de derechos. Los enlaces de origen se mantuvieron incluso cuando el archivo de imagen correspondiente no pudiera redistribuirse legalmente. El procedimiento de selección descrito comenzó con 612 imágenes candidatas. De estas, se excluyeron 85 porque estaban fuera del período 1757–1911 o de la tradición de pintura de exportación, 58 se excluyeron por ser reproducciones modernas, registros borrosos o por representar temas incorrectos, 29 se excluyeron por carecer de una figura femenina identificable o de resolución de imagen adecuada, y 7 se excluyeron por tener metadatos insuficientes. El corpus analítico final constó de 433 registros.
Normalización de metadatos y preprocesamiento de imágenes
A cada pintura del corpus analítico final se le asignó un identificador estable QEP que oscilaba entre QEP_001 y QEP_433. Se conservaron los metadatos museísticos asociados, incluyendo institución, número de inventario, título, fecha, técnica o materiales, lugar de origen, enlace de origen y descripción del catálogo disponible. Para el análisis visual, se registró la etiqueta preliminar de inteligencia artificial, la categoría humana adjudicada, el número de figuras femeninas, grupo de edad, postura, vestimenta, entorno espacial, objetos asociados y relaciones sociales. Cada pintura se clasificó en una de siete categorías principales: élite/belleza, doméstica, sirvienta, laboral, mercado, artística o ritual/matrimonio. En escenas con múltiples figuras femeninas, se identificó la figura principal según su prominencia visual y centralidad narrativa. Cuando ninguna figura femenina era dominante, la categoría principal se asignó en función de la actividad representada principal y del contexto general de la escena. Las categorías superpuestas se resolvieron priorizando la actividad representada y el contexto de la escena por encima de la vestimenta o la apariencia únicamente. Los casos ambiguos fueron revisados independientemente por ambos codificadores y resueltos mediante consenso. Las imágenes originales se guardaron en formato JPEG o PNG. Únicamente se recortaron los bordes de las páginas web, marcos del catálogo o márgenes que no formaban parte de la imagen. No se reconstruyó, recoloreó, mejoró ni restauró el contenido pictórico.
Etiquetado preliminar basado en CLIP
Se utilizó el codificador de imágenes CLIP ViT-B/32 para el análisis preliminar de similitud entre imagen y texto⁹. Los términos candidatos de identidad incluyeron mujer de élite, mujer doméstica, sirvienta, mujer trabajadora, mujer del mercado, intérprete femenina, novia y mujer ritual. Los términos de escena incluyeron interior chino, jardín, mercado callejero, taller, producción de té, trabajo textil y escena ceremonial. Se conservó el conjunto completo de plantillas de indicaciones, su orden, cualquier agrupación de indicaciones, procedimientos de normalización del texto, reglas de decisión, puntuaciones de confianza y empates para cada imagen.
Se aplicó de forma consistente la lista completa de indicaciones a todas las imágenes utilizando el modelo OpenAI CLIP ViT-B/32 implementado en Python 3.10 con PyTorch 2.0.1 y el paquete OpenAI CLIP. La inferencia se realizó en una GPU con soporte CUDA con un tamaño de lote de 32 utilizando precisión FP32. Cada imagen se redimensionó y recortó al centro a 224 × 224 píxeles, y los canales RGB se normalizaron utilizando la transformación de preprocesamiento asociada al modelo ViT-B/32. Las indicaciones de texto se construyeron utilizando los descriptores de identidad y de escena definidos anteriormente y se codificaron con el codificador de texto de CLIP. Se calculó la similitud del coseno entre los vectores integrados normalizados de imagen y texto, y la indicación con la puntuación de similitud más alta se asignó como la etiqueta preliminar de la IA. Se conservaron las puntuaciones de similitud para todas las etiquetas candidatas para su posterior revisión humana. Se utilizó una semilla aleatoria fija de 42, y se aplicaron procedimientos de preprocesamiento idénticos, plantillas de indicaciones y reglas de decisión a las 433 pinturas.
Localización asistida por SAM
El modelo Segment Anything (SAM) se utilizó estrictamente para localizar figuras, prendas de vestir, muebles, herramientas, objetos rituales y regiones arquitectónicas destinadas a la inspección visual humana. Es fundamental destacar que SAM no participó en la canalización de clasificación; sus máscaras, recortes y características derivadas se mantuvieron aisladas de los procesos de etiquetado y agrupamiento mediante CLIP, asegurando así que la aplicación de SAM proporcionara únicamente ayudas para la localización sin influir ni inflar el rendimiento de la clasificación.
Se aplicaron indicaciones manuales por puntos o cuadros delimitadores cuando fue necesario para refinar la localización de los elementos visuales. Se generaron máscaras SAM para figuras femeninas, prendas de vestir, muebles, herramientas, objetos rituales y elementos arquitectónicos, y cada resultado de segmentación se inspeccionó visualmente para verificar una cobertura regional adecuada. Las máscaras resultantes facilitaron la identificación y revisión de características iconográficas relevantes, pero no se utilizaron para la etiquetación con CLIP ni para la asignación de categorías.
Reducción de dimensionalidad y agrupamiento
Se calcularon las incrustaciones de imágenes CLIP, y se utilizó UMAP con distancia coseno para la visualización bidimensional10. Se registró la representación utilizada para el agrupamiento, junto con su procedimiento de preprocesamiento, dimensionalidad y definición de distancia.
Se aplicaron k-medias y agrupamiento jerárquico a las representaciones de características de imagen para identificar agrupaciones visuales recurrentes dentro del corpus11. Se evaluaron soluciones candidatas de k-medias para k = 5–9 utilizando el coeficiente de silueta y el índice de Davies-Bouldin. Se utilizó la inicialización k-medias++ con n_init = 10, max_iter = 300, tol = 1 × 10⁻4 y random_state = 42. El agrupamiento jerárquico se realizó mediante agrupamiento aglomerativo con enlace promedio y distancia coseno. Las soluciones candidatas se compararon utilizando índices de validación cuantitativos, estabilidad de los grupos e interpretabilidad desde el punto de vista histórico del arte, y se seleccionó la solución final de agrupamiento por su representación más coherente de los patrones visuales recurrentes. Se conservó la asignación de grupos resultante para cada una de las 433 pinturas para su comparación posterior con las categorías codificadas por humanos.
Codificación manual, entrenamiento y adjudicación
Dos codificadores revisaron de forma independiente las 433 imágenes utilizando un manual de codificación versionado que abarcaba categoría principal, cantidad de figuras, grupo de edad, postura, vestimenta, entorno espacial, objetos y relaciones sociales. Se conservaron los registros específicos de cada codificador antes de la adjudicación. Los codificadores tenían formación relevante en historia del arte y análisis visual, y fueron entrenados mediante el manual de codificación estandarizado y ejemplos representativos del corpus de pinturas. Antes de la codificación formal, completaron un ejercicio de calibración que incluía 30 pinturas, con el fin de promover una interpretación coherente de las siete categorías de identidad y las cinco dimensiones de indicadores visuales.
Durante la codificación formal, ambos codificadores evaluaron de forma independiente todas las pinturas elegibles, permaneciendo ciegos ante las decisiones de codificación del otro, las etiquetas preliminares de la IA y las asignaciones de grupos. La fiabilidad entre codificadores se evaluó mediante el kappa de Cohen. El valor observado de kappa para la categoría principal de identidad fue de 0,88, y las variables categóricas de indicadores visuales oscilaron entre 0,79 y 0,92, lo que demuestra un fuerte acuerdo entre los codificadores. Las discrepancias se resolvieron mediante discusión y consenso, y las categorías adjudicadas y los códigos de indicadores visuales se registraron para su posterior análisis12. Se conservaron las etiquetas previas a la adjudicación.
Concordancia entre IA y seres humanos y estimación del rendimiento
La categoría humana adjudicada se utilizó como referencia para la comparación descriptiva con una etiqueta preliminar de IA por cada pintura. La precisión exacta general se calculó como 356/433 (82,2 %). El índice de recuperación por categoría se calculó como el número de coincidencias exactas entre IA y seres humanos dividido por el soporte de referencia humana para cada categoría. Se informaron explícitamente el soporte por categoría, las coincidencias exactas, los desajustes y los denominadores correspondientes.
Con base en las 433 etiquetas emparejadas a nivel de caso generadas por inteligencia artificial y humanas, se calcularon los falsos positivos de la clase objetivo, así como la precisión, recuperación y puntuaciones F1 por categoría. Se construyó una matriz de confusión completa para analizar los patrones de clasificación fuera de la diagonal, lo cual guió posteriormente la revisión de discrepancias, la documentación de la taxonomía de errores y las reglas de adjudicación.
Paquete y materiales para la reproducibilidad
El flujo de trabajo computacional y los materiales de investigación complementarios se organizaron en un repositorio con control de versiones. El paquete de reproducibilidad fue diseñado para incluir secuencias de comandos para el preprocesamiento, análisis de CLIP, localización de SAM, UMAP, agrupamiento, análisis de concordancia y generación de figuras, junto con el código de categorización manual, archivos de configuración, información sobre dependencias, resultados derivados a nivel de caso e inventario legible por máquina de las fuentes de las imágenes y la información sobre derechos. Se asignó un identificador persistente a los materiales de investigación archivados para facilitar su reproducibilidad y reutilización.
Se utilizó Microsoft Excel 2021 para organizar y gestionar los metadatos. Los análisis computacionales emplearon CLIP ViT-B/32 para la etiquetación preliminar visión-lenguaje, SAM para la localización de elementos visuales, UMAP con distancia del coseno para la reducción de dimensionalidad, y agrupamiento por K-medias y agrupamiento jerárquico para el análisis exploratorio de patrones. Las soluciones de agrupamiento se evaluaron mediante el coeficiente de silueta y el índice de Davies-Bouldin, y el acuerdo entre codificadores se evaluó utilizando la kappa de Cohen. Se documentó el entorno de software, las configuraciones del modelo, los parámetros computacionales y las semillas aleatorias utilizadas en todo el flujo de trabajo para favorecer la reproducibilidad.
Resultados
Construcción del corpus y composición descriptiva
Figura 1 presenta una visión general en cuatro paneles del corpus. Figura 1A muestra el proceso de cribado reportado, desde 612 registros candidatos hasta 433 registros conservados. Figura 1B muestra ejemplos representativos de medios y formatos. Figura 1C presenta los conteos en cuatro intervalos de tiempo, y Figura 1D resume la composición por fuente y medio del corpus. Dado que los intervalos de tiempo abarcan períodos desiguales, estos conteos describen la composición del corpus muestreado y no deben interpretarse como tasas históricas de producción.
Tabla 1 resume las características agregadas del corpus. Las colecciones de museos representaron 302 registros, los archivos digitales 81 y los catálogos publicados 50. Los soportes se clasificaron como acuarela de exportación (n = 176), pintura sobre papel de pith (n = 112), hoja de álbum de exportación (n = 83), pintura de figura (n = 41) y otro formato (n = 21). Los metadatos se clasificaron como completos (n = 288), parciales (n = 118) o mínimos (n = 27). Las figuras femeninas se clasificaron como centrales (n = 214), secundarias (n = 102) o múltiples (n = 117). Cada bloque de clasificación incluyó los 433 registros.
Etiquetas preliminares de IA y categorías de referencia humana
Tabla 2 resume el acuerdo agregado entre las etiquetas generadas inicialmente por inteligencia artificial y las categorías de referencia humana en las 433 pinturas, mientras Tabla suplementaria 1 proporciona las etiquetas preliminares de IA a nivel de caso, las clasificaciones realizadas por los codificadores, las categorías de referencia humana adjudicadas, el estado de coincidencia y las asignaciones de clústeres. En general, las etiquetas de IA y las de referencia humana coincidieron en 356 pinturas, lo que corresponde a una precisión de coincidencia exacta del 82,2 %. El índice de recuperación a nivel de categoría se calculó como la proporción de coincidencias exactas entre IA y humano en relación con el respaldo de referencia humana para cada categoría.
El recuerdo a nivel de categoría varió desde 73,3 % para escenas rituales/matrimoniales (33/45) hasta 88,4 % para élite/belleza (99/112). El recuerdo fue del 84,7 % para trabajo (61/72), 82,1 % para actuación (32/39), 79,7 % para entorno doméstico (51/64), 79,3 % para sirviente (46/58) y 79,1 % para mercado (34/43). En general, el acuerdo exacto fue de 356/433 (82,2 %). La evaluación de los pares a nivel de caso permitió calcular la precisión y las puntuaciones F1 en las siete categorías, que oscilaron entre 74,5 % y 89,2 % para la precisión, y entre 0,75 y 0,88 para las puntuaciones F1. Se proporciona una matriz de confusión completa con los falsos positivos por clase objetivo y los patrones fuera de la diagonal en la Figura suplementaria 1.
Resúmenes de patrones computacionales informados
Figura 2 presenta cuatro visualizaciones de análisis computacionales informados. Figura 2A muestra una galería de nueve pinturas con superposiciones de segmentación de colores utilizadas para la localización visual y revisión. Figura 2B muestra un diagrama de dispersión UMAP de los embeddings de imágenes CLIP informados, con contornos de densidad etiquetados como C1–C7. Figura 2C compara el número informado de pinturas (puntos sólidos) con el recuerdo a nivel de categoría (círculos abiertos), y Figura 2D presenta una galería de pinturas representativas agrupadas según las mismas etiquetas. La validación de clústeres respaldó la solución de agrupamiento seleccionada, que arrojó un puntaje de silueta de 0.54 y un índice de Davies-Bouldin de 0.92. La asignación de clústeres a categorías humanas demostró una fuerte concordancia, ya que cada clúster derivado correspondía predominantemente a una categoría de referencia humana distinta.
Tabla 3 presenta siete perfiles computacionales reportados con tamaños de muestra correspondientes a los siete apoyos de categorías de referencia humana. La tabla de contingencia agrupada por categoría se proporciona en la Tabla Suplementaria 2 y muestra la distribución de las siete categorías de referencia humana adjudicadas a través de los grupos C1–C7. El análisis de estas asignaciones de grupos a nivel de caso demostró que el agrupamiento computacional recuperó estructuras visuales que correspondían estrechamente a las siete categorías de referencia humana.
Asociaciones basadas en señales visuales y síntesis interpretativa
Tabla 4 resume los perfiles cualitativos de señales visuales utilizados para caracterizar las siete categorías codificadas por humanos. Estos perfiles describen asociaciones recurrentes entre la vestimenta, el entorno espacial, la postura, los objetos y las relaciones sociales. No se derivaron de una tabulación cruzada cuantitativa y, por lo tanto, no establecen estatus legal, etnia, causación social ni recepción por parte del público.
Figura 3 integra resúmenes cuantitativos descriptivos de las características visuales codificadas con un modelo conceptual interpretativo. Figura 3A muestra las siete categorías de referencia humana adjudicadas y sus tamaños muestrales. Figura 3B muestra las asociaciones relativas entre estas categorías y los marcadores visuales codificados a lo largo de cinco dimensiones: vestimenta, entorno espacial, objetos, postura y relaciones sociales. Las intensidades de asociación mostradas se calcularon a partir de las anotaciones a nivel de caso dentro de cada categoría de referencia humana. Figura 3C resume las relaciones entre las categorías de referencia humana, las dimensiones de marcado visual y los arquetipos de implicación de clase, utilizando flujos ponderados derivados de las observaciones codificadas. Estas relaciones cuantitativas caracterizan patrones representacionales recurrentes dentro de las pinturas muestreadas y no deben interpretarse como estimaciones de distribuciones demográficas o sociales históricas. Figura 3D presenta un modelo conceptual interpretativo transcultural y debe entenderse como un marco interpretativo informado históricamente, más que como una vía causal sometida a prueba empírica.
Interpretación integrada de patrones visuales
En todo el corpus, las siete categorías de identidad femenina se caracterizaron por combinaciones recurrentes de vestimenta, entorno espacial, objetos, postura y relaciones sociales. Estas combinaciones proporcionaron evidencia descriptiva de convenciones visuales estructuradas dentro de las pinturas analizadas. Las interpretaciones históricas relacionadas con el género, la jerarquía y la mediación intercultural siguieron siendo inferenciales.
En conjunto, los resultados agregados identificaron siete categorías de identidad femenina de referencia humana y cinco dimensiones recurrentes utilizadas para caracterizarlas: vestimenta, entorno espacial, objetos, postura y relaciones sociales. Las etiquetas preliminares de inteligencia artificial coincidieron con las categorías humanas adjudicadas en 356 de 433 pinturas (82,2 %), con la menor recuperación a nivel de categoría observada en escenas rituales o de bodas (73,3 %). Estos hallazgos respaldaron la organización descriptiva y la comparación del corpus. Las etiquetas de inteligencia artificial y humanas a nivel de caso permitieron estimaciones de precisión y F1 a nivel de categoría. Por separado, el análisis de conglomerados identificó estructuras que correspondían a las siete categorías de referencia humana. No obstante, estos hallazgos computacionales caracterizan convenciones de representación visual, en lugar de establecer afirmaciones causales sobre la realidad social histórica o la recepción por parte del público.
DISPONIBILIDAD DE LOS DATOS:
Los datos que respaldan este estudio, incluyendo metadatos, información de las fuentes y registros de cribado, están disponibles a través de Zenodo en https://doi.org/10.5281/zenodo.21130291.
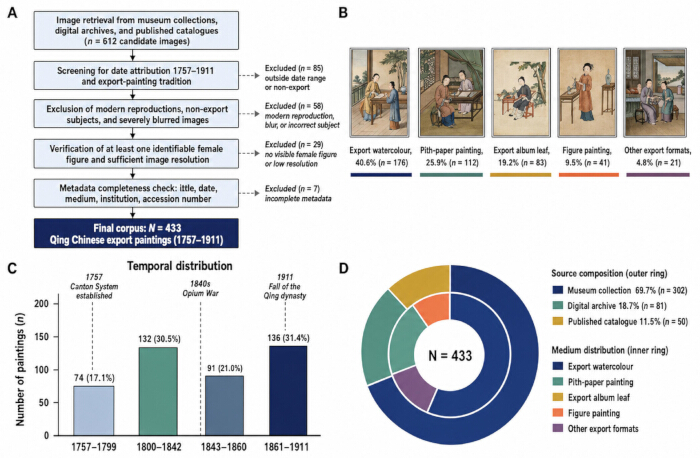
Figura 1: Construcción del corpus y composición descriptiva de la muestra de 433 pinturas. (A) Selección secuencial de 612 imágenes candidatas, resultando en 433 pinturas elegibles. Las exclusiones incluyeron pinturas fuera del período de estudio o de la tradición de pintura de exportación (n = 85), reproducciones modernas, imágenes borrosas o con sujetos incorrectos (n = 58), imágenes sin una figura femenina identificable o con resolución insuficiente (n = 29) y registros con metadatos insuficientes (n = 7). (B) Ejemplos representativos de cinco soportes y formatos: acuarela de exportación (40,6 %, n = 176), pintura sobre papel de matasueño (25,9 %, n = 112), hoja de álbum de exportación (19,2 %, n = 83), pintura de figura (9,5 %, n = 41) y otros formatos de exportación (4,8 %, n = 21). (C) Distribución de las pinturas muestreadas en cuatro intervalos cronológicos. (D) Distribución de las fuentes de colección (anillo exterior) y de los soportes/formatos (anillo interior). Los porcentajes se basan en la muestra total (N = 433) y se redondean a un lugar decimal. Haga clic aquí para ver una versión más grande de esta figura.
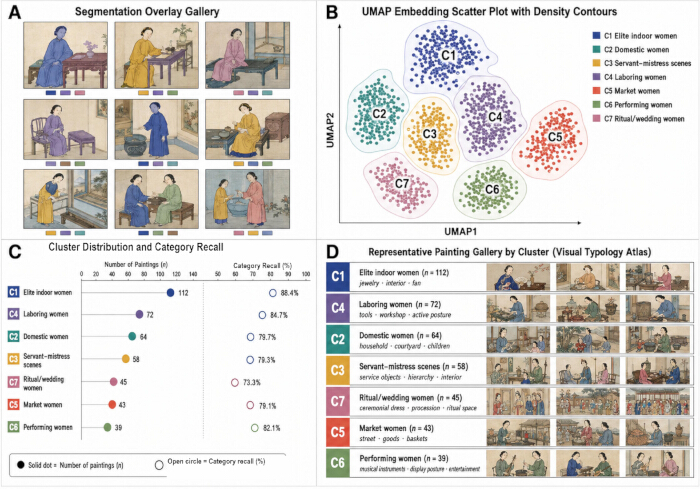
Figura 2: Segmentación informada, visualización de incrustación, distribución de clústeres, recuperación de categorías y pinturas representativas. (A) Galería de nueve pinturas con superposiciones de segmentación coloreadas utilizadas para localizar figuras o elementos visuales para revisión. (B) Gráfico de dispersión UMAP de las incrustaciones de imágenes CLIP informadas, con contornos de densidad y etiquetas C1–C7. (C) Número informado de pinturas (puntos sólidos, eje superior) y recuperación de categorías (círculos abiertos, eje inferior); la recuperación de categorías equivale a los aciertos exactos divididos por el soporte de referencia humana. No se muestran intervalos de confianza ni barras de error. (D) Galería de pinturas representativas agrupadas por las etiquetas C1–C7, con imágenes seleccionadas según su proximidad a los respectivos centroides de clúster. Abreviaturas: AI = inteligencia artificial; CLIP = Preentrenamiento Contrastivo Lenguaje-Imagen; SAM = Modelo de Segmentación Universal; UMAP = Aproximación y Proyección Uniforme de Variedad; C1–C7 = etiquetas informadas 1–7. Haga clic aquí para ver una versión más grande de esta figura.
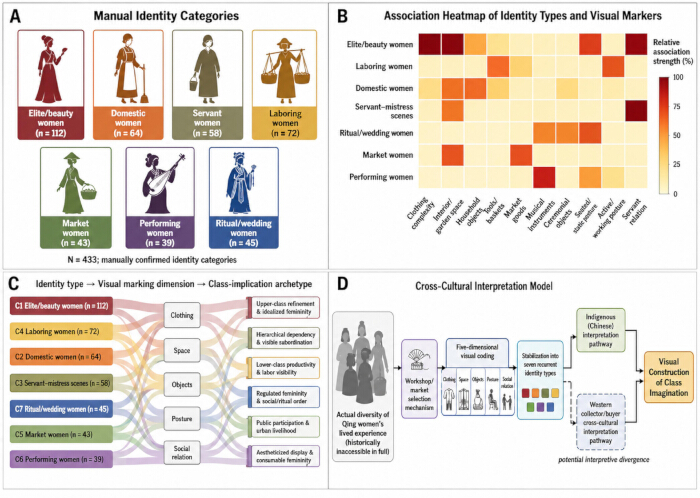
Figura 3: Asociaciones de señales visuales y marco conceptual interpretativo intercultural. (A) Siete categorías adjudicadas de identidad femenina de referencia humana y sus tamaños muestrales dentro del corpus de 433 pinturas. (B) Mapa de calor de asociaciones que muestra la intensidad relativa de las relaciones entre las siete categorías de referencia humana y los marcadores visuales codificados relacionados con la vestimenta, el entorno espacial, los objetos, la postura y las relaciones sociales. Las intensidades de asociación se derivaron de las anotaciones a nivel de caso dentro de cada categoría. (C) Representación aluvial que resume las relaciones ponderadas entre las categorías de referencia humana, las dimensiones de marcado visual y los arquetipos de implicación de clase basados en las observaciones codificadas. (D) Modelo conceptual interpretativo intercultural que vincula las actividades representadas, la selección del taller y del mercado, la codificación visual pentadimensional, los tipos recurrentes de identidad y las posibles vías interpretativas. Haga clic aquí para ver una versión ampliada de esta figura.
Tabla 1: Características del corpus y completitud de los metadatos (N = 433). Los conteos y porcentajes resumen seis bloques separados: intervalo de fecha, fuente, medio o formato, completitud de los metadatos, representación de figuras femeninas y tipo de escena. Cada bloque utiliza N = 433 como denominador y suma 433; los porcentajes son proporciones del corpus dentro de cada bloque, redondeadas a un decimal. Haga clic aquí para descargar este archivo.
Tabla 2: Etiquetas preliminares de IA y categorías de referencia humana (N = 433). El soporte representa el número de pinturas asignadas a cada categoría de referencia humana. Las coincidencias exactas indican pinturas para las cuales la etiqueta preliminar generada por IA correspondió a la categoría de referencia humana. El índice de recuperación a nivel de categoría se calcula como el número de coincidencias exactas dividido por el número de soportes de referencia humana. Haga clic aquí para descargar este archivo.
Tabla 3: Resumen del perfil computacional reportado. C1–C7 reproducen los tamaños de perfil validados y las etiquetas dominantes. La integración de las asignaciones de clústeres a nivel de caso y la tabla de contingencia de clústeres por categoría confirma que el agrupamiento no supervisado capturó eficazmente las estructuras visuales correspondientes a las siete categorías de referencia humana. Haga clic aquí para descargar este archivo.
Tabla 4: Perfiles cualitativos de las categorías de identidad femenina y señales visuales relacionadas con la clase. Los conteos y porcentajes resumen las categorías de referencia humana, mientras que la vestimenta, el espacio, los objetos, la postura y las relaciones sociales caracterizan los perfiles visuales recurrentes asociados con cada categoría. Las interpretaciones relacionadas con la clase representan lecturas iconográficas de patrones pictóricos, más que medidas directas del estatus social histórico. Haga clic aquí para descargar este archivo.
Figura suplementaria 1: Matriz de confusión que compara las etiquetas preliminares de IA con las categorías de referencia humana adjudicadas para el corpus de 433 pinturas. Las filas representan las categorías de referencia humana adjudicadas (etiquetas reales) y las columnas representan las categorías preliminares generadas por CLIP (etiquetas predichas). Los valores de las celdas indican el número de pinturas para cada combinación de etiquetas de IA y humanas. Las celdas diagonales representan coincidencias exactas entre IA y humanos, con el porcentaje correspondiente de recuperación a nivel de categoría. Las celdas fuera de la diagonal representan discrepancias entre la clasificación preliminar de IA y la categoría de referencia humana adjudicada. La precisión general por coincidencia exacta fue del 82,2 % (356/433). Haga clic aquí para descargar este archivo.
Tabla suplementaria 1: Comparación por caso entre las etiquetas preliminares de IA, las categorías de referencia humana adjudicadas y las asignaciones de clústeres UMAP. Cada fila representa una de las 433 pinturas chinas de exportación Qing incluidas en el corpus analítico. La tabla muestra el identificador estable de la imagen QEP, la etiqueta preliminar CLIP ViT-B/32, clasificaciones independientes del Codificador Humano 1 y del Codificador Humano 2, la categoría de referencia humana adjudicada, el estado de coincidencia entre IA y humano, y la asignación del clúster UMAP. «Coincidencia exacta» indica acuerdo entre la etiqueta preliminar de IA y la categoría de referencia humana adjudicada; «Discrepancia» indica desacuerdo. La categoría humana adjudicada sirvió como clasificación de referencia para los análisis de concordancia entre IA y humano. Haga clic aquí para descargar este archivo.
Tabla suplementaria 2: Tabla de contingencia de categorías de referencia humana y asignaciones de clústeres computacionales. Las filas representan las siete categorías de referencia humana adjudicadas, y las columnas representan los clústeres C1–C7 obtenidos a partir del análisis computacional de agrupamiento. Los valores de las celdas indican el número de pinturas asignadas a cada combinación de categoría y clúster. El soporte total representa el número de pinturas en cada categoría de referencia humana. La concentración de observaciones a través de las combinaciones de categoría–clúster proporciona una evaluación descriptiva de la correspondencia entre los clústeres computacionales derivados independientemente y las categorías de referencia humana adjudicadas. Haga clic aquí para descargar este archivo.
Discusión
Dentro de los resúmenes agregados proporcionados, 433 registros se organizaron en siete categorías de referencia humana y se describieron mediante cinco familias de señales visuales. La categoría de elite/belleza fue la más grande (112/433), y 356 etiquetas preliminares coincidieron con la referencia humana reportada (82,2 %). Estas son observaciones del corpus. Apoyan el estudio de fórmulas pictóricas recurrentes, pero no la afirmación más fuerte de que dichas fórmulas reproducen fielmente la sociedad Qing o provocaron una respuesta particular entre audiencias extranjeras13.
El discurso prescriptivo sobre el género, la posición en el hogar, el trabajo y la ley Qing moldearon las vidas de las mujeres sin determinarlas de manera uniforme. Los estudios sobre las mujeres del Alto Qing documentan su participación en el trabajo, la escritura, los rituales, la religión y el entretenimiento, junto con los regímenes familiares y de castidad prescritos. Los Ocho Cuarteles formaron un grupo de estatus hereditario y multiétnico definido por la ley y la práctica administrativa; por lo tanto, la pertenencia a un Cuartel no debe equipararse automáticamente con la etnia manchú14,15,16,17. En este estudio, la vestimenta, la postura, los objetos y el entorno son indicaciones pictóricas y no evidencia de rango legal, afiliación Cuartel/Han, etnia, conformidad moral o identidad vivida. Se requeriría evidencia archivística y legal para respaldar tales afirmaciones.
Los hallazgos computacionales también requieren moderación cultural y técnica. No se debe asumir que los modelos generales de visión y lenguaje son culturalmente neutrales. Los resultados publicados de CulturalVQA muestran un desempeño desigual entre regiones y facetas culturales, pero esa referencia no evaluó CLIP ViT-B/32 ni utilizó arte histórico del este de Asia8,18,19. Por lo tanto, esto motiva, en lugar de sustituir, un conjunto de pruebas comparables para este corpus. Hasta que esté disponible tal experimento, CLIP constituye una ayuda preliminar de organización, no una autoridad sobre la identidad o jerarquía qing. La canalización computacional confirmó que SAM funcionó estrictamente como evidencia auxiliar de localización; no se utilizaron máscaras ni características derivadas de máscaras como entradas para etiquetado o agrupamiento, asegurando que la categorización visual dependiera únicamente de los embeddings semánticos globales de las imágenes no segmentadas. La investigación en patrimonio digital también enfatiza la sensibilidad cultural, la supervisión interdisciplinaria, la accesibilidad, la protección de datos y flujos de trabajo transparentes20.
Históricamente, la relevancia de los patrones radica en el comercio de pinturas de exportación: talleres chinos y la demanda extranjera seleccionaron y estandarizaron temas que eran portátiles, comprensibles y coleccionables; las imágenes repetidas en los talleres también demuestran copia con variación, en lugar de duplicación puramente mecánica1,2,3,4,5. Por lo tanto, el corpus puede contribuir a las historias sobre género, jerarquía, imágenes de la vida cotidiana y encuentros interculturales al mostrar qué fórmulas se repiten a gran escala. No demuestra que las imágenes sean registros etnográficos exhaustivos. La comparación computacional puede orientar la lectura detallada y la contextualización intercultural21, mientras que los registros de producción, historiales de compra y evidencia de recepción deben sustentar las afirmaciones sobre la intención del mercado o el significado para la audiencia.
La respuesta afectiva y cognitiva sigue siendo una dirección de investigación adicional más que un resultado del presente estudio. Shi y colegas combinaron calificaciones de preferencia, análisis de dimensiones latentes y seguimiento ocular para distinguir las vías emocionales, formales-estéticas y cognitivas en las respuestas a las imágenes de linternas Xiashi Pinprick22. Un diseño comparable podría probar si los espectadores prestan atención de manera diferente a la ropa, los objetos, la postura o la jerarquía en las pinturas de exportación. Dado que este estudio no recopiló calificaciones, seguimiento ocular ni otros datos del público, no puede inferir el arousal emocional, la saliencia visual ni la recepción a partir del contenido de la imagen únicamente.
Las limitaciones son teóricas, metodológicas y prácticas. Teóricamente, las categorías de señales materiales simplifican el género, las relaciones domésticas, la jerarquía legal, la etnia y la experiencia vivida. Metodológicamente, las inferencias están limitadas por la supervivencia del material, la recolección, la digitalización, los metadatos, los modelos de cero muestras (zero-shot), la codificación y los sesgos temporales desiguales. Aunque la canalización analítica demuestra una detección robusta de patrones, estos sesgos estructurales subrayan la necesidad de considerar las salidas computacionales como análisis de convenciones pictóricas, más que como ventanas transparentes a la realidad social de la dinastía Qing. Prácticamente, los derechos de imagen restringen la redistribución, y los hallazgos podrían no generalizarse entre instituciones, períodos, medios o entornos computacionales. Sujeta a esas limitaciones, el estudio ofrece un marco supervisado por humanos para transformar observaciones visuales repetidas en preguntas históricas verificables, en lugar de conclusiones automatizadas. Al tratarse de un estudio interpretativo y no de una intervención, no evaluó el progreso hacia ningún Objetivo de Desarrollo Sostenible (ODS) ni indicador. Sin embargo, su temática es relevante para el Objetivo 5, y su documentación consciente de los derechos y su enfoque educativo intercultural están conceptualmente alineados con las metas 11.4 y 4.7; no se midió ningún resultado relacionado con los ODS. El paquete de reproducibilidad proporcionado alinea el estudio con las recientes demandas de flujos de trabajo digitales transparentes en el patrimonio cultural y con los requisitos FAIR de identificadores persistentes, metadatos ricos, licencias, procedencia y datos, algoritmos, herramientas y flujos de trabajo reutilizables20,23.
Divulgaciones
Los autores no tienen nada que revelar.
Agradecimientos
Los autores agradecen al Museo Victoria y Alberto, al Museo Británico, al Museo Metropolitano de Arte, al Museo Nacional Smithsoniano de Arte Asiático, al Museo Peabody Essex, al Museo de Arte de Hong Kong, a la Biblioteca Británica, al Instituto de Investigación Getty y a otras instituciones poseedoras y equipos de catálogo cuyos registros en línea apoyaron el descubrimiento del corpus. El acceso a un registro en línea no implica permiso para redistribuir su imagen; por ello, los derechos a nivel de panel y los enlaces de origen se documentan por separado. Los autores también reconocen a las comunidades de investigación abierta que apoyan CLIP y SAM, así como el apoyo administrativo de la Universidad Ciudad de Macao y de la Universidad Normal Politécnica de Guangdong.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Modelo de visión y lenguaje utilizado para el análisis preliminar de similitud entre imagen–texto y la asignación de etiquetas preliminares de IA. |
| Estación de trabajo computacional | Estación de trabajo computacional de los autores’ | GPU con soporte para CUDA; la configuración exacta del hardware debe informarse | Estación de trabajo utilizada para la inferencia de CLIP y SAM y para análisis computacionales; deben informarse las especificaciones de GPU, CPU, RAM, sistema operativo y CUDA del entorno original de ejecución. |
| Matplotlib | Equipo de desarrollo de Matplotlib | Paquete de Python; la versión exacta debe informarse | Utilizado para la visualización computacional y la generación de figuras y gráficos de análisis. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Utilizado para la organización de metadatos, registros de cribado y gestión de datos tabulares del estudio. |
| NumPy | Desarrolladores de NumPy | Paquete de Python; la versión exacta debe informarse | Utilizado para el cálculo numérico y la manipulación de matrices de características de imagen y análisis. |
| pandas | Equipo de desarrollo de pandas | Paquete de Python; la versión exacta debe informarse | Utilizado para el manejo de datos estructurados, procesamiento de metadatos y organización de resultados analíticos a nivel de caso. |
| Python 3.10 | Python Software Foundation | Python 3.10 | Entorno de programación utilizado para implementar el flujo de trabajo computacional de análisis de imágenes. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | Entorno de aprendizaje profundo utilizado para ejecutar la codificación de imágenes y texto basada en CLIP y la inferencia en GPU. |
| scikit-learn | Desarrolladores de scikit-learn | Paquete de Python; la versión exacta debe informarse | Utilizado para cálculos de agrupamiento por K-medias, agrupamiento jerárquico, coeficiente de silueta, índice de Davies–Bouldin y kappa de Cohen’. |
| Modelo de Segmentación Universal (SAM) | Meta AI Research | SAM | Modelo de segmentación utilizado para localizar figuras femeninas, prendas de vestir, muebles, herramientas, objetos rituales y regiones arquitectónicas para inspección visual. |
| umap-learn | McInnes et al. | Implementación en Python de UMAP | Utilizado para la reducción de dimensionalidad y la visualización en dos dimensiones de incrustaciones de imágenes CLIP con distancia coseno. |
Referencias
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.