VoiceNet-RAI integra características MFCC, incorporaciones multilingües wav2vec 2.0 y EfficientNet-Lite para la clasificación de género y edad a partir de datos de voz. El marco logra una precisión de hasta el 97,87 % en el subconjunto de idioma inglés y permite aplicaciones responsables en reconocimiento de voz, autenticación y peritaje digital.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
VoiceNet: Un marco de trabajo de inteligencia artificial responsable y multilingüe de reconocimiento de voz para la clasificación de género y edad
127 visualizaciones
⸱
11 de septiembre de 2026
En este artículo
Resumen
Resumen
La clasificación precisa del género y la edad a partir de datos de voz es importante para una interacción humano-ordenador (IHO) personalizada, segura y ética. Con el creciente uso de modelos de voz preentrenados de gran tamaño, como wav2vec 2.0, surge la necesidad de aprovechar estas representaciones de forma responsable para inferir datos demográficos en múltiples idiomas y con conciencia de la privacidad. Este estudio propone VoiceNet-RAI, un marco de aprendizaje profundo (DL) que integra coeficientes cepstrales en frecuencia mel (MFCC) con incrustaciones multilingües basadas en transformadores de wav2vec 2.0 dentro de una arquitectura EfficientNet-Lite, para apoyar una clasificación precisa, justa y transparente en diversos contextos lingüísticos. El marco combina información espectral y contextual para mejorar la robustez bajo condiciones variables de grabación. Los experimentos con datos de voz multilingües que abarcan 28 idiomas demuestran un rendimiento elevado en la clasificación, alcanzando el subconjunto en inglés una exactitud del 97,87 %, una precisión del 98,61 %, una recuperación del 98,70 % y una puntuación F1 del 98,65 %. La validación externa utilizando el conjunto de datos Mozilla Common Voice arrojó una exactitud del 98,27 % en la clasificación de género, lo que demuestra su generalización a un conjunto de datos independiente. Un análisis de ablación mostró además que la combinación de características MFCC y wav2vec 2.0 mejoró el rendimiento en comparación con representaciones basadas únicamente en datos brutos o en MFCC. Estos hallazgos demuestran el potencial de las representaciones híbridas de voz espectral-contextual para una clasificación robusta y responsable del género y la edad.
Introducción
El reconocimiento de voz es un componente fundamental de la comunicación humana mediante el cual los individuos expresan sus sentimientos, pensamientos y objetivos. Las voces humanas se producen mediante un proceso biológico en el que el aire es exhalado desde los pulmones y moldeado en sonido por órganos articulatorios como los labios, la lengua y los dientes1. El oído desempeña un papel esencial en la identificación de la voz y puede distinguir entre voces masculinas y femeninas según características como el volumen y el tono. Una característica que contribuye a diferencias significativas en el tono vocal entre hombres y mujeres es el dimorfismo sexual2. La clasificación por edad y género a partir de la voz es relevante para numerosas aplicaciones, incluyendo la interacción humano-máquina, el reconocimiento automático de género, saludos personalizados, preclasificación de emociones en el habla y clasificación de llamadas basada en género3.
El habla es una parte intrínseca de la interacción humana. La voz humana contiene múltiples características que varían entre individuos y pueden proporcionar información sobre estados emocionales y mentales, así como sobre la edad y el sexo. Estas características multidimensionales pueden utilizarse en aplicaciones como sistemas de seguridad basados en voz y asistentes de inteligencia artificial (IA) orientados al habla. Otras áreas en las que el análisis de voz es importante incluyen los sistemas de verificación automática del hablante (ASV) y los sistemas de IA basados en emociones. Los sistemas de entrada basados en voz también pueden reducir el espacio de búsqueda dentro de bases de datos4,5. Además, los sistemas de seguridad basados en IA pueden utilizar datos de voz en aplicaciones como investigaciones criminales y protección de víctimas. Las voces masculinas y femeninas presentan características diferentes debido a variaciones en las propiedades resonantes del tracto vocal. Estas características pueden extraerse de señales de voz en una forma adecuada para su procesamiento computacional, lo que permite la clasificación del género a partir de datos de voz6,7. Por lo tanto, se requieren algoritmos de aprendizaje eficaces para la clasificación del género basada en la voz. Los algoritmos de aprendizaje profundo (DL) son particularmente adecuados para la clasificación relacionada con el habla debido a su capacidad para aprender patrones complejos a partir de datos de audio. Dichos modelos pueden contener capas convolucionales, recurrentes, convolucionales temporales o completamente conectadas, dependiendo de la arquitectura. Estas capas pueden aprender características acústicas relevantes, incluyendo el tono y el tono fundamental. Una vez entrenado, un modelo puede clasificar el género a partir de grabaciones de audio previamente no vistas8. Otra área importante de investigación en aprendizaje automático (ML) es la clasificación de la edad a partir de grabaciones de voz. Los algoritmos de ML pueden utilizar características acústicas como el tono, el timbre y la amplitud para identificar patrones relacionados con la edad. Técnicas como el análisis de componentes principales (PCA) también pueden aplicarse para extraer patrones informativos de los datos de voz y potencialmente mejorar el rendimiento de la clasificación9.
El aprendizaje profundo (DL) ha demostrado un rendimiento sólido en aplicaciones como el reconocimiento de imágenes, emociones y voz. Las redes neuronales profundas (DNN), en particular, se utilizan ampliamente para tareas relacionadas con el habla. En este estudio, se aplican enfoques basados en DL a la clasificación de voz en combinación con técnicas establecidas de extracción de características. Los coeficientes cepstrales en escala Mel (MFCC) capturan características espectrales relevantes de las señales de voz y proporcionan una representación eficiente para el procesamiento posterior. Las características extraídas se integran posteriormente en un marco de aprendizaje por transferencia para la clasificación de género y edad basada en la voz10,11.
Estudios recientes han adoptado cada vez más representaciones de voz basadas en transformadores y auto-supervisadas para la clasificación de atributos del hablante. Los investigadores han examinado sesgos demográficos, incluyendo sesgos de género y edad, en modelos de voz auto-supervisados como HuBERT y wav2vec 2.0, destacando la importancia de una evaluación consciente de la equidad12. Más recientemente, enfoques basados en transformadores e independientes del idioma han demostrado la eficacia de las representaciones de voz contextuales aprendidas para el reconocimiento de género en condiciones multilingües y ruidosas13. Sinha et al. investigaron además las representaciones por capas de wav2vec 2.0 para la clasificación de edad y género, y mostraron que diferentes capas del transformador capturan niveles variables de información relacionada con el hablante14. Estos avances motivan el marco propuesto VoiceNet-RAI, que combina información espectral convencional basada en MFCC con representaciones contextuales de wav2vec 2.0, incorporando al mismo tiempo consideraciones multilingües y de Inteligencia Artificial Responsable.
Estudios recientes han demostrado que la edad y el género del hablante pueden caracterizarse utilizando tanto características acústicas convencionales como representaciones basadas en aprendizaje profundo. Los enfoques que combinan información acústica y temporal han mostrado que características complementarias del habla pueden mejorar el rendimiento en la clasificación de edad y género15,16. Investigaciones relacionadas también han demostrado que las características de habla transformadas generadas mediante representaciones profundas de cuello de botella pueden mejorar el rendimiento en la clasificación de edad y género del hablante17. Estos hallazgos respaldan el uso más amplio de representaciones espectrales, temporales y aprendidas para tareas de clasificación que involucran señales de habla y derivadas del habla.
Varios estudios han investigado el reconocimiento de edad y género a partir de la voz mediante enfoques de aprendizaje automático y aprendizaje profundo18,19,20,21,22,23,24,25,26,27,28,29,30. Enfoques más recientes han explorado representaciones transformadas de los coeficientes cepstrales en frecuencia mel (MFCC) y redes neuronales profundas para la clasificación de edad y género del hablante31, mientras que la variabilidad multilingüe y dependiente del idioma sigue siendo una consideración importante al desarrollar sistemas robustos de clasificación demográfica basados en la voz. Las diferencias en la pronunciación, la estructura fonética, las características del hablante y las condiciones de grabación pueden reducir la generalización del modelo entre idiomas y poblaciones. Por consiguiente, el uso de representaciones espectrales y contextuales del habla complementarias podría mejorar la robustez en entornos multilingües.
Aunque enfoques híbridos han combinado previamente múltiples características acústicas o clasificadores de conjunto para el reconocimiento demográfico basado en la voz, VoiceNet-RAI se diferencia al integrar dos niveles complementarios de representación del habla dentro de un marco unificado. Específicamente, las características convencionales de MFCC preservan características espectrales y vocales localizadas, mientras que wav2vec 2.0 proporciona representaciones contextualizadas aprendidas a partir de señales de voz en bruto mediante un codificador Transformer. En lugar de depender exclusivamente de descriptores acústicos diseñados manualmente o de una única representación profunda, VoiceNet-RAI realiza una fusión a nivel de características de las representaciones de MFCC y wav2vec 2.0 agregadas temporalmente, y luego perfecciona la representación híbrida resultante utilizando EfficientNet-Lite. La novedad científica, por tanto, radica en la integración coordinada de representaciones espectrales, contextualizadas auto-supervisadas y profundas ligeras para la clasificación de género y edad, junto con una evaluación multilingüe, validación en conjuntos de datos independientes y análisis de equidad en subgrupos. Esta combinación extiende las canalizaciones convencionales de clasificación de habla más allá de la fusión de características orientada a la precisión, hacia un marco que considera simultáneamente la complementariedad de las representaciones, el diseño ligero del modelo, la generalización y la Inteligencia Artificial Responsable.
Las principales contribuciones de esta investigación incluyen el desarrollo de un enfoque para identificar el género y la edad a partir de datos de voz mediante la integración de características MFCC y wav2vec 2.0 con EfficientNet-Lite. Se realizaron experimentos exhaustivos en un conjunto de datos de grabaciones de voz de 28 idiomas, evaluando las características originales, las características MFCC, las características wav2vec 2.0 y sus combinaciones con modelos de ML y DL. El desempeño del modelo se evaluó utilizando tanto el conjunto de datos multilingüe completo como el subconjunto en idioma inglés. El marco se evaluó además desde perspectivas multilingües y de Inteligencia Artificial Responsable mediante análisis de subgrupos específicos por género e idioma, evaluación independiente del hablante y validación utilizando el conjunto de datos Mozilla Common Voice. Además, se comparó el desempeño del marco propuesto con los enfoques más avanzados reportados en la literatura existente, y se presentaron los resultados de la validación cruzada. Se ha llevado a cabo una amplia cantidad de investigaciones relacionadas, y Tabla 1 resume estos estudios, incluyendo los modelos, conjuntos de datos y resultados reportados19,20,21,22,23,24,25,26,27,28,29,30,31.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utilizó conjuntos de datos públicos de BVC Challenging Voice Set y Mozilla Common Voice sin participación directa de sujetos. Por lo tanto, no se requirió aprobación ética institucional ni consentimiento informado adicional. Solo se procesaron los datos necesarios para la clasificación por género y edad, y no se realizó ningún intento para identificar a los hablantes individuales. La metodología completa del flujo de trabajo del marco propuesto se muestra en Figura 1.
Adquisición de datos
El conjunto de datos utilizado en el enfoque propuesto consistió en archivos de audio .wav obtenidos del BVC Challenging Voice Set, un conjunto de datos de voz de acceso público desarrollado por el grupo Biometrics Vision and Computing (BVC) y alojado en GitHub32. El conjunto de datos contenía grabaciones de voz de 526 individuos, incluyendo 336 hablantes masculinos y 190 femeninos. Comprendía aproximadamente 3.964 grabaciones, incluyendo grabaciones de una sola oración y de varias oraciones de cada hablante. Tabla 2 resume las características demográficas, la cobertura lingüística, las propiedades de grabación, la estrategia de particionamiento de los datos y los ajustes de preprocesamiento utilizados para los conjuntos de datos de habla en el marco propuesto de VoiceNet-RAI.
Extracción de características
Los archivos de audio se procesaron para extraer propiedades esenciales, que posteriormente se almacenaron en un archivo CSV. Los metadatos, incluyendo edad, género y pronunciación del hablante, se extrajeron de los archivos README correspondientes. Se utilizó Python junto con el paquete SciPy para procesar los archivos WAV y extraer características relevantes. Se emplearon la transformada rápida de Fourier (FFT) y las funciones de frecuencia de NumPy para convertir las señales de audio del dominio temporal al dominio frecuencial. Los archivos WAV representaban la amplitud como una función del tiempo; sin embargo, las características relacionadas con la frecuencia que podían distinguir voces masculinas y femeninas eran de mayor interés para la tarea de clasificación33.
Para transformar las señales de audio en representaciones en el dominio de la frecuencia, se implementó la Transformada Discreta de Fourier (DFT) utilizando el algoritmo FFT. La transformada de Fourier convierte una señal en el dominio del tiempo en un espectro de frecuencia. Dado que este espectro no conserva la información temporal, la señal de audio se dividió en segmentos solapados y la transformada de Fourier se aplicó a cada segmento mediante el enfoque de Transformada de Fourier de Tiempo Corto (STFT). La función np.fft.fft generó el espectro de frecuencia complejo, mientras que np.fft.fftfreq proporcionó las frecuencias de muestreo correspondientes. En el directorio de muestras, había disponibles 10 archivos de audio de un solo hablante. Cada archivo WAV se procesó utilizando ventanas deslizantes de 200 ms para extraer las frecuencias dominantes. Por ejemplo, una grabación de audio de 4 segundos produjo una lista de 20 valores de frecuencia. Para un directorio que contiene 10 grabaciones, las 10 listas correspondientes, cada una con 20 valores de frecuencia, se combinaron en una lista de listas. Las frecuencias se filtraron para conservar valores entre 20 Hz y 280 Hz, excluyéndose el ruido potencial alrededor de 50 Hz.
Representación híbrida de características MFCC y wav2vec 2.0
Para capturar tanto representaciones contextuales de habla de alto nivel como características acústicas de bajo nivel, este estudio empleó una estrategia híbrida de extracción de características que integró características MFCC con incrustaciones basadas en el transformador wav2vec 2.0.
Extracción de características MFCC
Los coeficientes cepstrales en escala de frecuencia mel (MFCCs) son características ampliamente utilizadas en el procesamiento de señales de voz y audio, especialmente para aplicaciones como el reconocimiento de voz y la identificación de hablantes34,35. En este estudio, la extracción de MFCC transformó las señales de audio en vectores de características que representan propiedades perceptualmente relevantes del habla. El proceso comenzó con un preénfasis para realzar los componentes de alta frecuencia, seguido de la división en tramas y el enventanado para separar la señal en tramas cortas y solapadas. Cada muestra de audio se remuestreó primero a 16 kHz y se segmentó en tramas de 25 ms con un solapamiento de 10 ms. Luego, se aplicó la transformada rápida de Fourier a cada trama para convertir la señal del dominio del tiempo al dominio de la frecuencia.
Al espectro de frecuencia resultante se le aplicó una serie de bancos de filtros Mel que aproximaron la respuesta de frecuencia no lineal de la percepción auditiva humana. Estos bancos de filtros enfatizaron las frecuencias más relevantes desde el punto de vista perceptual, mientras reducían la contribución de las menos informativas. Posteriormente, se calculó el logaritmo de la salida de cada banco de filtros para aproximar la sensibilidad logarítmica del oído humano a la intensidad sonora. Luego, se aplicó una Transformada Coseno Discreta (DCT) a las energías logarítmicas de los bancos de filtros para descorrelacionar los coeficientes y generar una representación compacta de la señal de audio. Los coeficientes resultantes, conocidos como MFCC, capturaron características espectrales importantes del habla. Se utilizaron MFCC para la clasificación por género y edad porque capturan características acústicas que diferencian las voces según estos atributos.
extracción de incrustaciones wav2vec 2.0
El modelo Base wav2vec 2.0 fue preentrenado en grandes corpus de habla sin etiquetar. El modelo consistía en un codificador Transformer de múltiples capas que procesaba entradas de forma de onda en bruto y generaba incorporaciones de habla contextualizadas36.
Dada una forma de onda de entrada x ∈ RT, el modelo wav2vec 2.0 produjo una secuencia de representaciones latentes:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
donde cada vector de incrustación tenía una dimensionalidad de 768. Para obtener una representación de longitud fija adecuada para la clasificación, se aplicó una operación de agrupamiento temporal promedio a lo largo de todos los pasos temporales.
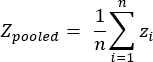 (2)
Mecanismo de fusión de características
Las características MFCC y wav2vec 2.0 se fusionaron mediante la concatenación a nivel de características. Específicamente, las características MFCC se agruparon primero utilizando promedio temporal para producir un vector de longitud fija.
m ∈ R40 (3)
El vector final de características híbridas se obtuvo como:
h = [m || zpooled] ∈ R808 (4)
donde || denota concatenación. Esta fusión combinó incrustaciones contextuales profundas con características espectrales diseñadas manualmente, permitiendo al modelo capturar tanto información semántica de alto nivel como patrones acústicos finamente detallados.
Todas las muestras de audio se remuestrearon primero a 16 kHz. Las características MFCC se calcularon por tramas y se promediaron temporalmente para producir un vector fijo de 40 dimensiones, mientras que los embeddings de wav2vec 2.0 se promediaron a lo largo del tiempo para generar una representación de 768 dimensiones. Dado que ambos conjuntos de características se convirtieron en vectores de longitud fija antes de la fusión, no fue necesario alinearlas a nivel de trama en el tiempo. Las representaciones resultantes de MFCC y wav2vec se concatenaron entonces en un vector de características híbrido de 808 dimensiones antes de ser introducidas en el modelo de clasificación.
Integración con EfficientNet-Lite
El vector de características fusionado, h, se reconfiguró en un formato adecuado para el aprendizaje de características y se proporcionó como entrada al modelo EfficientNet-Lite para su entrenamiento. Una capa de proyección completamente conectada primero mapeó el vector de 808 dimensiones a un espacio latente de mayor dimensionalidad, tras lo cual los bloques EfficientNet-Lite refinaron las características jerárquicas. Se emplearon capas de normalización por lotes y capas de desactivación (dropout) para reducir el sobreajuste y mejorar la generalización del modelo. Se utilizó la función de activación SoftMax para generar las probabilidades finales predichas para las clases de género y edad. La representación fusionada, h ∈ R808, se trató inicialmente como un vector de características unidimensional y se pasó a través de una capa de proyección completamente conectada que la mapeó a 4.096 dimensiones. Luego, la representación proyectada se reconfiguró en un tensor de 1 × 64 × 64 antes de ser suministrada a la arquitectura EfficientNet-Lite.
Para adaptarse a la representación de características de voz de un solo canal, en lugar de la entrada convencional de imagen de tres canales, se modificó la capa convolucional de entrada de EfficientNet-Lite, pasando de tres a un canal de entrada. Los bloques restantes de extracción de características de EfficientNet-Lite se mantuvieron sin modificaciones arquitectónicas importantes. Se aplicó una capa de agrupamiento promedio global adaptable a los mapas de características finales para producir una representación de longitud fija. La cabeza de clasificación original fue reemplazada por una capa completamente conectada específica para la tarea, que contenía dos unidades de salida para la clasificación de género y el número correspondiente de unidades de salida para los grupos de edad predefinidos. Finalmente, se aplicó la función de activación SoftMax para generar las probabilidades de clase. La representación híbrida propuesta combinó incrustaciones de voz modernas auto-supervisadas con características tradicionales de procesamiento de señales. Las incrustaciones wav2vec 2.0 capturaron información contextual y dependencias de largo alcance, mientras que las características MFCC proporcionaron información acústica complementaria de bajo nivel. La integración de estas representaciones mejoró el rendimiento de clasificación, particularmente en condiciones de voz ruidosa y multilingüe.
Clasificador ML
En esta investigación, se analizó el rendimiento de múltiples algoritmos de ML para la clasificación por género y grupo de edad basada en la voz.
Bosque aleatorio
Se utilizó el Bosque Aleatorio (RF) como un clasificador robusto de Aprendizaje Automático (ML), combinando múltiples Árboles de Decisión (DTs) para mejorar la precisión de las predicciones y reducir el sobreajuste. RF funcionó mediante un procedimiento de aprendizaje conjunto en el que se agruparon las predicciones de múltiples árboles para generar la predicción final37,38. Este enfoque permitió a RF captar diversos patrones en los datos al tiempo que reducía el sobreajuste comúnmente asociado con árboles DT individuales. La aleatoriedad introducida durante la construcción de los árboles mejoró la generalización del modelo, haciendo que RF fuera adecuado para tareas de clasificación como la clasificación por género y edad a partir de datos de voz.
Regresión Logística
Se utilizó la regresión logística (RL) como modelo estadístico de aprendizaje automático para clasificación39. Para clasificación binaria, la RL estima la probabilidad de un resultado en función de las características de entrada mediante la función logística (sigmoide), y las probabilidades resultantes se utilizan para generar predicciones de clase. La RL también era aplicable a problemas de clasificación multiclase que involucraban más de dos clases. Para clasificación multiclase, la RL empleó enfoques como uno contra el resto o regresión SoftMax, dependiendo del contexto de clasificación.
Clasificador de árboles extremos
El clasificador Extra Trees (ETC) se utilizó como un algoritmo de aprendizaje conjunto que combina múltiples árboles de decisión (DT) para generar predicciones40,41. A diferencia del bosque aleatorio (RF), el ETC introduce aleatoriedad adicional al seleccionar al azar las características candidatas y los umbrales de división durante la construcción del árbol. Este procedimiento genera árboles menos correlacionados y reduce la sensibilidad del modelo a características individuales, mejorando así la robustez frente al ruido. Se utilizó el índice de Gini como criterio de división para evaluar la importancia de las características y particionar los datos.
Máquina de Vectores de Soporte
Se utilizó una Máquina de Vectores de Soporte (SVM) como clasificador de aprendizaje automático (ML) para identificar un límite de decisión óptimo en un espacio de características de alta dimensión42. El objetivo era determinar un hiperplano que maximizara el margen entre las clases. Un margen más amplio entre el límite de decisión y los puntos de datos más cercanos generalmente favorece una mejor separación de clases y una mayor capacidad de generalización. La SVM es aplicable a varias tareas de aprendizaje automático, incluyendo clasificación, regresión y análisis de datos basado en características.
Redes Neuronales Convolucionales
Se utilizaron redes neuronales convolucionales (CNN) como modelos de aprendizaje profundo (DL) para tareas de clasificación que implican representaciones estructuradas de datos de imagen y audio. Las CNN unidimensionales (1D-CNN) también se han aplicado ampliamente a datos secuenciales y textuales. Las arquitecturas de CNN emplearon filtros convolucionales y operaciones de agrupación para extraer características discriminativas de los datos de entrada43,44. Para la clasificación de género y edad a partir de datos de voz, se aplicaron CNN a representaciones derivadas del habla para aprender patrones asociados con el tono, la frecuencia, el timbre y otras características vocales relevantes para distinguir entre grupos de género y edad.
VGG19
Se utilizó VGG19 como una arquitectura de aprendizaje profundo caracterizada por una estructura jerárquica profunda y relativamente uniforme para la extracción de características45. Su arquitectura empleó filtros convolucionales pequeños de 3 × 3 a lo largo de 19 capas, lo que permitió la extracción progresiva de características discriminativas. Cuando se aplicó a representaciones derivadas del habla, VGG19 capturó tanto patrones acústicos de bajo nivel, como variaciones de tono y frecuencia, como características discriminativas de nivel superior. Su arquitectura profunda permitió una abstracción progresiva de características para modelar las características vocales asociadas con el género y la edad.
EfficientNet-Lite
EfficientNet-Lite se utilizó como una arquitectura de DL eficiente computacionalmente46,47. El modelo empleó una estrategia de escalado equilibrada para lograr un buen rendimiento de clasificación, requiriendo menos recursos computacionales que arquitecturas de DL más pesadas. Su enfoque de escalado compuesto consideró conjuntamente la profundidad, la anchura del modelo y la resolución de entrada para lograr una extracción eficiente de características.
Se seleccionó EfficientNet-Lite para el marco propuesto VoiceNet-RAI debido a su arquitectura ligera y su favorable equilibrio entre el rendimiento de clasificación y la complejidad del modelo. En comparación con arquitecturas más pesadas, utilizó bloques convolucionales eficientes y escalado compuesto para lograr un aprendizaje efectivo de características con menos parámetros y menores requisitos computacionales. Estas características hicieron que EfficientNet-Lite fuera adecuado para el marco de clasificación de voz propuesto y ofrecieron la posibilidad de implementarlo en entornos con recursos limitados.
MobileNet
Se utilizó MobileNet como una arquitectura ligera de aprendizaje profundo (DL) para aplicaciones con recursos computacionales limitados, incluidos entornos de computación móvil y en el borde48. Su eficiencia computacional se logró principalmente mediante convoluciones separables por profundidad, que redujeron el número de parámetros y operaciones computacionales en comparación con arquitecturas convolucionales convencionales. Estas características hicieron que MobileNet fuera adecuado para evaluar la clasificación por género y edad a partir de datos de voz, manteniendo requisitos computacionales relativamente bajos.
InceptionV3
Se utilizó InceptionV3 como una arquitectura profunda para extraer características jerárquicas de representaciones derivadas del habla49. La arquitectura incorporó operaciones convolucionales, de agrupación y mixtas para extraer características a diferentes niveles de abstracción. Para la clasificación de género y edad a partir de datos de voz, InceptionV3 se utilizó para aprender patrones acústicos complejos y representaciones jerárquicas asociadas con variaciones en las características vocales.
Parámetros de evaluación
La precisión fue una de las métricas de evaluación más utilizadas para tareas de clasificación50. Aunque la precisión proporcionaba una medida útil del rendimiento general de la clasificación, no siempre ofrecía una evaluación completa, especialmente para conjuntos de datos desequilibrados. Por lo tanto, se utilizaron métricas adicionales, incluyendo la exactitud (precisión), la recuperación (recall) y la puntuación F1, para evaluar el rendimiento del modelo. Estas métricas proporcionaron una evaluación más completa al considerar las predicciones correctas e incorrectas para cada clase.
La exactitud se definió como la proporción de observaciones clasificadas correctamente respecto al número total de observaciones. Aunque la exactitud era particularmente informativa para conjuntos de datos equilibrados, el conjunto de datos utilizado en este estudio estaba desequilibrado. Por lo tanto, se consideraron los verdaderos positivos (TP), falsos positivos (FP), verdaderos negativos (TN) y falsos negativos (FN) al calcular e interpretar las métricas de clasificación. La ecuación siguiente representa la definición estándar de exactitud:
Precisión = (VP+VN)/(VP+VN+FP+FN)×100 (5)
La precisión evalúa la capacidad del clasificador para devolver únicamente instancias relevantes:
Precisión= TP/(TP+FP) ×100 (6)
La recuperación, también conocida como sensibilidad, mide la capacidad del clasificador para identificar todas las instancias relevantes:
Sensibilidad= TP/(FN+TP) × 100 (7)
El puntaje F1 combina la precisión y la recuperación en una sola medida y es particularmente útil para evaluar el rendimiento de clasificación en conjuntos de datos desequilibrados:
Puntuación F1 = 2 × (PPV × TPR)/(TPR + PPV) × 100 (8)
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Experimental results for age and gender classification were evaluated using MFCC-based and hybrid feature representations with ML and DL models. The dataset was partitioned into training and testing sets at an 80:20 ratio, with 80% used for training and 20% for testing. Speaker-level partitioning was applied to prevent recordings from the same speaker from appearing in both sets.
The hyperparameters and implementation details of the proposed framework are summarized in Table 3...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Este estudio desarrolló y evaluó un marco automatizado para la clasificación por género y edad a partir de datos de voz, integrando características MFCC y embeddings de wav2vec 2.0 con EfficientNet-Lite. En los experimentos iniciales, EfficientNet-Lite alcanzó una exactitud del 83,48 %, una precisión del 82,87 %, una recuperación del 84,28 % y una puntuación F1 del 83,54 % utilizando las características originales. Tras la integración de las características MFCC, el rendimiento mejoró considerablemente, alcanzando una ex...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen conflictos de intereses que declarar.
Agradecimientos
Los autores desean agradecer al Proyecto de Apoyo a Investigadores de la Universidad Princess Nourah bint Abdulrahman número (PNURSP2026R748), Universidad Princess Nourah bint Abdulrahman, Riad, Arabia Saudita, por financiar esta investigación.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Conjunto de voces desafiantes BVC | Biometrics Vision and Computing Group / OgeNI | Conjunto de voces desafiantes BVC | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, variante exacta utilizada | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| Unidad de procesamiento gráfico | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Conjunto de datos Mozilla Common Voice | Fundación Mozilla | Common Voice, versión utilizada en los experimentos | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | Desarrolladores de NumPy | Versión exacta utilizada en los experimentos | https://numpy.org/ |
| Procesador | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Fundación Python Software | Versión exacta utilizada en los experimentos | https://www.python.org/ |
| PyTorch | Fundación PyTorch | Versión exacta utilizada en los experimentos | https://pytorch.org/ |
| Scikit-learn | Desarrolladores de Scikit-learn | Versión exacta utilizada en los experimentos | https://scikit-learn.org/ |
| SciPy | Desarrolladores de SciPy | Versión exacta utilizada en los experimentos | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11, edición/construcción exacta si está disponible | https://www.microsoft.com/windows/windows-11 |
Referencias
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.