Este protocolo integra registros conductuales multimodales para evaluar correlatos observables del esfuerzo cognitivo y la eficacia funcional de la revisión en la traducción escrita y la interpretación simultánea del inglés al chino. Combina el registro de pulsaciones de teclas, la captura de pantalla, el análisis de audio, la codificación basada en transcripciones y la evaluación de calidad estandarizada.
Artículo de método
Un protocolo conductual para evaluar el esfuerzo cognitivo y la revisión estratégica en tareas de traducción y traducción a vista de inglés a chino
En este artículo
Resumen
Resumen
Este artículo presenta un protocolo conductual multimodal para examinar correlatos observables del esfuerzo cognitivo y la revisión estratégica durante la traducción escrita y la interpretación simultánea del inglés al chino. Los registros de pulsaciones de teclas y las grabaciones de pantalla se sincronizan para la traducción escrita, mientras que se utilizan grabaciones de audio y transcripciones textuales para la interpretación simultánea. Los episodios de revisión y autocorrección se codifican por tipo y por resultado funcional (efectivo, neutro o perjudicial), independientemente de las calificaciones globales de calidad del producto. En una demostración con 62 participantes asignados a grupos novatos y entrenados, ambos grupos completaron las dos condiciones de tarea en orden contrabalanceado. Los participantes entrenados obtuvieron puntuaciones medias más altas de calidad del producto en la traducción escrita (20,1 ± 2,1 frente a 16,8 ± 2,3) y en la interpretación simultánea (18,9 ± 2,4 frente a 15,4 ± 2,6), así como una proporción mayor de revisiones o autocorrecciones efectivas. Dado que las pausas, eliminaciones, latencia de inicio y densidad de revisión son indicadores indirectos y sensibles a la tarea, se interpretan como correlatos conductuales que requieren triangulación, en lugar de medidas directas de un constructo unitario. El protocolo está diseñado para textos expositivos controlados y puede adaptarse a otros pares de idiomas tras recalcular los métodos de entrada, los umbrales de pausa, la comparabilidad de los textos y los procedimientos de calificación.
Introducción
La traducción escrita y la interpretación simultánea del inglés al chino requieren comprensión del texto fuente, transferencia entre lenguas y formulación en el idioma de destino, pero imponen condiciones de tarea diferentes. La traducción escrita permite la lectura recursiva y la edición diferida, mientras que la interpretación simultánea exige una producción oral bajo restricciones temporales más estrictas. La carga cognitiva, la dificultad de procesamiento y el esfuerzo cognitivo son constructos relacionados pero no intercambiables: la carga se refiere a las exigencias de la tarea, mientras que el esfuerzo concierne a los recursos que un participante invierte bajo dichas exigencias. El esfuerzo cognitivo es latente y multidimensional; por lo tanto, la latencia, las pausas, las omisiones y la densidad de revisiones se consideran aquí como correlatos conductuales que pueden reflejar planificación, monitoreo, procesos motores o dificultad, y deben interpretarse conjuntamente, y no como mediciones directas del esfuerzo1,2,3,4,5,6,7,8.
La investigación orientada al proceso combina puntuaciones del producto con registros conductuales alineados en el tiempo para identificar cuándo y cómo ocurren las decisiones de traducción. El registro de pulsaciones de teclas proporciona información útil sobre las secuencias de producción y revisión, pero la composición mediante métodos de entrada chinos puede separar los eventos físicos de pulsación de teclas de los caracteres definitivos; por ello, se requiere una grabación de pantalla sincronizada para reconstruir el estado del texto visible9,10,11. Los umbrales de pausa son decisiones analíticas y no límites cognitivos universales, y umbrales más cortos pueden alterar significativamente las conclusiones basadas en pausas8,12. En consecuencia, el protocolo requiere verificaciones explícitas de sincronización, análisis de sensibilidad a los umbrales y diferenciación entre medidas específicas de la tarea y medidas compartidas.
La frecuencia de revisiones por sí sola no indica si el monitoreo mejora un resultado. Las revisiones escritas y las autocorrecciones orales pueden enfocarse en la elección léxica, la sintaxis, el significado o el estilo, pero su resultado funcional debe evaluarse en comparación con el significado original y el segmento meta inmediatamente anterior. La investigación sobre interpretación a la vista en procesamiento inglés-chino y chino-inglés muestra que la formación, la direccionalidad, la coordinación ojo-voz y los desencadenantes específicos del problema lingüístico pueden alterar los patrones de desempeño13,14,15,16. Por esta razón, el tipo de episodio, el resultado del episodio, la calidad del producto final y el comportamiento relacionado con la ejecución se codifican como variables separadas.
El protocolo está diseñado para adultos o traductores/intérpretes capacitados que trabajen con textos expositivos breves y no especializados en sesiones controladas basadas en computadora. Es más adecuado cuando se pueden capturar registros de pulsaciones de teclas y de pantalla para la producción escrita, y se puede grabar audio de alta calidad para la producción oral. El marco puede adaptarse a otros pares de idiomas, pero se debe volver a validar la coincidencia de textos, la segmentación en unidades de información, el comportamiento del teclado o del método de entrada, los umbrales de pausa y los puntos de referencia de calificación para cada par de idiomas y sistema de escritura17. La demostración compara las condiciones de la tarea en lugar de atribuir todas las diferencias únicamente a la modalidad, porque también varían la longitud del texto, los límites de tiempo, el modo de salida y las oportunidades de revisión.
Protocolo
Todos los métodos que implicaron el uso de sujetos humanos se realizaron cumpliendo con las directrices institucionales y recibieron aprobación explícita del Comité de Ética en Investigación con Seres Humanos del Instituto de Tecnología de la Información de Guilin (Número de aprobación: UYHAJ2025899). Se obtuvo el consentimiento informado por escrito de todos los participantes antes de su participación. Consulte la Tabla de materiales para obtener una lista completa del equipo y el software utilizados en este estudio.
1. Reclutamiento de participantes y asignación a grupos
- Reclute a 62 participantes, compuestos por estudiantes de inglés o traducción e intérpretes profesionales en formación. Verifique que todos los participantes sean hablantes nativos de chino con visión y audición normales o corregidas a la normalidad.
- Asigne a los participantes con menos de 12 meses de formación estructurada en traducción al grupo de principiantes, y a aquellos con al menos 12 meses al grupo entrenado. Informe por separado la experiencia previa en traducción escrita y en interpretación simultánea para todos los participantes.
- Examine a los participantes antes de la asignación de tareas para excluir a aquellos con exposición previa a los textos fuente, discapacidad sensorial no corregida o incapacidad para utilizar el método estandarizado de entrada de texto chino.
- Excluya las tareas tras la grabación únicamente por razones preespecificadas, como el uso prohibido de herramientas externas, ejecución incompleta, archivos dañados o audio inutilizable.
- Lleve un registro de exclusión de tareas sin información que identifique personalmente a los participantes. Informe la muestra final analizada de forma consistente en el texto y en la Figura 1A–D.
2. Selección de materiales y evaluación piloto
- Seleccione textos expositivos breves en inglés de dominios académicos generales, educativos, sociales o de comunicación pública. Utilice textos para traducción escrita de aproximadamente 180–220 palabras y textos para interpretación simultánea de aproximadamente 120–160 palabras.
- Iguale o ajuste estadísticamente la longitud del texto, dificultad léxica, complejidad sintáctica, densidad de información y familiaridad con el tema entre las condiciones de la tarea.
- Solicite a tres expertos bilingües que califiquen de forma independiente la dificultad léxica, complejidad sintáctica, densidad de información, familiaridad con el tema y adecuación para la transferencia en una escala de 1 a 5 puntos (1 = muy baja, 5 = muy alta).
- Calcule un coeficiente de correlación intraclase (ICC) de efectos aleatorios bidireccional con un intervalo de confianza del 95 % para las calificaciones promediadas. Revise los ítems que muestren acuerdo deficiente (ICC < 0.75).
- Mantenga pares de textos solo cuando las variables estandarizadas de emparejamiento se encuentren dentro de un margen de tolerancia de ±10 %.
- Defina una unidad de información como la proposición más pequeña en el texto fuente que expresa una idea, relación o evento independientemente evaluable. Resuelva desacuerdos sobre los límites antes de la aplicación de la tarea.
- Realice una prueba piloto de las instrucciones, método de entrada, sincronización, calidad de sonido y límites de tiempo con participantes que no se incluirán en el análisis principal. Registre las distribuciones de tiempos de finalización y la proporción de participantes que alcanzan cada límite de tiempo.
- Revise un texto o límite de tiempo cuando los participantes de la prueba piloto muestren rendimiento de techo/piso, ambigüedad persistente o inestabilidad en la grabación. Documente todos los cambios antes de iniciar el estudio principal.
3. Administración de la tarea y configuración de la grabación
- Evalúe a los participantes individualmente en una habitación silenciosa y aislada acústicamente, utilizando configuraciones estandarizadas de hardware y software.
- Lea un guion estandarizado de instrucciones y permita un elemento de práctica no experimental. Prohíba el uso de diccionarios, motores de búsqueda, inteligencia artificial generativa, traducción automática y corpus externos.
- Equilibre los dos órdenes de tareas (traducción escrita primero frente a interpretación simultánea primero) dentro de cada grupo de entrenamiento y mantenga un intervalo de descanso de 5 minutos.
- Prepare la lista de asignación antes de finalizar el reclutamiento y oculte la asignación hasta que se confirme la elegibilidad. Si se utilizan múltiples textos fuente, equilibre la identidad del texto independientemente del orden de la tarea y conserve una variable de identificación del texto para el análisis.
- Presente el texto fuente en inglés de forma continua e indique al participante que produzca una traducción al chino precisa y natural en el campo de entrada designado. Permita edición ilimitada, pero prohíba estrictamente el pegado de texto externo.
- Aplique el límite máximo de 20 minutos establecido en el estudio piloto sin mostrar un reloj regresivo, y registre si se alcanza dicho límite.
- Capture continuamente la totalidad del proceso de traducción escrita, utilizando un software de registro de pulsaciones de teclas sincronizado con la grabación continua de pantalla. Conserve las traducciones finales junto con los archivos de registro con marcas de tiempo para su posterior extracción conductual.
- Presente el texto fuente de interpretación simultánea en pantalla e indique al participante que comience una versión oral en chino sin tomar notas escritas.
- Aplique de forma consistente el límite máximo de 6 minutos y registre si se alcanza este límite. Distinga una observación con límite de tiempo de una observación completada normalmente.
- Grabe la producción oral mediante software de captura digital de audio. Genere transcripciones verbatim rigurosas a partir de estas grabaciones para facilitar el posterior codificado.
4. Extracción de indicadores del proceso conductual
- Extraiga los correlatos conductuales de la tarea escrita a partir de los archivos de registro, definiendo la latencia inicial como el intervalo desde el inicio del estímulo hasta el primer carácter chino introducido.
- Extraiga el tiempo total de la tarea, el número y duración de las pausas, la tasa de eliminaciones, la densidad de revisiones y la velocidad de producción. Mantenga las marcas de tiempo originales y el denominador exacto utilizado para cada medida normalizada.
- Utilice 2 s como umbral operativo para la pausa escrita. Indique si se incluyen las pausas durante la navegación con el cursor, la selección de texto o la elección de candidatos del método de entrada.
- Extraiga los correlatos conductuales de la tarea oral a partir de la forma de onda y la transcripción verificada, definiendo la latencia de inicio como el intervalo desde la presentación del estímulo hasta la primera emisión significativa en el idioma objetivo.
- Excluya la inhalación, la limpieza de garganta y los sonidos no léxicos abandonados de la latencia de inicio. Extraiga el tiempo total de interpretación, las pausas silenciosas, las pausas rellenas, las repeticiones, los inicios fallidos, las autocorrecciones y la velocidad del habla.
- Defina una pausa silenciosa oral como un silencio dentro del enunciado de al menos 1,0 s. Revise los límites de las pausas comparando la forma de onda y la transcripción verificada, y excluya los silencios iniciales y finales de los conteos de pausas dentro del enunciado.
- Complete un registro de control de calidad para cada tarea aplicada. Documente si el archivo de proceso correspondiente es legible y completo, si la transcripción ha sido verificada y si la codificación se ha completado o resuelto. Mantenga el registro original y registre cualquier corrección en el historial de auditoría.
5. Codificación de la revisión estratégica y la autocorrección oral
- Reconstruya cada revisión escrita alineando el registro de pulsaciones, el video de pantalla y el texto final.
- Trate un episodio como una secuencia continua de acciones de edición dirigidas al mismo segmento objetivo, y cierre el episodio cuando la producción se reanude en otro lugar durante al menos 2 s o se edite un segmento diferente.
NOTA: Para la entrada en chino, distinga los cambios en la composición antes de la confirmación de las eliminaciones del texto objetivo posteriores a la confirmación, y codifique solo estos últimos como revisiones textuales. - Asigne un tipo principal de revisión según cambios semánticos, sintácticos, léxicos o estilísticos. Permita una etiqueta secundaria para casos superpuestos, pero utilice la etiqueta principal para conteos mutuamente excluyentes. Aplique los ejemplos resueltos proporcionados en Archivo Suplementario 1.
- Elabore una transcripción literal con marcas de tiempo antes de codificar la autocorrección oral. Instruya al primer transcriptor para que marque el contenido léxico, pausas rellenas, repeticiones, falsos inicios, interrupciones y segmentos ininteligibles.
- Que un segundo revisor capacitado verifique la transcripción frente al audio y resuelva discrepancias, preservando las marcas de tiempo originales del audio.
- Defina una autocorrección oral como una reformulación manifiesta que sustituye, completa o corrige un segmento inmediatamente anterior en la lengua meta. No infiera monitoreo encubierto únicamente a partir del silencio. Aplique las mismas reglas de decisión léxicas, sintácticas, semánticas y estilísticas a la autocorrección oral.
- Codifique una repetición exacta sin cambio correctivo como disfluencia, un inicio abandonado seguido por una nueva construcción como falso inicio más reparación, y una omisión o mistraducción sin reformulación manifiesta como un error de salida.
- Cuando el audio no esté claro o cuando dos categorías sigan siendo igualmente plausibles, marque el episodio como ambiguo. Mantenga etiquetas provisionales para episodios ambiguos y resuélvalos antes del análisis de fiabilidad.
- Juzgue el resultado funcional comparando los segmentos objetivo previos y posteriores al episodio con la unidad de información fuente y el contexto local del texto meta. Realice este juicio antes de revelar la puntuación holística final. No utilice un cambio en la puntuación holística como definición de efectividad.
- Codifique por duplicado al menos el 20 % de las producciones seleccionadas entre ambos grupos y órdenes de tareas, y calcule la fiabilidad a partir de las codificaciones independientes antes de la resolución.
- Capacite nuevamente y vuelva a codificar si el acuerdo entre evaluadores cae por debajo de un kappa de Cohen de 0,80. Documente este umbral exacto y cualquier acción correctiva realizada.
6. Evaluación de la calidad y modelado estadístico
- Califique cada traducción escrita final y cada interpretación simultánea con la rúbrica analítica de 25 puntos del Archivo Suplementario 1.
- Valore la exactitud, completitud, adecuación léxica, coherencia y naturalidad en el idioma meta de 0 a 5 utilizando los puntos de referencia indicados. No interpole criterios de calificación tras examinar la pertenencia a grupos.
- Instruya a los evaluadores a utilizar tanto el audio como la transcripción verificada para las dimensiones de interpretación simultánea. Analice las pausas y las medidas de disfluencia por separado de las puntuaciones de la rúbrica.
- Capacite a dos evaluadores independientes utilizando el manual de codificación y al menos 10 producciones de práctica, manteniendo a los evaluadores ciegos respecto al grupo de participantes y al orden de las tareas.
- Tras la calificación independiente y la codificación de episodios, calcule la fiabilidad antes de cualquier discusión. Resuelva las discrepancias por consenso y consulte a un tercer evaluador solo cuando no se alcance el consenso.
- Informe un coeficiente de correlación intraclase de efectos aleatorios bidireccionales y acuerdo absoluto para las puntuaciones continuas promediadas de calidad. Informe el kappa de Cohen para el código categórico principal de revisión y un kappa separado para el código de resultado efectivo/neutral/detrimental. Indique el número exacto y el porcentaje de episodios codificados por duplicado.
- Verifique que cada archivo de proceso sea legible y completo antes del análisis, alinee los registros de la tarea escrita con los registros de pantalla correspondientes y verifique las transcripciones frente al audio.
- Registre los fallos de alineación, los problemas de inteligibilidad y las acciones correctivas en un registro de control de calidad. Normalice las medidas de frecuencia utilizando 100 unidades informativas del texto fuente para la frecuencia de pausas y 100 caracteres chinos producidos para la densidad de revisión escrita.
- Codifique el resultado funcional independientemente de la puntuación final de calidad holística. Codifique un episodio como efectivo cuando el segmento posterior a la revisión mejore el texto sin introducir nuevos problemas, como neutral cuando no produzca cambios sustanciales y como perjudicial cuando introduzca un error.
- Calcule la tasa de efectividad como el número de episodios efectivos dividido por el total de episodios clasificables, excluyendo los episodios ambiguos del denominador.
- Analice la demostración como un conjunto de datos exploratorio con medidas repetidas. Especifique el modelo de efectos fijos para predecir la puntuación total de calidad utilizando la condición de la tarea, el grupo de entrenamiento, las métricas de pausa, la densidad de revisión, la tasa de efectividad, la carga de disfluencia y la velocidad del habla.
- Incluya una intersección aleatoria por participante e incluya efectos aleatorios del texto fuente solo si el diseño contiene suficientes textos muestreados independientemente.
- Centre los predictores continuos, revise los residuos y verifique la colinealidad. Informe el método de estimación, la versión del software, β, EE, IC del 95 %, valores p exactos, componentes de varianza, AIC, BIC y R2 marginal/condicional. Describa el análisis como exploratorio y evite afirmaciones causales confirmatorias.
- Exporte un paquete de análisis reproducible que contenga datos desidentificados, diccionario, manual de codificación, rúbrica, detalles del software, guiones y resultados. Confirme que cada valor de figura y tabla pueda rastrearse hasta una variable y un paso de análisis nombrados antes de su publicación.
Resultados
Características basales de los participantes y disponibilidad de datos
El cuestionario incluyó a 62 participantes (31 novatos y 31 entrenados), y la hoja de tareas contenía 124 registros, lo que indica dos registros de tareas completados por participante (Tabla 1). El grupo novato contaba con menos de 12 meses de formación estructurada en traducción (máximo observado, 8,6 meses), mientras que el grupo entrenado tenía al menos 12 meses (mínimo observado, 13,3 meses). Las distribuciones por edad, sexo, duración del aprendizaje del inglés, dominio del idioma y orden de realización de las tareas fueron similares entre los grupos. Figura 1 muestra la muestra final analizada y distingue correctamente los datos específicos de cada tarea: los registros de pulsaciones y grabaciones de pantalla corresponden a la traducción escrita, los audios y transcripciones literales corresponden a la interpretación simultánea, y las calificaciones de calidad se aplican a ambas.
Perfiles conductuales en diferentes condiciones de la tarea
Los perfiles conductuales difirieron entre las dos condiciones de la tarea y entre los grupos de entrenamiento (Tabla 2; Figura 2A–E). La traducción escrita tuvo tiempos de finalización más largos y pausas medias más prolongadas, mientras que la interpretación simultánea presentó más pausas por cada 100 unidades de información bajo el umbral reportado. Dentro de cada condición de tarea, el grupo entrenado completó las tareas más rápidamente y obtuvo puntuaciones medias de producción más altas. Estos contrastes no deben interpretarse como efectos puramente modales, ya que también variaron la longitud del texto, el límite de tiempo, el modo de salida y la posibilidad de revisión. Las pausas no son uniformemente disruptivas: una pausa puede reflejar dificultad no resuelta, planificación exitosa, monitoreo o actividad relacionada con el método de entrada; por ello, las mediciones de pausas se interpretan junto con las mediciones de revisión, entrega y calidad.
Revisión estratégica, autocorrección y modelado predictivo
El marco de codificación separó el tipo de episodio del resultado funcional (Tabla 3; Figura 3A–D). Los participantes entrenados produjeron más episodios de revisión por escrito que los novatos (12,4 ± 3,7 frente a 8,9 ± 3,0 por tarea), mientras que la cantidad total de autorreparaciones orales no difirió significativamente entre los grupos (4,9 ± 1,6 frente a 4,4 ± 1,5 por tarea). Sin embargo, el grupo entrenado tuvo una proporción mayor de episodios efectivos en ambas tareas. El resumen de efectos mixtos reportado en la Tabla 4 presenta asociaciones en lugar de relaciones causales; por lo tanto, la Figura 3E muestra las estimaciones de efectos fijos reportadas y sus intervalos de confianza en lugar de un diagrama causal.
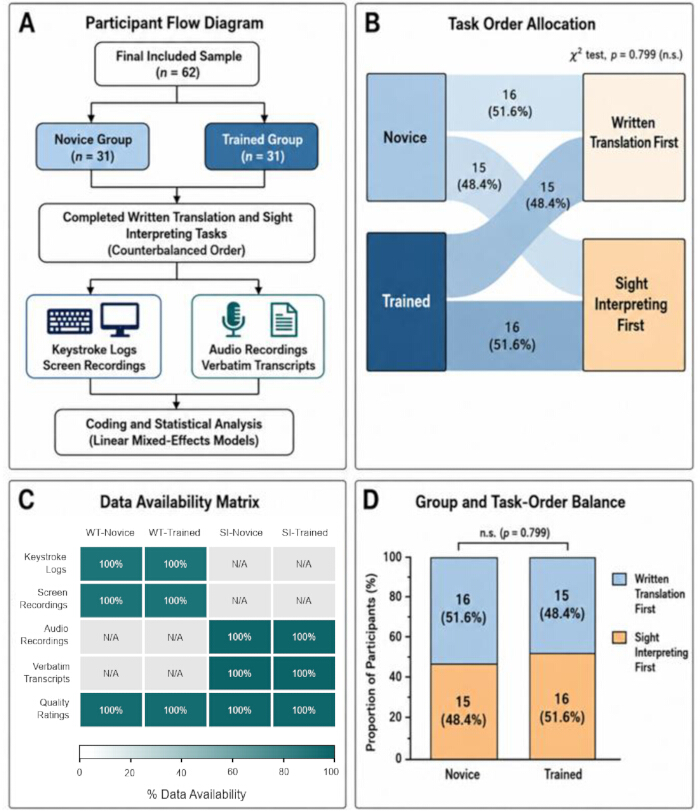
Figura 1: Flujo de participantes, asignación del orden de las tareas y disponibilidad de datos específicos por tarea. (A) Muestra final analizada de 62 participantes y 124 registros de tareas. (B) Asignación contrabalanceada del orden de las tareas dentro de los grupos de principiantes y entrenados. (C) Matriz de disponibilidad en la que los registros de pulsaciones y grabaciones de pantalla son aplicables únicamente a la traducción escrita, las grabaciones de audio y transcripciones literales solo a la interpretación simultánea, y las calificaciones de calidad a ambas tareas. (D) Equilibrio entre grupo y orden (prueba de chi-cuadrado, p = 0.799). n = 62 participantes (31 por grupo). Haga clic aquí para ver una versión más grande de esta figura.
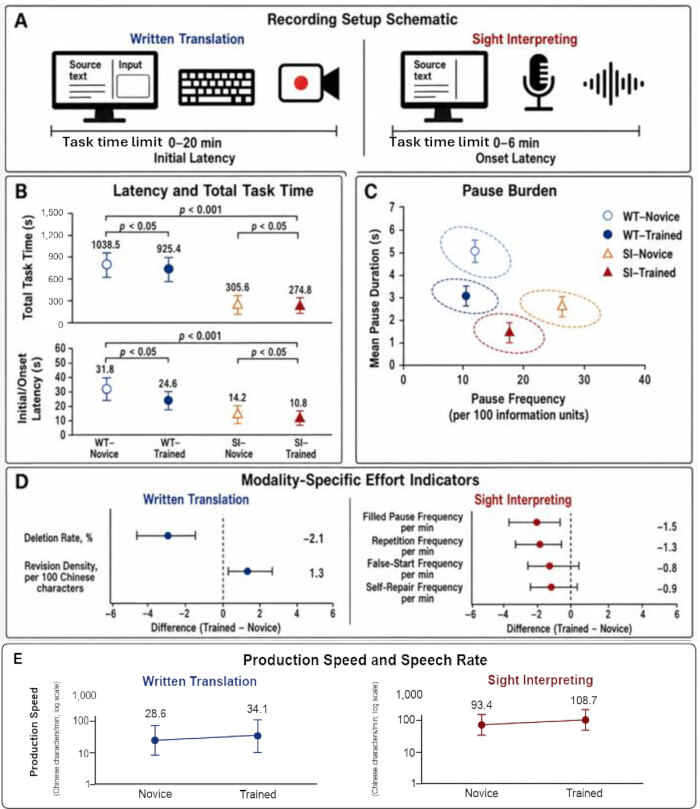
Figura 2: Perfiles conductuales en las condiciones de tarea de traducción escrita e interpretación simultánea. (A) Montaje de grabación específico para cada tarea. (B) Latencia inicial/de inicio y tiempo total de la tarea. (C) Distribución conjunta de la frecuencia de pausas y la duración media de las pausas. (D) Indicadores específicos de cada tarea de eliminaciones, revisiones y disfluencias orales. (E) Velocidad de producción escrita y velocidad de habla oral. En los paneles B, C y E, los puntos y las barras de error muestran las medias del grupo ± DE; en el panel D, los puntos muestran las diferencias medias entre expertos y novatos y las barras de error muestran los intervalos de confianza del 95 %. n = 31 participantes por grupo. En el panel E, el eje y se muestra en escala logarítmica. Haga clic aquí para ver una versión más grande de esta figura.
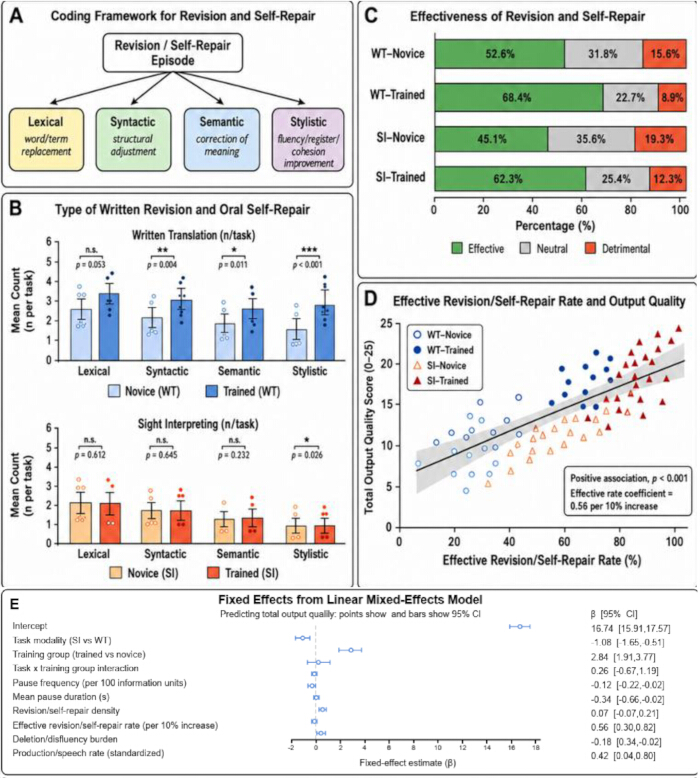
Figura 3: Codificación de revisiones/autorreparaciones, resultados funcionales y asociaciones con la calidad de la salida. (A) Marco de decisión para asignar de forma independiente el tipo de episodio y el resultado funcional. (B) Recuentos promedio de episodios léxicos, sintácticos, semánticos y estilísticos en cada condición de la tarea. (C) Proporciones promedio de episodios efectivos, neutros y perjudiciales. (D) Asociación descriptiva entre la tasa de episodios efectivos y la puntuación total de calidad de la salida. (E) gráfico de bosque que muestra los efectos fijos de un modelo lineal de efectos mixtos con intervalos de confianza del 95 % (detallados en Tabla 4); el gráfico es asociativo y no representa un modelo causal. Haga clic aquí para ver una versión más grande de esta figura.
| Variables | Grupo novato (n = 31) | Grupo entrenado (n = 31) | Valor de p |
| Edad, años | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| Mujeres, n (%) | 22 (71,0) | 21 (67,7) | 0.779 |
| Duración del aprendizaje del inglés, años | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| Puntuación de competencia en inglés | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| Duración de la formación en traducción, meses | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.001 |
| Duración de la formación en interpretación simultánea, meses | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.001 |
| Práctica previa de traducción escrita ≥5 tareas, n (%) | 9 (29,0) | 24 (77,4) | <0.001 |
| Práctica previa de interpretación simultánea ≥5 tareas, n (%) | 5 (16,1) | 20 (64,5) | <0.001 |
| Traducción escrita primero, n (%) | 16 (51,6) | 15 (48,4) | 0.799 |
| Interpretación simultánea primero, n (%) | 15 (48,4) | 16 (51,6) | 0.799 |
Tabla 1: Características de los participantes y perfiles iniciales de entrenamiento lingüístico por grupo. Las variables se presentan como media ± desviación estándar para datos continuos y como frecuencias (porcentajes) para datos categóricos. Los valores de p informados reflejan comparaciones entre grupos para verificar el equilibrio demográfico basal y confirmar las diferencias previstas en la duración del entrenamiento.
| Variables | Traducción escrita Novato (n = 31) | Traducción escrita Entrenado (n = 31) | Interpretación visual Novato (n = 31) | Interpretación visual Entrenado (n = 31) | Efecto de la tarea p | Efecto del grupo p |
| Latencia inicial/de inicio, s | 31,8 ± 12,4 | 24,6 ± 9,7 | 14,2 ± 5,6 | 10,8 ± 4,2 | <0,001 | 0,003 |
| Tiempo total de la tarea, s | 1038,5 ± 168,2 | 925,4 ± 151,6 | 305,6 ± 59,3 | 274,8 ± 50,7 | <0,001 | 0,004 |
| Frecuencia de pausas, por cada 100 unidades informativas | 18,6 ± 6,1 | 14,2 ± 5,0 | 24,8 ± 7,4 | 19,6 ± 6,3 | <0,001 | 0,001 |
| Duración media de la pausa, s | 4,1 ± 1,2 | 3,3 ± 1,0 | 2,7 ± 0,8 | 2,3 ± 0,7 | 0,012 | 0,002 |
| Ritmo de producción/hablado, caracteres chinos/min | 28,6 ± 6,7 | 34,1 ± 7,5 | 93,4 ± 18,9 | 108,7 ± 20,4 | 0,001 | |
| Tasa de eliminación, % | 8,9 ± 3,4 | 6,8 ± 2,7 | 0,009 | |||
| Densidad de revisiones, por cada 100 caracteres chinos | 7,6 ± 2,8 | 8,9 ± 3,1 | 0,087 | |||
| Frecuencia de pausas llenas, por min | 5,7 ± 1,9 | 4,2 ± 1,6 | 0,002 | |||
| Frecuencia de repeticiones, por min | 4,9 ± 1,8 | 3,6 ± 1,4 | 0,004 | |||
| Frecuencia de inicios falsos, por min | 2,8 ± 1,1 | 2,0 ± 0,9 | 0,006 | |||
| Frecuencia de autocorrecciones, por min | 4,8 ± 1,7 | 3,9 ± 1,4 | 0,031 | |||
| Puntuación total de calidad, 0–25 | 16,8 ± 2,3 | 20,1 ± 2,1 | 15,4 ± 2,6 | 18,9 ± 2,4 | 0,002 | <0,001 |
| Precisión, 0–5 | 3,4 ± 0,7 | 4,1 ± 0,6 | 3,1 ± 0,8 | 3,8 ± 0,7 | 0,004 | <0,001 |
| Completitud, 0–5 | 3,3 ± 0,8 | 4,0 ± 0,6 | 3,0 ± 0,8 | 3,7 ± 0,7 | 0,006 | <0,001 |
| Adecuación léxica, 0–5 | 3,2 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,041 | <0,001 |
| Coherencia, 0–5 | 3,5 ± 0,6 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,003 | <0,001 |
| Naturalidad en el idioma de destino, 0–5 | 3,4 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,7 | 0,007 | <0,001 |
Tabla 2: Indicadores del proceso conductual y calidad de los resultados en las distintas condiciones de la tarea y grupos. Los valores se expresan como media ± desviación estándar. Los valores de p informados indican los efectos principales de la modalidad de la tarea (traducción escrita frente a interpretación simultánea) y del historial de formación (novato frente a entrenado) sobre cada variable de proceso y calidad.
| Variables | Traducción escrita Novato | Traducción escrita Entrenado | p valor | Interpretación visual Novato | Interpretación visual Entrenado | p valor |
| Revisión léxica/auto-corrección, n/tarea | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| Revisión sintáctica/auto-corrección, n/tarea | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| Revisión semántica/auto-corrección, n/tarea | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| Revisión estilística/auto-corrección, n/tarea | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| Episodios totales de revisión/auto-corrección, n/tarea | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| Episodios efectivos, % | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| Episodios neutrales, % | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| Episodios perjudiciales, % | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
Tabla 3: Tipo y efectividad de las revisiones escritas y autoreparaciones orales en las distintas condiciones de la tarea. Los tipos de episodios se reportan como recuentos medios por tarea (± desviación estándar), y los resultados funcionales se expresan como porcentajes medios (± desviación estándar). Los valores de p indican la significancia de las diferencias entre grupos dentro de cada modalidad de tarea.
| Efectos fijos | β | EE | IC 95% | valor p |
| Intercepto | 16.74 | 0.42 | 15.91 a 17.57 | <0.001 |
| Modalidad de la tarea: interpretación auditiva frente a traducción escrita | -1.08 | 0.29 | -1.65 a -0.51 | <0.001 |
| Grupo de entrenamiento: entrenado frente a novato | 2.84 | 0.47 | 1.91 a 3.77 | <0.001 |
| Interacción entre modalidad de la tarea y grupo de entrenamiento | 0.26 | 0.47 | -0.67 a 1.19 | 0.581 |
| Frecuencia de pausas, por cada 100 unidades de información | -0.12 | 0.05 | -0.22 a -0.02 | 0.018 |
| Duración media de la pausa, s | -0.34 | 0.16 | -0.66 a -0.02 | 0.041 |
| Densidad de revisiones/autocorrecciones | 0.07 | 0.07 | -0.07 a 0.21 | 0.334 |
| Tasa efectiva de revisión/autocorrección, por incremento del 10% | 0.56 | 0.13 | 0.30 a 0.82 | <0.001 |
| Carga de eliminaciones/disfluencias | -0.18 | 0.08 | -0.34 a -0.02 | 0.027 |
| Tasa de producción/emisión verbal, estandarizada | 0.42 | 0.19 | 0.04 a 0.80 | 0.032 |
Tabla 4: Efectos fijos informados por el modelo lineal de efectos mixtos que predice la calidad total de la producción. El resumen detalla los coeficientes no estandarizados (β), errores estándar (SE), intervalos de confianza del 95 % (IC) y los valores p exactos para todos los predictores de tarea y conducta especificados.
Discusión
Este estudio demuestra un protocolo multimodal para medir indicadores observables de procesos y codificar la revisión estratégica en la traducción escrita y la interpretación simultánea del inglés al chino. El protocolo no mide directamente una variable unitaria de esfuerzo cognitivo. En cambio, la latencia, las pausas, las eliminaciones y los patrones de revisión se interpretan como correlatos conductuales sensibles a la tarea, cuyo significado depende de la triangulación con registros sincronizados y evidencia de la calidad del producto1,2,3,4,5,6,7,8. Ambas tareas también difieren en los materiales, el momento, el modo de salida y la oportunidad de revisión; por lo tanto, los contrastes representativos describen diferencias condicionadas por la tarea, más que efectos aislados de modalidad. La principal contribución analítica es la separación de la frecuencia de revisión del resultado funcional. En los resúmenes presentados, los participantes entrenados realizaron más revisiones escritas, no menos, mientras que el número total de autocorrecciones orales no difirió significativamente entre los grupos. Sus mayores proporciones de episodios efectivos sugieren que el monitoreo de la calidad puede ser más informativo que la frecuencia bruta, aunque esta interpretación depende de reglas de decisión transparentes, codificación independiente de los resultados y fiabilidad informada. El manual de codificación y los ejemplos desarrollados en Archivo Suplementario 1 tienen como objetivo hacer que esta distinción sea reproducible y no promocional.
Los pasos críticos son la alineación entre registros, la calidad del audio, la verificación de la transcripción y la consistencia en la codificación. Deben revisarse las marcas de tiempo disponibles y las señales de límites de tareas al alinear los registros y las grabaciones. El audio debe inspeccionarse para detectar recortes y comprensibilidad antes de la transcripción, y los límites de pausas propuestos deben verificarse frente a la forma de onda y la transcripción. Para entradas en chino, no se deben equiparar las pulsaciones de teclas de composición con revisiones de caracteres confirmados. Estas verificaciones y acciones correctivas deben registrarse en un registro de control de calidad.
Varias limitaciones restringen la interpretación. La demostración utiliza cohortes de estudiantes y aprendices, textos expositivos generales breves, diferentes duraciones de tareas y límites de tiempo, y una muestra basada en disponibilidad. Las condiciones de la tarea también difieren en el modo de salida y las oportunidades de revisión, y el conjunto de datos no contiene identificadores de textos fuente muestreados independientemente para estimar la variación a nivel de texto. Además, los umbrales de pausa son decisiones operacionales, y las pausas más largas pueden reflejar tanto planificación productiva como dificultades no resueltas. La generalización a profesionales, dominios especializados, otros pares de idiomas u otros sistemas de escritura requiere una nueva validación de los materiales, el manejo de los métodos de entrada, los umbrales y los puntos de referencia para la calificación.
Trabajos futuros pueden combinar los registros conductuales con seguimiento ocular, pupilometría o medidas subjetivas de carga de trabajo para probar qué pausas y revisiones corresponden a la atención, al esfuerzo experimentado o a una planificación exitosa5,6,13,14,15,16. Shreve et al. utilizaron seguimiento ocular en la traducción a la vista y no deben citarse como un estudio de pupilometría18; la pupilometría se discute directamente por Seeber5. Dichas extensiones multimodales deben mantener la separación entre la demanda de la tarea, el esfuerzo invertido, la conducta observada y el desempeño. Por lo tanto, el presente protocolo se utiliza mejor como un marco transparente de evaluación de procesos cuyos indicadores respaldan, pero por sí solos no establecen, afirmaciones sobre el esfuerzo cognitivo latente.
Divulgaciones
Los autores no declaran conflictos de intereses comerciales o financieros. En cuanto al uso de inteligencia artificial, los autores informan que OpenAI Codex fue utilizado durante el proceso de revisión únicamente para ayudar con la edición lingüística, verificaciones de coherencia, la preparación de revisiones con seguimiento y la regeneración de diseños de figuras basados en datos proporcionados por los autores. Los autores revisaron minuciosamente todas las salidas asistidas por inteligencia artificial y asumen plena responsabilidad por la exactitud, integridad y originalidad del manuscrito final. El cuaderno estructurado que sustenta los resúmenes reportados está disponible públicamente en Zenodo (https://doi.org/10.5281/zenodo.21189434). El Archivo Suplementario 1 contiene el manual de codificación y la rúbrica de calidad anclada.
Agradecimientos
El autor agradece al Instituto de Tecnología de la Información de Guilin por el apoyo de laboratorio, a los expertos bilingües que evaluaron los textos originales, a los evaluadores independientes y a los participantes. Esta investigación no recibió ninguna subvención específica de ninguna agencia de financiamiento en los sectores público, comercial o sin fines de lucro.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Software de análisis acústico (Praat) | Paul Boersma y David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Computadora de escritorio | Dell | OptiPlex | |
| Software de grabación de audio digital (Audacity) | Equipo de Audacity | https://www.audacityteam.org/ | |
| Software de registro de pulsaciones (Inputlog) | Universidad de Amberes | https://www.inputlog.net/ | |
| Software de grabación de pantalla (OBS Studio) | Proyecto OBS | https://democreator.wondershare.com/ | |
| Software de análisis estadístico (SPSS) | IBM | Version 27 |
Referencias
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Reimpresiones y permisos
Este artículo ha sido publicado
Video próximamente