Este artículo presenta un flujo de trabajo bioinformático reproducible que integra conjuntos de datos transcriptómicos públicos, aprendizaje automático, validación externa, PCR cuantitativa de transcripción inversa, cribado del Mapa de Conectividad y acoplamiento molecular para identificar biomarcadores de hipertensión pulmonar y compuestos terapéuticos candidatos.
Artículo de investigación
Identificación de biomarcadores y compuestos terapéuticos candidatos para la hipertensión pulmonar mediante bioinformática y aprendizaje automático
En este artículo
Resumen
Resumen
Este estudio tuvo como objetivo identificar biomarcadores moleculares asociados a la hipertensión pulmonar (HP) y compuestos candidatos de bajo peso molecular mediante el uso de datos transcriptómicos públicos y recursos de validación independientes. Tres conjuntos de datos del Gene Expression Omnibus (GSE22356, GSE33463 y GSE48149) se integraron tras la normalización, la anotación de sondas y la corrección del efecto de lote mediante ComBat. Se utilizaron análisis de expresión diferencial, análisis de redes de coexpresión génica ponderada, análisis de enriquecimiento funcional, análisis de redes de interacción proteína-proteína y tres algoritmos de aprendizaje automático para identificar genes centrales característicos. El rendimiento diagnóstico se evaluó mediante curvas de característica operativa del receptor. La validación externa incluyó una cohorte independiente de tejido pulmonar (GSE117261), un conjunto de datos de secuenciación de ARN a nivel de célula individual de la arteria pulmonar (GSE210248) y la validación mediante reacción en cadena de la polimerasa con retrotranscripción cuantitativa en muestras independientes de tejido pulmonar. Se empleó la reubicación de fármacos basada en Connectivity Map y el acoplamiento molecular para seleccionar compuestos candidatos. Se identificaron setenta y ocho genes expresados diferencialmente, y CXCL10, JUN, IFIH1, MX1 y TLR7 se seleccionaron como genes centrales característicos. En la cohorte independiente de tejido pulmonar GSE117261, JUN mostró el mayor respaldo externo, mientras que la replicación de los otros genes fue variable. La reacción en cadena de la polimerasa con retrotranscripción cuantitativa en 20 muestras biológicamente independientes de hipertensión arterial pulmonar y 20 muestras de control confirmó la sobreexpresión de los cinco genes. El modelo aparente de qRT-PCR de cinco genes y los análisis de validación cruzada estratificada repetida cinco veces (100 repeticiones) arrojaron un área bajo la curva de 1.000, aunque la pequeña cohorte requiere una interpretación cautelosa y una validación prospectiva independiente. El análisis a nivel de célula individual del conjunto de datos GSE210248 respaldó una alteración en la comunicación entre células inmunitarias y estructurales, así como un cambio fenotípico en las células del músculo liso. BRD-K91900765/VX-745 obtuvo la puntuación más alta en el cribado mediante Connectivity Map. MAPK14/p38α, su diana farmacológica establecida, se incluyó como proteína de referencia positiva en el acoplamiento, mientras que el acoplamiento frente a las cinco proteínas asociadas a biomarcadores se consideró exploratorio. Estos hallazgos respaldan a los cinco genes como biomarcadores candidatos de HP y a VX-745 como una hipótesis computacional de reubicación de fármacos que requiere validación experimental.
Introducción
La hipertensión pulmonar (PH) es un síndrome cardiorrespiratorio progresivo caracterizado por una presión arterial pulmonar elevada de forma persistente, un aumento de la resistencia vascular pulmonar y, eventualmente, insuficiencia ventricular derecha. Los criterios hemodinámicos actuales definen la PH como una presión arterial pulmonar media en reposo de >20 mmHg, medida mediante cateterización del lado derecho del corazón1. Entre los diferentes subtipos clínicos, la hipertensión arterial pulmonar (PAH) es una de las formas más graves y se caracteriza por un remodelado vascular pulmonar progresivo. Sus características patológicas incluyen disfunción endotelial, proliferación y migración anormal de células del músculo liso arterial pulmonar, activación de fibroblastos adventiciales, depósito de matriz extracelular, infiltración de células inflamatorias y estrechamiento u oclusión de las arterias pulmonares distales2. Estos cambios indican que la PH/PAH no es solo un trastorno de vasoconstricción, sino también una enfermedad compleja de remodelado vascular impulsada por mecanismos moleculares, celulares e inmuno-inflamatorios coordinados.
Las terapias actuales para la HAP se dirigen principalmente a las vías de la prostaciclina, endotelina, óxido nítrico–guanilato ciclasa soluble y fosfodiesterasa tipo 53˒4. Aunque estos tratamientos mejoran los síntomas, la capacidad de ejercicio y los parámetros hemodinámicos, sus efectos siguen siendo principalmente vasodilatadores y hemodinámicos. Su capacidad para revertir el remodelado vascular pulmonar establecido es limitada, y muchos pacientes continúan experimentando progresión de la enfermedad a pesar de la terapia combinada. Por lo tanto, la identificación de nuevos biomarcadores moleculares y candidatos terapéuticos que reflejen el proceso de remodelado representa una necesidad médica importante no satisfecha. En particular, la activación inmune-inflamatoria, la señalización relacionada con interferones, las vías de los receptores tipo Toll, el reclutamiento inmune mediado por quimioquinas y el cambio fenotípico de las células musculares lisas han surgido como posibles factores que contribuyen a la progresión de la HP/HAP5˒6.
Los conjuntos de datos transcriptómicos de alto rendimiento proporcionan recursos valiosos para identificar firmas moleculares asociadas a enfermedades en la HP/APH. Sin embargo, los estudios basados en un único conjunto de datos suelen estar limitados por tamaños muestrales pequeños, efectos de lote, heterogeneidad de plataformas y validación insuficiente. El análisis de expresión diferencial puede identificar genes con expresión alterada, pero podría no captar completamente los módulos de coexpresión relacionados con la enfermedad ni las interacciones a nivel de red. El análisis de redes de coexpresión génica ponderada (WGCNA) puede identificar módulos de genes asociados a rasgos de la enfermedad, mientras que el análisis de redes de interacción proteína-proteína (PPI) puede revelar genes altamente conectados dentro de redes biológicas. Los métodos de aprendizaje automático también pueden priorizar genes con valor diagnóstico o de clasificación. No obstante, la dependencia de un solo algoritmo podría introducir sesgos específicos del modelo. Por lo tanto, la integración del análisis de expresión diferencial, WGCNA, análisis de redes PPI y múltiples algoritmos de aprendizaje automático podría mejorar la solidez en el descubrimiento de biomarcadores.
Otro desafío importante en los estudios de biomarcadores transcriptómicos es la interpretación biológica. Las señales de tejido total pueden reflejar cambios en la expresión génica dentro de células vasculares residentes, la infiltración de células inmunitarias o proporciones alteradas de múltiples poblaciones celulares. La secuenciación de ARN a nivel de célula individual ofrece la oportunidad de ubicar los genes candidatos derivados del tejido total en un contexto celular. En la HP/APH, la remodelación vascular pulmonar implica células endoteliales, células musculares lisas, fibroblastos, monocitos/macrófagos, linfocitos y otras células inmunitarias o estructurales. La progresión de la enfermedad también se asocia con una comunicación alterada entre células y el cambio fenotípico de las células musculares lisas. Por lo tanto, combinar el cribado transcriptómico de tejido total con la validación a nivel de célula individual puede ayudar a determinar si los biomarcadores candidatos están asociados con la activación inmunitaria, la remodelación estructural vascular o un desequilibrio en la comunicación multicelular.
Además del descubrimiento de biomarcadores, las firmas transcriptómicas pueden utilizarse para la reubicación computacional de fármacos. El Mapa de Conectividad (CMap) vincula perfiles de expresión génica asociados a enfermedades con moléculas pequeñas que podrían revertir o modular dichas firmas7. Cuando se combina con la curación de compuestos y el acoplamiento molecular, esta estrategia puede generar hipótesis terapéuticas susceptibles de verificación experimental. Aunque la predicción mediante CMap y el acoplamiento molecular no pueden establecer la eficacia de un fármaco, sí pueden priorizar compuestos candidatos para futuros ensayos de unión a dianas, experimentos con células y validación en modelos animales.
Se desarrolló un flujo de trabajo integrado y reproducible para identificar biomarcadores de HP/APH y compuestos terapéuticos candidatos. Se integraron tres conjuntos de datos transcriptómicos públicos del Gene Expression Omnibus tras la normalización y la corrección del efecto de lote. Se utilizaron análisis de expresión diferencial, WGCNA, análisis de enriquecimiento funcional, análisis de redes de interacción de proteínas (PPI) y tres algoritmos de aprendizaje automático para seleccionar genes característicos robustos. El análisis de la curva ROC, una cohorte independiente de validación en tejido pulmonar, evidencia de secuenciación de ARN de célula única en la arteria pulmonar y la validación mediante PCR cuantitativa de transcripción inversa en muestras independientes se emplearon para evaluar aún más los genes seleccionados. Finalmente, se aplicó la reubicación de fármacos basada en CMap y el acoplamiento molecular para identificar compuestos candidatos. La novedad del estudio radica en su marco de validación multinivel, que conecta el descubrimiento transcriptómico en muestras masivas, la priorización mediante aprendizaje automático, la validación independiente, la confirmación experimental mediante PCR cuantitativa de transcripción inversa, la interpretación mecanicista a nivel de célula única y el cribado computacional de compuestos. La hipótesis del estudio fue que la HP/APH está impulsada por un programa coordinado de inflamación inmunitaria y remodelación vascular, y que los genes robustos dentro de este programa podrían servir como biomarcadores candidatos y ofrecer oportunidades de reubicación de fármacos.
Protocolo
Los conjuntos de datos públicos del Gene Expression Omnibus (GEO) analizados en este estudio contenían datos transcriptómicos desidentificados de estudios previamente publicados y no requirieron aprobación ética adicional. El Comité de Ética de la Universidad Huaihua aprobó el estudio independiente de validación mediante reacción en cadena de la polimerasa con retrotranscripción cuantitativa (qRT-PCR) en tejido pulmonar humano (número de aprobación: 2024(A05112)). Se obtuvo consentimiento informado por escrito de todos los participantes o de sus representantes legalmente autorizados antes de la recolección de muestras. Los procedimientos de aprobación y consentimiento se aplicaron a todas las 20 muestras de tejido pulmonar de pacientes con hipertensión arterial pulmonar (PAH) y a las 20 muestras de control incluidas en la validación mediante qRT-PCR. Las herramientas de investigación utilizadas para este protocolo se enumeran en la Tabla de Materiales.
1. Recolección y preprocesamiento de conjuntos de datos transcriptómicos públicos
Los conjuntos de datos de microarreglos relacionados con hipertensión pulmonar (PH) GSE22356, GSE33463 y GSE48149 se obtuvieron de la base de datos GEO. Las muestras de PH/hipertensión arterial pulmonar (PAH) y controles se extrajeron según las anotaciones fenotípicas originales. Las matrices de expresión y los archivos de anotación de la plataforma se descargaron utilizando scripts reproducibles en R y el paquete GEOquery.
Se realizó de manera consistente la anotación de sondas y la asignación de símbolos génicos en todos los conjuntos de datos. Cuando múltiples sondas se asignaban al mismo gen, se calculó el valor medio de expresión. Se aplicó la normalización por cuantiles y se eliminaron los genes con baja expresión o baja varianza. Los conjuntos de datos se combinaron y los efectos de lote se corrigieron utilizando el algoritmo ComBat del paquete sva8. La corrección se evaluó mediante diagramas de caja y análisis de componentes principales.
2. Identificación de genes diferencialmente expresados
Se utilizó el paquete limma para comparar los niveles de expresión entre muestras de PH y controles en la matriz de expresión corregida por lotes9. Se ajustó un modelo lineal y se aplicaron estadísticas bayesianas empíricas. Los genes diferencialmente expresados se definieron utilizando un valor de P ajustado <0.05 y un cambio absoluto en el log2 de la razón > 0.585. Los resultados se visualizaron mediante gráficos de volcan y mapas de calor.
3. Construcción de la red de coexpresión génica ponderada
Se construyó una red de coexpresión génica ponderada utilizando el paquete WGCNA10. Se realizó la agrupación de muestras para detectar valores atípicos. Se seleccionó la potencia de umbralización suave en función del índice de ajuste a la topología libre de escala. Se identificaron módulos génicos mediante el algoritmo de corte dinámico de árboles. Se correlacionaron los eigengenes de los módulos con el fenotipo de HP, y se seleccionó el módulo asociado a la enfermedad con la correlación más fuerte. Los genes del módulo clave se intersectaron con los genes diferencialmente expresados para obtener los genes de consenso.
4. Análisis de enriquecimiento funcional
Se analizaron las categorías de proceso biológico, componente celular y función molecular de Gene Ontology utilizando clusterProfiler11. Se realizó un análisis de enriquecimiento de vías de la Enciclopedia de Kyoto de Genes y Genomas para identificar las vías de señalización12. Se utilizaron un valor de P < 0,05 y un valor de q < 0,2 como umbrales de enriquecimiento, y los términos enriquecidos se visualizaron mediante gráficos de burbujas11.
5. Construcción de la red de interacciones proteína-proteína e identificación de genes centrales
La lista consenso de genes se envió a la base de datos STRING, seleccionando Homo sapiens como especie y un umbral de confianza en la interacción > 0,413. El archivo de interacciones se importó a Cytoscape, y se utilizó el complemento CytoHubba para clasificar los genes según el grado del nodo. Los genes altamente conectados se definieron como genes centrales.
6. Selección de genes característicos diagnósticos mediante aprendizaje automático
Se aplicaron tres algoritmos independientes de selección de características. Primero, se realizó una regresión logística mediante el operador de contracción y selección de mínimos absolutos utilizando el paquete glmnet y validación cruzada de 10 grupos para identificar genes con coeficientes distintos de cero14. Segundo, se aplicó la eliminación recursiva de características con máquinas de vectores de soporte para eliminar características redundantes y seleccionar el subconjunto de características que alcanzó la mayor precisión en la validación cruzada15. Tercero, se construyó un modelo de bosque aleatorio y las características se clasificaron según la disminución media de la impureza de Gini16. Se utilizó la intersección de los conjuntos de genes derivados de los tres algoritmos para definir el conjunto final de genes característicos principales. El paquete pROC se empleó para generar curvas de característica operativa del receptor y calcular los valores del área bajo la curva17.
7. Validación de genes centrales utilizando conjuntos de datos independientes de muestras agrupadas y de célula individual
GSE117261 se utilizó como una cohorte externa e independiente de validación en tejido pulmonar que contenía 58 muestras de HAP y 25 muestras de controles de donantes fallidos18. Este conjunto de datos no se utilizó en el análisis de expresión diferencial de descubrimiento, la construcción de la red de coexpresión génica ponderada ni en la selección de características mediante aprendizaje automático. La matriz de expresión fue normalizada y anotada, y el análisis de expresión diferencial se realizó utilizando limma v3.68.0. Se aplicó la corrección de la tasa de falsos descubrimientos de Benjamini-Hochberg en todo el transcriptoma anotado. Las curvas de característica operativa del receptor (ROC) para un solo gen se calcularon utilizando pROC v1.19.0.1, intervalos de confianza del 95 % de DeLong y puntos de corte del índice de Youden. Se ajustó un modelo exploratorio de regresión logística de cinco genes dentro de GSE117261, y su rendimiento interno se evaluó adicionalmente mediante validación cruzada anidada repetida.
GSE210248 (Tabla 1) se utilizó como conjunto de datos de validación a nivel de célula individual de la arteria pulmonar que contiene muestras de tres pacientes con HAP y tres donantes sanos19. Los datos se procesaron utilizando Seurat v5.5.1 para el control de calidad, la normalización, la reducción de dimensionalidad, la agrupación en clústeres y la anotación celular20. Se identificaron las principales poblaciones celulares, incluyendo células endoteliales, células musculares lisas, fibroblastos, monocitos/macrófagos y células T/células asesinas naturales. La comunicación entre células se analizó utilizando CellChat v2.1.2 y la base de datos de ligandos y receptores CellChatDB.human21. Se creó un objeto CellChat a partir de la matriz de expresión normalizada de Seurat y los metadatos de tipo celular. Se identificaron genes sobrerexpresados e interacciones de ligando-receptor; se calcularon las probabilidades de comunicación; se eliminaron las interacciones que involucraban grupos celulares con menos de 10 células; y se infirieron y agregaron redes de comunicación a nivel de vía. Este conjunto de datos se utilizó únicamente para la validación mecanicista externa y no para el entrenamiento del modelo.
| Elemento | Descripción |
| Conjunto de datos | GSE210248 |
| Tipo de datos | Secuenciación de ARN unicelular basada en gotas de 10x Genomics; perfilado transcriptómico de alto rendimiento |
| Muestras humanas | Tres muestras de arteria pulmonar de PAH y tres muestras de arteria pulmonar de donantes sanos |
| Origen del tejido | Tejido de arteria pulmonar ex vivo, que refleja principalmente la ecología celular de la pared vascular pulmonar y el proceso de remodelación vascular |
| Objetivo analítico principal | Localización de tipos celulares, cambio fenotípico de células musculares lisas, comunicación entre células inmunitarias y estructurales, y validación de consistencia mecanicista de genes candidatos |
Tabla 1: Información básica del conjunto de datos de validación de célula individual GSE210248. La tabla resume el acceso al conjunto de datos, la plataforma de secuenciación, la fuente del tejido, la composición de la muestra y el propósito analítico del análisis de validación de arteria pulmonar a nivel de célula individual.
8. Validación de la expresión génica mediante qRT-PCR
La validación mediante qRT-PCR incluyó 20 muestras de tejido pulmonar de pacientes con HP/HPA independientes desde el punto de vista biológico y 20 muestras de control de tejido pulmonar independientes desde el punto de vista biológico. El ARN total se extrajo utilizando el Total RNA Extraction Kit. La concentración y pureza del ARN se evaluaron mediante un espectrofotómetro, y la integridad del ARN se analizó mediante electroforesis en gel de agarosa. Solo se incluyeron muestras de ARN con valores de A260/280 entre 1,8 y 2,1 y sin degradación visible.
Se transcribieron cantidades iguales de ARN a ADN complementario utilizando el Kit Solarbio Universal RT-PCR (AMV; número de catálogo RP1200). Se realizó PCR cuantitativa para CXCL10, JUN, IFIH1, MX1 y TLR7 utilizando la Mezcla Maestra de PCR con SYBR Green en un Sistema de PCR en Tiempo Real. Cada muestra biológica se analizó en tres réplicas técnicas, junto con controles sin plantilla y sin transcripción inversa. Se utilizó el valor promedio de Ct de las tres réplicas técnicas para el análisis subsiguiente; las réplicas técnicas no se consideraron observaciones independientes. Se utilizaron cebadores que abarcan uniones exón-exón y producen amplicones de 80–200 pb (Tabla 2). La especificidad de los cebadores se verificó mediante el análisis NCBI Primer-BLAST y el análisis de la curva de disociación22.
Se utilizó β-actina (ACTB) como gen de referencia interno para normalizar los niveles de expresión de los genes diana. La expresión relativa se calculó mediante el método 2-ΔΔCt23. Para comparaciones entre grupos, se emplearon pruebas U de Mann-Whitney bilaterales según la distribución de los datos, y se aplicó la corrección de tasa de falsos descubrimientos de Benjamini-Hochberg en los cinco genes. Se generaron curvas ROC de un solo gen con intervalos de confianza del 95 % de DeLong, y los puntos de corte óptimos se seleccionaron utilizando el índice de Youden. El modelo de regresión logística de cinco genes se ajustó e inicialmente evaluó en las mismas 40 muestras biológicas; por lo tanto, esta estimación se definió como el rendimiento aparente dentro de la muestra. Para evaluar un posible sobreajuste, se realizaron 100 repeticiones de validación cruzada estratificada de cinco pliegues utilizando un modelo de regresión logística regularizado con L2, y se calculó el rendimiento ROC agrupado fuera de los pliegues.
| Gen | Acceso RefSeq | Primer directo (5′–3′) | Primer inverso (5′–3′) | Tamaño del producto (pb) | Tm (°C) | Que abarque exones |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Sí |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Sí |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Sí |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Sí |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Sí |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Sí |
Tabla 2: Secuencias de cebadores utilizadas para la PCR cuantitativa de transcripción reversa. La tabla enumera los genes diana, los números de acceso de RefSeq, las secuencias de los cebadores directos e inversos, los tamaños de los productos, las temperaturas de fusión y el estado de los cebadores respecto al cruce de exones utilizados para la qRT-PCR.
9. Selección de compuestos candidatos y acoplamiento molecular
Las firmas génicas centrales reguladas al alza y reguladas a la baja se enviaron a la base de datos Connectivity Map para identificar moléculas pequeñas que se predijo revertirían el perfil de expresión asociado a la HP7. Los candidatos se clasificaron según la puntuación Logit y la probabilidad de predicción.
La estructura tridimensional de BRD-K91900765/VX-745 se obtuvo de PubChem bajo el CID 303852524. La información farmacológica relacionada con el compuesto fue curada a partir de bases de datos públicas de fármacos, y los descriptores estructurales se calcularon utilizando DrugBank y SwissADME25,26. Las estructuras de proteínas se obtuvieron del RCSB Protein Data Bank utilizando los siguientes identificadores PDB: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN; y MAPK14/p38α, 1OUK27. La detección ciega de cavidades y el acoplamiento molecular se realizaron utilizando CB-Dock2 v2.0 con el motor de puntuación AutoDock Vina v1.2.028,29. Los archivos de proteína y ligando se cargaron en CB-Dock2, las cavidades candidatas se detectaron automáticamente, y el acoplamiento se realizó dentro de las cajas específicas para cada cavidad generadas por el servidor. Para cada proteína, se registraron el identificador de la cavidad, la puntuación Vina, el volumen de la cavidad, el centro de la caja de acoplamiento, las dimensiones de la caja de acoplamiento y el archivo del complejo proteína-ligando. La conformación con la puntuación Vina más negativa se seleccionó como la conformación predicha de mayor rango. MAPK14/p38α se incluyó como el blanco farmacológico establecido y la proteína de referencia positiva para el acoplamiento de VX-745. El acoplamiento frente a CXCL10, JUN, IFIH1, MX1 y TLR7 fue exploratorio y no se interpretó como evidencia de un targeting farmacológico directo, unión, inhibición o eficacia.
10. Análisis estadístico y control de la reproducibilidad
Todos los análisis estadísticos se realizaron en R, salvo que se indique lo contrario. Se consideraron estadísticamente significativos los valores de P bilaterales < 0,05. Se aplicó corrección por múltiples pruebas a los análisis de expresión diferencial, enriquecimiento, validación externa y qRT-PCR, tal como se especificó anteriormente. Se utilizó validación cruzada para evaluar la estabilidad de los modelos de aprendizaje automático y del modelo combinado de qRT-PCR.
Resultados
Preprocesamiento de datos transcriptómicos públicos e identificación de genes diferencialmente expresados
La integración y la corrección con ComBat de GSE22356, GSE33463 y GSE48149 redujeron las diferencias sistemáticas entre los conjuntos de datos. Los diagramas de caja mostraron que las distribuciones de expresión de las muestras se volvieron más consistentes tras la corrección. El análisis de componentes principales indicó que las muestras se agrupaban principalmente según el origen del conjunto de datos antes de la corrección, pero se volvieron más entremezcladas después de la corrección, lo que indica una reducción efectiva del efecto de lote (Figura 1).
Utilizando umbrales de un cambio absoluto en el log2 de la razón de expresión >0,585 y un valor de p ajustado < 0,05, se identificaron 78 genes expresados diferencialmente, incluyendo 44 genes regulados positivamente y 34 regulados negativamente (Figura 2A). El mapa de calor mostró que los genes relacionados con interferón, incluyendo XAF1, MX1, IFI44L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 y TLR7, generalmente estaban regulados positivamente en muestras relacionadas con HP. En contraste, los genes relacionados con eritroides, incluyendo HBG1, HBD, ALAS2, CA1 y SLC4A1, tendían a estar regulados negativamente (Figura 2B).
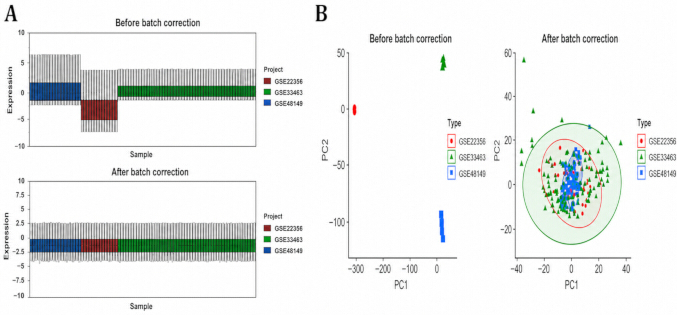
Figura 1: Corrección del efecto por lotes. (A) Diagramas de caja de la matriz de expresión combinada antes y después de la corrección con ComBat. (B) Gráficos de análisis de componentes principales que muestran la distribución de las muestras antes y después de la corrección del efecto por lotes. Haga clic aquí para ver una versión más grande de esta figura.
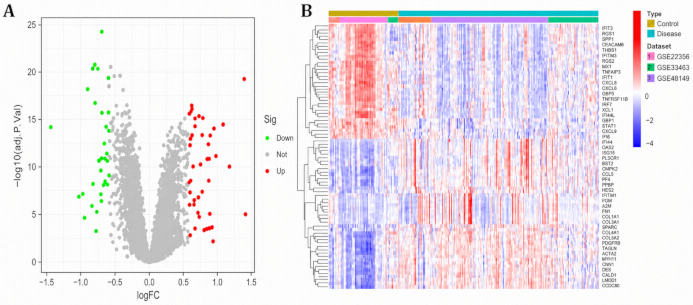
Figura 2: Genes expresados diferencialmente. (A) Gráfico de volcán que muestra los genes regulados al alza y regulados al alza en muestras relacionadas con la HP. (B) Mapa de calor que muestra los genes expresados diferencialmente entre los grupos control y de enfermedad. Haga clic aquí para ver una versión más grande de esta figura.
Construcción de la red de coexpresión génica ponderada y enriquecimiento funcional
La agrupación de muestras mostró una agrupación general estable sin valores atípicos evidentes (Figura 3A). El índice de ajuste de topología libre de escala se acercó a 0,8 con una potencia de 9, y se seleccionó β = 9 para la construcción de la red (Figura 3B). La agrupación de genes y la identificación dinámica de módulos produjeron múltiples módulos de coexpresión (Figura 3C). El módulo azul mostró la asociación más fuerte con el estado de HP (r = 0,55, P = 1 × 10⁻¹⁹), mientras que los módulos turquesa y gris también mostraron correlaciones con HP (Figura 3D).
Los genes de consenso obtenidos mediante la intersección de los genes del módulo clave de análisis de red de coexpresión génica ponderada con los genes diferencialmente expresados se enriquecieron en defensa inmunitaria antiviral, regulación de NF-κB y JAK-STAT, respuestas a factores inflamatorios, unión a receptores de citoquinas y quimioquinas, y regulación transcripcional (Figura 4A). El análisis de enriquecimiento en la Base de Datos Kyoto de Genes y Genomas identificó interacción citoquina-receptor de citoquina, señalización de quimioquinas, señalización de receptores tipo NOD, señalización de receptores tipo Toll, señalización de factor de necrosis tumoral y señalización de interleucina-17 (Figura 4B), lo que respalda la disregulación inmune-inflamatoria como base molecular del remodelado vascular pulmonar.
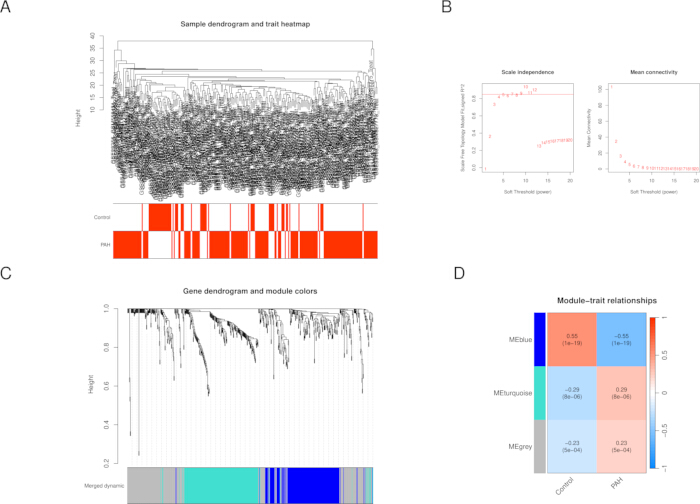
Figura 3: Análisis de red de coexpresión génica ponderada. (A) Árbol de agrupamiento de muestras y mapa de calor de rasgos. (B) Gráfico de selección del umbral suave. (C) Dendrograma de genes y colores de módulos. (D) Mapa de calor de la relación entre módulos y rasgos. Haga clic aquí para ver una versión más grande de esta figura.
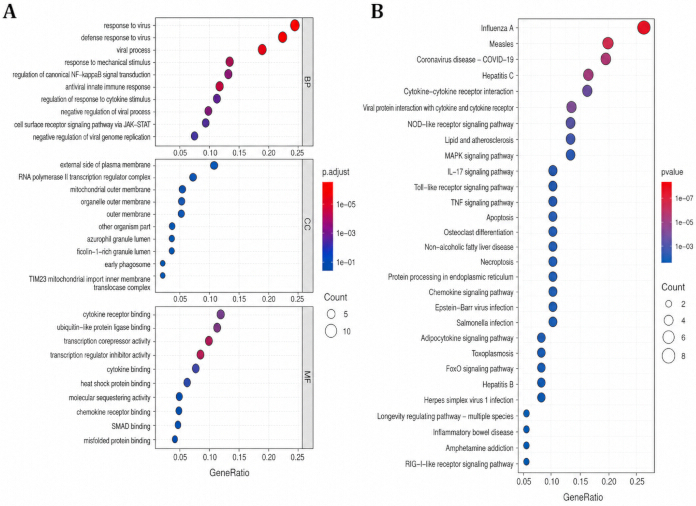
Figura 4: Análisis funcional de enriquecimiento. (A) Resultados del enriquecimiento de Ontología Genética para los genes de consenso. (B) Resultados del enriquecimiento de rutas de la Enciclopedia de Kyoto de Genes y Genomas para los genes de consenso. Haga clic aquí para ver una versión más grande de esta figura.
Red de interacción proteína-proteína y selección de genes centrales
La red de interacciones proteína-proteína STRING construida a partir de los genes de consenso reveló una red inmune-inflamatoria interconectada (Figura 5A). La clasificación CytoHubba basada en grado mostró que FN1, CD44, JUN, TGFB1, CXCL8 y BCL2 presentaban alta conectividad (Figura 5B). Es posible que estos genes centrales participen en la señalización inflamatoria, la adhesión celular, la remodelación de la matriz extracelular y la remodelación estructural del vaso pulmonar.
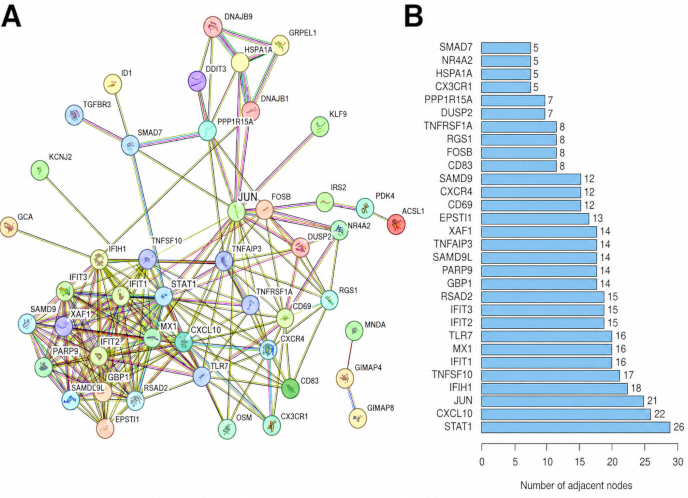
Figura 5: Red de interacciones proteína-proteína y genes centrales. (A) Red de interacciones proteína-proteína de los genes de consenso obtenida mediante STRING. (B) Genes centrales clasificados por grado, identificados mediante CytoHubba. Haga clic aquí para ver una versión más grande de esta figura.
Selección de características mediante aprendizaje automático y rendimiento diagnóstico
La regresión mediante el operador de contracción y selección de mínimos absolutos identificó seis genes candidatos con coeficientes distintos de cero tras la validación cruzada (Figura 6A, B). La eliminación recursiva de características mediante máquina de vectores de soporte conservó ocho genes y obtuvo una precisión de validación cruzada de 0,883 y un error de 0,117 (Figura 7A). El error fuera de bolsa del bosque aleatorio se estabilizó cuando el número de árboles fue ≥100, y los genes IFIH1, JUN y TLR7 se ubicaron entre los principales según la puntuación de importancia (Figura 7B).
La intersección de los resultados del operador de contracción y selección por mínimos absolutos, la máquina de vectores de soporte con eliminación recursiva de características y el bosque aleatorio identificó cinco genes centrales: CXCL10, JUN, IFIH1, MX1 y TLR7 (Figura 8A). El análisis de la curva ROC de un solo gen mostró una discriminación diagnóstica moderada a buena, con valores del área bajo la curva de 0,842 para IFIH1, 0,833 para JUN, 0,827 para TLR7, 0,814 para CXCL10 y 0,759 para MX1 (Figura 8B).
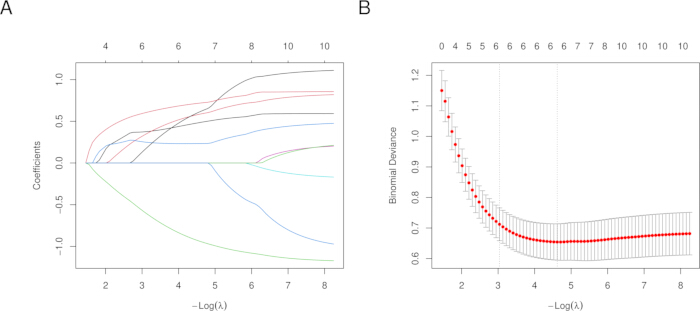
Figura 6: Análisis de regresión mediante el operador de contracción y selección por mínimos absolutos. (A) Trayectoria de coeficientes generada por la regresión mediante el operador de contracción y selección por mínimos absolutos. (B) Gráfico del error de validación cruzada. Haga clic aquí para ver una versión más grande de esta figura.
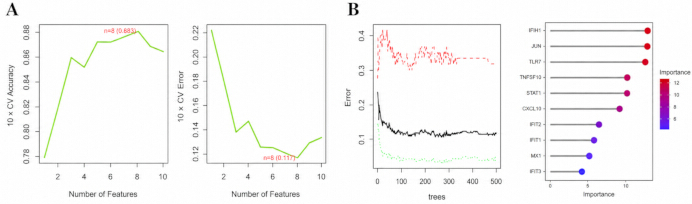
Figura 7: Análisis de máquinas de vectores de soporte con eliminación recursiva de características y bosque aleatorio. (A) Gráfico de selección de características mediante máquinas de vectores de soporte con eliminación recursiva. (B) Modelo de bosque aleatorio y clasificación por importancia de genes. Haga clic aquí para ver una versión más grande de esta figura.
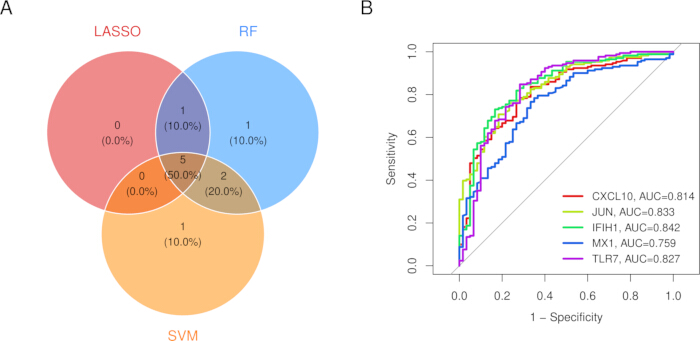
Figura 8: Resumen de aprendizaje automático. (A) Diagrama de Venn que muestra la intersección de los tres algoritmos de selección de características. (B) Curvas de característica de operación del receptor para los cinco genes principales. Haga clic aquí para ver una versión más grande de esta figura.
Validación externa en GSE117261
GSE117261 se utilizó como una cohorte independiente de validación en tejido pulmonar y no se incluyó en la detección de expresión diferencial, la construcción de la red de coexpresión génica ponderada ni en la selección de características mediante aprendizaje automático (Tabla 3). Los resultados completados de validación mostraron una replicación heterogénea entre los cinco genes (Tabla 4). CXCL10 aumentó (cambio en el log₂ de la razón = 0,677; P = 0,0410; FDR = 0,144) y produjo un AUC de 0,639 (IC del 95 %, 0,491–0,786), con un punto de corte de 6,245, sensibilidad de 0,724 y especificidad de 0,600. JUN aumentó (cambio en el log₂ de la razón = 0,463; P = 0,00248; FDR = 0,0194) y produjo un AUC de 0,714 (IC del 95 %, 0,593–0,835), con un punto de corte de 8,708, sensibilidad de 0,707 y especificidad de 0,720.
IFIH1 (cambio de expresión log2 = 0,107; P = 0,371; FDR = 0,591; AUC = 0,543, IC del 95 %, 0,398–0,687), MX1 (cambio de expresión log2 = 0,109; P = 0,488; FDR = 0,690; AUC = 0,475, IC del 95 %, 0,337–0,614) y TLR7 (cambio de expresión log2 = -0,050; P = 0,543; FDR = 0,733; AUC = 0,546, IC del 95 %, 0,414–0,679) no cumplieron los criterios prespecificados de apoyo externo. TLR7 también mostró una dirección opuesta al resultado de qRT-PCR. El modelo exploratorio de cinco genes ajustado y evaluado dentro de GSE117261 arrojó un AUC aparente de 0,740, mientras que la validación cruzada anidada repetida arrojó un AUC de 0,656. Por lo tanto, JUN recibió el respaldo independiente más fuerte, CXCL10 mostró evidencia limitada pero consistentemente direccional, y la replicación de IFIH1, MX1 y TLR7 fue débil o discordante.
| Elemento | Descripción |
| Acceso al conjunto de datos | GSE117261 |
| Origen de los datos | Gene Expression Omnibus (GEO) |
| Tipo de muestra | Datos de microarreglo transcriptómico de tejido pulmonar humano |
| Tamaño de la muestra | 58 muestras de HAP y 25 muestras de controles de donantes fallecidos no utilizados |
| Plataforma | GPL6244 / Affymetrix Human Gene 1.0 ST Array |
| Objetivo de validación | Diferencias de expresión, análisis ROC de un solo gen y modelado ROC exploratorio combinado de cinco genes para CXCL10, JUN, IFIH1, MX1 y TLR7 |
| Papel en este estudio | Conjunto de datos de validación externa independiente; no incluido en los análisis originales de entrenamiento, WGCNA ni selección de características |
Tabla 3: Información básica del conjunto de datos de validación externa independiente GSE117261. La tabla resume la fuente del conjunto de datos, el tipo de muestra, el tamaño de la muestra, la plataforma, los objetivos de validación y el papel de GSE117261 en el estudio.
| Gen/modelo | PAH n | Control n | cambio de expresión log2 | Valor P | FDR | AUC | IC 95% AUC | Umbral de Youden | Sensibilidad | Especificidad |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| Modelo de cinco genes (aparente/dentro de la muestra) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| Modelo de cinco genes (CV anidado repetido) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
Tabla 4: Resultados reales de diferencias de expresión y validación mediante ROC para GSE117261. La tabla muestra los tamaños de las muestras de PAH y controles, los cambios en la expresión log₂, valores de P, valores ajustados por la tasa de falsos descubrimientos, AUC, intervalos de confianza del 95 %, puntos de corte del índice de Youden, sensibilidades, especificidades e interpretaciones para los cinco genes y los modelos combinados exploratorios.
Validación mediante PCR cuantitativa de transcripción inversa
La validación mediante PCR cuantitativa de transcripción inversa incluyó 20 muestras biológicamente independientes de tejido pulmonar de PAH y 20 muestras biológicamente independientes de control, con tres réplicas técnicas promediadas para cada muestra biológica. CXCL10, JUN, IFIH1, MX1 y TLR7 mostraron una regulación positiva significativa en PAH (Tabla 5; Figura 9A). Los valores medios de expresión relativa fueron aproximadamente 3,470 para CXCL10, 2,560 para JUN, 2,760 para IFIH1, 2,650 para MX1 y 2,580 para TLR7. Los valores P correspondientes/valores FDR fueron 1,43 × 10⁻7/7,15 × 10⁻7, 4,17 × 10⁻5/4,17 × 10⁻5, 1,10 × 10⁻5/1,38 × 10⁻5, 1,58 × 10⁻6/2,63 × 10⁻6 y 1,37 × 10⁻6/2,63 × 10⁻6, respectivamente.
El análisis ROC de un solo gen basado en la expresión por qRT-PCR mostró AUC de 0,988 para CXCL10 (IC del 95 %, 0,961-1,000), 0,880 para JUN (IC del 95 %, 0,758-1,000), 0,908 para IFIH1 (IC del 95 %, 0,820-0,995), 0,945 para MX1 (IC del 95 %, 0,874-1,000) y 0,948 para TLR7 (IC del 95 %, 0,886-1,000) (Figura 9B; Tabla 5). El modelo de regresión logística de cinco genes alcanzó un AUC aparente de 1,000 (IC del 95 % de DeLong: 1,000-1,000), con sensibilidad y especificidad de 1,000 (Figura 9C). La consistencia en la dirección de la expresión entre la validación por PCR cuantitativa de transcripción inversa y GSE117261 se visualizó mediante un mapa de calor (Figura 9D). Dado que las mismas 40 muestras se utilizaron tanto para el ajuste como para la evaluación, esto reflejó el rendimiento aparente dentro de la muestra. En 100 repeticiones de validación cruzada estratificada de cinco pliegues utilizando un modelo de regresión logística regularizado con L2, el AUC agrupado fuera de pliegue también se mantuvo en 1,000 (IC del 95 %, 1,000-1,000), y cada repetición produjo un AUC de 1,000. A pesar de esta estabilidad interna, la cohorte era pequeña y sigue siendo necesaria una validación prospectiva independiente. La comparación direccional con GSE117261 mostró aumentos concordantes para CXCL10, JUN, IFIH1 y MX1, pero una dirección discordante para TLR7 (Figura 9D).
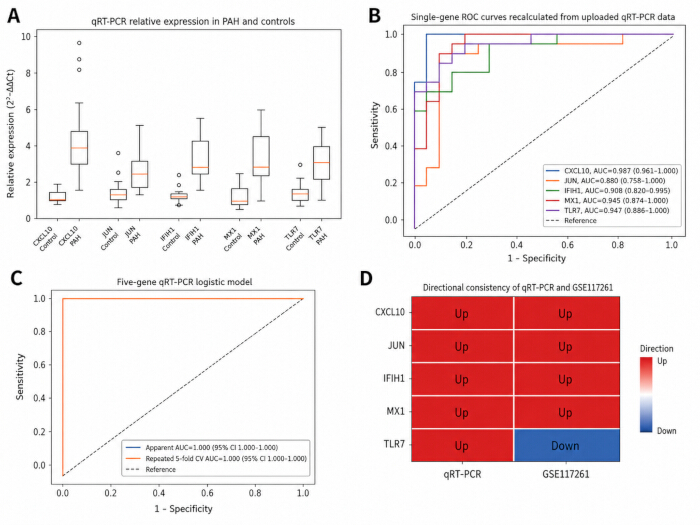
Figura 9: Validación mediante PCR cuantitativa de transcripción inversa. (A) Gráficos de caja que muestran la expresión relativa de CXCL10, JUN, IFIH1, MX1 y TLR7 en 20 muestras biológicamente independientes de tejido pulmonar de PAH y 20 muestras biológicamente independientes de control. Cada muestra biológica se midió en tres réplicas técnicas, y el valor medio de Ct se utilizó para el análisis. En cada gráfico de caja, la línea central representa la mediana, el cuadro representa el rango intercuartílico, los bigotes se extienden hasta 1,5 veces el rango intercuartílico, y los puntos individuales más allá de los bigotes representan valores atípicos. (B) Curvas ROC de un solo gen basadas en los valores de expresión de qRT-PCR; se muestran las AUC y los intervalos de confianza del 95 % de DeLong. (C) Curvas ROC para el modelo de regresión logística de cinco genes, que muestran tanto el rendimiento aparente/dentro de la muestra como el rendimiento agrupado fuera del pliegue procedente de 100 análisis de validación cruzada estratificada repetida de cinco pliegues. (D) Mapa de calor que muestra la consistencia en la dirección de la expresión entre qRT-PCR y GSE117261; CXCL10, JUN, IFIH1 y MX1 aumentaron de forma concordante, mientras que TLR7 fue discordante. Haga clic aquí para ver una versión ampliada de esta figura.
| Gen/modelo | PAH n | Control n | Control 2^-ΔΔCt, media ± DE | PAH 2^-ΔΔCt, media ± DE | Dirección | Valor p | FDR | AUC | IC 95% AUC | Umbral de Youden | Sensi- bilidad | Espe- cificidad | Tipo de validación | ||||
| CXCL10 | 20 | 20 | 1.099 ± 0.502 | 3.470 ± 1.043 | Sobreexpresión | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.000 | 2.028 | 1 | 0.95 | Análisis de qRT-PCR de un solo gen | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | Sobreexpresión | 4.17E-05 | 4.17E-05 | 0.88 | 0.758–1.000 | 1.423 | 0.85 | 0.9 | Análisis de qRT-PCR de un solo gen | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | Sobreexpresión | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.995 | 1.579 | 0.8 | 0.85 | Análisis de qRT-PCR de un solo gen | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | Sobreexpresión | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.000 | 1.779 | 0.9 | 0.9 | Análisis de qRT-PCR de un solo gen | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.444 | 2.580 ± 1.284 | Sobreexpresión | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.000 | 1.764 | 0.85 | 0.9 | Análisis de qRT-PCR de un solo gen | ||||
| Modelo de cinco genes (aparente/dentro de la muestra) | 20 | 20 | No apli- cable | No apli- cable | No aplicable | / | / | 1 | 1.000–1.000 | 0.998 | 1 | 1 | Mismas 40 muestras biológicas utilizadas para ajuste y evaluación del modelo | ||||
| Modelo de cinco genes (CV de 5 pliegues repetido 100×) | 20 | 20 | No apli- cable | No apli- cable | No aplicable | / | / | 1 | 1.000–1.000 | 0.716 | 1 | 1 | Validación cruzada interna mediante regresión logística regularizada L2 | ||||
Tabla 5: Resultados completos de expresión por qRT-PCR y de ROC para CXCL10, JUN, IFIH1, MX1 y TLR7, incluyendo los análisis del modelo combinado de cinco genes. La tabla informa los tamaños muestrales de PAH y controles, los valores de expresión relativa, las direcciones de expresión, valores de P, valores ajustados por la tasa de falsos descubrimientos, AUC, intervalos de confianza del 95 %, puntos de corte del índice de Youden, sensibilidades, especificidades y tipos de validación para los genes individuales y los modelos combinados.
Validación transcriptómica a nivel de célula individual en GSE210248
GSE210248 proporcionó apoyo mecanicista a nivel celular al mostrar que el remodelado arterial pulmonar en la HPA iba acompañado de una comunicación alterada entre células inmunitarias y células estructurales vasculares. Esta observación fue consistente con el enriquecimiento transcriptómico masivo de respuestas inflamatorias, señalización de quimioquinas, señalización del receptor tipo Toll y señalización del factor de necrosis tumoral.
Evidencia a nivel de célula individual sugirió que la red de señalización de la arteria pulmonar por PAH se desplazó hacia células estructurales, incluyendo células musculares lisas y fibroblastos. Las células musculares lisas exhibieron múltiples estados, incluyendo estados similares a células sensibles al oxígeno/pericitos, contráctiles, sintéticos y similares a fibroblastos. Estos resultados respaldan un modelo de enfermedad en el cual la activación inmune-inflamatoria y la remodelación conjunta de células estructurales vasculares impulsan la progresión de la HP/PAH.
Selección de compuestos candidatos y acoplamiento molecular
El cribado mediante Mapa de Conectividad identificó a BRD-K91900765 como el compuesto candidato mejor clasificado entre los 10 primeros resultados, con una puntuación Logit de 10,13 y una probabilidad predicha de 0,085 (Figura 10). La curación del compuesto mostró que BRD-K91900765 corresponde a VX-745/neflamapimod, un inhibidor selectivo de p38α/MAPK14 con un identificador de compuesto en PubChem de 3038525 y una masa molecular de 436,27 g/mol (Tabla 6).
El acoplamiento exploratorio de BRD-K91900765/VX-745 con las cinco proteínas asociadas a biomarcadores produjo puntuaciones máximas de Vina de -7,5 kcal/mol para CXCL10, -7,6 kcal/mol para JUN, -7,5 kcal/mol para IFIH1, -8,7 kcal/mol para MX1 y -8,1 kcal/mol para TLR7 (Tablas 7–11; Figura 11A–E). Estos resultados indicaron únicamente compatibilidad estructural predicha, sin establecer a las cinco proteínas como dianas farmacológicas directas. Predicciones preliminares de absorción, distribución, metabolismo, excreción y toxicidad sugirieron que el compuesto poseía varias propiedades características de fármacos, aunque el valor relativamente alto de cLogP calculado requiere una evaluación adicional (Tabla 12). Se incluyó el acoplamiento contra la diana establecida de VX-745, MAPK14/p38α (PDB ID: 1OUK), como análisis de referencia positivo. La cavidad principal de MAPK14, C1, produjo una puntuación de Vina de -7,9 kcal/mol, un volumen de cavidad de 3560 Å3, un centro de la caja de acoplamiento de (2, 22, 34) y dimensiones de (22, 31, 31) (Tabla 13; Figura 11F).
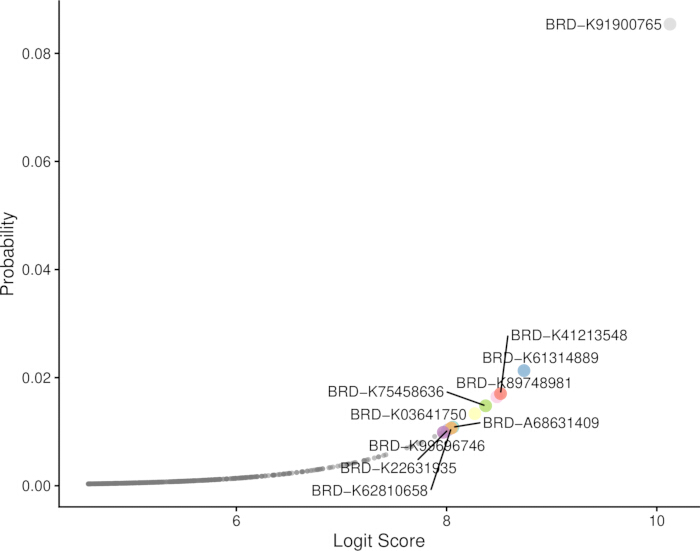
Figura 10: Clasificación de compuestos candidatos del Mapa de Conectividad. Clasificación de los compuestos candidatos identificados mediante el cribado del Mapa de Conectividad. BRD-K91900765 fue el compuesto mejor clasificado, con una puntuación Logit de 10,13 y una probabilidad predicha de 0,085. Haga clic aquí para ver una versión más grande de esta figura.
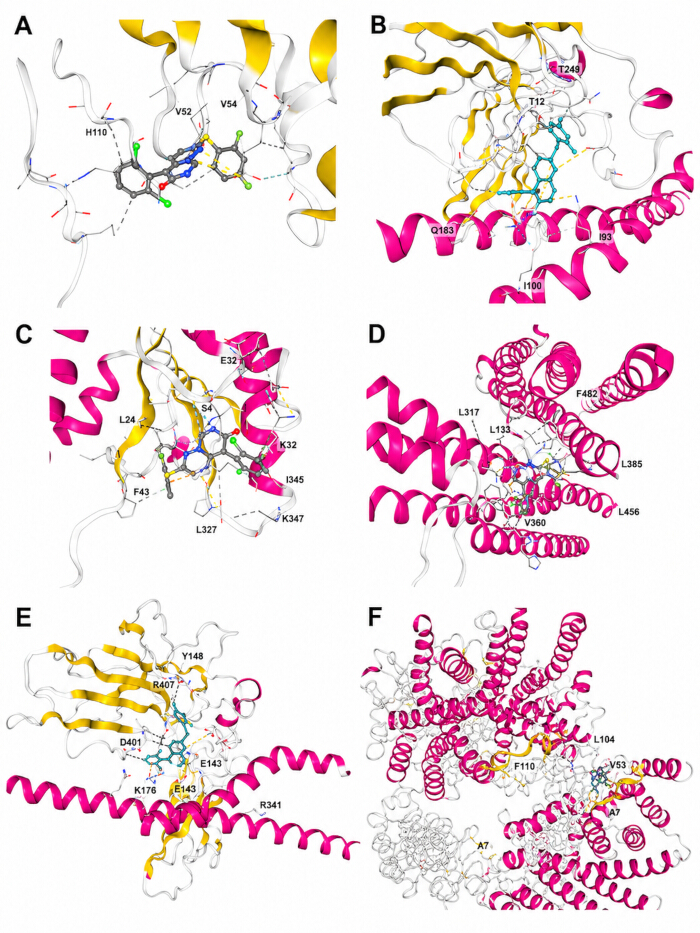
Figura 11: Diagramas tridimensionales de acoplamiento molecular para BRD-K91900765/VX-745. (A) Acoplamiento exploratorio con CXCL10. (B) Acoplamiento exploratorio con JUN. (C) Acoplamiento exploratorio con IFIH1. (D) Acoplamiento exploratorio con MX1. (E) Acoplamiento exploratorio con TLR7. (F) Acoplamiento de referencia positiva con el blanco farmacológico establecido MAPK14/p38α (PDB ID: 1OUK). Los paneles A–E indican compatibilidad estructural predicha y no establecen un direccionamiento farmacológico directo. Haga clic aquí para ver una versión ampliada de esta figura.
| Elemento | Descripción |
| CMap/Broad ID | BRD-K91900765 (formato común de lote: BRD-K91900765-001-xx-x) |
| Nombre común/sinónimos | VX-745; neflamapimod; VRT-031745; VD-31745 |
| Nombre químico | 5-(2,6-diclorofenil)-2-(2,4-difluorofenil)sulfanilpirimido[1,6-b]piridazin-6-ona |
| PubChem CID | 3038525 |
| Número CAS | 209410-46-8 |
| Fórmula molecular / masa molecular relativa | C19H9Cl2F2N3OS; 436.27 g/mol |
| SMILES canónico | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| Objetivo farmacológico principal establecido | MAPK14/p38α; también se ha descrito inhibición de p38β con menor selectividad que p38α |
Tabla 6: Información química y farmacológica para BRD-K91900765/VX-745. La tabla resume los identificadores del compuesto, alias, nombre químico, fórmula molecular, masa molecular, descriptores estructurales y diana farmacológica establecida de BRD-K91900765/VX-745.
| ID de CurPocket | Puntuación de Vina (kcal/mol) | Volumen de cavidad (ų) | Centro (x, y, z) | Tamaño de acoplamiento (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 33, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 22, 22, 22 |
| C3 | -6 | 208 | 34, 15, 9 | 22, 22, 22 |
| C2 | -5.8 | 465 | 45, -6, 19 | 22, 22, 22 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 22, 22 |
Tabla 7: Bolsillos de acoplamiento predichos para BRD-K91900765/VX-745 con CXCL10 (ID de PDB: 1LV9). La tabla muestra los identificadores de cavidad ordenados, las puntuaciones de Vina, los volúmenes de las cavidades, los centros de la caja de acoplamiento y las dimensiones de la caja de acoplamiento generados por CB-Dock2.
| ID de CurPocket | Puntuación de Vina (kcal/mol) | Volumen de cavidad (ų) | Centro (x, y, z) | Tamaño de acoplamiento (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
Tabla 8: Bolsillos de acoplamiento predichos para BRD-K91900765/VX-745 con JUN (ID PDB: 1JUN). La tabla muestra los identificadores de cavidades clasificados, las puntuaciones de Vina, los volúmenes de las cavidades, los centros de la caja de acoplamiento y las dimensiones de la caja de acoplamiento generados por CB-Dock2.
| ID de CurPocket | Puntuación de Vina (kcal/mol) | Volumen de cavidad (ų) | Centro (x, y, z) | Tamaño de acoplamiento (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
Tabla 9: Bolsillos de acoplamiento predichos para BRD-K91900765/VX-745 con IFIH1 (ID de PDB: 3B6E). La tabla muestra los identificadores de cavidades ordenados, las puntuaciones de Vina, los volúmenes de las cavidades, los centros de las cajas de acoplamiento y las dimensiones de las cajas de acoplamiento generados por CB-Dock2.
| ID del bolsillo CurPocket | Puntuación de Vina (kcal/mol) | Volumen de la cavidad (ų) | Centro (x, y, z) | Tamaño de acoplamiento (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 22, 22, 22 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 22 |
| C3 | -7 | 306 | 12, 12, -7 | 22, 22, 22 |
| C2 | -6.9 | 408 | -3, 1, -12 | 22, 22, 22 |
| C5 | -6.2 | 179 | 24, 25, 13 | 22, 22, 22 |
Tabla 10: Bolsillos de acoplamiento predichos para BRD-K91900765/VX-745 con MX1 (ID de PDB: 5GTM). La tabla muestra los identificadores de cavidad ordenados, puntajes de Vina, volúmenes de cavidad, centros del cuadro de acoplamiento y dimensiones del cuadro de acoplamiento generados por CB-Dock2.
| ID de CurPocket | Puntuación de Vina (kcal/mol) | Volumen de cavidad (ų) | Centro (x, y, z) | Tamaño de acoplamiento (x, y, z) |
| C2 | -8.1 | 7347 | 112, 137, 148 | 33, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 22, 22 |
| C1 | -8 | 7676 | 137, 112, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 117, 157, 88 | 22, 22, 22 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 22, 22, 22 |
Tabla 11: Bolsillos de acoplamiento predichos para BRD-K91900765/VX-745 con TLR7 (ID PDB: 7CYN). La tabla muestra los identificadores de cavidades ordenados, las puntuaciones de Vina, los volúmenes de las cavidades, los centros de las cajas de acoplamiento y las dimensiones de las cajas de acoplamiento generados por CB-Dock2.
| Categoría | Parámetro | Resultado | Interpretación |
| Propiedad fisicoquímica | Peso molecular | 436.27 g/mol | Por debajo de 500 Da, cumpliendo el umbral de peso molecular de Lipinski |
| Propiedad fisicoquímica | cLogP | Aproximadamente 5,49 | Ligeramente superior a 5, lo que sugiere una alta lipofilicidad y la necesidad de considerar la solubilidad y la unión no específica |
| Propiedad fisicoquímica | TPSA | Aproximadamente 47,26 Ų | Área superficial polar baja, consistente con una permeabilidad de membrana potencialmente favorable |
| Semejanza a fármaco | HBA/HBD | May-00 | Cumple con los umbrales de Lipinski para aceptores y donadores de enlaces de hidrógeno |
| Semejanza a fármaco | Enlaces rotatables | 3 | Baja flexibilidad conformacional, favorable para conformaciones de unión estables |
| Alertas estructurales | Alertas PAINS/Brenk | No detectado | No se detectaron alertas estructurales comunes de interferencia en ensayos múltiples ni estructuras reactivas |
| Predicción de toxicidad | Mutagenicidad Ames | Predicho no tóxico por Ames | Sugiere un riesgo mutagénico predicho bajo; aún se requiere validación experimental |
| Predicción de toxicidad | Carcinogenicidad | Predicho no carcinogénico | Sugiere un riesgo carcinogénico a largo plazo relativamente bajo; aún se requiere validación experimental |
| Nota farmacocinética | Disponibilidad oral/penetración en cerebro | La literatura y bases de datos indican una molécula pequeña disponible por vía oral y capaz de penetrar en el cerebro | Consistente con su origen como inhibidor de p38α; aún se necesita una reevaluación para indicaciones de PH |
Tabla 12: Predicciones preliminares de propiedades fisicoquímicas, similitud con fármacos, ADMET y toxicidad para BRD-K91900765/VX-745. La tabla resume las propiedades fisicoquímicas predichas, medidas de similitud con fármacos, alertas estructurales, parámetros de toxicidad y características farmacocinéticas. Estas predicciones computacionales son preliminares y no sustituyen la validación experimental de la farmacocinética o la toxicología.
| ID de CurPocket | Puntuación de Vina (kcal/mol) | Volumen de cavidad (ų) | Centro (x, y, z) | Tamaño de acoplamiento (x, y, z) |
| C1 | -7.9 | 3560 | 2, 22, 34 | 22, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 22, 22, 22 |
| C3 | -7.4 | 351 | 12, 7, 37 | 22, 22, 22 |
| C2 | -6.3 | 827 | 18, 5, 28 | 22, 22, 22 |
| C4 | -6.3 | 334 | -16, 17, 38 | 22, 22, 22 |
Tabla 13: Bolsillos de acoplamiento predichos para BRD-K91900765/VX-745 con su diana farmacológica establecida MAPK14/p38α (ID PDB: 1OUK), incluidos como análisis de referencia positiva. La tabla muestra los identificadores de cavidades ordenados, las puntuaciones de Vina, los volúmenes de las cavidades, los centros de las cajas de acoplamiento y las dimensiones de las cajas de acoplamiento generados utilizando el mismo protocolo de acoplamiento aplicado a las cinco proteínas asociadas a biomarcadores.
En conjunto, los análisis de descubrimiento y los resultados de qRT-PCR respaldan a CXCL10, JUN, IFIH1, MX1 y TLR7 como biomarcadores candidatos de HP/PAH asociados con la desregulación inmuno-inflamatoria y el remodelado vascular pulmonar, aunque la replicación independiente en GSE117261 fue más sólida para JUN y variable para los demás genes. BRD-K91900765/VX-745 es un candidato computacionalmente priorizado para reposicionamiento de fármacos con un mecanismo plausible de inhibición de MAPK14/p38α; se requiere validación de unión al blanco, celular, farmacocinética, toxicidad y en modelos animales antes de cualquier interpretación terapéutica.
DISPONIBILIDAD DE LOS DATOS:
Todos los conjuntos de datos transcriptómicos públicos utilizados en este estudio están disponibles en la base de datos Gene Expression Omnibus con los números de acceso GSE22356, GSE33463, GSE48149, GSE117261 y GSE210248. Todos los archivos de código, conjuntos de datos procesados, datos brutos y analizados de qRT-PCR desidentificados, resultados del modelo y archivos de entrada y salida del acoplamiento molecular se han consolidado en un repositorio estructurado de Zenodo. El repositorio incluye un archivo README que describe cada archivo, las versiones del software y los paquetes, el orden de ejecución de los scripts y los pasos completos para su reproducción: https://zenodo.org/records/21682282
Discusión
Se desarrolló un flujo de trabajo integrado y reproducible para identificar biomarcadores moleculares asociados a la HP/APH y compuestos terapéuticos candidatos, combinando transcriptómica pública, análisis de redes de coexpresión génica ponderada, enriquecimiento funcional, análisis de redes de interacción proteína-proteína, tres algoritmos de aprendizaje automático, validación externa, interpretación transcriptómica a nivel de célula individual, confirmación mediante PCR cuantitativa de transcripción inversa, cribado del Mapa de Conectividad y acoplamiento molecular. CXCL10, JUN, IFIH1, MX1 y TLR7 fueron consistentemente priorizados como genes característicos centrales y se asignaron colectivamente a un eje molecular relacionado con la inflamación inmunitaria y la respuesta al interferón. Estos hallazgos respaldan la idea de que la HP/APH no es solo un trastorno hemodinámico, sino también una enfermedad compleja de remodelación vascular que implica activación inmunitaria, señales inflamatorias, detección innata de ácidos nucleicos y cambios fenotípicos celulares y estructurales2,5,6.
El potencial diagnóstico de los cinco genes fue respaldado por la selección de características mediante múltiples algoritmos y por el análisis ROC en la cohorte de descubrimiento. La validación independiente en GSE117261 fue heterogénea en lugar de uniforme: JUN cumplió los criterios prespecificados de FDR y AUC, CXCL10 mostró un aumento nominal consistente en la dirección esperada sin alcanzar significancia de FDR a nivel del transcriptoma, IFIH1 y MX1 mostraron una replicación limitada, y TLR7 mostró una dirección discordante. Estos resultados no respaldan la afirmación de que los cinco genes fueron validados independientemente e indican posibles efectos de la composición de la cohorte, la heterogeneidad tisular, las diferencias entre plataformas y la gravedad de la enfermedad. En contraste, la qRT-PCR en 20 muestras de tejido pulmonar de pacientes con HAP y 20 controles confirmó la regulación positiva significativa de los cinco genes y un desempeño ROC favorable para cada gen individual.
El modelo logístico de qRT-PCR de cinco genes alcanzó un AUC aparente de 1.000 (IC del 95 %, 1.000–1.000), y su AUC agrupado fuera de los pliegues se mantuvo en 1.000 en 100 análisis repetidos de validación cruzada estratificada en cinco pliegues. Sin embargo, el modelo se desarrolló con solo 40 muestras biológicas, y la separación completa en una cohorte retrospectiva pequeña puede generar estimaciones de rendimiento optimistas e inestables. Por lo tanto, el panel debe considerarse una firma molecular exploratoria y no una herramienta diagnóstica clínicamente validada. Se requieren cohortes más grandes y multicéntricas, coeficientes de modelo fijos preespecificados, validación a nivel proteico, inmunohistoquímica y pruebas prospectivas antes de su traslación clínica.
Entre los cinco genes principales, CXCL10 podría promover el reclutamiento de células inmunitarias y la amplificación inflamatoria local dentro del microentorno vascular pulmonar. IFIH1 y TLR7 participan en la detección innata de ácidos nucleicos y podrían reflejar la activación de vías inflamatorias similares a las antivirales. MX1 es un gen clásico estimulado por interferón y podría representar un marcador descendente de la activación de la vía de interferón de tipo I. JUN es un factor de transcripción sensible al estrés que vincula la estimulación inflamatoria con la proliferación celular, la apoptosis y la remodelación del tejido. En conjunto, estos genes sugieren un modelo biológicamente coherente en el que la activación inmunitaria innata y la señalización relacionada con el interferón interactúan con los procesos de remodelación vascular en la HP/APH. Esta interpretación es coherente con evidencia previa que indica que la inflamación, la inmunidad y las vías relacionadas con el interferón contribuyen a la patobiología de la APH2,5,6.
La validación a nivel de célula individual proporcionó un contexto mecanicista para los hallazgos derivados del análisis masivo. GSE210248 sugirió que la remodelación arterial pulmonar en la HPAP se acompañaba de una comunicación alterada entre células inmunitarias y células estructurales vasculares, incluyendo células musculares lisas, fibroblastos, células endoteliales y monocitos/macrófagos. La presencia de múltiples estados fenotípicos en las células musculares lisas, como los estados contráctil, sintético, similar a células sensoras de oxígeno/pericitos y similar a fibroblastos, respalda un modelo de enfermedad en el que la activación inmunitaria y la remodelación estructural de las células ocurren simultáneamente. Esta evidencia celular es importante porque las señales transcriptómicas masivas pueden originarse en cambios en las proporciones celulares, en la infiltración de células inmunitarias o en alteraciones transcripcionales en las células vasculares residentes. Por lo tanto, el análisis a nivel de célula individual sitúa a CXCL10, JUN, IFIH1, MX1 y TLR7 dentro de un ecosistema multicelular de remodelación vascular pulmonar, en lugar de dentro de un proceso restringido a un solo tipo celular18,19,20,21.
El análisis de reposicionamiento de fármacos identificó BRD-K91900765, correspondiente a VX-745/neflamapimod, como el candidato computacional mejor clasificado. VX-745 es un inhibidor selectivo de p38α/MAPK14, y su relación con las vías de estrés inflamatorio hace plausible mecanísticamente su implicación en el contexto de la inflamación asociada a la HP/APH30. Por lo tanto, se incluyó el acoplamiento molecular frente a MAPK14/p38α como un análisis de referencia positiva mecanísticamente relevante. En contraste, el acoplamiento frente a CXCL10, JUN, IFIH1, MX1 y TLR7 fue exploratorio e indicó únicamente compatibilidad estructural predicha; no demostró que estas proteínas asociadas a biomarcadores sean dianas directas de VX-745 ni estableció unión directa, inhibición de la diana o eficacia terapéutica. Una hipótesis más biológicamente plausible es que VX-745 podría modular indirectamente la firma transcripcional inmuno-inflamatoria e interferón-relacionada identificada mediante la inhibición de MAPK14. Las predicciones del mapa de conectividad, las puntuaciones de acoplamiento y las estimaciones ADMET siguen siendo evidencia computacional. Trabajos futuros deberían incluir ensayos bioquímicos de unión a la diana, experimentos en células endoteliales y musculares lisas arteriales pulmonares, modelos de estimulación inflamatoria, evaluaciones farmacocinéticas y toxicológicas, y validación en modelos animales.
Estudios experimentales recientes sobre hipertensión pulmonar hipóxica también han destacado la importancia de la comunicación entre neutrófilos y células vasculares pulmonares. Se ha informado que las interacciones mediadas por HCK entre neutrófilos y células musculares lisas arteriales pulmonares, así como las interacciones mediadas por SERPINB3 entre neutrófilos y células endoteliales, contribuyen al remodelado vascular pulmonar31˒32. El eje SERPINB3–STAT1/3 es particularmente relevante para los hallazgos presentes porque señales relacionadas con interferón, STAT1 y la vía JAK–STAT fueron identificadas en los análisis transcriptómicos. En conjunto, estas observaciones respaldan la interpretación de que la activación de células inmunitarias y su comunicación con células estructurales vasculares podría contribuir a la progresión de la HP/APH.
El estudio tiene varias fortalezas. Se utilizaron múltiples conjuntos de datos públicos y corrección del efecto de lote para reducir el sesgo específico del conjunto de datos. Se combinó el análisis de expresión diferencial, el análisis de redes de coexpresión génica ponderada, el análisis de interacciones proteína-proteína y tres algoritmos de aprendizaje automático para mejorar la solidez de las características. La validación independiente en muestras masivas, la confirmación mediante qRT-PCR y la evidencia a nivel de célula individual proporcionaron capas complementarias pero no idénticas de evidencia. Los hallazgos heterogéneos del GSE117261 y el pequeño tamaño de la cohorte de qRT-PCR también destacan limitaciones importantes, incluyendo una replicación externa incompleta, posibles efectos específicos del tejido y de la plataforma, y el riesgo de sobreajuste. El descubrimiento de biomarcadores también se extendió al cribado de compuestos candidatos, aunque los análisis de acoplamiento molecular siguen siendo generadores de hipótesis. Estudios futuros deberían validar los cinco genes en cohortes independientes más grandes utilizando transcriptómica espacial, proteómica, inmunohistoquímica y modelos de organoides o vasos-en-un-chip. En conjunto, CXCL10, JUN, IFIH1, MX1 y TLR7 siguen siendo biomarcadores candidatos para la HP/HPAA asociados a la remodelación vascular inmuno-inflamatoria y relacionada con interferones, mientras que BRD-K91900765/VX-745 es un candidato computacional para el reposicionamiento de fármacos cuya relevancia terapéutica requiere validación experimental.
Divulgaciones
Los autores declaran que no tienen intereses competidores.
Agradecimientos
Este estudio fue apoyado por el Proyecto de Construcción de la Provincia Innovadora de Hunan (No. 2022JJ30465).
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| 2× Mezcla maestra de PCR con SYBR Green | Beijing Solarbio Science & Technology Co., Ltd. | n.º de catálogo SR1110 | Amplificación por PCR cuantitativa en tiempo real basada en colorante y detección de fluorescencia |
| AI21.msvmRFE.R y e1071 | Script personalizado en R con el paquete CRAN e1071 | AI21.msvmRFE.R; e1071 v1.7-17 | Eliminación recursiva de características mediante máquinas de vectores de soporte |
| Agarosa | Beijing Solarbio Science & Technology Co., Ltd. | n.º de catálogo A8201; CAS 9012-36-6 | Evaluación de la integridad del ARN total mediante electroforesis en gel de agarosa |
| Aparato de electroforesis en gel de agarosa | Beijing Liuyi Biotechnology Co., Ltd. | Modelo DYCZ-24DN | Evaluación electroforética de la integridad del ARN |
| Motor de puntuación AutoDock Vina | Centro de Biología Estructural Computacional, Scripps Research | v1.2.0; RRID: SCR_011958 | Puntuación de la posición del ligando-proteína dentro del flujo de trabajo CB-Dock2 |
| CB-Dock2 | Laboratorio Cao, servidor web CB-Dock2 | v2.0; acceso julio 2026 | Detección ciega de cavidades y acoplamiento molecular de VX-745 con las estructuras proteicas seleccionadas |
| CellChat | Paquete R CellChat | v2.1.2 | Inferencia y visualización de la comunicación célula-célula a partir de la matriz de expresión de célula individual |
| CellChatDB.human | Distribuido con el paquete R CellChat | CellChatDB.human; subconjunto de señalización secretada; umbral mínimo de células = 10 | Base de datos humana de interacciones ligando-receptor para CellChat |
| clusterProfiler | Paquete R Bioconductor | v4.20.0; versión 3.23 de Bioconductor | Análisis de enriquecimiento de Ontología Genética y del Enciclopedia de Genes y Genomas de Kioto |
| Mapa de Conectividad (CMap/CLUE) | Instituto Broad | Recurso L1000/CLUE; RRID: SCR_016204; acceso julio 2026 | Análisis computacional de reposicionamiento de fármacos |
| Primeros oligonucleotídicos personalizados | Beijing Solarbio Science & Technology Co., Ltd. | Sintetizados a medida; las secuencias de los cebadores se proporcionan en la Tabla 2 | Amplificación de ACTB, CXCL10, JUN, IFIH1, MX1 y TLR7 |
| cytoHubba | Tienda de aplicaciones Cytoscape | v0.1 | Clasificación de genes centrales basada en grado en la red de interacción proteína-proteína |
| Cytoscape | Consortium Cytoscape | v3.10.4; RRID: SCR_003032 | Visualización y análisis de redes de interacción proteína-proteína |
| DrugBank | Base de conocimientos DrugBank | v6.0; RRID: SCR_002700 | Curación de identidad de compuestos e información farmacológica |
| Sistema de documentación de geles | Beijing Liuyi Biotechnology Co., Ltd. | Modelo WO-9413B | Visualización y registro de los resultados de integridad del ARN en gel de agarosa |
| Gene Expression Omnibus (GEO) | Centro Nacional de Información Biotecnológica | GSE22356, GSE33463, GSE48149, GSE117261 y GSE210248; RRID: SCR_005012 | Recuperación de conjuntos de datos transcriptómicos masivos y de célula individual |
| GEOquery | Paquete R Bioconductor | v2.80.0; versión 3.23 de Bioconductor | Descarga programática e importación de datos de expresión y fenotipo de GEO |
| glmnet | Paquete R CRAN | v5.0 | Regresión logística con operador de contracción y selección absoluta mínima y modelado logístico regularizado |
| limma | Paquete R Bioconductor | v3.68.0; versión 3.23 de Bioconductor; RRID: SCR_010943 | Análisis de expresión diferencial y estadísticas bayesianas empíricas |
| Espectrofotómetro NanoDrop | Thermo Fisher Scientific | NanoDrop ND-1000; software v3.8 | Medición de la concentración de ARN y de las relaciones de pureza A260/280 y A260/230 |
| NCBI Primer-BLAST | Centro Nacional de Información Biotecnológica | Herramienta web; RRID: SCR_003095; acceso julio 2026 | Verificación de la especificidad de los cebadores |
| pROC | Paquete R CRAN | v1.19.0.1; RRID: SCR_024286 | Análisis de características operativas del receptor, intervalos de confianza de DeLong y puntos de corte del índice de Youden |
| Banco de Datos de Proteínas (PDB) | Banco de Datos de Proteínas RCSB | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | Recuperación de estructuras proteicas determinadas experimentalmente para acoplamiento molecular |
| PubChem | Centro Nacional de Información Biotecnológica | PubChem CID 3038525; RRID: SCR_004284 | Recuperación de la estructura tridimensional e identificadores químicos de BRD-K91900765/VX-745 |
| R | Foundation R para Computación Estadística | v4.6.1; RRID: SCR_001905 | Computación estadística, procesamiento de datos, aprendizaje automático y visualización |
| randomForest | Paquete R CRAN | v4.7-1.2 | Selección de características mediante bosque aleatorio y clasificación de importancia de variables |
| Sistema de PCR en tiempo real | Stratagene, ahora Agilent Technologies | Sistema Mx3000P de PCR en Tiempo Real | Amplificación por qRT-PCR, adquisición de fluorescencia, análisis de curva de fusión y exportación de Ct |
| Seurat | Paquete R CRAN; Laboratorio Satija | v5.5.1; RRID: SCR_016341 | Control de calidad, normalización, reducción de dimensionalidad, agrupamiento y anotación en secuenciación de ARN de célula individual |
| STRING | Consortium STRING | v12.0; RRID: SCR_005223 | Construcción de red de interacción proteína-proteína |
| sva (ComBat) | Paquete R Bioconductor | v3.60.0; versión 3.23 de Bioconductor | Corrección de efectos de lote entre conjuntos de datos |
| SwissADME | Instituto Suizo de Bioinformática | Servidor web; acceso julio 2026 | Preselección de similitud con fármacos, propiedades fisicoquímicas y ADME |
| Kit de extracción de ARN total | Beijing Solarbio Science & Technology Co., Ltd. | n.º de catálogo R1200 | Extracción y purificación de ARN total a partir de muestras de tejido pulmonar |
| Kit RT-PCR universal (AMV) | Beijing Solarbio Science & Technology Co., Ltd. | n.º de catálogo RP1200 | Transcripción inversa de ARN total a ADN complementario |
| WGCNA | Paquete R CRAN | v1.74 | Construcción de red de coexpresión génica ponderada y análisis de módulo-carácter |
Referencias
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.