Este estudio identifica cinco biomarcadores relacionados con la cuproptosis y la ferroptosis en la colitis ulcerosa mediante el aprendizaje automático integrado, la secuenciación de ARN de célula individual y la validación experimental, aportando información sobre el diagnóstico clínico y la inmunoterapia dirigida.
Se requiere una suscripción a JoVE para ver este contenido. Inicie sesión o comience su prueba gratuita.
Artículo de investigación
Abordaje de la ferroptosis y la cuproptosis en la colitis ulcerosa: hallazgos de bioinformática exhaustiva y validación experimental
En este artículo
Resumen
Resumen
La colitis ulcerosa (CU) es un trastorno intestinal persistente con una patogénesis parcialmente definida y tasas crecientes de prevalencia e internación en países recientemente industrializados. En la CU, la muerte excesiva de células epiteliales intestinales altera la barrera mucosa y desencadena respuestas inflamatorias. La ferroptosis y la cuproptosis son dos formas recientemente descritas de muerte celular regulada. La mayoría de los estudios sobre CU han examinado estos procesos por separado; sin embargo, sus funciones combinadas en la progresión de la CU permanecen insuficientemente caracterizadas. Para investigar sus roles sinérgicos en la patogénesis de la CU, utilizamos un enfoque escalonado que incluyó un perfilado transcriptómico a gran escala para identificar dianas candidatas, seguido de validación en modelos in vitro. Los genes diferencialmente expresados (DEG) se intersectaron con genes relacionados con la ferroptosis (FRG) y genes relacionados con la cuproptosis (CRG). Las dianas comunes se priorizaron mediante un consenso de algoritmos de aprendizaje automático y análisis de redes de coexpresión de genes ponderados (WGCNA). Cinco biomarcadores—LCN2, IDO1, CXCL2, NOS2 y CD274—se encontraron significativamente sobreexpresados en la CU. Un análisis a nivel de célula individual caracterizó su expresión en diferentes tipos celulares, observándose que LCN2 y NOS2 se enriquecieron principalmente en células epiteliales. La relevancia mecanicista de estos marcadores se evaluó además mediante ensayos in vitro. El tratamiento con inhibidores de la ferroptosis o de la cuproptosis alivió la inflamación asociada a la CU y moduló la expresión de los biomarcadores en modelos celulares Caco-2. Estos hallazgos identifican cinco biomarcadores asociados con la progresión de la CU y aportan evidencia experimental que respalda su posible aplicación en el diagnóstico clínico y la intervención terapéutica.
Introducción
La colitis ulcerosa (CU) es una enfermedad inflamatoria intestinal recurrente asociada con una carga global creciente y costos sustanciales de tratamiento a largo plazo1,2. Aunque los aminosalicilatos, corticosteroides, terapias biológicas y moléculas pequeñas han ampliado las opciones de tratamiento, lograr una remisión duradera sigue siendo difícil para muchos pacientes3,4. Esta necesidad clínica insatisfecha resalta la importancia de identificar marcadores moleculares reproducibles y mecanismos abordables que puedan facilitar un diagnóstico temprano y un tratamiento guiado por mecanismos5.
La ferroptosis es una forma dependiente del hierro de muerte celular regulada impulsada por la peroxidación lipídica, el agotamiento del glutatión y la actividad deteriorada de GPX46. Los niveles elevados de hierro y malondialdehído en la colitis ulcerosa son compatibles con una lesión epitelial ferroptótica, mientras que la activación experimental del eje SLC7A11–GSH–GPX4 o la inhibición directa de la ferroptosis pueden proteger la barrera intestinal7,8.
La cuproptosis, descrita en 2022, se desencadena cuando el cobre se une a proteínas mitocondriales lipoiladas, lo que provoca agregación proteica y estrés proteotóxico9. Dado que el intestino desempeña un papel central en el metabolismo del cobre, la alteración de esta vía puede amplificar la lesión epitelial oxidativa e inflamatoria en la colitis ulcerosa10.
La ferroptosis y la cuproptosis podrían converger a través del desequilibrio de iones metálicos, el metabolismo mitocondrial, el agotamiento del glutatión y el estrés oxidativo11. Sin embargo, aún no se ha determinado si esta interacción produce una firma molecular reproducible en la colitis ulcerosa ni si dicha firma responde a la inhibición específica de las vías implicadas.
La hipótesis del estudio fue que la interacción disregulada entre ferroptosis y cuproptosis en la colitis ulcerosa converge en una firma reproducible de biomarcadores que puede priorizarse en conjuntos de datos transcriptómicos de población celular completa y de célula individual, y atenuarse mediante la inhibición específica de la vía en un modelo de lesión del epitelio intestinal. Por consiguiente, se integraron bioinformática multicohorte, aprendizaje automático, análisis de célula única y experimentos dirigidos en Caco-2 para identificar y evaluar funcionalmente los biomarcadores candidatos (Figura 1).
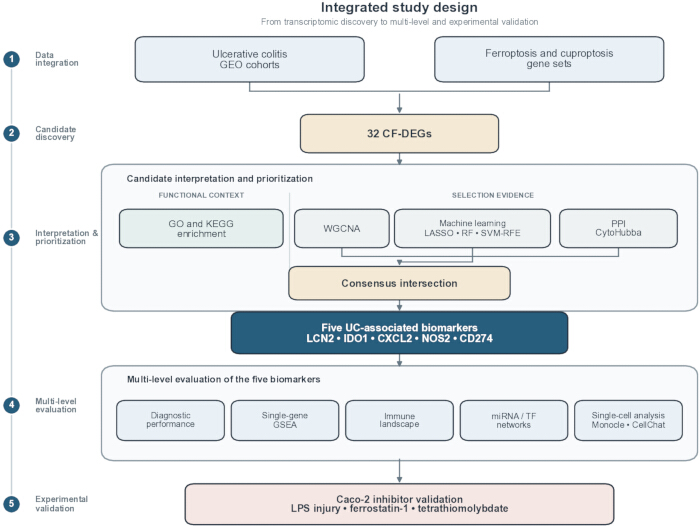
Figura 1: Flujo del estudio. Flujo integrado para el cribado transcriptómico multicohorte, priorización de biomarcadores basada en aprendizaje automático y redes, localización a nivel de célula individual y validación mediante inhibidores en células Caco-2. UC: colitis ulcerosa; GEO: Gene Expression Omnibus; WGCNA: análisis de red de coexpresión génica ponderada; PPI: interacción proteína-proteína; ROC: característica operativa del receptor; GSEA: análisis de enriquecimiento de conjuntos de genes. Haga clic aquí para ver una versión más grande de esta figura.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Protocolo
Este estudio utilizó conjuntos de datos de acceso público y líneas celulares humanas disponibles comercialmente. No se incluyeron participantes humanos, tejidos humanos recién recolectados ni animales vertebrados; por lo tanto, no se requirió la aprobación del comité de ética institucional. Las herramientas de investigación, el software y los recursos en línea utilizados en el protocolo se enumeran en la Tabla de materiales.
1. Procesamiento de datos para el análisis de expresión diferencial
Para establecer los cohortes de descubrimiento y validación transcriptómicos, se realizó una búsqueda en la base de datos Gene Expression Omnibus (GEO) utilizando el término «colitis ulcerosa». Cuatro conjuntos de datos—GSE87466, GSE92415, GSE107499 y GSE75214—se utilizaron como conjunto de entrenamiento, mientras que GSE47908 se reservó para validación externa. Los conjuntos de datos de entrenamiento se normalizaron y corrigieron por lotes mediante ComBat en Sangerbox 3.0, mientras que el conjunto de datos de validación se procesó de forma independiente.
Se obtuvieron un total de 583 genes relacionados con la ferroptosis (FRG) de FerrDB y se complementaron con genes reportados en la literatura para reducir el sesgo de una sola fuente12. Un conjunto de 96 genes relacionados con la cuproptosis (CRG) se compiló a partir de estudios publicados12,13,14. El análisis de expresión diferencial se realizó mediante limma con umbrales de |cambio en el log₂| > 1 y P ajustado por Benjamini–Hochberg < 0,05. Los gráficos diagnósticos de normalización, corrección por lotes, expresión diferencial y agrupamiento se proporcionan en la Figura Suplementaria 1. La composición de las muestras, las plataformas y las asignaciones de las cohortes se detallan en la Tabla Suplementaria 1.
2. Identificación de DEG-FC en la CU
Se realizó un análisis de correlación de Pearson utilizando umbrales de |r| > 0,5 y P < 0,05 para identificar FRG y CRG coexpresados. El conjunto de genes resultante se intersectó con los genes expresados diferencialmente (DEG) para identificar genes expresados diferencialmente con coexpresión de cuproptosis y ferroptosis (CF-DEG).
3. Análisis de enriquecimiento
Se realizaron análisis de enriquecimiento de Gene Ontology (GO) y Kyoto Encyclopedia of Genes and Genomes (KEGG) utilizando clusterProfiler y la plataforma Bioinformatics.com.cn. Se utilizó un valor de P ajustado por Benjamini–Hochberg < 0,05 como umbral de significancia. Los gráficos de enriquecimiento se proporcionan en la Figura Suplementaria 2.
4. Análisis de red de coexpresión génica ponderada (WGCNA)
La estructura modular subyacente a los perfiles de expresión génica se analizó mediante el análisis de red de coexpresión génica ponderada (WGCNA). Las muestras anormales se identificaron y excluyeron mediante agrupamiento jerárquico combinado con la función goodSamplesGenes. Posteriormente, se determinó una potencia adecuada de umbralización suave (β) para cumplir con el criterio de topología libre de escala en la construcción de la red.
Los datos de expresión procesados se utilizaron para construir una matriz de superposición topológica (TOM) para el análisis de coexpresión génica. Mediante el enfoque de corte dinámico de árboles, los genes con patrones de expresión altamente consistentes se organizaron en módulos génicos, cada uno conteniendo al menos 100 genes. Se analizaron las asociaciones entre los eigengenes de los módulos (MEs) y los fenotipos para identificar los módulos asociados con el proceso de la enfermedad y extraer los conjuntos génicos correspondientes. Los diagnósticos de cribado de WGCNA se proporcionan en la Figura Suplementaria 3.
5. Selección de biomarcadores
Para priorizar los candidatos para el seguimiento experimental, se aplicaron en paralelo tres algoritmos de aprendizaje automático15. Se utilizó la regresión mediante el operador de contracción y selección por mínimos absolutos (LASSO, por sus siglas en inglés) para la selección de características, un bosque aleatorio con ntree = 500 para clasificar la importancia de los genes, y una máquina de vectores de soporte con eliminación recursiva de características (SVM-RFE, por sus siglas en inglés) para identificar el subconjunto de características con el menor error de validación cruzada. Los diagnósticos completos del cribado se proporcionan en la Figura Suplementaria 5.
La importancia de los genes se evaluó según la contribución de cada gen individual a la precisión de la clasificación, y se recopilaron los genes con mayor puntuación para generar un conjunto preliminar de genes16. El algoritmo SVM-RFE realizó la selección de características y la optimización del modelo mediante eliminación iterativa de características, lo que permitió identificar el subconjunto óptimo de características para la clasificación17. Los genes comunes a los tres algoritmos se consideraron biomarcadores candidatos identificados mediante aprendizaje automático.
Los genes diferencialmente expresados en la CF (CF-DEGs) se utilizaron para construir una red de interacción proteína-proteína (PPI), y CytoHubba se empleó para clasificar los nodos centrales. La intersección de los módulos clave de WGCNA, las tres salidas del aprendizaje automático y el conjunto central de PPI definió cinco biomarcadores candidatos integrados: LCN2, IDO1, CXCL2, NOS2 y CD274. Estos genes se clasificaron como candidatos diagnósticos asociados a la colitis ulcerosa (UC). Experimentos posteriores con inhibidores clasificaron además a LCN2, IDO1, CXCL2 y NOS2 como marcadores sensibles a la inhibición de la ferroptosis y a CD274 como un marcador sensible a la inhibición de la cuproptosis. No se consideró que estos genes fueran reguladores upstream demostrados de ninguna de las dos vías.
6. Desarrollo del modelo predictivo y evaluación multimétodo
Para evaluar el potencial clínico de traslación de la firma génica identificada, se construyó un nomograma utilizando el paquete rms para evaluar el rendimiento diagnóstico. El rendimiento del modelo se evaluó mediante una curva de calibración, la prueba de Hosmer-Lemeshow (HL) y el índice de concordancia de Harrell (índice C).
La calibración del modelo se evaluó utilizando la prueba de Hosmer-Lemeshow (HL) y el error absoluto medio (MAE). Se establecieron como umbrales un valor de P > 0,05 y un MAE < 0,1 para un ajuste y una precisión del modelo aceptables, respectivamente. Se generaron curvas de característica operativa del receptor (ROC) y se calculó el área bajo la curva (AUC) para evaluar el rendimiento predictivo del nomograma para la colitis ulcerosa (UC). Se utilizó un conjunto de datos independiente para evaluar la generalización y estabilidad del modelo.
7. Análisis de enriquecimiento de conjuntos de genes (GSEA)
En el conjunto de entrenamiento, se realizó un análisis de correlación de Spearman entre cada biomarcador y todos los demás genes. Los resultados de correlación se ordenaron para generar un conjunto de genes clasificados. Se llevó a cabo un análisis de enriquecimiento de conjuntos de genes (GSEA) utilizando el conjunto de genes c2.cp.kegg_medicus.v2025.1.Hs.symbols de la Base de Datos de Firmas Moleculares (MSigDB) como referencia. Las vías biológicas con P < 0,05 se consideraron significativamente enriquecidas.
8. Análisis del paisaje inmunitario
La herramienta CIBERSORT y la matriz de firmas LM22 se utilizaron para realizar el análisis de desconvolución de los datos de expresión y estimar las proporciones de los 22 subtipos de células inmunitarias. Posteriormente, se realizó un análisis de correlación de Spearman para evaluar las asociaciones entre los cinco biomarcadores y los subtipos de células inmunitarias.
9. Análisis de la red reguladora
Se obtuvo información sobre la regulación de factores de transcripción (TF) y microARN (miARN) relacionados con genes a partir de las bases de datos integradas ChEA3 y TarBase 9.0 mediante la plataforma NetworkAnalyst. Se incluyeron en la red reguladora los miARN asociados con al menos dos nodos.
10. ARN-seq de una sola célula
Los conjuntos de datos de células individuales de UC GSE116222, que comprenden tres muestras sanas y tres muestras de UC, y GSE214695, que comprenden seis muestras sanas y seis muestras de UC, fueron integrados. Las células se conservaron cuando contenían entre 200 y 5.000 genes detectados, >1.000 identificadores moleculares únicos, < 30% de transcritos mitocondriales, < 3% de transcritos de hemoglobina, y < 50 % de transcritos ribosomales. Se utilizó la función NormalizeData para la normalización, y Harmony se empleó para la corrección de lotes antes del agrupamiento y la anotación.
Después del filtrado, los datos se normalizaron utilizando la función NormalizeData. Se utilizó Harmony para minimizar los efectos de lote entre las muestras. Se aplicaron la aproximación uniforme de variedades y proyección (UMAP) y el incrustado estocástico de vecinos distribuido en t (t-SNE) para la reducción de dimensionalidad y la agrupación de células, con el fin de caracterizar las estructuras locales y globales dentro de la población celular. Se conservaron un total de 31.712 células de alta calidad para análisis posteriores. Los tipos celulares se anotaron según los genes marcadores canónicos de células.
Se realizó un análisis de pseudotiempo utilizando Monocle 2 para investigar los cambios en los estados de las células epiteliales y mieloides procedentes de tejidos de CU. Se evaluaron las trayectorias de desarrollo celular y las diferencias entre grupos, y se visualizaron los patrones de expresión de biomarcadores a lo largo de la trayectoria de pseudotiempo.
CellChat se utilizó para evaluar la comunicación entre células epiteliales y subpoblaciones de células mieloides. Se integraron patrones de expresión específicos de subpoblaciones para inferir probabilidades de interacción y vías de señalización clave entre células epiteliales y mieloides, y para caracterizar sus potenciales redes reguladoras intercelulares.
11. Experimentos con células
Las células de adenocarcinoma de colon humano Caco-2 se cultivaron en medio de Eagle modificado por Dulbecco que contenía 10% de suero bovino fetal, 100 U/mL de penicilina y 100 µg/mL de estreptomicina a 37 °C en una atmósfera con 5% de CO₂. Las células Caco-2 fueron seleccionadas como un modelo reproducible de monocapa epitelial para ensayos de barrera intestinal y lesión inflamatoria; sin embargo, su origen maligno limita la extrapolación directa al epitelio colónico no maligno. La información sobre los pasajes no estaba disponible en los registros experimentales archivados.
Se estableció un modelo in vitro de inflamación-lesión mediante la exposición de las células a 1 µg/mL de lipopolisacárido (LPS) durante 24 h. Las células se asignaron a un grupo control con vehículo de dimetilsulfóxido, un grupo con solo LPS, un grupo con LPS + 4 µM de ferrostatina-1 o un grupo con LPS + 40 µM de tetratiomolibdato, con concentraciones finales de solvente equivalentes. El grupo con solo LPS sirvió como control positivo de lesión/modelo para las comparaciones de rescate con inhibidores.
- Viabilidad celular
La viabilidad celular se evaluó mediante un ensayo de viabilidad celular según las instrucciones del fabricante. Después de la incubación a 37 °C durante aproximadamente 2 h, se midió la absorbancia a 450 nm utilizando un lector de microplacas. - Medición de los niveles de MDA y Fe²⁺
Los niveles intracelulares de malondialdehído (MDA) y Fe2⁺ se midieron utilizando los kits de ensayo correspondientes según las instrucciones de los fabricantes. La proteína total se cuantificó mediante un ensayo de ácido bicinconínico, y cada resultado se normalizó respecto al contenido proteico de la muestra correspondiente. - Ensayo con sonda fluorescente de iones de cobre
Tras la eliminación del medio de cultivo, se añadió una sonda fluorescente específica para Cu2⁺ a una concentración final de 1 µM y se incubó durante 30 min a 37 °C. Las imágenes se adquirieron inmediatamente sin lavado, utilizando un microscopio de fluorescencia invertido con longitudes de onda de excitación y emisión de 510 y 578 nm, respectivamente. Los parámetros de adquisición se mantuvieron constantes entre los grupos, y la barra de escala de las imágenes se calibró a 50 µm. - RT-qPCR
El ARN total se aisló utilizando un reactivo de extracción de ARN basado en fenol–guanidinio. Se sintetizó ADN complementario a partir de 1 µg de ARN utilizando un kit de síntesis de primera cadena de ADN complementario, y se emplearon reactivos basados en SYBR Green para la PCR en tiempo real. Cada reacción se realizó por triplicado técnico. Las secuencias de los cebadores se proporcionan en Supplementary Table 2, y la abundancia relativa de ARN mensajero se calculó utilizando el método 2⁻ΔΔCt.
12. Análisis estadístico
La normalidad y la homogeneidad de la varianza se evaluaron mediante las pruebas de Shapiro-Wilk y de Levene centrada en la mediana, respectivamente. Los datos que cumplían ambos supuestos se analizaron utilizando una prueba t no apareada de dos colas o un análisis de varianza de un solo factor seguido de la prueba de diferencia significativa honesta de Tukey. Cuando no se cumplía alguno de los supuestos, se utilizó la prueba t de Welch o el análisis de varianza de Welch seguido de comparaciones de Games-Howell.
Los resultados se presentan como media ± desviación estándar. Las cuentas reales de réplicas biológicas, los valores P exactos bilaterales y las comprobaciones de supuestos se informan en la Tabla Suplementaria 3. La hoja fuente archivada de la Figura 13 contiene menos réplicas de control para los paneles A (n = 4), C (n = 4) y F (n = 2), mientras que todas las demás combinaciones de panel/grupo contienen n = 6.
Los análisis computacionales se realizaron utilizando R y los flujos de trabajo limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat, y Cytoscape/CytoHubba. Los recursos en línea incluyeron FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn, y Sangerbox 3.0.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Resultados
Identificación y anotación funcional de genes coexpresados en cuproptosis y ferroptosis
Se integraron cuatro conjuntos de datos de entrenamiento que comprendían 421 muestras de UC y 97 controles sanos. Se identificaron un total de 551 genes expresados diferencialmente, incluyendo 362 genes sobreexpresados y 189 genes subexpresados. El análisis de correlación arrojó 444 genes correlacionados con ferroptosis y cuproptosis, y la intersección con los genes expresados diferencialme...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Discusión
Este estudio integró la transcriptómica masiva, el aprendizaje automático, el análisis a nivel de célula individual y experimentos celulares dirigidos para examinar la interacción entre ferroptosis y cuproptosis en la colitis ulcerosa. Cinco candidatos diagnósticos asociados a la colitis ulcerosa fueron reproducibles en las cohortes de descubrimiento y validación, se localizaron principalmente en compartimentos epiteliales y mieloides, y mostraron expresión sensible a la inhibición de vías en células Caco-2. Estos hallaz...
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Divulgaciones
Los autores no tienen nada que revelar.
Agradecimientos
Este trabajo fue apoyado por el Proyecto de Jóvenes Eruditos Qihuang de la Administración Nacional de Medicina Tradicional China (Número de subvención 2022256). Se agradece a todos los miembros de los equipos de investigación de la Universidad de Medicina Tradicional China de Liaoning y del Tercer Hospital Afiliado de la Universidad de Medicina Tradicional China de Liaoning por el apoyo técnico y las contribuciones a la curación de datos y al análisis bioinformático.
OpenAI Codex (OpenAI) se utilizó durante la revisión únicamente para ayudar con la edición en inglés, el formato del documento y las verificaciones de calidad de las figuras. Todo el contenido científico, los análisis, las citas y la presentación final fueron revisados y verificados por los autores, quienes asumen toda la responsabilidad por el manuscrito.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Kit de ensayo de proteínas BCA | Beyotime Institute of Biotechnology | P0010 | Cuantificación de proteínas para normalización. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Plataforma en línea; acceso en 2026 | Plataforma de visualización y análisis GO/KEGG. |
| Línea celular Caco-2 | ATCC | HTB-37 | Línea celular de adenocarcinoma colorrectal humano utilizada para el modelo de lesión epitelial. |
| Kit de conteo celular-8 | GLPBio | GK10001 | Ensayo de viabilidad celular medido a 450 nm. |
| CIBERSORT con firma LM22 | Desarrolladores de CIBERSORT | LM22 | Desconvolución de 22 fracciones de células inmunitarias. |
| ChEA3 | Laboratorio Ma'ayan | Plataforma en línea; acceso en 2026 | Enriquecimiento de factores de transcripción y predicción de redes reguladoras. |
| Incubadora de CO2 | No registrado | N/A | Incubadora humedecida utilizada para cultivo a 37 °C y 5 % de CO2. |
| Sonda fluorescente para Cu2+ | BIOFOUNT | CAS 98907-26-7 | Detección de fluorescencia intracelular de Cu2+ . |
| Cytoscape con CytoHubba | Consortium Cytoscape | Versión no registrada | Visualización de interacciones proteína-proteína y clasificación de nodos centrales. |
| Medio de Eagle modificado de Dulbecco | Gibco | 11965092 | Medio de cultivo para células Caco-2. |
| Dietilsulfóxido | No registrado | N/A | Control vehicular. |
| Suero bovino fetal | No registrado | N/A | Suplemento del medio al 10 %. |
| Kit de ensayo para Fe2+ | Abcam | ab83366 | Medición de Fe2+ intracelular. |
| FerrDB | Desarrolladores de FerrDB | Base de datos en línea; acceso en 2026 | Fuente de genes relacionados con la ferroptosis. |
| Ferrostatina-1 | Sigma-Aldrich | SML0583 | Inhibidor de la ferroptosis; concentración final de 4 µM. |
| Harmony | Broad Institute/comunidad | Versión no registrada | Corrección de lotes en análisis de célula individual. |
| Microscopio invertido de fluorescencia | Olympus | IX71 | Imagen de fluorescencia de Cu2+ con excitación/emisión a 510/578 nm. |
| Lipopolisacárido | No registrado | N/A | Estímulo de lesión inflamatoria a 1 µg/mL durante 24 h. |
| Kit de ensayo de malondialdehído | Beyotime Institute of Biotechnology | S0131S | Medición de peroxidación lipídica. |
| Lector de microplacas | No registrado | N/A | Medición de absorbancia a 450 nm. |
| Monocle | Bioconductor/comunidad | Versión 2 | Análisis de seudotiempo en células individuales. |
| Base de datos de firmas moleculares | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | Conjunto de genes de referencia para GSEA. |
| NetworkAnalyst | Desarrolladores de NetworkAnalyst | Plataforma en línea; acceso en 2026 | Integración de redes de factores de transcripción y de miARN. |
| Penicilina–estreptomicina | No registrado | N/A | 100 U/mL de penicilina y 100 µg/mL de estreptomicina. |
| R | Foundation R para computación estadística | Versión no registrada | Entorno de análisis bioinformático. |
| Conjunto de paquetes R | CRAN/Bioconductor | Versiones de paquetes no registradas | Flujos de trabajo con limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC y rms. |
| Sistema de PCR en tiempo real | No registrado | N/A | Instrumento de RT-qPCR con SYBR Green. |
| Kit de síntesis de ADNc de primera cadena RevertAid | Thermo Fisher Scientific | K1622 | Síntesis de ADNc de primera cadena a partir de 1 µg de ARN. |
| Sangerbox | Desarrolladores de Sangerbox | 3.0 | Normalización y corrección de lotes con ComBat. |
| Seurat | Satija Lab/comunidad | Versión 4 | Control de calidad, normalización, agrupamiento y visualización en células individuales. |
| Software de análisis estadístico | No registrado | N/A | Análisis estadístico de los experimentos originales con células. |
| STRING | Consortium STRING | Base de datos en línea; acceso en 2026 | Construcción de red de interacciones proteína–proteína. |
| Reactivos de PCR en tiempo real con SYBR Green | Takara | RR820A | PCR cuantitativa en tiempo real. |
| TarBase | DIANA Tools | 9.0 | Interacciones miARN–gen respaldadas experimentalmente. |
| Tetratiomolibdato | Sigma-Aldrich | 323446 | Cheleador de cobre; concentración final de 40 µM. |
| Reactivo TRIzol | Takara | 9108 | Extracción de ARN total. |
Referencias
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Acceso restringido. Inicie sesión o comience una prueba gratuita para ver este contenido.