Este protocolo presenta un flujo de trabajo reproducible para desarrollar, evaluar e interpretar modelos de inteligencia artificial explicables en el ámbito sanitario. Integra la preparación estandarizada de datos, el desarrollo del modelo, técnicas de explicabilidad, evaluación cuantitativa y prácticas de reproductibilidad para mejorar la transparencia, la fiabilidad y la aplicabilidad clínica.
Artículo de método
Un protocolo experimental reproducible para el desarrollo y la evaluación de modelos de inteligencia artificial explicable en sistemas de salud
En este artículo
Resumen
Resumen
La inteligencia artificial (AI) está siendo adoptada cada vez más como una herramienta valiosa para la toma de decisiones clínicas, la predicción de enfermedades, el diagnóstico médico y la atención sanitaria personalizada. Sin embargo, la falta de transparencia, la implementación inconsistente de métodos de inteligencia artificial explicable (XAI) y la reproducibilidad limitada siguen siendo barreras importantes para la implementación confiable de modelos de IA en entornos clínicos. Este artículo propone un protocolo sistemático, reproducible y transparente para desarrollar, evaluar e interpretar modelos de inteligencia artificial explicable para aplicaciones en el ámbito sanitario. El flujo de trabajo comienza con la configuración del entorno computacional, seguido de la adquisición y caracterización de datos, el preprocesamiento, la ingeniería de características, el desarrollo del modelo, la optimización de hiperparámetros, la evaluación del rendimiento predictivo, el análisis de explicabilidad, la validación estadística y la evaluación de la reproducibilidad. El protocolo incorpora métodos de XAI como las Explicaciones Aditivas SHapley (SHAP), Explicaciones Locales Independientes del Modelo (LIME), el Mapeo de Activación de Clases Ponderado por Gradientes (Grad-CAM), Gradientes Integrados, la visualización de la atención y las explicaciones contrafactuales, para generar interpretaciones tanto globales como locales del modelo. El protocolo destaca varios componentes clave, incluida la preparación de conjuntos de datos sanitarios estandarizados, el desarrollo de modelos estables de aprendizaje automático, la evaluación del rendimiento predictivo, la generación de explicaciones clínicamente relevantes y la evaluación estadística de la reproducibilidad en experimentos repetidos. Al integrar el desarrollo del modelo, la explicabilidad, la evaluación cuantitativa y cualitativa, la validación estadística y la evaluación de la reproducibilidad en un flujo de trabajo unificado, este protocolo proporciona un marco integral para desarrollar modelos de IA transparentes y reproducibles para aplicaciones en el ámbito sanitario.
Introducción
La inteligencia artificial se ha convertido en un componente integral de la atención sanitaria moderna al permitir el análisis inteligente de datos clínicos complejos y apoyar la toma de decisiones médicas basada en evidencia1. La rápida digitalización de la atención sanitaria mediante historiales clínicos electrónicos, sistemas de imágenes médicas, dispositivos portátiles y tecnologías genómicas ha generado grandes volúmenes de datos heterogéneos que requieren enfoques computacionales avanzados para su interpretación efectiva2.
Los algoritmos de aprendizaje automático (ML) y aprendizaje profundo (DL) han demostrado capacidades notables para extraer patrones significativos a partir de conjuntos de datos multidimensionales en el ámbito de la salud, mejorando así la precisión diagnóstica, la predicción de enfermedades y la evaluación de los resultados en pacientes3. Los modelos basados en inteligencia artificial se han aplicado con éxito en radiología, patología, cardiología, oncología, oftalmología y otras especialidades médicas para ayudar a los clínicos a detectar enfermedades en etapas más tempranas y recomendar estrategias de tratamiento personalizadas4. Estas tecnologías también han contribuido a la optimización del flujo de trabajo, la reducción de la variabilidad diagnóstica y la mejora en el uso de los recursos sanitarios5.
Los recientes avances en hardware computacional, computación en la nube y marcos de trabajo de inteligencia artificial de código abierto han acelerado el desarrollo y la implementación de aplicaciones inteligentes para la atención médica6. En consecuencia, la inteligencia artificial se ha convertido en una tecnología habilitadora clave para la medicina de precisión y los sistemas de apoyo a la toma de decisiones clínicas7. A pesar de estos avances, la adopción generalizada de la inteligencia artificial en la práctica clínica rutinaria sigue siendo limitada, ya que muchos modelos de alto rendimiento ofrecen poca información sobre cómo se generan sus predicciones8.
La mayoría de los algoritmos de aprendizaje profundo funcionan como modelos complejos de caja negra en los que el proceso interno de toma de decisiones es difícil de comprender para los médicos y los investigadores9. Aunque estos modelos a menudo logran un excelente rendimiento predictivo, su falta de transparencia socava la confianza del usuario y plantea desafíos para la validación clínica, la aprobación regulatoria y la seguridad del paciente10. Los profesionales de la salud deben poder justificar las decisiones asistidas por inteligencia artificial antes de incorporarlas a la práctica clínica habitual, particularmente en entornos médicos de alto riesgo11.
El XAI ha surgido como un enfoque efectivo para mejorar la transparencia e interpretabilidad de los modelos de aprendizaje automático12. En lugar de tratar los modelos de predicción como sistemas opacos, las técnicas de XAI proporcionan información sobre las características, regiones de la imagen o variables clínicas que contribuyen a predicciones individuales13. Dichas explicaciones permiten a los médicos comprender mejor el comportamiento del modelo, identificar posibles sesgos y determinar si las decisiones generadas por inteligencia artificial son coherentes con el conocimiento médico establecido14.
Se han introducido varias técnicas de explicabilidad para aplicaciones en el ámbito sanitario. Las explicaciones aditivas basadas en el valor de Shapley (SHAP) miden la contribución de cada característica a la predicción del modelo sobre la base de la teoría de juegos cooperativos15. Las explicaciones locales interpretables independientes del modelo (LIME) crean un modelo simplificado y explican las predicciones de un modelo opaco16. Para tareas con imágenes médicas que utilizan modelos de aprendizaje profundo, los mapas de activación ponderados por gradientes (Grad-CAM) generan mapas de calor que indican visualmente las regiones de una imagen que contribuyen a las decisiones de clasificación17. La combinación de estos métodos ha mejorado notablemente la transparencia de los sistemas de inteligencia artificial en diversos ámbitos sanitarios18.
A pesar del creciente interés en los métodos de explicabilidad en entornos sanitarios, su uso sigue siendo variado en la literatura. Los investigadores difieren no solo en el uso de estrategias de preprocesamiento, sino también en el diseño de la arquitectura del modelo, las métricas de evaluación e incluso en las técnicas de explicación19. Además, muchos artículos informan una alta precisión predictiva, pero no logran proporcionar una evaluación exhaustiva de la calidad de las explicaciones ni de su reproducibilidad20.
La reproducibilidad es uno de los principales cuellos de botella en la ciencia actual de inteligencia artificial. A menudo, los artículos no revelan la versión del software, el entorno computacional, la canalización de preprocesamiento, la configuración de hiperparámetros, la inicialización de la semilla aleatoria ni las configuraciones del hardware21. Debido a esto, los investigadores independientes suelen no poder reproducir los resultados publicados ni verificar los métodos descritos utilizando otros conjuntos de datos o plataformas de software22. La falta de documentación detallada es uno de los factores que dificultan los estudios de referencia, la investigación colaborativa y la traducción clínica de los sistemas de inteligencia artificial23.
Ante estos desafíos, varias organizaciones y agencias reguladoras han enfatizado la importancia de una inteligencia artificial transparente, confiable y reproducible para aplicaciones en el ámbito sanitario24. Las guías de informe existentes han mejorado la presentación metodológica, pero principalmente describen qué debe informarse, en lugar de proporcionar procedimientos experimentales estandarizados que los investigadores puedan implementar directamente25. Por consiguiente, aún existe la necesidad de un protocolo integral que integre la preparación de conjuntos de datos, el desarrollo del modelo, el análisis de explicabilidad, la evaluación estadística y las prácticas de reproducibilidad en un único flujo de trabajo experimental26.
Un protocolo experimental estandarizado ofrece varias ventajas para la comunidad de inteligencia artificial en salud. Además, promueve la coherencia metodológica, facilita la comparación de estudios independientes, aumenta la transparencia de los experimentos computacionales y permite la validación confiable de los resultados publicados27. Los flujos de trabajo estandarizados también ayudan en la educación y formación, la investigación colaborativa y la evaluación regulatoria mediante procedimientos claramente documentados que son reproducibles en diferentes laboratorios e instituciones sanitarias28.
Se desarrolló y probó un protocolo experimental reproducible para entrenar y evaluar modelos de IA en sistemas de salud. El protocolo describe estándares para configurar el entorno computacional, preprocesar conjuntos de datos de salud, desarrollar modelos de aprendizaje automático, aplicar métodos de IAX, evaluar el rendimiento predictivo, realizar validación estadística y evaluar la reproductibilidad29. Es probable que la integración de estos componentes en un flujo de trabajo coherente aumente la transparencia, confiabilidad y reproductibilidad de la investigación en IA para la salud, además de ayudar a desarrollar sistemas de salud inteligentes confiables30.
Protocolo
El experimento de validación realizado utilizó el Conjunto de Datos de Diabetes de los Indios Pima, disponible públicamente y con identificación eliminada, y no involucró registros de pacientes identificables ni reclutamiento nuevo de pacientes. Por lo tanto, no se requirió consentimiento informado ni aprobación institucional del comité de revisión institucional (IRB) o ético, y todos los análisis se realizaron de acuerdo con los términos aplicables del conjunto de datos y las políticas institucionales de investigación.
El ejemplo práctico de validación utiliza el conjunto de datos públicamente disponible de diabetes en indígenas Pima, que contiene 768 registros para la predicción binaria de diabetes. Se aplicó a este conjunto de datos el flujo de trabajo central completo de nueve etapas. Las nueve etapas principales comprendieron la selección y validación del conjunto de datos, la configuración del entorno computacional, el preprocesamiento de los datos, la partición del conjunto de datos, el desarrollo y entrenamiento del modelo, la evaluación del rendimiento predictivo y computacional, el análisis de interpretabilidad, la validación estadística y la evaluación de la reproducibilidad. La validación externa y la evaluación por expertos clínicos se mantuvieron como módulos opcionales de validación y no se realizaron en el presente ejemplo práctico. Figura 1 ilustra el flujo de trabajo del protocolo principal, y Tabla 1 resume únicamente las nueve etapas principales implementadas en la presente validación práctica; la validación externa opcional y la evaluación por expertos clínicos se describen por separado dentro del Protocolo y no se incluyen entre las nueve etapas experimentales.
1. Seleccione y valide el conjunto de datos de atención médica
- Seleccione el conjunto de datos de Diabetes en Indios Pima como conjunto de datos principal para el ejemplo de validación desarrollado. Verifique la fuente del conjunto de datos, el tamaño de la muestra, el objetivo de predicción, la distribución de clases y la estructura de los datos.
- Aplique los criterios predefinidos de inclusión, exclusión y calidad de los datos. Elimine registros duplicados e inválidos antes del desarrollo del modelo.
- Registre la fuente del conjunto de datos, sus características, la tarea de predicción, la distribución de clases, los criterios de inclusión y exclusión, y la estrategia de particionamiento en Tabla 2.
- Aplique los criterios de decisión para la selección del conjunto de datos y del modelo
- Defina el objetivo de predicción antes de seleccionar el conjunto de datos, la arquitectura del modelo, la estrategia de preprocesamiento o el método de explicabilidad.
- Relacione la modalidad del conjunto de datos con el objetivo de predicción. Seleccione datos tabulares para variables clínicas estructuradas, datos de imágenes para imágenes médicas, datos de series temporales para señales fisiológicas, datos de texto para narrativas clínicas, o datos multimodales cuando estén disponibles modalidades complementarias para el mismo paciente o unidad de estudio.
- Evalúe los conjuntos de datos candidatos según el tamaño de la muestra, disponibilidad del resultado, distribución de clases, valores faltantes, calidad de la anotación, relevancia clínica, completitud de los datos y accesibilidad. Seleccione el conjunto de datos que cumpla con los requisitos predefinidos.
- Seleccione modelos convencionales de aprendizaje automático para datos tabulares estructurados cuando el tamaño de la muestra, los recursos computacionales o los requisitos de interpretabilidad limiten el uso de arquitecturas complejas. Seleccione arquitecturas de aprendizaje profundo cuando haya suficientes datos de entrenamiento y entradas de alta dimensionalidad, como imágenes médicas, señales fisiológicas o texto clínico, disponibles.
- Seleccione arquitecturas multimodales únicamente cuando estén disponibles múltiples modalidades para el mismo paciente o unidad de estudio y puedan alinearse de forma confiable sin introducir fugas de información. Seleccione las operaciones de preprocesamiento según las características de la modalidad de datos seleccionada.
- Seleccione métodos de explicabilidad según el modelo y la modalidad de los datos. Utilice métodos independientes del modelo, como SHAP o LIME, para modelos tabulares adecuados, y métodos específicos de la modalidad, como Grad-CAM para modelos basados en imágenes, cuando sea aplicable.
- Documente la justificación para las selecciones del conjunto de datos, la estrategia de preprocesamiento, el modelo y los métodos de explicabilidad. Mantenga estas decisiones como parte del registro de reproducibilidad.
2. Configurar el entorno computacional para el desarrollo del modelo de XAI
- Configure el sistema operativo, la CPU, la RAM, el almacenamiento y la GPU según los requisitos del modelo seleccionado. Cree un entorno de Python aislado e instale las bibliotecas necesarias de aprendizaje automático, aprendizaje profundo, estadística, visualización e IA explicativa (XAI).
- Registre el entorno computacional real, la arquitectura del modelo y los hiperparámetros utilizados para la validación realizada en Tabla 3. Especifique el optimizador, la tasa de aprendizaje, el tamaño del lote, el número máximo de épocas, la función de pérdida, los parámetros de regularización, la estrategia de validación, la configuración de detención temprana, la configuración de semilla aleatoria, los métodos de explicabilidad, el hardware, el sistema operativo, la versión de Python y las versiones de las bibliotecas de software relevantes. Distinga estas configuraciones utilizadas experimentalmente de los ajustes generales o recomendados del protocolo.
- Utilice la configuración reportada en la Tabla 3 al reproducir la validación del conjunto de datos de Pima Indians Diabetes y los resultados predictivos, de explicabilidad, estadísticos y de reproducibilidad correspondientes.
- Ejecute un script de validación para confirmar la importación exitosa de paquetes, la carga del conjunto de datos, la ejecución del modelo y la generación de resultados. Mantenga la configuración final del entorno para garantizar la reproducibilidad.
3. Preparar y caracterizar conjuntos de datos de atención médica para el desarrollo de modelos de IAe
- Seleccionar y adquirir el conjunto de datos de atención médica
- Seleccione un conjunto de datos de atención médica adecuado para la tarea de predicción clínica definida. Evalúe los conjuntos de datos candidatos según el objetivo de investigación, el tipo de datos, el tamaño de la muestra, la calidad de las anotaciones, el equilibrio de clases y la relevancia clínica.
- Prefiera conjuntos de datos de referencia públicamente disponibles cuando aborden adecuadamente la tarea de predicción y faciliten la validación independiente.
- Obtenga las aprobaciones éticas requeridas, los permisos institucionales y la autorización de acceso a los datos antes de adquirir conjuntos de datos institucionales o internos. Obtenga el conjunto de datos seleccionado de un repositorio verificado o de una base de datos institucional autorizada.
- Conservar los archivos originales del conjunto de datos sin modificaciones y registrar el proveedor del conjunto de datos, la versión, la información de adquisición, las condiciones de licencia, los criterios de inclusión, los criterios de exclusión y los metadatos asociados. Organice el conjunto de datos en directorios separados para datos crudos, anotaciones, metadatos e información complementaria.
- Caracterizar el conjunto de datos de atención médica
- Identifique las variables predictoras, las etiquetas de resultado, los tipos de características, las modalidades de datos y las distribuciones de clases. Determine el número de sujetos, muestras, dimensiones de características y anotaciones disponibles.
- Confirme que las características del conjunto de datos sean compatibles con el método de IA seleccionado.
- Utilice el conjunto de datos de diabetes de los indígenas Pima como único conjunto de datos experimental detallado para validar el protocolo central de nueve etapas. Incluya únicamente los conjuntos de datos adicionales enumerados en Tabla 2 para demostrar la aplicabilidad del protocolo general en datos tabulares clínicos, historiales médicos electrónicos, imágenes dermatoscópicas, datos de series temporales fisiológicas e imágenes médicas. No utilice estos conjuntos de datos adicionales para entrenamiento del modelo, pruebas, validación estadística ni generación de los resultados experimentales reportados.
- Evaluar la calidad del conjunto de datos
- Revise el conjunto de datos en busca de registros duplicados, archivos dañados, valores faltantes, errores de anotación y entradas de datos irregulares. Elimine los registros duplicados confirmados y corrija las irregularidades de formato verificadas. Documente todos los procedimientos de control de calidad del conjunto de datos.
- Verifique la correspondencia entre datos de imágenes, clínicos, de laboratorio y fisiológicos mediante identificadores de sujetos cuando se utilicen conjuntos de datos multimodales.
- Elimine registros duplicados o inconsistentes, maneje los valores faltantes, estandarice las características numéricas, codifique las variables categóricas y aplique preprocesamiento específico por modalidad. Divida el conjunto de datos en conjuntos independientes de entrenamiento, validación y prueba. Consulte Figura 2 para conocer el flujo de trabajo de preparación, preprocesamiento, partición y evaluación de la calidad del conjunto de datos de atención médica.
- Garantizar la privacidad de los datos y el cumplimiento ético
- Elimine los identificadores directos de los datos de atención médica. Aplique procedimientos de anonimización o seudonimización cuando sea necesario. Trate la información de salud del paciente de acuerdo con los requisitos éticos, de protección de datos, de consentimiento informado y institucionales aplicables.
- Registre la aprobación ética aplicable, la exención, los procedimientos de gobernanza de datos, los métodos de anonimización y el flujo de trabajo de preparación del conjunto de datos.
- Evalue el posible sesgo algorítmico comparando el desempeño del modelo en subgrupos demográficos o clínicos relevantes cuando dicha información esté disponible y sea éticamente permisible.
- Documente el uso previsto, la población objetivo, las limitaciones del modelo, los modos potenciales de falla, los requisitos de supervisión humana y los requisitos éticos, de protección de datos y regulatorios de atención médica aplicables.
- Registre las limitaciones de equidad identificadas y las consideraciones de IA responsable como parte de la documentación final del modelo.
NOTA: Obtenga un conjunto de datos de atención médica estandarizado y documentado que sea adecuado para el desarrollo de modelos de IA, que cumpla con los aspectos éticos y que esté libre de inconsistencias importantes identificadas.
4. Preprocesar y particionar datos sanitarios para el entrenamiento del modelo de IA
- Realizar control de calidad
- Inspeccionar el conjunto de datos en busca de registros duplicados, valores faltantes, valores inválidos, etiquetas inconsistentes, valores atípicos y archivos corruptos.
- Eliminar o corregir observaciones inválidas según criterios predefinidos y registrar todas las exclusiones. Verificar la coherencia de las variables predictoras y las etiquetas del resultado.
- Manejar datos faltantes
- Cuantificar la ausencia de datos para cada variable. Aplicar la estrategia predefinida de imputación o exclusión.
- Estimar los parámetros de imputación utilizando únicamente los datos de entrenamiento y aplicar la transformación ajustada a los datos de validación y prueba.
- Normalizar y transformar los datos
- Aplicar escalado de características, normalización, codificación, reducción de dimensionalidad u otras transformaciones requeridas por el modelo seleccionado. Ajustar todas las transformaciones dependientes de los datos utilizando únicamente los datos de entrenamiento.
- Aplicar las transformaciones ajustadas sin cambios a los datos de validación y prueba.
- Cuantificar el desequilibrio de clases en los datos de entrenamiento. Aplicar ponderación de clases, SMOTE, sobremuestreo o aumento únicamente al conjunto de datos de entrenamiento. Mantener la distribución original de los conjuntos de datos de validación y prueba.
- Confirmar que ningún sujeto, observación duplicada, muestra aumentada, estadístico de preprocesamiento, criterio de selección de características o muestra sintética se comparta entre las particiones de entrenamiento y evaluación.
5. Desarrollar y configurar el modelo de IA interpretable
- Defina la arquitectura del modelo especificando las modalidades de los datos de entrada, las operaciones de preprocesamiento, los codificadores de características específicos para cada modalidad, el mecanismo de fusión de características, la capa de predicción y el módulo de explicabilidad.
- Seleccione la arquitectura de aprendizaje automático o aprendizaje profundo según la tarea de predicción y la modalidad de entrada. Configure la capa de entrada, los componentes de extracción de características, las capas ocultas, la capa de salida y las funciones de activación. Defina el optimizador, la tasa de aprendizaje, el tamaño del lote, la función de pérdida, las épocas, la regularización, el dropout, la detención temprana y el programa de ajuste de la tasa de aprendizaje.
- Optimice los hiperparámetros utilizando únicamente los datos de entrenamiento y validación.
- Registre la arquitectura finalizada y la configuración de hiperparámetros en Tabla 3.
- Verifique la compatibilidad dimensional entre entrada y salida antes del entrenamiento.
NOTA: Establezca un modelo XAI completamente configurado que incluya una arquitectura adecuada, hiperparámetros definidos y técnicas de explicabilidad integradas.
6. Entrenar, optimizar y preservar el modelo de IA interpretable
- Cargue los conjuntos de datos predefinidos de entrenamiento y validación, así como la configuración final del modelo. Inicialice el modelo utilizando la semilla aleatoria predefinida y los parámetros de entrenamiento.
- Entrene el modelo utilizando el optimizador especificado, la función de pérdida, el tamaño del lote y los criterios de detención.
- Supervise el rendimiento en validación y conserve el punto de control correspondiente al criterio predefinido de selección del modelo. Evalúe el punto de control seleccionado en el conjunto de datos de prueba independiente sin realizar más optimizaciones.
- Guarde el modelo entrenado, la configuración de preprocesamiento, los hiperparámetros, la semilla aleatoria y el registro de entrenamiento.
NOTA: Obtenga un modelo XAI optimizado entrenado y validado utilizando el conjunto de datos de salud preparado. Conserve el modelo con mejor desempeño, los hiperparámetros, los registros de entrenamiento, la configuración de preprocesamiento y el entorno computacional para garantizar la reproducibilidad.
7. Evaluar el rendimiento predictivo y computacional
- Evaluar el rendimiento predictivo
- Cargue el modelo optimizado y el conjunto de datos de prueba independiente tras completar el entrenamiento del modelo y la optimización de hiperparámetros. Mantenga sin cambios los parámetros del modelo entrenado y la canalización de preprocesamiento durante la fase de prueba.
- Genere predicciones para todas las muestras del conjunto de datos de prueba. Compare las salidas predichas con las etiquetas reales correspondientes.
- Calcular métricas de rendimiento
- Seleccione métricas de evaluación según el tipo de tarea de predicción.
- Calcule la exactitud, precisión, exhaustividad, especificidad, puntuación F1, exactitud equilibrada, coeficiente de correlación de Matthews (MCC) y área bajo la curva ROC (AUC-ROC) para tareas de clasificación, según corresponda. Calcule el error absoluto medio (MAE), la raíz del error cuadrático medio (RMSE), el coeficiente de determinación (R2) y otras medidas pertinentes para tareas de regresión, según corresponda.
- Evaluar la generalización y robustez del modelo
- Evalúe el modelo utilizando un conjunto de datos externo recopilado independientemente del conjunto de datos de desarrollo, siempre que dichos datos estén disponibles.
- Prefiera conjuntos de datos externos procedentes de una institución sanitaria diferente, región geográfica o población de pacientes distinta para evaluar la transportabilidad.
- Realice una validación temporal utilizando datos recopilados en un período posterior cuando haya conjuntos de datos longitudinales disponibles.
- Realice una validación multicéntrica evaluando el modelo finalizado por separado en las instituciones participantes cuando haya datos multicéntricos disponibles.
- Realice una validación geográfica utilizando una población independiente de una región geográfica diferente cuando sea factible.
- Informe sobre las diferencias de rendimiento y los intervalos de confianza entre los conjuntos de datos de desarrollo y externos.
- Evaluar el rendimiento computacional
- Mida el tiempo de entrenamiento del modelo en el entorno computacional predefinido, el tiempo de inferencia y de prueba en condiciones computacionales idénticas, así como el consumo de memoria, el tamaño del modelo y la utilización del hardware.
- Repita las mediciones computacionales en ejecuciones independientes.
- Calcule el tiempo medio de ejecución para reducir el efecto de la variabilidad experimental.
- Comparar el rendimiento del modelo
- Seleccione métodos convencionales apropiados de aprendizaje automático o aprendizaje profundo para la evaluación comparativa.
- Evalúe el modelo XAI propuesto y los modelos comparadores utilizando el mismo conjunto de datos. Aplique procedimientos de preprocesamiento y métricas de evaluación idénticos a todos los modelos comparativos.
- Realice todos los experimentos comparativos dentro del mismo entorno computacional.
NOTA: Obtenga evidencia experimental de la estabilidad predictiva y la reproducibilidad bajo las condiciones computacionales y el conjunto de datos evaluados.
8. Generar y evaluar las salidas de XAI
- Generar explicaciones del modelo
- Cargue el modelo XAI optimizado. Seleccione muestras de evaluación que no se hayan utilizado para el entrenamiento del modelo. Aplique los métodos de explicabilidad predefinidos sin modificar el modelo entrenado ni la canalización de preprocesamiento.
- Genere explicaciones globales y locales del modelo
- Genere explicaciones globales para caracterizar el comportamiento general del modelo predictivo.
- Genere explicaciones locales para caracterizar predicciones individuales del modelo.
- Aplique SHAP al conjunto de datos de Diabetes en Indios Pima para generar explicaciones globales y locales de las predicciones del modelo tabular.
- Genere un gráfico resumen de SHAP para visualizar la dirección y magnitud general de las contribuciones de las características.
- Genere un gráfico de importancia de características de SHAP utilizando los valores absolutos medios de SHAP para clasificar las características según su contribución general a las predicciones del modelo.
- Genere un gráfico de cascada de SHAP para una predicción representativa del conjunto de prueba, a fin de ilustrar las contribuciones específicas de las características por paciente.
- Genere un gráfico de dependencia de características de SHAP para examinar la relación entre una característica seleccionada y su contribución a la salida del modelo.
- Aplique LIME a predicciones representativas del conjunto de prueba para generar explicaciones locales de predicciones individuales del modelo.
- Genere una explicación contrafactual específica del paciente para ilustrar los cambios en las características asociados con un cambio en el resultado predicho.
- Seleccione técnicas adicionales de explicabilidad según la modalidad de los datos y la arquitectura del modelo.
- Utilice Grad-CAM o mapas de saliencia para modelos basados en imágenes compatibles, visualizaciones de atención para arquitecturas basadas en transformadores e Integrales de Gradientes para modelos diferenciables cuando sea aplicable.
- Considere Grad-CAM, mapeo de saliencia, visualización de atención e Integrales de Gradientes como opciones generales de protocolo dependientes de la modalidad, y no las interprete ni informe como resultados experimentales del conjunto de validación de Indios Pima Diabetes, a menos que se realicen los análisis correspondientes.
- Aplique métodos de explicabilidad a la validación práctica con el conjunto Pima
- Aplique SHAP y LIME al conjunto de datos de Diabetes en Indios Pima para generar explicaciones globales y locales de las predicciones del modelo tabular.
- Genere visualizaciones resumen de SHAP, de importancia de características, de cascada y de dependencia de características a partir de los resultados de validación con el conjunto Pima.
- Genere una explicación local de LIME para predicciones representativas del conjunto de prueba.
- Genere una explicación contrafactual específica del paciente para ilustrar los cambios en las características asociados con un cambio en la predicción del modelo.
- Considere Grad-CAM, visualización de atención, mapeo de saliencia e Integrales de Gradientes como opciones de explicabilidad dependientes de la modalidad para otros tipos de datos sanitarios y arquitecturas de modelos.
- No informe Grad-CAM, visualización de atención, mapeo de saliencia ni Integrales de Gradientes como hallazgos experimentales de la validación práctica con el conjunto Pima, a menos que se realicen los análisis correspondientes.
- Evaluar la calidad de las explicaciones
- Evalúe si las explicaciones generadas reflejan el proceso de predicción del modelo. Analice la estabilidad de las explicaciones a través de ejecuciones experimentales repetidas y la consistencia de las salidas de explicación bajo condiciones computacionales idénticas.
- Evalúe la sensibilidad de las salidas de explicación ante cambios en los datos de entrada cuando sea aplicable. Compare las explicaciones generadas con conocimientos del dominio disponibles o interpretaciones de expertos.
- Identifique características predictivas o regiones anatómicas que coincidan con conocimientos médicos establecidos cuando estén disponibles dichas comparaciones.
- Registre el nivel de acuerdo o desacuerdo entre las explicaciones generadas y la interpretación clínica disponible.
- Cuantificar la incertidumbre de la predicción
- Genere estimaciones de confianza en las predicciones para las muestras evaluadas utilizando un método de estimación de incertidumbre adecuado a la arquitectura del modelo seleccionado y a la aplicación sanitaria.
- Aplique dropout de Monte Carlo, predicción basada en ensambles, inferencia bayesiana, predicción conforme u otro enfoque validado de estimación de incertidumbre cuando sea apropiado.
- Repita los pases estocásticos de predicción al usar dropout de Monte Carlo y calcule la predicción media y la varianza predictiva para cada muestra de evaluación.
- Informe conjuntamente los intervalos de confianza o incertidumbre de la predicción junto con las predicciones correspondientes del modelo.
- Evalúe si las estimaciones de incertidumbre identifican predicciones asociadas con menor fiabilidad o mayor error de predicción. Mantenga el método de estimación de incertidumbre, los parámetros, las semillas aleatorias y las salidas de incertidumbre generadas para garantizar la reproducibilidad.
- Documentar y preservar las salidas de explicabilidad
- Guarde todas las puntuaciones generadas de importancia de características, mapas de calor, mapas de saliencia, visualizaciones de atención e interpretaciones específicas del paciente. Almacene las salidas de explicabilidad utilizando formatos de archivo estandarizados. Archive las salidas junto con el modelo entrenado y la configuración de preprocesamiento.
- Registre la configuración computacional, los parámetros de explicación, el tiempo de ejecución y las versiones del software utilizadas para la generación de explicaciones. Preservar toda la documentación de explicabilidad para facilitar la revisión independiente y la reproducibilidad.
- Evaluar cuantitativamente la calidad de las explicaciones
- Evalúe la fidelidad de la explicación perturbando o enmascarando sistemáticamente las características identificadas como importantes y midiendo el cambio correspondiente en la salida del modelo. Calcule una puntuación de fidelidad de la explicación comparando la magnitud de la atribución con el cambio resultante en la predicción del modelo.
- Evalúe la estabilidad de la explicación generando explicaciones para ejecuciones repetidas, entradas perturbadas o muestras clínicamente similares y calculando la similitud entre los patrones de atribución resultantes. Calcule la infidelidad midiendo la discrepancia entre el cambio predicho en la salida y el cambio estimado a partir de la atribución de la explicación bajo perturbaciones controladas de la entrada.
- Para explicaciones de imágenes médicas, evalúe la precisión de localización utilizando una región de interés definida por expertos cuando estén disponibles anotaciones de referencia. Evalúe la utilidad clínica obteniendo evaluaciones independientes de expertos clínicos calificados utilizando criterios de interpretación predefinidos.
- Calcule kappa de Cohen o kappa de Fleiss cuando múltiples expertos evalúen de forma independiente la relevancia o el acuerdo de las explicaciones.
NOTA: Genere explicaciones globales y locales que caractericen el comportamiento predictivo del modelo de IA entrenado. Preservar las salidas de explicabilidad y las configuraciones correspondientes para una interpretación transparente y una evaluación reproducible.
9. Realizar la validación estadística y la evaluación de la reproducibilidad
- Realizar la validación estadística
- Seleccione los métodos estadísticos de acuerdo con el objetivo del estudio, el diseño experimental, la distribución de los datos y las características de las variables evaluadas.
- Reporte las variables continuas como la media ± desviación estándar o como la mediana y el rango intercuartílico, según corresponda, y las variables categóricas como frecuencias y porcentajes.
- Realice una validación cruzada de cinco pliegues en el conjunto de entrenamiento para evaluar la estabilidad del rendimiento del modelo y reporte la exactitud, el área bajo la curva ROC, la precisión, la recuperación y la puntuación F1 como valores medios ± desviación estándar entre los grupos. Estime intervalos de confianza del 95 % para las métricas de rendimiento en el conjunto de prueba independiente utilizando 1.000 remuestras bootstrap.
- Compare el modelo propuesto con los modelos básicos de CNN, Bosque Aleatorio y SVM mediante la prueba de McNemar para comparaciones de precisión emparejadas, la prueba de DeLong para comparaciones de AUC-ROC correlacionadas y pruebas de bootstrap emparejadas con 1.000 remuestras para comparaciones del puntaje F1.
- Informe el estadístico de prueba correspondiente y el valor p exacto para cada comparación, y utilice un nivel de significancia bilateral de α = 0.05.
- Comparar estadísticamente el rendimiento del modelo
- Comparar el modelo de inteligencia artificial explicable propuesto con los modelos básicos seleccionados de vanguardia en aprendizaje automático y aprendizaje profundo.
- Aplicar la prueba t de Student tprueba t o prueba de Mann-Whitney U según corresponda al comparar dos grupos. Aplique ANOVA de un solo factor para comparaciones paramétricas pertinentes que involucren más de dos grupos. Aplique la prueba de Kruskal-Wallis para comparaciones no paramétricas pertinentes que involucren más de dos grupos.
- Considere p < 0,05 estadísticamente significativo, tal como se especifica en el manuscrito original.
- Utilice un nivel de significación bilateral de α = 0,05 para todas las comparaciones estadísticas predeterminadas y reporte los estadísticos de prueba y valores p correspondientes.
- Informe los intervalos de confianza del 95 % para las métricas principales de rendimiento predictivo.
- Utilice el muestreo de reemplazo (bootstrap) para estimar intervalos de confianza de las medidas de rendimiento cuando sea apropiado. Utilice la prueba de DeLong para comparar valores de ROC-AUC correlacionados cuando los mismos sujetos sean evaluados por dos modelos. Utilice la prueba de McNemar para comparar resultados categóricos de clasificación apareados generados para los mismos sujetos. Utilice procedimientos de bootstrap apareados para comparar la puntuación F1 u otras métricas de rendimiento derivadas cuando sea apropiado.
- Evalúe la calibración utilizando gráficos de calibración, pendiente/intersección de la calibración y puntuación de Brier cuando estén disponibles predicciones probabilísticas.
- Para la validación del conjunto de datos de diabetes de los indios Pima trabajado, utilice la comparación estadística por pares predefinida especificada para el modelo propuesto y los modelos de referencia. Aplique la prueba seleccionada de forma consistente a las predicciones en el conjunto de prueba por pares o a las mediciones de rendimiento en ejecuciones repetidas, según corresponda a la comparación. Utilice un nivel de significancia bilateral de α = 0,05 y reporte el estadístico de prueba y el valor p exacto. No informe pruebas estadísticas alternativas como si hubieran sido realizadas, a menos que sus resultados se presenten en la sección de Resultados.
- Aplicar pruebas bilaterales e interpretar la significancia estadística utilizando un umbral predefinido de p < 0.05.
- Evaluar la robustez del modelo
- Repita el procedimiento completo de entrenamiento y evaluación 10 veces utilizando diferentes semillas aleatorias, manteniendo la partición predeterminada del conjunto de datos, los procedimientos de preprocesamiento, la arquitectura del modelo, los hiperparámetros, el entorno de software y el protocolo de evaluación.
- Registre el AUC-ROC, la precisión y la puntuación F1 para cada ejecución independiente y reporte la media ± desviación estándar a lo largo de las 10 ejecuciones.
- Compare los valores de rendimiento resultantes entre ejecuciones repetidas para evaluar la estabilidad predictiva y la reproducibilidad bajo diferentes inicializaciones aleatorias.
- Evaluar la reproducibilidad de la explicabilidad
- Genere atribuciones de características, mapas de atención u otras salidas explicativas en múltiples ejecuciones experimentales cuando se incluya la evaluación de estabilidad de las explicaciones. Compare cuantitativamente las salidas explicativas entre ejecuciones repetidas utilizando una medida adecuada de similitud o de concordancia basada en rangos.
- Para la validación realizada con el conjunto de datos de diabetes de los indios Pima, no informe métricas cuantitativas de estabilidad de las explicaciones a menos que se hayan realizado los análisis y salidas de explicaciones repetidas correspondientes.
- Evalúe la concordancia entre las explicaciones generadas por el modelo y las interpretaciones de los clínicos cuando estén disponibles evaluaciones clínicas apropiadas. Calcule el kappa de Cohen o el kappa de Fleiss, según corresponda, para evaluar la concordancia entre evaluadores.
- Documentar la reproducibilidad
- Conservar los datos brutos, los procedimientos de preprocesamiento, el código fuente, los modelos entrenados, las configuraciones de hiperparámetros, los resultados de explicabilidad, los scripts de análisis estadístico y los resultados generados.
- Registre el entorno de software y la configuración de hardware utilizados durante todo el flujo de trabajo. Vuelva a ejecutar de forma independiente el flujo de trabajo completo utilizando los archivos y configuraciones archivados.
- Compare el rendimiento predictivo replicado con los resultados experimentales originales, y las explicaciones del modelo replicado con las salidas de explicabilidad originales.
- Registre cualquier diferencia observada durante la replicación. Actualice la documentación experimental para reflejar las observaciones sobre reproducibilidad identificadas durante la ejecución independiente.
NOTA: Obtenga resultados estadísticamente validados de rendimiento predictivo y explicabilidad que puedan evaluarse en experimentos repetidos. Conserve documentación suficiente sobre los aspectos computacionales, analíticos y metodológicos para permitir la verificación independiente de todo el flujo de trabajo.
- Lista de verificación de reproducibilidad
- Registre el nombre del conjunto de datos, la versión, la fecha de adquisición, la fuente, los criterios de inclusión, los criterios de exclusión y el recuento final de muestras. Registre todas las operaciones de preprocesamiento, los parámetros de transformación, la configuración de normalización, los procedimientos de selección de características y las reglas de partición de los datos.
- Registre el sistema operativo, CPU, GPU, RAM, versión de Python, versiones de los frameworks y versiones de las bibliotecas. Registre todas las especificaciones de la arquitectura del modelo y los hiperparámetros.
- Registre el optimizador, la tasa de aprendizaje, el tamaño del lote, el número de épocas, la función de pérdida, la regularización y los criterios de detención temprana. Registre todas las semillas aleatorias y la configuración del generador de números aleatorios.
- Conservar los pesos del modelo entrenado y las configuraciones de preprocesamiento. Conservar los registros de entrenamiento, los scripts de evaluación, los scripts de análisis estadístico y las salidas de explicabilidad. Registrar las versiones del modelo y del software utilizadas en los experimentos finales.
- Conservar el entorno computacional completo necesario para la replicación independiente.
- Documente la disponibilidad del código fuente, conjuntos de datos, pesos del modelo y materiales de apoyo sujetos a restricciones éticas, legales, de licencia y de privacidad.
- Vuelva a ejecutar el flujo de trabajo archivado de forma independiente y compare los resultados replicados con los resultados originales.
- Documente los requisitos completos de reproducibilidad utilizando la lista de verificación estandarizada.
Resultados
El marco de XAI propuesto se implementó utilizando el conjunto de datos de diabetes de los indios Pima como conjunto de datos representativo del sector salud. El conjunto de datos de diabetes de los indios Pima se utilizó como el único conjunto de datos para la validación experimental. Todos los resultados predictivos, de explicabilidad, estadísticos y de reproducibilidad informados se generaron a partir de este conjunto de datos. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM y BraTS 2021 no fueron evaluados experimentalmente y se incluyen únicamente como ejemplos que ilustran la aplicabilidad del protocolo general en diferentes modalidades de datos sanitarios. Se utilizó el conjunto de datos completo tras eliminar los registros inválidos y duplicados, y se realizaron las operaciones de preprocesamiento especificadas antes del desarrollo del modelo. El conjunto de datos se dividió en subconjuntos independientes de entrenamiento, validación y prueba mediante una estrategia de partición estratificada predefinida. Se mantuvo la independencia de las muestras entre los tres subconjuntos para minimizar la posibilidad de fugas de datos.
El modelo predictivo se configuró utilizando la arquitectura y los hiperparámetros predefinidos. El modelo se entrenó utilizando el optimizador Adam con la tasa de aprendizaje y el tamaño de lote predefinidos durante un máximo de 100 épocas. Se aplicó detención temprana basada en la pérdida de validación, y se conservó el modelo correspondiente al mejor desempeño en validación. Se especificaron semillas aleatorias para la partición del conjunto de datos, la inicialización del modelo y experimentos repetidos para mejorar la reproducibilidad.
El modelo entrenado se evaluó en el conjunto de prueba independiente utilizando exactitud, precisión, exhaustividad, especificidad, puntuación F1, coeficiente de correlación de Matthews (MCC), área bajo la curva característica de operación del receptor (AUC-ROC) y precisión promedio (AP). El modelo propuesto se comparó con los modelos de referencia predefinidos utilizando procedimientos idénticos de preprocesamiento, particiones de datos y protocolos de evaluación. Se generaron curvas características de operación del receptor (ROC), curvas de precisión-exhaustividad y una matriz de confusión a partir de las predicciones del conjunto de prueba independiente.
Se realizó una validación cruzada de cinco pliegues en los datos de entrenamiento para evaluar la estabilidad del rendimiento. Se estimaron intervalos de confianza del 95 % para las métricas principales de rendimiento, y se llevaron a cabo comparaciones estadísticas predefinidas entre el modelo propuesto y los modelos de referencia.
La validación cruzada de cinco pliegues produjo una precisión del 93,01 ± 0,48 %, un AUC-ROC de 0,954 ± 0,007, una exactitud del 92,42 ± 0,87 %, una recuperación del 93,02 ± 0,45 % y una puntuación F1 del 92,72 ± 0,62 %. Los intervalos de confianza bootstrap del 95 % estimados a partir de 1.000 remuestras fueron de 0,897–0,973 para la precisión, de 0,890–0,970 para la exactitud, de 0,880–0,963 para la recuperación, de 0,887–0,965 para la puntuación F1 y de 0,931–0,984 para el AUC-ROC. Las comparaciones estadísticas con los modelos básicos CNN, bosque aleatorio y SVM se realizaron utilizando la prueba de McNemar para la precisión, la prueba de DeLong para el AUC-ROC y pruebas bootstrap pareadas con 1.000 remuestras para la puntuación F1.
El procedimiento completo de entrenamiento y evaluación se repitió en 10 ejecuciones independientes utilizando diferentes semillas aleatorias. Las ejecuciones repetidas arrojaron un AUC-ROC de 0,957 ± 0,008, una exactitud de 93,24 ± 0,74 % y una puntuación F1 de 92,35 ± 0,92 %, lo que indica una variabilidad relativamente baja entre ejecuciones repetidas. Las métricas de rendimiento obtenidas en las ejecuciones repetidas se resumieron utilizando la media y la desviación estándar. Se examinó la variabilidad entre ejecuciones para determinar si el rendimiento predictivo permaneció estable bajo ejecuciones repetidas.
No se realizó una validación externa en el ejemplo práctico presentado porque no se utilizó ningún conjunto de datos externo e independiente. Por consiguiente, todos los resultados predictivos, estadísticos y de reproducibilidad informados se obtuvieron a partir del Conjunto de Datos sobre Diabetes en Indios Pima utilizando las particiones predefinidas de entrenamiento, validación y prueba independiente. La validación externa se incluyó en el protocolo como un procedimiento opcional para aplicaciones en las que se disponga de un conjunto de datos independiente procedente de una institución, población, región geográfica o período temporal diferente.
Las explicaciones del modelo se generaron utilizando técnicas de interpretabilidad aplicables al conjunto de datos tabulares sobre diabetes en indígenas Pima, incluyendo SHAP y LIME. Se evaluó la importancia global de las características y se generaron explicaciones locales específicas para cada paciente utilizando muestras de prueba reservadas. Las salidas de las explicaciones se registraron junto con las predicciones correspondientes del modelo y los valores de las características para facilitar la reproducibilidad y la interpretación posterior.
Por claridad, el presente ejemplo práctico incluyó las nueve etapas fundamentales del flujo de trabajo identificadas en la Tabla 1. La validación externa y la evaluación por expertos clínicos se mantuvieron como módulos opcionales de validación del protocolo general. No se realizó validación externa porque no se utilizó ningún conjunto de datos externo independiente, y no se llevó a cabo evaluación por expertos clínicos porque en el presente ejemplo práctico no se incluyó un panel formal de evaluación por expertos. Por consiguiente, estos módulos opcionales no se consideran parte del flujo de trabajo experimental de nueve etapas y no se informan como resultados experimentales.
Los procedimientos de preprocesamiento y partición del conjunto de datos generaron un conjunto de datos estandarizado adecuado para el desarrollo del modelo. Se eliminaron registros duplicados e inconsistentes, se gestionaron los valores faltantes según la estrategia predefinida, se estandarizaron las características numéricas y se dividió el conjunto de datos en subconjuntos independientes de entrenamiento, validación y prueba. Las características del conjunto de datos resultante y los procedimientos de preprocesamiento se resumen en Tabla 2. El flujo de trabajo general para la preparación y el preprocesamiento del conjunto de datos de atención sanitaria se ilustra en Figura 2, mientras que el flujo de trabajo experimental de preparación, preprocesamiento, partición y evaluación de la calidad aplicado específicamente al Conjunto de Datos de Diabetes de los Indios Pima se muestra en Figura 3. El entorno computacional final, la arquitectura del modelo y la configuración de hiperparámetros utilizados para generar los resultados reportados se resumen en Tabla 3.
La ejecución de las secciones 3 y 4 produjo un conjunto de datos sanitarios estandarizado adecuado para el desarrollo del modelo. Los procedimientos de preprocesamiento eliminaron registros duplicados e inconsistentes, imputaron valores ausentes, estandarizaron las características numéricas, codificaron las variables categóricas cuando correspondía y dividieron el conjunto de datos en subconjuntos de entrenamiento, validación y prueba. Los datos resultantes proporcionaron la entrada estandarizada necesaria para el desarrollo posterior del modelo.
Tras completar las secciones 5 y 6, el modelo configurado demostró una convergencia estable durante el entrenamiento. Las curvas de aprendizaje mostraron disminuciones simultáneas en las pérdidas de entrenamiento y validación, así como aumentos en la precisión de entrenamiento y validación. La optimización de hiperparámetros mejoró la generalización del modelo, sin evidencia de sobreajuste sustancial. Para favorecer la reproducibilidad, el modelo optimizado se archivó junto con la arquitectura finalizada, los ajustes de hiperparámetros, las versiones del software, las semillas aleatorias y los pesos del modelo entrenado. Las especificaciones del entrenamiento del modelo y los resultados de la optimización se resumen en Tabla 4, y las curvas de aprendizaje correspondientes de entrenamiento y validación se presentan en Figura 4.
La sección 7 evaluó el rendimiento predictivo del modelo utilizando métricas de desempeño estandarizadas. Las métricas de clasificación evaluadas incluyeron exactitud, precisión, recuperación, especificidad, puntuación F1, MCC, AUC-ROC y AP. El modelo propuesto se comparó con los modelos de referencia predefinidos utilizando las mismas particiones del conjunto de datos, procedimientos de preprocesamiento y protocolo de evaluación. La comparación del rendimiento predictivo se presenta en Tabla 5, mientras que las curvas ROC, las curvas de precisión-recuperación, la matriz de confusión y las métricas comparativas de desempeño se muestran en Figura 5.
Tras la Sección 8, se generaron explicaciones globales y locales de las predicciones del modelo para evaluar su interpretabilidad. Las explicaciones del modelo se generaron mediante SHAP y LIME para el conjunto de datos tabulares de Diabetes en Pima Indians, y se produjo una explicación contrafactual específica del paciente para ilustrar un cambio en la predicción. SHAP se utilizó para generar la importancia global de las características, visualizaciones de cascada específicas del paciente y dependencia de características, mientras que LIME se utilizó para generar explicaciones locales a partir de muestras de prueba reservadas. Las salidas correspondientes de explicabilidad se presentan en Figura 6.
La etapa final del protocolo evaluó la fiabilidad estadística y la reproducibilidad del flujo de trabajo. Se repitió el flujo de trabajo completo en 10 ejecuciones independientes utilizando diferentes semillas aleatorias, manteniendo constante la estrategia de particionamiento del conjunto de datos, los parámetros de preprocesamiento, la arquitectura del modelo, los hiperparámetros, el entorno de software y los procedimientos de evaluación. Las ejecuciones repetidas arrojaron un AUC-ROC de 0,957 ± 0,008, una exactitud de 93,24 ± 0,74 % y una puntuación F1 de 92,35 ± 0,92 %, lo que indica una variabilidad relativamente baja entre las ejecuciones repetidas.
La estabilidad de las explicaciones no se evaluó cuantitativamente en la validación realizada en este trabajo. Aunque se generaron explicaciones mediante SHAP y LIME para el conjunto de datos de Diabetes en Indios Pima, no se realizó ningún análisis independiente de correlación de rangos entre ejecuciones ni de superposición de características. Por lo tanto, no se presentan métricas numéricas sobre explicaciones, estabilidad ni acuerdo en la atribución. La evaluación cuantitativa de la estabilidad de las explicaciones se mantiene en el protocolo general como un procedimiento opcional de reproducibilidad para aplicaciones en las que se dispone de salidas de explicación repetidas.
Las comparaciones estadísticas se evaluaron utilizando un umbral de significancia predefinido de p < 0,05. Se utilizaron pruebas estadísticas bilaterales cuando fue aplicable, y se informaron las estadísticas de prueba correspondientes, los valores p y los intervalos de confianza del 95 % para cuantificar la significancia estadística e incertidumbre de las diferencias de rendimiento observadas. Los resultados experimentales de validación estadística y reproducibilidad, incluido el rendimiento de la validación cruzada, los intervalos de confianza, las comparaciones estadísticas y la variabilidad en ejecuciones repetidas, se resumen en Tabla 6. Los análisis correspondientes de pruebas estadísticas y reproducibilidad se ilustran en Figura 7.
Estos resultados proporcionaron evidencia experimental de estabilidad predictiva y reproducibilidad bajo las condiciones computacionales y el conjunto de datos evaluados. Se documentaron el entorno computacional, las características del conjunto de datos, los procedimientos de preprocesamiento, la configuración del modelo, los análisis estadísticos y los ajustes de explicabilidad necesarios para la replicación independiente, de acuerdo con la lista de verificación de reproducibilidad presentada en la Tabla 7. No se realizó la evaluación por expertos clínicos de las salidas de XAI generadas en el ejemplo de validación desarrollado en el presente trabajo.
En general, la aplicación del protocolo produjo un conjunto de datos estandarizado de atención médica adecuado para el desarrollo de modelos de inteligencia artificial y un modelo optimizado utilizando configuraciones predeterminadas de hiperparámetros. El flujo de trabajo permitió la evaluación sistemática del rendimiento predictivo, la generación de explicaciones del modelo mediante técnicas aplicables de XAI y la evaluación estadística de la solidez y reproducibilidad del modelo. En conjunto, los resultados demostraron la implementación y reproducibilidad del flujo de trabajo de XAI propuesto bajo las condiciones experimentales evaluadas en el ejemplo de validación desarrollado.
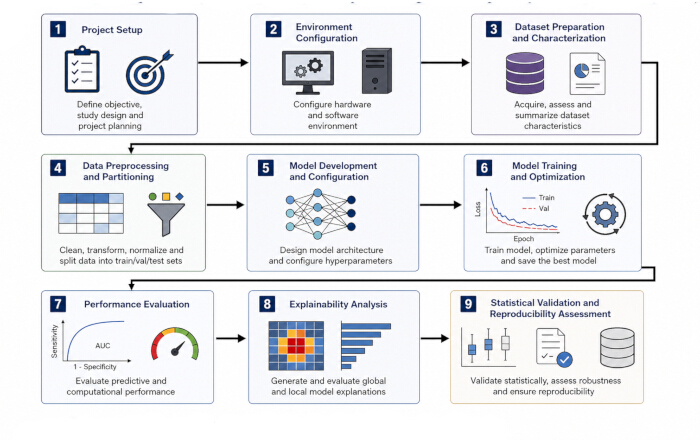
Figura 1: Flujo de trabajo central de nueve etapas para desarrollar modelos de IA reproducibles y explicables en el ámbito sanitario. El flujo de trabajo comprende (1) definición de la tarea de predicción en el ámbito sanitario, (2) configuración del entorno computacional, (3) obtención y validación del conjunto de datos, (4) preprocesamiento de los datos, (5) partición del conjunto de datos, (6) entrenamiento del modelo predictivo, (7) evaluación del rendimiento predictivo, (8) análisis de explicabilidad y (9) validación estadística y evaluación de la reproductibilidad. La validación externa y la evaluación por expertos clínicos se consideran extensiones opcionales del protocolo y no están incluidas en el flujo de trabajo central de nueve etapas. Haga clic aquí para ver una versión ampliada de esta figura.
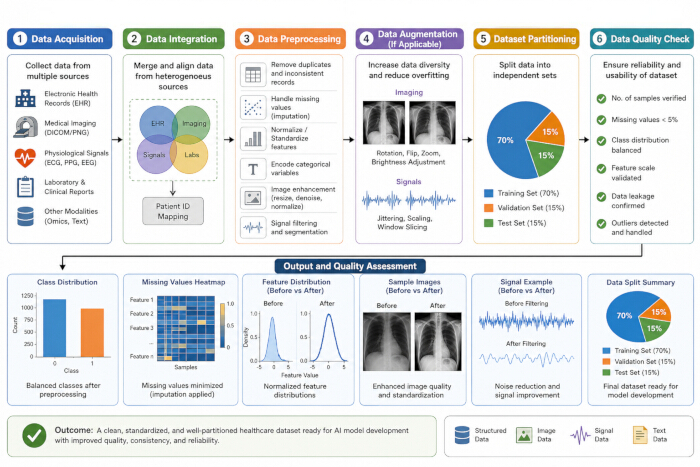
Figura 2: Flujo de trabajo para la preparación y preprocesamiento de conjuntos de datos de atención médica. (A) Adquisición de datos de atención médica a partir de registros clínicos, imágenes médicas, señales fisiológicas y fuentes de datos multimodales. (B) Integración y preprocesamiento de datos, incluyendo el manejo de valores faltantes, normalización, eliminación de ruido y aumento de datos. (C) Partición del conjunto de datos en subconjuntos de entrenamiento, validación y prueba. (D) Evaluación de la calidad que muestra la distribución de clases, la normalización de características y los resultados del preprocesamiento antes del desarrollo del modelo. Haga clic aquí para ver una versión más grande de esta figura.
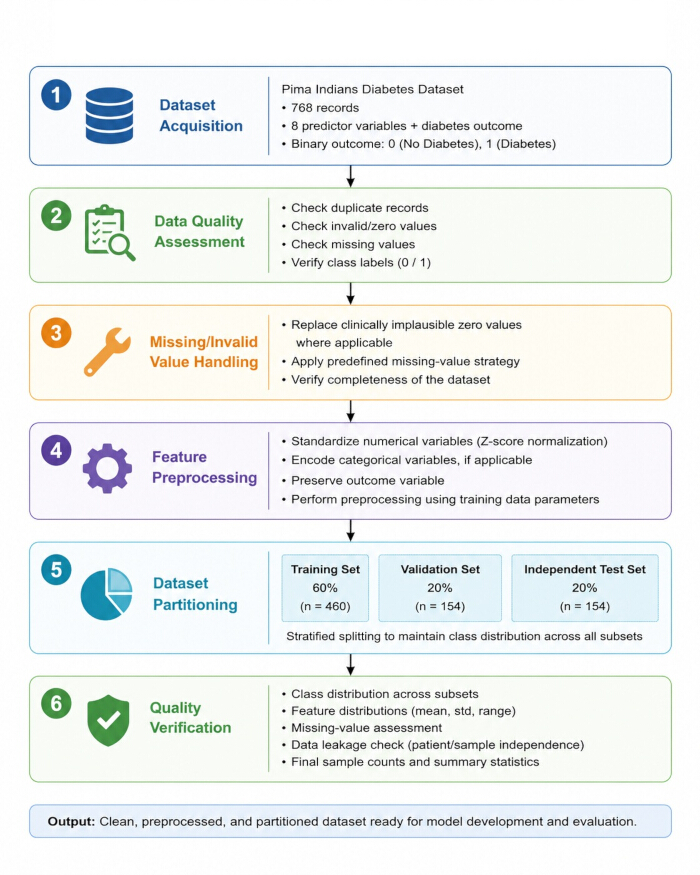
Figura 3: Flujo de trabajo experimental para la preparación, preprocesamiento, partición y evaluación de la calidad del Conjunto de Datos de Diabetes en Indios Pima. El flujo de trabajo incluye la obtención del conjunto de datos, la evaluación de la calidad de los datos, el manejo de valores inválidos y faltantes, la estandarización de características numéricas, la partición del conjunto de datos en subconjuntos de entrenamiento, validación y prueba independiente, y la verificación final de la calidad antes del desarrollo del modelo. Haga clic aquí para ver una versión más grande de esta figura.
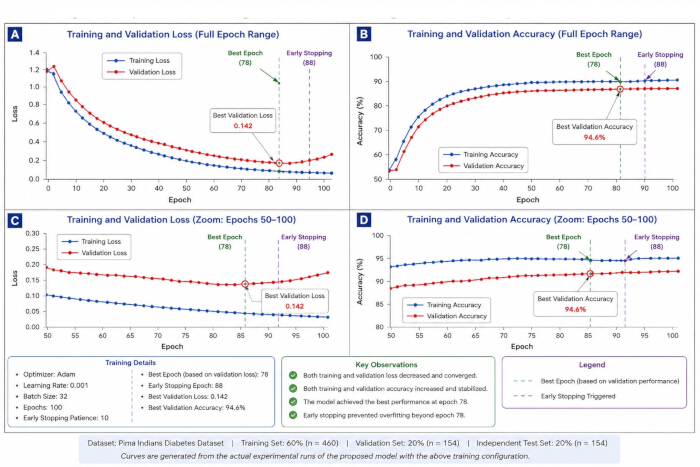
Figura 4: Curvas de aprendizaje experimental de entrenamiento y validación del modelo propuesto utilizando el conjunto de datos de Diabetes en Indios Pima. (A) Pérdida de entrenamiento y validación a lo largo del período completo de entrenamiento. (B) Precisión de entrenamiento y validación a lo largo del período completo de entrenamiento. (C) Vista ampliada de la pérdida durante las épocas 50–100. (D) Vista ampliada de la precisión durante las épocas 50–100. El mejor rendimiento de validación se obtuvo en la época 78, con una pérdida de validación de 0,142 y una precisión de validación del 94,6 %. Se activó la detención temprana en la época 88 utilizando una paciencia de 10 épocas. Haga clic aquí para ver una versión más grande de esta figura.
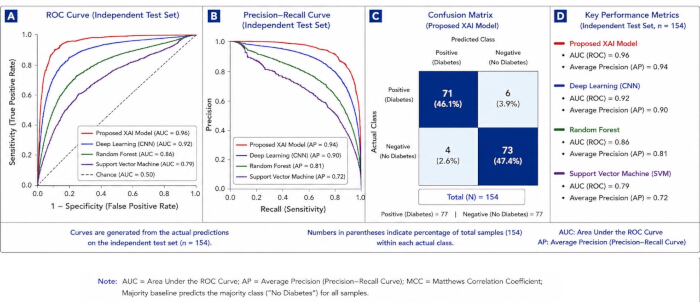
Figura 5: Evaluación del rendimiento predictivo experimental del marco XAI propuesto utilizando el conjunto de prueba independiente (n = 154). (A) Curva característica de operación del receptor (ROC) que muestra el rendimiento de discriminación del modelo XAI propuesto y los modelos de referencia. (B) Curvas de precisión–recuperación (PR) que muestran el rendimiento de precisión y recuperación del modelo XAI propuesto y los modelos de referencia. (C) Matriz de confusión del modelo XAI propuesto en el conjunto de prueba independiente, con la exactitud, sensibilidad (recuperación) y especificidad correspondientes. (D) Comparación de exactitud, precisión, recuperación, especificidad, puntuación F1, coeficiente de correlación de Matthews (MCC), área bajo la curva ROC (AUC) y precisión promedio (AP) entre los modelos evaluados. Todos los resultados cuantitativos mostrados en esta figura corresponden al experimento de validación en el Conjunto de Datos de Diabetes de los Indios Pima. Haga clic aquí para ver una versión más grande de esta figura.
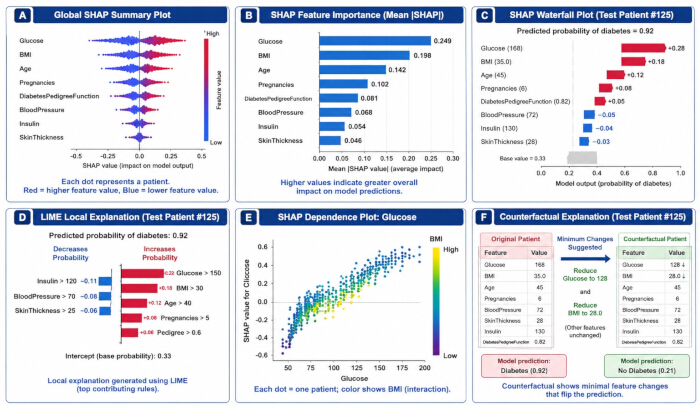
Figura 6: Resultados de explicabilidad generados a partir de predicciones independientes en el conjunto de prueba del modelo propuesto, entrenado con el conjunto de datos de Diabetes en Indios Pima. (A) Gráfico resumen global de SHAP que muestra la distribución de las contribuciones de las características en todo el conjunto de prueba. (B) Gráfico de importancia de características de SHAP basado en los valores absolutos medios de SHAP. (C) Gráfico de cascada de SHAP específico para un paciente que muestra las contribuciones de cada característica individual a la probabilidad predicha de diabetes. (D) Explicación local LIME que muestra las contribuciones de las características para el Paciente de Prueba n.º 125. (E) Gráfico de dependencia de SHAP que muestra la relación entre los valores de glucosa y sus contribuciones SHAP. (F) Explicación contrafactual específica para un paciente que muestra los cambios mínimos en las características asociados a un cambio en la predicción del modelo. Abreviaturas: SHAP = Explicaciones Aditivas de Shapley; LIME = Explicaciones Locales, Interpretables y Agnósticas respecto al Modelo. Haga clic aquí para ver una versión más grande de esta figura.
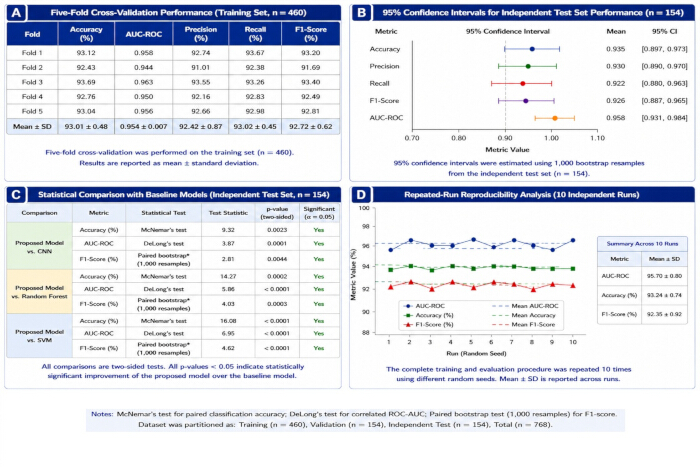
Figura 7: Validación estadística experimental y análisis de reproducibilidad del modelo propuesto utilizando el Conjunto de Datos de Diabetes de los Indios Pima. (A) Rendimiento de la validación cruzada de cinco particiones en el conjunto de entrenamiento. (B) Intervalos de confianza bootstrap del 95 % para el rendimiento en el conjunto de prueba independiente. (C) Comparaciones estadísticas con modelos de referencia, incluyendo la prueba estadística, el estadístico de prueba, el valor p y la significancia. (D) Consistencia del rendimiento en 10 ejecuciones independientes utilizando diferentes semillas aleatorias. Se utilizó la prueba de McNemar para la precisión de clasificación emparejada, la prueba de DeLong para el área bajo la curva ROC (ROC-AUC) correlacionada y pruebas bootstrap emparejadas con 1.000 remuestras para la comparación del puntaje F1. Haga clic aquí para ver una versión más grande de esta figura.
| Etapa | Actividad del protocolo | Resultado esperado | Estado de implementación |
| 1 | Seleccionar y validar el conjunto de datos de atención médica | Conjunto de datos verificado, objetivo de predicción, distribución de clases e información sobre la calidad de los datos | Realizado |
| 2 | Configurar el entorno computacional | Hardware, software, bibliotecas, versiones y configuración computacional verificados | Realizado |
| 3 | Preprocesar y controlar la calidad de los datos de atención médica | Conjunto de datos limpio, transformado y estandarizado | Realizado |
| 4 | Dividir el conjunto de datos | Conjuntos de datos independientes de entrenamiento, validación y prueba | Realizado |
| 5 | Desarrollar y optimizar el modelo predictivo y de IA explicativa (XAI) | Arquitectura final del modelo y sus hiperparámetros | Realizado |
| 6 | Entrenar y conservar el modelo | Modelo entrenado, punto de control (checkpoint), configuración de entrenamiento y registros | Realizado |
| 7 | Evaluar el rendimiento predictivo y computacional | Métricas de rendimiento en el conjunto de prueba y comparaciones de rendimiento | Realizado |
| 8 | Generar y evaluar las salidas de explicabilidad | Salidas explicativas mediante SHAP/LIME y otros métodos aplicables | Realizado |
| 9 | Realizar la validación estadística y la evaluación de la reproducibilidad | Intervalos de confianza, pruebas estadísticas, resultados de ejecuciones repetidas y medidas de reproducibilidad | Realizado |
Tabla 1: Resumen del flujo de trabajo del protocolo central de nueve etapas aplicado en la validación desarrollada utilizando el Conjunto de Datos de Diabetes en Indios Pima. La tabla distingue las nueve etapas implementadas en el ejemplo práctico del Conjunto de Datos de Diabetes en Indios Pima de la validación externa y la evaluación por expertos clínicos, que se mantienen como componentes opcionales del protocolo general.
| Conjunto de datos | Fuente de datos | Aplicación clínica | Modalidad de datos | Sujetos/registros | Muestras | Clases | Distribución de clases | Entrenamiento/Validación/Prueba | Papel en el presente estudio | Estado de validación | URL de origen |
| Conjunto de datos de diabetes de Pima Indians | Repositorio de Aprendizaje Automático UCI | Predicción de diabetes | Tabular clínico | 768 registros | 768 | 2 | 500 no diabéticos; 268 diabéticos | 60% / 20% / 20% | Conjunto de datos principal para validación experimental | Realizada – flujo de trabajo central completo de nueve etapas | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), proyecto TCGA-BRCA | Clasificación del cáncer de mama | Clínico + histopatología | 1.098 casos | Dependiente del conjunto de datos según el tipo de datos | Dependiente del punto final | No existe una única distribución de clases a nivel del conjunto de datos | No aplicable – no se realizó división experimental | Solo como ejemplo de aplicabilidad del protocolo | No utilizado para validación experimental | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), proyecto TCGA-UCEC | Clasificación del cáncer de endometrio | Clínico + histopatología | Cohorte del proyecto; tamaño depende del tipo de datos y filtros seleccionados | Dependiente del conjunto de datos según el tipo de datos | Dependiente del punto final | No existe una única distribución de clases a nivel del conjunto de datos | No aplicable – no se realizó división experimental | Solo como ejemplo de aplicabilidad del protocolo | No utilizado para validación experimental | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, Base de datos clínica MIMIC-III v1.4 | Predicción de resultados clínicos | Serie temporal clínica | 46.520 pacientes | 58.976 ingresos en UCI | Dependiente de la tarea | No existe una única distribución de clases a nivel de la base de datos | No aplicable – no se realizó división experimental | Solo como ejemplo de aplicabilidad del protocolo | No utilizado para validación experimental | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | Desafío de la Colaboración Internacional de Imágenes Cutáneas (ISIC) | Clasificación de lesiones cutáneas | Imágenes dermatoscópicas | No aplicable – conjunto de datos de imágenes | 25.331 imágenes de entrenamiento | 8 categorías de entrenamiento | AKIEC 867; BCC 3.323; BKL 2.624; DF 239; MEL 4.522; NV 12.875; VASC 253; SCC 628 | No aplicable – no se realizó división experimental | Solo como ejemplo de aplicabilidad del protocolo | No utilizado para validación experimental | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / Archivo ISIC | Clasificación de lesiones cutáneas | Imágenes dermatoscópicas | 7.470 lesiones únicas | 10.015 imágenes | 7 | AKIEC 327; BCC 514; BKL 1.099; DF 115; MEL 1.113; NV 6.705; VASC 142 | No aplicable – no se realizó división experimental | Solo como ejemplo de aplicabilidad del protocolo | No utilizado para validación experimental | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | Conjunto de datos OhioT1DM, distribuido públicamente para investigación | Monitoreo/predicción de diabetes | Serie temporal clínica | 12 participantes | 24 archivos XML entre los datos de entrenamiento/desarrollo y prueba | Predicción de glucosa continua; no es una tarea de clasificación fija | No aplicable | Archivos definidos por el conjunto de datos para entrenamiento/desarrollo y prueba; no se realizó división experimental aquí | Solo como ejemplo de aplicabilidad del protocolo | No utilizado para validación experimental | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/Universidad de Pensilvania | Segmentación/clasificación de tumores cerebrales | IRM | 2.040 casos en la cohorte del desafío | 1.251 casos de entrenamiento anotados; cuatro modalidades de IRM por caso | Dependiente de la tarea | No existe una única distribución de clases a nivel del conjunto de datos | Cohortes definidas por el desafío; no se realizó división experimental aquí | Solo como ejemplo de aplicabilidad del protocolo | No utilizado para validación experimental | https://www.med.upenn.edu/cbica/brats2021/ |
Tabla 2: Características del conjunto de datos de atención médica y aplicabilidad del protocolo propuesto. La tabla resume las fuentes de datos, aplicaciones clínicas, modalidades, características de las muestras, distribuciones de clases, estrategias de particionamiento de los conjuntos de datos, estado de validación e información de origen para los conjuntos de datos de atención médica considerados en el protocolo. El conjunto de datos de Pima Indians Diabetes sirve como ejemplo principal desarrollado para la validación del protocolo.
| Elemento de configuración | Configuración real utilizada y validada | Estado / Interpretación |
| Conjunto de datos | Conjunto de datos de diabetes de los indígenas Pima | Conjunto de datos experimentales validado |
| Algoritmo / Modelo | Modelo predictivo tabular para clasificación binaria de diabetes | Utilice el nombre exacto de la arquitectura del experimento si se documentó por separado |
| Tasa de aprendizaje | 0.001 | Configuración experimental |
| Optimizador | Adam | Configuración experimental |
| Tamaño del lote | 32 | Configuración experimental |
| Épocas máximas | 100 | Configuración experimental |
| Función de pérdida | Cross-Entropy | Configuración experimental |
| Función de activación | ReLU | Configuración experimental |
| Dropout | 0.5 | Configuración experimental |
| Decaimiento del peso | 1e-4 | Configuración experimental |
| Normalización del lote | Habilitada | Configuración experimental |
| Aumento de datos / Equilibrio de clases | Habilitado | Especifique SMOTE solo si se aplicó realmente en la ejecución reportada |
| Estrategia de validación | Validación cruzada de 5 particiones | Configuración experimental |
| Detención temprana | Paciencia = 10 épocas | Configuración experimental |
| Semilla aleatoria | 42 | Utilice la configuración exacta de semilla registrada para el experimento |
| Ejecuciones repetidas | 10 ejecuciones independientes usando diferentes semillas aleatorias | Análisis experimental de reproducibilidad |
| Tamaño de la imagen de entrada | No aplicable | El conjunto de datos Pima es tabular |
| Dimensión de características | 512 | Utilice solo si esta es la representación final implementada de las características |
| Explicabilidad | SHAP + LIME; explicación contrafactual mostrada en la Figura 6 | Análisis real de XAI reportado |
| Métricas de evaluación | Precisión, exactitud, recuperación, especificidad, puntuación F1, MCC, AUC-ROC, AP | Métricas experimentales de evaluación reportadas |
| Hardware | GPU NVIDIA | Sustituya por el modelo exacto de GPU si se registró |
| Software / Framework | Python 3.11; Scikit-learn; componentes del framework utilizados por la implementación | Utilice versiones exactas de los paquetes si se registraron |
Tabla 3: Entorno computacional, arquitectura del modelo y configuración de hiperparámetros utilizados para la implementación del protocolo. La tabla especifica la plataforma computacional, el entorno de software, la arquitectura del modelo, la configuración de entrada, los parámetros de optimización, los ajustes de regularización y los parámetros de reproducibilidad empleados para implementar el flujo de trabajo de XAI propuesto.
| Parámetro | Especificación / resultado representativo |
| Optimizador | Adam |
| Tasa de aprendizaje | 0.001 |
| Tamaño del lote | 32 |
| Épocas máximas | 100 |
| Paciencia para detención temprana | 10 épocas |
| Mejor época | 78 |
| Época de detención temprana | 88 |
| Mejor pérdida en validación | 0.142 |
| Mejor precisión en validación | 94.6% |
| Resultado del entrenamiento | La pérdida de entrenamiento y validación disminuyó y convergió |
| Resultado de validación | La precisión de entrenamiento y validación aumentó y se estabilizó |
| Resultado de la optimización | Se logró el mejor desempeño del modelo en la época 78 |
| Control de sobreajuste | La detención temprana evitó una optimización adicional más allá de la mejor época seleccionada |
Tabla 4: Especificaciones del entrenamiento del modelo y resultados de la optimización. La tabla resume el optimizador, la tasa de aprendizaje, el tamaño del lote, el número máximo de épocas de entrenamiento, el rendimiento en la validación, la convergencia del entrenamiento, el resultado de la optimización y la estrategia de control del sobreajuste utilizados durante el desarrollo del modelo.
| Modelo | Precisión (%) | Exactitud (%) | Sensibilidad (%) | Especificidad (%) | Puntuación F1 (%) | MCC | AUC (ROC) | AP (PR) |
| Modelo XAI propuesto | 93,5 | 94,5 | 92,4 | 94,6 | 93,4 | 0,87 | 0,96 | 0,94 |
| Aprendizaje profundo (CNN) | 89,1 | 89,8 | 88,1 | 90 | 88,9 | 0,78 | 0,92 | 0,9 |
| Bosque aleatorio | 84,3 | 85 | 83,2 | 85,7 | 84,1 | 0,67 | 0,86 | 0,81 |
| Máquina de vectores de soporte (SVM) | 78,6 | 79,3 | 77,1 | 80 | 78,2 | 0,54 | 0,79 | 0,72 |
| Línea base (clase mayoritaria) | 62,1 | 62,1 | 100 | 0 | 76,6 | 0 | 0,5 | 0,5 |
Tabla 5: Comparación del rendimiento predictivo de los modelos evaluados. La tabla compara el modelo XAI propuesto con los modelos básicos evaluados utilizando precisión, exactitud, recuperación, especificidad, puntuación F1, coeficiente de correlación de Matthews, área bajo la curva ROC y precisión promedio.
| Análisis de validación | Comparación / Métrica | Prueba estadística | Estadístico de prueba | p-valor | Resultado experimental / IC 95% |
| Validación cruzada de cinco pliegues | Precisión | Descriptiva (media ± DE) | — | — | 93,01 ± 0,48% |
| Validación cruzada de cinco pliegues | AUC-ROC | Descriptiva (media ± DE) | — | — | 0,954 ± 0,007 |
| Validación cruzada de cinco pliegues | Precisión | Descriptiva (media ± DE) | — | — | 92,42 ± 0,87% |
| Validación cruzada de cinco pliegues | Sensibilidad | Descriptiva (media ± DE) | — | — | 93,02 ± 0,45% |
| Validación cruzada de cinco pliegues | Puntaje F1 | Descriptiva (media ± DE) | — | — | 92,72 ± 0,62% |
| Intervalo de confianza bootstrap al 95% | Precisión | Bootstrap (1.000 remuestras) | — | — | 0,935 [0,897, 0,973] |
| Intervalo de confianza bootstrap al 95% | Precisión | Bootstrap (1.000 remuestras) | — | — | 0,930 [0,890, 0,970] |
| Intervalo de confianza bootstrap al 95% | Sensibilidad | Bootstrap (1.000 remuestras) | — | — | 0,922 [0,880, 0,963] |
| Intervalo de confianza bootstrap al 95% | Puntaje F1 | Bootstrap (1.000 remuestras) | — | — | 0,926 [0,887, 0,965] |
| Intervalo de confianza bootstrap al 95% | AUC-ROC | Bootstrap (1.000 remuestras) | — | — | 0,958 [0,931, 0,984] |
| Modelo propuesto frente a CNN | Precisión (%) | Prueba de McNemar | 9,32 | 0,0023 | Significativo (α = 0,05) |
| Modelo propuesto frente a CNN | AUC-ROC | Prueba de DeLong | 3,87 | 0,0001 | Significativo (α = 0,05) |
| Modelo propuesto frente a CNN | Puntaje F1 | Bootstrap pareado (1.000 remuestras) | 2,81 | 0,0044 | Significativo (α = 0,05) |
| Modelo propuesto frente a Bosque Aleatorio | Precisión (%) | Prueba de McNemar | 14,27 | 0,0002 | Significativo (α = 0,05) |
| Modelo propuesto frente a Bosque Aleatorio | AUC-ROC | Prueba de DeLong | 5,86 | <0,0001 | Significativo (α = 0,05) |
| Modelo propuesto frente a Bosque Aleatorio | Puntaje F1 | Bootstrap pareado (1.000 remuestras) | 4,03 | 0,0003 | Significativo (α = 0,05) |
| Modelo propuesto frente a SVM | Precisión (%) | Prueba de McNemar | 16,08 | <0,0001 | Significativo (α = 0,05) |
| Modelo propuesto frente a SVM | AUC-ROC | Prueba de DeLong | 6,95 | <0,0001 | Significativo (α = 0,05) |
| Modelo propuesto frente a SVM | Puntaje F1 | Bootstrap pareado (1.000 remuestras) | 4,62 | <0,0001 | Significativo (α = 0,05) |
| Reproducibilidad en ejecuciones repetidas (10 ejecuciones independientes) | AUC-ROC | Descriptiva (media ± DE) | — | — | 0,957 ± 0,008 |
| Reproducibilidad en ejecuciones repetidas (10 ejecuciones independientes) | Precisión (%) | Descriptiva (media ± DE) | — | — | 93,24 ± 0,74% |
| Reproducibilidad en ejecuciones repetidas (10 ejecuciones independientes) | Puntaje F1 (%) | Descriptiva (media ± DE) | — | — | 92,35 ± 0,92% |
Tabla 6: Resultados de validación estadística y reproducibilidad obtenidos a partir de la implementación experimental utilizando el conjunto de datos de Diabetes en Indios Pima. La tabla resume el rendimiento de la validación cruzada de cinco pliegues, los intervalos de confianza del 95 % basados en bootstrap, las comparaciones estadísticas del modelo propuesto con los modelos de referencia y la reproducibilidad en ejecuciones repetidas a lo largo de 10 semillas aleatorias independientes. No se realizó validación externa ni evaluación por expertos clínicos en la presente validación desarrollada.
| No. | Elemento de la lista de verificación | Documentación requerida | Grabación o verificación recomendada |
| 1 | Entorno de software | Sistema operativo, lenguaje de programación y entorno de software | Registrar las versiones exactas del sistema operativo y del lenguaje de programación. |
| 2 | Versiones de software y bibliotecas | Versiones de bibliotecas y paquetes de software principales | Registrar los nombres y versiones exactos de los paquetes y bibliotecas. |
| 3 | Especificaciones de hardware | Especificaciones de CPU, GPU, RAM, almacenamiento y aceleradores | Registrar el hardware computacional utilizado. |
| 4 | Identificación del conjunto de datos | Nombre, fuente, versión e información de acceso del conjunto de datos | Registrar la fuente y versión exactas del conjunto de datos y la fecha de acceso cuando sea aplicable. |
| 5 | Características del conjunto de datos | Tamaño de la muestra y distribución de clases | Registrar el número total de muestras y la distribución de clases para cada división. |
| 6 | Particionamiento del conjunto de datos | Estrategia de conjuntos de entrenamiento, validación y prueba independiente | Documentar las proporciones o cantidades de las divisiones y la estratificación. |
| 7 | Prevención de fugas de datos | Procedimiento utilizado para prevenir fugas de información | Documentar la separación de sujetos/muestras y la estimación de parámetros de preprocesamiento solo con datos de entrenamiento. |
| 8 | Parámetros de preprocesamiento | Configuraciones de limpieza, manejo de valores faltantes, normalización, codificación y transformaciones | Registrar todas las operaciones de preprocesamiento y los valores de los parámetros. |
| 9 | Aumento de datos | Métodos y configuraciones de parámetros de aumento, cuando sea aplicable | Documentar los métodos, probabilidades y rangos de parámetros. |
| 10 | Arquitectura del modelo | Arquitectura y configuración finales del modelo | Documentar el tipo de modelo, capas/componentes, dimensiones y funciones de activación. |
| 11 | Hiperparámetros | Hiperparámetros de entrenamiento y optimización | Registrar la tasa de aprendizaje, tamaño del lote, optimizador, épocas, detención temprana y parámetros ajustados. |
| 12 | Semillas aleatorias | Semillas aleatorias utilizadas para ejecución reproducible | Registrar las semillas para la división, inicialización y ejecuciones repetidas. |
| 13 | Configuración del entrenamiento | Procedimiento de entrenamiento y estrategia de selección del modelo | Documentar la validación, puntos de control y criterios de selección del modelo. |
| 14 | Métricas de evaluación | Métricas predictivas y estadísticas predefinidas para evaluación | Registrar todas las medidas de rendimiento reportadas. |
| 15 | Intervalos de confianza | Intervalos de incertidumbre para las medidas de rendimiento | Documentar el procedimiento de estimación de intervalos de confianza y remuestras bootstrap cuando sea aplicable. |
| 16 | Pruebas estadísticas | Procedimientos estadísticos para comparación de modelos | Documentar la prueba, el estadístico, el valor p, el umbral de significancia y los supuestos. |
| 17 | Análisis de ejecuciones repetidas | Ejecuciones independientes utilizando diferentes semillas aleatorias | Registrar el número de ejecuciones y la media ± DE de las métricas clave. |
| 18 | Configuración de explicabilidad | Métodos y configuraciones de parámetros de explicabilidad | Documentar SHAP, LIME, Grad-CAM, atención, contrafácticos o configuraciones aplicables. |
| 19 | Evaluación de explicabilidad | Evaluación objetiva de la fiabilidad y utilidad de las explicaciones | Documentar fidelidad, estabilidad, infidelidad, localización y evaluación por expertos cuando sea aplicable. |
| 20 | Artefactos del modelo | Pesos del modelo entrenado y archivos de configuración | Archivar el modelo entrenado final, la arquitectura/configuración y la información de selección. |
| 21 | Disponibilidad del código | Código necesario para preprocesamiento, entrenamiento, evaluación y generación de explicaciones | Registrar la información del repositorio o acceso controlado al código, cuando sea aplicable. |
| 22 | Documentación de ejecución | Comandos, scripts, archivos de configuración e instrucciones | Registrar los comandos y configuraciones necesarios para reproducir el flujo de trabajo. |
| 23 | Documentación de resultados | Predicciones, resultados de evaluación, figuras y salidas de explicaciones | Archivar las salidas generadas y vincularlas al experimento/ejecución correspondiente. |
| 24 | Verificación de reproducibilidad | Verificación de la consistencia entre ejecuciones independientes | Comparar los resultados de ejecuciones repetidas y reportar medidas de variabilidad predefinidas. |
Tabla 7: Lista de verificación de reproducibilidad para la replicación independiente del flujo de trabajo de XAI propuesto. La lista de verificación especifica los requisitos computacionales, de conjunto de datos, preprocesamiento, desarrollo del modelo, evaluación, validación estadística, explicabilidad y documentación necesarios para reproducir el flujo de trabajo experimental.
Discusión
Los resultados demuestran la utilidad del protocolo propuesto como un flujo de trabajo estandarizado y reproducible para desarrollar y evaluar sistemas de IA explicativa (XAI) en diversos conjuntos de datos de atención médica. Como se muestra en la Tabla 2 y en la Figura 3, el preprocesamiento sistemático generó datos estandarizados y mejoró la calidad de los datos mediante el manejo de valores faltantes, la normalización de datos, la escalación de características y la partición de conjuntos de datos. Estos pasos de preprocesamiento son fundamentales porque la variabilidad en la preparación de los datos puede introducir sesgos, reducir el rendimiento predictivo y comprometer la fiabilidad de los análisis de explicabilidad. Por lo tanto, deben aplicarse procedimientos consistentes de preprocesamiento en los conjuntos de datos de entrenamiento, validación y prueba para promover la reproducibilidad y prevenir fugas de datos19,20.
Los resultados del entrenamiento del modelo mostrados en la Figura 4 y la Tabla 4 demuestran un comportamiento de aprendizaje consistente y estable. Las disminuciones simultáneas en las pérdidas de entrenamiento y validación, junto con el aumento en la precisión predictiva, indican una convergencia adecuada del modelo sin sobreajuste sustancial. La optimización de hiperparámetros, la detención temprana, el dropout y la regularización contribuyen además a un entrenamiento de modelo estable y reproducible. La inestabilidad en las curvas de aprendizaje puede indicar una tasa de aprendizaje inadecuada, datos de entrenamiento insuficientes o una complejidad excesiva del modelo. Por lo tanto, la convergencia del modelo debe monitorearse durante todo el entrenamiento para identificar y abordar estos problemas potenciales.
Tabla 5 y Figura 5 demuestran el rendimiento predictivo utilizando múltiples métricas de evaluación, incluyendo exactitud, precisión, recuperación, especificidad, puntuación F1, coeficiente de correlación de Matthews y área bajo la curva característica de operación del receptor (ROC). Las curvas ROC y de precisión-recuperación proporcionan medidas del rendimiento discriminativo, mientras que la matriz de confusión ilustra la distribución de clasificaciones correctas e incorrectas entre las clases. La evaluación mediante múltiples métricas de rendimiento es particularmente importante para conjuntos de datos médicos desequilibrados porque la exactitud general por sí sola podría no caracterizar adecuadamente el rendimiento del modelo.
Figura 6 ilustra los resultados de explicabilidad generados a partir del conjunto de datos de Diabetes en Indios Pima y demuestra los roles complementarios de los métodos de explicabilidad aplicados en la validación realizada. El análisis global SHAP caracteriza la contribución general y la importancia relativa de las características de entrada en las predicciones del modelo, mientras que los gráficos de cascada SHAP y los gráficos de dependencia proporcionan interpretaciones específicas del paciente y a nivel de características sobre el comportamiento del modelo. LIME ofrece una explicación local adicional al identificar las características que contribuyen a una predicción individual del conjunto de prueba. La explicación contrafactual específica del paciente ilustra además los cambios mínimos en las características asociados con un cambio en el resultado predicho. Juntos, estos enfoques ofrecen perspectivas complementarias globales y locales sobre el comportamiento del modelo y mejoran la transparencia y la interpretabilidad del modelo predictivo tabular. Grad-CAM, la visualización de atención, los mapas de saliencia y los gradientes integrados no se aplicaron en la validación realizada con el conjunto de datos Pima y se mantienen únicamente como opciones dependientes del tipo de modalidad dentro del protocolo general.
La validación estadística (Tabla 6 y Figura 7) y las evaluaciones de reproducibilidad demuestran la estabilidad del rendimiento predictivo en diferentes ejecuciones experimentales. La combinación de validación cruzada, estimación de intervalos de confianza, pruebas de hipótesis y evaluación de reproducibilidad en ejecuciones repetidas proporciona un marco sistemático para evaluar la robustez del modelo. Dicha validación es particularmente importante en aplicaciones de atención médica, ya que la reproducibilidad en experimentos independientes ofrece evidencia sobre la fiabilidad y la generalización de los modelos de inteligencia artificial antes de su implementación en entornos clínicos21,23.
Varios pasos son fundamentales para la implementación exitosa de este protocolo. Realice la limpieza de datos antes de la extracción de características y del entrenamiento del modelo para minimizar el sesgo potencial derivado de datos incompletos, inconsistentes o erróneos. Realice la optimización de hiperparámetros utilizando únicamente los datos de entrenamiento y validación, y mantenga el conjunto de datos de prueba independiente durante todo el desarrollo y optimización del modelo. Documente claramente los estados del generador de números aleatorios, las versiones del software, las configuraciones del hardware y los ajustes de preprocesamiento para facilitar la reproducibilidad entre plataformas computacionales. Además, seleccione métodos de explicabilidad basados en el modelo predictivo y en el tipo de datos sanitarios para obtener explicaciones interpretables y clínicamente relevantes20,29,30.
El protocolo tiene varias limitaciones. La precisión y fiabilidad de las predicciones y explicaciones del modelo dependen en gran medida de la disponibilidad de conjuntos de datos sanitarios suficientemente grandes, representativos y de alta calidad. La subrepresentación de poblaciones de pacientes específicas, los errores de medición, las variables faltantes y la heterogeneidad entre las fuentes de datos pueden afectar negativamente tanto el rendimiento predictivo como la estabilidad de las explicaciones del modelo. Además, los enfoques actuales de interpretabilidad pueden caracterizar el comportamiento del modelo, pero no necesariamente establecen mecanismos causales. Por lo tanto, los resultados de la IAX deben interpretarse junto con la experiencia clínica pertinente.
En general, este protocolo proporciona un enfoque estandarizado para el desarrollo, evaluación y análisis de explicabilidad de modelos reproducibles en diferentes áreas de la atención sanitaria. Al integrar un preprocesamiento estandarizado, optimización de hiperparámetros, evaluación mediante múltiples métricas de rendimiento, enfoques complementarios de explicabilidad y validación estadística, el flujo de trabajo ofrece un marco transparente y trazable para la investigación de inteligencia artificial en el ámbito sanitario.
Los resultados indican además que el desarrollo de modelos de IA transparentes y coherentes puede respaldarse mediante la combinación de un preprocesamiento sistemático de datos, procedimientos estandarizados de desarrollo de modelos, evaluación exhaustiva del rendimiento, múltiples métodos de explicabilidad y validación estadística rigurosa. El protocolo puede adaptarse a bases de datos clínicas, imágenes médicas, señales fisiológicas y datos sanitarios multimodales, manteniendo al mismo tiempo un marco para experimentación reproducible en diferentes entornos computacionales. A través de la implementación estandarizada, técnicas complementarias de explicabilidad y evaluación de la reproducibilidad, el protocolo proporciona un marco para el desarrollo de modelos de IA explicables y confiables, y puede servir como fundamento metodológico para futuras investigaciones biomédicas y para validaciones externas y clínicas posteriores.
Divulgaciones
Los autores declaran que no tienen intereses financieros competitivos, relaciones comerciales ni relaciones personales que pudieran haber influido en el trabajo reportado en este estudio. Los autores no tienen conflictos de intereses que declarar.
Agradecimientos
Los autores agradecen el apoyo institucional proporcionado por sus respectivas instituciones afiliadas durante el desarrollo y la validación experimental de este protocolo de XAI en atención médica. Los autores también agradecen las instalaciones computacionales y los recursos de software utilizados para realizar los análisis experimentales. Esta investigación no recibió financiamiento externo. Los autores agradecen el uso de Python 3.11, Matplotlib 3.9 y SciPy 1.13 para el análisis computacional, la visualización de datos y la generación de las figuras presentadas en este estudio.
Materiales
| Nombre | Empresa | Número de catálogo | Comentarios |
|---|---|---|---|
| Captum | Meta AI | Última versión estable | Explicabilidad en PyTorch |
| CUDA Toolkit | NVIDIA | 12.2 | Aceleración mediante GPU |
| cuDNN | NVIDIA | 9.x | Infraestructura para aprendizaje profundo |
| Git | Git SCM | Última versión estable | Control de versiones |
| GitHub | GitHub Inc. | Plataforma web | Repositorio de código fuente |
| Grad-CAM | jacobgil | Última versión publicada | Visualización de CNN |
| Jupyter Notebook | Proyecto Jupyter | Última versión estable | Desarrollo interactivo |
| LightGBM | Microsoft | 4.x | Impulso de gradiente |
| LIME | Comunidad LIME | 0.2.0 | Explicabilidad local |
| Matplotlib | Desarrolladores de Matplotlib | 3.9 | Visualización |
| Microsoft Excel | Microsoft | Microsoft 365 | Organización de datos |
| NumPy | Desarrolladores de NumPy | 1.26 | Computación numérica |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB de VRAM | Entrenamiento de modelos |
| OpenCV | Organización OpenCV | 4.10 | Preprocesamiento de imágenes |
| Pandas | Equipo de desarrollo de Pandas | 2.2 | Preprocesamiento de datos |
| Pillow (PIL) | Biblioteca de imágenes de Python | 10.x | Procesamiento de imágenes |
| Plotly | Plotly Technologies | 5.x | Visualización interactiva |
| Python | Python Software Foundation | 3.11 | Entorno de programación |
| PyTorch | PyTorch Foundation | 2.3 | Aprendizaje profundo |
| Scikit-learn | Desarrolladores de Scikit-learn | 1.5 | Aprendizaje automático |
| SciPy | Desarrolladores de SciPy | 1.13 | Computación científica |
| Seaborn | Desarrolladores de Seaborn | 0.13 | Gráficos estadísticos |
| SHAP | Comunidad SHAP | 0.46 | Explicabilidad global |
| SimpleITK | Insight Software Consortium | 2.x | Procesamiento de imágenes médicas |
| Statsmodels | Desarrolladores de Statsmodels | 0.14 | Análisis estadístico |
| RAM del sistema | Cualquier fabricante | 32 GB o superior | Memoria |
| TensorBoard | 2.15 | Supervisión del entrenamiento | |
| TensorFlow | 2.15 | Aprendizaje profundo | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | Sistema operativo |
| Visual Studio Code | Microsoft | Última versión estable | Desarrollo de código |
| XGBoost | Desarrolladores de XGBoost | 2.1 | Impulso de gradiente |
Referencias
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.