Ce protocole guide les débutants en bioinformatique à travers un pipeline d’analyse CUT&RUN d’introduction qui permet aux utilisateurs d’effectuer une analyse initiale et de valider les données de séquençage CUT&RUN. La réalisation des étapes d’analyse décrites ici, combinée à l’annotation des pics en aval, permettra aux utilisateurs de tirer des enseignements mécanistes de la régulation de la chromatine.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Analyse introductive et validation des données de séquençage CUT&RUN
Dans cet article
Résumé
Résumé
La technique CUT&RUN facilite la détection des interactions protéine-ADN à travers le génome. Les applications typiques de CUT&RUN comprennent le profilage, les modifications de la queue des histones ou la cartographie de l’occupation de la chromatine par le facteur de transcription. L’adoption généralisée de CUT&RUN est motivée, en partie, par des avantages techniques par rapport au ChIP-seq conventionnel, notamment des exigences d’entrée de cellule plus faibles, des exigences de profondeur de séquençage plus faibles et une sensibilité accrue avec un signal de fond réduit en raison d’un manque d’agents de réticulation qui masquent autrement les épitopes d’anticorps. L’adoption généralisée de CUT&RUN a également été réalisée grâce au partage généreux de réactifs par le laboratoire Henikoff et au développement de kits commerciaux pour accélérer l’adoption par les débutants. À mesure que l’adoption technique de CUT&RUN augmente, l’analyse et la validation du séquençage CUT&RUN deviennent des goulets d’étranglement critiques qui doivent être surmontés pour permettre une adoption complète par des équipes de laboratoire principalement humides. L’analyse CUT&RUN commence généralement par des contrôles de qualité sur les lectures de séquençage brutes afin d’évaluer la profondeur de séquençage, la qualité de lecture et les biais potentiels. Les lectures sont ensuite alignées sur un assemblage de séquence génomique de référence, et plusieurs outils bioinformatiques sont ensuite utilisés pour annoter les régions génomiques d’enrichissement en protéines, confirmer l’interprétabilité des données et tirer des conclusions biologiques. Bien que plusieurs pipelines d’analyse in silico aient été développés pour prendre en charge l’analyse de données CUT&RUN, leur structure multi-modules complexe et l’utilisation de plusieurs langages de programmation rendent les plateformes difficiles pour les débutants en bioinformatique qui peuvent manquer de familiarité avec plusieurs langages de programmation mais souhaitent comprendre la procédure d’analyse CUT&RUN et personnaliser leurs pipelines d’analyse. Ici, nous fournissons un protocole de pipeline d’analyse CUT&RUN étape par étape en langage unique, conçu pour les utilisateurs de tout niveau d’expérience en bioinformatique. Ce protocole comprend la réalisation de contrôles de qualité critiques pour valider que les données de séquençage sont adaptées à l’interprétation biologique. Nous nous attendons à ce que le respect du protocole d’introduction fourni dans cet article, combiné à l’annotation des pics en aval, permette aux utilisateurs de tirer des informations biologiques de leurs propres ensembles de données CUT&RUN.
Introduction
La capacité de mesurer les interactions entre les protéines et l’ADN génomique est fondamentale pour comprendre la biologie de la régulation de la chromatine. Des tests efficaces qui mesurent l’occupation de la chromatine pour une protéine donnée fournissent au moins deux éléments d’information clés : i) la localisation génomique et ii) l’abondance des protéines dans une région génomique donnée. Le suivi des changements de recrutement et de localisation d’une protéine d’intérêt dans la chromatine peut révéler des loci cibles directs de la protéine et révéler les rôles mécanistes de cette protéine dans les processus biologiques basés sur la chromatine tels que la régulation de la transcription, la réparation de l’ADN ou la réplication de l’ADN. Les techniques disponibles aujourd’hui pour profiler les interactions protéine-ADN permettent aux chercheurs d’explorer la régulation à une résolution sans précédent. De telles avancées techniques ont été rendues possibles par l’introduction de nouvelles techniques de profilage de la chromatine qui incluent le développement du clivage sous les cibles et de la libération à l’aide de nucléases (CUT & RUN) par le laboratoire Henikoff. CUT&RUN offre plusieurs avantages techniques par rapport à l’immunoprécipitation de la chromatine (ChIP) conventionnelle, notamment des exigences d’entrée de cellule plus faibles, des exigences de profondeur de séquençage plus faibles et une sensibilité accrue avec un signal de fond réduit en raison de l’absence d’agents de réticulation qui masquent autrement les épitopes des anticorps. L’adoption de cette technique pour étudier la régulation de la chromatine nécessite une compréhension approfondie du principe sous-jacent à la technique et une compréhension de la façon d’analyser, de valider et d’interpréter les données CUT&RUN.
La procédure CUT&RUN commence par la liaison des cellules à Concanavalin A conjuguées à des billes magnétiques pour permettre la manipulation d’un faible nombre de cellules tout au long de la procédure. Les cellules isolées sont perméabilisées à l’aide d’un détergent doux pour faciliter l’introduction d’un anticorps qui cible la protéine d’intérêt. La nucléase micrococcique (MNase) est ensuite recrutée dans l’anticorps lié à l’aide d’une étiquette de protéine A ou de protéine A/G attachée à l’enzyme. Le calcium est introduit pour initier l’activité enzymatique. La digestion de la MNase aboutit à des complexes mononucléosomales ADN-protéines. Le calcium est ensuite chélaté pour terminer la réaction de digestion, et de courts fragments d’ADN issus de la digestion de la MNase sont libérés des noyaux, puis soumis à la purification de l’ADN, à la préparation de la banque et au séquençage à haut débit1 (Figure 1).
Des approches in silico pour cartographier et quantifier l’occupation des protéines dans le génome se sont développées parallèlement aux approches de laboratoire humide utilisées pour enrichir ces interactions ADN-protéine. L’identification des régions de signaux enrichis (pics) est l’une des étapes les plus critiques de l’analyse bioinformatique. Les premières méthodes d’analyse ChIP-seq ont utilisé des algorithmes tels que MACS2 et SICER3, qui ont utilisé des modèles statistiques pour distinguer les véritables sites de liaison protéine-ADN du bruit de fond. Cependant, le bruit de fond plus faible et la résolution plus élevée des données CUT&RUN rendent certains programmes d’appel de pointe utilisés dans l’analyse ChIP-seq inadaptés à l’analyse CUT&RUN4. Cet enjeu met en évidence le besoin de nouveaux outils mieux adaptés à l’analyse des données CUT&RUN. SEACR4 représente l’un de ces outils récemment développé pour permettre des appels de pointe à partir de données CUT&RUN tout en surmontant les limites associées aux outils généralement utilisés pour l’analyse ChIP-seq.
Les interprétations biologiques des données de séquençage CUT&RUN sont tirées des sorties en aval de l’appel de pic dans le pipeline d’analyse. Plusieurs programmes d’annotation fonctionnelle peuvent être mis en œuvre pour prédire la pertinence biologique potentielle des pics appelés à partir des données CUT&RUN. Par exemple, le projet Gene Ontology (GO) fournit une identification fonctionnelle bien établie des gènes d’intérêt 5,6,7. Divers outils et ressources logiciels facilitent l’analyse GO pour révéler les gènes et les ensembles de gènes enrichis parmi les pics CUT&RUN 8,9,10,11,12,13,14. De plus, les logiciels de visualisation tels que Deeptools15, Integrative genomics viewer (IGV)16 et UCSC Genome Browser17 permettent de visualiser la distribution des signaux et les modèles dans les régions d’intérêt du génome.
La capacité à tirer des interprétations biologiques des données CUT&RUN dépend essentiellement de la validation de la qualité des données. Les composants critiques à valider comprennent l’évaluation de : i) la qualité du séquençage de la bibliothèque CUT&RUN, ii) la similarité des répliques et iii) la distribution du signal aux centres de pointe. La validation des trois composants est cruciale pour garantir la fiabilité des échantillons de la bibliothèque CUT&RUN et des résultats d’analyse en aval. Par conséquent, il est essentiel d’établir des guides d’analyse CUT&RUN d’introduction pour permettre aux débutants en bioinformatique et aux chercheurs en laboratoire humide d’effectuer de telles étapes de validation dans le cadre de leurs pipelines d’analyse CUT&RUN standard.
Parallèlement au développement de l’expérience CUT&RUN en laboratoire humide, divers pipelines d’analyse CUT&RUN in silico, tels que CUT&RUNTools 2.018,19, nf-core/cutandrun20 et CnRAP21, ont été développés pour soutenir l’analyse des données CUT&RUN. Ces outils offrent des approches puissantes pour analyser les ensembles de données CUT&RUN et CUT&Tag unicellulaires et en vrac. Cependant, la structure modulaire relativement complexe du programme et la familiarité requise avec plusieurs langages de programmation pour effectuer ces pipelines d’analyse peuvent entraver l’adoption par les débutants en bioinformatique qui cherchent à comprendre en profondeur les étapes d’analyse CUT&RUN et à personnaliser leurs propres pipelines. Le contournement de cet obstacle nécessite un nouveau pipeline d’analyse CUT&RUN d’introduction qui est fourni dans des scripts simples étape par étape encodés à l’aide d’un langage de programmation unique simple.
Dans cet article, nous décrivons un protocole de pipeline d’analyse CUT&RUN simple et monolangage qui fournit des scripts étape par étape pris en charge par des descriptions détaillées pour permettre aux utilisateurs novices et débutants d’effectuer une analyse de séquençage CUT&RUN. Les programmes utilisés dans ce pipeline sont accessibles au public par les groupes de développeurs d’origine. Les principales étapes décrites dans ce protocole comprennent l’alignement de lecture, l’appel de pointe, l’analyse fonctionnelle et, surtout, les étapes de validation pour évaluer la qualité de l’échantillon afin de déterminer la pertinence et la fiabilité des données pour l’interprétation biologique (figure 2). De plus, ce pipeline offre aux utilisateurs la possibilité de croiser les résultats d’analyse avec les ensembles de données CUT&RUN accessibles au public. En fin de compte, ce protocole de pipeline d’analyse CUT&RUN sert de guide d’introduction et de référence pour les débutants en analyse bioinformatique et les chercheurs en laboratoire humide.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
REMARQUE : Les informations sur les fichiers CUT&RUN fastq dans GSE126612 sont disponibles dans le Tableau 1. Les renseignements relatifs aux applications logicielles utilisées dans cette étude sont énumérés dans la Table des matières.
1. Télécharger le pipeline Easy-Shells_CUTnRUN depuis sa page Github
- Ouvrez le terminal à partir du système d’exploitation.
REMARQUE : Si l’utilisateur ne sait pas comment ouvrir le terminal sous macOS et Windows, consultez cette page Web (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). Pour Linux, consultez cette page Web (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Téléchargez le pipeline d’analyse compressé à partir de Github en tapant wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip dans le terminal.
- Après avoir téléchargé le fichier zip, décompressez le fichier zip téléchargé en tapant unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/ dans le terminal.
- Après la décompression, supprimez le fichier zip en tapant rm ~/Desktop/Easy-Shells_CUTnRUN.zip dans le terminal et modifiez le nom du dossier en tapant mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN.
- Après avoir supprimé le fichier compressé, tapez chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh dans le terminal pour définir l’autorisation exécutable pour tous les scripts shell dans le répertoire de travail. À partir de maintenant, il suffit de taper le chemin et le nom de ces scripts shell dans le terminal ou de faire glisser les scripts dans le terminal et d’entrer pour exécuter ces scripts shell dans le terminal.
REMARQUE : Le shell Bash est généralement préinstallé sur la plupart des distributions Linux. Cependant, les versions récentes de macOS ne fournissent plus de shell Bash préinstallé. Si le système ne dispose pas de Bash, installez d’abord le shell Bash. Consultez les liens ci-dessous pour obtenir des instructions décrivant comment installer le shell Bash dans le système d’exploitation Linux (https://ioflood.com/blog/install-bash-shell-linux/) et macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The first thing you will,you will see the following :). Ces scripts shell étape par étape sont écrits pour créer un dossier ~/Desktop/GSE126612 pour effectuer la plupart de cette analyse CUT&RUN dans ce répertoire sans qu’il soit nécessaire de le modifier. Si l’utilisateur comprend comment utiliser ces scripts shell, il peut réviser et personnaliser ces scripts shell pour analyser d’autres ensembles de données CUT&RUN et modifier les options selon les besoins spécifiques du projet. Pour lire et modifier ces scripts shell, envisagez d’utiliser Visual Studio Code (https://code.visualstudio.com/) comme option pour un programme facile à utiliser disponible pour les principaux systèmes d’exploitation.
2. Installation des programmes nécessaires à Easy Shells CUTnRUN
- Parmi les scripts shell portant le nom de Script_01_installation_***.sh, découvrez le script shell dont le nom inclut le type de système d’exploitation du système de l’utilisateur. Actuellement, Easy Shells CUTnRUN prend en charge le script d’installation pour les systèmes basés sur macOS, Debian/Ubuntu et CentOS/RPM.
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Dans le terminal, utilisez le script shell d’installation en tapant ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh ou faites glisser le fichier de script shell dans le terminal et entrez.
- Lisez le fichier Test_README.md dans le dossier /path/to/SEACR-1.3/Testfiles. Suivez les instructions du fichier README pour déterminer si le SEACR dans le système de l’utilisateur fonctionne correctement.
REMARQUE : Il est crucial de valider la fonction SEACR avec les fichiers de test fournis par la page Github SEACR pour obtenir des résultats d’appel de pointe corrects à partir des données CUT&RUN. Par conséquent, suivez les instructions de Test_README.md dans /path/to/SEACR-1.3/Testfiles immédiatement après l’installation de SEACR. Bien que Easy Shells CUTnRUN fournisse des scripts shell d’installation pour certains systèmes d’exploitation, ces scripts peuvent ne pas fonctionner dans le système de certains utilisateurs pour installer tous les programmes requis pour Easy Shells CUTnRUN. En cas de problème lors de l’installation, consultez le site Web d’origine du programme désinstallé ou demandez de l’aide à l’aide de la page Web des problèmes GitHub de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
3. Téléchargement de l’ensemble de données CUT&RUN accessible au public à partir de Sequence Read Archive (SRA)
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE :Ce script va : (i) Créer un dossier (~/Desktop/GSE126612/fastq) et télécharger une liste de fichiers SRA écrits dans un fichier texte (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) dans le dossier fastq. À titre d’exemple, le SRR_list.txt inclut les fichiers fastq d’un sous-ensemble de GSE126612 échantillons CUT&RUN. (ii) Téléchargez les fichiers bruts fastq dans le dossier fastq. (iii) Créez un dossier (~/Desktop/GSE126612/log/fastq) et notez un fichier journal (download-fastq_log.txt) et un fichier d’informations d’exemple téléchargé (SRR_list_info.txt) dans ce dossier de journal. - Après avoir exécuté le script, vérifiez le fichier journal. S’il y a un message d’erreur dans le fichier journal, corrigez-le et essayez à nouveau l’étape 3.3. S’il y a un problème pour résoudre le problème, demandez de l’aide sur la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Pour faciliter la mise en pratique de ce pipeline d’analyse CUT&RUN, les échantillons suivants accessibles au public sont extraits de SRA : un échantillon provenant d’un contrôle simulé (IgG), trois échantillons d’une protéine d’architecture de la chromatine et du facteur de transcription (CTCF), quatre échantillons correspondant à une marque d’histone « active » (H3K27Ac) et trois échantillons correspondant à des régions d’initiation transcriptionnelle marquées par l’ARN polymérase II (RNAPII-S5P). Le séquençage a été effectué en tant qu’extrémité appariée, donc deux fichiers sont appariés par échantillon.
4. Contrôle qualité initial des fichiers de séquençage bruts
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh dans le terminal ou faites glisser le script shell dans le terminal et entrez.
REMARQUE : Ce script shell va : (i) Exécuter le programme FastQC pour tous les fichiers fastq bruts dans le dossier ~/Desktop/GSE126612/fastq et enregistrer les fichiers du rapport de contrôle qualité dans le dossier ~/Desktop/GSE126612/fastqc.1st . (ii) Notez un fichier journal (fastqc.1st.log.SRR-number.txt) par exécution FastQC dans un dossier de journal (~/Desktop/GSE126612/log/fastqc.1st). - Une fois l’exécution du script shell terminée, examinez le fichier journal pour clarifier la réussite de l’exécution. S’il y a un message d’erreur dans le fichier journal, corrigez-le et répétez l’étape 4.3. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Parmi les fichiers de sortie, fastqc.html fichiers incluent des résultats de contrôle de qualité conviviaux. S’il y a de graves problèmes de qualité, discutez avec des collègues en bio-informatique afin de déterminer si les données conviennent à l’analyse en aval. Des rapports de contrôle qualité similaires sont utilisés pour confirmer l’amélioration de la qualité des données après le découpage de l’adaptateur. Pour utiliser ce script pour d’autres jeux de données, modifiez le chemin d’accès des répertoires de travail et de sortie pour répondre aux besoins de l’utilisateur. Une différence notable lors de l’interprétation du contrôle qualité de CUT&RUN par rapport aux lectures ChIP-seq est que les lectures en double dans CUT&RUN n’indiquent pas nécessairement des doublons PCR. En effet, les MNase recrutées digéreront dans les mêmes endroits ou dans des endroits similaires au sein de groupes expérimentaux.
5. Qualité et découpage de l’adaptateur pour les fichiers de séquençage bruts
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh dans le terminal ou faites glisser le script Script_04_trimming.sh dans le terminal et entrez.
REMARQUE : Ce script shell va : (i) Exécuter le programme Trim-Galore pour tous les fichiers bruts fastq dans ~/Desktop/GSE126612/fastq pour effectuer le découpage de l’adaptateur et de la qualité. (ii) Créez un dossier (~/Desktop/GSE126612/trimmed) et enregistrez les fichiers de sortie Trim-Galore dans le dossier tronqué. (iii) Créez un dossier de journal (~/Desktop/GSE126612/log/trim_galore) et notez un fichier de journal trim_galore_log_RSS-number.txt lors d’une exécution de Trim-Galore. - Une fois l’exécution terminée, examinez attentivement le fichier journal. S’il y a un message d’erreur dans le fichier journal, corrigez-le et répétez l’étape 5.3. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
- Une fois ce processus terminé, comparez les fichiers de sortie .html avec les fichiers fastqc.html créés dans la version 4.3. Révisez le chemin des répertoires d’entrée et de sortie pour effectuer l’étape de découpage de tous les fichiers fastq situés ailleurs.
6. Téléchargement de l’indice Bowtie2 pour les génomes de référence pour les échantillons de contrôle réels et de pointe
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh dans le terminal ou faites glisser le script shell dans le terminal et entrez.
REMARQUE : Ce texte radiophonique permettra de : (i) télécharger les indices Bowtie2 pour les génomes de référence des échantillons réels (humain ; hg19 ; utilisé dans la publication originale22) et les génomes de référence de contrôle Spike-in (levure bourgeonnante ; R64-1-1) dans le dossier bowtie2-index (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) Notez un fichier journal (bowtie2-index-log.txt) dans un répertoire de journaux (~/Desktop/GSE126612/log/bowtie2-index). - Une fois l’exécution terminée, vérifiez le fichier journal. S’il y a un message d’erreur, corrigez-le et répétez l’étape 6.3. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : À l’heure actuelle, les indices Bowtie2 pour divers génomes de référence sont fournis sur le site Web de Bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml). Les utilisateurs peuvent modifier Script_05_bowtie2-index.sh pour télécharger n’importe quel index Bowtie2 afin de répondre à leurs besoins. Si l’utilisateur ne peut pas localiser l’indice Bowtie2 du génome de référence d’intérêt, localisez les fichiers fasta de séquence du génome de référence à partir de :- Ensembl ftp (https://ftp.ensembl.org/pub/current_fasta/)
- Page web de l’UCSC (https://hgdownload.soe.ucsc.edu/downloads.html)
- ou d’autres bases de données spécifiques à l’espèce.
Après avoir localisé les fichiers fasta de séquence du génome de référence, créez un index Bowtie2 pour le génome de référence téléchargé en suivant la section « L’indexeur bowtie2-build » (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) du site Web Bowtie2.
7. Cartographie des lectures de séquençage CUT&RUN tronquées sur les génomes de référence
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script shell va : (1) Exécuter le programme bowtie2 pour mapper tous les fichiers fastq ajustés de l’adaptateur et de qualité à la fois au contrôle expérimental (humain ; hg19) et au contrôle de pointe (levure bourgeonnante ; R64-1-1) référencent les génomes indépendamment. (ii) Exécutez la fonction de vue samtools pour compresser les fichiers de paires de lecture mappés au format bam. (iii) Créez un dossier (~/Desktop/GSE126612/bowtie2-mapped) et enregistrez le fichier compressé des paires de lecture mappées dans le dossier mappé bowtie2. (iv) Créez un dossier (~/Desktop/GSE126612/log/bowtie2-mapped) et notez le journal du processus de cartographie sous forme de fichier texte bowtie2_log_hg19_SRR-number.txt pour les paires de lecture cartographiées sur le génome de référence hg19 et bowtie2_log_R64-1-1_SRR-number.txt pour les paires de lecture cartographiées sur R64-1-1) pour indiquer l’efficacité de la cartographie dans le dossier de journal de mappage bowtie2. - Une fois l’exécution terminée, vérifiez le fichier journal. S’il y a un message d’erreur dans le fichier journal, corrigez-le et exécutez à nouveau le script shell. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Ce script shell exécute bowtie2 avec des options pour mapper les fichiers de séquençage d’extrémité appariée afin de trouver des paires de lecture mappées de manière concordante avec des longueurs de fragment de 10 à 700 pb. Découvrez les descriptions des options en tapant bowtie2 --help dans le terminal ou en visitant le site Web de bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner) pour comprendre et modifier les options si nécessaire. Utilisez ce script shell pour mapper n’importe quel autre fichier fastq en modifiant le chemin d’accès et le format de nom des fichiers fastq et des index Bowtie2.
8. Tri et filtrage des fichiers de paires de lecture mappés
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant « chsh -s $(which bash) » dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script va : (i) Exécuter la fonction de vue samtools pour tous les fichiers de paires de lecture mappés compressés dans le dossier ~/Desktop/GSE126612/bowtie2-mapped pour filtrer les paires de lecture mappées aux régions chromosomiques non canoniques, à la liste noire annotée publiquement et aux régions de répétition TA. (ii) Exécutez la fonction de tri samtools pour trier les fichiers bam filtrés par les noms des fragments ou les coordonnées au sein du même répertoire. (iii) Notez un fichier journal pour un fichier bam d’entrée dans le répertoire ~/Desktop/GSE126612/log/filter-sort-bam . - Une fois l’exécution terminée, examinez attentivement les fichiers journaux. S’il y a un message d’erreur dans les fichiers journaux, corrigez-le et essayez d’exécuter à nouveau le script shell. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Les fichiers bam résultants (sortie) triés par les noms des fragments serviront de fichiers d’entrée pour créer des fichiers BED de fragment et des fichiers bedGraph de comptage de lectures brutes. Les fichiers bam triés par coordonnées serviront de fichiers d’entrée pour générer des fichiers BEDPE fragmentaires. Tous les BED, bedGraph et BEDPE seront utilisés pour les appels de pic et la visualisation dans l’analyse en aval. Tous les fichiers de lit d’annotation pour les régions chromosomiques canoniques (chr1~22, chrX, chrY et chrM), les régions de la liste noireannotées publiquement 23 et les régions de répétition TA18 se trouvent dans le répertoire ~/Desktop/Easy-Shells_CUTnRUN/blacklist . Si nécessaire, utilisez ce répertoire pour ajouter des fichiers de liste noire supplémentaires. Utilisez ce script shell pour exécuter les mêmes fonctions pour d’autres fichiers bam de paires de lecture mappées en modifiant le chemin d’accès et le nom des fichiers bam. Tapez samtools view --help et samtools sort --help dans le terminal pour plus de description de ces fonctions.
9. Convertissez les paires de lectures mappées en fichiers bedGraph de fragments BEDPE, BED et de comptages bruts
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script va : (i) Exécuter macs3 filterdup et la fonction awk pour convertir les fichiers bam triés par coordonnées en fragmenter les fichiers BEDPE dont la longueur des fragments est inférieure à 1 ko, et enregistrer les fichiers BEDPE dans ~/Desktop/GSE126612/BEDPE. (ii) Créez un répertoire de journaux (~/Desktop/GSE126612/log/bam-to-BEDPE) et notez un fichier journal par fichier de fragments de lectures mappés. (iii) Exécuter les fonctions bedtools bamtobed et awk, cut, sort pour convertir les fichiers bam triés par les noms des fragments en fichiers BED fragmentés dont la longueur des fragments est inférieure à 1 kb. (iv) Créez un dossier (~/Desktop/GSE126612/bam-to-bed) et enregistrez les fichiers BED fragmentaires dans le dossier bam-to-bed. (v) Notez un fichier journal par fragments de lecture mappé dans un répertoire de journaux (~/Desktop/GSE126612/log/bam-to-bed). (vi) Exécuter la fonction bedtools genomecov pour générer des fichiers bedGraph bruts readcounts en utilisant les fichiers BED fragmentés dans un dossier (~/Desktop/GSE126612/bedGraph). - Une fois l’exécution terminée, vérifiez attentivement les fichiers journaux. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Les fichiers bedGraph de sortie seront utilisés comme fichiers d’entrée pour le programme d’appel de crête SEACR avec l’option de normalisation dans la section 12 et la normalisation SFRC (Scaled Fractional Readcount)22 dans la section 10. Les fichiers BED de fragments serviront de fichiers d’entrée pour les lectures mappées normalisées par million de pointes dans la normalisation de contrôle négatif (SRPMC) 24,25 dans la section10.To capturer de courts fragments (>100 pb) uniquement pour les données CUT&RUN de facteurs associés à la chromatine, modifier l’étape de filtrage des fragments dans ce script et procéder à l’étape de normalisation. Pour comparer les signaux CUT&RUN entre des fragments de taille courte et normale au sein d’un même échantillon, la normalisation SFRC peut être utile pour réduire l’effet potentiel de sous-échantillonnage causé par la capture de fragments courts uniquement. Utilisez ce script shell pour effectuer les mêmes processus pour d’autres fichiers bam séquencés par paires en modifiant le chemin d’accès et le format de nom des fichiers bam et bed.
10. Conversion de fichiers bedGraph en fichiers bedGraph et bigWig normalisés
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter la boucle for avec la fonction awk pour créer des fichiers bedGraph normalisés SFRC en utilisant des fichiers bedGraph bruts readcounts dans ~/Desktop/GSE126612/bedGraph. (ii) Exécutez la fonction bedGraphToBigWig pour créer le format compressé (.bw) des fichiers bedGraph normalisés SFRC dans ~/Desktop/GSE126612/bigWig. (iii) Notez un fichier journal pour enregistrer le facteur de normalisation utilisé pour le calcul SFRC par exécution et enregistrez le fichier journal dans ~/Desktop/GSE126612/log/SFRC. - Une fois l’exécution terminée, vérifiez les fichiers journaux. S’il y a un message d’erreur, corrigez-le et exécutez à nouveau le script shell. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : La normalisation du nombre de lectures fractionnées à l’échelle a été utilisée dans la publication originale22 de GSE126612'ensemble de données CUT&RUN. La formule de la normalisation au groupe i est la même que ci-dessous :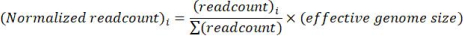
Étant donné que cette méthode de normalisation n’inclut pas la normalisation avec un contrôle négatif (par exemple, un échantillon d’IgG) ni un contrôle de pointe, cette approche n’est peut-être pas idéale pour observer la différence de signal à l’échelle du génome entre les échantillons. Cependant, étant donné que cette méthode est théoriquement similaire à d’autres normalisations basées sur le nombre total de lectures (par exemple, le nombre par million), elle serait suffisante pour observer la différence de signal local entre les échantillons. - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script va : (i) Exécuter la boucle for avec la fonction bedtools genomecov pour créer des fichiers bedgraph normalisés SRPMC dans ~/Desktop/GSE126612/bedGraph en utilisant des fichiers BED fragmentaires dans ~/Desktop/GSE126612/bam-to-bed. (ii) Notez un fichier journal pour enregistrer les facteurs de normalisation utilisés pour la normalisation SRPMC lors d’une exécution dans ~/Desktop/GSE126612/log/SRPMC. (iii) Exécutez la fonction bedGraphToBigWig pour créer le format compressé (.bw) des fichiers bedGraph normalisés et enregistrez les fichiers bigWig normalisés dans le dossier ~/Desktop/GSE126612/bigWig . - Une fois l’exécution terminée, examinez attentivement les fichiers journaux. S’il y a un message d’erreur dans les fichiers journaux, corrigez-le et exécutez à nouveau le script shell. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : La formule de normalisation SRPMC a été développée pour normaliser le nombre réel de lectures d’échantillons avec un contrôle négatif (échantillon IgG, par exemple) et un contrôle de pic en combinant le facteur de normalisation RPM (lectures par million de lectures mappées), le RPS (ratio de lectures par lecture de pointe) et le rapport de signal relatif au contrôle24,25. La définition de RPS est la même que ci-dessous :
En appliquant le RPS à la fois pour l’échantillon réel et l’échantillon de contrôle négatif, le rapport de signal relatif (RS) au contrôle pour l’échantillon réel peut être calculé comme suit :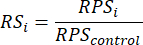
Et la définition du facteur de normalisation RPM (RPM :NF) est la même que ci-dessous :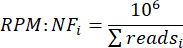
À partir de là, le facteur de normalisation SRPMC (SRPMC :NF) est sorti en combinant le RS et le RPM :NF ensemble :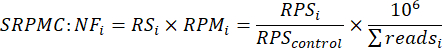
Et cette formule peut être simplifiée comme ci-dessous :
Par conséquent, la méthode SRPMC normalise les lectures par le rapport (1) des lectures de pic entre le contrôle et l’échantillon, et (2) les lectures de contrôle normalisées RPM. Étant donné que ce facteur de normalisation prend en compte les lectures de pointe et rend les lectures de contrôle comparables entre les échantillons, cette méthode serait appropriée pour observer la différence à l’échelle du génome entre les échantillons et réduire l’effet de lot dans les lectures totales des échantillons réels et des témoins dans différentes expériences de lot. Ces fichiers bedGraph normalisés deviendront des fichiers d’entrée pour appeler les pics à l’aide de SEACR dans la section 11. Et ces fichiers bigWig normalisés seront utilisés dans la visualisation des loci via IGV et la création de cartes thermiques et de tracés moyens via Deeptools. Il est fortement suggéré d’utiliser un navigateur génomique pour visualiser le modèle de paysage de l’ensemble de données CUT&RUN à l’aide des fichiers bigWig normalisés dans des régions génomiques représentatives afin d’évaluer la qualité des données. Les échantillons CUT&RUN qui présentent des modèles de signal de fond bruyants qui ressemblent au contrôle IgG sont probablement appropriés à omettre pour les analyses en aval. Utilisez ces scripts shell pour normaliser d’autres fichiers bedGraph de lecture, de lecture et de comptage brut, en modifiant le chemin d’accès et les noms de fichiers pour les fichiers bed et bedgraph d’entrée et de sortie. Modifiez ces scripts pour appliquer d’autres calculs de normalisation en modifiant les facteurs et la formule dans ce script.
11. Validation de la distribution de la taille des fragments
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter picard.jar fonction CollectInsertSizeMetrics à l’aide de fichiers bam de paires de lectures mappées dans le dossier ~/Desktop/GSE126612/filtered-bam pour identifier la distribution de la taille d’insertion. (ii) Créez un dossier (~/Desktop/GSE126612/insert-size-distribution) et enregistrez les résultats de l’analyse de la distribution de la taille d’insertion dans le dossier créé. (iii) Notez un fichier journal pour un fichier bam d’entrée dans le dossier ~/Desktop/GSE126612/log/insert-size-distribution . - Une fois l’exécution terminée, vérifiez attentivement les fichiers journaux. S’il y a un message d’erreur dans les fichiers journaux, corrigez-le et essayez d’exécuter à nouveau le script shell. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : En général, l’analyse de la taille de l’insert (sortie) pour les échantillons CUT&RUN montre des pics majeurs dans les plages de taille nucléosomale mono- (100-300 pb) et di- (300-500 pb). Des erreurs ou des limitations techniques (telles qu’une digestion excessive ou insuffisante de la MNase pendant la préparation des échantillons CUT&RUN ou une sélection inappropriée de la taille lors de la préparation de la banque) peuvent entraîner l’enrichissement de fragments trinucléosomales ou plus grands (500 à 700 pb) et identiques ou plus courts que les fragments subnucléosomales (<100 pb). Parfois, l’absence de pics de taille mononucléosomique avec l’enrichissement des fragments longs (>500 pb) et courts (<100 pb) peut être due à des plages de sélection de la taille de la banque choisies au stade du laboratoire humide ou à une faible profondeur de séquençage. Comparez la profondeur de séquençage ('bases séquencées totales' / 'taille totale du génome de référence'), la vue d’ensemble du paysage génomique à l’aide des fichiers bigWig de la section 10 et le modèle de distribution de la taille des inserts pour clarifier la qualité des échantillons CUT&RUN traités. Les lignes pointillées dans les histogrammes représentent la « fraction cumulée » des lectures dont la taille de l’insert est supérieure ou égale à la valeur sur l’axe des x. Cette ligne pointillée permet d’identifier la distribution des tailles d’insertion dans le fichier de lectures mappées en entrée. La progression le long de l’axe des x est associée à l’augmentation de la taille de l’insert. La ligne pointillée identifie la proportion de paires lues mappées dans le fichier bam d’entrée qui ont une taille d’insertion au moins aussi grande que celle indiquée sur la position de l’axe des x d’intersection. Par conséquent, l’interprétation commence à 1 sur la gauche, indiquant que toutes les lectures ont une taille d’insert supérieure ou égale à la plus petite taille, et diminue vers 0 à mesure que la taille de l’insert augmente.
12. Pics d’appels à l’aide de MACS2, MACS3 et SEACR
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter les fonctions callpeak macs2 et macs3 callpeak avec et sans contrôle IgG en utilisant des fichiers BEDPE fragmentés pour appeler les peaks et enregistrer les résultats d’appel peak dans les répertoires de sortie (~/Desktop/GSE126612/MACS2 et ~/Desktop/GSE126612/MACS3). (ii) Notez le journal de ces appels de pointe sous forme de fichier texte dans le répertoire de journaux (~/Desktop/GSE126612/log/MACS2 et ~/Desktop/GSE126612/log/MACS3) - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter SEACR_1.3.sh script avec et sans contrôle IgG, avec des options strictes et détendues en utilisant des readcounts bruts bedGraph et des fichiers bedGraph normalisés pour appeler les pics. (ii) Créez le répertoire de sortie (~/Desktop/GSE126612/SEACR-peaks) et enregistrez les résultats d’appel de pointe par SEACR. (iii) Notez le journal de ces appels de pointe sous forme de fichier texte dans le répertoire de journaux (~/Desktop/GSE126612/log/SEACR). - Une fois l’exécution des scripts shell terminée, vérifiez attentivement les fichiers journaux. S’il y a un message d’erreur dans les fichiers journaux, corrigez-le d’abord. Certains programmes peuvent ne pas appeler ensemble les pics de l’échantillon de contrôle IgG avec l’option de contrôle IgG, omettant ainsi le message d’erreur concernant l’échantillon de contrôle IgG avec l’option de contrôle IgG. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Ces deux scripts shell effectuent des appels de pic pour les échantillons CUT&RUN à l’aide de trois appelants de pic (MACS2, MACS3 et SEACR) avec diverses options : avec/sans option de contrôle IgG, utilisation de comptages de lectures bruts fichiers bedGraph avec option de normalisation de l’appelant de pic ou comptages de lectures normalisés fichiers bedGraph sans option de normalisation de l’appelant de pic, et options d’appel de pic SEACR strictes et détendues. Étant donné que les fichiers de sortie d’appel de pic ne sont pas suffisants pour être utilisés directement dans les analyses en aval, Easy Shells CUTnRUN inclut un script pour traiter ces fichiers de sortie de pics appelés afin de créer de nouveaux fichiers de pics qui incluent le chromosome, le début, la fin et le nom des pics. Grâce à des approches d’appels de pointe intensifs, Easy Shells CUTnRUN offre la possibilité de choisir le programme d’appel de pointe le mieux adapté au projet CUT&RUN d’un utilisateur en comparant les pics appelés sur trois appelants de pointe. De plus, ce pipeline d’analyse CUT&RUN offre également la possibilité de sélectionner les options d’appel de pointe les mieux adaptées au projet CUT&RUN d’un utilisateur. Ces comparaisons seront effectuées par diagramme de Venn, et visualisation sous forme de carte thermique et de graphique moyen.
13. Création de limes de lit de pic appelées
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécutez la fonction awk à l’aide des fichiers de lit dans le dossier ~/Desktop/GSE126612/SEACR pour créer deux types de fichiers de lit de pointe SEACR ~/Desktop/GSE126612/peak-bed_SEACR dossier. L’ensemble des fichiers de lit de crête incluent le début et la fin de chaque crête, et les fichiers de lit de crête focalisés incluent le début et le lit du bac de signal le plus élevé dans chaque crête. (ii) Exécutez la fonction awk à l’aide des fichiers _peaks.xls dans les dossiers ~/Desktop/GSE126612/MACS2 et ~/Desktop/GSE126612/MACS3 pour créer des fichiers de lit de pic entiers qui incluent le début et la fin de chaque pic appelé par MACS2 et MACS3 dans les dossiers ~/Desktop/GSE126612/peak-bed_MACS2 et ~/Desktop/GSE126612/peak-bed_MACS3 . (iii) Exécutez la fonction awk à l’aide des fichiers _summits.bed dans les dossiers ~/Desktop/GSE126612/MACS2 et ~/Desktop/GSE126612/MACS3 pour créer des fichiers de lit de pic ciblés qui incluent le début et la fin du bac le plus significatif dans chaque pic. (iv) Les fichiers journaux sont écrits au format texte dans le dossier ~/Desktop/GSE126612/log/peak-bed . - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter la fonction bedtools intersect à l’aide de fichiers de lit de crête qui sont appelés sans l’option de contrôle IgG pour supprimer les pics superposés avec les pics de contrôle IgG. (ii) Les fichiers de lit de pic filtrés sont enregistrés dans les dossiers ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 et ~/Desktop/GSE126612/peak-bed-filtered_SEACR . (iii) Un fichier journal log_filter-peaks.txt est créé dans le dossier ~/Desktop/GSE126612/log/filter-peaks . - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter les fonctions cat et sort pour concaténer les fichiers de lit de pic entiers MACS2 et MACS3 des répliques en un seul fichier de lit de pic et trier le fichier de lit de pic concaténé dans le dossier ~/Desktop/GSE126612/bed-for-comparison . (ii) Exécutez la fonction de fusion des outils de lit en utilisant les fichiers de lit de pic entiers concaténés pour fusionner les pics qui se chevauchent. (iii) Un fichier journal log_cat-merged-peak-bed_MACS.txt est écrit dans le dossier de journaux ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter les fonctions cat et sort pour concaténer les fichiers de lit de pic SEACR entiers des répliques en un seul fichier de lit de pic et trier le fichier de lit de pic concaténé dans le dossier ~/Desktop/GSE126612/bed-for-comparison . (ii) Exécutez la fonction de fusion des outils de lit en utilisant les fichiers de lit de pic entiers concaténés pour fusionner les pics qui se chevauchent. (iii) Un fichier journal log_cat-merged-peak-bed_SEACR.txt est écrit dans le dossier de journaux ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Une fois l’exécution des scripts shell terminée, examinez attentivement les fichiers journaux. S’il y a un message d’erreur dans les fichiers journaux, corrigez-le et exécutez à nouveau le(s) script(s). S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Les fichiers de lit de pic de l’ensemble des régions de pic seront utilisés comme fichiers d’entrée de l’analyse du diagramme de Venn pour comparer la similitude entre les options d’appel de pic, les méthodes d’appel de pic, les répétitions et les observations du paysage génomique près des régions de pic. Les fichiers de lit de pic des régions de pic fusionnées seront utilisés pour l’analyse en composantes principales (PC) et l’analyse de corrélation du coefficient de Pearson à l’aide de deeptools. Les fichiers de lit de pic ciblés seront utilisés pour l’analyse de la carte thermique et du tracé moyen à l’aide de Deeptools.
14. Validation de la similarité entre les répétitions à l’aide de la corrélation de Pearson et de l’analyse en composantes principales (PC).
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, les utilisateurs peuvent voir ce qui suit : /path/to/bash (ou un message similaire tel que /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, ignorez cette étape.
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter la fonction de fichier BED multiBamSummary à l’aide des fichiers bam des réplicats, qui ont été triés par coordonnées, et fusionner les fichiers de lit de pic entier pour CTCF, H3K27Ac et RNAPII-S5P afin de générer des fichiers matriciels pour l’analyse de corrélation de Pearson dans le dossier Desktop/GSE126612/deeptools_multiBamSummary . (ii) Exécutez la fonction plotCorrelation à l’aide des fichiers de matrice pour effectuer le calcul du coefficient de corrélation de Pearson et le clustering de carte thermique, et enregistrez le résultat dans le dossier ~/Desktop/GSE126612/deeptools_plotCorrelation . (iii) Notez un fichier journal log_plotCorrelation.txt dans le dossier ~/Desktop/GSE126612/log/corrélation . - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter la fonction de fichier BEDi multiBamSummary à l’aide des fichiers bam, qui ont été triés par coordonnées, et fusionner les fichiers de lit de pic entier, qui comprend tous les pics CTCF, H3K27ac et RNAPII-S5P, afin de générer des fichiers matriciels pour l’analyse en composantes principales (ACP) dans le dossier Desktop/GSE126612/deeptools_multiBamSummary . (ii) Exécutez la fonction plotPCA en utilisant les fichiers matriciels pour effectuer l’ACP et enregistrez le résultat dans le dossier ~/Desktop/GSE126612/deeptools_plotPCA . (iii) Notez un fichier journal log_plotPCA.txt dans le dossier ~/Desktop/GSE126612/log/corrélation . - Une fois l’exécution des scripts shell terminée, vérifiez les fichiers journaux. S’il y a un message d’erreur, corrigez-le et exécutez à nouveau les scripts shell. S’il y a un problème pour résoudre le problème, demandez de l’aide en utilisant la page Web des problèmes github de Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : En principe, les répétitions correctement préparées et traitées présentent des valeurs de coefficient de corrélation de Pearson plus élevées au sein d’un même groupe de clustering et un positionnement proche dans l’analyse en composantes principales. Toute répétition, qui présente un coefficient de corrélation de Pearson plus faible et une longue distance par rapport aux autres répétitions dans le graphique en composantes principales, peut représenter une valeur aberrante potentielle parmi les répétitions. Ce script shell s’applique à tous les formats bam pour les données de lecture mappées. Modifiez le chemin d’accès et le nom de fichier des fichiers bigwig pour répondre aux exigences spécifiques du projet.
15. Validation de la similitude entre les répétitions, les méthodes d’appel de pic et les options à l’aide du diagramme de Venn
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, il peut y avoir quelque chose comme /path/to/bash (par exemple, /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, envisagez de sauter cette étape
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter la fonction de venn d’intervention en utilisant les fichiers de lit de pic de la région de pic entière pour trouver les chevauchements entre les pics appelés par diverses options (avec/sans option de contrôle IgG, avec/sans normalisation, et options d’appel de pic strictes/détendues pour SEACR). (ii) Créez un dossier (~/Desktop/GSE126612/intervene_methods) et enregistrez les résultats de l’analyse du diagramme de Venn dans ce dossier. (iii) Notez un fichier journal log_intervene_methods.txt dans le dossier ~/Desktop/GSE126612/log/intervene. - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter la fonction de venn d’intervention en utilisant les fichiers de lit de pic de la région de pic entière pour trouver les chevauchements entre les pics des réplicats. (ii) Créez un dossier (~/Desktop/GSE126612/intervene_replicates) et enregistrez les résultats de l’analyse du diagramme de Venn dans ce dossier. (iii) Notez un fichier journal log_intervene_replicates.txt dans le dossier ~/Desktop/GSE126612/log/intervene . - Une fois l’exécution des scripts shell terminée, examinez les fichiers journaux. S’il y a un message d’erreur, corrigez-le et exécutez à nouveau les scripts shell. En cas de problème lors de l’utilisation du pipeline d’analyse Easy Shells CUTnRUN, demandez de l’aide sur la page Web des problèmes GitHub d’Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Les résultats de l’analyse du diagramme de Venn permettent de choisir les options d’appel de pic, les méthodes et les réplicats les plus appropriés avec une reproductibilité élevée pour l’analyse en aval. Il peut être préférable de choisir les options et les méthodes d’appel de crête qui montrent les numéros de crête appelés les plus élevés avec un bon chevauchement avec d’autres méthodes et options d’appel de pointe.
16. Analyse des cartes thermiques et des graphiques moyens pour visualiser les pics appelés.
- Ouvrez le terminal et tapez echo $SHELL pour vérifier le shell par défaut dans le terminal actif. Si le shell Bash est le shell par défaut dans le terminal actuel, il peut y avoir quelque chose comme /path/to/bash (par exemple, /bin/bash) dans le terminal.
- Si le shell par défaut n’est pas Bash, définissez le shell Bash comme shell par défaut en tapant chsh -s $(which bash) dans le terminal. Si le terminal utilise le shell Bash par défaut, envisagez de sauter cette étape
- Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
REMARQUE : Ce script est écrit pour : (i) Exécuter la fonction de point de référence computeMatrix à l’aide de fichiers bigWig normalisés et de fichiers de lit de pic ciblés pour créer des matrices de comptage de lectures normalisées au centre des pics ciblés dans le dossier ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Exécutez la fonction plotHeatmap à l’aide de la matrice de comptages de lectures normalisés pour générer des cartes thermiques et des graphiques moyens qui visualisent le modèle de distribution des comptages de lectures normalisés aux emplacements de pic ciblés. (iii) Créez un dossier (~/Desktop/GSE126612/deeptools_plotHeatmap) et enregistrez les fichiers de sortie plotHeatmap dans ce dossier. (iv) Notez un fichier journal log_plotHeatmap_focused.txt dans le dossier ~/Desktop/GSE126612/log/plotHeatmap . - Tapez ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh dans le terminal ou faites glisser le fichier de script shell dans le terminal et entrez.
Ce script est écrit pour : (i) Exécuter la fonction de point de référence computeMatrix à l’aide de fichiers bigWig normalisés et de fichiers de lit de pic entier pour créer des matrices de comptage de lectures normalisées au centre de l’ensemble des pics dans le dossier ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Exécutez la fonction plotHeatmap en utilisant la matrice de comptages normalisés pour générer des cartes thermiques et des graphiques moyens qui visualisent le modèle de distribution du nombre de lectures normalisé à l’ensemble des emplacements de pointe. (iii) Créez un dossier (~/Desktop/GSE126612/deeptools_plotHeatmap) et enregistrez les fichiers de sortie plotHeatmap dans ce dossier. (iv) Notez un fichier journal log_plotHeatmap_whole.txt dans le dossier ~/Desktop/GSE126612/log/plotHeatmap . - Une fois l’exécution des scripts shell terminée, examinez les fichiers journaux. S’il y a un message d’erreur, corrigez-le et exécutez à nouveau les scripts shell. En cas de problème lors de l’utilisation du pipeline d’analyse Easy Shells CUTnRUN, demandez de l’aide sur la page Web des problèmes GitHub d’Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
REMARQUE : Idéalement, les emplacements des sommets des pics MACS2/3 et les emplacements des pics focalisés des pics SEACR présentent une distribution de signal nette et ciblée au centre des graphiques. Cependant, si l’algorithme d’appel de crête ne fonctionne pas correctement pour les données CUT&RUN, une distribution de signal « bruyante » moins ciblée peut apparaître dans les graphiques. Par conséquent, l’utilisation du nombre de pics appelés et des modèles de distribution du signal de crête des tracés de sortie guidera la détermination de la validité du pic pour une analyse CUT&RUN ultérieure qui inclut l’annotation de pic en aval.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
La qualité et le découpage de l’adaptateur permettent de conserver les lectures avec une qualité de séquençage élevée
Les techniques de séquençage à haut débit sont susceptibles de générer des erreurs de séquençage telles que des « mutations » de séquence dans les lectures. De plus, les dimères d’adaptateur de séquençage peuvent être enrichis dans les ensembles de données de séquençage en raison d’une mauvaise suppression de l’adaptateur lors de la préparation de la bibliothèque. Des erreurs de séquen...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
La capacité de cartographier l’occupation des protéines sur la chromatine est fondamentale pour mener des études mécanistes dans le domaine de la biologie de la chromatine. À mesure que les laboratoires adoptent de nouvelles techniques de laboratoire humide pour profiler la chromatine, la capacité d’analyser les données de séquençage de ces expériences de laboratoire humide devient un goulot d’étranglement courant pour les scientifiques de laboratoire humide. Par conséquent, nous décrivo...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs ne déclarent aucune divulgation.
Remerciements
Toutes les figurines illustrées ont été créées avec BioRender.com. Le CAI reconnaît le soutien fourni par le biais d’une bourse de chercheur en début de carrière de l’Alliance de recherche sur le cancer de l’ovaire, d’une subvention d’accélération de la Fondation Forbeck et du prix national de recherche sur la détection précoce de l’Alliance du cancer de l’ovaire du Minnestoa.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Logiciel pour compresser et convertir les readcounts bedGraph en bigWig |
| bedtools-2.31.1 | The Quinlan Lab @ l’Université de l’Utah | https://bedtools.readthedocs.io/en/latest/index.html | Logiciel pour traiter les fichiers bam/bed/bedGraph |
| bowtie2 2.5.4 | Université | Johns Hopkinshttps://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Logiciel pour construire l’indice de nœud papillon et effectuer l’alignement |
| CollectInsertSizeMetrics (Picard) | Broad institute | https://github.com/broadinstitute/picard | Logiciel pour effectuer l’analyse de la distribution de la taille des inserts |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html | Logiciel pour effectuer le découpage de l’adaptateur |
| Deeptoolsv3.5.1 | Max Planck Institute | https://deeptools.readthedocs.io/en/develop/index.html | Logiciel pour effectuer l’analyse de corrélation du coefficient de Pearson, l’analyse en composantes principales et l’analyse de la carte thermique/du tracé moyen |
| FastQC Version 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC | Logiciel pour vérifier la qualité du fichier fastq |
| Intervenezv0.6.1 | Biologie computationnelle & Régulation des gènes - Mathelier group | https://intervene.readthedocs.io/en/latest/index.html | Logiciel pour effectuer l’analyse du diagramme de Venn à l’aide de fichiers de pics |
| MACSv2.2.9.1 | Initiative de Chan Zuckerberg | https://github.com/macs3-project/MACS/tree/macs_v2 | Logiciel pour appeler les pics |
| MACSv3.0.2 | Initiative de Chan Zuckerberg | https://github.com/macs3-project/MACS/tree/master | Logiciel pour appeler les pics |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools | Logiciel pour traiter les fichiers sam/bam |
| SEACRv1.3 | Howard Hughes Medial institute | https://github.com/FredHutch/SEACR | Logiciel pour appeler les pics |
| SRA Toolkit Version 3.1.1 | NCBI | https://github.com/ncbi/sra-tools | Logiciel pour télécharger SRR à partir de GEO |
| Trim_Galore v0.6.10 | Babraham Bioinformatics | https://github.com/FelixKrueger/TrimGalore | Logiciel pour effectuer un parage de qualité et d’aptitude |
Références
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Réimpressions et autorisations
