Nous présentons ici un protocole pour établir un modèle cellulaire de la maladie d’Alzheimer induit par l’acide okadaïque dans les cellules SH-SY5Y et évaluer les effets neuroprotecteurs de la gastrodin par stress oxydatif et analyse des voies AKT/GSK-3β.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Gastrodin atténue l’hyperphosphorylation de la Tau associée aux changements de signalisation AKT/GSK-3β dans un modèle cellulaire de la maladie d’Alzheimer
* These authors contributed equally
Dans cet article
Résumé
Résumé
La maladie d’Alzheimer (MA) est une maladie neurodégénérative courante pour laquelle il existe actuellement peu de médicaments efficaces. En tant que principal composant bioactif dérivé de Gastrodia elata, Gastrodin (GAS) a montré un potentiel thérapeutique clair pour traiter la MA ; cependant, le mécanisme moléculaire de son action reste à élucider. Dans cette étude, nous visons à étudier le mécanisme de l’effet du SGA sur les cellules modèles de la MA. La pharmacologie des réseaux est employée pour analyser les cibles et les voies de signalisation affectées par le SGA dans la MA. Un modèle cellulaire d’AD est construit en induisant des cellules SH-SY5Y de neuroblastome humain avec de l’acide okadaïque (OA). La viabilité cellulaire a été évaluée à l’aide du test CCK-8, tandis que les niveaux de SOD, MDA et T-AOC ont été mesurés. Le taux d’apoptose a été déterminé par double coloration par Annexin V-FITC/PI, et l’expression de facteurs liés à l’apoptose, ainsi que d’AKT, GSK-3β, p-Tau (Ser396) et p-Tau (Thr181), a été analysée à l’aide de techniques RT-qPCR et Western blotting. L’analyse de la pharmacologie des réseaux suggère que le SGA a le potentiel de réguler l’apoptose cellulaire et les voies de signalisation associées, y compris PI3K/AKT. Nos expériences démontrent que le SGA peut inhiber les niveaux de MDA, augmenter le T-AOC et le SOD dans les cellules modèles de l’AD, et réduire l’apoptose cellulaire. Les résultats du Western blot indiquent que le GAS atténue les effets inhibiteurs de l’OA sur l’expression de p-AKT (Ser473) et de p-GSK-3β (Ser9). De plus, elle atténue la surexpression de p-Tau (Ser396) et p-Tau (Thr181), supprime l’expression de Bax et améliore l’expression de Bcl-2. Le SGA démontre la capacité d’atténuer les lésions par stress oxydatif induites par l’arthrose et d’atténuer l’apoptose. Le SGA peut supprimer l’hyperphosphorylation de Tau, qui est associée à des modifications de la voie de signalisation AKT/GSK-3β, exerçant ainsi des effets neuroprotecteurs potentiels.
Introduction
La maladie d’Alzheimer (MA) est un trouble neurodégénératif progressif principalement caractérisé par une perte de mémoire et des troubles cognitifs, représentant la forme la plus répandue de démence dans le monde, représentant environ 60 % à 80 % descas 1. La pathogenèse sous-jacente de la MA reste complexe et pas encore totalementélucidée 2. Les principaux signes pathologiques observés dans les cas cliniques de la DA incluent l’accumulation de plaques séniles (SP) et d’emmêlements neurofibrillaires (NFT) dans lecerveau 3,4. Il est bien reconnu que les deux événements pathologiques principaux dans l’AD sont le dépôt extracellulaire de la protéine β-amyloïde (Aβ) pour former des plaques séniles et l’agrégation intracellulaire de la protéine Tau hyperphosphorylée pour former des nœudsneurofibrillaires 5,6,7. De plus, le stress oxydatif et la neuroinflammation sont des facteurs complémentaires pouvant contribuer à l’aggravation de la maladied’Alzheimer 8,9,10,11.
À mesure que la tendance mondiale au vieillissement de la population s’intensifie, le nombre de patients atteints de démence a significativement augmentéde 12,13. Cependant, les options de traitement de la MA restent limitées, principalement composées de médicaments à cible unique tels que la mémantine, le donépézil et lagalantamine 14. Cependant, leurs effets thérapeutiques sont principalement palliatifs plutôt que modificateurs de la maladie, et certains effets indésirables tels que des troubles gastro-intestinaux, des vertiges et des bradycardies ont été rapportés. Par conséquent, le développement de stratégies thérapeutiques plus sûres et plus efficaces reste une prioritéimportante de recherche 15,16. Les médicaments monoclonaux récemment lancés, comme Lecanemab, ont apporté un nouvel espoir aux patients atteints de MAE légère. Pourtant, leurs coûts élevés et leurs limites ne répondent pas à la demande thérapeutique importante. La prévention et le traitement de la MA continuent de poser un défi important17,18. Les résultats de diverses études ont démontré que les plantes médicinales, en particulier les médecines traditionnelles chinoises, présentent des effets multicomposantes ciblant plusieurs voies impliquées dans des troubles neurodégénératifs tels que la MA. Des études ont montré que les composés actifs issus de Ganoderma lucidum peuvent atténuer les dommages oxydatifs dans les tissus cérébraux des souris atteints de la MA, inhiber l’apoptose, réduire la nécrose des neurones hippocampiques et améliorer le troublecognitif 19. Dans la recherche sur la MA, Bao et al. ont utilisé la pharmacologie en réseau pour identifier les cibles clés de l’Astragaloside IV dans l’inflammation associée à la MA. Leurs résultats ont révélé que le récepteur du facteur de croissance épidermique (EGFR) et l’interleukine-1β (IL-1β) sont des cibles cruciales, fournissant des candidats thérapeutiques potentiels et des cibles pathologiques pour le traitement clinique des maladiesneurodégénératives 20. Dartigues et al.21 ont analysé l’extrait de Ginkgo biloba et démontré qu’il a des effets bénéfiques sur la réduction du risque de démence et de mortalité chez les personnes âgées. Les patients traités avec l’extrait de Ginkgo biloba présentaient un taux de mortalité plusfaible 22.
Gastrodia elata, appartenant à la famille des Orchidaceae, est une herbe traditionnelle chinoise, comestible et médicinale. Le rhizome de Gastrodia elata est abondant dans le gastrodin (GAS), les polysaccharides de gastrodia et les alcaloïdes. Des recherches pharmacologiques récentes ont démontré que ces composés actifs possèdent des effets améliorant la mémoire et la cognition, ainsi que des propriétés neuroprotectrices et une efficacité dans le traitement de l’insomnie et desvertiges 23. Le principal composé bioactif de Gastrodia elata est le GAS, extrait du tubercule et possède des propriétés médicinales. Le GAS, également connu sous le nom d’alcool 4-hydroxybenzylique 4-O-β-d-glucoside, appartient à la classe des glycosidesphénoliques 24. La structure chimique du SGA est illustrée à la Figure 1, affichant un poids moléculaire de 286,278. La masse moléculaire relativement faible des glycosides et monoglycosides facilite leur pénétration efficace à travers la barrière hémato-encéphalique, servant ainsi de base fondamentale au rôle neuroprotecteur duGAS 25. De plus, leur grande absorbabilité renforce encore leur efficacité26. Ces dernières années, de nombreuses études ont démontré le potentiel du SAG dans le traitement de divers troubles cérébraux, notamment la maladie deParkinson (MP)31, et l’ischémiecérébrale 32. Le SGA présente une large gamme de propriétés pharmacologiques, notamment des effets antioxydatifs, hypolipidémiques, anti-inflammatoires et anti-âge33,34. Son mécanisme d’action implique plusieurs voies de signalisation telles que Nrf2, NF-κB et AMPK35. Le SGA exerce des effets neuroprotecteurs dans un modèle murin de lésions neurologiques induites par la Pb en modulant la voieWnt/Nrf2 36, et présente également un effet anti-apoptotique dans le traitement des troubles neurodégénératifs grâce à la régulation de la voie de signalisationNrf2 37. Le SGA a également exercé un effet bénéfique sur la DA en supprimant l’expression hippocampique de BACE1 via la voie de signalisation38 de la protéine kinase/facteur d’initiation eucaryote-2α (PKR/eIF2α). De plus, le SGA a montré des effets inhibiteurs sur l’activation de la signalisation NF-κB induite par TCDD, atténuant ainsi l’apoptose des neurones PC12 et l’activationdes astrocytes 39.
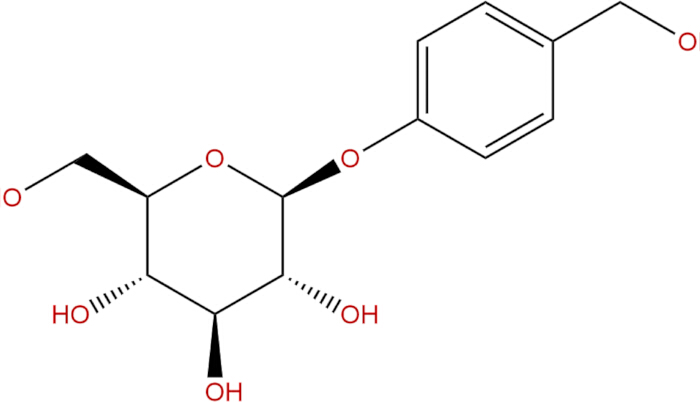
Figure 1 : Formule structurale chimique du GAS. Veuillez cliquer ici pour voir une version agrandie de cette figure.
L’OA, dérivée de l’éponge noire du genre Halichondria, appartient à une classe d’acides gras à longue chaîne et constitue le principal composant du poison diarrhétique des coquillages (DSP). Elle inhibe efficacement les activités des phosphatases protéiques, en particulier PP1A et PP2A, entraînant une hyperphosphorylation cellulaire et une perturbation de l’homéostasiecellulaire 40,41. Cette caractéristique en fait un outil précieux pour étudier les maladies associées à la phosphorylation des protéines. Ainsi, l’utilisation de l’AA permet la construction de modèles cellulaires DA présentant des altérations dans la phosphorylation des protéines Tau. Cette étude vise à étudier l’impact et le mécanisme du GAS, le principal composant actif de Gastrodia elata, sur le modèle cellulaire de la DA induit par l’OA, et à clarifier son effet neuroprotecteur sur les cellules modèles de la DA en ciblant la voie de signalisation AKT/GSK-3β.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Toutes les opérations de pharmacologie en réseau ont été menées conformément aux Directives pour les méthodes d’évaluation de la pharmacologie en réseau. Toutes les procédures expérimentales ont été réalisées conformément aux règlements de gestion des laboratoires de l’Université scientifique et technologique de Zhejiang.
Pharmacologie des réseaux
Prédiction des cibles potentielles de GAS : Le SMILES canonique de GAS (PubChem CID : 1150) a été extrait de la basede données PubChem 42. La structure SMILES a été téléchargée dans la base de données SwissTargetPrediction (http://www.swisstargetprediction.ch/)43. Le paramètre d’espèce était réglé sur Homo sapiens. Les cibles prédites avec une valeur de probabilité > 0,1 ont été conservées afin de réduire les prédictions de faux positifs. Toutes les cibles protéiques prédites ont été standardisées en symboles géniques officiels à l’aide de la base de donnéesUniProt 43 (espèce limitée à Homo sapiens), et les entrées en double ont été supprimées.
Les gènes liés à la maladie d’Alzheimer ont été collectés à partir de la base de données GeneCards (https://www.genecards.org/)44,45 et de la base OMIM (https://www.omim.org/)46 en utilisant « Alzheimer » comme terme de recherche. Dans les GeneCards, les gènes avec un score de pertinence > 10 ont été sélectionnés. Les cibles obtenues à partir de GeneCards et OMIM ont été fusionnées, les doublons ont été retirés, et les noms de gènes ont été standardisés à l’aide de UniProt.
Les cibles GAS prédites et les gènes liés à la DA ont été importés sur la plateforme en ligne Venny 2.1 afin d’obtenir des cibles qui se chevauchent. Un total de 52 gènes intersectants (voir Tableau Supplémentaire 1) ont été identifiés comme cibles thérapeutiques potentielles du SGA dans la MA.
Les 52 cibles qui s’entrecroisent ont été téléchargées dans la base de données STRING (https://string-db.org/)47 pour l’analyse PPI. L’espèce a été réglée sur Homo sapiens, et le score minimum requis d’interaction a été fixé à 0,4 (confiance moyenne). Les nœuds déconnectés étaient cachés. Les données d’interaction obtenues ont été exportées et visualisées à l’aide du logiciel Cytoscape (version 3.9.1).
Analyse d’enrichissement GO et KEGG : Les 52 cibles croisées ont été téléchargées dans la base de données Metascape (https://metascape.org/)48 pour les analyses d’enrichissement de Gene Ontology (GO) et de la Kyoto Encyclopedia of Genes and Genomes (KEGG). L’espèce était réglée sur Homo sapiens. Les critères d’enrichissement ont été définis comme étant < valeur p de 0,01, chevauchement minimum ≥ 3, et facteur d’enrichissement > 1,5. Les voies KEGG ont été classées selon la valeur p, et les 20 voies les plus significativement enrichies ont été sélectionnées pour la visualisation. Les résultats d’enrichissement ont été visualisés à l’aide d’une plateforme de bioinformatique en ligne.
Le fichier de structure protéique de GSK-3β a été obtenu à partir de la base de données RCSB PDB. Le fichier de structure de GAS au format SDF a été téléchargé depuis la base de données PubChem puis converti au format Mol2 à l’aide du logiciel Open Babel GUI. Les fichiers mentionnés ci-dessus ont été traités à l’aide d’un logiciel AutoDock pour ajouter des atomes d’hydrogène, éliminer les molécules d’eau et assigner des charges. Les fichiers traités ont ensuite été sauvegardés au format PDBQT. Après avoir détecté et traité les liaisons de torsion dans les molécules de ligand, les fichiers étaient ensuite stockés au format PDBQT. L’énergie de liaison la plus faible entre les deux molécules a été obtenue en effectuant un amarrage moléculaire à l’aide du logiciel AutoDock Vina. Par la suite, les résultats de l’amarrage ont été visualisés et analysés à l’aide de PyMOL.
Préparation de la solution de la crosse
La poudre d’OA (25 μg) a été complètement dissoute dans 1200 μL de 10 % de diméthylsulfoxyde (DMSO) préparée avec une solution stérile tamponnée phosphate (PBS) pour générer une solution de type stock à 25 μM. La solution d’origine était alicotée et stockée à -80 °C. Avant chaque expérience, l’OA était fraîchement dilué avec le Médium Eagle Modifié (DMEM) complet de Dulbecco (voir Tableau des matériaux) jusqu’aux concentrations de travail souhaitées. La poudre de gaz (20 mg) était dissoute dans 1,4 mL de PBS stérile, filtrée à travers une membrane de 0,22 μm pour la stérilisation, puis préparée sous forme de solution de 50 mM, stockée à -20 °C. Avant utilisation, la solution d’origine était diluée avec du DMEM complet aux concentrations de travail indiquées.
Construction du modèle de cellules AD
Des cellules SH-SY5Y du neuroblastome humain ont été obtenues et utilisées dans cette étude (voir tableau des matériaux). Les cellules SH-SY5Y ont été induites avec des concentrations de gradient d’OA (0, 10, 20, 40, 80, 160 nM) pour des durées de 12, 24 et 36 heures respectivement, afin d’établir le modèle des cellules AD.
Essai de viabilité cellulaire
Pour déterminer la concentration optimale et la durée d’induction d’OA pour établir le modèle de cellules AD, les cellules SH-SY5Y ont été traitées avec des concentrations de gradient d’OA (0, 10, 20, 40, 80 et 160 nM) pour différentes périodes (12, 24 et 36 h), et la viabilité cellulaire a été évaluée à l’aide du testCCK-8 49. Les cellules SH-SY5Y ont été ensemencées en plaques de 96 puits à une densité de 7,5 × 10cellules de 3 par puits dans 100 μL de DMEM complet. Les plaques ont été incubées à 37 °C dans un incubateur humidifié avec 5 % de CO₂ pendant 24 heures afin de permettre l’attachement cellulaire. Après 24 heures d’attachement, 100 μL de solution de travail OA ont été ajoutés à chaque puits pour atteindre des concentrations finales de 0, 10, 20, 40, 80 et 160 nM sur un volume total de 200 μL par puits. Le groupe témoin (CON) a reçu un volume égal de DMEM complet sans OA, tandis que le groupe OA a reçu OA aux concentrations indiquées. Les cellules ont été incubées pendant 12 heures, 24 heures ou 36 heures dans des conditions de culture standard. Chaque concentration et chaque moment temporel étaient réglés avec six puits répliqués. Trois puits vierges (uniquement le milieu) étaient inclus pour la correction de fond.
Détermination de l’indice de stress oxydatif cellulaire
Les cellules SH-SY5Y en phase de croissance logarithmique ont été ensemencées en une plaque à 6 puits. Après le traitement cellulaire, le milieu précédent a été jeté des puits. Par la suite, les puits ont été lavés trois fois avec du PBS pré-refroidi à 4 °C. Ensuite, un tampon de lyse cellulaire a été ajouté, et les cellules ont été lysées sur glace selon la méthode appropriée indiquée par le kit. La teneur en protéines des échantillons a été quantifiée à l’aide du kit de test des protéines BCA (voir Tableau des matériaux). Les activités du T-AOC, SOD et MDA ont été déterminées selon les instructions fournies avec les kits de test respectifs (voir Tableau des matériaux).
Détection de l’apoptose cellulaire
L’apoptose cellulaire a été évaluée à l’aide d’un kit de double coloration Annexin V-FITC/PI (voir Tableau des matériaux) selon les instructions du fabricant. En résumé, des cellules flottantes et des cellules adhérentes ont été prélevées. Les cellules adhérentes ont été digérées à l’aide de trypsine sans EDTA pour éviter les dommages aux membranes artificielles et combinées avec des cellules flottantes. Les cellules ont été lavées deux fois avec du PBS froid et resuspendues dans 500 μL de tampon de liaison 1× à une densité de 0,5–1 ×10,6 cellule.
Par la suite, 5 μL d’Annexine V-FITC et 5 μL de Propidium Iodure (PI) ont été ajoutés à chaque échantillon, légèrement mélangés, puis incubés à température ambiante dans l’obscurité pendant 10 à 20 minutes. Les échantillons ont été placés sur la glace et analysés en moins d’une heure à l’aide d’un cytomètre en flux.
Pour l’analyse cytométrique en flux, des contrôles non colorés et des contrôles à une seule coloration (Annexin V-FITC seulement et PI uniquement) ont été utilisés pour définir les paramètres de compensation et les portes de quadrants. La grille de diffusion avant et latérale (FSC/SSC) a été appliquée pour la première fois pour exclure les débris et les agrégats cellulaires. Un minimum de 10 000 événements par échantillon a été réalisé. Les données ont été analysées à l’aide du logiciel FlowJo.
Analyse quantitative PCR en temps réel (RT-qPCR)
Selon les instructions fournies par le kit de transcription inverse AG, l’ARN extrait a été soumis à une transcription inverse pour générer de l’ADN complémentaire (ADNc), qui a ensuite été dilué 10 fois avec de l’eau stérile servant de modèle. Le système de réaction RT-qPCR a été préparé selon le protocole du kit Green Master Mix (No Rox), et l’analyse a été réalisée à l’aide d’un instrument de PCR quantitative fluorescente (voir Tableau des matériaux). Les valeurs de Ct obtenues ont été traitées et analysées, et les niveaux d’expression des gènes cibles ont été calculés à l’aide de la méthode 2-ΔΔCt, où ΔCt représente la différence entre les valeurs de Ct dans le groupe traité et GAPDH, et ΔΔCt représente la différence entre les valeurs de ΔCt dans le groupe traité et le groupe témoin. La liste des amorces se trouve dans le Tableau Supplémentaire 2.
Analyse du Western blotting
Le tampon de lyse cellulaire, ainsi qu’un inhibiteur de protéase et un inhibiteur de phosphatase, ont été combinés dans un ratio de 100:1:1. Les cellules ont été lysées pour extraire des protéines cellulaires. La concentration en protéines a été déterminée à l’aide du kit de test BCA. Les protéines (20–30 μg par voie) ont été séparées sur des gels SDS-PAGE à 10 % à 80 V pour le gel d’empilement et 120 V pour le gel résolus. Les protéines ont été transférées dans les membranes de PVDF (0,45 μm) à 300 mA pendant 90 minutes grâce au transfert humide. La membrane a été bloquée avec 5 % de lait écrémé à température ambiante pendant 2 heures, suivie d’une incubation nocturne avec un anticorps primaire (voir Tableau des matériaux) à 4 °C. Après incubation avec l’anticorps secondaire à température ambiante pendant 1 heure, la membrane a été lavée quatre fois avec TBST pendant 5 minutes chacune. Les bandes ont été visualisées à l’aide de réactifs de détection par chimiluminescence améliorée (ECL) (voir Tableau des matériaux), et la détection a été réalisée à l’aide d’un système d’imagerie sur gel. Les valeurs en niveaux de gris ont été analysées à l’aide du logiciel ImageJ pour obtenir des informations sur les données.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Dépistage ciblé lié aux GAS pour le traitement de la MA
L’identification des cibles de GAS pour traiter la DA impliquait des recherches dans les bases de données et une analyse logicielle. La base de données suisse de prédiction de cibles a fourni 100 cibles potentielles, tandis que OMIM et GeneCards (avec un score de pertinence > 10) ont été interrogés pour des cibles liées à la DA, ce qui a donné un total de 2376 cibles potentielles. Par la suite, l’utilisation de l...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Ces dernières années, la prévalence de la maladie d’Alzheimer a augmenté à l’échelle mondiale. Cette affection se caractérise par une évolution chronique, une nature irréversible, un handicap et des taux de mortalité élevés, ce qui en fait un défi majeur dans le contexte d’un vieillissement de la population mondiale. Malgré sa proéminence, l’étiologie de l’ADA est complexe, et sa pathogenèse reste incomplètementcomprise 51.
La médecine ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n’ont rien à divulguer.
Remerciements
Cette recherche a été soutenue par l’Open Fund de l’Université Sci-Tech du Zhejiang, Shaoxing Academy of Biomedicine (SXAB202007).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Système PCR en temps réel 7500 | APExBIO ; | S0080 | Utilisé pour détecter les cellules apoptotiques |
| Instrument de marquage enzymatique A450 | Proteintech & nbsp ; | 50599-2-IG | WB, dilution 1:1000 |
| Kit de détection d’apoptose Annexin V-FITC | Proteintech & nbsp ; | 60178-1-IG | WB, dilution 1:1000 |
| Anticorps anti-Bax | Proteintech & nbsp ; | 10494-1-AP | WB, dilution 1:1000 |
| Anticorps anti-Bcl-2 | Abcam ; | ab32057 | WB, dilution 1:1000 |
| Anticorps anti-GAPDH | Proteintech & nbsp ; | 28866-1-AP | WB, dilution 1:1000 |
| Anticorps anti-p-Tau (Ser396) | Biofroxx ; | 1172 | Tampon de blocage pour WB |
| Anticorps anti-p-Tau (Thr181) | Vazyme Biotech ; | A311-01/02 | Utilisé pour le test de viabilité cellulaire |
| Lait écrémé Biofroxx | Solarbio Science & Technologie & nbsp ; | D8371 | Solvant pour composés |
| Kit CCK-8 | Wisent Biotechnologie | 319-105-CL | Pour la culture cellulaire |
| Diméthylsulfoxyde (DMSO) | APExBIO (États-Unis) | K1231 | Réactif de détection de WB |
| Milieu DMEM à haute glycémie | Aladdin Biochemical Technology & nbsp ; | G111309 | Composé actif |
| Réactif chimiluminescent ECL | Proméga ; | ; A6101 | Pour l’amplification qPCR |
| Cytomètre en débit | Solarbio Science & Technologie & nbsp ; | BC6410 | Dosage de peroxydation lipidique |
| Gastrodin (GAS) poudre, pureté & ge ; 98% | MedChemExpress | HY-N6785 | Inducteur de l’hyperphosphorylation des tau |
| Système d’imagerie sur gel | Beyotime Biotechnology | C0221A | Laver les cellules |
| Mix maître GoTaq qPCR | Proteintech & nbsp ; | SA00001-1 | WB, dilution 1:5000 |
| Kit de test MDA (malondiadéhyde) | Proteintech & nbsp ; | SA00001-2 | WB, dilution 1:5000 |
| Acide okadaïque (OA) | ATCC | CRL-2266 | Cellule |
| PBS | Beyotime Biotechnology | S0101M | Pour le test de stress oxydatif |
| Anticorps secondaire (IgG anti-souris de chèvre, conjugué à HRP) | Solarbio Science & Technologie & nbsp ; | 1315 av. J.-C. | Détection de la capacité antioxydante |
| Anticorps secondaire (anti-lapins IgG de chèvre, conjugué à HRP) | Beyotime Biotechnology & nbsp ; | R0016 | Extraction d’ARN |
| SH-SY5Y | Sigma-Aldrich & nbsp ; | 9002-07-7 | Digestion cellulaire |
| Kit d’analyse SOD (dismutase totale de superoxyde) | Thermo Fisher Scientific | A45072 | Lecteur de microplaques multifonctionnel pour la détection d’absorbance |
| Kit de capacité antioxydant totale (T-AOC) | Becton, Dickinson and Company | 661310 | Pour l’analyse multi-paramètre d’une seule cellule et le tri de cellules. |
| Réactif Trizol | Thermo Fisher Scientific | 4351104 | Analyse de l’expression génique |
| Trypsine | Bio Rad | 1708195 | Imagerie en gel ADN/ARN/protéine |
Références
- Hu, X., Wang, T., Jin, F. Alzheimer's disease and gut microbiota. Sci China Life Sci. 59 (10), 1006-1023 (2016).
- Qiu, C., Du, Y. A call for action to strengthen research on population interventions against Alzheimer's disease and senile dementia. J Shandong Univ Health Sci. 55 (10), 1-6 (2017).
- Livingston, G., et al. Dementia prevention, intervention,and care: 2020 report of the Lancet Commission. Lancet. 396 (10248), 413-446 (2020).
- Li, T. F., Guo, Z. Q., Wang, Y. Abnormal ß-amyloid metabolism and Alzheimer disease. J Neurosci Ment Health. 22 (12), 904-908 (2022).
- Zheng, J., et al. Oral administration of a fusion protein between the cholera toxin B subunit and the 42-amino acid isoform of amyloid-β peptide produced in silkworm pupae protects against Alzheimer's disease in mice. PLoS One. 9 (12), e113585(2014).
- La Spada, A. R., et al. A Becn1 mutation mediates hyperactive autophagic sequestration of amyloid oligomers and improved cognition in Alzheimer's disease. PLoS Genet. 13 (8), e1006962(2017).
- Aboelwafa, H. R., El-Kott, A. F., Abd-Ella, E. M., Yousef, H. N. The possible neuroprotective effect of silymarin against aluminum chloride-prompted Alzheimer's-like disease in rats. Brain Sci. 10 (9), 628(2020).
- Tobore, T. O. On the central role of mitochondria dysfunction and oxidative stress in Alzheimer's disease. Neurol Sci. 40 (8), 1527-1540 (2019).
- Kawamoto, E. M., et al. Oxidative state in platelets and erythrocytes in aging and Alzheimer's disease. Neurobiol Aging. 26 (6), 857-864 (2005).
- Stancu, I. C., et al. Aggregated Tau activates NLRP3–ASC inflammasome exacerbating exogenously seeded and non-exogenously seeded Tau pathology in vivo. Acta Neuropathol. 137 (4), 599-617 (2019).
- Connolly, K., et al. Potential role of chitinase-3-like protein 1 (CHI3L1/YKL-40) in neurodegeneration and Alzheimer's disease. Alzheimers Dement. 19 (1), 9-24 (2022).
- Yingquan, W., Jing-Hong, L., Ruixia, J. Alzheimer disease in China (2015-2050) estimated using the 1% population sampling survey in 2015. China J Alzheimers Dis Relat Disord. 2 (1), 289-298 (2019).
- Amat-Ur-Rasool, H., Ahmed, M., Hasnain, S., Carter, W. G. Anti-cholinesterase combination drug therapy as a potential treatment for Alzheimer's disease. Brain Sci. 11 (2), 184(2021).
- Cummings, J., Lee, G., Mortsdorf, T., Ritter, A., Zhong, K. Alzheimer's disease drug development pipeline: 2017. Alzheimers Dement (N Y). 3 (3), 367-384 (2017).
- Birks, J. S., Harvey, R. J. Donepezil for dementia due to Alzheimer's disease. Cochrane Database Syst Rev. 6 (6), CD001190(2018).
- Knopman, D. S., et al. Alzheimer's disease. Nat Rev Dis Primers. 7 (1), 33(2021).
- Silva, T., Reis, J., Teixeira, J., Borges, F. Alzheimer's disease, enzyme targets and drug discovery struggles: from natural products to drug prototypes. Ageing Res Rev. 15, 116-145 (2014).
- Liu, X., Yi, W., Xi, B., Dai, Q., Lu, L. Identification of drug-disease associations using a random walk with restart method and supervised learning. Comput Math Methods Med. 2022 (1), 7035634(2022).
- Yu, N., et al. Ganoderma lucidum triterpenoids (GLTs) reduce neuronal apoptosis via inhibition of ROCK signal pathway in APP/PS1 transgenic Alzheimer's disease mice. Oxid Med Cell Longev. 2020 (1), 1-11 (2020).
- Bao, M., et al. Astragaloside IV against Alzheimer's disease via microglia-mediated neuroinflammation using network pharmacology and experimental validation. Eur J Pharmacol. 957, 175992(2023).
- Dartigues, J. F., et al. Ginkgo biloba extract consumption and long-term occurrence of death and dementia. J Prev Alzheimers Dis. 4 (1), 16-20 (2017).
- Savaskan, E., Mueller, H., Hoerr, R., von Gunten, A., Gauthier, S. Treatment effects of Ginkgo biloba extract EGb 761® on the spectrum of behavioral and psychological symptoms of dementia: meta-analysis of randomized controlled trials. Int Psychogeriatr. 30 (3), 285-293 (2017).
- Wang, D., Liu, W., Lu, M., Xu, Q. Neuropharmacological effects of Gastrodia elata Blume and its active ingredients. Front Neurol. 16, 1574277(2025).
- El Menyiy, N., et al. Chemistry, biological activities,and pharmacological properties of gastrodin: mechanism insights. Chem Biodivers. 21 (6), e202400402(2024).
- Yu, H., et al. Research progress on classification of chemical constituents from Gastrodia elata and their pharmacological effects. Chin Tradit Herbal Drugs. 53, 5553-5562 (2022).
- Tang, C., et al. Comparative pharmacokinetics of gastrodin in rats after intragastric administration of free gastrodin, parishin and Gastrodia elata extract. J Ethnopharmacol. 176, 49-54 (2015).
- Fu, X., et al. Antioxidation effects and mechanism of gastrodin in AD rat models. Acta Anat Sin. 41 (4), 485-490 (2010).
- Shi, R., et al. Gastrodin alleviates vascular dementia in a 2-VO vascular dementia rat model by altering amyloid and Tau levels. Pharmacology. 105 (7-8), 386-396 (2020).
- Fasina, O. B., et al. Gastrodin from Gastrodia elata enhances cognitive function and neuroprotection of AD mice via the regulation of gut microbiota composition and inhibition of neuron inflammation. Front Pharmacol. 13, 814271(2022).
- Zheng, Q., et al. MicroRNA-452 promotes tumorigenesis in hepatocellular carcinoma by targeting cyclin-dependent kinase inhibitor 1B. Mol Cell Biochem. 389 (1-2), 187-195 (2014).
- Yan, J., Yang, Z., Zhao, N., Li, Z., Cao, X. Gastrodin protects dopaminergic neurons via insulin-like pathway in a Parkinson's disease model. BMC Neurosci. 20 (1), 31(2019).
- Xiao, H., et al. Gastrodin promotes hippocampal neurogenesis via PDE9-cGMP-PKG pathway in mice following cerebral ischemia. Neurochem Int. 150, 105171(2021).
- Liu, Y., et al. A review on central nervous system effects of gastrodin. Front Pharmacol. 9, 24(2018).
- Fu, J., et al. Gastrodia elata specific miRNA attenuates neuroinflammation via modulating NF-κB signaling pathway. Int J Neurosci. 134 (12), 1652-1662 (2023).
- Wang, Y., et al. Gastrodin: a comprehensive pharmacological review. Naunyn Schmiedebergs Arch Pharmacol. 397 (6), 3781-3802 (2024).
- Liu, C. M., et al. Effects of gastrodin against lead-induced brain injury in mice associated with the Wnt/Nrf2 pathway. Nutrients. 12 (6), 1805(2020).
- De Oliveira, M. R., Brasil, F. B., Fürstenau, C. R. Nrf2 mediates the anti-apoptotic and anti-inflammatory effects induced by gastrodin in hydrogen peroxide-treated SH-SY5Y cells. J Mol Neurosci. 69 (1), 115-122 (2019).
- Zhang, J. S., et al. Gastrodin suppresses BACE1 expression under oxidative stress condition via inhibition of the PKR/eIF2α pathway in Alzheimer's disease. Neuroscience. 325, 1-9 (2016).
- Jiao, M., et al. Effect of the SSeCKS–TRAF6 interaction on gastrodin-mediated protection against 2,3,7,8-tetrachlorodibenzo-p-dioxin-induced astrocyte activation and neuronal death. Chemosphere. 226, 678-686 (2019).
- Cohen, P., Holmes, C. F., Tsukitani, Y. Okadaic acid: a new probe for the study of cellular regulation. Trends Biochem Sci. 15 (3), 98-102 (1990).
- Qin, Y., et al. Okadaic acid detection through a rapid and sensitive amplified luminescent proximity homogeneous assay. Toxins (Basel). 15 (8), 501(2023).
- Kim, S., et al. PubChem 2023 update. Nucleic Acids Res. 51 (D1), D1373-D1380 (2022).
- Daina, A., Michielin, O., Zoete, V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 47 (W1), W357-W364 (2019).
- Stelzer, G., et al. The GeneCards suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 54 (1), 1.30.31-1.30.33 (2016).
- Safran, M., et al. Practical guide to life science databases. , Springer Nature. Singapore. (2021).
- Amberger, J. S., Bocchini, C. A., Schiettecatte, F., Scott, A. F., Hamosh, A. OMIM.org: Online Mendelian Inheritance in Man (OMIM®), an online catalog of human genes and genetic disorders. Nucleic Acids Res. 43 (D1), D789-D798 (2014).
- Szklarczyk, D., et al. The STRING database in 2021: customizable protein–protein networks,and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 49 (D1), D605-D612 (2020).
- Zhou, Y., et al. Metascape provides a biologist-oriented resource for the analysis of systems-level datasets. Nat Commun. 10 (1), 1523(2019).
- Tominaga, H., et al. A water-soluble tetrazolium salt useful for colorimetric cell viability assay. Anal Commun. 36 (2), 47-50 (1999).
- Ton, A. M. M., et al. Oxidative stress and dementia in Alzheimer's patients: effects of synbiotic supplementation. Oxid Med Cell Longev. 2020 (1), 2638703(2020).
- Roth, K. A. Caspases, apoptosis,and Alzheimer disease: causation,correlation,and confusion. J Neuropathol Exp Neurol. 60 (9), 829-838 (2001).
- Cheng, M., et al. The effects of Porphyromonas gingivalis on the apoptosis of hippocampal cells in Sprague-Dawley rats and its underlying mechanisms. Int J Clin Exp Med. 13 (1), 300-309 (2020).
- Liu, H., et al. Development of chemical fingerprints for quality control of Xiong Ma Tang and its related preparations by high-performance liquid chromatography. J Chromatogr Sci. 54 (2), 206-215 (2016).
- Liu, S. J., et al. Gastrodin attenuates microglia activation through renin-angiotensin system and Sirtuin3 pathway. Neurochem Int. 120, 49-63 (2018).
- Hu, Y., Li, C., Shen, W. Gastrodin alleviates memory deficits and reduces neuropathology in a mouse model of Alzheimer's disease. Neuropathology. 34 (4), 370-377 (2014).
- Liu, J., et al. Systems pharmacology uncovers the multiple mechanisms of Xijiao Dihuang decoction for the treatment of viral hemorrhagic fever. Evid Based Complement Alternat Med. 2016 (1), 9025036(2016).
- Ran, B., et al. Drug-drug interactions prediction using fingerprint only. Comput Math Methods Med. 2022 (1), 7818480(2022).
- Sharma, V. K., Singh, T. G., Singh, S., Garg, N., Dhiman, S. Apoptotic pathways and Alzheimer's disease: probing therapeutic potential. Neurochem Res. 46 (12), 3103-3122 (2021).
- Zhou, W., Gao, Y., Xu, S., Yang, Z., Xu, T. Purification of a mannose-binding lectin Pinellia ternata agglutinin and its induction of apoptosis in Bel-7404 cells. Protein Expr Purif. 93, 11-17 (2014).
- Goedert, M., Spillantini, M. G., Jakes, R., Rutherford, D., Crowther, R. Multiple isoforms of human microtubule-associated protein tau: sequences and localization in neurofibrillary tangles of Alzheimer's disease. Neuron. 3 (4), 519-526 (1989).
- Hernández, F., Gómez De Barreda, E., Fuster-Matanzo, A., Lucas, J. J., Avila, J. GSK3: a possible link between beta amyloid peptide and tau protein. Exp Neurol. 223 (2), 322-325 (2010).
- Lu, Z., et al. Neuroprotection and mechanism of Gas-miR36-5p from Gastrodia elata in an Alzheimer's disease model by regulating glycogen synthase kinase-3β. Int J Mol Sci. 24 (24), 17295(2023).
- Vossel, K. A., et al. Tau reduction prevents Aβ-induced axonal transport deficits by blocking activation of GSK3β. J Cell Biol. 209 (3), 419-433 (2015).
- Singh, A. K., et al. Berberine: a plant-derived alkaloid with therapeutic potential to combat Alzheimer's disease. CNS Agents Med Chem. 19 (3), 154-170 (2019).
- Belsare, K. D., et al. Soluble TREM2 inhibits secondary nucleation of Aβ fibrillization and enhances cellular uptake of fibrillar Aβ. Proc Natl Acad Sci U S A. 119 (5), e2114486119(2022).
- Matsuda, S., et al. Roles of PI3K/AKT/GSK3 pathway involved in psychiatric illnesses. Diseases. 7 (1), 22(2019).
- Pan, S., et al. Oleanolic acid derivatives induce apoptosis in human leukemia K562 cell involved in inhibition of both Akt1 translocation and pAkt1 expression. Cytotechnology. 67 (5), 821-829 (2014).
- Zhou, F., et al. Network pharmacology-based strategy to investigate pharmacological mechanisms of Tinospora sinensis for treatment of Alzheimer's disease. J Ethnopharmacol. 259, 112940(2020).
- Liu, Z., Wang, Z. Protein tyrosine kinase 2 regulates tau phosphorylation through PI3K/AKT/Gsk3β signaling pathway. Labeled Immunoassays Clin Med. 29 (3), 464-470 (2022).
- Cope, P. J., Ourradi, K., Li, Y., Sharif, M. Models of osteoarthritis: the good, the bad and the promising. Osteoarthritis Cartilage. 27 (2), 230-239 (2019).
- Wang, X., Blanchard, J., Tung, Y. C., Grundke-Iqbal, I., Iqbal, K. Inhibition of protein phosphatase-2A (PP2A) by I1PP2A leads to hyperphosphorylation of tau, neurodegeneration,and cognitive impairment in rats. J Alzheimers Dis. 45 (2), 423-435 (2015).
- Liu, T. T., et al. Gastrodin alleviates Aβ25-35-induced glycolytic dysfunction via activating PI3K/AKT/BACH1 signaling in Alzheimer's disease models. Exp Neurol. 389, 115225(2025).
- Zuo, H. J., et al. Gastrodin regulates PI3K/AKT-Sirt3 signaling pathway and proinflammatory mediators in activated microglia. Mol Neurobiol. 61 (5), 2728-2744 (2024).
- Wang, Y. P., Mandelkow, E. Tau in physiology and pathology. Nat Rev Neurosci. 17, 22-35 (2015).
- Pardridge, W. M. Drug transport across the blood–brain barrier. J Cereb Blood Flow Metab. 32 (11), 1959-1972 (2012).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.