Cet article propose une méthode de surveillance de la sécurité dans une chaîne de production combinant You Only Look Once version 11 (YOLOv11) avec des réseaux neuronaux convolutifs. Elle atteint une précision moyenne à un seuil d'intersection sur union de 0,5 (mAP@0,5) de 0,91, un mAP@0,5:0,95 de 0,82 et un débit de 120 images par seconde sur une unité de traitement graphique, surpassant ainsi les modèles de référence évalués.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Surveillance en temps réel de la sécurité des lignes de production utilisant la détection d'objets et l'amélioration des caractéristiques basées sur l'apprentissage profond
Dans cet article
Résumé
Résumé
Avec l'approfondissement de l'industrie 4.0, les niveaux d'automatisation et d'intelligence des chaînes de production se sont considérablement améliorés, ce qui accroît les exigences en matière de performance en temps réel, de précision et de sécurité du suivi. Les systèmes de surveillance traditionnels, qui reposent sur des inspections manuelles ou des décisions basées sur des seuils simples, souffrent généralement de temps de réponse lents, de taux élevés de fausses alarmes et d'une intelligence limitée. Par conséquent, cet article propose un système de surveillance de la sécurité des chaînes de production intégrant You Only Look Once version 11 (YOLOv11) à un réseau neuronal convolutif (CNN). Premièrement, les images acquises ont été prétraitées. Ensuite, YOLOv11 a été utilisé pour identifier en temps réel les travailleurs, les équipements et les dangers potentiels. Puis, un réseau CNN amélioré, doté d'une fusion de caractéristiques multi-échelle et de mécanismes d'attention, a été introduit afin d'améliorer les capacités d'extraction de caractéristiques pour les cibles petites et partiellement masquées. Enfin, les résultats de détection ont été fusionnés avec les caractéristiques renforcées par le CNN pour évaluer l'état de sécurité. Des expériences ont été menées à l'aide d'un jeu de données sur la sécurité en chaîne de production construit en interne, en utilisant l'optimiseur de descente de gradient stochastique (SGD) avec un momentum de 0,9, un taux d'apprentissage initial de 0,01, une décroissance du poids de 0,0005, un ajustement du taux d'apprentissage par recuit cosinus, une taille de lot de 32 et un entraînement sur 200 époques. Le mAP@0,5 et la vitesse de détection en images par seconde (FPS) ont été utilisés comme métriques d'évaluation pour la comparaison avec les algorithmes de référence évalués. Les résultats montrent que le système proposé a atteint un mAP@0,5 de 0,91 et une vitesse de détection de 120 FPS. Il a également démontré des performances robustes dans des conditions complexes telles que l'ombrage et des variations d'éclairage, confirmant ainsi son efficacité et son potentiel d'application pratique dans la surveillance de la sécurité des chaînes de production.
Introduction
Dans la production industrielle moderne, la sécurité est le pilier essentiel garantissant l'efficacité de la production et le bien-être du personnel. L'environnement de la chaîne de production implique généralement des équipements mécaniques à grande vitesse, des procédés technologiques complexes et des opérations collaboratives combinant plusieurs tâches. Le moindre risque potentiel pour la sécurité peut entraîner de graves accidents industriels, provoquant d'importantes pertes économiques et même des décès. Il est donc crucial de mettre en place un système de surveillance de la sécurité efficace, intelligent et en temps réel afin d'améliorer la sécurité dans la production industrielle1,2.
Les méthodes traditionnelles de surveillance de la sécurité reposent principalement sur la surveillance vidéo manuelle et divers capteurs (tels que les capteurs infrarouges, de fumée et de vibration)3. La surveillance manuelle n'est pas seulement inefficace, mais elle est également sujette à des détections manquées en raison de la fatigue du personnel de surveillance, et elle ne peut pas assurer une couverture continue et complète. Bien que les capteurs puissent offrir une certaine fonction d'alerte précoce, leur portée de détection est limitée et ils sont sensibles aux interférences environnementales, ce qui entraîne des problèmes importants de fausses alarmes4. Les systèmes de surveillance intelligents sont devenus un domaine de recherche de plus en plus important. L'analyse en temps réel d'un flux vidéo à l'aide d'un algorithme d'apprentissage profond permet d'identifier automatiquement les événements anormaux, les comportements dangereux et les risques potentiels, améliorant ainsi considérablement l'intelligence du système de surveillance4,5.
La détection d'objets est une technologie fondamentale dans la surveillance intelligente. En tant que représentants des détecteurs d'objets monocouche, les algorithmes de la série You Only Look Once (YOLO) présentent des avantages significatifs. De YOLOv1 à YOLOv8, cet ensemble d'algorithmes a connu un développement continu, avec des améliorations apportées à l'architecture du réseau, à la fonction de perte et à la méthodologie d'entraînement, entre autres aspects6,7. YOLOv11, en particulier, a atteint une précision de détection plus élevée tout en conservant un taux d'images par seconde élevé, notamment lorsqu'il est confronté à des arrière-plans complexes et à des cibles densément regroupées8.
Cependant, malgré ses excellentes performances dans les tâches générales de détection d'objets, YOLOv11 fait toujours face à des défis dans des scénarios spécifiques de surveillance de la sécurité en ligne de production9. Par exemple, la précision de détection de YOLOv11 peut diminuer lorsque les travailleurs sont partiellement masqués par des équipements ou lorsque les panneaux de sécurité sont petits et présentent une forte ressemblance avec la couleur du fond. Cela exige du modèle des capacités plus poussées d'extraction de caractéristiques et de compréhension sémantique10.
Les réseaux neuronaux convolutifs (CNN) possèdent de solides capacités en matière d'extraction de caractéristiques d'image11. En concevant des architectures de réseau plus profondes et plus complexes, les CNN peuvent apprendre des caractéristiques d'image plus riches et plus abstraites. Le couplage d'un CNN avec YOLOv11 exploite les capacités de détection rapide de YOLOv11 et l'extraction approfondie de caractéristiques du CNN, permettant ainsi de construire un système de surveillance de sécurité plus robuste et plus intelligent.
Sur cette base, cet article propose un système de surveillance de la sécurité en ligne de production utilisant YOLOv11 et un CNN. Les aspects innovants de cette étude comprennent : (1) la proposition d'une architecture de fusion profonde combinant YOLOv11 et un CNN amélioré ; (2) l'introduction d'une fusion de caractéristiques multi-échelle et d'un mécanisme d'attention composite afin d'améliorer la reconnaissance des caractéristiques clés de sécurité ; et (3) la vérification des avantages en performance du modèle sur un jeu de données de scènes complexes construit par nos soins.
Développement des algorithmes de la série YOLO
Depuis sa première présentation par Redmon et al. en 201512, l'algorithme You Only Look Once (YOLO) a suscité un grand intérêt. Contrairement aux détecteurs à deux étapes qui s'appuient sur des propositions de régions, YOLO aborde la détection d'objets comme une tâche de régression. En prédisant directement les classes et les positions des objets dans une image, YOLO augmente nettement la vitesse de détection, ce qui le rend adapté à une utilisation en temps réel13.
En tant que travail pionnier de cette série, YOLOv1 parvient pour la première fois à une détection de cibles de bout en bout14. YOLOv1 consiste à diviser l'image d'entrée en une structure en grille, où chaque cellule de grille, généralement organisée selon un format S × S, est chargée de détecter les objets situés dans ses limites.
Plus précisément, la sortie de YOLOv1 est un tenseur. Parmi les S × S × (B × 5 + C), la prédiction de chaque boîte englobante contient 5 éléments : les coordonnées du centre (x,y), la largeur w, la hauteur h et la confiance c. Le processus de calcul est illustré dans l'équation (1) :
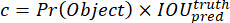 (1)
Parmi eux, Pr(Object) représente la probabilité qu'il y ait une cible dans la grille, et IOU représente le rapport entre l'intersection et l'union entre la boîte englobante prédite et la boîte de référence. Chaque grille prédit également un ensemble de probabilités de classe, Pr représentant la probabilité que la cible appartienne à la i-ième classe en présence d'une cible. La fonction de perte de YOLOv1 est composée de trois composantes principales : la perte liée à la prédiction des coordonnées, la perte liée à l'estimation de la confiance et la perte liée à la prédiction de la catégorie15.
YOLOv2 introduit la normalisation par lots, un classificateur à haute résolution et une stratégie d'apprentissage multi-échelle, ce qui améliore la stabilité et la précision16. YOLOv3 utilise Darknet-53 comme réseau de base et s'inspire du concept de réseau pyramidal de caractéristiques (FPN) pour améliorer la détection des objets17.
YOLOv4 a apporté de nombreuses optimisations par rapport à YOLOv3, en introduisant des technologies telles que le Cross Stage Partial Network (CSPNet)18, le Path Aggregation Network (PANet)19 et l'amélioration des données Mosaic afin d'améliorer davantage les performances du modèle. YOLOv5 a apporté des contributions significatives en matière d'ingénierie, en proposant une implémentation plus facile à utiliser et plus efficace20.
Ces dernières années, la série YOLO n’a cessé d’évoluer, avec la sortie successive des versions YOLOv6, YOLOv7 et YOLOv8. En introduisant la structure Extended Efficient Layer Aggregation Network (E-ELAN) ainsi que des techniques de re-paramétrisation de modèle, YOLOv7 réalise de nouvelles avancées en termes de vitesse et de précision. Ces améliorations augmentent non seulement l'efficacité de l'apprentissage des caractéristiques, mais optimisent également les performances d'inférence du réseau, permettant à YOLOv7 de surpasser les versions précédentes ainsi que de nombreux détecteurs dominants dans diverses tâches de détection d'objets en temps réel. YOLOv8 optimise davantage la structure du réseau, adopte une conception sans ancres, simplifie le modèle et améliore sa capacité de généralisation21.
S'appuyant sur les avantages des versions précédentes, YOLOv11, utilisé dans cette étude, a été optimisé pour des scénarios industriels complexes. Ses améliorations principales incluent un réseau d'extraction de caractéristiques, un module de fusion de caractéristiques plus efficace et une conception de fonction de perte plus robuste. Ces améliorations permettent à YOLOv11 de mieux performer lorsqu'il s'agit de gérer les occultations, les petites cibles et les arrière-plans complexes dans les environnements de production. YOLOv11 est une version de la série YOLO publiée par Ultralytics. Par rapport à YOLOv8, elle améliore le module C3K2 et le chemin de fusion de caractéristiques, et introduit une stratégie d'ancrage adaptative, offrant ainsi une robustesse de détection accrue dans les scénarios industriels.
Fondements et progrès du réseau neuronal convolutif (CNN)
Le réseau neuronal convolutif (CNN) est un modèle fondamental qui a profondément influencé le succès de l'apprentissage profond en vision par ordinateur. Il fonctionne en extrayant des caractéristiques locales des images au moyen d'opérations de convolution, puis en réduisant la dimensionnalité des caractéristiques par des opérations de regroupement (pooling), permettant ainsi une abstraction hiérarchique des images22.
Un CNN typique est composé de plusieurs couches de convolution, de regroupement et entièrement connectées. La couche de convolution analyse l'image d'entrée à l'aide d'un noyau de convolution, calcule des produits scalaires sur des régions locales et produit une carte de caractéristiques. Le processus de calcul est illustré dans l'équation (2) :
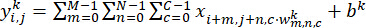 (2)
Où x est l'image d'entrée, wk et bk sont respectivement les poids et le biais du noyau de convolution, et  sont les valeurs de la carte de caractéristiques en sortie à la position (i,j). La couche de regroupement utilise généralement le regroupement maximal (Max Pooling) ou le regroupement moyen (Average Pooling). La couche entièrement connectée est chargée d'extraire les caractéristiques et de prédire les probabilités de classification.
Sur cette base, cet article conçoit un module d'amélioration des caractéristiques CNN pour YOLOv11, composé de deux branches parallèles : une branche de convolution multi-échelle qui utilise des noyaux de convolution 3 × 3 et 5 × 5 pour extraire des caractéristiques multi-échelles ; et une branche d'attention qui connecte successivement les modules d'attention de canal (Squeeze-and-Excitation) et d'attention spatiale afin de renforcer les caractéristiques discriminantes des cibles principales. Les sorties des deux branches sont fusionnées par addition élément par élément, et la fonction de perte correspondante pour l'amélioration des caractéristiques est indiquée dans la formule (3) :
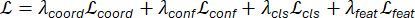 (3)
Lcoord est la perte de régression des coordonnées de la boîte englobante ; Lconf est la perte de confiance vis-à-vis de la cible ; Lcls est la perte de classification par catégorie ; Lfeat est la perte d'amélioration des caractéristiques, utilisée pour contraindre les caractéristiques discriminantes des petites cibles et des cibles partiellement masquées extraites par le module d'amélioration du CNN ; λcoord, λconf, λcls, λfeat sont les coefficients de pondération des termes de perte correspondants. Pour cette tâche, on fixe λfeat = 0,05, et les poids restants sont ajustés selon les exigences de la tâche de détection.
Les structures classiques de CNN, telles que VGGNet23 et ResNet24, ont connu un grand succès dans les tâches de classification d'images. Parmi ces architectures, ResNet atténue efficacement le problème de disparition du gradient lors de l'entraînement de réseaux profonds, facilitant ainsi la construction de structures de réseaux plus profondes et plus complexes.
Dans les tâches de détection d'objets, le CNN est généralement utilisé comme extracteur de caractéristiques (backbone). Par exemple, Darknet, le Darknet partiel en plusieurs étapes (CSPDarknet), etc., dans la série d'algorithmes YOLO, sont tous basés sur le CNN25. Pour améliorer les capacités d'extraction de caractéristiques, les chercheurs ont proposé de nombreuses structures de CNN améliorées. Par exemple, le module Inception extrait des caractéristiques en parallèle à l’aide de noyaux de convolution multi-échelles. DenseNet renforce la réutilisation des caractéristiques grâce à des connexions denses. Le réseau Squeeze-and-Excitation ajuste de manière adaptative l’importance des canaux de caractéristiques au moyen de mécanismes d’attention26.
Dans cette étude, nous avons conçu un module CNN amélioré afin de renforcer les capacités d'extraction de caractéristiques de YOLOv11. Ce module associe une fusion de caractéristiques multi-échelle à un mécanisme d'attention pour capturer plus efficacement les informations critiques en matière de sécurité dans les scénarios de ligne de production.
État d'application de l'apprentissage profond dans la surveillance de la sécurité industrielle
L'apprentissage profond a considérablement gagné en importance dans le domaine de la surveillance de la sécurité industrielle. Les algorithmes basés sur les réseaux neuronaux convolutifs (CNN) sont utilisés pour déterminer si les travailleurs portent correctement leurs casques de sécurité, détecter les intrusions non autorisées dans des zones dangereuses et surveiller l'état d'équipements défectueux27.
En ce qui concerne la reconnaissance du comportement, les réseaux neuronaux convolutifs 3D et les réseaux neuronaux récurrents sont utilisés pour analyser le comportement opérationnel des travailleurs et identifier des actions potentiellement dangereuses. Par exemple, en analysant les séquences de postures des travailleurs, il est possible de déterminer s'ils violent les procédures de sécurité28.
YOLO et Faster R-CNN sont largement utilisés pour la détection de personnel et d'équipements dans des vidéos de surveillance en temps réel. Par exemple, un système de détection de casques en temps réel basé sur YOLOv5 a été proposé dans la littérature, améliorant efficacement l'intelligence de la gestion de la sécurité sur les chantiers29.
Bien que des progrès aient été réalisés dans les recherches existantes, plusieurs défis demeurent. Premièrement, les scènes industrielles présentent généralement des éclairages complexes, des occultations et des interférences de fond, ce qui impose des exigences strictes quant à la robustesse de l'algorithme. Deuxièmement, la performance en temps réel est une exigence clé, et l'algorithme doit réaliser une inférence à haute vitesse tout en maintenant sa précision. Enfin, les recherches existantes se concentrent principalement sur la détection mono-tâche et manquent d'exploration de la fusion d'informations provenant de multiples sources ainsi que d'analyses globales30.
Dans cette étude, le modèle de fusion proposé YOLOv11 et CNN vise à relever les défis susmentionnés et à assurer une surveillance complète et en temps réel des risques liés à la sécurité sur la ligne de production, en améliorant les capacités d'extraction et de fusion des caractéristiques.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
YOLOv11 et algorithme CNN
Architecture générale du système
Le système de surveillance de la sécurité en ligne de production proposé dans cet article adopte une architecture hybride combinant YOLOv11 à un CNN amélioré afin d'assurer une surveillance en temps réel avec une grande précision et une vitesse élevée. Comme illustré dans la Figure 1, le système se compose principalement d'un module de prétraitement des entrées, d'un module de détection d'objets YOLOv11, d'un module d'amélioration des caractéristiques par CNN et d'un module de décision par fusion. L'image d'entrée est d'abord normalisée et augmentée par le module de prétraitement afin d'améliorer la capacité de généralisation du modèle. Ensuite, les caractéristiques sont extraites par le squelette CSPDarknet, et le champ réceptif est étendu par le module de regroupement par pyramide spatiale rapide (SPPF). Les caractéristiques multi-échelles sont fusionnées après remise à l'échelle, puis l'attention sur les canaux et l'attention spatiale sont appliquées successivement aux caractéristiques fusionnées afin d'améliorer davantage la représentation discriminante des cibles clés. Le module d'amélioration des caractéristiques par CNN est inséré après les sorties des couches C3, C4 et C5 du réseau squelette YOLOv11, recevant des cartes de caractéristiques multi-échelles de dimensions respectives 80 × 80 × 256, 40 × 40 × 512 et 20 × 20 × 1 024. Ce module d'amélioration renforce davantage l'extraction des caractéristiques pour les cibles petites et partiellement occultées. Enfin, le module de décision par fusion combine les résultats de détection de YOLOv11 avec les caractéristiques améliorées par CNN et les optimise conjointement au moyen d'une fonction de perte conçue, afin de produire la position exacte, la catégorie et le score de confiance de la cible.
Cadre de détection YOLOv11
YOLOv11 a introduit plusieurs améliorations essentielles qui exploitent les atouts du cadre de détection monoculaire de la série YOLO. Son architecture est divisée en trois composants principaux : un réseau squelette, un réseau de fusion de caractéristiques et une tête de détection. Le réseau squelette utilise une structure CSPDarknet améliorée. Le réseau de fusion de caractéristiques intègre des connexions locales inter-étapes et des convolutions séparables par profondeur, s'inspirant des réseaux pyramidaux de caractéristiques et des réseaux d'agrégation de chemins afin de fusionner efficacement des caractéristiques multi-échelles.
Module d'amélioration des caractéristiques
Le module d'amélioration des caractéristiques vise à accroître la sensibilité du modèle aux caractéristiques clés de sécurité. Il traite les cartes de caractéristiques produites par chaque couche du réseau principal YOLOv11, en fusionnant les informations à différentes échelles grâce à des opérations de suréchantillonnage et de sous-échantillonnage. Plus précisément, la branche multi-échelle capture la diversité des échelles spatiales, tandis que la branche d'attention renforce dynamiquement les canaux et les réponses de position clés. Ces deux branches n'agissent pas indépendamment, mais sont complémentaires et fusionnées par des connexions résiduelles et une recalibration des caractéristiques. La carte de caractéristiques traitée par le module d'amélioration à chaque échelle est ajustée pour correspondre au nombre de canaux de la carte de caractéristiques d'origine à l'aide d'une convolution 1 × 1, puis fusionnée avec la carte de caractéristiques YOLOv11 d'origine par addition élément par élément. La carte de caractéristiques fusionnée est ensuite transmise au réseau pyramidal de caractéristiques (FPN) suivant pour une fusion multi-échelle, formant ainsi une représentation hiérarchique des caractéristiques de sécurité. Afin d'assurer une intégration transparente entre les modules, une stratégie d'apprentissage conjointe de bout en bout est adoptée, la fonction de perte comprenant la perte de détection YOLOv11 et la perte d'amélioration des caractéristiques du module CNN.
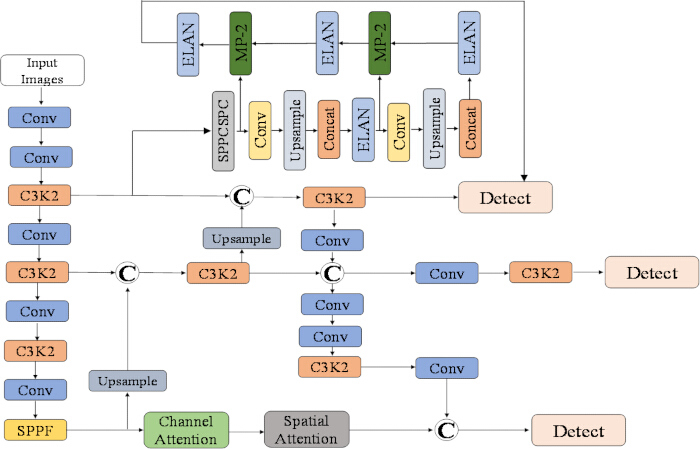
Figure 1. Algorithme YOLOv11-CNN. Le module d'amélioration des caractéristiques vise à amplifier la sensibilité du modèle aux caractéristiques critiques de sécurité. Il traite les cartes de caractéristiques provenant de différentes couches du réseau principal YOLOv11, en fusionnant des caractéristiques à différentes échelles par des opérations de suréchantillonnage et de sous-échantillonnage. De plus, il intègre des mécanismes d'attention spatiale et par canal. Afin d'assurer une intégration fluide entre les modules YOLOv11 et CNN, une stratégie d'apprentissage conjointe est utilisée. Pendant l'apprentissage, les paramètres des deux modules sont optimisés de bout en bout. La fonction de perte combine la perte de détection de YOLOv11 avec la perte d'amélioration des caractéristiques du module CNN. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Afin de vérifier l'efficacité du modèle de fusion proposé YOLOv11 et CNN pour la surveillance de la sécurité en ligne de production, un jeu de données couvrant divers scénarios de risques sécuritaires a été construit. Ce jeu de données contient 12 000 images de scènes de lignes de production, réparties en ensembles d'apprentissage, de validation et de test selon un ratio de 7:1,5:1,5, avec une graine aléatoire fixe de 42. Il couvre diverses conditions de travail, notamment un éclairage standard, un faible éclairage, une ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Les résultats expérimentaux montrent que le modèle de fusion YOLOv11–CNN proposé améliore la précision de détection et les performances en temps réel pour la surveillance de la sécurité en ligne de production. En exploitant la détection efficace en une seule étape de YOLOv11 et l'amélioration des caractéristiques par le module CNN, le système a identifié les travailleurs, les équipements et les zones dangereuses dans des conditions complexes d'éclairage et d'occultation. La fusion de caractéristiques multi-échelles et le...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n'ont aucune incompatibilité d'intérêts à déclarer.
Remerciements
Ce travail a été financé en partie par la Fondation de recherche scientifique de l'Université de Taizhou pour les talents avancés « Recherche sur les technologies clés de la détection de précision pour la fabrication intelligente » (TZXY2020QDJJ006).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| API COCO | N/A | Outil d'évaluation utilisé pour mesurer la précision de détection de la cible et effectuer des analyses statistiques. | |
| CUDA 11.4 | NVIDIA | N/A | Plateforme de calcul parallèle utilisée conjointement avec le cadre PyTorch 1.12. |
| Edge TPU | N/A | Plateforme de déploiement utilisée pour les tests de latence et de consommation d'énergie ; la latence signalée était de 18 ms et la consommation d'énergie de 15 W. | |
| Dispositif de calcul en périphérie Jetson Xavier | NVIDIA | Dispositif de calcul en périphérie utilisé pour les tests de débit ; la vitesse de traitement signalée était de 70 images par seconde avec une latence au 99e centile inférieure à 50 ms. | |
| GPU NVIDIA Tesla V100 | NVIDIA | GPU utilisé sur le serveur d'entraînement/évaluation. | |
| PyTorch 1.12 | N/A | Cadre d'apprentissage profond utilisé pour l'entraînement et l'évaluation du modèle. | |
| scikit-learn | N/A | Outil d'évaluation et d'analyse statistique utilisé pour l'évaluation du modèle. | |
| Jeu de données personnel sur la sécurité en ligne de production | N/A | N/A | Jeu de données composé de 12 000 images de scènes de lignes de production au format VOC, couvrant des conditions d'éclairage normales, faible éclairage, occlusion partielle, occlusion importante, flou de mouvement et arrière-plans complexes ; six catégories d'annotations : travailleurs, casques de sécurité, bras robotiques, zones dangereuses, outils et véhicules. |
| Serveur d'entraînement | Serveur équipé d'un GPU NVIDIA Tesla V100 et d'un système d'exploitation Ubuntu 20.04. | ||
| Système d'exploitation Ubuntu 20.04 | N/A | Système d'exploitation utilisé sur le serveur d'entraînement/évaluation. | |
| Format d'annotation VOC | N/A | N/A | Format d'annotation utilisé pour le jeu de données personnel sur la sécurité en ligne de production. |
| Modèle de détection d'objets YOLOv11 | Ultralytics | N/A | Modèle de détection d'objets utilisé pour détecter en temps réel les travailleurs, les équipements et les dangers potentiels. |
Références
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.