Cette étude présente un cadre automatisé de prototypage d'interfaces utilisateurs intégrant des principes de conception cognitive, une modélisation perceptive des couleurs et un apprentissage profond. Le système améliore l'accessibilité, la clarté de la disposition, l'harmonie des couleurs et la cohérence entre écrans, produisant ainsi des conceptions d'interfaces cohérentes et centrées sur l'utilisateur.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Cadre de prototypage automatisé d'interfaces utilisateur intégrant des principes de conception cognitive et visuelle pour améliorer l'utilisabilité et la clarté de la mise en page
Dans cet article
Résumé
Résumé
Une conception efficace de l'interface utilisateur (IU) exige un équilibre harmonieux entre attrait visuel, ergonomie cognitive et cohérence de la disposition. Toutefois, les approches actuelles de génération automatique d'IU se concentrent principalement sur l'apparence visuelle ou la détection de composants, et manquent d'un cadre unifié intégrant les principes cognitifs, l'intelligence chromatique et le raisonnement structurel. De plus, les méthodes existantes souffrent d'une généralisation limitée en matière de disposition, d'une faible interprétabilité, d'une sélection statique des couleurs et d'un comportement incohérent entre les écrans. Dans ce contexte, ce travail propose un cadre de prototypage automatisé d'IU qui intègre une détection de composants basée sur le réseau neuronal convolutif régional accéléré (Faster R-CNN) et une modélisation chromatique perceptive fondée sur l'espace colorimétrique uniforme CIECAM02 (CAM02-UCS), enrichi par des principes de conception cognitive et visuelle. Le Faster R-CNN permet d'identifier les composants d'IU et d'inférer des structures hiérarchiques à partir de jeux de données d'interfaces à grande échelle. Un module amélioré de génération de couleurs analyse des images de marque ou de référence afin d'assurer des thèmes chromatiques perceptuellement uniformes, harmonieux et conformes aux exigences d'ergonomie, en utilisant l'espace CAM02-UCS. Ces résultats sont ensuite optimisés à l'aide de règles de conception cognitive, incluant le regroupement gestaltiste, les lois de Fitts et de Hick, un espacement fondé sur l'attention et la modélisation de la hiérarchie visuelle, afin de générer automatiquement des dispositions d'IU raffinées et orientées vers la tâche. Des expériences menées sur les jeux de données RICO, ENRICO et Guo UI Color montrent que le système proposé atteint une précision de 92,4 % dans la détection des composants, améliore la clarté de la disposition et la précision de l'ordre de lecture de 18,7 %, et produit des palettes de couleurs jugées 24,5 % plus harmonieuses par les concepteurs, comparé aux méthodes de référence. Les évaluations par les utilisateurs indiquent également une réduction de 31 % de la charge cognitive perçue et une augmentation de 28 % de la cohérence du design entre les écrans. Ces résultats démontrent que la combinaison d'une compréhension structurelle fondée sur l'apprentissage profond, d'une modélisation chromatique ancrée dans la perception et de principes de conception cognitive permet de produire des prototypes d'IU hautement efficaces, esthétiquement cohérents et conviviaux. Ce cadre établit une approche nouvelle et bout-en-bout pour un prototypage automatisé d'IU intelligent et centré sur l'humain.
Introduction
Les interfaces graphiques utilisateur (IGU) servent de support fondamental de communication entre les êtres humains et les systèmes informatiques, influençant considérablement l'ergonomie, l'accessibilité et l'expérience utilisateur (UX) globale1,2. Les systèmes logiciels modernes s'appuient sur des interfaces intuitives et esthétiques pour attirer et fidéliser les utilisateurs. Traditionnellement, la conception d'interfaces consiste à créer des maquettes graphiques qui sont ensuite traduites en code front-end par des ingénieurs. Toutefois, les différences entre les protocoles spécifiques aux plateformes selon les systèmes d'exploitation exigent des adaptations répétées, augmentant ainsi la complexité et l'effort de développement. La génération automatisée de code d'interface est donc apparue comme une direction de recherche importante, réduisant l'effort manuel et améliorant l'efficacité du développement.
Les premières approches de génération automatisée d'interfaces utilisateur combinaient des techniques traditionnelles de traitement d'image avec des modèles d'apprentissage profond pour la détection et la classification de régions3,4. Actuellement, les stratégies dominantes pour la génération de code d'interface graphique appliquent des techniques de vision par ordinateur afin d'analyser les images d'interfaces utilisateur et de les convertir en représentations structurées de niveau frontal5,6,7. Alors que les méthodes de traitement d'image s'appuient sur des caractéristiques conçues manuellement, les approches d'apprentissage profond extraient des représentations hiérarchiques à partir de jeux de données à grande échelle. En conséquence, les chercheurs ont exploré des approches hybrides combinant l'apprentissage profond à des techniques spécifiques de traitement d'image afin d'améliorer la robustesse et la précision.
La couleur est un autre facteur essentiel dans la conception d'interfaces utilisateur, influençant la perception de l'utilisateur, l'ergonomie et l'attrait esthétique1. Il devient difficile de maintenir une cohérence entre le contenu des images et les schémas de couleurs de l'interface lorsque les entrées visuelles varient en teinte et en contexte8,9,10. Par conséquent, d'importantes recherches se sont concentrées sur la génération automatisée de palettes de couleurs et la modélisation perceptive des couleurs. Les méthodes existantes de génération de couleurs incluent des techniques fondées sur l'espace colorimétrique CIELAB11. D'autres approches utilisent des algorithmes de regroupement, comme les k-moyennes, pour extraire les couleurs dominantes d'images12. En conséquence, les travaux récents adoptent de plus en plus des approches fondées sur les données et l'apprentissage automatique pour la modélisation des couleurs.
Parallèlement, les approches d'apprentissage profond ont considérablement amélioré la détection des composants d'interface et la compréhension de la disposition. Les réseaux neuronaux ont permis un analyse structurelle plus précise des interfaces mobiles13. Toutefois, ces méthodes se concentrent principalement sur la précision de détection et négligent souvent des aspects de niveau supérieur tels que l'ergonomie cognitive, la hiérarchie de la disposition et l'efficacité des interactions. Des modèles génératifs pour la synthèse de dispositions d'interface ont également été proposés14,15, mais ils rencontrent des difficultés à maintenir une cohérence entre les écrans et à fournir des décisions de conception interprétables16. D'autres approches se concentrent sur la similarité visuelle ou la qualité de rendu, mais manquent d'un cadre unifié combinant la sémantique des composants, l'harmonie des couleurs et les contraintes d'utilisabilité17. La reconnaissance de texte est également importante pour comprendre le contenu de l'interface. Des techniques telles que les réseaux neuronaux récurrents convolutifs (CRNN) permettent une reconnaissance précise de motifs textuels complexes dans les écrans d'interface18,19,20.
Plusieurs systèmes ont été proposés pour générer du code d'interface utilisateur à partir de croquis ou d'images. Sketch2Code utilise la détection d'objets pour convertir des croquis en représentations de code21,22, mais il est sensible à la qualité de l'image. REDRAW fournit un pipeline automatisé pour la collecte de données et l'entraînement de modèles, combinant des réseaux neuronaux convolutifs et récurrents afin de générer des représentations structurées d'interfaces utilisateur23,24. Des travaux ultérieurs ont introduit des métriques d'évaluation améliorées pour évaluer la qualité des interfaces utilisateur générées25. Parmi les approches plus récentes figurent les modèles basés sur la diffusion et les modèles basés sur les transformeurs pour la génération de mise en page, tels que les transformeurs de mise en page par diffusion sans méthodes d'auto-encodeur, la génération de mise en page d'interface graphique utilisant des graphes d'agencement d'interface graphique basés sur les transformeurs, et la génération de mise en page d'interface utilisateur guidée par de grands modèles linguistiques26,27,28. Un aperçu comparatif de ces approches est fourni dans Tableau 1.
| Références et méthodes clés | Objectif | Avantages | Inconvénients |
| Génération automatisée de thèmes de couleurs d'interface utilisateur basée sur l'image : extraction des couleurs dominantes + modélisation perceptive des couleurs CAM02-UCS¹ | Générer automatiquement des thèmes de couleurs d'interface utilisateur à partir d'images de référence tout en optimisant l'harmonie et l'ergonomie. | Fondement perceptif solide (CAM02-UCS) ; équilibre explicite entre harmonie et ergonomie (contraste et diversité) ; inclut une implémentation web et une évaluation par des concepteurs. | Se concentre uniquement sur la couleur/le thème (pas sur la disposition ou la structure des composants) ; approche basée sur des règles/heuristiques plutôt que sur une synthèse d'interface utilisateur apprise de bout en bout. |
| Unification de la génération de mise en page avec un modèle de diffusion découplé (LDGM)²⁵ | Génération unifiée et flexible de mises en page pour des scènes graphiques et des interfaces utilisateur. | Diversité et contrôlabilité à l'état de l'art pour la génération de mises en page ; prend en charge la génération conditionnelle et plusieurs types d'attributs. | Les sorties basées sur la diffusion peuvent présenter des problèmes d'alignement ou de fines nuances de mise en page, sauf contraintes ; complexité du modèle et coût d'inférence plus élevés. |
| Transformeurs de mise en page par diffusion sans méthodes d'auto-encodeur : transformeur + diffusion pour la génération de mise en page (sans auto-encodeur)²⁶ | Améliorer la fidélité et l'alignement pour les benchmarks de génération de mise en page (métriques FID, d'alignement et de superposition). | Meilleure capture des corrélations sémantiques entre objets voisins ; performances élevées sur les métriques FID et d'alignement. | Se concentre principalement sur la géométrie de la mise en page (positions, tailles, catégories) plutôt que sur la sémantique de l'interface utilisateur. |
| Génération de mise en page d'interface graphique à partir de graphes d'agencement d'interface graphique (GUI-AGs) à l'aide de modèles basés sur des transformeurs²⁷ | Créer des mises en page d'interface graphique à partir de contraintes positionnelles ou graphiques afin d'aider les concepteurs. | Les représentations sous forme de graphes capturent les contraintes relationnelles ; le transformeur permet une génération flexible conditionnée par des contraintes. | Peut nécessiter des graphes de contraintes explicites fournis par les concepteurs ; accent limité sur les métriques de couleur et d'ergonomie. |
| Génération de mise en page d'interface utilisateur à l'aide de modèles linguistiques de grande taille (LLMs) guidés par une grammaire d'interface utilisateur : modèles linguistiques de grande taille (LLMs) + grammaire hiérarchique d'interface utilisateur²⁸ | Explorer l'utilisation des LLMs pour la génération de mises en page et améliorer l'explicabilité/le contrôle grâce à des représentations grammaticales. | Contrôlabilité et explicabilité de haut niveau ; possibilité d'exploiter l'apprentissage dans le contexte offert par les LLMs (type GPT). | Travail préliminaire avec une validation empirique limitée ; conception de la grammaire et robustesse à travers les interfaces utilisateur |
Tableau 1 : Comparaison des méthodes existantes de modélisation des couleurs d'interface utilisateur et de génération de mise en page. Le tableau résume les approches représentatives en matière de conception d'interface utilisateur, notamment la génération de thèmes de couleurs, la génération de mise en page par diffusion, les méthodes basées sur les transformeurs et la génération de mise en page guidée par de grands modèles linguistiques. Pour chaque méthode, la technique sous-jacente, l'objectif, les avantages et les limites sont présentés, mettant en évidence les différences en matière de modélisation perceptive, de capacité de génération de mise en page, de contrôlabilité et de considérations d'utilisabilité.
Malgré ces avancées, une limitation majeure persiste : aucun système existant ne parvient à intégrer conjointement la détection des composants, la modélisation perceptive des couleurs, les principes cognitifs de conception et la cohérence de mise en page sur plusieurs écrans au sein d’un cadre unique et bout en bout1. Les approches actuelles optimisent généralement un ou deux aspects seulement — tels que la détection, la disposition ou les couleurs — sans tenir compte de leurs interdépendances. Cette fragmentation met en évidence un manque critique dans la recherche sur le développement de systèmes automatisés de prototypage d’interfaces utilisateur unifiés et centrés sur l’humain. En particulier, les principes de conception cognitive tels que les lois de la Gestalt, la loi de Fitts et la loi de Hick sont souvent abordés de manière conceptuelle, sans être formellement intégrés dans des modèles computationnels.
Pour pallier ces limitations, cette étude propose un cadre de prototypage d'interfaces utilisateur (UI) automatisé de bout en bout qui intègre la détection de composants, la modélisation perceptive des couleurs et les principes de conception cognitive au sein d'un système unifié. Ce cadre vise à améliorer la qualité de la disposition, à réduire la charge cognitive, à renforcer l'harmonie des couleurs et à accroître l'utilisabilité globale. Ces améliorations sont validées par des expériences menées sur les ensembles de données RICO, ENRICO et Guo’s UI Color Datasets, démontrant l'efficacité de la combinaison des aspects structurels, perceptifs et cognitifs au sein d'un unique pipeline automatisé de prototypage d'interfaces utilisateur. On émet l'hypothèse que l'intégration de la détection de composants basée sur l'apprentissage profond, de la modélisation perceptive des couleurs et des principes de conception cognitive au sein d'un cadre unifié améliorera significativement la qualité des prototypes d'interface par rapport aux approches existantes. Plus précisément, H1 suppose que le cadre améliore la qualité de la disposition, notamment l'alignement, le regroupement et l'ordre de lecture. H2 postule que le cadre réduit la charge cognitive de l'utilisateur. H3 suggère que la modélisation perceptive des couleurs améliore la coordination des couleurs et l'harmonie visuelle. H4 affirme que l'utilisabilité globale et la qualité esthétique des prototypes d'interface sont améliorées.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude utilise des ensembles de données accessibles au public et ne concerne ni sujets humains ni animaux.
Le cadre automatisé de prototypage d'interface utilisateur proposé intègre une compréhension structurelle fondée sur l'apprentissage profond, une modélisation des couleurs perceptuellement uniforme et des principes de conception cognitive afin de générer des prototypes d'interface cohérents et centrés sur l'utilisateur. La méthodologie débute par une architecture Faster R-CNN entraînée sur les ensembles de données RICO et ENRICO pour détecter les composants d'interface et en extraire les relations hiérarchiques, permettant ainsi une interprétation précise de diverses dispositions d'écran. Les composants détectés sont ensuite traités par un module d'intelligence chromatique, qui extrait des indices de couleur basés sur la marque ou sur une image, modélise la similarité perceptive à l'aide de CAM02-UCS et génère des palettes de couleurs harmonieuses, sensibles au contraste et conformes aux normes d'accessibilité. Ensuite, des principes de conception cognitive — notamment les lois de regroupement de la Gestalt, la loi de Fitts, la loi de Hick, l'espacement fondé sur l'attention et les contraintes de hiérarchie visuelle — sont appliqués au moyen d'un moteur d'optimisation cognitive afin d'affiner l'organisation spatiale et l'alignement des composants. Enfin, une couche de raisonnement de mise en page intègre les contraintes structurelles, perceptuelles et cognitives pour générer des prototypes d'interface à plusieurs écrans cohérents, équilibrant convivialité, esthétique et clarté fonctionnelle. Ce pipeline intégré assure la cohérence perceptive, réduit la charge cognitive et respecte les principes de conception centrée sur l'humain. Le flux de travail complet de la méthode proposée est illustré dans Figure 1.
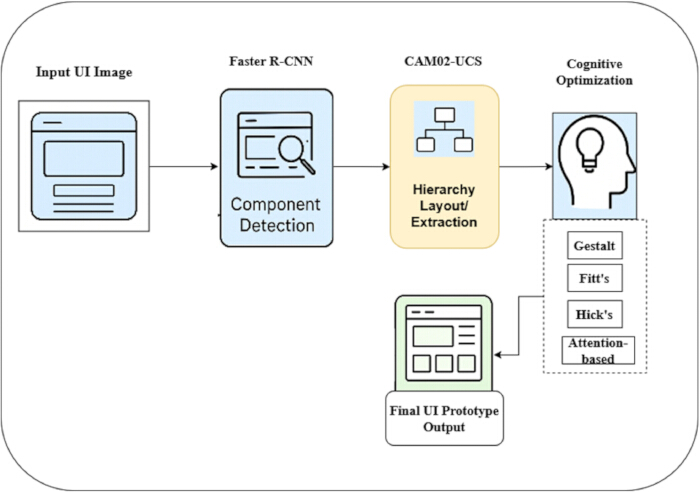
Figure 1. Architecture générale du cadre de prototypage automatisé d'interface utilisateur proposé. Le diagramme illustre l'ensemble du pipeline, à partir d'une image d'interface utilisateur en entrée. La détection de composants est réalisée à l'aide de Faster R-CNN afin d'identifier les éléments d'interface. Les composants détectés sont ensuite traités à l'aide d'une modélisation perceptive fondée sur CAM02-UCS pour l'extraction de la hiérarchie et de la disposition. Une optimisation cognitive est ensuite appliquée en utilisant les principes de la Gestalt, la loi de Fitts, la loi de Hick et des ajustements fondés sur l'attention. Les flèches indiquent le flux des données entre les modules, conduisant à la sortie du prototype final d'interface utilisateur. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Aperçu du cadre
Figure 1 illustre le flux de travail de bout en bout du cadre de prototypage d'interface utilisateur (IU) automatisé proposé, qui transforme une capture d'écran brute d'une IU en un prototype raffiné sur le plan cognitif. Le processus débute avec l'image d'entrée de l'IU, qui est transmise au module de détection de composants basé sur Faster R-CNN. Ce module identifie les éléments d'interface tels que les boutons, les icônes, les champs de texte et les conteneurs, puis fournit leurs cadres englobants et leurs étiquettes de classe correspondants. Les composants détectés sont ensuite traités lors de l'étape d'extraction de la hiérarchie et de la disposition. En se basant sur les relations spatiales et les motifs structurels, le système construit un arbre hiérarchique de la disposition qui reflète la manière dont les utilisateurs perçoivent naturellement l'organisation de l'écran. Cette représentation capture le regroupement visuel et les dépendances structurelles entre les éléments de l'IU. La disposition extraite est ensuite affinée par une optimisation cognitive grâce à l'application de principes de conception centrés sur l'humain. Ces principes incluent le regroupement de la Gestalt pour le regroupement visuel, la loi de Fitts pour optimiser la taille des cibles tactiles et leur accessibilité, la loi de Hick pour réduire la complexité de décision, et un espacement fondé sur l'attention afin d'améliorer la hiérarchie visuelle. En conséquence, la disposition devient plus intuitive, plus lisible et plus efficace pour l'interaction utilisateur. Enfin, la disposition optimisée est combinée à une modélisation perceptive des couleurs pour générer un prototype d'IU cohérent. L'interface obtenue est structurellement précise, visuellement harmonieuse et conforme aux attentes humaines en matière d'utilisabilité.
Le cadre a été implémenté à l'aide de PyTorch 2.0 sur Ubuntu 22.04. Les expériences ont été menées sur un système équipé d'un GPU NVIDIA RTX 4090 (24 Go de mémoire vidéo). Le modèle Faster R-CNN utilisait un réseau ResNet-50 comme base, pré-entraîné sur le jeu de données ImageNet. L'entraînement a été effectué à l'aide de l'optimiseur de descente de gradient stochastique (SGD) avec un taux d'apprentissage de 0,001, une taille de lot de 16 et jusqu'à 60 époques. Un arrêt précoce a été appliqué pour éviter le surapprentissage, en utilisant un ensemble de validation composé de 20 % des données. Bien que l'entraînement ait été effectué sur un maximum de 60 époques, la convergence était généralement atteinte plus tôt grâce à l'arrêt précoce basé sur la perte de validation. Le moment et la décroissance du poids ont été fixés respectivement à 0,9 et 0,0005. L'augmentation des données comprenait la normalisation, le retournement horizontal aléatoire, ainsi que le rognage aléatoire et le redimensionnement.
Préparation du jeu de données
Pour soutenir le cadre proposé de prototypage automatisé d'interfaces utilisateur (UI), trois jeux de données complémentaires ont été utilisés : ENRICO29, RICO30 et le jeu de données sur les couleurs d'interfaces utilisateur de Guo1. Le jeu de données RICO contient 66 261 écrans d'interfaces utilisateur Android collectés à partir de 9 700 applications, offrant une grande diversité à grande échelle pour la détection de composants et l'extraction de structures hiérarchiques. ENRICO comprend 1 464 captures d'écran d'interfaces utilisateur de haute qualité, classées manuellement en 20 motifs de conception, permettant une meilleure généralisation pour le raisonnement structurel et la modélisation de la cohérence de la disposition. Le jeu de données sur les couleurs d'interfaces utilisateur de Guo se compose de 128 images d'interfaces utilisateur sélectionnées, annotées avec des thèmes de couleurs, qui sont utilisées pour la modélisation perceptive des couleurs et l'évaluation des palettes. Toutefois, en raison de sa taille relativement plus petite, ce jeu de données peut introduire une certaine variabilité dans les caractéristiques de disposition. Pour cette étude, un jeu de données combiné de 5 128 écrans a été préparé pour l'entraînement et l'évaluation. Plus précisément, environ 4 000 images provenant de RICO ont été utilisées pour entraîner le modèle Faster R-CNN à la détection de composants, 1 000 images provenant d'ENRICO ont été utilisées pour l'apprentissage des motifs de disposition et la modélisation de la cohérence structurelle, et 128 images provenant du jeu de données de Guo ont été utilisées pour les tâches d'évaluation des couleurs. Toutes les images ont été normalisées à une résolution de 480 × 800 pixels, converties en un espace colorimétrique sRGB uniforme, et réannotées avec des cadres englobants normalisés et des métadonnées hiérarchiques afin d'assurer la compatibilité entre les jeux de données. Un aperçu des jeux de données utilisés dans cette étude est fourni dans le tableau 2. Le jeu de données RICO permet la détection à grande échelle des composants d'interface utilisateur et l'analyse structurelle, tandis qu'ENRICO améliore la capacité du modèle à reconnaître les motifs de disposition et à assurer une cohérence entre les écrans. Le jeu de données sur les couleurs d'interfaces utilisateur de Guo, bien que plus petit, joue un rôle essentiel dans l'évaluation de l'harmonie perceptive des couleurs et la modélisation du contraste. Ensemble, ces jeux de données fournissent une base complète et bien équilibrée pour l'entraînement, la validation et l'évaluation du cadre proposé de prototypage automatisé d'interfaces utilisateur.
| Ensemble de données | Nombre total d'images disponibles | Images utilisées dans l'étude | Objectif dans le cadre proposé |
| RICO Dataset30 | 66 261 | 4 000 | Détection des composants d'interface utilisateur, extraction de la disposition structurelle |
| ENRICO Dataset29 | 1 464 | 1 000 | Apprentissage des motifs de conception, modélisation de la cohérence de la disposition |
| Guo’s UI Color Dataset1 | 128 | 128 | Extraction des thèmes de couleurs, évaluation perceptive des couleurs |
| Total combiné | 67 853 | 5 128 | Ensemble de données complet pour la détection, la disposition et la modélisation des couleurs |
Tableau 2 : Résumé des ensembles de données utilisés dans le cadre proposé. Le tableau présente les ensembles de données utilisés pour l'entraînement et l'évaluation, notamment les ensembles de données RICO, ENRICO et Guo’s UI Color Datasets. Il indique le nombre total d'images disponibles, le sous-ensemble utilisé dans cette étude, ainsi que le rôle spécifique de chaque ensemble de données dans la détection de composants, la modélisation de la disposition et l'analyse perceptive des couleurs dans le cadre proposé.
Une stratégie d'échantillonnage stratifié a été utilisée afin de préserver la diversité des composants d'interface utilisateur, des structures de mise en page et des distributions de couleurs à travers les jeux de données RICO, ENRICO et Guo. Le jeu de données a été divisé en sous-ensembles d'apprentissage (70 %), de validation (15 %) et de test (15 %) à l'aide d'un échantillonnage stratifié. Les images ont été normalisées à l'aide des moyennes (0,485, 0,456 et 0,406) et des écarts types (0,229, 0,224 et 0,225). L'augmentation des données comprenait un retournement horizontal aléatoire (probabilité = 0,5) et un rognage aléatoire (plage d'échelle : 0,8–1,0), suivis d'un redimensionnement à 224 × 224 pixels appliqué durant l'entraînement.
Annotation des composants et prétraitement
Les ensembles de données RICO, ENRICO et Guo’s UI Color Dataset soutiennent collectivement les trois composantes fonctionnelles principales du cadre de prototypage automatisé proposé : la détection des composants, la modélisation de la disposition et l'optimisation perceptive des couleurs. L'ensemble de données RICO contient une collection à grande échelle de plus de 66 000 écrans d'interfaces utilisateur mobiles et est principalement utilisé pour entraîner le module de détection des composants. Sa diversité permet au modèle Faster R-CNN d'apprendre des représentations robustes des éléments d'interface courants tels que les boutons, les images et les champs de texte à travers une large gamme d'applications. Cela garantit une détection et une localisation précises des composants d'interface sous diverses conditions de conception. L'ensemble de données ENRICO fournit des écrans d'interface de haute qualité, étiquetés par motifs, afin d'apprendre les relations structurelles et les schémas de disposition. Il permet au système de comprendre les relations entre composants, l'organisation hiérarchique et les modèles de conception courants. Cet ensemble de données joue un rôle essentiel dans la modélisation des structures de disposition et le respect de la cohérence entre plusieurs écrans, permettant ainsi au cadre de générer des dispositions conformes aux conventions de conception établies. En revanche, l'ensemble de données Guo’s UI Color Dataset est spécifiquement utilisé pour la modélisation perceptive et cognitive des couleurs. Contrairement à RICO et ENRICO, qui se concentrent sur les aspects structurels, cet ensemble contient des images d'interfaces soigneusement sélectionnées accompagnées de thèmes de couleurs annotés. Ces annotations servent à entraîner les modules d'extraction des couleurs et d'évaluation de l'harmonie chromatique. En mappant les relations entre couleurs dans des espaces colorimétriques perceptuels tels que CAM02-UCS, le cadre apprend à générer des palettes de couleurs équilibrées en termes de contraste, d'accessibilité et de cohérence esthétique. Ensemble, ces ensembles de données forment un pipeline intégré : RICO soutient la détection des composants, ENRICO permet la compréhension des motifs de disposition et la cohérence structurelle, et l'ensemble de données de Guo facilite l'optimisation perceptive des couleurs. Cette intégration garantit que les prototypes d'interface générés sont structurellement précis, visuellement harmonieux et optimisés sur le plan cognitif.
La normalisation a été effectuée à l'aide d'une moyenne de [0,485, 0,456, 0,406] et d'un écart type de [0,229, 0,224, 0,225]. Des techniques d'augmentation des données, incluant le rognage aléatoire, le retournement horizontal et la rotation, ont été appliquées afin d'améliorer la généralisation du modèle. De plus, les valeurs des pixels ont été ramenées à l'intervalle [0, 1], et toutes les images ont été redimensionnées à une résolution de 480 × 800 pixels afin d'assurer l'uniformité entre les ensembles de données. Les images redimensionnées à 224 × 224 pixels sont utilisées pour l'augmentation durant l'apprentissage, tandis que la résolution d'origine de 480 × 800 pixels est conservée pour l'analyse de la disposition. Des boîtes englobantes ont été ajustées afin de filtrer les annotations non pertinentes à l'aide de seuils prédéfinis. Pour assurer l'uniformité entre les ensembles de données, tous les éléments d'interface utilisateur ont été annotés manuellement à l'aide de l'outil d'annotation LabelImg. Un schéma prédéfini a été établi avant l'annotation afin de classer les éléments d'interface utilisateur en catégories telles que bouton, texte, image, icône et conteneur. Pour la représentation des boîtes englobantes, un système de coordonnées uniforme a été appliqué, et une information hiérarchique a été construite en fonction des relations spatiales entre les éléments et de leurs associations parent-enfant au sein de l'arbre de disposition. En outre, des directives ont été établies afin de garantir une annotation cohérente des éléments, une gestion appropriée des composants superposés et l'application de seuils de taille minimale sur les ensembles de données RICO, ENRICO et Guo.
Des formulations mathématiques détaillées pour l'entraînement de détection des composants et l'extraction des motifs de disposition sont fournies dans le Supplementary File 1.
Le modèle Faster R-CNN a été entraîné à l'aide de SGD avec une inertie de 0,9 et une décroissance du poids de 0,0005. Le taux d'apprentissage initial a été fixé à 0,001 et ajusté à l'aide d'une politique de décroissance par étapes fondée sur les performances de validation. L'entraînement a été effectué sur un maximum de 60 époques avec une taille de lot de 16. Un arrêt précoce a été appliqué afin d'éviter le surapprentissage, en utilisant un ensemble de validation composé de 20 % des données d'entraînement.
La fonction de mappage f(.) prend en entrée les éléments d'interface utilisateur détectés et produit en sortie une représentation hiérarchique de la disposition. Elle calcule les relations d'adjacence entre les éléments d'interface utilisateur en fonction de critères de distance spatiale et d'alignement, puis construit une matrice d'adjacence pour représenter ces relations. Un algorithme de regroupement, tel que DBSCAN, est ensuite appliqué pour regrouper les composants associés. Enfin, les éléments regroupés sont organisés en structures hiérarchiques selon des relations parent–enfant, formant ainsi une représentation structurée de la disposition.
Des formulations détaillées pour la modélisation de l'harmonie des couleurs et de l'objectif d'optimisation unifié sont fournies dans le Supplementary File 1.
Cette fonction objective formalise mathématiquement l'intégration de la détection structurelle, du raisonnement sur la disposition et de la modélisation perceptive des couleurs, en garantissant que tous les composants du cadre contribuent conjointement à la génération de prototypes d'interface utilisateur cohérents et centrés sur l'utilisateur. L'optimisation est réalisée de manière modulaire pour chaque composant du cadre. La descente de gradient stochastique (SGD) est utilisée pour entraîner le module de détection des composants, tandis que l'optimiseur Adam est utilisé lors de l'optimisation conjointe de l'objectif unifié. L'objectif combiné sert à guider la performance globale du système. Lors des étapes d'optimisation conjointe, la fonction objective est minimisée à l'aide de l'optimiseur Adam avec un taux d'apprentissage de 0,001 et une taille de lot de 16. L'entraînement est effectué pendant un maximum de 60 époques, avec arrêt précoce appliqué lorsque la variation de la perte sur l'ensemble de validation est inférieure à 10−4 pendant cinq époques consécutives.
Détection de composants à l'aide de Faster R-CNN
Le cadre proposé utilise Faster R-CNN pour la détection automatique des composants d'interface utilisateur (IU), notamment les boutons, icônes, champs de texte, images et conteneurs. Faster R-CNN convient bien à cette tâche car il associe une grande précision de détection d'objets à une génération efficace de propositions de régions, ce qui est essentiel pour gérer des agencements d'IU complexes contenant des éléments densément groupés. Le modèle utilise un réseau ResNet-50 comme base, pré-entraîné sur le jeu de données ImageNet, afin d'extraire des cartes de caractéristiques convolutionnelles à partir de chaque écran d'IU. Pendant l'entraînement, les couches initiales ont été figées afin de préserver les caractéristiques visuelles générales, tandis que les couches supérieures (conv4_x et conv5_x) ont été affinées spécifiquement pour la détection de composants d'IU. Ces cartes de caractéristiques capturent les structures visuelles, les contours, les textures et les limites des composants. Lors de la détection, le réseau de proposition de régions (RPN) identifie des régions candidates (ancres) susceptibles de contenir des composants d'IU. Les ancres sont définies à l'aide de plusieurs échelles (128, 256 et 512) et de rapports d'aspect (1:1, 1:2 et 2:1) afin de s'adapter aux éléments d'IU de tailles variées. Pendant l'entraînement, les ancres ayant un taux d'intersection sur union (IoU) supérieur à 0,7 par rapport aux boîtes de référence sont étiquetées comme positives, tandis que celles dont l'IoU est inférieur à 0,3 sont étiquetées comme négatives ; les ancres dont les valeurs d'IoU sont intermédiaires sont ignorées. Chaque ancre se voit attribuer une probabilité indiquant la présence d'un composant. Une suppression non maximale (NMS) est ensuite appliquée pour éliminer les propositions redondantes et superposées, assurant ainsi une localisation efficace des éléments d'IU significatifs, même dans des interfaces encombrées. Une fois les régions candidates générées, chaque proposition est classée dans des catégories prédéfinies de composants, et les coordonnées de son cadre englobant sont affinées. Une opération d'alignement des régions d'intérêt (ROI) extrait des représentations de caractéristiques de taille fixe pour chaque proposition, qui sont ensuite traitées par des couches entièrement connectées pour la classification et la régression. La branche de classification fournit les probabilités de classe, tandis que la branche de régression prédit les coordonnées précises du cadre englobant. L'ensemble du modèle Faster R-CNN est entraîné de bout en bout en optimisant une fonction de perte combinée, qui intègre la perte du RPN et la perte finale de détection. Cela permet au système non seulement de reconnaître avec précision les composants d'IU, mais aussi de les localiser exactement au sein de structures d'interface variées. Une description détaillée de la détection de composants par Faster R-CNN, incluant l'étape du RPN, la classification des ROI, l'affinement des cadres englobants et l'objectif d'optimisation final, est fournie dans le Supplementary File 1.
Algorithme S1 fournit le flux de travail détaillé de détection des composants et d'extraction structurelle (Fichier supplémentaire 1). Il décrit le processus complet de détection automatique des composants d'interface utilisateur et d'extraction structurelle à partir d'une image d'écran brute. L'image d'entrée est d'abord prétraitée, puis transmise à un réseau neuronal convolutif (CNN) principal afin d'extraire des caractéristiques visuelles profondes. Ces caractéristiques sont utilisées par la proposition de régions (RPN) pour générer des boîtes englobantes candidates, qui sont ensuite affinées par classification et régression. La suppression non maximale (NMS) élimine les détections redondantes afin d'assurer une localisation précise. Après la détection, les composants sont regroupés selon leur proximité spatiale à l'aide du regroupement spatial basé sur la densité d'applications avec bruit (DBSCAN). Cette étape de regroupement permet de construire un arbre hiérarchique d'interface utilisateur qui représente les relations hiérarchiques entre composants et leurs regroupements logiques. Cette représentation hiérarchique constitue la base pour l'analyse ultérieure de la disposition et la compréhension de l'interface utilisateur. Figure 2 illustre le processus de détection de composants par Faster R-CNN sur un écran d'interface utilisateur mobile. L'interface d'entrée (à gauche) contient des éléments d'interface tels que des boutons et des blocs de texte, qui sont automatiquement encadrés par des boîtes englobantes. Ces régions détectées sont ensuite classées dans des catégories de composants (par exemple, Bouton et Texte), comme indiqué par les liaisons étiquetées. Le module de détection Faster R-CNN (à droite) affine les coordonnées des boîtes englobantes, attribue des étiquettes sémantiques et produit des informations structurées au niveau des composants. Cette étape constitue une base essentielle pour les processus ultérieurs, notamment l'extraction de la disposition, l'optimisation cognitive et la génération de maquettes d'interface utilisateur, en fournissant des représentations précises et sémantiquement significatives des composants d'interface utilisateur.
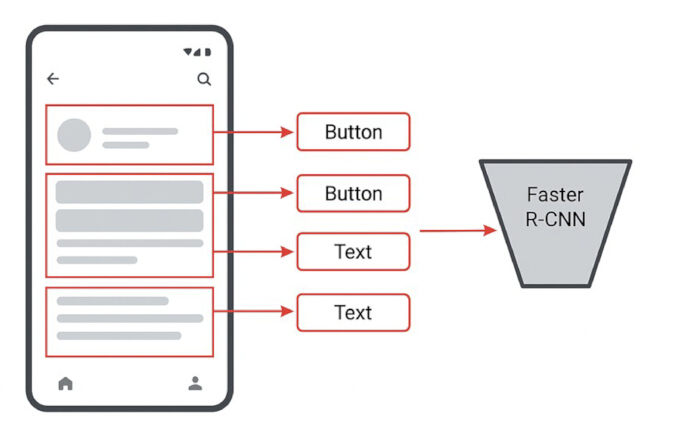
Figure 2. Détection de composants d'éléments d'interface utilisateur à l'aide de Faster R-CNN. La figure illustre la détection de composants d'interface à partir d'une capture d'écran d'interface d'entrée. Les régions d'intérêt sont identifiées à l'aide de boîtes englobantes, et des éléments tels que les boutons et les champs de texte sont classifiés à l'aide de Faster R-CNN. Des flèches indiquent l'association des composants détectés à leurs étiquettes sémantiques correspondantes. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Extraction du motif de la disposition et modélisation hiérarchique
Après la détection des composants à l'aide de Faster R-CNN, chaque élément d'interface utilisateur (UI) est représenté par un rectangle englobant. Toutefois, ces rectangles seuls ne permettent pas de comprendre comment les éléments sont organisés structurellement au sein de l'interface, par exemple quels éléments appartiennent aux en-têtes, aux barres de navigation ou à des régions de contenu groupées. Pour pallier cette limitation, les composants détectés sont transformés en un arbre logique d'interface utilisateur, dans lequel chaque composant est considéré comme un nœud, et les composants fonctionnellement ou visuellement liés sont regroupés sous des nœuds parents communs. Afin d'identifier des groupes de disposition significatifs, des techniques de regroupement telles que DBSCAN ou le regroupement hiérarchique ascendant sont appliquées. Ces méthodes analysent la proximité spatiale et les motifs d'alignement entre les composants afin de détecter les relations entre les éléments d'interface. De façon analogue aux pratiques humaines de conception, le système apprend à reconnaître des motifs structurels courants tels que les en-têtes, les pieds de page, les grilles et les blocs de contenu. Une fois le regroupement établi, des propriétés structurelles supplémentaires — notamment l'alignement, l'organisation en grille et l'ordre de lecture — sont analysées pour construire une représentation complète de la disposition. Par exemple, des composants alignés en colonnes de largeur égale peuvent indiquer une disposition basée sur des cartes, tandis que des éléments empilés verticalement peuvent indiquer une interface basée sur un formulaire ou un fil d'actualité. En intégrant le regroupement, le raisonnement spatial et les règles d'alignement, le cadre construit un arbre hiérarchique d'interface utilisateur qui capture à la fois le regroupement visuel et les relations fonctionnelles. Cette représentation hiérarchique sert de fondement aux étapes ultérieures d'affinement de la disposition et de modélisation de la cohérence entre plusieurs écrans, permettant au système de générer des conceptions d'interface structurées, cohérentes et centrées sur l'utilisateur.
Des formulations détaillées pour la distance spatiale et la similarité d'alignement sont fournies dans le Fichier Supplémentaire 1.
Regroupement par regroupement de mise en page (DBSCAN)
Pour identifier les groupes de disposition, l'algorithme DBSCAN est appliqué. DBSCAN utilise deux paramètres : (1) ε = distance maximale entre les composants voisins et (2) = nombre minimal de composants requis pour former un groupe. Pour cette analyse, les paramètres de DBSCAN ont été choisis empiriquement en fonction de la résolution normalisée de l'interface utilisateur (480 × 800 pixels). Le paramètre de distance de voisinage a été fixé à ε = 50 pixels afin de capturer la proximité spatiale entre les composants adjacents de l'interface utilisateur. Le nombre minimal de points requis pour former un groupe a été fixé à MinPts = 3 afin d'éviter la formation de groupes insignifiants ou spurieux de composants d'interface utilisateur.
La formulation détaillée de la construction de l'arborescence logique de l'interface utilisateur est fournie dans Fichier supplémentaire 1.
Modélisation perceptive des couleurs avec CAM02-UCS
La modélisation perceptive des couleurs garantit que les couleurs utilisées dans l'interface utilisateur générée sont harmonieuses, lisibles et cognitivement efficaces. Les couleurs dominantes sont extraites de sources d'entrée telles que des images d'interface à l'aide de techniques de regroupement. Plus précisément, un regroupement par K-moyennes avec initialisation K-moyennes++ est appliqué sur 300 itérations afin d'obtenir des palettes de couleurs représentatives. Toutefois, l'espace colorimétrique RVB (RGB) ne reflète pas fidèlement la perception visuelle humaine, ce qui signifie que des couleurs numériquement proches peuvent sembler perceptuellement différentes. Pour pallier cette limitation, toutes les couleurs extraites sont transformées en CAM02-UCS, un espace perceptuellement uniforme. Dans cet espace, des distances égales correspondent à des différences de couleur perçues équivalentes, ce qui le rend adapté à la modélisation de l'harmonie et du contraste des couleurs. Une fois projetées dans CAM02-UCS, les différences perceptives entre couleurs sont calculées à l'aide de la distance euclidienne, permettant au système de quantifier le contraste, l'harmonie et les variations entre les couleurs. Les couleurs trop proches sont espacées pour améliorer la lisibilité, tandis que les couleurs excessivement contrastées sont atténuées afin d'éviter l'inconfort visuel. La palette générée respecte également des normes d'accessibilité telles que WCAG AA et AAA, assurant un contraste suffisant entre les éléments au premier plan et en arrière-plan. En outre, l'harmonie des couleurs est garantie en limitant les relations au sein de la palette à des schémas complémentaires, analogues ou triadiques, selon le thème d'interface souhaité. Cela assure que la palette de couleurs résultante soit non seulement esthétiquement plaisante, mais aussi fonctionnellement accessible et optimisée sur le plan cognitif. Pour affiner davantage la palette, un processus d'optimisation est appliqué sous contraintes de similarité perceptive, de contraste, d'harmonie et de cohérence avec l'identité visuelle. Une couleur principale est sélectionnée (par exemple, à partir de l'identité de marque), et les couleurs secondaires sont ajustées en luminance et en chroma afin de préserver la hiérarchie visuelle. Un mécanisme d'évaluation basé sur des règles évalue les palettes candidates selon les distances perceptives et les métriques d'accessibilité, minimisant ainsi la charge cognitive tout en maintenant un équilibre esthétique. En conséquence, le cadre produit des schémas de couleurs pour interfaces qui présentent une cohérence, une lisibilité et une uniformité perceptive de niveau professionnel.
Des expressions mathématiques détaillées pour la modélisation perceptive des couleurs basée sur CAM02-UCS sont fournies dans le Fichier Supplémentaire 1.
Algorithme S2 (Fichier Supplémentaire 1) décrit le flux de travail d'extraction et d'optimisation des couleurs perçues basé sur CAM02-UCS, soumis à des contraintes d'harmonie et d'accessibilité. Dans un premier temps, les couleurs dominantes sont extraites de l'image d'entrée puis transformées dans l'espace CAM02-UCS afin que les différences de couleur correspondent à la perception humaine. Les distances perçues entre les couleurs sont ensuite calculées et limitées à des seuils prédéfinis pour assurer à la fois la clarté et l'harmonie. Par la suite, l'accessibilité est garantie par l'évaluation des rapports de contraste en luminance conformément aux directives WCAG. La palette finale est obtenue en optimisant une fonction objective combinée qui équilibre l'espacement perçu, les exigences de contraste et les contraintes d'harmonie des couleurs. Cela garantit que les jeux de couleurs d'interface générés sont non seulement esthétiquement plaisants, mais aussi lisibles, accessibles et perceptuellement cohérents.
Optimisation de la conception cognitive
L'optimisation de conception cognitive garantit que les prototypes d'interface utilisateur générés automatiquement sont non seulement visuellement cohérents, mais aussi faciles à comprendre et à utiliser. Ce module intègre des principes fondamentaux de conception cognitive, notamment les principes de la Gestalt, la loi de Fitts et la loi de Hick, afin de guider l'agencement, le regroupement et l'espacement des composants de l'interface utilisateur. Des formulations mathématiques détaillées relatives à l'optimisation de conception cognitive sont fournies dans le fichier supplémentaire 1.
Objectif intégré d'optimisation cognitive
L'expression mathématique de l'objectif intégré d'optimisation cognitive est fournie dans Fichier supplémentaire 1. Les coefficients représentant l'importance du regroupement visuel, de l'efficacité de l'interaction et de la complexité de la décision sont notés respectivement par alpha, bêta et gamma. Dans cette étude, les valeurs de alpha, bêta et gamma ont été déterminées empiriquement à l'aide du jeu de données de validation. Pour la présente expérience, les coefficients ont été fixés comme suit : α = 0,5, β = 0,3 et γ = 0,2. Cette configuration assure un équilibre efficace entre regroupement visuel, efficacité de l'interaction et simplicité de la décision.
Cohérence entre plusieurs écrans et génération de l'interface utilisateur
La modélisation de la cohérence multisupport garantit que les différents écrans d'une application partagent une identité visuelle, une structure de mise en page et un schéma d'interaction cohérents. Lorsque les utilisateurs naviguent entre les écrans, ils développent des attentes concernant le positionnement des éléments, la typographie, les espacements et la hiérarchie visuelle. Pour répondre à ces attentes, le système analyse les schémas entre écrans à l'aide de modèles dérivés des jeux de données RICO et ENRICO. Ces modèles capturent les structures d'interface utilisateur courantes telles que les mises en page accueil–détail, les schémas liste–détail, les formulaires en plusieurs étapes et les flux de tableau de bord. En comparant le positionnement des composants et leur comportement de regroupement, le système construit un profil structurel interscreen qui identifie les éléments devant rester constants et ceux pouvant varier. Une fois les schémas structurels identifiés, le cadre impose une cohérence dans les échelles de typographie, les rapports d'espacement, les grilles de mise en page et les ancres de navigation. Par exemple, les barres d'en-tête conservent une hauteur constante, les boutons principaux gardent une taille et un alignement uniformes, et les blocs de contenu suivent un ordre visuel prévisible. Ceci est obtenu grâce à un processus de régularisation de la mise en page qui évalue chaque écran par rapport à des contraintes structurelles globales. Si un écran s'écarte des modèles appris—comme des remplissages incohérents ou des titres mal alignés—le système ajuste automatiquement la mise en page pour rétablir la cohérence. Ces corrections contribuent à assurer une expérience utilisateur fluide et réduisent les coûts cognitifs liés aux changements d'écran. Le cadre analyse en outre le graphe de navigation entre les écrans afin de maintenir une cohérence dans le flux d'interaction. Les schémas de navigation courants, notamment les transitions avant/arrière, la navigation par onglets et les workflows en plusieurs étapes, sont identifiés et appliqués. Chaque transition est validée afin de garantir son adéquation avec le modèle mental de l'utilisateur, améliorant ainsi l'ergonomie et réduisant la confusion. En conséquence, le modèle de cohérence multiscreen minimise le bruit visuel, renforce la familiarité et favorise une expérience d'interaction unifiée.
Des formulations mathématiques détaillées concernant la cohérence multiscreen et la génération d'interface utilisateur sont fournies dans le Fichier supplémentaire 1.
Enfin, le moteur de rendu génère des sorties visuelles sous des formats tels que des structures filaires SVG, des prototypes HTML/CSS ou des maquettes d'interface utilisateur basées sur des pixels. Les écrans d'interface utilisateur obtenus présentent un ordre de lecture correct, des relations harmonieuses entre les couleurs, un alignement précis sur la grille et une hiérarchie visuelle cohérente à travers plusieurs écrans.
Algorithme S3 fournit l'optimisation de la disposition cognitive-visuelle et le flux de travail de cohérence multi-écran (Fichier supplémentaire 1). L'Algorithme S3 décrit le processus intégré d'optimisation cognitive et structurelle utilisé pour générer des dispositions d'interface utilisateur conviviales. Il combine le regroupement perceptif (principes de la Gestalt), l'efficacité des interactions (loi de Fitts) et la simplicité de décision (loi de Hick) au sein d'un cadre d'optimisation unifié. Dans un premier temps, les relations spatiales entre les composants sont évaluées afin d'établir des regroupements perceptifs. L'efficacité des interactions est ensuite optimisée en ajustant la taille et la disposition des composants, tandis que la complexité des décisions est maîtrisée en limitant le nombre de choix présentés aux utilisateurs. En outre, l'algorithme impose une cohérence multi-écran en alignant chaque écran sur des modèles de disposition appris, assurant ainsi une uniformité dans la typographie, les espacements et l'organisation structurelle. Une fonction d'optimisation multi-objectif affine ensuite la disposition en équilibrant l'alignement, les espacements et le coût cognitif, produisant ainsi une interface à la fois visuellement cohérente et cognitivement efficace. Dans l'ensemble, cet algorithme garantit que les dispositions multi-écran générées conservent un haut niveau de cohérence visuelle, d'ergonomie et de clarté perceptive.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Le cadre proposé de prototypage automatisé d'interfaces utilisateur a été évalué à l'aide d'un ensemble de données intégré comprenant 5 128 écrans d'interfaces utilisateur provenant de trois sources : 4 000 images RICO, 1 000 écrans ENRICO et 128 échantillons d'interfaces utilisateur annotés en couleurs provenant du jeu de données UI Color de Guo. Cet ensemble de données mixte fournit une référence bien équilibrée pour évaluer la précision de détection des composants, la clarté structurelle de la disp...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Les résultats démontrent des améliorations statistiquement significatives en matière d'ergonomie, d'organisation structurelle et de qualité perceptive (p < 0,05), confirmant l'efficacité de l'intégration de principes de conception cognitive dans la création automatisée de maquettes d'interface utilisateur. Contrairement aux systèmes traditionnels de génération d'interfaces qui reposent principalement sur la détection visuelle ou des heuristiques fondées sur des règles, le cadre proposé intègre le regroupement de type...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n'ont aucun conflit d'intérêts.
Remerciements
Les auteurs reconnaissent le soutien académique et institutionnel fourni par le Wuhan College of Foreign Languages & Foreign Affairs, l'université Keimyung et l'Institut de commerce et de langues étrangères de Shanghai pendant la réalisation de cette recherche.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| UC (Processeur) | AMD Ryzen 9 7950X (16 cœurs, 32 threads, 4,5–5,7 GHz) | Advanced Micro Devices (AMD), États-Unis | Ryzen 9 7950X |
| CUDA Toolkit | Version 11.8 | NVIDIA Corporation, États-Unis | CUDA Toolkit 11.8 |
| cuDNN | Version 8.9 | NVIDIA Corporation, États-Unis | cuDNN v8.9 |
| Faster R-CNN | Modèle de détection d'objets (avec réseau de proposition de régions) | Meta AI Research / Detectron2 | Framework Detectron2 |
| Matplotlib | Version 3.7 | Équipe de développement Matplotlib | v3.7.0 |
| GPU NVIDIA RTX 4090 | Carte graphique 24 Go GDDR6X | NVIDIA Corporation, Santa Clara, Californie, États-Unis | RTX 4090 |
| NumPy | Version 1.24 | Développeurs NumPy | v1.24.0 |
| OpenCV | Version 4.8 | Fondation OpenCV | v4.8.0 |
| PyTorch | Version 2.0 | Fondation PyTorch (Meta AI) | v2.0.0 |
| ResNet-50 avec FPN | CNN de base avec réseau de pyramide de caractéristiques | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Version 1.3 | Développeurs Scikit-learn | v1.3.0 |
| SciPy | Version 1.10 | Communauté SciPy | v1.10.0 |
| Mémoire système (RAM) | 64 Go DDR5 | Corsair / Kingston (ou équivalent) | Ki DDR5 64 Go |
| Système d'exploitation Ubuntu | Version 22.04 LTS | Canonical Ltd., Royaume-Uni | Ubuntu 22.04 LTS |
Références
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.