Ce travail propose un cadre d'analyse des émotions multimodal de bout en bout qui exploite des encodeurs transformeurs, des représentations d'émotions désintriquées et une attention intermodale basée sur les graphes avec une cartographie visuelle afin d'améliorer la précision de la reconnaissance des émotions sur deux ensembles de données.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Cartographie visuelle des caractéristiques émotionnelles multimodales pour la conception d'interactions intelligentes
Dans cet article
Résumé
Résumé
En permettant aux machines de comprendre, d'interpréter et de réagir aux états affectifs humains, la cartographie visuelle des traits émotionnels multimodaux est essentielle à la conception d'interfaces intelligentes. Toutefois, les algorithmes actuels de détection des émotions multimodales se concentrent principalement sur la performance prédictive, offrant peu d'éclairages sur l'interprétabilité, la prise de conscience des interactions ou les interactions intermodales au niveau des caractéristiques. Ce travail présente un cadre pour la cartographie visuelle des aspects émotionnels multimodaux combinant une visualisation orientée interaction, un apprentissage de représentations interprétables et la prédiction des émotions. Sans utiliser de caractéristiques créées manuellement, des encodeurs basés sur des transformeurs ont été utilisés pour extraire des intégrations émotionnelles de haut niveau à partir des modalités textuelle, audio et visuelle. Afin d'améliorer la robustesse, des informations spécifiques aux émotions et spécifiques aux modalités ont été séparées à l'aide d'une technique d'apprentissage de représentations désentrelacées. De plus, un réseau d'attention intermodale basé sur les graphes a été conçu pour modéliser, grâce à un pondération d'attention adaptative, les relations émotionnelles subtiles entre les modalités. Un module de cartographie visuelle multi-vue a été développé afin de représenter les trajectoires émotionnelles temporelles, les distributions d'attention intermodale et les intégrations émotionnelles latentes, améliorant ainsi la transparence. Le jeu de données Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) et le jeu de données chinois d'analyse des sentiments multimodaux (CH-SIMS) ont été utilisés pour évaluer le cadre proposé. Selon les résultats expérimentaux, le cadre proposé offrait une meilleure interprétabilité au niveau des caractéristiques et une visualisation sensible aux interactions, tout en surpassant systématiquement les méthodes de référence représentatives en termes de précision, de score F1, de corrélation et d'erreur absolue moyenne. En outre, le module de cartographie visuelle a facilité l'interprétation qualitative des représentations émotionnelles multimodales, des interactions intermodales et des dynamiques émotionnelles temporelles, soutenant ainsi la visualisation et l'analyse sensibles aux interactions.
Introduction
La capacité à identifier correctement et à comprendre les émotions humaines est devenue essentielle pour améliorer l'interaction entre les humains et les machines. En plus d'être fondamentale pour l'amélioration de l'interaction homme-machine, l'analyse des émotions a le potentiel de révolutionner plusieurs domaines, notamment le diagnostic médical pré-diagnostique1, l'analyse comportementale en classe2, le suivi psychologique des patients3, l'identification de la fatigue dans les véhicules4 et la gestion intelligente dans les environnements domestiques intelligents5. Les récents progrès dans l'informatique affective et l'apprentissage profond6 ont accru l'intérêt pour la création de systèmes en temps réel capables de saisir la complexité des émotions humaines.
De nombreuses méthodes actuelles s'appuient principalement sur des données unimodales, telles que des signes textuels, graphiques ou auditifs7,8,9Ces approches échouent systématiquement à détecter des signaux subtils tels que l'ironie ou les nuances spécifiques au contexte. La recherche s'oriente désormais vers l'évaluation émotionnelle multimodale, qui intègre des données complémentaires provenant de multiples sources afin de surmonter ces limitations.10,11,12Les avantages de la fusion de plusieurs modalités ont été démontrés par des modèles de référence tels que la mémoire à long et court terme avec fusion précoce (EF-LSTM)13 et les réseaux neuronaux profonds légers et FM (LF-DNN).14, les réseaux de fusion tensorielle (TFN) et les approches de fusion multimodale à faible rang. Cependant, la plupart de ces approches reposent sur une génération hors ligne des caractéristiques et ne conviennent pas à des situations dynamiques du monde réel.
Afin de prendre en compte les états émotionnels, la recherche et les applications dans le domaine de l'identification multimodale des émotions se sont développées au cours des dix dernières années15. L'une des zones de recherche les plus difficiles et les plus importantes aujourd'hui est la surveillance continue des états émotionnels à l'aide de diverses sources de données16. La notion de multimodalité est apparue tout naturellement avec l'émergence d'un tel système varié de connaissances, conduisant à de nombreuses avancées dans l'application des émotions dans des domaines tels que le calcul émotionnel, l'interaction homme-machine (IHM), l'apprentissage, les jeux vidéo, le service à la clientèle, les soins médicaux, l'évaluation de l'expérience utilisateur (UX), etc. Toutefois, l'application des techniques de reconnaissance des émotions à l'évaluation de l'expérience utilisateur n'a pas toujours été simple.
L'une des principales raisons de privilégier la reconnaissance multimodale plutôt que les méthodes unimodales réside dans les inconvénients inhérents à la dépendance à une seule source d'information. Les systèmes de détection des émotions unimodaux peuvent souffrir d'une précision réduite en raison de données manquantes ou imprécises, tandis que les approches MER sont plus fiables et offrent une compréhension plus complète et nuancée des états expressifs en intégrant plusieurs sources de données17. Par exemple, le langage facial seul peut ne pas suffire à classer précisément les émotions, notamment lorsque les gestes sont complexes ou ambigus. Toutefois, la combinaison des expressions faciales avec d'autres formes de communication, telles que le langage ou les indices physiques, pourrait améliorer la précision de la reconnaissance des émotions.
Des recherches approfondies sur la reconnaissance des émotions ont été menées sur plusieurs modalités. Les premières études se sont concentrées sur l'identification de caractéristiques distinctives provenant de différentes modalités, telles que les entrées graphiques, acoustiques ou textuelles. Il devient toutefois de plus en plus évident que l'intégration de diverses modalités peut fournir une information émotionnelle équilibrée, conduisant à une détection des sentiments plus fiable et plus précise. Ce segment passe en revue les avancées clés dans l'analyse des émotions unimodale et multimodale, en mettant l'accent sur les approches de base, leurs limites et la justification de notre méthode.
La première étude sur la reconnaissance des émotions s'est principalement concentrée sur une seule modalité. Dans le domaine visuel, des recherches pionnières ont permis de catégoriser les mouvements faciaux typiques20. Des progrès ultérieurs ont inclus des techniques permettant de capturer la dynamique temporelle, comme le mouvement visuel21 et les modèles de Markov cachés22, tandis que les réponses faciales ont été divisées en unités d'action à l'aide du système de codage des actions faciales (FACS)23. Les LSTM et les réseaux neuronaux convolutifs (CNN) ont été utilisés avec succès pour extraire des caractéristiques significatives directement à partir de signaux audio bruts ; les méthodologies d'identification des émotions basées sur l'audio ont évolué du traitement classique du signal vers l'apprentissage profond24. L'extraction de signaux de sentiment contextuels dans l'analyse émotionnelle basée sur le texte a été considérablement améliorée par des réseaux neuronaux récurrents (RNN) intégrant des mécanismes d'attention, et plus récemment par des modèles basés sur les transformeurs. Malgré leurs réussites, les techniques unimodales sont intrinsèquement incapables de représenter fidèlement les complexités que les individus ressentent, car elles manquent des informations complémentaires présentes dans d'autres modalités.
Certains modèles fondés sur des mécanismes d'attention, tels que le modèle DialogXL25, ont été proposés en 2021 afin de recueillir des données environnementales à plus long terme dans le domaine de l'identification du sentiment en conversation. Kim et al.26 ont introduit le modèle EmoBERTa en 2021 afin d'améliorer la précision de la reconnaissance des émotions dans les conversations (ERC). Ce modèle utilise des données sur les intervenants pour enrichir les caractéristiques des locuteurs dans les échanges ainsi que leurs interactions mutuelles. En 2022, Li et al.27 a présenté la méthode CoG-BART. L'organisation utilise un apprentissage contrastif supervisé pour améliorer la capacité du modèle à interpréter les données pertinentes. Il convient de noter que l'apprentissage supervisé nécessite une quantité importante de données étiquetées.
Un exemple typique de ce type de travail est le cadre de représentation tenant compte des interactions multimodales (Multimodal Interaction-Aware Representation, MIAR)28, qui utilise des jetons d'interaction de caractéristiques et un alignement contrastif pour améliorer la généralisation entre les modalités. MIAR améliore l'alignement des modalités et obtient des performances élevées sur plusieurs ensembles de données ; toutefois, il se concentre principalement sur la précision prédictive sans aborder la cartographie visuelle. De même, le modèle de fusion audiovisuelle à attention croisée (Cross-Attentional Audio-Visual Fusion model)29 capture efficacement les interactions audiovisuelles fines pour la prédiction de la valence et de l'activation, mais se limite à deux modalités et ne dispose pas de fonctionnalités de visualisation. Les approches de modélisation temporelle basées sur les réseaux LSTM et la fusion par auto-encodeur parviennent à capturer correctement la dynamique temporelle des émotions, mais offrent peu d'informations sur les interactions entre modalités et les représentations émotionnelles apprises. Plus récemment, des méthodes basées sur les transformeurs, telles que le réseau de fusion multimodale basé sur les transformeurs (Transformer-based Multimodal Fusion Network, TMFN)30, ont démontré de solides performances sur les jeux de données CMU-MOSI et CMU-MOSEI grâce à une fusion multimodale améliorée et à un apprentissage contrastif. Néanmoins, ces approches restent principalement axées sur la performance et offrent un soutien limité à l'explicabilité, à l'interprétation au niveau des caractéristiques et à la visualisation orientée vers les interactions.
Afin d'améliorer l'intégration des données textuelles, acoustiques et visuelles, plusieurs techniques de reconnaissance multimodale des émotions ont été proposées. Bien qu'elles n'aient pas réussi à capturer les interactions complexes entre modalités, les techniques de fusion précoce telles que EF-LSTM et LF-DNN ont démontré les avantages de l'utilisation d'informations multimodales pour l'analyse des sentiments et des émotions. Bien que le TFN ait amélioré les performances sur des jeux de données de référence comme CMU-MOSI et CMU-MOSEI et ait introduit une modélisation explicite des interactions intermodales, son interprétabilité limitée et sa complexité computationnelle élevée ont restreint son utilité. Pour améliorer l'alignement des modalités et la fusion dynamique des caractéristiques, des approches plus récentes telles que MIAR, les modèles de fusion à attention croisée, TMFN et les transformeurs multimodaux adaptatifs ont recours à des architectures de transformeurs et à des mécanismes d'attention. Ces méthodes se sont principalement concentrées sur la performance prédictive, offrant peu d'informations sur les représentations émotionnelles au niveau des caractéristiques et les dépendances intermodales, malgré des résultats compétitifs sur des métriques d'évaluation courantes telles que la précision, le score F1 et l'erreur absolue moyenne. En outre, peu d'études ont mis au point des techniques de visualisation permettant de révéler les plongements latents des émotions, les distributions d'attention et la dynamique temporelle des émotions, ou ont intégré une modélisation graphique des interactions intermodales. L'approche proposée intègre une cartographie visuelle multi-vues, une fusion d'attention intermodale basée sur les graphes et un apprentissage de représentations désintriquées afin de surmonter ces limites et d'améliorer les performances de la reconnaissance multimodale des émotions.
De même, le transformateur adaptatif multimodal32 propose une fusion par échange afin d'atténuer de manière adaptative les informations modales bruitées ou manquantes, améliorant ainsi la performance de la classification des sentiments. Bien que cette approche puisse efficacement corriger les écarts dans la distribution des informations modales, sa conception est spécifique à l'analyse des sentiments et offre peu d'informations sur les représentations émotionnelles apprises. Une autre contribution importante est le modèle de fusion multimodal33, qui intègre des réseaux neuronaux convolutifs (CNN), des LSTM multiplicatifs et une attention basée sur les transformeurs pour la reconnaissance en temps réel des émotions multimodales. Ce modèle effectue une fusion complète des modalités vidéo, audio et texte, et démontre une performance robuste en matière de reconnaissance. Néanmoins, comme d'autres modèles existants, il se concentre principalement sur la précision prédictive et ne dispose pas de fonctionnalités explicites permettant la visualisation ou une interprétabilité orientée interaction.
En conclusion, bien que les approches actuelles de pointe en matière de reconnaissance multimodale des émotions aient obtenu des résultats considérables en capturant les interactions intermodales et en améliorant la précision des prédictions, la plupart d'entre elles se concentrent sur des tâches orientées vers la reconnaissance. Les aspects liés à l'interprétabilité au niveau des caractéristiques, à la visualisation des représentations émotionnelles dans l'espace image, ainsi qu'à l'intégration du cadre proposé dans la conception d'interactions intelligentes ont reçu peu d'attention. C'est en gardant ces défis à l'esprit que le cadre proposé est introduit.
La majorité des méthodes actuelles se concentrent principalement sur l'amélioration des performances prédictives tout en offrant une faible interprétabilité des représentations émotionnelles apprises et des interactions intermodales, malgré des progrès notables dans la reconnaissance multimodale des émotions28,29. Les interactions complexes entre les modalités textuelle, acoustique et visuelle sont souvent difficiles à modéliser pour les stratégies de fusion actuelles, en particulier lorsque surviennent des divergences entre modalités et des pénuries d'information 28,31. Bien que les architectures basées sur les transformeurs et les mécanismes d'attention aient amélioré l'apprentissage des représentations, leur transparence et leur interprétabilité sont souvent réduites par l'absence de séparation explicite entre l'information spécifique aux émotions et celle propre aux modalités31,32,33. En outre, seules quelques études ont exploré la modélisation basée sur les graphes pour représenter les interactions intermodales ou développé des cadres de visualisation capables de révéler la dynamique temporelle des émotions, les distributions d'attention et les intégrations émotionnelles. Ces limites soulignent la nécessité d'un cadre multimodal interprétable pour une interaction intelligente homme-machine, combinant une cartographie visuelle orientée interaction avec un apprentissage intermodal robuste.
Ce travail présente un cadre interprétable pour la cartographie visuelle d'aspects émotionnels multimodaux dans la conception d'interfaces intelligentes. Sans nécessiter de caractéristiques créées manuellement, le système utilise un apprentissage profond de bout en bout pour extraire des représentations émotionnelles de haut niveau à partir de modalités textuelles, audio et visuelles. Les interactions émotionnelles intermodales sont modélisées à l’aide d’un mécanisme de fusion par attention basé sur les graphes, qui sépare les informations spécifiques aux émotions et celles spécifiques aux modalités, permettant un apprentissage de représentations désentrelacées et améliorant l’interprétabilité et la robustesse. En outre, un module de visualisation multi-vue est conçu pour afficher les dynamiques émotionnelles temporelles, les schémas d’attention intermodale et les intégrations émotionnelles. L’efficacité et l’adaptabilité du cadre proposé dans les systèmes intelligents d’interaction homme-machine sont évaluées par une validation sur des jeux de données de référence en reconnaissance émotionnelle multimodale.
Ce travail propose un cadre original pour la cartographie visuelle des aspects multimodaux des émotions, allant au-delà des approches traditionnelles axées sur la prédiction, afin de surmonter la modélisation insuffisante des interactions intermodales et l'interprétabilité limitée des systèmes actuels d'identification des émotions multimodales. Au sein d'une architecture unique, la méthode proposée combine un apprentissage de représentations multimodales basé sur les transformeurs, une modélisation de caractéristiques désentrelacées sensibles aux émotions, une fusion d'attention intermodale fondée sur les graphes et une visualisation orientée vers les interactions. Contrairement aux approches actuelles, qui se concentrent principalement sur la performance de classification, le cadre proposé sépare clairement les représentations spécifiques aux émotions et celles spécifiques aux modalités, afin d'améliorer l'interprétabilité, la robustesse et la cohérence intermodale. De plus, un mécanisme d'attention basé sur les graphes est introduit afin de permettre une modélisation adaptative des interactions intermodales en capturant les interdépendances émotionnelles fines entre les modalités textuelle, audio et visuelle. Un module de cartographie visuelle multi-vue est conçu pour accroître la transparence en révélant les trajectoires temporelles des émotions, les schémas d'attention intermodale et les plongements latents des émotions, offrant ainsi des aperçus intuitifs du processus de décision du modèle. En plus d'offrir une visualisation et une interprétabilité améliorées des dynamiques émotionnelles multimodales, une évaluation expérimentale sur les jeux de données de référence CH-SIMS et CMU-MOSEI a montré des performances compétitives en termes de précision, de score F1, d'erreur absolue moyenne et de corrélation.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Le travail proposé vise à améliorer la conception d'interactions intelligentes en offrant un cadre interprétable pour la cartographie visuelle de caractéristiques émotionnelles multimodales. Les bases de données CH-SIMS et CMU-MOSEI, accessibles au public, ont été utilisées dans cette étude. Les deux jeux de données ont été obtenus auprès de leurs sources officielles et utilisés conformément aux directives d'utilisation, aux normes de recherche et aux conditions de licence établies par leurs créateurs respectifs. Le contenu multimodal des jeux de données, incluant des données textuelles, audio et vidéo, a d'abord été recueilli et annoté par les fournisseurs des jeux de données, conformément à leurs autorisations accordées par les participants et à leurs protocoles de collecte de données. Aucune interaction humaine directe, aucun recrutement de nouveaux participants et aucune collecte d'informations personnellement identifiables n'ont eu lieu dans cette étude. Toutes les analyses ont été effectuées à l'aide de jeux de données de recherche accessibles au public. Par conséquent, notre analyse de données secondaires n'a nécessité aucune approbation éthique supplémentaire ni examen par un comité d'éthique institutionnel (IRB). L'étude a été menée conformément aux normes institutionnelles appropriées régissant l'utilisation de jeux de données accessibles au public, les procédures éthiques de recherche et les politiques applicables en matière d'utilisation des données.
Un mécanisme d'attention transmodale basé sur les graphes a été utilisé pour apprendre des caractérisations émotionnelles entre modalités, en exploitant des caractéristiques spécifiques aux émotions ou aux modalités afin d'améliorer la compréhension. Un composant de mappage visuel multi-vue est utilisé pour renforcer la conception interactive en temps réel sensible aux émotions, et son efficacité est évaluée en matière de reconnaissance émotionnelle. Les résultats montrent que la méthode proposée améliore à la fois l'interprétabilité et l'efficacité des interfaces utilisateur intelligentes sensibles aux émotions dans des contextes réels. Figure 1 illustre le flux architectural du travail proposé. Figure 1 présente le flux complet du cadre de mappage visuel suggéré pour l'apprentissage de caractéristiques émotionnelles multimodales dans le contexte des systèmes d'interaction intelligents. Le processus débute avec trois modalités d'entrée synchronisées, à savoir le texte, l'audio et la vidéo, qui capturent respectivement des informations émotionnelles complémentaires provenant des modalités linguistique, prosodique et des expressions faciales. Un encodeur transformeur spécifique à chaque modalité traite chaque modalité afin d'obtenir des représentations de haut niveau des données brutes d'entrée. Ces représentations sont ensuite transmises à un module d'apprentissage de représentations désintriquées, où les intégrations spécifiques aux émotions sont séparées des caractéristiques spécifiques aux modalités, afin d'assurer une cohérence dans les émotions apprises à travers des sources de données hétérogènes. Les intégrations spécifiques aux émotions provenant de chaque modalité sont ensuite agrégées par un réseau d'attention transmodale basé sur les graphes, qui modélise les dépendances émotionnelles inter-modales et attribue des poids dynamiques d'importance à chaque modalité en fonction du contexte d'interaction. Enfin, le cadre fournit à la fois des sorties de classification émotionnelle et des indications sur l'interaction, facilitant ainsi une prise de décision transparente sensible aux émotions et une conception d'interaction intelligente adaptative.
Acquisition de données multimodales
Les ensembles de données CH-SIMS et CMU-MOSEI sont deux ensembles de données multimodales existants et disponibles dans le domaine public qui ont recueilli des informations multimodales, telles que des vidéos, des fichiers audio et des textes synchronisés. L'ensemble de données CH-SIMS comprend des examens multimodaux portant sur des personnes chinoises, incluant 2 281 segments vidéo, extraits de plusieurs extraits provenant de films, de séries télévisées et d'émissions de variétés. L'ajout d'éléments audio et textuels correspondants à ces segments vidéo rend les études sur l'analyse multimodale des émotions plus intéressantes et plus accessibles. Toutefois, l'un des plus grands ensembles de données multimodales pour l'analyse des opinions, des sentiments et des émotions est l'ensemble de données CMU-MOSEI, recueilli à partir de plus de 23 000 extraits vidéo de phrases prononcées par plus de 1 000 locuteurs sur une grande variété de sujets. Cet ensemble de données a été divisé aléatoirement en sous-ensembles d'apprentissage (70 %), de validation (15 %) et de test (15 %), tout en préservant la distribution des classes.
Des transcriptions textuelles, des signaux audio et des images vidéo sont obtenus et alignés temporellement de manière à correspondre à un niveau temporel finement détaillé. L'intégration au niveau des images garantit que les mécanismes proposés d'apprentissage de représentation et de fusion basée sur les graphes peuvent conjointement modéliser et exploiter le contenu émotionnel issu des expressions visuelles, des tons vocaux et du contenu linguistique. Une extraction efficace des dynamiques émotionnelles intermodales est rendue possible par cette technique d'acquisition multimodale, essentielle à la conception d'interactions intelligentes et à une cartographie visuelle compréhensible.
Tableau 1 présente les structures clés des jeux de données multimodaux sur les émotions utilisés dans la méthode proposée. Afin d'obtenir un éventail plus large de sentiments associés, tels que les mots parlés, les intonations vocales et les expressions faciales, CH-SIMS et CMU-MOSEI intègrent les modalités vidéo, audio et texte provenant de ces jeux de données. En outre, un nombre limité d'échantillons de données est disponible dans CH-SIMS, permettant un examen approfondi des interactions entre modalités et des variations émotionnelles en Chine. En revanche, le jeu de données CMU-MOSEI revêt une importance plus grande pour évaluer la robustesse des algorithmes d'apprentissage de représentation et de visualisation associés abordés dans ce travail, car il contient une grande quantité de données couvrant diverses langues, sujets et niveaux d'émotions annotés. De plus, par rapport aux recherches antérieures, il réduit les difficultés liées à la sélection d'informations lors des tests de modèles.
Prétraitement et synchronisation multimodaux
Les annotations temporelles provenant des jeux de données CH-SIMS et CMU-MOSEI ont été utilisées pour synchroniser les modalités textuelle, auditive et visuelle, assurant ainsi un apprentissage cohérent de la représentation multimodale. Chaque énoncé constituait l'unité fondamentale d'analyse et était associé à des segments audio et vidéo correspondants appartenant au même intervalle temporel. L'alignement a été effectué au niveau de l'énoncé. La transcription a été divisée en segments selon les horodatages de début et de fin de chaque énoncé. La correspondance texte-audio-visuel a été établie en extrayant les images vidéo et les signaux audio correspondants situés dans cet intervalle temporel. Alors que les segments audio ont été traités à l'aide de Wav2Vec 2.0 afin de produire des représentations acoustiques, les images visuelles du segment vidéo ont été échantillonnées à une fréquence prédéterminée et encodées à l'aide du Vision Transformer (ViT). L'encodeur RoBERTa a été utilisé pour créer des intégrations textuelles à partir des transcriptions des énoncés. La synchronisation temporelle a été obtenue en alignant toutes les caractéristiques des modalités sur une même limite d'énoncé, puisque les trois modalités produisaient des séquences de longueurs variables. Un format de longueur fixe a été utilisé pour normaliser les séquences de longueurs différentes. Les séquences plus longues ont été tronquées à la longueur maximale autorisée, tandis que les séquences plus courtes ont été complétées par des zéros. Pendant l'apprentissage, des masques d'attention ont été utilisés pour distinguer les éléments ajoutés par complétion des positions réelles des caractéristiques. Les intégrations spécifiques à chaque modalité ont été projetées dans un espace latent commun avant la fusion, afin de surmonter les différences de longueur de séquence entre les modalités. Cela a garanti une cohérence dimensionnelle et permis au mécanisme d'attention basé sur les graphes de faciliter un apprentissage efficace des interactions croisées entre modalités. Afin de préserver la qualité des données et l'intégrité de la synchronisation, les échantillons comportant des fichiers corrompus, des annotations manquantes ou des informations incomplètes sur les modalités ont été exclus des études.
Extraction de caractéristiques basée sur les transformeurs
Une méthode d'apprentissage profond est utilisée pour apprendre des représentations de caractéristiques de haut niveau intégrant les émotions à partir d'informations provenant de plusieurs modalités, telles que la vision, l'audio et le texte, de manière end-to-end, après l'alignement des données multimodales et tout prétraitement requis. En utilisant un encodeur de type transformeur pour apprendre des représentations de caractéristiques intrinsèquement discriminatives à partir de données multimodales brutes, la méthode proposée élimine le besoin d'ingénierie de caractéristiques. Afin de garantir la cohérence entre les ensembles de données utilisés dans l'approche proposée, un plongement (embedding) de taille fixe est appris pour chaque modalité. Par exemple, des plongements de caractéristiques de 768 dimensions sont appris pour chacune des modalités individuelles, notamment les modalités image, audio et texte, formant collectivement un espace de caractéristiques unifié utilisé dans l'ensemble de l'approche, en particulier une méthode d'extraction de caractéristiques appliquée à l'ensemble de données CH-SIMS proposé et à l'ensemble de données CMU-MOSEI afin d'apprendre des caractéristiques de haut niveau à partir de données de tailles variées.
Modalité visuelle : Transformeur de vision pour des intégrations de trames tenant compte des émotions
Un modèle Vision Transformer (ViT-Base) a été utilisé pour extraire des informations visuelles à partir des images de vidéos afin d'obtenir des représentations spatiales pertinentes pour les émotions. Avant l'extraction des caractéristiques, les images de chaque segment vidéo ont été redimensionnées à (224 × 224) pixels et échantillonnées à des intervalles temporels réguliers. En utilisant une taille de patch de 16 × 16 pixels, l'architecture ViT-Base produit une série de jetons visuels qui sont traités par 12 couches d'encodeur de transformeur. Les représentations au niveau des images ont été projetées dans un espace d'intégration de 768 dimensions à l'aide d'un modèle ViT préentraîné servant de squelette visuel. Les intégrations au niveau des images ont été agrégées par moyennage pour créer la représentation visuelle finale de chaque segment. Pendant l'entraînement, une normalisation des images et des méthodes d'augmentation courantes, telles que le rognage aléatoire et le retournement horizontal, ont été utilisées pour améliorer la généralisation. Le cadre de fusion multimodale proposé a ensuite été utilisé pour combiner ces intégrations visuelles avec des représentations textuelles et auditives.
Pour préserver les dynamiques temporelles des émotions, des extraits vidéo provenant des jeux de données CH-SIMS et CMU-MOSEI seront échantillonnés uniformément pour la modalité visuelle. Les images de chaque vidéo, 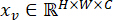 , peuvent être divisées en N sections de taille fixe, puis aplaties et inversément transformées vers un espace d'incorporation latent de dimension
 . Une série est créée en ajoutant des incorporations de position et un jeton de regroupement ajustable :
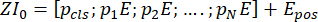 (1)
où  représente le codage de position et
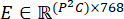 est la matrice d'incorporation des fragments.
Des couches d'encodeur de transformeur empilées, composées de réseaux feed-forward et d'une auto-attention multi-têtes, sont utilisées pour traiter la séquence de fragments intégrée. La transformation au niveau de la couche l est décrite comme suit :
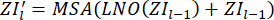 (2)
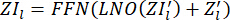 (3)
Pour obtenir le vecteur de caractéristiques visuelles sensible aux émotions, la sortie équivalente au jeton de classe est extraite comme vecteur de caractéristiques  . Afin de garantir des représentations visuelles émotionnelles cohérentes malgré les différences linguistiques et de contenu entre les ensembles de données, les intégrations au niveau des images de chaque segment vidéo sont combinées pour capturer les expressions faciales et l'évolution des émotions.
Modalité audio utilisant Wav2Vec 2.0 pour les empreintes acoustiques de prosodie et sémantiques Des empreintes vocales contextualisées ont été produites à l’aide d’un encodeur préentraîné Wav2Vec 2.0 servant de base acoustique. Un vecteur de caractéristiques acoustiques de longueur fixe pour chaque phrase a été obtenu en agrégeant les représentations cachées en sortie à l’aide d’un regroupement par moyenne. Le modèle Wav2Vec 2.0 a été utilisé pour extraire des représentations acoustiques à partir de signaux audio afin de capturer les caractéristiques vocales contextuelles et liées aux émotions. Avant l’extraction des caractéristiques, les enregistrements audio ont été normalisés et rééchantillonnés à 16 kHz. Afin d’assurer la synchronisation entre les modalités textuelle et visuelle, chaque segment audio au niveau de l’énoncé a été isolé en utilisant les bornes temporelles fournies par les annotations du jeu de données. L’encodeur acoustique préentraîné a été ajusté durant l’entraînement du modèle afin d’améliorer l’adaptation spécifique à la tâche, permettant ainsi aux représentations obtenues de refléter plus précisément les aspects émotionnels des signaux vocaux. Une fusion d’attention multimodale basée sur les graphes et un apprentissage de représentations désintriquées ont ensuite été réalisés à partir des empreintes audio finales.
Dans le domaine audio, Wav2Vec-2.0 est utilisé pour modéliser les signaux vocaux provenant des informations initiales de parole issues des jeux de données CH-SIMS et CMU-MOSEI, extrayant directement des caractéristiques audio liées à l'émotion. Un encodage de caractéristiques convolutif existe pour chaque signal vocal d'entrée  :
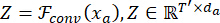 (4)
où Z représente des traits prosodiques de bas niveau tels que la mélodie, le ton et l'énergie. Un réseau de contexte basé sur un transformeur est utile pour les structures susmentionnées, car il représente des dépendances temporelles à longue portée :
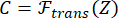 (5)
Les données acoustiques prosodiques et sémantiques, essentielles pour exprimer l'émotion, sont intégrées à ces représentations acoustiques contextuelles. Un descripteur audio de longueur fixe est créé en appliquant une procédure de regroupement temporel :
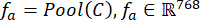 (6)
La conception évite l'utilisation de caractéristiques acoustiques telles que les MFCC et assure une bonne robustesse en extrayant simplement des représentations à partir des formes d'onde, à l'aide de données vocales en anglais provenant de CMU-MOSEI et de données vocales en chinois provenant de CH-SIMS.
Modalité textuelle utilisant RoBERTa pour des intégrations contextuelles des émotions
Pour la modalité textuelle, le transformeur profond bidirectionnel RoBERTa est appliqué aux transcriptions vocales des deux jeux de données afin de générer une sémantique contextuelle et une signification affective. Des encodeurs de transformeur basés sur RoBERTa ont été utilisés pour extraire des représentations textuelles à partir des données de transcription afin de capturer l'information sémantique contextuelle et émotionnelle. Un modèle RoBERTa préentraîné a été utilisé pour le jeu de données CMU-MOSEI en langue anglaise, tandis qu'une variante chinoise de RoBERTa a été utilisée pour le jeu de données chinois CH-SIMS afin de mieux prendre en compte les caractéristiques linguistiques propres à chaque langue. Le prétraitement du texte comprenait la tokenisation à l'aide du tokenizer RoBERTa approprié pour chaque langue ainsi que la normalisation du texte. Pour garantir un traitement par lots cohérent, les séquences d'entrée ont été converties en intégrations de tokens et complétées ou tronquées jusqu'à une longueur de séquence maximale prédéfinie. Conformément au format d'entrée de RoBERTa, des tokens spéciaux de classification et de séparation ont été introduits. Une intégration textuelle de longueur fixe a été obtenue en agrégeant les représentations de tokens contextualisées produites par l'encodeur de transformeur à l'aide de la représentation finale de phrase équivalente à [CLS]. Afin d'adapter les représentations apprises à la tâche de reconnaissance des émotions, les encodeurs RoBERTa préentraînés ont été affinés par un entraînement multimodal. Le cadre de fusion multimodal proposé a ensuite été utilisé pour combiner les intégrations textuelles avec les caractéristiques audio et visuelles.
Les intégrations de jetons et les encodages de position peuvent être combinés pour chaque entrée tokenisée, 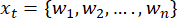 , afin de créer la représentation d'entrée dans la technique de transformation bidirectionnelle profonde connue sous le nom de
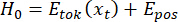 (7)
Cette forme est représentée à travers les couches du transformateur L, qui utilise l'auto-attention pour découvrir les dépendances contextuelles entre les mots :
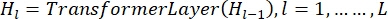 (8)
L'intégration contextuelle de l'émotion est obtenue à l'aide de l'état caché final du jeton de classification :
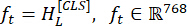 (9)
La polarité des sentiments, les émotions intenses et les implications associées sont des exemples de caractéristiques linguistiques liées aux émotions qui seront représentées par cet intégration. RoBERTa facilite la modélisation indépendante du langage. Cela permet au système d'utiliser la même taille d'intégration pour les textes anglais provenant du jeu de données CMU-MOSEI et pour les textes chinois provenant du jeu de données CH-SIMS.
Trois vecteurs de caractéristiques spécifiques à chaque modalité, chacun de 768 dimensions, sont extraits pour les modalités visuelle fv, audio fa et textuelle ft, grâce à l'étape proposée d'apprentissage de la représentation des caractéristiques profondes. Dans la conception d'interaction intelligente, ces représentations apprises créent un espace de caractéristiques multimodal unifié qui sert de base à la cartographie visuelle au niveau des caractéristiques, à la fusion intermodalle basée sur les graphes et à l'apprentissage de représentations désentrelacées.
Apprentissage de représentations désenchevêtrées
Après avoir appris une représentation de caractéristiques profondes, un traitement supplémentaire des vecteurs de caractéristiques multimodaux provenant des modalités visuelle, auditive et textuelle peut produire une description émotionnelle disjointe. Si les intégrations de caractéristiques spécifiques à chaque modalité — auditive, visuelle et textuelle — utilisées à l'étape précédente sont représentées respectivement par fv, fa et ft, de sorte que  et
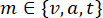 , l'objectif de cette étape consiste à factoriser l'ensemble des caractéristiques de modalité en deux représentations latentes distinctes, incluant notamment les représentations émotionnelles après prise en compte de la sémantique antérieure de chacune des différentes modalités.
Cela est réalisé en alimentant chaque caractéristique de modalité, fm, dans deux réseaux de projection parallèles : un encodeur d'émotion  et un encodeur de modalité
 , où les deux encodages sont produits.
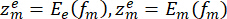 (10)
Où  représente la caractéristique latente associée à l'émotion, et
 représente une caractéristique latente propre à une modalité. Cela permet aux intégrations spécifiques aux émotions de communiquer avec un espace de manière répétée à travers plusieurs entrées, notamment audio, visuelles et textuelles, tout en conservant les données structurelles uniques associées à chaque modalité.
Une séparation efficace est obtenue en reconstruisant avec des contraintes d'indépendance. La reconstruction de la caractéristique de modalité d'origine est donnée par :
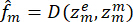 (11)
où  est un réseau de décodage. La perte de reconstruction préserve les données suivantes :
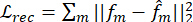 (12)
De plus, l'orthogonalité, ou la décorrélation, entre l'émotion et les représentations spécifiques à la modalité limite souvent le chevauchement d'information :
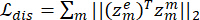 (13)
En atteignant ces objectifs, le modèle pourrait apprendre des représentations émotionnelles fiables, compréhensibles et résistantes aux variations de modalité. Les étapes ultérieures de fusion intermodalité basée sur les graphes et les caractéristiques de cartographie visuelle, en particulier pour la conception d'interactions intelligentes, dépendent fortement de représentations émotionnelles interprétables et structurées.
Cohérence émotionnelle entre les modalités
L'ajout de la cohérence émotionnelle améliore nettement l'efficacité de la fusion entre les modalités. Cela s'explique par le fait que les stratégies de fusion n'ont pas à compenser d'importantes différences entre les deux représentations, puisque les intégrations émotionnelles spécifiques à chaque modalité partagent un espace latent. L'illustration combinée des deux émotions est décrite comme suit  . La fusion pondérée sera plus stable lorsque les représentations spécifiques aux émotions sont cohérentes, car les variations entre les signaux provenant de différentes modalités n'auront alors plus d'impact sur le résultat.
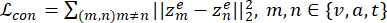 (14)
En imposant un alignement sémantique des informations émotionnelles, cet objectif réduit les divergences entre les modalités et garantit que la perception des émotions reste cohérente, quelle que soit la modalité utilisée pour les exprimer. Par conséquent, un espace de représentation cohérent et affectif est créé en projetant les indices émotionnels obtenus à partir des signaux vocaux, des expressions faciales et du contenu linguistique.
Impact sur la fusion transmodale
La fusion intermodal devient plus efficace lorsque la cohérence émotionnelle est introduite entre les modalités. Les mécanismes de fusion n'ont plus à compenser des écarts importants entre les représentations intermodales, car les intégrations spécifiques aux émotions sont alignées dans un espace latent commun. La représentation émotionnelle fusionnée est définie comme suit :
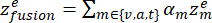 (15)
Où αm représente le poids de l'attention accordé à la modalité m. La fusion pondérée devient plus stable et compréhensible lorsque les représentations spécifiques aux émotions sont cohérentes, car le résultat de la fusion met en évidence des preuves émotionnelles complémentaires plutôt que des signaux de modalité contradictoires.
Mathématiquement, abaisser  variance entre différents types de représentations spécifiques aux émotions par rapport à est équivalent à :
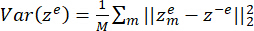 (16)
où  représente l'expression moyenne des émotions. Une variance réduite entraîne un pondération des modalités d'entrée selon leur signification émotionnelle précise plutôt que selon le bruit de la modalité, assurant ainsi une convergence améliorée du réseau et une évaluation plus précise de l'attention.
L'objectif d'apprentissage final des visualisations d'émotions désintriquées est de combiner la fragmentation, la reconstruction et l'uniformité émotionnelle :
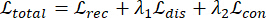 (17)
deux hyperparamètres, λ1 et λ2, contrôlent la relation entre la fiabilité émotionnelle intermodalités et la dissociation. Le modèle proposé acquiert des représentations émotionnelles invariantes par rapport aux modalités, interprétables et fusionnables afin d'atteindre cet objectif, en mettant l'accent sur l'établissement d'une base solide pour une fusion ultérieure basée sur les graphes et pour la représentation au niveau des caractéristiques dans la conception d'interfaces intelligentes.
Fusion par attention multi-modale basée sur les graphes
Un réseau d'attention transmodale basé sur les graphes a été utilisé pour simuler des relations émotionnelles fines entre les modalités. Afin de faciliter le flux d'information entre les modalités, un graphe multimodal entièrement connecté a été construit, chaque intégration spécifique à une modalité (texte, audio et visuel) étant représentée comme un nœud du graphe. Les relations entre modalités ont servi à établir la matrice d'adjacence du graphe, qui a ensuite été améliorée par une méthode d'attention apprenable. Un espace latent partagé a été créé en concaténant et en projetant les sorties provenant de plusieurs têtes d'attention. Une représentation unifiée de l'émotion multimodale a ensuite été produite en agrégeant les représentations des nœuds à l'aide d'un regroupement pondéré par l'attention. Cette représentation fusionnée a ensuite été transmise aux modules de prédiction et de visualisation pour l'analyse tenant compte des interactions et la reconnaissance des émotions. Le module de fusion par graphe possédait une dimension de représentation cachée de 256 et deux couches d'attention sur graphes, chacune comportant huit têtes d'attention. Pour déterminer l'importance relative des modalités voisines, les coefficients d'attention entre les nœuds connectés ont été calculés puis normalisés à l'aide de la fonction softmax. Chaque couche d'attention sur graphe était suivie d'une normalisation par couche, de connexions résiduelles et d'un taux de désactivation de 0,2 afin d'améliorer la stabilité de l'apprentissage et de réduire le surajustement. Après concaténation et projection des sorties de plusieurs têtes d'attention vers un espace latent commun, les représentations des nœuds ont été combinées en un seul vecteur d'émotion multimodal à l'aide d'un regroupement pondéré par l'attention. Ensuite, la représentation fusionnée a été utilisée pour la cartographie visuelle multi-vue et la prédiction des émotions.
Diverses interactions transmodales ont été capturées à l'aide d'une attention graphique multi-tête. La fonction softmax a été utilisée pour normaliser les coefficients d'attention entre les nœuds connectés pour chaque nœud. Afin d'augmenter la stabilité de l'apprentissage et d'éviter le surapprentissage, les couches d'attention graphique empilées du module de fusion de graphes ont été suivies de connexions résiduelles, d'une normalisation par couche et d'une régularisation par abandon (dropout).
Examinons, les termes individuellement, qui représentent les représentations correspondant aux émotions spécifiques recueillies par les modalités visuelle, audio et textuelle ; chaque composant se situe dans l'espace latent partagé  . Les modèles pour les nœuds de modalité utilisent une notation pour le graphe
 , les nœuds de l'ensemble
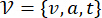 correspondant aux trois nœuds de modalité eux-mêmes, afin de renforcer explicitement les dépendances émotionnelles partagées entre les différentes représentations de modalités.
Après avoir attribué un vecteur de caractéristiques spécifique à chaque émotion à chaque nœud du graphe, nous avons :
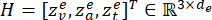 (18)
Contrairement aux méthodes de fusion traditionnelles, qui utilisent des poids de fusion prédéterminés ou fixes, la méthode proposée apprend des poids de fusion adaptatifs en fonction de leur importance et de leurs interdépendances, tant entre les canaux qu'entre les situations émotionnelles.
Un réseau d'attention sur graphes (GAT) est utilisé pour la fusion intermodalités. Un coefficient d'attention est calculé pour chaque nœud i et ses nœuds voisins, c'est-à-dire le nœud j :
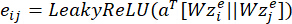 (19)
L'effet émotionnel du passage du mode j à la modalité i est mesuré par les poids normalisés αij.
Ensuite, l'apparence fusionnée de chaque nœud de modalité est calculée comme un regroupement pondéré de ses voisins :
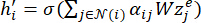 (20)
où la fonction d'activation  est non linéaire. En fin de compte, les caractéristiques mises à jour de chaque nœud sont combinées pour obtenir une représentation globale fusionnée de l'émotion :
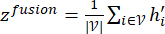 (21)
Il s'agit d'une technique utile pour la modélisation interprétable des émotions et la cartographie visuelle ultérieure, car elle capture des informations complémentaires provenant de diverses modalités tout en préservant les relations inter-modalités complexes.
L'algorithme 1 (Supplementary File 1) fournit le schéma général pour réaliser la fusion intermodalité basée sur les graphes. Dans un premier temps, un graphe est créé à partir des caractéristiques spécifiques aux émotions associées à chacune des modalités visuelle, audio et textuelle. Les scores d'attention pour chaque paire de nœuds du graphe, qui représentent la combinaison des dépendances émotionnelles, sont ensuite calculés. Ces scores d'attention sont ensuite normalisés afin d'indiquer la contribution relative de chaque modalité au contexte émotionnel spécifié, permettant ainsi l'apprentissage des poids d'attention. L'intégration générale de l'émotion est produite lors de la dernière étape par agrégation des caractéristiques associées aux nœuds du graphe. En ce sens, la fusion générale des caractéristiques multimodales liées aux émotions spécifiées par l'algorithme montre des perspectives prometteuses en termes d'adaptabilité, d'interprétabilité et d'intelligence contextuelle.
Figure 2 montre la structure et le fonctionnement du réseau d'attention croisée proposé pour la fusion de sentiments multimodaux. Les intégrations spécifiques aux émotions, obtenues indépendamment pour les modalités textuelle, auditive et vidéo, passent d'abord par des mécanismes d'attention au niveau de chaque modalité, qui apprennent l'importance relative des informations linguistiques, vocales et faciales dans un contexte émotionnel donné. Les représentations pondérées par l'attention des modalités sont ensuite combinées pour former une intégration émotionnelle unifiée, dans laquelle la matrice d'attention capture les dépendances intermodales et les intensités d'interaction. La matrice d'attention apprise par le réseau module dynamiquement les contributions des modalités, lui permettant de se concentrer sur la modalité la plus informative tout en ignorant celles qui sont bruitées ou moins pertinentes. La représentation émotionnelle fusionnée permet une reconnaissance précise des émotions et une analyse fine des états émotionnels tels que neutre, étreinte et inquiétude.
Module de cartographie visuelle
À l'aide de la section de cartographie visuelle, créée spécifiquement à cet effet, un concepteur d'interactions intelligent peut convertir la représentation unifiée de l'état émotionnel en une forme visuelle compréhensible et facilement exploitable après le processus de fusion intermodale, en se basant sur le graphe.
Afin de faciliter la compréhension des représentations émotionnelles latentes, des techniques de réduction de dimensionnalité ont été utilisées pour visualiser les intégrations multimodales d'émotions apprises. Après avoir réduit la dimensionnalité des caractéristiques tout en conservant la majeure partie de la variance à l'aide de l'analyse en composantes principales (Principal Component Analysis, PCA), les intégrations ont été projetées dans un espace bidimensionnel à l'aide de l'embedding stochastique t-SNE (t-distributed Stochastic Neighbor Embedding). Une valeur de perplexité de 30, un taux d'apprentissage de 200 et 1 000 itérations d'optimisation ont été utilisés pour t-SNE. Les regroupements spécifiques aux émotions et les relations entre modalités ont été visualisés à l'aide des projections obtenues. Les poids d'attention croisés normalisés obtenus par le réseau d'attention basé sur les graphes ont été utilisés pour créer des cartes de chaleur d'attention. Les contributions relatives des modalités textuelle, audio et visuelle durant la prédiction des émotions sont représentées dans ces cartes de chaleur. Les coefficients d'attention appris ont été utilisés comme poids des arêtes pour construire des graphes d'interaction multimodale, permettant ainsi d'examiner visuellement les relations intermodales et le flux d'information au sein du cadre de fusion. Des tracés de trajectoires émotionnelles ont été réalisés en suivant l'évolution des intégrations émotionnelles latentes au fil des énoncés successifs afin d'analyser la dynamique émotionnelle temporelle. Ces trajectoires fournissent des informations sur la manière dont les états émotionnels et les contributions des modalités évoluent dans le temps. Toutes les visualisations ont été créées à l'aide de bibliothèques Python telles que Matplotlib et Scikit-learn. Afin d'évaluer l'interprétabilité, la formation des groupes, les contributions des modalités et la dynamique temporelle des émotions, des analyses qualitatives des visualisations d'intégration, des graphes d'interaction et des cartes de chaleur d'attention ont été menées.
Soit la variable 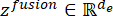 représentant la représentation fusionnée de l'état émotionnel par la fonction du réseau d'attention sur graphes. Contrairement à la visualisation au niveau de la sortie des tracés d'état émotionnel, l'objectif principal du module est de convertir les représentations d'état émotionnel et les poids correspondants du mécanisme d'attention en une forme visuelle compréhensible.
À l'aide du αji appris, une carte thermique d'attention est créée afin d'examiner visuellement la contribution de chaque modalité. Les poids d'attention entrants sont ensuite additionnés pour déterminer un score d'importance composite pour chaque modalité :
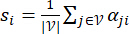 (22)
où si représente la contribution émotionnelle relative de la modalité I. Pour faciliter la création d'une carte de chaleur d'attention, les valeurs obtenues sont normalisées et mappées sur une échelle de couleurs permettant à l'utilisateur d'identifier facilement la modalité prédominante à différents pas de temps ou états interactifs. Grâce à diverses modalités d'entrée visuelles, auditives ou textuelles, une telle interface aide l'utilisateur à comprendre le fonctionnement du mécanisme d'attention du système.
Le graphe appris est modélisé spécifiquement comme un « graphe d'interaction pondéré » afin de représenter la dépendance intermodale des émotions humaines. Chaque modalité est représentée par un nœud du graphe, et l'intensité des interactions liées aux émotions humaines est représentée par des poids sous la forme de αji sur les arêtes qui les relient. Le graphe pondéré ci-dessus illustre l'intensité des interactions émotionnelles humaines. La définition de i et j est la suivante :
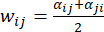 (23)
L'épaisseur ou la transparence des lignes dans la visualisation graphique est correctement affichée grâce à ces poids. Cela facilite la compréhension des interactions entre les modalités. Le concepteur peut mieux comprendre comment les indicateurs émotionnels interagissent durant le processus de fusion à l'aide des graphes d'interaction intermodale.
Les intégrations émotionnelles fusionnées  à différents pas de temps sont réduites à un espace de dimension inférieure à l’aide d’un algorithme de réduction de dimension tel que l’ACP ou le t-SNE, afin de visualiser l’évolution des émotions temporelles :
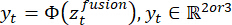 (24)
où la fonction de projection est représentée par  . L'émergence de trajectoires émotionnelles 2D/3D, qui illustrent les transitions émotionnelles, les intensités et la stabilité dans les interactions, peut être interprétée comme une représentation intuitive de l'évolution des états émotionnels au fil du temps. Ces aspects peuvent être utilisés pour l'interaction intelligente, la prise de décision et la surveillance en temps réel.
Contrairement aux systèmes d'émotions classiques qui se contentent d'associer des classes ou des scores particuliers, ce système met l'accent sur la manière dont les émotions humaines s'y forment. Il révèle son processus de prise de décision en offrant des visualisations des caractéristiques intermédiaires, notamment les facteurs de pondération, les interactions entre modèles et leurs chemins respectifs. Cela permet à l'utilisateur de comprendre comment chaque facteur — visuel, vocal ou linguistique — l'influence lors de la production de ses réponses aux émotions humaines.
Associer les émotions à des formes compréhensibles par le biais de représentations visuelles peut ainsi combler l’écart entre l’analyse des émotions à l’aide de méthodes d’apprentissage profond et leur intégration dans la conception d’interfaces intelligentes. Les données recueillies à partir de ces deux approches peuvent ensuite être utilisées pour créer des interfaces utilisateur plus précises. Ainsi, la méthode proposée peut fournir aux concepteurs d’interactions des informations essentielles afin d’élaborer des interfaces utilisateur plus précises. Autrement dit, la compréhension des émotions devient une composante très active de la conception d’interactions. La précision ne peut qu’augmenter lorsque la compréhension des émotions est intégrée activement à la conception d’interactions.
Le module de cartographie visuelle permet une explicabilité de plusieurs manières interconnectées mais distinctes : l'explicabilité au niveau des caractéristiques révèle les représentations sous-jacentes de l'émotion créées par le réseau de neurones profond (DNN), ce qui nous permet de comprendre la sémantique utilisée pour décrire chaque caractéristique liée à l'émotion ; l'explicabilité au niveau de la modalité utilise les données provenant des graphes d'interaction et des cartes thermiques de l'attention visuelle pour décrire comment chaque modalité — visuelle, audio ou textuelle — contribue aux décisions prises pour exprimer les émotions ; enfin, les trajectoires résultant de l'intégration des émotions nous permettent de comprendre comment chaque modalité visuelle et textuelle évolue dans le temps selon une perspective d'interaction dynamique. Veuillez vous référer à l'algorithme 2 (Supplementary File 1).
Les caractéristiques émotionnelles multimodales fusionnées sont mappées à des représentations visuellement significatives pour la conception d'interactions intelligentes à l'aide de l'algorithme de mappage visuel proposé, l'algorithme 2. Les poids d'attention multimodaux basés sur un graphe sont utilisés pour quantifier les différences entre les éléments d'entrée visuels, audio et textuels à chaque pas de temps. Ces différences sont ensuite mappées à des représentations visuelles afin de mettre en évidence les principales sources influençant les émotions, à l'aide d'éléments visuels de type cartes thermiques. Afin d'offrir une vue éclairante sur l'interaction entre les éléments d'entrée et de transmettre l'évolution émotionnelle générée par ces éléments multimodaux, l'algorithme calcule ensuite les intensités d'interaction par paires pour créer les poids d'interaction multimodaux. Parallèlement, une représentation de l'évolution émotionnelle est établie en projetant les éléments émotionnels fusionnés, accumulés au fil du temps, dans un espace de faible dimension afin de produire une évolution continue des éléments émotionnels.
Prédiction des émotions et rétroaction de l'interaction
Le résultat de la représentation d'émotion fusionnée, représenté par , est ensuite utilisé comme fonction pour la rétroaction d'interaction et la prédiction d'émotion. En outre, la prédiction d'émotion est décrite comme un modèle multitâche comprenant une tâche de régression pour la reconnaissance de l'intensité émotionnelle continue et une tâche de classification pour la reconnaissance d'émotion discrète. Le modèle de classification suivant, basé sur softmax, est utilisé pour la reconnaissance d'émotion discrète :
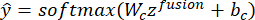 (25)
où  représente les probabilités attendues des classes d'émotions et où Wc et bc sont des contraintes apprenables. La perte d'entropie croisée est utilisée pour améliorer l'objectif de classification :
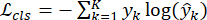 (26)
où yk est l'étiquette de référence, et K est le nombre de classes d'émotions. Une branche de régression est utilisée pour estimer l'intensité émotionnelle en parallèle, produisant une prédiction d'attributs affectifs continus variés, incluant la valence et l'activation. Donnez-lui la définition suivante :
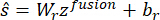 (27)
où le score d'intensité émotionnelle attendu est indiqué par  . La perte quadratique moyenne est utilisée pour améliorer la tâche de régression :
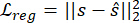 (28)
En général, les deux tâches sont combinées dans l'objectif de prédiction :
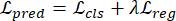 (29)
où les objectifs de régression et de classification sont équilibrés par λ. Cela suggère une modification dynamique du module de visualisation en fonction de l'état émotionnel identifié afin de permettre ce type de rétroaction sensible à l'interaction. Le contexte d'interaction à un instant donné t est représenté par ct. La réponse du module de visualisation est donnée par :
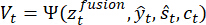 (30)
où la fonction d'adaptation de la visualisation est représentée par  . Cela permet d'ajuster en temps réel les cartes thermiques de modalité, les graphes d'interaction et les trajectoires émotionnelles en fonction des changements et des émotions anticipés. Cela indique que le système offre un soutien important en matière de rétroaction, en plus de bien performer dans la prédiction des états émotionnels.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Ce travail valide le cadre de cartographie visuelle proposé pour les caractéristiques émotionnelles multimodales, tant en termes d'interprétabilité tenant compte des interactions que de performance prédictive, en utilisant deux jeux de données de référence, CH-SIMS et CMU-MOSEI. Selon les résultats expérimentaux, l'approche proposée offre systématiquement de meilleures performances que les techniques actuelles de reconnaissance émotionnelle multimodale selon diverses métriques, notamment la corrélation, la précision, le ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Les résultats expérimentaux démontrent que, sur les jeux de données CH-SIMS et CMU-MOSEI, le cadre de mappage visuel proposé pour les caractéristiques émotionnelles multimodales surpasse les techniques actuelles de reconnaissance des émotions multimodales. Par rapport aux modèles de fusion précoce et tardive, tels que EF-LSTM et TFN, la technique proposée atteint une précision et des scores F1 plus élevés, démontrant ainsi sa robustesse dans le traitement d'informations émotionnelles variées. L'amélioration de la méthode...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n'ont aucun conflit d'intérêts.
Remerciements
Les auteurs tiennent à remercier le soutien fourni par l'École d'habitat, de construction et d'aménagement de l'Universiti Sains Malaysia, Penang, Malaisie, ainsi que par l'École de design artistique de l'Université des sciences et technologies de Changsha. & Technology, Changsha, Chine. Les auteurs tiennent également à exprimer leur reconnaissance à l'Académie des arts et du design de Xiamen, Université de Fuzhou, Xiamen, Chine, pour leur soutien académique et de recherche tout au long de ce travail.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Adam | Bibliothèque d'optimiseurs PyTorch | https://pytorch-optimizers.readthedocs.io/en/latest/ (Taux d'apprentissage = 1 × 10⁻⁴) | Optimisation des paramètres pendant l'entraînement du modèle |
| CH-SIMS | Dépôt du jeu de données original | Dernière version publique | Jeu de données de référence pour l'analyse multimodale du sentiment/émotion en chinois |
| CMU-MOSEI | Dépôt du CMU Multimodal SDK | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (Dernière version publique) | Jeu de données de référence pour la reconnaissance multimodale des sentiments et des émotions |
| Encodeur d'émotions désentrelacé | Implémentation personnalisée | https://pytorch-geometric.readthedocs.io/en/latest/(Architecture à double encodeur) | Séparation des représentations latentes spécifiques à l'émotion et spécifiques à la modalité |
| Réseau d'attention sur graphes (GAT) | PyTorch Geometric | GAT multi-têtes (https://pytorch-geometric.readthedocs.io/en/latest/) | Modélisation des relations émotionnelles intermodales et fusion adaptative de caractéristiques |
| Couche d'attention intermodale basée sur les graphes | Implémentation personnalisée | Fusion d'attention multi-têtes | Apprentissage des dépendances émotionnelles fines entre les modalités |
| Matplotlib | Projet Matplotlib | 3.7+ | Génération de graphiques et d'analyses visuelles |
| NetworkX | Projet NetworkX | 3.0+ | Construction et visualisation de graphes d'interaction intermodale |
| GPU NVIDIA | Société NVIDIA | GPU compatible CUDA | Accélération de l'entraînement des transformeurs et des réseaux neuronaux graphiques |
| Analyse en composantes principales (ACP) | Scikit-learn | sklearn.decomposition.PCA | Réduction initiale des plongements émotionnels en haute dimension |
| Python | Fondation logicielle Python | 3.8+ | Langage de programmation principal pour la mise en œuvre du cadre d'analyse des émotions multimodales |
| PyTorch | Fondation PyTorch | 2.0+ | Développement, entraînement et optimisation de réseaux neuronaux profonds |
| RoBERTa | Transformers Hugging Face | https://huggingface.co/docs/transformers/index (roberta-base, plongements de 768 dimensions) | Extraction de représentations linguistiques et sémantiques contextuelles des émotions |
| Seaborn | Projet Seaborn | 0.12+ | Génération de cartes de chaleur d'attention et de visualisations statistiques |
| Embellissement stochastique t-SNE (t-distributed Stochastic Neighbor Embedding) | Scikit-learn | scikit-learn.org (Perplexité = 30, Itérations = 1000) | Visualisation des groupes et trajectoires émotionnelles latentes |
| Ubuntu Linux | Ubuntu Canonical | 20.04 LTS ou ultérieur | Environnement expérimental d'exécution |
| Transformeur visuel (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, plongements de 768 dimensions | Extraction de représentations visuelles sensibles aux émotions à partir des images vidéo |
| Wav2Vec 2.0 | Meta AI Research | Modèle de base, plongements de 768 dimensions | Extraction de caractéristiques acoustiques et vocales contextuelles des émotions |
Références
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.