Ce protocole décrit un flux de travail d'apprentissage profond pour la segmentation sémantique, la reconstruction et la synthèse de style artistique de motifs du patrimoine culturel immatériel, en utilisant l'extraction de caractéristiques basée sur des transformeurs, la reconstruction antagoniste et la génération d'images spatialement adaptative afin de soutenir la préservation numérique et les applications créatives liées au patrimoine.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Reconstruction guidée par segmentation sémantique et synthèse de style artistique de motifs du patrimoine culturel immatériel à l'aide d'un cadre d'apprentissage profond
Dans cet article
Résumé
Résumé
La préservation numérique et la reconstruction de motifs du patrimoine culturel immatériel (PCI) attirent une attention croissante avec les progrès des techniques de synthèse d'images fondées sur l'apprentissage profond. Les approches existantes basées sur SegCycle-SPADE ont montré un potentiel pour la segmentation structurelle et la reconstruction artistique de motifs artisanaux traditionnels ; toutefois, des limites persistent, notamment une diversité insuffisante des ensembles de données, une intégration inadéquate des sémantiques culturelles et une préservation insuffisante des caractéristiques structurelles des motifs durant la reconstruction. Pour surmonter ces défis, cette étude propose un cadre SegCycle-SPADE amélioré destiné à la segmentation sémantique et à la reconstruction artistique de types de motifs de PCI. Un modèle de segmentation basé sur les Transformers, SegFormer, est utilisé afin d'identifier précisément les limites des motifs et les régions de motifs. En outre, un module de fusion de caractéristiques culturelles à attention croisée est introduit pour renforcer les motifs culturellement significatifs et améliorer la représentation des caractéristiques. La traduction et la reconstruction des motifs sont réalisées à l'aide de CycleGAN, tandis que la dénormalisation spatialement adaptative (SPADE) est utilisée pour la synthèse du style artistique afin de maintenir la cohérence sémantique entre les cartes de segmentation et les images générées. Afin d'améliorer la généralisation du modèle et la diversité artistique, le cadre est entraîné à l'aide à la fois du jeu de données de motifs culturels Miao Batik et du jeu de données WikiArt. Les résultats expérimentaux démontrent que le cadre SegCycle-SPADE guidé par l'attention proposé améliore la précision de segmentation et les performances de reconstruction des motifs patrimoniaux par rapport aux méthodes existantes de reconstruction basées sur des réseaux antagonistes génératifs (GAN). Le cadre proposé offre une solution évolutible pour la documentation assistée par intelligence artificielle, la reconstruction et la revitalisation artistique de conceptions traditionnelles de motifs.
Introduction
Le patrimoine culturel, qui englobe des éléments immatériels tels que les coutumes, les langues et les croyances, ainsi que des éléments matériels comme les œuvres d'art, les bâtiments et les documents écrits, constitue une manifestation fondamentale de l'histoire humaine, de la créativité et de l'identité1. La conservation du patrimoine vise à permettre aux communautés de renouer avec leurs origines et d'offrir aux générations futures l'accès à leur mémoire culturelle collective. Elle favorise également la compréhension interculturelle, l'appréciation des traditions et coutumes diverses, ainsi que la reconnaissance de récits historiques variés. Ces biens culturels nous aident à comprendre les valeurs, les points de vue et les expériences des générations passées et contribuent à la formation des identités sociales contemporaines et à la continuité culturelle. Les principes fondamentaux de la préservation du patrimoine culturel sont illustrés dans Figure 1.
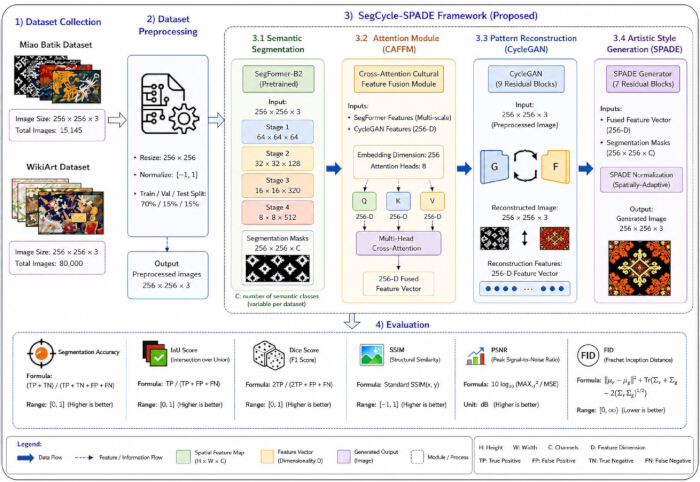
Figure 1. Aperçu conceptuel de la reconstruction de motifs du patrimoine culturel à l'aide du cadre SegCycle-SPADE. Illustration schématique de l'approche proposée pour reconstruire et améliorer les motifs du patrimoine culturel immatériel. Le flux de travail comprend la collecte de jeux de données à partir des ensembles Miao Batik et WikiArt, le prétraitement des images, la segmentation sémantique à l'aide de SegFormer-B2, la fusion de caractéristiques à l'aide du module de fusion de caractéristiques culturelles par attention croisée (CAFFM), la reconstruction de motifs à l'aide de CycleGAN, la synthèse de style artistique à l'aide de SPADE, et l'évaluation finale à l'aide de métriques de segmentation et de reconstruction. Les flèches indiquent le flux des données et des représentations de caractéristiques à travers l'ensemble du cadre. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
La mémoire collective et l'héritage culturel de la société humaine sont incarnés dans le patrimoine culturel immatériel (PCI), qui constitue un moyen important d'expression artistique et d'identité culturelle. Toutefois, le PCI fait face à des défis importants en raison des effets de la mondialisation et de la numérisation2,3,4. De nombreuses pratiques de PCI en voie de disparition nécessitent de nouvelles approches en matière de préservation et de développement, en raison de la diminution du nombre d'artisans qualifiés et d'une adaptabilité limitée aux marchés modernes5,6. En tant qu'axe important de la recherche sur le PCI, la conception durable met l'accent sur le développement intégré de la culture, de la société et de l'environnement, offrant ainsi une voie pratique pour la préservation continue du PCI. Grâce à des approches de conception durable, le PCI peut être revitalisé tout en s'adaptant aux besoins de la société contemporaine7,8.
Dans cette étude, le terme « motifs du patrimoine culturel immatériel » désigne des représentations de motifs visuels qui transmettent et préservent des valeurs culturelles immatérielles sous-jacentes. Par conséquent, le cadre proposé vise à préserver et documenter l'information culturelle associée à ces motifs tout en reconstituant leurs formes visuelles.
La broderie Miao et le batik sont des formes importantes du PCI chinois, reflétant l'histoire, les croyances et les traditions de la communauté Miao à travers des motifs symboliques tels que les oiseaux, les papillons et les totems ancestraux9. Ces motifs sont profondément intégrés aux vêtements rituels et aux pratiques festives et contribuent au développement culturel et économique local10,11. Les progrès des technologies numériques, en particulier de l'intelligence artificielle (IA) et de l'apprentissage profond (DL), ont créé de nouvelles opportunités pour la préservation, l'analyse, la reconstruction et la documentation du patrimoine culturel. Le batik Miao du Guizhou, l'une des traditions de batik les mieux préservées en Chine, constitue un support important pour transmettre les savoirs culturels, les croyances, les coutumes et les rituels du peuple Miao12,13,14,15,16.
De récentes études ont démontré le potentiel du deep learning (apprentissage profond) pour la préservation du patrimoine culturel et la reconstruction de motifs, avec une précision de segmentation améliorée (précision au niveau des pixels = 88,6 %, moyenne de l'intersection sur l'union [IoU] = 78,1 %) et de meilleures performances de reconstruction par rapport au U-Net et au DeepLabV3+. Toutefois, plusieurs défis persistent. Les approches existantes fondées sur des réseaux antagonistes génératifs (GAN) ont souvent du mal à préserver les détails structurels fins dans les motifs complexes.17, alors qu'une diversité limitée des ensembles de données restreint la généralisation du modèle à travers les domaines culturels18De plus, les modèles de traduction d'image à image, tels que CycleGAN, peuvent ne pas préserver la cohérence sémantique entre les cartes de segmentation et les images générées.19, et l'absence de mécanismes d'attention peut entraîner la perte de détails des motifs culturellement significatifs lors de la reconstruction20Par conséquent, un cadre amélioré intégrant une segmentation basée sur les transformeurs, un apprentissage des caractéristiques guidé par l'attention et un entraînement sur plusieurs jeux de données est nécessaire pour une reconstruction efficace des motifs d'hémorragie intracérébrale (ICH).
De nouvelles opportunités pour la préservation du patrimoine culturel sont apparues grâce à la numérisation de la broderie Miao et aux progrès rapides de l'intelligence artificielle générative. Les modèles de diffusion, une classe émergente de modèles génératifs profonds, ont démontré des performances remarquables dans les tâches de vision par ordinateur en raison de leurs puissantes capacités de génération de contenu21,22,23,24,25. Lors du processus de diffusion inverse, le modèle apprend progressivement à reconstruire les données d'origine à partir de représentations bruitées26,27,28. Des études antérieures ont également exploré l'application de technologies de reconstruction tridimensionnelle et de conception assistée par ordinateur (CAO) pour la préservation et la diffusion du patrimoine culturel.
Même si les réseaux neuronaux convolutifs (CNN) et les GAN offrent de bonnes performances en génération d'images et en préservation des caractéristiques, ils font toujours face à des défis liés à des champs réceptifs limités, à l'effondrement de modes et à une instabilité lors de l'apprentissage29. Les architectures basées sur les transformeurs, telles que SegFormer et Segmenter, excellent à capturer le contexte global et les relations sémantiques ; toutefois, elles sont coûteuses en ressources de calcul et peuvent éprouver des difficultés avec les détails fins. Bien que les modèles de diffusion comme Stable Diffusion démontrent de solides capacités de génération d'images, ils manquent souvent d'un contrôle précis sur les caractéristiques structurelles et artistiques des conceptions générées. De plus, la plupart des approches existantes utilisent des stratégies d'entraînement indépendantes qui limitent le partage efficace d'informations et l'optimisation collaborative entre les composants de segmentation et de génération, entraînant un compromis entre précision structurelle et authenticité artistique30.
Les modèles récents basés sur la diffusion, tels que la diffusion latente et Stable Diffusion, permettent une synthèse d'images de haute qualité, mais nécessitent un débruitage itératif, ce qui augmente le coût computationnel et le temps d'inférence. De plus, la préservation de motifs culturels fins et d'une cohérence structurelle reste difficile en l'absence de mécanismes de conditionnement spécialisés. Les modèles génératifs basés sur les Transformers capturent efficacement les relations contextuelles globales, mais exigent souvent des ensembles de données à grande échelle et des ressources computationnelles importantes. En revanche, le cadre proposé SegCycle-Normalisation Adaptative Spatiale (SegCycle-SPADE) combine la segmentation basée sur SegFormer, la fusion de caractéristiques par attention croisée, la reconstruction CycleGAN et la synthèse guidée par SPADE afin de fournir une orientation structurelle explicite, améliorant ainsi la préservation des motifs, la cohérence sémantique et la reconstruction contrôlable des motifs du patrimoine culturel.
La majorité des techniques de pointe de segmentation sémantique reposent sur des réseaux de neurones convolutionnels entièrement convolutifs (FCNN) dotés d'architectures en forme de U31. Pendant la phase d'encodage, des caractéristiques profondes ayant de grands champs réceptifs sont extraites au moyen d'une série d'opérations de convolution et de sous-échantillonnage. La phase de décodage restaure progressivement la résolution spatiale par suréchantillonnage, permettant finalement une prédiction sémantique au niveau des pixels. En compensant la perte d'information spatiale pendant le sous-échantillonnage et en améliorant les performances de segmentation dans un large éventail d'applications, les connexions de saut permettent d'intégrer directement dans le décodeur des informations à haute résolution provenant de différents niveaux de l'encodeur32.
Bien que les méthodes récentes basées sur des GAN, des CNN ou des modèles de diffusion aient donné des résultats prometteurs en matière de génération d'images et de restauration du patrimoine culturel, elles peinent souvent à maintenir une cohérence sémantique, à préserver les motifs structurels fins et à assurer une reconstruction reproductible à travers des motifs culturels variés. La plupart des approches existantes traitent la segmentation, la reconstruction et la synthèse de style comme des processus distincts, ce qui peut entraîner la perte d'éléments culturellement significatifs et des résultats incohérents. Pour combler cette lacune méthodologique, cette étude propose un cadre unifié SegCycle-SPADE qui intègre une segmentation sémantique basée sur SegFormer, un nouveau module de fusion de caractéristiques culturelles par attention croisée (CAFFM), une reconstruction basée sur CycleGAN et une synthèse de style guidée par SPADE. En intégrant explicitement l'information de segmentation structurelle à l'apprentissage génératif de caractéristiques, le cadre proposé permet une reconstruction plus fiable, sémantiquement cohérente et reproductible des motifs du patrimoine culturel immatériel (ICH), tout en préservant l'authenticité culturelle et la qualité artistique.
Trois principales limites des approches actuelles de reconstruction du patrimoine culturel sont identifiées dans cette étude : (i) une préservation insuffisante des motifs structurels fins dans les méthodes de reconstruction basées sur des GAN ; (ii) une généralisation limitée résultant d’un entraînement sur des ensembles de données restreints ou spécifiques à un domaine ; et (iii) une cohérence sémantique insuffisante entre les sorties de segmentation et les images générées dans les cadres de traduction image-à-image. De plus, la segmentation, la reconstruction et la synthèse de style sont généralement traitées comme des processus distincts, entraînant la perte d’éléments culturellement importants durant la reconstruction. En combinant une segmentation sémantique basée sur les transformeurs, une fusion de caractéristiques par attention croisée, une reconstruction CycleGAN et une synthèse artistique guidée par SPADE au sein d’une architecture unifiée, le cadre SegCycle-SPADE proposé remédie à ces limites et améliore la préservation des motifs, la cohérence sémantique et l’authenticité artistique dans la reconstruction des motifs du PCI.
L'objectif principal de cette étude est de développer un cadre SegCycle-SPADE amélioré pour la reconstruction artistique guidée par segmentation sémantique des motifs d'hématome intracérébral (ICH). Le cadre intègre SegFormer pour une segmentation précise des motifs culturels, CycleGAN pour la reconstruction des motifs et SPADE pour une synthèse artistique cohérente sur le plan du style. Afin d'améliorer la représentation des caractéristiques et de préserver les détails structurels fins, un module CAFFM est introduit pour faciliter une interaction efficace entre les caractéristiques de segmentation et de génération. Entraîné sur les ensembles de données Miao Batik et WikiArt, le cadre proposé améliore l'authenticité de la reconstruction, la cohérence stylistique et la préservation des motifs culturellement significatifs.
En combinant la segmentation sémantique, la fusion de caractéristiques guidée par l'attention, la reconstruction de motifs et la synthèse de style au sein d'une architecture unifiée, cette étude présente un nouveau cadre SegCycle-SPADE pour la reconstruction artistique de motifs ICH. Les principales contributions de ce travail sont les suivantes. Premièrement, un nouveau cadre de reconstruction guidé par segmentation sémantique est développé grâce à l'intégration de SegFormer, permettant l'extraction précise et la préservation de motifs culturels complexes et d'éléments structurels. Deuxièmement, un nouveau module CAFFM est introduit afin de fusionner efficacement les caractéristiques de segmentation avec des représentations génératives, permettant au modèle de capturer les relations à longue portée entre les motifs culturels et les schémas de style artistique. Troisièmement, le CAFFM proposé améliore la préservation des éléments culturellement significatifs tout en renforçant le réalisme visuel et la cohérence structurelle des motifs patrimoniaux reconstruits. Quatrièmement, en intégrant CycleGAN pour la reconstruction de motifs culturels et SPADE pour la synthèse artistique guidée par segmentation, le cadre garantit à la fois une exactitude sémantique et une authenticité stylistique dans les sorties générées. Cinquièmement, afin d'améliorer la généralisation et la diversité artistique, le modèle est entraîné à l'aide du jeu de données des motifs culturels Miao Batik pour l'apprentissage des motifs culturels et du jeu de données WikiArt pour la représentation des styles artistiques. WikiArt sert de jeu de données auxiliaire pour évaluer la capacité de généralisation du cadre, la robustesse de l'apprentissage des caractéristiques et l'efficacité du contrôle du style dans divers contextes visuels, plutôt que comme style cible pour une application directe dans les produits du patrimoine culturel Miao. Enfin, par rapport aux méthodes existantes de reconstruction du patrimoine culturel basées sur des GAN, les résultats expérimentaux démontrent que le cadre SegCycle-SPADE proposé atteint une meilleure précision de segmentation, une qualité de reconstruction accrue et une cohérence stylistique améliorée.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Le cadre proposé de SegCycle-SPADE a été conçu pour reconstruire et améliorer les motifs traditionnels du patrimoine culturel grâce à la segmentation sémantique, au renforcement des caractéristiques à l’aide de mécanismes d’attention, à la reconstruction générative et à la synthèse de styles artistiques. Cette étude a utilisé des ensembles de données d’images artistiques et du patrimoine culturel accessibles au public, notamment le jeu de données Miao Batik et le jeu de données WikiArt. Aucun participant humain, donnée de patient, information personnelle, sujet animal ou dossier clinique n’a été impliqué dans la recherche ; par conséquent, aucune approbation par un comité d’éthique institutionnel ni consentement éclairé n’était requis. Dans un premier temps, le jeu de données des motifs culturels Miao Batik et le jeu de données WikiArt ont été utilisés pour l’évaluation. Le jeu de données Miao Batik a été décrit par Quan et al. (2024)32 et contient 15 148 images annotées de motifs traditionnels de batik Miao. Les annotations existantes fournies par les créateurs du jeu de données ont été utilisées directement, et aucune annotation manuelle supplémentaire n’a été générée dans cette étude. Ensuite, un prétraitement des images est effectué par redimensionnement, normalisation, suppression du bruit et création d’une carte de segmentation. Les paramètres exacts de prétraitement sont décrits dans la sous-section Prétraitement des données. Le cadre proposé utilise un modèle basé sur les transformeurs, nommé SegFormer-B2, pour la segmentation sémantique des données. La méthode est conçue pour détecter les régions clés des motifs culturels et en apprendre les structures. Les caractéristiques segmentées sont ensuite renforcées par un mécanisme d’attention, dans lequel les informations importantes liées aux motifs culturels sont mises en évidence tandis que les informations non pertinentes sont écartées. La configuration du mécanisme d’attention est décrite dans la sous-section CAFFM. Les caractéristiques améliorées sont ensuite transmises à un CycleGAN, où les structures endommagées sont reconstruites par apprentissage cyclique. Pendant l’entraînement, des échantillons de motifs incomplets ont été artificiellement créés en appliquant des opérations de masquage aléatoire et d’occlusion partielle aux images originales de batik Miao. Ces procédures de dégradation simulaient des régions manquantes et des dommages structurels fréquemment observés dans les artefacts du patrimoine culturel dégradés. Les images incomplètes ainsi obtenues ont été utilisées comme entrées du module de reconstruction CycleGAN, tandis que les images originales correspondantes servaient de cibles de reconstruction. Les motifs du patrimoine culturel reconstruits sont ensuite améliorés par SPADE, où un enrichissement artistique est réalisé à partir des cartes de segmentation générées. Les performances du cadre proposé sont évaluées à l’aide de métriques quantitatives de segmentation et de qualité d’image, tandis que l’authenticité visuelle des motifs culturels reconstruits est évaluée de manière qualitative. L’authenticité visuelle a été évaluée par inspection visuelle des motifs culturels générés et n’a pas été utilisée comme métrique quantitative indépendante. L’évaluation s’est concentrée sur la préservation des motifs, la cohérence sémantique, les caractéristiques culturelles, la cohérence structurelle et l’apparence artistique par rapport aux motifs culturels de référence correspondants. L’évaluation quantitative des performances du modèle a été réalisée à l’aide de l’exactitude de segmentation, du coefficient d’intersection sur union (IoU), du coefficient de Dice, de l’indice de similarité structurelle (SSIM), du rapport signal sur bruit de crête (PSNR) et de la distance d’Inception de Fréchet (FID). Figure 2 illustre l'ensemble du flux de travail du cadre SegCycle-SPADE proposé et résume les métriques d'évaluation utilisées dans cette étude.
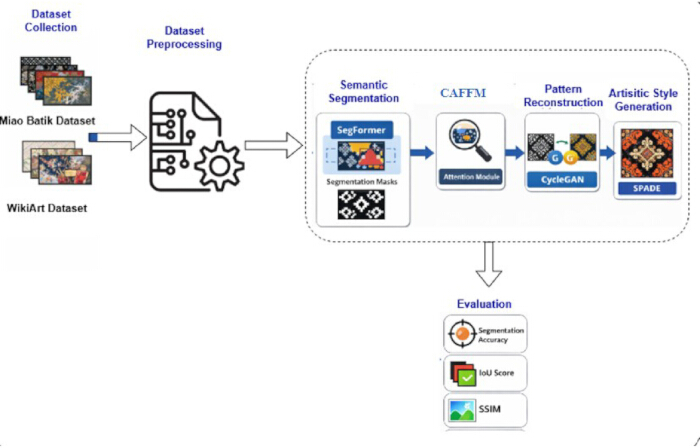
Figure 2. Flux de travail global de l'architecture du cadre SegCycle-SPADE proposé. Vue d'ensemble du flux de travail complet de SegCycle-SPADE. Les images provenant des ensembles de données Miao Batik et WikiArt subissent un prétraitement avant d'être traitées par segmentation sémantique à l'aide de SegFormer-B2, un renforcement des caractéristiques à l'aide du CAFFM, une reconstruction de motifs à l'aide de CycleGAN et une génération de style artistique à l'aide de SPADE. Les performances du modèle sont évaluées à l'aide de l'exactitude de la segmentation, de l'intersection sur l'union (IoU), du coefficient de Dice, de la mesure de l'indice de similarité structurale (SSIM), du PSNR et de la distance d'Inception de Fréchet (FID), tandis que l'authenticité visuelle est évaluée de manière qualitative. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Le cadre SegCycle-SPADE pour la reconstruction de motifs culturels est conçu pour intégrer plusieurs composants d'apprentissage profond afin d'assurer une segmentation, une reconstruction et une amélioration artistique précises des motifs, comme illustré dans la Figure 2. Des images provenant du jeu de données sur les motifs culturels du batik Miao et du jeu de données WikiArt sont utilisées afin de fournir une diversité de motifs culturels et de styles artistiques. Dans un premier temps, les images sont traitées à l'aide d'un module de segmentation sémantique basé sur SegFormer afin d'identifier et de délimiter les motifs culturels par rapport à l'arrière-plan. L'architecture globale comprend quatre étapes principales. Premièrement, le modèle SegFormer extrait des cartes de segmentation sémantique à partir des images de motifs culturels. Deuxièmement, le CAFFM intègre les caractéristiques de segmentation avec des représentations génératives afin d'améliorer l'apprentissage des caractéristiques. Troisièmement, le module CycleGAN reconstruit les motifs culturels en utilisant les représentations de caractéristiques fusionnées. Enfin, le module SPADE génère des sorties améliorées sur le plan stylistique tout en préservant la cohérence structurelle grâce à une synthèse guidée par la segmentation. Les cartes de caractéristiques affinées sont ensuite traitées par le module de reconstruction CycleGAN, qui apprend à restaurer les motifs culturels incomplets en associant les motifs dégradés à leurs formes complètes correspondantes. Des échantillons de motifs incomplets ont été générés en appliquant des opérations aléatoires de masquage et d'occlusion partielle aux images originales de batik Miao, simulant ainsi des régions manquantes et une dégradation structurelle fréquemment observées dans les artefacts culturels endommagés. Chaque image dégradée a été appariée avec son image originale correspondante, qui a servi de cible de reconstruction durant l'entraînement. Cette stratégie a permis au module CycleGAN d'apprendre à restaurer les structures de motifs manquants tout en préservant la cohérence sémantique et les caractéristiques culturellement significatives. Enfin, le générateur SPADE produit des sorties artistiques visuellement améliorées en conditionnant la synthèse d'images aux cartes de segmentation générées, préservant ainsi l'intégrité structurelle des motifs culturels tout au long du processus d'amélioration artistique.
Les étapes suivantes sont incluses dans le cadre proposé du SegCycle-SPADE.
Étape 1 : Collecte du jeu de données
Deux jeux de données ont été utilisés afin d'atteindre les objectifs d'apprentissage des motifs culturels et de génération de styles artistiques. Le jeu de données des motifs culturels du batik Miao a été utilisé pour fournir des informations sur les motifs culturels traditionnels. Ce jeu de données est publiquement accessible via Zenodo (https://doi.org/10.5281/zenodo.20807658) et contient 15 148 images annotées de motifs traditionnels de batik Miao. Les annotations existantes fournies par les créateurs du jeu de données ont été utilisées directement, et aucune annotation manuelle supplémentaire n'a été générée dans cette étude. Le jeu de données WikiArt a été utilisé pour fournir des informations variées sur les styles artistiques afin de générer des styles artistiques, et a été obtenu à partir du référentiel publiquement accessible WikiArt (https://www.wikiart.org/).
Étape 2 : Prétraitement des données
Toutes les images ont été prétraitées par redimensionnement, normalisation et réduction du bruit. Les annotations existantes de motifs culturels, obtenues à partir des sources d'origine des ensembles de données, ont été utilisées pour soutenir l'étape de segmentation sémantique. Aucune annotation supplémentaire ni aucune procédure de reclassement n'a été effectuée dans le cadre de cette étude.
Étape 3 : Segmentation sémantique par motifs à l'aide de SegFormer
Le modèle SegFormer a été utilisé pour la segmentation de motifs culturels. Le choix précis du squelette du modèle et de la stratégie d'initialisation est décrit dans la sous-section Semantic Pattern Segmentation Using SegFormer. Plus précisément, l'architecture SegFormer-B2, dotée d'un squelette MIT-B2 pré-entraîné sur ImageNet, a été utilisée pour la segmentation sémantique des motifs. Ce modèle capture efficacement les informations contextuelles globales tout en préservant les détails structurels complexes des motifs culturels traditionnels.
Étape 4 : CAFFM
Le CAFFM combine des caractéristiques de segmentation sémantique avec des représentations génératives, permettant au cadre d'apprendre à la fois les caractéristiques des motifs structurels et les informations de style artistique. Les détails d'intégration du CAFFM sont fournis dans la sous-section CAFFM. Le module est placé entre l'étape de segmentation sémantique basée sur SegFormer et l'étape de reconstruction générative, où il fusionne les caractéristiques structurelles issues de la segmentation avec les caractéristiques de reconstruction au moyen d'une attention croisée multi-têtes. Ce processus améliore la préservation des motifs culturels et renforce le réalisme des sorties reconstruites.
Étape 5 : Reconstruction du motif (CycleGAN)
Les caractéristiques fusionnées sont ensuite traitées par le module CycleGAN afin de reconstruire les structures de motifs culturels. L'architecture CycleGAN et la configuration d'entraînement sont décrites dans la sous-section Reconstruction du motif à l'aide de CycleGAN. Le module de reconstruction comprend deux générateurs et deux discriminateurs, utilise une architecture de générateur de type réseau résiduel comportant neuf blocs résiduels, emploie un discriminateur PatchGAN, et est entraîné à l'aide de pertes adverses et de pertes de cohérence cyclique. Cette configuration permet une cartographie bidirectionnelle entre les domaines et facilite la reconstruction de structures de motifs culturels incomplètes.
Étape 6 : Génération de style artistique (SPADE)
Les motifs reconstruits sont ensuite traités par le module SPADE afin d'effectuer une synthèse de style artistique guidée par segmentation. La configuration du générateur SPADE est décrite dans la sous-section Artistic Style Generation Using SPADE. Le module utilise des blocs résiduels SPADE, des couches de normalisation adaptative spatialement et une conditionnelle sémantique dérivée des cartes de segmentation de SegFormer ainsi que des représentations de caractéristiques CAFFM. En conditionnant la génération d'images sur des cartes de segmentation, les sorties synthétisées conservent un alignement structurel avec les motifs culturels d'origine tout en intégrant des caractéristiques stylistiques artistiques.
Étape 7 : Estimation des performances
Le cadre proposé a été évalué à l'aide de plusieurs métriques d'évaluation de la segmentation et de la qualité d'image, notamment la précision de la segmentation, l'indice d'intersection sur union (IoU), le coefficient de similarité de Dice (Dice), le SSIM, le PSNR et le FID. Pour évaluer la cohérence expérimentale, toutes les expériences ont été répétées cinq fois en utilisant différentes graines aléatoires, et les résultats sont exprimés sous la forme moyenne ± écart-type. La signification statistique a été évaluée à l'aide de tests t appariés, avec un seuil de significativité de p < 0,05.
Collecte des ensembles de données
Dans le cadre proposé de SegCycle-SPADE, deux ensembles de données sont utilisés pour la compréhension des motifs culturels et l'apprentissage de style. Le premier ensemble de données utilisé dans ce cadre est l'ensemble de données des motifs culturels du batik Miao. Cet ensemble contient des motifs culturels du batik Miao, généralement des images traditionnelles de batik Miao incluant des motifs tels que des animaux, des plantes et des formes géométriques, utilisés dans l'art de l'ethnie Miao. Cet ensemble comprend des images riches en informations texturales, généralement importantes pour la préservation du patrimoine culturel. Le second ensemble de données utilisé dans le cadre proposé de SegCycle-SPADE est l'ensemble de données WikiArt. Cet ensemble contient un grand nombre d'œuvres d'art provenant généralement de styles variés. Il est utilisé pour l'apprentissage de styles complexes, ce qui est généralement utile pour améliorer les œuvres artistiques. Cet ensemble comprend 80 000 œuvres d'art en haute définition, réparties en 27 styles différents, ce qui le rend particulièrement adapté aux tâches de génération ou de transformation de style basées sur l'apprentissage profond (DL).
Jeu de données Miao Batik :
Le jeu de données Miao Batik (https://doi.org/10.5281/zenodo.20807658) comprend 15 148 images de motifs de batik représentant des symboles culturellement significatifs. Les images incluent une variété de dessins traditionnels, tels que des motifs animaux (par exemple, papillons et poissons), des motifs végétaux et des formes géométriques portant une symbolique culturelle. Ce jeu de données constitue un élément essentiel du cadre proposé, car il fournit des structures culturelles authentiques permettant au module de segmentation d'identifier et de préserver avec précision les limites des motifs lors de la reconstruction des motifs (Tableau 1). Dans cette étude, les motifs culturellement importants désignent des éléments visuels symboliques couramment répertoriés dans la littérature relative au patrimoine culturel Miao et représentés dans les annotations du jeu de données, notamment les oiseaux, les papillons, les motifs floraux et les totems ancestraux. Ces motifs ont été sélectionnés en fonction de leur importance culturelle documentée et de leur présence récurrente dans les dessins traditionnels de batik et de broderie Miao, et non uniquement en fonction de leur fréquence d'apparition ou de leur composition spatiale. Les annotations de motifs guidées par des experts et les étiquettes de segmentation proviennent de la source d'origine du jeu de données Miao Batik et ont été utilisées directement dans cette étude. Aucune annotation manuelle supplémentaire, aucun reclassement ni aucune procédure d'annotation assistée par un expert n'ont été effectués par les auteurs. Les annotations existantes fournies par les créateurs du jeu de données ont été utilisées pour l'entraînement et l'évaluation de la segmentation sémantique.
| Paramètre | Description |
| Nom du jeu de données | Miao Batik Cultural Pattern Dataset |
| Source du jeu de données | Référentiel Zenodo (DOI : 10.5281/zenodo.20807658) |
| Domaine | Patrimoine culturel immatériel (PCI) / Analyse de motifs textiles |
| Nombre total d'images | 15 148 images |
| Type d'image | Images numériques de motifs textiles traditionnels de batik Miao |
| Catégories de motifs | Motifs animaux, motifs végétaux et motifs géométriques |
| Origine culturelle | Culture ethnique Miao, province de Guizhou, Chine |
| Résolution initiale des images | Images haute résolution (généralement ≥ 1 000 pixels sur le côté le plus court) capturées sous forme de scans bruts ou de photographies avant le prétraitement |
| Résolution d'entraînement | Images redimensionnées à 256 × 256 pixels lors du prétraitement |
| Disponibilité des annotations | Les annotations de segmentation existantes fournies par les créateurs du jeu de données ont été utilisées sans modification pour l'entraînement et l'évaluation. Aucune annotation manuelle supplémentaire, aucun reclassement ni aucune procédure de confirmation par un expert n'ont été effectués dans cette étude. |
| Application dans cette étude | Segmentation de motifs culturels, extraction de caractéristiques, préservation de motifs et reconstruction de motifs |
Tableau 1 : Caractéristiques du jeu de données des motifs culturels du batik Miao. Résumé du jeu de données des motifs culturels du batik Miao utilisé pour la segmentation sémantique, l'analyse des motifs culturels et la reconstruction des motifs. Le tableau décrit la source du jeu de données, les caractéristiques des images, les catégories de motifs, l'origine culturelle, la résolution des images et le rôle de ce jeu de données dans le cadre proposé SegCycle-SPADE.
Jeu de données WikiArt :
Le jeu de données WikiArt [https://www.wikiart.org/] est un référentiel numérique d'art à grande échelle très utilisé, comprenant plus de 80 000 images issues de 27 styles artistiques différents présentés dans le tableau 2. Ces styles incluent l'art de la Renaissance, l'impressionnisme, le cubisme et le surréalisme. Ce jeu de données est très important dans le cadre proposé, car il fournit des connaissances permettant au module SPADE de créer des motifs enrichis culturellement tout en conservant les informations structurelles obtenues à partir du processus de segmentation. Le jeu de données comprend 56 000 images pour l'apprentissage et 12 000 images destinées à la validation et aux tests. Les images de ce jeu de données contribuent efficacement à l'entraînement du modèle d'apprentissage profond.
| Paramètre | Description |
| Nom du jeu de données | WikiArt Dataset |
| Source du jeu de données | Référentiel WikiArt (https://www.wikiart.org/) |
| Domaine | Art numérique et peintures |
| Nombre total d'images | Environ 80 000 œuvres |
| Images d'entraînement | 56 000 |
| Images de validation | 12 000 |
| Images de test | 12 000 |
| Styles artistiques | 27 styles artistiques, incluant la Renaissance, l'Impressionnisme, le Cubisme, le Surréalisme, l'Expressionnisme, le Réalisme et l'Art abstrait |
| Résolution initiale des images | Les résolutions initiales des images varient selon les œuvres et les sources. Les images ont été redimensionnées à une résolution uniforme de 256 × 256 pixels lors du prétraitement. |
| Résolution d'entraînement | Les images ont été redimensionnées à 256 × 256 pixels lors du prétraitement, avant l'apprentissage du style artistique et la synthèse d'images guidée par segmentation. |
| Partitionnement du jeu de données | Partitionnement aléatoire stratifié (70 % entraînement, 15 % validation, 15 % test) à l'aide d'une graine aléatoire fixe de 42 |
| Stratégie d'échantillonnage des styles | Un échantillonnage proportionnel stratifié a été utilisé afin de préserver la distribution des 27 styles artistiques dans les sous-ensembles d'entraînement, de validation et de test |
| Utilisation dans cette étude | Apprentissage du style artistique, représentation des styles et synthèse artistique guidée par segmentation |
Tableau 2 : Caractéristiques du jeu de données WikiArt. Résumé du jeu de données WikiArt utilisé pour l'apprentissage du style artistique et la synthèse d'images guidée par le style. Le tableau décrit la source du jeu de données, la répartition des images, la couverture des styles artistiques, la partition du jeu de données, la résolution des images et son application dans le cadre proposé SegCycle-SPADE.
Le jeu de données Miao Batik contient 15 148 images représentant des motifs culturels traditionnels Miao. Ce jeu de données est accessible publiquement via Zenodo (https://doi.org/10.5281/zenodo.20807658). Avant l'entraînement du modèle, toutes les images ont été inspectées visuellement, redimensionnées à 256 × 256 pixels, normalisées et examinées afin d'identifier les échantillons corrompus ou en double. Le contrôle qualité n'a conduit à l'exclusion d'aucune image ; par conséquent, les 15 148 images ont été conservées pour les analyses ultérieures. Le jeu de données a été divisé aléatoirement en sous-ensembles d'entraînement (70 %), de validation (15 %) et de test (15 %), en utilisant une graine aléatoire fixée à 42 afin d'assurer la reproductibilité des partitions. Le jeu de données WikiArt a été obtenu à partir du dépôt officiel WikiArt (https://www.wikiart.org/) et contient plus de 80 000 œuvres d'art couvrant 27 styles artistiques. Pour les expériences d'apprentissage de style, 56 000 images ont été utilisées pour l'entraînement, 12 000 pour la validation et 12 000 pour les tests.
Prétraitement des données
Avant l'entraînement du cadre SegCycle-SPADE proposé, le jeu de données de motifs culturels du batik Miao et le jeu de données WikiArt ont subi plusieurs étapes de prétraitement afin d'assurer une qualité d'image cohérente et une représentation précise des caractéristiques. Le même pipeline de prétraitement fondamental, comprenant la suppression du bruit par filtre gaussien, la normalisation, le redimensionnement à une résolution d'entrée uniforme et la vérification de la qualité des images, a été appliqué aux deux jeux de données. Toutefois, les jeux de données ont joué des rôles distincts au sein du cadre. Le jeu de données WikiArt a été utilisé pour l'apprentissage et la synthèse de styles artistiques, tandis que le jeu de données de batik Miao a été principalement utilisé pour la segmentation et la reconstruction des motifs culturels. Aucune modification spécifique aux jeux de données n'a été apportée au-delà de ces rôles liés aux tâches. Afin d'assurer un traitement cohérent par le modèle d'apprentissage profond, les images ont d'abord été redimensionnées à une résolution fixe. Cette étape était nécessaire car les images des deux jeux de données présentaient des résolutions variables selon leur source. Le redimensionnement a amélioré l'efficacité computationnelle et a empêché les incohérences dimensionnelles d'affecter l'entraînement. La deuxième étape de prétraitement a été la normalisation, au cours de laquelle les valeurs des pixels ont été ramenées à une plage standardisée afin de stabiliser les mises à jour de gradient pendant l'entraînement. Les images ont ensuite été traitées à l'aide d'un filtrage gaussien pour réduire le bruit susceptible d'interférer avec les structures des motifs culturels. Pour le jeu de données de batik Miao, les masques existants de segmentation des motifs culturels, obtenus directement à partir de la source d'origine du jeu de données, ont été utilisés sans modification pour l'entraînement et l'évaluation de la segmentation sémantique. Aucun nouveau masque de segmentation n'a été généré spécifiquement pour cette étude.
Sauf indication contraire, les équations décrivant les méthodes établies ont été adaptées d'études antérieures et sont citées en conséquence. Les équations décrivant le CAFFM proposé et le cadre d'optimisation composite SegCycle-SPADE ont été élaborées par les auteurs pour cette étude.
Soit une image d'entrée provenant du jeu de données représentée par Équation 1 :
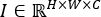 (1)
Ici, H, W et C désignent respectivement la hauteur, la largeur et le nombre de canaux de couleur de l'image. Toutes les images sont redimensionnées à une dimension fixe H′ × W′, comme indiqué dans l'équation 2 :
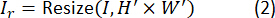
Ici, Ir est l'image redimensionnée. Les valeurs normalisées des pixels sont calculées selon l'équation 3 :
 (3)
Cela permet de stabiliser la procédure d'apprentissage. Le filtrage du bruit est effectué à l'aide d'un filtre gaussien, comme indiqué dans l'équation 4 :
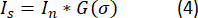
Ici, G(σ) est un filtre gaussien et * représente une convolution. Un filtre gaussien à noyau 5 × 5 avec un écart type de σ = 1.0 a été utilisé. Un remplissage réfléchi a été appliqué aux pixels des bords afin de réduire les artefacts de bord. Avant la mise à l'échelle et la normalisation, le processus de suppression du bruit a été effectué immédiatement après le chargement de l'image. Afin de garantir un prétraitement uniforme tout au long de l'étude, la même configuration de filtre a été appliquée à chaque image des jeux de données Miao Batik et WikiArt. Pour le jeu de données Miao Batik, les masques de segmentation sont créés selon l'équation 5 :

Ici, M est un masque de segmentation utilisé pour guider le modèle SegFormer.
Le pipeline de prétraitement commence par l'acquisition d'images à partir des ensembles de données Miao Batik et WikiArt, comme illustré dans la Figure 3. Aucune technique d'augmentation des données n'a été utilisée durant l'entraînement. Après le prétraitement, qui comprenait le redimensionnement, la normalisation, le débruitage gaussien et la préparation des masques de segmentation, les images ont été directement utilisées pour l'entraînement, la validation et les tests du cadre SegCycle-SPADE proposé. La première étape du pipeline de prétraitement consiste à redimensionner les images à une taille fixe, permettant au modèle d'apprentissage profond de les traiter plus efficacement. La deuxième étape concerne la normalisation, qui convertit les valeurs des pixels en une plage numérique standardisée et facilite la convergence du modèle. La troisième étape implique la suppression du bruit, au cours de laquelle les images sont débarrassées des perturbations indésirables afin d'améliorer la reconnaissance des motifs. En outre, pour l'ensemble de données Miao Batik, les régions des motifs culturels sont annotées, permettant ainsi la génération de masques utilisés dans le module de segmentation du modèle proposé, garantissant ainsi la préservation des motifs culturels durant la génération. Le résultat final de cette étape est un jeu de données nettoyé, prêt à être utilisé pour l'entraînement des modules de segmentation et de génération du modèle proposé.
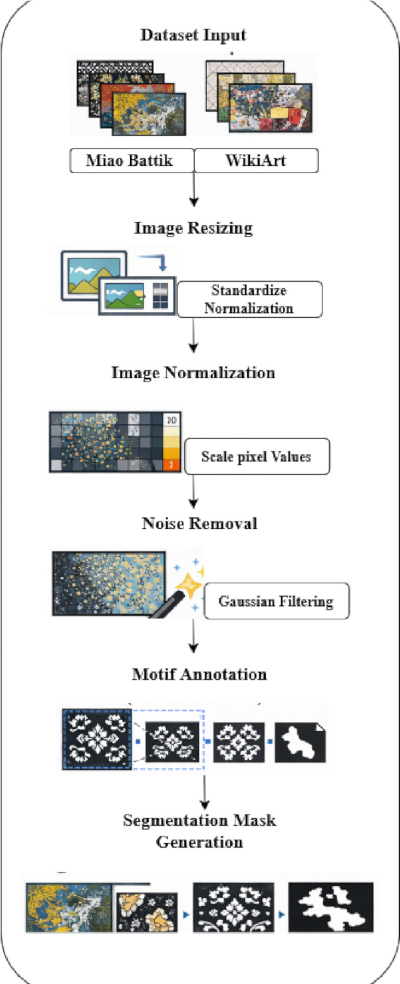
Figure 3. Pipeline de prétraitement des images pour le patrimoine culturel. Flux de travail illustrant les procédures de prétraitement des images appliquées avant l'entraînement du modèle. Le pipeline comprend l'acquisition du jeu de données, le redimensionnement des images, la normalisation, le débruitage gaussien, les annotations existantes des motifs culturels et la préparation des masques de segmentation. Les images et masques traités résultants sont utilisés comme entrées pour la segmentation sémantique et la reconstruction des motifs. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Chaque image a fait l'objet d'un processus de contrôle de qualité avant l'entraînement du modèle. Le jeu de données Miao Batik contenait 15 148 images. Les échantillons corrompus, en double et de faible qualité avaient déjà été traités par les créateurs du jeu de données d'origine ; par conséquent, aucune image supplémentaire n'a été exclue lors du contrôle de qualité dans cette étude. En conséquence, les 15 148 images ont été conservées pour l'analyse. Les images ont été chargées au format RVB lors du prétraitement et redimensionnées à 256 × 256 pixels à l'aide d'une interpolation bilinéaire. Les valeurs des pixels ont été ramenées de l'intervalle [0, 255] à [0, 1] en divisant par 255. Une normalisation par canal a ensuite été appliquée en utilisant des valeurs moyennes de [0,485, 0,456, 0,406] et des écarts types de [0,229, 0,224, 0,225] respectivement pour les canaux rouge, vert et bleu. Le pipeline de prétraitement comprenait le chargement des images, la conversion en RVB, le redimensionnement, la mise à l'échelle des valeurs des pixels, la normalisation et la conversion en tenseur. Lorsque cela était nécessaire, les images en niveaux de gris étaient converties au format RVB à trois canaux afin de garantir la compatibilité avec les modèles d'apprentissage profond. Après prétraitement, les images ont été réparties en sous-ensembles d'entraînement, de validation et de test. Toutes les étapes du cadre SegCycle-SPADE — y compris la segmentation sémantique, la fusion de caractéristiques, la reconstruction de motifs et la synthèse artistique basée sur SPADE — ont utilisé une résolution d'entrée constante de 256 × 256 pixels.
Segmentation sémantique par SegFormer
Après cette étape de prétraitement, les images nettoyées et normalisées du jeu de données des motifs culturels du batik miao et du jeu de données WikiArt sont intégrées au module de segmentation sémantique basé sur l'architecture proposée de SegFormer-B2. L'objectif de cette étape est d'identifier correctement et de séparer les motifs culturels présents dans les motifs patrimoniaux. Le cadre proposé de SegFormer repose sur une architecture de type transformeur, intégrant un encodeur transformeur hiérarchique et un décodeur MLP léger afin de capturer précisément l'information contextuelle globale ainsi que les détails structurels des motifs patrimoniaux complexes. Le modèle extrait d'abord des représentations de caractéristiques à plusieurs échelles à partir de l'image d'entrée, puis fusionne ces représentations via le décodeur pour produire des motifs segmentés précis. Cela garantit que les motifs présents dans l'image patrimoniale sont correctement segmentés en éléments tels que des motifs géométriques, floraux ou symboliques, en les dissociant du fond tout en préservant leur intégrité structurelle. Ces informations structurelles sont ensuite utilisées lors des étapes ultérieures de génération des motifs dans le cadre SegCycle-SPADE.
Soit l'image d'entrée prétraitée représentée par Équation 6 :
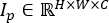 (6)
L'encodeur SegFormer divise l'image en fragments et extrait des caractéristiques hiérarchiques à l'aide de couches de transformation, comme indiqué dans l'équation 71 :
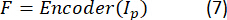
Ici, F désigne les cartes de caractéristiques multi-échelles obtenues à partir de l'encodeur de transformation. Ces caractéristiques codent à la fois les motifs de texture locaux et les relations contextuelles globales entre les régions de motifs. Le modèle SegFormer extrait des cartes de caractéristiques à différentes échelles, tel que défini dans l'équation 8 :
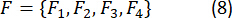
L'utilisation de représentations multiscales facilite la détection de motifs de différentes tailles au sein des motifs culturels. Enfin, les caractéristiques sont combinées à l'aide du décodeur MLP comme indiqué dans l'équation 91 :
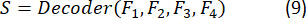
Ici, S désigne la carte de segmentation prédite finale.
Le squelette SegFormer-B2 a été initialisé à l'aide de poids préentraînés sur ImageNet, puis affiné sur le jeu de données Miao Batik pour la segmentation de motifs culturels. Le point de contrôle préentraîné a été obtenu à partir de l'implémentation officielle de SegFormer. Plus précisément, le point de contrôle MIT-B2 préentraîné sur ImageNet-1K (mit_b2.pth), fourni par le dépôt officiel de SegFormer, a été utilisé pour initialiser le squelette SegFormer-B2 avant l'affinage. Les poids préentraînés correspondent au squelette MIT-B2 publié par les auteurs de SegFormer et ont servi de modèle d'initialisation pour l'entraînement à la segmentation sémantique. Les couches restantes spécifiques à la tâche ont été initialisées à l'aide des procédures par défaut d'initialisation des poids de PyTorch avant l'entraînement.
Un encodeur Transformer hiérarchique à quatre étapes utilisant des incorporations de fragments superposés est employé dans l'architecture. À la première étape, la taille des fragments a été fixée à 7 × 7 avec un pas de 4. Pour chacune des quatre étapes de l'encodeur, les dimensions d'incorporation étaient respectivement de 64, 128, 320 et 512. Sur l'ensemble des quatre étapes, on comptait 1, 2, 5 et 8 têtes d'auto-attention multi-têtes, et les profondeurs correspondantes de l'encodeur étaient de 3, 4, 6 et 3 couches. Les caractéristiques multi-échelles extraites par l'encodeur ont été agrégées à l'aide d'un décodeur entièrement basé sur des perceptrons multicouches (MLP) léger. Avant de produire la carte de segmentation finale, le décodeur a projeté les caractéristiques issues de chaque étape de l'encodeur vers un espace d'incorporation unique. Tous les blocs Transformer ont utilisé la fonction d'activation appelée unité linéaire d'erreur gaussienne (GELU). Un taux de dropout de 0,1 a été appliqué durant l'apprentissage afin d'améliorer la généralisation et de réduire le surapprentissage.
Durant la phase d'entraînement, le cadre SegFormer reçoit les images prétraitées provenant des deux jeux de données. Les images du jeu de données Miao Batik contiennent des régions de motifs qui servent d'étiquettes pour l'apprentissage supervisé du modèle de segmentation. L'encodeur Transformer traite l'image entière et capture les relations à longue portée entre les composants de l'image, ce qui est particulièrement important pour les motifs traditionnels de batik comportant des motifs répartis spatialement. Le mécanisme d'extraction hiérarchique des caractéristiques capture simultanément les structures locales, telles que les textures géométriques répétées. Le décodeur MLP traite ces caractéristiques extraites et produit un masque de segmentation mettant en évidence les régions de motifs. Les cartes de segmentation générées à cette étape sont ensuite utilisées comme entrées structurelles pour le module d'attention et l'étape de reconstruction du motif, contribuant ainsi à préserver l'authenticité des motifs générés.
Les motifs culturels ont été divisés en différentes classes pour la segmentation sémantique en fonction de leurs caractéristiques visuelles et culturelles. La taxonomie de segmentation comprenait des motifs animaux (par exemple, papillons, poissons, oiseaux et autres faunes symboliques), des motifs végétaux (par exemple, fleurs, feuilles, vignes et motifs botaniques), des motifs géométriques (par exemple, formes répétées, bordures et structures géométriques abstraites), ainsi que des régions d'arrière-plan représentant les zones sans motif. Des masques de segmentation au niveau des pixels ont été utilisés pour attribuer chaque pixel à l'une des classes prédéfinies. Les étiquettes entières ont été codées comme suit : Étiquette 0 = arrière-plan, Étiquette 1 = motifs animaux, Étiquette 2 = motifs végétaux, et Étiquette 3 = motifs géométriques. Les annotations de segmentation et les étiquettes de motifs ont été obtenues directement à partir de la source du jeu de données original Miao Batik. Aucune annotation manuelle supplémentaire, aucun reclassement, aucune vérification des limites ni aucune procédure de confirmation par un expert n'ont été effectués dans cette étude. Les annotations existantes fournies par les créateurs du jeu de données ont été utilisées sans modification pour l'entraînement et l'évaluation.
Le modèle SegFormer pour la segmentation de motifs culturels traite les images prétraitées des ensembles de données Miao Batik et WikiArt à l'aide d'un mécanisme basé sur les transformeurs afin de détecter avec précision les régions de motifs culturels, comme illustré dans la Figure 4. Tout d'abord, l'image d'entrée contenant des motifs culturels traditionnels est fournie au modèle SegFormer. L'encodeur de transformeur extrait à la fois des informations contextuelles globales et des caractéristiques structurelles locales à partir de fragments d'image. Les caractéristiques multi-échelles résultantes sont transmises au décodeur de segmentation, qui utilise un réseau feed-forward mixte pour affiner les représentations des caractéristiques et améliorer la détection des motifs. La sortie du modèle SegFormer est une carte de segmentation qui met en évidence les pixels correspondant aux motifs culturels tout en supprimant les informations de fond non pertinentes. Les motifs culturels isolés servent ensuite de guide structurel pour les étapes suivantes du cadre SegCycle-SPADE.
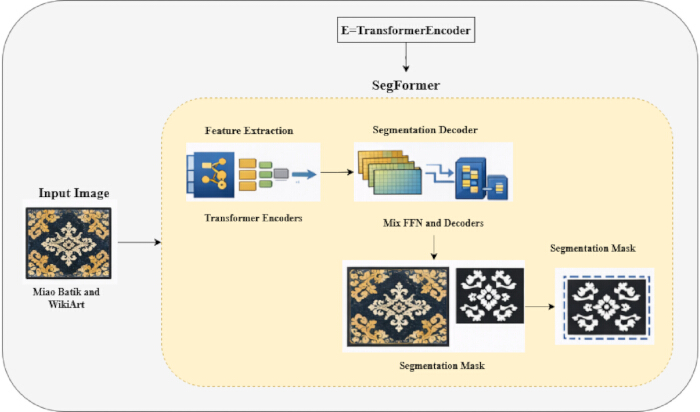
Figure 4. Segmentation sémantique basée sur SegFormer-B2 de motifs culturels. Architecture du module de segmentation sémantique SegFormer-B2 utilisé pour l'extraction de motifs culturels et entraîné exclusivement sur le jeu de données Miao Batik. Ce cadre comprend un encodeur basé sur un transformeur permettant l'extraction de caractéristiques multi-échelles et un décodeur de segmentation léger pour générer des masques de motifs. Le modèle prédit quatre classes sémantiques — animal, végétal, géométrique et fond — où les masques de segmentation obtenus identifient des régions de motifs culturellement significatives tout en supprimant les informations de fond non pertinentes. Ces résultats de segmentation fournissent une orientation structurelle pour les étapes ultérieures de fusion de caractéristiques, de reconstruction et de synthèse artistique du cadre proposé SegCycle-SPADE. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Il n'est pas nécessaire de créer de nouvelles annotations de segmentation dans le cadre proposé. Le jeu de données Miao Batik a été obtenu à partir d'une source publique déjà existante, et le modèle a été entraîné en utilisant les informations relatives aux motifs fournies par les créateurs du jeu de données. Au cours du processus d'apprentissage, le modèle SegFormer a produit des cartes de segmentation sémantique. Par conséquent, la présente étude n'a nécessité aucun logiciel d'annotation manuelle supplémentaire, aucune directive d'annotation ni aucune procédure de contrôle qualité des annotations.
CAFFM
Afin d'améliorer l'interaction entre les caractéristiques de la segmentation sémantique et les représentations de la reconstruction générative, l'étude a également proposé un module CAFFM. L'encodeur SegFormer-B2 fournit des cartes de caractéristiques sémantiques au module CAFFM, tandis que l'étape de reconstruction CycleGAN fournit des cartes de caractéristiques génératives. Tout d'abord, des couches de projection linéaire sont utilisées pour projeter les deux flux de caractéristiques dans un espace d'intégration commun. Pour le calcul de l'attention croisée, des représentations de requête (Q), de clé (K) et de valeur (V) sont créées à partir des tenseurs de caractéristiques générés. Les relations entre les informations des motifs structurels et les éléments de style artistique sont ensuite modélisées à l'aide d'une attention croisée multi-têtes. Une normalisation par couche, des connexions résiduelles et des couches feed-forward avec activation GELU sont ensuite appliquées aux représentations de caractéristiques fusionnées. Le résultat du module CAFFM est transmis à l'étape de synthèse basée sur SPADE, permettant ainsi de préserver des thèmes culturellement significatifs sans nuire à la cohérence artistique.
Pour garantir la compatibilité des caractéristiques, les caractéristiques d'entrée sont d'abord projetées à l'aide de couches de projection linéaire dans un espace d'incorporation partagé dont la dimension est de 256. Les interconnexions entre les informations structurelles sémantiques et les représentations stylistiques génératives sont ensuite modélisées à l'aide d'un mécanisme d'attention croisée multi-têtes (MultiHead Cross-Attention) comportant huit têtes d'attention. Le calcul de l'attention croisée utilise les vecteurs Requête (Q), Clé (K) et Valeur (V), qui sont produits par des couches spécifiques de transformation linéaire. Afin d'améliorer la stabilité de l'apprentissage et de préserver l'intégrité des caractéristiques, des connexions résiduelles et une normalisation par couche (Layer Normalization) sont utilisées pour renforcer davantage les représentations de caractéristiques fusionnées. L'apprentissage non linéaire des caractéristiques est ensuite amélioré par l'application d'un réseau feed-forward utilisant la fonction d'activation Gaussian Error Linear Unit (GELU). Une représentation de caractéristique de sortie de dimension 256 est générée par le module et transmise à d'autres étapes pour la synthèse créative. Le CAFFM combine avec succès les données de style artistique et les structures de motifs culturels grâce à une technique de fusion basée sur l'attention croisée, ce qui améliore la préservation des motifs et la cohérence visuelle dans les motifs patrimoniaux reconstruits.
Dans le système proposé, les caractéristiques structurelles sont extraites à partir du jeu de données Miao Batik, tandis que les caractéristiques stylistiques sont apprises à partir du jeu de données WikiArt. Soit Fs la carte de caractéristiques obtenue à partir du réseau de segmentation SegFormer en utilisant des images du jeu de données Miao Batik, et Fa la carte de caractéristiques issue de la branche d'extraction des caractéristiques stylistiques utilisant des images WikiArt. Le CAFFM proposé combine les deux domaines de caractéristiques à l'aide d'un mécanisme d'attention croisée afin d'apprendre les dépendances structurelles et stylistiques des motifs culturels. Tableau 3 présente toutes les caractéristiques architecturales, notamment les dimensions des plongements, les couches de normalisation, les fonctions d'activation et la configuration des têtes d'attention. Pour une taille d'image d'entrée de 256 × 256 pixels, l'encodeur SegFormer-B2 produit des cartes de caractéristiques sémantiques de taille 64 × 64 × 128, tandis que la branche d'extraction des caractéristiques stylistiques produit des cartes de caractéristiques de taille 64 × 64 × 128. Les deux cartes de caractéristiques sont projetées, au moyen de couches linéaires apprenables, dans un espace de plongement commun de dimension 256 avant la fusion par attention croisée.
| Paramètre | Configuration |
| Cadre proposé | SegCycle-SPADE |
| Modèle de segmentation sémantique | SegFormer-B2 |
| Étapes de l'encodeur SegFormer | 4 |
| Initialisation des poids | SegFormer-B2 pré-entraîné sur ImageNet-1K (architecture MIT-B2) |
| Source du point de contrôle (checkpoint) | Référentiel officiel NVIDIA SegFormer (https://github.com/NVlabs/SegFormer); point de contrôle : segformer.b2.512x512.ade.160k |
| Stratégie de réglage fin | Réglage fin de bout en bout sur le jeu de données Miao Batik |
| Taille de l'embedding de patch | 7 × 7 |
| Pas de décalage des patchs (patch stride) | 4 |
| Dimensions des embeddings | 64, 128, 320 et 512 |
| Profondeurs de l'encodeur | 3, 4, 6 et 3 |
| Nombre de têtes d'attention | 1, 2, 5 et 8 |
| Type de décodeur | Décodeur entièrement basé sur des perceptrons multicouches (All-MLP Decoder) |
| Fonction d'activation | GELU |
| Taux de dropout | 0,1 |
| Module d'amélioration des caractéristiques | Module de fusion de caractéristiques culturelles par attention croisée (CAFFM) |
| Dimension d'embedding du CAFFM | 256 |
| Nombre de têtes d'attention du CAFFM | 8 |
| Échelles de fusion du CAFFM | 4 |
| Modèle de reconstruction | CycleGAN |
| Modèle de génération de style | SPADE |
| Jeu de données culturel | Jeu de données Miao Batik |
| Jeu de données de style | Jeu de données WikiArt |
| Nombre d'images Miao Batik | 15 148 |
| Nombre d'images WikiArt | Environ 80 000 |
| Résolution des images d'entrée | 256 × 256 pixels |
| Format de couleur | RVB (RGB) |
| Méthode d'interpolation | Interpolation bilinéaire |
| Méthode de débruitage | Filtrage gaussien |
| Taille du noyau gaussien | 5 × 5 |
| Écart type gaussien (σ) | 1 |
| Plage de normalisation | [0, 1] |
| Taille du lot (batch size) | 16 |
| Nombre d'époques | 100 |
| Optimiseur | Adam |
| Taux d'apprentissage | 0,0002 |
| Paramètres d'Adam | β₁ = 0,5, β₂ = 0,999, ε = 1 × 10⁻⁸, décroissance du poids = 0 |
| Fonctions de perte | Perte de segmentation, perte antagoniste (adversarial loss), perte de cohérence cyclique, perte de reconstruction, perte de préservation des motifs et perte de cohérence de style |
| Stratégie de division du jeu de données | Entraînement / Validation / Test |
| Jeu d'entraînement | 70 % |
| Jeu de validation | 15 % |
| Jeu de test | 15 % |
| Graine aléatoire (random seed) | 42 |
| Métriques d'évaluation | Précision de segmentation, IoU, coefficient de Dice, SSIM, PSNR et FID |
| Langage de programmation | Python 3.8.10 |
| Framework d'apprentissage profond | PyTorch 1.10.0 |
| Plateforme matérielle | GPU NVIDIA RTX 3090 (24 Go de mémoire vidéo), processeur Intel Core i7 (11e génération), 32 Go de RAM |
| Environnement d'exploitation | Ubuntu 20.04 LTS |
Tableau 3 : Configuration expérimentale et modèle. Résumé des composants architecturaux, de la configuration d'apprentissage, des paramètres de prétraitement, des ensembles de données, des paramètres d'optimisation, des métriques d'évaluation et de l'environnement informatique utilisés pour la mise en œuvre et l'évaluation du cadre SegCycle-SPADE proposé.
Le module d'attention mappe d'abord la carte de caractéristiques en représentations de requête, de clé et de valeur à l'aide de l'équation 10 :
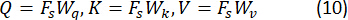
Ici, Wq, Wk et Wv sont des matrices de poids ajustables. Les poids d'attention sont calculés en fonction de la similarité entre le vecteur requête et le vecteur clé à l'aide de l'équation 1117 :
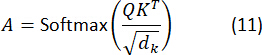
Ici, dk est la dimension du vecteur de clé. La représentation améliorée des caractéristiques est calculée en multipliant les poids d'attention par la matrice des valeurs à l'aide de l'équation 12 :
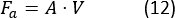
Ici, Fa est la représentation améliorée de la carte de caractéristiques. Cette représentation améliorée est calculée en combinant les caractéristiques de segmentation d'origine avec les caractéristiques améliorées obtenues à l'aide du mécanisme d'attention en utilisant l'équation 13 :
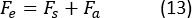
Ici, Fe est la carte de caractéristiques améliorée utilisée pour la reconstruction du motif. Le CAFFM est étendu par un mécanisme d'attention croisée multi-échelle afin d'extraire des caractéristiques pour les motifs culturels à différentes échelles. Soit Fsi les caractéristiques de segmentation à l'échelle i, tandis que Faj désigne les caractéristiques de style artistique à la même échelle. La représentation finale des caractéristiques est définie à l'aide de l'équation 14 :
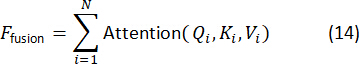
Ici, Qi, Ki et Vi représentent respectivement les matrices de requête, de clé et de valeur à l'échelle i, et N désigne le nombre d'échelles de caractéristiques. Dans cette étude, N = 4, ce qui correspond aux cartes de caractéristiques extraites à des résolutions spatiales de 1/4, 1/8, 1/16 et 1/32 de la taille de l'image d'entrée. Ces représentations de caractéristiques multi-échelles ont été fusionnées à l'aide de poids d'attention apprenables avant la reconstruction et la synthèse artistique. Cette extension permet à la méthode d'extraire des motifs culturels globaux et des textures afin de reconstruire des motifs culturels. CAFFM est placé entre l'étape de segmentation basée sur SegFormer et l'étape de synthèse créative basée sur SPADE dans le système SegCycle-SPADE proposé. Premièrement, tandis que CycleGAN crée simultanément des caractéristiques de reconstruction contenant des informations stylistiques et liées aux motifs, SegFormer-B2 récupère des cartes de caractéristiques sémantiques décrivant les propriétés structurelles des motifs culturels. Le module CAFFM reçoit ces deux flux de caractéristiques et utilise une fusion basée sur l'attention croisée pour identifier les relations entre les représentations structurelles et artistiques. Afin de créer des motifs culturellement authentiques tout en préservant la cohérence sémantique et les caractéristiques structurelles, les cartes de caractéristiques fusionnées résultantes sont ensuite transmises au module SPADE pour une synthèse créative guidée par segmentation.
Reconstruction de motifs à l'aide de CycleGAN
Une fois l'étape d'amélioration des caractéristiques basée sur l'attention terminée, les cartes de caractéristiques contiendront les structures de motifs culturels améliorées. Toutefois, ces cartes peuvent encore présenter des régions de motifs incomplètes ou endommagées. Ainsi, afin de résoudre le problème de la reconstruction des motifs, le cadre proposé utilisera le modèle CycleGAN. Dans ce cadre, les deux domaines seront les motifs culturels d'origine et les motifs culturels reconstruits. À l’aide des caractéristiques améliorées issues des étapes précédentes, le modèle CycleGAN reconstruira les motifs culturels tout en préservant la cohérence structurelle. Cela garantira que les motifs culturels, tels que les motifs géométriques, floraux et symboliques, conservent leur disposition spatiale. Les images originales de batik Miao ont subi des opérations aléatoires de masquage et d'occlusion partielle afin de générer des motifs culturels incomplets ou endommagés. Ces procédés de dégradation simulent des régions de motifs manquantes et des dommages structurels fréquemment observés sur les artefacts du patrimoine culturel dégradés. Les images dégradées ont été utilisées comme entrées du module de reconstruction, tandis que les images originales correspondantes ont servi d'images de référence pour l'évaluation des performances et l'analyse de la qualité de reconstruction. Cette stratégie a permis au modèle d'apprendre à restaurer les structures de motifs manquants tout en préservant la cohérence sémantique et les caractéristiques culturelles.
Soit X le domaine des motifs culturels incomplets et Y le domaine des motifs culturels reconstruits. Les deux générateurs apprennent à effectuer une correspondance bidirectionnelle à l'aide de l'équation 15 :
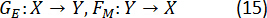
Ici, GE est utilisé pour reconstruire les structures de motifs et FM sert à replacer les motifs dans le domaine d'origine. La perte antagoniste permet de garantir que les motifs reconstruits soient réalistes (Équation 16)30
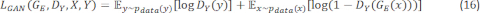
Ici, DY est le discriminateur utilisé pour distinguer les motifs réels des motifs reconstruits, et GE(x) désigne le motif reconstruit généré. CycleGAN impose également une cohérence cyclique afin de préserver la disposition structurelle des motifs culturels (Équation 17)30.
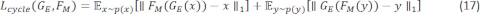
La fonction de perte finale est définie à l'aide de l'équation 1830 :
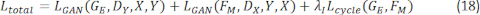
Ici, λi désigne le coefficient de pondération pour la perte de cohérence cyclique et a été fixé à 10 pendant l'apprentissage, conformément à la formulation initiale de CycleGAN. Cette valeur a été choisie afin d'équilibrer l'apprentissage antagoniste et la cohérence de reconstruction entre les domaines source et cible.
Le module de reconstruction CycleGAN comprend deux générateurs et deux discriminateurs pour la traduction bidirectionnelle d'images. Chaque générateur suit une architecture de réseau résiduel composée d'une couche de convolution initiale 7 × 7, suivie de deux couches de convolution de sous-échantillonnage, de neuf blocs résiduels et de deux couches de sur-échantillonnage. Toutes les opérations de convolution utilisent une taille de noyau de 3 × 3, à l'exception de la couche d'entrée, qui utilise un noyau 7 × 7 pour une extraction améliorée des caractéristiques. Une normalisation d'instance est appliquée après chaque couche de convolution afin d'améliorer la stabilité de l'apprentissage, tandis qu'une activation ReLU est utilisée dans tout le réseau du générateur. La couche de sortie utilise une fonction d'activation Tanh pour produire des sorties d'images normalisées. Le discriminateur suit une architecture PatchGAN 70 × 70 composée d'une série de couches convolutives avec des tailles de noyau de 4 × 4 et des canaux de caractéristiques croissants progressivement. La normalisation d'instance et l'activation LeakyReLU (pente négative = 0,2) sont utilisées dans le discriminateur afin d'améliorer la discrimination des caractéristiques et l'apprentissage antagoniste. Le module CycleGAN reçoit en entrée des images de motifs culturels prétraitées et génère des représentations de motifs reconstruits, qui sont ensuite transmises au CAFFM pour intégration avec les caractéristiques de segmentation. L'entraînement du CycleGAN a été effectué à l'aide de l'optimiseur Adam (β₁ = 0,5, β₂ = 0,999) avec un taux d'apprentissage initial de 0,0002. Le taux d'apprentissage a été maintenu constant pendant les 100 premières époques, puis décroît linéairement jusqu'à zéro au cours de la période restante d'entraînement. Un tampon de relecture contenant 50 images précédemment générées a été utilisé pour stabiliser l'entraînement du discriminateur. Les générateurs et les discriminateurs ont été mis à jour selon un rapport de 1:1, une mise à jour du générateur étant suivie d'une mise à jour du discriminateur à chaque itération d'entraînement.
Le processus de reconstruction du CycleGAN repose sur les cartes de caractéristiques améliorées obtenues à l'aide du mécanisme CAFFM illustré dans la Figure 5. Les cartes de caractéristiques contiennent des motifs culturels renforcés issus des étapes précédentes de segmentation et de CAFFM. Ces cartes sont utilisées comme entrée pour le premier générateur GE. Le premier générateur GE apprend l'application nécessaire pour reconstruire les motifs culturels. Les sorties sont ensuite transmises au discriminateur DY afin de distinguer les motifs culturels réels des motifs reconstruits. Le discriminateur DY aide le générateur GE à produire des sorties réalistes. Afin de garantir que les motifs culturels ne soient pas déformés durant la reconstruction, le second générateur FM effectue une application de cycle-consistance. Le second générateur FM remappe les sorties vers le domaine d'origine. Les sorties sont ensuite évaluées par le discriminateur pour en assurer le réalisme. Les sorties finales sont ensuite transmises au module SPADE pour la génération de style artistique dans l'étape suivante du cadre SegCycle-SPADE proposé.
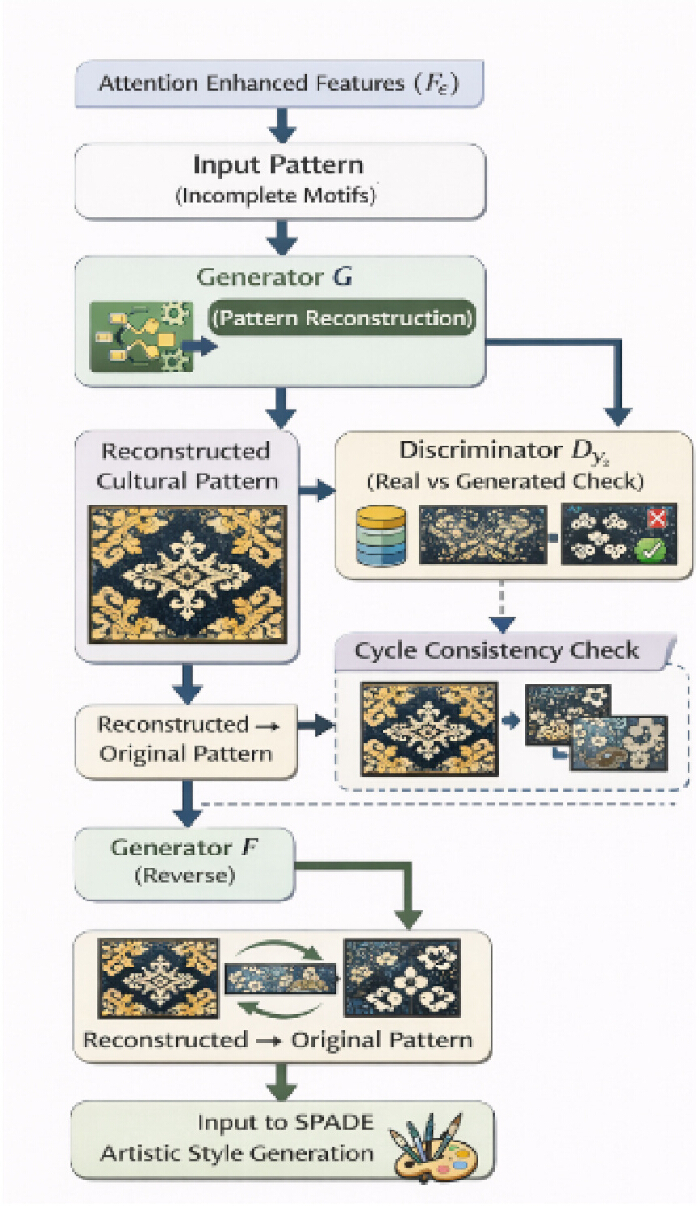
Figure 5. Flux de travail de reconstruction de motif basé sur CycleGAN. Flux de travail du module de reconstruction CycleGAN. Des représentations de caractéristiques améliorées par l'attention sont fournies en entrée du réseau générateur afin de reconstruire des motifs culturels incomplets. Le discriminateur évalue les sorties reconstruites par rapport aux motifs de référence, tandis que la correspondance de cohérence cyclique préserve l'intégrité structurelle lors de la traduction bidirectionnelle des images. Les motifs reconstruits sont ensuite transmis au module SPADE pour la synthèse de style artistique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Génération de style artistique à l'aide de SPADE
Par la suite, les motifs culturels reconstruits sont soumis au module SPADE pour la génération de style artistique. L'objectif principal du module SPADE est d'ajouter des textures visuellement riches de style artistique aux motifs culturels reconstruits sans compromettre la disposition structurelle des motifs. Le module SPADE est une technique de génération d'images conditionnelle qui utilise le concept de segmentation d'image pour la création d'images. Des cartes sémantiques multicanal correspondant aux classes de motifs prédéfinies ont été encodées à partir des masques de segmentation sémantique produits par SegFormer-B2. Le générateur SPADE a reçu ces cartes encodées comme entrées de conditionnement. Les paramètres d'échelle spatialement adaptative (γ) et de biais (β) ont été générés en traitant les cartes sémantiques à travers des couches de convolution dans chaque couche SPADE. Le générateur a ainsi pu préserver les limites des motifs, les structures spatiales et les informations sémantiques durant la synthèse artistique en appliquant ces paramètres aux activations normalisées des caractéristiques. Le guidage sémantique a pu influencer à la fois la reconstruction structurelle de haut niveau et la synthèse de textures de bas niveau, puisque le processus de conditionnement a été effectué à plusieurs couches du générateur SPADE. En conséquence, les motifs artistiques créés intègrent des traits stylistiques issus du jeu de données WikiArt tout en conservant les structures de motifs culturels identifiées lors de l'étape de segmentation.
L'ensemble de données WikiArt, qui comprend des œuvres provenant de 27 catégories artistiques différentes — telles que la Renaissance, l'impressionnisme, le cubisme, l'expressionnisme, le surréalisme, le réalisme et l'art abstrait — a été utilisé comme ressource principale pour comprendre les styles artistiques. Afin d'exposer le modèle à une variété de caractéristiques créatives et d'améliorer la généralisation du style, des images de style ont été sélectionnées aléatoirement parmi les différentes catégories durant l'entraînement. L'ensemble de données a été divisé en sous-ensembles d'entraînement, de validation et de test, avec une représentation équilibrée des catégories artistiques afin de réduire les biais de style. Un échantillonnage stratifié a été utilisé pour garantir une représentation équilibrée des 27 catégories artistiques. Les échantillons de chaque catégorie ont été répartis proportionnellement entre les sous-ensembles d'entraînement, de validation et de test, tout en préservant la distribution initiale des classes. Le module CAFFM a été utilisé pour fusionner les aspects de style extraits des images WikiArt avec les caractéristiques de reconstruction produites par CycleGAN. Afin de permettre au réseau de synthèse de transférer les qualités artistiques tout en conservant la structure sémantique et les limites des motifs culturels dérivés des cartes de segmentation, les représentations fusionnées résultantes ont été fournies comme information de conditionnement au générateur SPADE. Grâce à cette technique de conditionnement par le style, le cadre proposé a permis de produire des motifs artistiques culturellement authentiques, avec des représentations structurelles et stylistiques cohérentes.
SPADE introduit également des paramètres spatialement adaptatifs qui dépendent de la carte de segmentation. Les paramètres peuvent être définis comme indiqué dans l'équation 191 :
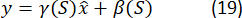
Ici, γ(S) est le paramètre d'échelle variant spatialement et β(S) est le paramètre de biais variant spatialement. Ces paramètres peuvent aider le générateur à créer différentes textures et styles en fonction de la région sémantique dans les images. L'œuvre d'art culturelle finale peut être définie comme indiqué dans l'équation 20 :
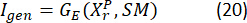
Ici, GE est le générateur SPADE, XrP est le motif reconstruit, et SM est la carte de segmentation. L'œuvre finale préserve l'intégrité structurelle des motifs culturels tout en améliorant l'apparence artistique. Une fonction de perte composite, équilibrant la précision de la segmentation sémantique, la préservation des motifs culturels, la qualité de reconstruction des motifs et la cohérence du style artistique, a été utilisée pour optimiser l'architecture SegCycle-SPADE proposée. Un mélange pondéré des pertes de segmentation (Lseg), adversaire (Ladv), de cycle-consistance (Lcycle), de reconstruction (Lrecon), de préservation des motifs (Lmotif) et de cohérence stylistique (Lstyle) a été employé pour définir l'objectif global d'apprentissage. La fonction de perte totale est définie dans l'équation 21 :
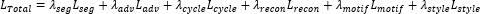 (21)
Afin de garantir une cohérence structurelle entre les motifs culturels d'entrée et reconstruits, le coefficient de perte de cycle de cohérence a été fixé à 10. Pour préserver les caractéristiques fines des motifs et améliorer la précision visuelle, le coefficient de perte de reconstruction a été défini à 5. Afin de mettre en évidence la préservation des structures de motifs culturellement essentielles durant la synthèse artistique, un coefficient de 2 a été utilisé pour la perte de préservation des motifs. Pour favoriser le transfert de style artistique sans déformer excessivement les structures sémantiques des motifs, le coefficient de perte de cohérence de style a été ajusté à 1. Afin de maintenir une contribution équilibrée entre la production d'images réalistes et la segmentation précise des motifs, des poids égaux ont été attribués aux pertes de segmentation et adversariale. Les représentations de style basées sur les caractéristiques du jeu de données WikiArt ont été utilisées pour calculer la perte de cohérence de style. En particulier, les traits de style artistique ont été capturés à l’aide de corrélations de matrices de Gram extraites de cartes de caractéristiques profondes. La différence de norme de Frobenius entre les matrices de Gram de l'image cible de style et de l'image générée a été utilisée pour calculer la perte de style, comme indiqué dans l'équation 22 :
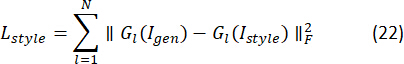
Ici, Gl est la matrice de Gram calculée à partir de la lème couche de caractéristiques, Igen désigne l'image artistique générée, Istyle désigne l'image de style cible issue du jeu de données WikiArt, et F désigne la norme de Frobenius. Cette formulation permet au cadre proposé de préserver les caractéristiques artistiques tout en maintenant l'intégrité structurelle et sémantique des motifs culturels.
Les représentations de caractéristiques fusionnées produites par le module CAFFM sont utilisées comme entrées de conditionnement pour le module SPADE, qui constitue le composant de synthèse artistique du cadre proposé. Le générateur SPADE comprend sept blocs résiduels SPADE avec une dimension de caractéristique latente de 256 canaux et génère des images de sortie avec une résolution de 256 × 256 pixels. Les cartes de segmentation sémantique obtenues à partir du module SegFormer–CAFFM sont utilisées comme entrées de conditionnement tout au long des couches résiduelles SPADE. Les couches SPADE sont appliquées avant les fonctions d'activation dans chaque bloc résiduel, permettant un conditionnement sémantique guidé par la segmentation. Grâce à des opérations successives de sur-échantillonnage et de convolution, la représentation latente des caractéristiques est progressivement affinée pour générer des motifs artistiques haute résolution tout en préservant la cohérence sémantique et la structure des motifs. Des fonctions d'activation LeakyReLU sont utilisées dans tout le générateur, et une fonction d'activation Tanh est appliquée à la couche de sortie pour produire des images normalisées.
Algorithme et flux de travail
Le cadre SegCycle-SPADE intègre la segmentation sémantique, la fusion de caractéristiques, la reconstruction de motifs et la synthèse de style artistique au sein d’un pipeline d’apprentissage unifié. Le flux de travail commence par l’acquisition et le prétraitement du jeu de données, incluant le redimensionnement des images, la normalisation, la suppression du bruit et la préparation des masques de segmentation. Les images prétraitées sont ensuite traitées à l’aide du réseau de segmentation SegFormer-B2 afin d’extraire des représentations sémantiques des motifs. Les caractéristiques de segmentation obtenues sont fusionnées avec les caractéristiques de reconstruction via le module CAFFM, permettant une interaction entre les informations structurales des motifs et les représentations des caractéristiques artistiques. Les cartes de caractéristiques fusionnées sont ensuite transmises au module de reconstruction CycleGAN, qui restaure les structures de motifs culturels incomplètes tout en préservant la cohérence sémantique. Les motifs reconstruits sont ensuite fournis au générateur SPADE pour une synthèse artistique guidée par la segmentation, permettant un enrichissement stylistique tout en conservant les limites des motifs et leur authenticité structurelle. Pendant l’apprentissage, les paramètres du modèle sont optimisés à l’aide de la fonction de perte composite décrite dans les équations 21 et 22, qui équilibre la précision de la segmentation, la préservation des motifs, la qualité de la reconstruction et la cohérence du style artistique. Un flux de mise en œuvre détaillé étape par étape, incluant le chargement du jeu de données, le prétraitement, l’initialisation du modèle, les itérations d’apprentissage, les procédures de validation, la sélection des points de contrôle et l’évaluation finale, est fourni dans le fichier supplémentaire 1 (algorithme 1). L’ensemble du flux de travail algorithmique a été implémenté avec une taille de lot de 16, un taux d’apprentissage de 0,0002 et 100 époques d’entraînement. Une graine aléatoire fixe de 42 a été utilisée pour la partition du jeu de données, l’initialisation du modèle et toutes les expériences d’apprentissage. Cette graine a été appliquée de manière cohérente aux générateurs de nombres aléatoires de Python, NumPy et PyTorch afin d’assurer la reproductibilité. L’optimiseur Adam a été configuré avec β₁ = 0,5, β₂ = 0,999, et sans décroissance du poids (weight decay = 0). Les points de contrôle du modèle ont été sélectionnés en fonction du score d’IoU de validation le plus élevé obtenu sur le jeu de données de validation.
Optimisation de la fonction de perte
Afin de préserver les structures des motifs culturels durant la reconstruction et la synthèse artistique, le cadre proposé utilise un objectif d'optimisation composite qui combine les pertes de segmentation, adversaire, de cohérence cyclique, de reconstruction, de préservation des motifs et de cohérence de style. La formulation mathématique complète, les coefficients de pondération et la définition de la perte de style sont fournies dans les équations 21 et 22 dans la sous-section Artistic Style Generation using SPADE. Le composant de préservation des motifs pénalise les écarts structurels entre les régions de motifs prédites et les masques de segmentation correspondants du jeu de référence, favorisant ainsi le maintien des structures de motifs culturellement significatives tout au long du processus de reconstruction.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Le cadre proposé SegCycle-SPADE a été évalué à l'aide de deux ensembles de données : l'ensemble de motifs culturels du batik Miao et l'ensemble de données WikiArt. L'ensemble de données du batik Miao contient des images du patrimoine culturel traditionnel et a été principalement utilisé pour des tâches de segmentation sémantique et de reconstruction structurelle, tandis que l'ensemble de données WikiArt contient des styles artistiques variés et a été utilisé pour l'apprentissage et la génération de styles artistiques. Le...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
La préservation et la reconstruction numérique des motifs du patrimoine culturel immatériel (ICH) suscitent un intérêt croissant ces dernières années en raison de la disparition progressive des savoir-faire traditionnels. Des études antérieures ont tenté de répondre à la perte du patrimoine culturel à l’aide de techniques de traitement d’image fondées sur l’apprentissage profond (DL). Par exemple, Quan et al.32 ont proposé un cadre de préservation du patrimoine culturel basé sur des graphes de con...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Conflit d'intérêts :
Les auteurs déclarent ne pas avoir d'intérêts concurrents.
Remerciements
Les auteurs reconnaissent le soutien académique et institutionnel fourni par le Guangdong Engineering Polytechnic et l'Université normale du Sud de la Chine pendant la réalisation de cette recherche. Cette recherche a été soutenue par le projet général du Fonds national des sciences sociales de 2023 (n° 23BH161), intitulé « Musée de régénération numérique : recherche sur la revitalisation et la communication des reliques culturelles chinoises classiques de calligraphie et de peinture ».
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Optimiseur Adam | Bibliothèque d'optimiseurs PyTorch | Adam | Algorithme d'optimisation utilisé pendant l'entraînement du modèle. |
| Kit d'outils CUDA | Société NVIDIA | CUDA 11.3 | Accélération GPU pour les calculs d'apprentissage profond. |
| cuDNN | Société NVIDIA | cuDNN 8.2 | Bibliothèque d'accélération de réseaux neuronaux profonds utilisée pour accélérer l'entraînement et l'inférence. |
| CycleGAN | Université de Californie à Berkeley / Open Source | Implémentation officielle PyTorch (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Réseau génératif antagoniste utilisé pour la reconstruction de motifs culturels. |
| Poids préentraînés ImageNet | ImageNet / Open Source | mit_b2.pth (point de contrôle préentraîné sur ImageNet-1K) | Utilisé pour initialiser le squelette SegFormer-B2 avant l'ajustement fin sur le jeu de données Miao Batik. |
| Processeur Intel | Société Intel | Intel Core i7 (11e génération) | Processeur utilisé pour le prétraitement des images, le soutien à l'entraînement du modèle et l'inférence. |
| Matplotlib | Équipe de développement de Matplotlib | Matplotlib 3.5.1 | Visualisation des courbes d'apprentissage et des résultats d'évaluation. |
| Jeu de données Miao Batik | Référentiel Zenodo | DOI : 10.5281/zenodo.20807658 | Jeu de données de motifs culturels contenant 15 148 images, utilisé pour la segmentation sémantique et la reconstruction de motifs. |
| NumPy | Développeurs de NumPy | NumPy 1.21.5 | Calcul numérique et traitement des jeux de données. |
| GPU NVIDIA | Société NVIDIA | NVIDIA RTX 3090 (24 Go de mémoire vidéo) | Plateforme matérielle utilisée pour l'entraînement et l'inférence du modèle. |
| OpenCV | Fondation OpenCV | OpenCV 4.5.5 | Prétraitement d'images, redimensionnement, interpolation et débruitage gaussien. |
| Système d'exploitation | Canonical Ltd. | Ubuntu 20.04 LTS | Environnement d'exécution expérimental. |
| Pillow (PIL) | Bibliothèque d'images Python | Pillow 8.4.0 | Chargement et manipulation d'images. |
| Python | Fondation Python | Python 3.8.10 | Langage de programmation utilisé pour l'implémentation et les expérimentations. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Framework d'apprentissage profond utilisé pour l'entraînement et l'inférence du modèle. |
| Graine aléatoire | Paramètre expérimental | 42 | Graine fixe utilisée pour la partition du jeu de données, l'initialisation du modèle et la reproductibilité expérimentale. |
| Scikit-learn | Développeurs de Scikit-learn | Scikit-learn 1.0.2 | Partitionnement des jeux de données, analyse statistique et métriques d'évaluation. |
| Seaborn | Communauté open source | Seaborn 0.11.2 | Visualisation de données statistiques. |
| SegFormer-B2 | Recherche NVIDIA / Open Source | SegFormer-B2 (squelette MIT-B2) | Modèle de segmentation sémantique basé sur les transformeurs, utilisé pour la segmentation de motifs culturels. |
| Masques / annotations de segmentation | Jeu de données Miao Batik | Inclus avec le jeu de données | Étiquettes de segmentation sémantique au niveau des pixels, utilisées pour la classification des motifs et l'entraînement. |
| SPADE | Recherche NVIDIA / Open Source | Implémentation officielle PyTorch (https://github.com/NVlabs/SPADE) | Modèle de synthèse d'images guidé par segmentation, utilisé pour la génération de motifs artistiques. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Utilitaires de traitement d'images et transformations de jeux de données utilisés avec PyTorch. |
| Jeu de données WikiArt | WikiArt | https://www.wikiart.org/ | Jeu de données de styles artistiques contenant plus de 80 000 œuvres réparties en 27 styles artistiques, utilisé pour l'apprentissage et la synthèse de styles. |
Références
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.