Ce protocole présente un cadre expérimental évolutif pour le jumelage médecin-patient sur les plateformes de consultation médicale en ligne. En intégrant conjointement la compatibilité clinique centrée sur le patient et la capacité de service côté médecin dans un modèle de notation hybride, cette méthode optimise la précision de l’appariement, minimise les temps d’attente des patients et assure une répartition équilibrée de la charge de travail des médecins.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Cadre expérimental pour l’appariement médecin-patient conscient de la compatibilité et de la capacité lors de consultations en ligne
Dans cet article
Résumé
Résumé
Les plateformes de consultation médicale en ligne à grande échelle nécessitent un appariement efficace, assisté par algorithmes, médecin-patient, pour équilibrer l’ajustement centré sur le patient et l’efficacité opérationnelle. Les approches existantes optimisent souvent indépendamment la compatibilité clinique ou la capacité des médecins, ce qui entraîne des délais d’attente prolongés et des charges de travail inégales. Ce protocole présente un cadre expérimental évolutif permettant d’intégrer conjointement compatibilité et capacité dans un score d’appariement hybride. À l’aide d’un ensemble de données simulé comprenant 240 médecins, 3 600 demandes de patients et 9 785 paires de candidats, la méthode quantifie la compatibilité (par exemple, alignement de la spécialité, ajustement des modes) et la capacité (par exemple, le rapport de charge, le temps d’attente estimé). Le cadre évalue les paires candidates via un score hybride et compare la performance aux stratégies de benchmark basées sur des règles, uniquement en compatibilité et uniquement en capacité sur 12 épreuves d’évaluation. Des résultats représentatifs démontrent que le cadre hybride atteint une qualité de correspondance supérieure, incluant une précision moyenne au rang 1 de 0,740 et un score F1 de 0,714. De plus, il offre une grande efficacité opérationnelle avec un taux de remplissage de capacité de 0,825 h et un temps d’attente moyen estimé court de 5,52 h. En maximisant la satisfaction moyenne des patients (4,43/5,00) et en minimisant le déséquilibre de charge (0,195), ce cadre fournit un protocole pratique pour un routage intelligent des consultations et une gestion de la plateforme.
Introduction
La consultation médicale en ligne est devenue un mode de prestation de soins de plus en plus important, étendant l’accès aux services médicaux au-delà des rencontres conventionnelles en faceà face 1. En Chine, l’expansion de la télémédecine sur Internet a été renforcée par l’élaboration de politiques, la croissance du marché et une intégration plus profonde avec le système de santé plus large, faisant de la consultation numérique un élément de plus en plus important de l’organisationde santé 2. Les preuves à grande échelle des hôpitaux en ligne indiquent en outre que les services de consultation en ligne fonctionnent désormais à grande échelle, fonctionnant comme une partie significative de la prestation de services de routine plutôt qu’un complément marginal3. Parallèlement, la télémédecine asynchrone a élargi le champ des soins à distance en permettant des modes d’interaction flexibles, améliorant l’accessibilité tout en augmentant simultanément la complexité opérationnelle des plateformes de consultationnumériques 4.
À mesure que ces plateformes s’étendent, leurs performances ne peuvent être jugées uniquement par la disponibilité technique. L’expérience du patient et la qualité du service sont devenues des résultats centraux de la prestation de soinsnumériques 5. Des recherches récentes ont montré que l’utilisation des systèmes de consultation en ligne est associée à des différences mesurables dans l’expérience des patients, notamment en ce qui concerne l’accès, la commodité et les processus derendez-vous 6. Cependant, la consultation numérique génère également une charge de travail supplémentaire pour les médecins, incluant la gestion des messages et le travail effectué en dehors des heures cliniques habituelles, ce qui fait de la gestion des capacités une préoccupation opérationnellecentrale 7. Ce défi est aggravé par la répartition inégale de la demande entre les médecins, car des indices visibles tels que les avis, les évaluations et d’autres informations de profil peuvent orienter le trafic des patients vers un sous-ensemble limité de médecins trèsvisibles. L’attribution médecin-patient sur les plateformes de consultation en ligne n’est donc pas seulement un problème de recherche côté patient, car les médecins peuvent également montrer des préférences de réponse sélective face à des demandes de consultationhétérogènes 9.
Du point de vue du patient, le choix de la consultation en ligne est intrinsèquement multidimensionnel. Les utilisateurs évaluent simultanément le temps d’attente, les qualifications des médecins, le niveau hospitalier, le mode de service et le coût de la consultation lors du choix des optionsde soins 10. En lien avec cette complexité, une revue systématique récente a conclu que les plateformes de consultation médicale en ligne nécessitent des mécanismes de recommandation capables de réduire la surcharge d’informations et d’aligner mieux les besoins des patients avec les ressources desmédecins 11. Les études méthodologiques ont donc commencé à introduire des approches d’appariement structurées, incluant un appariement stable dynamique sous informations incomplètes, afin d’améliorer l’allocation médecin-patient dans les environnements de consultationen ligne 12. Des recherches plus récentes sur les recommandations ont également souligné que le jumelage médecin-patient devrait améliorer l’efficacité de l’allocation tout en réduisant la concentration excessive de la demande autour de médecins très visibles issus des hôpitauxde premier plan 13. Les preuves de méthodes mixtes montrent une hétérogénéité substantielle des préférences en télémédecine, indiquant qu’une logique d’allocation universelle est peu susceptible d’être suffisante à l’échelle14 de la plateforme. Malgré ces avancées, la littérature existante tend à traiter les facteurs liés à la compatibilité et les contraintes de capacité des médecins comme des problèmes distincts, même si les plateformes de consultation en ligne doivent gérer simultanément l’adéquation relationnelle et l’absorbabilitédu service 11.
Pour combler cette lacune, cette méthode vise à établir un cadre expérimental évolutif pour l’appariement médecin-patient conscient de la compatibilité et de la capacité sur les plateformes de consultation médicale en ligne à grande échelle. La logique de cette technique est que l’optimisation isolée de la préférence clinique ou de la capacité de service du médecin conduit à des délais d’attente prolongés, à des charges de travail inégales et à des expériences de consultation sous-optimales. L’avantage principal de cette stratégie hybride par rapport aux techniques alternatives basées sur des règles ou à objectif unique est sa capacité à modéliser conjointement les besoins des patients, les caractéristiques des médecins et les contraintes dynamiques des services afin de maintenir un équilibre de charge de travail et une forte satisfactiondes patients 12. En détaillant la construction du score d’appariement hybride et du processus d’évaluation basé sur le pliage, ce protocole fournit une base pratique pour un routage intelligent de consultation. Les lecteurs peuvent utiliser ce cadre méthodologique pour déterminer si une logique de correspondance dualement consciente est appropriée pour optimiser le triage, l’allocation des ressources et la gestion des flux de travail dans leurs applications spécifiques de santé numérique.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
L’ensemble de données d’évaluation utilisé dans ce protocole a été simulé de façon computationnelle à partir de distributions opérationnelles agrégées et désidentifiées et ne contenait aucune donnée réelle ou identifiable de participants humains. Par conséquent, l’étude a été jugée exemptée d’un examen éthique complet par le Conseil d’Éthique Institutionnelle (IRB) de l’Université NingboTech (Exemption n° NT9918276).
1. Préparation des données et définition de la cohorte
- Constituez le vivier de médecins comprenant 240 médecins en ligne actifs répartis dans huit spécialités de consultation : médecine interne, cardiologie, neurologie, dermatologie, pédiatrie, gynécologie, orthopédie et psychiatrie.
- Extraire et définir les variables suivantes pour chaque dossier médical : spécialité, sexe, titre professionnel (Résident, Médecin Principal, Chef associé ou Chef), niveau hospitalier (Primaire, Secondaire ou Tertiaire), années de pratique, années d’expérience en consultation en ligne, frais de consultation, capacité nominale quotidienne de consultation, charge quotidienne actuelle, note historique, temps moyen de première réponse, taux d’acceptation historique, taux de suivi du service et mode de consultation soutenue (Texte, Texte plus voix, ou texte plus voix plus vidéo).
- Établissez le pool de demandes de patients contenant 3 600 demandes de consultation.
REMARQUE : Pour contextualiser la dimension temporelle de l’évaluation, ce pool est calibré pour représenter une période opérationnelle continue de 30 jours, couvrant à la fois les jours de semaine standard et les week-ends. Cette période est conçue pour capturer les variations cycliques courantes de la demande des patients tout en excluant explicitement les périodes atypiques extrêmes (par exemple, les grandes fêtes nationales ou les pics épidémiques) afin d’établir une base de référence stable et stable pour l’évaluation algorithmique de la performance. - Extraire et définir les variables suivantes pour chaque demande de patient : âge, sexe, spécialité cible, niveau de gravité (faible, modéré ou élevé), niveau d’urgence (routinière, urgent ou prioritaire), plafond budgétaire, sexe préféré du médecin (homme, femme ou sans préférence), mode de consultation préféré (texte, voix ou vidéo), visites antérieures sur plateforme, niveau d’engagement numérique, nombre de comorbidités, niveau de ville et période de contact préféré.
- Nettoyez le jeu de données en excluant tout dossier dont les valeurs manquantes sont dans la spécialité, les frais de consultation, la capacité quotidienne, la charge actuelle, le temps moyen de première réponse, la gravité, l’urgence, le plafond budgétaire, le mode de consultation préféré ou le genre du médecin préféré. Assurez-vous que tous les enregistrements conservés sont complets avant de procéder à la génération de paires.
2. Génération de paires candidates
- Générez des paires médecin-patient candidats en utilisant une règle de prélèvement spécialisée en premier. Pour chaque demande d’un patient, il faut faire venir les premiers médecins correspondant à la spécialité cible du patient.
- Élargir la fenêtre de prélèvement aux spécialités à haute fréquence adjacentes qui restent actives sur la plateforme le même jour uniquement si moins de deux médecins actifs ayant une capacité de consultation restante sont disponibles dans la spécialité cible initiale.
REMARQUE : Dans ce protocole, « adjacence » est structurellement définie par des schémas établis de référencement croisé clinique et des chevauchements anatomiques ou symptomatiques (par exemple, le transfert d’un patient de la cardiologie vers la médecine interne générale), tandis que « haute fréquence » désigne spécifiquement les spécialités se classant dans le quartile supérieur (top 25 %) du volume historique quotidien de demandes de consultation sur la plateforme. - Relier chaque patient à deux à quatre médecins candidats, en visant un nombre moyen empirique d’environ 2,72 candidats par demande. Établir la couche finale de paires candidates contenant 9 785 paires. Voir la Figure 1 pour le flux de travail global de l’étude.
3. Opérationnalisation par variables paires
- Définissez toutes les variables par paires utilisées dans la construction des scores avant l’étalonnage. Consultez le tableau 1 pour les définitions, seuils et correspondances de score prédéfinis.
- Cochez la correspondance de spécialité (S) comme 1 lorsque la spécialité médicale est identique à la spécialité cible du patient, et 0 sinon.
- Le mode code ajustait (M) comme 1 lorsque le mode supporté par le médecin couvre entièrement le mode préféré du patient, et 0 sinon.
- Code correspondance par préférence de genre (G) comme 1 lorsque le patient choisit Pas de préférence ou lorsque le sexe du médecin correspond à la préférence déclarée, et 0 sinon.
- Ajustement à l’accessibilité au code (A) : 1 lorsque les honoraires médicaux sont inférieurs ou égaux au plafond budgétaire du patient, 0,5 lorsque les honoraires dépassent le budget de pas plus de 20 %, et 0 lorsque les honoraires dépassent le budget de plus de 20 %.
- Normaliser l’évaluation historique des médecins en utilisant la fourchette observée au niveau des médecins (minimum 4,10, maximum 4,98). Calculez le score de qualité normalisé (Q) à l’aide de la formule suivante :
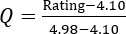 (1)
Fixez les valeurs en dessous de 4,10 après la troncature à 0, et les valeurs supérieures à 4,98 à 1. - Définissez l’ajustement urgence-réponse (U) en fonction de l’urgence du patient et du temps moyen de première réponse du médecin, tel que spécifié dans le Tableau 1.
- Calculez le rapport de charge des médecins en divisant la charge quotidienne actuelle par la capacité nominale quotidienne. Calculez les créneaux restants du jour même en soustrayant la charge quotidienne actuelle de la capacité nominale quotidienne.
- Calculez le temps d’attente estimé (en heures) à l’aide de la formule suivante :
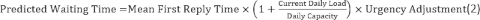
Cette construction sert d’estimation heuristique inspirée des principes fondamentaux de la théorie des files d’attente, où le temps moyen de première réponse d’un médecin est pénalisé par son taux d’utilisation en temps réel (charge quotidienne actuelle / capacité quotidienne).
REMARQUE : Le facteur d’ajustement d’urgence est fixé à 0,80 pour les requêtes prioritaires, 0,90 pour les demandes urgentes et 1,00 pour les requêtes de routine. Ces facteurs d’ajustement sont mis en œuvre sous forme de poids opérationnels prédéfinis pour faire respecter un routage prioritaire dans les cas graves, plutôt que des coefficients dérivés empiriquement.
4. Construction du score correspondant
- Construisez le cadre d’appariement à l’aide d’un module de compatibilité et d’un module de capacité, comme détaillé à la Figure 2.
- Calculez le score de compatibilité comme une combinaison linéaire pondérée des facteurs d’appariement centrés sur le patient :
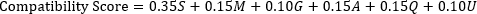 (3)
- Calculez le score de capacité à partir du score de rapport de charge (L), du score du slot restant (R) et du score de temps d’attente (W). Attribuer les scores catégoriels pour , , et en fonction des seuils définis dans le Tableau 1. Calculez le score de capacité comme suit :
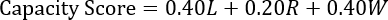 (4)
- Calculez le score hybride final en intégrant les composantes de compatibilité et de capacité :
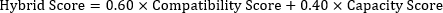 (5)
- Fixez le schéma de pondération 0,60–0,40 avant l’évaluation.
REMARQUE : Ce ratio prédéterminé est guidé par un principe fondamental des services de santé. La pertinence clinique et l’adéquation centrée sur le patient doivent constituer les critères principaux pour garantir la sécurité médicale, tout en appliquant une pénalité mathématique substantielle aux contraintes sévères de capacité, ce qui correspond à la littérature établie sur le triage qui privilégie l’adéquation clinique au détriment du débit opérationnel. - Ne réglez pas ces poids après l’inspection finale pour éviter un surajustement et garantir leur reproductibilité.
REMARQUE : Les chercheurs adoptant ce protocole sont fortement encouragés à réaliser des analyses de sensibilité complètes ou à employer des techniques décisionnelles objectives multi-critères (par exemple, le processus hiérarchique analytique [AHP] ou la pondération d’entropie) afin d’adapter le cadre à la charge opérationnelle spécifique de leur plateforme.
5. Sélection des matchs et benchmarking de stratégies
- Effectuer un benchmarking sur 12 folds d’évaluation répétés. Pour chaque plie, échantillonnez 300 demandes de patients sans remplacement dans l’ensemble du groupe de patients.
REMARQUE : Cette approche simple d’échantillonnage aléatoire est intentionnellement utilisée pour simuler la nature stochastique et imprévisible des flux d’arrivée des patients caractéristiques des plateformes de consultation en ligne en temps réel, plutôt que d’imposer un équilibre structurel artificiel à la demande entrante. - Conservez toutes les paires candidates liées aux requêtes échantillonnées dans le fold concerné.
- Comparez indépendamment quatre stratégies d’allocation distinctes sur la même couche de paire candidate spécifique au pli :
- Pour la base basée sur des règles, classez les candidats par correspondance exacte de spécialité, puis par frais de consultation plus bas, et enfin par note historique plus élevée.
- Pour une stratégie uniquement de compatibilité, sélectionnez le candidat ayant le score de compatibilité le plus élevé.
- Pour une stratégie basée uniquement sur la capacité, sélectionnez le candidat ayant le score de capacité le plus élevé.
- Pour la stratégie hybride, sélectionnez le candidat ayant le score hybride le plus élevé.
- Sélectionnez le médecin candidat ayant le score final spécifique à la stratégie le plus élevé comme correspondance finale pour chaque demande de patient.
- Résoudre les éventuels points nuls (scores identiques à trois décimales) en sélectionnant le candidat avec le temps d’attente estimé le plus faible, suivi du score de compatibilité le plus élevé, et enfin le score historique supérieur.
6. Calcul des résultats
- Calculez les résultats principaux : précision au rang 1, rappel et score F1.
- Attribuez des résultats de base à l’ensemble des 9 785 paires candidates avant de comparer en utilisant les distributions de probabilité dérivées de l’ensemble de données empirique de référence.
REMARQUE : Utilisez un environnement synthétique entièrement étiqueté pour permettre le calcul de la précision et la mémoire pour toutes les paires candidates. Une correspondance réussie est obtenue si la consultation est terminée, et que la satisfaction du patient est de 4,0 sur une échelle de 5 points, et qu’aucun retour de 14 jours n’a lieu en raison d’insatisfaction ou de décalage. - Calculez la précision au rang 1 comme la proportion de correspondances finales sélectionnées répondant au critère de réussite.
- Calculez le rappel comme la proportion de toutes les paires candidates réussies dans un pli correctement sélectionnées par la stratégie. Obtenir les résultats pour les paires candidates non sélectionnées à partir de l’environnement synthétique entièrement étiqueté établi à l’étape 6.2.
- Assurez-vous que la métrique de rappel capture avec précision la capacité de l’algorithme à identifier toutes les correspondances théoriquement viables au sein du pool de candidats simulés.
- Calculez le score F1 à l’aide de la formule suivante :
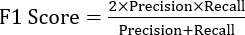 (6)
- Calculez les résultats secondaires : taux de remplissage de la capacité, temps d’attente moyen estimé, satisfaction moyenne des patients, taux de fin de consultation, taux de suivi sur 7 jours et taux d’amélioration rapporté.
- Calculez l’indice de déséquilibre de charge pour évaluer l’inégalité de la répartition de la charge de travail des médecins dans chaque plie :
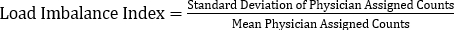 (7)
- Faites la moyenne des estimations 12 fois spécifiques pour obtenir les valeurs de résumé au niveau de la stratégie en utilisant les assignations de score initiales.
- Réaliser une analyse de régression logistique multivariable au sein du sous-ensemble des correspondances finales sélectionnées afin d’identifier les facteurs de niveau paire indépendamment associés à la réussite des appariements.
- Inclure les variables indépendantes prédéfinies suivantes en fonction de leur pertinence théorique : score de compatibilité, score de capacité, temps d’attente estimé, adéquation à l’accessibilité, correspondance à la spécialité, correspondance à la préférence de genre, niveau de gravité et niveau d’urgence.
- Employez une stratégie de sélection de variables à entrée forcée plutôt qu’une approche progressive pour préserver la structure théorique du modèle.
- Évaluer la multicolinéarité à l’aide du facteur d’inflation de la variance (VIF). Confirmez que toutes les valeurs de VIF restent inférieures à 5,0 avant l’estimation finale du modèle.
- Définissez la signification statistique comme un < p à deux queues de 0,05, et rapportez les résultats sous forme de rapports de cotes ajustés (aOR) avec des intervalles de confiance (IC) correspondants à 95 %.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Caractéristiques de référence du groupe de médecins et de demandes de patients
L’ensemble de données analytique simulé comprenait 240 médecins et 3 600 demandes de consultation de patients. Les caractéristiques de base des deux côtés du système d’appariement sont résumées dans le tableau 2, et les motifs de distribution côté plateforme sont illustrés à la figure 3.
Parm...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Le protocole actuel démontre un cadre de mise en relation médecin-patient conscient de la compatibilité et de la capacité dans un cadre de consultation médicale en ligne à grande échelle. La stratégie hybride a permis d’obtenir la performance globale la plus équilibrée en termes de précision d’appariement, de temps d’attente, d’utilisation de la capacité, de satisfaction des patients et de répartition de la charge de travail. Ce résultat est crucial car la consultation numérique élargit ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n’ont rien à divulguer.
Remerciements
Cette recherche a été financée par le projet Talent Introduction and Scientific Research Startup de l’Université NingboTech : Recherche sur la recommandation des médecins pour les plateformes de consultation médicale en ligne (1140157G20220699). Cette recherche a également été soutenue par le Projet d’Innovation Technologique Majeure de la Zone Haute Technologie de Ningbo (2023CX050007) et le Projet de Démonstration Majeure d’Application « Science and Technology Innovation Yongjiang 2035 » : Recherche sur la normalisation du dialecte Ningbo basée sur des modèles à grande échelle et la démonstration du développement d’applications intelligentes (2024Z021).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Paires candidats médecin-patient | Généré par l'étude | N/A | Dérivation des variables par paires et sélection de correspondances (9 785 paires candidates) |
| IBM SPSS Statistics | IBM Corp. | https://www.ibm.com/products/spss-statistics | Analyse statistique (Version 27) |
| Microsoft Excel | Microsoft Corporation | https://www.microsoft.com/microsoft-365/excel | Gestion des données et résumé descriptif (Version 2021) |
| Fichiers de demande de patient | Généré par l'étude | N/A | Caractéristiques de base côté patient et paramètres de préférence (3 600 demandes de consultation) |
| Fichiers de médecin | Généré par l'étude | N/A | Caractéristiques de base côté médecin et paramètres de capacité (240 médecins actifs) |
| Python | Python Software Foundation | https://www.python.org | Simulation, construction de score et évaluation (Version 3.11) |
Références
- Shen T, Li Y, Chen X. A systematic review of online medical consultation research. Healthcare. 2024;12(17):1687.
- Cheng TC, Yip W. Policies, progress, and prospects for internet telemedicine in China. Health Syst Reform. 2024;10(2):2389570.
- Yang M, et al. The status and challenges of online consultation service in internet hospitals operated by physical hospitals in China: a large-scale pooled analysis of multicenter data. BMC Health Serv Res. 2025;25(1):611.
- Culmer N, et al. Asynchronous telemedicine: a systematic literature review. Telemed Rep. 2023;4(1):366–86.
- Fadaizadeh L, Velayati F, Arab-Zozani M. Satisfaction of patients and physicians with telehealth services during the COVID-19 pandemic: a systematic review and meta-analysis. Healthc Inform Res. 2024;30(3):206–23.
- Ge X, Chappell P, Ledger J, Bakhai M, Clarke GM. The use of online consultation systems and patient experience of primary care: cross-sectional analysis using the General Practice Patient Survey. J Med Internet Res. 2024;26:e51272.
- Mandal S, et al. Quantifying the impact of telemedicine and patient medical advice request messages on physicians’ work-outside-work. npj Digit Med. 2024;7(1):35.
- Wan Y, et al. Influencing factors and mechanism of doctor consultation volume on online medical consultation platforms based on physician review analysis. Internet Res. 2021;31(6):2055–75.
- Lu Y, Wang Q. Doctors’ preferences in the selection of patients in online medical consultations: an empirical study with doctor-patient consultation data. Healthcare. 2022;10(8):1435.
- Wang P, Huang Y, Li H, Xi X. Public preferences for online medical consultations in China: a discrete choice experiment. Front Public Health. 2023;11:1282387.
- Jiang H, Mi Z, Xu W. Online medical consultation service-oriented recommendations: systematic review. J Med Internet Res. 2024;26:e46073.
- Zhao M, Wang Y, Zhang X, Xu C. Online doctor-patient dynamic stable matching model based on regret theory under incomplete information. Socioecon Plann Sci. 2023;87:101615.
- Zhang Y, Wang T, Wang Y, Li X, Tang Y. A deep learning approach integrating multi-dimensional features for expert matching in healthcare question answering communities. Front Public Health. 2025;13:1633754.
- Jiang M, et al. Resident preferences for telemedicine services in China in the digital health era: mixed methods study. Patient Educ Couns. 2025;137:108909.
- Wang Y, Shi C, Wang X, Meng H, Chen J. The relationship between static characteristics of physicians and patient consultation volume in internet hospitals: quantitative analysis. JMIR Form Res. 2024;8:e56687.
- Dhunnoo P, et al. Evaluation of telemedicine consultations using health outcomes, user attitudes, and experiences: scoping review. J Med Internet Res. 2024;26:e53266.
- Yang F, Cheng Y, Yao R, Zhang X. What key factors affect patient satisfaction on online medical consultation platforms? A case study from China. Healthcare. 2025;13(5):540.
- Oudbier SJ, et al. Implementation barriers and facilitators of remote monitoring, remote consultation, and digital care platforms through the eyes of healthcare professionals: a review of reviews. BMJ Open. 2024;14(6):e075833.
- Khairat S, Lin J, Liu S. Patient and provider recommendations for improved telemedicine user experience in primary care: a multi-center qualitative study. Telemed Rep. 2023;4(1):34–43.
- Campbell K, et al. The impact of virtual consultations on the quality of primary care: systematic review. J Med Internet Res. 2023;25:e48920.
- Wu B, Liu QB, Guo X, Yang C. Investigating patients’ adoption of online medical advice. Decis Support Syst. 2024;176:114050.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.