Cette méthode présente un cadre complet fondé sur l'intelligence artificielle explicative (XAI) permettant une migration sécurisée des données de santé dans le cloud, en exploitant un jeu de données synthétiques de soins de santé au sein d'un environnement cloud contrôlé. Le résultat est un prototype qui associe une sécurité de type zéro confiance, un contrôle d'accès basé sur le temps et une détection explicative des anomalies afin de garantir transparence et sécurité lors de la migration.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Un protocole expérimental pour la migration sécurisée de données dans le nuage pilotée par l'IA explicable utilisant des données de santé synthétiques
Dans cet article
Résumé
Résumé
Dans les systèmes de santé, de plus en plus de migrations de données vers le cloud sont effectuées, mais cela modifie également les périodes où le transfert de données constitue probablement le risque le plus important en matière de sécurité. Cet article décrit un protocole reproductible pour une migration sécurisée de données dans le cloud fondée sur l’intelligence artificielle explicative (XAI), utilisant un jeu de données synthétiques dans le domaine de la santé et un environnement cloud contrôlé. Le cadre développé combine une architecture de confiance nulle, le privilège temporel minimal, la communication chiffrée, la supervision centralisée et une détection explicative d’anomalies afin d’assurer une migration plus sécurisée, transparente et contrôlable. Les tests utilisent un jeu de données de 10 Go de dossiers de santé électroniques synthétiques, comprenant environ 20 millions d’enregistrements répartis sur 28 tables relationnelles. Le processus de migration a été réalisé sur Amazon Web Services (AWS) à l’aide de bases de données PostgreSQL et de réseaux privés virtuels. Pour la détection d’anomalies, la méthode Isolation Forest a été utilisée, et les explications additives de Shapley (SHAP) ont permis l’interprétation sécurisée des événements. Le cadre a été évalué lors de dix tentatives distinctes de migration, selon des critères tels que la durée d’exposition des identifiants, le délai de détection des incidents, la précision de la détection d’anomalies, la latence de migration et l’intégrité des données. Dans la configuration testée, l’exposition des identifiants a été réduite de 24 heures à 1 heure (une réduction de 95,8 %), la précision de détection des anomalies s’est établie à 97,4 %, le délai de détection des incidents a été ramené à environ 15 minutes, et l’intégrité des données a été préservée à 100 % grâce à une validation par somme de contrôle. Toutefois, les mesures de sécurité renforcées ont entraîné une augmentation moyenne de la latence de migration de 11 %. Ces résultats illustrent le potentiel de combiner l’intelligence artificielle explicative avec des flux de travail de migration sécurisés dans le cloud pour la gestion des données de santé.
Introduction
L'informatique en nuage fait désormais partie intégrante des systèmes de santé à travers le monde, offrant un stockage évolutif, des ressources informatiques et la possibilité d'échanger des dossiers médicaux, de soutenir les systèmes d'aide à la décision et de permettre l'analyse de données de santé via le nuage1,2,3. Alors que de nombreux établissements de santé modernisent leurs systèmes d'information, la migration vers le nuage est devenue une étape essentielle pour transférer leurs données médicales sensibles, auparavant conservées dans d'anciens systèmes locaux, vers des environnements cloud4. Une migration adéquate permet une récupération des données plus aisée, un fonctionnement plus efficace des opérations et un soutien accru aux analyses grâce à des niveaux d'intelligence supérieurs. Toutefois, on ne peut ignorer les risques sérieux liés à la sécurité et à la confidentialité que comporte le transfert de données d'un endroit à un autre5.
La phase de migration est un moment notoirement vulnérable du cycle de vie des données, puisque les données de santé sont activement transférées entre systèmes et réseaux par nature même du processus6. De plus, les organisations peuvent être exposées à des menaces telles que le piratage d'identifiants, l'accès non autorisé, l'interception de données, la manipulation de systèmes ou même la perte de données pendant la phase de migration6,7. Les environnements de santé sont particulièrement sensibles à ces risques, car les informations patient sont hautement confidentielles et exigent donc le plus haut niveau de conformité aux mesures réglementaires et de sécurité8,9. À défaut de cela, il n'est pas possible de garantir la confidentialité, l'intégrité et la traçabilité des données si le flux de migration n'est pas sécurisé et rendu observable10,11.
Un certain nombre de cadres et de normes de sécurité ont été élaborés afin d'améliorer la sécurité dans le cloud. Par exemple, l'architecture Zero Trust du National Institute of Standards and Technology (NIST) repose sur la vérification constante des utilisateurs, des appareils et des services12, tandis que les cadres d'adoption du cloud fournissent des orientations en matière de gouvernance, de gestion des identités, de chiffrement et de surveillance13. En réalité, les méthodes actuelles de sécurité dans le cloud mettent l'accent sur l'automatisation, l'infrastructure en tant que code et la surveillance continue14,15. Bien que ces approches reposent sur des principes de sécurité pertinents, elles traitent dans une large mesure des environnements généraux de déploiement et d'exploitation dans le cloud, plutôt que du processus de migration lui-même16. En effet, elles détaillent rarement des procédures pas à pas, précises et reproductibles pour effectuer des flux de travail sécurisés de migration de données médicales vers le cloud, combinant gestion des identités, transfert sécurisé des données, validation, surveillance et renforcement post-migration17.
La détection d'anomalies par apprentissage automatique est reconnue comme une technologie utile pour la surveillance de la sécurité dans les environnements cloud. Elle permet de détecter les activités anormales du système ainsi que les incidents de sécurité potentiels18. Toutefois, de nombreuses méthodes de détection d'anomalies sont des systèmes fermés qui ne fournissent pas d'explications sur les raisons ayant conduit au signalement d'un événement de sécurité19. L'impossibilité d'expliquer les décisions prises par le système réduit la crédibilité des administrateurs, complique les audits et diminue la valeur des décisions de sécurité automatisées dans les environnements de santé fortement réglementés20. Les méthodes d'intelligence artificielle explicables (XAI), telles que les explications additives basées sur la valeur de Shapley (SHAP) et les explications locales indépendantes du modèle (LIME), fournissent non seulement des explications claires des prédictions de l'apprentissage automatique, mais renforcent également la compréhension, la responsabilité et la confiance dans les systèmes de surveillance de la sécurité21,22.
Même si la sécurité des nuages informatiques et l'intelligence artificielle explicative ont fait d'énormes progrès, il existe encore une pénurie de protocoles expérimentaux reproductibles combinant des contrôles de migration sécurisés avec une surveillance de sécurité explicative dans un but d'intégration23. Les recherches existantes abordent principalement des composants isolés, tels que le chiffrement, le contrôle d'accès, la détection d'anomalies ou la gouvernance du cloud, et ne proposent nulle part une méthodologie intégrée pouvant être mise en œuvre, évaluée et reproduite de manière systématique24. De plus, très peu d'études ont tenté d'intégrer les principes de sécurité de type zéro confiance, le privilège minimal temporel, l'observabilité centralisée et la détection explicative d'anomalies au sein d'un unique flux de travail de migration cloud pour le secteur de la santé25,26.
Cet article présente un cadre fondé sur l'intelligence artificielle explicative (Explainable AI) pour une migration sécurisée des données dans le cloud au sein des systèmes de santé, afin de combler cette lacune. L'architecture proposée utilise un modèle de confiance nulle (zero-trust), un accès limité dans le temps, une communication sécurisée, une journalisation et une surveillance centralisées, ainsi qu'une détection d'anomalies interprétable basée sur SHAP, le tout intégré dans un processus de migration rigoureusement organisé27,28. Le protocole constitue un guide étape par étape pour la mise en œuvre, la surveillance et l'évaluation de la migration sécurisée des données de santé dans des conditions expérimentales. En associant des contrôles de sécurité à une surveillance interprétable par l'IA, le cadre proposé vise à renforcer le niveau de transparence, d'auditabilité et de sécurité tout au long du cycle de vie de la migration29,30.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude a utilisé un ensemble de données de santé entièrement synthétique, généré pour l'évaluation expérimentale de la migration sécurisée de données dans le cloud. Aucune donnée réelle de patient, aucune information personnelle relative à la santé (PHI) ni aucun dossier médical identifiable n'ont été utilisés. Par conséquent, aucune approbation par le comité d'éthique ni aucun consentement éclairé n'étaient requis. Tous les matériaux utilisés dans cette étude sont inclus dans le Tableau des matériaux.
1. Aperçu
- Configurer un environnement sécurisé de migration vers le cloud composé d'une couche source, d'une couche de centre de migration, d'une couche cible, d'une couche réseau, d'une couche de gestion des identités et des accès, d'une couche d'observabilité et d'une couche d'intelligence artificielle explicative.
- Déployer tous les composants dans des environnements cloud isolés afin de prendre en charge la migration sécurisée des données de santé. Établir des canaux de communication chiffrés entre tous les composants du système.
- Exécuter le protocole en suivant les étapes de préparation du jeu de données, de configuration de l'environnement, de déploiement de l'architecture, de migration sécurisée, de surveillance des anomalies et de validation après la migration. L'architecture générale du cadre proposé de migration sécurisée de données vers le cloud piloté par une intelligence artificielle explicative est illustrée dans Figure 1.
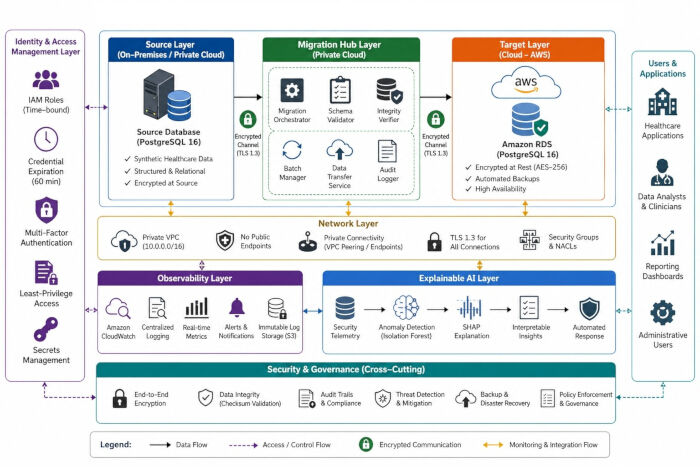
Figure 1 : Architecture générale du cadre de migration sécurisée de données dans le cloud, activé par une intelligence artificielle explicative (XAI), destiné aux systèmes de santé. Le cadre comprend la couche de gestion des identités et des accès, la couche de base de données source, la couche de centre de migration, la couche de base de données cible dans le cloud, la couche de sécurité réseau, la couche d'observabilité, la couche de surveillance par intelligence artificielle explicative, ainsi que des services transversaux de sécurité et de gouvernance. L'architecture intègre un contrôle d'accès temporel au privilège minimal, une communication chiffrée TLS 1.3, une vérification d'intégrité basée sur des sommes de contrôle, une surveillance continue de la sécurité et une fonctionnalité d'explicabilité fondée sur SHAP, afin d'assurer une migration sécurisée, transparente et reproductible des bases de données de santé. Cette figure a été créée par les auteurs à l'aide de Microsoft PowerPoint (Microsoft 365). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
2. Configuration de l'environnement informatique
- Configurer l'environnement informatique
- Préparer les ressources informatiques nécessaires au transfert sécurisé des données dans le cloud et à la surveillance fondée sur une intelligence artificielle explicative.
- Installer et configurer tout le matériel, les logiciels, les services cloud, les bases de données, les outils de sécurité et les bibliothèques d'apprentissage automatique répertoriés dans le Tableau des matériaux. Vérifier que tous les composants requis fonctionnent correctement avant de lancer l'expérience de migration.
- Configurer l'environnement cloud
- Mettre en place un environnement cloud sécurisé pour le transfert de données de santé. Créer un VPC privé afin d'assurer une communication fluide entre les systèmes source, le centre de migration et les systèmes cibles. Utiliser un chiffrement robuste non seulement pour les données au repos, mais aussi pour les données en transit.
- Préparer la base de données cible et les services de migration conformément aux informations indiquées dans le Tableau des matériaux.
- Configurer la gestion des identités et des accès. Configurer les services de surveillance et de journalisation.
3. Préparation et description du jeu de données
- Générez un jeu de données synthétique en matière de santé à l’aide de la bibliothèque Python Faker indiquée dans le tableau des matériaux. Configurez les attributs démographiques, notamment l’âge, le sexe, l’ethnicité et la localisation géographique des patients, en utilisant des distributions de probabilité prédéfinies.
- Générez des informations cliniques, incluant les diagnostics, les résultats de laboratoire, les médicaments, les allergies, les procédures et les hospitalisations, tout en préservant des relations cliniques réalistes.
- Générez des consultations patient longitudinales en attribuant plusieurs visites à chaque patient selon des distributions de fréquence de visite prédéfinies.
- Générez des horodatages pour les admissions, les examens de laboratoire, l’administration des médicaments, les résumés de sortie et les journaux d’audit en utilisant un ordre chronologique des événements.
- Introduisez des valeurs manquantes cliniquement réalistes, des enregistrements en double et des observations aberrantes selon des distributions de qualité des données prédéfinies.
- Remplacez toutes les informations d’identification personnelle par des valeurs synthétiques générées à l’aide de la bibliothèque Faker. Validez l’intégrité référentielle et la cohérence logique avant d’exporter le jeu de données. Exportez le jeu de données validé au format SQL compatible avec PostgreSQL. Configurez le jeu de données pour prendre en charge des scénarios réalistes de migration des données de santé. Les caractéristiques du jeu de données généré sont résumées dans le tableau 1.
- Définissez les relations de la base de données. Attribuez Patient_ID comme clé primaire pour la table des patients. Établissez des relations par clé étrangère entre les tables des patients, des visites, des laboratoires, des médicaments et des journaux d’audit. Vérifiez l’intégrité référentielle entre toutes les tables avant de lancer la migration.
- Simulez des caractéristiques réalistes des données de santé. Générez les âges des patients selon une distribution normale. Générez les fréquences de visite selon une distribution de Poisson. Introduisez des valeurs manquantes à un taux de 5 % afin de simuler l’incomplétude des dossiers médicaux électroniques dans le monde réel. Remplacez toutes les identités des patients par des valeurs hachées avant la migration. Vérifiez que tous les enregistrements générés respectent les contraintes de schéma prédéfinies.
- Validez le jeu de données généré en vérifiant la cohérence du schéma, l’intégrité référentielle, les valeurs manquantes, les enregistrements en double et les contraintes de qualité prédéfinies avant la migration.
| Paramètre | Valeur |
| Type de jeu de données | Données synthétiques de dossiers de santé électroniques |
| Taille du jeu de données | 10 Go |
| Nombre total d'enregistrements | 20 millions |
| Nombre de tables | 5 tables principales - 28 tables relationnelles |
| Enregistrements de patients | 5 000 000 |
| Enregistrements de visites | 10 000 000 |
| Résultats de laboratoire | 4 000 000 |
| Enregistrements de médicaments | 3 000 000 |
| Journaux d'audit | 5 000 000 |
| Clé primaire | Patient_ID |
| Taux de valeurs manquantes | 5 % |
| Répartition par âge | Répartition normale |
| Fréquence des visites | Répartition de Poisson |
| Seuil d'intégrité | <0,1 % de violations |
Tableau 1 : Caractéristiques du jeu de données synthétique en matière de santé utilisé pour la validation du protocole. Le tableau fournit un aperçu du jeu de données, tel que la taille de la base de données, le nombre de tables relationnelles, le nombre total d'enregistrements, les attributs des patients, les variables cliniques et les caractéristiques de validation permettant de reproduire les expériences de migration sécurisée.
4. Déploiement de l'architecture du système
- Déployer l'architecture sécurisée de migration vers le cloud composée de la couche source, de la couche du centre de migration, de la couche cible, de la couche de sécurité réseau, de la couche d'observabilité et de la couche d'intelligence artificielle explicative. L'architecture système déployée utilisée dans cette étude est illustrée dans Figure 2.
- Le cadre est constitué de six couches fonctionnelles qui, durant le processus de migration, exécutent leurs fonctions les unes après les autres. La première couche, la couche source, est celle qui contient la base de données synthétique de soins de santé.
- Le centre de migration est chargé de l'extraction du schéma, du transfert de données chiffrées, de la validation de l'intégrité et de l'orchestration de la migration. La couche cible est l'emplacement où la base de données migrée est stockée dans Amazon RDS PostgreSQL.
- La couche de sécurité réseau protège toutes les communications à l'aide de points de terminaison VPC privés, du chiffrement TLS 1.3, des groupes de sécurité et des listes de contrôle d'accès réseau.
- La couche d'observabilité collecte en continu les journaux d'authentification, les journaux de migration, les journaux d'activité de la base de données et les événements de sécurité à l'aide d'Amazon CloudWatch.
- La couche d'intelligence artificielle explicative reçoit les données de télémétrie de sécurité collectées, les analyse à l'aide d'un algorithme de forêt d'isolation et produit des explications fondées sur SHAP pour les anomalies détectées. Toutes les couches architecturales communiquent entre elles via des canaux réseau privés authentifiés tout au long du flux de travail de migration.
- Déployer et vérifier l'environnement de la base de données source afin d'assurer un accès sécurisé et la disponibilité des données avant la migration.
- Configurer une base de données PostgreSQL 16 avec le jeu de données synthétique de soins de santé. Conserver les informations sur les patients, les détails des visites, les résultats d'analyses, les dossiers de médicaments et les journaux d'audit dans la base de données source.
- Restreindre l'accès à la base de données aux services de migration autorisés et aux utilisateurs administratifs uniquement. Vérifier la disponibilité et la connectivité de la base de données avant de lancer les opérations de migration.
- Configurer le centre de migration pour coordonner l'extraction du schéma, le transfert de données chiffrées et l'orchestration de la migration.
- Déployer un serveur de migration dédié au sein du Cloud Privé Virtuel (VPC) privé. Configurer les services d'orchestration de migration pour coordonner l'extraction du schéma, le transfert des données et les activités de validation.
- Activer les services de validation du schéma afin de vérifier la compatibilité entre les environnements source et cible. Activer les services de vérification de l'intégrité pour valider les données migrées pendant et après le transfert. Vérifier la communication entre le centre de migration et les systèmes de base de données avant d'exécuter les tâches de migration.
- Déployer la couche cible. Déployer Amazon RDS PostgreSQL 16 comme environnement de base de données cible. Activer les services de sauvegarde et de récupération automatiques. Activer le chiffrement AES-256 pour les données stockées dans la base de données cible.
- Configurer la sécurité réseau. Désactiver toutes les adresses IP publiques associées aux ressources de migration. Autoriser la communication uniquement via des points de terminaison privés au sein du VPC. Configurer les listes de contrôle d'accès réseau (NACLs) et les groupes de sécurité. Activer le chiffrement TLS 1.3 pour toutes les communications entre les composants du système. Vérifier qu'aucun point de terminaison accessible publiquement ne reste actif.
- Configurer la surveillance centralisée afin de collecter en continu les événements de sécurité, les journaux de migration et les métriques de performance du système.
- Activer les services de journalisation et de surveillance d'Amazon CloudWatch. Collecter les journaux d'authentification, les journaux de migration, les journaux d'activité de la base de données et les journaux d'événements de sécurité. Configurer une rétention des journaux de 365 jours. Activer le stockage immuable des journaux pour répondre aux exigences d'audit et de conformité. Vérifier la collecte en temps réel des métriques et la génération d'alertes.
- Configurer l'environnement d'intelligence artificielle explicative pour effectuer une détection d'anomalies en temps réel et générer des explications de sécurité interprétables.
- Déployer les services de détection d'anomalies au sein de l'environnement de surveillance. Configurer le cadre d'intelligence artificielle explicative pour traiter la télémétrie de sécurité générée pendant la migration. Connecter les flux de télémétrie de sécurité provenant de la source, du centre de migration, de la base de données cible et des services de surveillance.
- Activer la détection d'anomalies en temps réel et la génération d'explications fondées sur SHAP. Vérifier l'ingestion réussie des données de télémétrie avant de lancer les expériences de migration.
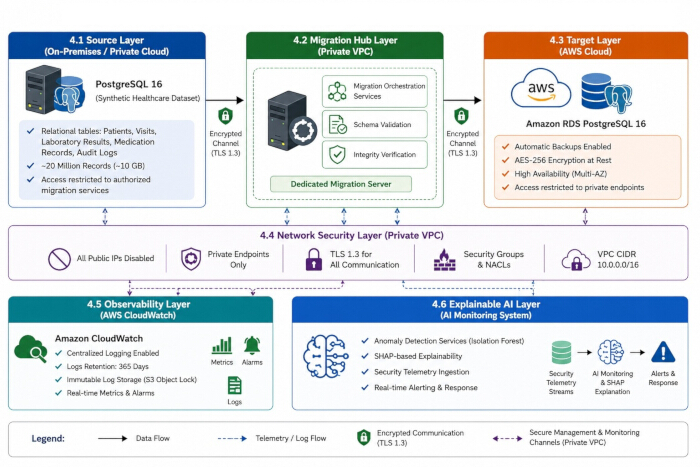
Figure 2 : Architecture de déploiement du cadre sécurisé de migration vers le cloud médical. L'environnement de déploiement illustre la base de données source PostgreSQL contenant le jeu de données médicaux synthétique, le centre de migration dédié au sein d'un cloud privé virtuel (VPC), la base de données cible Amazon RDS PostgreSQL, la couche de sécurité réseau, l'observabilité centralisée via Amazon CloudWatch, ainsi que la couche de surveillance par intelligence artificielle explicative. Toutes les communications s'effectuent par des points de terminaison privés protégés par un chiffrement TLS 1.3. Cette figure a été créée par les auteurs à l'aide de Microsoft PowerPoint (Microsoft 365). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
5. Flux de travail sécurisé pour la migration
REMARQUE : Exécutez le flux de travail de migration sécurisée en effectuant une modélisation des menaces, un transfert de schéma, une migration sécurisée des données, une validation de la migration et un renforcement après la migration.
- Identifier les menaces potentielles pour la sécurité et cartographier les contrôles d'atténuation appropriés avant d'entamer le processus de migration.
- Identifier les éléments à migrer, les vecteurs d'attaque potentiels et les scénarios d'attaques cybernétiques réalistes.
- Évaluer le vol d'identifiants résultant de la compromission de jetons d'authentification, les attaques internes impliquant un accès administratif non autorisé, les attaques par rejeu ciblant des requêtes d'authentification précédemment interceptées, les attaques de type « homme du milieu » (MITM) tentant d'intercepter des canaux de communication chiffrés, la falsification de schéma visant à modifier les structures de base de données pendant la migration, et les attaques d'élévation de privilèges cherchant à obtenir des permissions administratives non autorisées.
- Vérifier que l'utilisation d'une gestion temporaire des identifiants selon le principe du moindre privilège suffit à prévenir le vol d'identifiants et les attaques d'élévation de privilèges. Confirmer que la communication chiffrée avec TLS 1.3 protège contre les attaques par rejeu et les attaques de type « homme du milieu ».
- Vérifier que les politiques de gestion des identités et des accès (IAM) empêchent tout accès administratif non autorisé. S'assurer qu'une journalisation continue conserve un enregistrement de toutes les activités liées à la sécurité durant la migration. Veiller à ce que la vérification par somme de contrôle SHA-256 permette de détecter toute modification non autorisée du schéma ou des données.
- Vérifier que le cadre de détection d'anomalies explicatif est capable de repérer des activités inhabituelles durant la migration et qu'il peut également fournir des explications de sécurité interprétables. Élaborer une cartographie des contrôles de sécurité pour chaque menace identifiée. Confirmer que toutes les menaces identifiées sont correctement atténuées avant de commencer la migration de la base de données. Les auteurs ont résumé le modèle de menace et les contrôles de sécurité dans le tableau 2.
- Transférer le schéma de la base de données. Extraire les définitions du schéma à partir de la base de données PostgreSQL source. Valider la compatibilité du schéma avec l'environnement cible. Vérifier les structures des tables, les clés primaires, les clés étrangères, les index et les contraintes. Déployer les définitions de schéma validées sur la base de données cible. Confirmer le déploiement réussi du schéma avant le transfert des données.
- Migrer les données de santé de manière sécurisée via des canaux de communication chiffrés tout en surveillant en continu les activités de migration.
- Configurer la taille des lots de migration à 10 000 enregistrements par transaction. Établir des canaux de communication chiffrés à l'aide de TLS 1.3. Transférer les données via des points de terminaison réseau privés au sein du cloud privé virtuel (VPC).
- Activer des tentatives de nouvelle transmission automatiques avec un maximum de trois tentatives pour les transactions ayant échoué.
Maintenir le débit de transfert des données entre 100 Mo/s et 150 Mo/s. Surveiller en continu les activités de migration tout au long du processus de transfert. Enregistrer tous les événements de migration dans des journaux d'audit centralisés.
- Vérifier l'intégralité et l'intégrité de la migration en comparant les sommes de contrôle, les nombres d'enregistrements et les structures de base de données.
- Générer des valeurs de hachage SHA-256 pour toutes les tables sources avant la migration, et des valeurs de hachage SHA-256 pour toutes les tables cibles après la migration. Comparer les sommes de contrôle des sources et des cibles. Vérifier croisément les nombres de lignes des bases de données source et cible. Contrôler la cohérence des schémas, des relations entre tables et des contraintes de base de données. Considérer la migration comme réussie uniquement lorsque les valeurs de somme de contrôle, les nombres d'enregistrements et les structures de schéma sont identiques.
- Supprimer les privilèges temporaires et finaliser les contrôles de sécurité après la réussite de la migration des données.
- Révoquer immédiatement toutes les informations d'identification temporaires de migration dès la fin de la migration. Retirer les privilèges élevés liés à la migration des comptes de service. Archiver les journaux d'audit et les enregistrements de surveillance de sécurité.
- Vérifier la bonne exécution des procédures de sauvegarde. Désactiver les serveurs temporaires de migration et les ressources associées. Effectuer un examen final de la sécurité de l'environnement migré. Documenter les résultats de la migration et les résultats de la validation. Le flux de travail complet de migration sécurisée utilisé dans cette étude est illustré dans la figure 3.
| Scénario de menace | Contrôle de sécurité | Méthode de détection | Atténuation |
| Vol d'identifiants | Privilège temporel minimal (TLP) | Journaux IAM | Révocation automatique des identifiants |
| Attaque interne | Contrôle d'accès basé sur les rôles (RBAC) | Journaux d'audit + SHAP | Terminaison de session |
| Attaque par rejeu | TLS 1.3 + validation du nonce | Surveillance du réseau | Rejet des demandes en double |
| Attaque de l'homme du milieu (MITM) | Chiffrement TLS 1.3 | Validation du certificat | Communication chiffrée |
| Altération du schéma | Somme de contrôle SHA-256 + validation du schéma | Vérification d'intégrité | Restauration du schéma validé |
| Élévation de privilèges | Application des politiques IAM | Journaux de sécurité | Révocation des privilèges |
Tableau 2 : Modèle de menace et mesures de sécurité respectives prises dans le cadre de migration proposé. Le tableau présente les principales menaces sécuritaires représentatives et leurs mécanismes d'atténuation correspondants fondés sur les principes de sécurité de confiance zéro, le chiffrement, la gestion des identités, la vérification de l'intégrité, la surveillance et la détection d'anomalies explicables.
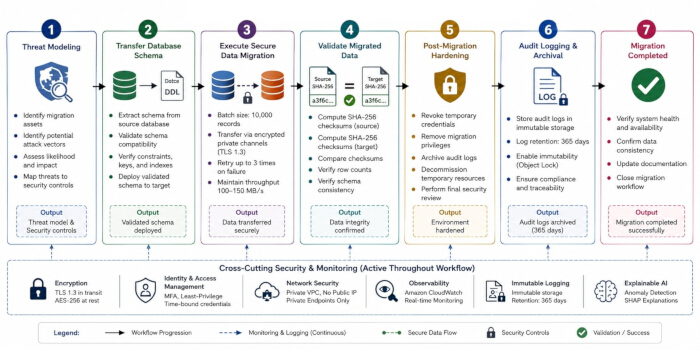
Figure 3 : Flux de travail du protocole proposé de migration sécurisée de bases de données dans le cloud. Le protocole comprend sept étapes séquentielles : modélisation des menaces, transfert du schéma, migration sécurisée de la base de données, validation des données migrées, renforcement après migration, journalisation et archivage des audits, et achèvement de la migration. Une surveillance de la sécurité, une communication chiffrée, une gestion des identités, une journalisation immuable et une détection explicative des anomalies sont maintenues tout au long du flux de travail de migration. Cette figure a été créée par les auteurs à l’aide de Microsoft PowerPoint (Microsoft 365). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
6. Configurer la surveillance de l'intelligence artificielle explicative
REMARQUE : Le plan du processus est le suivant : identifier les caractéristiques de sécurité liées à la migration, élaborer un modèle permettant de détecter les irrégularités, reconnaître quand des actions de migration sont suspectes, et produire des résultats explicables grâce aux méthodes d'interprétation SHAP.
- Extraire et prétraiter les caractéristiques de télémétrie de sécurité nécessaires à la détection d’anomalies et à l’analyse d’explicabilité.
- Collecter les journaux de sécurité à partir des serveurs de base de données, des serveurs d’authentification, des serveurs d’applications et des systèmes de surveillance réseau. Rassembler tous les événements liés à la migration dans un référentiel centralisé de journaux. Supprimer les enregistrements en double et les entrées incomplètes. Synchroniser les horodatages de toutes les sources de journaux à l’aide du temps universel coordonné (UTC).
- Calculer la fréquence d’accès de chaque utilisateur pendant les opérations de migration. Enregistrer le nombre de tentatives de connexion échouées associées à chaque compte. Surveiller les changements d’adresses IP source tout au long des sessions de migration.
- Mesurer la durée de la session utilisateur, de l’initiation à la fermeture de la connexion. Calculer les volumes de transfert de données entrants et sortants pendant les activités de migration. Normaliser toutes les caractéristiques extraites à l’aide de la normalisation Min-Max.
- Tableau 3 résume les caractéristiques de sécurité utilisées pour la détection d’anomalies et l’analyse d’explicabilité.
- Entraîner et valider le modèle Isolation Forest à l’aide du jeu de données de caractéristiques de sécurité préparé.
- Partitionner le jeu de données. Diviser aléatoirement le jeu de données en ensemble d’entraînement (70 %), ensemble de validation (15 %) et ensemble de test (15 %). Maintenir une distribution cohérente d’événements normaux et anormaux dans tous les sous-ensembles.
- Sélection du modèle d’intelligence artificielle explicative. Choisir l’algorithme Isolation Forest car il détecte efficacement les activités de migration anormales sans nécessiter de données d’entraînement étiquetées. Utiliser l’algorithme pour isoler les observations anormales par partitionnement aléatoire récursif de l’espace des caractéristiques.
- Appliquer SHAP TreeExplainer pour quantifier la contribution de chaque caractéristique de sécurité à la prédiction d’anomalie et améliorer la transparence du processus de surveillance de sécurité.
- Configurer le modèle de détection d’anomalies. Initialiser un modèle Isolation Forest. Configurer le modèle à l’aide des paramètres indiqués dans Tableau 4.
- Définir la formulation mathématique utilisée pour calculer les scores d’anomalie et expliquer les contributions des caractéristiques.
- Définir le vecteur de caractéristiques de sécurité pour chaque événement de migration comme indiqué dans l’équation 1.
xi = [x1 , x2, x3, x4, x5 ] (1)
où x1 désigne la fréquence d’accès, x2 le nombre de tentatives de connexion échouées, x3 la fréquence de changement d’adresse IP, x4 la durée de la session, et x5 le volume de transfert de données. - Extraire les caractéristiques de sécurité à partir des journaux de migration. Normaliser toutes les valeurs des caractéristiques avant l’entraînement du modèle. Calculer le score d’anomalie Isolation Forest pour chaque événement de migration à l’aide de l’équation 2.
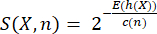 (2)
où S(X,n) désigne le score d’anomalie de l’observation X, X désigne le vecteur de caractéristiques de sécurité, E(h(X)) est la longueur moyenne du chemin de l’observation X, c(n) est la longueur moyenne des recherches infructueuses dans un arbre binaire de recherche, et n est le nombre total d’échantillons d’entraînement. Le facteur de normalisation est calculé comme indiqué dans l’équation 3.
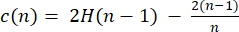 (3)
où H(n-1) désigne le (n-1)-ième nombre harmonique. - Classer comme anormaux les événements de migration dont les scores d’anomalie dépassent le seuil de décision prédéfini.
- Appliquer SHAP (SHapley Additive exPlanations) pour expliquer la contribution de chaque caractéristique de sécurité à la prédiction d’anomalie. Calculer la valeur SHAP pour la caractéristique i à l’aide de l’équation 4.
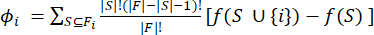 (4)
où (F) désigne l’ensemble complet des caractéristiques, (S) un sous-ensemble de caractéristiques, et (f(.)) la fonction de prédiction d’Isolation Forest. - Calculer l’importance globale des caractéristiques en calculant la valeur absolue moyenne de SHAP à l’aide de l’équation 5.
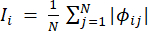 (5)
où (N) désigne le nombre total d’événements de migration. - Classer les caractéristiques de sécurité selon leurs valeurs absolues moyennes de SHAP. Générer des graphiques résumés SHAP, des graphiques de dépendance et des graphiques de forces pour visualiser l’importance globale et locale des caractéristiques.
- Définir le vecteur de caractéristiques de sécurité pour chaque événement de migration comme indiqué dans l’équation 1.
- Entraîner le modèle Isolation Forest à l’aide du jeu de données d’entraînement. Évaluer les performances du modèle à l’aide du jeu de données de validation. Si nécessaire, ajuster les seuils de contamination. Conserver la configuration du modèle offrant les meilleures performances. Valider les performances du modèle. Déterminer des métriques telles que la précision, le rappel, le score F1 et l’AUC-ROC. Noter les mesures de performance du modèle pour comparaison ultérieure.
- Appliquer le modèle entraîné pour identifier les événements de migration anormaux et classer les activités suspectes.
- Effectuer la prédiction d’anomalie. Appliquer le modèle Isolation Forest entraîné au jeu de données de test. Générer des scores d’anomalie pour tous les événements de migration.
- Identifier les activités suspectes. Déterminer si les événements de migration sont typiques ou anormaux. Marquer comme suspects les événements dépassant les niveaux d’anomalie prédéfinis. Produire une documentation des anomalies à des fins d’examen de sécurité.
- La conclusion du processus de détection d’anomalies fournit des scores d’anomalie, étiquette les événements de migration comme normaux ou anormaux, mesure l’efficacité de la détection par analyse ROC et identifie les principales anomalies de sécurité. Des exemples de sorties produites par le processus conçu sont présentés dans Figure 4.
- Catégoriser les anomalies détectées. Classer les anomalies en anomalies d’authentification, anomalies réseau, anomalies de session et anomalies de transfert de données. Conserver les étiquettes d’anomalie pour l’analyse explicative.
- Évaluer les performances de détection. Consulter les incidents de sécurité enregistrés à ce jour. Puis, en les utilisant comme référence, évaluer les anomalies détectées et déterminer lesquelles constituent de véritables anomalies. Déterminer le taux de détection des anomalies et le taux de faux positifs. Établir un enregistrement officiel de la documentation de la précision de détection afin de permettre sa reproduction.
- Générer des explications fondées sur SHAP pour interpréter la contribution des caractéristiques de sécurité individuelles aux prédictions d’anomalie.
- Configurer l’environnement SHAP. Charger le modèle Isolation Forest entraîné. Initialiser SHAP TreeExplainer. Vérifier l’intégration réussie entre le modèle de détection d’anomalies et le cadre d’explicabilité.
- Sélectionner des échantillons de référence. Choisir aléatoirement 1 000 échantillons représentatifs du jeu de données d’entraînement. Utiliser ces échantillons comme jeu de données de référence SHAP. Calculer les valeurs SHAP. Calculer les valeurs SHAP pour toutes les anomalies détectées. Mesurer les contributions individuelles des caractéristiques aux prédictions d’anomalie. Stocker les sorties SHAP pour analyse ultérieure.
- Générer des explications globales. Créer des graphiques résumés SHAP montrant l’importance globale des caractéristiques. Générer des diagrammes en barres SHAP basés sur les valeurs absolues moyennes de SHAP. Produire des graphiques de dépendance SHAP pour les caractéristiques fortement influentes.
- Générer des explications locales. Sélectionner des événements de migration anormaux représentatifs. Créer des graphiques de forces SHAP et des graphiques en cascade. Visualiser les contributions des caractéristiques responsables de chaque anomalie.
- Des sorties représentatives d’explicabilité générées lors du processus d’interprétation sont présentées dans Figure 5. Ces visualisations illustrent l’importance globale des caractéristiques, le classement des contributions des caractéristiques, les relations de dépendance entre les caractéristiques de sécurité influentes, et les explications locales pour des anomalies de migration individuelles.
- Classer les caractéristiques de sécurité. Calculer les valeurs absolues moyennes de SHAP pour toutes les caractéristiques. Classer les caractéristiques selon leur contribution à la détection d’anomalies. Identifier les indicateurs de sécurité les plus influents affectant la sécurité de la migration. Tableau 5 résume les classements d’importance des caractéristiques basés sur SHAP.
- Valider la cohérence des explications. Répéter l’analyse SHAP sur cinq exécutions expérimentales indépendantes. Mesurer la stabilité et la cohérence des explications. Vérifier que les classements des caractéristiques restent stables lors d’analyses répétées.
NOTE : Tableau 6 présente les problèmes courants rencontrés lors de la détection d’anomalies explicables et les actions correctives recommandées.
| Fonctionnalité | Description | Objectif |
| Fréquence d'accès | Nombre de demandes d'accès utilisateur pendant la migration | Détecter un comportement d'accès anormal |
| Nombre d'échecs de connexion | Nombre de tentatives d'authentification infructueuses | Identifier des tentatives d'accès par force brute ou non autorisées |
| Changements d'adresse IP | Fréquence des changements d'adresse IP source | Détecter un comportement réseau suspect |
| Durée de session | Durée des sessions utilisateur pendant la migration | Identifier des activités de session anormales |
| Volume de transfert de données | Quantité de données transférées pendant la migration | Détecter un déplacement inhabituel ou une exfiltration de données |
Tableau 3 : Caractéristiques de télémétrie de sécurité utilisées pour la détection d'anomalies explicables. Le tableau présente les caractéristiques de sécurité qui ont été surveillées pendant la migration de la base de données, leurs significations, les méthodes de mesure utilisées et la manière dont elles ont contribué à la détection d'anomalies et à l'analyse d'explicabilité.
| Paramètre | Valeur | Description |
| Algorithme | Isolation Forest | Modèle de détection d'anomalies |
| n_estimators | 100 | Nombre d'arbres d'isolation |
| contamination | 0,02 | Proportion attendue d'anomalies |
| max_samples | Auto | Échantillons utilisés par arbre |
| random_state | 42 | Graine pour la reproductibilité |
| bootstrap | False | Échantillonnage sans remise |
| Ensemble d'apprentissage | 70 % | Données d'entraînement du modèle |
| Ensemble de validation | 15 % | Validation des hyperparamètres |
| Ensemble de test | 15 % | Évaluation finale du modèle |
Tableau 4 : Configuration de la forêt d'isolation utilisée pour détecter les anomalies lors de la migration sécurisée de bases de données. Ce tableau détaille les configurations des hyperparamètres du modèle de forêt d'isolation pour l'apprentissage, telles que la manière dont le jeu de données a été divisé, le niveau de contamination, le nombre d'estimateurs, la graine aléatoire et la configuration de l'évaluation.
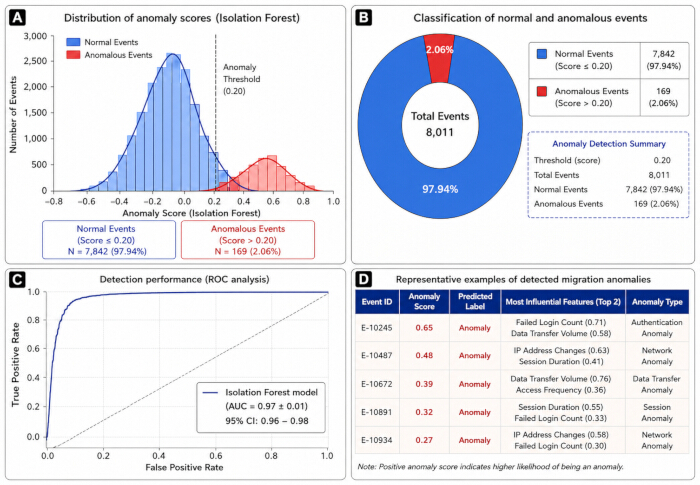
Figure 4 : Résultats représentatifs du cadre de détection d'anomalies lors d'une migration sécurisée de données dans le cloud. (A) Distribution des scores d'anomalie de la forêt d'isolation, indiquant le seuil d'anomalie. (B) Classification des événements de migration en catégories normales et anormales. (C) Courbe caractéristique de fonctionnement du récepteur (ROC) illustrant les performances du modèle de forêt d'isolation (AUC = 0,97 ± 0,01). (D) Événements de migration anormaux représentatifs montrant les scores d'anomalie, les étiquettes prédites, les caractéristiques de sécurité influentes et les catégories d'anomalie. Cette figure a été générée par les auteurs à l'aide de Python 3.11 (Matplotlib 3.9) et mise en forme avec Microsoft PowerPoint (Microsoft 365). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
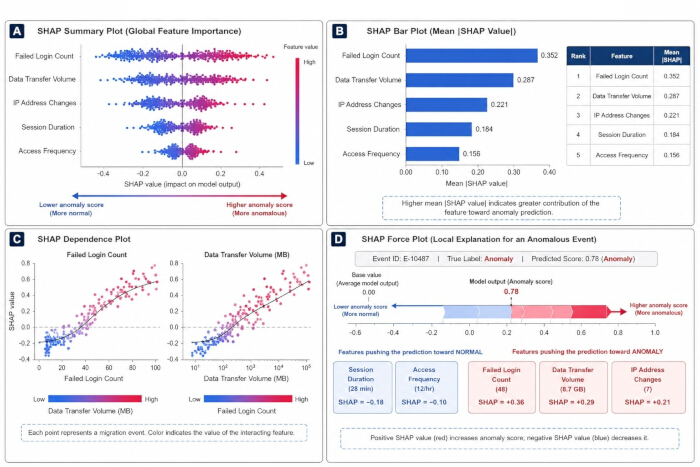
Figure 5 : Exemples de sorties explicatives basées sur SHAP produites lors de l'interprétation des anomalies. (A) Graphique récapitulatif SHAP mettant en évidence les caractéristiques les plus importantes au niveau global. (B) Classement des caractéristiques de sécurité selon leur valeur absolue moyenne SHAP. (C) Graphiques de dépendance SHAP illustrant l'effet du nombre de connexions échouées et du volume de transfert de données sur la prédiction d'anomalie. (D) Graphique de forces SHAP fournissant une explication locale pour un événement typique de migration anormale. Ces graphiques illustrent l'interprétabilité globale et locale du modèle de détection d'anomalies proposé. Cette figure a été générée par les auteurs à l'aide de Python 3.11 (Matplotlib 3.9) et mise en forme à l'aide de Microsoft PowerPoint (Microsoft 365). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
| Rang | Caractéristique | Valeur moyenne absolue de SHAP | Interprétation |
| 1 | Nombre de tentatives de connexion échouées | 0.352 | Indicateur le plus influent d'une activité anormale |
| 2 | Volume de transfert de données | 0.287 | Contribution importante à la détection d'anomalies |
| 3 | Changements d'adresse IP | 0.221 | Indique un comportement réseau suspect |
| 4 | Durée de session | 0.184 | Associée à des sessions utilisateur anormales |
| 5 | Fréquence d'accès | 0.156 | Reflette des schémas d'accès inhabituels |
Tableau 5 : Scores d'importance des caractéristiques SHAP des données de télémétrie de sécurité. Le tableau présente le classement des caractéristiques de sécurité selon leurs valeurs absolues moyennes de SHAP et précise leurs contributions respectives à la prédiction d'anomalies.
| Problème | Cause possible | Solution recommandée |
| Peu d'anomalies détectées | Paramètre de contamination trop bas | Augmenter le seuil de contamination et réentraîner le modèle. |
| Taux élevé de faux positifs | Journaux de migration bruyants ou incohérents | Nettoyer les données des journaux et normaliser les caractéristiques de sécurité avant l'entraînement du modèle. |
| Explications SHAP instables | Échantillons de référence insuffisants | Augmenter le nombre d'échantillons de référence représentatifs utilisés par SHAP. |
| Mauvaise précision de détection des anomalies | Déséquilibre des caractéristiques ou prétraitement insuffisant | Appliquer des procédures de normalisation, d'équilibrage et de contrôle qualité des caractéristiques. |
| Convergence lente du modèle | Jeu de données volumineux ou ressources computationnelles limitées | Optimiser les hyperparamètres ou utiliser un GPU ou un traitement parallèle. |
| Défaillances de communication | Instabilité du réseau pendant la surveillance | Vérifier les canaux de communication sécurisés et répéter la synchronisation. |
| Caractéristiques de sécurité manquantes | Collecte de journaux incomplète | Valider les sources de journaux avant l'extraction des caractéristiques et régénérer le jeu de données de caractéristiques. |
Tableau 6 : Guide de dépannage pour la migration sécurisée de bases de données basée sur l'intelligence artificielle explicative. Ce tableau fournit un résumé des problèmes typiques d'implémentation, des causes possibles, des signes diagnostiques, des actions recommandées et des résultats attendus suite à l'exécution du protocole et à sa reproductibilité.
7. Évaluation des performances
REMARQUE : Cette section décrit le protocole expérimental utilisé pour comparer le cadre de migration de base avec le cadre de migration proposé basé sur une IA explicative de type zéro confiance. L'évaluation des performances comprend la sécurité, la capacité de détection des anomalies, l'efficacité de la migration et la validation statistique dans des conditions expérimentales identiques.
- Configurer les environnements de référence et proposé dans des conditions identiques afin de permettre une comparaison équitable des performances.
- Configurer l’environnement de migration conventionnel. Mettre en place des identifiants statiques à long terme ayant une durée de validité supérieure à 24 heures. Activer des points d’accès réseau publics pour l’accès à la base de données. Désactiver les mécanismes de détection d’anomalies et d’explicabilité basés sur l’intelligence artificielle. Surveiller manuellement les activités de migration à l’aide des journaux de sécurité classiques. Enregistrer les événements de migration en vue d’une comparaison ultérieure des performances.
- Configurer le cadre de migration de type zéro confiance. Activer des identifiants temporaires selon le principe du moindre privilège, avec expiration automatique à la fin de la migration. Désactiver tous les points d’accès réseau publics. Activer la communication via un réseau privé en utilisant des canaux sécurisés.
- Déployer le modèle entraîné de détection d’anomalies par forêt d’isolation. Activer l’outil d’interprétation SHAP TreeExplainer. Configurer une surveillance de sécurité automatisée tout au long du processus de migration. Vérifier la communication sécurisée entre tous les composants de migration avant l’exécution.
- Effectuer des expériences de migration répétées dans des conditions contrôlées afin d’évaluer la reproductibilité du cadre.
- Réaliser une expérience de migration. Mener dix expériences de migration indépendantes pour chacun des environnements de référence et proposé. Maintenir des configurations matérielles, logicielles et réseau identiques durant toutes les expériences.
- Migrer 10 Go de données de santé lors de chaque essai expérimental. Répéter toutes les expériences dans des conditions de charge de travail identiques. Enregistrer les événements de sécurité, les journaux de migration, les résultats de détection d’anomalies et les temps d’exécution au cours de chaque expérience.
- Valider l’intégrité de la migration. Calculer les sommes de contrôle SHA-256 avant et après la migration. Vérifier l’intégrité complète des données après chaque expérience de migration. Documenter les résultats de la validation des sommes de contrôle.
- Calculer des métriques quantitatives de sécurité, de migration et de détection d’anomalies pour une évaluation comparative.
- Mesurer la performance en matière de sécurité. Mesurer la durée d’exposition des identifiants. Calculer le nombre d’identifiants exposés durant la migration. Mesurer le temps de détection des incidents. Enregistrer la durée d’exposition au réseau public.
- Évaluer la performance de la détection d’anomalies. Calculer la précision, la justesse, le rappel, le score F1 et l’aire sous la courbe caractéristique de fonctionnement du récepteur (AUC) de la détection d’anomalies. Évaluer la performance de la migration. Mesurer la latence totale de migration et calculer le débit de migration. Enregistrer la surcharge de communication introduite par les mécanismes de sécurité.
- Effectuer une validation statistique. Calculer la moyenne et l’écart type pour toutes les métriques de performance. Calculer les intervalles de confiance à 95 %. Réaliser des tests t de Student appariés pour comparer les cadres de référence et proposé. Considérer une signification statistique pour p < 0,05. Les résultats représentatifs de l’évaluation des performances obtenus lors de la comparaison expérimentale sont présentés dans Figure 6.
- Tableau 7 résume la comparaison quantitative des performances entre le cadre de référence et le cadre de migration proposé.
Tableau 8 résume les problèmes courants d’implémentation rencontrés lors de la migration sécurisée de bases de données, leurs causes possibles et les mesures correctives recommandées.
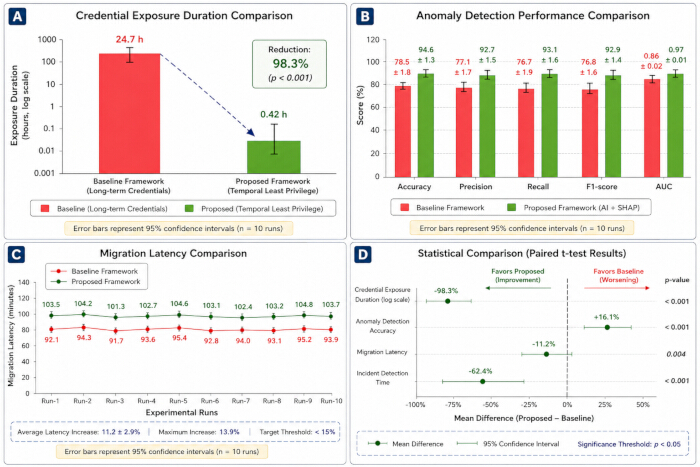
Figure 6 : Comparaison des performances entre le cadre de migration de base et le cadre de migration sécurisé vers le cloud proposé, basé sur un modèle zéro confiance et une IA explicative. (A) Comparaison de la durée d'exposition des identifiants à l’aide d’identifiants à privilèges limités à long terme et temporaires. (B) Comparaison des métriques de performance de détection d’anomalies, incluant la précision, l’exactitude, le rappel, le score F1 et l’AUC. (C) Comparaison de la latence de migration sur dix exécutions expérimentales indépendantes, montrant que l’augmentation de la latence est restée en dessous du seuil d’acceptation prédéfini. (D) Comparaison statistique des métriques clés de performance à l’aide de tests t appariés de Student, indiquant les différences moyennes et les intervalles de confiance à 95 %. Les barres d’erreur représentent les intervalles de confiance à 95 % obtenus à partir de dix exécutions expérimentales indépendantes. Cette figure a été générée par les auteurs à l’aide de Python 3.11 (Matplotlib 3.9) et mise en forme à l’aide de Microsoft PowerPoint (Microsoft 365). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
| Métrique de performance | Cadre de référence (moyenne ± ÉT) | Cadre proposé (moyenne ± ÉT) | Amélioration | Intervalle de confiance à 95 % | p-valeur |
| Durée d'exposition des identifiants (h) | 24,70 ± 1,32 | 0,42 ± 0,18 | Réduction de 98,3 % | 23,6–24,9 | <0,001 |
| Précision de détection des anomalies (%) | 72,4 ± 2,1 | 94,6 ± 1,3 | +22,2 % | 20,8–23,5 | <0,001 |
| Précision (%) | 68,1 ± 2,5 | 92,7 ± 1,5 | +24,6 % | 23,1–26,0 | <0,001 |
| Rappel (%) | 70,3 ± 2,4 | 93,1 ± 1,6 | +22,8 % | 21,4–24,2 | <0,001 |
| Score F1 (%) | 69,2 ± 2,2 | 92,9 ± 1,4 | +23,7 % | 22,3–25,0 | <0,001 |
| AUC | 0,78 ± 0,03 | 0,97 ± 0,01 | +0,19 | 0,17–0,21 | <0,001 |
| Latence de migration (min) | 87,6 ± 3,2 | 97,4 ± 2,9 | Surcharge de 11,2 % | 8,9–10,7 | 0,002 |
| Intégrité des données (%) | 99,8 | 100,0 | Amélioration de 0,2 % | N/A | 0,031 |
| Exposition au réseau public | Activée | Éliminée | Élimination de 100 % | N/A | <0,001 |
Tableau 7 : Comparaison des performances entre les cadres de migration de bases de données sécurisées existants et proposés. Le tableau présente la durée d'exposition des identifiants, l'efficacité de la détection des anomalies, la latence de migration, l'intégrité des données et les améliorations de sécurité évaluées de manière quantitative lors de la validation du protocole.
| Problème | Cause possible | Solution recommandée |
| Échec d'authentification lors de la migration | Identifiants temporaires expirés ou non valides | Regénérez les identifiants temporaires et vérifiez les politiques IAM avant de redémarrer la migration. |
| Latence élevée de la migration | Conflits réseau ou bande passante insuffisante | Optimisez le routage réseau, planifiez la migration pendant les périodes de faible trafic et vérifiez la connectivité des points de terminaison. |
| Alertes d'anomalie en faux positif | Seuil de contamination inapproprié pour la forêt d'isolation | Ajustez le paramètre de contamination à l'aide du jeu de données de validation et réentraînez le modèle. |
| Explications SHAP instables | Échantillons de référence insuffisants ou non représentatifs | Augmentez la taille de l'échantillon de référence pour SHAP et assurez-vous d'un échantillonnage représentatif. |
| Discordance d'intégrité des données | Migration interrompue ou transfert de données corrompu | Relancez la migration après avoir validé les valeurs de hachage SHA-256 ainsi que la cohérence entre la source et la cible. |
| Échec de connexion au point de terminaison sécurisé | Erreurs de configuration du pare-feu ou du protocole TLS | Vérifiez les certificats SSL/TLS, les règles du pare-feu et la configuration du point de terminaison privé. |
| Précision faible de détection d'anomalie | Extraction de caractéristiques incomplète ou prétraitement insuffisant | Revoyez l'ingénierie des caractéristiques, normalisez les caractéristiques de sécurité et réentraînez le modèle. |
| Problèmes de convergence du modèle | Hyperparamètres inappropriés | Ajustez les paramètres d'apprentissage et validez les performances du modèle avant le déploiement. |
Tableau 8 : Guide de dépannage pour la migration sécurisée d'une base de données de santé. Le tableau recense les erreurs fréquentes lors de la migration, leurs causes possibles, les mesures correctives recommandées et les résultats attendus afin de garantir une exécution fiable du protocole de migration sécurisée.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Aperçu expérimental
Le protocole sécurisé de migration de données dans le cloud, basé sur une intelligence artificielle explicative (XAI), a été évalué à l’aide d’un jeu de données synthétique dans le domaine de la santé, comprenant environ 20 millions de dossiers de santé électroniques (DSE) répartis dans 28 tables de bases de données relationnelles, pour un volume total de 10 Go. Les expériences ont été menées dans un environnement cloud Amazon Web Services (AWS), utilisant ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Dans cette recherche, un protocole reproductible et sécurisé de migration de bases de données dans le cloud a été développé, intégrant les principes de sécurité de type zéro confiance, un contrôle d'accès basé sur le temps et le privilège minimal, une intelligence artificielle explicative (XAI) et une surveillance continue de la sécurité, le tout dans un dispositif expérimental restreint. L'objectif de cet article n'était pas d'utiliser un nouvel algorithme de migration ; les auteurs présentent donc principalement un flu...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun intérêt financier concurrent, aucune relation commerciale ou relation personnelle susceptible d’avoir influencé les travaux rapportés dans cette étude. Les auteurs n’ont aucun conflit d’intérêts à divulguer. Tous les matériaux nécessaires pour reproduire la méthodologie présentée dans cette étude sont accessibles publiquement dans un dépôt GitHub. Le dépôt est disponible à l’adresse suivante : https://github.com/priyankanalawade896-tech/XAI-Secure-Cloud-Data-Migration. Le dépôt contient uniquement des données de référence générées de manière synthétique et n’inclut aucune information réelle relative à des patients, aucune information médicale protégée ni aucun dossier de soins identifiable.
Remerciements
Les auteurs reconnaissent le soutien institutionnel fourni par leurs établissements affiliés respectifs durant le développement et l'évaluation de ce protocole. Les auteurs reconnaissent également l'utilisation des infrastructures de calcul institutionnelles et des ressources de calcul en nuage qui ont permis la validation expérimentale du cadre sécurisé de migration des données dans le cloud proposé.
Cette recherche n'a reçu aucun financement externe. L'étude a été menée à l'aide des installations de recherche institutionnelles et des ressources informatiques fournies par les établissements affiliés des auteurs. Aucun financement par subvention ni soutien financier n'a été reçu d'un organisme public, commercial ou à but non lucratif.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Chiffrement AES | NIST | AES-256 | Chiffrement des données au repos |
| Amazon RDS PostgreSQL | Amazon Web Services | PostgreSQL 16 | Base de données cible |
| Plateforme cloud | Amazon Web Services | AWS | Infrastructure cloud |
| CloudWatch | Amazon Web Services | Dernière version stable | Surveillance et journalisation |
| Docker | Docker Inc. | 27.0 | Conteneurisation |
| Faker | Développeurs de Faker | 30.0 | Génération de données synthétiques |
| GPU | NVIDIA | RTX 4090 | 24 Go de mémoire vidéo |
| Matplotlib | Développeurs de Matplotlib | 3.9 | Visualisation |
| NumPy | Développeurs de NumPy | 1.26 | Traitement numérique |
| Système d'exploitation | Canonical | Ubuntu 22.04 LTS | Environnement système |
| Pandas | PyData | 2.2 | Traitement des données |
| PostgreSQL | Groupe mondial de développement PostgreSQL | 16 | Base de données source |
| Python | Fondation logicielle Python | 3.11 | Langage de programmation |
| Scikit-learn | Développeurs de Scikit-learn | 1.5 | Apprentissage automatique |
| SHAP | Développeurs de SHAP | 0.46 | IA explicable |
| Terraform | HashiCorp | 1.8 | Approvisionnement d'infrastructure |
| TLS | IETF | TLS 1.3 | Chiffrement des données en transit |
| Cloud privé virtuel | Amazon Web Services | VPC | Environnement réseau privé |
| Station de travail | Dell/HP | NA | Intel Xeon Gold 6226R, 64 Go de RAM, 1 To de SSD |
Références
- Kindervag J. Build security into your network's DNA: The Zero Trust Network Architecture. Cambridge (MA): Forrester Research; 2010.
- Rose S, Borchert O, Mitchell S, Connelly S. Zero Trust Architecture. NIST Special Publication 800-207. Gaithersburg (MD): National Institute of Standards and Technology; 2020. doi:10.6028/NIST.SP.800-207.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119. doi:10.1038/s41746-020-00323-1.
- Kairouz P, McMahan HB, Avent B, Bellet A, Bennis M, Bhagoji AN, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210. doi:10.1561/2200000083.
- Nguyen DC, Ding M, Pathirana PN, Seneviratne A, Li J, Niyato D, et al. Privacy-preserving federated learning: A comprehensive survey. IEEE Commun Surv Tutor. 2021;23(3):1622-1651. doi:10.1109/COMST.2021.3075434.
- Sarker IH. AI-driven cybersecurity: An overview, security intelligence modeling, and research directions. SN Comput Sci. 2021;2:173. doi:10.1007/s42979-021-00557-0.
- Kuo AM. Opportunities and challenges of cloud computing to improve health care services. J Med Internet Res. 2011;13(3):e67. doi:10.2196/jmir.1867.
- Kota TK. Cloud migration for healthcare data: Challenges and solutions. Nanotechnol Percept. 2024;20:3048-3062.
- Rancea A, Anghel I, Cioara T. Edge computing in healthcare: Innovations, opportunities, and challenges. Future Internet. 2024;16(9):329.
- Mersha M, et al. Explainable artificial intelligence: A survey of needs, techniques, applications, and future direction. Neurocomputing. 2024;599:128111. doi:10.1016/j.neucom.2024.128111.
- Mennella C, Maniscalco U, De Pietro G, Esposito M. Ethical and regulatory challenges of AI technologies in healthcare: A narrative review. Heliyon. 2024;10(4):e26297. doi:10.1016/j.heliyon.2024.e26297.
- Roppelt JS, Kanbach DK, Kraus S. Artificial intelligence in healthcare institutions: A systematic literature review on influencing factors. Technol Soc. 2024;76:102443. doi:10.1016/j.techsoc.2023.102443.
- Lekkala S, Avula R, Gurijala P. Next-Gen firewalls: Enhancing cloud security with generative AI. J Artif Intell Cloud Comput. 2024;3(4):1-9. doi:10.47363/JAICC/2024(3)404.
- Al-Hammuri K, Gebali F, Kanan A. ZTCloudGuard: Zero Trust context-aware access management framework to avoid medical errors in the era of generative AI and cloud-based health information ecosystems. AI. 2024;5(3):1111-1131. doi:10.3390/ai5030055.
- Pfeifer B, Sirocchi C, Bloice MD, Kreuzthaler M, Urschler M. Federated unsupervised random forest for privacy-preserving patient stratification. Bioinformatics. 2024;40(Suppl 2):ii198-ii207. doi:10.1093/bioinformatics/btae382.
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: Challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60. doi:10.1109/MSP.2020.2975749.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. In: Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS); 2017. p. 4768-4777.
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-1144. doi:10.1145/2939672.2939778.
- Ortigossa ES, Gonçalves T, Nonato LG. Explainable artificial intelligence (XAI)—From theory to methods and applications. IEEE Access. 2024;12:80799-80846. doi:10.1109/ACCESS.2024.3409843.
- Chaddad A, et al. Explainable, domain-adaptive, and federated artificial intelligence in medicine. IEEE/CAA J Autom Sin. 2023;10(4):859-876. doi:10.1109/JAS.2023.123123.
- Albshaier L, Almarri S, Albuali A. Federated learning for cloud and edge security: A systematic review of challenges and AI opportunities. Electronics. 2025;14(5):1019. doi:10.3390/electronics14051019.
- Vani MS, Sudhakar RV, Mahendar A, et al. Personalized health monitoring using explainable AI: Bridging trust in predictive healthcare. Sci Rep. 2025;15:31892. doi:10.1038/s41598-025-15867-z.
- Zakhmi K, et al. Evolving Zero Trust architectures for AI-driven cyber threats in healthcare and other high-risk data environments: A systematic review. Cureus. 2025;17(6):e85446. doi:10.7759/cureus.85446.
- Selvaperumal D, et al. Artificial intelligence-enabled zero-trust cyber security framework for smart healthcare infrastructure. Int J Artif Intell Mach Learn. 2026;6(2 Suppl):204-217. doi:10.51483/IJAIML.6.2s.2026.204-217.
- Abbas SR, Seol H, Abbas Z, Lee SW. Exploring the role of artificial intelligence in smart healthcare: A capability and function-oriented review. Healthcare (Basel). 2025;13(14):1642. doi:10.3390/healthcare13141642.
- Al-Nafjan A, et al. Artificial intelligence in predictive healthcare: A systematic review. J Clin Med. 2025;14(19):6752. doi:10.3390/jcm14196752.
- Qureshi SS, et al. Advanced AI-driven intrusion detection for securing cloud-based industrial IoT. Egypt Inform J. 2025;30:100644. doi:10.1016/j.eij.2025.100644.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 785-794. doi:10.1145/2939672.2939785.
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. In: Proceedings of the 8th IEEE International Conference on Data Mining; 2008. p. 413-422. doi:10.1109/ICDM.2008.17.
- Abadi M, Agarwal A, Barham P, Brevdo E, Chen Z, Citro C, et al. TensorFlow: A system for large-scale machine learning. In: Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI); 2016. p. 265-283.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.