Ce protocole présente un flux de travail reproductible basé sur l'apprentissage profond utilisant des données cycliques multicanal et des caractéristiques conçues pour prédire l'état de santé, la durée de vie utile restante et les performances de stockage d'énergie des batteries lithium-ion.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Un flux de travail d'apprentissage profond reproductible pour prédire les performances des batteries lithium-ion à l'aide de données de cyclage multicanaux
Dans cet article
Résumé
Résumé
Ce protocole présente un flux de travail reproductible basé sur l'apprentissage profond pour prédire les performances des batteries lithium-ion à l'aide de données cycliques multicanal. Afin de surmonter les limites des modèles basés sur les données existants en matière d'intégration d'informations multisources et de représentation des caractéristiques, la méthode utilise cinq jeux de données publics sur les batteries. Les entrées comprennent les signaux opérationnels bruts, tels que la tension, le courant, la capacité, la température, la résistance interne, ainsi que l'efficacité coulombique et énergétique, combinés à des caractéristiques élaborées telles que la capacité incrémentielle, la tension différentielle et le flux énergétique. Le protocole décrit des procédures standardisées de prétraitement permettant de construire des tenseurs temporels au niveau des batteries sur plusieurs fenêtres d'observation. Afin d'améliorer la reproductibilité, le flux de travail évalue différentes architectures de réseaux neuronaux candidates, notamment des réseaux neuronaux profonds, des réseaux neuronaux convolutifs (CNN), des réseaux à mémoire à long court terme (LSTM), des modèles CNN–LSTM et des modèles basés sur des transformateurs, en utilisant des graines aléatoires fixes, des exécutions d'évaluation répétées et un suivi de l'environnement. Les résultats représentatifs ont montré que l'architecture CNN–LSTM intégrant des données multicanal et des caractéristiques élaborées atteignait des performances prédictives favorables parmi les modèles évalués. La configuration sélectionnée a obtenu une erreur absolue moyenne de 0,024 et une valeur R2 de 0,955 pour l'estimation de l'état de santé, tout en conservant de hautes performances prédictives pour l'estimation de la durée de vie restante et de l'énergie déchargeable. Des analyses d'ablation et de robustesse ont en outre mis en évidence la contribution de l'intégration des caractéristiques multicanal et la stabilité du flux de travail axé sur la reproductibilité lors d'évaluations répétées. Cette méthodologie standardisée fournit un cadre reproductible pour la gestion du cycle de vie des batteries et la modélisation prédictive dans diverses conditions de fonctionnement.
Introduction
Les batteries au lithium-ion jouent un rôle central dans la transition mondiale vers les énergies renouvelables en raison de leur densité énergétique élevée, de leur longue durée de cycle et de leurs faibles taux d'autodécharge dans des applications allant de l'électronique portable aux systèmes de stockage d'énergie à l'échelle du réseau. Toutefois, une utilisation prolongée entraîne inévitablement une dégradation progressive de la capacité et une augmentation de la résistance interne1. Cette baisse de performance réduit non seulement la viabilité économique, mais introduit également de graves risques pour la sécurité, notamment le déclenchement thermique. Alors que le déploiement de systèmes de stockage d'énergie à grande échelle continue de s'accélérer, la gestion du cycle de vie des batteries devient de plus en plus complexe2. Les protocoles traditionnels de surveillance basés sur des seuils et les inspections manuelles s'avèrent insuffisants dans des environnements de fonctionnement dynamiques3. De plus, le recours à un seul paramètre ne permet pas de prédire avec précision l'état de santé (SOH) ou la durée de vie résiduelle (RUL) des batteries soumises à des variations des taux de charge-décharge, des températures ambiantes et des tensions de décharge4. Bien que le flux de travail actuel ait été principalement validé à l'aide de jeux de données de cyclage contrôlés en laboratoire, l'architecture multicanal et le cadre de modélisation temporelle pourraient permettre une adaptation future aux conditions de fonctionnement dynamiques rencontrées dans les applications des véhicules électriques et dans des environnements environnementaux variables.
La dégradation des batteries est un processus électrochimique hautement complexe et non linéaire, provoqué par la croissance de l'interphase solide-électrolyte, la perte de lithium actif et la détérioration structurale des matériaux d'électrode. Historiquement, l'estimation d'état s'est appuyée sur des modèles équivalents de circuits ou sur des équations aux dérivées partielles (EDP) électrochimiques et physiques5. Bien que ces modèles physiques fournissent des informations mécanistiques précieuses, ils souffrent d'une charge de calcul importante et de difficultés d'identification des paramètres lors du traitement de signaux couplés multicanal. Par conséquent, leur mise en œuvre en temps réel dans des systèmes embarqués de gestion de batterie (BMS) est fortement limitée par la complexité des cinétiques de diffusion et la variabilité environnementale dans des conditions de décharge à haut débit6. En revanche, le flux de travail basé sur l'apprentissage profond (DL) proposé concentre la majeure partie de la charge de calcul dans la phase d'entraînement hors ligne, tandis que le modèle entraîné effectue une inférence relativement rapide lors du déploiement. Ce cadre pourrait donc permettre une mise en œuvre future dans des BMS à ressources limitées et dans des environnements de calcul en périphérie.
Récemment, les approches d'apprentissage profond (DL) fondées sur les données se sont imposées comme des outils puissants en raison de leurs capacités exceptionnelles de modélisation non linéaire. Néanmoins, les méthodologies actuelles d'apprentissage profond présentent deux limitations majeures. Premièrement, de nombreuses approches s'appuient principalement sur des courbes de dégradation de capacité unique ou sur des seuils spécifiques de tension de décharge, tout en négligeant les corrélations spatiotemporelles inhérentes aux réponses cycliques multicanal, telles que la tension, le courant et la température. Cette limitation réduit la robustesse du modèle dans des scénarios de fonctionnement à multiples conditions7. Des études antérieures ont montré que la non-prise en compte des états thermiques lors d'opérations complexes peut accélérer l'accumulation d'erreurs de prédiction8,9. Deuxièmement, un défi persistant de reproductibilité existe dans le domaine de l'apprentissage automatique (ML). Les variations des conditions expérimentales, les pipelines de prétraitement insuffisamment décrits et le choix arbitraire des hyperparamètres des réseaux de neurones entraînent fréquemment l'échec de modèles pourtant robustes lors de la validation croisée entre jeux de données10. Afin de réduire le risque de fuite d'information durant le prétraitement et la prévision précoce des cycles, le flux de travail proposé détermine les facteurs d'échelle de normalisation et les références des caractéristiques élaborées exclusivement à partir des jeux de données d'entraînement, avant toute validation externe ou évaluation croisée entre jeux de données.
Pour combler ces lacunes essentielles, l'objectif général de ce protocole est de présenter un flux de travail d'apprentissage profond (DL) automatisé et hautement reproductible permettant de prédire les performances de stockage d'énergie des batteries lithium-ion à l'aide de données cycliques multicanal. La logique sous-jacente à cette méthode consiste à capturer explicitement les dépendances complexes à long terme associées à la dégradation des batteries en intégrant des données de séries chronologiques cross-modales au sein d'une architecture de réseau neuronal en haute dimension. Un avantage majeur de ce protocole par rapport aux approches existantes basées sur la physique ou l'apprentissage profond réside dans sa standardisation globale, qui établit un pipeline complet allant du prétraitement des signaux bruts à l'ingénierie des caractéristiques, en passant par l'entraînement du modèle et l'évaluation de l'incertitude. Bien que des architectures hybrides de réseaux neuronaux aient déjà été étudiées auparavant, le flux de travail actuel met l'accent sur une intégration multicanal standardisée en alignant les variables électrochimiques de cyclage avec des caractéristiques de dégradation conçues dans un cadre d'entraînement axé sur la reproductibilité. Contrairement à de nombreux flux de travail précédemment rapportés, ce protocole intègre des configurations standardisées de paramètres, des graines aléatoires fixes, des exécutions d'évaluation répétées et un suivi complet de l'environnement afin d'améliorer la reproductibilité sur des jeux de données de batteries hétérogènes et dans différents contextes de laboratoire. En outre, le flux de travail compare systématiquement plusieurs architectures de réseaux neuronaux afin d'évaluer la stabilité prédictive et les performances selon différentes configurations d'entrée. Dans les jeux de données et les conditions expérimentales évalués, l'architecture combinant réseau neuronal convolutif et mémoire à long court terme (CNN–LSTM) a montré des performances prédictives favorables par rapport aux modèles CNN autonomes et aux modèles basés sur des transformeurs évalués, en combinant l'extraction de caractéristiques locales avec la modélisation de séquences temporelles à longue portée, tout en conservant une complexité computationnelle modérée. Ce protocole convient particulièrement aux chercheurs et ingénieurs souhaitant développer des modèles prédictifs reproductibles et adaptatifs à l'environnement pour la gestion du cycle de vie des batteries.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Une approbation éthique institutionnelle n’était pas requise pour cette étude, car la recherche a utilisé exclusivement des ensembles de données publics sur le cyclage des batteries lithium-ion et n’a impliqué ni participants humains, ni sujets animaux, ni échantillons biologiques.
1. Acquisition et organisation des données
- Acquérir des jeux de données de cyclage multicanal
- Téléchargez des jeux de données de cyclage de batteries lithium-ion à partir de référentiels publics contenant des enregistrements de charge-décharge. Obtenez directement les jeux de données CALCE, SANYO, PANASONIC, KOKAM et GOTION depuis les référentiels en libre accès de leurs institutions respectives ou via les liens d'identifiant d'objet numérique afin de garantir la cohérence des versions des jeux de données.
- Sélectionnez des échantillons de batteries comportant un nombre complet de cycles, des mesures de capacité et au moins une courbe continue de charge-décharge. Vérifiez la continuité en vous assurant qu'aucune interruption supérieure à deux heures ne se produit au sein d'un cycle unique, et que les phases à courant constant et à tension constante sont entièrement enregistrées.
- Filtrer les enregistrements bruts de cyclage
- Filtrez les enregistrements bruts de cyclage afin de conserver les échantillons contenant des mesures de température, de résistance interne, d'efficacité coulombique et d'efficacité énergétique. Excluez les cellules de batterie qui ne disposent pas de ces canaux d'état obligatoires du flux d'analyse, car la fusion ultérieure de caractéristiques multicanal nécessite un ensemble complet de variables physiques d'entrée.
- Supprimez les cycles contenant des enregistrements incomplets, des horodatages incohérents, des procédures d'essai non définies ou des conditions de terminaison de charge-décharge ambiguës. Définissez les cycles anormaux comme étant ceux qui présentent des baisses soudaines de capacité excédant 5 % entre des cycles adjacents, des mesures de tension en dehors de la plage de fonctionnement spécifique à la chimie, ou des intervalles d'horodatage non monotones.
- Construire une base de données temporelle de batteries
- Organisez chronologiquement les enregistrements de cyclage conservés afin de construire une base de données de séries temporelles au niveau de la batterie.
- Stockez les jeux de données traités au format de données hiérarchique version 5 (HDF5). Conservez une structure de répertoire normalisée organisée par source du jeu de données, système chimique et identifiant individuel de cellule de batterie.
- Attribuez des identifiants uniques aux cellules de batterie individuelles avant la partition du jeu de données. Mettez en œuvre un regroupement basé sur l'identifiant de la cellule de batterie lors de la séparation entre ensemble d'apprentissage et ensemble de test, afin de garantir que tous les cycles consécutifs provenant d'une même batterie physique restent exclusivement dans un seul sous-ensemble du jeu de données.
REMARQUE : Conservez séparément les jeux de données bruts d'origine avant tout prétraitement, normalisation, rééchantillonnage ou ingénierie de caractéristiques.
- Définir des fenêtres d'observation
- Construisez des fenêtres d'observation multicanal en utilisant les 50 premiers cycles, les 100 premiers cycles, et les 20 % initiaux de la durée de vie totale de la batterie. Calculez le seuil de 20 % de la durée de vie en multipliant la durée de vie totale en cycles avant la dégradation de capacité en fin de vie par 0,2.
- Alignez les mesures de tension, courant, capacité, température, résistance interne et efficacité au sein de chaque fenêtre d'observation avant la construction du tenseur.
- Formatez la structure d'entrée finale sous la forme d'un tenseur tridimensionnel composé de la longueur de la fenêtre d'observation, de 128 points d'échantillonnage normalisés par cycle, et de l'ensemble ordonné de caractéristiques multicanal.
2. Prétraitement des données et ingénierie des caractéristiques
- Prétraiter les données brutes de cyclage
- Appliquer un prétraitement uniforme aux jeux de données bruts de cyclage afin de standardiser la qualité des données provenant de toutes les sources de batteries. Exécuter toutes les procédures de prétraitement, de synchronisation et de standardisation à l’aide de Python 3.10, avec la bibliothèque Pandas pour la manipulation des séries temporelles et SciPy pour l’interpolation numérique.
- Supprimer les valeurs aberrantes, détecter les données manquantes, calibrer les horodatages, identifier les phases de charge et de décharge, et normaliser les fréquences d’échantillonnage avant toute analyse ultérieure. Appliquer une méthode de seuil basée sur un score Z modifié, avec un critère de rejet supérieur à 3,0, pour la détection d’anomalies.
- Détecter automatiquement les valeurs manquantes à l’aide de l’identification des indicateurs NaN dans tous les tableaux numériques. Différencier les phases de charge et de décharge selon la polarité du courant en attribuant les valeurs de courant positives aux cycles de charge et les valeurs négatives aux cycles de décharge.
- Reconstruire les segments de signal manquants à l’aide de polynômes d’interpolation d’Hermite cubiques par morceaux afin de préserver la dynamique temporelle électrochimique lors de l’alignement des transitions de phase.
- Recalculer les courbes de cyclage
- Recalculer les courbes de cyclage lorsque des variations de densité d’échantillonnage ou des dérives de signal sont détectées entre les jeux de données. Déclencher automatiquement le recalcul chaque fois que l’intervalle entre deux mesures consécutives s’écarte de plus de 10 % par rapport à la fréquence médiane d’échantillonnage de la phase de cyclage correspondante.
- Standardiser le nombre de points d’échantillonnage dans chaque cycle afin de réduire les variations liées à la plateforme d’enregistrement. Projeter toutes les séquences temporelles sur une grille spatiale fixe à l’aide d’une interpolation linéaire unidimensionnelle.
- Compresser ou étendre chaque profil de charge-décharge en exactement 128 points d’échantillonnage équidistants avant la construction du tenseur.
- Normaliser les variables continues
- Normaliser toutes les variables continues avant l’entraînement du modèle afin de stabiliser la convergence du réseau et de réduire les biais liés à l’échelle. Appliquer une normalisation Min-Max pour transformer toutes les variables continues dans une plage numérique comprise entre 0 et 1.
- Calculer tous les paramètres de normalisation exclusivement à partir du jeu de données d’entraînement. Appliquer les paramètres de normalisation figés aux jeux de données de validation et de test afin de réduire le risque de fuite temporelle vers l’avant lors de la prédiction des premiers cycles.
- Construire des tenseurs d’entrée multicanal
- Diviser les enregistrements continus de cyclage de chaque batterie en segments temporels de longueur fixe. Structurer les segments temporels selon des fenêtres d’observation prédéfinies correspondant aux 50 premiers cycles, aux 100 premiers cycles, ou aux 20 % initiaux du cycle de vie de la batterie.
- Aligner les mesures de tension, courant, capacité, température, résistance interne et efficacité au sein de chaque segment temporel avant la construction du tenseur.
- Concaténer les matrices de caractéristiques alignées en un tenseur tridimensionnel au format (N × 128 × C), où N représente la longueur de la fenêtre d’observation, 128 indique les points d’échantillonnage normalisés à l’intérieur du cycle, et C désigne le nombre total de canaux de caractéristiques physiques et calculées.
- Extraire les caractéristiques calculées
- Extraire des caractéristiques électrochimiques calculées à partir des signaux bruts de cyclage afin d’améliorer l’identification des motifs de dégradation. Calculer les caractéristiques de capacité incrémentielle et de tension différentielle en déterminant dQ/dV et dV/dQ sur la grille d’échantillonnage normalisée.
- Appliquer un filtrage de Savitzky–Golay pour obtenir des courbes lissées de capacité incrémentielle et de tension différentielle.
- Extraire des indicateurs de dégradation, notamment les décalages du pic de tension, les différences de tension lors des transitions de phase, et les variations du rendement énergétique d’un cycle à l’autre, à partir des caractéristiques électrochimiques filtrées.
3. Construction et entraînement du modèle DL
- Construire des modèles prédictifs candidats
- Élaborer un cadre standardisé d'apprentissage et d'évaluation pour tous les modèles prédictifs présentés dans la Figure 1A. Mettre en œuvre le flux de travail d'apprentissage profond à l'aide de PyTorch version 2.0 ou supérieure.
- Exécuter le flux de travail d'apprentissage à l'aide de scripts modulaires en Python pour le chargement des données, l'initialisation du modèle, l'optimisation et l'évaluation.
- Préparer des modèles de référence d'apprentissage automatique classiques incluant la régression linéaire, la forêt aléatoire et les modèles d'arbres de décision boostés par gradient. Configurer le modèle de forêt aléatoire avec 100 arbres et une profondeur maximale de 10.
- Configurer le cadre d'arbres de décision boostés par gradient avec un taux d'apprentissage de 0,1 et une profondeur maximale d'arbre de 5 à l'aide de la bibliothèque Scikit-learn.
- Préparer des architectures candidates d'apprentissage profond incluant le perceptron multicouche, le CNN unidimensionnel, le réseau LSTM, le CNN–LSTM et les modèles basés sur des transformeurs.
- Standardiser les hyperparamètres principaux pour toutes les architectures d'apprentissage profond en utilisant l'optimiseur AdamW, des fonctions d'activation de type unité linéaire d'erreur gaussienne, une dimension cachée de 128 et un taux de dropout de 0,2.
- Configurer l'architecture CNN–LSTM
- Configurer l'architecture CNN–LSTM afin de fusionner les informations multicanal relatives aux cycles à partir des tenseurs d'entrée (Figure 1B). Construire l'architecture hybride en enchaînant l'extracteur de caractéristiques convolutif à deux couches récurrentes empilées, contenant chacune 128 unités cachées.
- Terminer l'architecture par trois têtes de régression entièrement connectées en parallèle pour prédire simultanément l'état de santé (SOH), la durée de vie restante (RUL) et l'énergie déchargeable.
- Traiter les tenseurs d'entrée multicanal à travers trois couches convolutives unidimensionnelles consécutives aux tailles de noyau 3, 5 et 7 afin d'extraire des caractéristiques localisées à plusieurs échelles.
- Appliquer une normalisation par lot après chaque couche convolutive afin d'améliorer la stabilité du gradient durant l'optimisation.
- Remodeler les cartes de caractéristiques convolutives en séquences temporelles continues avant la modélisation de séquence.
- Alimenter les séquences temporelles encodées dans des couches récurrentes empilées afin de capturer les dépendances de dégradation à long terme sur les fenêtres d'observation prédéfinies.
- Partitionner les ensembles de données pour l'apprentissage du modèle
- Diviser les ensembles de données de cellules de batterie traitées en sous-ensembles d'apprentissage, de validation et de test selon un ratio 70:15:15. Effectuer la division des données à l'aide d'une graine aléatoire fixe de valeur 42.
- Appliquer un échantillonnage stratifié basé sur la chimie des batteries afin de maintenir des distributions de dégradation équilibrées dans tous les sous-ensembles de données.
- Effectuer la partition des données strictement au niveau de la cellule de batterie, plutôt que d'individualiser aléatoirement les cycles, afin de préserver les trajectoires séquentielles de dégradation.
- Conserver chaque cellule de batterie comme une unité indivisible lors de la partition pour éviter toute fuite d'information entre les ensembles de données.
- Vérifier par programme l'isolement des ensembles de données en calculant l'intersection des identifiants de cellules de batterie entre les sous-ensembles d'apprentissage, de validation et de test, et confirmer l'absence de chevauchement.
- Constituer un ensemble de test externe en utilisant l'ensemble complet des données GOTION sur le phosphate de fer lithium (LFP) pour une évaluation hors distribution et une évaluation de la généralisation inter-ensembles.
- Rendre le code source, les fichiers de configuration d'environnement et les partitions de données traitées publiquement accessibles via un dépôt GitHub dédié afin de soutenir la transparence méthodologique et la reproductibilité.
- Initialiser l'apprentissage du modèle
- Définir la fonction de perte de régression comme l'erreur quadratique moyenne avant l'apprentissage. Calculer l'objectif global d'apprentissage en agrégeant les valeurs de perte de chaque cible de prédiction avec un poids égal.
- Définir le taux d'apprentissage initial à 1 × 10⁻³ et choisir une taille de lot de 32 ou 64 selon la taille de l'ensemble de données.
- Utiliser une taille de lot de 64 pour les ensembles de données contenant plus de 5 000 cycles afin d'améliorer l'utilisation du matériel. Utiliser une taille de lot de 32 pour les ensembles de données plus petits afin d'améliorer la stabilité de l'optimisation.
NOTE : Choisir ces hyperparamètres à l'aide d'une évaluation préliminaire par recherche en grille afin d'équilibrer la vitesse de convergence et la stabilité du gradient sur différentes fenêtres d'observation.
- Appliquer des contrôles d'apprentissage
- Appliquer un planificateur dynamique de taux d'apprentissage basé sur les variations de la perte de validation. Réduire le taux d'apprentissage d'un facteur 0,5 si la perte de validation ne s'améliore pas sur 5 époques consécutives.
- Maintenir un seuil minimal de taux d'apprentissage de 1 × 10⁻⁵ durant l'optimisation.
- Arrêter l'apprentissage du modèle après un maximum de 100 époques afin de réduire le surapprentissage.
- Appliquer l'arrêt précoce si la perte de validation ne diminue pas sur 15 époques consécutives. Restaurer les poids du modèle correspondant à l'itération de validation la plus performante.
- Conserver des enregistrements de reproductibilité
- Définir une graine aléatoire fixe de valeur 42 avant l'initialisation et l'apprentissage du modèle.
- Appliquer la graine aléatoire fixe de manière cohérente aux modules aléatoires de Python, à NumPy et au backend PyTorch, tout en désactivant les opérations CUDA non déterministes.
- Enregistrer l'environnement logiciel, les versions des dépendances, les réglages des paramètres, les partitions de données et les sorties d'apprentissage pour chaque exécution expérimentale.
- Exécuter tous les flux de travail d'apprentissage profond sous Ubuntu 22.04 avec accélération CUDA 11.8 sur une station de travail équipée d'un processeur graphique NVIDIA RTX 3090 ou d'un matériel équivalent.
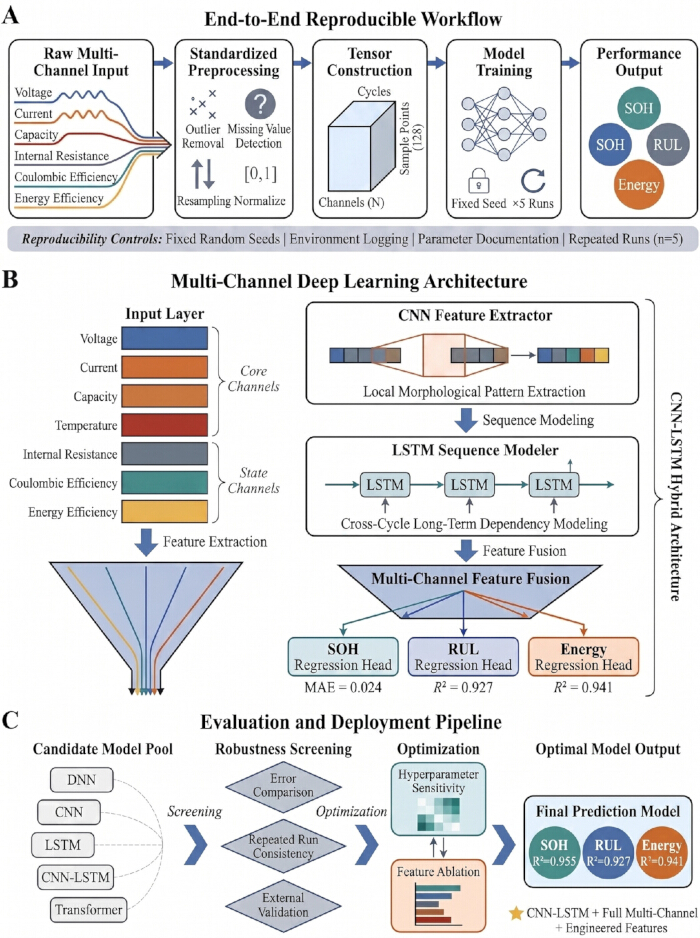
Figure 1. Flux de travail reproductible d'apprentissage profond (DL) pour la prédiction des performances des batteries lithium-ion multicanal. (A) Flux de travail reproductible de bout en bout illustrant l'acquisition de données multicanal, le prétraitement standardisé, la construction de tenseurs, l'entraînement du modèle et la prédiction d'indicateurs de performance des batteries. Les contrôles de reproductibilité incluent des graines aléatoires fixes, des répétitions des entraînements, le suivi des paramètres et la journalisation de l'environnement. (B) Architecture hybride CNN-LSTM utilisée pour l'extraction de caractéristiques multicanal, la modélisation de séquences temporelles, la fusion de caractéristiques et la prédiction de l'état de santé (SOH), de la durée de vie utile restante (RUL) et de l'énergie déchargeable. (C) Pipeline d'évaluation et de déploiement montrant le criblage des modèles candidats, l'évaluation de la robustesse, l'optimisation des hyperparamètres et la sélection finale du modèle. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
4. Évaluation du modèle et prédiction de cibles
- Générer les prédictions du modèle
- Traiter les ensembles de données du test-batterie cible à travers chaque modèle entraîné. Charger les ensembles de données de test prétraités sous forme de tenseurs PyTorch sérialisés avant l'inférence.
- Exécuter le passage d'inférence directe en utilisant un gestionnaire de contexte désactivant les gradients afin d'éviter des mises à jour involontaires des paramètres durant l'évaluation.
- Générer simultanément des prédictions pour chaque indicateur de performance à l'aide des têtes de régression entraînées.
- Extraire les sorties simultanées des trois têtes de régression parallèles configurées pour la prédiction de l'état de santé (SOH), de la durée de vie restante (RUL) et de l'énergie déchargeable.
- Calculer les valeurs cibles de prédiction
- Calculer l'état de santé (SOH) en comparant la capacité disponible actuelle avec la capacité initiale de la batterie.
- Définir la capacité initiale de la batterie comme étant la capacité de décharge maximale enregistrée durant les trois premiers cycles de stabilisation.
- Calculer le SOH comme le rapport entre la capacité du cycle actuel et la référence établie de capacité initiale.
- Estimer la durée de vie restante (RUL) en identifiant le seuil opérationnel au-delà duquel la capacité stable de la batterie cesse.
- Définir la fin de vie comme le numéro de cycle auquel la capacité de la batterie diminue de façon irréversible en dessous de 80 % de la capacité nominale.
- Calculer la RUL comme le nombre de cycles restants à partir du point d'observation actuel jusqu'au seuil défini de fin de vie.
- Prévoir l'énergie déchargeable à partir des conditions de décharge enregistrées.
- Calculer l'énergie déchargeable de référence en intégrant numériquement le produit de la tension de décharge et du courant de décharge sur l'intervalle de décharge, en utilisant la méthode d'intégration trapézoïdale.
- Évaluer la performance prédictive
- Calculer l'erreur absolue moyenne (MAE), l'erreur quadratique moyenne (RMSE), l'erreur moyenne absolue en pourcentage (MAPE) et le coefficient de détermination (R2) pour chaque cible de prédiction.
- Calculer toutes les métriques d'évaluation à l'aide du module de métriques de Scikit-learn en utilisant des formulations statistiques standardisées.
- Appliquer des calculs de métriques identiques à tous les modèles, ensembles de données et configurations d'entrée afin de maintenir la cohérence de l'évaluation.
- Regrouper toutes les métriques de performance sur l'ensemble des échantillons de batteries combinés dans l'ensemble de test indépendant afin d'évaluer la généralisation globale du modèle.
- Présenter les performances stratifiées
- Calculer la moyenne et l'écart-type pour chaque métrique d'évaluation sur plusieurs exécutions expérimentales répétées.
- Dériver les mesures statistiques rapportées à partir de cinq initialisations indépendantes du modèle.
- Indiquer les intervalles de confiance à 95 % conjointement avec les métriques de performance moyennes afin de quantifier l'incertitude prédictive.
- Comparer la performance des modèles selon différentes longueurs de fenêtres d'observation et configurations de canaux d'entrée.
- Stratifier l'analyse comparative en utilisant des fenêtres d'observation correspondant à 50 cycles, 100 cycles et 200 cycles.
- Évaluer la performance prédictive selon plusieurs configurations d'entrée, allant des entrées basées uniquement sur la capacité à l'intégration complète de tenseurs multicanal. Se référer à Figure 1C pour le flux de travail d'évaluation, de criblage de la robustesse et de sélection du déploiement.
5. Analyse de la reproductibilité, de la robustesse et de la sensibilité
- Vérifier la reproductibilité et la robustesse
- Conserver des partitions de données identiques, des flux de travail de prétraitement et des procédures expérimentales identiques dans toutes les évaluations de reproductibilité présentées dans la Figure 2A.
- Calculer le coefficient de variation des métriques d'évaluation principales sur plusieurs essais afin d'évaluer la cohérence de la reproductibilité.
- Répéter toutes les procédures d'évaluation en utilisant le même flux de travail standardisé d'apprentissage et de test.
- Initialiser chaque évaluation répétée avec des poids de réseau aléatoires tout en conservant les mêmes procédures déterministes de chargement et de mélange des données.
- Réaliser des expériences d'apprentissage répétées
- Entraîner les modèles de prédiction plusieurs fois dans des conditions expérimentales identiques en utilisant des valeurs prédéfinies fixes de graine aléatoire afin d'assurer une initialisation reproductible des poids.
- Effectuer cinq exécutions d'apprentissage indépendantes en utilisant des partitions de jeu de données identiques pour réduire la variabilité liée aux données.
- Calculer les métriques finales de performance en moyennant les métriques d'évaluation obtenues lors des cinq exécutions d'apprentissage répétées.
- Regrouper les métriques finales de robustesse en utilisant les scores d'évaluation moyennés plutôt que combiner les tenseurs de prédiction bruts.
- Évaluer la sensibilité aux hyperparamètres
- Modifier individuellement le taux d'apprentissage, la taille du lot, la dimension de la couche cachée et le taux de dropout lors de l'analyse de sensibilité.
- Évaluer des taux d'apprentissage allant de 1 × 10⁻⁴ à 1 × 10⁻², des tailles de lot allant de 32 à 128, des dimensions cachées allant de 32 à 256, et des taux de dropout allant de 0,1 à 0,5.
- Enregistrer les changements correspondants de précision prédictive après chaque ajustement d'hyperparamètre.
- Quantifier la variation de la performance prédictive à l'aide du RMSE et du R2.
- Réaliser une analyse d'ablation des caractéristiques
- Supprimer des canaux d'entrée sélectionnés, notamment la température, la résistance interne et les vecteurs de caractéristiques conçus, du flux d'entrée multicanal.
- Effectuer l'ablation des caractéristiques selon une stratégie « leave-one-out » en supprimant un groupe de caractéristiques à la fois tout en préservant la structure restante du flux d'entrée multicanal.
- Comparer la performance prédictive obtenue après chaque expérience de suppression de caractéristique afin d'évaluer la contribution de chaque groupe de caractéristiques à la stabilité et à la précision du modèle.
- Quantifier la contribution relative de chaque groupe de caractéristiques en calculant le pourcentage d'augmentation de l'erreur absolue moyenne par rapport au modèle de référence multicanal entièrement intégré. Se référer à la Figure 2B pour le flux de travail d'évaluation de la robustesse et d'analyse de sensibilité.
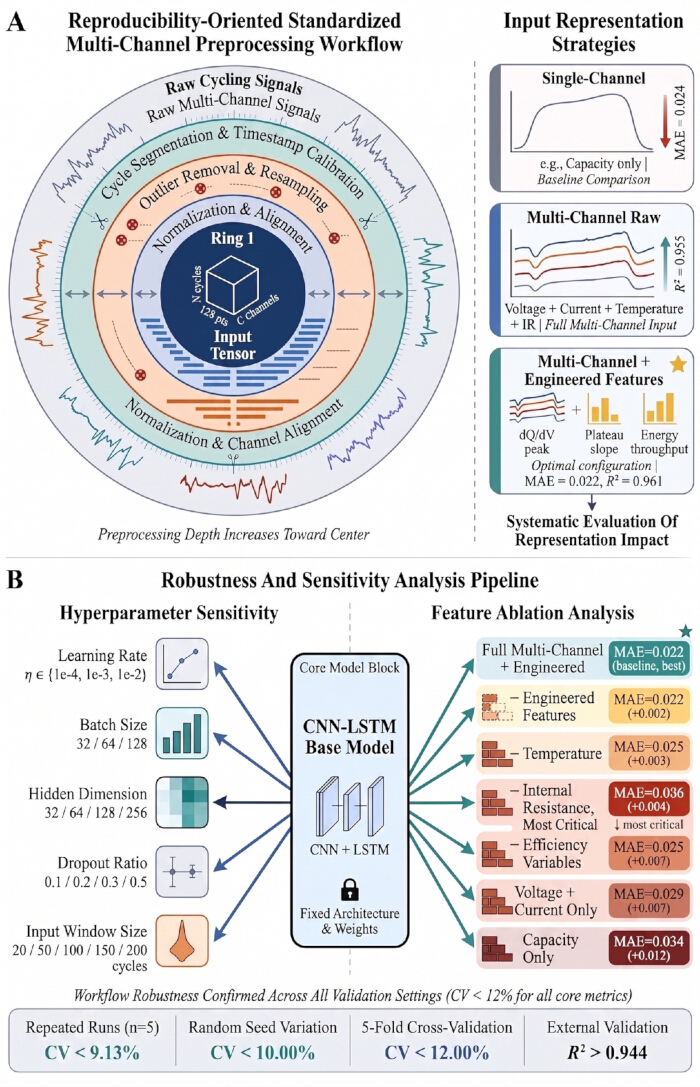
Figure 2. Flux de travail normalisé de prétraitement, évaluation de la robustesse et analyse de sensibilité. (A) Flux de travail standardisé de prétraitement multicanal illustrant le traitement des signaux bruts de cyclage, l'étalonnage des horodatages, la suppression des valeurs aberrantes, le rééchantillonnage, la normalisation, l'alignement des canaux et la construction du tenseur. Les stratégies de représentation des entrées comparent les entrées monocanales, les entrées multicanal brutes et les entrées multicanal combinées à des caractéristiques conçues. (B) Pipeline d'évaluation de la robustesse et d'analyse de sensibilité montrant la perturbation systématique des hyperparamètres, l'évaluation par exécutions répétées, l'analyse d'ablation des caractéristiques, la validation croisée et la validation externe du flux de travail CNN-LSTM. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Signaux cycliques multicanal et distribution des données
Des signaux cycliques multicanal représentatifs et des distributions de performance ont été analysés afin de caractériser le comportement de réponse au cyclage des batteries lithium-ion. L'étude a utilisé cinq ensembles de données de batteries lithium-ion représentant plusieurs systèmes chimiques, notamment l'oxyde de cobalt et de lithium (LCO), l'oxyde de nickel, cobalt et aluminium (NCA), l'oxyde de nickel, manganèse e...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Le flux de travail DL reproductible décrit dans ce protocole a permis de prédire avec précision les performances des batteries au lithium-ion à l'aide de données cycliques multicanal. Le flux de travail a atteint une erreur absolue moyenne (MAE) de test de 0,024 et une valeur R2 de 0,955 pour l'estimation de l'état de santé (SOH) dans les conditions expérimentales évaluées, ce qui soutient son utilité potentielle pour la gestion du cycle de vie des batteries et les applications de surveillance du stockage d'én...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir d'intérêts financiers concurrents ni de conflits d'intérêts.
Remerciements
Les auteurs reconnaissent le soutien institutionnel fourni par le Département de physique de l'Université des sciences et technologies du Sud et par Homerton College, Université de Cambridge, qui ont offert l'environnement académique et les ressources informatiques nécessaires à cette recherche. Les auteurs remercient également les institutions de recherche et les contributeurs ayant rendu publiques les bases de données ouvertes sur les batteries lithium-ion, notamment CALCE, SANYO, PANASONIC, KOKAM et GOTION, permettant ainsi cette analyse multicanal complète.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Jeu de données sur les batteries CALCE | Center for Advanced Life Cycle Engineering (CALCE), Université du Maryland | https://calce.umd.edu/battery-data | Source de données cycliques multicanal sur les batteries lithium-ion destinées à l'entraînement et à la validation du modèle |
| CUDA Toolkit | NVIDIA | Version 11.8 | Accélération GPU pour l'entraînement du modèle d'apprentissage profond |
| Jeu de données GOTION IFP20100140A | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | Validation externe et analyse de la dégradation des batteries multicanal |
| Jeu de données KOKAM SLPB533459H4 | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | Modélisation et validation de la dégradation des batteries multicanal |
| Matplotlib | Équipe de développement de Matplotlib | Version 3.7.1 | Visualisation des performances du modèle, analyse de sensibilité et résultats de reproductibilité |
| NumPy | Développeurs de NumPy | Version 1.24.3 | Calcul numérique et construction de tenseurs |
| Jeu de données PANASONIC NCR18650BD | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | Source de données cycliques multicanal et extraction de caractéristiques conçues |
| Pandas | Développeurs de Pandas | Version 2.0.3 | Organisation des données, prétraitement et gestion des données tabulaires |
| PyTorch | Fondation PyTorch | Version 2.0.1 | Construction et entraînement d'architectures d'apprentissage profond, incluant le modèle CNN–LSTM |
| Python | Fondation logicielle Python | Version 3.10.12 | Prétraitement des données, ingénierie des caractéristiques, entraînement et évaluation du modèle |
| Jeu de données SANYO UR18650E | Référentiel de données prognostiques de la NASA | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | Source de données cycliques multicanal destinées à l'évaluation de la reproductibilité et à la validation du modèle |
| Scikit-learn | Développeurs de Scikit-learn | Version 1.2.2 | Implémentation du modèle de référence, partitionnement du jeu de données et calcul des métriques de performance |
Références
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.