Le cadre MSCNN-LSTM proposé intègre une extraction multi-échelle des caractéristiques spatiales avec une modélisation de séquences temporelles pour la reconnaissance d'actions dans les vidéos sportives, capturant des caractéristiques spatiales fines et des motifs de mouvement temporels tout en atteignant des performances de classification compétitives sur des jeux de données de référence pour les actions sportives.
Article de recherche
Reconnaissance d'actions dans les vidéos sportives à l'aide de réseaux convolutionnels multi-échelles avec modélisation temporelle basée sur la mémoire à long et court terme (LSTM)
Dans cet article
Résumé
Résumé
La reconnaissance d'actions dans les vidéos sportives reste un défi en raison de la complexité des dynamiques de mouvement, des occultations et de la forte variabilité intra-classe. Bien que les approches existantes basées sur l'apprentissage profond, notamment les modèles CNN-BiLSTM et ceux utilisant le transfert d'apprentissage, aient montré leur efficacité dans la reconnaissance d'activités humaines, leurs performances peuvent être limitées dans des scénarios sportifs impliquant des mouvements rapides et variés. De nombreuses méthodes existantes s'appuient sur des filtres convolutionnels à une seule échelle, qui ne parviennent pas efficacement à capturer simultanément les caractéristiques de mouvement fines et grossières. Pour pallier cette limitation, cette étude propose un réseau neuronal convolutionnel multi-échelle (MSCNN) intégré à un réseau à mémoire à long court terme (LSTM) pour la reconnaissance d'actions dans les vidéos sportives. Le MSCNN extrait des représentations spatiales à partir de plusieurs champs réceptifs grâce à des noyaux convolutionnels en parallèle, permettant ainsi d'apprendre à la fois des caractéristiques de mouvement détaillées et contextuelles. Ces caractéristiques sont ensuite traitées par le LSTM afin de capturer les dépendances temporelles et la continuité du mouvement entre les images consécutives. Une évaluation expérimentale a été menée sur les jeux de données de référence UCF11, UCF Sports et JHMDB. Le modèle MSCNN-LSTM proposé a atteint des précisions de classification respectives de 98,3 %, 95,4 % et 81,7 %, surpassant ainsi les approches comparatives évaluées dans cette étude. Une étude d'ablation a en outre mis en évidence la contribution de l'extraction de caractéristiques multi-échelle et de la modélisation temporelle à la performance globale. Ces résultats démontrent le potentiel du cadre proposé pour combiner les informations spatiales et temporelles dans le cadre de la reconnaissance d'actions dans les vidéos sportives.
Introduction
La reconnaissance des activités humaines possède de nombreuses applications dans divers domaines du monde réel, notamment la surveillance intelligente, la détection d'anomalies, la recherche audiovisuelle fondée sur les actions et la surveillance médicale des patients1,2. La reconnaissance d'actions, en particulier dans les flux vidéo provenant de systèmes de surveillance et de plateformes de médias sociaux, présente un potentiel important pour la détection d'anomalies et la compréhension des événements3. Les actions humaines sont identifiées lors de l'analyse vidéo par l'observation de différentes parties du corps, telles que les mains et les jambes. Contrairement aux images fixes, une seule image est souvent insuffisante pour représenter une action4. Par exemple, la position initiale d'activités comme le football et la corde à sauter peut sembler similaire sur une seule image. Les différences entre ces actions deviennent évidentes lorsqu'elles sont observées sur une séquence d'images qui capture les schémas de mouvement et les interactions du corps humain avec son environnement5,6,7. Les abréviations utilisées tout au long de ce manuscrit sont résumées dans Tableau 1 afin d'améliorer la lisibilité et garantir une terminologie cohérente.
| Abbréviation | Forme complète |
| AI | Intelligence artificielle |
| AUC | Aire sous la courbe |
| BiLSTM | Mémoire à long et court terme bidirectionnelle |
| CNN | Réseau neuronal convolutif |
| CUDA | Architecture unifiée de calcul par périphérique |
| F1-score | Moyenne harmonique de la précision et du rappel |
| GPU | Unité de traitement graphique |
| HAR | Reconnaissance des activités humaines |
| JHMDB | Base de données sur le mouvement humain conjoint |
| LSTM | Mémoire à long et court terme |
| mAP-T | Précision moyenne temporelle |
| MCC | Coefficient de corrélation de Matthews |
| MSCNN | Réseau neuronal convolutif multi-échelle |
| ROC | Caractéristique de fonctionnement du récepteur |
| TSI | Indice de stabilité temporelle |
| UCF | Université de Floride centrale |
| VRAM | Mémoire vive vidéo |
Tableau 1 : Liste des abréviations utilisées dans le manuscrit. Abréviations et acronymes courants employés tout au long de l'étude, accompagnés de leurs formes complètes respectives.
La classification rapide et précise des vidéos sportives est importante pour un large éventail d'applications8,9,10, notamment l'analyse sportive, la détection d'événements, la recherche fondée sur le contenu et les systèmes de recommandation11,12,13. Avec la croissance rapide des contenus vidéo liés au sport, les limites des cadres analytiques antérieurs sont devenues de plus en plus évidentes14. Par conséquent, la demande croît pour des approches robustes capables de relever les défis posés par la complexité et la nature dynamique des activités sportives. Les méthodes traditionnelles de classification des vidéos sportives se sont largement appuyées sur des descripteurs conçus manuellement, tels que le flux optique et l'histogramme des gradients orientés (HOG), afin de caractériser les motifs de mouvement et les activités dans les vidéos sportives15.
Les réseaux de neurones convolutifs (ConvNets), qui ont obtenu des résultats remarquables dans la classification d'images statiques, ont également été appliqués à l'analyse de vidéos. Toutefois, la reconnaissance d'actions reste plus difficile, car les vidéos contiennent des informations spatiotemporelles dynamiques. Les approches actuelles basées sur l'apprentissage profond peuvent généralement être regroupées en trois catégories : les réseaux à deux flux16, les réseaux convolutifs 3D, et les architectures à faible coût computationnel. Afin d'apprendre l'information temporelle à partir du flux optique, les réseaux à deux flux utilisent un ConvNet supplémentaire17,18, bien que cette approche soit coûteuse en termes de calcul. Alors que les architectures convolutives 3D telles que C3D, I3D et R3D peuvent modéliser directement l'information temporelle, elles augmentent considérablement le nombre de paramètres, rendant ainsi l'optimisation plus complexe. Les méthodes à faible coût computationnel cherchent à réduire la complexité du modèle en explorant des opérations 3D décomposées.
De plus, comme les réseaux de neurones convolutifs (CNN) peuvent extraire des caractéristiques spatiales locales et les LSTM peuvent capturer des informations contextuelles temporelles, les modèles hybrides peuvent apprendre efficacement des motifs de mouvement spatiotemporels à partir d'entrées capteurs. Des études récentes combinant des architectures de réseaux de neurones convolutifs et récurrents ont produit des résultats encourageants18,19,20. Toutefois, comme les LSTM compressent l'information lors du traitement des séquences, le bruit introduit durant l'extraction des caractéristiques peut nuire à la performance de reconnaissance. Pour résoudre ce problème, plusieurs études ont intégré des mécanismes d'attention21,22. Les mécanismes d'attention permettent au modèle de se concentrer sur les caractéristiques les plus pertinentes pour la tâche de reconnaissance, améliorant ainsi la performance de classification.
Bien que les modèles profonds LSTM bidirectionnels combinés à une extraction de caractéristiques basée sur les CNN aient donné des résultats prometteurs pour la reconnaissance d'activités humaines, plusieurs défis persistent lorsqu'on étend ces architectures à la reconnaissance d'actions dans les vidéos sportives. Premièrement, les architectures CNN-LSTM existantes utilisent souvent une extraction de caractéristiques convolutionnelles à une seule échelle, ce qui peut limiter leur capacité à capturer des actions se produisant à différentes résolutions spatiales et temporelles, comme les mouvements simultanés des joueurs et des objets dans des scènes sportives. Les réseaux convolutionnels multi-échelles, notamment les CNN 3D23 et les CNN à deux flux, ont démontré l'importance de capter les indices spatiaux et de mouvement à différentes échelles, bien que ce concept soit encore peu exploré dans les systèmes hybrides basés sur LSTM. Deuxièmement, la plupart des modèles CNN-BiLSTM antérieurs24 se concentrent principalement sur les dépendances temporelles à court terme, alors que la continuité du mouvement à long terme et les interactions entre objets, fréquentes dans les sports collectifs, peuvent ne pas être correctement représentées. De nombreuses approches basées sur le transfert d'apprentissage, telles que MobileNetV2 et ResNet, s'appuient sur des caractéristiques de trames statiques et n'exploitent pas pleinement les mécanismes d'attention temporelle ou la fusion adaptative de caractéristiques multi-échelles25. En outre, la plupart des modèles existants ont été évalués principalement sur des jeux de données de référence comme UCF11 et JHMDB. Des jeux de données plus récents, spécifiques aux sports et capturant des mouvements complexes de caméra ainsi que des motifs d'activité, tels que SoccerNet et FineGym, restent encore peu explorés. Ces limitations soulignent la nécessité d'un cadre d'extraction de caractéristiques convolutionnelles multi-échelles intégré à des modules de mémoire temporelle, tels que les réseaux LSTM ou BiLSTM, afin de mieux capturer à la fois les représentations spatiales fines et les dépendances temporelles à longue portée dans la reconnaissance d'actions dans les vidéos sportives.
De plus, les réseaux de neurones convolutifs (CNN) peuvent extraire des caractéristiques spatiales locales, tandis que les réseaux LSTM peuvent modéliser le contexte temporel. Par conséquent, les architectures hybrides CNN-RNN ont montré des performances prometteuses dans la reconnaissance des activités humaines26,27. Des études récentes ont étendu les cadres CNN-LSTM classiques en intégrant des stratégies d'apprentissage complémentaires afin d'améliorer la reconnaissance des activités humaines. Par exemple, des mécanismes d'attention ont été introduits pour mettre en évidence les caractéristiques pertinentes à la tâche et supprimer les représentations moins informatives, améliorant ainsi les performances de reconnaissance28. D'autres approches ont adopté l'apprentissage multi-tâches afin d'optimiser conjointement la reconnaissance d'actions et la segmentation temporelle, améliorant l'efficacité de l'apprentissage et la qualité de la représentation des caractéristiques29. Malgré ces progrès, les méthodes existantes peuvent encore avoir une capacité limitée à distinguer des actions visuellement similaires, car les caractéristiques spatiales et temporelles fines ne sont pas toujours capturées efficacement. Tableau 2 résume les forces et les limites des approches existantes30.
| Référence / Année | Méthode utilisée | Jeu(x) de données | Métriques de performance | Principales forces | Limites |
| Hassan et al. (2024)1 | KFDI (Key Frame Dynamic Image) | UCF11 | Précision : 85,3 % | Sélection efficace des images clés et amélioration de la représentation d'image dynamique. | Sensible aux erreurs de sélection de trames ; modélisation temporelle limitée. |
| Zhou et al. (2023)24 | Dilated CNN + BiLSTM + Residual Block | UCF11, UCF Sports | Précision : UCF11 : 89 % et UCF Sports : 92,2 % | Intègre l'apprentissage spatial et temporel ; capture des informations multi-échelles. | Coût computationnel élevé ; risque de surajustement sur de petits jeux de données. |
| Ullah et al. (2025)34 | Caractéristiques locale–globale + QSVM | UCF11 | Précision : 82,6 % | Combine des caractéristiques conçues manuellement et des caractéristiques profondes pour une reconnaissance robuste. | Nécessite un réglage manuel ; évolutivité limitée. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101 et JHMDB | Précision : UCF11 : 97,73 % ; UCF50 : 98,81 % ; UCF101 : 98,46 % ; JHMDB : 83,38 % | Capture les dépendances spatiales et temporelles à longue portée. | Coût computationnel élevé et besoins importants en données. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Précision : 85,1 % | Apprentissage end-to-end des caractéristiques spatio-temporelles. | Besoins élevés en mémoire et en GPU. |
| Karuppannan et al. (2024)35 | Autoencodeur profond + CNN | UCF11 | Précision : 96,2 % | Apprentissage de représentations compactes des caractéristiques. | Modélisation temporelle à long terme limitée. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF Sports, JHMDB, UCF101 et HMDB51 | Précision : KTH : 97,67 % ; UCF Sports : 95,00 % ; JHMDB : 73,13 % ; UCF101 : 92,97 % ; HMDB51 : 69,74 % | Apprentissage temporel efficace basé sur la profondeur. | Nécessite une estimation précise de la profondeur et un prétraitement intensif. |
Tableau 2 : Comparaison des méthodes existantes d'apprentissage profond pour la reconnaissance d'actions dans les vidéos sportives. Résumé des approches représentatives d'apprentissage profond, incluant les ensembles de données, les caractéristiques méthodologiques, les avantages et les limites, mettant en évidence les lacunes de recherche comblées par le cadre proposé MSCNN-LSTM.
Un cadre pour l'animation faciale pilotée par la synchronisation audio a été proposé, combinant un modèle de débruitage facial (FDM) avec un modèle de diffusion latente local-à-global (LG-LDM) afin de générer des animations faciales expressives sur le plan émotionnel. Un auto-encodeur variationnel quantifié par vecteurs centré sur l'émotion (EVQ-VAE) a été utilisé pour reconstruire la géométrie faciale tridimensionnelle détaillée ainsi que les variations d'expression subtiles31. Un cadre de préhension robotique prenant en compte les occultations et utilisant une vision stéréo binoculaire a également été développé pour effectuer la segmentation de la cible, la localisation, l'inférence des occultations et l'estimation de la pose de préhension pour plusieurs cibles dans des conditions d'occultation32. En outre, un cadre en deux étapes pour l'extraction du sol à partir de nuages de points a été introduit, utilisant la projection sur grille et la division adaptative de bacs, où les probabilités d'élévation et de courbure ont été utilisées pour affiner les frontières sol-obstacle après une extraction grossière par analyse des caractéristiques basée sur grille33.
Malgré les progrès considérables réalisés dans la reconnaissance d'actions fondée sur l'apprentissage profond, les méthodes existantes peinent encore à gérer la forte variabilité et la complexité des vidéos sportives, notamment les mouvements rapides, le déplacement de la caméra et les interactions entre plusieurs joueurs. De nombreux modèles traditionnels basés sur des CNN ou des LSTM fonctionnent à une échelle spatiale unique et peuvent donc avoir des difficultés à capturer efficacement à la fois les motifs de mouvement locaux et globaux. En outre, le maintien de la cohérence temporelle dans des séquences de longue durée ou des actions superposées reste un défi. Bien que les méthodes d'apprentissage par transfert aient amélioré l'extraction de caractéristiques, leur adaptation à des jeux de données spécifiques aux sports reste relativement peu explorée.
Cette étude vise à développer et à évaluer un cadre Multi-Scale Convolutional Neural Network–Long Short-Term Memory (MSCNN-LSTM) pour la reconnaissance d'actions dans les vidéos sportives, en intégrant une extraction multi-échelle des caractéristiques spatiales avec une modélisation temporelle basée sur LSTM afin de capturer à la fois des caractéristiques spatiales fines et des dépendances temporelles à long terme. Le cadre proposé utilise des noyaux de convolution complémentaires et une fusion de caractéristiques à plusieurs niveaux pour améliorer la représentation des actions sportives complexes dans des conditions difficiles. Ses performances ont été évaluées sur les jeux de données de référence UCF11, UCF Sports et JHMDB à l'aide de l'exactitude, de la précision, du rappel, du score F1, de la moyenne de la précision moyenne dans le temps (mAP-T), de l'indice de stabilité temporelle (TSI), du coefficient kappa de Cohen (κ), du coefficient de corrélation de Matthews (MCC) et de l'aire sous la courbe ROC (AUC). Les résultats expérimentaux ont démontré des performances compétitives par rapport aux méthodes évaluées dans cette étude, mettant en évidence le potentiel du cadre pour l'analyse sportive, le suivi de la performance des athlètes, la détection automatisée d'événements et la compréhension des vidéos sportives.
Protocole
Cette étude a utilisé un cadre d'apprentissage profond en deux étapes pour la reconnaissance d'actions dans des vidéos sportives, intégrant un réseau neuronal convolutif multi-échelle (MSCNN) à un réseau à mémoire à long et court terme (LSTM). Des jeux de données de référence accessibles au public, à savoir UCF11, UCF Sports et JHMDB, ont été utilisés pour le développement et l'évaluation du modèle. Aucune nouvelle donnée n'a été collectée auprès de participants humains, et aucune information personnellement identifiable n'a été consultée ou traitée. Étant donné que l'étude consistait en une analyse secondaire de jeux de données anonymisés et accessibles au public, et qu'elle ne comportait pas de participation humaine directe, une approbation éthique institutionnelle et un consentement éclairé n'étaient pas requis.
Le flux de travail comprenait un échantillonnage par trames et une normalisation temporelle, suivis d'une extraction de caractéristiques à l'aide du module MSCNN. Les caractéristiques extraites ont ensuite été traitées à l'aide d'un réseau LSTM pour la modélisation temporelle, puis transmises à une couche de classification multiclasse. Enfin, le modèle a été entraîné et évalué à l'aide des jeux de données de référence sélectionnés. Figure 1 illustre l'architecture générale du cadre proposé.
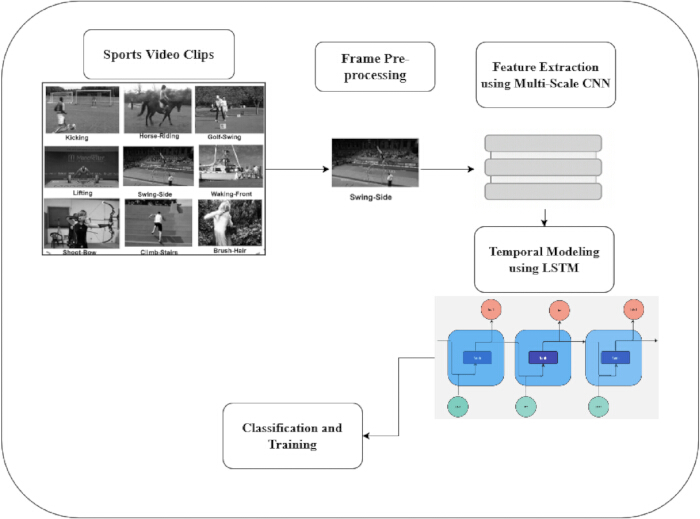
Figure 1 : Architecture proposée MSCNN-LSTM pour la reconnaissance d'actions dans les vidéos sportives. Flux global illustrant le prétraitement vidéo, l'extraction de caractéristiques spatiales multi-échelle, l'apprentissage de séquences temporelles et la classification des actions. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Figure 1 illustre le flux de travail du cadre proposé pour la reconnaissance d'actions dans les vidéos sportives, basé sur une architecture hybride MSCNN-LSTM. Le processus débute avec des extraits vidéo sportifs contenant diverses actions athlétiques, telles que donner un coup de pied, faire de l'équitation ou effectuer un swing de golf. Les vidéos brutes ont été décomposées en images individuelles lors de l'étape de prétraitement, au cours de laquelle les images sont rognées, normalisées et préparées pour l'entrée du modèle. Les images prétraitées ont ensuite été transmises au module MSCNN pour l'extraction de caractéristiques. L'architecture convolutionnelle multi-échelle capture des caractéristiques spatiales à différents champs réceptifs, permettant ainsi d'extraire à la fois des informations locales et contextuelles à partir des images de la vidéo sportive. Les vecteurs de caractéristiques extraits ont ensuite été traités par le réseau LSTM afin de modéliser les dépendances temporelles et l'évolution du mouvement entre les images consécutives. Enfin, le module de classification et d'apprentissage a utilisé les représentations spatiotemporelles apprises pour prédire la catégorie d'action de chaque extrait vidéo. Le cadre proposé comprend quatre étapes séquentielles, commençant par la collecte de données et le prétraitement à l'aide des jeux de données de référence UCF11 (YouTube Actions), UCF Sports et JHMDB. Chaque vidéo sportive a été convertie en une séquence d'images, qui ont été redimensionnées, normalisées et augmentées par rotation, retournement et rognage afin d'améliorer la robustesse face aux variations environnementales. Les images prétraitées ont ensuite été traitées par le Réseau neuronal convolutionnel multi-échelle (MSCNN) proposé, dans lequel des branches convolutionnelles parallèles dotées de noyaux 3 × 3, 5 × 5 et 7 × 7 extraient des caractéristiques spatiales locales et contextuelles complémentaires. Ces caractéristiques multi-échelles ont été concaténées puis affinées à l'aide d'une normalisation par lot et d'un regroupement maximal afin de générer des représentations de caractéristiques compactes. Les caractéristiques au niveau des images ainsi obtenues ont ensuite été transmises à un réseau à mémoire à long et court terme (LSTM) pour modéliser les dépendances temporelles entre les images consécutives. Les sorties finales du LSTM ont été aplaties puis transmises à des couches entièrement connectées avec une activation ReLU, suivies d'un classifieur Softmax pour prédire la catégorie d'action. Le réseau a été entraîné à l'aide de l'optimiseur Adam, d'une fonction de perte d'entropie croisée et d'une régularisation par abandon (dropout) afin de réduire le surajustement. Les performances du modèle ont finalement été évaluées sur les jeux de données de référence UCF11, UCF Sports et JHMDB à l'aide de l'exactitude, de la précision, du rappel et du score F1.
1. Collecte des données et prétraitement
Trois ensembles de données de référence accessibles au public pour les sports et les actions humaines ont été utilisés dans cette étude. Ces ensembles de données contiennent des séquences vidéo réelles de sports, avec des mouvements de caméra, des points de vue et des complexités de fond variables. Plus précisément, l'étude a utilisé UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), qui contient 11 catégories d'actions extraites de 1 168 vidéos YouTube enregistrées auprès d'environ 25 individus, avec plusieurs échantillons par action. La base de données de mouvements humains annotés conjointement (JHMDB)34,35 contient 21 classes d'actions et 928 vidéos annotées. L'ensemble de données UCF Sports comprend 10 classes d'actions et 150 séquences vidéo capturées à partir de sources de diffusion avec une résolution de 720 × 480 pixels (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
Dans leur ensemble, ces ensembles de données couvrent à la fois les sports individuels et collectifs et offrent une variabilité en durée temporelle et en échelle visuelle permettant d'évaluer le cadre de reconnaissance d'actions MSCNN-LSTM proposé. Dans le cadre du processus de contrôle de qualité des données, les ensembles de données UCF11, UCF Sports et JHMDB ont été examinés afin d'identifier les vidéos corrompues, les fichiers en double et les séquences comportant des annotations incomplètes. Aucun échantillon répondant à ces critères d'exclusion n'a été identifié ; par conséquent, toutes les vidéos disponibles ont été conservées pour l'analyse ultérieure. Les ensembles de données ont ensuite été divisés en sous-ensembles d'apprentissage (70 %), de validation (15 %) et de test (15 %) à l'aide d'une stratégie de division aléatoire cohérente. Figure 2 présente des images représentatives utilisées pour l'apprentissage et l'évaluation.
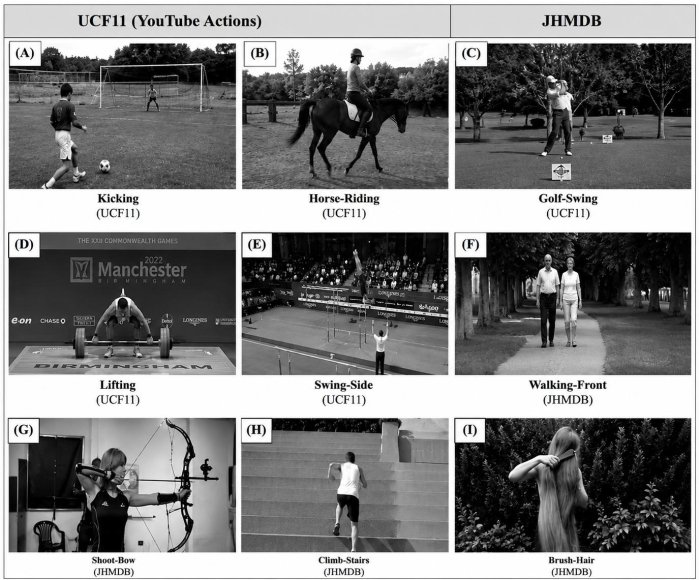
Figure 2 : Images représentatives provenant des jeux de données de référence pour la reconnaissance d'actions sportives. Les panneaux (A–D) montrent des exemples du jeu de données UCF11 (YouTube Actions), les panneaux (E–H) du jeu de données UCF Sports, et les panneaux (I–L) du jeu de données JHMDB. Ces images illustrent les variations des classes d'actions, des points de vue, des arrière-plans, des conditions d'éclairage et de la complexité des mouvements. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Le modèle de reconnaissance d'actions proposé a été évalué sur les jeux de données de référence UCF11, UCF Sports et JHMDB, comme résumé dans le Tableau 3. Ces jeux de données représentent des motifs de mouvement variés et des conditions environnementales difficiles. Le jeu de données UCF11 (Actions YouTube) contient des actions sportives réparties en 11 classes, acquises dans des conditions variables d'éclairement, de point de vue et de fond. Le jeu de données UCF Sports comprend 150 vidéos de sports de terrain provenant de diffusions professionnelles, présentant des séquences de mouvement réalistes. Le jeu de données JHMDB fournit des annotations détaillées de mouvement humain pour 21 catégories d'actions fines et sert de jeu de référence pour la reconnaissance d'actions spatiotemporelles. Ensemble, ces jeux de données ont été utilisés pour évaluer les performances du modèle dans des scénarios d'actions sportives et humaines. Le réseau a été entraîné à l'aide de l'optimiseur Adam pendant 100 époques, avec une taille de lot de 32, un taux d'apprentissage initial de 0,001 et une fonction de perte d'entropie croisée. Le modèle présentant la perte de validation la plus faible a été sélectionné pour l'évaluation finale. Toutes les expériences ont utilisé une graine aléatoire fixe de 42. L'arrêt prématuré et la réduction du taux d'apprentissage en plateau ont été appliqués pour améliorer la convergence, et un élagage des gradients avec un seuil de 5,0 a été utilisé lors de l'entraînement du LSTM afin d'éviter l'explosion des gradients. Le modèle MSCNN-LSTM proposé comportait environ 15 millions de paramètres entraînables. La configuration matérielle et logicielle utilisée pour l'implémentation est résumée dans le Tableau 4. Étant donné que les distributions des classes étaient suffisamment équilibrées, aucune procédure supplémentaire de pondération des classes ou de rééchantillonnage n'a été appliquée. Les modèles comparateurs ont été implémentés en utilisant les hyperparamètres rapportés dans leurs études d'origine, les paramètres d'entraînement ayant été harmonisés lorsque cela était faisable. Les valeurs de performance ont été rapportées comme la moyenne ± l'écart type obtenus à partir de cinq exécutions indépendantes avec différentes initialisations aléatoires. Les différences entre le modèle proposé et les modèles comparateurs ont été évaluées à l'aide de tests t appariés avec un seuil de significativité de p < 0,05.
| Jeu de données | Nombre de classes | Nombre de vidéos | Résolution (px) | Source | Description |
| UCF11 (YouTube Actions) | 11 | 1168 | Variable (≈ 320×240) | University of Central Florida | Comprend 11 actions humaines provenant de sports (par exemple, tir au basket, plongeon, swing de golf, jonglage au football). Les vidéos sont extraites de YouTube et présentent une grande variabilité d'éclairage, de point de vue et de fond. |
| UCF Sports | 10 | 150 | 720×480 | UCF Sports Action Dataset | Contient des activités sportives telles que le plongeon, l'équitation, le swing de golf, la course et la musculation, enregistrées à partir de véritables séquences télévisées (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | Max Planck Institute for Intelligent Systems | Comprend des activités quotidiennes et sportives telles que la réception, le saut, le brossage des cheveux, le tir et la course, avec des annotations articulaires destinées à l'analyse du mouvement et de la posture. |
Tableau 3 : Caractéristiques des jeux de données de référence utilisés pour l'apprentissage et l'évaluation. Aperçu des jeux de données UCF11, UCF Sports et JHMDB, incluant le nombre de classes d'actions, d'échantillons vidéo, les caractéristiques des jeux de données, ainsi que leurs rôles dans l'apprentissage, la validation et les tests du modèle.
| Paramètres utilisés | Description |
| Langage de programmation | Python 3.8.18 [4] |
| Framework d'apprentissage profond | TensorFlow 2.15.0 [1] |
| Accélérateur GPU | NVIDIA GeForce RTX 3090 (24 Go de mémoire vidéo) [1] |
| Processeur (CPU) | Intel Core i9 @ 3,5 GHz × 16 cœurs |
| Système d'exploitation | Windows 11 |
| Mémoire (RAM) | 64 Go DDR4 |
| Optimiseur | Adam (taux d'apprentissage = 0,001) |
| Taille du lot | 32 |
| Nombre d'époques | 100 |
| Fonctions d'activation | ReLU (couches CNN), Softmax (couche de sortie) |
| Taux de dropout | 0,5 |
Tableau 4 : Environnement de simulation et configuration des hyperparamètres du modèle MSCNN-LSTM proposé. Spécifications matérielles, environnement logiciel, paramètres de l'optimiseur, taux d'apprentissage, taille du lot, nombre d'époques, dimensions des entrées et autres hyperparamètres utilisés lors de l'entraînement et de l'évaluation du modèle.
2. Prétraitement
Avant l'entraînement, chaque vidéo brute était convertie en une séquence de trames ordonnée dans le temps, puis normalisée, échantillonnée temporellement et augmentée. Chaque vidéo d'entrée V était d'abord convertie en une séquence de trames et représentée sous forme d'un tenseur 4D V ∈ RT×H×W×C, où T correspond au nombre de trames, H × W i désigne l'indice de la trame, et C indique le nombre de canaux de couleur (3 pour RGB). Le pipeline de prétraitement comprenait l'extraction des trames, le redimensionnement spatial suivi d'un rognage central ou aléatoire à une résolution fixe (H′, W′), la normalisation de l'intensité par pixel, et une augmentation facultative des données incluant un retournement aléatoire, un changement d'échelle et des variations de couleur, avant l'extraction des caractéristiques. Plus précisément, la normalisation de l'intensité était mise en œuvre soit par une normalisation en score standard comme dans l'Éq. (1).
 (1)
où μ, σ sont les moyennes et les écarts types des canaux calculés sur l'ensemble d'apprentissage, ou selon une normalisation min-max comme dans l'équation (2).
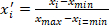 (2)
Après la normalisation, chaque image était représentée par F̃t ∈ RH′×W′×C′ et le tenseur vidéo résultant était représenté par V′ ∈ RT×H′×W′×C. Dans un prétraitement convolutif multi-échelle, plusieurs cartes de caractéristiques spatiales à différents champs récepteurs sont obtenues en appliquant plusieurs convolutions 2D (ou 3D pour les premières convolutions spatiotemporelles) avec des tailles de noyau différentes ; une représentation des caractéristiques temporelles est ensuite générée pour chaque image ou court extrait vidéo, puis transmise au module LSTM. L'article original applique d'abord MobileNetV2, puis Deep BiLSTM pour la modélisation temporelle ; le même pipeline de prétraitement décrit ci-dessus est entièrement compatible avec un remplacement par une convolution multi-échelle + LSTM.
3. Échantillonnage et normalisation temporelle
Étant donné que la durée des vidéos T varie entre les jeux de données et au sein de chaque jeu de données, nous échantillonnons uniformément ou remplaçons temporellement les images afin de fournir à la convolution multi-échelle + LSTM une longueur d'entrée fixe N, exprimée en nombre d'images ou de courts extraits. Les indices d'images uniformes peuvent être calculés selon l'équation (3),
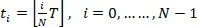 (3)
ainsi, la séquence d'images échantillonnée est Vs = {F̃t0, …, F̃tN−1}. Lorsqu'une fidélité temporelle plus fine est requise, nous effectuons une interpolation temporelle linéaire : pour tout temps fractionnaire rééchantillonné τ ∈ [0, T−1] calculé comme dans l'équation (4).
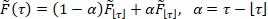 (4)
de sorte que la séquence rééchantillonnée Vs comporte exactement N images et préserve un mouvement fluide. Alternativement, un échantillonnage par courtes séquences contiguës (fenêtre temporelle de longueur w et pas s) produit un ensemble de tenseurs de séquences, chaque séquence Cj ∈ RT×H′×W′×C avec j = 0, …, ⌊(T − w)/s⌋. Pour la normalisation temporelle au sein du réseau, un regroupement temporel simple à plusieurs échelles s'avère efficace : étant donnée une séquence d'activations temporelles X = {x1, …, xN} produite par des convolutions multi-échelles, appliquer les caractéristiques regroupées comme indiqué dans l'équation (5).
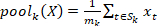 (5)
où Sk est le support temporel pour l'échelle k (par exemple, Sk peut être des blocs non superposés ou des indices dilatés) et mk = |Sk|.
Avant l'extraction des caractéristiques, toutes les vidéos ont été redimensionnées à 224 × 224 pixels et échantillonnées à 25 images par seconde. Chaque expérience a utilisé une longueur de séquence constante de 32 images. Parmi les techniques d'augmentation des données figuraient le recadrage aléatoire (échelle = 0,8–1,0), la rotation aléatoire (±15°), le retournement horizontal aléatoire (probabilité = 0,5) et la modification de la luminosité (±20 %). Les valeurs moyennes d'ImageNet [0,485, 0,456, 0,406] et les écarts types [0,229, 0,224, 0,225] ont été utilisées pour normaliser les valeurs des pixels. Pour chaque séquence vidéo, une sélection uniforme des images a été utilisée pour l'échantillonnage temporel. Les vidéos plus longues ont été recoupées ou échantillonnées uniformément afin de préserver une longueur de séquence constante, tandis que les vidéos comportant moins de 32 images ont été complétées par des zéros. Ces paramètres ont été systématiquement utilisés durant l'apprentissage et l'évaluation.
4. Extraction de caractéristiques à l'aide de MSCNN
Un réseau neuronal convolutif multi-échelle (MSCNN) a été utilisé pour améliorer la représentation spatiale des actions dans les vidéos sportives. Les réseaux neuronaux convolutifs classiques, qui reposent sur une taille unique de noyau, peuvent avoir une capacité limitée à capturer des caractéristiques à plusieurs échelles spatiales. Étant donné que certaines actions sportives présentent des caractéristiques visuelles similaires, il peut être difficile pour une architecture convolutive mono-échelle de capturer simultanément des caractéristiques locales et globales. Pour pallier cette limitation, le cadre proposé utilise des noyaux convolutifs de différentes tailles afin d'effectuer une extraction multi-échelle des caractéristiques et une fusion des caractéristiques.
Dans l'architecture de réseau proposée, des noyaux de convolution 1 × 1 ont été utilisés pour organiser l'information entre les canaux et réduire la dimensionnalité des cartes de caractéristiques d'entrée. En outre, ces couches augmentent la capacité expressive du réseau en introduisant des transformations de caractéristiques supplémentaires et des représentations non linéaires. Des noyaux de convolution de tailles différentes permettent l'extraction d'informations spatiales à plusieurs échelles. Une normalisation séquentielle est effectuée après la fusion pondérée de caractéristiques multi-échelles afin d'améliorer la stabilité de l'apprentissage. Afin d'atténuer les problèmes de disparition et d'explosion du gradient lors de l'entraînement de réseaux profonds, l'architecture proposée utilise des connexions résiduelles et une modélisation temporelle basée sur les LSTM.
La conception multi-échelle améliore la capacité du réseau à capturer des caractéristiques à différentes résolutions spatiales et renforce la capacité de représentation des caractéristiques. De plus, le noyau de convolution conventionnel N × N est décomposé en opérations de convolution N × 1 et 1 × N. Les convolutions N × 1 et 1 × N utilisées dans le module MSCNN sont conçues pour capturer des caractéristiques spatiales directionnelles et multi-échelles complémentaires à partir de trames vidéo individuelles. Ces opérations de convolution améliorent la représentation des caractéristiques spatiales en extrayant des motifs à différentes échelles de champ récepteur. Les relations temporelles entre les trames consécutives sont ensuite modélisées par le module LSTM, qui traite la séquence de caractéristiques extraites par le MSCNN afin d'apprendre les dépendances temporelles à long terme pour la reconnaissance d'actions.
Chaque vidéo sportive V = {F1, F2, …, FT} est décomposée en T images. Pour encoder les variations spatiales, par exemple la posture des joueurs, le flou de mouvement ou la trajectoire du ballon, des branches convolutionnelles à trois échelles différentes interviennent selon s ∈ {1, 2, 3}, correspondant à des tailles de noyau de 3 × 3, 5 × 5 et 7 × 7. Chaque branche extrait des cartes de caractéristiques comme indiqué dans l'équation (6) :
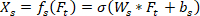 (6)
où Ws et bs sont les poids et les biais de la convolution à l'échelle s, et σ est l'activation ReLU. La couche de fusion multi-échelle agrège les caractéristiques comme indiqué dans l'équation (7) :
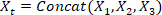 (7)
Ce tenseur de caractéristiques fusionné intègre à la fois des indices de mouvement fins et des informations contextuelles à grande échelle, telles que les activités de groupe. Figure 3 illustre uniquement le module d'extraction de caractéristiques MSCNN. La couche LSTM (256 unités cachées), la couche dense (128 neurones) et la couche dropout (0,5) utilisées pour la modélisation temporelle et la classification sont présentées séparément dans la Figure 4.
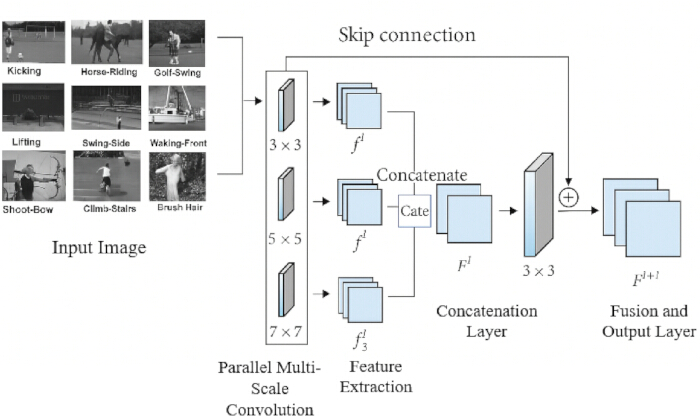
Figure 3 : Module proposé d'extraction de caractéristiques par réseau neuronal convolutionnel multi-échelle (MSCNN). Trois branches convolutionnelles parallèles aux tailles de noyau de 3 × 3, 5 × 5 et 7 × 7 extraient des caractéristiques spatiales complémentaires à différentes échelles, qui sont fusionnées avant la modélisation temporelle par le réseau LSTM. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
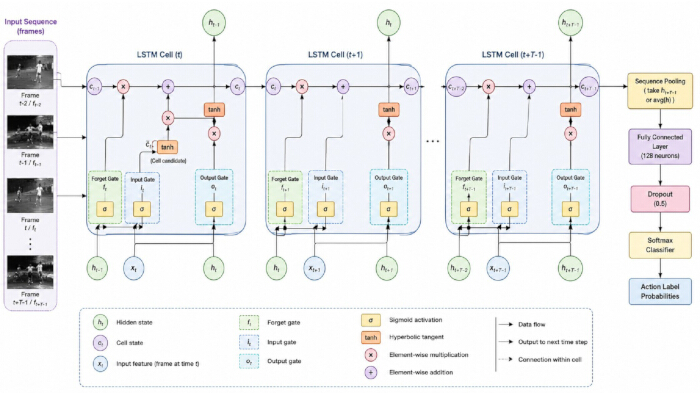
Figure 4 : Architecture LSTM proposée pour la reconnaissance d'actions dans les vidéos sportives. Le module LSTM modélise les dépendances temporelles à l’aide des opérations de portes d’entrée, d’oubli et de sortie sur des trames vidéo consécutives. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Figure 3 illustre le module proposé d'extraction de caractéristiques par réseau neuronal convolutif multi-échelle (MSCNN) pour la reconnaissance d'actions dans les vidéos sportives. Les images vidéo d'entrée ont été traitées en parallèle par trois branches convolutives aux tailles de noyau 3 × 3, 5 × 5 et 7 × 7, chacune contenant 64 filtres afin de capturer des caractéristiques spatiales fines et grossières complémentaires. Les sorties ont été affinées à l'aide d'une normalisation par lot (Batch Normalization), d'une activation ReLU et d'un regroupement maximal (max pooling) 2 × 2, puis concaténées et fusionnées par une convolution 1 × 1 comportant 128 filtres. Une connexion de saut résiduelle a préservé les informations spatiales de bas niveau et amélioré le flux des gradients. Les cartes de caractéristiques fusionnées ont été aplaties puis transmises à une couche LSTM comportant 256 unités cachées pour la modélisation temporelle, suivie d'une couche entièrement connectée à 128 neurones, d'une activation ReLU et d'un taux de désactivation (dropout) de 0,5 avant la classification finale à l'aide d'une couche Softmax. Les cartes de caractéristiques multi-échelle (f1l, f2l et f3l) ont été concaténées pour former la représentation fusionnée (Fl), qui a ensuite été affinée par une convolution 3 × 3 afin de générer la carte de caractéristiques de sortie pour la couche suivante. Cette architecture hiérarchique permet d'apprendre des caractéristiques spatiales complémentaires à plusieurs champs réceptifs, améliorant ainsi les performances de reconnaissance des actions sportives.
5. Modélisation temporelle à l'aide de LSTM
Afin de modéliser l'évolution temporelle le long des séquences vidéo, la séquence de caractéristiques agrégée a été fournie au système LSTM afin de capturer les dépendances dynamiques et la continuité du mouvement. Pour chaque vidéo d'entrée, nous avons d'abord extrait des caractéristiques CNN multi-échelles par image. Soient les images de la vidéo notées I1, …, IT. Pour chaque image t et chaque échelle s, l'encodeur convolutionnel multi-échelle produit un vecteur de caractéristiques ft(s) ∈ Rd. Ensuite, les échelles sont fusionnées en un descripteur d'image unique par projection + concaténation ou par somme pondérée, comme indiqué dans l'équation (8) :
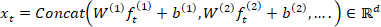 (8)
Ensuite, introduire la séquence {xt}tT=1 dans un LSTM afin de modéliser la dynamique temporelle. Dans la notation standard du LSTM, à l'instant t, les portes et états sont donnés par les équations (9) à (13) :
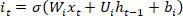 (9)
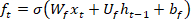 (10)
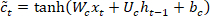 (11)
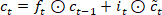 (12)
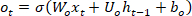 (13)
Ici, σ est l'activation sigmoïde, ⊙ est la multiplication élément par élément. Bien que des architectures LSTM bidirectionnelles puissent être utilisées pour capturer le contexte temporel passé et futur, le cadre proposé emploie un LSTM standard pour modéliser les dépendances temporelles entre les images vidéo séquentielles. Ce choix de conception est conforme à l'architecture MSCNN-LSTM présentée dans cette étude. Après traitement du segment, une représentation du segment a été obtenue (par exemple, dernier état caché ou regroupement temporel) : z = Poolt(vt).
Figure 4 illustre le flux de travail de l'architecture LSTM proposée pour la reconnaissance d'actions sportives. Le réseau recevait une séquence d'images vidéo ou de caractéristiques extraites par un CNN et les traitait à travers des pas de temps successifs (t−2, t−1 et t). Chaque cellule LSTM comprenait une porte d'entrée, une porte d'oubli et une porte de sortie, qui régulaient le flux d'information à travers le réseau. La porte d'entrée intégrait de nouvelles informations dans l'état de la cellule, la porte d'oubli éliminait les informations temporelles non pertinentes, et la porte de sortie produisait l'état caché transmis au pas de temps suivant. L'état de la cellule préservait les dépendances temporelles à long terme, tandis que l'état caché capturait les informations temporelles à court terme. Après un traitement séquentiel, les sorties LSTM étaient agrégées pour générer une représentation temporelle des caractéristiques, qui était ensuite transmise à une couche entièrement connectée et à un classificateur Softmax afin de prédire l'action sportive correspondante. Le réseau était entraîné à l'aide de l'optimiseur Adam pendant 100 époques avec une taille de lot de 32, un taux d'apprentissage initial de 0,001 et une fonction de perte d'entropie croisée. Le modèle présentant la perte de validation la plus faible était sélectionné pour l'évaluation finale. Afin d'assurer la reproductibilité, toutes les expériences ont été réalisées en utilisant une graine aléatoire fixe de 42. L'arrêt précoce et la réduction du taux d'apprentissage en plateau ont été utilisés pour améliorer la convergence, et une limitation des gradients avec un seuil de 5,0 a été appliquée durant l'entraînement du LSTM afin d'éviter l'explosion des gradients. Le modèle MSCNN-LSTM proposé comportait environ 15 millions de paramètres entraînables.
Les scores de classe finaux et les probabilités utilisent une couche linéaire suivie d'une fonction softmax, comme indiqué dans l'équation (14) :
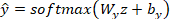 (14)
Entraîner en minimisant la perte d'entropie croisée sur les extraits étiquetés, comme dans l'équation (15) :
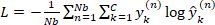 (15)
où Nb est la taille du lot, C le nombre de classes, et y(n) la vérité terrain au format one-hot. Une régularisation (dropout sur les sorties de xt/LSTM, décroissance du poids) et une limitation du gradient sont appliquées pour améliorer la stabilité sur de longues séquences sportives.
Résultats
Le modèle MSCNN-LSTM proposé a été entraîné et évalué sur les ensembles de données UCF11 (YouTube Actions), UCF Sports et JHMDB, qui comprenaient des actions sportives variées, des points de vue différents et des motifs de mouvement diversifiés. Étant donné que les distributions des classes étaient suffisamment équilibrées, aucune procédure supplémentaire de pondération des classes ou de rééchantillonnage n’a été appliquée. Les modèles comparateurs ont été implémentés en utilisant les hyperparamètres indiqués dans leurs études d’origine, les paramètres d’entraînement ayant été harmonisés lorsque cela était possible. Les résultats sont exprimés sous la forme de la moyenne ± l’écart type obtenus à partir de cinq exécutions indépendantes avec différentes initialisations aléatoires. Les différences entre le modèle proposé et les modèles comparateurs ont été évaluées à l’aide de tests t appariés avec un seuil de significativité fixé à p < 0,05.
Figure 5 compare la précision de classification entre les trois jeux de données. Le modèle MSCNN-LSTM a atteint la précision la plus élevée, avec 98,3 % sur UCF11, 95,4 % sur UCF Sports et 81,7 % sur JHMDB. Ces valeurs dépassent celles obtenues par les modèles Dilated CNN–BiLSTM, Two-Stream LSTM et ViT-ReT. La précision plus faible sur JHMDB reflète la difficulté accrue de reconnaître des actions fines dans des vidéos de résolution inférieure.
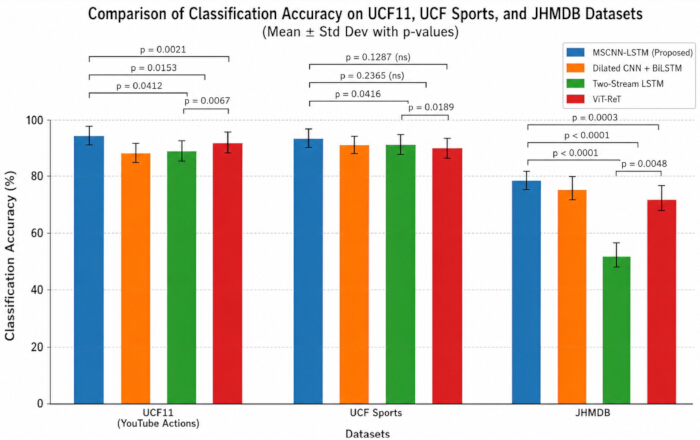
Figure 5 : Comparaison de la précision de classification (%) de différents modèles d'apprentissage profond sur des jeux de données vidéo sportives. Précision de classification des modèles MSCNN-LSTM, ViT-ReT, Two-Stream LSTM et Dilated CNN + BiLSTM sur les jeux de données UCF11, UCF Sports et JHMDB. Les résultats sont exprimés comme moyenne ± écart-type à partir de cinq exécutions indépendantes (n = 5). Les barres d'erreur représentent un écart-type. La significativité statistique a été évaluée à l'aide de tests t appariés bilatéraux (p < 0,05). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Le modèle proposé a également atteint la plus grande précision sur l'ensemble des jeux de données, avec des valeurs d'environ 96 % sur UCF11, 93 % sur UCF Sports et 78 % sur JHMDB (Figure 6). Les valeurs de rappel étaient respectivement d'environ 95 %, 94 % et 77 % (Figure 7), tandis que les scores F1 correspondants étaient d'environ 95,5 %, 93,5 % et 77,5 % (Figure 8). Ces résultats indiquent que le modèle maintient un équilibre favorable entre l'identification correcte des classes d'actions et la limitation des prédictions faussement positives.
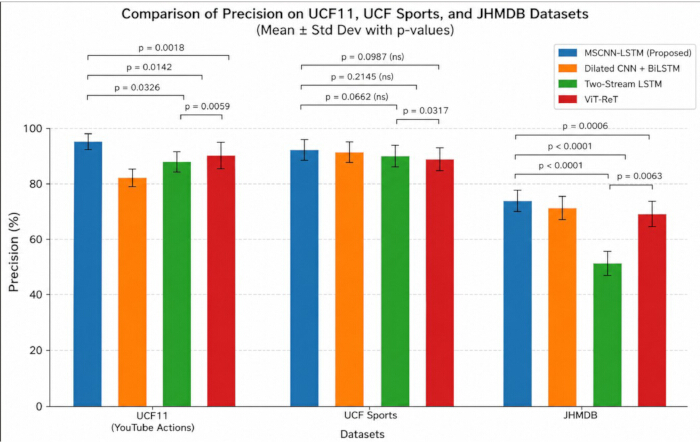
Figure 6 : Comparaison de la précision (%) de différents modèles d'apprentissage profond sur des ensembles de données vidéo sportives. Les valeurs de précision sont indiquées sous forme de moyenne ± écart-type à partir de cinq exécutions indépendantes (n = 5). Les barres d'erreur représentent un écart-type. La signification statistique a été évaluée à l'aide de tests t appariés bilatéraux (p < 0,05). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
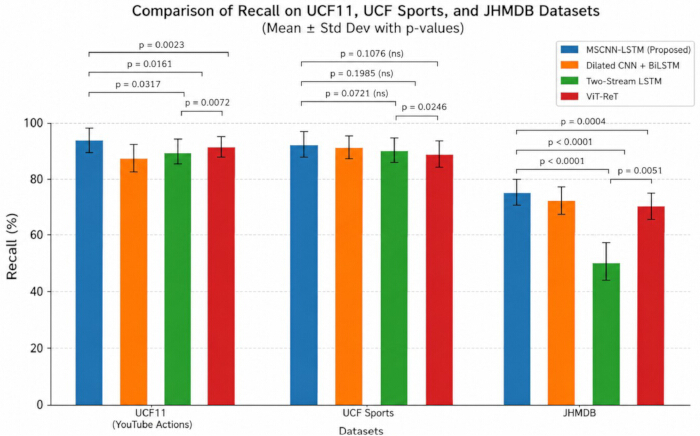
Figure 7 : Comparaison du rappel (%) de différents modèles d'apprentissage profond sur des ensembles de données vidéo sportives. Les valeurs de rappel sont indiquées sous forme de moyenne ± écart-type à partir de cinq exécutions indépendantes (n = 5). Les barres d'erreur représentent un écart-type. La significativité statistique a été évaluée à l'aide de tests t appariés bilatéraux (p < 0,05). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
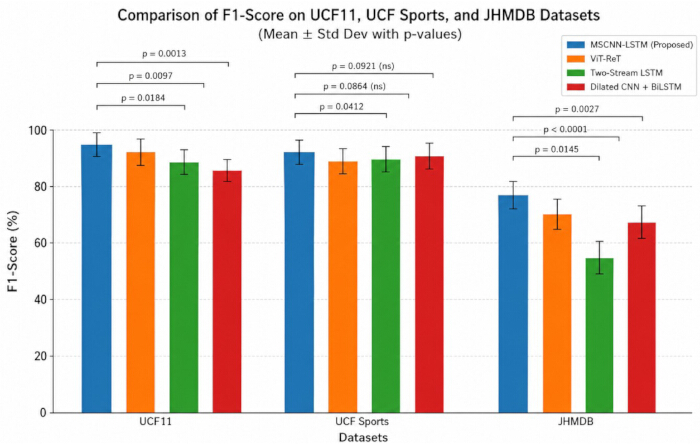
Figure 8 : Comparaison du score F1 (%) de différents modèles d'apprentissage profond sur des ensembles de données vidéo sportives. Les scores F1 sont indiqués comme moyenne ± écart-type à partir de cinq exécutions indépendantes (n = 5). Les barres d'erreur représentent un écart-type. La significativité statistique a été évaluée à l'aide de tests t appariés bilatéraux (p < 0,05). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau 5 présente les résultats du kappa de Cohen et du coefficient de corrélation de Matthews. Sur UCF11, le modèle proposé a atteint κ = 0,96 et MCC = 0,96, contre des valeurs κ/MCC de 0,92/0,92 pour ViT-ReT, 0,90/0,90 pour Two-Stream LSTM et 0,87/0,87 pour Dilated CNN–BiLSTM. Sur UCF Sports, le MSCNN-LSTM a atteint κ = 0,95 et MCC = 0,94, dépassant ainsi les valeurs correspondantes obtenues par ViT-ReT (0,90/0,90), Two-Stream LSTM (0,88/0,89) et Dilated CNN–BiLSTM (0,84/0,85). Sur JHMDB, le modèle proposé a atteint κ = 0,83 et MCC = 0,84, contre 0,74/0,75 pour ViT-ReT, 0,70/0,71 pour Two-Stream LSTM et 0,71/0,72 pour Dilated CNN–BiLSTM. Ces résultats montrent une concordance plus forte entre les étiquettes prédites et les étiquettes de référence pour le modèle proposé.
| Modèle | Jeu de données | Kappa de Cohen (κ) | Coefficient de corrélation de Matthews (MCC) |
| Dilated CNN + BiLSTM [4] | UCF11 (YouTube Actions) | 0,87 ± 0,01 | 0,88 ± 0,01 |
| UCF Sports | 0,84 ± 0,02 | 0,85 ± 0,02 | |
| JHMDB | 0,71 ± 0,03 | 0,72 ± 0,03 | |
| Two-Stream LSTM [38] | UCF11 (YouTube Actions) | 0,90 ± 0,01 | 0,91 ± 0,01 |
| UCF Sports | 0,88 ± 0,02 | 0,89 ± 0,02 | |
| JHMDB | 0,70 ± 0,03 | 0,71 ± 0,03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF11 (YouTube Actions) | 0,92 ± 0,01 | 0,92 ± 0,01 |
| UCF Sports | 0,90 ± 0,01 | 0,90 ± 0,01 | |
| JHMDB | 0,74 ± 0,02 | 0,75 ± 0,02 | |
| MSCNN–LSTM proposé | UCF11 (YouTube Actions) | 0,96 ± 0,01 | 0,96 ± 0,01 |
| UCF Sports | 0,95 ± 0,01 | 0,94 ± 0,01 | |
| JHMDB | 0,83 ± 0,02 | 0,84 ± 0,02 |
Tableau 5 : Comparaison du kappa de Cohen (κ) et du coefficient de corrélation de Matthews (MCC) entre différents modèles d'apprentissage profond. Comparaison des performances des modèles MSCNN-LSTM, ViT-ReT, Two-Stream LSTM et Dilated CNN + BiLSTM sur les jeux de données UCF11, UCF Sports et JHMDB. Des valeurs plus élevées indiquent un meilleur accord entre les étiquettes prédites et les étiquettes réelles, ainsi qu'une fiabilité accrue de la classification. Les valeurs sont exprimées en moyenne ± écart-type (ET) obtenues à partir de cinq exécutions indépendantes (n = 5).
Figure 9 présente les courbes caractéristiques de fonctionnement du récepteur. Le modèle MSCNN-LSTM proposé a obtenu des valeurs d'AUC de 0,975 sur UCF11, de 0,961 sur UCF Sports et de 0,937 sur JHMDB. Les valeurs d'AUC constamment élevées indiquent une forte capacité de discrimination entre les classes d'actions à travers des ensembles de données de complexité différente.
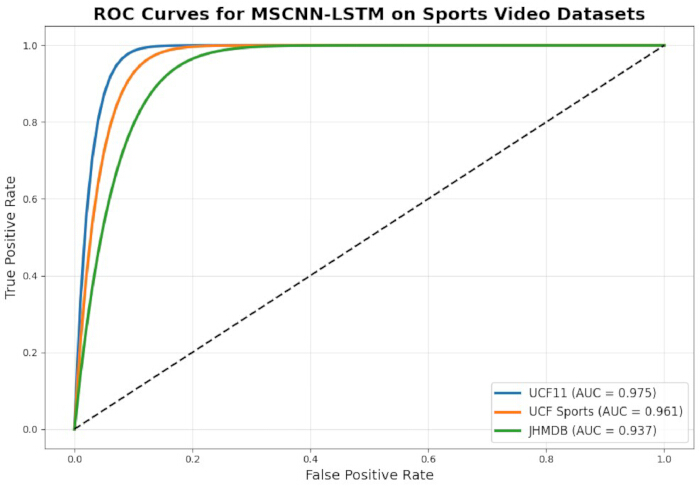
Figure 9 : Courbes caractéristiques de fonctionnement du récepteur (ROC) du modèle MSCNN-LSTM proposé. Courbes ROC pour les jeux de données UCF11, UCF Sports et JHMDB illustrant le compromis entre le taux de vrais positifs et le taux de faux positifs. La surface sous la courbe (AUC) résume la performance discriminante du modèle à différents seuils de classification. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Les résultats de performance temporelle sont résumés dans le Tableau 6. Sur UCF11, le modèle proposé a atteint un mAP-T de 98,3 %, une précision au niveau des images de 96,5 % et un TSI de 0,95. Sur UCF Sports, les valeurs correspondantes étaient de 95,4 %, 94,0 % et 0,93. Sur JHMDB, le modèle a atteint un mAP-T de 81,7 %, une précision au niveau des images de 78,9 % et un TSI de 0,88 (Tableau 7). Ces valeurs étaient supérieures à celles obtenues par les modèles comparateurs et indiquaient une cohérence temporelle et une stabilité des prédictions améliorées, tant pour les séquences d'actions courtes que longues.
| Méthode | Jeu de données | mAP-T (%) | Précision au niveau des images (%) | Indice de stabilité temporelle (IST) |
| Dilated CNN + BiLSTM4 | UCF11 (Actions YouTube) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCF Sports | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| Two-Stream LSTM38 | UCF11 (Actions YouTube) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCF Sports | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer)6 | UCF11 (Actions YouTube) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCF Sports | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (Actions YouTube) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCF Sports | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
Tableau 6 : Comparaison des métriques de performance temporelle pour la reconnaissance d'actions dans les vidéos sportives. Résultats expérimentaux de la précision moyenne sur les segments temporels (mAP-T), de l'exactitude au niveau des images et de l'indice de stabilité temporelle (TSI) pour différents modèles d'apprentissage profond sur les ensembles de données de référence. Les valeurs sont indiquées sous la forme moyenne ± écart-type à partir de cinq exécutions indépendantes (n = 5).
| Configuration | CNN multi-échelle (MSCNN) | LSTM | Précision (%) | F1-Score (%) | mAP-T (%) |
| Benchmark CNN uniquement | ✗ | ✗ | 90,4 ± 1,2 | 89,8 ± 1,3 | 88,9 ± 1,4 |
| CNN + LSTM | ✗ | ✓ | 93,1 ± 0,9 | 92,4 ± 1,0 | 91,7 ± 1,1 |
| MSCNN uniquement | ✓ | ✗ | 94,2 ± 0,8 | 93,6 ± 0,9 | 92,8 ± 1,0 |
| MSCNN-LSTM proposé | ✓ | ✓ | 98,3 ± 0,5 | 97,8 ± 0,6 | 97,1 ± 0,6 |
Tableau 7 : Étude d'ablative du cadre MSCNN-LSTM proposé. Contribution à la performance des composants MSCNN et LSTM dans des conditions d'entraînement et d'évaluation identiques. Les valeurs sont indiquées comme moyenne ± ÉT provenant de cinq exécutions indépendantes (n = 5).
Figure 10, Figure 11, Figure 12 présentent respectivement les matrices de confusion normalisées par ligne pour UCF11, UCF Sports et JHMDB. Les trois matrices montrent une dominance diagonale nette, indiquant que la majorité des classes d'actions ont été correctement identifiées. Des erreurs limitées en dehors de la diagonale sont survenues principalement entre des actions présentant des caractéristiques visuelles ou de mouvement similaires. La matrice JHMDB présente une confusion entre classes relativement plus importante, ce qui est cohérent avec les performances quantitatives plus faibles observées sur cet ensemble de données plus difficile.
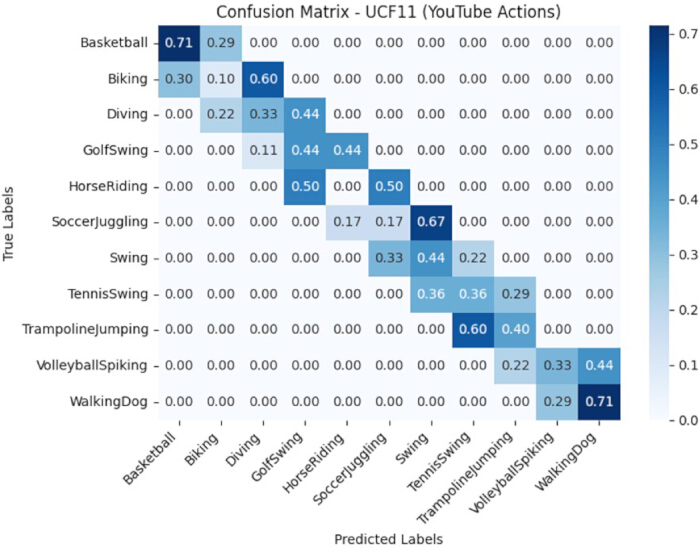
Figure 10 : Matrice de confusion normalisée par ligne du modèle MSCNN-LSTM proposé sur le jeu de données UCF11. Chaque ligne est normalisée à l'unité, et les entrées diagonales représentent le rappel par classe plutôt que la précision globale de classification, qui est indiquée séparément. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
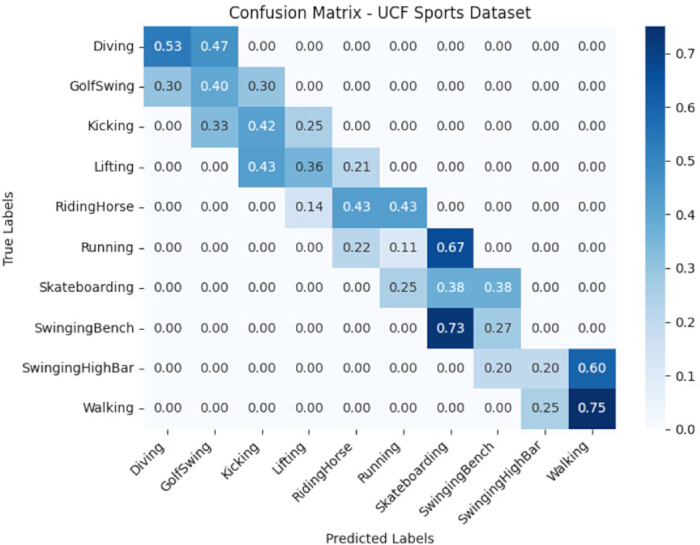
Figure 11 : Matrice de confusion normalisée par ligne du modèle MSCNN-LSTM proposé sur le jeu de données UCF Sports. Chaque ligne est normalisée à l'unité, et les éléments diagonaux représentent le rappel par classe plutôt que la précision globale de classification, qui est indiquée séparément. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
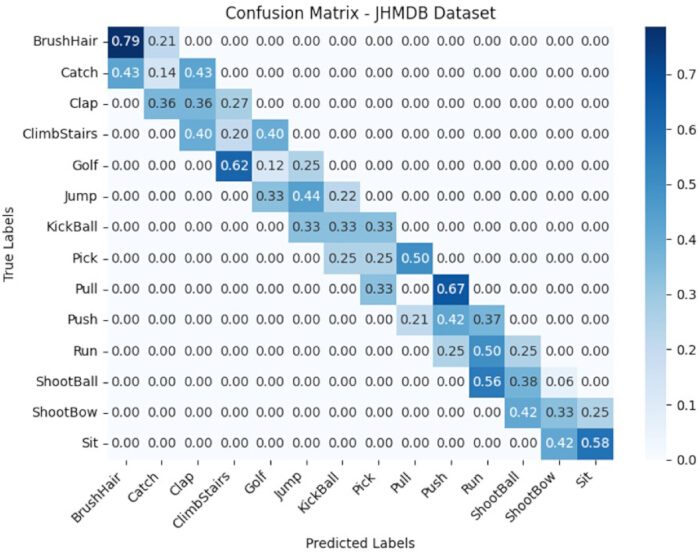
Figure 12 : Matrice de confusion normalisée par ligne du modèle MSCNN-LSTM proposé sur l'ensemble de données JHMDB. Chaque ligne est normalisée à l'unité, et les éléments diagonaux représentent le rappel par classe plutôt que la précision globale de classification, qui est indiquée séparément. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Dans l'ensemble, le cadre MSCNN-LSTM proposé a systématiquement surpassé les modèles comparateurs évalués selon les mesures de classification, d'accord, de discrimination et de stabilité temporelle. Les résultats ont confirmé l'hypothèse selon laquelle la combinaison d'une extraction multi-échelle des caractéristiques spatiales avec une modélisation temporelle fondée sur des LSTM améliore la reconnaissance des actions sportives sur des ensembles de données présentant des niveaux variés de complexité des mouvements, de qualité d'image et de conditions de point de vue.
DISPONIBILITÉ DES DONNÉES :
Les jeux de données analysés au cours de la présente étude sont accessibles publiquement à partir des sources suivantes : le jeu de données UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) et le jeu de données UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Afin de favoriser la reproductibilité de cette étude, le pipeline de prétraitement, la répartition du jeu de données (génération des subdivisions entraînement/validation/test), les fichiers de mise en œuvre, les fichiers de configuration et la documentation d'accompagnement utilisés lors des expériences ont été déposés dans le dépôt Zenodo et sont accessibles publiquement à l'adresse https://doi.org/10.5281/zenodo.21020947.
Discussion
Le cadre MSCNN-LSTM proposé surpasse systématiquement les approches évaluées sur les jeux de données de référence UCF11, UCF Sports et JHMDB. Les méthodes antérieures fondées sur des réseaux CNN dilatés–BiLSTM, des architectures de transformeur visuel (Vision Transformer) et des CNN 3D ont démontré une capacité efficace d'apprentissage des caractéristiques spatiotemporelles, mais peuvent être limitées par une complexité computationnelle élevée, des besoins importants en entraînement ou une représentation insuffisante des motifs de mouvement fins23,24,25. En revanche, le cadre proposé intègre une extraction multi-échelle des caractéristiques spatiales avec une modélisation temporelle fondée sur LSTM, permettant ainsi de capturer à la fois les détails locaux du mouvement et les dépendances temporelles à longue portée. Cette intégration améliore la reconnaissance des actions sportives complexes, réduit la confusion entre classes et renforce la cohérence temporelle, en particulier sur le jeu de données JHMDB, plus difficile. Ces résultats indiquent que le cadre proposé offre une représentation équilibrée des informations spatiales et temporelles par rapport aux approches évaluées basées sur des CNN, des réseaux récurrents ou des transformeurs.
Du point de vue théorique, le cadre MSCNN-LSTM offrait une approche unifiée de la fusion de caractéristiques multi-échelles et de l'apprentissage séquentiel temporel36,37. L'utilisation de champs réceptifs hiérarchiques permettait l'extraction d'informations spatiales à différentes échelles, tandis que le LSTM modélisait les dépendances entre les images consécutives d'une vidéo. Cette conception étendait le pipeline classique CNN-LSTM en préservant les informations spatiales locales et contextuelles avant la modélisation temporelle. La performance constante observée sur des ensembles de données contenant des classes d'actions variées, des motifs de mouvement différents et des points de vue caméra diversifiés soutenait davantage la robustesse de l'architecture proposée.
D'un point de vue pratique, le cadre présenté montre un potentiel pour l'analyse automatisée des sports, l'évaluation de la performance des athlètes, la détection d'événements et la compréhension des vidéos sportives. Toutefois, une validation supplémentaire dans des conditions opérationnelles réelles est nécessaire avant toute mise en œuvre. Bien que l'architecture ait atteint une performance de reconnaissance élevée, sa pertinence pour des dispositifs à ressources limitées ou pour des plateformes d'analyse basées sur le cloud devrait être confirmée par une évaluation complémentaire du coût computationnel, du temps d'inférence, des besoins en mémoire et de la consommation énergétique.
L'étude d'ablation a démontré les contributions complémentaires des composants MSCNN et LSTM. La MSCNN a amélioré l'extraction des caractéristiques spatiales en apprenant des représentations à plusieurs échelles de champs récepteurs, tandis que le LSTM a renforcé la modélisation temporelle en capturant les dépendances de mouvement entre des images consécutives. La configuration complète MSCNN-LSTM a obtenu les meilleures performances, indiquant que l'extraction multi-échelle des caractéristiques spatiales et la modélisation des séquences temporelles ont contribué conjointement à l'amélioration observée dans la reconnaissance d'actions.
Dans l'ensemble, le cadre MSCNN-LSTM proposé a efficacement combiné l'apprentissage des représentations spatiales et temporelles pour la reconnaissance d'actions dans les vidéos sportives. L'évaluation sur les ensembles de données UCF11, UCF Sports et JHMDB a montré une performance améliorée par rapport aux approches d'apprentissage profond évaluées. Ces résultats confirment l'hypothèse selon laquelle l'intégration de caractéristiques convolutionnelles multi-échelles avec une modélisation temporelle basée sur LSTM améliore la reconnaissance d'actions sportives complexes. Néanmoins, une validation sur des ensembles de données plus vastes, plus diversifiés et couvrant plusieurs domaines est nécessaire afin d'établir la généralisation et l'applicabilité dans des conditions réelles.
Plusieurs limites doivent être prises en compte. Premièrement, l'évaluation a été restreinte à des jeux de données de référence accessibles au public et pourrait ne pas représenter pleinement la diversité et la complexité des environnements sportifs réels. Deuxièmement, bien que des partitions fixes pour l'entraînement, la validation et les tests aient été utilisées, un biais dans les jeux de données ou une fuite involontaire d'informations n'a pas pu être totalement exclue. Troisièmement, les performances indiquées peuvent varier selon la composition du jeu de données, l'initialisation du modèle, les procédures de prétraitement et les paramètres d'entraînement. De plus, les composants de modélisation convolutifs et temporels multi-échelles ont accru les exigences en matière de calcul, ce qui pourrait nuire au déploiement sur des dispositifs aux ressources limitées. Enfin, le cadre n'a pas été évalué à l'aide de jeux de données externes ou dans des scénarios de production en temps réel.
Les modèles vidéo basés sur les transformeurs ont montré des performances élevées sur des ensembles de données de reconnaissance d'actions à grande échelle, mais nécessitent souvent des ressources computationnelles importantes et de grandes quantités de données d'entraînement. Le cadre MSCNN-LSTM proposé offre une approche alternative en combinant l'extraction multi-échelle des caractéristiques spatiales avec une modélisation temporelle récurrente. De futurs travaux devraient explorer la validation croisée entre ensembles de données, l'inférence en temps réel, l'optimisation computationnelle, l'estimation de l'incertitude, ainsi que des architectures hybrides intégrant des mécanismes d'attention basés sur les transformeurs au sein du cadre multi-échelle CNN-LSTM proposé38.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir de conflits d'intérêts.
Remerciements
Cette recherche a été menée au Centre de technologie de l'intelligence artificielle (CAIT), Faculté des sciences et technologies de l'information, Universiti Kebangsaan Malaisie. Les auteurs remercient sincèrement l'établissement pour son soutien institutionnel et les installations de recherche mises à disposition. Ce travail n'a reçu aucun financement spécifique d'un organisme public, commercial ou à but non lucratif.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| GPU GeForce RTX 3090 | NVIDIA Corporation | RTX 3090, 24 Go de mémoire vidéo | Utilisé pour l'entraînement et l'inférence de modèles d'apprentissage profond |
| Processeur Intel Core i9 | Intel Corporation | 16 cœurs, 3,5 GHz | Utilisé pour le prétraitement des données et les calculs |
| Mémoire système | Générique | 64 Go de RAM DDR4 | Prend en charge le traitement vidéo à grande échelle |
| Langage de programmation Python | Python Software Foundation | Version 3.8.18 | Langage de programmation principal pour la mise en œuvre |
| TensorFlow | Version 2.15 | Framework d'apprentissage profond utilisé pour le développement de modèles | |
| Système d'exploitation | Microsoft Corporation | Windows 11 | Développement et expérimentation de modèles |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | Accélération GPU pour l'entraînement de modèles |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Bibliothèque d'accélération pour réseaux neuronaux profonds |
| OpenCV | Open Source | Version 4.8.1 | Extraction et prétraitement des images vidéo |
| NumPy | Open Source | Version 1.24.4 | Calcul numérique et traitement de tableaux |
| Scikit-learn | Open Source | Version 1.3.2 | Évaluation des performances et analyse statistique |
| Matplotlib | Open Source | Version 3.7.5 | Visualisation des résultats expérimentaux |
| Jeu de données UCF11 | University of Central Florida | Jeu de données public | Jeu de données de référence pour la reconnaissance d'actions sportives |
| Jeu de données UCF Sports | University of Central Florida | Jeu de données public | Jeu de données de référence pour la reconnaissance d'actions sportives |
| Jeu de données JHMDB | Max Planck Institute for Informatics | Jeu de données public | Jeu de données de référence pour la reconnaissance de mouvements et d'actions humaines |
Références
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543