Cette étude propose un algorithme qui couple étroitement les caractéristiques visuelles hiérarchiques capturées par un encodeur hiérarchique à fenêtre décalée avec la profondeur préalable de la boîte englobante 3D Manhattan générée par la détection de segments de ligne, permettant ainsi une reconstruction sémantique à haute précision de scènes intérieures complexes.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Une méthode d’analyse sémantique pour les images de scènes intérieures basée sur des connaissances préalables sur la structure du bâtiment
Dans cet article
Résumé
Résumé
Pour traiter les discontinuités de prédiction sémantiques et les distorsions physiques des frontières causées par l’occlusion du mobilier dans des scènes intérieures complexes, cet article propose une méthode d’analyse sémantique qui exploite les priors de structure de bâtiment. Le schéma utilise un encodeur transformateur hiérarchique à fenêtre décalée pour extraire des caractéristiques visuelles multi-échelles et combine un algorithme de détection de segments de ligne à consistance gradient-direction pour construire une boîte englobante 3D Manhattan. Cette boîte englobante est transformée en un champ de distance signé (SDF) avant d’encoder des contours géométriques discrets en un champ potentiel physique continu. Un mécanisme d’attention croisée guidé par la structure force les signaux visuels à s’aligner avec les frontières géométriques orthogonales 3D réelles, restaurant la continuité des caractéristiques dans les zones occultées. Un graphe d’adjacence spatiale construit à partir de nœuds superpixels pilote un Réseau Convolutionnel de Graphes (GCN) pour agréger des caractéristiques, assurant une cohérence sémantique macroscopique dans le plan porteur physique de charge. Une combinaison de perte d’entropie croisée au niveau des pixels et d’une perte de cohérence structurelle conçue sur mesure renforce les contraintes, pénalisant les prédictions hors limites. Des expériences réalisées sur plusieurs exécutions indépendantes montrent que la moyenne de l’intersection sur l’union (mIoU) atteint 68,7 % avec un écart-type de 0,2 %, et que le score F1 de la limite structurelle atteint 76,4 % avec un écart-type de 0,3 %, confirmant la robustesse des modules proposés. Avec une taille de nœud d’image unique de 256, le temps moyen d’inférence est resté à 61 ms.
Introduction
L’analyse sémantique des images de scènes intérieures occupe une place centrale dans la cognition spatiale tridimensionnelle et les tâches de raisonnement spatialintelligent 1,2. L’extraction de caractéristiques visuelles dans des environnements physiques réels est souvent gravement entravée par des configurations spatialescomplexes 3. Résoudre la discontinuité sémantique et la distorsion physique des limites de la structure de fondation du bâtiment causée par l’occlusion de mobilier à grande échelle est important pour la recherche en cognitionspatiale 4,5. Éliminer avec précision les interférences des objets encombrés et restaurer la continuité physique du même mur et sol déterminera directement la précision de la reconstitution tridimensionnelle de la scène et de l’analyse logique spatialeglobale 6. La discontinuité sémantique causée par l’occlusion du mobilier à grande échelle et l’effet de réparation structurelle des recommandations proposées à priori du bâtiment sont illustrées dans la Figure 1, où l’entrée occultée rouge-vert bleu (RGB) dans le Tableau 1A, la distorsion du masque de base dans la Figure 1B, et le résultat de réparation préalable de la structure dans la Figure 1C sont comparés sous la même condition de scène intérieure.
Pour répondre aux exigences de précision du raisonnement logique spatial, les réseaux visuels actuels pilotés par des pixels grand public rencontrent de multiples obstacles lorsqu’ils traitent des environnements intérieurscomplexes 7,8. Les espaces intérieurs sont souvent remplis de meubles denses et de mobilier encombré, ce qui entraîne une perte significative des signaux de frontière visuelle bas niveau sur les images9. Les mécanismes conventionnels d’extraction des caractéristiques reposent excessivement sur des réponses locales bidimensionnelles des couleurs et textures, manquant d’une compréhension macroscopique des lois orthogonales rigides des structures artificiellestridimensionnelles 10. Cette limitation du champ réceptif local rend la propagation des caractéristiques facilement interrompue, rendant difficile l’extension de la topologie globale à travers lesocclusions 11. Actuellement, il est urgent de résoudre le problème fondamental des discontinuités de prédiction sémantiques et des distorsions sévères des frontières physiques causées par l’occlusion et l’interférence12.
Pour traiter les défauts structurels des fondations des bâtiments causés par l’obstruction et les interférences, la communauté académique a développé une variété de mesures d’interventionciblées 13. Les réseaux d’agrégation de caractéristiques intermodals compensent efficacement les lacunes inhérentes d’une seule modalité visuelle en perception spatiale en introduisant des cartes de profondeur ou des priors textuels pour aider avec les images rouge-vert-bleu(RGB) 14,15. Les cadres de perception des limites et de sélection adaptative de contexte injectent des stratégies d’amélioration physique des contours dans l’étape de décodage des caractéristiques, ce qui améliore considérablement l’ajustement des contours des résultats de prédiction dans les scènescomplexes 16,17. Les modèles d’inférence basés sur les GCN et les mécanismes d’interaction des caractéristiques améliorent significativement la fluidité des caractéristiques et la cohérence macro-sémantique dans des régions homogènes en construisant des connexions au niveau desnœuds 18,19. Intégrer des priors structurels explicites de Manhattan dans la pipeline d’extraction des caractéristiques visuelles impose des limites de cohérence géométrique, ce qui répond aux défis de discontinuité des caractéristiques causés par une occlusion étendue d’objets aupremier plan 20.
Pour relever le défi central des défauts de prédiction sémantiques et des distorsions sévères des frontières physiques associées à l’infrastructure de construction, un cadre d’analyse sémantique est proposé basé sur un mécanisme de couplage en boucle fermée incorporant des priors architecturaux. Ce cadre transcende les pipelines d’ingénierie naïfs en établissant un alignement bidirectionnel entre des champs potentiels géométriques continus et des variétés de caractéristiques visuelles discrètes, formant une synergie non triviale qui corrige les erreurs d’occlusion par des lois structurales. Ce schéma repose sur un réseau de colonne vertébrale visuelle multi-échelles et un algorithme de détection de segments de ligne basé sur l’estimation du point d’arrivée pour acquérir des caractéristiques d’apparence locale et des priors d’arêtes orthogonales représentant en parallèle la boîte délimitante 3D de Manhattan, puis les transformer en SDF. L’algorithme utilise un mécanisme d’attention croisée guidé par la structure, utilisant des caractéristiques visuelles comme vecteurs de requête et traitant les caractéristiques SDF comme des clés et des valeurs pour les calculs du produit scalaire, forçant ainsi le signal visuel à s’aligner avec la frontière géométrique 3D réelle dans l’espace des caractéristiques. Un graphe d’adjacence spatiale construit à partir de nœuds superpixels et de traits de coplanarité spatiale est alimenté dans un GCN pour effectuer l’agrégation de caractéristiques inter-nœuds et le passage de messages. Le processus d’optimisation des paramètres de bout en bout utilise conjointement l’entropie croisée au niveau des pixels et une fonction de perte de cohérence structurelle personnalisée, qui contraint et pénalise strictement les pixels prédicts franchissant la frontière du bâtiment-prior. Le pipeline complet d’analyse sémantique est résumé dans la Figure 2, qui relie l’entrée d’images RVB, l’extraction géométrique a priori, l’alignement d’attention croisée, le raisonnement des graphes superpixels et le décodage sémantique des masques au sein d’une architecture unifiée.
Les premiers réseaux d’analyse de scènes reposaient sur des opérations convolutionnelles pour capturer les textures d’apparence locale, mais en raison des limitations des champs réceptifs locaux, ils présentaient une cohérence sémantique insuffisante des cibles à grandeéchelle 21,22. Des études antérieures ont appliqué le module d’auto-attention de l’architecture visuelle Transformer pour extraire des informations contextuelles globales et construire des caractéristiques d’association de pixels à longuedistance 23,24. Les stratégies d’agrégation de caractéristiques multi-modales extraient les caractéristiques géométriques spatiales tridimensionnelles de la scène en fusionnant des nuages de points de la carte de profondeur et des entrées de commandestexte 25,26. Les mécanismes d’attention hybrides pour la fusion de caractéristiques ciblant des domaines spécifiques ont progressivement mûri. En construisant des ponts d’interaction de caractéristiques, ils ont considérablement réduit la perte d’énergie et la rareté des caractéristiques dans la transmission multi-échelle des signaux visuels, et ont amélioré la robustesse de l’analyse syntaxique complexe. Les conceptions d’encodeurs de pointe intègrent et inférent conjointement des détails spatiaux dans le domaine haute fréquence aux côtés de caractéristiques globales et locales, renforçant la capacité du réseau à distinguer les catégories sémantiques à grain fin avec une grande similarité et améliorant la précision de l’analyse syntaxiqueen intérieur 27,28. Les avancées récentes dans les architectures de segmentation sémantique fournissent des références précieuses pour optimiser l’efficacité computationnelle et la perception spatiale. Les modèles conçus pour la prédiction dense et l’agrégation contextuelle à plusieurs échelles extraient des caractéristiques géométriques fines à travers des contextes complexes. Le découplage des caractéristiques et les stratégies de fusion synergique traitent l’ambiguïté sémantique dans les régions frontières. Des mécanismes d’attention légers et des modules d’agrégation à gated optimisent la distribution des paramètres, accélérant ainsi l’inférence tout en préservant les détails structurels locaux. La mise en œuvre de ces conceptions architecturales efficaces offre des conseils théoriques pour réduire la surcharge de calcul des opérations d’inférence topologique non euclidiennes dans l’analyse syntaxique de scènes intérieures.
Les priors de structure de bâtiment et l’estimation de la disposition 3D sont utilisés pour corriger les erreurs d’analyse visuellelocale 29. Des études antérieures ont extrait des caractéristiques géométriques orthogonales et parallèles des bâtiments intérieurs comme contraintes d’inférence afin de réduire le biais de prédiction du réseau causé par des arrière-plans intérieursencombrés 30,31. Les schémas existants utilisent des algorithmes de détection de segments de ligne et des techniques d’analyse de points d’ablation d’image pour générer des boîtes délimitantes 3D Manhattan afin de cartographier les limites physiques des pièces et d’aider à localiser les caractéristiques visuellessous-jacentes 32. L’architecture conjointe du module de connaissance des limites et du contexte multi-échelle intègre implicitement des informations structurelles antérieures dans le processus de décodage des caractéristiques à haute dimension, forçant le réseau à produire des masques sémantiques qui correspondent étroitement aux contours physiques réels, améliorant ainsi la dentelure et le flou des contours des objets33. Les conceptions de fonctions de perte semi-supervisées ou faiblement supervisées avec des propriétés d’amélioration des limites ont été largement explorées. En s’appuyant sur des formules mathématiques rigoureuses pour punir un comportement indépendant de classification des pixels qui viole les règles topologiques spatiales, la fluidité géométrique et l’intégrité structurelle du résultat final de segmentation sont garanties par la source de l’optimisation du gradient34.
Certaines études ont utilisé des réseaux de neurones graphiques pour réaliser l’agrégation inter-domaines de caractéristiques visuelles et le raisonnement sur les relations topologiques dans un espace de hautedimension 35. L’algorithme de segmentation superpixel pré-agrège des blocs de pixels adjacents avec une réponse couleur et des textures similaires en nœuds connectés indépendants. L’algorithme de segmentation superpixel compresse la redondance computationnelle de la structure du graphe au niveau de l’image et préserve la topologie géométrique de base de l’image36. Le GCN, construit sur le vecteur de caractéristiques de nœud de haute dimension, et la matrice d’adjacence représentant la proximité spatiale favorise la transmission directionnelle efficace et la fusion interactive d’informations visuelles multi-échelle le long du graphe connexe physique dans le domainespatial 37,38. L’application du module d’amélioration de l’information temporelle et du mécanisme hybride de connexion à saut multi-échelle supprime le lissage excessif et l’homogénéisation des caractéristiques des nœuds générés lors du passage de messages profondsmulti-couches 39. La technologie de transformation en ondelettes de graphe multi-échelle, ainsi que la stratégie d’optimisation de l’apprentissage des pseudo-éléments d’étiquette, optimisent le mécanisme anti-bruit de fond de la formule de mise à jour des caractéristiques des nœuds, de sorte que les caractéristiques ayant les mêmes attributs sémantiques maintiennent un mode de réponse coopérative dans la topologie réseaucomplexe 40. Le mécanisme de raisonnement basé sur les graphes associe des grilles de pixels régulières à des espaces topologiques non euclidiens pour effectuer des calculs d’agrégation de caractéristiques de structures de bâtiments irrégulières et de composantsintérieurs 41.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Les ensembles de données de scènes RVB intérieures et leurs annotations sémantiques ont été préparés avant l’entraînement réseau. Les grands ensembles de données 3D intérieures et RGB-D sur les scènes intérieures (voir le tableau des matériaux) ont été obtenus à partir de leurs dépôts officiels. Les scènes d’acquisition intérieures contenant l’occlusion du mobilier, la variation de l’éclairage, l’interruption des limites des murs et des dispositions spatiales complexes ont été conservées pour correspondre au scénario d’analyse cible. Les étiquettes sémantiques ont été converties en masques d’annotation PNG indexés à canal unique, et toutes les images RVB ainsi que les masques sémantiques ont été redimensionnés à 512 × 512 pixels. L’augmentation des données en ligne a été appliquée pendant l’entraînement, avec un basculement horizontal aléatoire à une probabilité de 0,5, une échelle de luminosité aléatoire entre 0,8 et 1,2, et une rotation aléatoire entre −10° et +10° pour élargir la distribution de la disposition structurelle. Les canaux RVB ont été normalisés avec des valeurs moyennes de 0,485, 0,456 et 0,406 et des valeurs d’écart-type de 0,229, 0,224 et 0,225. Le benchmark 3D intérieur à grande échelle a suivi la répartition officielle de la version utilisée dans cette étude, avec 1201 scènes d’entraînement et 312 scènes de validation pour le développement et la validation du modèle. Le benchmark RGB-D de scène intérieure a suivi le protocole d’évaluation officiel, avec 795 images d’entraînement et 654 images de test. Aucune répartition supplémentaire basée sur les pourcentages n’a été appliquée à ces deux références publiques.
Un réseau visuel de transformateur hiérarchique à fenêtre décalée (voir le tableau des matériaux) a été initialisé comme le réseau dorsal des encodeurs de transformateurs à fenêtre mobile. La taille de l’embedding du patch était configurée à 4 x 4 pixels. Les dimensions d’immersion des quatre étages hiérarchiques ont été réglées à 128, 256, 512 et 1024, et le nombre de blocs transformateurs dans les quatre étages a été fixé à 2, 2, 18 et 2. La taille de la fenêtre d’attention locale était fixée à 7 x 7, et le nombre de têtes d’attention était fixé à 4, 8, 16 et 32 pour les quatre étapes hiérarchiques. Des fonctions d’activation continue non linéaires étaient utilisées à l’intérieur de toutes les couches de perceptron multicouches. Le downsampling spatial a été réalisé par des opérations de fusion de patchs avec un pas de 2 à chaque étape hiérarchique. L’architecture du réseau central et les hyperparamètres du module d’inférence convolutionnelle ont été résumés dans le tableau 1.
L’extraction des caractéristiques d’auto-attention par fenêtre décalée a ensuite été effectuée sur les cartes de caractéristiques d’entrée. Chaque carte de caractéristiques était divisée en fenêtres locales non superposées avec des dimensions spatiales de 7 × 7. L’attention de fenêtre régulière et celle de fenêtre décalée étaient alternées entre des blocs de transformateurs à fenêtre décalée adjacents. La distance de décalage cyclique était réglée à 3 pixels, et un encodage de biais positionnel relatif était appliqué dans chaque fenêtre d’attention locale. Les caractéristiques visuelles locales ont été agrégées via l’auto-attention multi-têtes pour générer des représentations hiérarchiques et multi-échelles.
Les priors structurels de Manhattan ont été extraits d’images RVB intérieures. Les segments structuraux des arêtes ont été détectés à l’aide d’un algorithme de détection de segments de ligne à consistance gradient-direction. Les directions structurelles dominantes ont été regroupées via un algorithme de consensus aléatoire d’échantillon (RANSAC) (voir le tableau des matériaux) basé sur l’estimation du point d’arrivée. Trois directions Manhattan mutuellement orthogonales ont été reconstruites pour générer la représentation de la boîte englobante 3D de Manhattan. La frontière structurelle reconstruite a été convertie en une carte SDF en calculant la distance euclidienne minimale de chaque pixel au segment de ligne de limite le plus proche.
Les caractéristiques d’attention croisée guidées par la structure ont été générées après l’obtention des éléments visuels et des précédents SDF. La variété de caractéristiques visuelles a été mappée au tenseur d’interrogation Q via la matrice de transformation linéaire W sous-élément Q de la capsule à double frappe R, puis à la matrice de formation W sous-élément Q de la double coupe R à la matrice 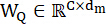 de formation. Le champ de distance continue précédent a été mappé au tenseur clé K et au tenseur de valeur V via les matrices
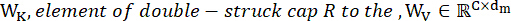 de transformation , et la dimension du modèle a été fixée à 512. La modulation multi-têtes divisait l’espace de projection en 8 sous-espaces indépendants, chaque tête ayant une dimension de 64. La disposition spatiale antérieure projetait des coordonnées discrètes de pixels dans un champ potentiel continu et générait la matrice d’affinité structurelle S comme un biais spatial additif explicite pour moduler la matrice de similarité du produit scalaire. Le tenseur des caractéristiques visuelles a été utilisé comme source de requête car l’analyse sémantique exige que chaque emplacement visuel récupère activement des preuves structurellement cohérentes de l’espace a priori géométrique. Le SDF prior a été utilisé comme source clé et de valeur car il stocke la distance continue des limites et les indices structurels intérieur-extérieur dérivés de la disposition Manhattan. Le terme produit scalaire mesurait la compatibilité entre l’apparence sémantique et le prior géométrique, tandis que le terme structurel additif λS déplaçait les poids de l’attention vers des pixels sur le même plan physique ou près du même contour architectural. Le coefficient λ représentait la confiance dans le prior structurel extrait et contrôlait dans quelle mesure les contraintes orthogonales rigides étaient intégrées dans la distribution d’attention. Cette formulation réduisait la diffusion transfrontalière des caractéristiques causée par l’occlusion du mobilier et conservait la relaxation adaptative dans les agencements hors Manhattan. La distribution de l’attention guidée par la structure a été calculée selon l’équation 1.
Équation 1 : 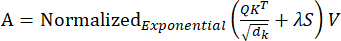
où A désigne la matrice d’agrégation de l’attention guidée par la structure, Q désigne le tenseur de requête généré à partir de caractéristiques visuelles, K désigne le tenseur clé généré à partir des caractéristiques antérieures SDF, V désigne le tenseur de valeur généré à partir de représentations a priori structurales, dk désigne la dimension des caractéristiques du tenseur clé, λ désigne le coefficient de pondération structurelle adaptatif utilisé pour identifier la confiance géométrique des régions locales et relâcher les contraintes orthogonales rigides dans des espaces non-Manhattan et S désigne la matrice d’affinité SDF. La division par dk a stabilisé l’échelle des logits d’attention et empêché que les grandes dimensions des caractéristiques ne produisent des poids d’attention surconcentrés. La fonction exponentielle normalisée (voir le tableau des matériaux) transformait les scores de similarité modulés en une distribution spatiale normalisée, permettant à chaque pixel d’agréger des informations structurelles a priori en fonction de la cohérence sémantique et géométrique. Ce design explique pourquoi les priors de l’apparence visuelle et des limites architecturales sont fusionnés au niveau de l’attention plutôt que par une concaténation directe de caractéristiques.
Le graphe topologique des superpixels a été construit à partir de la carte de caractéristiques alignée sur la structure. La carte des caractéristiques était segmentée à l’aide d’un algorithme de génération de régions spatiales. Le nombre de superpixels était fixé à 256, le coefficient de compacité à 10, le coefficient de lissage gaussienne à 1,0, et le nombre d’itération à 10. Les contraintes de proximité spatiale étaient appliquées en fixant le poids métrique de distance à un rapport constant de 1,0 à la distance colorimétrique des caractéristiques lors du clustering, maintenant ainsi une génération uniforme de nœuds sur les frontières denses de clac. Les pixels avec des réponses sémantiques homogènes ont été agrégés en nœuds superpixels. Les arêtes des graphes ont été construites selon les relations d’adjacence spatiale, la force d’affinité SDF et les contraintes de cohérence géométrique coplanaire. Le processus de construction de la matrice d’affinité structurelle et de la connectivité topologique est montré à la Figure 3, qui montre comment la guidance SDF a été transformée en relations spatiales au niveau des graphes.
La formulation graphe a été introduite pour convertir le raisonnement dense pixel par pixel en raisonnement spatial nœud par nœud sur des régions structurelles homogènes. Chaque nœud superpixel représentait une région locale avec une réponse sémantique et une continuité spatiale similaires, tandis que chaque arête représentait un chemin fiable pour la transmission de caractéristiques soumis aux contraintes d’adjacence, d’affinité de champ de distance et de coconsistance coplanaire. Cette conception réduisait l’influence des pixels bruyants isolés et permettait aux zones obstruées des murs, des planchers et des plafonds de recevoir des messages provenant de nœuds physiquement adjacents. La construction des arêtes servait donc de pont mathématique entre le guidage SDF continu et le raisonnement discret non euclidien sur les graphes.
Un réseau de raisonnement convolutionnel à trois couches a été configuré avec des dimensions de caractéristiques cachées de 512, 256 et 128. La couche convolutionnelle du graphe effectuait un lissage des caractéristiques sur la structure du graphe en fonction des relations spatiales entre les nœuds. L’adjacence en boucle propre a conservé l’état original de chaque nœud lors du passage des messages, empêchant que les caractéristiques d’une petite région structurelle soient effacées par les grandes régions environnantes. La normalisation symétrique a mis à l’échelle les éléments de la matrice d’adjacence par le produit des racines carrées inverses des degrés des nœuds, de sorte que les nœuds de haut et de bas degré contribuaient sous des magnitudes numériques comparables lors de la propagation. La propagation en avance effectuait une agrégation spatiale localisée, dans laquelle chaque état de nœud absorbait des caractéristiques de haute dimension provenant de groupes coplanaires adjacents avant que la fonction de rectification non linéaire par élément ne soit appliquée. Cette formulation faisait que la couche de convolution de graphe approchait la diffusion sémantique le long de plans intérieurs physiquement significatifs plutôt qu’un lissage illimité sur les frontières d’objets non liés. Les caractéristiques des nœuds graphiques ont été évaluées selon l’équation 2.
Équation 2 : 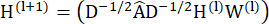
La projection des caractéristiques denses des pixels vers les nœuds superpixels, le passage de messages par convolution graphique, et la rétroprojection des coordonnées sont présentées dans la Figure 4, clarifiant le chemin d’agrégation des caractéristiques des grilles d’images régulières vers une topologie non euclidienne, puis de retour à une représentation sémantique dense. La projection des caractéristiques de pixels denses dans la Figure 4A vers les nœuds superpixels de la Figure 4B, le passage du message graphe-convolution dans la Figure 4C, et la rétroprojection des coordonnées dans la Figure 4D clarifient le chemin d’agrégation des caractéristiques des grilles d’images régulières vers une topologie non euclidienne, puis de retour à une représentation sémantique dense.
où H(l) désigne le tenseur de caractéristiques du nœud de la l-ième couche de convolution du graphe, Â désigne la matrice d’adjacence avec des connexions à auto-boucle, D désigne la matrice des degrés correspondant à la matrice d’adjacence, W(l) désigne la matrice de poids apprenable de la l-ième couche de convolution du graphe, et σ désigne la fonction d’activation de l’unité linéaire rectifiée. Le terme ÂH(l) agrégeait des caractéristiques provenant des nœuds superpixels adjacents, tandis que D−1/2 et D−1/2 équilibraient la contribution des nœuds avec différentes densités de connexion. La matrice apprenable W(l) projetait des caractéristiques agrégées dans un nouvel espace sémantique, permettant à la couche graphe de distinguer la cohérence structurelle de la proximité spatiale ordinaire. L’activation non linéaire a préservé la différence de réponses entre les régions coplanaires et non coplanaires après l’agrégation des caractéristiques.
Les caractéristiques de segmentation sémantique ont été décodées après le raisonnement des graphes. Le décodeur a été construit à l’aide de trois étages d’upsampling d’interpolation bilinéaire et d’opérations de fusion par connexion inter-couche. Les caractéristiques peu profondes des encodeurs spatiaux étaient concaténées avec des caractéristiques sémantiques de haut niveau par fusion canal. La résolution des caractéristiques a été rétablie à la taille originale de l’image, et la carte finale de prédiction sémantique des probabilités a été générée via une couche de convolution 1 × 1.
Le réseau d’analyse sémantique complet a été entraîné à l’aide d’un optimiseur de désintégration poids découplé (voir le tableau des matériaux). Le taux d’apprentissage initial a été fixé à 0,0001, le coefficient de désintégration pondérative à 0,01, et la taille du lot à 8 pour les deux benchmarks publics. Le taux de désintégration du premier moment était fixé à 0,9, le taux de désintégration du second moment à 0,999, et le coefficient de stabilité numérique de l’épsilon était fixé à 1 × 10⁻8. La perte de validation était surveillée à la fin de chaque époque, et les points de contrôle étaient sauvegardés lorsque le mIoU sur l’ensemble de validation augmentait. Le réseau a été entraîné pendant 300 époques en utilisant une stratégie de désintégration du taux d’apprentissage polynomial avec une puissance de décroissance de 0,9. Cinq entraînements indépendants ont été réalisés en utilisant différentes initialisations de graines aléatoires afin d’établir une base d’évaluation statistiquement rigoureuse. Le réseau a été optimisé conjointement en utilisant la perte d’entropie croisée au niveau des pixels et la perte de cohérence structurelle. Toutes les expériences ont été réalisées sur une plateforme informatique équipée de matériel de calcul parallèle à haute mémoire, et des informations matérielles détaillées ont été rapportées dans le Table of Materials.
L’optimisation conjointe imposait l’alignement géométrique des frontières en calculant la magnitude du gradient spatial du tenseur de probabilité de classe. La perte de cohérence structurelle a été utilisée comme régularisateur, multipliant la norme des gradients de prédiction spatiale par les valeurs SDF continues. La logique mathématique était que les changements de catégories sémantiques devaient se concentrer près des contours architecturaux réels, où la SDF tendait vers zéro, tandis que les intérieurs plats des murs, des sols et des plafonds devaient maintenir des réponses sémantiques lisses. Lorsqu’un grand gradient de prédiction apparaissait loin d’une frontière structurelle, le terme du champ de distance augmentait la pénalité et décourageait les fausses transitions sémantiques à l’intérieur d’un plan physique homogène. Lorsqu’un gradient de prédiction apparaissait près d’un contour de distance nulle, la pénalité restait limitée et préservait les transitions de classe légitimes le long des frontières architecturales. Les régions de transition sémantiques étaient contraintes à s’aligner avec les contours de distance nulle de la SDF, comme indiqué par l’équation 3.
Équation 3 : 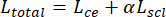
où Ltotal désigne la fonction objectif d’optimisation finale, Lce désigne la perte d’entropie croisée au niveau des pixels, Lscl désigne la perte de pénalité de cohérence structurelle, et α désigne le coefficient de pondération de perte structurelle. Le terme cross-entropie offrait une supervision sémantique au niveau des pixels via des masques d’annotage, tandis que le terme de cohérence structurelle imposait une régularisation géométrique à l’aide de priors architecturaux. Le coefficient de pondération α la reconnaissance équilibrée des catégories et l’alignement des frontières, empêchant l’optimisation de surajuster la précision locale des étiquettes ou les contours structurels rigides. Cet objectif commun reliait la sémantique visuelle, la cohérence physique des frontières et les paramètres du réseau entraînables au sein d’une cible d’optimisation unifiée.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Installation expérimentale
Cette étude a utilisé deux ensembles de données standards d’analyse des scènes intérieures, un jeu de données 3D intérieur à grande échelle et un jeu de données RGB-D sur les scènes intérieures, afin d’évaluer la performance et d’ajuster le modèle. Le jeu de données 3D intérieur à grande échelle contient des scènes complexes de l’espace physique scannées de manière réaliste et des vues RVB haute résolution, fournissa...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
L’algorithme de cet article couple étroitement les caractéristiques visuelles hiérarchiques capturées par un encodeur transformateur hiérarchique à fenêtre décalée avec la profondeur préalable de la boîte englobante 3D Manhattan générée par la détection de segments de ligne, permettant ainsi une reconstruction sémantique à haute précision de scènes intérieures complexes. Un mécanisme d’attention croisée guidé par la structure force le signal visuel à s’aligner avec la véritable frontière...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont pas de conflits d’intérêts financiers.
Remerciements
Financement : Programme clé de recherche et développement du Shaanxi (Programme n° 2024 CY2-GJHX-76).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Références
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.