Cette étude présente un cadre en deux étapes pour la classification des couvertures terrestres hyperspectrales et LiDAR, utilisant une extraction de caractéristiques de type MetaFormer et un appariement bidirectionnel par flux pour l'alignement intermodal avant la fusion. L'évaluation sur trois ensembles de données de référence publics démontre des performances de classification compétitives selon des protocoles de référence fixes.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Apprentissage continu de champs de vecteurs cross-modaux pour la classification de l'occupation des sols par imagerie hyperspectrale et LiDAR
Dans cet article
Résumé
Résumé
La classification multimodale par télédétection joue un rôle important dans des applications telles que la cartographie urbaine et la surveillance environnementale. Toutefois, les distributions hétérogènes de caractéristiques entre les modalités de détection peuvent entraîner un mauvais alignement des caractéristiques et une incohérence sémantique, limitant ainsi l'efficacité de la fusion multimodale. Les approches existantes de fusion multimodale, notamment les méthodes basées sur les convolutions, les graphes, l'attention, la contraste, le transport ou les séquences, permettent d'exploiter des informations complémentaires mais peuvent ne pas suffisamment aligner les distributions de caractéristiques propres à chaque modalité. Cette étude propose FlowErs, un cadre de classification multimodal en deux étapes qui relève ce défi grâce à une correspondance de flux multimodaux. L'hypothèse de travail est que la réduction des écarts entre les distributions de caractéristiques appariées avant la fusion améliore la classification des couverts terrestres selon des protocoles de référence fixes. Dans la première étape, des encodeurs MetaFormer spécifiques à chaque modalité extraient des représentations hiérarchiques à partir de données d'imagerie hyperspectrale (HSI) et de détection par lumière et télémétrie (LiDAR). Un module de correspondance de flux multimodaux apprend ensuite des champs de vitesse conditionnés au temps afin de déplacer les distributions de caractéristiques appariées vers une représentation latente partagée, en utilisant un objectif bidirectionnel d'erreur quadratique moyenne. Dans la seconde étape, le module d'alignement préentraîné est réutilisé pour aligner les représentations multimodales avant qu'une tête de fusion légère n'effectue une classification pixel par pixel. L'évaluation sur trois jeux de données publics de référence a démontré une précision globale maximale (OA) de 97,56 % selon des subdivisions fixes. Les performances variaient selon les classes de couvert terrestre, et l'étude discute des limites propres à chaque classe ainsi que de l'influence du déséquilibre des classes sur les métriques agrégées. L'évaluation actuelle se limite à des expériences avec subdivisions fixes, sans analyse statistique répétée ni profilage computationnel. Les travaux futurs exploreront la robustesse statistique, l'efficacité computationnelle et la généralisation inter-régionale.
Introduction
Une classification précise de l'utilisation et de la couverture des terres (LULC) à l'aide d'images issues de la télédétection est essentielle pour un large éventail d'applications réelles, notamment l'aménagement urbain, la surveillance environnementale, la gestion des catastrophes et le développement durable1. Ces dernières années, les données de télédétection multimodales, incluant les images hyperspectrales (HSI), la détection et télémétrie par lumière (LiDAR) et le radar à synthèse d'ouverture (SAR), sont devenues de plus en plus accessibles. Cette disponibilité accrue a considérablement élargi les capacités de la télédétection en matière de classification fine de la couverture des sols2. Ces modalités de détection capturent des caractéristiques distinctes mais complémentaires de la surface terrestre. L'HSI fournit des informations spectrales riches permettant de caractériser la composition des matériaux, tandis que le LiDAR fournit des informations précises sur la structure et l'altitude3. L'intégration de ces sources de données hétérogènes peut produire des représentations de caractéristiques plus discriminantes, plus robustes au bruit et plus complètes sur le plan sémantique que chacune des modalités prise isolément4.
Néanmoins, l'exploitation efficace des données multimodales demeure un défi persistant5. Une difficulté majeure provient de l'hétérogénéité intrinsèque des modalités de détection, qui diffèrent par leur résolution spatiale, leurs caractéristiques de bruit, leurs distributions statistiques et la sémantique de leurs caractéristiques6. Par exemple, un même objet d'occupation du sol peut être représenté comme une signature spectrale en haute dimension dans l'HSI et comme des structures géométriques clairsemées dans le LiDAR7. Par conséquent, les caractéristiques propres à chaque modalité se situent souvent dans des variétés de caractéristiques différentes, ce qui rend la fusion directe des caractéristiques inefficace ou potentiellement trompeuse. De plus, de nombreuses approches existantes de fusion multimodale, notamment celles basées sur les convolutions, l'attention ou les Transformers, supposent implicitement que les caractéristiques extraites à partir de capteurs différents sont déjà alignées spatialement et sémantiquement8. Or, cette hypothèse n'est souvent pas valide dans les applications pratiques. Une simple concaténation des caractéristiques ou une fusion pixel par pixel ne permet pas de capturer adéquatement les écarts intermodaux, ce qui peut entraîner une optimisation instable et une performance de généralisation réduite. En outre, bien que les méthodes de fusion basées sur l'attention améliorent l'interaction entre caractéristiques, elles peuvent offrir une modélisation limitée des dépendances intermodales à longue portée nécessaires pour une classification de l'occupation du sol à grande échelle ou en haute résolution9. En conséquence, l'alignement efficace des représentations de caractéristiques hétérogènes reste un défi majeur en télédétection multimodale, car des intégrations incompatibles peuvent limiter l'exploitation d'informations complémentaires.
Pour relever ce défi, l'alignement transmodal est formulé comme un problème de transport conditionnel de caractéristiques. La méthode d'appariement de flux fournit un cadre mathématiquement fondé pour apprendre des applications continues et inversibles entre des distributions de caractéristiques hétérogènes10. Elle transporte une distribution vers une autre au moyen d'un champ de vitesses dépendant du temps, paramétré par une équation différentielle ordinaire (ODE), favorisant ainsi des transformations continues entre des variétés de caractéristiques11. Contrairement aux modèles basés sur la diffusion, qui s'appuient sur des perturbations stochastiques par bruit ou un appariement implicite de distributions via un apprentissage antagoniste, l'appariement de flux apprend des transformations déterministes et bijectives entre des espaces de caractéristiques structurés12. Ces caractéristiques rendent l'appariement de flux particulièrement adapté à la télédétection multimodale, où les images hyperspectrales (HSI), le LiDAR et le RADAR à synthèse d'ouverture (SAR) représentent chacun des variétés de caractéristiques en haute dimension, capturant des propriétés complémentaires de la surface terrestre13. Ainsi, l'appariement de flux offre une approche rigoureuse pour établir une correspondance transmodale par transport continu de caractéristiques, tout en favorisant la cohérence géométrique lors de l'alignement des caractéristiques. Sous des hypothèses de régularité appropriées, un flux ODE peut fournir une application inversible ; toutefois, l'inversibilité exacte et l'interprétabilité physique n'ont pas été évaluées empiriquement dans la présente étude. L'hypothèse de travail est que la réduction des écarts entre distributions de caractéristiques appariées avant la fusion améliore la classification globale des couvertures terrestres selon des subdivisions de référence fixes.
Motivé par ces considérations, le cadre proposé, FlowErs, intègre une étape d'alignement basée sur les flux au sein d'une architecture en deux étapes. Dans la première étape, un réseau de flux bidirectionnel est entraîné pour aligner les variétés de caractéristiques de chaque modalité. Plus précisément, des squelettes MetaFormer spécifiques à chaque modalité extraient des plongements hiérarchiques de caractéristiques, et un objectif d'appariement de flux est optimisé afin de transporter des échantillons entre les distributions de caractéristiques propres à chaque modalité. Ce processus fournit une transformation lisse et inversible entre les espaces de caractéristiques, favorisant un alignement plus étroit des représentations appartenant à la même classe sémantique au sein d'un domaine latent partagé. Dans la deuxième étape, l'aligneur de flux pré-entraîné est figé, et de nouvelles entrées multimodales sont transformées avant d'être fusionnées par un classificateur léger. Cette stratégie d'entraînement découplée sépare l'alignement géométrique de la classification sémantique, permettant aux deux étapes d'optimiser des objectifs complémentaires. Le module d'alignement vise à réduire les disparités entre les distributions de caractéristiques avant la fusion, sans prétendre à une garantie démontrée de préservation du volume. En outre, FlowErs propose une formulation explicite de transport de caractéristiques pour la fusion multimodale, bien que la robustesse aux erreurs d'appariement n'ait pas été évaluée séparément dans la présente étude.
Les principales contributions de cette étude sont résumées comme suit. FlowErs est présenté comme un cadre en deux étapes pour la classification multimodale des couvertures terrestres. Dans le cadre proposé, des caractéristiques spécifiques à chaque modalité sont d'abord extraites à l'aide d'encodeurs MetaFormer, puis alignées au moyen d'un module basé sur les flux, avant une fusion légère des caractéristiques. Cette conception découplée permet une optimisation efficace tout en conservant une grande flexibilité entre différentes modalités de détection. De plus, cette étude explore l'appariement de flux conditionnel comme mécanisme de transport de caractéristiques pour l'alignement croisé apparié de caractéristiques dans la télédétection multimodale. Le module de flux bidirectionnel prédit des cibles de vitesse opposées pour des représentations de caractéristiques appariées avant la fusion, offrant ainsi une stratégie d'alignement explicite antérieure à l'intégration multimodale. En outre, le cadre proposé est évalué sur trois ensembles de données de référence publics, atteignant une précision globale maximale (OA) de 97,56 % selon les subdivisions fixes fournies. Les limites au niveau des classes et la portée de l'évaluation actuelle sont également documentées explicitement.
Les récents progrès dans l'appariement de flux (flow matching) en ont fait un cadre puissant de modélisation générative unifiant les modèles basés sur la diffusion, l'énergie et le transport. Contrairement aux modèles de diffusion, qui simulent des trajectoires stochastiques, l'appariement de flux apprend une équation différentielle ordinaire (ODE) déterministe qui transporte une distribution a priori simple, comme un bruit gaussien, vers la distribution cible des données au moyen d'un champ de vitesses apprenable15. Cette formulation relie directement l'estimation du score à l'évolution de la densité, conduisant à des trajectoires de probabilité plus régulières et à une dynamique d'entraînement plus stable. Un avantage majeur de l'appariement de flux réside dans sa formulation déterministe et efficace sur le plan computationnel. Les modèles de flux rectifiés16 simplifient davantage les trajectoires de transport en les rendant presque rectilignes, améliorant ainsi la stabilité numérique et permettant une génération d'échantillons de haute qualité avec relativement peu d'étapes d'intégration. Des études ultérieures, notamment les modèles de cohérence17, ont intégré des objectifs inspirés de la diffusion dans des cadres compacts basés sur les flux, afin d'obtenir une qualité d'échantillonnage comparable, voire supérieure, avec une inférence efficace. De plus, l'entraînement basé sur les flux peut tirer parti de modèles de diffusion pré-entraînés, facilitant l'utilisation de priors génératifs à grande échelle tout en réduisant les coûts d'échantillonnage. Des études récentes ont étendu l'appariement de flux à un large éventail d'applications. Par exemple, Hu et al.18 ont étudié l'utilisation de modèles transformeurs et de manipulations dans l'espace latent pour un montage d'images contrôlable et composable à l'aide de l'appariement de flux. D'autres applications incluent la synthèse d'images19, le diagnostic de défauts de roulements20 et le soudage robotisé multitarget et multijoints21. Collectivement, ces études démontrent que l'appariement de flux s'applique au-delà de la synthèse d'images haute résolution et conditionnelle, tout en offrant une base théorique solide avec un potentiel de généralisation à différents domaines. En apprenant des cartes de transport continues et déterministes, l'appariement de flux assure un équilibre entre efficacité, contrôlabilité et fidélité générative. Sa formulation basée sur les ODE offre une perspective unifiée de la modélisation générative moderne et constitue une base théorique pour des applications impliquant la représentation de données multimodales et l'alignement de caractéristiques.
La classification multimodale par télédétection vise à surmonter les limitations des modalités de détection individuelles en intégrant des informations complémentaires provenant de l'imagerie hyperspectrale (HSI), de l'imagerie multispectrale, du LiDAR et du RADAR à synthèse d'ouverture (SAR). Les approches de fusion précoce s'appuyaient sur des caractéristiques conçues manuellement ou sur des algorithmes basés sur des noyaux, tels que les machines à vecteurs de support (SVM), mais étaient limitées par la forte dimensionnalité et une interaction insuffisante entre les modalités22. Les progrès du deep learning ont permis de développer des stratégies de fusion structurées, incluant la fusion précoce, intermédiaire et tardive, la fusion au niveau des caractéristiques offrant un compromis pratique entre intégration de l'information et complexité computationnelle23. Les réseaux neuronaux convolutifs (CNN) capturent efficacement les informations spatiales et spectrales locales, tandis que les architectures basées sur les Transformers modélisent des dépendances à longue portée au prix d'une complexité computationnelle plus élevée24. Par conséquent, les architectures hybrides combinant CNN et Transformers sont devenues de plus en plus populaires, car elles exploitent les forces complémentaires de ces deux approches. Des exemples représentatifs incluent des méthodes de fusion à échelles adjacentes qui améliorent l'information contextuelle par des interactions inter-échelles25 et des cadres multiniveaux qui combinent des caractéristiques superficielles de CNN avec des représentations profondes de Transformers à l'aide de mécanismes d'attention adaptatifs26. Dans leur ensemble, ces études soulignent l'importance d'une interaction efficace entre échelles et modalités pour réduire la redondance des caractéristiques et améliorer la représentation sémantique.
Des développements récents ont également exploré des stratégies complémentaires pour l'apprentissage multimodal. Par exemple, les méthodes de représentation de faible rang, telles que le cadre guidé par la courbe d'Ebbinghaus, réduisent le surapprentissage en préservant la structure de variété tout en supprimant les informations redondantes27. Parallèlement, l'apprentissage multimodal distribué a été étudié afin de répondre aux contraintes de confidentialité et de communication dans les applications pratiques. Par exemple, FedFusion projette des caractéristiques superficielles dans des sous-espaces de faible rang pour permettre un apprentissage multimodal fédéré28. Collectivement, ces études illustrent trois directions de recherche complémentaires : les architectures hybrides CNN–Transformeur pour équilibrer la modélisation des caractéristiques locales et globales, l'apprentissage de faible rang pour réduire la redondance et le bruit, et l'apprentissage distribué pour un déploiement évolutif et respectueux de la vie privée. Néanmoins, des défis importants persistent, notamment le déséquilibre entre modalités, la disponibilité limitée de données étiquetées, ainsi que le compromis entre compression du modèle et précision de la classification. Ces défis ont motivé des recherches continues sur des cadres de fusion multimodale légers et généralisables. Des approches récentes d'alignement multimodal ont également intégré l'attention croisée, l'apprentissage contrastif, la fusion basée sur les graphes, l'adaptation de domaine et des stratégies d'appariement de distributions. En revanche, FlowErs formule l'alignement multimodal comme un transport de caractéristiques appariées et conditionné au temps, et est présenté comme une stratégie d'alignement complémentaire plutôt que comme un remplacement universel des approches existantes.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude a utilisé exclusivement des ensembles de données de référence accessibles au public (Houston2013, Augsburg et MUUFL) pour la classification de la couverture terrestre en télédétection. Aucun participant humain, aucune expérience sur des animaux ni aucun échantillon biologique nouvellement collecté n'a été impliqué. Par conséquent, une approbation éthique institutionnelle n'était pas requise.
Aperçu de l'étude
Le cadre proposé, FlowErs, effectue une classification multimodale des couvertures terrestres au moyen d'une stratégie d'apprentissage en deux étapes. Son flux de travail global est illustré dans la Figure 1A–C. Le cadre comprend trois composants principaux : (i) des encodeurs basés sur MetaFormer qui extraient des représentations hiérarchiques de caractéristiques à partir de modalités de détection hétérogènes, (ii) un module d'appariement d'écoulement multimodal (MFM) qui aligne explicitement les distributions de caractéristiques intermodales, et (iii) une tête de classification légère qui prédit les catégories de couverture terrestre à partir des représentations de caractéristiques fusionnées. Le flux de travail global extrait d'abord des caractéristiques spécifiques à chaque modalité, aligne ensuite ces caractéristiques dans un espace latent partagé par appariement d'écoulement conditionnel, et effectue enfin une classification pixel par pixel des couvertures terrestres à l'aide des représentations multimodales alignées.
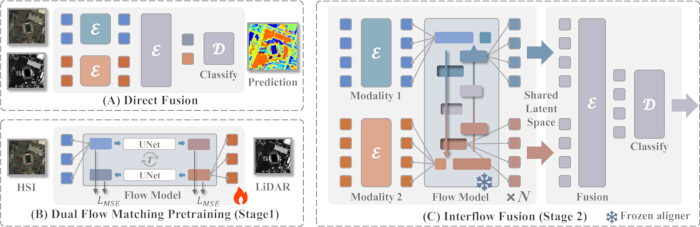
Figure 1 : Aperçu du cadre FlowErs proposé pour la classification multimodale des couvertures terrestres. (A) Fusion directe conventionnelle de caractéristiques, dans laquelle les caractéristiques spécifiques à chaque modalité extraites d'images hyperspectrales (HSI) et de données de détection et de télémétrie par lumière (LiDAR) sont concaténées directement avant la classification. (B) Étape 1 : Préentraînement par correspondance bidirectionnelle de flux multimodaux. Un U-Net conditionné par le temps apprend un transport bidirectionnel continu des caractéristiques entre les représentations spécifiques à chaque modalité à l'aide d'une perte quadratique moyenne pour aligner les distributions hétérogènes de caractéristiques. (C) Étape 2 : Fusion par interflux. Le module préentraîné de correspondance de flux est figé et réutilisé pour aligner les représentations de caractéristiques spécifiques à chaque modalité avant la fusion légère des caractéristiques et la classification pixel par pixel des couvertures terrestres. E, encodeur ; D, décodeur ; T, intégration temporelle ; , perte quadratique moyenne ; S, représentation latente partagée. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Le cadre proposé sépare l'alignement des caractéristiques de la classification sémantique au moyen d'une stratégie d'apprentissage en deux étapes. Lors de la première étape, le module MFM est entraîné pour apprendre le transport bidirectionnel des caractéristiques entre les variétés de caractéristiques spécifiques à chaque modalité. Lors de la deuxième étape, le module d'alignement de flux pré-entraîné est figé et réutilisé afin d'aligner les représentations de caractéristiques multimodales avant la fusion légère et la classification. Cette conception découplée permet au module d'alignement et au réseau de classification d'optimiser des objectifs complémentaires tout en réduisant les écarts de distribution des caractéristiques avant la fusion multimodale.
Aperçu théorique
L'appariement de flux est un paradigme de modélisation générative récemment proposé qui apprend une transformation déterministe continue entre deux distributions de probabilité. Contrairement aux modèles basés sur la diffusion, qui introduisent une stochasticité par des perturbations de bruit, l'appariement de flux paramétrise directement un champ de vitesses apprenable qui transporte continûment une distribution de probabilité vers une autre. Cette formulation de transport continu permet l'alignement de caractéristiques au moyen d'une équation différentielle ordinaire (ODE), permettant ainsi à des représentations de caractéristiques appariées provenant de différentes modalités de détection d'évoluer le long d'une trajectoire commune avant la fusion des caractéristiques. Dans la présente étude, l'appariement de flux conditionnel est utilisé pour apprendre un transport bidirectionnel de caractéristiques entre des intégrations spécifiques aux modalités extraites par les encodeurs MetaFormer. Le modèle est entraîné à l'aide d'un objectif d'appariement de flux conditionnel qui minimise l'écart entre les champs de vitesses prédits et cibles sur des représentations de caractéristiques interpolées. La formulation mathématique complète, la dérivation théorique, les équations régissant le processus et l'objectif d'entraînement sont fournis dans le Supplementary File 1.
Formulation du problème
La classification des couvertures terrestres à partir de données de télédétection multimodales implique l'apprentissage de représentations sémantiques à partir de modalités de détection hétérogènes, telles que l'HSI et le LiDAR. Ces modalités présentent des caractéristiques de détection distinctes. L'HSI acquiert des informations spectrales riches avec des centaines de canaux ( ), tandis que le LiDAR fournit des informations structurelles fines avec relativement peu de canaux (
 ). Ce déséquilibre entre la richesse spectrale et la rareté structurelle crée un écart de domaine important dans les distributions de caractéristiques, rendant la fusion directe des caractéristiques sous-optimale et potentiellement instable.
Formellement, étant donné une paire d'entrées multimodales, 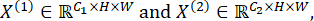 l'objectif consiste à prédire une carte sémantique au niveau des pixels selon l'Équation 1 :
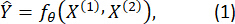
Ici, 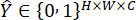 est le tenseur d'étiquettes encodé en one-hot, C désigne le nombre total de catégories de couverture terrestre, et θ représente tous les paramètres apprenables du modèle. Le jeu de données Houston2013 présente une taille d'image de 349 × 1905 pixels avec 144 bandes hyperspectrales (HSI) et 1 bande LiDAR. Le jeu de données Augsburg a une taille d'image de 1152 × 480 pixels avec 224 bandes HSI et 1 bande LiDAR. Le jeu de données MUUFL a une taille d'image de 325 × 220 pixels avec 64 bandes HSI et 2 bandes LiDAR. Pour tous les jeux de données, les fragments d'image d'entrée ont été redimensionnés à 32 × 32 pixels avant l'entraînement.
Les approches multimodales classiques fusionnent des caractéristiques spécifiques à chaque modalité par concaténation ou par des mécanismes d'attention, en supposant implicitement que différentes modalités résident dans un espace de caractéristiques compatible. Toutefois, cette hypothèse est rarement valable pour les données de télédétection, car les distributions statistiques spécifiques à chaque modalité ainsi que leurs caractéristiques spatiales et spectrales diffèrent considérablement.
Pour combler explicitement cette divergence, un module d'appariement de flux,  , est introduit. Le module est paramétré par
 et apprend des transformations bidirectionnelles continues entre des variétés de caractéristiques spécifiques à chaque modalité. Plus précisément (Équation 2) ,
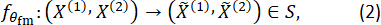
Ici, S désigne l'espace latent partagé dans lequel les représentations de caractéristiques spécifiques à chaque modalité sont alignées géométriquement. Ensuite, les représentations de caractéristiques alignées sont fusionnées et classées selon l'équation 3 comme suit :
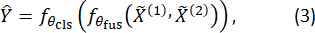
Ici,  et
 désignent respectivement les modules de fusion de caractéristiques et de classification. Cette formulation définit le cadre global de FlowErs. Plutôt que de s'appuyer uniquement sur une fusion statistique implicite des caractéristiques, le cadre proposé introduit un mécanisme explicite d'alignement basé sur les flux, qui transporte continuellement les représentations de caractéristiques spécifiques à chaque modalité vers un espace latent partagé avant la fusion des caractéristiques multimodales et la prédiction sémantique.
Encodeur MetaFormer
FlowErs effectue un alignement de caractéristiques multimodal à l'aide d'encodeurs légers spécifiques à chaque modalité, qui apprennent des représentations de caractéristiques informatives et géométriquement cohérentes à partir de chaque modalité de détection. Comme illustré dans la Figure 2, chaque modalité est traitée par un encodeur indépendant basé sur l'architecture MetaFormer. MetaFormer généralise la conception fondamentale du Transformer en dissociant le mélange des jetons de la transformation des canaux, sans calculer explicitement l'auto-attention. Cette conception permet un traitement efficace des images hyperspectrales (HSI) de haute dimension, tout en restant adaptable aux modalités à faible nombre de canaux, telles que le LiDAR.
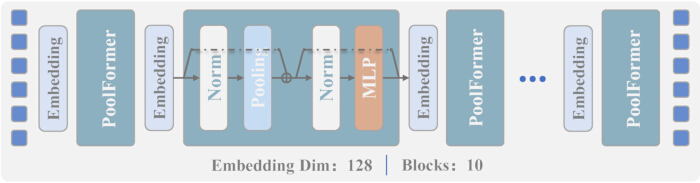
Figure 2 : Architecture de l'encodeur MetaFormer spécifique à la modalité utilisé dans le cadre proposé FlowErs. L'encodeur transforme les entrées spécifiques à chaque modalité en représentations hiérarchiques de caractéristiques au moyen d'opérations répétées d'intégration et de blocs PoolFormer. Chaque bloc PoolFormer comprend une normalisation, un mélange de jetons basé sur le regroupement (pooling), une addition résiduelle, une normalisation et un perceptron multicouche (MLP). Les représentations hiérarchiques de caractéristiques obtenues sont transmises au module d'appariement de flux multimodal pour l'alignement des caractéristiques intermodales. Norm : normalisation ; MLP : perceptron multicouche. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Pour chaque modalité  , l'encodeur MetaFormer
 , transforme l'entrée
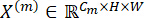 en une hiérarchie de représentations latentes de caractéristiques (Équation 4) :
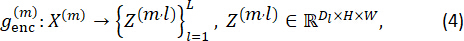
Ici, L désigne le nombre total d'étapes de l'encodeur, et Dl désigne la dimension d'incorporation à l'étape l. L'encodeur MetaFormer comprend trois étapes (N = 3) avec des dimensions d'incorporation respectives de 64, 128 et 256. Les nombres correspondants de blocs PoolFormer à chaque étape sont 2, 6 et 2, conformément à l'architecture hiérarchique progressive décrite dans le manuscrit.
Chaque encodeur commence par une convolution 1 × 1 qui projette les canaux d'entrée dans un espace d'incorporation commun (Équation 5) :
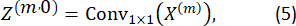
Cette couche de projection est suivie par L blocs MetaFormer empilés. Chaque bloc comprend deux opérations résiduelles : (i) un mélange de jetons par regroupement spatial afin d'agréger les informations contextuelles et (ii) une transformation de canal au moyen d'un perceptron multicouche (MLP) pour affiner les représentations des caractéristiques spectrales et spatiales. Ces opérations sont exprimées à l’aide des équations 6 et 7 comme suit :
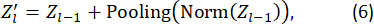

Ici, Pooling(·) désigne une agrégation de contexte spatial basée sur le regroupement moyen et MLP(·) désigne un réseau feed-forward convolutif à deux couches intégrant une activation GELU et une régularisation par abandon (dropout).
L'encodeur suit une architecture hiérarchique dans laquelle la dimension de l'intégration augmente progressivement au fil des étapes successives (par exemple, 64  128 256). Cette conception progressive permet aux couches plus profondes d'encoder des informations spatiales et spectrales de plus en plus riches, tout en améliorant la capacité de représentation des caractéristiques apprises. L'implémentation utilise un noyau de regroupement 3 × 3, une dimension cachée de l'ALM de 128 et un taux de suppression de 0,1. Toutes les couches de convolution dans l'encodeur MetaFormer utilisent des noyaux 1 × 1 avec un pas de 1 et sans remplissage. L'opérateur de regroupement utilise un regroupement moyen 3 × 3 avec un pas de 1 et un remplissage de 1. La normalisation par lot (BatchNorm2d) est utilisée dans tout l'encodeur. L'ALM possède une dimension cachée de 128, utilise la fonction d'activation GELU et un taux de suppression de 0,1. Les trois étapes de l'encodeur contiennent respectivement 2, 6 et 2 blocs PoolFormer, et ces paramètres architecturaux sont appliqués de manière cohérente à toutes les étapes.
Contrairement aux encodeurs basés sur les Transformers, l'encodeur MetaFormer élimine le coût computationnel quadratique associé à l'auto-attention tout en réduisant les biais spécifiques aux modalités durant l'extraction des caractéristiques. Son mélangeur de jetons basé sur le regroupement agrège efficacement le contexte spatial local, tandis que l'alignement intermodal est ensuite réalisé par le module de mise en correspondance de flux. Par conséquent, les représentations de caractéristiques de niveau le plus élevé produites par l'encodeur fournissent des entrées sémantiquement informatives et géométriquement cohérentes pour l'alignement des caractéristiques multimodales.
Correspondance de flux multimodale
Le défi principal après l'extraction des caractéristiques est l'alignement de représentations hétérogènes de caractéristiques provenant de modalités sensorielles distinctes et situées sur des variétés de caractéristiques différentes. La concaténation directe de  et de
 donne souvent de mauvais résultats en raison de distributions incohérentes des caractéristiques et de biais spécifiques à chaque modalité. FlowErs répond explicitement à ce défi en introduisant un module MFM qui apprend des transformations continues et bidirectionnelles entre les deux espaces de caractéristiques, comme illustré schématiquement dans la Figure 1B.
Soit 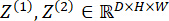 les représentations de caractéristiques extraites par les encodeurs MetaFormer. Un champ d'écoulement continu paramétré par le temps d'interpolation
 est défini à l'aide de l'équation 8 comme suit :
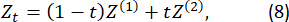
Ici, t = 0 correspondant à la modalité source et t = 1 correspondant à la modalité cible.
Le modèle de correspondance d'écoulement, , est implémenté sous la forme d'un U-Net conditionné par le temps qui prédit le champ de vitesse instantané régissant la transformation le long de cette trajectoire d'interpolation. Chaque prédicteur d'écoulement comprend trois blocs de sous-échantillonnage (64 128 256 512) et trois blocs de sur-échantillonnage correspondants (512 256 128 64), utilisant des convolutions 3 × 3, une normalisation par lot et une activation par unité linéaire rectifiée (ReLU). Les intégrations temporelles intermédiaires ont respectivement des dimensions de 128, 256, 512, 256 et 128. L'intégration temporelle utilise un encodage positionnel sinusoïdal fixe. L'intégration de l'équation différentielle ordinaire (ODE) est effectuée à l'aide de la méthode d'Euler explicite avec un pas fixe. Pendant l'apprentissage, le nombre d'étapes d'intégration a été fixé à 6, tandis que 5 étapes d'intégration ont été utilisées par défaut lors de l'inférence. Le nombre réel d'itérations de la boucle d'intégration est calculé comme suit : 
Le champ de vitesse prédit est donné par l'équation 9 comme suit :
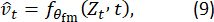
Ici,  désigne la vitesse instantanée prédite. Le modèle apprend à approximer le déplacement
 , encourageant ainsi des transformations continues entre les espaces de caractéristiques spécifiques à chaque modalité. L'objectif d'apprentissage est formulé comme une perte bidirectionnelle de l'erreur quadratique moyenne (MSE) conditionnée au temps, comme suit (Équation 10) :
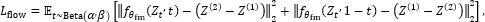 (10)
L'échantillonnage de t à partir de la distribution bêta spécifiée expose le modèle à des états d'interpolation intermédiaires, mais n'établit pas une cohérence cyclique exacte. Contrairement aux méthodes d'alignement basées sur la diffusion, la formulation proposée par correspondance de flux est déterministe, ne nécessite aucun échantillonnage stochastique lors de l'inférence et peut être entraînée à l'aide de données étiquetées et non étiquetées.
Un modèle d'apprentissage par flux entraîné sert ensuite d'opérateur d'alignement déterministe qui projette les représentations de caractéristiques spécifiques à chaque modalité dans un espace latent partagé S. Les représentations alignées sont obtenues comme suit (Équation 11) :
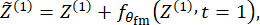
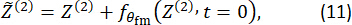
Ici,  et
 désignent les représentations de caractéristiques alignées. L'alignement basé sur le flux est appliqué aux représentations de caractéristiques intermédiaires des deux premières étapes de l'encodeur (étapes 1 et 2), dont les dimensions d'incorporation sont respectivement de 64 et 128. Les caractéristiques de l'encodeur de niveau le plus élevé (étape 3, dimension d'incorporation 256) ne sont pas traitées par le module de correspondance de flux. Au lieu de cela, ces caractéristiques sont concaténées directement et transmises au classificateur pour la prédiction multimodale.
Ce mécanisme d'alignement bidirectionnel transporte progressivement les représentations de caractéristiques spécifiques à chaque modalité vers un espace latent partagé au moyen d'un champ d'écoulement continu. Par conséquent, et s'alignent plus étroitement avant la fusion des caractéristiques multimodales, fournissant des représentations de caractéristiques sémantiquement cohérentes et géométriquement compatibles pour la classification ultérieure.
Pipeline d'entraînement
FlowErs exploite à la fois des données étiquetées et non étiquetées tout en maintenant un alignement transmodal stable grâce à une stratégie d'entraînement en deux étapes, comme illustré dans la Figure 1(B,C). Lors de la première étape, un module d'alignement invariant aux modalités est appris par correspondance de flux non supervisée. Lors de la deuxième étape, une classification supervisée est effectuée à l'aide des représentations latentes alignées, tout en réutilisant le module d'alignement de flux préentraîné.
Étape 1 : Préentraînement non supervisé par flux
Étant donné des paires d'images multimodales,  des représentations de caractéristiques spécifiques à chaque modalité,
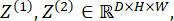 sont extraites à l'aide des encodeurs MetaFormer. Des représentations de caractéristiques intermédiaires sont générées en utilisant l'interpolation définie dans l'équation 8, où
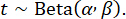 Le module d'appariement de flux,
 , est optimisé en minimisant l'objectif conditionné bidirectionnel défini dans l'équation 10, sans utiliser d'étiquettes de classe. Durant cette étape, seuls les paramètres d'appariement de flux,
 , sont mis à jour, permettant au modèle d'apprendre des correspondances tenant compte de la géométrie à partir d'échantillons étiquetés et non étiquetés avant la classification supervisée. L'étape 1 (préentraînement par appariement de flux) a été réalisée à l'aide de l'optimiseur AdamW avec un taux d'apprentissage de 1 × 10⁻4, une décroissance du poids de 1 × 10⁻2, et un planning de taux d'apprentissage avec recuit cosinus. Des tailles de lot de 16 ont été utilisées pour les jeux de données Houston2013 et Trento, tandis que des tailles de lot de 32 ont été utilisées pour les jeux de données Augsburg et MUUFL. Le module d'appariement de flux a été préentraîné pendant 2 000 époques en utilisant à la fois des échantillons étiquetés et non étiquetés. La graine aléatoire a été fixée à 3407. Toutes les expériences ont été menées à l'aide de PyTorch sur un seul GPU NVIDIA A100 (80 Go de mémoire).
Étape 2 : Classification supervisée avec un aligneur partagé
Le module d'appariement de flux préentraîné est réutilisé lors de l'entraînement supervisé et est appliqué aux deux premières étapes de l'encodeur plutôt qu'à tous les niveaux de caractéristiques. Les représentations de caractéristiques alignées sont ensuite fusionnées à l'aide de la tête de classification pour générer des prédictions au niveau des pixels. L'optimisation supervisée minimise la perte d'entropie croisée masquée (Équation 12) :
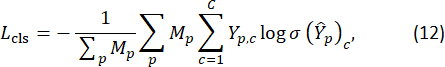
Ici, M désigne le masque d'étiquette, Y désigne les étiquettes réelles encodées en one-hot, et σ(·) désigne la fonction softmax. Pendant l'étape 2 (apprentissage supervisé), le module préentraîné de correspondance de flux est resté complètement figé et a servi d'opérateur fixe d'alignement intermodal. Ses poids préentraînés ont été chargés au début de l'étape 2 et n'ont pas été mis à jour durant l'apprentissage supervisé. Seuls les paramètres de l'encodeur MetaFormer et du classificateur ont été optimisés. L'apprentissage supervisé a été effectué à l'aide de l'optimiseur AdamW avec des taux d'apprentissage spécifiques à chaque jeu de données : 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) et 1 × 10⁻5 (Trento). La décroissance du poids a été fixée à 1 × 10⁻2 pour tous les jeux de données sauf MUUFL, pour lequel une valeur de 5 × 10⁻2 a été utilisée. Des tailles de lot de 16 ou 32 ont été employées selon le jeu de données. Les modèles ont été entraînés pendant 100 époques (Houston2013 et MUUFL), 200 époques (Augsburg) et 20 époques (Trento) en utilisant un planning de décroissance du taux d'apprentissage de type annealing cosinus. La fonction de perte CrossEntropyLoss avec réduction moyenne a été utilisée comme fonction de perte. Aucun arrêt précoce n'a été appliqué ; à la place, le point de contrôle du modèle atteignant la plus haute précision globale (OA) sur l'ensemble de test a été sélectionné comme modèle final. Le flux de travail complet de mise en œuvre de la procédure d'entraînement en deux étapes est résumé dans le fichier supplémentaire S1 (algorithme S1).
Cette stratégie d'apprentissage découplée sépare l'alignement géométrique de la discrimination sémantique. Lors de l'étape 1, le modèle apprend des correspondances bidirectionnelles de caractéristiques continues à l'aide de l'objectif d'appariement de flux. Lors de l'étape 2, le module d'alignement préentraîné fournit une opération commune de transport de caractéristiques avant la fusion des caractéristiques multimodales, tandis que le réseau de classification apprend des représentations discriminantes par classe à partir de l'espace latent aligné. La réutilisation de l'aligneur préentraîné favorise un alignement cohérent des caractéristiques avant la fusion, mais ne constitue pas une garantie indépendante d'une généralisation améliorée.
Ensembles de données expérimentales
Le cadre proposé a été évalué à l'aide de trois ensembles de données de référence multimodales de télédétection représentatifs : Houston201329, Augsburg30 et MUUFL31.
L'ensemble de données Houston2013 a été publié dans le cadre du concours IEEE GRSS Data Fusion. Il représente un paysage urbain diversifié à Houston, aux États-Unis, et contient 15 classes de couverture des sols, incluant des zones résidentielles, des routes, de la végétation et des masses d'eau. L'ensemble de données comprend des images hyperspectrales (HSI) avec 144 bandes spectrales couvrant le spectre visible au proche infrarouge, ainsi qu'un modèle numérique de surface (DSM) issu d'un LiDAR à une bande unique, avec une résolution spatiale de 2,5 m. Les textures urbaines complexes et la variabilité spectrale importante au sein des classes rendent cet ensemble de données difficile pour une classification précise de la couverture des sols.
L'ensemble de données d'Augsburg a été acquis au-dessus d'une zone urbaine densément construite en Allemagne. Il comprend des images hyperspectrales avec 224 bandes spectrales couvrant la plage de longueurs d'onde de 400 à 1000 nm, ainsi que des données d'élévation LiDAR co-enregistrées. L'ensemble de données contient 17 classes de couverture terrestre annotées, incluant des structures bâties, des sols nus, de l'asphalte, de la végétation et des ombres, avec une résolution spatiale de 2 m. Comparé à Houston2013, Augsburg présente des corrélations spectrales plus fortes ainsi qu'une plus grande diversité de classes, offrant un banc d'essai exigeant pour évaluer l'alignement des caractéristiques intermodales et la généralisation.
L'ensemble de données MUUFL Gulfport a été recueilli au-dessus d'un campus universitaire et représente un environnement semi-urbain contenant une végétation abondante ainsi que de petites structures artificielles. Cet ensemble comprend des images hyperspectrales de 64 bandes débruitées, ainsi que des mesures LiDAR bichromatiques comprenant des informations d'élévation et d'intensité. Il contient 11 classes de couverture des sols et présente des détails spatiaux fins, des pixels mixtes et des conditions d'éclairement variables, ce qui le rend particulièrement adapté à l'évaluation de la fusion de caractéristiques multimodales pour la classification d'objets de petite taille.
Ces trois jeux de données de référence englobent conjointement des variations importantes en termes de résolution spatiale (1–2,5 m), de dimensionnalité spectrale (64–224 bandes), de complexité de la scène et de composition des couvertures terrestres. Par conséquent, ils offrent une référence diversifiée pour évaluer l'efficacité et la généralisabilité des méthodes de classification multimodale des couvertures terrestres. Les caractéristiques principales des jeux de données sont résumées dans le tableau 1. Les partitions entraînement/test pour les trois jeux de données correspondent aux subdivisions officielles fournies par les fournisseurs initiaux des données. Plus précisément, le jeu de données Houston2013 utilise la partition officielle issue du concours IEEE GRSS Data Fusion de 2013, comprenant 2 832 échantillons d'apprentissage et 12 197 échantillons de test. Le jeu de données Augsburg utilise les annotations officielles mask_train et mask_test, produisant 4 538 échantillons d'apprentissage et 47 896 échantillons de test. Le jeu de données MUUFL utilise la partition officielle train_test_gt.mat, contenant 28 645 échantillons d'apprentissage et 24 283 échantillons de test. Pour chaque jeu de données, un patch d'image de 32 × 32 pixels, centré sur chaque pixel étiqueté, a été extrait comme échantillon individuel d'apprentissage ou de test. Aucune autre division ou rééchantillonnage des données n'a été effectué.
| Propriété | Houston2013 | Augsburg | MUUFL |
| Taille de l'image HSI (pixels) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Taille de l'image LiDAR (pixels) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Bandes spectrales HSI | 144 | 224 | 64 |
| Bandes LiDAR | 1 | 1 | 2 |
| Plage de longueurs d'onde HSI | 0,38–1,05 µm | 0,40–1,00 µm | 375–1050 nm |
| Plage de longueurs d'onde LiDAR | Non applicable | Non applicable | Non applicable |
| Résolution spatiale (HSI) | 2,5 m | 2,0 m | 0,54 m × 1,00 m |
| Résolution spatiale (LiDAR) | 2,5 m | 2,0 m | 0,60 m × 0,78 m |
| Nombre de classes de couverture terrestre | 15 | 17 | 11 |
Tableau 1 : Caractéristiques des trois ensembles de données de référence de télédétection multimodale utilisés pour l'évaluation. Ce tableau résume les dimensions des images, les caractéristiques spectrales, les résolutions spatiales et le nombre de classes d'occupation des sols pour les ensembles de données de référence Houston2013, Augsburg et MUUFL utilisés afin d'évaluer le cadre proposé FlowErs.
Détails de mise en œuvre
Le cadre FlowErs a été implémenté dans PyTorch et entraîné ainsi qu'évalué à l'aide d'une unité de traitement graphique (GPU) disposant de 80 Go de mémoire. L'entraînement a été effectué sur 100 époques avec une taille de lot de 16. L'optimiseur AdamW a été utilisé avec un taux d'apprentissage initial de 1 × 10⁻⁴ et une décroissance du poids de 1 × 10⁻². Un planificateur de taux d'apprentissage par recuit cosinus a été employé pour mettre à jour le taux d'apprentissage tout au long de l'entraînement. Un taux de dropout de 0,1 a été appliqué afin d'améliorer la généralisation du modèle et de réduire le surapprentissage. La fonction de perte d'entropie croisée a été utilisée pour l'optimisation supervisée. Pour assurer la reproductibilité, toutes les expériences ont été initialisées à l'aide d'une graine aléatoire fixe de 3407. Les partitions d'entraînement/test fournies ont été utilisées sans créer de fractionnement de validation supplémentaire. Chaque patch d'entrée a été redimensionné à 32 × 32 pixels avant l'entraînement. Aucune augmentation des données, aucune correction explicite d'enregistrement d'image ou aucune normalisation supplémentaire du chargeur de données n'a été appliquée. Les pixels associés à des étiquettes négatives ont été exclus du calcul de la perte supervisée. La gestion des pixels manquants ou bruités n'a pas été évaluée séparément.
Métriques d'évaluation
Trois métriques d'évaluation largement utilisées ont été employées pour évaluer les performances de classification : l'exactitude globale (OA), l'exactitude moyenne (AA) et le coefficient Kappa (k). L'OA mesure la proportion d'échantillons correctement classés parmi tous les échantillons, l'AA représente la moyenne des exactitudes de classification sur l'ensemble des classes d'occupation des sols, et le coefficient Kappa quantifie l'accord entre les classifications prédites et de référence, corrigé pour l'accord dû au hasard. Des valeurs plus élevées pour ces trois métriques indiquent de meilleures performances de classification. Toutes les valeurs indiquées dans les tableaux 2 à 6 sont des estimations ponctuelles à découpage fixe obtenues à l'aide de la graine aléatoire 3407. Aucun intervalle de confiance, test de significativité statistique ni valeur p n'est indiqué.
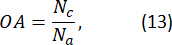
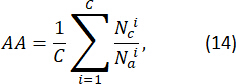
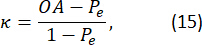
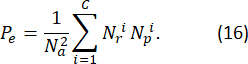
Ici, Nc et Na désignent respectivement les nombres totaux d'échantillons correctement classifiés et d'échantillons évalués.  et
 désignent respectivement les nombres d'échantillons correctement classifiés et le nombre total d'échantillons pour la i-ème classe. Dans le calcul du coefficient Kappa, Pe désigne la probabilité d'un accord survenant par hasard, et
 et
 désignent respectivement les effectifs de référence et les effectifs prédits pour la i-ème classe.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Le flux de travail global d'évaluation du cadre proposé FlowErs est illustré dans la Figure 1, qui résume la stratégie de classification multimodale en deux étapes. Le processus d'extraction de caractéristiques spécifiques à chaque modalité, basé sur l'encodeur MetaFormer, est présenté dans la Figure 2, et les caractéristiques principales des trois jeux de données de référence utilisés pour l'évaluation sont résumées dans le Tableau 1. Les perfo...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
La présente étude introduit FlowErs, un cadre de télédétection multimodal qui sépare l'alignement des caractéristiques intermodales de la classification sémantique au moyen d'une stratégie d'apprentissage en deux étapes. Plutôt que de fusionner directement des caractéristiques spécifiques à des modalités hétérogènes, le cadre proposé aligne d'abord les représentations de caractéristiques à l'aide d'une correspondance de flux conditionnelle, avant la fusion multimodale et la classification. Cette conception répond au défi...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Conflit d'intérêts :
Les auteurs déclarent ne pas avoir de conflits d'intérêts.
Remerciements
This work was financially supported by the Scientific Research Fund Project of Shaanxi A&F University (Grant No. ZK25-38) and the Education Department of Shaanxi Province (Grant No. 24JK0734).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Optimiseur AdamW | Fondation PyTorch | Inclus dans PyTorch | Utilisé pour l'optimisation du modèle. PyTorch 2.5.0 a été utilisé. |
| Jeu de données de référence d'Augsburg | Hu J et al. (Données sur les sciences du système Terre, 2022) ; Technologie de télédétection, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | Jeu de données de référence multimodal en télédétection publique utilisé pour l'évaluation des modèles. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4 ; https://developer.nvidia.com/cuda-12-4-0-download-archive | Utilisé pour l'entraînement et l'inférence de modèles accélérés par GPU. |
| Unité de traitement graphique (GPU) | NVIDIA Corporation | NVIDIA A100 80 Go PCIe | Utilisé pour l'entraînement et l'évaluation du modèle. |
| jeu de données de référence Houston2013 | Concours de fusion de données de la société IEEE Geoscience and Remote Sensing | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Jeu de données de référence public comprenant des images hyperspectrales et des données LiDAR, utilisé pour l'évaluation des modèles. |
| Jeu de données de référence MUUFL Gulfport | Université de Floride (Gader P et al., Rapport technique REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Jeu de données de référence public comprenant des images hyperspectrales et des données LiDAR, utilisé pour l'évaluation des modèles. |
| Système d'exploitation | Canonical Ltd. | Ubuntu 22.04 LTS ; https://ubuntu.com | Environnement informatique utilisé pour le développement, l'entraînement et l'évaluation du modèle. |
| PyTorch | Fondation PyTorch | PyTorch 2.5.0 ; https://pytorch.org/get-started/previous-versions/#v250 | Cadre d'apprentissage profond utilisé pour implémenter, entraîner et évaluer le modèle FlowErs. |
| Python | Fondation Python | Python 3.11 ; https://www.python.org/downloads/release/python-3110/ | Langage de programmation utilisé pour implémenter et exécuter le flux de travail computationnel. |
Références
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.