Ce protocole décrit une méthodologie structurée de conception de services permettant de diagnostiquer des problèmes complexes dans les processus d'application et de consultation de services publics à faible risque. L'approche intègre la cartographie des parties prenantes, la cartographie des parcours, la conception participative et la prototypage à faible fidélité, ainsi qu'une évaluation simulée fondée sur des tâches portant sur le comportement des utilisateurs, leur prise de décision et l'ergonomie des supports de service avant leur mise en œuvre.
Article de méthode
Un protocole de visualisation de design de service systémique pour les problèmes complexes dans les processus de consultation et d'application des services publics à faible risque
21 vues
⸱
11 septembre 2026
Dans cet article
Résumé
Résumé
Les problèmes complexes de service public présentant des caractéristiques proches de celles des « problèmes complexes » — tels que la multiplicité des acteurs, l’information fragmentée, les limites floues de la responsabilité et l’absence d’une solution unique et incontestée — sont difficiles à structurer dans des contextes administratifs courants. Cet article présente un protocole systématique de visualisation par conception de service, destiné aux applications et aux processus de consultation dans le domaine du service public à faible risque, définis comme des services administratifs qui ne déterminent pas de traitement médical, de statut juridique, d’éligibilité financière, de protection de l’enfance, de sanctions disciplinaires ou d’autres décisions à enjeux élevés ayant une incidence sur les droits. Le protocole intègre la cartographie des parties prenantes, la cartographie du parcours de service public, la méthode de co-conception Double Diamond et des tests de prototypes basse fidélité afin de transformer des défis administratifs fragmentés en concepts de service actionnables et co-conçus, puis de les évaluer au moyen de tâches simulées. Dans un parcours représentatif d’application administrative à faible risque, les tests par tâches simulées menés auprès de 28 participants (112 enregistrements de tâches de référence et 112 enregistrements post-prototype) ont montré une réduction du temps d’exécution des tâches (178,4 ± 49,6 s à 121,7 ± 38,2 s), un nombre moindre d’erreurs (1,86 ± 0,91 à 0,79 ± 0,63 erreur par tâche) et un taux de réussite accru (62,5 % à 82,1 %) après exposition aux supports générés par le protocole. Ces résultats constituent une preuve d’utilisabilité fondée sur les tâches, bien que la séquence fixe avant/après puisse inclure des effets d’apprentissage. Ce protocole reproductible offre une approche structurée et axée sur la visualisation pour diagnostiquer les problèmes complexes de service public et concevoir des solutions en prototypant dans des environnements de service public à faible risque.
Introduction
Les organisations de service public font de plus en plus face à des défis complexes qui résistent à de simples ajustements administratifs. Ces problèmes se caractérisent par l'implication de multiples acteurs, une répartition fragmentée des responsabilités, un accès inégal à l'information et des tensions entre les procédures administratives standardisées et les besoins variés des usagers. Plutôt que d'affirmer qu'il existe une formule entièrement reproductible pour les résoudre, ce protocole les considère comme des problèmes de service limités et à faible risque, présentant des traits semblables à ceux des « problèmes complexes » (wicked problems), qui peuvent être structurés, visualisés et explorés au moyen d'étapes de facilitation reproductibles1,2. Dans la prestation courante des services publics, ces problèmes se manifestent par des dysfonctionnements opérationnels : les citoyens ont du mal à identifier les documents requis, le personnel d'accueil fait face à des demandes répétitives, et les administrateurs appliquent des règles qui ne sont pas clairement visibles pour les usagers finaux.
Pour répondre à ces complexités, l'innovation dans la fonction publique s'est orientée vers des approches participatives centrées sur l'utilisateur, au lieu des réformes internes axées sur l'efficacité. Les recherches actuelles indiquent que la cocréation et la coproduction permettent aux citoyens, aux professionnels et aux organisations de contribuer conjointement à l'innovation des services3,4,5. Toutefois, ce changement vers une approche participative soulève un défi méthodologique. Bien que divers intervenants puissent convenir qu'un service est inefficace, ils parviennent rarement à un consensus sur l'endroit précis où se produit la défaillance structurelle, sur les personnes les plus touchées ou sur les interventions spécifiques nécessaires.
Ce protocole s'adresse aux chercheurs en conception de services, aux chercheurs en administration publique, aux équipes chargées de l'amélioration des services au sein des municipalités ou des universités, ainsi qu'aux facilitateurs formés qui ont besoin d'une méthode reproductible pour transformer les plaintes impliquant plusieurs acteurs en supports visuels diagnostiques avant la mise en œuvre. Il convient particulièrement aux applications à faible risque, telles que les services de consultation, d'inscription, de vérification de statut et de suivi, dans lesquels les utilisateurs doivent interpréter des exigences, préparer des documents, avancer par étapes successives et coordonner leurs actions avec plusieurs intervenants. Il ne doit pas être utilisé comme méthode principale pour la prise de décision en cas d'urgence, les transactions hautement standardisées dotées de procédures établies en une seule étape, les décisions juridiques, les traitements médicaux, la protection de l'enfance, les décisions relatives au statut d'immigration, les attributions d'aides financières, les procédures disciplinaires, ou dans tout contexte nécessitant un accès à des dossiers nominatifs.
Par rapport à l'analyse des parties prenantes, à la cartographie des parcours ou aux ateliers participatifs menés séparément, le flux de travail proposé associe, au sein d'une séquence unique et vérifiable, la cartographie des acteurs, l'analyse détaillée des services par étape, la formulation conjointe des défis et la simulation de tests de prototypes. Cette intégration permet d'éviter que les équipes passent directement d'un mécontentement généralisé à des idées de solutions, sans avoir d'abord identifié les personnes concernées, les lieux où surviennent les dysfonctionnements et les matériaux pouvant être testés en toute sécurité. De récentes revues sur la conception participative dans le secteur public et en santé publique insistent également sur la nécessité de processus transparents, d'une animation explicite et d'une évaluation rigoureuse de la participation et des dynamiques de pouvoir4,6,7,8,9.
Le design de service offre un cadre pratique pour relever ce défi grâce à des méthodes visuelles, participatives et axées sur la prototypologie6,8,10. Plutôt que de considérer les défaillances de service comme des lacunes politiques abstraites, le design de service examine les interactions entre les utilisateurs, le personnel, les points de contact et les processus en coulisses. Par conséquent, la co-conception est de plus en plus proposée au sein de l'administration publique comme un moyen d'impliquer les citoyens dans la définition de problèmes complexes4,7,11. Toutefois, les initiatives de co-conception échouent souvent lorsqu'elles manquent d'un mécanisme structuré permettant de traduire les expériences subjectives des parties prenantes en supports de service public testables, ou lorsqu'elles ne gèrent pas explicitement les différences de pouvoir entre les participants.
Une transition méthodologique rigoureuse exige l'intégration séquentielle d'outils analytiques spécifiques. La cartographie des parties prenantes sert de base diagnostique en clarifiant l'implication des acteurs, leur influence, leurs dépendances et les asymétries d'information12. La cartographie du parcours est ensuite utilisée pour identifier les points de friction spécifiques et les ambiguïtés en matière de responsabilité à travers les différentes étapes successives du service13. Par la suite, le cadre Double Diamond offre un cheminement structuré pour transformer ces dysfonctionnements cartographiés en défis de conception exploitables, en séparant l'exploration divergente du problème du développement convergent des solutions7,8,14. Enfin, les tests de prototypes à faible fidélité permettent d'évaluer en toute sécurité des concepts co-conçus avant leur mise en œuvre — une étape essentielle dans les services publics, où des changements prématurés peuvent perturber l'accès des citoyens ou accroître la charge administrative15,16.
Malgré l'augmentation des lignes directrices méthodologiques sur ces outils, la reproductibilité demeure une limitation critique dans la littérature sur la co-conception de services publics6,7,8,17. De nombreuses études décrivent les ateliers de conception en termes généraux, masquant ainsi les étapes analytiques précises nécessaires à une réplication indépendante. Une méthode rigoureuse devrait établir des étapes fixes, des allocations de temps définies, des règles de notation standardisées, des résultats visuels cohérents et des critères de décision transparents. En outre, elle devrait clairement distinguer l'évaluation de l'utilisabilité à un stade précoce et fondée sur des tâches, des affirmations plus larges concernant le rendement réel en matière d'agence.
Cet article présente un protocole systématique de visualisation en conception de service, élaboré pour structurer des problèmes complexes impliquant de multiples acteurs dans le cadre de l'innovation en services publics à faible risque4,6,16,17. Conçu spécifiquement pour les applications et les processus de consultation en services publics, ce protocole intègre de manière séquentielle la cartographie des parties prenantes, la cartographie des parcours, un atelier Double Diamond et des tests de prototype. L'objectif global est d'offrir aux chercheurs et aux praticiens une approche reproductible pas à pas permettant de passer de plaintes fragmentées sur un service à un diagnostic visuel, à une définition objective du problème et à la validation empirique de concepts de service conçus conjointement.
Protocole
L'application représentative décrite dans cet article a été approuvée par le Comité d'éthique sur la protection de la recherche humaine de la City University of Macau, à Macao, Chine (numéro d'approbation : 2600AL2401 ; valable du 10 janvier 2026 au 10 janvier 2028). Un consentement éclairé écrit ou électronique a été obtenu auprès de tous les participants avant leur participation. Le protocole ne comportait aucune intervention médicale, aucune population vulnérable, aucun leurre, aucun prélèvement d'échantillons biologiques, aucune donnée financière privée, aucune évaluation individuelle de performance ni aucun accès à des documents administratifs officiels. Les outils de recherche utilisés pour le protocole sont répertoriés dans le Tableau des matériaux.
1. Recrutement des participants et définition du contexte
- Sélectionnez une application de service public à faible risque et un processus de consultation à évaluer, par exemple un parcours administratif municipal, universitaire ou communautaire qui nécessite une recherche d'information, une clarification des critères d'éligibilité, une préparation de documents, un dépôt de demande, un traitement, une notification et un accompagnement postérieur.
- Excluez les contextes impliquant un traitement médical, le traitement d'une affaire juridique, le statut d'immigration, la protection de l'enfance, la détermination d'une aide financière, des procédures disciplinaires, des décisions d'urgence ou des dossiers administratifs officiels.
- Considérez un problème de service public adapté à ce protocole lorsqu'il présente au moins trois caractéristiques complexes ou proches des « problèmes irrésolus » : implication de plusieurs groupes d'acteurs, limites de responsabilité floues, échecs répétés de coordination entre acteurs, informations sur le service incomplètes ou incohérentes, et absence d'une solution unique et consensuelle.
REMARQUE : Ne présentez pas le protocole comme une solution à un problème entièrement irrésolu. Présentez-le comme une méthode permettant de structurer un problème de service public limité et à faible risque en vue d'un diagnostic, d'une conception collaborative et d'un test simulé. - Recrutez entre 80 et 120 participants pour l'étape du questionnaire, en fonction de leur familiarité avec l'utilisation, la prestation, la coordination ou la gestion des services publics.
- Utilisez cette taille d'échantillon comme objectif pratique de planification afin de permettre l'élaboration de profils des parties prenantes stables et descriptifs pour plusieurs groupes de rôles, tout en restant réalisable dans le cadre d'une étude de conception de service non interventionnelle.
- Sélectionnez des participants représentant tous les rôles majeurs des parties prenantes impliquées dans le processus de service public.
- Constituez un sous-groupe de 20 à 30 participants destinés à participer aux étapes de l'atelier de conception collaborative et de test de prototype.
- Formez 4 à 6 groupes mixtes selon les rôles, en veillant à ce que chaque groupe reste suffisamment petit pour favoriser une participation active.
- Veillez à ce que chaque groupe mixte inclue au moins trois catégories de parties prenantes, telles que citoyens, personnel d'accueil, travailleurs communautaires ou administrateurs.
- Séparez les citoyens et les prestataires de services lors des discussions initiales sur la cartographie des parties prenantes si des déséquilibres de pouvoir sont anticipés.
- Réalisez une synthèse en groupes mixtes après les discussions initiales. Pendant cette synthèse, utilisez un tour de parole structuré, l'écriture silencieuse d'idées, la soumission anonyme de fiches et un vote anonyme par points pour éviter que les administrateurs ou le personnel professionnel dominent les contributions des citoyens.
- Portez une attention particulière au recrutement des participants, à la préparation des rôles et aux conditions permettant aux utilisateurs de proposer des idées plutôt que de simplement répondre à des problèmes définis par des experts7,9,18.
- Indiquez à tous les participants de ne pas divulguer de noms identifiables, numéros d'identité, adresses personnelles, numéros de téléphone, identifiants de dossier, dossiers médicaux, dossiers juridiques, relevés de revenus ou fichiers de performance des organismes.
- Attribuez des codes de participant non identifiables (par exemple, P001 et P002).
- Formez tous les animateurs avant la collecte de données en utilisant le même script d'animation, des exemples de cartes de points douloureux, une grille d'évaluation des défis de conception et des exemples de notation de prototypes.
- ÉTAPE CRITIQUE : Calibrez les animateurs en leur demandant de classer indépendamment au moins cinq exemples de points douloureux et cinq ébauches d'énoncés « Comment pourrions-nous ».
REMARQUE : Les animateurs doivent atteindre au moins 80 % d'accord sur les décisions d'inclusion, de regroupement et de révision avant de poursuivre. - Discutez des divergences jusqu'à ce que les animateurs atteignent au moins 80 % d'accord sur les décisions d'inclusion, de regroupement et de révision.
- Utilisez au moins deux animateurs chaque fois que possible : un animateur principal pour guider la discussion et un observateur chargé d'enregistrer le déroulement chronologique, l'équilibre de participation et les écarts par rapport au protocole.
- Si plusieurs animateurs dirigent des groupes parallèles, organisez un débriefing de 15 à 20 minutes après chaque grande étape et documentez toute différence dans les consignes ou les règles d'interprétation sur la fiche d'audit.
ATTENTION : Après avoir terminé le recrutement des participants, obtenu leur consentement, formé les animateurs et préparé le matériel, les chercheurs peuvent suspendre l'étude avant de commencer l'étape 1. Reprenez uniquement après avoir confirmé que tous les participants ont reçu un code et que toutes les feuilles de travail ne contiennent aucune information identifiable.
2. Préparation des matériaux du protocole
- Préparez les matériaux du protocole avant leur mise en œuvre.
- Préparez la fiche d'information destinée aux participants, le questionnaire anonyme basé sur les rôles, la feuille de travail de cartographie des parties prenantes, la grille d'évaluation des parties prenantes sur cinq points, le modèle de cartographie du parcours de service public, les cartes des points de friction, le modèle de défis de conception, les cartes de solutions, la feuille de sélection de prototype, la grille de calibration du facilitateur, les fiches de tâches simulées, la liste de contrôle d'équivalence des ensembles de tâches, la grille d'évaluation des prototypes, la fiche de codage, les notes de syntaxe ou de flux de travail d'analyse, et la liste de contrôle de dé-identification.
- Attribuez à chaque matériel propre à l'étude un identifiant interne stable et un numéro de version.
- Organisez le modèle de cartographie du parcours en sept étapes par défaut : recherche d'informations, clarification des critères d'éligibilité ou des exigences, préparation des documents, soumission de la demande, traitement interdépartemental, notification du résultat et accompagnement postérieur.
- Adaptez les noms des étapes uniquement après avoir documenté en quoi le service sélectionné diffère du parcours administratif standard à faible risque.
- Conserver la même séquence de points de contact, d'acteurs responsables, d'entrées et de sorties d'informations, des points douloureux et des conséquences en aval.
- Concevoir des scénarios simulés de service public pour les fiches de tâches du prototype, sans inclure de données personnelles, administratives ou institutionnelles réelles.
- Se référer au tableau 1 pour les étapes, les durées, les matériaux et les résultats prédéfinis requis pour le protocole.
- Se référer au tableau 2 pour les éléments de collecte des données, les règles de cotation, les seuils de validité et les mesures de protection des données.
- Utiliser des méthodes de conception de services pour rendre visibles, discutables et testables les problèmes complexes liés aux services publics¹⁹.
Tableau 1 : Étapes du protocole, durée, matériaux requis et résultats prédéfinis. Le déroulement du protocole comprend les activités principales, les participants, la durée estimée, les matériaux nécessaires et les résultats attendus pour chaque étape.Veuillez cliquer ici pour télécharger ce tableau.
Tableau 2 : Métriques de collecte des données, méthodes, critères d'exclusion et mesures de protection des données. Les métriques recueillies à chaque étape du protocole, les méthodes correspondantes de collecte des données, les critères d'exclusion prédéfinis, ainsi que les mesures mises en œuvre pour protéger la confidentialité des participants et l'intégrité des données.Veuillez cliquer ici pour télécharger ce tableau.
3. Étape 1 : Cartographie des parties prenantes
- Demander aux participants d'utiliser la feuille de travail de cartographie des parties prenantes pour énumérer individuellement cinq à huit acteurs impliqués dans le processus de service public sélectionné.
- Allouer 25 à 35 minutes pour l'étape de cartographie des parties prenantes.
- Se référer à Figure 1 pour visualiser l'ensemble du flux de travail du protocole de visualisation.
- Demander aux participants d'évaluer chaque acteur listé selon quatre dimensions à l'aide d'une échelle verbale à cinq points (1 = très faible ; 5 = très élevé) : influence sur le résultat du service, dépendance par rapport aux autres acteurs, accès à l'information sur le service, et pression en matière de coordination.
- Fournir des exemples écrits avant que les participants n'effectuent les évaluations.
- Définir une forte influence comme celle d'un acteur dont la décision, le retard ou l'interprétation affecte sensiblement le résultat du service.
- Définir une forte dépendance comme celle d'un acteur qui ne peut pas mener à bien le processus de service sans information, confirmation ou action provenant d'autres acteurs.
- Calculer le score moyen pour chaque groupe de parties prenantes sur chacune des dimensions.
- Signaler un écart d'au moins deux points entre les groupes de parties prenantes sur une même dimension comme une divergence de perception, car il représente un décalage d'au moins 40 % de l'échelle à cinq points et est suffisamment important pour alimenter la discussion en atelier, plutôt que d'être un simple bruit mineur dans les évaluations.
- Reporter chaque divergence de perception identifiée à la discussion en atelier.
- Utiliser les résultats de la cartographie des parties prenantes pour rendre visibles les rôles des acteurs, leurs dépendances, leur influence et les asymétries d'information avant le début des travaux de refonte20.
- Élaborer un profil des relations entre acteurs comprenant les catégories de parties prenantes, les scores moyens par dimension et les divergences de perception signalées.
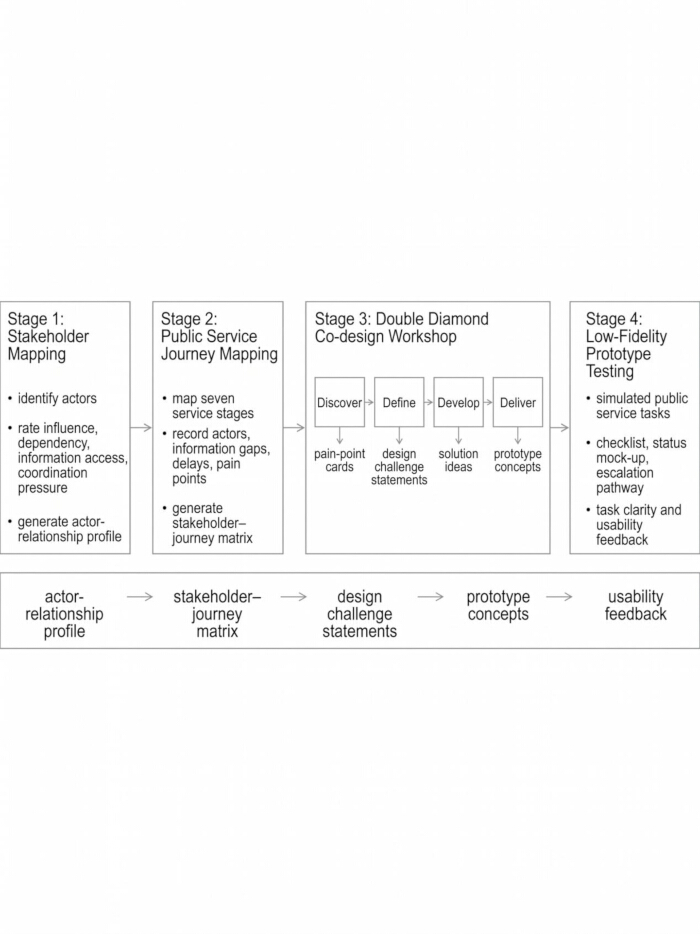
Figure 1 : Flux global du protocole de visualisation de conception de service public. Le flux de travail comprend quatre étapes interconnectées : la cartographie des parties prenantes, la cartographie du parcours de service public, la co-conception selon le modèle Double Diamond, et les tests de prototype. Les livrables comprennent des profils d'acteurs et de relations, des matrices parties prenantes-parcours, des énoncés de défis de conception, des concepts de prototype, ainsi que des retours d'utilisabilité en phase précoce. Les phases Découvrir, Définir, Développer et Livrer du cadre Double Diamond sont mises en évidence afin d'illustrer la transition entre une exploration divergente et un développement convergent de solutions. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
4. Étape 2 : Cartographie du parcours client dans le service public
- Guider le sous-groupe de l'atelier pour cartographier le processus de service en sept étapes.
- Allouer 45 à 60 minutes pour cette étape.
- Demander aux participants d'enregistrer l'acteur principal, les informations d'entrée, les informations de sortie, le canal de communication, le délai typique, le point de friction, la gravité et la conséquence en aval pour chaque étape.
- Demander aux participants d'évaluer la gravité de chaque point de friction selon une échelle à cinq niveaux (1 = gêne mineure ; 5 = défaillance grave susceptible de nuire à l'accès au service, de déclencher une plainte formelle ou de provoquer une escalade majeure).
- ÉTAPE CRITIQUE : regrouper les points de friction uniquement lorsqu'ils concernent la même étape du parcours, impliquent le même type de lacune informationnelle ou d'ambiguïté de responsabilité, et entraînent une conséquence en aval similaire.
- Conserver dans le fichier brut de codage les points de friction signalés par un seul participant. Ne pas hiérarchiser ces points de friction sauf s'ils reçoivent une note de gravité de 4 ou 5.
- Élaborer une matrice intégrée parcours-des-parties-prenantes (Figure 2) afin de visualiser la présence de points de friction (P), de lacunes informationnelles (I), d'ambiguïtés de responsabilité (R) et d'opportunités de refonte (O) dans les différentes cellules de la matrice.
- Utiliser la cartographie du parcours pour localiser les défaillances du service au niveau des points de contact successifs, plutôt que de considérer l'insatisfaction ou les retards comme un résultat unique et agrégé21.
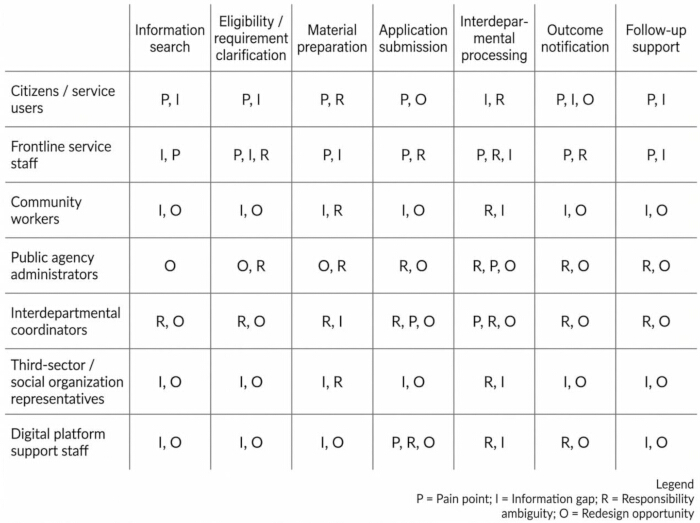
Figure 2 : Matrice intégrée du parcours des parties prenantes pour la visualisation des problèmes de service public. La matrice organise sept étapes du service public sur l'axe horizontal et les principaux groupes de parties prenantes sur l'axe vertical. Chaque cellule indique la présence de problèmes spécifiques liés au service, désignés par les abréviations suivantes : P = point douloureux ; I = lacune informationnelle ; R = ambiguïté de responsabilité ; O = opportunité de refonte. La matrice sert de pont visuel entre la cartographie des parties prenantes et la conception collaborative en reliant les rôles des parties prenantes aux problèmes spécifiques à chaque étape du service. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
5. Étape 3 : Atelier de conception participative en double diamant
- Mener l'atelier de co-conception Double Diamond lors d'une séance de 2,5 à 3 heures.
- Adoptez le cadre Double Diamond pour séparer l'exploration divergente de la prise de décision convergente7,8,14.
- Veiller à ce que les citoyens, les prestataires de première ligne, les administrateurs et les organisations partenaires participent à la création ou à la conception conjointe, plutôt que de s'appuyer uniquement sur une réforme interne dirigée par des experts4,22.
- Exécuter la phase de découverte (30 à 40 min).
- Demander aux participants d'examiner la matrice du parcours des parties prenantes et d'ajouter les cartes des points de friction manquants.
- Veillez à ce que chaque carte de point douloureux valide enregistre l'étape du parcours, l'acteur concerné, la défaillance du service, le manque d'information ou l'ambiguïté concernant les responsabilités, ainsi que la conséquence en aval.
- Exécuter la phase de définition (40 à 50 min).
- Demander à chaque participant de sélectionner en silence les trois cartes de points douloureux qui représentent le mieux les dysfonctionnements de service graves et transversaux aux acteurs.
- Utilisez un vote anonyme par points ou un classement écrit avant la discussion ouverte afin de réduire les effets liés au statut et les déséquilibres de pouvoir.
- Regroupez les cartes sélectionnées selon l'étape du parcours, l'acteur concerné, le manque d'information ou l'ambiguïté de responsabilité, et la conséquence en aval.
- Demander au facilitateur de lire à voix haute chaque groupe et de confirmer que les participants s'entendent sur le fait que les cartes décrivent la même défaillance de service.
- Transformer chaque groupe en un énoncé unique de défi de conception de type « Comment pourrions-nous ».
- Veiller à ce que chaque énoncé de défi de conception précise l'acteur concerné, l'étape problématique du parcours, la défaillance du service et la direction souhaitée d'amélioration.
- Évaluer chaque défi de conception à l’aide d’une grille de quatre critères évaluant la spécificité, la clarté des acteurs, le lien avec les données cartographiées et la faisabilité pour des tests de prototype à faible fidélité.
- Revoir toute affirmation qui omet un acteur, combine plusieurs décompositions non liées, propose prématurément une solution ou ne peut pas être testée à l'aide de matériaux de service simulés.
- Enregistrer le projet initial, la raison de la révision et l'énoncé final validé dans la feuille de vérification.
ATTENTION : Les chercheurs peuvent faire une pause après avoir approuvé les énoncés finaux du défi de conception et reprendre lorsque les cartes de solutions et les feuilles de sélection des prototypes ont été préparées. - Exécuter la phase de développement (50 à 60 min).
- Demander aux participants de formuler des idées d'amélioration des services pour chaque défi de conception et de les noter sur des fiches de solution.
- Exclure les idées nécessitant des données issues de cas réels, des dossiers d'admissibilité individuels, des changements juridiques ou politiques majeurs, ou des fichiers administratifs identifiables.
- Exécuter la phase de livraison (30 à 40 min).
- Demander aux participants d'évaluer chaque idée de solution selon une échelle de cinq points en fonction de l'impact attendu sur le service, de la faisabilité de mise en œuvre, de l'accord des parties prenantes et de l'adéquation au test de tâche simulée.
REMARQUE : Sélectionner les concepts prototypes ayant un score moyen d'au moins 4,0 pour la faisabilité et la testabilité. Ce seuil est nécessaire pour garantir que les prototypes sont viables pour des tests en tâche simulée, sans créer de goulots d'étranglement lors de la mise en œuvre.
6. Étape 4 : Test du prototype de basse fidélité
- Développer des prototypes de faible fidélité pour les concepts prioritaires.
- Préparer trois formats de prototype : une liste de contrôle des exigences du service en une page, une maquette de suivi de l’état du service et un parcours de suivi ou d’escalade.
- ÉTAPE CRITIQUE : Créer deux jeux de tâches appariés avant les tests. S’assurer que les jeux de tâches sont équilibrés en nombre d’étapes de décision, en longueur de lecture, en champs requis, en complexité du scénario et en temps d’achèvement attendu.
- Apparier les jeux de tâches selon le nombre d’étapes de décision, la longueur de lecture, les champs requis, la complexité du scénario et le temps d’achèvement prévu.
- Effectuer un test pilote des jeux de tâches appariés auprès de trois à cinq utilisateurs extérieurs à l’étude.
- Revoir les jeux de tâches si la différence moyenne de temps d’achèvement excède 10 %.
- Soumettre les participants à des tâches simulées de service public afin d’évaluer les prototypes.
- Utiliser, chaque fois que possible, un dispositif contrebalancé ou un groupe témoin afin de distinguer la familiarité avec la tâche de l’exposition au prototype.
- Si tous les participants accomplissent les tâches initiales avant les tâches post-prototype, noter ce point comme un risque potentiel d’effet d’apprentissage dans les sections Protocole, Résultats et Discussion.
- Fournir à chaque participant quatre scénarios de tâches initiales avant l’exposition au prototype.
- Après l’exposition au prototype, fournir quatre scénarios de tâches comparables, mais non identiques.
- Fixer une limite de temps maximale de 5 min par tâche.
- Lire les mêmes instructions de tâche à chaque participant.
- Ne pas donner d’indices pendant l’exécution de la tâche. Limiter les clarifications aux questions d’ordre procédural uniquement.
- Mesurer le temps d’achèvement de chaque tâche en secondes, du moment où la tâche est présentée jusqu’à la réponse finale.
- Considérer la tâche comme incomplète, attribuer un temps d’achèvement de 300 s et coder le succès de la tâche comme 0 si le participant n’achève pas la tâche dans les 5 min.
- Ne coder une tâche comme réussie que si le participant sélectionne la bonne réponse ou accomplit toutes les étapes de décision requises dans le délai imparti.
- Calculer le nombre d’erreurs en comptabilisant les étapes de décision manquées, incorrectes ou superflues.
- Mesurer immédiatement après chaque tâche la clarté perçue par le participant à l’aide d’une échelle à cinq points (1 = très peu clair ; 5 = très clair).
- Une fois toutes les tâches terminées, demander aux participants d’évaluer l’utilisabilité du prototype et leur intention d’adoption.
REMARQUE : L’évaluation des prototypes vise à mesurer la clarté et l’utilisabilité fondées sur des tâches des documents générés par le protocole, et non les améliorations de la performance dans les services publics23.
7. Analyse des données et contrôle de qualité
- Exclure les réponses au questionnaire complétées en moins de 3 min, celles comportant plus de 20 % de valeurs manquantes, des réponses identiques pour tous les items de type échelle de Likert, ou celles contenant des informations incohérentes concernant le rôle.
- Résumer les données du questionnaire à l’aide de moyennes et d’écarts types pour les variables continues, et de fréquences et de pourcentages pour les variables catégorielles.
- Coder les données issues de la cartographie des parties prenantes et du parcours à l’aide de la fiche de codage structurée. Deux chercheurs doivent coder indépendamment au moins 20 % des données avant une discussion de consensus, puis rapporter le pourcentage d’accord et le kappa de Cohen ou une statistique de fiabilité équivalente.
- Analyser les résultats des ateliers en comptabilisant les cartes de points douloureux valides, les regroupements de problèmes, les énoncés de défis de conception, les idées de solutions, les évaluations de faisabilité et les concepts de prototype présélectionnés.
- Calculer le score d’utilisabilité du prototype spécifique au protocole à partir de cinq items notés sur une échelle à cinq points : clarté des exigences, visibilité de l’état d’avancement, clarté des étapes suivantes, facilité d’exécution de la tâche et confiance dans l’utilisation du matériel. Transformer le score brut (allant de 5 à 25) en une échelle de 0 à 100 à l’aide de la formule :
score d’utilisabilité = (score brut - 5) / 20 x 10017 - Analyser les données de test du prototype afin d’extraire des indicateurs de clarté et d’utilisabilité fondés sur les tâches. Utiliser IBM SPSS Statistics (Analyse > Comparer les moyennes > Test t pour échantillons appariés ; Analyse > Tests non paramétriques > Échantillons apparentés ; Analyse > Statistiques descriptives > Tableaux croisés > Statistiques > McNemar) ou les commandes R équivalentes (t.test(..., paired = TRUE), wilcox.test(..., paired = TRUE) et mcnemar.test()) pour exporter la statistique du test, la valeur exacte de P, l’intervalle de confiance à 95 % lorsque disponible, ainsi que la taille de l’effet.
- Interpréter les valeurs de P de manière descriptive en utilisant un alpha prédéfini de 0,05, et insister sur le sens, l’ampleur et la cohérence de l’effet à travers les différents indicateurs24.
- Regrouper les enregistrements répétés des tâches au niveau du participant ou utiliser un modèle approprié pour mesures répétées si quatre tâches par condition sont analysées simultanément.
REMARQUE : Ne pas traiter tous les enregistrements de tâches comme statistiquement indépendants, sauf si cette hypothèse est explicitement justifiée. - ÉTAPE CRITIQUE : Documenter toutes les décisions relatives au nettoyage des données, au codage, à l’appariement des ensembles de tâches et à l’analyse statistique dans une feuille d’audit afin d’assurer la reproductibilité. S’assurer que toutes les données anonymisées sont stockées dans des fichiers protégés par mot de passe, accessibles uniquement aux membres de l’équipe de recherche.
Résultats
Inclusion des participants et faisabilité du protocole
Le protocole a été mis en œuvre avec succès, avec 100 réponses valides au questionnaire (taux de complétion de 89,3 %) et un sous-groupe dédié de 28 participants ayant complété les étapes de l'atelier et des tests de prototype. Les participants retenus représentaient sept catégories d'intervenants impliqués dans le processus de service public : citoyens ou usagers des services (n = 32), personnel d'accueil au premier contact (n = 18), travailleurs communautaires (n = 14), administrateurs d'agences publiques (n = 12), coordinateurs interdépartementaux (n = 8), représentants du secteur tiers (n = 10) et personnel de soutien aux plateformes numériques (n = 6).
Les 28 participants à l'atelier ont été divisés en cinq groupes aux rôles mixtes, chaque groupe comprenant au moins trois catégories d'intervenants. Tous les groupes ont réalisé une cartographie des parties prenantes, une cartographie du parcours, une co-conception selon la méthode Double Diamond et des tests de prototype, produisant des profils d'acteurs et de leurs relations, des matrices parcours-intervenants, des énoncés de défis de conception validés, des concepts de prototype et des enregistrements simulés de tests de tâches (Tableau 3). Les étapes structurées de cartographie ont nécessité moins d'interventions de la part du facilitateur que les phases de définition du problème.
Tableau 3 : Critères d'inclusion des participants, composition des parties prenantes et étapes de mise en œuvre du protocole. Recrutement et inclusion des participants, composition des groupes de parties prenantes, participation aux ateliers, achèvement du protocole et résultats de la mise en œuvre au cours des quatre étapes du protocole. Veuillez cliquer ici pour télécharger ce tableau.
Sorties de visualisation : cartographie des parties prenantes et parcours
L'étape de cartographie des parties prenantes a permis d'identifier neuf catégories d'acteurs, dont sept sont apparues de manière constante dans tous les groupes et ont constitué l'axe vertical de la matrice parcours-parties prenantes. Les administrateurs d'agences publiques ont obtenu les scores moyens d'influence les plus élevés, tandis que les citoyens ont enregistré les scores de dépendance les plus élevés et les scores d'accès à l'information les plus faibles. Neuf écarts de perception, définis comme des différences d'évaluation de deux points ou plus, ont été identifiés. L'écart le plus important concerne l'accès perçu à l'information entre les citoyens et les administrateurs.
L'étape de cartographie du parcours a généré 126 énoncés bruts de points de friction. Après une fusion structurée selon les étapes du parcours et les conséquences en aval, 38 dysfonctionnements uniques ont été retenus, parmi lesquels 12 répondaient aux critères prédéfinis de priorisation (fréquence ≥10 % ou gravité ≥4,0). La majorité des dysfonctionnements prioritaires se sont produits lors de la préparation des documents, de la clarification des critères d'éligibilité et du traitement interdépartemental. Ces résultats ont été synthétisés sous forme de matrice intégrée du parcours des parties prenantes (Figure 2).
Transformation par co-conception et génération de prototypes
Lors de l'atelier de co-conception Double Diamond, les participants ont produit 94 cartes de points douloureux valides, regroupées en 14 domaines problématiques. Sur les 17 énoncés initiaux de défi de conception, six ont dû être révisés car ils manquaient de direction en matière d'amélioration, définissaient l'acteur concerné de manière trop large ou proposaient une solution avant de définir clairement le problème. Après révision fondée sur une grille d'évaluation, 11 énoncés de défi de conception ont été conservés.
Durant la phase de développement, les participants ont généré 32 idées d'amélioration des services. L'application des seuils prédéfinis de faisabilité et de testabilité (scores ≥4,0) a permis de réduire ce nombre à six concepts retenus. Trois concepts de prototype basse fidélité ont été sélectionnés pour des tests basés sur des tâches : une liste de contrôle des exigences de service en une page, un prototype de suivi de l'état du service, et un parcours de remontée défini (Figure 3). Les résultats numériques issus de toutes les étapes de visualisation et de co-conception sont résumés dans le Tableau 4.
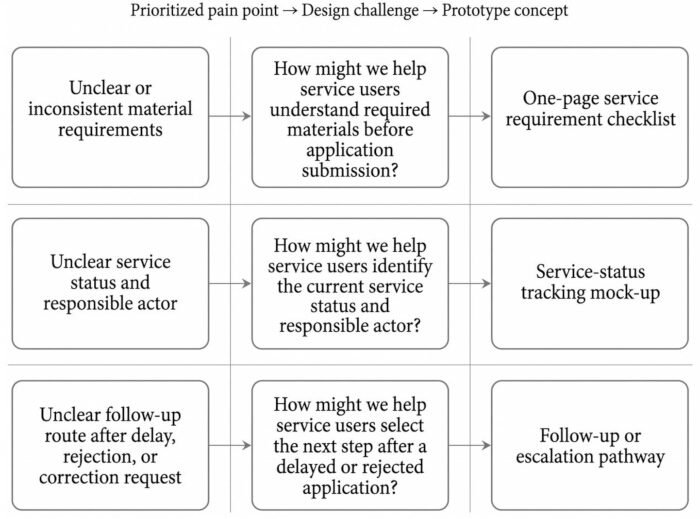
Figure 3 : Voie de transformation des points douloureux en prototypes. Cette figure illustre trois voies de transformation permettant de passer des points douloureux prioritaires à des énoncés de défis de conception et à des concepts de prototype à faible fidélité. Les énoncés de défis de conception sont formulés selon le modèle « Comment pourrions-nous », une méthode collaborative de conception utilisée pour présenter les problèmes comme des opportunités ouvertes de génération de solutions. Les exemples présentés incluent : (1) des exigences en matière de documents peu claires ou incohérentes transformées en une liste de contrôle des exigences du service sur une page ; (2) l'absence de clarté concernant l'état du service et l'acteur responsable transformée en un prototype de suivi de l'état du service ; et (3) l'absence de clarté quant aux démarches à suivre après des retards, des refus ou des demandes de correction transformée en un parcours de suivi ou d'escalade. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau 4 : Résultats produits par le protocole et résultats quantitatifs des tests fondés sur des tâches. Les résultats générés à chaque étape du protocole, ainsi que les résultats quantitatifs issus de l'évaluation simulée du prototype basée sur des tâches, comprennent des indicateurs d'utilisabilité et de performance. Veuillez cliquer ici pour télécharger ce tableau.
Résultats des tests de prototype basés sur des tâches
Le protocole a généré 224 enregistrements de tâches simulées provenant de 28 participants, composés de 112 enregistrements de tâches de référence et de 112 enregistrements post-prototype. Les matériaux générés par le protocole ont été associés à une amélioration des performances lors des tâches simulées. Une analyse appariée a été réalisée au niveau des participants (n = 28) afin de tenir compte des corrélations intra-individuelles lors des tâches répétées. Le temps moyen de réalisation d'une tâche a significativement diminué, passant de 178,4 ± 35,8 s au départ à 121,7 ± 28,4 s après le prototype (différence moyenne = −56,7 s ; IC 95 %, −68,3 – −45,1 s ; dz de Cohen = −1,92 ; test t apparié, P < 0,001). De même, le nombre moyen d'erreurs par participant a diminué de 1,86 ± 0,61 à 0,79 ± 0,44 (différence moyenne = −1,07 erreur ; IC 95 %, −1,27 – −0,87 ; dz de Cohen = −2,05 ; test t apparié, P < 0,001). Les taux de réussite aux tâches ont été analysés à l’aide d’un test de Wilcoxon sur les proportions de réussite par participant, révélant une amélioration significative (Z = −4,12, P < 0,001). Les notes moyennes d’intelligibilité ont également significativement augmenté au niveau des participants, passant de 3,1 ± 0,5 à 4,2 ± 0,4 (différence moyenne = 1,10 point ; IC 95 %, 0,94 à 1,26 ; dz de Cohen = 2,71 ; test t apparié, P < 0,001).
Le taux global de réussite des tâches est passé de 62,5 % (70/112 enregistrements de tâches) au niveau de référence à 82,1 % (92/112 enregistrements de tâches) après l'exposition au prototype, soit une augmentation de 19,6 points de pourcentage (IC à 95 %, de 8,2 à 31,1 points de pourcentage ; comparaison de deux proportions, P = 0,001). Étant donné que les effectifs agrégés indiquent 22 enregistrements de tâches réussies supplémentaires après l'exposition au prototype, tous les tableaux de discordance appariés possibles ont produit un résultat exact de sensibilité de McNemar inférieur à P < 0,01, ce qui confirme la même conclusion directionnelle tout en évitant la reconstruction de paires discordantes individuelles non disponibles.
Les résultats déclarés par les participants étaient cohérents avec ces constatations opérationnelles. Les notes moyennes de clarté sont passées de 3,1 ± 0,7 à 4,2 ± 0,5 sur l'échelle à cinq points (n = 112 enregistrements de tâches par condition ; différence moyenne = 1,10 point ; IC à 95 %, 0,94 à 1,26 ; différence moyenne standardisée au niveau résumé = 1,81 ; P au niveau résumé < 0,001). Les matériaux finaux ont obtenu un score d'utilisabilité spécifique au protocole de 78,4 ± 9,6 et une note d'intention d'adoption de 4,1 ± 0,6 (Figure 4). Ces scores d'utilisabilité ont été calculés à partir des cinq items spécifiques à l'étude plutôt qu'à partir de l'échelle standardisée d'utilisabilité du système (SUS). Les commentaires libres confirment ces résultats : 21 des 28 participants ont signalé une amélioration de la clarté visuelle de la matrice du parcours des parties prenantes, 17 des 28 ont indiqué des rôles d'acteurs plus clairs, 19 des 28 ont mentionné des étapes de service plus claires, et 20 des 28 ont confirmé l'utilisabilité pratique des matériaux du prototype.
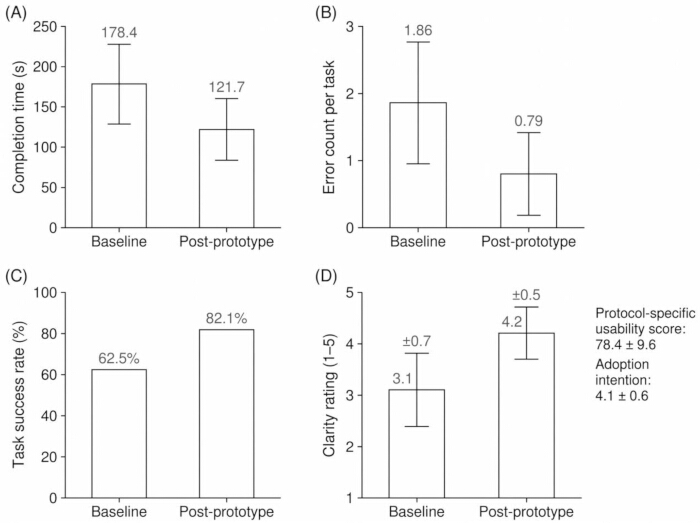
Figure 4 : Résultats liés à la clarté et à l'utilisabilité fondés sur les tâches après exposition au prototype. (A) Temps moyen d'achèvement de la tâche (s). (B) Nombre moyen d'erreurs par tâche. (C) Taux de réussite des tâches (%). (D) Clarté évaluée par les participants (échelle de 1 à 5). Les métriques supplémentaires dans le panneau (D) incluent le score d'utilisabilité spécifique au protocole et l'intention d'adoption. Les barres représentent les moyennes au niveau des participants, et les barres d'erreur indiquent l'écart-type (SD). Les comparaisons entre les conditions de référence et post-prototype ont été effectuées au niveau des participants et étaient statistiquement significatives (P < 0,001) pour le temps d'achèvement, le nombre d'erreurs, la clarté et le taux de réussite des tâches. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Discussion
Ce protocole fournit une méthode systématique et reproductible pour structurer des problèmes complexes dans des environnements de service public à faible risque. En intégrant successivement la cartographie des parties prenantes, la cartographie des parcours, la co-conception selon la méthode Double Diamond et les tests de prototypes à faible fidélité, cette méthode transforme des plaintes fragmentées provenant de multiples acteurs en interventions de service testables, tout en maintenant une distinction claire entre les preuves d'utilisabilité simulées et la performance administrative réelle. Les résultats représentatifs montrent que les difficultés rencontrées dans les services publics ne sont que rarement isolées à une seule étape procédurale ; elles sont plutôt réparties entre les usagers, le personnel de première ligne et les administrateurs des services centraux. Une contribution essentielle de ce protocole réside dans sa capacité à rendre visibles les dépendances entre multiples acteurs et les asymétries d'information avant même le début du développement de solutions.
Un élément central de ce protocole est la matrice du parcours des parties prenantes. Dans les services publics impliquant plusieurs acteurs, les parties prenantes ont fréquemment des interprétations différentes quant à l'origine des défaillances du service. La matrice fonctionne comme un objet-frontière, un artefact concret qui peut s'adapter à différentes limites conceptuelles tout en conservant une identité commune parmi les groupes de participants, facilitant ainsi un consensus interfonctionnel et une conception collaborative25,26. En traduisant l'insatisfaction diffuse des utilisateurs en événements observables et spécifiques à chaque étape, la matrice réduit le risque d'une formulation floue des problèmes et aide à empêcher les participants aux ateliers de recourir par défaut à des ajustements administratifs familiers mais inefficaces.
L'application structurée du cadre Double Diamond favorise une transition maîtrisée de l'exploration du problème à la refonte concrète du service. Les résultats indiquent que le passage de doléances générales à des défis de conception précis du type « Comment pourrions-nous » constitue souvent la phase la plus exigeante du processus, nécessitant une animation active, des critères de sélection explicites et des révisions documentées. En l'absence de contraintes structurelles (spécifiant l'acteur concerné, l'étape du parcours, la défaillance du service et l'amélioration souhaitée), les séances de co-conception risquent de produire des solutions génériques qui ne traitent pas les défaillances de service identifiées. Le lien direct entre un point douloureux prioritaire (par exemple, des exigences en matière de documents peu claires) et son prototype correspondant (par exemple, une liste de contrôle sur une page) illustre la validité générative du protocole.
Il est important de distinguer les résultats issus des tests de prototypes fondés sur des tâches, générés par ce protocole, des affirmations concernant une amélioration organisationnelle réelle. Les réductions observées du temps d'achèvement des tâches et des taux d'erreur indiquent que les supports conçus conjointement sont clairs et utilisables dans des conditions simulées. Toutefois, la phase précoce de prototypage dans le secteur public vise principalement à favoriser l'apprentissage et à atténuer les risques avant la mise en œuvre16,27. La séquence fixe de tests avant/après utilisée dans l'application représentative pourrait également introduire une familiarité avec la tâche ou des effets d'apprentissage, car les participants ont accompli les tâches de référence avant les tâches post-prototype. Les mises en œuvre futures devraient utiliser des ordres de tâches contrebalancés, des groupes témoins appariés ou des modèles à mesures répétées afin de distinguer les effets du prototype des effets d'apprentissage.
Le dépannage des échecs courants de protocole est essentiel pour la reproductibilité. Si la cartographie des parties prenantes ne produit que des libellés génériques d'acteurs, les facilitateurs doivent demander aux participants de préciser la décision, l'information ou la dépendance en matière de coordination associée à chaque acteur. Si les parcours se transforment en listes de plaintes, les facilitateurs doivent rattacher chaque carte à une étape spécifique du parcours, à l'acteur concerné, à une lacune informationnelle et à une conséquence en aval.
Une modification du protocole est attendue lorsque le flux de travail est transféré à différents environnements de services publics. Pour les services administratifs universitaires, les intitulés des étapes peuvent mettre l'accent sur l'inscription, les recours et les processus d'accompagnement. Pour la refonte des parcours ambulatoires en santé, les garanties éthiques et les approbations de gouvernance clinique devraient être élargies. Pour la coordination des services sociaux, les exigences inter-organismes en matière de protection des données peuvent nécessiter des mesures de désidentification et de contrôle des références plus strictes. Les différences culturelles, administratives et gouvernementales peuvent également influencer la liberté avec laquelle les participants critiquent les procédures, la répartition de l'autorité au sein des groupes mixtes, ainsi que la nécessité d'un vote anonyme ou d'une cartographie distincte entre utilisateurs et prestataires.
Plusieurs limites doivent être prises en compte lors de l'application de cette méthode. Premièrement, le protocole est conçu spécifiquement pour des services consultatifs et administratifs à faible risque. Son application à des environnements à enjeux élevés, tels que les interventions médicales ou les décisions juridiques, nécessiterait des mesures de protection éthique, une expertise spécifique au domaine et des protocoles de protection des données considérablement renforcés. Deuxièmement, bien que la séparation des groupes d'utilisateurs et de prestataires lors de la phase initiale de cartographie puisse réduire la suppression des retours négatifs, des déséquilibres de pouvoir inhérents pourraient encore influencer la dynamique collaborative durant la synthèse à rôles mixtes. Troisièmement, la réussite de la phase Définir dépend de l'expertise du facilitateur. Par conséquent, des groupes de recherche indépendants devraient utiliser une formation normalisée des facilitateurs, des exercices d'étalonnage, des listes de contrôle d'observation et des débriefings post-séance avant de comparer les résultats dans différents contextes.
En conclusion, ce protocole de visualisation systématique offre une approche structurée et éthiquement encadrée pour diagnostiquer et concevoir des solutions à des problèmes complexes de service public. Il fait progresser l'innovation dans le service public au-delà des discussions politiques abstraites en fournissant un ensemble d'outils reproductible qui fait le lien entre la réforme menée par des experts et la conception centrée sur l'utilisateur. De futures recherches devraient appliquer ce protocole à d'autres domaines du service public, notamment les services numériques municipaux, les services administratifs universitaires, le soutien à l'éducation, la refonte des parcours ambulatoires en santé et la coordination des prestations sociales. De futures études devraient également évaluer la performance des prototypes élaborés lors d'ateliers contrôlés après leur mise en œuvre dans les flux de travail administratifs courants.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun intérêt concurrentiel.
Remerciements
Les auteurs remercient tous les participants, y compris les citoyens, le personnel des services de première ligne et les administrateurs d'agences publiques, pour leur participation aux questionnaires, aux ateliers de co-conception et aux séances de test de prototypes. Leurs contributions et leurs observations sur les expériences de services publics impliquant plusieurs acteurs ont soutenu l'élaboration de ce protocole systématique de visualisation de la conception de services.
Les auteurs tiennent également à remercier le soutien institutionnel et académique fourni par la Faculté de l'innovation et du design de l'Université municipale de Macao, la Faculté des arts et du design de l'Université de Shenzhen, ainsi que la Faculté des arts et du design de l'Université Guangdong Baiyun. Cette recherche n'a reçu aucune subvention spécifique d'un organisme de financement public, commercial ou à but non lucratif.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Notes sur la syntaxe ou le flux de travail d'analyse | Équipe de recherche | PSD-VP-S17 v1.1 | Documenter le flux de travail SPSS ou équivalent en R pour les comparaisons appariées, les tests de Wilcoxon, les vérifications de sensibilité de McNemar, les tailles d'effet, les intervalles de confiance et la production de rapports. |
| Questionnaire anonyme basé sur les rôles | Équipe de recherche | PSD-VP-S02 v1.1 | Recueillir des informations sur les rôles des parties prenantes et leurs perceptions initiales du processus de service public sélectionné. |
| Liste de contrôle de désidentification | Équipe de recherche | PSD-VP-S14 v1.1 | S'assurer que les noms des participants, numéros d'identification, adresses, identifiants de dossier et documents administratifs ne sont ni collectés ni divulgués. |
| Modèle de défi de conception | Équipe de recherche | PSD-VP-S07 v1.1 | Transformer les points douloureux regroupés en énoncés structurés et testables du type « Comment pourrions-nous ». |
| Grille de calibration des animateurs | Équipe de recherche | PSD-VP-S15 v1.1 | Standardiser la préparation des animateurs, le codage des exemples, la révision des énoncés de défi et la cohérence entre animateurs. |
| Fiche d'évaluation des parties prenantes sur cinq points | Équipe de recherche | PSD-VP-S04 v1.1 | Évaluer l'influence de chaque partie prenante, sa dépendance, son accès à l'information et la pression en matière de coordination. |
| IBM SPSS Statistics | IBM Corporation | Version 26.0 ou ultérieure | Réaliser des analyses descriptives, des tests t appariés, des tests de Wilcoxon signés et des tests de McNemar pour les résultats des tests de prototype. |
| Matériaux de prototype basse fidélité | Équipe de recherche | PSD-VP-S10 v1.1 | Développer et tester des matériaux de service en phase initiale, incluant une liste de contrôle des exigences, une maquette du statut du service et un parcours de suivi. |
| Microsoft Excel | Microsoft Corporation | Microsoft 365 ou équivalent | Organiser les données des questionnaires, calculer des statistiques descriptives, gérer les fiches de codage et préparer des tableaux récapitulatifs. |
| Cartes des points douloureux | Équipe de recherche | PSD-VP-S06 v1.1 | Enregistrer les dysfonctionnements du service, les lacunes informationnelles, l'ambiguïté des responsabilités, les acteurs concernés et les conséquences en aval. |
| Fiche d'information pour les participants | Équipe de recherche | PSD-VP-S01 v1.1 | Expliquer l'objectif de l'étude, les procédures, les droits des participants et les exigences de consentement avant la participation. |
| Stockage sécurisé des données avec mot de passe | Système informatique institutionnel ou de l'équipe de recherche | Accès restreint à l'équipe de recherche | Stocker de manière sécurisée les données des questionnaires désidentifiées, les résultats des ateliers, les fichiers de codage et les enregistrements des tests de tâches. |
| Grille d'évaluation des prototypes | Équipe de recherche | PSD-VP-S12 v1.1 | Évaluer la clarté du prototype, son ergonomie, la réussite des tâches, le nombre d'erreurs et l'intention d'adoption. |
| Fiche de sélection des prototypes | Équipe de recherche | PSD-VP-S09 v1.1 | Sélectionner les concepts de prototype qui répondent à des seuils prédéfinis de faisabilité et de testabilité. |
| Modèle de cartographie du parcours de service public | Équipe de recherche | PSD-VP-S05 v1.1 | Cartographier le processus de service public à travers la recherche d'information, la clarification des exigences, la préparation des documents, la soumission, le traitement, la notification et le soutien de suivi. |
| Fiches de tâches simulées | Équipe de recherche | PSD-VP-S11 v1.1 | Évaluer l'achèvement des tâches, l'exactitude des décisions et la clarté avant et après l'exposition au prototype. |
| Cartes des solutions | Équipe de recherche | PSD-VP-S08 v1.1 | Documenter les idées d'amélioration du service générées lors de l'atelier de co-conception Double Diamond. |
| Fiche de cartographie des parties prenantes | Équipe de recherche | PSD-VP-S03 v1.1 | Identifier 5 à 8 acteurs impliqués dans le processus de service public et visualiser les rôles et les dépendances entre acteurs. |
| Fiche de codage structurée | Équipe de recherche | PSD-VP-S13 v1.1 | Coder les données de cartographie des parties prenantes, les résultats de la cartographie des parcours, les regroupements de points douloureux et les résultats des ateliers. |
| Liste de contrôle d'équivalence des ensembles de tâches | Équipe de recherche | PSD-VP-S16 v1.1 | Documenter l'appariement des tâches de base et post-prototype selon les étapes de décision, la longueur de lecture, les champs requis, la complexité et le temps de réalisation lors du test pilote. |
Références
- Rittel HWJ, Webber MM. Dilemmas in a general theory of planning. Policy Sci. 1973;4(2):155-69.
- Suoheimo M, Vasques R, Rytilahti P. Deep diving into service design problems: Visualizing the iceberg model of design problems through a literature review on the relation and role of service design with wicked problems. Des J. 2021;24(2):231-51.
- Voorberg WH, Bekkers V, Tummers LG. A systematic review of co-creation and co-production: Embarking on the social innovation journey. Public Manag Rev. 2015;17(9):1333-57.
- Schwoerer K, Keppeler F, Mussagulova A, Puello S. CO-DESIGN-ing a more context-based, pluralistic, and participatory future for public administration. Public Adm. 2022;100(1):72-97.
- Edelmann N, Mergel I. Co-production of digital public services in Austrian public administrations. Adm Sci. 2021;11(1):https://doi.org/10.3390/admsci11010022
- Blomkamp E. Systemic design practice for participatory policymaking. Policy Des Pract. 2022;5(1):12-31.
- Vargas C, et al. Exploring co-design: A systematic review of concepts, processes, models, and frameworks used in public health research. J Public Health. 2025;47(4):https://doi.org/10.1093/pubmed/fdaf084
- Wacnik P, Daly SR, Verma A. Participatory design: A systematic review and insights for future practice. Des Sci. 2025;11:https://doi.org/10.1017/dsj.2025.10009
- Udoewa V. An introduction to radical participatory design: Decolonising participatory design processes. Des Sci. 2022;8:https://doi.org/10.1017/dsj.2022.24
- Stickdorn M, Schneider J. This is service design thinking: Basics, tools, cases. BIS Publishers; Amsterdam; 2011. https://www.wiley.com/en-us/This+is+Service+Design+Thinking%3A+Basics%2C+Tools%2C+Cases-p-9781118156308
- Blomkamp E. The promise of co-design for public policy. Aust J Public Adm. 2018;77(4):729-43.
- Bryson JM. What to do when stakeholders matter: Stakeholder identification and analysis techniques. Public Manag Rev. 2004;6(1):21-53.
- Folstad A, Kvale K. Customer journeys: A systematic literature review. J Serv Theory Pract. 2018;28(2):196-227.
- Design C. Eleven lessons: Managing design in eleven global brands. Design Council; London; 2007. https://www.idi-design.ie/content/files/ElevenLessons_Design_Council_2.pdf
- Steen M, Manschot M, De Koning N. Benefits of co-design in service design projects. Int J Des. 2011;5(2):53-60.
- Not E, et al. Designing a digital environment to support the co-production of public services: Balancing multiple requirements and governance concepts. Digit Gov: Res Pract. 2024;5(3):https://doi.org/10.1145/3603632
- Excellence UGCfPS. Design thinking for public service excellence. UNDP Global Centre for Public Service Excellence; Singapore; 2014. https://www.undp.org/publications/designthinking-public-service-excellence
- Osborne SP. The new public governance? Public Manag Rev. 2006;8(3):377-87.
- Hartley J. Innovation in governance and public services: Past and present. Public Money Manage. 2005;25(1):27-34.
- Freeman RE. Strategic management: A stakeholder approach. Pitman; Boston; 1984.
- Stickdorn M, Hormess ME, Lawrence A, Schneider J. This is service design doing: Applying service design thinking in the real world. O'Reilly Media; Sebastopol; 2018. https://www.thisisservicedesigndoing.com/
- Bovaird T. Beyond engagement and participation: User and community coproduction of public services. Public Adm Rev. 2007;67(5):846-60.
- Donetto S, Pierri P, Tsianakas V, Robert G. Experience-based co-design and healthcare improvement: Realizing participatory design in the public sector. Des J. 2015;18(2):227-48.
- Tomczak M, Tomczak E. The need to report effect size estimates revisited: An overview of some recommended measures of effect size. Trends Sport Sci. 2014;21(1):19-25.
- Sanders EBN, Stappers PJ. Co-creation and the new landscapes of design. CoDesign. 2008;4(1):5-18.
- Star SL, Griesemer JR. Institutional ecology, 'translations' and boundary objects: Amateurs and professionals in Berkeley's Museum of Vertebrate Zoology, 1907-39. Soc Stud Sci. 1989;19(3):387-420.
- Liedtka J. Why design thinking works. Harv Bus Rev. 2018;96(5):72-9.