Cette étude présente un cadre de collaboration cyber-physique pour l'industrie 5.0 assisté par une IA explicative, utilisant un CNN-transformer et SHAP pour la détection d'anomalies acoustiques industrielles sur le jeu de données MIMII. L'intégration du calcul en périphérie permet une maintenance prédictive interprétable et centrée sur l'humain.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Collaboration cyber-physique soutenue par l'IA explicable pour une fabrication durable dans l'Industrie 5.0
Dans cet article
Résumé
Résumé
Dans cette étude, nous présentons une approche innovante de fabrication durable de pièces industrielles, utilisant un système de collaboration cyber-physique basé sur une intelligence artificielle explicative (XAI) pour l'industrie 5.0. Les systèmes cyber-physiques humains (CPHS) actuels intègrent l'intelligence artificielle de manière limitée et manquent souvent d'explicabilité. Par conséquent, il est nécessaire d'améliorer leur évolutivité et leur flexibilité, conformément aux principes de l'industrie 5.0 : résilience, viabilité à long terme et centrage sur l'humain. Pour remédier à ces lacunes, nous proposons une architecture intégrant l'apprentissage profond et l'intelligence artificielle explicative dans l'écosystème des systèmes cyber-physiques (CPS), afin de permettre une prise de décision intelligente et explicite. Plus précisément, nous utilisons le jeu de données Malfunctioning Industrial Machine Investigation and Inspection (MIMII) pour la détection de défauts de machines à partir de signaux acoustiques. Les signaux audio subissent une transformation spectrale afin de générer des images de spectrogrammes, qui sont ensuite traitées par un réseau neuronal convolutif (CNN) pour l'extraction de caractéristiques spatiales et par un encodeur de type transformeur pour les caractéristiques temporelles. Afin d'améliorer la transparence et de faciliter la coopération humaine en boucle, l'approche fondée sur les explications additives de Shapley (SHAP) aide les opérateurs à comprendre le processus de prise de décision du système en mettant en évidence les caractéristiques d'entrée influençant les prédictions du modèle. En outre, le cadre est appliqué dans un système cyber-physique basé sur le calcul en périphérie (edge computing) afin d'obtenir une faible latence et une faible consommation d'énergie tout en fournissant des réponses en temps opportun, contribuant ainsi à assurer un environnement de production durable. Les résultats expérimentaux montrent que l'architecture CNN-Transformeur proposée atteint une précision de 98,5 % et surpasse les systèmes CPHS existants tout en maintenant une latence faible. L'utilisation de l'intelligence artificielle explicative dans un tel système de coopération cyber-physique augmente considérablement la confiance des opérateurs et permet une collaboration fluide entre l'humain et la machine.
Introduction
La transition du modèle Industrie 4.0, qui mettait l'accent sur la technologie, la mécanisation et la communication, vers le nouveau modèle Industrie 5.0, combinant progrès technologique, adaptabilité, développement durable et centrage sur l'humain, a influencé l'évolution dynamique des systèmes industriels.1,2La Commission européenne définit l'industrie 5.0 comme un paradigme axé non seulement sur la productivité et l'efficacité, mais aussi sur trois piliers que sont l'orientation humaine, la durabilité et la résilience. Il est important de noter que des recherches récentes ont mis en évidence le rôle des systèmes d'intelligence artificielle, de la coopération homme-machine et de la fabrication durable comme principaux moteurs des environnements de l'industrie 5.0.3,4. Les méthodes traditionnelles de maintenance ne sont plus suffisantes dans cet environnement industriel en évolution. Pour assurer la résilience dans des contextes complexes et instables, la maintenance doit évoluer vers une forme plus adaptable et systémique.5Depuis 2011, l'industrie 4.0 constitue le modèle dominant de transformation industrielle en Europe, encourageant la transformation numérique des entreprises afin d'améliorer leurs opérations et d'optimiser les ressources disponibles.4. Il est donc impératif d'augmenter l'efficacité sans éliminer la main-d'œuvre humaine dans la production, tout en protégeant la santé et la sécurité des travailleurs. C'est pourquoi les entreprises et les milieux académiques ont commencé à définir les principes du paradigme de l'industrie 5.0.5,6,7, en partie motivé par la notion japonaise de Société 5.08,9,10,11. Malgré l'accent accru mis récemment sur la maintenance durable dans la littérature, la plupart des évaluations systématiques existantes restent fragmentées ou spécifiques à un domaine, faute de cadre global intégrant la résilience, la durabilité et l'intelligence artificielle. Par exemple, certains auteurs examinent les pratiques de maintenance durable pour des systèmes ou des stratégies spécifiques, notamment la maintenance productive totale durable (STPM), tandis que d'autres chercheurs abordent l'intégration de thématiques de durabilité dans les techniques de maintenance.12,13,14. Auteur ont mené une évaluation complète des critères d'adoption de la durabilité et ont mis en évidence les facteurs technologiques permettant à la fabrication industrielle d'avoir un impact durable positif15. Néanmoins, dans le cadre du paradigme de l'Industrie 5.0, la durabilité, la résilience et la prise de décision fondée sur l'intelligence artificielle ne sont intégrées de manière complète dans aucun de ces travaux. En conséquence, les approches de maintenance abordent fréquemment la durabilité de manière séparée. La méthode SHAP se distingue parmi les autres techniques d'intelligence artificielle explicative (XAI) en raison de sa méthode d'attribution des caractéristiques théoriquement solide.16,17,18.
La prise de décision fondée sur les données est rendue possible par l'intelligence artificielle, mais des modèles précis nécessitent souvent de grandes quantités de données. Les techniques classiques d'apprentissage automatique (ML), telles que les arbres de décision, la régression logistique et la régression linéaire, donnent fréquemment de mauvais résultats dans des situations fortement non linéaires, car elles supposent des distributions de données relativement simples19. En apprenant des représentations complexes de caractéristiques à partir de vastes ensembles de données, les réseaux neuronaux profonds (DNN) contournent ces limitations20. Selon des études, les réseaux plus profonds offrent souvent de meilleures performances que les structures peu profondes dans les tâches complexes de prise de décision21, mais leur profondeur accrue et la complexité de leurs paramètres rendent le modèle moins interprétable22.
Un système cyber-physique (SCP) est une technologie essentielle pour la fabrication de l'industrie 5.0, car il associe intelligence distribuée, ordinateurs embarqués, processus physiques et communication. Pour permettre des opérations industrielles flexibles, intelligentes et en temps réel, les SCP modernes intègrent rapidement l'informatique en périphérie, l'intelligence artificielle en périphérie et l'Internet des objets vert (G-IoT)23,24. La durabilité et la résilience ont été mises en avant dans des études récentes sur la maintenance 4.0 et la maintenance intelligente. Bien que des travaux antérieurs aient examiné l'importance des technologies de maintenance 4.0 dans la fabrication durable et proposé des cadres de modélisation pour une maintenance durable, des études bibliométriques et systématiques ont évalué les technologies de maintenance intelligente25,26,27,28. D'autres recherches ont étudié l'intégration de la maintenance durable dans les environnements de l'industrie 4.0 et les systèmes de production orientés vers la durabilité29,30,31,32. Le concept d'opérateur 4.033, les cadres humains-centrés de l'industrie 5.034 et les perspectives socio-économiques35 ont tous suscité un intérêt considérable pour la maintenance centrée sur l'humain. De plus, les progrès réalisés en matière de maintenance numérique36, de maintenance prédictive et prescriptive37,38 et de stratégies de maintenance durable39,40 ont été soulignés dans des études récentes. Malgré ces avancées, les recherches restent dispersées, et peu d'études proposent un paradigme cohérent intégrant l'intelligence artificielle explicative, la durabilité, la résilience et la coopération cyber-physique centrée sur l'humain. Les systèmes cyber-physiques (SCP) n'ont pas encore atteint une autonomie complète malgré leur déploiement croissant, et le paradigme de l'industrie 5.0 ne le favorise pas. L'industrie 5.0, en revanche, met davantage l'accent sur la supervision humaine, la coopération et la prise de décision. En intégrant la pensée humaine et la coopération aux processus cyber-physiques, des systèmes cyber-humains tels que les SCP avec humain en boucle (HiLCPS)41, les SCP centrés sur l'humain (HCPS)42,43 et les systèmes cyber-physiques humains (CPHS)44 étendent les SCP traditionnels. Cette intégration améliore l'adaptabilité, la transparence, la sécurité et la résilience en permettant une collaboration en temps réel entre les systèmes intelligents et les opérateurs humains45,46.
La détection industrielle des anomalies audio a été grandement améliorée grâce à de nouvelles architectures, notamment le Vision Transformer (ViT), l'Audio Spectrogram Transformer (AST), le Conformer et l'apprentissage auto-supervisé ; toutefois, leur intégration dans des systèmes cyber-physiques explicables pour l'industrie 5.0 reste limitée. En l'absence d'une intégration de l'explicabilité, du déploiement en périphérie (edge) et d'un soutien décisionnel avec intervention humaine dans une même architecture, les recherches actuelles se concentrent principalement sur la précision de classification ou sur l'interprétabilité a posteriori fondée sur l'IA explicable (XAI). Cette étude propose une nouvelle architecture cyber-physique collaborative CNN-Transformeur activée par une IA explicable, combinant informatique en périphérie, modélisation des dépendances temporelles, explicabilité basée sur SHAP, apprentissage des caractéristiques spatiales et soutien décisionnel centré sur l'humain, afin de permettre une fabrication durable dans le cadre de l'industrie 5.0 et de surmonter ces limitations.
Il existe donc un déficit de recherche important. Les techniques actuelles de détection acoustique d'anomalies basées sur des CNN ou des Transformers privilégient la performance de classification, mais manquent de coopération cyber-physique et d'explicabilité. Bien que les cadres de l'Industrie 5.0 proposent des modèles centrés sur l'humain, ils ne parviennent pas à intégrer l'apprentissage profond explicatif, l'intelligence de périphérie et la prise de décision assistée par l'opérateur au sein d'un système unique. Les techniques de maintenance prédictive fondées sur l'IA explicable (XAI) améliorent la transparence, mais fonctionnent indépendamment des architectures CPHS. Par conséquent, un système cyber-physique humain unique, conforme à l'Industrie 5.0 et intégrant une détection auditive précise des anomalies, une explicabilité basée sur SHAP, un déploiement compatible avec l'informatique en périphérie et une coopération avec l'humain en boucle, fait encore défaut.
Cet article propose un nouveau paradigme de collaboration cyber-physique reposant sur une IA explicable combinant un réseau de neurones convolutifs (CNN) et un modèle de type Transformer, destiné à l'Industrie 5.0 afin de surmonter ces contraintes. L'architecture proposée intègre dans un seul cadre de système cyber-physique (CPHS) le déploiement informatique en périphérie, l'extraction des caractéristiques spatiales basée sur les CNN, l'apprentissage des dépendances temporelles fondé sur les Transformers, l'explicabilité basée sur SHAP et un soutien aux décisions incluant l'intervention humaine. Contrairement aux méthodes actuelles qui traitent ces éléments de manière indépendante, le cadre proposé offre une solution intégrée permettant d'améliorer simultanément les performances de détection des anomalies, la transparence du modèle, l'efficacité opérationnelle et la collaboration centrée sur l'humain pour une fabrication durable.
L'objectif principal de cette étude est de concevoir un système cyber-physique humain (CPHS) doté d'une intelligence artificielle explicative pour une fabrication durable de l'industrie 5.0, en combinant une approche d'explicabilité fondée sur SHAP, le calcul en périphérie (edge computing), un soutien aux décisions incluant l'humain en boucle, et une méthode hybride de détection d'anomalies acoustiques basée sur un réseau de neurones convolutifs (CNN) et des Transformers. En particulier, le cadre proposé vise à améliorer la précision de la détection d'anomalies tout en fournissant des prévisions claires et compréhensibles, à faciliter un déploiement efficace en périphérie et à encourager une prise de décision coopérative entre les systèmes intelligents et les opérateurs humains. En atteignant simultanément des performances élevées en matière de détection, une bonne explicabilité, un fonctionnement à faible latence et une collaboration cyber-physique centrée sur l'humain, cette architecture intégrée remédie aux insuffisances des cadres actuels de détection d'anomalies acoustiques, de maintenance prédictive basée sur l'IA explicable (XAI) et des systèmes CPHS.
L'architecture proposée présente un système cyber-physique humain unifié doté d'une intelligence artificielle explicative (CPHS) pour l'industrie 5.0, contrairement aux techniques actuelles de détection d'anomalies acoustiques, qui se concentrent principalement sur la précision de la classification. Elle intègre au sein d'une même architecture l'extraction spatiale de caractéristiques basée sur les CNN, la modélisation temporelle fondée sur les Transformers, l'explicabilité basée sur SHAP, l'informatique en périphérie (edge computing) et une assistance à la décision incluant l'opérateur humain. L'architecture proposée répond aux enjeux clés de transparence, d'assistance aux opérateurs et de coopération cyber-physique en combinant une détection précise des anomalies, une prise de décision compréhensible et un déploiement en temps réel sur des dispositifs périphériques. La principale contribution scientifique de ce travail réside dans l'intégration au niveau système, ce qui distingue clairement l'approche proposée des recherches antérieures axées uniquement sur la détection d'anomalies, l'intelligence artificielle explicative ou les cadres de l'industrie 5.0.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
La méthodologie proposée utilise une approche systémique de type système cyber-physique humain (CPHS) propre à l'Industrie 5.0, combinant un apprentissage profond explicatif et un cadre de collaboration cyber-physique rendu possible par l'informatique en périphérie, afin de soutenir les processus de fabrication durables. Premièrement, le problème est abordé en reconnaissant certaines limites des solutions CPHS actuelles, telles qu'un manque d'intelligence alimentée par l'intelligence artificielle, d'explicabilité et de collaboration centrée sur l'humain. Pour relever ces défis, la solution proposée s'appuie sur le jeu de données MIMII pour la surveillance de l'état des machines industrielles à l'aide du traitement des signaux acoustiques.
Le cadre proposé commence par l'entrée des spectrogrammes générés dans un modèle de CNN qui extrait des caractéristiques spatiales en reconnaissant des motifs fréquentiels significatifs associés à différents états de la machine. Les caractéristiques spatiales extraites seront converties en séquences puis transmises à un module encodeur de type transformeur afin de capturer les dépendances temporelles par auto-attention. La représentation des caractéristiques transformée est ensuite transmise à un module classificateur entièrement connecté pour classer les états de la machine comme normaux ou anormaux. De plus, afin d'assurer la transparence et de faciliter une prise de décision centrée sur l'humain, l'approche explicative SHAP est utilisée pour expliquer les prédictions en sélectionnant les régions temps-fréquence significatives dans la sortie du modèle. Le modèle conçu sera implémenté dans un environnement CPS doté de capacités de calcul en périphérie, permettant une inférence en temps réel avec une faible latence computationnelle et une consommation d'énergie réduite. En outre, un schéma incluant l'humain dans la boucle sera intégré afin de permettre aux opérateurs humains de valider les résultats à l'aide des informations explicatives. Les performances sont validées à l'aide de l'exactitude, de la précision, du rappel et du score F1, ainsi que d'autres métriques au niveau du système telles que la latence et l'efficacité énergétique.
Le cadre proposé est un mécanisme CPHS piloté par l'IA explicable (XAI) pour une fabrication durable dans le contexte de l'industrie 5.0, et son flux de travail est présenté sous forme de pipeline allant de l'acquisition des données à la prise de décision et à l'exécution intelligentes, comme illustré dans la Figure 1. Dans la phase initiale du processus d'acquisition des données, des signaux sonores sont collectés à partir de machines dans des industries telles que les moteurs, les pompes et les roulements, à l'aide de jeux de données incluant MIMII. Les signaux de données ainsi obtenus sont transmis à l'étape suivante, appelée prétraitement des données, où ils subissent un filtrage, une normalisation et une segmentation. Les signaux de données segmentés sont finalement convertis en spectrogramme à l'aide de la transformée de Fourier à court terme (STFT) au niveau de la couche de représentation des caractéristiques.
Ensuite, la couche du modèle d'intelligence artificielle utilise les images de spectrogramme pour extraire des caractéristiques au moyen du module CNN, identifiant ainsi les motifs spatiaux et les anomalies. Puis, les caractéristiques extraites sont remodelées et transmises à l'encodeur de transformeur, qui apprend les dépendances temporelles et les relations à longue portée grâce à des mécanismes d'auto-attention. Les vecteurs de caractéristiques obtenus sont classés comme normaux ou anormaux à l’aide de la couche de classification. Afin d’assurer la transparence du processus de prédiction, la couche d’explicabilité utilise SHAP pour mettre en évidence les régions temps-fréquence significatives dans le spectrogramme.
En outre, un processus impliquant l'intervention humaine est mis en œuvre, dans lequel des opérateurs interprètent les résultats du modèle et fournissent un retour. Dans la couche de déploiement, le modèle s'exécute sur une infrastructure CPHS basée sur l'informatique en périphérie, garantissant une inférence rapide et une faible consommation d'énergie, tout en pouvant éventuellement interagir avec des systèmes cloud pour répondre aux besoins de stockage ou d'analyses avancées. Dans son ensemble, le cadre garantit une détection précise des défauts, une explicabilité et un fonctionnement en temps réel efficace, conformément aux exigences de l'industrie 5.0.
Définition du problème et analyse des exigences
Les systèmes cyber-physiques humains (CPHS) dans les environnements de l'industrie 5.0 promettent intelligence, durabilité et centrage sur l'humain. Cependant, les cadres contemporains de conception des CPHS souffrent d'un manque de fonctionnalités avancées activées par l'intelligence artificielle, d'explicabilité et d'un soutien adéquat à la collaboration homme-machine. En effet, les CPHS conventionnels reposent sur des modèles basés sur des règles ou non interprétables, ce qui entrave leur adaptation aux conditions industrielles changeantes et limite la confiance des opérateurs dans l'automatisation. De plus, les CPHS conventionnels ne parviennent pas à analyser efficacement des données hautement complexes, telles que les signaux acoustiques industriels contenant à la fois des composantes spatiales (c'est-à-dire la fréquence) et temporelles, qui sont essentielles pour la maintenance prédictive. Il est donc nécessaire de concevoir un cadre capable de détecter les anomalies des machines avec une grande précision, de fournir des explications et de fonctionner en périphérie (edge), permettant ainsi les systèmes cyber-physiques (CPS).
Ici, x(t) est le signal acoustique d'entrée, S(f,t) est la représentation spectrogramme du signal,  est l'étiquette et θ est l'ensemble des paramètres de l'architecture CNN-Transformer. Les symboles utilisés dans les équations suivantes sont introduits juste après leur première apparition afin de préserver la rigueur mathématique.
Du point de vue mathématique, la tâche peut être formalisée comme un problème d'apprentissage supervisé. Soit x(t) le signal acoustique industriel. La TFD de x(t) est calculée selon la formule suivante :
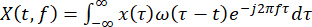 (1)
où ω(.) est la fonction fenêtre et f est la fréquence. Le spectrogramme généré 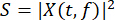 sert d'entrée à l'algorithme d'apprentissage profond. L'objectif est d'entraîner la fonction de correspondance
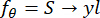 (2)
où est l'étiquette de classe (normale ou anormale), et où S est l'entrée spectrogramme, y est l'étiquette de sortie prédite et θ est l'ensemble des paramètres apprenables de l'architecture CNN-Transformer. Le problème d'optimisation est formulé comme la minimisation de la perte de classification :
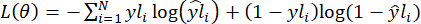 (3)
sous réserve des contraintes de latence minimale  , d'efficacité énergétique
 et d'interprétabilité, où l'explication ∅(SHAP) reflète l'importance des caractéristiques dans le processus de prédiction,
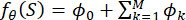 (4)
où  représente la contribution de chaque caractéristique individuelle. Conformément à ce qui précède, les exigences de conception comprennent les éléments suivants : (i) une détection fiable des anomalies basée sur un apprentissage profond hybride, (ii) des sorties interprétables permettant une intervention humaine, et (iii) une mise en œuvre dans un cadre de CPS renforcé par le calcul en périphérie.
Acquisition et prétraitement des données
À cet égard, afin d'évaluer le cadre CPHS proposé basé sur l'intelligence artificielle explicative, le jeu de données MIMII13 a été sélectionné. Ce jeu de données constitue une référence largement utilisée pour la détection d'anomalies dans les machines industrielles à l'aide de signaux acoustiques. Cette base de données contient des enregistrements sonores de diverses machines, telles que des rails coulissants, des ventilateurs, des pompes et des vannes, fonctionnant dans des conditions normales ainsi que défectueuses. Pour chaque machine, les enregistrements varient selon différents paramètres et environnements bruités. Cela le rend adapté à l'entraînement et à l'évaluation de modèles dans des conditions industrielles en temps réel.
Alors que le jeu de données MIMII est largement utilisé dans les études de détection d'anomalies non supervisées qui s'appuient uniquement sur des échantillons normaux pendant l'entraînement, il inclut des annotations explicites des états normaux et anormaux des machines. Le problème est formulé comme une tâche de classification binaire supervisée afin d'évaluer la capacité de l'architecture CNN-Transformeur basée sur une IA explicable proposée à distinguer les états sains des états défectueux des machines. Plus précisément, les étiquettes officielles MIMII sont utilisées, attribuant l'étiquette de classe 0 aux échantillons normaux et l'étiquette de classe 1 aux échantillons anormaux.
Tableau 1 présente les détails de la description du jeu de données. Environ 12 000 enregistrements de signaux acoustiques sont pris en compte dans la présente recherche, incluant à la fois des fonctionnements normaux et défectueux des machines. Conformément aux exigences, tous les enregistrements de cette étude ont été capturés à 16 kHz et ont une durée de 10 s. Bien que le jeu de données contienne environ 12 000 enregistrements, un sous-ensemble équilibré en classes de 2 000 enregistrements de test a été sélectionné uniquement pour visualiser la matrice de confusion. Toutes les métriques de performance indiquées ont été calculées à l’aide du jeu de test complet (environ 2 400 enregistrements). En outre, les échantillons d’entraînement et de test sont séparés selon un ratio de 80:20 pour l’apprentissage du modèle. Cette base de données convient particulièrement aux applications de l’industrie 5.0, car elle inclut des conditions réelles de bruit ambiant. La répartition des enregistrements utilisée dans cette étude est indiquée dans Tableau 2. À partir de ce jeu de données, environ 12 000 enregistrements couvrant tous les types de machines et les conditions de rapport signal-sur-bruit (SNR) ont été sélectionnés pour des expériences de classification binaire supervisée, en utilisant une répartition entraînement/test de 80:20, illustrant les types de machines industrielles, les identifiants de machine correspondants, les nombres totaux d’enregistrements acoustiques normaux et anormaux, les conditions de SNR, ainsi que la répartition entraînement/test utilisée pour la classification binaire supervisée.
L'expérience a été réalisée à l'aide du jeu de données MIMII (Malfunctioning Industrial Machine Investigation and Inspection) version 1.0, qui comprend quatre types de machines industrielles : ventilateurs, pompes, vannes et rails coulissants. Les données ont été recueillies à partir de différents identifiants de machines (ID00–ID06, selon le type de machine) et de différentes conditions. La base de données MIMII comprend des données acquises à des rapports signal-sur-bruit (SNR) de −6 dB, 0 dB et +6 dB. Les données normales correspondent à l'état sain de la machine industrielle, tandis que les données anormales correspondent à un état anormal. Les classes ont été étiquetées selon l'annotation de la base de données, les données normales étant étiquetées classe 0 et les données anormales classe 1.
Un processus d'évaluation équitable exigeait que la répartition entre les ensembles d'apprentissage et de test soit effectuée au niveau des enregistrements audio d'origine, avant toute division, augmentation ou création de spectrogrammes. En conséquence, des segments audio provenant du même enregistrement ne pouvaient pas apparaître à la fois dans les ensembles d'apprentissage et de test. Pour l'expérience d'évaluation, des enregistrements présentant différents rapports signal-sur-bruit (−6 dB, 0 dB et +6 dB) ont été utilisés, offrant ainsi la possibilité d'évaluer le cadre proposé dans diverses conditions industrielles.
Afin d'éviter les fuites de données, la séparation entre ensemble d'apprentissage et de test a été effectuée en utilisant le fichier audio d'origine comme base, avant toute segmentation ou génération de spectrogramme. Les segments provenant de l'enregistrement audio de 10 s ont été attribués exclusivement soit à l'ensemble d'apprentissage, soit à l'ensemble de test, sans qu'aucun segment ne soit présent dans les deux ensembles. Par la suite, les spectrogrammes ont été générés et augmentés séparément pour chaque jeu de données. Ainsi, le problème de fuite de données est évité, empêchant ainsi une évaluation trop optimiste des performances.
Prétraitement du jeu de données
Les signaux acoustiques bruts provenant du jeu de données MIMII sont ensuite traités afin d'améliorer la qualité du signal et de permettre une extraction efficace des caractéristiques. Le signal d'entrée est désigné par x(t), où t représente le temps. La première étape consiste en un filtrage du bruit, par lequel les bruits de fond sont éliminés à l'aide d'une fonction de filtrage telle que :
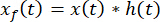 (5)
où ∗ représente le processus de convolution et h(t) est la réponse impulsionnelle du filtre. Ce processus améliore la clarté du signal acoustique et minimise les effets du bruit, souvent prédominant dans les environnements industriels. La normalisation du signal est utilisée afin de garantir que les amplitudes de tous les signaux audio soient comparables avant leur introduction dans le modèle d'apprentissage profond. Le signal normalisé, noté xn(t), est calculé comme suit :
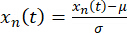 (6)
où μ et σ sont respectivement la valeur moyenne et l'écart type du signal d'entrée. Tous les signaux d'entrée sont garantis de moyennes nulles et de variances unitaires grâce à cette procédure. Enfin, pour le traitement, le signal d'entrée normalisé est divisé en plusieurs petits segments. Étant donné que la durée du signal complet est T, il est décomposé en N trames superposées, chacune ayant une longueur L, à l'aide d'une fonction fenêtrage glissant :
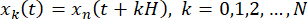 (7)
où H est la taille du saut. Le spectrogramme peut être défini par la formule suivante :
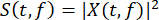 (8)
Les spectrogrammes obtenus de cette manière sont intégrés dans le cadre basé sur un CNN et un transformeur afin d'extraire des caractéristiques spatiales et temporelles permettant une détection efficace des anomalies. Figure 2 illustre le pipeline de prétraitement.
Figure 2 illustre un pipeline de prétraitement vertical qui peut être utilisé pour des données acoustiques acquises dans un contexte industriel. Tout d'abord, les signaux audio bruts sont extraits du jeu de données MIMII et transmis à une étape de suppression du bruit afin de réduire les interférences. Ensuite, le signal est normalisé pour éliminer les incohérences d'amplitude, garantissant ainsi une uniformité du signal. Le signal est ensuite divisé en segments plus petits et partiellement superposés. Après la segmentation, des transformations STFT sont appliquées aux données pour convertir les signaux temporels en signaux temps-fréquence. Puis, le spectre de puissance est calculé dans le cadre de la génération du spectrogramme du signal. Les spectrogrammes prétraités constituent ainsi la sortie produite par ce processus et seront utilisés dans le modèle CNN-transformeur proposé.
Génération du spectrogramme
Après la normalisation et la segmentation des données, les signaux acoustiques sont convertis en une représentation temps-fréquence à l'aide de la transformation de Fourier à court terme (STFT). Le spectrogramme obtenu fournit une représentation visuelle des variations de la composition fréquentielle au cours de la période d'analyse. Dans les environnements industriels, les pannes de machines se manifestent généralement sous forme de motifs fréquentiels, ce qui rend les spectrogrammes plus utiles pour détecter les anomalies des machines.
Les données traitées résultantes sont donc converties en images de spectrogrammes afin de distinguer les cas normaux des cas anormaux au sein des machines. Les données audio seront converties en plusieurs spectrogrammes afin de permettre au modèle d'apprentissage d'analyser les composantes fréquentielles locales et les variations temporelles du processus de la machine. Ces images sont utilisées comme données d'entrée pour le modèle CNN-transformeur, où le CNN gère les motifs spatiaux (fréquentiels) tandis que les transformeurs gèrent les relations temporelles.
Algorithme 1 : Génération de spectrogrammes à partir de signaux acoustiques
Entrée : signal audio brut x(t)
Résultat : Spectrogramme S(t, f)
Étape 1 : Charger le signal audio x(t)
Étape 2 : Appliquer un filtrage du bruit
Étape 3 : Normaliser le signal xn(t)
Étape 4 : Segmenter le signal en trames :
pour k = 1 à N, faire
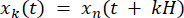
fin pour
Étape 5 : Appliquer une fenêtre temporelle w(t) à chaque segment
Étape 6 : Calculer la TFD :
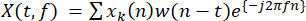 (9)
Étape 7 : Calculer l'amplitude :
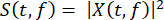 (10)
Étape 8 : Enregistrer le spectrogramme S(t, f)
Étape 9 : Retourner le jeu de données du spectrogramme
Le processus de génération des spectrogrammes commence par l'acquisition du signal audio d'origine, suivi d'étapes de prétraitement telles que la réduction du bruit et la normalisation du signal afin de garantir l'intégrité et la qualité du signal. Ensuite, l'audio normalisé est divisé en plusieurs fenêtres superposées afin de capturer les caractéristiques temporelles des périodes longues et courtes. Pour éviter les fuites spectrales, chaque segment est multiplié par une fonction fenêtrée avant d'être soumis à la transformation de Fourier à court terme. Par la suite, le signal transformé est représenté comme une fonction à valeurs complexes dans le domaine fréquentiel, et ses amplitudes sont élevées au carré. Ainsi, l'énergie des fréquences au cours du temps donné est représentée par les spectrogrammes. Enfin, ceux-ci sont stockés sous forme de données semblables à des images et fournis au réseau neuronal pour l'entraînement.
Extraction de caractéristiques spatiales à l'aide de CNN
Après la création des spectrogrammes, les images temps-fréquence obtenues sont utilisées comme entrées et fournies à un réseau neuronal convolutif (CNN). En considérant le spectrogramme d'entrée comme  , où H représente le domaine fréquentiel et W le domaine temporel. L'objectif de l'utilisation du CNN ici est d'apprendre des caractéristiques spatiales discriminantes à partir du spectrogramme d'entrée. Ces caractéristiques spatiales discriminantes permettront de distinguer un fonctionnement normal d'un fonctionnement anormal d'une machine dans un environnement industriel.
Une opération de base effectuée par le réseau neuronal convolutif (CNN) est la convolution. La convolution avec un filtre donné  est donnée par :
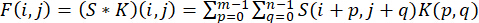 (11)
L'opération décrite ci-dessus permet au réseau de neurones d'identifier des caractéristiques spatiales locales, telles que les contours, les fréquences et le contenu harmonique, dans le spectrogramme. Cela s'effectue grâce à plusieurs opérations de filtrage générant diverses représentations de caractéristiques, produisant ainsi plusieurs cartes de caractéristiques. La convolution est suivie d'une fonction d'activation non linéaire, comme illustré ci-dessous :
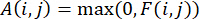 (12)
Cette non-linéarité permet au réseau de capturer et de représenter des relations complexes entre les variables. L'étape suivante dans un réseau neuronal convolutif implique l'application d'opérations de regroupement. La technique courante du regroupement maximal est exprimée mathématiquement comme suit :
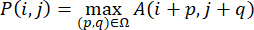 (13)
où Ω désigne la fenêtre de regroupement. Le regroupement permet d'atteindre une invariance par translation et de conserver uniquement les informations pertinentes tout en éliminant les redondances. À partir de variables de bas niveau telles que les fréquences jusqu'au comportement complexe de la machine, des caractéristiques de niveau supérieur peuvent être extraites de manière hiérarchique à l'aide d'un réseau neuronal convolutif. Par conséquent, les cartes de caractéristiques peuvent être utilisées pour représenter la sortie finale du réseau :
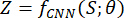 (14)
où représente les paramètres apprenables du CNN. Les cartes de caractéristiques contiennent des informations spatiales riches et sont transformées en séquences afin de servir d'entrées pour l'encodeur de transformeur lors de la phase suivante. Le processus d'extraction des caractéristiques spatiales décrit ci-dessus est essentiel pour permettre au modèle de détecter des anomalies minimes dans les signaux acoustiques industriels.
Figure 3 illustre comment les caractéristiques spatiales sont extraites horizontalement à partir de l'entrée spectrogramme à l'aide d'un modèle de réseau de neurones convolutif (CNN). Le processus commence par le spectrogramme d'entrée, qui encode les propriétés temps-fréquence du signal audio sous une forme picturale. Ce spectrogramme est ensuite transmis à une couche de convolution, dans laquelle plusieurs types de filtres extraient des caractéristiques spatiales telles que les bandes de fréquence, les contours et les textures, produisant ainsi des cartes de caractéristiques. Ensuite, les cartes de caractéristiques extraites passent par une fonction d'activation non linéaire, l'unité linéaire redressée (ReLU), permettant au réseau de neurones de détecter des dépendances dans les données d'entrée. Les cartes de caractéristiques sont ensuite acheminées vers une couche de sous-échantillonnage (pooling), où la taille de la carte est réduite tout en conservant ses caractéristiques les plus importantes. Ce processus, composé de couches de convolution, d'activation et de sous-échantillonnage, se répète plusieurs fois, créant ainsi une hiérarchie de représentation des caractéristiques qui commence par des éléments simples et évolue vers des caractéristiques plus sophistiquées liées aux opérations des machines.
Modélisation temporelle à l'aide d'un encodeur de type transformeur
Une fois les caractéristiques spatiales extraites à l'aide du CNN, l'étape suivante consiste à dériver des cartes de caractéristiques de haut niveau qui capturent les motifs basés sur la fréquence, appris à partir du spectrogramme. Les cartes de caractéristiques obtenues sont ensuite aplaties et remodelées en séquences afin de capturer l'information temporelle présente dans le signal acoustique. En supposant que les cartes de caractéristiques soient représentées par 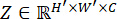 , où H', W', et C désignent respectivement la hauteur, la largeur et les canaux, la séquence suivante est obtenue :
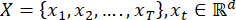 (15)
où T représente la longueur de la séquence, et d est la dimension des caractéristiques. Le modèle Transformer utilise ensuite cette séquence pour modéliser les dépendances à long terme au moyen d'un mécanisme d'auto-attention. Contrairement aux modèles récurrents classiques, le modèle Transformer traite chaque élément de la séquence en parallèle et utilise des poids d'attention pour déterminer la pertinence relative de chaque élément. Le fonctionnement du mécanisme d'attention repose sur des vecteurs Requête Q, Clé K et Valeur V générés pour chaque entrée xt selon l'équation suivante :
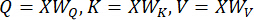 (16)
où WQ, WK, WV sont des poids entraînables. Les similarités entre les éléments sont déterminées par :
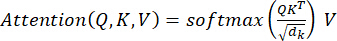 (17)
dk est la dimension importante des vecteurs. Cette procédure facilite l'apprentissage par le modèle des dépendances issues d'instants éloignés dans le signal et lui permet de se concentrer uniquement sur les segments temporels pertinents. Afin d'augmenter la capacité d'apprentissage du réseau, une attention multi-tête est utilisée, ce qui désigne le processus par lequel plusieurs têtes d'attention apprennent en parallèle à partir de l'entrée :
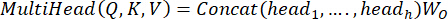 (18)
Chaque tête traite des caractéristiques distinctes de la séquence temporelle en entrée. Ceci est suivi de réseaux neuronaux feed-forward et de connexions résiduelles :
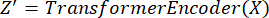 (19)
La séquence codée résultante capture les caractéristiques spatiales et temporelles de l'entrée. Cette séquence est transmise à la couche de classification pour détecter les anomalies.
Figure 4 illustre le processus global de modélisation temporelle à l'aide d'un encodeur de type transformeur appliqué aux caractéristiques extraites du CNN. Tout d'abord, les cartes de caractéristiques extraites du CNN sont utilisées ; elles contiennent des informations spatiales provenant du spectrogramme. Ces cartes sont aplaties en une séquence, chaque élément correspondant à un instant donné. Ensuite, la séquence passe par une transformation linéaire qui projette les données en vecteurs d'une dimension spécifique. Comme les modèles de type transformeur ne peuvent pas capturer naturellement les dépendances temporelles, un encodage de position est également ajouté aux vecteurs intégrés afin de préserver la structure temporelle de la séquence. Enfin, la séquence traverse un encodeur de transformeur, composé d'une pile de plusieurs couches, dans lequel un mécanisme d'auto-attention multi-têtes est utilisé pour permettre au modèle d'apprendre les relations entre les instants de la séquence. Un réseau de neurones à propagation avant améliore davantage ces intégrations, tandis que des connexions résiduelles garantissent une propagation efficace des gradients. Ce processus est répété à travers les couches empilées de l'encodeur de transformeur, qui capturent progressivement des interactions temporelles de plus en plus complexes. En fin de compte, les intégrations de la séquence sont combinées en une représentation de longueur fixe par regroupement (par exemple, regroupement par moyenne ou jeton de classification (CLS)), produisant ainsi une représentation globale des caractéristiques temporelles.
Couche de classification
Après l'encodage temporel à l'aide de l'encodeur de transformeur, les sorties seront une séquence de vecteurs encodés, chacun comportant des caractéristiques liées aux aspects spatiaux et temporels du signal d'entrée. La première étape vers la classification à partir des sorties encodées consiste à agréger toutes ces caractéristiques en un seul vecteur. Cela est réalisé soit en appliquant un regroupement par moyenne (mean pooling) à la séquence de vecteurs de caractéristiques, soit en utilisant le « jeton de classification » (classification token). Supposons que la sortie du transformeur soit 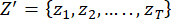 , où chaque
 . La caractéristique agrégée h est calculée comme suit :
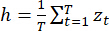 (20)
Ensuite, le vecteur de caractéristiques agrégé h représente l'entrée sous une forme compacte et sert d'entrée au classificateur. La partie classification comprend une ou plusieurs couches denses, qui transforment la représentation apprise en un espace de sortie. Une couche dense implémente une transformation définie comme suit :
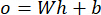 (21)
où o est la sortie (logits), b est le vecteur de biais et W est la matrice de poids. Ces derniers représentent les scores de classe sous une forme non normalisée. Pour intégrer une non-linéarité dans le modèle, des fonctions d'activation telles que ReLU sont souvent utilisées. Enfin, une fonction d'activation softmax est appliquée aux logits afin d'obtenir une probabilité pour chaque classe :
 (22)
où C représente le nombre de classes (C = 2 ; normal et anormal). La prédiction de classe sera basée sur la valeur de probabilité maximale. Pendant l'apprentissage, les valeurs optimales des paramètres du modèle sont obtenues en minimisant la perte d'entropie croisée entre les étiquettes réelles et prédites, permettant ainsi une classification précise des états de la machine. En résumé, la couche de classification joue une fonction essentielle en transformant les caractéristiques temporelles extraites à l'aide de l'architecture Transformer en décisions pratiques. Grâce à une discrimination adéquate entre les états sains et défectueux de la machine, la détection d'anomalies et la prise de décision intelligente deviennent possibles dans le cadre du paradigme Industry 5.0.
Figure 5 montre le fonctionnement de la couche de classification, qui suit l'encodeur Transformer. Le processus débute avec la sortie de la séquence encodée, dans laquelle chaque vecteur contient des informations temporelles apprises à partir de l'entrée. Ces vecteurs sont combinés en un seul vecteur, appelé vecteur de caractéristiques global. L'étape suivante consiste à transmettre ce vecteur de caractéristiques global à travers plusieurs couches de réseaux neuronaux denses. Dans chaque couche dense, des opérations de multiplication matricielle sont effectuées afin de créer des combinaisons linéaires des entrées. Ensuite, une fonction d'activation non linéaire, telle que ReLU, peut être appliquée pour augmenter la flexibilité dans l'apprentissage des frontières de décision. À la fin de la dernière couche dense, des scores logit sont obtenus pour chaque classe. Ces scores logit peuvent être utilisés comme entrée de la fonction Softmax afin de calculer les probabilités pour chaque classe. Ces scores de probabilité permettent de déterminer si l'entrée appartient à la Classe 0 (Normale) ou à la Classe 1 (Anormale).
Explicabilité à l'aide de SHAP
Une fois que le modèle a classé les signaux d'entrée, des prédictions sont générées selon que la machine fonctionne normalement ou anormalement. Toutefois, dans un environnement de l'industrie 5.0, il ne suffit pas de produire des prédictions ; le système doit également offrir transparence et explicabilité afin d'aider la prise de décision humaine. Le cadre présenté ici utilise SHAP, un modèle fondé sur la théorie des jeux qui quantifie l'importance de chaque caractéristique dans la détermination de la prédiction. Ce faisant, SHAP attribue des poids aux caractéristiques, permettant ainsi d'évaluer l'importance relative des différentes sections du spectrogramme en entrée par rapport à la prédiction globale.
La formulation mathématique de SHAP repose sur une décomposition du modèle f(x) :
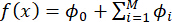 (23)
où ∅0 est la valeur de référence (sortie moyenne du modèle), ∅i est l'effet de la i-ème caractéristique, et M est le nombre de caractéristiques d'entrée. Pour la présente étude, les caractéristiques correspondent aux intervalles temps-fréquence du spectrogramme. Les valeurs SHAP sont positives lorsqu'elles contribuent à la probabilité d'un état anormal, négatives dans le cas contraire. Cette formulation garantit une explication unique et localement cohérente pour chaque prédiction. La méthode SHAP peut être appliquée à un modèle pré-entraîné de type CNN-transformeur afin de fournir une interprétation fondée sur l'importance des caractéristiques. La représentation visuelle mettra en évidence les intervalles temps-fréquence les plus importants du spectrogramme influant sur le processus de décision. Par exemple, un comportement anormal de l'équipement peut se traduire par certaines bandes de fréquence à haute énergie que le cadre SHAP identifie comme des contributeurs importants au processus décisionnel.
De plus, SHAP peut favoriser la coopération entre les humains et les machines dans un environnement cyber-physique. En effet, les prédictions peuvent être expliquées à l’aide de représentations visuelles intuitives, permettant aux opérateurs et aux systèmes de prise de décision de vérifier les prévisions, d’analyser le problème et de prendre les mesures appropriées. Cela accroît non seulement la confiance, mais rend également les processus de fabrication basés sur l’intelligence artificielle fiables et traçables. En intégrant des algorithmes d’apprentissage profond répondant aux normes de performance actuelles à SHAP, qui assure l’explicabilité, l’architecture proposée répond aux exigences de l’industrie 5.0.
Algorithme 2 : Interprétabilité basée sur SHAP pour la prédiction du modèle
Entrée : modèle entraîné f(x), spectrogramme d'entrée S
Résultat : valeurs SHAP  et carte d'explication
Étape 1 : Entrer le spectrogramme S dans un modèle entraîné
Étape 2 : Calculer la prédiction : y = f(S)
Étape 3 : Initialiser un expliquant SHAP axé sur l'apprentissage profond
Étape 4 : Calculer les valeurs SHAP :
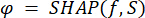
Étape 5 : Pour chaque caractéristique i dans S :
Calculer la contribution 
Étape 6 : Générer la carte d'explication :
Mettre en évidence les régions présentant une forte 
Étape 7 : Visualiser l'importance des caractéristiques (carte thermique)
Étape 8 : Renvoyer les valeurs SHAP et la carte d'explication
L'algorithme d'explicabilité basé sur SHAP commence par obtenir une image de spectrogramme prétraitée en entrée, puis la transmet à l'architecture CNN-transformeur entraînée afin d'effectuer des prédictions (par exemple, état normal ou anormal de la machine). Après avoir effectué des prédictions à l'aide de l'architecture entraînée, la méthode SHAP est utilisée pour interpréter le modèle. En particulier, les valeurs SHAP (ϕ) sont calculées pour chaque caractéristique d'entrée afin d'identifier quelles composantes temps-fréquence de l'entrée contribuent le plus à la prédiction. Pour calculer ces valeurs, il est nécessaire de comparer les sorties du modèle pour des entrées contenant ou non certaines caractéristiques.
Après avoir calculé les valeurs SHAP pour chaque caractéristique, son influence sur la prédiction peut être évaluée par le signe et l'amplitude de la valeur SHAP. Par exemple, les caractéristiques ayant des valeurs SHAP plus élevées sont plus susceptibles d'influencer le résultat, et un signe positif ou négatif indique que la caractéristique pousse la prédiction respectivement vers la classe normale ou anormale. À partir des résultats, une carte d'explication peut être établie sous forme de carte thermique.
Enfin, l'algorithme produit à la fois les valeurs SHAP et les visualisations, offrant un aperçu de la manière dont les humains peuvent analyser la décision du modèle. Cette technique rend le processus plus transparent et permet aux humains de participer à la prise de décision, garantissant ainsi à la fois les prédictions de l'algorithme et leur fiabilité dans l'industrie pilotée par l'intelligence artificielle. Des échantillons représentatifs ont été sélectionnés parmi des cas anormaux correctement diagnostiqués, provenant de divers types de machines, afin d'améliorer la fiabilité de l'analyse d'explicabilité. Alors qu'une analyse globale de l'importance des caractéristiques SHAP a été réalisée en agrégeant les valeurs SHAP sur l'ensemble de test afin d'identifier les positions temporelles et fréquentielles systématiquement influentes, des explications SHAP locales ont été générées pour ces cas représentatifs. Sans nécessiter d'annotation par un expert, cette analyse intégrée locale et globale fournit une interprétation fiable des prédictions du modèle.
Intégration des CPS compatibles au cloud périphérique
Cette solution proposée est utilisée dans le cadre des CPS dotés de capacités de calcul en périphérie (edge), qui vise à assurer l'efficacité, la durabilité et le fonctionnement industriel en temps réel. Une fois le modèle entraîné, le CNN-transformer sera déployé selon une approche de calcul en périphérie. La couche de calcul en périphérie concernée se situe à proximité des dispositifs industriels de l'Internet des objets (IIoT), notamment les capteurs et les machines. Plutôt que de transmettre toutes les données collectées vers le cloud, le dispositif en périphérie effectue une inférence sur le signal acoustique entrant sans les transférer préalablement. Ainsi, le système peut détecter presque instantanément les anomalies des machines et prendre les mesures nécessaires avant que la situation ne se dégrade davantage. Un autre avantage de cette approche reposant sur le calcul en périphérie est une latence et une efficacité améliorées, puisque les données sont analysées près du lieu de leur génération. En d'autres termes, contrairement à l'approche basée sur le cloud, où le temps d'inférence Tinf
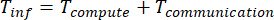 (24)
La latence sera, en général, considérablement réduite grâce à une diminution de Tcommunication. Un autre avantage est la réduction de la consommation de bande passante et de l'énergie dépensée lors de la transmission continue des données. Ce système est donc évolutif et durable pour les grandes installations industrielles comportant de nombreux dispositifs connectés. En outre, le CPS permet l'interaction avec la couche physique (machines), l'IA (couche de calcul) et la couche humaine.
Collaboration avec intervention humaine
Un élément clé du CPS proposé pour l'industrie 5.0, qui inclut des opérateurs humains activement impliqués dans le processus de décision aux côtés de modèles d'intelligence artificielle, est la collaboration avec l'humain dans la boucle. Plus précisément, selon le cadre conçu, le système ne devient pas une boîte noire autonome, mais permet plutôt aux opérateurs d'interagir avec lui et d'observer des résultats de prédiction explicables sous forme d'explications SHAP. Les prédictions en question font référence aux résultats (normal/anormal), accompagnés de visualisations de parties des spectrogrammes utilisées pour les établir.
Une telle interaction aide les opérateurs à mieux comprendre comment la prédiction est établie et quels facteurs y contribuent. La participation humaine implique la vérification des résultats du système et permet aux opérateurs de les modifier si nécessaire, selon leur jugement professionnel. La collaboration avec les opérateurs humains rend le système plus digne de confiance, plus efficace, plus sûr et plus fiable, contribuant ainsi à prévenir les erreurs.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Le système de collaboration cyber-physique intégrant une IA explicable a été testé expérimentalement sur environ 12 000 enregistrements audio provenant du jeu de données MIMII, qui contient des conditions de fonctionnement normales et anormales de machines. Le jeu de données d'apprentissage comprenait environ 9 600 enregistrements, tandis que le jeu de données de test comprenait environ 2 400 échantillons audio. Selon les résultats, le modèle CNN-transformeur proposé a atteint une précision de classification de 98,5 % su...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Les résultats expérimentaux démontrent que l'architecture proposée combinant CNN et transformeur surpasse les algorithmes individuels en intégrant efficacement l'apprentissage des caractéristiques spatiales et temporelles. Selon l'étude d'ablation, bien que le CNN extrait des caractéristiques discriminantes basées sur la fréquence à partir des spectrogrammes, l'encodeur transformeur améliore les performances du modèle en capturant les dépendances temporelles à longue portée dans les signaux acoustiques. De plus, la matri...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Un outil d'intelligence artificielle (ChatGPT) a été utilisé uniquement pour aider à la révision linguistique et à l'amélioration de la grammaire, de la clarté et de la lisibilité. Les outils d'intelligence artificielle n'ont pas été utilisés pour générer des données scientifiques, réaliser des expériences, analyser des résultats, interpréter des découvertes ou formuler des conclusions scientifiques. L'ensemble du contenu scientifique, de l'analyse des données, de l'interprétation et de la version finale du manuscrit a fait l'objet d'une vérification, d'une révision et d'une approbation indépendantes par les auteurs, qui assument l'entière responsabilité de l'exactitude et de l'intégrité du travail. Les auteurs n'ont aucun conflit d'intérêts à déclarer.
Remerciements
FINANCEMENT : Ce travail a été soutenu par le projet clé sur la réforme de l'enseignement universitaire de la province du Shaanxi (n° de projet 23BG053) ; la fondation de recherche scientifique pour les talents de haut niveau de l'Université polytechnique du Shaanxi (n° de projet BSJ-2023-08) ; et le projet de recherche scientifique de l'Université polytechnique du Shaanxi (n° de projet 2024YKYB-006). Les auteurs remercient sincèrement l'Université polytechnique du Shaanxi, Xianyang, Chine, et l'Université d'ingénierie des transports de Xi’an, Xi’an, Chine, pour avoir fourni les installations et le soutien institutionnel qui ont permis cette recherche.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Échelle de soutien social | Échelle universitaire publiée ; initialement développée par Park et révisée/complétée par Kim | version à 25 items ; format de réponse en échelle de Likert à 5 points ; aucun numéro de catalogue commercial | Mesure le soutien social perçu chez les futurs enseignants de la petite enfance selon quatre dimensions : Soutien émotionnel, Soutien informationnel, Soutien matériel et Soutien évaluatif. Alpha de Cronbach global’s alpha = 0,96. |
| Échelle d'auto-efficacité de l'enseignant | Échelle universitaire publiée ; initialement développée par Enochs et Riggs ; version d'étude adaptée en chinois | version à 25 items ; format de réponse en échelle de Likert à 5 points ; aucun numéro de catalogue commercial | Évalue l'efficacité professionnelle des enseignants dans le contexte chinois de la formation initiale en éducation de la petite enfance, selon les dimensions de l'auto-efficacité enseignante générale et de l'auto-efficacité enseignante personnelle. Alpha de Cronbach global’s alpha = 0,96. |
| Échelle d'interaction enseignant-enfant | Échelle universitaire publiée ; développée par Lee et examinée par le comité d'experts de l'étude pour une utilisation en Chine | version de 30 éléments ; format de réponse en échelle de Likert à 5 points ; aucun numéro de catalogue commercial | Évalue la compétence déclarée par l'enseignant dans ses interactions avec l'enfant, plutôt que la qualité observée des interactions en classe. Comprend l'interaction émotionnelle, l'interaction verbale et l'interaction comportementale ; coefficient global de Cronbach’s alpha = 0,94. |
| Formulaire d'informations démographiques | Équipe de recherche, collaboration entre l'Université des arts et des sciences du Sichuan et l'Université de Daegu | Section personnalisée du questionnaire d'étude ; aucun numéro de catalogue commercial | Caractéristiques recueillies des participants incluant le sexe, le niveau d'éducation, la catégorie professionnelle, le lieu du stage, la durée du stage, le type de stage et le type de jardin d'enfants. |
| Information destinée au participant et modèle de consentement éclairé | Équipe de recherche ; approuvé par le Comité d'éthique de la recherche de l'Université de Daegu | Numéro d'approbation éthique : XXX ; document officiel d'approbation locale à vérifier | Utilisé avant la distribution du questionnaire pour expliquer l'objectif de l'étude et le contenu du sondage, ainsi que pour obtenir le consentement éclairé des participants, futurs enseignants de la petite enfance. |
| Pilote du questionnaire de l'enquête | Équipe de recherche et panel d'experts | Version pilote utilisée en juin 1er–5, 2024 ; aucun numéro de catalogue commercial | A testé de façon pilote la clarté et la pertinence de l'échelle des perceptions professionnelles, de l'échelle du soutien social, de l'échelle de l'auto-efficacité des enseignants, de l'échelle des interactions enseignant-enfant et des items démographiques auprès de 50 futurs enseignants en éducation de la petite enfance. |
| Procédure d'examen par un groupe d'experts | Équipe de recherche ; panel d'experts composé de deux professeurs d'éducation de la petite enfance, d'une directrice de maternelle, de trois superviseurs de stage et de l'équipe de recherche | Revue de contenu basée sur un consensus ; aucun numéro de modèle commercial | Utilisé pour réviser les items de l'échelle en ce qui concerne l'ambiguïté, l'opportunité, la clarté sémantique, l'adaptation au développement et la pertinence culturelle avant l'enquête formelle. |
| Formulaires imprimés de questionnaire sur site | Équipe de recherche ; fournitures pour enquête institutionnelle locale | Formulaires d'enquête sur papier ; aucun numéro de catalogue commercial | Utilisé pour la passation des questionnaires sur site. Dans l'échantillon final, 336 questionnaires sur site valides ont été obtenus avant combinaison avec les questionnaires en ligne. |
| Tencent | Application mobile WeChat ; la version doit être vérifiée à partir de l'enregistrement de l'appareil ou de l'application utilisée en juin–juillet 2024 | Utilisé comme canal de diffusion en ligne pour la passation de questionnaires ; 27 questionnaires complétés ont été recueillis par voie en ligne/via WeChat. | |
| Procédure de recrutement par téléphone et en personne | Équipe de recherche | Procédure normalisée de recrutement ; aucun numéro de catalogue commercial | Utilisé pour contacter les institutions ou les participants, expliquer l'objectif de l'étude et le contenu du questionnaire, et appuyer le consentement éclairé avant la passation du questionnaire. |
| SPSS Statistics | IBM | Version 27.0 | Utilisé pour les statistiques descriptives, les coefficients de corrélation de Pearson, Cronbach’analyse de fiabilité alpha de Cronbach, vérifications de la normalité à l'aide de l'asymétrie et de l'aplatissement, et Harman’un test à facteur unique pour le biais de méthode commune. |
| SPSS Amos | IBM | Version 26.0 | Utilisé pour l'analyse factorielle confirmatoire, la modélisation par équations structurelles, les tests d'invariance de mesure multi-groupes, les tests de bootstrap des effets indirects et les comparaisons de modèles alternatifs. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel ou version d'Excel installée localement ; vérifier la version exacte installée avant soumission | Recommandé/utilisé comme environnement de travail pour organiser les données codées issues du questionnaire, le dictionnaire de données, les tableaux supplémentaires et le tableau des matériaux de JoVE. La version locale exacte doit être vérifiée par les auteurs. |
| Critères des indices d'ajustement en modélisation par équations structurelles | Conseils méthodologiques publiés ; références de Schreiber et al. et de Kline citées dans le manuscrit | Aucun numéro de catalogue commercial ; critères appliqués dans le plan d'analyse statistique | Définit et présente les indices d'ajustement du modèle, notamment la statistique du khi-deux, le khi-deux divisé par les degrés de liberté, l'indice de Tucker-Lewis, l'indice de concordance comparative, l'indice ajusté de qualité d'ajustement, l'indice d'ajustement incrémentiel, l'erreur quadratique moyenne d'approximation et le résidu quadratique moyen standardisé. |
| Procédure de test de médiation par bootstrap | SPSS Amos / plan d'analyse statistique de l'équipe de recherche | 5 000 échantillons de bootstrap ; intervalles de confiance corrigés du biais à 95 % | Utilisé pour tester les associations indirectes par l'intermédiaire de l'efficacité enseignante. Les effets indirects étaient considérés comme significatifs lorsque l'intervalle de confiance corrigé du biais à 95 % n'incluait pas zéro. |
| Procédure de test d'invariance de mesure | SPSS Amos / plan d'analyse statistique de l'équipe de recherche | Analyse factorielle confirmatoire à groupes multiples ΔCFI &< 0,010 et ΔRMSEA &< .015 critères | Utilisé pour évaluer l'invariance configurationnelle, métrique et scalaire selon le sexe, le type de programme, la durée du stage et l'établissement, avant l'interprétation des estimations combinées de la MEE. |
Références
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.