Cette étude propose un modèle hybride de prévision des coûts pour les réseaux électriques qui combine des quotas de coûts physiques avec des ajustements dynamiques macroéconomiques et technologiques, ainsi qu'une compensation des résidus basée sur XGBoost. Atteignant une MAPE de 2,34 %, il équilibre précision et interprétabilité, répondant ainsi aux besoins de transparence réglementaire dans l'établissement des tarifs.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Prévision rétrospective utilisant des données de grille provinciales et un modèle hybride Physique-IA basé sur des quotas
Dans cet article
Résumé
Résumé
La transition énergétique mondiale et les réformes en cours sur les marchés de l'électricité obligent les entreprises de réseau électrique à concilier une fourniture d'énergie fiable avec des réglementations tarifaires de transport et de distribution de plus en plus strictes. Les méthodes traditionnelles de budgétisation fondées sur l'extrapolation historique reflètent souvent mal la base physique du fonctionnement des actifs, tandis que les modèles d'apprentissage automatique pilotés par les données atteignent une grande précision prédictive mais manquent de transparence nécessaire à la vérification réglementaire des coûts. Pour surmonter ce compromis entre précision prévisionnelle et interprétabilité, cette étude propose un modèle hybride de prévision des coûts basé sur des quotas de coût. Le cadre utilise des quotas opérationnels normalisés comme référence physique pour la budgétisation et intègre un mécanisme dynamique d'évolution des quotas piloté par les conditions macroéconomiques et les progrès technologiques. Le modèle Extreme Gradient Boosting (XGBoost) est utilisé pour capturer les résidus non linéaires échappant aux estimations fondées sur les quotas, tandis que la méthode SHAP (Shapley Additive exPlanations) permet d'interpréter la contribution des principaux facteurs de coût. Le modèle a été évalué à l'aide de 16 ans de données opérationnelles anonymisées provenant d'un réseau électrique provincial en Chine. Il a atteint une erreur moyenne absolue en pourcentage (MAPE) de 2,34 %, réduisant les erreurs de prévision de 61,8 %, 46,6 % et 34,1 % par rapport aux modèles SARIMAX, XGBoost seul et Attention-LSTM, respectivement. Le cadre proposé intègre les principes d'ingénierie des quotas de coût avec une intelligence artificielle explicative, offrant à la fois des prévisions précises des coûts à long terme et un outil de décision transparent pour la vérification réglementaire des coûts autorisés.
Introduction
La transition énergétique mondiale redéfinit la gestion des actifs du réseau électrique et les pratiques opérationnelles par l'intégration de la production décentralisée d'énergie renouvelable, l'augmentation des événements météorologiques extrêmes et le déploiement généralisé des technologies de l'Internet des objets, éléments qui exigent tous une plus grande flexibilité opérationnelle et davantage de ressources de maintenance afin d'assurer la fiabilité du système1,2. Parallèlement, les organismes de régulation de l'électricité ont renforcé la surveillance des tarifs de transport et de distribution à travers des cadres tels que le RIIO au Royaume-Uni et les examens du taux de rendement de la Federal Energy Regulatory Commission aux États-Unis, en mettant l'accent sur la transparence dans la justification des coûts3. La Chine a adopté de manière similaire un mécanisme réglementaire de « coût autorisé plus rendement raisonnable », exigeant des services publics qu'ils démontrent des liens clairs entre les activités d'ingénierie et les dépenses financières4. Toutefois, les services publics manquent souvent d'outils quantitatifs transparents reliant les opérations physiques des actifs aux prévisions de coûts, ce qui limite l'efficacité de la vérification réglementaire des coûts5.
Les approches prévisionnelles existantes présentent des limitations importantes dans ce contexte6. Les méthodes traditionnelles, notamment la budgétisation incrémentielle et les modèles basés sur ARIMA, supposent des tendances historiques relativement stables et donnent souvent de mauvais résultats en cas de changements structurels provoqués par des fluctuations économiques ou des conditions météorologiques extrêmes7. En revanche, les modèles modernes d'apprentissage automatique, tels que les architectures LSTM et Transformer, offrent une grande précision prédictive pour les prévisions à court terme, mais manquent de l'interprétabilité ingénierique nécessaire à la prise de décision réglementaire8,9. Bien que des approches hybrides récentes combinent des techniques statistiques et d'apprentissage automatique, elles négligent généralement les quotas normalisés de coûts d'ingénierie qui sont à la base des systèmes comptables des réseaux électriques10. Pour remédier à ces limites, cette étude propose un cadre prévisionnel hybride fondé sur les quotas, qui associe une évolution dynamique des quotas à une correction résiduelle basée sur l'apprentissage automatique, préservant ainsi l'interprétabilité ingénierique tout en améliorant la précision des prévisions.
Une importante direction de recherche découle de la régulation incitative dans les industries en monopole naturel, notamment le mécanisme RPI-X au Royaume-Uni et le cadre chinois de vérification des coûts autorisés11. Ces études évaluent principalement l'efficacité opérationnelle à l'aide de l'analyse par enveloppement des données (DEA) et de l'analyse stochastique de frontière (SFA)12. Des travaux antérieurs ont examiné les relations à long terme entre les dépenses en capital (CAPEX), les dépenses d'exploitation (OPEX) et l'efficacité des coûts afin d'appuyer la régulation tarifaire13,14. Bien que ces approches fournissent des aperçus macroéconomiques précieux, leurs résultats sont généralement exprimés sous forme de scores d'efficacité relative plutôt que de prévisions monétaires adaptées à la budgétisation annuelle15,16. En outre, les modèles de frontière supposent généralement des structures d'actifs physiques et des conditions d'exploitation relativement stables, ce qui limite leur capacité à capturer les changements brusques des coûts provoqués par le vieillissement du matériel, le remplacement des infrastructures ou une croissance rapide de la demande17,18.
Une deuxième direction de recherche s'intéresse aux modèles prévisionnels fondés sur la statistique et l'intelligence artificielle. Les premières études utilisaient la régression linéaire multiple et les modèles autorégressifs intégrés à moyenne mobile avec variables exogènes (ARIMAX) pour la prédiction des coûts19. Plus récemment, la régression par vecteurs de support, les forêts aléatoires, les modèles XGBoost, LSTM et Transformer ont nettement amélioré les performances prévisionnelles en exploitant les relations non linéaires et les espaces de caractéristiques en haute dimension20,21,22. Ces approches intègrent fréquemment des indicateurs macroéconomiques tels que la demande d'électricité, les indices des prix à la production (PPI) et des variables climatiques23. Toutefois, les coûts de fonctionnement du réseau électrique découlent d'activités d'ingénierie, de la détérioration des équipements, de la planification de la maintenance et de décisions de gestion, et non pas uniquement de variables macroéconomiques24. Par conséquent, les modèles purement basés sur les données agissent souvent comme des « boîtes noires », ce qui rend difficile l'explication des coûts prévus lors des examens réglementaires ou de la vérification des coûts autorisés25,26.
La gestion des quotas de coûts techniques offre une solution potentielle à ce défi27. La méthode de calcul des coûts par activité (ABC) s'appuie depuis longtemps sur des quotas opérationnels standardisés pour estimer les besoins en main-d'œuvre, en matériaux, en équipements et en maintenance pour les opérations courantes du réseau28. Les principales entreprises électriques chinoises ont élaboré des bases de données complètes couvrant les activités d'inspection, de maintenance, d'essai, de réparation et de remplacement d'équipements. Toutefois, ces normes techniques sont principalement utilisées pour le règlement des projets et les audits, plutôt que pour des prévisions dynamiques à long terme29,30. De plus, les normes de quotas ne sont généralement révisées que tous les quelques années, ce qui les rend insuffisamment réactives face à l'évolution des prix des matières premières, aux progrès technologiques et aux pratiques opérationnelles31. L'application de systèmes de quotas à des millions d'actifs distribués pose également des défis informatiques considérables pour les prévisions à grande échelle32.
Malgré des progrès significatifs dans la prévision statistique, l'apprentissage automatique et la gestion des coûts en ingénierie, aucun cadre existant n'intègre efficacement les quotas normalisés de coûts en ingénierie, l'ajustement dynamique de la macroéconomie et l'apprentissage automatique explicatif au sein d'un modèle unifié de prévision pour la vérification réglementaire des coûts. On a émis l'hypothèse que la combinaison de quotas de coûts en évolution dynamique avec un apprentissage résiduel fondé sur XGBoost pourrait améliorer la précision des prévisions à long terme tout en préservant la transparence technique requise pour la prise de décision réglementaire. Afin de tester cette hypothèse, un cadre hybride de prévision fondé sur les quotas a été développé, intégrant la modélisation physique des coûts, des mécanismes d'ajustement macroéconomique et technologique, une compensation résiduelle par XGBoost et une interprétation du modèle basée sur SHAP. L'approche proposée vise à fournir à la fois des prévisions précises des coûts à long terme et des preuves transparentes afin d'appuyer la vérification des coûts autorisés dans le cadre de la réglementation moderne des marchés de l'électricité.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude a utilisé des données opérationnelles et financières anonymisées, collectées auprès d'un réseau électrique provincial dans l'est de la Chine. Toutes les données ont été regroupées et désidentifiées avant l'analyse, et aucune information personnelle identifiable ou sensible au niveau individuel n'a été incluse. Par conséquent, une approbation éthique n'était pas requise. L'accès aux données et leur analyse se sont conformés aux réglementations applicables en matière de protection des données ainsi qu'aux accords institutionnels régissant les informations du secteur électrique.
Aperçu du cadre de prévision
Afin d'intégrer les approches prévisionnelles fondées sur la physique et celles basées sur les données, un cadre prévisionnel hybride a été mis au point, combinant les quotas de coûts d'ingénierie avec l'apprentissage automatique. Plutôt que de simplement combiner plusieurs algorithmes, ce cadre suit le principe selon lequel les modèles physiques établissent la prévision de base, tandis que l'apprentissage automatique compense les erreurs résiduelles. Cette conception garantit que le processus de prévision s'appuie sur les mécanismes physiques sous-jacents aux activités de production et d'exploitation du réseau électrique, plutôt que de se fonder uniquement sur une extrapolation historique des coûts.
Le cadre établit d'abord une correspondance hiérarchique entre les actifs du réseau électrique, les activités opérationnelles normalisées et les comptes de coûts financiers. Les coûts de production et d'exploitation sont considérés comme des représentations monétaires des ressources consommées par les actifs physiques — notamment les sous-stations, les lignes de transport, les alimentations de distribution, les dispositifs de mesure et l'équipement numérique d'inspection — lors d'activités courantes telles que l'inspection, la maintenance, les essais, les réparations et les remplacements. Les quotas de coût constituent le lien entre les charges de travail techniques mesurables et les dépenses financières correspondantes.
Comme illustré dans la Figure 1, les quotas de coût fonctionnent comme des unités comptables normalisées intégrées à l'ensemble du processus d'exploitation et de maintenance des actifs, plutôt que comme des règles abstraites d'allocation financière. Les charges de travail des actifs au niveau le plus bas sont converties en quotas opérationnels normalisés, puis associées à des catégories de coûts, notamment la main-d'œuvre, les matériaux, les équipements de construction, les services externalisés et les fournitures d'urgence. Ce mappage hiérarchique préserve l'interprétabilité technique et la traçabilité réglementaire tout au long du processus de prévision, et fournit la base physique pour la construction du modèle statique de quota de référence.
Aperçu du flux de travail méthodologique
Le cadre de prévision proposé comprend trois étapes séquentielles : (1) la construction d'une référence physique à partir de quotas de charge de travail par ressource, (2) l'évolution dynamique des quotas de coût par ajustements macroéconomiques et technologiques, et (3) une compensation des résidus fondée sur l'apprentissage automatique afin de capturer les effets non linéaires systématiques. Comme illustré dans Figure 1, le cadre établit une correspondance hiérarchique allant des ressources et activités opérationnelles normalisées de niveau inférieur jusqu'aux prévisions des coûts de production et d'exploitation. Les détails de mise en œuvre de chaque étape sont décrits dans les sous-sections suivantes.
Modèle de coût de base physique fondé sur les charges de travail au niveau des actifs
Le coût de production et d'exploitation d'un réseau électrique, Ctotal, comprend les dépenses associées à plusieurs activités commerciales, notamment l'exploitation des sous-stations, l'entretien des lignes de transport, la gestion du réseau de distribution, le service à la clientèle et les systèmes d'appui. Dans cette étude, on suppose que le coût d'exploitation de base est déterminé par la charge de travail générée par chaque activité opérationnelle normalisée et par son quota de coût correspondant.
Le coût de base statique est calculé comme suit :
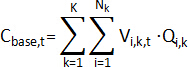 (1)
où Vi,k,t désigne la charge de travail associée à la i-ème ressource ou tâche opérationnelle dans la catégorie commerciale k pendant la période t, et Qi,k représente le coût unitaire normalisé correspondant défini par le système de quotas de coûts techniques. La catégorie commerciale inclut les principales fonctions opérationnelles telles que la maintenance des postes électriques, l'inspection des lignes de transport, l'exploitation du réseau de distribution et le service à la clientèle. La double sommation agrège les coûts de toutes les activités opérationnelles normalisées afin d'estimer la dépense théorique de base nécessaire au maintien d'un fonctionnement normal du réseau.
L'équation (1) établit la relation physique entre les charges de travail d'ingénierie et les dépenses financières en associant directement des activités opérationnelles normalisées à des comptes de coûts. Contrairement aux modèles prévisionnels purement statistiques, cette formulation fournit une référence d'ingénierie interprétable qui sert de fondement aux ajustements dynamiques ultérieurs des quotas et à la correction des résidus basée sur l'apprentissage automatique. Cette équation a été élaborée à partir des pratiques opérationnelles et du système de quotas de coûts utilisés par les entreprises provinciales de réseau électrique en Chine. Tableau 1 résume les notations utilisées dans l'équation (1), incluant la charge de travail (Vi,k,t), le coût unitaire normalisé (Qi,k), le nombre de tâches opérationnelles (Nk) et l'indice de catégorie d'activité (k).
Mécanisme d'évolution dynamique des quotas en cas de perturbations environnementales externes
Les quotas de coût standardisés (Qi,k) fournissent une référence interprétable sur le plan physique, mais ne tiennent pas compte des changements des conditions macroéconomiques ni des progrès technologiques. Afin d'améliorer leur pertinence à long terme, un mécanisme d'évolution dynamique a été introduit pour ajuster les quotas de référence en fonction à la fois de l'inflation des prix et des gains d'efficacité liés à la technologie.
Le premier ajustement tient compte des variations des coûts d'approvisionnement résultant de l'inflation macroéconomique. L'exploitation et la maintenance du réseau électrique dépendent fortement de matières premières en vrac, telles que le cuivre, l'aluminium et l'acier au silicium, dont les prix sont étroitement liés aux fluctuations de l'indice des prix à la production (IPP). Étant donné que  est un indice ayant une valeur de base de 100, il est d'abord converti en un taux d'inflation normalisé :
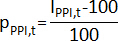 (2)
Sur cette base, la fonction de correction des prix  est définie comme suit :
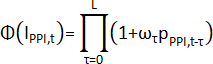 (3)
où  est un vecteur de poids retardé de longueur L satisfaisant
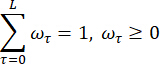
La structure de décalage représente la transmission différée de l'inflation macroéconomique aux coûts d'approvisionnement dans la chaîne d'approvisionnement du réseau électrique. La conversion de l'indice IPP en un taux d'inflation normalisé préserve l'effet cumulatif des variations de prix tout en évitant les biais d'échelle associés à l'utilisation directe des valeurs de l'indice. Les équations (2) et (3) sont adaptées de modèles établis de correction de l'inflation macroéconomique, la structure de décalage étant calibrée pour les cycles d'approvisionnement du secteur électrique33,34.
Les progrès technologiques ont été intégrés au moyen d’un facteur de réduction des coûts reflétant l'amélioration de l'efficacité opérationnelle résultant d'avancées telles que l'inspection par véhicules aériens sans pilote, la robotique intelligente et les technologies numériques de maintenance. Le facteur d'ajustement technologique est défini comme suit :
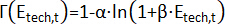 (4)
Dans cette partie, α et β sont des coefficients d'élasticité empiriques estimés à partir de données de panel historiques en utilisant la méthode des moindres carrés non linéaires. Afin de garantir que le facteur de progrès technologique représente toujours une réduction raisonnable du coût unitaire du quota, le processus d'estimation des paramètres impose la contrainte 0 < Γ(Etech,t) ≤ 1. Il convient de noter que ce facteur reflète principalement l'amélioration d'efficacité à long terme découlant du remplacement par des technologies matures. L'équation (4) est originale à cette étude, adaptant le concept de courbe d'apprentissage provenant de la littérature sur les coûts des technologies énergétiques35,36 aux opérations de maintenance du réseau. Les coûts supplémentaires pouvant survenir au stade initial du déploiement d'équipements numériques, tels que l'exploitation parallèle des anciens et nouveaux systèmes, l'intégration des plateformes, les tests de communication et la maintenance supplémentaire, ne sont pas déduits de force du quota de référence ; au lieu de cela, ils sont identifiés par le module ultérieur de compensation des résidus basé sur l'apprentissage automatique :
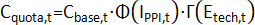 (5)
où Cbase,t désigne le coût de base statique calculé à partir des charges de travail des ressources de base et des quotas de coûts de fonctionnement standardisés ; capture l'effet de transmission des fluctuations macroéconomiques des prix sur les matériaux, l'équipement et les prix des services externes ; et Γ(Etech,t) reflète la réduction des coûts unitaires d'exploitation et de maintenance fondée sur l'efficacité après la maturation technologique. Grâce à ce mécanisme d'évolution dynamique, la référence de quota ne demeure plus sur une base comptable statique, mais peut s'ajuster de manière adaptative aux changements des environnements économiques et des conditions technologiques. L'équation (5) est originale à cette étude et représente l'intégration novatrice des corrections de prix et de technologie dans le cadre de référence des quotas.
Capture systématique des résidus non linéaires dans le cadre de contraintes de quota
Malgré des corrections évolutives complexes, le modèle de quota génère inévitablement des écarts systématiques lorsqu'il est confronté à des perturbations météorologiques imprévues liées à des catastrophes et à des directives politiques soudaines, telles que l'augmentation des coûts liés au traitement des réclamations des clients pendant les périodes de réduction temporaire des tarifs. Cet écart constitue le terme résiduel des deux côtés de l'équation :
Rt=Cactual,t-Cquota,t (6)
Étant donné que les règles physiques conventionnelles ne peuvent pas expliquer cet aspect, l'apprentissage automatique peut pallier ces limitations. Afin d'éviter le fléau de la dimensionnalité provoqué par des caractéristiques en haute dimension, cette étude utilise l'algorithme XGBoost, basé sur des ensembles d'arbres de décision, pour modéliser la relation non linéaire Rt37,38. Une matrice de caractéristiques fortes perturbations Xt, incluant des paramètres météorologiques tels que le nombre annuel de jours extrêmement froids Dice et l'intensité des politiques macroéconomiques, est définie.
Pour un compensateur non linéaire composé d'arbres de régression, la logique de génération du résidu prédit  peut s'exprimer comme suit39 :
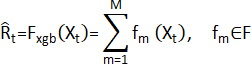 (7)
où F désigne l'espace de toutes les structures possibles d'arbres de classification et de régression. Afin d'équilibrer précision de l'ajustement et prévention du surajustement, une fonction objective régularisée contenant un terme de pénalité de complexité structurelle est construite et minimisée à la m-ième itération :
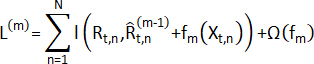 (8)
où  est une fonction de perte convexe mesurant l'écart entre le résidu réel et le résidu prédit. Cet article adopte la perte de Huber afin d'améliorer la robustesse du modèle face aux dépenses anormalement élevées. Le terme de régularisation
 est utilisé pour limiter la complexité de la structure de l'arbre et est défini par :
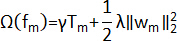 (9)
où Tm représente le nombre de nœuds feuilles dans l'arbre m-ième, wm représente le vecteur de poids correspondant des feuilles, et γ et λ désignent respectivement le coefficient de pénalité du nombre de nœuds feuilles et le coefficient de régularisation des poids.
L'équation finale de prévision est la suivante :
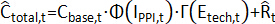 (10)
Étendu davantage comme suit :
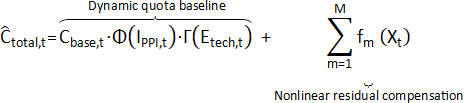 (11)
La formule ci-dessus représente mathématiquement la structure en boucle fermée du modèle de prévision proposé. La demande finale de coût de production et d'exploitation n'est pas directement générée par le modèle d'apprentissage automatique ; elle est plutôt obtenue en superposant la compensation résiduelle non linéaire identifiée par le module d'apprentissage automatique à la référence dynamique du quota. Parmi ces composantes, les facteurs de prix et de technologie reflètent principalement l'évolution dynamique de la référence du quota, tandis que les facteurs difficiles à caractériser explicitement par des règles, tels que les chocs climatiques, les perturbations politiques et les pics d'événements de réparation, sont captés par le module de compensation résiduelle basé sur l'apprentissage automatique. Les équations (10) et (11) sont originales à cette étude et combinent la référence physique avec la capture résiduelle fondée sur l'apprentissage automatique dans un cadre unifié de prévision.
Figure 2 montre que les résultats de prévision du modèle proposé présentent une logique claire de génération hiérarchique. D'une part, le quota de référence fournit une base physique stable, transparente et vérifiable pour la demande de coût ; d'autre part, les ajustements de prix, les effets technologiques et les résidus de chocs externes permettent au modèle de s'adapter aux changements dynamiques dans des environnements complexes. Contrairement aux modèles boîte noire qui produisent directement des valeurs prédites, cette structure de décomposition peut clairement révéler « pourquoi les coûts augmentent ou diminuent », renforçant ainsi l'interprétabilité des résultats du modèle dans le cadre de l'examen budgétaire et de la régulation des tarifs de transport et de distribution.
Sources de données et procédures de collecte
Les modèles théoriques doivent être rigoureusement validés par des données empiriques afin de démontrer leur utilité pratique. Étant donné que les données financières fondamentales du secteur électrique impliquent des informations sensibles liées au fonctionnement des infrastructures nationales, cette étude extrait des données comptables mensuelles précises et anonymisées provenant d'un réseau électrique provincial typique dans l'est de la Chine, désigné pour plus de commodité comme E-Grid, couvrant 16 années civiles consécutives allant de 2010 à 2025. Cette province a connu un cycle économique typique marqué par un passage d'une croissance tirée par les industries lourdes traditionnelles à une croissance axée sur la fabrication de haute technologie, le taux de croissance annuel composé de l'échelle des actifs du réseau atteignant 7,4 %. L'évolution complexe de sa structure de coûts présente donc une pertinence potentielle pour d'autres systèmes électriques en développement rapide. Les données proviennent de trois sources principales : (1) les journaux internes d'exploitation et de maintenance, enregistrant les charges de travail au niveau des actifs, les fréquences d'inspection et les interventions de réparation ; (2) les systèmes comptables financiers fournissant des états mensuels des coûts relatifs à la main-d'œuvre, aux matériaux, à l'équipement et aux services externalisés ; et (3) les bases de données environnementales externes, incluant les relevés météorologiques de l'Administration météorologique de Chine et les indicateurs macroéconomiques du Bureau national des statistiques.
Contrôle de qualité et traitement des données manquantes
Pour plus de 130 indicateurs initiaux intégrés à partir de systèmes multiples, une procédure rigoureuse de contrôle de qualité a été mise en œuvre. Les données manquantes, représentant moins de 3 % des observations totales, ont été traitées par interpolation linéaire pour les variables continues présentant des tendances temporelles, et par imputation par la valeur modale pour les indicateurs catégoriels. Les valeurs aberrantes ont été identifiées à l’aide de la méthode de l’intervalle interquartile (IIQ), les valeurs dépassant 3,0 fois l’IIQ au-dessus du troisième quartile étant winsorisées au 99e centile afin de préserver l’intégrité des données et d’atténuer la distorsion due aux valeurs extrêmes.
Considérations relatives à la taille de l'échantillon
Le jeu de données comprend 192 observations mensuelles (janvier 2010 à décembre 2025), dont 156 observations (2010–2022) attribuées à l'entraînement et à la validation, et 36 observations (2023–2025) réservées à des tests hors échantillon. Bien que cette taille d'échantillon soit relativement modeste pour des applications d'apprentissage profond, elle convient bien à l'algorithme XGBoost, spécifiquement conçu pour offrir de bonnes performances avec des jeux de données tabulaires de petite à moyenne taille grâce à ses mécanismes de régularisation et d'élagage des arbres. Afin d'atténuer les risques éventuels de surapprentissage, (1) des pénalités strictes de régularisation ont été appliquées (γ = 0,1, λ = 1,0), (2) un arrêt précoce avec une tolérance de 50 cycles a été mis en œuvre, et (3) des contraintes conservatrices sur la profondeur des arbres ont été imposées (profondeur maximale = 5). Ces mesures garantissent conjointement la stabilité du modèle et sa capacité de généralisation, malgré la taille limitée de l'échantillon.
Segmentation des données et intégration hétérogène multiprovenance
Pour un test rigoureux, les données de janvier 2010 à décembre 2022 ont été attribuées à l'intervalle d'apprentissage-validation, contenant 156 observations, qui sert à entraîner les facteurs d'évolution des quotas et le réseau résiduel de compensation des quotas. La période de janvier 2023 à décembre 2025 est réservée comme ensemble de test hors échantillon mis à part, comprenant 36 observations. Pourquoi cette période a-t-elle été choisie comme ultime banc d'essai ? La raison est que ces trois années coïncident avec l'accélération de la construction de systèmes électriques de nouveau type, amplifiée par des événements de haute température à grande échelle liés à un fort phénomène El Niño, ainsi qu'une croissance rapide et inégale de la production d'énergie renouvelable distribuée. Le réseau électrique a fait face à des pressions sans précédent en matière de chaînes d'approvisionnement matériel et d'allocation de la main-d'œuvre pour les réparations.
La sélection scientifique et la définition quantitative des facteurs déterminants des coûts constituent la base permettant de garantir que le réseau résiduel d'apprentissage automatique puisse efficacement capturer les fluctuations systématiques. En se fondant sur la logique de gestion des coûts opérationnels standards dans les systèmes électriques, cette étude franchit la dimension unique de la prévision financière traditionnelle, qui repose uniquement sur les flux de trésorerie historiques, et reconstruit plutôt l'ingénierie des caractéristiques à partir de quatre limites fondamentales : l'échelle des actifs physiques, les conditions d'exploitation et de maintenance, l'évolution macroéconomique et l'environnement climatique externe, en utilisant des journaux d'exploitation originaux et des comptes de systèmes externes. Dans le processus réel de modélisation, pour plus de 130 indicateurs initiaux issus de l'intégration de systèmes multiples, cette étude utilise des tests de corrélation de Pearson afin d'éliminer les variables redondantes fortement colinéaires, avec un seuil de |r| > 0,85. Sur la base des connaissances préalables d'experts chevronnés en réseaux électriques, 42 caractéristiques d'entrée fondamentales sont finalement sélectionnées pour former la matrice de caractéristiques Xt. Afin de présenter clairement la structure sous-jacente et la distribution du tenseur d'entrée, Tableau 2 sélectionne 12 caractéristiques fondamentales représentatives parmi les quatre dimensions d'évaluation ci-dessus et résume leurs statistiques descriptives sur la période d'observation.
Afin d'illustrer davantage la base spatiale et topologique du système de caractéristiques multipoints, Figure 3 présente une topologie schématique anonymisée du réseau électrique provincial étudié. La figure superpose les postes électriques par niveau de tension, les corridors de transport, les grappes de sources renouvelables distribuées, les centres de charge et des zones représentatives de perturbations environnementales. Cette topologie permet d'expliquer pourquoi les coûts de production et d'exploitation sont conjointement influencés par l'échelle des actifs, la structure du réseau, l'intensité des réparations d'urgence et les chocs climatiques externes. Elle fournit également une base d'interprétation spatiale pour les variables pilotes des résidus utilisées dans le module de compensation XGBoost.
Tableau 2 montre que les variables explicatives issues de différentes dimensions économiques présentent des formes statistiques nettement distinctes. Les variables relatives aux actifs physiques, représentant la dynamique endogène du développement des entreprises, telles que la capacité des postes électriques et la longueur des lignes, possèdent des écarts types relativement stables et des coefficients d’asymétrie concentrés entre 0,1 et 0,8. L’ensemble de leur structure de données suit approximativement une distribution normale, reflétant objectivement une caractéristique de développement stable du réseau électrique au cours du cycle de construction des infrastructures. En net contraste figurent, en bas du tableau, les variables météorologiques et les perturbations environnementales externes. Par exemple, le nombre cumulé de jours de température élevée atteignant le seuil d’alerte au cours des 90 derniers jours et l’indice d’impact des déclenchements de lignes présentent une asymétrie fortement orientée vers la droite, avec des coefficients d’asymétrie respectifs de 2,15 et 2,45. Cette distribution typiquement à queue lourde confirme un point critique objectif, impossible à ignorer dans l’exploitation et la maintenance réelles du réseau électrique : bien que les catastrophes météorologiques extrêmes soient relativement rares sur une échelle annuelle, une fois déclenchées, elles provoquent souvent des augmentations exponentielles des besoins en main-d’œuvre de réparation et en consommation de pièces de rechange. D’un autre point de vue, la forte hétérogénéité et l’asymétrie marquée vers les valeurs extrêmes dans la distribution de ces caractéristiques multiples révèlent les limites théoriques des modèles traditionnels de séries chronologiques linéaires, tels que ARIMAX, qui reposent sur les hypothèses de normalité et d’homoscédasticité lorsqu’ils tentent de modéliser les coûts complexes du réseau électrique. Ceci établit non seulement plus fermement la pertinence de l’introduction d’un module d’apprentissage automatique allant au-delà de la base comptable physique, mais fournit également un soutien statistique solide au choix, par cet article, du modèle arborescent XGBoost, capable de traiter efficacement les distributions creuses de caractéristiques et les applications non linéaires afin d’approcher les résidus de coût.
Configuration du système d'optimisation et d'évaluation des hyperparamètres
Après avoir déterminé l'espace d'entrée des caractéristiques, le réglage des hyperparamètres du modèle influence directement les performances d'ajustement du réseau d'approximation des résidus. Étant donné que le réseau de compensation XGBoost implique plusieurs paramètres, tels que la profondeur des arbres (max depth), le taux d'apprentissage et les termes de pénalité de régularisation, et que ces paramètres présentent des interactions non linéaires, la méthode classique de recherche en grille n'entraîne pas seulement une complexité calculatoire élevée, mais risque également de rester piégée dans des minima locaux dans des espaces de grande dimension. Par conséquent, cette étude introduit l'estimateur par densité de noyau structuré en arbre (Tree-structured Parzen Estimator, TPE), une méthode d'optimisation bayésienne, dans le processus d'ajustement des paramètres. L'algorithme TPE peut orienter dynamiquement les directions d'échantillonnage suivantes à l'aide des retours de la fonction de perte issus des évaluations précédentes. En construisant une estimation de la densité de noyau a posteriori (KDE) de la variable objective, il réduit de manière adaptative l'espace de recherche des paramètres, permettant ainsi au modèle de s'approcher de la configuration optimale globale des hyperparamètres sans coût calculatoire élevé. L'objectif d'optimisation TPE consistait à minimiser l'erreur quadratique moyenne (RMSE) sur l'ensemble de validation sur 100 itérations, avec arrêt précoce après 50 tours sans amélioration.
Après avoir terminé l'optimisation des paramètres sur le jeu de validation interne, afin d'évaluer objectivement la performance finale de chaque modèle sur le jeu de test hors échantillon et de répondre aux exigences quantitatives des régulateurs en matière de vérification des coûts, cette étude utilise l'erreur moyenne absolue en pourcentage (MAPE) pour quantifier l'écart relatif dans la séquence prédite. Parallèlement, afin de répondre au besoin pratique de contrôler les échecs extrêmes de prédiction des coûts dans les opérations, l'erreur quadratique moyenne (RMSE) est également introduite afin d'imposer des pénalités plus fortes aux erreurs plus importantes. Enfin, le coefficient de détermination, R2, quantifie le pouvoir explicatif global de la régression par rapport à la variance réelle de la cible.
Les définitions mathématiques des indicateurs sont les suivantes :
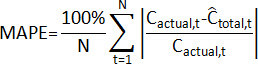 (12)
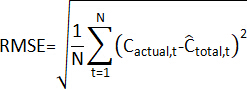 (13)
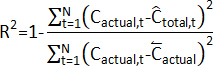 (14)
où  représente le coût réel de production et d'exploitation pendant la période t,
 représente le coût prédit par le modèle,
 représente le coût réel moyen dans l'échantillon de test, et N est le nombre d'échantillons dans l'ensemble de test.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Comparaison panoramique à dimensions réduites de la précision des prévisions
Lorsque tous les modèles optimisés par l'estimateur par zones parétiques (Tree-structured Parzen Estimator, TPE) ont été évalués sur le jeu de test hors échantillon 2023–2025, incluant les fluctuations liées à la reprise post-pandémique et les événements extrêmes de fortes températures, il a été possible de comparer objectivement la performance d'algorithmes courants de prévision. Afin d'effectuer une...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Cette étude démontre que l'intégration des quotas de coûts industriels avec l'apprentissage automatique fournit un cadre interprétable et précis pour la prévision à long terme des coûts du réseau électrique. Les résultats montrent que les variables liées au climat, en particulier les jours de températures extrêmement élevées et les indices d'impact des déclenchements de ligne, sont les facteurs prédominants des résidus de coût, soulignant l'influence croissante des perturbations externes sur les dépenses des services pub...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Tous les auteurs déclarent ne pas avoir de conflits d'intérêts.
CONTRIBUTION DES AUTEURS :
Xiaohui Wang a conçu et planifié l'étude, développé la méthodologie, effectué l'analyse formelle et rédigé le manuscrit initial. Tong Li a contribué à la gestion des données, à la mise en œuvre logicielle et à la validation. Yanchao Lu a contribué au développement de la méthodologie, à l'investigation et à l'interprétation des données. Quanfeng Lv a fourni les ressources, supervisé l'acquisition des données et relu de manière critique le manuscrit. Fan Liu a supervisé le projet, contribué à la conceptualisation et à l'interprétation des résultats, obtenu le financement et révisé de manière critique le manuscrit. Tous les auteurs ont examiné et approuvé la version finale du manuscrit.
Remerciements
Ce travail a été soutenu par le projet technologique de la State Grid Corporation of China, intitulé « Recherche sur l'analyse de l'allocation des coûts de production et d'exploitation et sur la technologie d'optimisation asynchrone » (numéro de projet : 520600250029-183-ZN).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Jeu de données comptables mensuelles anonymisées E-Grid | Réseau électrique provincial de Chine orientale | N/A | Jeu de données anonymisées sur les coûts mensuels de production et d'exploitation (2010–2025) comprenant 192 observations, incluant des données sur les actifs physiques, la maintenance, les données macroéconomiques et environnementales. Utilisé pour le développement du modèle (156 observations) et les tests hors échantillon (36 observations). |
| Bibliothèque de tracé Matplotlib | Équipe de développement de Matplotlib | 3.5.2 | Utilisée pour générer les figures du manuscrit et les sorties graphiques, notamment les graphiques de performance du modèle, les visualisations de topologie, les diagnostics des résidus, les graphiques radars et les résumés visuels liés à SHAP. |
| Bibliothèque de calcul numérique NumPy | Développeurs de NumPy | 1.22.3 | Utilisée pour les opérations sur tableaux numériques, les calculs matriciels et le contrôle de la reproductibilité. Une graine aléatoire fixe de 42 a été appliquée lorsque pertinent. |
| Bibliothèque de manipulation de données Pandas | Équipe de développement de pandas | 1.4.2 | Utilisée pour l'importation, l'intégration, la restructuration, le filtrage et le prétraitement des données, notamment l'imputation des valeurs manquantes, l'alignement des séries temporelles et la préparation des variables d'entrée du modèle. |
| Environnement de programmation Python | Fondation Python Software Foundation | 3.9.13 | Environnement de programmation utilisé pour implémenter l'ensemble du flux de travail de prévision, incluant le prétraitement des données, l'ingénierie des caractéristiques, l'entraînement du modèle, l'optimisation des hyperparamètres, la prédiction, les tests statistiques et l'évaluation des performances. |
| Bibliothèque d'apprentissage automatique Scikit-learn | Contributeurs de scikit-learn | 1.0.2 | Utilisée pour le prétraitement des données, la séparation entraînement-validation, l'évaluation de modèles auxiliaires et les procédures statistiques, notamment l'analyse de corrélation de Pearson et le calcul de métriques de performance sélectionnées. |
| Bibliothèque de calcul scientifique SciPy | Contributeurs de SciPy | 1.9.0 | Utilisée pour les calculs statistiques, notamment l'analyse de corrélation de Pearson et les procédures d'appui pour le traitement des valeurs aberrantes et la winsorisation. |
| Implémentation de l'estimateur par noyaux de Parzen structuré en arbre | Contributeurs d'Optuna | 3.1.0 | Implémentation d'optimisation bayésienne utilisée pour ajuster les hyperparamètres de XGBoost, notamment la profondeur maximale des arbres, le taux d'apprentissage et les paramètres de régularisation. L'estimateur par noyaux de Parzen structuré en arbre a été implémenté via le package open source Optuna. |
| Bibliothèque logicielle XGBoost | DMLC / Contributeurs de XGBoost | 1.7.1 | Bibliothèque d'apprentissage ensembliste basée sur les arbres de décision utilisée pour la compensation non linéaire des résidus. Le modèle implémente une fonction objective régularisée avec une perte de Huber et des pénalités de complexité des arbres, comme décrit dans les équations 7–9. |
Références
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.