Cet article étudie un algorithme d'optimisation de planification dynamique qui intègre le modèle Transformer et l'apprentissage par renforcement PPO, en se concentrant sur les conflits fréquents liés aux ressources et les retards de réponse dans la planification des activités syndicales.
Article de recherche
Algorithme de planification dynamique et d'optimisation des ressources pour les activités syndicales par l'intégration d'un Transformer et de l'apprentissage par renforcement
Dans cet article
Résumé
Résumé
Pour résoudre le problème de la baisse d'efficacité organisationnelle causée par les conflits fréquents d'allocation des ressources et les retards dans les réponses de planification lors de la gestion des activités syndicales, cet article propose un algorithme de planification dynamique intégrant le modèle Transformer et l'optimisation de politique proximale (PPO, Proximal Policy Optimization). Dans la mise en œuvre concrète, une structure de modélisation unifiée des scénarios de planification est d'abord conçue afin de convertir les états des activités, du personnel et des ressources en entrées tensorielles, permettant ainsi une intégration multidimensionnelle des contraintes. Ensuite, le mécanisme d'attention multi-têtes du modèle Transformer est utilisé pour encoder les séries temporelles des demandes d'activités passées et l'état des ressources, extraire des caractéristiques spatiotemporelles multidimensionnelles et améliorer la détection des risques de conflit. Par la suite, à partir des résultats du codage et du réseau de stratégie PPO, des actions de planification sont générées à partir de l'état actuel afin d'améliorer l'adaptabilité de la stratégie à des environnements complexes. Enfin, grâce à un mécanisme de mise à jour avec élagage et de correction de la fonction d'avantage, la stabilité de la stratégie durant les itérations ainsi que la performance améliorée de la planification sont garanties. Les expériences ont montré que, pour une densité de tâches de 1000, le temps moyen de décision de l'algorithme de planification est de 0,72 s et son délai de réponse moyen est de 1,59 s, indiquant une grande rapidité de réponse et une efficacité décisionnelle élevée. Sur sept types d'activités et niveaux de complexité, le taux de conflit des ressources se situe entre 0,05 et 0,12 ; le taux moyen d'utilisation des ressources varie de 0,75 à 0,86 ; et l'indice de stabilité de la planification est compris entre 0,8 et 0,91, réduisant ainsi efficacement les conflits fréquents d'allocation des ressources et assurant une grande stabilité de la planification. Dans des conditions de forte concurrence, les indices d'équilibre des ressources et de robustesse du transfert de stratégie atteignent respectivement 0,88 et 0,85, ce qui témoigne d'une bonne adaptabilité aux charges de tâches concurrentes.
Introduction
Les activités syndicales impliquent une planification complexe de multiples tâches et ressources, ce qui exige du système des capacités de réponse dynamique efficaces1,2. Les exigences liées aux activités changent fréquemment, et la répartition des ressources humaines et des lieux est complexe, ce qui peut facilement entraîner des conflits de planification et un gaspillage des ressources3,4. La capture précise de l'historique des activités et de l'état actuel des ressources, ainsi que l'amélioration de la capacité à identifier et à répondre aux conflits potentiels, sont essentielles pour renforcer l'efficacité opérationnelle de l'organisation5,6. L'intégration de technologies avancées de modélisation de séries chronologiques et d'algorithmes d'apprentissage par renforcement permet une compréhension approfondie et une optimisation intelligente dans des environnements de planification complexes, contribuant ainsi à maximiser l'utilisation des ressources, à accélérer la réactivité de la planification et à favoriser la modernisation intelligente de la gestion des activités syndicales.
Cependant, les approches de planification existantes utilisées en pratique sont largement basées sur des règles et statiques, ce qui les empêche de s'adapter aux changements fréquents des tâches et aux fluctuations des ressources, entraînant souvent des temps de réponse prolongés et de graves conflits de ressources. Dans la planification des activités syndicales, les types de tâches sont très variés ; l'utilisation des ressources est fortement contrainte et change fréquemment ; et les dépendances entre les activités ainsi que la compétitivité entre les ressources constituent une carte de planification complexe7,8. En pratique, l'horaire des activités ne peut pas être efficacement aligné avec les fenêtres temporelles disponibles des ressources telles que le personnel et les lieux9,10, et des conflits surviennent fréquemment, affaiblissant la cohérence globale des opérations organisationnelles11,12. Le système de planification ne fait pas face à un seul objectif d'optimisation, mais plutôt à un équilibre entre plusieurs indicateurs multidimensionnels, tels que la minimisation des conflits de ressources, la maximisation de la rapidité de réponse, la stabilité de la stratégie de planification et le taux d'achèvement des tâches13,14, ce qui présente des caractéristiques typiques d'optimisation multi-objectif. De plus, les activités syndicales présentent des phases et des cycles bien définis, et les stratégies de planification doivent s'adapter dynamiquement aux structures changeantes de demande de ressources au cours des différentes étapes des tâches. Des plans statiques générés une fois pour toutes ne peuvent pas supporter un environnement d'exécution soumis à des changements fréquents15,16. La logique de planification existante ne permet pas une exploration approfondie du comportement historique des tâches ni des motifs d'évolution de l'état des ressources. Elle est incapable de fournir des prévisions précises et des déductions stratégiques pour l'avenir17,18. La stratégie de planification du système réagit lentement aux tâches imprévues et aux changements temporaires des ressources, ce qui affecte la durabilité globale de l'opération19,20. La conception d'un système de planification doté de prédictibilité, de flexibilité et de stabilité est devenue une exigence technique clé dans les applications pratiques. Cela exige du modèle des capacités de perception d'informations en haute dimension, de mémoire séquentielle et de transfert stratégique, ainsi que la capacité de maintenir une prise de décision robuste et un équilibre des ressources dans un environnement multi-tâches, permettant ainsi une coordination intelligente et optimale de la planification des activités syndicales.
De nombreuses études ont proposé diverses solutions au problème de planification dynamique. Parmi celles-ci, la combinaison de l'apprentissage profond et de l'apprentissage par renforcement a montré une forte adaptabilité et des capacités d'optimisation. Certains chercheurs utilisent le LSTM (Long Short-Term Memory)21,22 pour modéliser des données chronologiques et combinent des stratégies d'apprentissage par renforcement afin d'optimiser le comportement de planification, obtenant ainsi des résultats satisfaisants. Un autre type de recherche s'appuie sur une méthode heuristique fondée sur un algorithme glouton, mettant l'accent sur la simplicité et l'efficacité des décisions de planification, ce qui convient aux scénarios aux règles bien définies23,24. D'autres études ont exploré l'application du réseau Q profond (DQN) à la planification, améliorant les stratégies grâce à l'approximation de la fonction de valeur25,26. Toutefois, ces méthodes présentent des problèmes tels qu'une capture insuffisante des dépendances à long terme, des mises à jour de stratégie instables et des délais de réponse importants lorsqu'elles sont confrontées à des scénarios d'activités syndicales complexes et changeants, ce qui rend difficile la satisfaction des besoins de planification liés à des tâches denses et variées. Par conséquent, la conception d'un algorithme de planification doté de capacités efficaces d'extraction de caractéristiques et de mises à jour stables de la stratégie est devenue un verrou qu'il convient de lever dans la recherche actuelle.
Dans la recherche sur l'ordonnancement multi-domaines, l'architecture Transformer a été appliquée à diverses tâches de prédiction de séries chronologiques et d'optimisation de l'ordonnancement, grâce à son mécanisme d'auto-attention multi-têtes, qui capture efficacement les dépendances temporelles à long terme27,28. Lorsqu'elle est combinée à l'algorithme PPO dans l'apprentissage par renforcement, la stratégie est mise à jour de manière stable et efficace en tronquant la fonction objectif, et cette approche a montré de bonnes performances dans des domaines tels que la commande robotique et la fabrication intelligente29,30,31. Certaines études ont tenté d'intégrer le Transformer à l'apprentissage par renforcement pour l'ordonnancement complexe des ressources32. Toutefois, dans l'ordonnancement dynamique des activités syndicales, peu d'études abordent la combinaison de types d'activités variés et de contraintes complexes de ressources. Certaines études ont utilisé des réseaux neuronaux graphiques pour modéliser les relations entre les ressources et les tâches, améliorant ainsi la précision de l'identification des conflits33,34. Certains chercheurs ont optimisé l'ordonnancement des ressources selon l'informatique en périphérie afin d'améliorer l'efficacité et les performances du modèle35,36. Toutefois, ces méthodes possèdent encore des capacités limitées de modélisation du contexte temporel. Sur la base de cela, cet article propose d'utiliser un Transformer pour encoder les séquences historiques des états des activités et des ressources, combiné à un réseau politique PPO, afin d'atteindre une perception élevée des risques de conflit et une mise à jour stable des stratégies d'ordonnancement face aux besoins changeants et complexes de l'organisation des activités syndicales.
Des études plus récentes ont exploré l'optimisation de la planification des ressources sous différents angles, tels que la consolidation des machines virtuelles pour une meilleure efficacité énergétique dans le calcul en nuage37, les algorithmes d'authentification dans les réseaux cellulaires38, la consolidation améliorée des machines virtuelles avec migration à chaud pour un calcul en nuage durable39, l'optimisation du trafic à l'aide de la prédiction d'attente et d'algorithmes évolutifs40, et le stockage dans le cloud basé sur la blockchain avec une optimisation renforcée et la préservation de l'intégrité41. Bien que ces travaux apportent des perspectives précieuses sur l'allocation des ressources et les algorithmes d'optimisation, ils ciblent principalement les infrastructures cloud, les télécommunications ou les systèmes de stockage, et ne prennent pas spécifiquement en compte les contraintes liées à plusieurs types d'activités, les conflits dynamiques entre personnel et lieux, ni les exigences de planification en temps réel inhérentes à la gestion des activités syndicales. Cette distinction souligne davantage la nécessité d'un cadre de planification dédié, adapté au contexte organisationnel des activités syndicales.
Les méthodes d'ordonnancement existantes pour les activités syndicales échouent souvent à capturer les dépendances spatiotemporelles à long terme et à maintenir une stabilité des politiques face à des changements dynamiques, ce qui entraîne des temps de réponse lents et de nombreux conflits de ressources. Pour combler ces lacunes de recherche, cette étude propose un modèle d'optimisation d'ordonnancement fondé sur le principe selon lequel l'attention multi-tête de l'architecture Transformer peut efficacement encoder des séquences historiques afin de prédire les conflits, et que l'optimisation de politique par proximité (Proximal Policy Optimization, PPO) avec un objectif tronqué garantit des mises à jour de politique stables et adaptatives. Plus précisément, le Transformer est utilisé pour encoder les séquences d'état des activités et des ressources, extrayant ainsi des caractéristiques spatiotemporelles clés afin d'améliorer la prévision des conflits, tandis que le PPO est combiné pour générer efficacement des actions d'ordonnancement et assurer des mises à jour stables. Une matrice de contraintes unifiée est conçue pour associer activités, personnel et lieux, améliorant ainsi la reconnaissance des dépendances complexes. Les principales innovations de ce travail sont : (1) l'intégration du codage temporel et de l'apprentissage par renforcement spécifiquement conçue pour l'ordonnancement des activités syndicales ; (2) un mécanisme d'attention sensible aux conflits qui privilégie la perception des risques ; et (3) une mise à jour par élagage accompagnée d'une correction de la fonction d'avantage afin d'assurer la robustesse de la stratégie en cas de forte concurrence. De nombreuses expériences menées sous diverses densités et complexités de tâches valident la supériorité du modèle par rapport aux méthodes existantes en termes de rapidité de réponse, d'utilisation des ressources et de stabilité, offrant ainsi une solution intelligente d'ordonnancement pratique et évolutible pour la gestion des activités syndicales.
Protocole
Figure 1 montre la structure d'un système de planification des activités syndicales intégrant la modélisation de séries temporelles et l'apprentissage par renforcement. La couche d'entrée intègre les plannings d'activités, la disponibilité des ressources et les informations relatives aux fenêtres temporelles du personnel, puis construit une matrice multidimensionnelle de relations de conflit tâche-ressource au moyen du module de graphe de contraintes. Le transformeur effectue un encodage par attention multi-têtes sur la séquence historique des états des activités et des ressources, produisant des états cachés dotés de dépendances temporelles. Le module de politique utilise les résultats d'encodage pour générer des distributions d'actions et une estimation d'état, puis exécute les décisions de planification après échantillonnage des actions. Les résultats d'exécution sont réinjectés dans l'environnement, mettant à jour l'état des ressources et générant des récompenses immédiates. Sur cette base, le module d'optimisation construit une fonction objectif tronquée, évalue la fonction d'avantage et corrige l'estimation du réseau de valeur afin de limiter la dérive de la politique et assurer des mises à jour stables des comportements de planification. Une boucle fermée de données est formée entre les modules, permettant une perception hautement sensible des conflits de ressources et des mises à jour adaptatives de stratégie dans des environnements dynamiques, améliorant ainsi la capacité de réponse intelligente et l'efficacité d'allocation des ressources du système de planification des activités syndicales dans des scénarios multi-tâches et fortement contraints.
Modélisation de scénarios de planification des activités syndicales
Toutes les demandes d'activités dans le système de planification sont organisées en séquences de planification discrètes basées sur des pas de temps. Chaque activité est définie par des heures de début et de fin précises, des catégories de ressources, des étapes et des niveaux de priorité. L'état d'utilisation du site est modélisé sous la forme d'une matrice bidimensionnelle d'intervalles temporels, où l'axe horizontal représente l'unité de temps normalisée et l'axe vertical représente le numéro de ressource spatiale. L'état des ressources est indiqué comme disponible ou occupé, formant une carte initiale de répartition des ressources à structure statique. Les informations de planification du personnel sont étendues dans la dimension temps-identité afin de construire un vecteur temporel continu, chacun enregistrant l'état de disponibilité des tâches du personnel et le numéro de département. Toutes les informations d'entrée sont intégrées dans une structure tensorielle tridimensionnelle, où désigne le pas de temps discret, le nombre d'entités de ressources, et le code d'attribut d'utilisation de la ressource correspondant (par exemple, si elle est occupée, le numéro d'activité, la priorité d'utilisation, etc.). Cette structure permet au système de planification de lire la configuration des ressources à tout moment, garantissant ainsi une représentation unifiée des différents types d'état des ressources.
Une fois que les informations de la tâche sont associées au modèle, le vecteur d'intensité de la tâche est défini en fonction de la priorité de l'activité et de la période d'utilisation des ressources. Les combinaisons de tâches pouvant entraîner un conflit sont marquées à l'aide de la méthode de détection du chevauchement des fenêtres temporelles. Les combinaisons en conflit sont converties en ensembles de nœuds, et des ensembles d'arêtes sont construits selon les types et périodes de ressources partagées afin de représenter explicitement les dépendances implicites. Le graphe de tâches final construit contient des informations limites sur la séquence temporelle, le chevauchement des ressources ou les conflits de contraintes, fournissant ainsi une base structurelle pour la détection ultérieure des conflits et la génération de stratégies d'ordonnancement. Cette structure conserve la nature dynamique de l'ordonnancement des tâches et les changements continus de l'état des ressources, tout en permettant la perception en temps réel des modifications des contraintes d'ordonnancement.
La détection de conflits utilise les régions partiellement superposées des dimensions temporelle et des ressources dans la structure tensorielle comme conditions initiales de jugement. Elle met en œuvre un traitement d'encodage statique des relations pour les paires de tâches dont les objectifs de planification se chevauchent. Elle construit une structure de graphe G=(V,E,C), où V représente l'ensemble des nœuds actifs, E représente les arêtes générées en fonction des conflits de ressources, et C est la matrice d'encodage des poids de conflit pour les arêtes. La fonction de poids de conflit est définie sous la forme suivante :
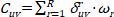 (1)
Parmi eux, Cuv est le poids de conflit entre les activités u et v ; u, v sont des indices d'activités ; R est le nombre total de types de ressources ; δuvr ∈ {0,1} indique si les fenêtres temporelles des activités u et v se chevauchent sur la ressource r ; ωr est le poids de sensibilité au conflit de la ressource r. Cette fonction effectue une somme pondérée des intensités de conflit, tenant compte des différences d'importance des conflits de ressources pour les résultats d'ordonnancement, tout en conservant une expression quantifiable de la répartition de l'intensité des conflits.
La structure du graphe de conflit ci-dessus est convertie en une matrice de contraintes à l’aide d’une représentation matricielle creuse. Chaque élément de la matrice contient le degré de conflit de ressource. La matrice est intégrée au processus de décision d’ordonnancement afin de déterminer si des tâches peuvent être planifiées en parallèle, tandis que la logique de protection par action se trouve dans le réseau de politique. Pour faire face à l’agrégation périodique des activités et aux rafales de tâches à haute densité, un mécanisme de mise à jour dynamique est mis en œuvre afin de surveiller les changements d’état des tâches et de modifier le contenu de la matrice en temps réel lorsque des ressources sont libérées ou ajoutées, garantissant ainsi la continuité et la cohérence de la limite d’ordonnancement tout au long de l’évolution des tâches.
L'application de cette structure de graphe de conflit permet au système d'ordonnancement de modéliser visuellement les goulots d'étranglement potentiels des ressources et les schémas de chevauchement des tâches, améliorant ainsi l'efficacité de l'analyse de découplage du réseau de décision dans des scénarios de contraintes complexes. Le comportement d'ordonnancement ne repose plus sur une correspondance logique basée sur des règles. Il cherche plutôt le chemin optimal dans l'espace des contraintes, renforçant la capacité à équilibrer dynamiquement les conflits locaux de ressources avec la carte globale des tâches. Le système peut maintenir la stabilité de l'ordonnancement et la cohérence des tâches dans un environnement où les ressources fluctuent et où les tâches sont fréquemment ajoutées ou supprimées.
Figure 2 montre un diagramme de structure de réseau basé sur la relation de poids des conflits de tâche. Chaque nœud de la figure représente une tâche à planifier, et les lignes entre les nœuds indiquent des conflits d'utilisation des ressources. L'épaisseur de l'arête reflète l'importance du conflit. Plus le conflit est grave, plus la ligne est épaisse. Le calcul du poids intègre le chevauchement des ressources et combine la sensibilité au conflit des différentes ressources afin de former une intensité composite de conflit entre les tâches. La structure du graphe révèle que certaines tâches forment des zones fortement connectées, indiquant une concurrence importante pour l'utilisation des ressources. Ce type de phénomène d'agrégation locale des conflits constitue la source principale des goulots d'étranglement de ressources et des retards de tâches dans le processus de planification, et l'algorithme de planification peut ainsi définir des cibles prioritaires de médiation. L'agencement des nœuds utilise une stratégie de disposition par force dirigée afin de regrouper automatiquement les tâches à haut conflit, permettant au système de planification d'identifier les groupes de tâches clés et d'optimiser la répartition des stratégies, renforçant ainsi la cohérence globale de la planification et la coordination des ressources.
Encodage de la séquence d'états historiques
À partir du graphe de conflit construit et de la matrice de contraintes, l'étape suivante consiste à encoder les séquences historiques d'activités et les états des ressources, afin d'extraire les motifs temporels sous-jacents à ces contraintes pour la prise de décision ultérieure. Les informations fondamentales du scénario de planification comprennent les demandes d'activités, les changements d'état des ressources et les enregistrements de retour sur les tâches. Ces informations constituent plusieurs séries chronologiques hétérogènes, correspondant à des attributs tels que les instants des événements, les identifiants d'utilisation des ressources et l'état d'exécution des activités. Afin d'unifier la structure de traitement, chaque type d'entrée est encodé sous forme de séquences vectorielles de longueur égale, et un indice temporel unifié est établi afin d'assurer l'alignement des états sous synchronisation temporelle. L'unité d'entrée à chaque instant est représentée par la concaténation de trois ensembles de vecteurs caractéristiques : le vecteur caractéristique d'activité représente le type de tâche, la priorité et le numéro d'étape ; le vecteur caractéristique de ressource enregistre l'occupation actuelle de la ressource, la capacité restante et la position de la fenêtre disponible ; le vecteur caractéristique de retour indique si la tâche a été exécutée sans problème au moment précédent, et si un conflit de ressource ou un événement de retard s'est produit.
Toutes les caractéristiques sont transformées linéairement et projetées dans un espace de même dimension pour obtenir une matrice d'incorporation normalisée X ∈ ℝT×d, où T représente le nombre d'instants temporels et d la dimension d'incorporation unifiée. Afin de préserver la structure temporelle, la matrice d'entrée est ajoutée élément par élément à la matrice de codage de position P afin de former l'entrée prenant en compte la position :
Z = X + P (2)
Z est la séquence d'entrée finale, qui sert d'entrée au mécanisme d'attention suivant. La conception du codage de position utilise un modèle fixe de fonctions sinus et cosinus afin d'éviter toute fuite d'information future et de garantir le respect strict des contraintes causales durant le codage. La structure ci-dessus permet au modèle de percevoir simultanément les caractéristiques de la tâche, l'état des ressources et la position temporelle. Elle dispose d'une base de mémoire d'état complète, offrant une structure unifiée à haute résolution pour le mécanisme d'attention ultérieur.
Le module d'attention traite la séquence d'entrée afin de capturer les relations potentielles entre plusieurs pas de temps. Plusieurs groupes de têtes d'attention sont utilisés pour traiter la séquence séparément, renforçant ainsi la sensibilité du modèle à différents types de trajectoires d'évolution d'état. Chaque tête d'attention génère à partir de la séquence d'entrée une matrice de requête Q, une matrice de clé K et une matrice de valeur V, calcule la matrice de distribution des poids et produit une représentation pondérée. La sortie d'une attention à une seule tête est la suivante :
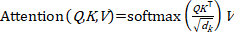 (3)
dk est le nombre de dimensions de caractéristiques par tête. Dans cette formule, QK⊤ représente la similarité entre instants, √dk est utilisé pour assurer la stabilité numérique, et la fonction softmax garantit la normalisation des poids. Différentes têtes d'attention se concentrent sur différentes combinaisons d'instants, et les dépendances dynamiques qu'elles capturent sont également variées, aidant ainsi à révéler des règles implicites telles que les prédicteurs de conflits de tâches, les schémas de consommation de ressources et les tendances anormales de rétroaction.
Les sorties de toutes les têtes d'attention sont concaténées puis transmises à travers une couche de transformation linéaire afin de générer une séquence de codage unifiée, qui sert d'entrée d'état au réseau de génération de stratégie d'ordonnancement. Cette séquence intègre la trajectoire comportementale de la tâche, les caractéristiques des variations des ressources et l'impact des écarts d'exécution précédents dans la fenêtre d'ordonnancement actuelle, résolvant ainsi efficacement le problème de la forte dépendance historique dans le comportement d'ordonnancement et de l'expression clairsemée des caractéristiques. Des modules de connexion résiduelle et de normalisation de couche sont intégrés à la couche de sortie du codeur afin d'améliorer la stabilité de l'apprentissage et les capacités de rétention de l'expression dans le réseau profond.
La séquence d'états cachés en sortie conserve non seulement l'information sur l'évolution temporelle, mais réagit également aux changements résultant de tâches soudaines ou de déséquilibres temporaires des ressources, démontrant ainsi une forte adaptabilité. Cette conception structurelle évite la définition explicite de règles, permet une modélisation structurée d'environnements d'ordonnancement dynamiques et soutient les modules de politique ultérieurs dans la génération de solutions d'ordonnancement assurant une cohérence globale et une adaptabilité locale dans des conditions multi-objectifs.
Génération de stratégies de planification dynamique
Les séquences d'états cachés encodées, qui intègrent à la fois les dépendances temporelles et les informations relatives aux conflits de ressources, sont ensuite transmises au réseau de politique afin de générer des actions d'ordonnancement adaptées à l'environnement courant. La séquence d'états cachés produite par le module de codage est utilisée comme entrée pour le réseau de stratégie de planification. L'ensemble des vecteurs d'état à chaque instant constitue l'expression courante de l'observation de l'environnement, reflétant l'évolution des caractéristiques des tâches, des tendances d'utilisation des ressources et des trajectoires de rétroaction historiques. La dimension de la représentation d'état et la longueur de la fenêtre temporelle sont fixes, et la continuité des changements d'état est capturée par un mécanisme de mise à jour glissante. Avant qu'il ne soit transmis au réseau de politique, le vecteur d'état est normalisé et réorganisé au niveau des caractéristiques afin de garantir que l'entrée conserve une distribution numérique stable dans l'espace de grande dimension, réduisant ainsi les explosions de gradient et les fluctuations de convergence.
La structure du réseau de politique utilise un module de sortie à deux branches, dont l'une génère la distribution des actions et l'autre produit une estimation de la fonction de valeur d'état. L'espace des actions comprend toutes les tâches planifiables et les ressources allocables. Le mécanisme de sélection des candidats élimine les combinaisons d'opérations illégales ou redondantes afin de former un ensemble d'actions limité et licite. La branche de politique produit une distribution de probabilité π(at|st), où at représente l'action de planification à l'instant donné, et st correspond à l'état courant en entrée. Une stratégie d'échantillonnage gaussien normalisé ou d'échantillonnage softmax est utilisée pour sélectionner des actions à partir de cette distribution afin de procéder effectivement au planification. L'autre sortie est l'estimation de la fonction de valeur d'état, qui représente l'espérance de récompense à long terme dans l'état donné et qui sert à l'évaluation et à la mise à jour de la politique.
Dans le réseau de politique, la couche cachée applique des fonctions d'activation et une normalisation par lot afin d'améliorer l'expressivité non linéaire et d'accélérer la convergence du réseau. Dans le processus de prise de décision, la priorité d'exécution, le coût de planification des ressources et les performances historiques des différentes tâches sont considérés comme des facteurs d'attention et intégrés au mécanisme de sélection d'action au moyen d'une matrice de poids spécifique, formant ainsi un cadre de sortie de politique ajustable de manière adaptative. Cette conception évite de dépendre de règles fixes, renforçant ainsi la flexibilité de la stratégie face aux conflits soudains et aux goulots d'étranglement structurels.
La stratégie de planification utilise un mécanisme d'échantillonnage aléatoire pour générer la séquence d'actions réelle. À chaque cycle de planification, une action exécutable est échantillonnée à partir de la distribution d'actions courante, puis l'état des ressources et la marque du nœud de tâche sont mis à jour. Une fois l'action exécutée, le système calcule une récompense de retour immédiat en fonction des changements de ressources et des résultats d'avancement de la tâche, afin de mesurer l'impact de ce cycle de planification sur l'objectif global. La conception de la récompense prend en compte plusieurs dimensions, notamment le taux d'achèvement des tâches, l'efficacité d'utilisation des ressources et le degré de suppression des conflits. Elle fournit un retour au module de mise à jour de la stratégie au moyen d'indicateurs complets.
L'ensemble du processus de planification construit une chaîne de décision markovienne et utilise la méthode d'échantillonnage de trajectoire empirique pour enregistrer la séquence état-action-récompense, notée (st, at, rt, st+1). L'optimisation de la stratégie repose sur la construction de la fonction d'avantage, où l'estimation de l'avantage est définie sous la forme suivante :
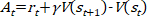 (4)
At représente la valeur d'avantage, rt est la récompense instantanée actuelle, γ est le facteur d'actualisation de la récompense, et V(st) et V(st+1) sont respectivement les sorties de la fonction de valeur d'état dans l'état actuel et l'état suivant. La fonction d'avantage reflète le degré de supériorité de l'action actuelle par rapport à la performance moyenne de la stratégie. Elle est utilisée pour guider l'amélioration ultérieure de la stratégie. Si At > 0, cela signifie que l'action actuelle est meilleure que l'espérance moyenne, et sa probabilité devrait être augmentée ; sinon, sa tendance de sélection devrait être réduite.
Au cours du processus de mise à jour de la stratégie, afin d'éviter les oscillations de stratégie causées par des amplitudes de mise à jour excessives, un mécanisme de troncature de la distribution cible est appliqué pour limiter l'étendue des variations entre les stratégies nouvelle et ancienne, préservant ainsi la continuité et la stabilité de la sortie du réseau. Un couplage étroit est établi entre la distribution des actions et la récompense de rétroaction, permettant à la stratégie de réagir immédiatement aux changements dans les contraintes complexes. Ce mécanisme maintient la stabilité de la prise de décision et une planification rationnelle des ressources dans des situations où les tâches changent fréquemment ou où les ressources présentent soudainement des déséquilibres, évitant efficacement des problèmes tels que l'allocation en double, l'engorgement des ressources ou l'accumulation dans les files d'attente des tâches. Le système de planification peut conserver un état de fonctionnement optimal face à des densités de tâches variables et des pénuries de ressources, démontrant ainsi de solides capacités d'adaptation.
Itération de la stratégie et mécanisme de mise à jour stable
Afin de garantir que les stratégies d'ordonnancement générées restent stables et ne se dégradent pas au fil des cycles d'entraînement répétés, un mécanisme de mise à jour itérative avec limitation (clipping) et correction de l'avantage est introduit dans cette sous-section. L'intervalle de mise à jour de la troncature entre les anciennes et les nouvelles stratégies est défini, et la fonction objectif par écrêtage est utilisée pour limiter la dérive stratégique afin d'éviter un choc d'ordonnancement durant le processus de mise à jour de la stratégie. Le réseau d'évaluation est corrigé en combinaison avec la fonction d'avantage afin d'améliorer la précision de l'ordonnancement à long terme.
La distribution de probabilité de la sortie d'action du réseau de politique est sujette à des fluctuations importantes au cours des itérations d'ordonnancement continues, ce qui peut entraîner un comportement instable ou une allocation désordonnée des ressources. Pour atténuer le choc d'ordonnancement causé par la dérive de la politique, un intervalle de mise à jour tronqué est conçu afin de contrôler l'amplitude de changement entre les anciennes et les nouvelles politiques, et un terme de restriction est établi pour affiner la fonction objectif. La probabilité de la politique historique est enregistrée lors du tour d'échantillonnage, et le terme de rapport est construit à partir de la probabilité de la politique actuelle. L'objectif de mise à jour de la politique est défini comme suit :
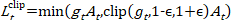 (5)
Ici, gt = πθ(at|st)/πθold(at|st) désigne le rapport de probabilité entre les politiques nouvelle et ancienne ; ε est le seuil de rognage qui limite la plage de mise à jour de la politique. Lorsque le rapport dépasse la limite, la valeur rognée est utilisée à la place afin d'empêcher la stratégie de produire des gradients excessifs à partir d'échantillons extrêmes, garantissant ainsi que l'ajustement des paramètres du réseau reste dans la plage prédéfinie. Cette structure contraint dynamiquement la plage de changements de la stratégie de sortie à chaque cycle d'ordonnancement, préserve la régularité et la cohérence de la sortie stratégique en cas de distributions denses de tâches et réduit significativement le taux de saccades du comportement d'ordonnancement.
La fonction objective de la politique est augmentée de termes de régularisation et de récompense d'entropie au cours du processus de mise à jour afin d'améliorer la diversité de la distribution des actions et de supprimer une convergence prématurée. Chaque cycle de mise à jour de la politique utilise plusieurs lots d'échantillons de trajectoires d'expérience pour un entraînement itératif, préservant ainsi une large couverture de l'espace des états. Lorsque la distribution de probabilité de la séquence d'actions en sortie est comparée avant et après la mise à jour, le taux d'écart de la distribution est calculé, et un seuil strict filtre la plage de perturbation acceptable de la politique. Ce mécanisme assure un contrôle limitant la migration des politiques d'ordonnancement entre les cycles, supprimant ainsi le surajustement dû à des changements radicaux de l'état des ressources.
Les mises à jour de stratégie reposent sur l'évaluation de l'état fournie par la fonction de valeur. Les écarts dans l'estimation de la valeur de l'état peuvent directement affecter la justesse de la fonction d'avantage, modifiant ainsi la direction de l'itération de stratégie. Pour améliorer la précision de l'évaluation, un mécanisme de rétropropagation multiséries temporelles est mis en place, et la valeur cumulée actualisée des récompenses futures est utilisée pour corriger la valeur de l'état courant. La récompense de rétropropagation adopte la structure d'Estimation Généralisée de l'Avantage (GAE), définie comme suit :
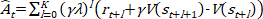 (6)
Ât est la valeur corrigée de l'avantage ; λ est le coefficient d'équilibre de rétropropagation ; rt+l représente la récompense immédiate de l'étape (t+l) ; V(st+l) est la valeur d'état produite par le réseau d'évaluation. Cette structure intègre des retours d'information immédiats à court terme et des prévisions d'état à long terme afin de corriger les écarts dans les prédictions de réponse de la stratégie face aux conflits futurs de ressources, aux pics de charge et à l'accumulation de tâches. λ contrôle la profondeur de rétropropagation et s'ajuste automatiquement durant les périodes de fluctuations marquées des ressources, renforçant ainsi la robustesse de la réponse du réseau d'évaluation face aux événements soudains.
La structure temporelle dépendante à plusieurs échelles intégrée dans la fonction d'avantage permet au réseau d'évaluation de modéliser les tendances à long terme des ressources. Pour détecter l'écart de la sortie de la politique, l'indice de cohérence du comportement de la politique est utilisé afin d'évaluer si le réseau présente une réponse excessive à l'erreur d'évaluation. Les termes résiduels de différence de rétroaction surveillent le comportement de mise à jour de la politique, et l'objectif d'apprentissage ainsi que l'amplitude de mise à jour des poids de la fonction de valeur sont corrigés dynamiquement. Le réseau d'évaluation et le réseau de politique sont optimisés conjointement pour garantir que l'estimation de la valeur ne s'écarte pas de l'objectif d'achèvement de la tâche, tout en empêchant la planification à haute fréquence de mal interpréter l'état de conflit de ressources.
Ce mécanisme de mise à jour de politique stable peut efficacement maintenir la contrôlabilité et la cohérence des mises à jour du comportement de la politique dans un environnement de tâche dynamique en haute dimension, améliorant ainsi l'efficacité de couverture des tâches et la flexibilité d'utilisation des ressources, et formant une structure d'ordonnancement intelligent en itération continue. Le comportement d'ordonnancement évite de tomber dans une optimalité locale lors de l'évolution à long terme et renforce l'adaptabilité globale aux changements dans les schémas de tâches et aux fluctuations des cycles de ressources.
Figure 3A montre l'évolution de la valeur de la fonction objectif en fonction du nombre d'itérations d'apprentissage sous différentes conditions de seuil de troncature. L'axe horizontal représente le nombre d'itérations d'apprentissage, et l'axe vertical représente la valeur numérique de la fonction objectif tronquée. ε est fixé à 0,1, 0,2 et 0,3, représentant différents niveaux de contrôle de la dérive de la politique. La courbe correspondant à une valeur plus faible de ε présente moins de fluctuations, et la fonction objectif reste stable. Lorsque ε = 0,1, la valeur globale de la fonction objectif se situe entre 0,8 et 1, ce qui illustre la progressivité et la stabilité de la mise à jour de la stratégie. En revanche, une valeur plus élevée de ε entraîne des fluctuations marquées. Lorsque ε = 0,3, la valeur globale de la fonction objectif se situe entre 0,65 et 0,95, et la courbe de la fonction objectif présente une amplitude d'oscillation plus importante, reflétant le risque d'une déviation importante lors du processus de mise à jour de la stratégie. Plus le seuil est faible, plus la stratégie est stable, ce qui la rend adaptée aux environnements de planification à contraintes élevées. Figure 3B montre les variations de l'estimation de l'avantage généralisé sous différents coefficients d'équilibre de retour arrière. λ est fixé respectivement à 0,8, 0,9 et 1,0, afin de contrôler la profondeur du retour arrière sur les récompenses futures. La courbe montre que plus λ est élevé, plus les fluctuations de l'AGA sont faibles, plus la tendance à long terme est lisse, et plus l'impact potentiel du comportement de planification après plusieurs étapes est précisément capté. La courbe avec λ = 0,8 présente des fluctuations périodiques marquées, indiquant une sensibilité accrue aux récompenses immédiates et une meilleure adaptation aux tâches à court terme et soudaines. En revanche, une valeur de λ égale à 1,0 se concentre davantage sur la modélisation des tendances à long terme et convient mieux aux scénarios de tâches périodiques.
Analyse de la complexité computationnelle et de la scalabilité
La complexité computationnelle du cadre Transformer-PPO proposé est déterminée par deux composants principaux : l'encodeur Transformer et l'optimisation de la politique PPO.
Pour l'encodeur Transformer comportant L couches, H têtes d'attention, une dimension d'incorporation d et une longueur de séquence d'entrée T (la fenêtre temporelle historique), la complexité temporelle par passe avant est O(L·T2·d + L·T·d2), où le terme T2 provient du mécanisme d'auto-attention. Dans l'implémentation, L = 3, H = 4, d = 128, et T est fixé à 100 pas de temps, ce qui donne un surcoût calculatoire maîtrisable. Pour des fenêtres historiques plus longues, le terme quadratique T2 devient le facteur dominant ; toutefois, en pratique, la planification des activités syndicales implique généralement des horizons historiques finis (par exemple, des fenêtres glissantes d'un trimestre ou d'un an), et la résolution en pas de temps peut être ajustée afin d'équilibrer précision et efficacité.
Pour le composant PPO, le réseau de politique et le réseau de valeur sont des MLP légers (256 et 128 neurones par couche cachée), dont la complexité d'inférence est O(d·m), où m représente le nombre d'unités cachées, ce qui est négligeable par rapport à l'encodeur Transformer. La mise à jour de la politique pendant l'apprentissage implique plusieurs époques de mises à jour de gradient par mini-lots, avec une complexité de O(B·E·d2), où B est la taille du lot et E le nombre d'époques de mise à jour.
En ce qui concerne l'évolutivité, le cadre présente trois propriétés favorables. Premièrement, le mécanisme d'attention peut être parallélisé au fil des pas de temps, permettant une accélération efficace par GPU. Deuxièmement, la taille du modèle est indépendante du nombre d'activités ou de ressources, car la matrice de contraintes est construite dynamiquement à chaque étape de planification, plutôt que d'être intégrée sous forme de paramètres fixes. Cela permet de déployer le même modèle entraîné sur des ensembles de différentes échelles sans réentraînement. Troisièmement, pour des scénarios extrêmement vastes, la longueur de la fenêtre historique T et la dimension d'incorporation d peuvent être réduites au prix d'un compromis, ou bien la variante d'attention creuse peut être adoptée afin de réduire la complexité O(T2) à O(T log T) ou O(T).
Résultats
Données expérimentales
Afin d'évaluer de manière exhaustive les performances de l'algorithme de planification dynamique Transformer-PPO présenté dans cet article, l'expérience utilise comme jeu de données de référence des données de gestion d'activités provenant d'un grand syndicat d'entreprise sur les trois dernières années. Ce jeu de données contient plus de 5 000 enregistrements d'activités, couvrant divers types, notamment des réunions, des formations et des événements de divertissement, ainsi que des informations de planification relatives à plusieurs ressources, telles que les lieux, le matériel et le personnel. Chaque enregistrement précise l'heure de début et de fin de l'activité, les besoins en ressources, la priorité et le statut réel d'exécution (y compris les conflits et l'utilisation des ressources). Afin de simuler des changements dynamiques proches de la réalité, les données ont été enrichies avec un supplément de 10 % de tâches soudaines aléatoires et d'événements de modification des ressources (comme l'occupation temporaire d'un lieu ou l'ajustement des plages horaires du personnel), afin de vérifier la robustesse de l'algorithme dans un environnement fortement incertain. La séquence continue d'états fournit une entrée structurée pour la modélisation temporelle par le Transformer et l'apprentissage de la politique par le PPO. L'expérience a comparé les performances de planification sous différentes densités et complexités de tâches afin de garantir que l'évaluation couvre des scénarios typiques des applications réelles, et a été confrontée au modèle LSTM-PPO actuellement populaire, à un modèle de planification par recherche gloutonne et à un modèle de planification par politique DQN.
L'encodeur Transformer comprend 3 couches, chacune dotée de 4 têtes d'attention, d'une dimension d'incorporation de 128 et d'une taille cachée de la couche entièrement connectée de 256. Le réseau de politique et le réseau de valeur partagent la même sortie du Transformer comme entrée, puis se divisent en deux perceptrons multicouches (MLP) distincts. Chaque MLP comporte deux couches cachées avec respectivement 256 et 128 neurones, en utilisant l'activation ReLU. Toutes les couches linéaires sont initialisées selon l'initialisation uniforme de Xavier.
L'optimiseur est Adam avec un taux d'apprentissage de 3 × 10⁻⁴, une taille de lot de 64 et un coefficient d'entropie de 0,01. Le paramètre de rognage PPO ε est fixé à 0,2, le facteur d'actualisation γ = 0,99, et le paramètre GAE λ = 0,95. Le modèle est entraîné sur 5 000 épisodes, chaque épisode comprenant jusqu'à 100 étapes de planification. Un rognage de gradient avec une norme maximale de 0,5 est appliqué afin d'éviter l'explosion des gradients. Ces paramètres sont choisis à l'aide d'une recherche préliminaire en grille et sont conformes aux pratiques courantes dans les tâches de planification basées sur l'apprentissage par renforcement. Toutes les expériences sont exécutées sur un seul accélérateur GPU (mémoire de 40 Go), en utilisant Python 3.9 et un framework d'apprentissage profond (voir le Tableau des matériaux).
Évolution temporelle de la sortie de l'attention multi-tête, amélioration résiduelle sous variation temporelle des caractéristiques d'encodage et stratification par priorité de tâche
À l’aide de l’historique réel de planification comme entrée, la demande de tâche, l’état d’utilisation des ressources et l’état d’exécution du retour sont extraits à des pas de temps consécutifs, et l’information de type multiple est intégrée dans un espace de caractéristiques unifié par une application linéaire et un encodage de position. Le mécanisme d’attention multi-tête calcule en parallèle les corrélations temporelles entre différentes séquences de caractéristiques et produit trois types de séquences de poids d’attention : tâche, ressource et retour. Chaque type de poids représente l’intensité d’attention du modèle portée à l’état correspondant à chaque pas de temps. Après normalisation, une courbe d’évolution est tracée afin de refléter le focus de perception de la couche d’encodage ainsi que la structure de changement dynamique des différentes dimensions d’information dans l’historique de planification. Ce processus est réalisé à partir de la trajectoire réelle d’exécution des activités et du journal d’utilisation des ressources dans le scénario de planification.
Figure 4 montre la tendance dynamique de l'attention du mécanisme d'attention multi-têtes sur différentes informations d'état dans la planification des activités syndicales. L'axe horizontal représente l'étape temporelle, reflétant l'avancement continu de la séquence de planification, tandis que l'axe vertical indique le poids d'attention normalisé, compris entre [0,1], représentant l'importance relative accordée par le modèle aux caractéristiques des tâches, à l'état des ressources et à l'état des retours. L'attention portée aux caractéristiques des tâches présente un pic net vers la 15e étape. Au stade initial de la planification, le modèle privilégie la capture des caractéristiques temporelles des tâches clés afin de prédire d'éventuels conflits et goulots d'étranglement des ressources, reflétant ainsi la sensibilité au risque à cette phase de la planification des activités. La courbe d'attention relative à l'état des ressources présente des fluctuations périodiques, et le poids d'attention global varie entre 0,2 et 0,8, reflétant le suivi continu par le système de planification des changements dans l'occupation des ressources, soutenant ainsi le traitement complexe du partage et de l'allocation des ressources, et permettant de répondre efficacement à la concurrence dynamique pour les ressources entre plusieurs tâches simultanées. L'attention portée à l'état de retour augmente progressivement, et le pic de poids apparaît vers l'étape 35, soulignant l'attention accrue du modèle aux retours sur les résultats d'exécution et aux conditions anormales durant les phases intermédiaires et finales de la planification, ce qui contribue à l'ajustement de la stratégie pour gérer les écarts de planification et améliorer la robustesse de l'ensemble du processus de planification. Cette tendance montre qu'une structure d'encodage intégrant le mécanisme d'attention multi-têtes peut capter des variations subtiles dans les caractéristiques temporelles et renforcer l'adaptabilité des stratégies de planification aux ressources variées et aux dépendances complexes entre tâches, améliorant ainsi l'efficacité et la stabilité globales de la planification dynamique des activités syndicales.
La séquence de codage de l'état caché et la structure de réponse aux caractéristiques de la tâche sont traitées. La partie de comparaison d'état construit les chemins de propagation des caractéristiques avant et après la connexion résiduelle dans les mêmes conditions d'entrée, observe l'évolution temporelle de l'état caché au fil des pas de temps consécutifs, et en extrait les caractéristiques de stabilité locale et de continuité globale afin d'analyser l'évolution fluide de l'expression de l'état durant la transmission de l'information. La tendance de réponse prioritaire selon la tâche est extraite à partir du chemin d'activation des caractéristiques à travers différentes stratégies de pondération de planification. En suivant les niveaux d'activation des différentes catégories de tâches au fil du temps, on capture l'effet d'ajustement dynamique du modèle sur sa capacité à différencier les tâches.
Figure 5A montre l'évolution de l'état caché du modèle avant et après l'application du mécanisme de connexion résiduelle. L'axe horizontal représente l'étape temporelle, et l'axe vertical représente la valeur de l'état caché. La sortie initiale, sans connexion résiduelle, présente des fluctuations importantes, marquées par une instabilité locale prononcée et des ruptures de tendance. La ligne pleine bleue représente la valeur d'état après l'application de la structure résiduelle. La tendance globale reste stable, et les fluctuations sont nettement réduites, ce qui indique que le modèle parvient à un amortissement du gradient et à un renforcement des caractéristiques lors de la propagation de l'état. Ce phénomène confirme le rôle du mécanisme résiduel dans l'amélioration de la stabilité des structures à dépendance longue, en supprimant efficacement l'atténuation de l'information causée par des couches plus profondes, et en renforçant la capacité expressive continue des séquences d'états historiques. Figure 5B illustre la dynamique d'activation des caractéristiques pour trois types de tâches dans une série temporelle. L'axe horizontal correspond à l'étape temporelle, et l'axe vertical à la valeur d'activation des caractéristiques, reflétant la sensibilité temporelle et l'attention stratégique accordée aux tâches de différents niveaux de priorité. Les tâches à faible priorité présentent une tendance décroissante, et la valeur d'activation des caractéristiques chute en dessous de 0,5 en phase finale, indiquant que le modèle leur accorde une attention appropriée au début de l'ordonnancement, puis réduit progressivement la réponse en ressources au fil du temps. Les caractéristiques des tâches à priorité moyenne augmentent lentement au fil du temps, avec des oscillations périodiques, reflétant une perception et un suivi flexibles des fluctuations de leurs besoins. Les tâches à haute priorité conservent une tendance ascendante continue, et la valeur d'activation des caractéristiques reste toujours supérieure à 2, avec un niveau d'activation élevé et stable, ce qui indique que le modèle maintient en permanence un haut degré de réactivité vis-à-vis de ces tâches. Cette réponse différenciée démontre la capacité du module de codage d'état à identifier précisément les attributs des tâches et fournit une base hiérarchique pour la prise de décision dans la génération des stratégies d'ordonnancement.
Analyse de l'évolution des performances multidimensionnelles de l'algorithme de planification dynamique Transformer-PP0
À partir du codage Transformer des séquences historiques de planification et de l'état des ressources, des caractéristiques spatiotemporelles sont extraites comme entrée d'état du PP0 ; ensuite, le réseau de politique produit l'action de planification, et l'environnement renvoie des récompenses immédiates et met à jour l'état ; au cours du processus d'apprentissage, les indicateurs bruts de chaque itération sont enregistrés, puis le bruit est éliminé par un filtrage à moyenne glissante, permettant d'analyser la tendance de convergence de l'algorithme ; lors de la visualisation finale, les données brutes montrent la dynamique instantanée, tandis que la courbe lissée reflète l'amélioration progressive des performances, confirmant que le modèle parvient à une planification stable grâce à la modélisation des séries temporelles et à l'optimisation de la politique.
Figure 6A,B montre l'analyse de l'évolution des performances multidimensionnelles de l'algorithme de planification dynamique Transformer-PPO. Les fluctuations des données initiales reflètent le bruit instantané du processus de planification, tandis que les données lissées extraient la tendance à long terme au moyen d'une moyenne glissante, éliminant ainsi les interférences des perturbations à court terme sur l'évaluation des performances de l'algorithme et facilitant l'observation de l'évolution des performances. L'analyse des données lissées révèle la relation dynamique entre la récompense et l'entropie de la politique : la courbe de récompense présente une croissance logarithmique, et la politique apprend rapidement à planifier efficacement les actions par l'exploration ; la croissance tend à s'aplatir en fin de processus, et la valeur de saturation de la récompense se stabilise autour de 12, indiquant que la politique est proche d'un optimum local. L'entropie de la politique décroît progressivement d'environ 2,2 au début à environ 0,6. PPO conserve une capacité d'exploration nécessaire grâce au terme de récompense d'entropie. Une exploration élevée (entropie élevée) au début favorise une augmentation rapide des récompenses, tandis que la stratégie ultérieure équilibre exploration et exploitation par élagage et mise à jour. L'optimisation coordonnée du taux de conflits et de l'utilisation des ressources montre que le taux de conflits chute à un niveau inférieur à 10 %, dont la limite inférieure reflète les conflits impossibles à éliminer dans le système réel en raison de l'aléatoire des tâches. Cette tendance à la baisse est directement attribuable à la capacité du Transformer à encoder les séquences d'activités passées, permettant au modèle de prédire proactivement les contentions de ressources. L'utilisation des ressources a augmenté jusqu'à près de 75 %, conformément à la loi des rendements marginaux décroissants. Il est raisonnable que l'utilisation n'atteigne pas un niveau plus élevé, car une utilisation excessive pourrait entraîner des retards de mise en file d'attente. La réduction des conflits a libéré davantage de ressources disponibles, et l'allocation optimisée des ressources a davantage réduit les conflits.
Évaluation de la rapidité de réponse et de l'efficacité de la prise de décision
Comparaison du temps de décision moyen et du délai de réponse moyen sous différentes densités de tâches (nombre de tâches : 100, 300, 500, 700, 1000). Comparaison du modèle de planification Transformer-PPO présenté dans cet article avec le modèle LSTM-PPO, le modèle de planification par recherche gloutonne et le modèle de planification stratégique DQN.
Figure 7A,B montre le temps de décision moyen et le délai de réponse moyen pour les quatre stratégies d'ordonnancement dans différentes conditions de densité de tâches, reflétant la capacité de prise de décision en temps réel de l'algorithme et la réactivité du système dans des scénarios à forte charge. À mesure que le nombre de tâches augmente, chaque stratégie présente une tendance à la hausse pour les deux indicateurs, mais les augmentations et la stabilité diffèrent. Dans les scénarios à forte intensité de tâches, la structure Transformer-PPO conserve une performance relativement stable en termes de temps de décision moyen. Lorsque la densité de tâches est de 1000, le temps de décision moyen est de 0,72 s et le délai de réponse moyen est de 1,59 s, ce qui est principalement dû à l'effet de compression de son encodage des caractéristiques temporelles sur l'espace d'état et à l'évitement efficace des opérations non valides dans l'espace d'action. En revanche, la stratégie DQN présente des temps de décision et des délais de réponse plus longs à mesure que le nombre de tâches augmente, reflétant sa capacité limitée à généraliser les politiques à travers des transitions d'état de haute dimension. Bien que la stratégie gloutonne prenne des décisions plus rapidement quel que soit le nombre de tâches, ses performances de réponse se dégradent sur des graphes de tâches complexes en raison d'un manque de modélisation des dépendances à long terme. LSTM-PPO possède une certaine capacité de perception temporelle dans la modélisation de séquences, mais elle obtient de mauvais résultats dans les scénarios de dépendance à long terme en raison d'une profondeur structurelle limitée. Les résultats révèlent l'impact clé de la conception structurelle sur la réactivité du système d'ordonnancement et soulignent la nécessité d'une optimisation coordonnée du mécanisme d'encodage et de l'efficacité de l'échantillonnage des politiques dans des conditions de forte concurrence.
Taux de conflit et évaluation de l'utilisation des ressources
Dans différentes conditions de complexité des types d'activités (type unique, types multiples indépendants, types multiples croisés, flux de travail multi-étapes, collaboration interdépartementale, insertion temporaire, cycle répété), le taux de conflit des ressources et le taux moyen d'utilisation des ressources sont analysés statistiquement. Le modèle d'ordonnancement Transformer-PPO présenté dans cet article est comparé aux modèles d'ordonnancement LSTM-PPO, recherche gloutonne et DQN.
Figure 8A,B montre le taux de conflit de ressources et l'utilisation moyenne des ressources pour différents modèles d'ordonnancement à travers sept niveaux de complexité d'activité. L'axe vertical représente le modèle d'ordonnancement, et l'axe horizontal représente le type d'activité. La tendance générale montre qu'avec l'augmentation de la complexité de la structure des activités (telles que les processus multi-étapes, la collaboration interdépartementale, l'insertion temporaire et les cycles répétés), le taux de conflit augmente pour tous les modèles. La stratégie gloutonne et le schéma DQN présentent une adaptabilité limitée aux changements dynamiques et sont clairement insuffisants en matière de contrôle des conflits. Le modèle Transformer-PPO maintient toutefois un taux de conflit faible dans des conditions de forte complexité, avec un taux global de conflit de ressources compris entre 0,05 et 0,12, reflétant sa compréhension approfondie de la structure des dépendances des tâches et des variations des ressources. En ce qui concerne l'utilisation des ressources, Transformer-PPO maintient un niveau élevé dans toutes les conditions, particulièrement en présence de croisements de types multiples et d'insertions temporaires. Sa stratégie d'ajustement dynamique réduit efficacement l'inactivité des ressources, avec un taux moyen d'utilisation des ressources compris entre 0,75 et 0,86. Les données confirment que le modèle Transformer-PPO parvient à un meilleur équilibre entre flexibilité d'ordonnancement et efficacité des ressources, offrant ainsi une plus grande praticité et évolutivité.
Stabilité de l'ordonnancement
L'indice de stabilité de l'ordonnancement est calculé dans différentes conditions de complexité des types d'activités (type unique, types multiples indépendants, types multiples croisés, processus multi-étapes, collaboration interdépartementale, insertion temporaire et cycle répété). Le modèle d'ordonnancement Transformer-PPO présenté dans cet article est comparé aux modèles d'ordonnancement LSTM-PPO, recherche gloutonne et DQN.
Tableau 1 présente les résultats comparatifs de l'indice de stabilité de planification entre différents modèles de planification, sous sept conditions de complexité de types d'activités. Le type de complexité retenu reflète la performance de stabilité du système de planification dans plusieurs scénarios. La valeur de l'indice varie de 0 à 1. Plus cette valeur est élevée, plus la résistance du modèle aux perturbations de planification est forte et plus la stratégie produite est stable. Les résultats expérimentaux montrent que Transformer-PPO conserve un indice de stabilité élevé dans toutes les structures de tâches. En particulier dans les scénarios impliquant des activités de types multiples, une collaboration interdépartementale et des cycles répétés, la stabilité de sa stratégie de planification est supérieure à celle des autres modèles, démontrant ainsi de solides capacités de préservation structurelle et d'adaptation dynamique. L'indice global de stabilité de planification varie entre 0,8 et 0,91. En revanche, la stabilité de l'algorithme glouton et du DQN diminue nettement lorsque la structure des tâches devient plus complexe, avec des oscillations évidentes de la politique et des écarts d'exécution. LSTM-PPO présente une certaine stabilité, mais ses performances globales restent inférieures à celles de Transformer-PPO. Cette comparaison confirme l'apport positif du mécanisme d'attention multi-têtes et du mécanisme de mise à jour par élagage de politique à la stabilité de la sortie de planification, soulignant l'avantage du modèle en termes de stabilité dans des scénarios complexes d'activités combinées.
Analyse de l'adaptation à la charge de concurrence des tâches
À mesure que le nombre de tâches simultanées augmente, le système d'ordonnancement doit relever les deux défis que sont les conflits de répartition des ressources et la réduction de la généralisation de la politique. Afin d'évaluer l'adaptabilité à l'ordonnancement de différents modèles face à une augmentation de la charge de tâches, cette section définit trois niveaux de concurrence des tâches (faible : 100 éléments, moyen : 500 éléments et élevé : 1000 éléments) afin de surveiller la répartition des ressources du système et la cohérence de la réponse de la politique durant le cycle d'ordonnancement. L'indice d'équilibre des ressources est utilisé pour refléter l'équilibre de charge des différentes unités de ressources durant le processus d'ordonnancement, et est calculé comme suit :
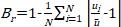 (7)
ui représente le taux d'utilisation réel des unités de ressource ; ū représente le taux d'utilisation moyen de toutes les ressources ; et N représente le nombre total de ressources. La plage de valeurs est [0,1], et plus elle est proche de 1, plus la répartition des ressources est équilibrée.
L'indice de robustesse du transfert de politique Rs mesure le degré de cohérence de la sortie politique dans différentes conditions de charge de tâche et est défini par :
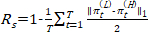 (8)
πt(L) et πt(H) sont respectivement les distributions des stratégies d'ordonnancement dans des scénarios de faible charge et de forte charge, et T est le pas de temps total. Plus cette valeur est proche de 1, plus la robustesse de la migration des stratégies est forte et plus l'adaptabilité est élevée.
Tableau 2 présente de manière systématique les performances des quatre modèles d'ordonnancement en termes d'équilibre des ressources et de robustesse du transfert de politique sous des charges de concurrence aux tâches variables. Les niveaux de concurrence aux tâches sont définis comme faibles (100 éléments), moyens (500 éléments) et élevés (1000 éléments), respectivement, reflétant l'adaptabilité du modèle à différents niveaux de pression liés à l'échelle des tâches. Les résultats montrent que le modèle Transformer-PPO atteint l'indice d'équilibre des ressources le plus élevé à tous les niveaux de charge, reflétant sa capacité à allouer rationnellement les ressources dans des scénarios de tâches multiples concurrentes. En même temps, l'indice de robustesse du transfert de politique est également nettement supérieur à celui des modèles comparatifs, démontrant une forte cohérence et adaptabilité des politiques. Dans des conditions de forte concurrence, les indices d'équilibre des ressources et de robustesse du transfert de politique sont respectivement de 0,88 et 0,85. En comparaison, LSTM-PPO se classe au deuxième rang, tandis que l'algorithme glouton et le modèle DQN montrent une dégradation significative des performances sous une charge élevée, avec une répartition inégale des ressources et des fluctuations de politique plus marquées. Cette évaluation a clairement mis en évidence les différences en matière de gestion des ressources et de robustesse des politiques dans le système d'ordonnancement lorsque la charge de tâches augmente, et a en outre confirmé l'applicabilité et la supériorité de la solution hybride Transformer-PPO pour l'ordonnancement dynamique et complexe d'activités en réunion.
Comparaison avec d'autres méthodes de pointe
Afin de comparer davantage la méthode proposée à des approches récentes de pointe (SOTA), trois algorithmes représentatifs issus des dernières publications combinant apprentissage profond et apprentissage par renforcement ont été implémentés pour des problèmes d'ordonnancement : (1) Transformer+DQN42, utilisant le même encodeur Transformer que le nôtre mais remplaçant PPO par DQN pour l'apprentissage de la politique, comme cela a été exploré dans des études récentes sur l'ordonnancement basé sur les valeurs ; (2) GRU+PPO43, remplaçant l'encodeur Transformer par une unité récurrente à porte d'entrée (Gated Recurrent Unit, GRU) afin de capturer les dépendances temporelles, représentant ainsi les méthodes avancées basées sur les RNN ; et (3) GraphSAGE+PPO44, utilisant un encodeur GraphSAGE pour modéliser les relations tâche-ressource sous forme de graphes, reflétant les approches récentes utilisant les réseaux de neurones graphiques pour l'ordonnancement. Toutes les méthodes sont entraînées dans des conditions expérimentales identiques (même jeu de données, densité de tâches de 1000, et configuration des épisodes) avec des hyperparamètres optimisés par recherche en grille afin d'assurer une comparaison équitable. Chaque méthode est évaluée sur 10 exécutions indépendantes, et les valeurs moyennes des métriques clés de performance (délai de réponse, taux de conflit de ressources, taux d'utilisation des ressources et indice de stabilité de l'ordonnancement) sont enregistrées.
Comme indiqué dans le Tableau 3, la méthode proposée Transformer+PPO surpasse systématiquement les trois modèles de référence SOTA sur l'ensemble des métriques évaluées. Le délai de réponse moyen de la méthode proposée (1,59 s) est nettement inférieur à celui de Transformer+DQN (2,13 s), de GRU+PPO (1,89 s) et de GraphSAGE+PPO (1,72 s), ce qui indique une efficacité supérieure en matière de prise de décision. Le taux de conflit de ressources de la méthode proposée (0,09) est également le plus faible, ce qui témoigne d'une meilleure anticipation des conflits. Cette amélioration s'explique par l'attention multi-têtes du Transformer, qui capture plus efficacement les dépendances à longue portée que le GRU ou GraphSAGE, combinée aux mises à jour de politique stables de PPO. En ce qui concerne l'utilisation des ressources, la méthode proposée atteint 0,82, dépassant les autres d'au moins 8 points de pourcentage, ce qui démontre une allocation des ressources plus efficace. L'indice de stabilité de la méthode proposée (0,88) est également le plus élevé, confirmant que l'objectif de limitation et la correction GAE dans PPO produisent des politiques d'ordonnancement plus robustes que DQN ou d'autres variantes de PPO. Dans l'ensemble, ces résultats valident le fait que la combinaison spécifique de Transformer et de PPO dans le cadre proposé offre des avantages clairs par rapport aux architectures alternatives récentes, renforçant ainsi l'intérêt de son application à la planification dynamique des activités syndicales.
DÉCLARATION DE DISPONIBILITÉ DES DONNÉES :
L'ensemble de données anonymisé utilisé dans cette étude, ainsi que le pipeline de prétraitement des données et les scripts d'évaluation, ont été déposés dans le dépôt Figshare et sont accessibles publiquement à l'adresse https://doi.org/10.6084/m9.figshare.33059243 (DOI : 10.6084/m9.figshare.33059243). L'ensemble de données contient des plannings d'activités, des journaux d'utilisation des ressources et des enregistrements d'événements de conflit provenant d'un grand syndicat d'entreprise, toutes les informations personnelles identifiables et sensibles sur le plan commercial ayant été supprimées.
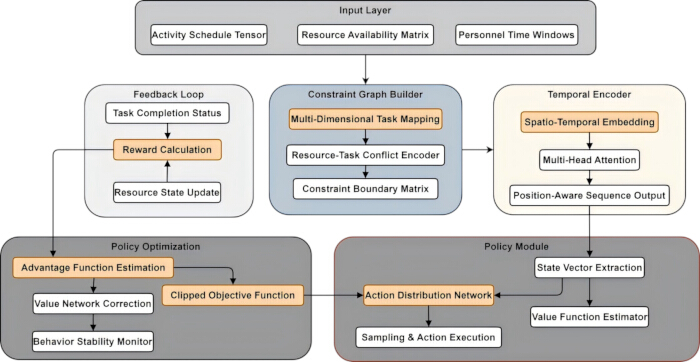
Figure 1 : Structure du système de planification des activités syndicales. Les demandes d'activités, la disponibilité des ressources et les informations sur les plages horaires du personnel sont intégrées afin de construire un graphe de contraintes tâche–ressource et une matrice de conflits. Les séquences historiques d'activités et d'états des ressources sont encodées à l'aide d'un modèle Transformer doté d'une attention multi-têtes. Les états encodés sont transmis aux réseaux de politique et de valeur de l'optimisation de politique proximale (PPO), qui génèrent des probabilités d'actions de planification et des estimations de valeur d'état. Les actions sélectionnées mettent à jour l'environnement de planification et génèrent des récompenses. L'objectif PPO tronqué et l'estimation généralisée de l'avantage sont ensuite utilisés pour mettre à jour le modèle, formant ainsi une boucle de rétroaction fermée destinée à la planification et à l'allocation des ressources adaptatives. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
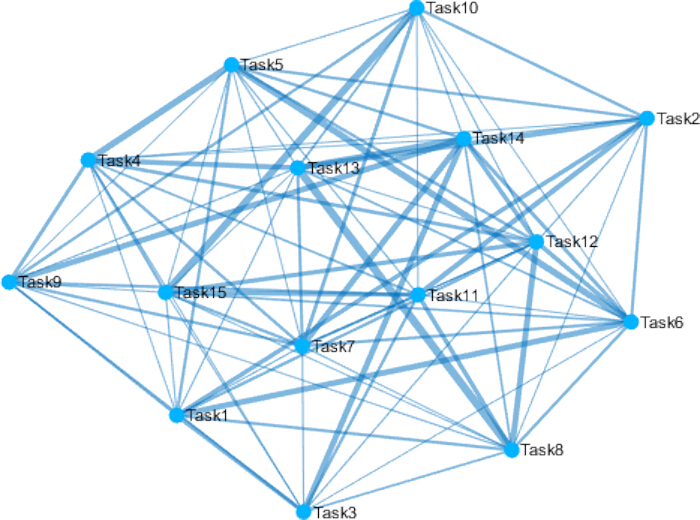
Figure 2 : Réseau de poids des conflits de tâches (l'épaisseur des arêtes reflète la gravité du conflit). Chaque nœud représente une activité en attente de planification, et chaque arête représente un conflit causé par une utilisation simultanée de personnel, de lieux, d'équipements ou d'autres ressources. L'épaisseur des arêtes est proportionnelle au poids de conflit calculé, les arêtes plus épaisses indiquant des conflits plus graves. Les groupes de nœuds fortement connectés représentent des goulots d'étranglement potentiels en ressources et des ensembles de tâches concurrentes. Une disposition de type force dirigée est utilisée pour rapprocher les tâches en conflit marqué. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
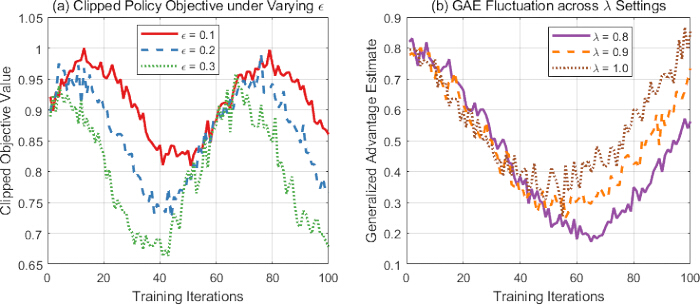
Figure 3 : Caractéristiques dynamiques de la stabilité de la stratégie et de l'estimation de l'avantage au cours de l'itération d'optimisation de planification. (A) Objectif de politique tronquée selon différentes valeurs de ε. (B) Variation de l'estimation GAE selon différents paramètres de λ. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
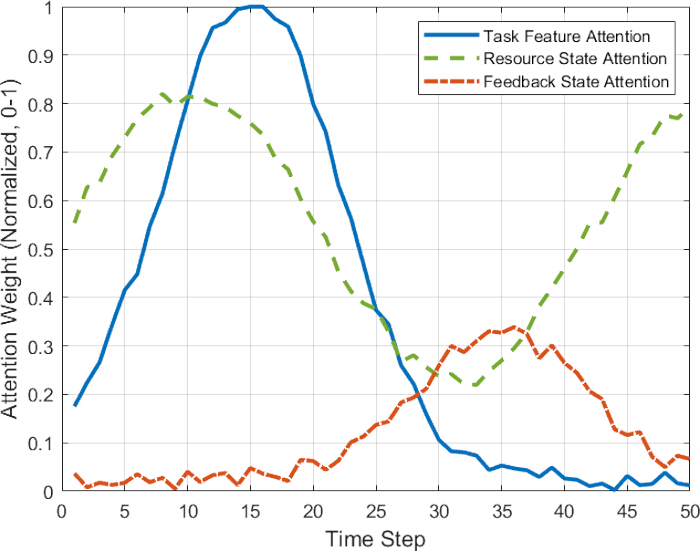
Figure 4 : Évolution temporelle de la sortie de l'attention multi-têtes Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
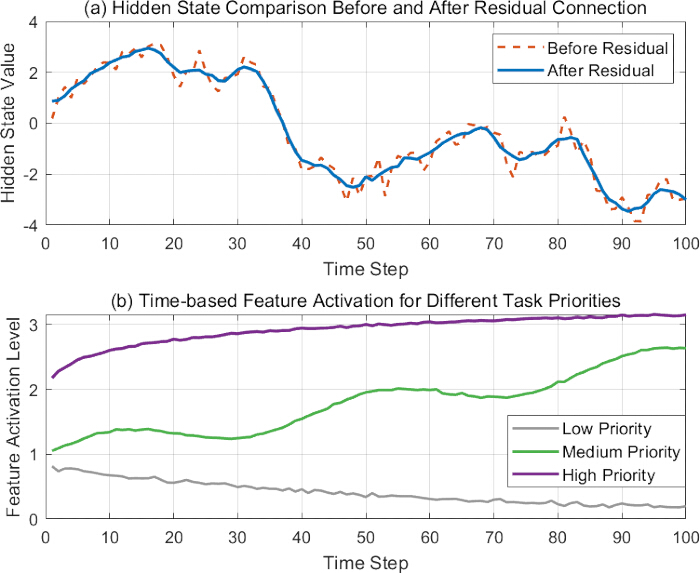
Figure 5 : Renforcement résiduel et stratification de la priorité des tâches sous variation temporelle des caractéristiques d'encodage. (A) Comparaison de l'état caché avant et après la connexion résiduelle. (B) Activation des caractéristiques en fonction du temps pour différentes priorités de tâche. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
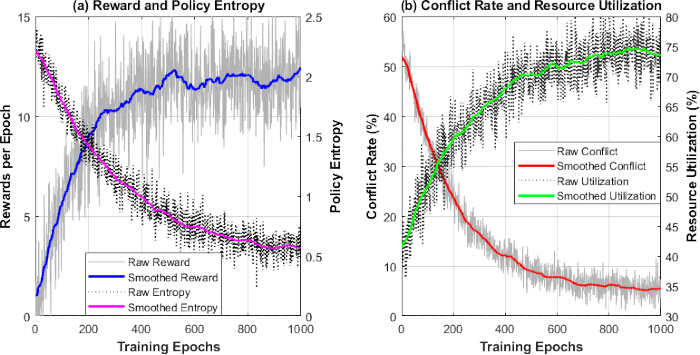
Figure 6 : Analyse de l'évolution des performances multidimensionnelles. (A) Récompense et entropie de la politique (B) Taux de conflit et utilisation des ressources. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
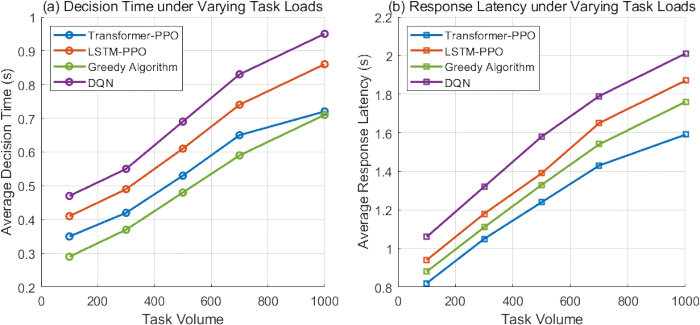
Figure 7 : Temps moyen de décision et retard moyen de réponse. (A) : Temps de décision selon des charges de tâches variables. (B) : Latence de réponse selon des charges de tâches variables. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
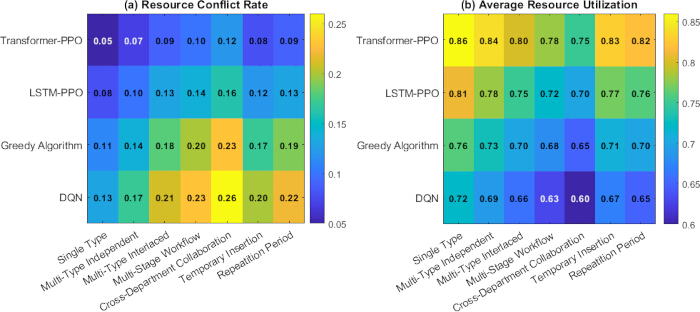
Figure 8 : Comparaison du taux de conflit de ressources et de l'utilisation moyenne des ressources (A) Taux de conflit de ressources. (B) Utilisation moyenne des ressources Veuillez cliquer ici pour afficher une version agrandie de cette figure.
| Condition de complexité de l'activité | Transformer-PPO | LSTM-PPO | Algorithme glouton | DQN |
| Type unique | 0.91 | 0.86 | 0.74 | 0.78 |
| Multi-type indépendant | 0.88 | 0.81 | 0.7 | 0.73 |
| Multi-type entrelacé | 0.85 | 0.76 | 0.65 | 0.68 |
| Flux de travail multi-étape | 0.83 | 0.73 | 0.61 | 0.66 |
| Collaboration interdépartementale | 0.8 | 0.7 | 0.59 | 0.63 |
| Insertion temporaire | 0.86 | 0.78 | 0.68 | 0.72 |
| Période de répétition | 0.84 | 0.75 | 0.64 | 0.69 |
Tableau 1 : Comparaison de l'indice de stabilité de planification selon différentes complexités d'activités. Les indices de stabilité de planification des modèles Transformer–PPO, mémoire à long court terme–PPO (LSTM–PPO), recherche gloutonne et réseau profond de Q-apprentissage (DQN) sont comparés selon sept conditions : activités d'un seul type, activités indépendantes de plusieurs types, activités de plusieurs types avec intersections, flux de travail multicouches, collaboration interdépartementale, insertion de tâches temporaires et activités à cycles répétés. L'indice de stabilité varie de 0 à 1, les valeurs plus élevées indiquant une résistance accrue aux perturbations de planification et des sorties de politique plus stables.
| Condition de concurrence des tâches | Modèle d'ordonnancement | Indice d'équilibre des ressources | Indice de robustesse du transfert de politique |
| Basse concurrence (100 tâches) | Transformer-PPO | 0.94 | 0.92 |
| LSTM-PPO | 0.89 | 0.85 | |
| Algorithme glouton | 0.83 | 0.78 | |
| DQN | 0.85 | 0.81 | |
| Concurrence moyenne (500 tâches) | Transformer-PPO | 0.91 | 0.89 |
| LSTM-PPO | 0.86 | 0.82 | |
| Algorithme glouton | 0.78 | 0.71 | |
| DQN | 0.81 | 0.76 | |
| Haute concurrence (1000 tâches) | Transformer-PPO | 0.88 | 0.85 |
| LSTM-PPO | 0.82 | 0.76 | |
| Algorithme glouton | 0.7 | 0.63 | |
| DQN | 0.75 | 0.68 |
Tableau 2 : Évaluation de l'adaptabilité à la charge de concurrence des tâches. L'indice d'équilibre des ressources et l'indice de robustesse du transfert de politique des quatre modèles d'ordonnancement sont comparés dans des conditions de faible, moyenne et forte concurrence, correspondant respectivement à 100, 500 et 1 000 tâches simultanées. Les deux indices varient de 0 à 1, des valeurs plus élevées indiquant une répartition plus équilibrée des ressources et une plus grande cohérence des politiques d'ordonnancement face aux variations de la charge de travail.
| Méthode | Délai moyen de réponse (s) | Taux de conflit de ressources | Utilisation des ressources | Indice de stabilité |
| Transformer+DQN | 2.13 ± 0.12 | 0.18 ± 0.02 | 0.68 ± 0.03 | 0.76 ± 0.04 |
| GRU+PPO | 1.89 ± 0.09 | 0.15 ± 0.01 | 0.72 ± 0.02 | 0.79 ± 0.03 |
| GraphSAGE+PPO | 1.72 ± 0.08 | 0.13 ± 0.01 | 0.74 ± 0.02 | 0.82 ± 0.03 |
| Proposée | 1.59 ± 0.05 | 0.09 ± 0.01 | 0.82 ± 0.02 | 0.88 ± 0.02 |
| (Transformer+PPO) |
Tableau 3 : Comparaison des performances avec d'autres méthodes à l'état de l'art. La méthode proposée Transformer–PPO est comparée aux approches Transformer–DQN, unité récurrente à porte d'entrée–PPO (GRU–PPO) et GraphSAGE–PPO dans des conditions expérimentales identiques à une densité de tâches de 1 000. Les résultats représentent les valeurs moyennes obtenues lors de 10 exécutions indépendantes. Les critères évalués incluent le délai de réponse en secondes, le taux de conflits liés aux ressources, le taux d'utilisation des ressources et l'indice de stabilité de l'ordonnancement. Des délais de réponse et des taux de conflits plus faibles indiquent de meilleures performances, tandis que des taux d'utilisation des ressources et des indices de stabilité plus élevés indiquent de meilleures performances.
Discussion
Les résultats expérimentaux montrent que l'algorithme Transformer-PPO proposé surpasse systématiquement les méthodes de référence (LSTM-PPO, recherche gloutonne et DQN) sur tous les indicateurs d'évaluation. Cette performance supérieure s'explique par deux facteurs clés. Premièrement, le mécanisme d'auto-attention multi-têtes du Transformer capture efficacement les dépendances temporelles à long terme dans les séquences d'activités et d'états des ressources, permettant ainsi une identification proactive des conflits potentiels. Cela explique pourquoi le taux de conflits reste faible même dans des situations complexes (par exemple, collaboration interdépartementale ou insertion temporaire), car le modèle peut anticiper la contention des ressources avant qu'elle ne se produise. Deuxièmement, la fonction objectif tronquée et la correction de l'avantage basée sur l'AEH (GAE) dans PPO assurent des mises à jour de stratégie stables, évitant des fluctuations importantes dans les décisions d'ordonnancement et garantissant une grande robustesse face à des charges de tâches variables.
Par rapport aux approches de planification existantes, la méthode proposée remédie aux limitations des modèles basés sur LSTM, qui souffrent de gradients qui s'annulent dans les séquences longues, et surpasse la faible généralisation des méthodes gloutonnes et DQN dans les environnements dynamiques. Bien que LSTM-PPO montre une performance modérée, il échoue à maintenir la stabilité lorsque les dépendances entre tâches s'étendent sur de longs horizons temporels, comme en témoignent ses taux de conflit plus élevés et son équilibre des ressources inférieur en cas de forte concurrence. L'algorithme glouton, bien qu'efficace sur le plan computationnel, manque de prévoyance et conduit à une allocation sous-optimale des ressources, augmentant ainsi les retards de réponse. La DQN, quant à elle, présente des oscillations de politique dues à l'absence d'une contrainte de région de confiance, ce qui dégrade ses performances dans les scénarios multitâches.
Néanmoins, cette étude présente plusieurs limites. L'ensemble de données provient d'un syndicat d'entreprise unique, ce qui pourrait limiter la généralisation des résultats à d'autres contextes organisationnels. De plus, le modèle suppose que toutes les informations relatives aux activités et aux ressources sont entièrement observables, une hypothèse qui pourrait ne pas être valable dans des contextes réels où les données sont incomplètes ou bruitées. La charge de calcul liée à l'encodeur Transformer augmente également avec la longueur de la fenêtre historique, ce qui pourrait nuire à l'applicabilité en temps réel pour des systèmes de très grande envergure.
Les travaux futurs pourraient se concentrer sur l'extension du modèle afin de gérer des environnements partiellement observables en utilisant une estimation récurrente de l'état, et sur l'intégration de techniques d'apprentissage méta pour permettre une adaptation rapide à de nouveaux ensembles avec peu de données historiques. Nous prévoyons également de déployer l'algorithme dans une architecture collaborative cloud-edge afin de réduire la latence de décision et de soutenir une planification distribuée. En outre, l'intégration de composants d'intelligence artificielle explicables pourrait fournir des justifications interprétables des décisions d'ordonnancement aux opérateurs humains, renforçant ainsi la confiance et l'adoption pratique.
Cet article étudie un algorithme d'optimisation de planification dynamique intégrant le modèle Transformer et l'apprentissage par renforcement PPO, en se concentrant sur les conflits fréquents de ressources et les retards de réponse dans la planification des activités syndicales. L'algorithme examine minutieusement les caractéristiques spatiotemporelles de l'historique des activités et de l'état des ressources à l'aide d'un mécanisme d'attention multi-têtes, renforçant ainsi sa capacité à identifier les risques potentiels de conflit. Associé au mécanisme de mise à jour stable de la stratégie fondée sur la fonction objectif par découpage (clipping), il permet une allocation efficace des ressources et une réponse rapide dans un environnement dynamique. Cette méthode démontre d'excellentes performances en matière de stabilité de planification, d'utilisation des ressources et de maîtrise des conflits, même face à des types d'activités complexes et variés ainsi qu'à des charges de tâches hétérogènes. Une analyse empirique révèle que l'algorithme présente un faible retard de réponse même sous une forte densité de tâches. Pour sept types d'activités et niveaux de complexité différents, le taux de conflit de ressources se situe entre 0,05 et 0,12, l'utilisation moyenne des ressources varie de 0,75 à 0,86, et l'indice de stabilité de planification atteint 0,8 à 0,91. Il maintient ainsi un taux de conflit faible et un haut niveau d'équilibre des ressources, des résultats nettement supérieurs à ceux des modèles de planification LSTM-PPO, de recherche gloutonne et DQN actuellement dominants. Par ailleurs, la robustesse du transfert de stratégie et la stabilité de la planification sont toutes deux satisfaisantes, indiquant une forte adaptabilité et une bonne résistance aux perturbations. Cet avantage en performance fournit un soutien technique solide au système de gestion des activités syndicales dans des scénarios de planification dynamiques et changeants.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun conflit d’intérêts financier.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Langage de programmation principal |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Infrastructure d'apprentissage profond (implémentation Transformer/PPO) |
| NumPy 1.23 | Développeurs de NumPy | https://numpy.org/doc/stable/release/1.23.0-notes.html | Bibliothèque de calcul numérique |
| Matplotlib 3.5 | Équipe de développement de Matplotlib | https://matplotlib.org/stable/users/installing.html | Visualisation des résultats |
| Jeu de données sur la planification des activités syndicales | Base de données interne d'une entreprise partenaire (anonymisée) | Non disponible publiquement en raison d'un accord de confidentialité ; les chercheurs peuvent contacter l'auteur correspondant pour obtenir un accès | Plus de 5 000 enregistrements d'activités (réunions, formations, loisirs) provenant d'un syndicat d'entreprise important sur une période de trois ans |
| NVIDIA A100 GPU | |||
| PyTorch |
Références
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.