Cette étude examine des biomarqueurs d'électroencéphalographie permettant de distinguer la maladie d'Alzheimer, la démence frontotemporale et les sujets témoins en bonne santé. Des modèles de forêts aléatoires utilisant des caractéristiques telles que la racine carrée moyenne, la densité spectrale de puissance et l'entropie ont été interprétés à l'aide de l'intelligence artificielle explicative et d'une analyse de l'ampleur de l'effet. La suppression des caractéristiques d'entropie ayant un faible impact a amélioré les performances de classification, atteignant une précision de 94 % sur l'ensemble de test.
Article de recherche
Fusion de biomarqueurs d'électroencéphalographie multidomaines pour la classification de la démence basée sur l'apprentissage automatique
Dans cet article
Résumé
Résumé
L'électroencéphalographie (EEG) a été étudiée comme une méthode non invasive permettant de caractériser l'activité cérébrale dans les affections neurodégénératives. Cette étude a évalué si des biomarqueurs EEG multidomaines pouvaient distinguer la maladie d'Alzheimer (AD), la démence frontotemporale (FTD) et des sujets témoins en bonne santé (HC). L'ensemble de données accessible au public comprenait des enregistrements EEG au repos, les yeux fermés, provenant de 88 participants, dont 36 atteints de la maladie d'Alzheimer, 23 de démence frontotemporale et 29 témoins sains. Des biomarqueurs EEG multidomaines ainsi que des caractéristiques démographiques ont été extraits pour une classification par apprentissage automatique. Les paramètres dérivés de l'EEG incluaient la valeur efficace (RMS), la densité spectrale de puissance (PSD) et des mesures d'entropie. Un classificateur de forêts aléatoires a été entraîné à l'aide de l'ensemble combiné de caractéristiques et interprété à l'aide d'une intelligence artificielle explicative. Des analyses de stabilité des caractéristiques et de la taille de l'effet de Cohen (d) ont été réalisées pour évaluer la contribution des caractéristiques, suivies d'une analyse d'ablation. Les caractéristiques basées sur l'entropie ont montré la plus faible contribution à la classification. Le modèle complet multidomaine a atteint une précision de 96 % lors de l'entraînement et de 92 % sur l'ensemble de test. Après suppression des caractéristiques d'entropie, la précision sur l'ensemble de test a augmenté à 94 %. Ces résultats décrivent les performances de classification des caractéristiques EEG multidomaines et démographiques sélectionnées dans le cadre d'un classificateur de forêts aléatoires.
Introduction
La maladie d'Alzheimer (MA) est une affection neurologique progressive associée à une détérioration des fonctions cognitive et motrice. Sa prévalence augmente considérablement avec l'âge, et la démence est une cause majeure de morbidité et de mortalité chez les personnes âgées1,2,3,4,5. Étant donné que le diagnostic et la classification de la maladie restent difficiles, l'analyse des signaux cérébraux a été étudiée comme moyen de caractériser les modifications neurophysiologiques associées à la démence.
L'électroencéphalographie (EEG) est une méthode non invasive permettant d'enregistrer l'activité électrique du cerveau et a été étudiée dans la maladie d'Alzheimer et d'autres troubles neurologiques6,7,8,9,10,11. Les signaux EEG reflètent les potentiels électriques générés par l'activité neuronale et sont enregistrés de manière non invasive à partir de plusieurs emplacements sur le cuir chevelu12,13,14. L'activité cérébrale est couramment caractérisée à l'aide des bandes de fréquence delta, theta, alpha, beta et gamma15. La maladie d'Alzheimer a été associée à un ralentissement de l'EEG, à une réduction de la complexité du signal et à une synchronisation altérée16. Des analyses spectrales ont rapporté une augmentation de l'activité delta et theta, ainsi qu'une diminution de l'activité alpha et beta chez les individus atteints de la maladie d'Alzheimer par rapport aux témoins sains17,18,19. Des études précédentes de classification par EEG ont signalé des performances élevées pour distinguer la maladie d'Alzheimer des témoins sains (HC) et la démence frontotemporale (FTD) des témoins sains. En revanche, la discrimination entre la maladie d'Alzheimer et la démence frontotemporale s'est généralement révélée plus difficile10,11.
Les méthodes d'apprentissage automatique ont été utilisées pour identifier des motifs dans les signaux EEG associés aux maladies neurologiques20,21. L'extraction de caractéristiques est donc un composant important de la classification fondée sur l'EEG. Des études antérieures ont examiné des caractéristiques spectrales, temporelles, de complexité et de connectivité fonctionnelle, combinées à des modèles d'apprentissage automatique3,15,22,23. Les caractéristiques spectrales sont particulièrement pertinentes car elles quantifient les modifications dépendantes de la fréquence de l'activité cérébrale, notamment une diminution de l'activité alpha et une augmentation de l'activité thêta observées dans la maladie d'Alzheimer23,24,25,26.
Plusieurs études fondées sur l'EEG ont évalué différentes combinaisons de caractéristiques, de classificateurs et de stratégies de validation. L'analyse basée sur la connectivité a été utilisée pour distinguer la maladie d'Alzheimer (AD), les démences frontotemporales (FTD) et les sujets témoins en bonne santé (HC), la performance de classification rapportée variant selon la comparaison et la procédure de sélection des caractéristiques27. Des caractéristiques fondées sur la transformation de Fourier ont également été évaluées pour distinguer la maladie d'Alzheimer, le trouble cognitif léger (MCI) et les témoins sains, bien que certaines limitations incluent un prétraitement limité et un risque de surajustement lié à la stratégie de validation28. Les mesures de complexité non linéaire de l'EEG ont montré un potentiel discriminant pour la classification de la maladie d'Alzheimer, certaines atteignant une grande précision, sensibilité et spécificité, bien que leur applicabilité à la discrimination du MCI et des stades de la maladie reste limitée21.
Des méthodes d'apprentissage profond basées sur des représentations temporelles et fréquentielles de l'EEG ont également été étudiées pour la classification multiclasse de la MA, du CIM et des sujets contrôles29. Bien que des performances élevées de classification aient été rapportées, certaines limites persistent, telles que des cohortes petites ou sélectionnées, un déséquilibre entre les classes, une sévérité hétérogène de la maladie, l'absence de validation externe et une interprétabilité réduite du modèle29. La stratégie de validation constitue également un aspect méthodologique important. Des approches indépendantes des participants ont montré que la validation croisée classique au niveau des époques peut surestimer les performances lorsque des époques provenant du même participant figurent à la fois dans les ensembles d'apprentissage et de test30. Cette limitation est particulièrement pertinente lors de la comparaison des résultats de classification entre études utilisant des protocoles de validation différents.
Des mesures de complexité et de connectivité ont également été évaluées à l'aide de classificateurs à vecteurs de support, la connectivité basée sur la phase et l'entropie multiscale présentant des niveaux variables de performance discriminatoire31,32. D'autres études utilisant des caractéristiques dérivées de la transformation de Fourier et de la transformée en ondelettes ont signalé des performances variables dans les comparaisons entre la maladie d'Alzheimer (AD), le trouble cognitif léger (MCI) et les sujets témoins en bonne santé (HC), la classification multiclasse restant généralement plus difficile que la classification binaire14. Les approches fondées sur l'entropie et la synchronie ont également permis de distinguer les groupes atteints de la maladie d'Alzheimer des groupes témoins, bien que les caractéristiques de la population témoin puissent influencer l'ampleur de l'effet observé2.
La présente étude évalue un ensemble de caractéristiques multidomaines comprenant les mesures de la racine carrée de la moyenne des carrés (RMS), de la densité spectrale de puissance (PSD) et de l'entropie extraites des bandes de fréquence de l'EEG, ainsi que l'âge en tant que variable démographique. La RMS représente l'amplitude du signal dans chaque bande de fréquence, tandis que la PSD représente la puissance dans le domaine fréquentiel. L'entropie est incluse comme mesure de la complexité du signal. Ces caractéristiques fournissent des descriptions complémentaires de l'activité EEG et sont évaluées à l'aide d'un classificateur de forêts aléatoires (Random Forest). L'étude examine en outre l'importance des caractéristiques, leur stabilité, l'intelligence artificielle explicative et l'analyse de la taille de l'effet afin d'évaluer la contribution relative des caractéristiques extraites. La présente étude analyse l'efficacité de caractéristiques EEG multidomaines, incluant des mesures spectrales, temporelles et fondées sur la complexité, pour distinguer la maladie d'Alzheimer (AD), la démence frontotemporale (FTD) et des sujets témoins en bonne santé (HC) à l'aide de l'apprentissage automatique. Elle examine également quelles caractéristiques issues des bandes de fréquence de l'EEG contribuent le plus fortement à la classification lorsqu'on utilise les mesures de densité spectrale de puissance (PSD), de racine carrée de la moyenne des carrés (RMS) et d'entropie. En outre, l'étude compare les contributions des caractéristiques fondées sur la puissance, notamment la PSD et la RMS, à celles des caractéristiques fondées sur l'entropie, et évalue l'apport de l'âge au modèle de classification.
Protocole
Une vue d'ensemble schématique du flux de travail de prétraitement des EEG, d'extraction des caractéristiques et de classification est présentée dans la Figure 1. Les matériaux et logiciels utilisés dans l'étude sont listés dans le Tableau des matériaux.
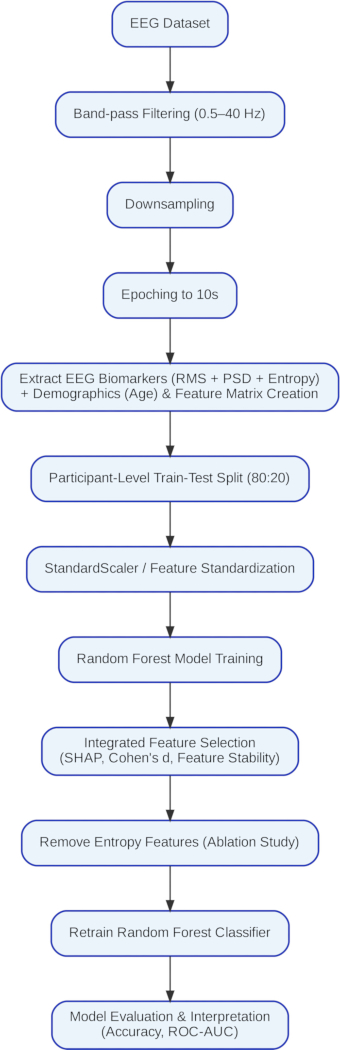
Figure 1 : Flux de travail du prétraitement des signaux EEG, de l'extraction de caractéristiques et du pipeline de classification. Aperçu schématique du flux de travail de l'étude, incluant la vérification des données EEG, le filtrage passe-bande et la re-référence, l'extraction des caractéristiques de la racine carrée de la moyenne des carrés (RMS), de la densité spectrale de puissance (PSD) et de l'entropie, l'ajout de l'âge, la séparation entre ensemble d'apprentissage et ensemble de test, le développement d'un modèle de forêt aléatoire, l'analyse de la stabilité des caractéristiques, l'analyse SHAP, l'analyse de la taille de l'effet selon Cohen’s d, la sélection intégrée de caractéristiques, l'ablation des caractéristiques d'entropie, la ré-entraînement du modèle et l'évaluation des performances. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
1. Acquisition des données
L'ensemble de données EEG au repos disponible publiquement a été obtenu à partir du référentiel OpenNeuro (ensemble de données ds004504, version 1.0.9)33. Les étiquettes des participants et les informations démographiques ont été vérifiées. L'ensemble de données comprenait 88 participants, dont 36 atteints de la maladie d'Alzheimer (AD), 23 de démence frontotemporale (FTD) et 29 témoins sains (HC).
2. Importation de l'enregistrement EEG
Pour chaque participant, l'enregistrement EEG a été chargé à l'aide de la bibliothèque MNE-Python. Chaque fichier EEG a été vérifié afin de confirmer qu'il était accessible, pouvait être importé avec succès et contenait un identifiant de participant valide. Les enregistrements dont les fichiers étaient manquants ou corrompus ont été exclus. La fréquence d'échantillonnage EEG initiale de 500 Hz a été conservée à ce stade. Les signaux ont été sous-échantillonnés afin de réduire la charge de calcul tout en préservant toutes les informations EEG cliniquement pertinentes pour cette étude.
3. Filtrage passe-bande
Les enregistrements EEG continus ont été filtrés à l’aide d’un filtre passe-bande du quatrième ordre, avec une fréquence de coupure basse de 0,5 Hz et une fréquence de coupure haute de 40 Hz.
4. Référencement par moyenne commune et segmentation en époques
Un référencement par moyenne commune (CAR) a été appliqué aux enregistrements EEG filtrés. À chaque échantillon temporel, le signal moyen calculé sur tous les canaux EEG disponibles a été soustrait de chaque canal. Les signaux EEG ainsi référencés ont été conservés pour les analyses ultérieures. Chaque enregistrement EEG référencé a été divisé en époques de durée fixe à l’aide de la fonction make_fixed_length_epochs() dans MNE-Python. Une durée d’époque de 10 s sans chevauchement a été utilisée.
5. Validation des époques
Pour chaque participant, seules les époques complètes de 10 s ont été conservées. Tout segment d'EEG restant plus court que 10 s à la fin d'un enregistrement a été écarté. Chaque époque conservée a ensuite été utilisée comme échantillon individuel pour l'extraction des caractéristiques.
6. Préparation des caractéristiques
Bien que les données du Mini-Mental State Examination (MMSE) étaient disponibles dans le jeu de données source, elles ont été exclues de l'analyse actuelle. Les caractéristiques extraites de l'EEG ont été fusionnées avec les informations démographiques des participants, incluant l'âge et les étiquettes diagnostiques, obtenues à partir du fichier de métadonnées participants.csv. L'identifiant du participant a été utilisé comme clé commune, et seuls les participants disposant à la fois de données sur les caractéristiques de l'EEG et d'informations démographiques correspondantes ont été conservés.
La matrice de caractéristiques multidomaine comprenait cinq caractéristiques de la racine carrée de la moyenne des carrés (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms et gamma_rms), cinq caractéristiques de densité spectrale de puissance (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd et gamma_psd) et cinq caractéristiques d'entropie (delta_entropy, theta_entropy, alpha_entropy, beta_entropy et gamma_entropy). L'âge a été inclus comme variable démographique complémentaire. Étant donné que les distributions d'âge peuvent différer selon les groupes diagnostiques, un biais de confusion démographique ne pouvait pas être entièrement exclu. Le groupe diagnostique, défini comme AD, HC ou FTD, a été attribué comme étiquette cible.
7. Prétraitement des données et partitionnement en ensemble d'apprentissage et de test
Lors du prétraitement, les enregistrements ont été sous-échantillonnés de 500 Hz à 250 Hz afin de réduire les exigences informatiques tout en conservant l'information fréquentielle EEG d'intérêt.
L'ensemble de données a été divisé en sous-ensembles d'apprentissage (80 %) et de test (20 %) au niveau des sujets à l'aide d'une stratégie de fractionnement groupée. Les prédictions au niveau des sujets ont ensuite été obtenues par un vote majoritaire sur les époques prédites appartenant à chaque participant. L'évaluation principale a utilisé une séparation groupée entraînement-test au niveau des sujets afin d'éviter que des époques provenant du même participant n'apparaissent dans les deux sous-ensembles. Les prédictions au niveau des sujets ont été obtenues par un vote majoritaire sur les époques prédites appartenant à chaque participant. L'ensemble de données a été examiné pour détecter les valeurs manquantes, et les observations manquantes ont été supprimées ou imputées selon le cas. Les étiquettes diagnostiques ont été encodées. Un StandardScaler a été ajusté sur les données d'apprentissage, puis appliqué aux ensembles de données d'apprentissage et de test.
8. Développement du modèle de forêt aléatoire
Un classificateur de forêt aléatoire a été initialisé avec 80 arbres, une profondeur maximale d'arbre de 10, un maximum de quatre caractéristiques, un minimum de cinq échantillons par feuille, et un état aléatoire fixé à 42. Le classificateur a été entraîné à l'aide du jeu de données d'entraînement standardisé.
9. Évaluation du modèle
Des étiquettes de classe ont été prédites pour les deux jeux de données, d'entraînement et de test. Une matrice de confusion a été établie, et l'exactitude, la précision, le rappel ainsi que le score F1 ont été calculés conjointement avec le rapport de classification. Les exactitudes d'entraînement et de test ont été enregistrées.
Pour l'évaluation par participant, veillez à ce que toutes les époques d'un participant donné soient attribuées exclusivement soit à l'ensemble d'entraînement, soit à l'ensemble de test. Le classificateur Forêt aléatoire a été entraîné en utilisant les mêmes hyperparamètres que dans l'analyse principale.
10. Validation croisée
En tant que procédure supplémentaire d'évaluation du modèle, une validation croisée stratifiée en cinq parties a été réalisée en utilisant shuffle = True et random_state = 30. La précision moyenne et l'écart type sur les cinq parties ont été calculés. Cette analyse a été considérée indépendamment de l'évaluation principale par réservation de sujets.
11. Analyse de la stabilité des caractéristiques
La stabilité des caractéristiques a été évaluée en répétant l'apprentissage du forêt aléatoire 10 fois à l'aide de graines aléatoires allant de 0 à 9. Pour chaque exécution, la précision sur l'ensemble de test et les scores d'importance des caractéristiques ont été enregistrés. La moyenne et l'écart type du score d'importance des caractéristiques ont été calculés pour chaque prédicteur sur l'ensemble des 10 exécutions, puis les prédicteurs ont été classés selon leur stabilité. Cette analyse a été utilisée pour évaluer la cohérence des classements des caractéristiques, et non pour remplacer l'évaluation principale au niveau des sujets.
12. Analyse d'intelligence artificielle explicative
L'expliqueur de type arbre SHAP (SHAP TreeExplainer) a été appliqué au modèle de forêt aléatoire entraîné. Les valeurs SHAP ont été calculées afin d'estimer la contribution de chaque caractéristique aux prédictions du modèle. La valeur moyenne absolue de SHAP a été calculée pour chaque caractéristique, et celles-ci ont été classées selon leur contribution SHAP. Les caractéristiques présentant des valeurs SHAP constamment faibles ont été identifiées et comparées aux résultats des analyses de stabilité des caractéristiques et de d de Cohen. Les caractéristiques montrant des contributions constamment faibles ont été sélectionnées pour une suppression ultérieure et un nouvel entraînement du modèle.
13. Analyse de la taille de l'effet statistique
La valeur d de Cohen a été calculée pour chaque biomarqueur EEG dans les comparaisons MA versus CS, MA versus DFT et DFT versus CS. L'ampleur de la taille de l'effet a été interprétée à l'aide de seuils fixés à 0,20 pour un effet faible, 0,50 pour un effet modéré et 0,80 pour un effet élevé.
14. Sélection intégrée des caractéristiques
Les résultats de l'analyse d'importance des caractéristiques par forêt aléatoire, de l'analyse SHAP et de l'analyse de Cohen’s d ont été comparés. Les prédicteurs qui présentaient de façon constante une faible importance des caractéristiques, une faible contribution SHAP et de petites tailles d'effet ont été identifiés comme candidats à l'élimination.
15. Ablation de caractéristiques
Les caractéristiques d'entropie ont été évaluées dans une analyse d'ablation exploratoire, et une matrice de caractéristiques réduite contenant la RMS, la DAP et l'âge a été construite. Le classificateur Forêt aléatoire a été réentraîné en utilisant les mêmes hyperparamètres. L'entraînement du modèle, les tests, la validation croisée et l'analyse de la caractéristique de fonctionnement du récepteur (ROC) ont été répétés à l'aide du jeu de caractéristiques réduit.
16. Analyse ROC
Les probabilités de classe ont été obtenues à partir du classificateur Random Forest optimisé. Des courbes ROC multiclasse ont été générées en utilisant une stratégie un-contre-le-reste. Les valeurs de la surface sous la courbe (AUC) spécifiques à chaque classe ainsi que l'AUC moyenne ont été calculées.
17. Comparaison des performances
Les performances du modèle complet basé sur les caractéristiques ont été comparées à celles du modèle réduit obtenu après l'ablation des caractéristiques en fonction de l'entropie.
Résultats
Le modèle de forêt aléatoire a atteint une précision d'apprentissage de 96 % et une précision de test de 92 %. Le score F1-moyenne macro était de 92 %, tandis que le score F1-moyenne pondérée était également de 92 %, indiquant des performances comparables entre les trois classes, alors que le score F1-moyenne pondérée était aussi de 92 %. La performance de classification était la plus élevée pour la classe maladie d'Alzheimer (AD), tandis que la classe démence frontotemporale (FTD) présentait des performances relativement plus faibles, comme indiqué dans Tableau 1.
Une analyse de la caractéristique de fonctionnement du récepteur (ROC) a été utilisée pour évaluer la séparation des classes selon différents seuils de classification. Comme indiqué dans Figure 2, la surface sous la courbe ROC (AUC) dépassait 0,98 pour les trois classes, indiquant une forte séparabilité entre les groupes de patients atteints de la maladie d'Alzheimer (AD), de démence à corps de Lewy (FTD) et du groupe témoin sain (HC).
Une analyse SHAP à l'aide de TreeExplainer a été réalisée afin d'évaluer les contributions des caractéristiques au modèle de classification par forêt aléatoire. Le graphique en barres récapitulatif de la Figure 3 présentait la contribution relative de la densité spectrale de puissance (PSD), de la racine carrée moyenne (RMS), de l'entropie et des caractéristiques démographiques. Les caractéristiques ayant des valeurs SHAP absolues plus élevées contribuaient davantage aux prédictions du modèle, tandis que les caractéristiques liées à l'entropie présentaient des contributions relativement faibles.
L'analyse de stabilité des caractéristiques a été réalisée en répétant l'entraînement de la forêt aléatoire selon les graines aléatoires spécifiées. La précision sur l'ensemble de test et les scores d'importance des caractéristiques ont été enregistrés pour chaque exécution, et la moyenne ainsi que l'écart type de l'importance des caractéristiques ont été calculés. Le modèle a atteint une précision moyenne de classification de 95 % dans cette analyse, avec un écart type de 0,17 %. Ces exécutions répétées ont principalement servi à évaluer la cohérence des classements des caractéristiques et ont été considérées indépendamment de l'évaluation principale par validation croisée à l'échelle des sujets. L'âge s'est classé parmi les premiers dans l'analyse de stabilité des caractéristiques, comme indiqué dans Tableau 2. Les caractéristiques theta_psd et theta_rms se sont également classées parmi les plus importantes, tandis que alpha_psd, alpha_rms, beta_psd et beta_rms ont montré une importance modérée.
Le d de Cohen a été calculé afin d'évaluer l'ampleur des différences entre groupes, comme indiqué dans le Tableau 3. L'atténuation dans la bande alpha (alpha_rms, d = 0,97 ; alpha_psd, d = 0,87) et l'augmentation de l'activité thêta (theta_rms, d = 0,72) ont montré les différences les plus marquées entre les participants atteints de la maladie d'Alzheimer (AD) et les témoins sains. Ces résultats sont cohérents avec le ralentissement cortical rapporté dans les études EEG de la démence34. Les caractéristiques basées sur l'entropie ont montré des tailles d'effet comparativement plus faibles. Les comparaisons entre AD et DFT ont révélé principalement des tailles d'effet allant de faible à modérée.
Les caractéristiques de la bande alpha ont montré de grandes tailles d'effet pour les comparaisons AD contre HC et FTD contre HC. Pour AD contre HC, les tailles d'effet rapportées étaient de −0,87 pour alpha_psd et de −0,97 pour alpha_rms. Pour FTD contre HC, l'atténuation de la bande alpha était de −0,73. La caractéristique theta_psd a montré une taille d'effet de 0,61 pour AD contre HC, tandis que theta_rms a montré une taille d'effet de 0,72. Des différences plus faibles ont été observées pour AD contre FTD.
Les caractéristiques de la bande bêta ont montré des tailles d'effet de groupe principalement faibles à modérées. Les tailles d'effet pour beta_psd étaient de −0,35 pour AD versus HC et de −0,41 pour AD versus FTD, tandis que beta_rms montrait surtout des effets faibles. Les caractéristiques de la bande gamma ont montré des effets modérés pour certaines comparaisons. La taille d'effet gamma_psd était de 0,47 pour FTD versus HC et de 0,20 pour AD versus HC, tandis que gamma_rms présentait une taille d'effet de 0,50 pour FTD versus HC.
Le delta PSD et le RMS ont montré de faibles effets de taille positive pour la MA contre HC (0,29 et 0,34, respectivement) et FTD contre HC (0,25 et 0,25, respectivement). Tailles d'effet pour la MA contre Les FTD étaient proches de zéro. L'entropie delta a montré des tailles d'effet faibles dans les trois comparaisons (0,08, 0,20 et −0,11).
Les analyses de stabilité des caractéristiques, de SHAP et de la taille de l'effet ont indiqué des contributions relativement faibles des caractéristiques d'entropie. Par conséquent, une analyse d'ablation a été réalisée en excluant les caractéristiques d'entropie et en conservant celles de la RMS, de la PSD et de l'âge. Après l'ablation des caractéristiques, le modèle de forêt aléatoire a atteint une précision d'apprentissage de 96 % et une précision de test de 94 %. Ce résultat a été interprété comme une comparaison exploratoire dans le cadre de sélection de caractéristiques évalué. La précision, le rappel, le score F1 et le nombre d'échantillons pour les classes AD, HC et FTD sont présentés dans Tableau 4.
Les performances avant et après l'ablacion des caractéristiques d'entropie sont comparées dans le Tableau 5. La précision lors des tests est passée de 92 % à 94 % après la suppression de l'entropie. Les changements par classe sont présentés dans le Tableau 6. Pour le TDF, la précision a augmenté de 4 % et le score F1 de 2 %. Le rappel pour le groupe HC a augmenté de 4 %, tandis que la précision a diminué de 2 %. Les mesures de performance moyenne macro et moyenne pondérée ont augmenté d’environ 1 % à 2 % suite à l’ablacion des caractéristiques.
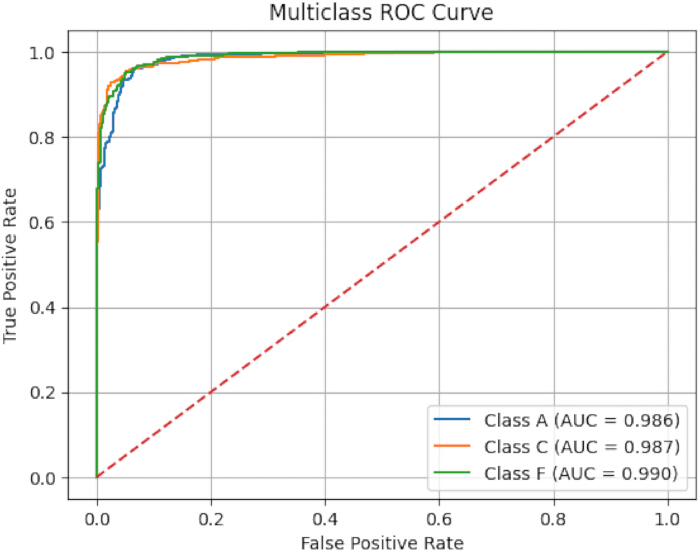
Figure 2: Courbes de caractéristique de fonctionnement du récepteur pour la maladie d'Alzheimer, la démence frontotemporale et les témoins sains. Courbes caractéristiques de fonctionnement du récepteur (ROC) multiclasse générées à l'aide de la méthode un-contre-touscontre-stratégie de repos pour la maladie d'Alzheimer (classe A), la démence frontotemporale (classe F) et les témoins sains (classe C). La surface sous la courbe (AUC) a été calculée pour chaque classe. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
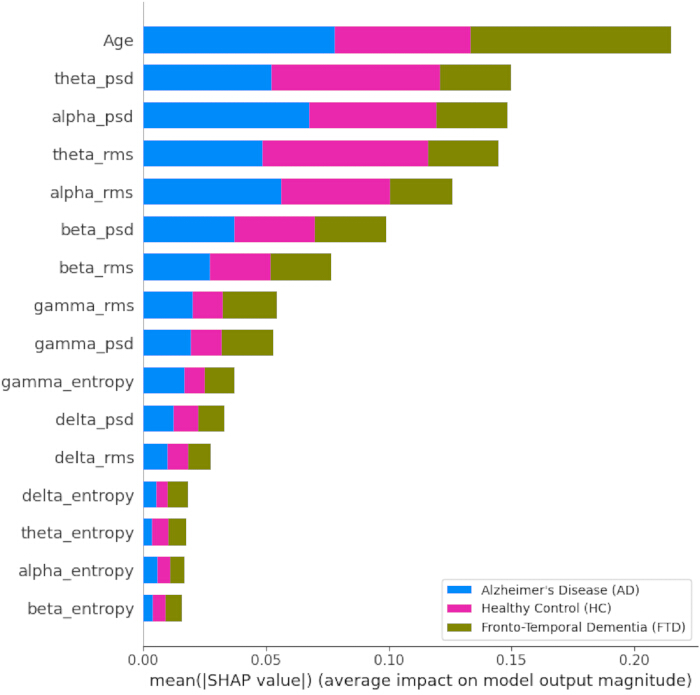
Figure 3 : Analyse récapitulative SHAP du modèle Random Forest entraîné. Graphique à barres récapitulatif montrant la contribution relative des caractéristiques dérivées de l'EEG et des caractéristiques démographiques au modèle de classification Random Forest. Les valeurs SHAP moyennes absolues ont été utilisées pour classer les contributions des caractéristiques suivantes : racine carrée moyenne (RMS), densité spectrale de puissance (PSD), entropie et âge. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Précision | Rappel | Score F1 | Support | |
| Alzheimer | 0.92 | 0.95 | 0.94 | 579 |
| Témoin | 0.93 | 0.92 | 0.93 | 480 |
| Démence frontotemporale | 0.93 | 0.87 | 0.9 | 314 |
| Moyenne macro | 0.93 | 0.92 | 0.92 | 1373 |
| Moyenne pondérée | 0.93 | 0.92 | 0.92 | 1373 |
Tableau 1 : Rapport de classification sur les données de test. Précision, rappel, score F1 et effectif pour les classes maladie d'Alzheimer, contrôle sain et démence frontotemporale dans l'ensemble de données de test, ainsi que les mesures de performance moyennes globales et moyennes pondérées.
| Caractéristique | Moyenne | Écart type |
| Âge | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
Tableau 2 : Classement de la stabilité des caractéristiques du modèle de forêt aléatoire. Valeurs moyennes d'importance des caractéristiques et variabilité correspondante obtenues à partir de plusieurs entraînements de forêts aléatoires utilisant des graines aléatoires allant de 0 à 9. Les caractéristiques ont été classées selon leur stabilité au cours des exécutions.
| Caractéristique | AD vs. HC | AD vs. FTD | FTD vs. HC |
| PSD du delta | 0.293 | -0.069 | 0.253 |
| PSD du theta | 0.612 | 0.23 | 0.355 |
| PSD de l'alpha | -0.869 | -0.219 | -0.64 |
| PSD du beta | -0.352 | -0.408 | 0.201 |
| PSD du gamma | 0.201 | -0.326 | 0.468 |
| Entropie du delta | 0.081 | 0.199 | -0.111 |
| Entropie du theta | 0.208 | 0.033 | 0.163 |
| Entropie de l'alpha | -0.061 | 0.071 | -0.137 |
| Entropie du beta | -0.37 | -0.042 | -0.332 |
| Entropie du gamma | -0.338 | 0.047 | -0.391 |
| RMS du delta | 0.342 | 0.041 | 0.251 |
| RMS du theta | 0.718 | 0.354 | 0.318 |
| RMS de l'alpha | -0.977 | -0.205 | -0.73 |
| RMS du beta | -0.494 | -0.365 | 0.015 |
| RMS du gamma | 0.187 | -0.33 | 0.5 |
Tableau 3 : Comparaison des tailles d'effet selon Cohen entre les groupes diagnostiques. Valeurs de d de Cohen pour les biomarqueurs EEG dans les comparaisons entre la maladie d'Alzheimer versus le témoin sain, la maladie d'Alzheimer versus la démence frontotemporale, et la démence frontotemporale versus le témoin sain.
| Précision | Rappel | Score F1 | Soutien | |
| Alzheimer | 0.94 | 0.95 | 0.94 | 579 |
| Témoin | 0.91 | 0.96 | 0.94 | 480 |
| Démence frontotemporale | 0.97 | 0.89 | 0.92 | 314 |
| Moyenne globale | 0.94 | 0.93 | 0.93 | 1373 |
| Moyenne pondérée | 0.94 | 0.94 | 0.94 | 1373 |
Tableau 4 : Rapport de classification après ablacion des caractéristiques. Précision, rappel, score F1 et effectif pour les classes maladie d'Alzheimer, contrôle sain et démence frontotemporale après suppression des caractéristiques d'entropie et réentraînement du modèle de forêt aléatoire.
| Métrique | Avant l'ablation | Après l'ablation | Changement |
| Précision d'apprentissage | 0.96 | 0.96 | 0 % de changement |
| Précision de test | 0.92 | 0.94 | +2 % d'amélioration |
| Précision macro | 0.93 | 0.94 | +1 % d'amélioration |
| Rappel macro | 0.92 | 0.93 | +1 % d'amélioration |
| Score-F1 macro | 0.92 | 0.93 | +1 % d'amélioration |
| Précision pondérée | 0.93 | 0.94 | +1 % d'amélioration |
| Rappel pondéré | 0.92 | 0.94 | +2 % d'amélioration |
| Score-F1 pondéré | 0.92 | 0.94 | +2 % d'amélioration |
Tableau 5 : Comparaison des performances avant et après l'ablation des caractéristiques. Comparaison des métriques de performance du modèle pour l'ensemble complet de caractéristiques multidomaines et l'ensemble réduit de caractéristiques obtenu après la suppression des caractéristiques d'entropie.
DISPONIBILITÉ DES DONNÉES :
Le jeu de données CSV traité utilisé pour le développement et l'analyse du modèle est fourni en tant que fichier supplémentaire 1. Le code de prétraitement est disponible dans un notebook Python à l'adresse https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, et les codes de construction du modèle et d'analyse sont disponibles à l'adresse https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. Le jeu de données CSV traité peut également être régénéré à l'aide du code de prétraitement fourni.
| Classe | Mesure | Avant | Après | Changement |
| Alzheimer | Précision | 0.92 | 0.94 | 0.02 |
| Rappel | 0.95 | 0.95 | Aucun changement | |
| Score F1 | 0.94 | 0.94 | Aucun changement | |
| Témoin | Précision | 0.93 | 0.91 | −2% |
| Rappel | 0.92 | 0.96 | 0.04 | |
| Score F1 | 0.93 | 0.94 | 0.01 | |
| FTD | Précision | 0.93 | 0.97 | 0.04 |
| Rappel | 0.87 | 0.89 | 0.02 | |
| Score F1 | 0.9 | 0.92 | 0.02 |
Tableau 6 : Évolution de la performance par classe avant et après l'ablation des caractéristiques. Évolutions de la précision, du rappel et du score F1 pour les classes maladie d'Alzheimer, contrôle sain et démence frontotemporale suite à la suppression des caractéristiques d'entropie.
Fichier supplémentaire 1 : jeu de données de caractéristiques EEG au niveau des époques, traité, utilisé pour le développement et l'analyse du modèle. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Le classificateur Forêt aléatoire a été utilisé pour classer des échantillons d'électroencéphalographie (EEG) en groupes de maladie d'Alzheimer (AD), de démence frontotemporale (FTD) et de témoins sains (HC), à l'aide de caractéristiques multidomaines, incluant la densité spectrale de puissance (PSD), la valeur efficace (RMS) et les mesures d'entropie. L'âge a été inclus comme variable démographique complémentaire. Étant donné que les distributions d'âge pouvaient différer selon les groupes diagnostiques, un biais de confusion démographique ne pouvait être entièrement exclu, et les performances rapportées reflétaient donc la contribution combinée des informations démographiques et électrophysiologiques. L'analyse a examiné la capacité des caractéristiques multidomaines de l'EEG à discriminer les groupes AD, FTD et HC, et a évalué la contribution des caractéristiques des bandes delta, theta, alpha, beta et gamma à la classification35. Les analyses de stabilité des caractéristiques et de taille d'effet ont indiqué que les caractéristiques basées sur la puissance, notamment la PSD et la RMS, contribuaient plus fortement que les caractéristiques basées sur l'entropie. Les biomarqueurs EEG extraits reflétaient également des profils associés à un ralentissement des rythmes et à une réduction de l'activité alpha.
Des études antérieures ont évalué des caractéristiques de l'EEG fondées sur l'entropie, la DSE (densité spectrale d'énergie) et la RMS (valeur efficace) à l'aide de différentes approches d'apprentissage automatique2,14,27,28,36,37. L'entropie avait été utilisée pour caractériser la complexité et l'irrégularité de l'EEG, tandis que la DSE avait servi à quantifier les caractéristiques spectrales2,14,27,28,36. La RMS avait également été évaluée comme caractéristique par bande de fréquence37. À partir du même jeu de données sous-jacent, des travaux antérieurs ont appliqué une classification binaire fondée sur la DSE avec une validation par exclusion d'un sujet33. L'analyse actuelle combine plutôt la RMS, l'entropie et la DSE dans les bandes alpha, beta, gamma, theta et delta, dans un cadre de classification multiclasse. Un transformateur léger pour l'EEG a été évalué sur le même jeu de données selon une stratégie de classification binaire par exclusion d'un sujet. Un transformateur léger pour l'EEG évalué sur le même jeu de données selon une stratégie de classification binaire par exclusion d'un sujet a rapporté une précision de 83,28 %. Une comparaison numérique directe avec les résultats actuels doit être interprétée avec prudence, car la tâche de classification et les procédures de validation diffèrent38.
Les caractéristiques de la bande alpha ont montré les tailles d'effet les plus élevées pour différencier la MA de la CS et la DFT de la CS, et une activité thêta accrue a également contribué à la différenciation de la MA par rapport à la CS. Les caractéristiques de la bande bêta ont présenté des effets plus faibles entre les groupes, tandis que les caractéristiques basées sur l'entropie ont montré une utilité discriminante relativement limitée. Les caractéristiques de la bande gamma ont montré des effets modérés pour certaines comparaisons, notamment DFT versus CS. Des études antérieures ont signalé une puissance alpha réduite et une activité thêta altérée dans la MA et dans des comparaisons diagnostiques connexes23,25,39. L'entropie a également été décrite comme un biomarqueur potentiellement informatif dans les maladies neurodégénératives36, indiquant que sa contribution peut varier selon le jeu de données, la définition des caractéristiques et l'approche analytique.
Les machines à vecteurs de support avaient été fréquemment utilisées dans des études précédentes de classification d'EEG3,21,24,37. Le classificateur Forêt aléatoire utilisé dans l'analyse actuelle fournissait des estimations d'importance des caractéristiques et était applicable à l'ensemble structuré de caractéristiques utilisé dans cette étude40,41. Des précisions d'apprentissage et de test de 96 % et 94 %, respectivement, ont été obtenues après l'ablation des caractéristiques d'entropie. La suppression des caractéristiques d'entropie a été associée à une amélioration des performances du modèle, confirmant la contribution relative moindre observée pour ces caractéristiques dans les analyses de stabilité, de SHAP et de taille de l'effet. Des approches basées sur l'apprentissage profond et les transformeurs ont également été appliquées à la classification de l'EEG, bien que ces approches nécessitent généralement des ensembles de données plus volumineux et soient conçues pour des représentations de plus haute dimension ou séquentielles27,39,42,43,44,45.
Les signaux EEG sont bruités et non stationnaires, et les modèles basés sur des ensembles d'arbres peuvent offrir une robustesse lors de l'analyse de représentations structurées de caractéristiques. Dans la présente étude, la valeur efficace (RMS), la densité spectrale de puissance (PSD), l'entropie et l'âge ont été évalués comme entrées complémentaires pour le modèle de forêt aléatoire. La RMS représentait l'amplitude du signal dans des bandes de fréquence, la PSD représentait la puissance spectrale, et l'entropie représentait la complexité du signal. Les résultats ont indiqué que la PSD et la RMS contribuaient plus fortement que l'entropie à la classification dans le cadre évalué. L'âge a également contribué au modèle, bien que son inclusion ait introduit un risque de confusion démographique. De futures recherches pourraient évaluer d'autres variables démographiques ainsi que d'autres approches d'apprentissage automatique ou d'apprentissage profond sur des jeux de données plus larges afin d'évaluer davantage la généralisabilité et les performances de classification.
Déclarations de divulgation
Aucun intérêt financier concurrent, relation personnelle, relation financière ou autre activité susceptible d'avoir influencé les travaux rapportés dans cette étude n'a été déclaré.
Remerciements
Nous reconnaissons le jeu de données EEG disponible publiquement utilisé dans cette étude ainsi que les contributions des chercheurs qui ont rendu ce jeu de données accessible à des fins de recherche. Aucun financement spécifique n'a été obtenu auprès d'organismes publics, commerciaux ou à but non lucratif.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | Environnement de calcul basé sur le cloud utilisé pour exécuter les carnets d'analyse | |
| MNE-Python | MNE-Python project | 1.12.1 | Utilisé pour le prétraitement des EEG, le référencement, le filtrage et la segmentation en époques |
| NumPy | NumPy project | (2.0.2) | Utilisé pour les calculs numériques et les opérations sur tableaux |
| OpenNeuro EEG dataset | OpenNeuro | ds004504, (1.0.9) | Jeu de données EEG publiquement disponible contenant des enregistrements de patients atteints de la maladie d'Alzheimer (AD), de démence frontotemporale (FTD) et de sujets témoins sains (HC) |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Environnement de programmation utilisé pour le traitement des données et le développement de modèles |
| scikit-learn | scikit-learn project | 1.6.1 | Utilisé pour le prétraitement, la séparation groupée des données, la classification par forêts aléatoires et l'évaluation des performances |
| SciPy | SciPy project | (1.16.3) | Utilisé pour les calculs de traitement du signal et les analyses statistiques |
| SHAP | SHAP project | 0.52.0 | Utilisé pour l'analyse d'intelligence artificielle explicative avec TreeExplainer |
Références
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379