Cette étude présente un cadre léger permettant de réduire les hallucinations dans les grands modèles linguistiques grâce à une vérification au niveau des affirmations et un seuil statistique adaptatif. En corrigeant sélectivement les affirmations non étayées à l'aide de l'inférence du langage naturel, cette approche améliore la précision factuelle tout en maintenant une faible latence de réponse et une efficacité pratique du déploiement.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Vérification adaptative des affirmations guidée par l'NLI avec modélisation décisionnelle statistique pour la réduction à faible latence des hallucinations dans les grands modèles de langage
Dans cet article
Résumé
Résumé
Les grands modèles linguistiques (LLM) présentent une tendance critique à produire des sorties factuellement incorrectes mais linguistiquement fluides — un phénomène appelé hallucination — qui pose de graves risques dans les applications exigeant une grande précision. Les stratégies actuelles d'atténuation, notamment la génération assistée par récupération et l'échantillonnage par auto-cohérence, introduisent soit une latence importante lors de l'inférence, soit dépendent d'une infrastructure externe de connaissances, limitant ainsi leur applicabilité dans les déploiements en temps réel. Cet article propose un cadre léger de vérification des affirmations en deux étapes, qui décompose les réponses des LLM en affirmations factuelles élémentaires et vérifie indépendamment chaque affirmation extraite par rapport à une référence générée séparément, obtenue via une consigne isolée de rappel factuel. Bien que le générateur et le vérificateur partagent le même modèle linguistique sous-jacent, la séparation entre la génération de la réponse et le rappel factuel réduit la conditionnalité directe de la réponse et atténue le biais de confirmation durant la vérification, en utilisant l'inférence en langue naturelle (NLI), et en appliquant un seuil statistique adaptatif — défini comme τ = µ + kσ sur la distribution des scores de confiance NLI — afin de corriger sélectivement uniquement les affirmations contredites. Contrairement aux méthodes antérieures basées sur la NLI qui reposent sur des seuils de décision fixes, le cadre proposé adapte dynamiquement son seuil de vérification à la distribution de confiance de chaque réponse, offrant ainsi des performances stables sur l'ensemble des référentiels évalués, sans nécessiter de réentraînement du modèle. Évalué sur TruthfulQA et FEVER, le cadre réduit le taux d'hallucination de 28 % à 9 % sur TruthfulQA — soit une réduction relative de 67,9 % — tout en ajoutant seulement 160 ms de latence supplémentaire par rapport au LLM de base, surpassant ainsi SelfCheckGPT et FActScore en précision de détection des hallucinations. Ces résultats indiquent que le cadre permet d'obtenir un bon compromis entre fiabilité factuelle et latence de réponse sur les référentiels évalués, bien qu'une validation supplémentaire dans divers domaines et contextes de déploiement soit nécessaire.
Introduction
Les modèles de langage de grande taille (LLMs) se sont imposés comme des composants fondamentaux des systèmes modernes d'intelligence artificielle, démontrant des capacités remarquables dans un large éventail de tâches de traitement du langage naturel, notamment la génération de texte, la réponse à des questions, la synthèse et le raisonnement complexe.1Leur capacité à produire des réponses fluides et cohérentes dans un contexte donné a accéléré leur adoption dans des domaines à fort impact tels que l'aide à la décision clinique, l'analyse juridique, le génie logiciel et la technologie éducative.2Cependant, une limitation critique et persistante compromet leur fiabilité dans ces contextes : l’hallucination, un phénomène dans lequel les modèles produisent des réponses linguistiquement fluides mais factuellement incorrectes, non étayées ou entièrement fabriquées 3. Des études empiriques font état de taux d’hallucination variant de 15 % à plus de 40 %, selon la tâche et le modèle, et même des systèmes à l’état de l’art comme GPT-4 présentent des incohérences factuelles mesurables lors d’évaluations spécifiques à un domaine.2,3Cette limitation comporte de sérieux risques dans les applications nécessitant une grande précision, où des résultats erronés peuvent entraîner une désinformation, un diagnostic incorrect ou une prise de décision défaillante.4Les hallucinations découlent fondamentalement de la nature probabiliste de la modélisation du langage : les grands modèles linguistiques génèrent des tokens en prédisant les prolongements statistiquement probables de séquences d'entrée, plutôt qu'en extrayant ou en raisonnant à partir de connaissances factuelles vérifiées.5Par conséquent, les résultats générés peuvent intégrer des affirmations crédibles en apparence mais inexactes, introduire des allégations non étayées ou confondre des concepts sémantiquement apparentés mais factuellement distincts.6.
Les stratégies d'atténuation existantes abordent ce problème selon plusieurs paradigmes, chacun présentant des limites notables. La génération assistée par récupération (Retrieval-Augmented Generation, RAG) réduit les hallucinations en ancrant les réponses dans des documents externes récupérés, mais introduit un surcoût de latence important, nécessite un accès à des bases de connaissances maintenues et reste vulnérable aux échecs de récupération dans des domaines spécialisés ou à ressources limitées7,8,9.
Bien que le générateur de réponses et le générateur de références soient instanciés à l'aide du même modèle sous-jacent GPT-3.5 Turbo, ils fonctionnent selon des objectifs de sollicitation et des contextes d'exécution différents. Le générateur de réponses produit une réponse sans contrainte à la requête de l'utilisateur, tandis que le générateur de références effectue une tâche isolée de rappel factuel, sans accès à la réponse précédemment générée. Cette séparation réduit les effets directs de conditionnement de la réponse et limite les biais de confirmation lors de la vérification des affirmations. Le cadre considère donc la référence générée comme indépendante sur le plan procédural, plutôt que statistiquement indépendante.
Des recherches récentes ont également exploré des stratégies de décodage légères afin de réduire les hallucinations dans la génération de texte, sans dépendre de la récupération externe ni de la vérification répétée. Une approche représentative est le décodage par contraste de couches (Decoding by Contrasting Layers, DoLA), qui améliore la véracité en comparant les représentations provenant des couches intermédiaires et finales du transformeur pendant le décodage. Contrairement aux cadres de vérification post-génération, ces méthodes interviennent directement durant la génération des tokens et optimisent ainsi une étape différente du processus de génération linguistique. Ces stratégies complémentaires montrent que la réduction des hallucinations peut être réalisée soit pendant le décodage, soit par vérification post-génération, chaque approche offrant des compromis distincts en termes de surcharge computationnelle, de complexité de mise en œuvre et de fiabilité factuelle.
Les méthodes d'auto-cohérence améliorent la fiabilité factuelle en échantillonnant plusieurs réponses et en sélectionnant la sortie la plus fréquente ou la plus cohérente, mais leur coût computationnel augmente linéairement avec le nombre d'échantillons, ce qui les rend inadaptées aux déploiements sensibles à la latence8. Les approches itératives de raffinement, qui révisent à plusieurs reprises les sorties par des boucles de rétroaction interne, réduisent progressivement les taux d'erreur, mais prolongent considérablement le temps d'inférence à chaque passage supplémentaire9. Les méthodes de vérification basées sur l'inférence naturelle (NLI) offrent une alternative plus ciblée en évaluant l'implication sémantique entre les affirmations générées et les textes de référence, mais les implémentations existantes reposent sur des seuils de décision fixes qui ne s'adaptent pas aux différentes distributions de confiance, domaines ou comportements des modèles10,11. Dans leur ensemble, ces approches imposent soit une surcharge computationnelle inacceptable, soit dépendent d'une infrastructure externe, soit manquent de l'adaptabilité nécessaire à un déploiement généralisé. Une comparaison des caractéristiques principales de ces approches de vérification des hallucinations est fournie dans le tableau supplémentaire 1.
Cet article propose un cadre de vérification de faits léger en deux étapes, conçu pour réduire les hallucinations dans les sorties des grands modèles linguistiques (LLM) tout en maintenant une faible latence de réponse. Dans la première étape, le LLM génère une réponse initiale, qui est ensuite décomposée en faits élémentaires. Dans la seconde étape, chaque fait est vérifié à l’aide de l’inférence en langue naturelle (Natural Language Inference, NLI) par rapport à une référence factuelle générée séparément lors d’un passage de raisonnement isolé n’ayant pas accès à la réponse initialement produite, et un seuil de confiance dérivé statistiquement régit la décision d’acceptation ou de correction au niveau de chaque fait. Les principales contributions de ce travail sont les suivantes : (1) Un pipeline de vérification au niveau des faits en deux étapes, qui dissocie la génération de la réponse de la validation factuelle, permettant ainsi une évaluation indépendante et ciblée de chaque fait élémentaire sans nécessiter de récupération externe ni de régénération complète de la réponse ; (2) Un mécanisme adaptatif de seuil statistique fondé sur la distribution des scores de confiance NLI (τ = µ + kσ), qui détermine dynamiquement les seuils d’acceptation et de correction plutôt que de s’appuyer sur des règles de décision fixes, améliorant ainsi la robustesse face à des distributions de confiance variables ; (3) Une stratégie de correction sélective qui limite la régénération aux seuls faits classés comme contradictoires, réduisant ainsi de manière significative la surcharge computationnelle par rapport aux approches de rééchantillonnage complet ou de raffinement itératif ; (4) Une évaluation empirique sur un jeu de données axé sur les hallucinations, démontrant que le cadre proposé réduit les taux d’hallucination de 28 % à 9 % tout en maintenant la latence de réponse dans des limites compatibles avec un déploiement pratique.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude n'a pas impliqué de participants humains, d'animaux, d'échantillons biologiques ni de données de patients. Par conséquent, une approbation éthique institutionnelle et un consentement éclairé n'étaient pas requis.
Aperçu de la conception de l'étude
Un cadre de vérification en deux étapes a été mis en œuvre pour améliorer la fiabilité factuelle des sorties des grands modèles linguistiques (LLM). La procédure comprenait la génération de réponses, l'extraction d'affirmations, la construction isolée de références, la vérification fondée sur l'inférence en langage naturel (NLI), la prise de décision statistique adaptative, la correction sélective et l'assemblage final de la réponse. Le cadre a été évalué à l'aide des ensembles de données de référence TruthfulQA et FEVER.
Flux opérationnel global
Requête de l'utilisateur → Génération de la réponse initiale → Extraction des affirmations → Génération indépendante des références → Vérification par inférence naturelle (NLI) → Calcul du seuil statistique → Correction des affirmations → Réponse finale vérifiée. Le flux de travail global du cadre adaptatif de vérification des affirmations est illustré dans Figure 1.
Préparation du jeu de données
Le jeu de données TruthfulQA12, contenant 817 questions axées sur des faits, a été téléchargé et préparé pour l'évaluation. Le jeu de données FEVER13 comprend 185 445 affirmations annotées étiquetées comme étant Supportées, Réfutées ou Ne contenant pas assez d'informations ; l'évaluation a utilisé les données de développement étiquetées, avec leurs champs d'affirmation, de preuve et d'étiquette de vérité terrain. Chaque affirmation a été évaluée par rapport à la preuve fournie, tandis que l'étiquette FEVER d'origine a été conservée comme résultat de référence pour la vérification. Le jeu de données FEVER, qui contient des paires affirmation-preuve pour la vérification de faits, a été obtenu et prétraité. Les questions et affirmations d'entrée ont été converties en un format texte normalisé. Les entrées en double et les échantillons incomplets ont été supprimés avant l'expérimentation. TruthfulQA a été divisé en sous-ensembles de validation et de test. Environ 20 % des échantillons de TruthfulQA (164 questions) ont été utilisés pour le réglage du seuil, tandis que les 653 questions restantes ont été réservées pour l'évaluation des performances. Pour FEVER, les affirmations fournies par le benchmark ont été utilisées directement comme unités de vérification et n'ont pas subi la procédure de génération de réponse et d'extraction d'affirmation appliquée à TruthfulQA. Les caractéristiques des jeux de données de référence utilisés pour le développement et l'évaluation du cadre sont résumées dans Tableau 1.
Génération de la réponse initiale
Chaque requête a été soumise au modèle linguistique de base. Les réponses ont été générées à l'aide d'un échantillonnage par noyau avec une température de 0,7 et un top-p de 0,9. La longueur maximale de sortie était limitée à 256 jetons. Les réponses générées ont été stockées sans post-traitement ni modification manuelle. Le texte généré a été transmis directement à l'étape d'extraction des affirmations.
Extraction de revendications
Chaque réponse générée a été décomposée en énoncés factuels indépendamment vérifiables. Un modèle de décomposition structuré a été utilisé pour identifier les affirmations élémentaires. Les énoncés composés ont été séparés en unités factuelles minimales. Les opinions subjectives, les expressions stylistiques et les éléments superflus de conversation ont été supprimés. Chaque affirmation extraite a été stockée comme une unité de vérification indépendante.
Exemple :
Réponse d'origine :
« Marie Curie était une physicienne et chimiste d'origine polonaise qui a mené des recherches pionnières sur la radioactivité. »
Revendications extraites : (1) Marie Curie était d'origine polonaise ; (2) Marie Curie était physicienne et chimiste ; (3) Marie Curie a mené des recherches sur la radioactivité.
Construction de références isolées :
Pour chaque affirmation extraite, une référence factuelle indépendante a été générée. Le modèle de vérification a reçu uniquement la requête initiale de l'utilisateur. L'accès à la réponse générée initialement a été restreint afin d'éviter tout biais de confirmation. Un prompt de rappel factuel a été utilisé pour encourager des réponses concises et fondées sur des preuves. Les références générées ont été stockées en vue d'une vérification ultérieure.
Vérification de l'inférence en langage naturel
Chaque paire affirmation-référence a été soumise à un modèle NLI pré-entraîné. Le modèle NLI a classé la relation comme suit : implication, neutre ou contradiction. Les probabilités de confiance pour les trois classes ont été enregistrées. Un score de vérification signé a été attribué : une valeur positive pour l'implication, zéro pour le cas neutre, ou une valeur négative en cas de contradiction. Tous les scores de vérification ont été regroupés pour le calcul du seuil.
Calcul du seuil statistique adaptatif
La confiance de vérification produite par le modèle NLI varie considérablement selon les réponses, car différentes requêtes génèrent un nombre variable d'assertions, un niveau différent de complexité sémantique et des distributions de confiance distinctes. Un seuil global fixe suppose que toutes les réponses suivent un profil de confiance similaire, ce qui est rarement observé en pratique. Pour tenir compte de cette variabilité, le cadre proposé estime la frontière de décision individuellement pour chaque réponse à l’aide de la moyenne et de l’écart type de ses scores de vérification. La moyenne reflète le niveau global de confiance de la réponse, tandis que l’écart type capture la dispersion des valeurs de confiance parmi les assertions extraites. Cette formulation adaptative permet au critère d’acceptation de s’ajuster à l’incertitude propre à chaque réponse, plutôt que de s’appuyer sur un seuil unique pour toutes les entrées.
La moyenne (µ) et l'écart type (σ) de tous les scores de vérification signés ont été calculés.
Le seuil de décision adaptatif a été calculé comme suit :

où τ représente le seuil adaptatif, µ désigne la moyenne des scores de vérification, σ désigne l'écart type, et k représente le paramètre de sensibilité.
Le paramètre de sensibilité a été initialisé à 0,7. Les affirmations classées comme impliquant des scores supérieurs ou égaux à +τ ont été acceptées. Les affirmations classées comme contradictoires avec des scores inférieurs ou égaux à −τ ont été marquées pour correction. Les affirmations dont les scores se situaient dans l'intervalle (−τ, +τ) ont été conservées comme neutres.
Correction sélective des revendications
Une réclamation était transmise pour correction uniquement lorsque le modèle NLI classait la paire réclamation-référence comme une contradiction, et que son score de vérification signé correspondant satisfaisait au critère de seuil adaptatif si ≤ -τ. Ainsi, la décision de correction était déterminée conjointement par l'étiquette de classe NLI et le seuil statistique spécifique à la réponse. Les réclamations classées comme impliquant une relation d'inférence (Entailment) avec si ≥ τ étaient acceptées, tandis que celles tombant dans l'intervalle -τ < si < τ étaient considérées comme neutres et conservées sans correction. Ce critère combiné garantissait que la correction n'était appliquée qu'aux réclamations présentant à la fois une contradiction sémantique et des preuves de vérification négatives suffisamment fortes.
Reconstruction de la réponse
Les affirmations acceptées et corrigées ont été organisées selon leur séquence d'origine. Les limites des phrases ont été rétablies afin de préserver la lisibilité. Des ajustements grammaticaux mineurs ont été appliqués lorsque nécessaire. Le résultat assemblé a été enregistré comme la réponse finale vérifiée.
Évaluation des performances
Le cadre a été évalué à l'aide de quatre métriques : (1) Précision : la proportion de réponses restées factuellement correctes après vérification ; (2) Score F1 : la moyenne harmonique de la précision et du rappel dans la détection des hallucinations ; (3) Latence de réponse : le temps total de traitement entre la soumission de la requête et la génération de la réponse vérifiée ; (4) Taux d'hallucination
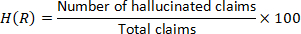
La latence a été indiquée comme le temps moyen d'exécution sur plusieurs mesures répétées. Étant donné que les valeurs individuelles de latence par exécution n'ont pas été conservées, les écarts types et les intervalles de confiance n'ont pas été calculés.
Évaluation de la justesse propre à chaque référence
Pour TruthfulQA, la réponse finale vérifiée a été comparée aux références de réponses validées par des humains du benchmark ainsi qu'aux listes de réponses incorrectes. Une réponse était considérée comme correcte lorsque ses affirmations factuelles étaient conformes aux informations de la réponse acceptée et ne contenaient aucun contenu correspondant aux motifs de réponses incorrectes identifiés. Pour FEVER, chaque affirmation de la sortie finale a été évaluée par rapport à ses preuves associées et à l'annotation FEVER d'origine ; les affirmations étiquetées « Supportées » ont été considérées comme factuellement vérifiées, tandis que celles étiquetées « Réfutées » ont été comptabilisées comme incorrectes. Les cas « Pas assez d'informations » ont été conservés comme indéterminés, sans être considérés comme une preuve factuelle positive. Les décisions au niveau des affirmations ont ensuite été agrégées pour chaque benchmark afin de calculer la Précision et le Taux d'hallucination rapportés.
Environnement expérimental
Le cadre a été mis en œuvre à l'aide de Python 3.9. Les opérations de traitement des données ont été effectuées à l'aide de bibliothèques d'analyse numérique et tabulaire. Le modèle NLI a fonctionné en mode inférence, sans réglage fin supplémentaire. Les expériences ont été exécutées sur une station de travail équipée d'un processeur Intel Core i5, de 16 Go de RAM et d'un système d'exploitation 64 bits. Toutes les évaluations ont été réalisées en utilisant un paramètre d'inférence en un seul passage afin d'assurer un fonctionnement à faible latence. Toutes les expériences ont été menées avec des configurations matérielles et logicielles identiques afin de garantir une évaluation cohérente entre les ensembles de données et les méthodes de référence.
Résultat attendu
Le protocole est conçu pour produire des décisions de vérification au niveau des affirmations en identifiant les affirmations potentiellement non étayées et en transférant de façon sélective les affirmations fortement contredites afin de les corriger. Le résultat attendu est une réponse vérifiée présentant moins d'incohérences factuelles et un surcroît de traitement limité, sous réserve des performances observées lors de l'évaluation expérimentale.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Génération de la réponse initiale
Le modèle linguistique de base a produit des réponses fluides et contextuellement pertinentes aux questions des deux ensembles de données de référence. Toutefois, un examen détaillé a révélé des affirmations non étayées et factuellement inexactes dans plusieurs réponses. Sur l'ensemble de données TruthfulQA, le système de base a présenté un taux d'hallucination de 28 %, tandis qu'un taux d'hallucination de 26 % a été observé sur l'ensemble de ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Le cadre proposé a amélioré les performances de vérification factuelle tout en évitant l'échantillonnage répété et la récupération externe. Sur TruthfulQA, le taux d'hallucination est passé de 28 % pour le modèle LLM de référence à 9 % avec le cadre complet, tandis que la précision est passée de 0,72 à 0,87. Sur FEVER, le taux d'hallucination est passé de 26 % à 10 %, la précision augmentant de 0,74 à 0,89. Ces comparaisons doivent être interprétées dans le contexte des paramètres expérimentaux et des implémentations uti...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n'ont aucune incompatibilité d'intérêts à déclarer.
Remerciements
Les auteurs tiennent à exprimer leur profonde gratitude à leur établissement pour avoir fourni le cadre académique et les ressources informatiques nécessaires à la réalisation de cette recherche. Les auteurs remercient également les développeurs et mainteneurs des ensembles de données de référence accessibles au public utilisés dans cette étude, qui ont permis une évaluation complète du cadre proposé. Ils remercient leurs collègues et les relecteurs pour leurs commentaires constructifs, qui ont contribué à améliorer la qualité et la clarté de ce travail. Les auteurs remercient par ailleurs la communauté de recherche open source pour les bibliothèques logicielles et outils mis à disposition, qui ont facilité les expérimentations, l'analyse des données et la visualisation des résultats. Leurs efforts continus ont considérablement fait progresser la recherche en traitement du langage naturel et en intelligence artificielle fiable. Les auteurs déclarent qu'aucun soutien financier externe ni financement n'a été reçu pour cette recherche.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Jeu de données de référence FEVER | Tâche partagée FEVER (Thorne et al.) | https://fever.ai/dataset/fever.html | Jeu de données publiquement disponible de paires affirmation-preuve utilisé pour l'évaluation |
| GPT-3.5 Turbo (grand modèle linguistique B10+2:12:12 | OpenAI | Identifiant du modèle : gpt-3.5-turbo ; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Utilisé à la fois comme générateur de réponses et comme générateur de référence indépendant, accessible via l'API OpenAI |
| NumPy | Développeurs de NumPy (logiciel libre) | https://numpy.org/ | Bibliothèque de calcul numérique utilisée pour les calculs statistiques, notamment la moyenne et l'écart type des scores de vérification NLI |
| Openai (bibliothèque cliente Python) | OpenAI | https://github.com/openai/openai-python | Bibliothèque cliente Python utilisée pour soumettre des invites et récupérer les complétions de GPT-3.5 Turbo |
| pandas | Équipe de développement de pandas (logiciel libre) | https://pandas.pydata.org/ | Bibliothèque d'analyse de données tabulaires utilisée pour le prétraitement des jeux de données et la gestion des résultats |
| Modèle préentraîné de classification d'inférence en langage naturel (NLI) | Plateforme de modèles Hugging Face (modèle basé sur l'architecture Microsoft DeBERTa-v3-large) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Utilisé en mode inférence, sans affinage, pour classer chaque paire affirmation-référence comme entraînement, neutre ou contradiction |
| Python | Fondation Python | Version 3.9 ; https://www.python.org/downloads/release/python-390/ | Langage de programmation principal utilisé pour implémenter le cadre de vérification |
| SciPy | Développeurs de SciPy (logiciel libre) | https://scipy.org/ | Bibliothèque de calcul scientifique utilisée pour soutenir l'analyse statistique des résultats expérimentaux |
| Transformers (bibliothèque Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | Bibliothèque Python utilisée pour charger et exécuter le modèle NLI préentraîné |
| Jeu de données de référence TruthfulQA | Initialement publié par Lin, Hilton et Evans | https://github.com/sylinrl/TruthfulQA | Jeu de données de référence publiquement disponible comprenant 817 questions factuelles, utilisé pour le réglage du seuil et l'évaluation |
| Ordinateur de station de travail | Non spécifié dans le manuscrit (veuillez confirmer le fabricant/modèle) | Processeur Intel Core i5 ; 16 Go de RAM ; système d'exploitation 64 bits | Matériel utilisé pour exécuter toutes les expériences dans des configurations identiques |
| Remarque : tous les URL répertoriés ci-dessus ont été vérifiés et confirmés actifs à la date de ce tableau. |
Références
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Réimpressions et autorisations
Cet article a été publié
Vidéo bientôt disponible