Cet article propose un modèle nouveau, les réseaux neuronaux graphiques à attention linéaire à emplacements avec porte pour la recommandation basée sur des sessions, qui adopte une attention linéaire à emplacements avec porte basée sur un graphe de session doublement construit. Ce modèle améliore la précision et l'efficacité des recommandations et surpasse l'état de l'art sur trois jeux de données publics.
Article de recherche
Réseaux de neurones graphiques à attention linéaire à fentes gâchées pour la recommandation basée sur les sessions
Dans cet article
Résumé
Résumé
Les systèmes de recommandation basés sur des sessions (SBR) visent à prédire l'élément suivant avec lequel un utilisateur est susceptible d'interagir, en se basant sur la séquence de comportements observée au cours de la session en cours. Les approches récentes exploitant le mécanisme d'attention du modèle Transformer (par exemple, GC-SAN) ont montré des performances supérieures par rapport aux méthodes traditionnelles ; toutefois, elles souffrent d'une charge de calcul élevée et d'une complexité spatiale importante en raison du coût quadratique de l'auto-attention. Pour pallier ces limitations, un nouveau modèle appelé GSLA4Rec (réseaux neuronaux graphiques à attention linéaire à emplacements avec porte logique pour la recommandation basée sur les sessions) est proposé, intégrant une attention linéaire combinée à un mécanisme de porte apprenable et à une stratégie de mise à jour de la mémoire basée sur des emplacements, inspirée de l'attention à emplacements avec porte. Plus précisément, GSLA4Rec construit d'abord deux graphes : un graphe de session permettant de capturer les transitions entre éléments au sein d'une même session, et un graphe global de voisinage destiné à encoder des signaux collaboratifs entre sessions, modélisant ainsi des informations contextuelles locales et globales. L'approche proposée repose sur le mécanisme d'attention linéaire à emplacements avec porte, qui (1) utilise des unités de porte pour atténuer le bruit provenant d'interactions non pertinentes ou redondantes dans les sessions longues, (2) exploite des unités d'emplacement pour stocker dynamiquement et mettre à jour des représentations compactes de la session—réduisant ainsi la surcharge mémoire, et (3) remplace l'auto-attention par une attention linéaire afin d'atteindre une complexité temporelle linéaire. Ensemble, ces composants améliorent significativement la précision prédictive et l'efficacité du modèle pour capturer les intérêts évolutifs des utilisateurs. Des expériences approfondies menées sur plusieurs jeux de données de référence publics, notamment Diginetica, Tmall et NowPlaying, montrent que GSLA4Rec surpasse systématiquement les méthodes SBR à l'état de l'art en matière de performance de recommandation, ce qui valide l'efficacité du mécanisme GSLA.
Introduction
Avec le développement rapide des services en ligne (tels que le commerce électronique, les plateformes de courtes vidéos et les fils d'actualité), le problème de la surcharge d'information est devenu de plus en plus marqué et grave. Les systèmes de recommandation1,2 fournissent des services de diffusion d'informations personnalisés et précis en analysant en profondeur les données comportementales des utilisateurs. Toutefois, dans de nombreuses applications pratiques caractérisées par un accès anonyme, des utilisateurs non connectés, la protection de la vie privée et des durées d'interaction courtes, les méthodes traditionnelles de recommandation telles que le filtrage collaboratif3 et la factorisation de matrices4,5 limitent fortement l'applicabilité des algorithmes de recommandation. Pour relever ces défis, la recommandation basée sur les sessions (SBR)6,7,8,9 a émergé. La SBR se concentre sur les données de séquence d'interactions au sein de la session en cours de l'utilisateur afin de prédire le prochain point d'intérêt potentiel. Ce paradigme évite non seulement la dépendance aux données historiques à long terme des utilisateurs, mais capte également avec acuité les changements dynamiques d'intérêts à court terme, démontrant ainsi une valeur d'application unique dans des scénarios tels que le commerce électronique, les courtes vidéos, la recommandation musicale, etc.
Les premières méthodes reposaient principalement sur les chaînes de Markov5,10,11,12 modéliser les probabilités de transition entre les éléments dans les séquences de sessions. Bien que ces méthodes permettent de capturer les dépendances de premier ordre dans les séquences, la caractérisation des dépendances complexes d'ordre supérieur et des dynamiques non linéaires des intérêts des utilisateurs reste limitée, ce qui restreint l'efficacité des modèles dans des scénarios complexes. Avec le développement de la technologie d'apprentissage profond13,14, les méthodes basées sur les réseaux neuronaux ont été largement appliquées dans le SBR. GRU4REC15a été le premier à appliquer des réseaux neuronaux récurrents14 (RNN) à la recommandation basée sur des sessions, en capturant efficacement les dépendances temporelles dans les séquences ; NARM16a encore amélioré la capacité d'analyse des centres d'intérêt des utilisateurs principaux en intégrant des mécanismes d'attention aux RNN ; STAMP17 ont utilisé des perceptrons multicouches (MLP) combinés à des mécanismes d'attention afin de se concentrer sur la capture des intérêts à court terme des utilisateurs. Bien que ces méthodes aient permis des progrès dans la modélisation de séquences, elles rencontraient encore des difficultés, telles que la gestion des dépendances à long terme et la sensibilité au bruit.
Ces dernières années, les réseaux neuronaux graphiques (GNNs)18,19,20,21 ont apporté une nouvelle perspective à la tâche de recommandation basée sur les sessions (SBR). Des modèles tels que SR-GNN22 modélisent explicitement les relations complexes de transition en construisant un graphe de session (SG), obtenant ainsi des améliorations substantielles en termes de précision des recommandations. Toutefois, la plupart des méthodes existantes basées sur les GNN effectuent la construction du graphe et le passage de messages au sein de chaque session individuelle, sans exploiter efficacement les informations de corrélation globale entre les éléments. Pour résoudre ce problème, GCE-GNN23 intègre des sémantiques globales et des graphes de session à l’aide d’un mécanisme d’auto-attention afin de pondérer de manière adaptative l’importance des éléments en construisant un graphe global de voisinage (NGG), ce qui permet d’obtenir des améliorations significatives des performances. Néanmoins, les méthodes existantes basées sur les GNN font toujours face à deux principaux obstacles : premièrement, la complexité du mécanisme d’auto-attention augmente quadratiquement avec la longueur de la session, entraînant un coût computationnel élevé lors du traitement de sessions longues ; deuxièmement, les GNN traditionnels ne disposent pas de la capacité de réguler dynamiquement l’importance des éléments durant l’agrégation des informations, ce qui rend difficile la distinction entre les comportements bruités et les comportements critiques, affectant ainsi la qualité des représentations.
Pour relever ces défis, cet article propose un réseau neuronal graphique à attention linéaire par slot avec porte pour la recommandation basée sur des sessions (GSLA4Rec) : (1) Conception d'un mécanisme de slot avec porte qui filtre le bruit par une fonction de seuil et stocke les informations sémantiques clés dans des emplacements de session, améliorant ainsi la robustesse du modèle et réduisant la surcharge de stockage ; (2) Introduction du mécanisme d'attention linéaire qui réduit la complexité calculatoire de O(N2) à O(N) où N est la longueur de la session), tout en conservant la capacité à modéliser les dépendances à longue distance ; (3) Réalisation d'expériences approfondies sur trois jeux de données publics de référence (Diginetica, Tmall et NowPlaying), montrant que GSLA4Rec surpasse nettement les méthodes SOTA existantes, en particulier en démontrant des avantages marqués dans les scénarios de sessions longues et éparses.
Protocole
Expérience de recommandation basée sur des sessions
La recommandation basée sur des sessions peut être examinée selon trois perspectives : SBR, l'apprentissage du contexte global et GSLA (voir le Tableau des matériaux). Aucun participant humain ni animal n'a été impliqué dans cette étude. Tous les jeux de données expérimentaux utilisés dans ce travail sont accessibles publiquement et fournis sous forme de Fichier supplémentaire : GSLA4Rec. zip.
Recommandation basée sur des sessions
La recommandation basée sur des sessions (SBR) était un système d'intelligence artificielle interagissant avec les utilisateurs au moyen de dialogues naturels multiphases afin de comprendre dynamiquement leurs préférences et de fournir des recommandations personnalisées. La SBR a évolué à partir de méthodes traditionnelles vers des approches fondées sur l'apprentissage profond et des approches hybrides, puis s'est orientée vers des solutions basées sur de grands modèles linguistiques (LLM).
Recommandation traditionnelle basée sur des sessions
L'approche traditionnelle de la recommandation basée sur les séquences (SBR) était généralement représentée par des méthodes fondées sur les chaînes de Markov et le filtrage collaboratif. La première générait des recommandations en décomposant des matrices de transition probabilistes spécifiques à chaque utilisateur. Par exemple, Guy Shani24 a proposé une méthode de recommandation fondée sur le processus de décision markovien, produisant des recommandations par décomposition de matrices correspondantes ; Wanrong Gu25 a amélioré les performances de recommandation en intégrant les chaînes de Markov avec les intervalles de temps d'achat. La seconde générait des recommandations en extrayant des relations séquentielles cachées entre les éléments interactifs adjacents par factorisation matricielle. Par exemple, Sarwar B1 a calculé la similarité entre éléments en se basant sur les comportements historiques des utilisateurs (tels que les notes et les clics) afin de recommander des éléments correspondant aux préférences passées des utilisateurs. Si l'utilisateur A aimait l'élément a, et que l'élément c était fortement similaire à a, le système recommandait c à A ; Rendle S5 a proposé FPMC, un modèle de recommandation séquentielle combinant la factorisation matricielle avec les chaînes de Markov, afin de capturer les relations séquentielles cachées entre les éléments interactifs adjacents. Toutefois, ces approches traditionnelles de SBR se concentraient sur les relations séquentielles entre éléments adjacents, ce qui rendait difficile la modélisation de relations de dépendance complexes.
Recommandation basée sur des sessions utilisant l'apprentissage profond
La recommandation basée sur des sessions par apprentissage profond a évolué à travers plusieurs étapes impliquant des réseaux neuronaux convolutifs (CNN)26,27,28,29, des RNN et des GNN. La RBS fondée sur les CNN utilisait des opérations telles que la convolution et le regroupement (pooling) pour apprendre des représentations de chaque contexte de session, utilisées ensuite pour les recommandations suivantes. Caser30 convertissait les L éléments les plus récents avec lesquels un utilisateur avait interagi en vecteurs de dimension d à l’aide d’une couche d’incorporation (embedding), formant ainsi une matrice d’incorporation traitée comme une « image » mappée dans le temps et dans l’espace latent. Elle utilisait ensuite trois types de filtres convolutifs de motifs séquentiels — au niveau ponctuel, au niveau de l’union sans saut, et au niveau de l’union avec un saut — afin d’apprendre des motifs séquentiels pour améliorer les performances de la RBS. Tuan et al.31 ont modélisé de manière uniforme les flux de clics de session et les caractéristiques de contenu à l’aide de noyaux de convolution 3D pour former des représentations conjointes spatio-temporelles et sémantiques.
Les RNN étaient une classe d'architectures de réseaux neuronaux spécialement conçues pour traiter des données séquentielles. L'idée fondamentale consistait à capturer les dépendances temporelles à l'aide de structures récurrentes telles que les réseaux à mémoire à long court terme (LSTM)13 et les unités récurrentes à seuil (GRU)32, et elles étaient largement utilisées dans des domaines tels que le traitement du langage naturel (NLP)33, la reconnaissance vocale34, la traduction automatique35, les déplacements36,37, la criminalité38, et la prédiction de tendances futures39 (par exemple, le trafic40, les marchés boursiers41,42 et la météorologie43). GRU4Rec, proposé par Hidasi et al., a constitué une étape importante dans la recherche en SBR, en introduisant pour la première fois les RNN dans le SBR et en capturant les motifs comportementaux séquentiels des utilisateurs au moyen de GRU afin de fournir des recommandations personnalisées.
Les réseaux neuronaux graphiques (GNNs)44 ont démontré une forte puissance expressive pour modéliser les relations complexes au sein des données structurées en graphes, et certains chercheurs ont introduit les GNNs pour modéliser les transitions complexes à l’intérieur ou entre des sessions. Selon les différentes architectures de modèles GNNs, les méthodes fondées sur les GNNs pour la recommandation de sessions (SBR) ont été généralement classées en réseaux neuronaux graphiques à seuil (GGNNs)45, réseaux de convolution sur graphes (GCNs)46 et réseaux d’attention sur graphes (GATs)47. SR-GNN a été le premier à appliquer les GNNs à la SBR en représentant les séquences de sessions sous forme de graphes orientés et en utilisant des GGNNs pour capturer les relations complexes de transition entre articles au sein des sessions, combiné à des mécanismes d’attention afin d’obtenir l’incorporation finale de la session, améliorant ainsi les performances de recommandation. Chen L48 a proposé un cadre GNNs à vues multiples qui combine des attributs structurés et des mots-clés non structurés pour modéliser les associations produits multidimensionnelles, améliorant ainsi la précision de la SBR. Driss E49 a conçu un système innovant de recommandation de sessions utilisant des réseaux neuronaux graphiques en capsule pour capturer les caractéristiques complexes des articles et améliorer la précision des prédictions pour la SBR.
Les techniques d'apprentissage profond susmentionnées avaient élargi le champ de recherche du SBR et amélioré efficacement les performances, mais présentaient encore certaines limites, principalement manifestées par : 1) Pour les éléments nouvellement apparus ou les sessions très peu denses, les modèles éprouvaient des difficultés à effectuer des prédictions précises en raison du manque de contexte global ; 2) Ils ne parvenaient pas à exploiter les motifs globaux présents dans l'ensemble des sessions historiques.
Recommandation hybride basée sur des sessions
La recommandation hybride basée sur des sessions a intégré les forces de différentes techniques, telles que le filtrage collaboratif, l'apprentissage profond (Deep-Learning) et les mécanismes d'attention, afin d'améliorer les performances des systèmes de recommandation basés sur les sessions (SBR). GC-SAN50 a incorporé un mécanisme d'auto-attention fondé sur SR-GNN pour mieux capturer les informations d'interaction des éléments importants au sein d'une session. FGNN51 a en outre agrégé les informations provenant des éléments voisins grâce à un mécanisme d'attention multi-têtes, permettant d'apprendre plusieurs relations relatives à l'élément cible. SR-HetGNN52 appartient aux méthodes de recommandation basée sur les sessions utilisant des graphes hétérogènes ; en introduisant différents types d'éléments (utilisateur, élément, session) et des arêtes multi-relationnelles (clic, achat, co-occurrence, association d'attributs), il construit un réseau global de connaissances, dépassant ainsi la limitation des séquences d'éléments uniques, et constitue une méthode importante pour modéliser le comportement des utilisateurs anonymes et les associations d'intérêts inter-sessions ces dernières années. KGSR-SAP53 a construit un graphe de connaissances en reliant les éléments par des arêtes représentant plusieurs types de relations, afin de décrire diverses interactions utilisateur-élément, résolvant ainsi le problème de perte d'information lorsque le graphe global ne contient que des arêtes d'un seul type (interaction utilisateur-élément). Wang ZH54 a proposé DiffSBR, un modèle de recommandation de session basé sur la diffusion. Ce modèle génère des préférences fiables pour l'élément suivant en simulant un débruitage de bruit, améliorant ainsi la modélisation des séquences dynamiques de clics des utilisateurs. Qiao ST55 a conçu un cadre de recommandation basée sur les sessions combinant un apprentissage multi-vues des intentions et un alignement avec des grands modèles linguistiques (LLM). Cette approche exploite l'intention implicite des utilisateurs sous divers angles et utilise des modèles linguistiques pour aligner les caractéristiques sémantiques, améliorant ainsi davantage les performances de recommandation.
Contexte mondial
Pour pallier l'insuffisance des « sessions de visualisation prises isolément », les chercheurs ont compris que l'information globale pouvait être utilisée pour améliorer la capacité de représentation de la session en cours, afin de résoudre des problèmes tels que la rareté des données, le démarrage à froid et l'écart sémantique dans les systèmes traditionnels de recommandation basés sur les sessions (SBR). Parallèlement, lors de la construction du contexte global, il était nécessaire d'intégrer l'information globale dans une session unique tout en minimisant les interférences de bruit. CSRM56 a optimisé la représentation au niveau des sessions en intégrant des informations collaboratives entre la session courante et les sessions voisines, en utilisant un encodeur de mémoire externe (OME) pour extraire l'intention collaborative à partir des informations collaboratives. CA-TCN57 a proposé un modèle de réseau convolutif temporel prenant en compte les sessions croisées, construisant des graphes globaux et des graphes de contexte de session afin de simuler l'impact des sessions croisées sur les éléments et les sessions, tandis que le réseau convolutif temporel (TCN) élargit son champ récepteur par des convolutions dilatées, avec un nombre de couches couvrant des séquences de longueur exponentielle (champ récepteur = ), résolvant ainsi le problème de disparition du gradient des RNN. Chen58 a proposé une méthode SBR basée sur des réseaux neuronaux hypergraphes (SR-HGNNs), qui intègre une propagation d'ordre mixte (bas ordre et haut ordre) et des mécanismes d'attention afin de résoudre le problème de sur-lissage des GNN traditionnels dans les courtes sessions et de distinguer l'importance des différents ordres de propagation, permettant ainsi de capturer plus précisément les dépendances et d'éviter les interférences de bruit. GCE-GNN a utilisé des paires d'éléments co-occurrents d'ordre multiple pour construire un graphe pondéré non orienté, en comptant les fréquences de co-occurrence des éléments afin de refléter leur importance dans la session ; AGNN-GC59 a utilisé les relations de transition entre éléments à travers les sessions pour construire un graphe collaboratif global, en calculant les probabilités de transition des éléments dans le graphe global afin de refléter les changements d'intérêt au sein de la session ; DA-GCN60 a utilisé le chemin le plus court pour mettre à jour la matrice d'adjacence et construire un graphe pondéré dynamique, en calculant la fréquence de co-occurrence dans le graphe global et la distance de chemin entre les éléments. Inspiré par ces travaux, cet article propose de construire un graphe global selon une méthode basée sur les voisins, c'est-à-dire en utilisant le coefficient de similarité de Jaccard pour calculer les sessions similaires, ce qui exploite non seulement l'information globale mais filtre également le bruit (en éliminant les éléments non pertinents), atteignant ainsi l'objectif de construire précisément le contexte global et de poser une base solide pour l'algorithme SBR ultérieur.
Attention linéaire à fente commandée
Les transformeurs traditionnels61 entraînent une complexité spatiotemporelle élevée en raison de la nécessité d'opérations d'attention entièrement connectées sur l'ensemble de la séquence, comme suit :
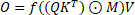 (1)
Où Q, K, V ∈ RN×d étaient des transformations linéaires des éléments d'entrée, M = {Mij = 1 si i ≥ j, sinon −∞} était le masque causal empêchant la fuite d'informations futures, ⊙ désignait le produit élément par élément, et f désignait la fonction d'activation softmax.
Pour obtenir une attention linéaire62, l'idée la plus directe consistait à supprimer la fonction d'activation softmax. Toutefois, si la fonction d'activation softmax était supprimée directement, l'attention linéaire entraînerait inévitablement certains problèmes potentiels : la perte du puissant pouvoir expressif des réseaux de neurones et l'incapacité à résoudre des problèmes complexes du monde réel.
Attention linéaire par slot avec contrôle de la mémoire limitée
En supposant que la fonction d'activation softmax doive être conservée, K et V ont été compressées séparément en K̃, Ṽ ∈ Rm×d. Du point de vue du réseau de mémoire, K̃ et Ṽ présentaient des emplacements mémoire dont la longueur augmentait avec la séquence, c'est-à-dire que le nombre d'emplacements m = N. Si m était fixe, la linéarisation était évidemment possible. Inspiré par le contrôle à mémoire bornée63, chaque jeton parmi les éléments d'entrée de longueur N devait être écrit de manière concurrentielle dans m emplacements.
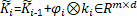 ,
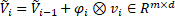 ,
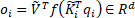 (2)
Où f était la fonction d'activation softmax et φi était le vecteur permettant de contrôler l'entrée effective pour le contrôle de la valeur clé ki, comme suit.
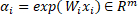 ,
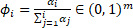 (3)
Ici, (φi)j représentait l'intensité d'écriture du ième jeton vers le jème emplacement, obtenue à l'aide d'une fonction softmax cumulative.
Pour obtenir un calcul linéaire efficace, la formule (2) a été réécrite sous la forme de la formule (4), qui calcule οi à partir de qi, ki et vi (éq. 4) par {οi|i=1T, qi, ki, vi)|i=1T} et adopte un calcul séquentiel en deux passes :
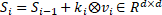 ,
 (4)
Ainsi, les opérations SLA pourraient être déduites :
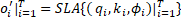 ,
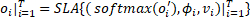 (5)
où oi′ ∈ ℝm, οi ∈ ℝd. Par conséquent, l'ASL pourrait bénéficier d'un entraînement par blocs, efficace en termes de matériel et en temps linéaire64.
Attention linéaire à fente sélective
L'attention linéaire par slot avec un contrôle à mémoire bornée pourrait réduire la complexité computationnelle et spatiale. Toutefois, l'accumulation d'informations pourrait également introduire des données bruitées dans l'interaction de session, de sorte qu'une décroissance dépendante des données était très importante pour conserver ou oublier sélectivement l'information, et ce mécanisme sélectif avait été réexaminé dans les modèles récents d'espaces d'état sélectifs65. GSLA avec dépendance aux données pouvait s'exprimer comme suit :
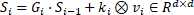 ,
 (6)
Ici, les portes de décroissance ont été paramétrées sous une forme de produit extérieur Gi = αi ⊗ βi, avec αi, βi ∈ [0,1]d. Dans ce qui suit, GSLA pourrait également s'écrire sous la forme équivalente suivante en fixant généralement βt = 1 et en utilisant la multiplication matricielle comme dans64 :
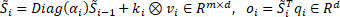 (7)
Lorsque αi et ki désignent respectivement la porte d'oubli et la porte d'entrée, ces deux portes peuvent être couplées selon la relation ki = 1 − αi, inspirée par la littérature sur les RNN à portes. Il était évident que GSLA pouvait être formulé selon un calcul séquentiel en deux passes, comme indiqué dans l'équation (8). La structure du second ordre permettait un entraînement parallèle par blocs afin d'améliorer l'efficacité de l'apprentissage, et l'insertion d'une opération softmax au milieu de cette structure du second ordre renforçait la capacité de modélisation de la mémoire à créneaux finis.
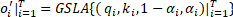 ,
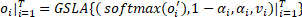 (8)
Transformation des données de session
Définition du problème
Soit la séquence de session donnée S = {v1s, v2s, ⋯, vns}, où vis désigne l’élément cliqué en ième position. En analysant le comportement de clic de l’utilisateur au sein de cette séquence, le système prédit l’élément suivant qui pourrait intéresser l’utilisateur, vn+1s.
Construction du graphe
Construction du graphe de session
Pour une session S = {v1s, v2s, ⋯, vns}, un graphe orienté Gs = (Vs, εs) a été construit, où Vs correspondait à l'ensemble des éléments de la session donnée S, et εs = {eijlocal|vi, vj, vi, vj ∈ Vs} représentait l'ensemble des arêtes de la session donnée S. ε(vi-1s, vis) désignait les éléments cliqués consécutivement au cours de cette session. L'arête eijlocal pouvait être divisée en quatre types : ein, eout, ein-out, eself. Étant donné qu'un même élément pouvait apparaître plusieurs fois dans la séquence, la valeur pondérée de chaque arête a été prise en compte.
La session actuelle s = [v1, v2, v4, v2, v3] a été convertie en un SG, comme illustré dans la Figure 1A.
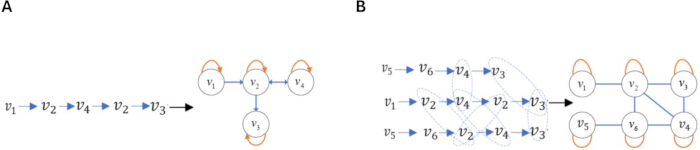
Figure 1 : Transformer des éléments interactifs en structures de graphes. (A) Illustration de la construction d'un graphe de session (SG) par transformation d'une session en un graphe. (B) Illustration de la construction d'un graphe global de voisins (NGG) en combinant plusieurs sessions en un graphe. Cette figure a été réalisée par les auteurs eux-mêmes à l'aide de Visio, avec des éléments entièrement personnalisés. Aucune ressource graphique externe protégée par des droits d'auteur n'a été utilisée, aucun droit de licence tiers supplémentaire n'était donc nécessaire. Le droit d'auteur de la figure appartient aux auteurs et sera conforme aux règles de droit d'auteur du journal en cas d'acceptation. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Construction du graphe global des voisins
À partir de la session actuelle S, le NGG correspondant Gg = (Vg, εg) a été construit afin d'enrichir l'apprentissage de la représentation de la session courante de manière inter-session. Vg constituait l'ensemble des éléments contenant tous les éléments de Gg, et εg = {eijglobal|vi, vj, vi, vj ∈ Vg} représentait l'ensemble des arêtes de Gg. ε(vi-1g, vig) désignait les éléments interagissant directement, vi-1g et vig, dans le NGG Gg. Ce processus comprenait deux étapes : l'acquisition des sessions voisines et la construction du NGG.
Acquisition de la session voisine
Dans l'ensemble du jeu de données, on a recherché les sessions comportant le nombre maximal d'éléments co-occurrents avec la session courante. Les N premières sessions présentant les comptages de co-occurrence les plus élevés ont été sélectionnées afin de construire un ensemble de sessions voisines candidates S. Ensuite, le coefficient de similarité de Jaccard a été utilisé pour calculer la similarité entre la session courante cu et une session Sr ∈ S provenant de l'ensemble candidat S, comme indiqué dans l'Équation (9).
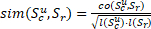 (9)
Ici, co(Scu, Sr) désigne le nombre d'éléments apparaissant simultanément dans Scu et Sr, tandis que l(Scu) et l(Sr) représentent respectivement les longueurs de Scu et Sr, et Scu et Sr désignent la session courante et une session voisine. Les sessions dont la similarité était inférieure à un seuil donné (pouvant être défini comme un hyperparamètre) étaient éliminées, et les sessions restantes constituaient l'ensemble des sessions voisines Ns pour la session courante.
Construction du graphe global voisin
À partir de l'ensemble de sessions voisines Ns, le NGG a été construit, comme illustré dans la Figure 1B. Lors de la construction de la matrice d'adjacence, si deux éléments (vi, vj) présentaient une interaction, l'entrée correspondante Aij était fixée à 1, sinon elle était fixée à 0. De plus, les interactions entre les éléments ont été traitées comme non orientées et munies de boucles réflexives, puis normalisées, comme indiqué dans le Tableau 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tableau 1 : Matrice d'adjacence normalisée du graphe global de voisinage. Le tableau présente la matrice d'adjacence normalisée décrivant les connexions pondérées entre les nœuds dans le graphe global de voisinage construit.
Conception d'un algorithme de recommandation basé sur des sessions
Cette section détaille le modèle innovant proposé GSLA4Rec, qui améliore les performances de SBR en introduisant le mécanisme GSLA au niveau de la représentation conjointe des caractéristiques de SG et de NGG.
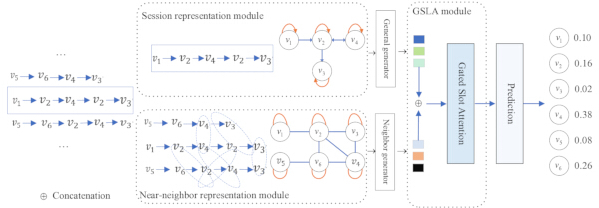
Figure 2 : Cadre GSLA4Rec. Ce cadre intègre l'apprentissage de la structure du graphe de session et du graphe global des voisins, filtre le bruit des interactions à l'aide d'un mécanisme de seuil, équilibre stockage et efficacité grâce à un mécanisme de mémoires tampons, et capture la pertinence des éléments au moyen d'un mécanisme d'attention linéaire afin de prédire la préférence de l'utilisateur pour le prochain clic. Cette figure a été réalisée par les auteurs eux-mêmes à l'aide de Visio, avec des éléments entièrement personnalisés. Aucune ressource graphique externe protégée par des droits d'auteur n'a été utilisée, aucun droit de licence tiers supplémentaire n'était donc nécessaire. Le droit d'auteur de la figure appartient aux auteurs et sera conforme aux règles de droit d'auteur de la revue en cas d'acceptation. GSLA4Rec désigne les réseaux neuronaux graphiques à attention linéaire avec seuil et mémoires tampons pour la recommandation basée sur les sessions (SBR). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Figure 2 présente le cadre de GSLA4Rec, composé de quatre composants principaux : 1) Représentation des éléments au niveau de la session. Elle utilise un modèle de réseaux neuronaux graphiques (GNN) sur le graphe de session (SG) afin d'apprendre les plongements des éléments au niveau de la session courante ; 2) Représentation des éléments au niveau global des voisins. Elle apprend les plongements des éléments au niveau global à partir de toutes les sessions, en utilisant une unité récurrente à grilles (GRU) pour intégrer de manière récursive les plongements des voisins de chaque élément selon le graphe global de voisinage (NGG) ; 3) GSLA. Elle modélise les préférences des utilisateurs pour la session courante en agrégant les représentations d'éléments apprises aux niveaux de session et global ; 4) Couche de prédiction. Elle produit les probabilités prédites pour les éléments candidats. Les quatre composants sont décrits en détail ci-après.
Représentation de la session
Dans SBR, la compréhension des comportements d'interaction des utilisateurs était cruciale. À cette fin, un SG et un NGG ont été construits pour l'apprentissage de la représentation de session, dans le but de comprendre de manière exhaustive les comportements d'interaction des utilisateurs et ainsi de saisir l'intention plus authentique des utilisateurs.
Représentation des éléments au niveau de la session
Sur la base du SG dans la Figure 1A, une méthode d'attention sur graphe bidirectionnel pondéré (WBGAT) a été utilisée pour extraire les caractéristiques du SG. Cette méthode a introduit des poids sur les arêtes et la directionnalité des éléments (voisins entrants et voisins sortants) à partir du mécanisme GAT standard, renforçant ainsi les arêtes importantes et capturant les dépendances bidirectionnelles, ce qui a permis de pallier les limites du GAT traditionnel concernant les relations asymétriques entre éléments et l'intensité des interactions. Le processus de calcul était le suivant :
Premièrement, calcul des poids de normalisation du degré entrant des éléments.
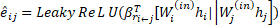 (10)
où eij indiquait le poids du voisin entrant du premier ordre des caractéristiques de l'élément j sur l'élément i,  représentait la relation entre l'élément i et l'élément j, β* ∈ ℝd étaient les vecteurs de poids, hi et hj étaient respectivement les représentations de l'élément i et de l'élément j, Wi(in) ∈ ℝd*d et Wj(in) ∈ ℝd*d étaient des paramètres entraînables, || représentait l'opération de concaténation. Pour distinguer les différentes relations de degré entrant, deux vecteurs de poids, nommés rin et rin-self, ont été entraînés. La fonction d'activation LeakyReLU a été utilisée.
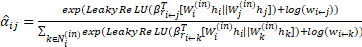 (11)
Pour rendre les coefficients comparables entre différents éléments, les poids d'attention ont été normalisés à l'aide de la fonction softmax. Lorsque Ni(in) représentait l'ensemble des voisins entrants de premier ordre de l'élément i, et que  était le poids du voisin entrant correspondant à l'arête dirigée (i←j) dans le graphe SG, cette méthode permettait au modèle d'apprendre les corrélations entre les caractéristiques des éléments tout en conservant l'information sur la force intrinsèque des connexions de la structure du graphe, en prenant le logarithme des poids des arêtes et en les ajoutant au score d'attention initial eij.
Deuxièmement, calcul des poids de normalisation du degré de sortie des éléments.
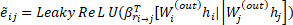 (12)
où ẽij indiquait le poids du voisin sortant du premier ordre des caractéristiques de l'élément j par rapport à l'élément i,  était la relation entre l'élément i et j, deux vecteurs de poids, à savoir rout et rout-self, ont été entraînés.
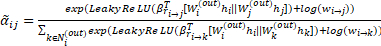 (13)
Où Ni(out) était l'ensemble des voisins sortants de premier ordre de l'élément i,  était le poids du voisin sortant de l'arête orientée (i→j) dans SG.
Troisièmement, l'agrégation des informations. L'incorporation mise à jour de l'élément pouvait être obtenue après pondération et sommation des incorporations de degré entrant et de degré sortant du premier ordre de l'élément i.
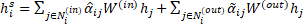 (14)
Où  et α̃ij désignent respectivement les poids des degrés entrant et sortant de l'élément i, et
 désigne la représentation mise à jour de l'élément i.
Représentation globale de l'élément voisin
Des recherches récentes sont unanimement convenues que la construction d'un graphe global pouvait améliorer la représentation des données et, par conséquent, accroître les performances en SBR, ce qui ne fait aucun doute. Toutefois, l'amélioration globale des données pourrait également introduire des informations non pertinentes, telles que du bruit. Dans le modèle proposé, afin d'obtenir une augmentation globale des données tout en minimisant au maximum le bruit, un graphe global de proches voisins a été construit.
À partir du NGG présenté dans Figure 1B et de la matrice d'adjacence normalisée de Tableau 1, la session actuelle et ses sessions voisines ont été transformées en un NGG, et une méthode GGNNs45 a été appliquée pour extraire les caractéristiques du NGG. Le processus d'apprentissage des vecteurs d'éléments dans le NGG est décrit par l'Équation (15).
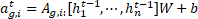
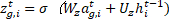
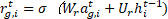
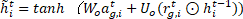
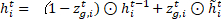 (15)
W ∈ ℝd×2d désignait les poids de contrôle, zg,i et rg,i représentaient respectivement la porte de mise à jour et la porte de réinitialisation. [h1t-1, ⋯, hnt-1] représentait la liste de tous les vecteurs d'éléments dans la session s. σ(x) = 1/(1 + e-x) était la fonction sigmoïde logistique, ⊙ désignait la multiplication élément par élément, et hi ∈ ℝd représentait le vecteur après mise à jour avec portes. La matrice d'adjacence As ∈ ℝn×n indiquait la connectivité entre les éléments dans les sessions voisines, et As,i: ∈ ℝ1×n représentait un bloc colonne de As correspondant à l'élément vs,i dans la matrice d'adjacence. Pour la session courante s = [v1, v2, v4, v2, v3], le NGG et la matrice d'adjacence normalisée étaient illustrés dans la Figure 1B et le Tableau 1, respectivement.
Représentation des éléments
La représentation de l'élément a été obtenue en additionnant le vecteur d'élément au niveau de la session et le vecteur d'élément global au niveau du voisin, comme indiqué dans l'équation (16) :
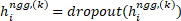
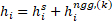 (16)
Là où la suppression a été utilisée sur les représentations d'éléments voisins au niveau global pour atténuer le surajustement.
Attention linéaire à fente sélective
L'attention linéaire à emplacement commandé (GSLA) présentée dans cet article intègre l'attention linéaire avec une commande à mémoire limitée et un mécanisme de contrôle dépendant des données. D'une part, elle hérite du mécanisme d'emplacement mémoire fini du modèle de contrôleur basé sur l'attention (ABC), qui compresse les paires clé-valeur, initialement croissantes avec la longueur de la séquence, en un nombre fixe d'emplacements, chacun étant mis à jour par écriture concurrentielle, résolvant ainsi le problème de complexité computationnelle de l'attention globale du transformeur. D'autre part, elle introduit un mécanisme de contrôle finement réglé, similaire à celui de la GLA, où les données d'entrée ajustent dynamiquement le taux de rétention de l'information historique au moyen d'une porte d'oubli αi, résolvant le problème de bruit causé par l'absence d'un mécanisme d'oubli dans le modèle ABC.
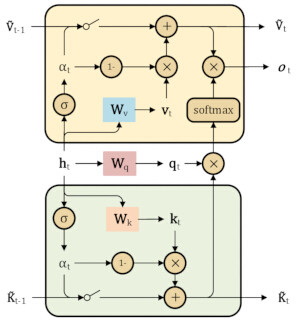
Figure 3 : Schéma du GSLA. Le vecteur d'entrée a été associé respectivement au vecteur de requête, au vecteur de mot-clé et au vecteur de valeur, puis traité par une attention linéaire avec contrôle de la mémoire limitée et un mécanisme de seuil dépendant des données afin d'obtenir le vecteur de requête mis à jour, le vecteur de mot-clé, le vecteur de valeur et le vecteur de sortie. Cette figure a été réalisée par les auteurs eux-mêmes à l'aide de Visio, avec des éléments entièrement personnalisés. Aucune ressource graphique externe protégée par des droits d'auteur n'a été utilisée, aucune licence tierce supplémentaire n'était donc nécessaire. Le droit d'auteur de la figure appartient aux auteurs et sera conforme aux règles de droit d'auteur de la revue en cas d'acceptation. GSLA désigne l'attention linéaire à emplacements avec seuil. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Comme spécifiquement mis en œuvre dans la Figure 3, le vecteur d'entrée a été projeté séparément en un vecteur de requête, un vecteur de clé et un vecteur de valeur64 :
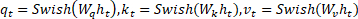 (17)
Où Wq, Wk, Wv ∈ ℝd×d représentaient les matrices de poids de transformation correspondant respectivement à la requête, à la clé et à la valeur, et ht désignait le vecteur d'incorporation à l'étape temporelle t dans la séquence d'entrée de la session. La fonction Swish était définie comme Swish(x) = x · σ(x) et constituait une fonction d'activation auto-régulée, où σ était la fonction sigmoïde ; elle surpassait la fonction d'activation ReLU traditionnelle dans plusieurs tâches d'apprentissage profond.
GSLA utilisait une porte d'oubli αi et une porte d'entrée 1 − αi, dépendant des données d'entrée, pour mettre à jour dynamiquement l'information dans l'emplacement de mémoire i. Le processus était le suivant64 :
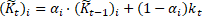 (18)
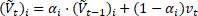 (19)
Ici, K̃t et Ṽt représentaient les emplacements des vecteurs clés et les emplacements des vecteurs de valeurs à l'instant t, tandis que K̃t-1 et Ṽt-1 représentaient les emplacements des vecteurs clés et les emplacements des vecteurs de valeurs à l'instant t−1. La porte d'oubli αi = σ(Wαht)1/τ, où Wα ∈ ℝd était la matrice de poids de transformation, σ était la fonction sigmoïde, et τ était le coefficient d'amortissement (généralement fixé à 8), servait à contrôler le degré de souplesse de la porte d'oubli. Cela permettait à GSLA d'ajuster en douceur le taux d'oubli des informations historiques : plus αi était grand, plus GSLA s'appuyait sur les informations passées ; plus αi était petit, plus GSLA se concentrait sur l'entrée actuelle.
Les emplacements du vecteur clé K̃t et les emplacements du vecteur valeur Ṽt des emplacements à l’étape t ont été exprimés sous forme matricielle, comme indiqué65 dans les équations (20) et (21) :
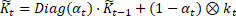 (20)
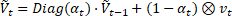 (21)
Ensuite, le GSLA doté de propriétés du second ordre (voir équation (8)) a été utilisé pour calculer la sortie oi |i=1T à chaque pas de temps i ∈ [1, …, T]. Une transformation linéaire a été appliquée à la sortie de chaque pas de temps afin d'obtenir le résultat h̃t. Enfin, la valeur moyenne des représentations de tous les éléments de la séquence de session a été calculée pour générer l'incorporation de session S̃e avec des mises à jour dynamiques de la mémoire :
 (22)
 (23)
Ici, ot représentait la sortie du Gated-Slot à l'instant t, h̃t désignait le résultat de la transformation linéaire appliquée à ot. S̃e désignait la valeur moyenne de h̃t à tous les instants.
Couche de prédiction
À partir de la représentation de session obtenue S̃e et de l'incorporation initiale de l'élément i, une opération de produit scalaire a été effectuée pour calculer le score de chaque élément candidat hi. Ensuite, la fonction softmax a été utilisée pour obtenir les probabilités de recommandation de l'élément candidat i :
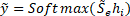 (24)
Ici, ỹ représentait les probabilités de recommandation de l'élément candidat, hi désignait le vecteur de l'élément candidat, et la fonction de perte d'entropie croisée a été utilisée pour l'entraînement du modèle.
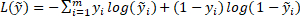 (25)
Ici, y était la représentation encodée en one-hot de la vérité terrain.
Résultats
Ensembles de données et prétraitement
Dans les expériences, trois ensembles de données publics SBR issus de données de transactions réelles dans des scénarios d'application pratiques ont été sélectionnés pour évaluer les performances du modèle : Diginetica, extrait du concours CIKM Cup 2016, qui contient les historiques de transactions et de clics des utilisateurs ; Tmall, qui concerne les journaux d'utilisateurs provenant de la plateforme Tmall et enregistre les comportements de navigation et d'achat des utilisateurs ; et Nowplaying, qui contient des enregistrements musicaux relatifs à l'historique d'écoute des utilisateurs sur des plateformes musicales. Ces ensembles de données étaient largement utilisés dans la recherche SBR et permettaient d'évaluer de manière complète l'efficacité et l'applicabilité du modèle.
À l'étape de prétraitement des données, les ensembles de données ont été normalisés afin d'assurer une cohérence dans la qualité des données. Plus précisément, toutes les sessions d'une durée inférieure à 2 ont été filtrées, et les éléments apparaissant moins de 5 fois ont été supprimés. En outre, pour chaque session S = {v1, v2, ..., vn}, plusieurs sous-séquences ont été générées pour l'entraînement et le test du modèle. Ces sous-séquences avaient la forme suivante : ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Après avoir terminé le prétraitement susmentionné, des analyses statistiques ont été réalisées sur les ensembles de données, et des informations détaillées sont présentées dans Tableau 2.
| Jeu de données | Diginetica | Tmall | Nowplaying |
| clic | 982961 | 818479 | 1367963 |
| entraînement | 719470 | 351268 | 825304 |
| test | 60858 | 25898 | 60417 |
| éléments | 43097 | 40728 | 60417 |
| longueur moyenne | 5.12 | 6.69 | 7.42 |
Tableau 2 : Description des jeux de données. Le tableau résume les statistiques des jeux de données Diginetica, Tmall et Nowplaying, incluant les nombres de clics, d'échantillons d'apprentissage et de test, d'éléments, ainsi que la longueur moyenne des sessions.
Paramètres expérimentaux
Configuration des paramètres
Afin de garantir l'équité de l'expérience, des méthodes de prétraitement ont été adoptées pour traiter trois jeux de données, tout en prédéfinissant les paramètres du modèle GSLA4Rec. Pour les jeux de données Diginetica et Nowplaying, la taille du lot a été fixée à 150, et à 300 pour le jeu de données Tmall. Les paramètres de ce modèle ont été initialisés à l'aide d'une distribution gaussienne de moyenne 0 et d'écart type 0,1, et la dimension a été fixée à 100. L'optimiseur utilisé était Adam, avec un taux d'apprentissage initial fixé à 0,001. Le taux d'apprentissage était multiplié par 0,1 toutes les 3 époques. L'entraînement a été effectué pendant un total de 30 époques sur une GPU NVIDIA TITAN V et avec PyTorch 1.11.0 avec cu113 (voir Tableau du matériel) afin de retenir la meilleure valeur. Le seuil de filtrage des sessions voisines a été fixé à 0,5, et une régularisation L2 a été appliquée dans l'expérience. Pour chaque jeu de données, les 10 % derniers des données triées par ordre chronologique des transactions ont été sélectionnés comme ensemble de test, tandis que les 10 % restants et les 80 % restants ont été choisis aléatoirement comme ensemble de validation et ensemble d'entraînement, respectivement. Le nombre de blocs mémoire dans GSLA a été fixé à une valeur dans {0, 1, 2, 3, 4, 5}.
Métriques d'évaluation
Cet article a adopté P@N (Précision@N, N = 10/20) et MRR@N (rang réciproque moyen@N, N = 10/20). P@N a été utilisée pour mesurer la proportion de recommandations correctes parmi les N premiers résultats de recommandation, MRR@N a été utilisée pour calculer le rang réciproque moyen des projets corrects ; plus la valeur de MRR est élevée, meilleure est la performance de tri.
Analyse des performances
L'efficacité du modèle GSLA4Rec a été évaluée par rapport à des références représentant différentes étapes du développement technologique. Au début, des méthodes d'apprentissage automatique ont été utilisées pour la SBR, par exemple FPMC5 a été utilisé pour prédire l'effet séquentiel basé sur une chaîne de Markov. Ensuite, l'apprentissage profond a été largement appliqué à la SBR avec le développement de l'intelligence artificielle ; par exemple, GRU4Rec10 reposait sur des RNN qui modélisent la SBR en empilant plusieurs couches de GRU et en concevant des fonctions de perte spécialisées pour optimiser la SBR, NARM16 a introduit l'AM afin de capturer les principaux intérêts des utilisateurs et a généré une représentation intégrée finale de l'élément pouvant être recommandé ensuite, STAMP17 a utilisé des perceptrons multicouches améliorés par l'AM pour capturer simultanément l'intérêt général et l'intérêt immédiat des utilisateurs. Ces dernières années, les réseaux neuronaux graphiques ont également été largement utilisés en SBR en raison de leur puissante capacité d'apprentissage sur des données non euclidiennes. Par exemple, SR-GNN22 a appliqué les GNN à la SBR pour la première fois, extrayant des relations complexes de transition d'articles via des GGNN et se concentrant sur les intérêts immédiats des utilisateurs en conjonction avec l'AM, GCE-GNN23 a utilisé des GAT pour obtenir les relations de transfert d'articles dans les contextes local et global, et a généré des représentations de session à travers RPE et l'AM souple, S2-DHCN66 a transformé les données de session en hypergraphe et en graphe de lignes, et a exploité l'apprentissage auto-supervisé pour améliorer la SBR.
Récemment, une approche globale a été adoptée pour améliorer les performances du SBR. Par exemple, GC-SAN50 combine des réseaux neuronaux graphiques (GNN) avec des réseaux d'auto-attention multicouches afin d'améliorer les performances de recommandation en modélisant les dépendances à court et à long terme ; TASRec67 intègre des informations temporelles en construisant une séquence de captures instantanées de graphes dynamiques à différents horodatages ; CT-GNN68 utilise des GNN intégrant des informations temporelles pour apprendre des associations temporelles supplémentaires entre les éléments ; CORE69 fusionne les informations de co-occurrence et les informations temporelles des éléments afin d'obtenir une représentation finale de session ; RESTC70 propose des motifs d'interaction spatio-temporels inspirés des propriétés d'uniformité et d'alignement de l'apprentissage contrastif ; COTRec66,71 adopte un apprentissage auto-supervisé sur deux vues de graphes de session et un entraînement conjoint pour résoudre la rareté des données dans le SBR ; RAIN71 exploite le masquage des arêtes et la reconstruction structurelle, et entraîne conjointement un indicateur d'arête afin d'identifier et d'éliminer explicitement les arêtes bruitées, ce qui améliore considérablement la précision et la robustesse du SBR.
| Ensembles de données | Diginetica | Tmall | Nowplaying | ||||||||||
| Classification des méthodes | Métriques | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Apprentissage automatique | FPMC | 15,42 | 22,10 | 6,20 | 6,66 | 13,12 | 16,05 | 7,10 | 7,30 | 5,28 | 7,35 | 2,66 | 2,82 |
| Apprentissage profond | GRU4REC | 17,92 | 30,80 | 7,73 | 8,20 | 9,47 | 10,93 | 5,78 | 5,89 | 6,74 | 7,92 | 4,40 | 4,48 |
| Apprentissage profond | NARM | 35,44 | 48,32 | 15,12 | 16,00 | 19,16 | 23,30 | 10,40 | 10,70 | 13,60 | 18,59 | 6,62 | 6,92 |
| Apprentissage profond | STAMP | 33,97 | 46,62 | 14,26 | 15,13 | 22,63 | 26,47 | 13,10 | 13,35 | 13,20 | 17,65 | 6,57 | 6,88 |
| Réseaux de neurones graphiques (GNNs) | SR-GNN | 38,42 | 51,26 | 16,89 | 17,76 | 23,41 | 27,57 | 13,46 | 13,72 | 14,17 | 18,86 | 7,15 | 7,47 |
| Réseaux de neurones graphiques (GNNs) | S2 -DHCN | 40,21 | 53,66 | 17,59 | 18,51 | 26,22 | 31,42 | 14,60 | 15,05 | 17,35 | 23,50 | 7,87 | 8,18 |
| Réseaux de neurones graphiques (GNNs) | GCE-GNN | 41,16 | 54,22 | 18,15 | 19,04 | 28,01 | 33,42 | 15,08 | 15,42 | 16,94 | 22,37 | 8,03 | 8,40 |
| GNNs+Att | TASRec | 39,85 | 52,53 | 17,19 | 18,22 | 25,72 | 29,58 | 14,22 | 14,51 | 16,35 | 20,52 | 7,30 | 7,78 |
| GNNs+Att | GC-SAN | 38,40 | 51,30 | 16,80 | 17,80 | 23,50 | 27,60 | 13,50 | 13,80 | 14,20 | 18,90 | 7,20 | 7,50 |
| GNNs+Tem | CT-GNN | 39,40 | 52,71 | 17,50 | 18,56 | 25,95 | 31,42 | 14,52 | 15,00 | 16,55 | 22,28 | 7,75 | 8,06 |
| GNNs+Tem | CORE | 41,03 | 52,84 | 17,95 | 18,47 | 32,97 | 39,16 | 18,72 | 19,16 | 17,65 | 21,81 | 7,92 | 7,35 |
| GNNs+Tem | RESTC | 42,35 | 55,93 | 18,75 | 19,65 | 35,57 | 42,47 | 18,05 | 18,52 | 18,39 | 24,79 | 8,31 | 8,72 |
| GNNs+COT | COTRec | 39,87 | 54,18 | 17,53 | 19,07 | 30,62 | 36,35 | 17,65 | 18,04 | - | - | - | - |
| GNNs+ReStr | RAIN | - | 55,50 | - | 19,20 | - | 38,73 | - | 19,12 | - | 24,17 | - | 8,47 |
| GNNs+Gated-Slot | GSLA4Rec | 43,35 | 56,47 | 19,38 | 19,98 | 36,56 | 43,60 | 19,46 | 19,96 | 19,80 | 27,10 | 8,86 | 9,32 |
| SD | ±0,0009 | ±0,0011 | ±0,0008 | ±0,0009 | ±0,0018 | ±0,0021 | ±0,0016 | ±0,0018 | ±0,0028 | ±0,0031 | ±0,0024 | ±0,0026 | |
| p-value | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,001 | <0,01 | |
| Tinference | 0,294 | 0,296 | 0,295 | 0,297 | 0,168 | 0,169 | 0,169 | 0,171 | 0,472 | 0,478 | 0,475 | 0,479 | |
Tableau 3 : Comparaison des performances sur trois ensembles de données. Ce tableau compare GSLA4Rec avec des méthodes de recommandation basées sur l'apprentissage automatique, l'apprentissage profond, les réseaux de neurones graphiques (GNN), l'attention, les méthodes temporelles et d'autres approches, sur les jeux de données Diginetica, Tmall et Nowplaying, en utilisant les métriques P@10, P@20, MRR@10 et MRR@20. Les écarts types (SD) et les valeurs p sont également indiqués pour GSLA4Rec.
Afin de vérifier les performances du modèle GSLA4Rec et d'éliminer l'aléatoire lié à l'amélioration des performances causé par des facteurs aléatoires, plusieurs expériences de regroupement et une analyse statistique ont été menées sur l'ensemble de test. Plus précisément, l'ensemble de test a été divisé en groupes de 150 sessions par lot, puis répété 30 fois à l'aide de la méthode de graine aléatoire. Les résultats moyens et le temps de calcul de toutes les expériences groupées ont été calculés comme étant respectivement les performances et le temps d'inférence du modèle GSLA4Rec. L'écart type (SD) et le test de significativité statistique t ont été calculés pour le modèle GSLA4Rec afin de vérifier davantage la stabilité et la certitude de l'amélioration des performances du modèle GSLA4Rec. Tableau 3 présente les performances, l'écart type, la valeur p et Tinference du modèle de recommandation proposé, GSLA4Rec, comparé aux modèles de référence sur les trois jeux de données. Les nombres soulignés indiquent la meilleure méthode de référence, et le modèle offrant les meilleures performances pour chaque métrique d'évaluation est indiqué en gras noir.
Méthodes de recommandation par apprentissage automatique : dans les tâches SBR, la méthode traditionnelle FPMC a présenté les pires performances, principalement parce que les modèles de chaîne de Markov n'ont pas réussi à capturer les motifs de transition complexes entre les éléments. 2) Méthodes de recommandation par apprentissage profond : des modèles tels que GRU4REC, NARM et STAMP ont utilisé des approches de modélisation de séquences et ont obtenu certaines améliorations de performance. Parmi eux, NARM et STAMP ont fourni de meilleurs résultats de recommandation que GRU4REC, principalement parce que NARM a introduit un mécanisme d'attention permettant de capter les intérêts principaux des utilisateurs. 3) Méthodes de recommandation par réseaux neuronaux graphiques (GNNs) : l'adoption des GNNs dans la SBR a permis des améliorations notables de performance. Par exemple, SR-GNN, qui a été pionnier dans la conversion des séquences de sessions en structures de graphes afin de capturer l'information structurelle spatiale des éléments, a surpassé les méthodes d'apprentissage profond représentées par STAMP avec un gain de 0,36 à 4,64 %, démontrant ainsi l'avantage spatial des structures de graphes dans le traitement des données séquentielles. S2-DHCN a adopté une convolution hypergraphique à double canal pour capturer les dépendances d'ordre supérieur entre les éléments et a combiné un apprentissage contrastif auto-supervisé pour améliorer les représentations, palliant ainsi la limitation des GNNs traditionnels qui modélisent uniquement des relations par paires et contiennent une information insuffisante ; sa performance a dépassé celle des méthodes d'apprentissage profond représentées par STAMP de 1,30 à 7,04 %. GCE-GNN, en intégrant efficacement l'information de session unique et l'information globale de session, a surpassé les méthodes d'apprentissage profond représentées par STAMP de 1,46 à 7,60 % et SR-GNN de 0,88 à 5,85 %, indiquant que les méthodes basées sur des structures de graphes intégrant une information contextuelle globale peuvent considérablement améliorer la performance de la SBR. 4) Méthodes de recommandation combinant GNNs et mécanisme d'attention : TASRec visait à capturer plus précisément les préférences à court et à long terme dans les séquences de comportement des utilisateurs en introduisant un mécanisme sensible au temps ; sa performance a dépassé celle des méthodes d'apprentissage profond de 0,73 à 5,91 % et celle du modèle SR-GNN de 0,30 à 2,31 %, mais elle restait inférieure à celle du modèle GCE-GNN de 0,59 à 3,84 %. GC-SAN a combiné des structures de graphes converties à partir de séquences de sessions avec des mécanismes d'auto-attention multi-têtes afin de capturer efficacement les dépendances locales et à long terme au sein des sessions ; sa performance était comparable voire légèrement supérieure à celle du modèle SR-GNN, mais inférieure à celle des modèles TASRec et GCE-GNN. Cela suggère que l'introduction de mécanismes d'attention peut améliorer efficacement la performance de la SBR, bien que l'amélioration soit moins marquée que celle obtenue grâce à l'information globale, confirmant ainsi l'importance de l'information contextuelle globale. 5) Méthodes de recommandation combinant GNNs et encodage temporel : CT-GNN a été le premier à combiner des structures de graphes avec un encodage temporel afin de capturer simultanément la « structure spatiale » et la « dynamique temporelle », surpassant ainsi le modèle GC-SAN de 0,55 à 3,82 %. CORE a capturé les préférences à long terme et les intentions à court terme en analysant statistiquement les fréquences de co-occurrence des éléments dans les sessions globales et en concevant un poids temporel pour les positions dans les sessions actuelles, puis a fusionné cette information de co-occurrence et temporelle afin d'obtenir la représentation finale de session ; sa performance a dépassé celle du modèle TASRec de 0,25 à 9,58 % et celle du modèle GC-SAN de 0,67 à 11,56 %, montrant une amélioration significative de 3,64 à 5,74 % par rapport au modèle GCE-GNN sur le jeu de données Tmall. RESTC a introduit un modèle d'apprentissage contrastif basé sur des GNNs spatio-temporels afin de résoudre des problèmes présents dans les GNNs traditionnels, tels que la focalisation uniquement sur les structures de graphes spatiaux, l'ignorance de l'information temporelle et une fusion spatio-temporelle insuffisante ; sa performance a dépassé celle du modèle CORE de 0,39 à 3,31 % et celle du modèle GCE-GNN de 0,28 à 7,56 %, indiquant que l'encodage temporel et l'apprentissage contrastif améliorent efficacement la performance de la SBR. RAIN a utilisé des techniques de masquage d'arêtes et de reconstruction structurelle afin d'entraîner conjointement un indicateur d'arêtes pour identifier et éliminer explicitement les arêtes bruitées, atteignant ainsi une performance proche de celle du modèle RESTC.
Le modèle proposé, GSLA4Rec, intègre des informations contextuelles globales et un mécanisme d'attention linéaire à tranches avec porte pour capturer efficacement les informations contextuelles des utilisateurs tout en filtrant le bruit et en réduisant la complexité computationnelle. Il a démontré des améliorations de performance sur tous les jeux de données, dépassant les deux modèles de référence les plus performants — le modèle RESTC de 0,54 à 2,31 % et le modèle GCE-GNN de 0,83 à 10,18 %. Cette amélioration était particulièrement marquée dans la gestion des dépendances séquentielles dans les scénarios de longues sessions en SBR (notamment des gains de 10,18 % et 4,73 % par rapport à GCE-GNN, et de 1,44 % et 2,31 % par rapport à RESTC sur les jeux de données Tmall et Nowplaying, respectivement). En résumé, le modèle GSLA4Rec proposé intègre une construction efficace de graphe pour capturer les contextes des utilisateurs et filtrer le bruit ; ses performances ont systématiquement surpassé celles de l'état de l'art sur tous les jeux de données.
Analyse de l'efficacité
Comme le montre la Figure 4, les résultats expérimentaux sur le jeu de données Diginetica ont montré que le GSLA4Rec proposé atteignait une vitesse d'apprentissage plus rapide que les modèles de référence en termes de temps d'entraînement par époque, tous les essais étant exécutés sur une GPU NVIDIA TITAN V et consommant environ 9300 Mo de mémoire. Les modèles basés sur l'apprentissage profond, notamment STAMP, NARM et GRU4Rec, fonctionnaient efficacement mais offraient les performances les plus faibles ; les modèles TASRec et GC-SAN, fondés sur les GNN et le mécanisme d'auto-attention, amélioraient les performances, mais souffraient d'un temps de calcul important. Bien que S2-DHCN et CORE, basés sur les GNN, entraînent une légère augmentation du temps de calcul, les performances globales ont considérablement progressé, en particulier pour le modèle GSLA4Rec proposé, qui a montré une amélioration substantielle des performances. La raison principale était que le modèle GSLA4Rec consommait moins de temps pour la construction du graphe que les modèles de référence ; de plus, il utilisait un mécanisme d'attention linéaire à double passage avec des emplacements mémoire fixes m, conduisant à une complexité temporelle linéaire O(Ldm). Cette conception était nettement plus efficace que l'auto-attention classique O(L2d), tout en conservant une forte capacité de mémoire grâce à une lecture des emplacements améliorée par softmax. Des expériences de test de performance sur l'ensemble de test, menées afin de synchroniser le temps d'inférence statistique, comme indiqué dans la dernière ligne du Tableau 3, ont démontré l'avantage en efficacité du modèle GSLA4Rec, évitant ainsi le piège de la « fausse haute précision mais indisponibilité » et réalisant véritablement un compromis entre efficacité et performance.
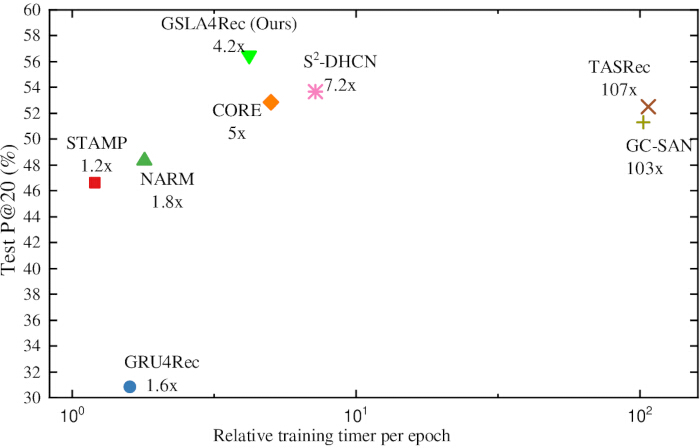
Figure 4 : Performances en fonction du temps d'exécution de GSLA4Rec sur Diginetica. Ce graphique montre que notre modèle GSLA4Rec proposé ainsi que les modèles de référence ont été exécutés sur une GPU NVIDIA TITAN V en utilisant Diginetica pour mesurer le temps d'entraînement relatif par époque, et que GSLA4Rec a atteint une vitesse d'entraînement plus rapide que les modèles de référence. Cette figure a été réalisée elle-même à l’aide d’OriginPro avec des éléments entièrement personnalisés. Aucune ressource graphique externe protégée par des droits d’auteur n’a été utilisée, aucun droit de licence tiers supplémentaire n’était donc nécessaire. Le droit d’auteur de la figure appartient aux auteurs et sera conforme aux règles de droit d’auteur de la revue en cas d’acceptation. GSLA4Rec désigne les réseaux neuronaux graphiques à attention linéaire à emplacements avec portes pour la SBR. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
En résumé, l'efficacité du modèle GSLA4Rec proposé, doté d'une attention à emplacements sélectifs à complexité linéaire, surpasse systématiquement l'état de l'art sur tous les jeux de données. En particulier, GSLA4Rec a obtenu des gains de performance significatifs dans les scénarios de recommandation pour sessions longues sur les jeux de données Tmall et Nowplaying, et a démontré une capacité supérieure à modéliser les dépendances séquentielles.
Analyse des expériences d'ablation
Impact de SG, NGG et GSLA
Afin d'évaluer l'impact du SG, du NGG, du mécanisme de contrôle, des emplacements mémoire et de l'attention linéaire sur le SBR actuel, des études d'ablation ont été menées sur les jeux de données Diginetica, Tmall et Nowplaying. GSLA4Rec‑NotSG excluait le codage de caractéristiques SG tout en conservant le codage NGG, GSLA4Rec‑NotNGG supprimait le codage NGG et effectuait l'extraction de caractéristiques uniquement à partir du SG, GSLA4Rec‑NotGM retirait uniquement le mécanisme de contrôle au sein de GSLA, GSLA4Rec‑NotMS éliminait simplement les emplacements mémoire de GSLA, et GSLA4Rec‑NotLA omettait uniquement le module d'attention linéaire dans GSLA.
| Jeu de données | Diginetica | Tmall | Nowplaying | |||
| Mesures | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
Tableau 4 : Performances des expériences d'ablation de GSLA4Rec. Le tableau indique les performances d'ablation de GSLA4Rec après suppression de composants individuels du modèle sur les jeux de données Diginetica, Tmall et Nowplaying, évaluées à l'aide de P@20 et MRR@20.
Tableau 4 présentait les résultats de l'étude d'ablation sur différents ensembles de données ; toutes les métriques de performance ont diminué par rapport au modèle complet. La baisse de performance en supprimant le codage du graphe de session global par voisinage proche (GSLA4Rec-NotNGG) était plus marquée que lors de la suppression du codage des caractéristiques du graphe de session (GSLA4Rec-NotSG). La suppression de n'importe quel sous-module de GSLA entraînait une dégradation des performances, classée du plus élevé au plus faible selon l'attention linéaire, les emplacements mémoire et le mécanisme de seuil. La raison en était que l'importance de chaque élément dans SBR était clairement différente, et qu'il existait un besoin de mémoire associative entre les éléments. On pouvait constater que GSLA constituait une partie essentielle du modèle proposé dans cet article.
Impact de différentes méthodes d'agrégation
Afin d'évaluer l'impact de différentes méthodes d'agrégation d'informations sur les performances du modèle GSLA4Rec, les trois méthodes classiques d'agrégation suivantes ont été étudiées : 1) le regroupement par moyenne (Average Pooling) : effectuer une opération de regroupement par moyenne sur les vecteurs générés par le SG et le NGG ; 2) la concaténation de vecteurs : concaténer les vecteurs produits par le SG et le NGG ; 3) la somme de vecteurs (Vector Summation) : additionner les vecteurs générés par le SG et le NGG. Les résultats sont présentés dans le Tableau 5. GSLA4Rec avec Vec-Sum a obtenu les meilleures performances sur Diginetica, Tmall et Nowplaying. En revanche, le regroupement par moyenne (Mean-pooling) a donné de mauvais résultats sur l'ensemble des jeux de données. La performance inférieure de l'agrégation par moyenne et de l'agrégation par concaténation pourrait provenir d'un surajustement dû à un nombre excessif de paramètres, ce qui a dégradé les performances globales du modèle.
| Jeu de données | Diginetica | Tmall | Nowplaying | |||
| Mesures | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Moyenne par regroupement | 45,26 | 15,63 | 38,84 | 16,3 | 23,56 | 7,55 |
| Concaténation de vecteurs | 51,77 | 17,24 | 39,83 | 18,24 | 24,06 | 8,88 |
| Somme de vecteurs | 56,47 | 19,98 | 43,6 | 19,96 | 27,1 | 9,32 |
Tableau 5 : Effets de différentes méthodes d'agrégation. Le tableau compare les effets du regroupement par moyenne, de la concaténation de vecteurs et de la sommation de vecteurs sur les performances de GSLA4Rec sur les jeux de données Diginetica, Tmall et Nowplaying, en utilisant P@20 et MRR@20.
Analyse des paramètres hyper-paramétriques
Effets de différentes tailles de fentes de mémoire
Les emplacements mémoire stockaient des informations provenant d'étapes temporelles antérieures, ce qui était particulièrement important pour les tâches comportant des dépendances temporelles. Cette section a examiné l'impact des tailles d'emplacements mémoire m = [0, 1, 2, 3, 4, 5] sur les performances de SBR. Les résultats expérimentaux, présentés dans le Tableau 6, ont indiqué que lorsque la taille des emplacements mémoire m était fixée à 3, les métriques P@20 et MRR@20 atteignaient des performances optimales sur les trois jeux de données. Cela suggère qu'une taille modérée d'emplacements mémoire améliore efficacement la précision des recommandations et la qualité du classement du modèle : des emplacements trop petits peinent à mémoriser suffisamment d'informations historiques et se concentrent davantage sur les intérêts à court terme des utilisateurs, tandis que lorsque la taille des emplacements mémoire augmente à 4 ou plus, le modèle stocke trop d'informations historiques, ce qui le pousse à trop s'appuyer sur les intérêts passés au détriment des informations d'entrée actuelles plus pertinentes, dégradant ainsi la qualité des recommandations.
| Jeu de données | Diginetica | Tmall | Nowplaying | |||
| Mesures | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53,40 | 17,60 | 38,05 | 15,65 | 22,55 | 7,40 |
| GSLA4Rec-m1 | 55,43 | 18,92 | 41,55 | 17,12 | 25,60 | 8,43 |
| GSLA4Rec-m2 | 56,02 | 19,35 | 42,90 | 18,25 | 26,62 | 8,95 |
| GSLA4Rec-m3 | 56,47 | 19,98 | 43,60 | 19,96 | 27,10 | 9,32 |
| GSLA4Rec-m4 | 53,96 | 19,25 | 43,06 | 19,09 | 26,34 | 8,35 |
| GSLA4Rec-m5 | 52,18 | 18,03 | 42,12 | 17,56 | 24,86 | 8,85 |
Tableau 6 : Effets de différentes tailles de mémoire tampon. Le tableau indique les performances de GSLA4Rec avec différentes configurations de mémoire tampon (m0–m5) sur les jeux de données Diginetica, Tmall et Nowplaying, en utilisant P@20 et MRR@20.
Effets de différents taux de dropout
Pour éviter le surapprentissage, une régularisation par abandon (dropout) a été introduite. Avant de sommer le vecteur d'élément au niveau de la session et le vecteur d'élément au niveau global du voisin, les sorties des neurones ont été aléatoirement abandonnées dans le vecteur d'élément global du voisin hingg,(k) afin d'améliorer la robustesse et la capacité de généralisation du modèle GSLA4Rec.
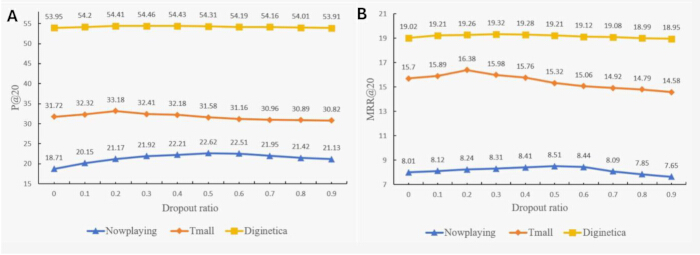
Figure 5 : Performances de GSLA4Rec selon différents taux de désactivation. (A) P@20 et (B) MRR@20 de GSLA4Rec selon différents taux de désactivation sur les jeux de données Nowplaying, Tmall et Diginetica. Les performances ont d'abord augmenté, puis diminué à mesure que le taux de désactivation augmentait, démontrant ainsi la robustesse et la capacité de généralisation du modèle. GSLA4Rec, réseaux neuronaux graphiques à attention linéaire à emplacements à seuil pour la recommandation basée sur des sessions (SBR). Cette figure a été réalisée par les auteurs à l'aide d'OriginPro avec des éléments entièrement personnalisés. Aucune ressource graphique externe protégée par des droits d'auteur n'a été utilisée ; par conséquent, aucune licence tierce supplémentaire n'était requise. Les droits d'auteur de la figure appartiennent aux auteurs et seront conformes aux règles de droit d'auteur de la revue en cas d'acceptation. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Figure 5A–B montre l'impact de différents taux de dropout dans l'équation (16) sur les performances du modèle. Les résultats expérimentaux indiquent que le modèle a de mauvaises performances lorsque le taux de dropout est faible ; toutefois, à mesure que ce taux augmente, les performances du modèle s'améliorent progressivement jusqu'à atteindre un niveau optimal. Plus précisément, le taux de dropout optimal était de 0,3 sur le jeu de données Diginetica, de 0,2 sur le jeu de données Tmall et de 0,5 sur le jeu de données Nowplaying. Lorsque le taux de dropout dépassait ces valeurs optimales, les performances du modèle commençaient à diminuer, principalement parce qu'un dropout excessif des neurones empêchait le modèle d'apprendre efficacement les caractéristiques importantes à partir des données de session.
Effets de différentes tailles d'incorporation
Afin de minimiser au maximum la charge de calcul tout en maintenant des performances optimales du modèle, l'impact de différentes dimensions d'incorporation d a été étudié sur les performances du modèle GSLA4Rec. Comme illustré dans Figure 6A–B, sur trois jeux de données publics — Diginetica, Tmall et Nowplaying —, le modèle GSLA4Rec a montré de faibles performances lorsque la dimension d'incorporation d était comprise entre 10 et 40 ; toutefois, les performances du modèle ont rapidement augmenté à mesure que la valeur de d croissait, les métriques de performance tendant à se stabiliser lorsque d se situait entre 80 et 120, puis les performances ont effectivement diminué lorsque d a continué d'augmenter, probablement en raison d'un surajustement causé par une dimension d'incorporation trop élevée. Par conséquent, la dimension du vecteur d'incorporation des éléments a finalement été fixée à 100.
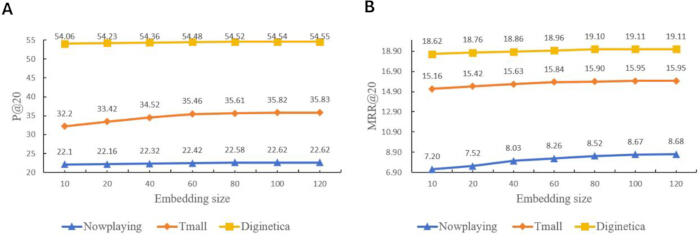
Figure 6 : Performances de GSLA4Rec pour différentes tailles d'incorporation. (A) P@20 et (B) MRR@20 de GSLA4Rec pour différentes tailles d'incorporation sur les jeux de données Nowplaying, Tmall et Diginetica. Les performances du modèle ont progressivement augmenté avec la taille de l'incorporation, puis ont finalement atteint un plateau. GSLA4Rec, réseaux neuronaux graphiques à attention linéaire à emplacements avec porte pour la recommandation basée sur des sessions (SBR). Cette figure a été réalisée par les auteurs à l'aide d'OriginPro avec des éléments entièrement personnalisés. Aucune ressource graphique externe protégée par des droits d'auteur n'a été utilisée ; par conséquent, aucune licence tierce supplémentaire n'était requise. Les droits d'auteur de la figure appartiennent aux auteurs et seront conformes aux règles de droit d'auteur de la revue en cas d'acceptation. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Effets de différentes durées de séance
Il était bien connu que la durée de chaque session variait selon les trois ensembles de données réels de SBR (Diginetica, Tmall et Nowplaying). Afin de vérifier la robustesse du modèle GSLA4Rec par rapport aux modèles de référence sur des sessions de différentes longueurs, toutes les sessions de Diginetica et Tmall ont été divisées en trois groupes : groupe court (S), groupe moyen (M) et groupe long (L), correspondant respectivement aux plages de 1 à 6, 7 à 12, et supérieures à 12. L’MRR@20 a été adopté pour évaluer les performances des méthodes au lieu de la P@20, car l’MRR reflète mieux la qualité du classement des résultats corrects. Figure 7A–B indiquaient que le modèle GSLA4Rec surpassait le modèle de référence basé sur les séquences NARM, le modèle de référence basé sur les GNN SR-GNN, le modèle de référence GNN amélioré par apprentissage contrastif S2-DHCN, et le modèle de référence spatio-temporel RESTC, pour différentes longueurs de sessions. Par ailleurs, on a également observé que les performances de toutes les méthodes diminuaient avec l’augmentation de la longueur des séquences, car les transitions d’articles à longue portée rendaient difficile la capture des préférences des utilisateurs. Toutefois, le modèle proposé GSLA4Rec présentait la vitesse de décroissance la plus lente par rapport aux modèles de référence, car le mécanisme à emplacements à seuil permettait d’éliminer les articles non pertinents. Ainsi, les performances de GSLA4Rec dépassaient respectivement celles du modèle NARM de 6,3 et 8,85 dans les groupes longs de Diginetica et Tmall.
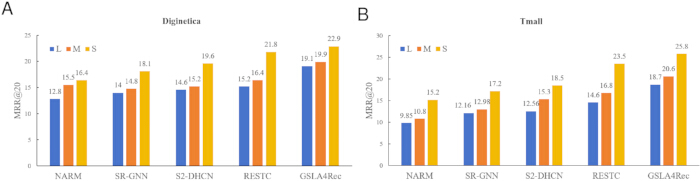
Figure 7 : Performances de GSLA4Rec selon différentes longueurs de session. Performances de GSLA4Rec et des modèles de référence selon différents groupes de longueur de session sur les jeux de données (A) Diginetica et (B) Tmall, évaluées à l’aide de MRR@20. Les groupes de longueur de session sont notés L, M et S. GSLA4Rec, réseaux neuronaux graphiques à attention linéaire par créneaux avec porte pour la recommandation basée sur les sessions (SBR). Cette figure a été réalisée par les auteurs à l’aide d’OriginPro avec des éléments entièrement personnalisés. Aucune ressource graphique externe protégée par des droits d’auteur n’a été utilisée ; par conséquent, aucune licence tierce supplémentaire n’était requise. Les droits d’auteur de la figure appartiennent aux auteurs et seront conformes aux règles de droit d’auteur de la revue en cas d’acceptation. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Conclusion
Cet article propose un réseau d'attention linéaire à emplacements commandés par contexte global pour la recommandation basée sur les sessions (SBR). En combinant SG et NGG, et en introduisant un mécanisme d'attention linéaire à emplacements commandés, cette méthode permet de se concentrer sur les éléments clés de la séquence de session, de capturer les dépendances à long et à court terme, de réduire efficacement le bruit et de diminuer la complexité computationnelle. Les résultats expérimentaux confirment que cette méthode présente une excellente précision et efficacité de recommandation sur trois jeux de données publics, en particulier dans les tâches de modélisation des dépendances à long terme.
DISPONIBILITÉ DES DONNÉES :
Trois ensembles de données publics courants (Diginetica, Tmall et Nowplaying, dont les URL sont disponibles dans le Tableau des matériaux) qui soutiennent les résultats de cette étude sont librement accessibles sur Internet. Parallèlement, trois ensembles de données publics largement utilisés ainsi que le code source de ce travail ont été soumis sous forme de Dossier supplémentaire : GSLA4Rec.zip. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Compared with baselines, the GSLA4Rec model achieves dual improvements in performance and efficiency for three core reasons. First, applying gating mechanisms to NGG alleviates data sparsity and filters noise effectively. Second, the memory slots mechanism balances storage capacity and efficiency via hyperparameter m adjustment. Third, the linear attention mechanism computes item correlations at an O(N) complexity, far lower than the O(N2)61. The GSLA4Rec model overly relies on users' interaction sequences and ignores the multimodal properties of items48. Meanwhile, the NGG construction uses a fixed Jaccard threshold without dynamic adjustment function, and the memory slots m cannot achieve adaptive adjustability65.
The GSLA4Rec model, which builds SG&NGG and adopts gated-slot linear attention, especially fits anonymous session recommendation39 across e-commerce and online streaming platforms. In e-commerce platforms, this model recommends matching products to users by capturing their browsing, clicking, or adding behaviors to their shopping cart, without relying on user characteristic attributes. The datasets Diginetica and Tmall used in this paper are e-commerce recommendation datasets. For short-video and music streaming platforms, this method analyzes users' playback sequences to infer their implicit preferences, updates content summaries to retain users, and extends viewing time. The dataset Nowplaying used in this paper is the music recommendation dataset.
There are alternative solutions that can replace the gated slot linear attention architecture. The emerging Mamba65 based state space model, as an alternative, has the characteristics of selective state storage space and linear computational complexity, balancing linear complexity and long sequence fitting ability, and combined with the LLM55 enhancement framework, it extracts the users' implicit intent from the original interaction log, thereby achieving good recommendation performance and efficiency. Future work can optimize GSLA4Rec from multiple perspectives: building dynamic NGG to replace fixed Jaccard filtering, implementing variable memory slots to automatically match sessions of different lengths, and incorporating user multimodal information to improve recommendation accuracy. In addition, with the help of LLM-augmented models55, users' implicit intentions can be mined from interaction sequences, and noisy conversation data can be filtered more accurately72.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont pas d’intérêts financiers concurrents connus ni de relations personnelles susceptibles d’avoir influencé les travaux rapportés dans cet article.
Remerciements
L'auteur remercie les évaluateurs pour leurs commentaires et suggestions réfléchis au cours du processus d'évaluation, ainsi que le professeur Jiang Nan, mon directeur de thèse, pour son encadrement attentif. Cette étude a été partiellement soutenue par la Fondation nationale des sciences de Chine dans le cadre de la subvention n°6217072713 et de la subvention n°62061019, ainsi que par des sujets de recherche ouverts en partie par le système de détection sans pilote de la province du Jiangxi et le centre de recherche ingénierie sur la technologie de l'intelligence artificielle en 2025, et en partie par le laboratoire clé provincial du Jiangxi des matériaux et dispositifs électroniques avancés (n°2024SSY03012).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | NONE | CUDA 11.3 est une version de la plateforme et du modèle de programmation de calcul parallèle publiée par NVIDIA en 2021, conçue pour améliorer les performances et la flexibilité de développement des applications accélérées par GPU. |
| Diginetica | Diginetica | NONE | Diginetica est le jeu de données officiel du concours CIKM (Conférence internationale sur la recherche d'information) Cup 2016, utilisé lors de la compétition algorithmique CIKM pour résoudre le problème de recherche personnalisée de produits en commerce électronique avec contexte de recherche. Il est désormais devenu le jeu de données de référence le plus répandu dans le domaine de la recommandation basée sur des sessions (SBR). |
| Nowplaying | Zenodo | NONE | Il s'agit d'un jeu de données à grande échelle sur le comportement d'écoute musicale, construit à partir de l'extraction de tweets contenant le hashtag « #nowplaying », principalement utilisé pour la recherche en recommandation conversationnelle musicale, recommandation contextuelle et analyse de corrélation des sentiments. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | NONE | OriginPro est un logiciel commercial professionnel de dessin scientifique et d'analyse de données développé par OriginLab Corporation, couramment utilisé pour la création de graphiques de niveau publication, l'analyse statistique des données, l'ajustement de courbes, le traitement du signal, etc. Cet article utilise OriginPro pour tracer des graphiques de comparaison expérimentale, des courbes et des diagrammes en barres. |
| PyTorch 1.11.0 | PyTorch Foundation | NONE | PyTorch est un framework open source de deep learning pour l'apprentissage machine et le deep learning, publié par Facebook en 2016. Il implémente principalement la différentiation automatique et introduit des graphes de calcul dynamiques afin de rendre la construction des modèles plus flexible. |
| TITAN V GPU | NVIDIA | NONE | Le TITAN V d'NVIDIA est une carte graphique phare lancée par NVIDIA fin 2017, principalement destinée aux domaines du calcul haute performance et de l'intelligence artificielle. |
| Tmall | Tmall | NONE | Issu du concours de recommandation Alibaba Tmall IJCAI 2015, Alibaba Tianchi a publié publiquement des journaux réels anonymisés de Tmall en ligne. C'est l'un des trois jeux de données standards dans le domaine SBR (Diginetica, Yoocoose, Tmall) et l'ensemble d'évaluation privilégié pour les scénarios de commerce électronique chinois. |
| visio 2021 | Microsoft | NONE | Visio est un logiciel de dessin vectoriel développé par Microsoft, utilisé pour créer des schémas de structure de modèles, des organigrammes, des diagrammes d'architecture, des topologies de réseau dans les articles scientifiques, et pour exporter des illustrations vectorielles destinées aux publications. |
Références
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.