Ce protocole décrit la création d'un ensemble de données basé sur les conditions météorologiques et l'évaluation systématique de modèles d'apprentissage automatique, d'apprentissage profond et de modèles hybrides pour prédire l'atténuation atmosphérique dans les communications optiques en espace libre sous diverses conditions environnementales irakiennes, notamment les tempêtes de poussière, le brouillard, la pluie et la neige.
Article de recherche
L'apprentissage automatique surpasse l'apprentissage profond pour la prédiction de l'atténuation atmosphérique dans les communications optiques en espace libre sous les conditions météorologiques irakiennes
Dans cet article
Résumé
Résumé
Les systèmes de communication optique par faisceau hertzien offrent une grande bande passante, une sécurité accrue et un fonctionnement sans licence, mais subissent fortement les dégradations de performance dues à l'atténuation atmosphérique provoquée par la diffusion et l'absorption. La précision de la prédiction de l'atténuation revêt une importance encore plus grande en Irak, où l'environnement est chaud, poussiéreux, brumeux et pluvieux de manière aléatoire. L'objectif de cette étude est d'évaluer la performance de techniques d'apprentissage automatique, d'apprentissage profond et de modélisation hybride pour prédire l'atténuation atmosphérique des systèmes de communication optique par faisceau hertzien dans diverses conditions météorologiques irakiennes. Un jeu de données synthétique de 1500 échantillons a été créé à l'aide de modèles physiques de propagation bien établis, couvrant cinq régimes météorologiques : ciel dégagé, brouillard, pluie, tempêtes de poussière et neige. Quinze modèles prédictifs ont été évalués de manière systématique, comprenant six techniques d'apprentissage automatique (Forêt aléatoire [RF], Boosting extrême par gradient, Machine à boosting par gradient légère, Régression par vecteurs de support, Régression linéaire et K-plus proches voisins), six architectures d'apprentissage profond (Perceptron multicouche, Réseau neuronal profond, Mémoire à long court terme [LSTM], Réseau neuronal convolutif unidimensionnel [CNN], CNN–LSTM et réseau à base de mécanisme d'attention) et trois approches hybrides. Les résultats ont montré que RF offrait les meilleures performances (R2 = 0,9654, erreur quadratique moyenne = 1,324 dB/km), comparée aux approches d'apprentissage profond (meilleur R2 = 0,7766) et aux méthodes hybrides (meilleur R2 = 0,9571). L'importance des caractéristiques a été analysée à l'aide des explications additives de Shapley, révélant que la concentration en poussière (67,3 %) et la visibilité (21,2 %) étaient les facteurs les plus influents. Bien que RF ait permis un entraînement et une inférence nettement plus rapides, des tests statistiques n'ont révélé aucune différence significative entre RF et la meilleure approche hybride (p = 0,083). On démontre ainsi que les techniques conventionnelles d'apprentissage automatique sont très efficaces pour estimer l'atténuation atmosphérique dans les systèmes de communication FSO en conditions environnementales défavorables, conformément aux théories physiques bien établies de la propagation. Toutefois, nous soulignons que ces conclusions reposent sur des données synthétiques et doivent être validées par des mesures atmosphériques réelles avant d'être appliquées à des systèmes FSO opérationnels.
Introduction
Les réseaux de communication optique en espace libre (FSO) offrent généralement une capacité plus élevée et une meilleure sécurité, mais l'atténuation atmosphérique due à la diffusion et à l'absorption constitue un facteur limitant majeur pour la distance de communication1. Dans ce travail, nous proposons une analyse détaillée des approches basées sur l'apprentissage automatique, l'apprentissage profond et les méthodes hybrides2 afin d'évaluer l'atténuation du signal FSO dans l'environnement difficile d'Irak, caractérisé par des températures élevées, des tempêtes de poussière et des précipitations irrégulières.
Les systèmes de communication par liaison optique sans fil (FSO) se sont imposés comme l'une des solutions prometteuses pour assurer une connectivité sans fil à large bande passante3, avec des débits de données dépassant 100 Gbps sur des distances allant de quelques centaines de mètres à plusieurs kilomètres4. Contrairement aux systèmes radiofréquences conventionnels, les liaisons FSO fonctionnent dans le spectre visible et infrarouge, offrant des avantages tels qu’un fonctionnement sans licence, une immunité aux interférences électromagnétiques, une sécurité accrue grâce à une faible divergence du faisceau et une grande capacité de bande passante5. Ces caractéristiques rendent la technologie FSO particulièrement attrayante pour les applications de liaison tronçale, les connexions entre bâtiments, les réseaux de secours en cas de catastrophe et la connectivité du dernier kilomètre, là où le déploiement de fibres optiques s’avère prohibitivement coûteux6. Toutefois, la communication par diffusion, déviation et absorption du faisceau7,8 dépend fortement des conditions environnementales en termes de disponibilité et de performance. Ce défi constitue l'une des principales limitations des systèmes de communication optique en espace libre. Les conditions météorologiques provoquent de fortes variations des niveaux d'atténuation (dB/km). En conditions de ciel clair, l'atténuation peut être inférieure à 0,5 dB/km, tandis qu’un brouillard dense peut entraîner une atténuation atteignant ≥50 dB/km à 1550 nm (selon le modèle de brouillard de Kim, qui prédit des valeurs d’atténuation allant jusqu’à 50 dB/km pour une visibilité inférieure à 50 m à 1550 nm)9,10, et une pluie intense peut provoquer une atténuation allant jusqu’à 20–30 dB/km selon l’intensité des précipitations (prévision selon le modèle de Carbonneau)11. Une prédiction précise de l’atténuation est donc nécessaire pour une conception fiable des liaisons, la planification des réseaux et l’élaboration de stratégies de transmission adaptatives. Les méthodes classiques reposent sur des modèles physiques de propagation, tels que le modèle de Kim pour le brouillard12, le modèle de Carbonneau pour la pluie13 et la théorie de diffusion de Mie pour les particules aérosols14. Cependant, bien que ces modèles fournissent une solide base théorique, ils s'appuient souvent sur des paramètres atmosphériques précis qui ne sont pas toujours disponibles en pratique, et ne tiennent fréquemment pas compte des interactions complexes entre plusieurs phénomènes météorologiques simultanés15.
La variabilité extrême des conditions environnementales en Irak pose des défis importants pour le déploiement des systèmes de communication optique en espace libre. Les conditions de transmission sont davantage compliquées par des précipitations minimales et des épisodes de brouillard isolés, tandis que les températures hivernales peuvent descendre en dessous de 0 °C et les températures estivales dépasser 50 °C16. Dans des spectres couramment utilisés comme 1550 nm à des longueurs d'onde normales, les tempêtes de poussière, appelées localement « al-haboob », peuvent réduire la visibilité à moins de 100 mètres, entraînant des valeurs d'atténuation supérieures à 20 dB/km17. Pour que les systèmes FSO puissent être déployés avec succès en Irak et dans d'autres pays du Moyen-Orient, il est nécessaire d'élaborer des modèles de prédiction fiables capables d'estimer précisément les performances du système dans ces différentes conditions environnementales18.
Les nouveaux développements en apprentissage automatique offrent des alternatives viables aux techniques classiques de modélisation basées sur la physique. La capacité des méthodes d'apprentissage automatique à apprendre directement des corrélations non linéaires complexes entre l'atténuation et les facteurs atmosphériques permet de détecter des interactions subtiles que les modèles analytiques traditionnels pourraient négliger19. Dans diverses tâches de prédiction climatologique, les forêts aléatoires (RF) et les stratégies de boosting par gradient ont démontré des performances élevées20. De même, les techniques d'apprentissage profond ont connu un succès remarquable dans le traitement du langage naturel, la vision par ordinateur et la prévision de séries temporelles21. Toutefois, ces approches sont peu explorées pour la prédiction de l'atténuation en communication par faisceau spatial (FSO), notamment avec des ensembles de données limités et des conditions météorologiques très variables22. Pour combler cette lacune, ce travail présente une étude approfondie des approches d'apprentissage automatique, d'apprentissage profond et hybrides pour prédire l'atténuation du signal FSO dans des conditions atmosphériques irakiennes. Cela est réalisé en construisant un jeu de données synthétique bien conçu, fondé sur des modèles de propagation physique bien établis23. Nous émettons l'hypothèse que, pour des jeux de données environnementales tabulaires de taille modérée et comportant peu de variables prédictives dominantes, la performance prédictive des méthodes d'ensemble basées sur les arbres surpassera celle des architectures complexes d'apprentissage profond. Les objectifs principaux sont : (1) établir une méthodologie de référence pour comparer les méthodes de prévision dans un environnement de simulation contrôlé, (2) identifier les meilleures stratégies algorithmiques pour prédire l'atténuation atmosphérique, et (3) évaluer l'importance des caractéristiques et l'interprétabilité des modèles afin de mieux comprendre les facteurs environnementaux ayant le plus d'impact sur l'atténuation. Dans ce travail, des données synthétiques sont utilisées, mais les bases sont posées pour une validation ultérieure à l'aide de mesures expérimentales réelles, ce qui est prévu dans des travaux futurs. En outre, des analyses de l'importance des caractéristiques et de l'interprétabilité des modèles sont intégrées afin de déterminer les facteurs environnementaux les plus influents sur l'atténuation.
Protocole
Cette étude n'a pas impliqué de participants humains ni d'animaux vertébrés, ni de prélèvement de tissus. Toutes les données utilisées pour cette recherche ont été générées de manière synthétique à l'aide de modèles de propagation physique et de paramètres météorologiques accessibles au public. Par conséquent, aucune approbation éthique d'un comité d'éthique (IRB) ou d'un comité institutionnel de soins et d'utilisation des animaux (IACUC) n'était nécessaire.
Génération du jeu de données fondée sur la théorie physique de la propagation. Le jeu de données a été conçu pour imiter les conditions atmosphériques horaires d'un système de communication optique en espace libre sur une année civile complète (2024) dans des conditions atmosphériques irakiennes. Nous avons créé une base de données synthétique comprenant 1 500 échantillons par heure.
Premièrement, les conditions météorologiques ont été attribuées aléatoirement selon les tendances régionales : ciel dégagé (54,3 %), poussière (24,9 %), brouillard (10,5 %), pluie (7,4 %) et neige (2,8 %). Deuxièmement, le modèle physique d'atténuation correspondant a été appliqué à chaque échantillon en fonction de la condition météorologique, à savoir la loi de Beer-Lambert pour le ciel dégagé, le modèle de Kim pour le brouillard, la théorie de Carbonneau pour la pluie et la théorie de la diffusion de Mie pour les tempêtes de poussière. Troisièmement, les paramètres du système FSO ont été fixés comme suit : puissance d'émission de 20 dBm, longueur d'onde de 1550 nm, distance de transmission de 3 km, ouverture d'émission de 2,5 cm et ouverture de réception de 20 cm. Quatrièmement, l'atténuation a été calculée en dB/km pour chaque échantillon. Enfin, l'ensemble complet de données a été divisé aléatoirement en 1 200 échantillons d'apprentissage (80 %) et 300 échantillons de test (20 %). Les conditions simulées incluent de fortes concentrations de poussière associées à des tempêtes de sable, des orages et des variations de température allant de −4,89 °C à 47,99 °C. Les conditions météorologiques et les distributions de paramètres ont été choisies en fonction des données climatiques irakiennes recueillies entre 2020 et 2024. Les cinq régimes météorologiques (ciel dégagé, brouillard, pluie, tempêtes de poussière et neige) ont été sélectionnés car ils couvrent tout le spectre des conditions atmosphériques affectant l'atténuation FSO en Irak, les tempêtes de poussière étant particulièrement fréquentes au Moyen-Orient. Les données historiques météorologiques recueillies dans différentes régions d'Irak ont été utilisées pour établir la distribution de probabilité de chaque condition météorologique. La distribution obtenue est la suivante : 54,3 % de ciel dégagé (état prédominant), 24,9 % de poussière (reflétant le problème des tempêtes de sable en Irak), 10,5 % de brouillard (fréquent lors des hivers dans le nord de l'Irak), 7,4 % de pluie (faibles précipitations typiques de l'Irak) et 2,8 % de neige (parfois observée dans les zones montagneuses du nord). Les paramètres météorologiques pertinents ont été modélisés à l'aide de distributions de probabilité pour chaque condition météorologique comme suit : la température a été modélisée selon une distribution normale (moyenne 28,55±11,18 °C) comprise entre −4,89 °C et 47,99 °C, en fonction des extrêmes saisonniers en Irak ; l'humidité a été modélisée selon une distribution uniforme (moyenne 42,01±25,56 %) allant de 0 % à 100 % ; la visibilité a été modélisée selon une distribution log-normale comprise entre 0,05 km et 29,99 km (moyenne 13,10±10,91 km) afin de tenir compte des fréquents épisodes de faible visibilité pendant les tempêtes de poussière ; la concentration de poussière a été modélisée selon une distribution exponentielle comprise entre 0 et 4,96 mg/m3 (moyenne 0,74±1,30 mg/m3), avec des probabilités plus élevées pour les faibles concentrations et des queues longues pour les événements extrêmes de poussière.
Le système de communication a été conçu avec une puissance d'émission de 20 dBm, une longueur d'onde de 1550 nm, une distance de transmission allant jusqu'à 3 km, une ouverture d'émission de 2,5 cm et une ouverture de réception de 20 cm afin de compenser les pertes dues à la divergence. Les paramètres du système FSO ont été divisés en deux groupes : les paramètres fixes, qui n'ont pas changé pour tous les échantillons, et les paramètres variables, modifiés lors de la génération du jeu de données. Pour l'ensemble des 1 500 échantillons, les paramètres suivants ont été fixés : puissance d'émission (20 dBm), longueur d'onde de fonctionnement (1550 nm), ouverture d'émission (diamètre 2,5 cm, rendement 0,7) et ouverture de réception (diamètre 20 cm, rendement 0,7). Ces paramètres ont été maintenus constants car ils correspondent aux spécifications physiques du matériel du système FSO et ne varient pas selon les conditions météorologiques. Le jeu de données a été créé à partir de 1 500 échantillons en faisant varier les paramètres suivants : température (−4,89 °C à 47,99 °C), humidité (0 % à 100 %), visibilité (0,05 km à 29,99 km), concentration de poussière (0 à 4,96 mg/m3) et conditions météorologiques (ciel dégagé, brouillard, pluie, poussière, neige). Ces paramètres ont été ajustés selon des distributions de probabilité dérivées des relevés climatiques irakiens pour les années 2020 à 2024. Pour chaque échantillon, la valeur d'atténuation (dB/km) a été calculée à l'aide du modèle physique d'atténuation correspondant, en fonction de la combinaison spécifique de conditions météorologiques et de paramètres variables.
L'atténuation physique a été modélisée à l'aide du modèle de Carbonneau pour la pluie, de la loi de Beer-Lambert pour un ciel clair, de la théorie de diffusion de Mie pour la poussière et du modèle de Kim pour le brouillard24. La loi de Beer-Lambert s'applique aux conditions de ciel dégagé, où l'atténuation est dominée par la diffusion moléculaire et l'absorption, qui décroissent de manière exponentielle avec la distance25. Le coefficient d'extinction α à 1550 nm est dû à la diffusion Rayleigh par les molécules d'air et à l'absorption par les gaz atmosphériques26. Le modèle de Kim est un modèle spécifique au brouillard qui relie l'atténuation à la visibilité à travers des coefficients empiriques dérivés des distributions de taille des gouttelettes de brouillard. L'exposant dépendant de la longueur d'onde q tient compte de la diffusion de Mie27. Le paramètre principal du modèle de Carbonneau est l'intensité de précipitation R, car l'atténuation due à la pluie dépend de la taille et de la densité des gouttes de pluie, et les coefficients sont déterminés empiriquement à 1550 nm et spécifiquement calibrés pour les longueurs d'onde optiques28. La théorie de diffusion de Mie s'applique aux conditions de poussière, puisque la taille des particules de poussière (rayon de 0,1 à 100 μm) est comparable à la longueur d'onde (1550 nm), et l'indice de réfraction complexe m = 1,55–0,005i pour la poussière du Moyen-Orient inclut à la fois la diffusion et l'absorption29. Les modèles d'atténuation physique suivants ont été mis en œuvre avec leurs équations respectives et leurs paramètres.
Pour des conditions de ciel dégagé, la loi de Beer-Lambert a été utilisée :
Aclear = 10×log₁₀(e(α×d)) (1)
où α est le coefficient d'extinction (variable selon une distribution normale centrée sur 0,02 dB/km avec une variation de ±0,005 dB/km à 1550 nm dans des conditions claires), et d est la distance de transmission (fixée à 3 km). Pour les conditions de brouillard, le modèle de Kim a été appliqué en utilisant l'équation suivante :
Afog = 10×ln(10)/V×(λ/550)−q (2)
où V est la visibilité en kilomètres (variant de 0,05 km à 10 km), λ est la longueur d'onde en nanomètres (fixée à 1550 nm) et q est le coefficient de distribution de la taille des particules calculé comme suit : q = 1,6 pour V > 50 km, q = 1,3 pour 6 < V < 50 km, q = 0,585 × V(1/3) pour 1 < V < 6 km, q = 0 pour 0,5 < V < 1 km, et q = 0,5 pour V < 0,5 km. Pour les conditions de pluie, le modèle de Carbonneau a été utilisé :
Arain=0.023×R0.93 (3)
où R est la pluviométrie en mm/h (variant entre 0,25 et 50 mm/h selon les données irakiennes sur les précipitations). La relation d'efficacité d'extinction a été utilisée pour les conditions de tempête de poussière en appliquant la diffusion de Mie :
Adust=10×log₁₀(e(τ×L)) (4)
où τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r est le rayon des particules (0,1–100 μm selon la composition de la poussière irakienne), Qext est l'efficacité d'extinction calculée à l'aide de la théorie de Mie, λ=1550 nm, m=1,55–0,005i est l'indice de réfraction complexe de la poussière du Moyen-Orient, et N(r) est la distribution de la taille des particules modélisée à l'aide d'une distribution log-normale avec un rayon moyen géométrique de 2,5 μm et un écart type de 2,0. Le modèle d'atténuation a été appliqué aux conditions de neige comme suit :
Asnow = 0.1×S0.75 (5)
où S est la vitesse de chute de neige en mm/h (0,5–15 mm/h). Cette équation empirique a été choisie en se basant sur les travaux publiés dans la littérature30, où des modèles d'atténuation pour la propagation optique à travers la neige ont été élaborés à l'aide de la théorie de diffusion de Mie appliquée aux distributions de taille des flocons de neige. L'équation est valable pour des taux de chute de neige compris entre 0,5 et 15 mm/h et suppose des conditions de neige sèche avec des diamètres typiques de flocons de 1 à 10 mm. Le coefficient 0,1 et l'exposant 0,75 ont été obtenus par ajustement de courbe aux calculs de diffusion de Mie30 pour la neige à 1550 nm. Elle ne tient pas compte de la neige humide ni des précipitations mixtes, qui peuvent présenter des propriétés d'atténuation variables, bien qu'elle fournisse une estimation raisonnable pour la neige sèche. Étant donné que cette approche est efficace sur le plan computationnel, fréquemment citée dans les publications sur les communications par faisceau spatial (FSO) et adaptée aux conditions de neige prévues dans le nord de l'Irak (région du Kurdistan en janvier et février), elle a été retenue pour cette étude. À l'aide de Numpy pour les calculs numériques, tous les modèles ont été implémentés en Python 3.9. Le modèle correspondant a été appliqué aux conditions météorologiques choisies aléatoirement et aux données ambiantes échantillonnées afin de calculer la valeur d'atténuation pour chaque échantillon. La distribution météorologique obtenue comprenait 814 conditions de ciel clair (54,27 %), 375 épisodes de poussière (25,00 %), 157 épisodes de brouillard (10,47 %), 111 épisodes de pluie (7,40 %) et 43 épisodes de neige (2,87 %).
L'examen des données météorologiques historiques recueillies auprès de stations météorologiques irakiennes dans plusieurs régions (Bagdad, Bassorah, Mossoul et Ramadi) entre 2020 et 2024 a permis d'établir les proportions des situations météorologiques. Les données brutes ont été fournies par le ministère des Transports de l'Irak et l'Organisation météorologique irakienne et de sismologie (IMOS). Les données comprenaient des relevés météorologiques quotidiens enregistrant les conditions atmosphériques en vigueur chaque jour. Les caractéristiques spécifiques extraites de ces relevés comprenaient la température (minimum, maximum et moyenne journalière), l'humidité relative, la visibilité, la quantité de précipitations et la survenue de tempêtes de poussière. Une partie des données de l'IMOS est accessible via le portail de données ouvertes du gouvernement irakien (https://www.motrans.gov.iq/) ; toutefois, les enregistrements particuliers utilisés dans cette étude ne sont pas archivés publiquement dans un dépôt central. Le tableau 1 résume les informations climatiques utilisées pour calculer les pourcentages des conditions météorologiques et des valeurs des paramètres. Les journées à ciel dégagé ont été définies comme des journées sans précipitation, avec une visibilité supérieure à 10 km et aucune activité de poussière, représentant 54,27 % des 1 825 jours enregistrés. Les journées de tempête de poussière (incluant les tempêtes de poussière complètes (visibilité < 1 km) et partielles (visibilité entre 1 et 10 km))) ont représenté 22,30 % des jours, tandis que les journées nuageuses (sans précipitation ni activité de poussière) ont constitué 14,08 % des jours. Les journées pluvieuses (avec précipitations mesurables) ont représenté 9,34 % des jours. < 1 km) et poussière en suspension (visibilité de 1 à 5 km)) représentaient 25,00 % des jours, indiquant la fréquence élevée des épisodes de tempête de sable dans le climat aride et semi-aride de l'Irak. Les jours où la visibilité était inférieure à 1 km en raison de la suspension de gouttelettes d'eau (hors réduction de visibilité causée par les poussières) ont été classés comme des jours de brouillard. Le pourcentage de jours de brouillard était de 10,47 %, et ces jours se produisaient principalement en hiver dans les régions du nord de l'Irak. Les jours de pluie, jours avec une précipitation mesurable >0,1 mm, étaient de 7,40 %, en accord avec la faible moyenne des précipitations annuelles en Irak, qui s'élève à 150–200 mm par an. Les jours de neige (jours avec accumulation de précipitations gelées) représentaient 2,87 % des jours et étaient limités aux régions montagneuses du nord (région du Kurdistan) en janvier et février. Ces proportions ont ensuite été utilisées comme poids probabilistes pour l'échantillonnage aléatoire lors de la génération du jeu de données. Ainsi, le jeu de données synthétique reflète la fréquence réelle de chaque condition météorologique dans l'environnement irakien.
Prise en compte des biais dans la génération de données synthétiques
Plusieurs mesures ont été prises afin de réduire les biais possibles :
(1) Sélectionner la distribution : Les propriétés statistiques des données climatiques sources ont été utilisées pour choisir les distributions de probabilité. La température suivait une distribution normale, avec une moyenne et un écart-type tels que relevés par l'IMOS. L'humidité suivait une distribution uniforme sur toute la plage observée (0-100 %). On a supposé que la visibilité suivait une distribution log-normale afin de tenir compte de la fréquence élevée d'événements de faible visibilité pendant les tempêtes de poussière. La concentration de poussière suivait une distribution exponentielle, avec des probabilités plus élevées à faible concentration et des queues longues lors d'événements extrêmes de poussière31. Ceci était conforme à la fréquence observée des épisodes de poussière en Irak32.
(2) Proportions des conditions météorologiques : L'analyse des données d'IMOS pour la période 2020–2024, comprenant 1 825 observations quotidiennes dans les quatre régions, a donné les proportions suivantes : 54,3 % de ciel dégagé, 24,9 % de poussière, 10,5 % de brouillard, 7,4 % de pluie et 2,8 % de neige. Les journées de ciel dégagé ont été définies comme des journées sans précipitations, avec une visibilité >10 km et sans activité de poussière. Les journées avec tempêtes de poussière incluaient à la fois les tempêtes complètes (visibilité <1 km) et la poussière en suspension (visibilité de 1 à 5 km). Une journée de brouillard correspond à une journée où la visibilité était inférieure à 1 km et où la cause était la suspension de gouttelettes d'eau (et non de poussière). Les journées de pluie ont été définies comme des journées avec une précipitation mesurable >0,1 mm. Les journées de neige ont été définies comme des journées avec accumulation de précipitations gelées33.
(3) Plages de paramètres : Les plages de paramètres étaient basées sur les valeurs extrêmes observées dans les enregistrements d'IMOS : la température variait de −4,89 °C (Mosoul, hiver) à 47,99 °C (Basra, été), la visibilité allait de 0,05 km (tempêtes de poussière sévères) à 29,99 km (conditions claires), et la concentration de poussière variait de 0 à 4,96 mg/m3 (selon la concentration maximale de poussière observée pendant des événements sévères de haboob)34.
(4) Hypothèses d'indépendance : Nous avons supposé que les paramètres environnementaux étaient échantillonnés indépendamment, ce qui constitue une simplification des conditions réelles dans lesquelles les variables atmosphériques sont corrélées (par exemple, une forte concentration de poussière est souvent associée à une faible visibilité). Afin de fournir un environnement de simulation contrôlé permettant une comparaison méthodique des modèles, cette hypothèse d'indépendance a été adoptée 35. Les conséquences de ces présupposés sont abordées dans la Discussion.
(5) Fractionnement stratifié : Le fractionnement entre ensemble d'apprentissage et ensemble de test a été réalisé de manière stratifiée selon la catégorie de condition météorologique (ciel dégagé, brouillard, pluie, poussière, neige), afin de garantir que la proportion de chaque condition météorologique dans les ensembles d'apprentissage et de test corresponde à la distribution du jeu de données d'origine. Ainsi, l'ensemble de test n'est pas déséquilibré par rapport aux conditions météorologiques rares (notamment la neige à 2,87 %)36.
Reconnaissance de la génération déterministe de cibles
Il est important de souligner que la bonne performance prédictive observée ici peut être en partie attribuée au fait que le modèle apprend ou approche les équations physiques déterministes utilisées pour générer les valeurs cibles synthétiques37. Contrairement aux mesures expérimentales du monde réel, qui contiennent du bruit de mesure, des erreurs instrumentales et des phénomènes physiques non modélisés, le jeu de données synthétique offre une relation propre et sans bruit entre les caractéristiques d'entrée et la cible d'atténuation. Cela s'explique par le fait que les valeurs d'atténuation ont été calculées directement à partir des modèles physiques de propagation (loi de Beer-Lambert, modèle de Kim, modèle de Carbonneau et théorie de diffusion de Mie) en fonction des paramètres d'entrée. Par conséquent, les métriques de performance quantitatives (R2, RMSE, MAE) reflètent la performance sur des données synthétiques dérivées d'équations et ne doivent pas être interprétées comme une performance attendue sur des données observationnelles ou expérimentales bruitées. Les résultats doivent être considérés principalement comme une évaluation comparative de méthodologies de modélisation dans un environnement de simulation contrôlé38.
Jeu complet de caractéristiques pour l'apprentissage du modèle
L'ensemble de données d'entraînement comprenait 10 caractéristiques d'entrée pour l'entraînement du modèle :
1. Température (°C)
2. Humidité (%)
3. Visibilité (km)
4. Concentration de poussière (mg/m3)
5. Taux de précipitation (mm/h)
6. Taux de précipitation neigeuse (mm/h)
7. Vitesse du vent (m/s)
8. Pression atmosphérique (hPa)
9. Mois (numérique, 1–12)
10. Saison (codée en binaire : printemps, été, automne, hiver)
Précision importante : les conditions météorologiques (ciel dégagé, brouillard, pluie, poussière, neige) ont été utilisées comme variable catégorielle pour la stratification lors de la répartition du jeu de données et n'ont pas été incluses comme caractéristiques d'entrée pour aucun modèle. L'analyse SHAP inclut uniquement les 10 caractéristiques énumérées ci-dessus. La variable saison a été encodée en one-hot (4 catégories : printemps, été, automne, hiver), et pour l'analyse SHAP, les contributions des variables saison encodées en one-hot ont été additionnées selon les saisons afin de produire une seule valeur de contribution saisonnière. Cette valeur combinée représente la contribution totale de toutes les variables liées à la saison à la prédiction de l'atténuation. Avant de créer la figure récapitulative, les quatre colonnes saison encodées en one-hot ont été identifiées, et leurs valeurs SHAP ont été additionnées pour chaque échantillon. Cette méthode garantit que l'utilisation par le modèle de la saison comme variable catégorielle composite est cohérente avec l'analyse SHAP.
Les principaux facteurs environnementaux ayant directement affecté l'atténuation optique par des mécanismes physiques étaient les caractéristiques 1 à 6. L'ajout des caractéristiques 7 et 8 (vitesse du vent et pression) en tant que facteurs météorologiques supplémentaires pourrait avoir un impact indirect sur l'atténuation en influant sur la stabilité de l'air et la dispersion des aérosols. Afin de tenir compte des variations saisonnières des conditions atmosphériques, les caractéristiques 9 et 10 (mois et saison) ont été incluses comme descripteurs temporels. La valeur d'atténuation (dB/km) a été utilisée comme variable cible pour tous les modèles. Les statistiques clés du jeu de données comprenaient la température (28,55 °C ± 11,18 °C), l'humidité (42,01 % ± 25,56 %), la visibilité (13,10 ± 10,91 km ; plage : 0,05–29,99 km), la concentration en poussières (0,74 ± 1,30 mg/m3 ; maximum : 4,96 mg/m3), l'atténuation (4,80 ± 7,20 dB/km ; plage : 0,09–50,93 dB/km), la portée de fonctionnement (5,74 ± 1,97 km) et le rapport signal-sur-bruit (64,88 ± 15,07 dB). La portée de fonctionnement et le RSB ont été calculés à partir des valeurs d'atténuation à l'aide d'équations standard de bilan de liaison FSO.
Calcul de la plage de fonctionnement
La plage de fonctionnement (en km) a été calculée à l'aide de l'équation du bilan de liaison :
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
où : Prx = puissance reçue (réglée à la sensibilité minimale de −30 dBm) ; Ptx = puissance d'émission (fixée à 20 dBm) ; Gt = gain de l'émetteur (calculé à partir des dimensions de l'ouverture) ; Gr = gain du récepteur (calculé à partir des dimensions de l'ouverture) ; λ = longueur d'onde (1550 nm) ; R = portée en km ; A = atténuation atmosphérique en dB/km (calculée à partir des modèles physiques).
Gains de l'émetteur et du récepteur : Le gain de l'émetteur (Gt) a été calculé selon la formule suivante : Gt = 10×log₁₀[0.7×(π×0,025/1,55×10⁻6)2] ≈ 44,2 dBi. Le gain du récepteur (Gr) a été calculé selon la formule suivante : Gr = 10×log₁₀[0,7×(π×0,20/1,55×10⁻6)2] ≈ 62,3 dBi. L'ouverture d'émission avait un diamètre de 2,5 cm, avec une efficacité de 0,7. L'ouverture de réception avait un diamètre de 20 cm, avec une efficacité de 0,7. L'équation a été résolue de manière itérative pour R afin de déterminer la distance maximale atteignable pour chaque valeur d'atténuation.
Calcul du rapport signal sur bruit
Le RSB (rapport signal sur bruit) en dB a été calculé à l'aide de l'équation suivante :
SNR=Prx−10×log₁₀(kTB)−NF (7)
où : Prx = puissance reçue en dBm (calculée à partir du bilan de liaison) ; k = 1,38×10⁻23 J/K (constante de Boltzmann) ; T = 290 K (température du récepteur) ; B = 109 Hz (bande passante du récepteur, 1 GHz) ; NF = 3 dB (facteur de bruit du récepteur). Le plancher de bruit a été calculé comme suit :
10 × log10(kTB) ≈ −84 dBm (8)
Pour chaque échantillon, après avoir calculé l'atténuation A à l'aide du modèle physique approprié, la portée opérationnelle a été déterminée en résolvant le bilan de liaison pour R, et le RSB a été calculé à partir de la puissance reçue Prx résultante à cette distance.
Valeurs de la plage de fonctionnement selon les conditions météorologiques : La plage de fonctionnement variait selon les conditions météorologiques : ciel dégagé (7,12 ± 1,85 km), brouillard (5,81 ± 1,92 km), neige (5,42 ± 1,56 km), pluie (3,81 ± 0,98 km) et poussière (3,72 ± 1,08 km). Une marge de 3 dB n’a pas été appliquée dans les calculs actuels ; la plage de fonctionnement représente la portée théorique maximale sans marge système. La plage de fonctionnement indiquée (5,74 ± 1,97 km) correspond à la moyenne générale sur l’ensemble des conditions météorologiques39.
Distance de transmission fixe : La distance de transmission dans les modèles d'atténuation physique a été fixée à 3 km. Il s'agit de la distance de liaison pour laquelle les calculs d'atténuation ont été effectués. La portée de fonctionnement indiquée correspond à la distance maximale théorique calculée à l'aide de l'équation du bilan de liaison, qui peut différer de la distance de transmission fixe de 3 km. Les valeurs d'atténuation spécifiques aux conditions météorologiques ont été enregistrées pour des conditions claires (0,27±0,06 dB/km), le brouillard (1,88±1,92 dB/km), la neige (6,45±2,54 dB/km), la pluie (13,58±6,32 dB/km) et la poussière (13,10±7,32 dB/km). Toutes les valeurs quantitatives rapportées dans cet article sont exprimées sous la forme moyenne ± écart type (ET), sauf indication contraire40.
Le R2 de validation croisée pour la forêt aléatoire est de 0,960 ± 0,007. Dans certains cas, comme la température (−4,89 à 47,99 °C), la visibilité (0,05 à 29,99 km), la concentration de poussière (0 à 4,96 mg/m3) et l'atténuation (0,09 à 50,93 dB/km), l'intervalle (du plus bas au plus élevé) est indiqué par écrit. L'ensemble de données a été divisé en sous-groupes pour les tests (300 échantillons ; 20 %) et l'apprentissage (1 200 échantillons ; 80 %). Un échantillonnage aléatoire stratifié a été utilisé pour effectuer la répartition apprentissage-test. Afin de garantir que le pourcentage de chaque condition météorologique dans l'ensemble d'apprentissage (80 %) et l'ensemble de test (20 %) corresponde à la distribution de l'ensemble de données d'origine, une stratification a été appliquée selon la catégorie de condition météorologique (ciel dégagé, brouillard, pluie, poussière et neige). En particulier, 1 200 (80 %) des 1 500 échantillons ont été attribués à l'ensemble d'apprentissage et 300 (20 %) à l'ensemble de test. Les échantillons ont été choisis aléatoirement pour chaque catégorie de conditions météorologiques tout en conservant les proportions initiales : parmi les 814 échantillons de ciel dégagé (54,27 %), 651 ont été affectés à l'apprentissage et 163 aux tests ; parmi les 375 échantillons de poussière (25,00 %), 300 à l'apprentissage et 75 aux tests ; parmi les 157 échantillons de brouillard (10,47 %), 126 à l'apprentissage et 31 aux tests ; parmi les 111 échantillons de pluie (7,40 %), 89 à l'apprentissage et 22 aux tests ; parmi les 43 échantillons de neige (2,87 %), 34 à l'apprentissage et 9 aux tests. Un échantillonnage aléatoire au sein de chaque strate a été réalisé en utilisant une graine aléatoire de 42 afin d'assurer la reproductibilité. Cette approche stratifiée a été choisie pour éviter une représentation déséquilibrée des conditions météorologiques rares (notamment la neige à 2,87 %) dans l'ensemble de test, ce qui pourrait autrement conduire à une évaluation peu fiable des performances pour ces conditions.
Évaluation d'un modèle d'apprentissage automatique
Six méthodes d'apprentissage automatique ont été évaluées, notamment la régression par vecteurs de support (SVR) avec un noyau à fonction de base radiale (C = 100), les k-plus proches voisins (KNN ; k = 10, vote pondéré par la distance), la forêt aléatoire (RF ; 200 arbres, profondeur maximale = 20), l'extrême gradient boosting (XGBoost ; 200 estimateurs, profondeur maximale = 10, taux d'apprentissage = 0,1), la machine d'augmentation de gradient légère (LightGBM ; 200 estimateurs, profondeur maximale = 10, taux d'apprentissage = 0,1), ainsi que la régression linéaire de base. Pour tous les modèles d'apprentissage automatique et d'apprentissage profond, un réglage des hyperparamètres a été effectué pour les paramètres les plus critiques, tandis que les valeurs par défaut ont été conservées pour les paramètres non spécifiés. Pour les modèles d'apprentissage automatique, les paramètres suivants ont été explicitement ajustés à l'aide d'une recherche en grille avec une validation croisée en 5 parties sur l'ensemble d'entraînement : 1) Forêt aléatoire : nombre d'arbres (testés : 50, 100, 150, 200, 250) et profondeur maximale (testée : 10, 15, 20, 25, sans limite), les valeurs optimales retenues étant 200 arbres et une profondeur de 20. 2) XGBoost : nombre d'estimateurs (testés : 100, 150, 200, 250), profondeur maximale (testée : 6, 8, 10, 12) et taux d'apprentissage (testés : 0,05, 0,1, 0,2), les valeurs optimales étant 200 estimateurs, une profondeur de 10 et un taux d'apprentissage de 0,1. 3) LightGBM : les mêmes plages de réglage ont été utilisées, conduisant à 200 estimateurs, une profondeur de 10 et un taux d'apprentissage de 0,1. 4) SVR : le paramètre de régularisation C (testé : 1, 10, 50, 100) et le coefficient du noyau gamma (testé : « scale », « auto », 0,1, 0,01) ont été ajustés, avec des valeurs optimales de C = 100 et un noyau RBF. 5) KNN : le nombre de voisins k (testé : 3, 5, 7, 10, 15) a été ajusté, avec une valeur optimale de k = 10 et un vote pondéré par la distance activé.
Tous les autres paramètres pour ces modèles ont été conservés à leurs valeurs par défaut telles que définies dans scikit-learn (voir le Tableau des matériaux pour la version ; par exemple, forêt aléatoire : bootstrap=True, min_samples_split=2, min_samples_leaf=1 ; XGBoost : subsample=1,0, colsample_bytree=1,0, gamma=0). Pour les modèles d'apprentissage profond, l'architecture (nombre de couches et d'unités par couche) et le taux de dropout (20 %) ont été ajustés manuellement par expérimentation itérative sur l'ensemble de validation, tandis que l'optimiseur (Adam), le taux d'apprentissage initial (0,001), la patience du mécanisme d'arrêt précoce (20 époques) et les paramètres de réduction du taux d'apprentissage (facteur 0,5, patience 10) ont été fixés selon les pratiques courantes décrites dans la littérature et maintenus constants pour toutes les expériences d'apprentissage profond.
Sources de données climatiques
Les informations météorologiques historiques recueillies à partir de stations météorologiques irakiennes dans plusieurs localités (Bagdad, Bassorah, Mossoul et Ramadi) entre 2020 et 2024 ont été utilisées pour calculer les proportions des états météorologiques et les distributions des variables. Les données brutes ont été fournies par le ministère des Transports de l'Irak et par l'Organisation météorologique irakienne et de sismologie (IMOS). Les données comprenaient des relevés météorologiques quotidiens détaillant l'état atmosphérique prédominant chaque jour. Les variables spécifiques extraites de ces relevés comprenaient la température (minimum, maximum et moyenne journaliers), l'humidité relative, la visibilité, la quantité de précipitations et la survenue de tempêtes de poussière. Les données de l'IMOS sont partiellement accessibles via le portail de données ouvertes du gouvernement irakien (https://www.motrans.gov.iq/), bien que les enregistrements spécifiques utilisés dans cette étude ne soient pas archivés publiquement dans un dépôt centralisé. Un résumé des données climatiques utilisées pour déterminer les proportions des conditions météorologiques et les plages de paramètres est fourni dans Tableau 1.
Une validation croisée en cinq parties a été utilisée sur l'ensemble d'apprentissage (1 200 échantillons) pour ajuster les hyperparamètres et estimer les performances de tous les modèles d'apprentissage automatique. Toutes les variables d'entrée (température, humidité, visibilité, concentration de poussière, taux de précipitations, taux de neige, vitesse du vent, pression) ont été normalisées par standardisation (normalisation par score Z) : x_scaled = (x − μ)/σ, où μ et σ représentent respectivement la moyenne et l'écart-type de l'ensemble d'apprentissage. La standardisation a été effectuée au sein de chaque pli de validation croisée en utilisant uniquement les statistiques du pli d'apprentissage afin d'éviter toute fuite de données. Les modèles basés sur des arbres (forêts aléatoires, XGBoost, LightGBM) sont invariants à l'échelle, mais la même standardisation a été appliquée pour assurer une cohérence entre tous les modèles d'apprentissage automatique. Une normalisation min-max a été utilisée pour les modèles d'apprentissage profond : x_scaled = (x−x_min)/(x_max−x_min), qui ramène les caractéristiques à l'intervalle [0, 1] selon les valeurs minimales et maximales de l'ensemble d'apprentissage. Des entrées bornées permettent une convergence plus rapide des réseaux de neurones, ce qui explique ce choix. L'ensemble de test a été normalisé à l'aide des paramètres obtenus à partir de l'ensemble d'apprentissage, et n'a pas été utilisé pour la sélection du modèle ou l'ajustement des hyperparamètres.
Des métriques de performance complètes ont été enregistrées, incluant le coefficient de détermination du test (R2), l'erreur quadratique moyenne (RMSE), l'erreur absolue moyenne (MAE), le R2 de validation croisée et le temps d'entraînement. Les temps d'entraînement pour tous les modèles d'apprentissage automatique et d'apprentissage profond sont indiqués en secondes (s) pour les modèles plus rapides (régression linéaire, KNN, SVR, forêt aléatoire, XGBoost, LightGBM) et en minutes (min) pour les modèles plus lents (architectures d'apprentissage profond). Tous les modèles ont été entraînés dans le même environnement informatique afin d'assurer une comparaison équitable41.
Le temps d'entraînement a été mesuré à l'aide du module time de Python, c'est-à-dire le temps écoulé sur l'horloge réelle entre le début et la fin de la fonction d'ajustement du modèle, à l'exclusion du temps nécessaire au chargement et au prétraitement des données. Le temps d'entraînement d'un modèle d'apprentissage profond correspond au temps nécessaire pour effectuer toutes les époques jusqu'à l'arrêt précoce. Cela inclut la propagation avant, la propagation arrière et les vérifications de validation. Toutes les expériences ont été réalisées en veillant à ce que le système n'exécute aucun autre processus informatiquement intensif, afin d'obtenir des mesures de temps cohérentes. Les temps indiqués représentent la moyenne de 5 exécutions indépendantes (écarts types)42.
Évaluation du modèle d'apprentissage profond
Six architectures d'apprentissage profond ont été évaluées à l'aide d'une accélération GPU, notamment un perceptron multicouche (MLP ; 64-32-16), un réseau neuronal profond (DNN) avec normalisation par lot (128-64-32-16), un réseau de mémoire à long terme et à court terme (LSTM ; 64-32 unités, longueur de séquence = 10), un réseau neuronal convolutif unidimensionnel (1D-CNN), un modèle hybride CNN-LSTM et un réseau basé sur le mécanisme d'attention. Tous les modèles d'apprentissage profond ont été implémentés à l'aide de TensorFlow avec l'API Keras et exécutés avec accélération GPU (voir Tableau des Matériaux pour les versions du matériel et des logiciels). L'architecture 1D-CNN comprenait trois couches de convolution (64, 128 et 256 filtres, taille du noyau 3, activation ReLU, padding=’same’), deux couches MaxPooling1D (taille du regroupement 2), une couche GlobalAveragePooling1D, une couche Dense avec 128 unités et activation ReLU, une couche Dropout (0,2), et une couche de sortie Dense (1 unité, activation linéaire), totalisant environ 245 000 paramètres entraînables. L'architecture hybride CNN-LSTM acceptait des séquences d'entrée de 10 pas de temps avec 5 caractéristiques, en utilisant deux couches Conv1D (64 et 128 filtres, taille du noyau 3, ReLU, padding=’same’), une couche MaxPooling1D (taille du regroupement 2), deux couches LSTM (64 et 32 unités, return_sequences=False), des couches Dropout (0,2), une couche Dense (32 unités, ReLU) et une couche de sortie Dense (1 unité, activation linéaire), totalisant environ 198 000 paramètres entraînables. Le réseau basé sur l'attention utilisait un mécanisme d'attention multi-têtes avec 4 têtes (dimensions de clé et de valeur de 64), dans lequel l'entrée était projetée sur 64 dimensions, suivie d'une attention par produit scalaire normalisé (formule : Attention(Q, K, V) = softmax(QKT/√d_k)V), des connexions résiduelles, une normalisation de couche, un réseau feedforward (128→64 unités), un regroupement par moyenne globale, un Dropout (0,2), une couche Dense (32 unités, ReLU) et une couche de sortie Dense (1 unité, activation linéaire), totalisant environ 167 000 paramètres entraînables43.
Tous les modèles ont utilisé l'arrêt précoce (patience = 20), la réduction du taux d'apprentissage (facteur = 0,5, patience = 10), le dropout (20 %) et l'optimiseur Adam (taux d'apprentissage = 0,001). Pour tous les modèles d'apprentissage profond, la taille du lot a été fixée à 32 échantillons, le nombre maximal d'époques d'entraînement était de 200 avec arrêt précoce (patience = 20, restauration des meilleurs poids), et la fonction de perte utilisée était l'erreur quadratique moyenne (MSE). La répartition entre ensemble d'entraînement et de validation était la suivante : à partir des 1 200 échantillons d'entraînement initiaux (après la répartition 80/20 entraînement-test), 80 % (960 échantillons) ont été utilisés pour l'entraînement et 20 % (240 échantillons) pour la validation. Nous avons stratifié la répartition entraînement-validation selon les conditions météorologiques afin de préserver la distribution. L'ensemble de validation a été utilisé uniquement pour l'arrêt précoce, la décroissance du taux d'apprentissage et la surveillance du surajustement ; il n'a jamais été utilisé pour la sélection du modèle ou l'ajustement des hyperparamètres au-delà de ces procédures automatisées. Nous n'avons pas réservé un ensemble de validation distinct pour les modèles d'apprentissage automatique ; à la place, nous avons utilisé une validation croisée en cinq parties sur les 1 200 échantillons d'entraînement pour ajuster les hyperparamètres et estimer les performances44.
Justification de l'évaluation des architectures LSTM et CNN-LSTM
L'ensemble de données principal se compose d'échantillons météorologiques générés indépendamment, mais nous avons également testé les architectures LSTM et CNN–LSTM pour les raisons suivantes : (1) les conditions atmosphériques réelles présentent une autocorrélation temporelle, et tester des modèles basés sur des séquences nous permet de déterminer si la prise en compte de ces dépendances pourrait améliorer la précision des prévisions ; (2) des recherches récentes en prévision atmosphérique ont démontré l'intérêt potentiel des architectures séquentielles pour modéliser l'évolution temporelle des paramètres météorologiques34 ; (3) tester une gamme diversifiée d'architectures garantit une comparaison exhaustive des approches méthodologiques, ce qui constitue une contribution essentielle de cette étude ; et (4) l'architecture hybride CNN–LSTM combine l'extraction de caractéristiques spatiales avec la modélisation temporelle, ce qui pourrait être avantageux pour capturer les interactions complexes entre plusieurs variables atmosphériques45.
Formatage des données pour l'entrée du modèle séquentiel
Pour les architectures séquentielles (LSTM et CNN–LSTM), les données d'entrée ont été restructurées à partir d'échantillons indépendants en pseudo-séquences à l'aide d'une approche par fenêtre glissante. En particulier, les 1 200 échantillons d'apprentissage ont d'abord été regroupés par catégories de conditions météorologiques afin de préserver la cohérence physique. Au sein de chaque catégorie météorologique, les échantillons ont été ordonnés selon leurs horodatages générés (observations simulées horaires pour l'année civile 2024). Ensuite, une fenêtre glissante de longueur 10 a été appliquée pour produire des séquences d'entrée composées de 10 pas de temps consécutifs (chacun comportant 5 caractéristiques : température, humidité, visibilité, concentration de poussière et taux de précipitation) afin de prédire l'atténuation au 11e pas de temps. Cette méthode préserve l'ordre temporel des observations simulées, tout en permettant aux modèles séquentiels d'apprendre les dépendances temporelles. La structure du jeu de test était identique, à l'exception de la même taille de fenêtre et du même ensemble de caractéristiques. Nous reconnaissons que cette structuration pseudo-séquentielle constitue une simplification méthodologique et ne reflète pas les dynamiques temporelles du monde réel. Nous avons indiqué cette limitation dans la section Discussion.
Évaluation des approches hybrides
Trois approches hybrides ont été examinées. La première approche était un modèle de vote combiné qui moyennait les prédictions issues des modèles Forêt aléatoire, XGBoost et Réseau neuronal profond en utilisant des poids égaux (chaque modèle se voyant attribuer un poids de 1/3), la prédiction finale étant calculée selon l'expression suivante :
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
Un poids égal a été choisi afin d'éviter l'introduction de paramètres supplémentaires et d'évaluer les performances de base de l'ensemble sans biais en faveur d'un modèle individuel. La deuxième approche utilisait un empilement avec un méta-apprenant Ridge. Les apprenants de base étaient la forêt aléatoire, XGBoost et un réseau neuronal profond (basé sur l'attention). La procédure d'empilement comprenait deux étapes : premièrement, chaque apprenant de base était entraîné sur l'ensemble d'entraînement complet de 1 200 échantillons à l'aide d'une validation croisée en 5 parties pour générer des prédictions hors pli, créant ainsi une nouvelle matrice de méta-caractéristiques de taille 1 200×3 (une prédiction par modèle de base et par échantillon). Deuxièmement, un méta-apprenant de régression Ridge (paramètre de régularisation L2 alpha=1,0) était entraîné sur ces méta-caractéristiques, en utilisant les valeurs d'atténuation initiales comme cible, afin d'apprendre les poids de combinaison optimaux pour les apprenants de base. La prédiction finale par empilement était la suivante :
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
où les poids w ont été appris par l'algorithmes méta d'apprentissage de type Ridge. La troisième approche était un réseau de neurones informé par la physique, qui combinait 70 % des prédictions du réseau de neurones avec 30 % des prédictions du modèle de Kim pour les échantillons en conditions de brouillard. La combinaison était réalisée par une moyenne pondérée fixe à l'aide de la formule suivante :
ŷhybrid=0,7×ŷneural+0,3×ŷKim (11)
où ŷneural est la sortie du réseau de neurones basé sur l'attention, et ŷKim est l'atténuation calculée à partir du modèle de brouillard de Kim en fonction de l'entrée de visibilité. Pour les échantillons sans brouillard, la composante physique était fixée à 0, et le modèle était exécuté comme un réseau de neurones pur. Les poids (70 % neuronal et 30 % physique) ont été fixés sur la base d'expérimentations préliminaires sur l'ensemble de validation (et non sur l'ensemble de test), au cours desquelles nous avons testé les combinaisons de poids suivantes : 90:10, 80:20, 70:30, 60:40 et 50:50. La répartition 70/30 a été retenue car elle offrait le meilleur R2 sur l'ensemble de validation tout en conservant une contrainte physique suffisante issue du modèle de Kim pour régulariser les prédictions et éviter des sorties physiquement irréalistes, en particulier dans les conditions de brouillard où le modèle de Kim fournit des bornes théoriques d'atténuation bien établies.
Analyse de l'importance et de l'interprétabilité des caractéristiques
Le modèle de forêt aléatoire avec l'importance des caractéristiques basée sur l'impureté (réduction de la variance) a été utilisé pour extraire les classements d'importance des 10 caractéristiques d'entrée. L'analyse a montré que la concentration de poussière (67,3 %) et la visibilité (21,2 %) étaient les prédicteurs les plus importants, expliquant ensemble 88,5 % de l'importance prédictive totale. La troisième caractéristique la plus importante était l'intensité des précipitations (6,0 %), suivie de la vitesse du vent (2,1 %), de la température (1,5 %), de l'humidité (0,9 %), du mois (0,5 %), de la saison (0,3 %), de l'intensité de chute de neige (0,1 %) et de la pression atmosphérique (0,1 %). Les faibles scores d'importance pour les caractéristiques temporelles (mois et saison) indiquent que la variation saisonnière de l'atténuation atmosphérique est principalement captée par des paramètres environnementaux sous-jacents plutôt que par des motifs basés uniquement sur le temps.
Une analyse SHAP (Shapley Additive exPlanations) a été réalisée afin d'évaluer les relations entre les facteurs environnementaux et l'atténuation. L'implémentation SHAP utilisée était le module TreeExplainer de la bibliothèque SHAP, spécifiquement optimisé pour les modèles basés sur des arbres, notamment Random Forest, XGBoost et LightGBM (voir le Tableau des matériaux pour la version). La configuration de l'analyse SHAP était la suivante : le modèle Random Forest entraîné a été transmis à TreeExplainer, qui a calculé les valeurs SHAP selon l'approche d'attribution de caractéristiques interventionnelle (marginale), fondée sur l'espérance conditionnelle de la sortie du modèle. Les valeurs SHAP ont été calculées pour les 300 échantillons de l'ensemble de test, produisant une matrice de dimensions 300 × 10 (une valeur SHAP par caractéristique et par échantillon). Pour chaque caractéristique, la valeur SHAP représentait sa contribution à la prédiction par rapport à la référence (la prédiction moyenne du modèle). Des valeurs SHAP négatives indiquaient une diminution de la prédiction, tandis que des valeurs SHAP positives montraient que la caractéristique augmentait la prédiction d'atténuation. L'importance de la contribution était indiquée par l'amplitude de la valeur SHAP. La distribution des valeurs SHAP pour chaque caractéristique (à l'aide de diagrammes en nuage d'abeilles), le sens de l'influence (la corrélation entre les valeurs des caractéristiques et les valeurs SHAP) ainsi que les classements d'importance des caractéristiques ont tous été visualisés à l'aide de graphiques récapitulatifs. Les fonctions de tracé intégrées à la bibliothèque SHAP — shap.summary_plot() pour le diagramme en nuage d'abeilles et shap.bar_plot() pour l'importance globale des caractéristiques — ont été utilisées pour produire toutes les visualisations SHAP.
Traitement des variables encodées en binaire : Quatre colonnes binaires (printemps, été, automne et hiver) ont d'abord été utilisées pour encoder la variable « saison ». Afin de créer une seule valeur de contribution « saison » par échantillon pour l'analyse SHAP, les contributions de ces quatre variables encodées en binaire ont été combinées en additionnant les valeurs SHAP pour chaque catégorie de saison. Pour réaliser ce regroupement, toutes les colonnes correspondant aux groupes de saisons encodées en binaire ont été identifiées, leurs valeurs SHAP ont été extraites pour chaque échantillon, puis additionnées élément par élément. Les valeurs SHAP combinées résultantes représentent la contribution globale de la saison à la prédiction d'atténuation. Cette méthode permet d'obtenir une seule ligne « saison » dans le graphique récapitulatif SHAP et garantit la cohérence avec l'utilisation de la saison par le modèle comme variable catégorielle composite. Étant donné que la valeur combinée offre une représentation plus compréhensible de la contribution totale de la saison, les valeurs SHAP de la saison n'ont pas été affichées séparément pour chaque catégorie de saison.
Résultats
Les caractéristiques du jeu de données synthétique sont résumées dans la Figure 1A–F. Le jeu de données comprenait des conditions de ciel clair, de poussière, de brouillard, de pluie et de neige (Figure 1A), avec des échantillons répartis entre les saisons chaudes et sèches et les saisons fraîches et humides (Figure 1B) ainsi que entre les périodes diurnes et nocturnes (Figure 1C). Les distributions de la température, de l'humidité et de la visibilité dans différentes conditions météorologiques sont présentées dans la Figure 1D–F.
Les modèles d'apprentissage automatique ont démontré une forte performance prédictive pour l'estimation de l'atténuation atmosphérique (Figure 2A–D ; Tableau 3). La forêt aléatoire (RF) a obtenu la meilleure performance globale parmi les modèles évalués, avec un R2 sur l'ensemble de test de 0,9654 et un RMSE de 1,324 dB/km (Figure 2A ; Tableau 3). La RF a expliqué 96,54 % de la variation observée tout en maintenant une erreur de prédiction inférieure à 1,5 dB/km. XGBoost a également bien performé (Figure 2C), suivi par LightGBM (Figure 2B). La robustesse des modèles a été confirmée par une validation croisée en cinq parties, la RF obtenant un R2 de validation croisée de 0,960 ± 0,007 (Figure 2D). En revanche, le classificateur des k plus proches voisins a montré des signes de surapprentissage, avec un R2 d'apprentissage de 1,000 et un R2 de test de 0,7341, tandis que la régression linéaire a atteint une performance prédictive modérée (Figure 2A ; Tableau 3).
L'analyse de l'importance des caractéristiques concernant les 10 caractéristiques d'entrée mentionnées ci-dessus est présentée dans la Figure 3A. Les scores d'importance relative sont classés comme suit : concentration en poussière (67,3 %), visibilité (21,2 %), intensité des précipitations (6,0 %), vitesse du vent (2,1 %), température (1,5 %), humidité (0,9 %), mois (0,5 %), saison (0,3 %), intensité des chutes de neige (0,1 %) et pression (0,1 %). La variable « condition météorologique » est utilisée pour la stratification du jeu de données, mais n'est pas incluse dans l'analyse de l'importance des caractéristiques, car il s'agit d'une variable composite catégorielle représentant plusieurs paramètres physiques sous-jacents, dont l'effet est capturé par les caractéristiques environnementales individuelles. Les analyses d'importance et d'interprétabilité des caractéristiques ont identifié les variables environnementales les plus fortement associées à l'atténuation (Figure 3A,B). La concentration en poussière (67,3 %), la visibilité (21,2 %) et l'intensité des précipitations (6,0 %) représentaient ensemble 94,4 % de l'importance prédictive totale (Figure 3A). L'analyse SHAP a en outre montré que l'augmentation de la concentration en poussière et la diminution de la visibilité étaient associées à une augmentation des prédictions d'atténuation (Figure 3B).
Les modèles d'apprentissage profond ont présenté une performance prédictive inférieure à celle des approches d'apprentissage automatique (Figure 4A–D). Le modèle d'apprentissage profond le plus performant, le réseau basé sur l'attention, a atteint un R2 de 0,7766 et un RMSE de 3,362 dB/km (Figure 4A). Les architectures récurrentes ont montré une performance particulièrement faible, les modèles LSTM et CNN–LSTM produisant des valeurs de R2 proches de zéro et des valeurs de RMSE supérieures à 7,19 dB/km (Figure 4B). La performance relativement médiocre des architectures LSTM et CNN-LSTM (R2 = 0,0110 et 0,0109, respectivement ; RMSE = 7,193 dB/km et 7,196 dB/km) peut être partiellement expliquée par la nature pseudo-séquentielle des données d'entrée, qui ne capture pas pleinement les dynamiques temporelles réelles des conditions atmosphériques.
Contrairement aux applications en série temporelle réelle, où les dépendances séquentielles sont fortes et bien définies, notre jeu de données se composait principalement d'échantillons indépendants avec un ordre temporel artificiellement imposé. La faible performance prédictive de ces architectures suggère que l'information temporelle extraite par l'approche à fenêtre glissante était soit insuffisante, soit non représentative de l'évolution atmosphérique réelle (Figure 4C). Cela confirme notre conclusion selon laquelle, pour les jeux de données de cette nature, des approches d'apprentissage automatique plus simples sont plus adaptées que des modèles complexes d'apprentissage profond basés sur des séquences. La performance de validation de toutes les architectures d'apprentissage profond est résumée dans la Figure 4D.
Les performances des approches d'apprentissage automatique, d'apprentissage profond et hybrides sont résumées dans la Figure 5A,B et le Tableau 3. Parmi les méthodes hybrides, l'ensemble de vote a atteint un R2 de 0,9340 et un RMSE de 1,827 dB/km (Figure 5A,B ; Tableau 3). L'empilement avec méta-apprenant Ridge a obtenu un R2 de 0,9571 et un RMSE de 1,473 dB/km (Figure 5A,B ; Tableau 3), se rapprochant des performances du forêt aléatoire (RF) mais nécessitant des temps d'entraînement nettement plus longs. Le réseau de neurones informé par la physique a atteint un R2 = 0,8269 et un RMSE = 2,960 dB/km (Figure 5A,B ; Tableau 3) et a performé mieux que les modèles d'apprentissage profond, mais moins bien que les meilleures approches d'apprentissage automatique. Une comparaison statistique entre les modèles RF et l'ensemble empilé a indiqué aucune différence significative en termes de performance prédictive (Tableau 3 ; test t apparié : t = −1,74, p = 0,083). Par conséquent, bien que RF ait obtenu la valeur numérique la plus élevée de R2, la différence par rapport à la meilleure approche hybride n'était pas statistiquement significative.
Dans l'ensemble, les résultats soutiennent l'hypothèse selon laquelle les approches d'apprentissage automatique peuvent prédire avec précision l'atténuation atmosphérique dans les conditions météorologiques irakiennes. La forêt aléatoire (RF) a systématiquement obtenu les performances prédictives les plus élevées (Figure 2A,B ; Tableau 3), tandis que les analyses d'importance des caractéristiques et de SHAP ont identifié la concentration de poussière et la visibilité comme les facteurs environnementaux dominants influençant l'atténuation (Figure 3A,B).
Déclaration relative aux données de validation : Toutes les évaluations du modèle ont été effectuées sur le jeu de données synthétiques décrit dans la section Méthodes. Aucune donnée expérimentale ou observationnelle sur l'atténuation atmosphérique n'a été utilisée pour la validation du modèle. Le jeu de données synthétiques a été créé à l'aide de modèles physiques de propagation bien établis (loi de Beer-Lambert, modèle de Kim, modèle de Carbonneau et théorie de diffusion de Mie), avec des paramètres météorologiques choisis à partir de distributions de probabilité basées sur des relevés climatiques irakiens. Comme indiqué dans la section Méthodes, les performances prédictives élevées pourraient refléter en partie l'apprentissage du modèle ou son approximation des équations physiques déterministes utilisées pour générer les valeurs cibles. Par conséquent, les métriques de performance quantitatives (R2, RMSE, MAE) représentent la performance sur des données synthétiques dérivées d'équations et doivent être interprétées comme des comparaisons relatives entre méthodologies de modélisation dans un environnement de simulation contrôlé, et non comme des garanties absolues de performance pour des systèmes FSO opérationnels. Cette approche permet un environnement contrôlé pour l'évaluation comparative des méthodologies de modélisation prédictive (énumérées dans Tableau 2), mais ne remplace pas la validation à l'aide de mesures réelles d'atténuation FSO dans des conditions météorologiques irakiennes réelles.
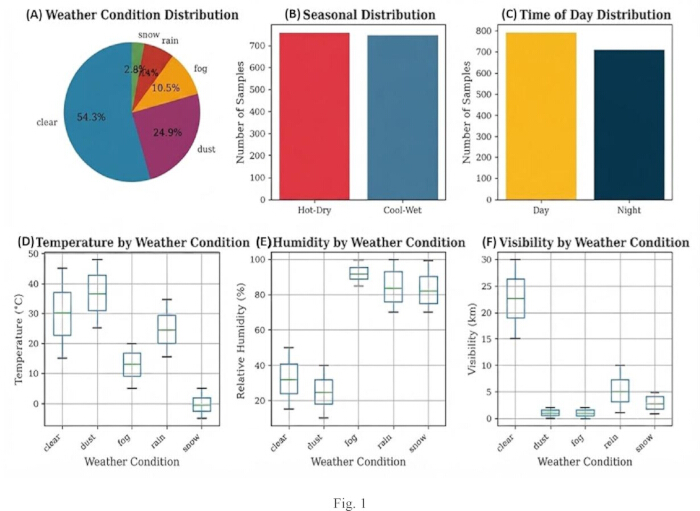
Figure 1 : Caractéristiques du jeu de données synthétiques et des variables environnementales utilisées pour la modélisation de l'atténuation atmosphérique. (A) Répartition des conditions météorologiques représentées dans le jeu de données, incluant des situations de ciel clair, de poussière, de brouillard, de pluie et de neige. (B) Répartition saisonnière des échantillons entre les périodes chaudes-sèches et fraîches-humides. (C) Répartition des échantillons collectés en conditions diurnes et nocturnes. (D) Répartitions de température pour chaque condition météorologique. (E) Répartitions d'humidité pour chaque condition météorologique. (F) Répartitions de visibilité pour chaque condition météorologique. Les boîtes à moustaches indiquent la médiane (ligne centrale), l'intervalle interquartile (boîte) et les valeurs minimale et maximale (moustaches). La température est exprimée en °C, l'humidité en % et la visibilité en km. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
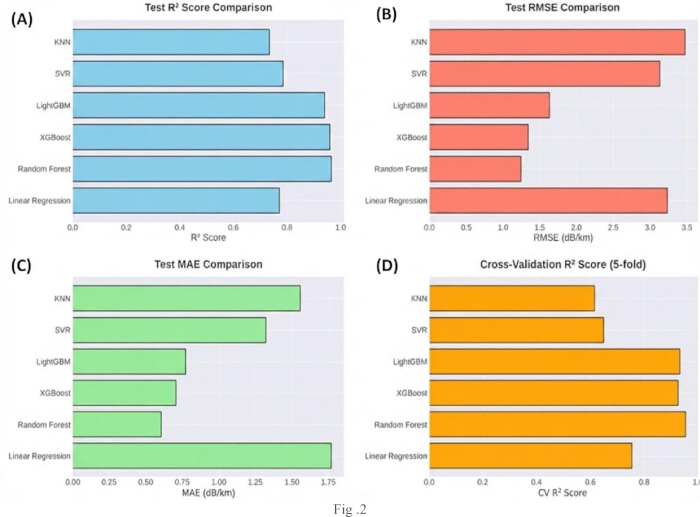
Figure 2 : Comparaison des performances des modèles d'apprentissage automatique pour la prédiction de l'atténuation atmosphérique. (A) Scores du coefficient de détermination (R2) sur l'ensemble de test pour les modèles d'apprentissage automatique évalués, incluant la régression linéaire, la forêt aléatoire, le boosting extrême par gradients (XGBoost), la machine à boosting par gradients léger (LightGBM), la régression par vecteurs de support (SVR) et les k-plus-proches voisins (KNN). (B) Valeurs de l'erreur quadratique moyenne (RMSE) sur l'ensemble de test pour chaque modèle d'apprentissage automatique. (C) Valeurs de l'erreur absolue moyenne (MAE) sur l'ensemble de test pour chaque modèle d'apprentissage automatique. (D) Scores du coefficient de détermination (R2) obtenus par validation croisée à cinq plis. Des valeurs R2 plus élevées et des valeurs RMSE et MAE plus faibles indiquent une meilleure performance prédictive. Les RMSE et MAE sont exprimées en dB/km. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
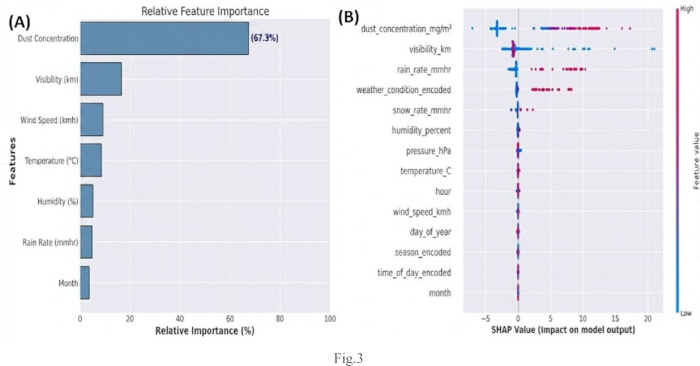
Figure 3 : Analyse de l'importance des caractéristiques et de l'interprétabilité du modèle pour la prédiction de l'atténuation atmosphérique. (A) Classement relatif de l'importance des caractéristiques basé sur l'impureté, issu du modèle Random Forest, montrant la contribution des 10 variables environnementales et temporelles à la prédiction de l'atténuation. La caractéristique la plus influente était la concentration de poussière (67,3 %), suivie par la visibilité (21,2 %), l'intensité des précipitations (6,0 %), la vitesse du vent (2,1 %), la température (1,5 %), l'humidité (0,9 %), le mois (0,5 %), la saison (0,3 %), l'intensité des chutes de neige (0,1 %) et la pression atmosphérique (0,1 %). L'importance relative correspond à un pourcentage de l'importance totale du modèle. (B) Graphique récapitulatif des explications additives de SHapley (SHAP) illustrant l'impact des caractéristiques individuelles sur les prédictions du modèle. La matrice SHAP a été calculée pour 300 échantillons du jeu de test (300 × 10 caractéristiques). Pour la variable « saison » encodée en one-hot (initialement quatre colonnes binaires : printemps, été, automne, hiver), les valeurs SHAP ont été combinées en sommant les quatre catégories afin d'obtenir une seule valeur de contribution « saison » par échantillon. Chaque point représente un échantillon, et l'échelle de couleurs indique la valeur de la caractéristique, allant des faibles valeurs (bleu) aux fortes valeurs (rouge). Des valeurs SHAP positives indiquent une augmentation de l'atténuation prédite, tandis que des valeurs SHAP négatives indiquent une diminution de l'atténuation prédite. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
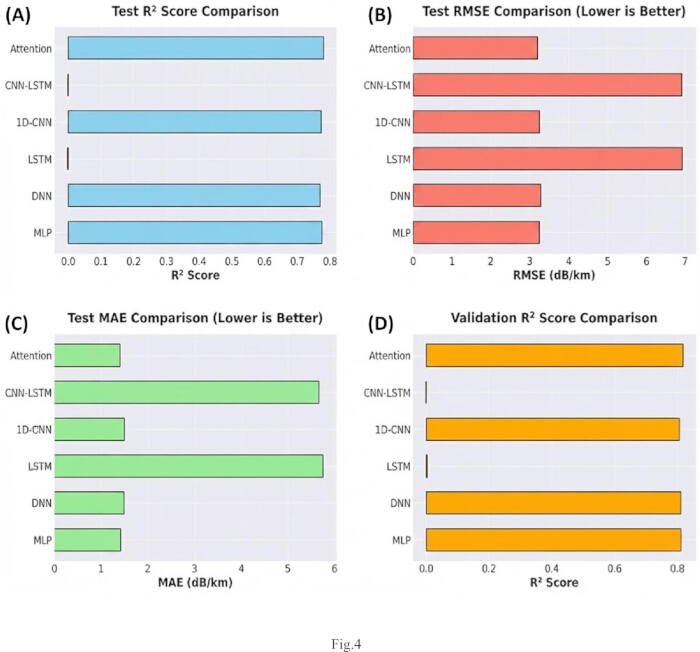
Figure 4: Comparaison des performances de modèles d'apprentissage profond pour la prédiction de l'atténuation atmosphérique. (A) Tester le coefficient de détermination (R2) scores pour les architectures d'apprentissage profond évaluées, incluant le perceptron multicouche (MLP), le réseau neuronal profond (DNN), la mémoire à long court terme (LSTM), le réseau neuronal convolutif unidimensionnel (1D-CNN), le réseau neuronal convolutif–mémoire à long court terme (CNN–LSTM) et les modèles fondés sur l'attention.B) Valeurs de l'erreur quadratique moyenne (RMSE) pour chaque modèle d'apprentissage profond.C) Valeurs de l'erreur absolue moyenne (MAE) sur l'ensemble de test pour chaque modèle d'apprentissage profond. (D) Coefficient de détermination sur l'ensemble de validation (R2) pour les modèles d'apprentissage profond évalués. Des R plus élevés2 des valeurs plus faibles de RMSE et de MAE indiquent une performance prédictive améliorée. Le RMSE et le MAE sont exprimés en dB/km. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
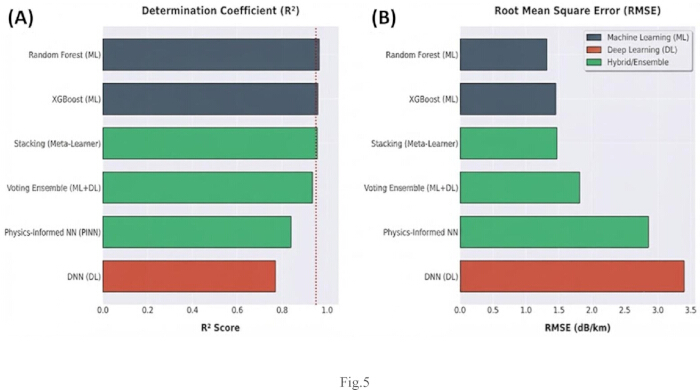
Figure 5 : Performances comparées des modèles d'apprentissage automatique, d'apprentissage profond et hybrides pour la prédiction de l'atténuation atmosphérique. (A) Valeurs du coefficient de détermination (R2) pour des approches représentatives d'apprentissage automatique, d'apprentissage profond et hybrides, incluant la forêt aléatoire, le boosting extrême de gradient (XGBoost), le réseau neuronal profond (DNN), l'ensemble par vote, le stacking et les réseaux neuronaux informés par la physique. (B) Valeurs de l'erreur quadratique moyenne (RMSE) pour les mêmes modèles. Les modèles sont codés par couleur selon trois catégories : apprentissage automatique (ML), apprentissage profond (DL) et techniques hybrides/ensemble. Des valeurs plus élevées de R2 et des valeurs plus faibles de RMSE indiquent une meilleure performance prédictive. La RMSE est exprimée en dB/km. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Condition météorologique | Proportion | Plage de température | Plage d'humidité | Plage de visibilité | Plage du paramètre principal |
| Ciel dégagé | 54,27 % (814 échantillons) | −4,89 à 47,99 °C | 0–100 % | >10 km | — |
| Poussière | 25,00 % (375 échantillons) | 10–45 °C | 10–60 % | 0,05–5 km | Poussière : 0–4,96 mg/m3 |
| Brouillard | 10,47 % (157 échantillons) | −5 à 20 °C | 70–100 % | 0,05–1 km | — |
| Pluie | 7,40 % (111 échantillons) | 5–30 °C | 60–100 % | 1–10 km | Pluie : 0,25–50 mm/h |
| Neige | 2,87 % (43 échantillons) | −10 à 5 °C | 50–100 % | 0,5–5 km | Neige : 0,5–15 mm/h |
Tableau 1 : Mesures de performance des modèles d'apprentissage automatique pour prédire l'atténuation atmosphérique.
| Modèle | R2 du test | RMSE (dB/km) | MAE (dB/km) | R2 de la CV | Temps d'entraînement (s) |
| Forêt aléatoire | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| Régression vectorielle de support (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| Régression linéaire | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| Plus proches voisins (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
Tableau 2 : Évaluation comparative de modèles spécifiques d'apprentissage profond, hybrides et d'apprentissage automatique.
| Modèle | Catégorie | R2 du test | RMSE (dB/km) | Rang |
| Forêt aléatoire | ML | 0,9654 | 1,324 | 1 |
| XGBoost | ML | 0,9582 | 1,455 | 2 |
| Ensemble par empilement | Hybride | 0,9571 | 1,473 | 3 |
| LightGBM | ML | 0,9507 | 1,581 | 4 |
| Ensemble par vote | Hybride | 0,934 | 1,827 | 5 |
| Réseau de neurones informé par la physique | Hybride | 0,8269 | 2,96 | 6 |
| Attention | DL | 0,7766 | 3,362 | 7 |
| LSTM / CNN–LSTM | DL | −0,0006 | 7,195 | — |
Tableau 3 : Comparaison de l'efficacité de chaque modèle évalué en matière de calcul (apprentissage et inférence).
DISPONIBILITÉ DES DONNÉES :
L'ensemble de données synthétiques complet, composé de 1 500 échantillons avec toutes les variables d'entrée (température, humidité, visibilité, concentration de poussière, taux de précipitations, taux de chute de neige, vitesse du vent, pression atmosphérique, mois, saison et conditions météorologiques) et la variable cible (atténuation en dB/km), est fourni en fichier supplémentaire accompagnant cet article à l'adresse https://doi.org/10.5281/zenodo.21792999. L'ensemble de données est formaté de manière à ce que chaque échantillon corresponde à une ligne, incluant toutes les variables calculées (plage de fonctionnement et rapport signal sur bruit).
Le code complet de mise en œuvre, incluant : les scripts de génération des données (implémentations des modèles physiques) ; les fonctions de prétraitement et de mise à l'échelle des caractéristiques ; toutes les implémentations des modèles d'apprentissage automatique ; toutes les implémentations de modèles d'apprentissage profond ; les scripts d'évaluation et de visualisation ; ainsi que les procédures de réglage des hyperparamètres et de validation croisée, doit également être fourni en tant que fichier supplémentaire.
Données climatiques sources : Les données climatiques utilisées pour définir les distributions de données synthétiques ont été obtenues auprès de l'Organisation irakienne de météorologie et de sismologie (IMOS) et du ministère irakien des Transports, couvrant la période 2020–2024. Un résumé des données climatiques utilisées pour déterminer les proportions des conditions météorologiques et les plages de paramètres est fourni dans le tableau supplémentaire 1. Les enregistrements IMOS spécifiques utilisés dans cette étude ne sont pas archivés publiquement dans un dépôt centralisé, mais peuvent être demandés directement à l'IMOS. Les statistiques descriptives et les distributions de probabilité dérivées sont fournies dans les documents supplémentaires afin de permettre la reproductibilité.
Informations sur le dépôt : Le code source et le jeu de données sont déposés dans un dépôt public (Zenodo) à l'adresse https://doi.org/10.5281/zenodo.21792999.
Discussion
Afin de prévoir l'atténuation atmosphérique dans les systèmes de communication en optique libre (FSO) fonctionnant dans des conditions météorologiques irakiennes, la présente étude a évalué des techniques d'apprentissage automatique, d'apprentissage profond et des méthodes hybrides. Étant donné que les effets atmosphériques restent l'un des principaux facteurs affectant la performance et la disponibilité des liaisons, des évaluations récentes ont souligné l'importance croissante de la modélisation prédictive pour les systèmes FSO21. Les résultats ont montré que les approches classiques d'apprentissage automatique, en particulier les forêts aléatoires (RF) et XGBoost, offraient une grande précision prédictive et, dans certains cas, surpassaient numériquement les méthodes d'apprentissage profond et hybrides. Toutefois, les tests statistiques n'ont pas révélé de différence significative (p = 0,083) entre la RF et le meilleur modèle hybride ensembliste (Stacking), ce qui signifie que les deux approches peuvent atteindre des résultats similaires sur ce jeu de données. Nos résultats indiquent que les méthodes ensemblistes basées sur des arbres restent très performantes pour des données environnementales tabulaires comportant des tailles d'échantillons modérées et un petit nombre de variables prédictives dominantes. L'analyse de l'importance des variables a révélé que la concentration en poussière et la visibilité étaient les principaux facteurs responsables de l'atténuation, expliquant conjointement la majeure partie de la puissance prédictive. Cette observation est conforme à des études antérieures mettant en évidence l'influence importante du brouillard, des poussières, des aérosols et de la pollution atmosphérique sur la propagation du signal optique22,23,24,25. Des conclusions similaires ont été rapportées dans des applications de surveillance environnementale, où les modèles d'apprentissage automatique tirent souvent profit de jeux de données comprenant un petit nombre de variables hautement informatives26,27,28,29,30,31,32. L'analyse SHAP a en outre amélioré l'interprétabilité du modèle en quantifiant l'influence des paramètres environnementaux individuels sur les prévisions d'atténuation.
Les performances inférieures des modèles d'apprentissage profond peuvent être attribuées à plusieurs facteurs. La taille du jeu de données était relativement modeste pour l'entraînement d'architectures neuronales complexes (dans https://doi.org/10.5281/zenodo.21792999), et les variables environnementales présentaient une importance des caractéristiques fortement concentrée. Des études antérieures ont montré que les méthodes d'apprentissage profond bénéficient généralement de grands ensembles de données, de structures hiérarchiques de caractéristiques et de représentations non linéaires complexes33,34,35,36,37. En revanche, le jeu de données d'atténuation utilisé dans cette étude contenait un nombre limité de prédicteurs dominants et ne possédait pas les dépendances temporelles nécessaires aux architectures récurrentes. Les faibles performances des modèles LSTM et CNN–LSTM suggèrent que les mécanismes d'apprentissage séquentiel pourraient ne pas apporter d'avantages substantiels dans cette application.
La prédominance de la concentration en poussière (67,3 %) et de la visibilité (21,2 %) en tant que prédicteurs de l'atténuation atmosphérique peut s'expliquer par plusieurs facteurs. Premièrement, la diffusion moléculaire et l'absorption à 1550 nm sont dominées par la diffusion de Mie due aux particules de poussière. Selon la théorie de Mie, l'efficacité d'extinction Q_ext est très sensible à la concentration des particules, et l'atténuation évolue presque linéairement avec la concentration en poussière dans le régime de concentration modérée à élevée. Deuxièmement, l'Irak est sujet à des tempêtes de poussière fréquentes (25,00 % des jours dans nos données climatiques), entraînant des valeurs d'atténuation comprises entre 4 et 30 dB/km. Ceci contraste avec le brouillard (10,47 %, 0,5–10 dB/km) et la pluie (7,40 %, 2–25 dB/km). La plus grande variabilité de l'atténuation par poussière produit des signaux plus marqués, que les modèles peuvent mieux apprendre. Troisièmement, la distribution exponentielle de la concentration en poussière (0,4–4,96 mg/m3) engendre une large gamme de valeurs d'atténuation. La queue longue associée aux événements de poussière extrêmes produit des valeurs élevées d'atténuation, cruciales pour une prédiction précise. Quatrièmement, le modèle de diffusion de Mie présente une dépendance plus simple (approximativement linéaire) par rapport à la concentration en poussière, ce qui est plus facile à approcher pour des modèles basés sur des arbres, comparé à la relation plus complexe entre la visibilité et l'atténuation par brouillard dans le modèle de Kim. Cinquièmement, cette découverte revêt une importance pratique, car les tempêtes de poussière constituent l'une des conditions environnementales les plus difficiles pour les communications par faisceau optique (FSO) au Moyen-Orient. Une prédiction précise pendant les épisodes de poussière est essentielle au fonctionnement fiable du système.
Ces résultats font progresser la recherche en communication par FSO en fournissant des orientations pratiques pour le choix d'algorithmes permettant de prédire l'atténuation atmosphérique. Une prévision précise de l'atténuation est essentielle pour la planification des réseaux, la gestion adaptative des liaisons et le déploiement fiable des systèmes de communication optique dans des environnements difficiles tels que le Moyen-Orient23,28,30,36. De plus, la méthodologie pourrait s'appliquer à d'autres problèmes de prédiction environnementale impliquant la propagation dans l'air, la surveillance atmosphérique et l'évaluation des performances des réseaux optiques38,39,40. L'utilisation de jeux de données réels plus volumineux, de techniques avancées d'apprentissage ensembliste, de cadres d'apprentissage par transfert ou d'architectures plus complexes intégrant les lois physiques constituent d'autres approches possibles pour étudier cette idée41,42,43,44,45.
Portée des conclusions et questions de généralisabilité
Les conclusions de ce travail reposent principalement sur un jeu de données synthétique généré à partir de modèles physiques de propagation bien établis (loi de Beer-Lambert, modèle de Kim, modèle de Carbonneau et théorie de la diffusion de Mie). Cette approche méthodologique a des implications pour la portée et la généralisation de nos résultats :
Conclusions tirées des données simulées : (1) Classement comparatif des performances des approches d'apprentissage automatique, d'apprentissage profond et des méthodes hybrides pour la prédiction de l'atténuation atmosphérique. (2) Identification de la concentration en poussière et de la visibilité comme prédicteurs environnementaux dominants de l'atténuation optique dans les conditions modélisées. (3) Avantage en efficacité computationnelle des méthodes d'ensemble basées sur les arbres par rapport aux architectures d'apprentissage profond. (4) Interprétabilité des analyses d'importance des caractéristiques et des valeurs SHAP pour expliquer les prédictions du modèle.
Conclusions nécessitant une confirmation dans des conditions réelles : (1) Les valeurs absolues de R2 et de RMSE obtenues par les modèles évalués dépendent des caractéristiques spécifiques du jeu de données synthétiques et pourraient refléter la capacité des modèles à apprendre les équations physiques déterministes utilisées pour générer les cibles. (2) Il reste à démontrer que le meilleur modèle, la forêt aléatoire (Random Forest), peut être appliqué à des conditions atmosphériques réelles inconnues. (3) Une validation sur le terrain est nécessaire pour que les résultats puissent être appliqués à des unités FSO opérationnelles installées en Irak. (4) Il est nécessaire de confirmer que les classements d'importance des variables identifiés restent robustes dans des conditions de mesure sur le terrain.
Il est important de distinguer la performance sur des données synthétiques dérivées d'équations de celle obtenue sur des données expérimentales ou observationnelles bruitées. Le jeu de données synthétique fournit une relation propre et sans bruit entre les caractéristiques d'entrée et la cible d'atténuation, ce qui peut produire des indicateurs de performance prédictive plus élevés que ceux pouvant être obtenus avec des données réelles comportant du bruit de mesure, des erreurs instrumentales et des phénomènes physiques non modélisés. Nous recommandons que les travaux futurs soient orientés vers l'obtention de mesures réelles d'atténuation FSO dans les conditions météorologiques irakiennes, afin de valider les résultats présentés dans cette étude et d'évaluer la véritable généralisabilité des méthodologies proposées.
Implications des données synthétiques pour la généralisabilité des modèles
Les implications de l'utilisation de données synthétiques dans cette étude doivent être soigneusement examinées en ce qui concerne la généralisabilité des modèles :
Avantages de l'approche synthétique L'ensemble de données est physiquement cohérent et repose sur des cadres théoriques établis grâce à l'utilisation de modèles de propagation physique reconnus. Les paramètres météorologiques ont été extraits de relevés météorologiques irakiens afin que l'ensemble de données reflète les propriétés statistiques des conditions météorologiques réelles en Irak. En plus d'éviter les variables perturbatrices des mesures sur le terrain (telles que les erreurs de mesure, l'étalonnage des équipements ou l'insuffisance des enregistrements de données), ce cadre contrôlé permet un examen méthodique des méthodologies de modélisation.
Limites à la généralisation L'ensemble de données synthétique présente des limites quant à la prise en compte de la complexité complète de l'atténuation atmosphérique réelle, notamment : (1) l'interaction de plusieurs phénomènes atmosphériques se produisant simultanément ; (2) le comportement non linéaire et non stationnaire des paramètres atmosphériques ; (3) la variabilité climatique à long terme non capturée par les distributions d'échantillonnage ; (4) les effets microclimatiques localisés pouvant affecter significativement la propagation en communication optique sans fil (FSO) ; et (5) le bruit et l'incertitude inhérents à la collecte de données dans des conditions réelles.
Prise en compte des biais dans la génération de données synthétiques L'hypothèse d'un échantillonnage indépendant des paramètres environnementaux (voir Méthodes) constitue une simplification excessive des conditions réelles, dans lesquelles les variables atmosphériques ont tendance à être corrélées (par exemple, de fortes concentrations de poussière sont généralement associées à une faible visibilité). Une hypothèse d'indépendance a été adoptée afin de disposer d'un environnement de simulation contrôlé permettant une comparaison systématique des modèles. Toutefois, cette méthode pourrait ne pas rendre compte de toute la complexité des interactions entre les paramètres atmosphériques. Nous utilisons une méthode de division stratifiée (en conservant les proportions des conditions météorologiques dans les ensembles d'apprentissage et de test) afin de minimiser le risque d'une représentation déséquilibrée des conditions rares dans l'ensemble de test (notamment la neige, à 2,87 %).
Génération déterministe de la cible : la forte performance prédictive observée dans cette étude peut être partiellement expliquée par l'apprentissage, par les modèles, des équations physiques déterministes utilisées pour générer les valeurs cibles. En revanche, les données expérimentales du monde réel contiennent du bruit de mesure, des erreurs instrumentales et des phénomènes physiques non modélisés qui rendent la prédiction plus difficile. Par conséquent, les métriques de performance quantitatives (R2, RMSE, MAE) doivent être interprétées comme des comparaisons relatives entre méthodologies dans un environnement de simulation contrôlé, et non comme des garanties absolues de performance pour des systèmes FSO opérationnels.
Par conséquent, bien que les résultats comparatifs sur le classement des performances des modèles soient probablement robustes (en raison de la cohérence physique des données synthétiques), les métriques de performance absolues (R2, RMSE, MAE) ne doivent pas être considérées comme indicatives des performances attendues dans des systèmes FSO opérationnels. Il est nécessaire de tester la généralisation du modèle à des environnements réels à l’aide de mesures expérimentales d’atténuation atmosphérique obtenues dans diverses conditions météorologiques en Irak.
Il existe quelques restrictions à prendre en compte. Premièrement, au lieu d'utiliser des observations sur le terrain, l'étude s'est appuyée sur un jeu de données synthétiques généré à l'aide de modèles physiques de propagation bien établis. Comme mentionné précédemment, les métriques quantitatives de performance (R², RMSE, MAE) ne doivent pas être interprétées comme des garanties absolues de performance pour des systèmes FSO opérationnels, mais plutôt comme des comparaisons relatives entre approches dans un environnement de simulation contrôlé. Deuxièmement, les modèles classiques et les modèles d'apprentissage profond n'ont peut-être pas pu apprendre des représentations de caractéristiques robustes en raison de la taille du jeu de données. Troisièmement, d'autres indicateurs de performance FSO, tels que la disponibilité de la liaison, les erreurs de pointage et l'atténuation induite par la turbulence, n'ont pas été pris en compte, au profit de la prédiction de l'atténuation. Quatrièmement, les proportions des conditions météorologiques ont été calculées à partir de données historiques allant de 2020 à 2024, ce qui pourrait ne pas refléter fidèlement les variations annuelles des régimes climatiques en Irak. Cinquièmement, la structure pseudo-séquentielle des données d'entrée des modèles CNN–LSTM et LSTM constitue une simplification méthodologique qui pourrait ne pas rendre adéquatement compte de la dynamique temporelle des applications réelles. Ces limitations doivent être prises en compte lors de l'évaluation des résultats, car elles pourraient affecter la généralisation des conclusions.
Priorité recommandée : Vérification dans le monde réel. La collecte et l'analyse de mesures réelles d'atténuation FSO dans les conditions météorologiques irakiennes constituent la voie la plus importante de recherche future. Cela devrait inclure : (1) la mise en place de bancs d'essai FSO dans différentes régions d'Irak (par exemple, Bagdad, Bassorah, Mossoul, Ramadi) afin de documenter les variations climatiques régionales ; (2) l'utilisation d'instruments étalonnés sur les sites FSO pour mesurer simultanément les paramètres atmosphériques (température, humidité, visibilité, concentration de poussière) ; (4) la documentation de l'atténuation pendant des événements météorologiques extrêmes (tempêtes de poussière, brouillard dense, fortes pluies) ; (5) la mise à disposition publique des données recueillies afin de permettre la reproductibilité et les études comparatives ; et (3) la poursuite du suivi pendant au moins un cycle annuel complet afin de capturer les fluctuations saisonnières. Une telle validation pratique offrirait l'opportunité d'évaluer la généralisabilité du modèle et d'améliorer les techniques prédictives développées dans cette étude.
Pour valider et améliorer les modèles générés, les recherches futures devraient se concentrer sur l'incorporation de mesures réelles de FSO obtenues dans des conditions météorologiques irakiennes. Des recherches supplémentaires pourraient examiner des stratégies de transfert d'apprentissage exploitant des ensembles de données atmosphériques pertinents, des programmes d'apprentissage en ligne capables de s'ajuster à des conditions environnementales changeantes, ainsi que des approches hybrides expérimentation-simulation combinant des données mesurées et des modèles physiques. Une recherche approfondie sur l'intelligence artificielle explicative et sur des méthodes d'apprentissage avancées fondées sur la physique pourrait également éclairer davantage les mécanismes sous-jacents à l'atténuation atmosphérique et renforcer la robustesse des futurs systèmes de prédiction.
Déclarations de divulgation
Conflit d'intérêts : Les auteurs déclarent ne pas avoir de conflits d'intérêts.
Remerciements
Les auteurs déclarent qu'aucun financement externe n'a été reçu pour cette recherche. Nous tenons à remercier le Centre international de recherche appliquée et théorique (IATRC), quartier de Bagdad, Irak.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Outil CUDA | NVIDIA Corporation | 11.8 | Bibliothèque d'accélération GPU pour l'apprentissage profond |
| cuDNN | NVIDIA Corporation | 8.6.0 | Bibliothèque de réseaux neuronaux profonds accélérée par GPU |
| GPU (unité de traitement graphique) | NVIDIA Corporation | GeForce RTX 4090, 24 Go de mémoire vidéo | Utilisé pour l'apprentissage profond accéléré par GPU |
| CPU (unité centrale de traitement) | Intel Corporation | Core i9-13900K, 24 cœurs/32 threads | Processeur de station de travail pour l'entraînement et l'évaluation de tous les modèles |
| Mémoire système (RAM) | n/a | 64 Go DDR5, 5200 MHz | Mémoire de la station de travail |
| API Keras | Open source (faisant partie de TensorFlow) | incluse avec TensorFlow 2.11.0 | API de haut niveau pour l'apprentissage profond, utilisée pour toutes les architectures d'apprentissage profond |
| LightGBM | Open source (Microsoft) | 3.3.5 | Cadre d'élévation de gradient (gradient boosting) |
| NumPy | Open source (NumFOCUS) | 1.23.5 | Bibliothèque de calcul numérique |
| Système d'exploitation | Canonical Ltd. | Ubuntu 22.04 LTS | Système d'exploitation de la station de travail |
| Python | Python Software Foundation | 3.9 | Langage de programmation utilisé pour la génération des données et la modélisation |
| scikit-learn | Open source | 1.2.2 | Bibliothèque d'apprentissage automatique (RF, SVR, KNN, régression linéaire, validation croisée, mise à l'échelle) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | Bibliothèque d'interprétabilité des modèles, module TreeExplainer |
| TensorFlow | Open source (Google) | 2.11.0 | Cadre d'apprentissage profond utilisé pour les six architectures d'apprentissage profond |
| XGBoost | Open source | 1.7.5 | Bibliothèque d'élévation de gradient extrême (Extreme Gradient Boosting) |
Références
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.