Ce protocole propose FedMediFormer-XAI, un cadre d'intelligence multimodal pour le diabète qui préserve la confidentialité grâce à l'apprentissage fédéré, aux transformeurs multimodaux, à l'augmentation basée sur la diffusion, à la recommandation personnalisée de médicaments fondée sur les graphes et à l'intelligence artificielle explicative, afin d'assurer une prédiction précise, une prise de décision transparente et une gestion personnalisée du diabète.
Article de méthode
FedMediFormer-XAI : Transformateurs multimodaux fédérés avec augmentation par diffusion et recommandation de médicaments basée sur les graphes pour le diabète
Dans cet article
Résumé
Résumé
La gestion du diabète fait face à plusieurs obstacles, tels que la fragmentation des données de santé, les préoccupations liées à la confidentialité, une faible explicabilité et l'absence de conseils thérapeutiques personnalisés. Ce travail de recherche présente FedMediFormer-XAI, un cadre unifié et approprié qui intègre l'apprentissage fédéré, des transformeurs multimodaux, une augmentation des données basée sur la diffusion, des réseaux neuronaux graphiques (GNN) pour la recommandation de médicaments et une intelligence artificielle explicative (XAI) dédiée à l'intelligence sur le diabète. Le système exploite divers types de données de santé, par exemple les dossiers cliniques, les indicateurs de santé publique, les données de surveillance continue de la glycémie, les images du fond d'œil, les mesures issues de capteurs portables et les informations pharmacologiques. Afin de générer des échantillons synthétiques et de corriger les déséquilibres de classes, des modèles de diffusion sont utilisés, tandis que des architectures de transformeurs multimodaux permettent d'apprendre les relations entre des sources de données très différentes. L'apprentissage fédéré permet un entraînement collaboratif des modèles de manière confidentielle, sans partage des données brutes des patients. Le composant GNN capture les interactions patient-médicament et médicament-médicament afin de proposer des recommandations de médicaments personnalisées. Des méthodes d'explicabilité telles que les explications additives de Shapley (SHAP), la visualisation de l'attention, les gradients intégrés et le raisonnement contrefactuel fournissent des interprétations transparentes des résultats de prédiction et de recommandation. Dans la mise en œuvre représentative, le cadre proposé a atteint une exactitude de 94,2 %, une précision de 93,1 %, un rappel de 92,8 %, un score F1 de 92,9 %, un coefficient de corrélation de Matthews (MCC) de 0,88 et une aire sous la courbe caractéristique de fonctionnement du récepteur (AUC-ROC) de 0,96. Le module de recommandation basé sur les graphes a obtenu une précision = 0,89, un rappel = 0,84 et un gain cumulé actualisé normalisé (NDCG) = 0,91. Le protocole propose une approche structurée pour intégrer des données de santé hétérogènes à l'aide de transformeurs multimodaux, d'apprentissage fédéré, d'augmentation basée sur la diffusion, de recommandation fondée sur les graphes et d'intelligence artificielle explicative. Les résultats informatiques rapportés démontrent le potentiel du cadre pour la prédiction du diabète et la recommandation personnalisée de médicaments, tandis que la conception fédérée favorise une gestion décentralisée des données. Une évaluation clinique prospective multicentrique est nécessaire pour établir l'utilité clinique, la généralisabilité et l'applicabilité en conditions réelles.
Introduction
Le diabète sucré figure parmi les principales maladies métaboliques chroniques affectant l'humanité et constitue un problème majeur de santé publique en raison de son expansion constante, de ses effets à long terme et des coûts élevés liés au traitement des patients1,2. Selon un rapport, plus de 537 millions d'adultes vivent actuellement avec le diabète dans le monde, et ce chiffre devrait augmenter considérablement au cours des prochaines décennies3. En l'absence de contrôle de l'hyperglycémie, la personne risque de développer des complications graves telles que la maladie coronarienne4, des lésions rénales5, des atteintes nerveuses6, une perte de la vue7 et un accident vasculaire cérébral8. Par conséquent, détecter la maladie dès son stade précoce, surveiller régulièrement l'état du patient et lui dispenser une formation par le biais de méthodes médicales avancées sont des mesures essentielles pour aider les patients à mener une vie plus saine et, ce faisant, réduire les dépenses du système de santé publique9,10.
De nos jours, l'utilisation des dossiers de santé électroniques (DSE), des dispositifs portables, des systèmes de surveillance continue de la glycémie (SCG), des technologies d'imagerie rétinienne et des applications de santé mobile se répand rapidement, générant de grands volumes de données de santé hétérogènes pouvant être analysées11. Ces différents outils de collecte de données peuvent fournir des informations variées sur le corps humain, sur sa capacité à fonctionner à différents stades d'une maladie, sur la manière dont le patient réagit à différents types de traitement, et sur son comportement en conditions réelles de vie12. L'intelligence artificielle (IA) s'est révélée être la meilleure solution pour traiter des données hautement complexes, prédire le diabète, surveiller l'évolution de la maladie et aider les médecins dans leurs décisions cliniques13. Par ailleurs, les algorithmes d'apprentissage automatique, notamment les forêts aléatoires, les machines à vecteurs de support et les méthodes de boosting par gradient, ont donné d'excellents résultats dans l'évaluation du risque de diabète14. Plus récemment, les architectures d'apprentissage profond ont permis une extraction automatique de caractéristiques et ont amélioré les performances prédictives dans diverses applications en santé15.
Grâce à des méthodes d'apprentissage multimodal, l'intelligence du diabète a été considérablement améliorée en intégrant des dossiers cliniques structurés, des mesures physiologiques, des images rétiniennes et des indicateurs comportementaux au sein d'un cadre prédictif unique16. En utilisant plusieurs sources d'information, les modèles multimodaux peuvent identifier des motifs qui ne sont pas visibles lorsque chaque modalité est examinée séparément17. Récemment, les modèles basés sur l'architecture Transformer ont appris très efficacement les dépendances à longue portée et les relations contextuelles à partir de divers types de données de santé18. Toutefois, des problèmes tels que des classes déséquilibrées, des données manquantes, une hétérogénéité des données et une généralisabilité limitée entravent encore l'utilisation généralisée des systèmes d'intelligence artificielle multimodaux dans les environnements cliniques19.
Même avec ces avancées, de nombreux systèmes existants d'intelligence du diabète s'appuient encore sur des cadres d'apprentissage centralisés qui exigent fondamentalement la consolidation des données des patients provenant d'institutions différentes dans un seul référentiel20. De telles méthodes entraînent déjà des conflits concernant la confidentialité des patients, la gestion des données, la cybersécurité et la conformité réglementaire21. En réalité, en raison de considérations juridiques et éthiques, les prestataires de soins de santé sont souvent limités dans leur capacité à partager des données sensibles sur les patients22. Dans ce contexte, l'apprentissage fédéré devient une solution viable, car il permet d'entraîner un modèle collaboratif sans partager les données réelles des patients23. Grâce à une optimisation décentralisée et à une agrégation sécurisée des paramètres, l'apprentissage fédéré permet une analyse médicale protégeant la vie privée en exploitant les connaissances issues de jeux de données géographiquement distribués24. Néanmoins, la surcharge de communication, l'hétérogénéité des clients et la stabilité de la convergence restent des problèmes majeurs dans les scénarios de santé fédérés25.
Un autre inconvénient des systèmes d'intelligence du diabète actuellement utilisés est le manque de transparence et de soutien pour une thérapie personnalisée. De nombreux modèles d'apprentissage profond se comportent comme des boîtes noires, ce qui pose problème aux cliniciens souhaitant comprendre le raisonnement sous-jacent aux prédictions et recommandations26. Les méthodes d'intelligence artificielle explicables (XAI), telles que SHAP, les gradients intégrés, la visualisation de l'attention et le raisonnement contre-factuel, s'avèrent prometteuses pour améliorer la transparence des modèles et la confiance des cliniciens27. Par ailleurs, les réseaux neuronaux graphiques (GNN) sont devenus les outils les plus avancés pour modéliser les interactions patient-médicament et médicament-médicament, permettant ainsi des recommandations thérapeutiques personnalisées et une évaluation de la sécurité des médicaments28. De nouveaux modèles de diffusion ont également permis de générer des données de santé synthétiques réalistes et de traiter le déséquilibre des classes29.
Les transformeurs, l'apprentissage fédéré, la génération de données synthétiques par diffusion, les réseaux de neurones graphiques et l'intelligence artificielle explicative ont chacun montré des résultats prometteurs dans les applications de santé ; toutefois, leur intégration au sein d'un cadre unique et reproductible d'intelligence du diabète reste limitée. Les approches existantes traitent généralement ces composants indépendamment, en se concentrant sur l'apprentissage préservant la confidentialité sans recommandation personnalisée de traitement, sur la prédiction multimodale sans entraînement décentralisé, ou sur l'explicabilité sans assistance décisionnelle clinique basée sur des graphes. Bien que les modèles de diffusion puissent contribuer à l'équilibrage des classes et que les architectures de transformeurs puissent apprendre les relations entre différentes modalités hétérogènes de soins de santé, les protocoles normalisés pour intégrer ces technologies complémentaires restent peu nombreux. Cette étude présente donc un protocole méthodologique unifié combinant prédiction multimodale, augmentation basée sur la diffusion, optimisation fédérée, recommandation personnalisée de médicaments fondée sur les graphes et intelligence artificielle explicative au sein d'un flux de travail reproductible, tout en offrant une base pour la validation clinique et la traduction ultérieures.
Contrairement aux études qui supposent la disponibilité de jeux de données multimodaux au niveau des patients, ce protocole intègre des jeux de données publiques hétérogènes sans effectuer d'appariement direct des patients. Des modèles indépendants spécifiques à chaque modalité sont entraînés pour chaque source de données, et les représentations latentes des caractéristiques sont combinées au moyen d'un mécanisme d'attention croisée entre modalités. Cette conception préserve la rigueur méthodologique tout en permettant l'intégration de connaissances multimodales à travers diverses bases de données de santé.
Le protocole proposé est principalement destiné au développement méthodologique et aux environnements d'intelligence artificielle en santé distribuée, dans lesquels des sources de données hétérogènes sont disponibles dans différents dépôts ou institutions, et où la centralisation directe des données est restreinte. Dans la mise en œuvre actuelle, les ensembles de données spécifiques à chaque modalité sont indépendants et ne sont pas appariés au niveau des patients ; par conséquent, l'intégration multimodale s'effectue au niveau des représentations apprises plutôt que par une correspondance directe au niveau des patients. Une application pratique nécessiterait des données patient multimodales correctement appariées, un prétraitement et des définitions des résultats cohérents entre les sites participants, une infrastructure informatique adaptée, ainsi que le respect des exigences éthiques, de confidentialité et réglementaires applicables.
Cet article présente FedMediFormer-XAI, un cadre de transformer multivue fédéré qui permet une intelligence du diabète respectueuse de la vie privée grâce à des fonctionnalités de prédiction, de recommandation et d'explicabilité réunies en un seul système. Ce cadre intègre un élargissement des données basé sur la diffusion pour traiter le déséquilibre des classes, un apprentissage par transformeur multivue pour la prédiction du diabète, un apprentissage fédéré pour le développement collaboratif de modèles, une recommandation personnalisée de médicaments basée sur un réseau neuronal graphique, ainsi que des méthodes d'intelligence artificielle explicative afin d'appuyer les décisions cliniques de manière transparente. L'architecture générale et le flux de travail du cadre proposé FedMediFormer-XAI sont illustrés dans Figure 1.
Les principales contributions du cadre proposé FedMediFormer-XAI sont résumées comme suit : (1) Un protocole unifié est présenté, intégrant l'apprentissage fédéré, les transformeurs multimodaux, l'augmentation des données par diffusion, la recommandation personnalisée de médicaments basée sur les réseaux neuronaux graphiques et l'intelligence artificielle explicative au sein d'un flux de travail unique et reproductible pour l'intelligence du diabète. (2) Une stratégie d'apprentissage fédéré respectueuse de la vie privée est développée afin de permettre un entraînement collaboratif du modèle à travers des clients de soins de santé distribués simulés, sans partage des données brutes des patients. (3) Une architecture de transformeur multimodal est introduite pour apprendre conjointement des représentations complémentaires à partir des dossiers cliniques structurés, des données de surveillance continue de la glycémie, des images du fond d'œil et des indicateurs de santé de la population. (4) La génération synthétique de données par diffusion est intégrée afin de réduire le déséquilibre des classes et d'améliorer la robustesse du modèle tout en préservant les caractéristiques statistiques des données d'entraînement d'origine. (5) Un module d'apprentissage par graphes hétérogènes basé sur GraphSAGE est utilisé pour modéliser les relations patient-médicament et médicament-médicament, permettant une recommandation personnalisée de médicaments et un classement des traitements tenant compte des interactions. (6) Plusieurs techniques d'intelligence artificielle explicative, incluant les explications SHapley Additive exPlanations (SHAP), les gradients intégrés, la visualisation de l'attention et les explications contrefactuelles, sont intégrées afin d'améliorer la transparence du modèle et de fournir des résultats de prédiction et de recommandation interprétables. (7) Un protocole de validation complet est fourni, incluant l'évaluation prédictive, l'évaluation de l'apprentissage fédéré, l'évaluation des recommandations, l'analyse de l'explicabilité, une évaluation centrée sur les cliniciens, une validation externe et une évaluation de la reproductibilité.
Protocole
Tous les ensembles de données utilisés dans cette étude ont été obtenus à partir de référentiels accessibles au public et contenaient des informations patient désidentifiées. Ces ensembles comprenaient le Pima Indians Diabetes Dataset, le CDC Diabetes Health Indicators Dataset, le OhioT1DM Dataset, le APTOS 2019 Blindness Detection Dataset, le Drug Review Dataset et le Drug-Drug Interaction Dataset. Aucun recrutement direct de patients, intervention, prélèvement d'échantillons ou accès à des informations de santé personnelles identifiables n'a été impliqué. L'étude s'est limitée à une analyse secondaire d'ensembles de données anonymisés accessibles au public, destinée au développement et à la validation méthodologiques, et a été menée conformément aux exigences institutionnelles relatives à l'utilisation de telles données. L'évaluation centrée sur l'être humain décrite dans ce protocole est prévue pour une mise en œuvre future et n'a pas été réalisée dans la présente étude. Les chercheurs menant cette évaluation devront obtenir l'approbation appropriée du comité d'éthique institutionnel, recueillir le consentement éclairé écrit de tous les participants et se conformer aux exigences institutionnelles applicables, aux accords relatifs à l'utilisation des données et aux réglementations nationales.
1. Configurer l'environnement de calcul
- Installez Python 3.11 comme environnement de programmation principal. Installez PyTorch 2.3 et TensorFlow 2.15 pour le développement et l'entraînement de modèles d'apprentissage profond. Installez la bibliothèque Transformers (v4.45) afin de mettre en œuvre des architectures basées sur les transformeurs.
- Installez PyTorch Geometric (v2.5) pour prendre en charge la construction et l'entraînement de réseaux neuronaux graphiques. Installez SHAP (v0.47) et Captum (v0.8) pour effectuer des analyses d'explicabilité et d'attribution des caractéristiques.
- Installez NumPy, Pandas et Scikit-learn pour les calculs numériques, le prétraitement des données et les utilitaires d'apprentissage automatique. Installez OpenCV et Matplotlib pour les tâches de traitement et de visualisation d'images. Installez NetworkX pour construire et analyser des graphes d'interactions médicamenteuses.
- Installez le CUDA Toolkit ainsi que les pilotes GPU NVIDIA compatibles afin de permettre le calcul accéléré par matériel. Configurez un GPU NVIDIA RTX 4090 disposant d'au moins 32 Go de mémoire système. Définissez la graine aléatoire à 42 pour l'entraînement, la validation et les tests afin d'assurer la reproductibilité des résultats. Vérifiez les installations et la compatibilité des bibliothèques logicielles utilisées. Enregistrez les versions des logiciels, les spécifications du matériel et les paramètres de configuration du modèle utilisés pour l'analyse.
2. Préparer et prétraiter les jeux de données
- Téléchargez et organisez les jeux de données cliniques, physiologiques, d'imagerie et pharmacologiques requis dans des dépôts spécifiques à chaque modalité, puis vérifiez leur intégrité. Confirmez les caractéristiques des jeux de données, les cibles de prédiction et les niveaux d'intégration tels que précisés dans les tableaux 1 et 2. Le flux de travail est illustré dans la figure 2.
- Supprimez les enregistrements en double, non valides, incohérents ou manquants pour les variables essentielles. Divisez chaque jeu de données applicable en sous-ensembles indépendants par patient : entraînement (70 %), validation (15 %) et test (15 %). Appliquez l'imputation par la médiane, la normalisation Min-Max et le codage catégoriel uniquement sur le sous-ensemble d'entraînement, puis appliquez les transformations ajustées sans modification aux sous-ensembles de validation et de test. Réalisez la génération de données synthétiques uniquement sur le sous-ensemble d'entraînement. Vérifiez la partition et la prévention des fuites conformément à l'annexe tableau 1.
- Importez les données de glucose, d'apport alimentaire, de dose d'insuline, d'activité physique et de sommeil. Standardisez les horodatages, alignez les événements à des intervalles réguliers, interpolez linéairement les valeurs de glucose non enregistrées, divisez les enregistrements continus en fenêtres de longueur fixe et appliquez une normalisation par score z pour générer les entrées du transformeur temporel.
- Chargez les images du fond d'œil et supprimez les fichiers corrompus ou illisibles, les doublons, les images sans étiquette, ainsi que celles présentant des artefacts sévères ou une visibilité insuffisante du champ rétinien.
- Redimensionnez les images conservées à 224 × 224 pixels, normalisez les intensités des pixels à l'intervalle [0, 1] et appliquez l'égalisation d'histogramme adaptative avec limitation de contraste (CLAHE).
- Augmentez les images d'entraînement par rotation aléatoire comprise entre ±15°, retournement horizontal avec une probabilité de 0,5, zoom aléatoire compris entre 0,9 et 1,1×, et ajustement de la luminosité dans une plage de ±20 %. N'appliquez aucune augmentation stochastique aux images de validation ou de test. Stockez les images traitées pour l'entraînement du Vision Transformer.
- Intégrez les représentations spécifiques à chaque modalité selon la stratégie d'intégration des jeux de données résumée dans le tableau 2. N'effectuez pas d'appariement direct au niveau patient entre des dépôts indépendants lorsque les identifiants patients communs ne sont pas disponibles.
- Stockez chaque jeu de données public comme un jeu de données indépendant et spécifique à une modalité, car les identifiants patients ne sont pas partagés entre les dépôts.
- Entraînez indépendamment les extracteurs de caractéristiques spécifiques à chaque modalité à l'aide des jeux de données correspondants : (a) Dossiers cliniques → encodeur TabTransformer ; (b) Indicateurs de santé de la population → encodeur TabTransformer ; (c) Surveillance continue du glucose → Transformeur temporel ; (d) Images du fond d'œil → Vision Transformer ; (e) Données pharmacologiques → module GraphSAGE.
- Extrayez indépendamment les plongements de caractéristiques latentes de chaque modalité. Fusionnez uniquement les plongements latents appris via le module de fusion par attention croisée proposé, plutôt que de combiner les dossiers bruts des patients.
- Veillez à ne pas effectuer d'appariement artificiel de patients entre des jeux de données publics indépendants. Conservez des partitions indépendantes d'entraînement, de validation et de test pour chaque jeu de données tout au long du prétraitement, de l'augmentation et du développement du modèle.
- Stockez les représentations de caractéristiques multimodales fusionnées pour les tâches de prédiction ultérieures, l'apprentissage fédéré, l'explicabilité et la recommandation personnalisée de médicaments (figure 2).
3. Réaliser une augmentation des données par diffusion
- Appliquer une augmentation basée sur la diffusion aux jeux de données cliniques et de santé publique sous forme tabulaire à l'aide de TabDDPM. Générer des échantillons synthétiques exclusivement à partir de la partition d'entraînement prétraitée afin d'éviter toute fuite d'information. Configurer le modèle conformément à Supplementary Table 2.
- Entraîner TabDDPM pendant un maximum de 500 époques en utilisant l'optimiseur Adam (taux d'apprentissage = 1 × 10⁻4 ; taille du lot = 256). Appliquer l'arrêt précoce si la perte sur l'ensemble de validation n'améliore pas d'au moins 0,001 pendant 20 époques consécutives. Générer des échantillons synthétiques pour les classes sous-représentées.
- Évaluer la qualité des données synthétiques à l'aide des statistiques de Kolmogorov–Smirnov (KS), de la divergence de Jensen–Shannon, de la distance de Wasserstein, d'une analyse de corrélation par caractéristique et des performances en classification descendante. Comparer les distributions des caractéristiques originales et synthétiques à l'aide du recouvrement d'histogrammes, de l'estimation par densité en noyau et des coefficients de corrélation par paires.
- N'accepter les échantillons synthétiques que lorsque les distributions des caractéristiques par classe restent cohérentes avec les données d'entraînement originales (test KS, p > 0,05 ; divergence de Jensen–Shannon < 0,10) et qu'elles ne contiennent aucune valeur clinique irréaliste. Combiner les échantillons acceptés avec le jeu de données d'entraînement original afin de produire un jeu de données équilibré par classe. Le flux de travail d'augmentation est illustré dans Figure 3.
- Valider les données synthétiques en réentraînant le modèle de prédiction du diabète à l'aide des jeux de données d'entraînement original et augmenté. Comparer l'exactitude (Accuracy), le score F1, le coefficient MCC et l'AUC-ROC afin d'évaluer les modifications de la généralisation du modèle et des biais distributionnels.
4. Développer le modèle de transformeur multimodal
Configurez le transformateur multimodal avec des encodeurs spécifiques aux modalités pour les données cliniques structurées, les séquences de mesure continue du glucose (CGM) et les images de fond d'œil, comme illustré dans la Figure 4. Intégrez les représentations obtenues à l'aide d'une attention croisée entre modalités pour la prédiction du diabète et la recommandation personnalisée de médicaments basée sur un graphe.
- Développer l'encodeur clinique
- Initialiser l'architecture de l'encodeur TabTransformer. Entrer des variables cliniques normalisées et des indicateurs de santé publique. Générer des représentations de caractéristiques contextuelles à l'aide de mécanismes d'attention de type transformeur.
- Configurer l'encodeur TabTransformer avec 32 variables d'entrée cliniques structurées, une dimension d'incorporation de 128, quatre couches de transformeur, huit têtes d'attention, une dimension de couche entièrement connectée de 512, un taux de désactivation de 0,20 et une activation par unité linéaire d'erreur gaussienne (GELU).
- Apprendre des incorporations latentes cliniques capturant les relations entre les attributs des patients. Stocker les incorporations cliniques obtenues en vue d'une intégration multimodale.
- Développer l'encodeur de surveillance continue de la glycémie
- Initialiser l'encodeur temporel de type transformeur. Introduire des séquences de surveillance continue de la glycémie et des mesures physiologiques. Utiliser des mécanismes d'auto-attention pour encoder les dépendances temporelles.
- Configurer le transformeur temporel avec une longueur de séquence de 96 pas temporels, un intervalle d'échantillonnage de 15 min, une dimension d'incorporation de 128, quatre couches de transformeur, huit têtes d'attention, un encodage positionnel sinusoïdal et un taux de désactivation de 0,20.
- Produire des incorporations séquentielles reflétant la dynamique glycémique du patient. Conserver les incorporations temporelles prêtes pour la prochaine étape de fusion.
- Développer l'encodeur Vision Transformer
- Initialiser l'architecture Vision Transformer. Entrer des images prétraitées du fond d'œil. Diviser les images en fragments de taille fixe.
- Configurer le Vision Transformer avec une résolution d'image d'entrée de 224 × 224 pixels, une taille de fragment de 16 × 16 pixels, une dimension d'incorporation de 768, 12 blocs de transformeur, 12 têtes d'attention et un taux de désactivation de 0,10.
- Générer des représentations de caractéristiques au niveau des fragments. Extraire des caractéristiques visuelles signifiant des pathologies rétiniennes et des biomarqueurs liés à la maladie. Conserver les incorporations d'images en vue de la fusion multimodale.
- Réaliser la fusion croisée entre modalités
- Extraire les représentations latentes des encodeurs clinique, de surveillance continue de la glycémie (CGM) et Vision Transformer, puis projeter chacune dans un espace latent commun à 256 dimensions à l'aide de projections linéaires indépendantes suivies d'une normalisation par couche.
- Concaténer les jetons modaux projetés, ajouter des incorporations intégrées apprenables selon le type de modalité, puis appliquer une attention multi-têtes croisée entre modalités afin de permettre l'échange d'information entre les représentations clinique, CGM et rétinienne. Configurer le bloc d'attention avec huit têtes, un espace modèle de 256 dimensions, une couche entièrement connectée de 1 024 dimensions, une activation GELU, un taux de désactivation de 0,10, des connexions résiduelles et une normalisation par couche.
- Appliquer un regroupement par moyenne (mean-pooling) à chaque groupe de jetons spécifique à une modalité, puis concaténer les représentations résultantes. Projeter le vecteur concaténé de 768 dimensions vers une représentation unifiée multimodale à 512 dimensions, et conserver les poids d'attention ainsi que les représentations fusionnées pour les analyses ultérieures d'explicabilité et d'ablation.
- Transmettre la représentation unifiée aux modules de prédiction du diabète et de recommandation de médicaments basés sur GraphSAGE. Conserver les partitions d'entraînement, de validation et de test spécifiques à chaque modalité tout au long du processus de fusion, sans appariement artificiel au niveau patient entre les jeux de données indépendants.
- Configurer le transformeur multimodal selon les paramètres du modèle résumés dans le tableau supplémentaire 3.
5. Configurer l'apprentissage fédéré
- Configurer le cadre d'apprentissage fédéré afin de permettre un entraînement collaboratif de modèles entre des établissements de santé géographiquement dispersés, sans échanger de données au niveau des patients. Réaliser une optimisation locale du modèle dans chaque établissement participant, en utilisant les données localement disponibles. Partager uniquement les paramètres du modèle protégés avec le serveur central d'agrégation. Préserver la confidentialité des patients tout en permettant le développement collaboratif de modèles multimodaux.
- Séparez les ensembles de données multimodaux et répartissez-les entre plusieurs clients fédérés afin de simuler un scénario dans lequel différentes institutions de santé collaborent sans partager leurs données.
- Configurer le réseau d'apprentissage fédéré avec 10 clients hospitaliers participants, un serveur central d'agrégation, cinq époques locales par tour de communication, 100 tours de communication, une fraction de participation des clients de 80 %, une sélection aléatoire des clients à chaque tour de communication et un minimum de huit clients participants par tour.
- Attribuez à chaque client un ensemble de données appartenant à un établissement particulier afin que les données restent locales et confidentielles. Répartissez les données d'apprentissage multimodales entre 10 clients hospitaliers simulés à l'aide d'une stratégie non indépendante et non identiquement distribuée (non-IID) basée sur une distribution de Dirichlet. afin de générer des distributions de classes hétérogènes, des compositions démographiques et des tailles de jeux de données clients.
- Utilisez une graine aléatoire fixe pour garantir la reproductibilité. Vérifiez les distributions obtenues au niveau des clients et conservez ces partitions tout au long de l'apprentissage fédéré. Gardez les ensembles de données de validation et de test indépendants des partitions des clients.
- Initialiser chaque client local avec les paramètres du modèle global reçus depuis le serveur central d'agrégation. Entraîner le transformeur multimodal local pendant cinq époques en utilisant les données d'entraînement locales du client. Optimiser le modèle local à l'aide de l'optimiseur AdamW avec un taux d'apprentissage de 1 × 10⁻4.
- Calculer les mises à jour des paramètres du modèle local après la fin de l'apprentissage local. Protéger les paramètres du modèle local avant leur transmission au serveur central d'agrégation. Transmettre les paramètres du modèle local protégés au serveur central d'agrégation pour l'agrégation globale.
- Recevoir les paramètres du modèle protégés provenant de tous les clients hospitaliers participants. Vérifier l'intégrité des mises à jour du modèle reçues avant agrégation. Agréger les poids locaux du modèle à l'aide de l'algorithme de moyennisation fédérée (FedAvg). Mettre à jour le transformeur multimodal global à l'aide des paramètres du modèle agrégés.
- Redistribuez les paramètres mis à jour du modèle global aux clients hospitaliers participants. Répétez les procédures d'apprentissage local et d'agrégation globale jusqu'à la réalisation de 100 cycles de communication ou jusqu'à ce que le critère de convergence prédéfini soit satisfait.
- Protéger les paramètres du modèle transmis à l'aide du mécanisme d'agrégation sécurisée spécifié et du chiffrement AES-256. Authentifier les clients participants à l'aide de certificats numériques.
- Établir des canaux de communication chiffrés à l'aide du protocole Transport Layer Security (TLS) 1.3. Conserver uniquement les paramètres agrégés du modèle global après chaque tour de communication.
- Évaluer la confidentialité et la sécurité à l'aide d'analyses d'exposition aux données brutes, de partage non autorisé, d'inférence d'appartenance et d'inversion de modèle. Pour l'inférence d'appartenance, comparer la valeur AUC-ROC de l'attaque au seuil aléatoire (0,50) ; évaluer l'inversion à l'aide de l'indice de similarité structurelle (SSIM) et du rapport signal-sur-bruit de crête (PSNR) pour les images rétiniennes, ainsi que de l'erreur normalisée de reconstruction pour les caractéristiques numériques.
- Vérifiez l'agrégation sécurisée en confirmant que le serveur ne peut pas accéder aux mises à jour individuelles des clients non agrégées. Vérifiez la protection AES-256/TLS 1.3 et confirmez qu'aucune transmission de mise à jour de modèle non chiffrée n'a lieu.
- Comparer les métriques de confidentialité entre les configurations fédérées et centralisées lorsque cela est applicable, et rapporter les métriques spécifiées dans Tableau supplémentaire 4.
- Estimer la complexité computationnelle de l'entraînement d'un transformeur local comme O(N × L × d2), où N représente le nombre d'échantillons, L le nombre de couches du transformeur et d la dimension de l'incorporation.
- Estimer la complexité computationnelle de l'agrégation fédérée comme O(K × P) par tour de communication, où K représente le nombre de clients participants et P le nombre de paramètres entraînables du modèle.
- Échanger uniquement les paramètres protégés du modèle entre les clients participants et le serveur central d'agrégation au cours de chaque tour de communication. Calculer la surcharge de communication en fonction de la taille du modèle, du nombre de clients participants et du nombre de tours de communication.
- Comparer les frais généraux liés à l'échange de paramètres avec le coût estimé du transfert des ensembles de données multimodales en santé correspondants. Configurer le cadre d'apprentissage fédéré conformément aux paramètres résumés dans Tableau supplémentaire 4. Le flux de travail de l'apprentissage fédéré et le processus d'agrégation des paramètres sont illustrés dans Figure 5.
6. Construire le module de recommandation personnalisée de médicaments
- Importez les données pharmacologiques, relatives aux médicaments, aux traitements des patients et aux interactions médicamenteuses dans l'environnement computationnel. Construisez un graphe hétérogène de soins de santé contenant des nœuds représentant les patients, les médicaments, les maladies, les tests de laboratoire et les facteurs de risque cliniques.
- Définissez les relations patient-maladie, patient-médicament, maladie-médicament, interaction médicament-médicament et patient-laboratoire comme des arêtes du graphe. Vérifiez la structure du graphe et supprimez les relations en double, non valides ou déconnectées avant l'entraînement du modèle.
- Représentez les nœuds patients à l’aide de l’âge, du sexe, de l’indice de masse corporelle (IMC), de l’HbA1c, de la glycémie, de la pression artérielle et de la durée du diabète. Représentez les nœuds médicaments à l’aide de la classe thérapeutique, du mécanisme d’action, de la posologie, de la fréquence d’administration et des effets indésirables connus.
- Représentez les nœuds maladie à l’aide de la gravité de la maladie, du stade de la maladie et des complications associées. Codez les attributs catégoriels et normalisez les caractéristiques continues des nœuds avant l’entraînement de GraphSAGE.
- Initialisez les plongements de nœuds à l’aide des caractéristiques prétraitées. Échantillonnez jusqu’à 25 nœuds voisins pour chaque nœud cible lors de l’agrégation de voisinage. Agrégez les représentations des nœuds voisins en utilisant l’agrégation par moyenne. Mettez à jour les plongements des nœuds cibles à l’aide des représentations agrégées du voisinage.
- Appliquez la fonction d’activation rectifiée (ReLU) après chaque couche GraphSAGE. Normalisez les plongements de nœuds obtenus. Répétez la procédure d’agrégation de voisinage sur trois couches GraphSAGE.
- Configurez le modèle GraphSAGE avec une dimension cachée de 256, une dimension d’incorporation de 128, trois couches GraphSAGE, une taille d’échantillonnage de voisinage de 25, un taux de désactivation de 0,30, un taux d’apprentissage de 1 × 10⁻4, une taille de lot de 512 et un maximum de 100 époques d’entraînement. Optimisez le modèle à l’aide de l’optimiseur Adam.
- Calculez le plongement spécifique au patient à partir du modèle GraphSAGE entraîné. Calculez les plongements pour les médicaments candidats. Calculez les scores d’adéquation entre la représentation du patient et les représentations des médicaments candidats. Classez les médicaments candidats selon leurs scores d’adéquation prédits.
- Identifiez et supprimez les médicaments contre-indiqués ou potentiellement dangereux à l’aide des informations disponibles sur les interactions médicamenteuses. Retournez les cinq médicaments éligibles les mieux classés comme recommandations personnalisées Top-5.
- Entraînez le modèle de recommandation avec la fonction de perte de classement personnalisé bayésien (BPR). Optimisez l’objectif de classement afin d’attribuer des scores plus élevés aux médicaments cliniquement appropriés qu’aux médicaments candidats moins adaptés.
- Identifiez les nœuds voisins influents et les relations du graphe cliniquement pertinentes contribuant à chaque recommandation médicamenteuse. Calculez les scores d’attribution des caractéristiques liées au patient, à la maladie, au laboratoire et aux médicaments contribuant à la recommandation.
- Générez des explications basées sur des graphes visuels illustrant les relations qui contribuent à chaque recommandation médicamenteuse personnalisée. Configurez le modèle de recommandation GraphSAGE selon les paramètres résumés dans le tableau supplémentaire 5. Le flux de travail de recommandation personnalisée de médicaments basé sur les graphes est illustré dans la figure 6.
7. Réaliser une évaluation de l'explicabilité
- Effectuer l'analyse SHAP
- Charger le transformeur multimodal entraîné et le jeu de test réservé dans l'environnement de calcul.
- Initialiser l'explicateur SHAP à l'aide du modèle de prédiction entraîné et d'un échantillon de référence composé de 100 échantillons d'entraînement, sélectionnés exclusivement dans le jeu d'entraînement par échantillonnage aléatoire stratifié selon la classe de résultat du diabète. Conserver la distribution approximative des classes de la partition d'entraînement complète dans l'échantillon de référence, et utiliser une graine aléatoire fixe de 42 pour garantir une sélection reproductible des échantillons. Calculer les valeurs SHAP pour les échantillons de test sélectionnés.
- Calculer l'importance globale des caractéristiques à partir des valeurs SHAP absolues, générer des visualisations SHAP globales et locales, et conserver les valeurs calculées pour des analyses quantitatives et statistiques ultérieures.
- Effectuer l'analyse des gradients intégrés
- Sélectionner des échantillons représentatifs correctement classés et mal classés dans le jeu de test réservé. Définir des entrées de référence spécifiques à chaque modalité avant de calculer les gradients intégrés. Utiliser une référence nulle pour les caractéristiques numériques normalisées de données cliniques et de CGM, représentant une contribution nulle normalisée de la caractéristique, et utiliser une image de référence à valeurs nulles pour l'entrée normalisée d'image rétinienne.
- Calculer les scores d'attribution des gradients intégrés en utilisant 100 étapes d'interpolation entre la référence et l'entrée initiale. Normaliser les scores d'attribution obtenus afin de permettre la comparaison entre les caractéristiques et les modalités. Générer des visualisations d'attribution pour identifier les caractéristiques cliniques, temporelles et d'imagerie influentes contribuant aux prédictions individuelles du modèle.
- Effectuer la visualisation de l'attention
- Extraire les matrices d'attention des couches du transformeur entraîné pour des échantillons de test représentatifs. Calculer les poids d'attention moyens sur les têtes d'attention correspondantes. Générer des cartes thermiques d'attention pour visualiser les interactions croisées entre les représentations cliniques, temporelles et d'imagerie rétinienne. Identifier les caractéristiques cliniques, temporelles et rétiniennes dominantes recevant des poids d'attention élevés lors de la prédiction.
- Extraire les poids d'attention du transformeur multimodal entraîné pour un échantillon de test réservé sélectionné aléatoirement et visualiser les distributions d'attention correspondantes pour les caractéristiques cliniques, les données temporelles de CGM, les données spatiales rétiniennes et les interactions croisées entre modalités.
- Générer des explications contrefactuelles
- Sélectionner des dossiers de patients représentatifs dans le jeu de test réservé. Définir les plages cliniquement admissibles et les contraintes pour les caractéristiques modifiables du patient avant de générer des échantillons contrefactuels. Limiter les caractéristiques continues à leur plage observée dans les données d'entraînement, et restreindre les caractéristiques catégorielles aux catégories valides présentes dans les données d'entraînement. Ne pas modifier les caractéristiques démographiques immuables, notamment l'âge et le sexe.
- Générer des échantillons contrefactuels en modifiant de manière minimale uniquement les caractéristiques modifiables autorisées, tout en respectant les contraintes cliniques et de domaine prédéfinies. Rejeter les contrefactuels contenant des valeurs en dehors de la plage observée dans les données d'entraînement, des états catégoriels invalides ou des modifications de caractéristiques immuables. Identifier les modifications de caractéristiques cliniquement plausibles les plus faibles nécessaires pour modifier le résultat prédit.
- Signaler les caractéristiques modifiées, les valeurs initiales, les valeurs contrefactuelles et les changements correspondants dans les prédictions du modèle. Le flux de travail d'évaluation de l'explicabilité est illustré dans Figure 7, tandis que des exemples représentatifs de visualisations d'attention et d'explications contrefactuelles sont présentés dans Figure supplémentaire 1.
- Évaluer la qualité des explications
- Calculer la fidélité afin de quantifier l'accord entre les explications générées et le comportement du modèle de prédiction. Calculer la stabilité en générant à plusieurs reprises des explications sous de légères perturbations des entrées et en comparant les motifs d'attribution obtenus. Évaluer la cohérence en comparant les explications générées pour des échantillons de test cliniquement similaires.
- Calculer la parcimonie en déterminant le nombre ou la proportion de caractéristiques contribuant de manière significative à chaque explication. Évaluer l'exhaustivité pour déterminer si les caractéristiques attribuées expliquent adéquatement la sortie correspondante du modèle. Évaluer la sensibilité en mesurant les changements des scores d'attribution suite à des perturbations contrôlées des caractéristiques d'entrée.
- Calculer l'infidélité afin de quantifier le désaccord entre les attributions de caractéristiques et les changements observés dans les prédictions du modèle. Enregistrer toutes les métriques quantitatives d'explicabilité pour des analyses statistiques ultérieures.
- Effectuer une validation clinicienne prospective
- Pour une validation clinique prospective future, obtenir l'approbation du comité d'éthique institutionnel compétent avant de recruter des experts cliniques. Après obtention de l'approbation éthique, recruter 12 cliniciens comprenant six endocrinologues, trois spécialistes du diabète et trois pharmacologues cliniciens, et obtenir le consentement éclairé de tous les participants avant de commencer l'évaluation.
- Sélectionner aléatoirement des prédictions du modèle et leurs explications correspondantes pour évaluation par les cliniciens. Présenter les explications sélectionnées indépendamment à chaque clinicien participant selon un format d'évaluation standardisé.
- Demander à chaque clinicien d'évaluer l'utilité, la pertinence clinique, l'interprétabilité et la fiabilité de l'explication à l'aide d'une échelle de Likert à cinq points. Enregistrer les notes anonymisées des cliniciens et calculer l'accord inter-juges ainsi que les mesures statistiques correspondantes telles que précisées à l'étape 7.7.
- Effectuer l'analyse statistique
- Évaluer la distribution des scores d'évaluation quantitatifs avant de choisir le test de comparaison statistique. Appliquer un test t apparié pour des mesures appariées normalement distribuées ou un test de Wilcoxon pour des mesures appariées non normalement distribuées, selon le cas.
- Calculer le kappa de Fleiss pour quantifier l'accord inter-juges parmi les cliniciens participants. Calculer les intervalles de confiance à 95 % pour les métriques principales d'explicabilité et d'évaluation clinicienne. Fixer le seuil de significativité statistique à p < 0,05.
- Signaler les statistiques de test calculées, les intervalles de confiance et les valeurs p accompagnant les résultats d'évaluation. Évaluer et rapporter les métriques d'explicabilité selon les critères résumés dans Tableau supplémentaire 6.
8. Évaluer les performances du modèle
- Comparer FedMediFormer-XAI avec la régression logistique, le forêt aléatoire, XGBoost, TabTransformer, le Vision Transformer, le Temporal Transformer et le transformeur multimodal centralisé à l’aide de la précision, du rappel, du score F1, du MCC et de l’AUC-ROC.
- Effectuer l’évaluation de chaque modèle de référence en utilisant la même stratégie prédéfinie d’entraînement, de validation et de test afin d’assurer une comparaison cohérente avec le cadre proposé.
- Répéter l’évaluation du modèle sur plusieurs exécutions expérimentales indépendantes et enregistrer les métriques de performance obtenues à chaque exécution. Calculer la moyenne, l’écart type (SD) et l’intervalle de confiance à 95 % (IC) pour la précision, le rappel, le score F1, le MCC et l’AUC-ROC. Présenter les résultats de performance sous la forme moyenne ± SD accompagnée de l’IC à 95 % correspondant.
- Évaluer la normalité des différences appariées de performance entre FedMediFormer-XAI et chaque modèle de référence. Appliquer un test t apparié aux mesures appariées normalement distribuées et un test de Wilcoxon aux mesures appariées non normalement distribuées. Fixer le seuil de significativité statistique à p < 0,05.
- Indiquer les statistiques de test correspondantes, les valeurs de p et les intervalles de confiance à 95 % afin de quantifier la significativité statistique et l’incertitude des différences de performance observées.
- Compter le nombre total de tours de communication jusqu’à la convergence finale des modèles. Surveiller la performance du modèle global durant l’entraînement fédéré. Étudier l’évolution de la convergence au fil des tours de communication.
- Évaluer l’efficacité de l’agrégation des paramètres. Examiner comment l’apprentissage décentralisé influence la performance prédictive. Comparer les résultats obtenus par apprentissage fédéré et apprentissage centralisé.
- Évaluer la convergence fédérée au fil des tours de communication et comparer la performance prédictive fédérée et centralisée. Évaluer les recommandations de médicaments à l’aide de Precision@5, Recall@5 et NDCG@5.
- Générer des échantillons négatifs — des échantillons de médicaments provenant du pool de médicaments candidats éligibles en sélectionnant les traitements qui ne sont pas observés comme des interactions positives patient-médicament pour le patient concerné. Exclure toutes les interactions positives connues et tous les médicaments contre-indiqués du pool d’échantillonnage négatif. Maintenir un ratio fixe d’échantillonnage négatif à positif de 1:1 pour l’entraînement de recommandation et utiliser une graine aléatoire fixe de 42 pour garantir la reproductibilité de la sélection des échantillons négatifs.
- Définir l’ensemble des éléments pertinents pour chaque patient exclusivement à partir des données de validation réservées. Définir l’ensemble des éléments pertinents Ru pour le patient u comme l’ensemble des médicaments satisfaisant aux critères d’interaction positive patient-médicament dans les enregistrements vérité terrain réservés. Ne pas utiliser les prédictions du modèle pour construire Ru. Retirer les médicaments contre-indiqués de l’ensemble de recommandation candidat avant le classement.
- Générer les cinq médicaments éligibles les mieux classés pour chaque patient évalué. Calculer Precision@5 comme la proportion des cinq médicaments recommandés appartenant à l’ensemble des éléments pertinents Ru du patient. Calculer Recall@5 comme la proportion des médicaments pertinents du patient récupérés parmi les cinq recommandations. Calculer NDCG@5 en utilisant la pertinence graduée des médicaments recommandés, en attribuant une pertinence plus élevée aux médicaments cliniquement appropriés et une pertinence nulle aux médicaments non pertinents. Agréger les métriques sur l’ensemble des patients évalués et rapporter la moyenne de Precision@5, Recall@5 et NDCG@5.
- Construire la vérité terrain pour la recommandation avant l’évaluation du modèle et maintenir les interactions patient-médicament réservées séparées des données d’entraînement pour la recommandation. Ne pas utiliser les interactions médicamenteuses du jeu de test, les étiquettes du jeu de test ou les informations sur les traitements futurs durant l’entraînement de GraphSAGE, l’échantillonnage négatif ou le classement des candidats.
- Mesurer la fidélité afin d’évaluer dans quelle mesure les explications reflètent fidèlement le comportement du modèle. Évaluer la stabilité des explications à travers plusieurs examens. Juger la compréhensibilité selon des critères orientés vers les médecins.
- Étudier la cohérence des explications à travers différents types de données. Confirmer la valeur clinique des explications produites. Les métriques d’évaluation utilisées tout au long de l’étude sont résumées dans le tableau supplémentaire 7.
9. Réaliser une validation prospective par des cliniciens
- Réaliser une validation prospective par des cliniciens après avoir obtenu l'approbation éthique appropriée et le consentement éclairé, en suivant les procédures de recrutement, d'évaluation, de collecte des données et d'analyse statistique décrites aux étapes 7.6 à 7.8. La conception de la validation prospective par des cliniciens, incluant la composition des participants, les critères d'évaluation, les conditions de comparaison et les analyses statistiques prévues, est résumée dans le Tableau supplémentaire 8.
10. Réaliser la validation et l'évaluation de la reproductibilité
- Réalisez des études d'ablation en supprimant systématiquement chaque composant individuel du cadre complet FedMediFormer-XAI, tout en conservant les mêmes partitions de jeu de données, procédures de prétraitement, paramètres d'entraînement et critères d'évaluation. Évaluez le modèle complet ainsi que les configurations sans augmentation par diffusion, sans apprentissage fédéré, sans recommandation de médicaments basée sur GraphSAGE et sans fusion multimodale.
- Comparez les configurations ablatées avec le cadre complet FedMediFormer-XAI à l’aide de l’exactitude, de la précision, du rappel, du score F1, du coefficient MCC et de l’AUC-ROC. Quantifiez la variation de chaque métrique de performance afin de déterminer la contribution de chaque composant du cadre. Comparez les résultats de validation avec les résultats des tests internes pour évaluer la généralisabilité. Effectuez des tests de significativité statistique afin de déterminer la fiabilité des différences de performance observées.
- Évaluez la généralisabilité du cadre à l’aide d’un jeu de données externe indépendant, lorsque celui-ci comporte des variables d’entrée compatibles et des définitions de résultats similaires. Appliquez les mêmes procédures de prétraitement et d’évaluation utilisées pour le jeu de données de test interne, puis comparez les métriques de performance obtenues avec les résultats du test interne.
- Effectuez une analyse de significativité statistique sur plusieurs exécutions expérimentales répétées. Évaluez la normalité des différences appariées de performance avant les tests statistiques. Appliquez un test t apparié aux mesures appariées normalement distribuées et un test de Wilcoxon aux mesures appariées non normalement distribuées. Fixez le seuil de significativité statistique à p < 0,05.
- Calculez la moyenne et l’intervalle de confiance à 95 % pour l’exactitude, la précision, le rappel, le score F1, le coefficient MCC et l’AUC-ROC. Indiquez les statistiques de test correspondantes, les p-values et les intervalles de confiance pour les comparaisons principales entre modèles. Documentez tous les paramètres du modèle, procédures de prétraitement, configurations d’entraînement et protocoles d’évaluation nécessaires pour reproduire les expériences rapportées.
- Conservez le code source, les fichiers de configuration, les scripts d’évaluation et les spécifications des modèles entraînés utilisés pour les expériences rapportées. Tenez des registres détaillés de l’entraînement des modèles, des paramètres expérimentaux, des graines aléatoires et des résultats d’évaluation.
- Vérifiez l’intégrité et la cohérence des matériaux disponibles pour la reproductibilité. Assurez-vous que les méthodes et matériaux documentés fournissent suffisamment d’informations pour permettre la reproduction indépendante du flux de travail expérimental.
- Résumez les ressources de reproductibilité et les procédures de validation utilisées dans l’étude dans le tableau supplémentaire 9. Documentez la procédure d’étude d’ablation et les critères d’évaluation permettant d’analyser la contribution des principaux composants du cadre.
Résultats
Analyse des performances prédictives
FedMediFormer-XAI a démontré des performances prédictives améliorées par rapport aux modèles de référence unimodaux et conventionnels évalués. L'augmentation basée sur la diffusion a amélioré la représentation des classes minoritaires, et les performances prédictives résultantes sont résumées dans le Tableau 3. L'évaluation sur plusieurs exécutions répétées a montré des performances prédictives stables pour l'ensemble des modèles évalués. FedMediFormer-XAI a obtenu les meilleures performances globales, avec une exactitude de 94,20 ± 0,34 % (IC à 95 % : 93,78–94,62), une précision de 93,10 ± 0,30 % (IC à 95 % : 92,73–93,47), un rappel de 92,80 ± 0,28 % (IC à 95 % : 92,45–93,15) et un score-F1 de 92,90 ± 0,28 % (IC à 95 % : 92,55–93,25). Le modèle a atteint un coefficient de corrélation de Matthews (MCC) de 0,88 ± 0,02 (IC à 95 % : 0,86–0,90) et une AUC-ROC de 0,96 ± 0,01 (IC à 95 % : 0,95–0,97). Le transformeur multimodal centralisé a fourni la deuxième meilleure performance globale, tandis que les modèles d'apprentissage automatique unimodaux et conventionnels ont montré des performances prédictives relativement inférieures. Ces résultats indiquent que l'apprentissage de représentations multimodales, combiné à une optimisation fédérée, permet d'obtenir de meilleures performances de classification du diabète, plus stables.
Étude d'ablation
Une ablation composante par composante a été utilisée pour évaluer la contribution de l'augmentation par diffusion, de l'apprentissage fédéré, de la recommandation de médicaments basée sur GraphSAGE et de la fusion multimodale. Le cadre complet FedMediFormer-XAI a atteint une exactitude de 94,20 ± 0,34 %, une précision de 93,10 ± 0,30 %, un rappel de 92,80 ± 0,28 %, un score F1 de 92,90 ± 0,28 %, un coefficient MCC de 0,88 ± 0,02 et une AUC-ROC de 0,96 ± 0,01 sur cinq exécutions indépendantes. La suppression de l'augmentation par diffusion a réduit l'exactitude à 91,80 ± 0,42 %, correspondant à une baisse de 2,40 points de pourcentage, tandis que le score F1 et l'AUC-ROC ont diminué respectivement à 90,30 ± 0,38 % et 0,94 ± 0,01. Cette réduction indique la contribution de l'augmentation basée sur la diffusion à la représentation des classes minoritaires et à la robustesse prédictive.
La suppression de l'apprentissage fédéré a entraîné une précision de 93,10 ± 0,37 %, représentant une baisse de 1,10 point de pourcentage par rapport au cadre complet. La précision, le rappel, le score F1, le coefficient MCC et l'AUC-ROC ont également été réduits à 92,20 ± 0,34 %, 91,80 ± 0,32 %, 92,00 ± 0,33 %, 0,86 ± 0,02 et 0,95 ± 0,01, respectivement. Cette comparaison illustre la contribution de la configuration fédérée à la performance prédictive.
La suppression du composant de recommandation personnalisée de médicaments basé sur GraphSAGE a entraîné une modification relativement faible de la performance de prédiction du diabète, avec une précision diminuée à 93,80 ± 0,35 % et un score F1 à 92,60 ± 0,30 %. Les valeurs correspondantes de MCC et de AUC-ROC étaient respectivement de 0,87 ± 0,02 et de 0,96 ± 0,01. Ce résultat indique que GraphSAGE contribue principalement à la recommandation personnalisée de médicaments, plutôt qu'à déterminer directement la performance de classification du diabète.
La plus grande réduction a été observée lorsque la fusion multimodale a été supprimée. La précision a diminué à 87,60 ± 0,55 %, soit une baisse de 6,60 points de pourcentage, tandis que la justesse, le rappel, le score F1, le MCC et l'AUC-ROC ont diminué respectivement à 86,80 ± 0,51 %, 85,90 ± 0,54 %, 86,30 ± 0,52 %, 0,76 ± 0,03 et 0,91 ± 0,01. Cette observation démontre l'importance de modéliser conjointement les informations complémentaires provenant des modalités cliniques, de la MGC et rétiniennes.
Analyse par apprentissage fédéré
Le cadre d'apprentissage fédéré a permis un entraînement collaboratif du modèle sur des clients distribués tout en conservant un traitement décentralisé des données brutes des patients. Pendant l'entraînement, le modèle local de chaque client a été ajusté individuellement, puis combiné selon la méthode de moyennisation fédérée. Après 100 tours de communication, le modèle global a convergé, et ses performances prédictives sont restées comparables à celles de l'apprentissage centralisé. Le cadre d'apprentissage fédéré a montré une convergence stable au fil des tours de communication, malgré des distributions hétérogènes des données entre les clients. L'échange protégé des paramètres a préservé le traitement décentralisé des données, tandis que le modèle global a conservé des performances prédictives compétitives par rapport au modèle de référence centralisé. Tableau 4 compare les implémentations centralisée et fédérée. L'apprentissage fédéré a nécessité un temps d'entraînement supplémentaire en raison de la surcharge liée à la communication, tout en maintenant des performances prédictives comparables à celles de l'apprentissage centralisé.
Analyse des performances au niveau des ensembles de données
Afin d'évaluer la généralisabilité à travers différentes modalités de santé, nous avons évalué les performances sur chaque ensemble de données séparément. Le modèle multimodal FedMediFormer-XAI a démontré des performances solides et globalement compétitives sur les ensembles de données évalués. Il a atteint une exactitude de 91,8 %, 93,1 %, 92,4 % et 94,2 % respectivement sur les ensembles de données Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM et APTOS 2019. Bien que l'ensemble de données APTOS 2019 ait obtenu une exactitude (94,7 %) et une précision (93,9 %) légèrement supérieures à celles du modèle multimodal, l'approche multimodale proposée a maintenu des performances compétitives sur tous les ensembles de données et a atteint une AUC-ROC de 0,96, comparable à la plus élevée observée au niveau des ensembles de données. Les résultats globaux au niveau des ensembles de données sont présentés dans le tableau 5. Pour les ensembles de données individuels, l'analyse des images rétiniennes a fourni les meilleures performances lorsqu'elle était utilisée seule, tandis que la fusion multimodale a produit les prédictions les plus stables et les mieux équilibrées.
Analyse de recommandation personnalisée de médicaments
Le composant de recommandation fondé sur un réseau neuronal graphique a été évalué à l’aide d’informations sur l’efficacité des médicaments et de données sur les interactions médicamenteuses, les médicaments candidats étant classés selon des scores d’adéquation patient-médicament appris, et les associations contre-indiquées étant exclues lors de la génération des recommandations. L’utilisation du format de graphe hétérogène et la modélisation des interactions patient-médicament et médicament-médicament ont pu être réalisées en profondeur, permettant ainsi de soutenir le choix personnalisé des médicaments et l’évaluation de la sécurité. Le modèle de recommandation GraphSAGE a efficacement capturé les relations complexes entre les patients, les maladies, les résultats de laboratoire et les médicaments. Les recommandations personnalisées ont démontré une performance élevée en matière de classement, tout en conservant des explications cliniquement pertinentes grâce à l’analyse des voisinages dans le graphe et à l’attribution des caractéristiques.
Selon le Tableau 6, le module de recommandation personnalisée de médicaments a été évalué à l'aide des métriques Precision@5, Recall@5 et NDCG@5. Ces métriques quantifient la pertinence et la qualité du classement des cinq premières recommandations de médicaments personnalisées produites par le module de recommandation fondé sur GraphSAGE. Le système de recommandation a obtenu de bonnes performances de classement, avec une précision = 0,89, un rappel = 0,84 et un NDCG = 0,91.
Analyse de l'explicabilité
Le cadre intègre SHAP, les gradients intégrés, la visualisation de l'attention et les explications contrefactuelles afin d'aider à l'interprétation des prédictions multimodales. SHAP a été utilisé pour quantifier les contributions au niveau des caractéristiques, les gradients intégrés pour attribuer les prédictions aux caractéristiques d'entrée, la visualisation de l'attention pour examiner l'attention du modèle à travers les modalités, et les explications contrefactuelles pour identifier les modifications des caractéristiques associées à des prédictions alternatives. Figure 8 présente un graphique récapitulatif représentatif de SHAP obtenu à partir du modèle entraîné FedMediFormer-XAI, tandis que Figure 9 présente des visualisations représentatives de l'attention extraites du transformeur entraîné. Ces figures illustrent des sorties obtenues à partir de l'évaluation du modèle, et non des illustrations schématiques de l'architecture proposée.
Dans Figure 8, les classements agrégés par importance des caractéristiques sont présentés. Les caractéristiques ayant des valeurs SHAP absolues plus élevées ont eu une influence plus importante sur les prédictions du modèle et sont également en bon accord avec les connaissances cliniques existantes.
Figure 9 présente des visualisations représentatives de l'attention extraites directement à partir du modèle entraîné FedMediFormer-XAI pour un échantillon de test retenu choisi aléatoirement. Les visualisations comprennent l'attention portée aux caractéristiques cliniques, l'attention temporelle du MCG (mesure continue du glucose), l'attention spatiale de la rétine et l'attention croisée entre les trois modalités. La visualisation de l'attention a permis de démontrer davantage la répartition apprise par le modèle de son attention à travers plusieurs modalités. L'échantillon sélectionné a montré une attention relativement plus marquée envers l'HbA1c, la durée du diabète et l'âge parmi les caractéristiques cliniques, tandis que la carte d'attention du MCG a mis en évidence plusieurs périodes marquées par une variabilité importante de la glycémie. La carte d'attention rétinienne a identifié des régions spécifiques de l'image contribuant à la représentation du modèle, et la matrice d'attention croisée a révélé des motifs d'attention à la fois intra-modalités et inter-modalités. Comme le montre la Figure 9, les cartes d'attention représentatives dérivées du modèle mettent en évidence des profils temporels sélectionnés du glucose, des variables cliniques influentes et des régions d'image rétinienne pertinentes sur le plan diagnostique, dans un échantillon de test retenu.
Résultats de l'évaluation centrée sur l'être humain
Un protocole d'évaluation prospective centrée sur l'être humain a été conçu pour évaluer la confiance des cliniciens, l'interprétabilité, l'ergonomie, l'utilité clinique et la pertinence des explications dans des conditions de prédiction seule et de prédiction accompagnée d'explications. L'évaluation proposée impliquera des endocrinologues, des spécialistes du diabète et des pharmacologues cliniciens, avec l'approbation appropriée du comité d'éthique institutionnel et le consentement éclairé. Étant donné que cette évaluation est prévue pour une mise en œuvre prospective ultérieure, les scores d'issue au niveau des cliniciens ne sont pas rapportés dans le présent protocole.
Tableau 7 résume le design proposé pour l'évaluation prospective par les cliniciens et les critères prédéfinis pour évaluer les effets des explications sur la confiance des cliniciens, l'interprétabilité et l'utilité perçue. L'évaluation prospective comparera les évaluations des cliniciens concernant les prédictions du modèle avec et sans explications associées, en utilisant des critères prédéfinis sur une échelle de Likert. Le cadre proposé d'évaluation de l'explicabilité centrée sur l'humain est présenté dans Figure 10
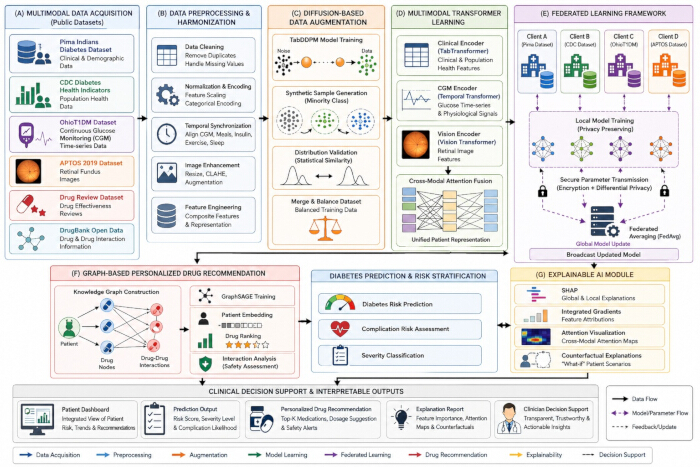
Figure 1 : Architecture globale du cadre FedMediFormer-XAI. Vue schématique du cadre FedMediFormer-XAI, illustrant l'acquisition et le prétraitement des données multimodales, l'augmentation basée sur la diffusion, l'apprentissage par transformeur spécifique à chaque modalité, l'entraînement fédéré du modèle, la recommandation personnalisée de médicaments basée sur GraphSAGE et l'analyse d'explicabilité. Le cadre produit des prédictions de diabète, des recommandations personnalisées de médicaments et des sorties de modèle interprétables. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
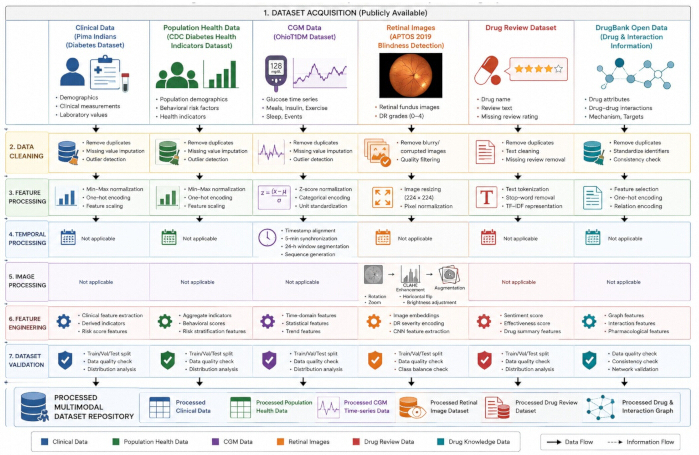
Figure 2 : Pipeline d'acquisition et de prétraitement des données multimodales. Schéma du flux opératoire d'acquisition et de prétraitement des jeux de données multimodaux utilisés dans FedMediFormer-XAI. Les données cliniques et de santé publique, les enregistrements de CGM, les images rétiniennes et les informations pharmacologiques subissent un contrôle qualité, un prétraitement, une normalisation, un encodage et une augmentation spécifiques à chaque modalité, avant d'être convertis en représentations prêtes à l'emploi pour l'analyse ultérieure. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
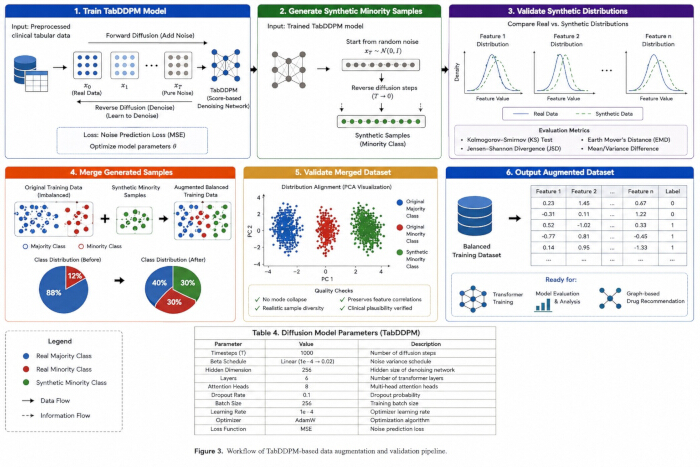
Figure 3: Flux de travail d'augmentation de données basé sur la diffusion. Schéma du flux de travail pour l'augmentation de données d'entraînement structurées sous forme tabulaire à l'aide de TabDDPM. Les échantillons générés subissent des évaluations de qualité et de similarité de distribution avant d'être intégrés aux données d'entraînement initiales afin d'améliorer l'équilibre des classes. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
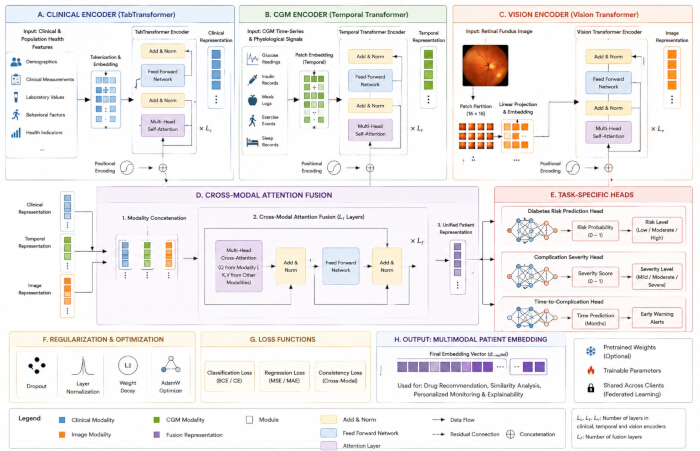
Figure 4 : Architecture du cadre de transformateurs multimodaux proposé. Architecture schématique comprenant (A) un encodeur TabTransformer pour les données cliniques, (B) un encodeur de transformeur temporel pour les données de CGM, et (C) un encodeur de transformateur d'images pour les images rétiniennes. (D) Les représentations spécifiques à chaque modalité sont intégrées par une attention croisée entre modalités afin de produire une représentation multimodale unifiée. (E) Des têtes de prédiction spécifiques aux tâches génèrent les sorties du modèle. (F) Des composants de régularisation et d'optimisation soutiennent l'entraînement du modèle, et (G) des pertes de classification, de régression et de cohérence inter-modalités guident le processus d'optimisation. La représentation multimodale obtenue permet des tâches ultérieures de prédiction, de recommandation et d'interprétabilité. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
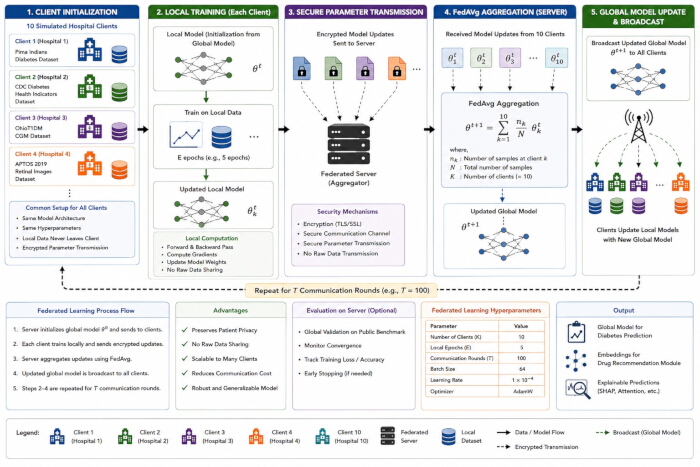
Figure 5 : Cadre de communication pour l'apprentissage fédéré. Flux schématique de l'entraînement fédéré à travers plusieurs clients hospitaliers distribués. Des modèles multimodaux locaux sont entraînés à l’aide de données propres à chaque client, et des mises à jour de modèle protégées sont transmises à un serveur central pour une moyenne fédérée (Federated Averaging). Le modèle global agrégé est redistribué aux clients pour les tours de communication suivants. Le cadre illustre également l’échange sécurisé de paramètres ainsi que l’évaluation des exigences en matière de confidentialité, de communication et de calcul. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
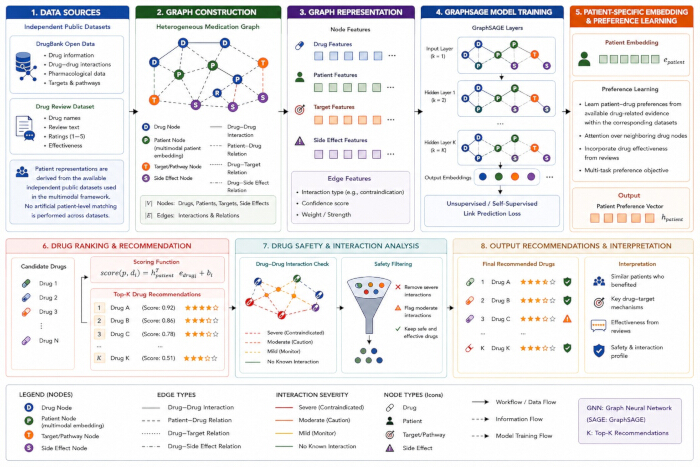
Figure 6 : Flux de travail pour la recommandation personnalisée de médicaments basée sur un graphe. Flux schématique pour la recommandation personnalisée de médicaments basée sur GraphSAGE. Les données pharmacologiques et celles relatives au patient sont organisées en un graphe hétérogène incluant des entités et des relations pertinentes en matière de soins de santé. GraphSAGE apprend les représentations du patient et du médicament, qui sont ensuite utilisées pour calculer des scores d’adéquation patient-médicament et classer les médicaments candidats. Les associations médicamenteuses contre-indiquées ou non sécuritaires sont filtrées avant la génération des recommandations finales Top-K, l’information basée sur le graphe soutenant l’interprétation de ces recommandations. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
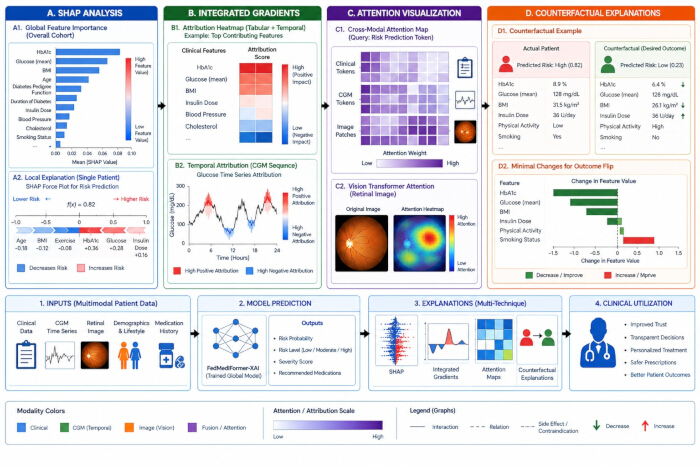
Figure 7 : Cadre d'évaluation de l'explicabilité. Aperçu schématique du flux de travail d'explicabilité. (A) L'analyse SHAP évalue les contributions des caractéristiques globales et locales ; (B) les gradients intégrés fournissent des explications basées sur l'attribution ; (C) la visualisation de l'attention identifie les caractéristiques influentes et les interactions entre modalités ; et (D) l'analyse contre-factuelle identifie les modifications des caractéristiques associées à des prédictions modifiées. Les résultats explicatifs obtenus soutiennent l'interprétation des prédictions du modèle et les recommandations personnalisées. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
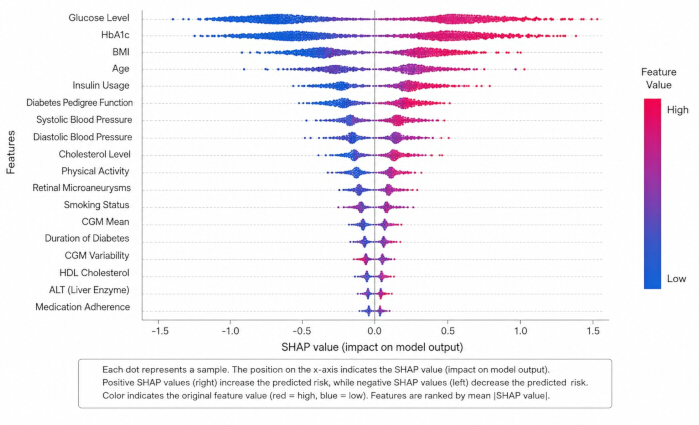
Figure 8 : Analyse représentative de l'importance des caractéristiques SHAP dérivée du modèle, générée par le modèle FedMediFormer-XAI entraîné. Le graphique récapitulatif SHAP montre la distribution des valeurs SHAP sur les échantillons évalués, les caractéristiques étant classées selon leur contribution moyenne absolue SHAP. Les valeurs SHAP positives indiquent une contribution à un risque de diabète prédit plus élevé, tandis que les valeurs négatives indiquent une contribution à un risque prédit plus faible. La couleur représente la valeur correspondante de la caractéristique, les valeurs plus élevées étant indiquées en rouge et les valeurs plus basses en bleu. Ce graphique représente un résultat réel d'interprétabilité dérivé du modèle, et non une illustration schématique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
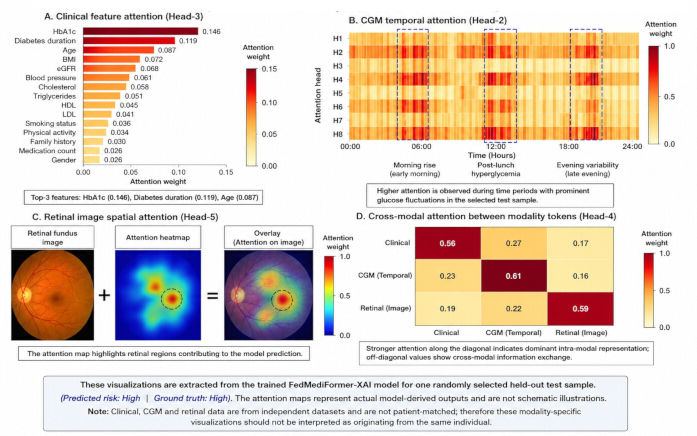
Figure 9 : Résultats représentatifs d'attention générés par le modèle entraîné FedMediFormer-XAI pour un échantillon de test retenu choisi aléatoirement. (A) Attention aux caractéristiques cliniques obtenue à partir d'une tête d'attention du transformeur multimodal, montrant les poids d'attention relatifs attribués aux caractéristiques cliniques. (B) Attention temporelle le long de la séquence de mesure continue du glucose (CGM), illustrant les périodes temporelles auxquelles le modèle accorde une attention plus forte. (C) Attention spatiale pour l'image du fond d'œil, incluant l'image d'origine, la carte de chaleur d'attention et la superposition d'attention. (D) Attention intermodale entre les descripteurs cliniques, CGM et du fond d'œil, montrant le poids accordé aux informations intramodales et intermodales. Les visualisations présentées sont des sorties dérivées du modèle, produites par le modèle entraîné. Les poids d'attention sont affichés pour l'échantillon de test sélectionné et doivent être interprétés comme des motifs d'attention du modèle, et non comme des mesures indépendantes de causalité clinique. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
| Jeu de données | Type de données | Échantillons/Enregistrements | Caractéristiques/Contenu | Objectif | Disponibilité publique |
| Jeu de données sur le diabète des Indiens Pima | Clinique sous forme tabulaire | 768 patients | 8 variables cliniques | Prédiction du risque de diabète | Public |
| Indicateurs de santé du diabète auprès des CDC | Santé de la population | 253 680 enregistrements | Démographie, mode de vie, indicateurs de santé | Analyse des risques au niveau de la population | Public |
| Jeu de données OhioT1DM | Séries chronologiques CGM | 12 sujets | Glycémie, insuline, repas, exercice, sommeil | Modélisation temporelle du diabète | Public |
| Détection de cécité APTOS 2019 | Images rétiniennes | 3 662 images | Photographies du fond d’œil avec étiquettes de gravité | Analyse de la rétinopathie diabétique | Public |
| Jeu de données sur les avis de médicaments | Pharmacologique | 215 063 avis | Efficacité des médicaments, notes, commentaires | Recommandation de médicaments | Public |
| Données ouvertes DrugBank | Grille de connaissances sur les médicaments | Des milliers de médicaments | Interactions médicamenteuses, cibles, voies métaboliques | Construction de graphes | Public/Accès académique |
Tableau 1 : Caractéristiques des ensembles de données. Résumé des ensembles de données accessibles publiquement utilisés dans cette étude, incluant le type de jeu de données, la taille de l'échantillon, la modalité des données, le contenu des caractéristiques, l'objectif prévu et la disponibilité.
| Jeu de données | Modalité | Cible de prédiction | Niveau de fusion |
| Pima Indians Diabetes | Clinique | Classification du diabète | Intégration de caractéristiques |
| CDC Diabetes Health Indicators | Santé de la population | Prédiction du risque de diabète | Intégration de caractéristiques |
| OhioT1DM | Surveillance continue de la glycémie | Prédiction de la tendance glycémique | Intégration de caractéristiques |
| APTOS 2019 | Images du fond d'œil rétinien | Analyse de la rétinopathie diabétique | Intégration de caractéristiques |
| Drug Review + DrugBank | Pharmacologique | Recommandation de médicaments | Intégration de graphes |
Tableau 2 : Stratégie d'intégration de jeux de données multimodaux. Résumé des jeux de données utilisés pour l'intelligence multimodale du diabète, incluant la modalité des données, l'objectif de prédiction et le niveau auquel les représentations spécifiques à chaque modalité sont intégrées. Les données cliniques, de santé publique, de surveillance continue de la glycémie et d'images rétiniennes sont représentées sous forme d'encodages de caractéristiques, tandis que les informations pharmacologiques sont intégrées via des encodages de graphes pour une recommandation personnalisée de médicaments.
| Modèle | Précision, moyenne ± ÉT (IC à 95 %) | Exactitude, moyenne ± ÉT (IC à 95 %) | Rappel, moyenne ± ÉT (IC à 95 %) | Score F1, moyenne ± ÉT (IC à 95 %) | MCC, moyenne ± ÉT (IC à 95 %) | AUC-ROC, moyenne ± ÉT (IC à 95 %) |
| Forêt aléatoire | 83,60 ± 0,74 (82,68–84,52) | 82,70 ± 0,60 (81,96–83,44) | 81,90 ± 0,56 (81,21–82,59) | 82,30 ± 0,56 (81,61–82,99) | 0,67 ± 0,03 (0,63–0,71) | 0,88 ± 0,01 (0,87–0,89) |
| XGBoost | 85,30 ± 0,71 (84,42–86,18) | 84,70 ± 0,60 (83,96–85,44) | 83,80 ± 0,56 (83,11–84,49) | 84,20 ± 0,56 (83,51–84,89) | 0,70 ± 0,03 (0,66–0,74) | 0,90 ± 0,01 (0,89–0,91) |
| TabTransformer | 87,50 ± 0,52 (86,85–88,15) | 87,00 ± 0,60 (86,26–87,74) | 86,20 ± 0,56 (85,51–86,89) | 86,60 ± 0,56 (85,91–87,29) | 0,75 ± 0,03 (0,71–0,79) | 0,92 ± 0,01 (0,91–0,93) |
| Vision Transformer | 88,80 ± 0,50 (88,18–89,42) | 88,20 ± 0,60 (87,46–88,94) | 87,60 ± 0,56 (86,91–88,29) | 87,90 ± 0,56 (87,21–88,59) | 0,78 ± 0,03 (0,74–0,82) | 0,93 ± 0,01 (0,92–0,94) |
| Temporal Transformer | 87,20 ± 0,51 (86,57–87,83) | 86,60 ± 0,60 (85,86–87,34) | 85,90 ± 0,56 (85,21–86,59) | 86,20 ± 0,56 (85,51–86,89) | 0,74 ± 0,03 (0,70–0,78) | 0,91 ± 0,01 (0,90–0,92) |
| CNN-LSTM | 86,90 ± 0,58 (86,18–87,62) | 86,30 ± 0,60 (85,56–87,04) | 85,60 ± 0,55 (84,92–86,28) | 85,90 ± 0,56 (85,21–86,59) | 0,73 ± 0,03 (0,69–0,77) | 0,91 ± 0,01 (0,90–0,92) |
| Centralized Multimodal Transformer | 91,30 ± 0,12 (91,15–91,45) | 90,70 ± 0,60 (89,96–91,44) | 90,10 ± 0,56 (89,41–90,79) | 90,40 ± 0,56 (89,71–91,09) | 0,83 ± 0,03 (0,79–0,87) | 0,95 ± 0,01 (0,94–0,96) |
| FedMediFormer-XAI | 94,20 ± 0,34 (93,78–94,62) | 93,10 ± 0,30 (92,73–93,47) | 92,80 ± 0,28 (92,45–93,15) | 92,90 ± 0,28 (92,55–93,25) | 0,88 ± 0,02 (0,86–0,90) | 0,96 ± 0,01 (0,95–0,97) |
Tableau 3 : Performance de prédiction du diabète. Performance prédictive comparative du FedMediFormer-XAI et des modèles de référence d'apprentissage automatique et d'apprentissage profond, évaluée à l'aide des métriques de précision, de rappel, de score F1, de MCC et d'AUC-ROC.
| Métrique | Apprentissage centralisé | Apprentissage fédéré |
| Précision (%) | 94,7 | 94,2 |
| AUC-ROC | 0,97 | 0,96 |
| Préservation de la confidentialité | Non | Oui |
| Partage des données brutes requis | Oui | Non |
| Nombre de cycles de communication | N/A | 100 |
| Durée d'entraînement (heures) | 4,8 | 5,6 |
| Conformité réglementaire | Moyenne | Élevée |
Tableau 4 : Performances de l'apprentissage fédéré par rapport à l'apprentissage centralisé. Comparaison des implémentations d'apprentissage centralisé et d'apprentissage fédéré en ce qui concerne la performance prédictive, les exigences de partage des données brutes, le nombre de tours de communication et la durée d'apprentissage.
| Jeu de données | Précision (%) | Pertinence (%) | Rappel (%) | AUC-ROC |
| Jeu de données sur le diabète des Indiens Pima | 91,8 | 90,5 | 89,8 | 0,93 |
| Indicateurs sanitaires du diabète des CDC | 93,1 | 92,2 | 91,6 | 0,95 |
| Jeu de données OhioT1DM | 92,4 | 91,8 | 91,1 | 0,94 |
| Détection de la cécité APTOS 2019 | 94,7 | 93,9 | 93,5 | 0,96 |
| Fusion multimodale (FedMediFormer-XAI) | 94,2 | 93,1 | 92,8 | 0,96 |
Tableau 5 : Résultats au niveau des ensembles de données. Analyse des performances sur les ensembles de données individuels et dans des configurations de fusion multimodale. Les résultats illustrent la contribution des différentes modalités de données à la performance prédictive globale.
| Mesure | Valeur |
| Precision@5 | 0.89 |
| Rappel@5 | 0.84 |
| NDCG@5 | 0.91 |
| Précision de détection des interactions médicamenteuses | 0.95 |
| Couverture des recommandations | 0.88 |
| Rang réciproque moyen (MRR) | 0.86 |
| Score de conformité en matière de sécurité | 0.94 |
Tableau 6 : Performance de la recommandation personnalisée de médicaments. Évaluation de la recommandation personnalisée de médicaments basée sur un graphe à l’aide de métriques de classement, de la précision de détection des interactions, de la couverture des recommandations et de l’évaluation de la sécurité médicamenteuse.
| Critère d'évaluation | Conception proposée de l'évaluation |
| Confiance des cliniciens | Évaluation sur une échelle de Likert à cinq points |
| Interprétabilité | Évaluation sur une échelle de Likert à cinq points |
| Pertinence clinique | Évaluation sur une échelle de Likert à cinq points |
| Utilité des explications | Évaluation sur une échelle de Likert à cinq points |
| Utilité perçue | Évaluation sur une échelle de Likert à cinq points |
| Accord entre évaluateurs | Kappa de Fleiss, à calculer après l'évaluation prospective |
| Comparaison statistique | Test statistique apparié, selon ce qui conviendra après le recueil des données |
| Participants | 12 cliniciens, sous réserve d'approbation éthique et de consentement éclairé |
| Statut de l'évaluation | Évaluation prospective/future |
Tableau 7 : Critères proposés d'évaluation centrés sur l'humain. Cadre d'évaluation prospectif centré sur les cliniciens, proposé pour évaluer l'utilité, la pertinence clinique, l'interprétabilité, la fiabilité et l'ergonomie des explications fournies par FedMediFormer-XAI. L'évaluation comprend une évaluation standardisée selon une échelle de Likert à cinq points, un accord entre évaluateurs calculé à l'aide du kappa de Fleiss, une comparaison statistique des conditions « prévision uniquement » et « prévision plus explication », ainsi que des intervalles de confiance à 95 %. L'évaluation par les cliniciens ne doit être réalisée qu'après obtention de l'approbation du comité d'éthique institutionnel compétent et du consentement éclairé.
Tableau supplémentaire 1 : Stratégie de validation du jeu de données. La partition du jeu de données, les procédures de validation, les stratégies d'équilibrage des classes et les mesures de contrôle qualité ont été mises en œuvre afin d'assurer la reproductibilité et une évaluation fiable du modèle. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Paramètres du modèle de diffusion. Paramètres de configuration du modèle de diffusion TabDDPM, incluant les paramètres d'apprentissage, les réglages d'optimisation, les dimensions latentes, la stratégie de planification du bruit et les spécifications de génération d'échantillons synthétiques. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 3 : Configuration du transformateur multimodal. Configuration de l'architecture de transformateur multimodal, incluant les encodeurs cliniques, temporels et d'images, les dimensions d'intégration et de fusion, les têtes d'attention, l'optimiseur, le taux d'apprentissage, la taille du lot, les époques d'entraînement, le critère d'arrêt précoce et la perte combinée d'entraînement. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 4 : Configuration de l'apprentissage fédéré. Paramètres utilisés pour l'entraînement fédéré préservant la confidentialité, incluant le nombre d'hôpitaux participants, les tours de communication, les époques d'entraînement locales, le taux de participation des clients, l'algorithme d'agrégation, l'optimiseur, le taux d'apprentissage, la méthode de chiffrement, le protocole de communication et la politique de partage des données brutes. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 5 : Configuration de GraphSAGE. Configuration du module hétérogène de recommandation personnalisée de médicaments basé sur GraphSAGE, incluant le type de graphe, les dimensions cachées et d'incorporation, le nombre de couches du graphe, la taille de l'échantillonnage des voisins, l'optimiseur, le taux d'apprentissage, la taille du lot, le nombre d'époques d'entraînement, la perte de classement personnalisé bayésien et le nombre de recommandations de médicaments principales. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 6 : Métriques d'évaluation de l'explicabilité. Métriques quantitatives et centrées sur l'humain utilisées pour évaluer l'explicabilité du cadre FedMediFormer-XAI. Les métriques évaluent la fidélité, la stabilité, la cohérence, la parcimonie, l'exhaustivité, la sensibilité, l'infidélité, l'accord entre évaluateurs et la qualité perçue des explications par les cliniciens. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 7 : Métriques d'évaluation. Des métriques prédictives, d'apprentissage fédéré, de recommandation et d'explicabilité sont utilisées pour évaluer les performances, la robustesse, la qualité du classement et l'interprétabilité du cadre. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 8 : Conception de l'évaluation centrée sur l'humain. Conception de l'étude d'évaluation centrée sur les cliniciens, incluant les groupes de participants, les conditions d'évaluation, les critères d'appréciation et les procédures d'analyse statistique. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 9 : Ressources pour la reproductibilité. Résumé des ensembles de données, spécifications de mise en œuvre, fichiers de configuration, procédures d'évaluation, documentation et registres expérimentaux nécessaires pour assurer la reproductibilité du cadre FedMediFormer-XAI proposé. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Interprétation des résultats clés
Les résultats représentatifs montrent qu'il est possible de combiner l'apprentissage par transformeur multimodal, l'apprentissage fédéré, l'augmentation basée sur la diffusion, la recommandation de médicaments par réseaux neuronaux graphiques et l'intelligence artificielle explicative au sein d'un cadre unifié d'intelligence pour le diabète. En intégrant des dossiers cliniques, des indicateurs de santé publique, des données de surveillance continue de la glycémie, des images de fond d'œil et des informations pharmacologiques, le cadre proposé FedMediFormer-XAI a démontré des performances prédictives élevées tout en permettant un développement de modèles interprétables et décentralisés. La méthode d'apprentissage multimodal a extrait des caractéristiques informatives à partir de différentes modalités de soins de santé, conduisant à une meilleure prédiction du diabète et à des recommandations personnalisées de traitement.
Avantages de l'apprentissage fédéré
L'une des principales contributions du cadre proposé est l'intégration de l'apprentissage fédéré afin de permettre une construction collaborative de modèles de manière décentralisée. L'apprentissage fédéré diffère des méthodes traditionnelles d'apprentissage centralisé en permettant à plusieurs institutions de participer à l'entraînement d'un modèle sans partager directement les données brutes des patients. Les résultats clés ont montré que l'apprentissage fédéré maintenait une précision prédictive comparable à celle de l'apprentissage centralisé, tout en soutenant une gestion décentralisée des données. Cette caractéristique est particulièrement pertinente dans les contextes de santé où le partage des données est limité par les politiques institutionnelles et les exigences en matière de confidentialité.
Analyse de l'explicabilité
L'évaluation de l'explicabilité a révélé que l'analyse SHAP, les gradients intégrés, la visualisation de l'attention et les explications contrefactuelles peuvent tous produire des informations cliniquement pertinentes sur le comportement du modèle. Les explications globales et locales concordaient largement, d'un point de vue clinique, sur les prédicteurs les plus importants (c'est-à-dire les mesures de glucose, l'indice de masse corporelle, l'âge, les schémas d'administration de l'insuline et les anomalies rétiniennes). Les visualisations de l'attention ont également montré que l'architecture de type transformeur se concentrait sur des caractéristiques temporelles et d'imagerie cliniquement pertinentes. Ces approches améliorent la transparence en fournissant des interprétations complémentaires des prédictions du modèle et des contributions des caractéristiques.
Analyse de recommandation personnalisée de médicaments
Nous proposons un modèle de recommandation basé sur un réseau de neurones graphique (GNN) qui, en plus de modéliser les relations patient-médicament et médicament-médicament, fournit des recommandations de médicaments personnalisées. En effet, la topologie du graphe hétérogène a permis à la fois de maîtriser les schémas d'efficacité du traitement et de prendre en compte la sécurité des médicaments. Les excellents résultats obtenus dans cette étude concernant la recommandation de médicaments illustrent les capacités des méthodes d'apprentissage basées sur les graphes pour développer des systèmes intelligents dans le domaine du diabète, allant au-delà de la prédiction des maladies, vers un cadre d'aide thérapeutique personnalisé.
Évaluation centrée sur l'être humain
Le cadre intègre un protocole d'évaluation prospective centré sur l'être humain afin d'évaluer les effets de l'explicabilité sur la confiance des cliniciens, l'interprétabilité, l'ergonomie et l'utilité clinique perçue. L'évaluation proposée comparera des conditions de prédiction seule et de prédiction accompagnée d'explications, en utilisant des critères d'évaluation standardisés. La mise en œuvre ultérieure de cette évaluation, après approbation appropriée par le comité d'éthique institutionnel et obtention du consentement éclairé, fournira des données empiriques sur l'acceptation par les cliniciens et l'utilité pratique des explications générées.
Étapes critiques pour une mise en œuvre réussie et reproductible
Plusieurs étapes du protocole proposé nécessitent une attention particulière afin d'assurer la reproductibilité. Le prétraitement et la partition de l'ensemble de données doivent maintenir une séparation au niveau du patient et éviter toute fuite de données, tandis que les distributions non-IID des clients spécifiées doivent être conservées durant l'apprentissage fédéré. La fusion multi-modale doit préserver les dimensions latentes définies, la configuration de l'attention, les intégrations par type de modalité, la normalisation et la projection finale. L'augmentation basée sur la diffusion doit utiliser des paramètres de prétraitement et d'entraînement cohérents, tandis que la recommandation basée sur GraphSAGE doit maintenir des représentations patient-médicament cohérentes, un criblage des interactions, des définitions des éléments pertinents et des critères de classement Top-K constants. L'analyse d'explicabilité doit utiliser des échantillons de référence fixes pour SHAP, des points de départ fixes pour les gradients intégrés, des procédures d'extraction de l'attention et des contraintes contre-factuelles autorisées sur le plan clinique. Les versions des logiciels, les graines aléatoires, les configurations des modèles, les partitions des ensembles de données et les paramètres d'évaluation doivent être documentés afin de minimiser les variations dépendant de l'implémentation.
Limites
Plusieurs limites doivent être prises en compte lors de l'interprétation des résultats de cette étude. Premièrement, le cadre a été développé et évalué à l'aide de jeux de données accessibles au public, qui pourraient ne pas représenter pleinement la diversité des populations de soins de santé du monde réel et des environnements cliniques. Deuxièmement, bien que l'apprentissage fédéré ait été évalué à l'aide de clients hospitaliers simulés, une validation à grande échelle impliquant des établissements de santé indépendants n'a pas été réalisée. Troisièmement, l'apprentissage fédéré introduit des surcoûts supplémentaires en termes de communication et de calcul, ce qui pourrait affecter la scalabilité dans des environnements aux ressources limitées. Enfin, les techniques d'explicabilité utilisées dans cette étude sont principalement des méthodes d'interprétation a posteriori et pourraient ne pas rendre pleinement compte du comportement des modèles complexes.
Le protocole de validation centré sur l'être humain proposé prend en compte un panel initial de 12 experts cliniciens composé d'endocrinologues, de spécialistes du diabète et de pharmacologues cliniciens. Cette taille d'échantillon vise une évaluation préliminaire de l'utilisabilité et de l'interprétabilité, et non une validation clinique définitive. Le panel d'experts relativement restreint pourrait limiter la puissance statistique et la généralisabilité. Des études prospectives futures devraient donc inclure des cohortes plus larges de cliniciens répartis dans plusieurs centres et représentant divers contextes cliniques et spécialités.
Une limitation importante du cadre proposé est que les modalités cliniques, de surveillance glycémique continue (CGM), d'imagerie rétinienne et liées aux médicaments proviennent de jeux de données publics indépendants plutôt que d'enregistrements multimodaux appariés à chaque patient. Par conséquent, le composant de fusion croisée entre modalités doit être interprété comme un cadre méthodologique permettant d'intégrer des représentations complémentaires de modalités, et non comme une preuve issue de mesures multimodales simultanées effectuées sur les mêmes patients. Les différences dans les caractéristiques des populations, les protocoles d'acquisition, les distributions de caractéristiques et les définitions des maladies entre les jeux de données sources peuvent introduire des écarts de distribution et limiter la mesure dans laquelle les relations croisées entre modalités apprises reflètent de véritables associations au niveau individuel. Bien que le protocole évite explicitement une correspondance artificielle au niveau des patients entre jeux de données indépendants, cette conception limite l'évaluation directe des interactions multimodales spécifiques à chaque patient et pourrait affecter la généralisabilité clinique. Ainsi, les performances multimodales rapportées ne doivent pas être interprétées comme équivalentes à une validation sur une cohorte multimodale prospective avec appariement des patients. De futures études devraient valider ce cadre à l'aide de jeux de données plus vastes et indépendamment collectés, contenant des informations synchronisées sur les aspects cliniques, la CGM, la rétine et les traitements provenant des mêmes patients.
Résolution des problèmes et modifications du protocole
Plusieurs considérations pratiques peuvent influencer la mise en œuvre du protocole proposé. Un déséquilibre entre les classes peut réduire la performance prédictive lorsque les classes minoritaires sont sous-représentées ; ce défi peut être atténué par des stratégies d'augmentation basées sur la diffusion et de rééchantillonnage. La présence de valeurs manquantes ou de formats de données incohérents peut nuire à la stabilité du modèle et doit être corrigée par des procédures rigoureuses de prétraitement. La convergence de l'apprentissage fédéré peut devenir instable lorsque les ensembles de données des clients présentent une hétérogénéité importante ; l'ajustement du nombre d'époques d'entraînement local, des taux d'apprentissage et de la fréquence d'agrégation peut améliorer la stabilité. Les limitations matérielles peuvent également affecter l'efficacité de l'entraînement, notamment lors du traitement de grands ensembles de données multimodales ou d'architectures de type transformeur. Dans de tels cas, la réduction de la taille des lots ou de la complexité du modèle peut améliorer la faisabilité computationnelle tout en préservant la reproductibilité.
Directions futures
Les recherches futures pourraient se concentrer sur l'intégration de technologies de jumeau numérique pour la simulation personnalisée des maladies et la planification des traitements. Des modèles fondamentaux entraînés sur de grands ensembles de données multimodales en santé pourraient améliorer davantage l'apprentissage des représentations et la généralisation des modèles. Des techniques d'explicabilité causale pourraient offrir un aperçu plus approfondi des mécanismes des maladies et des effets des traitements, allant au-delà des explications basées sur la corrélation. De plus, des approches d'apprentissage par renforcement pourraient soutenir l'optimisation adaptative des traitements et les stratégies dynamiques de recommandation médicamenteuse. Ces avancées pourraient renforcer davantage l'utilité clinique et les capacités de personnalisation des systèmes d'intelligence du diabète. En outre, les prédictions et recommandations médicamenteuses générées par l'intelligence artificielle doivent être considérées comme des outils d'aide à la décision, et non comme des substituts au jugement clinique professionnel. Une surveillance humaine appropriée reste essentielle pour un déploiement responsable et éthique des systèmes d'intelligence artificielle en santé.
Conclusion
FedMediFormer-XAI fournit un cadre reproductible intégrant l'apprentissage multimodal, l'entraînement fédéré, la recommandation personnalisée de médicaments et l'explicabilité pour l'intelligence du diabète. Les résultats représentatifs soutiennent la faisabilité du flux de travail proposé, bien qu'une validation supplémentaire à l'aide de jeux de données multimodaux appariés aux patients, de contextes cliniques plus larges et d'une évaluation prospective par des cliniciens soit nécessaire avant un déploiement clinique.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir d'intérêts financiers concurrents, de conflits d'intérêts ou de relations personnelles pouvant avoir influencé les travaux rapportés dans cette étude. Des outils d'intelligence artificielle ont été utilisés uniquement pour aider à l'amélioration linguistique, à l'organisation du manuscrit, à la mise en forme et à la révision lors de la préparation de cet article. L'ensemble du contenu scientifique, la conception de l'étude, la méthodologie, l'analyse des données, l'interprétation des résultats et les conclusions ont été élaborés, vérifiés et approuvés par les auteurs. Les auteurs assument l'entière responsabilité de l'exactitude, de l'intégrité et de l'originalité des travaux présentés dans ce manuscrit.
Remerciements
Les auteurs remercient les développeurs et les mainteneurs des ensembles de données accessibles au public et des ressources logicielles open source utilisées dans cette étude.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Chiffrement AES | NIST | AES-256 | Chiffrement des données au repos / des paramètres de modèle protégés en apprentissage fédéré |
| Jeu de données APTOS 2019 pour la détection de la cécité | Kaggle/APTOS | Sortie de 2019 | Jeu de données d'images de fond d'œil ; disponible publiquement et dé-identifié ; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta IA | Version 0,8 | Interprétabilité des modèles et analyse d'attribution |
| CUDA Toolkit | NVIDIA | Version 12.2 | Calcul accéléré par GPU |
| Ensemble de données sur les indicateurs de santé du diabète (CDC BRFSS 2015) | CDC/BRFSS ; Kaggle | Sortie de 2015 | Indicateurs de santé de la population ; accessibles au public et désidentifiés ; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Jeu de données pour la détection de la rétinopathie diabétique | Kaggle | Libération publique | Jeu de données d'images rétiniennes ; disponible publiquement et anonymisé ; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Certificats numériques | - | - | Authentification du client dans l'apprentissage fédéré |
| Jeu de données sur les interactions médicamenteuses | Kaggle | Libération publique | Données de graphe d'interaction médicamenteuse ; disponibles publiquement et dé-identifiées ; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Jeu de données sur l'évaluation des médicaments | Dépôt d'apprentissage automatique UCI | Jeu de données 462 | Jeu de données sur l'efficacité des médicaments et les avis; disponible publiquement et dé-identifié ; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Développeurs de Matplotlib | Version 3.9 | Visualisation |
| Jeu de données sur le diabète MTS | Kaggle | Libération publique | Jeu de données sur les capteurs portables et la prédiction du diabète ; disponible publiquement et anonymisé ; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | Développeurs de NetworkX | Version 3.3 | Construction et analyse du graphe des interactions médicamenteuses |
| NumPy | Développeurs de NumPy | Version 1.26 | Calcul numérique |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Entraînement et inférence du modèle ; au moins 32 Go de mémoire système |
| Jeu de données OhioT1DM | Ohio University | Libération publique | Jeu de données de surveillance continue du glucose ; disponible publiquement et anonymisé ; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | Fondation OpenCV | Version 4.10 | Traitement d'image |
| Pandas | PyData | Version 2.2 | Traitement et prétraitement des données |
| Jeu de données sur le diabète des Indiens Pima | Dépôt d'apprentissage automatique UCI | Jeu de données 34 | Jeu de données pour la prédiction du diabète clinique ; disponible publiquement et anonymisé ; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Fondation Python | Version 3.11 | Environnement de programmation principal |
| PyTorch | Meta IA | Version 2.3 | Développement et entraînement d'un modèle d'apprentissage profond |
| PyTorch Geometric | Équipe PyG | Version 2.5 | Construction et entraînement d'un réseau neuronal graphique |
| Scikit-learn | Développeurs de Scikit-learn | Version 1.5 | Utilitaires d'apprentissage automatique et évaluation |
| Mécanisme de regroupement sécurisé | - | - | Agrégation protégée des paramètres locaux des modèles en apprentissage fédéré |
| SHAP | Développeurs de SHAP | Version 0,47 | IA explicable et analyse d'attribution des caractéristiques |
| TensorFlow | Version 2.15 | Développement et entraînement d'un modèle d'apprentissage profond | |
| Transformers | Hugging Face | Version 4.45 | Implémentation d'une architecture basée sur les transformeurs |
| Sécurité de la couche de transport | IETF | TLS 1.3 | Canal de communication crypté pour l'échange de paramètres fédérés |
| Poste de travail | Générique | - | Environnement informatique ; au moins 32 Go de mémoire système |
Références
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.