Ce protocole présente le réseau désentrelacé à trois flux (TDE-Net), un cadre de reconstruction d'image à partir d'EEG qui combine des représentations complémentaires de l'EEG, un alignement visuel dans un espace dual et un décodage par diffusion.
Article de méthode
Réseau désenchevêré à trois flux avec fusion adaptative en double espace pour la reconstruction d'images basée sur l'électroencéphalographie sur THINGS-EEG2
Dans cet article
Résumé
Résumé
La reconstruction de stimuli visuels à partir de l'électroencéphalographie (EEG) non invasive nécessite de relier de courtes réponses neuronales bruitées à des représentations visuelles significatives, malgré un échantillonnage spatial limité. Les approches existantes de reconstruction d'images à partir de l'EEG utilisent diverses représentations neuronales et stratégies génératives, ce qui impose la mise en place de flux de travail reproductibles permettant de distinguer les contributions structurelles et sémantiques. Ce protocole présente le réseau triphasé désenchevêtré (TDE-Net), un cadre computationnel pour la reconstruction d'images basée sur l'EEG. Le protocole utilise des enregistrements prétraités de THINGS-EEG2 et organise les données EEG en trois flux : un ancrage EEG brut, un flux de graphe fonctionnel spécifique à l'échantillon et un flux sémantique temporel multi-échelle. Le flux de graphe capture les relations dans le domaine fréquentiel entre les canaux EEG à l'aide de la convolution sur graphes et d'un apprentissage contrastif inter-essais, tandis que le flux sémantique extrait des caractéristiques pertinentes pour la tâche via un pondération spatiale adaptative et des convolutions temporelles multi-échelle. Les caractéristiques structurelles et sémantiques sont mappées séparément vers des espaces latents d'auto-encodeur variationnel (VAE) et de pré-entraînement contrastif langage-image (CLIP), combinées à l'aide de poids de fusion sélectionnés sur un jeu de développement, puis décodées à l'aide de Stable UnCLIP. Chez 10 participants, TDE-Net a atteint une précision moyenne d'identification par paire CLIP de 0,8135, des métriques complémentaires démontrant une correspondance structurelle et dans l'espace des caractéristiques. Des analyses d'ablation et au niveau des représentations ont permis de caractériser davantage les contributions de chaque flux. Ce protocole fournit un cadre reproductible pour explorer les représentations EEG complémentaires et la reconstruction visuelle basée sur la diffusion.
Introduction
Le décodage de la perception visuelle est un domaine de recherche interdisciplinaire dans les interfaces cerveau-ordinateur (ICO) et les neurosciences cognitives. L'imagerie par résonance magnétique fonctionnelle (IRMf) a permis une reconstruction réaliste d'images1,2,3,4, mais son coût, sa portabilité limitée et son retard hémodynamique restreignent certaines applications. L'électroencéphalographie (EEG) fournit des mesures temporelles à l'échelle du milliseconde avec un équipement relativement accessible, mais son faible rapport signal/bruit et son échantillonnage spatial limité rendent difficile la reconstruction d'images à partir de l'EEG.
La complexité de la méthode doit être interprétée à la lumière du compromis général entre biais et variance5. Les premières méthodes de décodage visuel utilisaient des représentations peu profondes ou linéaires, tandis que des études ultérieures ont introduit des encodeurs compacts basés sur des convolutions, sur des graphes ou sur l'attention6,7,8,9,10,11. L'alignement croisé de modalités a également évolué, passant de l'apprentissage de caractéristiques multimodales12,13 à des modèles de diffusion latente et à de grands encodeurs visuels14,15,16. Ces approches établissent des références utiles, mais leurs représentations d'entrée, leurs cibles latentes et leurs décodeurs diffèrent ; par conséquent, les résultats doivent être interprétés dans le contexte de leurs paramètres expérimentaux respectifs.
L'objectif de TDE-Net est de fournir un cadre modulaire de reconstruction d'images à partir d'EEG qui sépare les représentations structurelles et sémantiques de l'EEG, les aligne avec des espaces latents visuels complémentaires, puis intègre ces prédictions pour une reconstruction d'images par diffusion. Des études récentes sur le décodage visuel à partir d'EEG ont introduit une génération guidée par transformeur dans EEG-CLIP17, un alignement tenant compte des éléments premiers plans avec des réseaux cérébraux dynamiques dans FSDBN18, un flou adaptatif guidé par la cognition avec un alignement soumis à des contraintes d'information19, ainsi qu'un apprentissage biomimétique bidirectionnel à plusieurs niveaux20. D'autres chaînes de traitement allant de l'EEG à l'image, telles que Perceptogram et la diffusion guidée basée sur des intégrations d'EEG, offrent des références supplémentaires pour la prédiction latente21,22. TDE-Net se distingue par son organisation architecturale : il sépare explicitement un ancrage EEG brut, une représentation fonctionnelle de graphe spécifique à l'échantillon et une représentation sémantique temporelle, puis effectue un alignement asymétrique vers les espaces VAE et CLIP avant la fusion. Cette architecture permet d'analyser séparément les contributions structurelles et sémantiques par des analyses dans l'espace latent et au niveau des images. Par rapport aux approches allant directement de l'EEG à l'image basées sur une seule représentation, cette conception modulaire offre des voies structurelle et sémantique distinctes, préserve une référence linéaire d'EEG durant la prédiction latente, et permet d'évaluer indépendamment la contribution de chaque représentation grâce à des analyses d'ablation et d'espaces latents.
TDE-Net est conçu pour des expériences avec des réponses EEG appariées et des stimuli visuels, des conditions d'entraînement suffisantes et une courte fenêtre post-stimulus dans laquelle la reconstruction sémantique est l'objectif principal. Son organisation par étapes permet d'examiner séparément l'extraction de caractéristiques, l'alignement latent, la fusion et le décodage par diffusion. Les applications linéaires restent adaptées aux très petits jeux de données ou aux contextes privilégiant une complexité minimale du modèle, tandis que les décodeurs neuronaux de bout en bout peuvent être préférables lorsque de grands jeux de données spécifiques à la tâche et un déploiement en temps réel sont disponibles.
Le protocole actuel évalue la configuration proposée dans le cadre de la présentation visuelle en séquence rapide (RSVP) THINGS-EEG2. Les principales contributions incluent un schéma de représentation de l'EEG en trois flux composé d'un ancrage linéaire brut, d'un flux de graphe fonctionnel spécifique à l'échantillon et d'un flux sémantique temporel multi-échelle. Ces représentations complémentaires sont mappées vers des espaces latents VAE et CLIP, et les prédictions correspondantes sont combinées avant le décodage par diffusion. Le cadre est évalué sur l'ensemble des 10 sujets de THINGS-EEG2 à l'aide de mesures de reconstruction par sujet, d'analyses d'ablation et de fenêtres temporelles, ainsi que de visualisations au niveau des représentations, les cartes d'attention spatiale étant interprétées comme des analyses topographiques par canal du cuir chevelu.
Protocole
Le protocole comprend six étapes séquentielles : la préparation des essais EEG et des latents d'images ; la construction du flux structurel de graphe ; l'entraînement de l'encodeur sémantique EEG ; l'ajustement des mappages CLIP/VAE ; la fusion des prédictions latentes, suivie du décodage des images ; et l'évaluation des résultats au niveau des images et au niveau des représentations (Figure 1).
1. Préparer les essais EEG et les intégrations d'images
- Documenter la cohorte source et le protocole d'acquisition.
NOTE : La cohorte source comprenait 10 adultes en bonne santé (âge moyen de 28,5 ans, écart-type de 4,0 ; huit femmes et deux hommes) ayant une vision normale ou corrigée à la normale. Les participants ont donné leur consentement éclairé par écrit, ont reçu une rémunération monétaire et ont suivi le protocole initial approuvé par le comité d'éthique du Département de l'Éducation et de la Psychologie de la Freie Universität Berlin, conformément à la Déclaration d'Helsinki23.- Utiliser le jeu de données THINGS-EEG2 accessible au public comme ressource pour une analyse secondaire.
- Utiliser la partition source composée de 1 654 concepts d'apprentissage et de 200 concepts de test non superposés provenant de THINGS, avec des proportions équilibrées entre les partitions pour les 27 catégories de niveau supérieur. Sélectionner dix images avec fond naturel pour chaque concept d'apprentissage et une image pour chaque concept de test, afin d'obtenir 16 540 conditions d'apprentissage et 200 conditions de test distinctes.
NOTE : Dans la présente étude, la tâche de détection de cible utilisait des images spécifiques de Buzz l'Éclair exclues de l'analyse de reconstruction actuelle23. - Suivre le déroulement temporel du protocole initial de présentation visuelle en série rapide lors de l'interprétation des époques.
NOTE : Chaque séquence commençait par un intervalle vide de 750 ms, suivi de 20 images présentées au centre. Chaque image couvrait 7 degrés d'angle visuel, restait à l'écran pendant 100 ms et présentait une asynchronie de début de stimulus de 200 ms, correspondant à 5 images/s. Un second intervalle vide de 750 ms précédait une période de réponse pouvant atteindre 2 s, durant laquelle les participants clignaient d'abord des yeux puis indiquaient si une image cible était apparue. Une cible de fixation centrale en forme de cible restait visible tout au long de la séquence23. - Tenir compte de la structure initiale des sessions d'enregistrement lors de l'organisation du jeu de données. Utiliser les données provenant des quatre sessions d'enregistrement réalisées par chaque participant, chaque session comprenant quatre séries de test et 15 séries d'apprentissage d'environ 5 minutes chacune. Conserver quatre répétitions pour chaque condition d'apprentissage et 80 répétitions pour chaque condition de test, correspondant à 82 160 essais d'images non cibles analysés par participant23.
- Utiliser les données EEG acquises avec la configuration d'enregistrement THINGS-EEG2 initiale. Ces enregistrements ont été effectués à 1 000 Hz à l'aide d'un EASYCAP à 64 électrodes disposées selon le système international 10-10 et d'un amplificateur BrainVision actiCHamp, avec Fz comme référence en ligne et un filtre passe-bande en ligne de 0,1–100 Hz.
- Utiliser les données prétraitées publiées, qui ont été segmentées de -200 à 800 ms par rapport au début de l'image, corrigées par rapport à l'intervalle préstimulus, sous-échantillonnées à 100 Hz, restreintes à 17 canaux pariéto-occipitaux, débarrassées des essais cibles et soumises à une normalisation multivariée du bruit indépendamment pour chaque session d'enregistrement23.
- Préparer les tenseurs d'essais EEG
- Charger les tenseurs THINGS-EEG2 prétraités publiés pour les 10 participants. À partir de chaque époque source, sélectionner l'intervalle post-stimulus de 0 à 800 ms et les 17 canaux pariéto-occipitaux, en conservant la fréquence d'échantillonnage de 100 Hz pour obtenir 80 points temporels par essai. Préserver la partition source de 16 540 conditions d'images d'apprentissage et de 200 conditions d'images de test distinctes pour chaque participant23 (Figure 2).
- Pour le pré-entraînement du flux de graphes, conserver les quatre répétitions d'apprentissage indépendantes pour chaque condition d'image et en échantillonner deux pour former une paire positive. Pour les flux brut et sémantique, faire la moyenne des quatre répétitions d'apprentissage et faire la moyenne des 80 répétitions de test disponibles pour chaque condition.
- Utiliser les tenseurs THINGS-EEG2 prétraités produits par le pipeline MVNN initial ; au sein de chaque extracteur de caractéristiques implémenté, appliquer la normalisation Z au niveau des fichiers documentée avant le calcul des caractéristiques.
NOTE : Cette utilisation asymétrique des répétitions est intentionnelle : les essais répétés fournissent des paires positives pour le pré-entraînement contrastif du flux de graphes, tandis que les flux brut et sémantique utilisent des moyennes au niveau des conditions pour la cartographie supervisée. La conception résultante combine un apprentissage de l'invariance au niveau des répétitions dans le flux structurel avec une prédiction latente au niveau des conditions dans les flux brut et sémantique.
- Préparer les latents d'images appariées
- Utiliser l'encodeur visuel CLIP en 1 024 dimensions et l'encodeur VAE associé à sd2-community/stable-diffusion-2-1-unclip pour extraire les cibles d'images appariées. Redimensionner les images d'entrée du VAE à 768 x 768 pixels, stocker le mode a posteriori du VAE sous forme d'un vecteur de 36 864 dimensions (4 x 96 x 96) et préserver l'ordre des conditions d'images.
- Enregistrer trois formes d'entrée : les tenseurs d'essais répétés pour l'apprentissage contrastif de graphes, les tenseurs EEG moyennés pour les flux brut et sémantique, et les latents d'images CLIP/VAE appariés pour la cartographie supervisée.
- Normaliser et mettre en cache les entrées
- Mettre en cache les tenseurs EEG prétraités, les caractéristiques extraites de graphe et sémantiques, ainsi que les latents d'images appariés avec un ordre de conditions fixe.
- Lors de la cartographie par ridge, estimer les paramètres de standardisation par caractéristique à partir des entrées d'apprentissage et appliquer ces paramètres aux entrées de développement et de test.
2. Construire le flux structurel du graphe
- Construire le flux de graphes à partir d'essais d'entraînement répétés et exporter les caractéristiques au niveau des nœuds après un pré-entraînement contrastif. Utiliser la même règle de construction de graphe pour l'extraction des caractéristiques sur les données de test, sans recourir aux latents des images de test durant le calcul des caractéristiques.
- Transformer les essais EEG en entrées de graphe dans le domaine fréquentiel
- Transformer chaque essai à l’aide d’une transformée de Fourier rapide (FFT) de 80 points et conserver les 40 premières tranches de fréquences non négatives, s’étendant de 0 Hz à 48,75 Hz pour une fréquence d’échantillonnage de 100 Hz. Utiliser le spectre logarithmique d’amplitude comme matrice de caractéristiques nodales X de dimension 17 × 40. Pour chaque échantillon EEG, calculer C_ij = |corr(X_i, X_j)| entre chaque paire des 17 vecteurs de caractéristiques de canaux.
- Dans chaque ligne, conserver la corrélation diagonale (auto-corrélation) et les trois corrélations non diagonales les plus fortes (k = 4 entrées conservées, auto-corrélation incluse), puis symétriser la matrice conservée afin de définir la matrice d’adjacence fonctionnelle pondérée A propre à chaque échantillon. Appliquer une normalisation symétrique par degré avant la convolution sur graphe.
- Utiliser cette construction durant l’entraînement et le test ; les coordonnées physiques des électrodes ne sont pas utilisées pour définir un graphe fixe.
NOTE : Le fait de conserver la connectivité propre préserve le signal de chaque nœud, tandis que la limitation des connexions inter-canaux à trois par ligne contrôle la densité du graphe avant la symétrisation. La représentation dans le domaine fréquentiel fournit une description compacte basée sur l’amplitude pour la construction du graphe, mais ne préserve pas la phase ni tous les détails temporels fins liés au verrouillage de phase des potentiels évoqués ; ces aspects temporels restent disponibles dans les flux temporels bruts d’ancrage et sémantiques.
- Aggréger la topologie des électrodes par convolution spectrale sur graphe
- Appliquer un réseau de neurones à convolution sur graphe (GCN) à cinq couches24 avec 80 unités cachées par couche, des activations ReLU, un dropout de 0,3, une normalisation symétrique par degré et un regroupement (pooling) moyen sur le graphe.
- Utiliser une tête de projection à deux couches de dimension 80 pour l’objectif contrastif, et exporter la représentation nodale de dimension 17 × 80 destinée à la fusion structurelle. Appliquer la convolution spectrale sur graphe à la matrice d’adjacence dépendante de l’entrée ; ne pas introduire d’opérateur de convolution dynamique distinct.
- Entraîner le flux de graphes avec un apprentissage contrastif inter-essais
- Dans la partition d’entraînement, sélectionner aléatoirement deux répétitions provenant de la même condition d’image comme paire positive, et traiter les représentations issues d’autres conditions dans le lot comme des exemples négatifs. Optimiser l’objectif contrastif InfoNCE25 avec une température τ = 0,5, une taille de lot de 32, l’algorithme Adam avec un taux d’apprentissage de 5 × 10⁻⁴, 20 époques, un recuit en cosinus jusqu’à eta_min = 10–6, et une graine aléatoire fixée à 42.
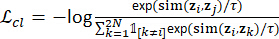 (1)
- Définir la similarité cosinus dans l’objectif contrastif et utiliser la fonction indicatrice pour identifier les répétitions appariées. Conserver la dimension de projection à 80 et appliquer la même température aux deux directions de la perte contrastive.
- Dans la partition d’entraînement, sélectionner aléatoirement deux répétitions provenant de la même condition d’image comme paire positive, et traiter les représentations issues d’autres conditions dans le lot comme des exemples négatifs. Optimiser l’objectif contrastif InfoNCE25 avec une température τ = 0,5, une taille de lot de 32, l’algorithme Adam avec un taux d’apprentissage de 5 × 10⁻⁴, 20 époques, un recuit en cosinus jusqu’à eta_min = 10–6, et une graine aléatoire fixée à 42.
- Exporter les caractéristiques nodales du graphe pour une fusion précoce
- Geler l’encodeur de graphe après le pré-entraînement et exporter les caractéristiques nodales des 17 canaux avec 80 dimensions par nœud. Concaténer ces caractéristiques avec le signal EEG brut moyenné selon la dimension des caractéristiques afin d’obtenir l’entrée structurelle brute-plus-graphe pour la transformation VAE.
- Enregistrer le tenseur de caractéristiques résultant brut-plus-graphe et l’utiliser uniquement comme entrée structurelle pour la branche de régression VAE.
3. Entraîner l'encodeur sémantique EEG
- Entraîner l'encodeur sémantique EEG sur les tenseurs EEG moyens à 17 canaux et 80 points.
- Optimiser la perte d'encodage cosinus avec AdamW (taux d'apprentissage 5 x 10⁻⁴ ; décroissance du poids 0,01), une taille de lot de 64, 50 époques, un recuit cosinus avec eta_min = 10–6, une graine aléatoire de 42 et une sortie de 1 024 dimensions.
- Appliquer un filtrage spatial adaptatif fondé sur les données
- Appliquer une opération apprenable de pondération des canaux par produit tensoriel au tenseur EEG d'entrée et étendre la représentation à une profondeur de 9. Considérer cette opération comme une couche de pondération des canaux fondée sur les données plutôt qu'une implémentation du filtre spatial classique du modèle de patron spatial commun (CSP)26.
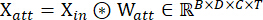 (2)
- Utiliser l'opération apprise de pondération des canaux pour produire neuf cartes de caractéristiques, puis les transmettre au bloc de convolution temporelle multi-échelle.
- Appliquer une opération apprenable de pondération des canaux par produit tensoriel au tenseur EEG d'entrée et étendre la représentation à une profondeur de 9. Considérer cette opération comme une couche de pondération des canaux fondée sur les données plutôt qu'une implémentation du filtre spatial classique du modèle de patron spatial commun (CSP)26.
- Modéliser les champs réceptifs temporels à plusieurs échelles
- Appliquer trois convolutions temporelles parallèles avec des tailles de noyau de 5, 15 et 31 échantillons, en utilisant un remplissage de même longueur. Concaténer les trois sorties pour obtenir 24 canaux de caractéristiques temporelles et appliquer une normalisation par lot et une activation GELU.
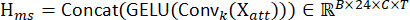 (3)
REMARQUE : Les convolutions fournissent des champs réceptifs temporels multi-échelle dans le cadre plus large de la modélisation convolutionnelle temporelle27. - Utiliser les trois tailles de noyau comme filtres temporels multi-échelle ; interpréter leurs sorties comme des représentations de signaux apprises plutôt que comme des attributions directes à des composantes spécifiques du potentiel évoqué lié à l'événement (ERP).
- Appliquer trois convolutions temporelles parallèles avec des tailles de noyau de 5, 15 et 31 échantillons, en utilisant un remplissage de même longueur. Concaténer les trois sorties pour obtenir 24 canaux de caractéristiques temporelles et appliquer une normalisation par lot et une activation GELU.
- Recalibrer les canaux de caractéristiques pertinents à la tâche
- Appliquer une attention en profondeur avec un regroupement moyen adaptatif sur la dimension temporelle et une convolution à noyau 7 suivie d'une normalisation Softmax, conforme aux principes de recalibrage des canaux28. Multiplier élément par élément les poids d'attention obtenus avec le tenseur de caractéristiques multi-échelle.
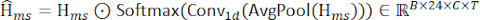 (4)
- Utiliser la sortie d'attention comme entrée du bloc de convolution spatiale et ne pas interpréter les poids appris comme une localisation neuronale causale.
- Appliquer une attention en profondeur avec un regroupement moyen adaptatif sur la dimension temporelle et une convolution à noyau 7 suivie d'une normalisation Softmax, conforme aux principes de recalibrage des canaux28. Multiplier élément par élément les poids d'attention obtenus avec le tenseur de caractéristiques multi-échelle.
- Exporter la caractéristique sémantique EEG globale
- Appliquer une convolution 1 x 1 suivie d'une convolution par profondeur couvrant les 17 canaux d'électrodes, une normalisation par lot, une activation GELU, un regroupement moyen avec un facteur de 2 et une désactivation avec p = 0,5. Aplatir le résultat et le projeter vers un vecteur de caractéristiques sémantiques de 1 024 dimensions.
- Enregistrer un vecteur de caractéristiques sémantiques de 1 024 dimensions pour chaque échantillon EEG moyenné.
4. Cartographier les caractéristiques de l'EEG vers les espaces latents CLIP et VAE
- Associer chaque tenseur de caractéristiques EEG à la représentation latente de l'image ayant le même indice de condition. Ajuster des mappings séparés pour les cibles CLIP et VAE, et maintenir toutes les conditions d'image dans la partition d'apprentissage disjointes de celles présentes dans la partition de test réservée.
- Ajuster une régression ridge29 avec un terme constant et un maximum de 50 000 itérations. Utiliser λCLIP = 1 000 pour les mappings brut-vers-CLIP et sémantique-vers-CLIP, λVAE = 0 pour l'ancrage brut-vers-VAE, et λVAE, struct = 1 000 pour le mapping flux-structurel-vers-VAE. Standardiser les entrées du mapping à l’aide des statistiques de la partition d’apprentissage.
NOTE : Le flux structurel correspond à la concaténation des caractéristiques EEG brutes et des caractéristiques de graphe ; le flux sémantique contient la sortie du codeur sémantique sans concaténation de caractéristiques brutes. - Mapper les caractéristiques structurelles vers l'espace latent VAE
- Ajuster le mapping ridge flux-structurel-vers-VAE avec λVAE,struct = 1 000 et prédire la représentation latente VAE en 36 864 dimensions. Cette branche reçoit les représentations concaténées d'EEG brut et de graphe ; c'est la seule branche non linéaire qui concatène explicitement des caractéristiques brutes.
- Mapper les caractéristiques sémantiques vers l'espace latent CLIP
- Ajuster le mapping ridge flux-sémantique-vers-CLIP avec λCLIP = 1 000 et prédire la représentation CLIP en 1 024 dimensions. L'entrée sémantique n'est pas concaténée avec l'EEG brut.
NOTE : Dans cet article, λ désigne la régularisation ridge et α désigne un poids de fusion latente. - Évaluer l'alignement dans l'espace latent à l’aide du coefficient de corrélation de Pearson (PCC) calculé échantillon par échantillon. Utiliser les conditions de développement pour la sélection du poids de fusion, et évaluer les 200 conditions de test réservées uniquement après que les mappings et les poids de fusion ont été figés.
- Ajuster le mapping ridge flux-sémantique-vers-CLIP avec λCLIP = 1 000 et prédire la représentation CLIP en 1 024 dimensions. L'entrée sémantique n'est pas concaténée avec l'EEG brut.
5. Fusionner les prédictions latentes et exécuter la reconstruction par diffusion
- Sélectionnez αVAE et αCLIP à l’aide d’une répartition par condition dérivée uniquement des 16 540 conditions d’entraînement. Avec la graine aléatoire 42, utilisez les mêmes indices d’ajustement (90 %) et indices de développement (10 %) pour les 10 sujets ; les 200 conditions de test réservées restent en dehors de cette procédure.
NOTE : Les pénalités ridge et le coefficient de préservation structurelle ont été fixés comme valeurs de configuration avant l’évaluation finale sur l’ensemble réservé et n’ont pas été ajustés sur les 200 conditions de test. - Pour chaque sujet et chaque valeur candidate d’α dans {0,00 ; 0,05 ; ... ; 1,00}, ajustez l’encodeur supervisé par cible et les mappings ridge sur le sous-ensemble d’ajustement, puis calculez la corrélation intra-échantillon moyenne (PCC) dans l’espace latent sur le sous-ensemble de développement.
- Moyenne pondérée de façon égale les valeurs de PCC par sujet parmi les 10 sujets, puis sélectionnez indépendamment les poids dans l’espace CLIP et l’espace VAE selon la moyenne maximale entre sujets. Fixez les deux valeurs avant de réajuster les modèles d’entraînement finaux et d’évaluer les conditions de test réservées.
NOTE : Cette procédure a sélectionné αCLIP = 0,55 et αVAE = 0,65. - Pour l’espace VAE, définissez la prédiction fusionnée comme la somme pondérée de l’ancrage brut-vers-VAE et de la prédiction VAE du flux structurel :
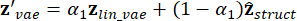 (5)
- Fixez αVAE = 0,65, de sorte que l’ancrage brut-vers-VAE contribue à hauteur de 0,65 et que la prédiction du flux structurel contribue à hauteur de 0,35. Conservez cette valeur fixe pour chaque sujet et chaque condition de test.
- Pour l’espace CLIP, définissez la prédiction fusionnée comme la somme pondérée de l’ancrage brut-vers-CLIP et de la prédiction CLIP du flux sémantique :
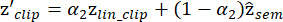 (6)
- Fixez αCLIP = 0,55, de sorte que l’ancrage brut-vers-CLIP contribue à hauteur de 0,55 et que la prédiction du flux sémantique contribue à hauteur de 0,45. Conservez cette valeur fixe pour chaque sujet et chaque condition de test.
NOTE : Interprétez l’opération de fusion comme un ensemble pondéré fixe de prédictions latentes, au sens général de la combinaison d’ensembles30. Ne la décrivez pas comme une réduction garantie du surapprentissage ni comme une solution uniformément optimale pour tous les indicateurs. - Chargez le pipeline figé Stable UnCLIP d’image-à-image depuis sd2-community/stable-diffusion-2-1-unclip avec les poids de variation en fp16. Utilisez l’embedding CLIP fusionné comme condition sémantique et le latent VAE fusionné comme initialisation structurelle.
NOTE : Le décodeur suit les principes de diffusion avec suppression de bruit et de guidance sans classificateur31,32. - Appliquez une initialisation structurelle bruitée aux latents de diffusion. Reformez chaque prédiction VAE en 36 864 dimensions en un tenseur 4 × 96 × 96, conformément à la formulation latente de l’auto-encodeur variationnel33, puis ajoutez un bruit gaussien après avoir multiplié le latent structurel par le coefficient d’échelle structurelle gamma = 0,02. Utilisez T_diff = 1 000 pas temporels d’entraînement de diffusion et une graine de diffusion fixe à 0 pour la procédure de reconstruction rapportée.
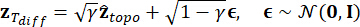 (7)
- Fixez le coefficient de préservation structurelle gamma à 0,02 lors de l’initialisation bruitée et conservez cette valeur constante pour toutes les conditions de test. Transmettez le latent résultant au décodeur sans utiliser d’information provenant de l’image réelle.
- Appliquez la guidance par attention croisée et décodez le latent image. Concaténez le vecteur CLIP fusionné de 1 024 dimensions avec l’extension de conditionnement de 1 024 dimensions utilisée par le pipeline, ajoutez un vecteur de condition négative nul pour la guidance sans classificateur (CFG), puis décodez avec une échelle de guidance de 7,5. Utilisez la valeur par défaut du pipeline de 20 étapes de suppression de bruit et enregistrez une image PNG par condition de test.
- Enregistrez l’image reconstruite avec l’index original de la condition de test et conservez le même index pour tous les calculs ultérieurs d’indicateurs.
NOTE : Tableau 1 résume le partitionnement des données, le prétraitement, la construction du graphe, l’entraînement du modèle, le mapping latent, la fusion et les paramètres de décodage utilisés dans le flux de travail rapporté. La feuille de calcul jointe fournit le même résumé de paramètres dans un format lisible par machine.
6. Évaluer la reconstruction et l'alignement au niveau de la représentation
- Calculer la fidélité de bas niveau à l'aide de la corrélation entre pixels (PixCorr) et de la similarité structurelle (SSIM). Calculer les précisions d'identification par paires pour AlexNet Couche 2, AlexNet Couche 5, Inception-v3 et OpenAI CLIP ViT-L/14 ; calculer les distances de corrélation pour EfficientNet (EffNet) et SwAV, pour lesquelles des valeurs plus faibles indiquent des représentations de caractéristiques plus proches.
- Pour l'analyse CLIP, former la matrice de corrélation entre les caractéristiques extraites à partir de 200 images reconstruites et les 200 images réelles correspondantes. Pour chaque reconstruction, comparer la corrélation avec l'image correcte à celles obtenues avec les 199 autres images, puis faire la moyenne des 200 × 199 comparaisons binaires résultantes afin d'obtenir la précision d'identification par paires CLIP.
- Pour des fenêtres glissantes s'étendant jusqu'aux points temporels 8, 16, ..., 80, ajuster les modèles de prédiction EEG bruts par ridge regression et calculer le coefficient de corrélation de Pearson (PCC) moyen par échantillon entre les latents prédits et les latents réels de CLIP et de VAE, sur les 200 conditions de test du sujet sub-01. Utiliser les prédictions CLIP et VAE basées uniquement sur le flux sémantique sur la fenêtre complète comme niveaux de référence en pointillés.
- Construire des matrices de similarité des représentations (RSM) à partir des caractéristiques CLIP normalisées en L2, en utilisant la similarité cosinus. Ordonner les deux matrices selon un regroupement hiérarchique de type Ward appliqué aux intégrations CLIP réelles, en utilisant la distance euclidienne.
- Pour la visualisation en deux dimensions, dériver cinq groupes par k-means à partir des intégrations réelles, puis appliquer une projection conjointe PCA-50 suivie d'un t-SNE (t-distributed stochastic neighbor embedding) aux caractéristiques réelles et prédites ; utiliser le t-SNE uniquement à des fins de visualisation qualitative.
- Visualiser les motifs EEG blanchis et les poids du modèle par canal du scalp avec des canaux étiquetés, des échelles de couleurs explicites et des règles d'ordonnancement reproductibles. Interpréter ces graphiques comme des analyses auxiliaires des signaux mesurés au niveau du scalp et des paramètres du modèle, et non comme une preuve de localisation corticale des sources, d'activation anatomique ou de causalité.
Résultats
TDE-Net a été évalué selon six perspectives complémentaires : la performance de reconstruction, les résultats visuels représentatifs, la contribution des composants, la dépendance temporelle, la structure représentationnelle sémantique et l'attention aux canaux du scalp. La fidélité de bas niveau a été évaluée à l'aide de PixCorr et de SSIM, l'alignement dans l'espace des caractéristiques à l'aide des mesures AlexNet, Inception-v3, CLIP, EffNet et SwAV, et la performance au niveau des sujets à partir des résultats des 10 sujets de THINGS-EEG2. Sauf indication contraire, chaque figure qualitative identifie le sujet correspondant et le sous-ensemble de condition de test.
Performance de la reconstruction et résultats représentatifs
Comme modèle de référence interne, nous avons en outre mis en œuvre une ligne de base légère d'encodeur EEG à convolution et à attention. Ce modèle extrait une unique représentation EEG de 1024 dimensions à partir de chaque essai et la projette indépendamment dans les espaces latents CLIP et VAE, en utilisant le même protocole de régression ridge et de décodage par diffusion que la méthode proposée. Dans les sections suivantes, ce modèle est désigné sous le nom de Baseline. L'encodeur correspond à la référence sémantique à convolution et à attention de type LMDA utilisée dans l'implémentation locale, comportant 373 950 paramètres entraînables et une sortie de 1 024 dimensions.
Tableau 2 compare TDE-Net avec le modèle de référence interne à convolution-attention et des méthodes représentatives de reconstruction d'images basées sur l'EEG selon les métriques indiquées. Pour une évaluation cohérente, les méthodes ont été mises en œuvre dans un cadre expérimental unifié utilisant la même partition THINGS-EEG2, une entrée de 17 canaux, un prétraitement identique, des conditions de test réservées, et des définitions de métriques identiques, tout en conservant leurs architectures spécifiques à chaque méthode. Dans le résumé portant sur dix sujets, TDE-Net a atteint des valeurs moyennes ± écart-type de 0,2531 ± 0,0138 pour le PixCorr, de 0,3388 ± 0,0025 pour le SSIM, de 0,8777 ± 0,0115 pour la couche 2 d'AlexNet, de 0,9153 ± 0,0116 pour la couche 5 d'AlexNet, de 0,7606 ± 0,0213 pour Inception-v3, de 0,8135 ± 0,0074 pour la précision d'identification par paire CLIP, de 0,8285 ± 0,0122 pour la distance EffNet, et de 0,5085 ± 0,0101 pour la distance SwAV. Le résumé par sujet complète les exemples qualitatifs obtenus chez un seul sujet.
La valeur CLIP indique la précision d'identification par paire, plutôt que la similarité cosinus ou un score générique de caractéristique CLIP. Étant donné que le flux sémantique est entraîné vers une cible dans l'espace CLIP, cette mesure reflète à la fois la reconstruction sémantique et l'alignement sur une cible de branche. Elle est donc examinée conjointement avec PixCorr, SSIM, AlexNet, Inception-v3, EffNet et SwAV, qui caractérisent des aspects complémentaires de la fidélité de bas niveau et de l'accord dans l'espace des caractéristiques.
Pour caractériser les performances au niveau des sujets, nous avons appliqué la procédure complète de test TDE-Net aux sujets sub-01 à sub-10, en utilisant les mêmes 200 conditions d'images mises de côté pour chaque sujet. Tableau 3 présente les huit mesures d'évaluation pour chaque sujet, ainsi que la moyenne et l'écart-type (SD) inter-sujets. La précision moyenne d'identification par paire CLIP était de 0,8135 (SD, 0,0074). Les valeurs moyennes de PixCorr et de SSIM étaient respectivement de 0,2531 et 0,3388. Les précisions moyennes des couches 2 et 5 d'AlexNet étaient de 0,8777 et 0,9153, et celle d'Inception-v3 était en moyenne de 0,7606. Les distances EffNet et SwAV, pour lesquelles des valeurs plus faibles sont préférables, étaient en moyenne de 0,8285 et 0,5085 respectivement. La faible dispersion inter-sujets observée pour ces mesures indique un comportement quantitatif comparable en matière de reconstruction parmi les 10 sujets de THINGS-EEG2.
Figure 3 présente des reconstructions pour les sept indices de condition exclus (1, 32, 62, 86, 87, 108 et 175 ; numérotation des fichiers à partir de zéro) chez les 10 sujets. La première ligne montre les stimuli réels, et les lignes suivantes affichent les reconstructions correspondantes pour les sujets sub-01 à sub-10. Les reconstructions conservent les catégories sémantiques communes et les attributs visuels caractéristiques des stimuli, tandis que l'identité fine des objets, leur forme et leur texture locale varient selon les sujets. Cette disposition fournit un complément qualitatif aux résultats intersujets résumés dans Tableau 3.
Figure 4 présente des reconstructions qualitatives pour six conditions de test sub-01 spécifiées. Les lignes montrent le stimulus réel, un comparateur Perceptogram généré par notre implémentation locale21, et la reconstruction obtenue par TDE-Net. Les exemples mettent en évidence le maintien des attributs de catégorie d'objet, de forme, de couleur et de fond, tandis que les détails d'identité fine et du fond varient selon les méthodes.
Figure supplémentaire 1 présente les groupes de meilleures, médianes et pires reconstructions sélectionnés parmi les 200 conditions de test sub-01 dans THINGS-EEG223. Les conditions sont classées selon l'accord cosinus entre l'incorporation CLIP prédite par EEG fusionnée figée et l'incorporation CLIP de l'image de référence correspondante. Les groupes affichés illustrent la gamme d'accord sémantique observée pour ce sujet.
Contribution des composants et comportement de fusion
Tableau 4 présente une ablation progressive des flux structurel et sémantique, basée sur les valeurs moyennes inter-sujets obtenues selon la même procédure d'évaluation. L'ancrage linéaire prédit directement les latents CLIP et VAE à partir des données EEG prétraitées en utilisant une régression ridge, et sert de point de départ contrôlé pour l'étude d'ablation. Il suit le principe linéaire général de cartographie latente utilisé dans les études antérieures de type EEG-vers-image, notamment Perceptogram21, tout en adoptant le prétraitement, la régularisation, le décodage et les paramètres d'évaluation du pipeline actuel. Cette conception permet d'analyser le flux structurel, le flux sémantique et la fusion dans les deux espaces par rapport à une référence linéaire commune.
À partir de l'ancrage linéaire, l'ajout du flux structural a augmenté le SSIM de 0,331 à 0,339 et la précision de la couche 5 d'AlexNet de 0,913 à 0,932, bien que la précision de la couche 2 d'AlexNet ait légèrement diminué, passant de 0,889 à 0,886. L'ajout du flux sémantique à la place a produit la valeur PixCorr la plus élevée (0,237), tout en maintenant une précision élevée pour la couche 2 d'AlexNet (0,888) et en réduisant les distances EffNet et SwAV à 0,865 et 0,531 respectivement. Lorsque les deux flux ont été intégrés par fusion dans un espace dual, TDE-Net a atteint les précisions d'identification par paire les plus élevées pour Inception-v3 (0,761) et CLIP (0,814), ainsi que les distances EffNet (0,829) et SwAV (0,509) les plus faibles. Sa précision pour la couche 2 d'AlexNet (0,878) est restée inférieure à celle de l'ancrage linéaire, et son SSIM (0,339) est resté légèrement inférieur à celui de la configuration avec flux structural. Dans l'ensemble, les résultats d'ablation intersujets montrent que les flux structural et sémantique influencent différents aspects de la reconstruction, tandis que leur fusion renforce principalement l'identification sémantique et la cohérence dans l'espace profond des caractéristiques.
Figure 5 montre la sensibilité de l'ensemble de développement aux deux poids de fusion sur l'intervalle α = 0,00–1,00 par incréments de 0,05. La courbe dans l'espace CLIP atteint son maximum pour αCLIP = 0,55, tandis que la courbe dans l'espace VAE atteint son maximum pour αVAE = 0,65. Des valeurs de PCC similaires ont été observées pour les candidats voisins, tandis que les maxima apparaissent à des poids différents pour les deux espaces latents.
Contribution temporelle des signaux EEG
Figure 6 montre la corrélation intra-classe latente moyenne par condition pour les fenêtres EEG brutes se terminant à 8, 16, ..., 80 points temporels chez le sujet-01 (n = 200 conditions de test). Les courbes CLIP et VAE augmentent lorsque la fenêtre d'analyse s'élargit et atteignent un plateau dans les fenêtres ultérieures. Les lignes en pointillés indiquent les valeurs de référence correspondantes obtenues avec le flux sémantique uniquement sur la fenêtre complète. Cette analyse caractérise la dépendance à la fenêtre temporelle selon le protocole de cartographie rapporté.
Alignement sémantique et analyse au niveau des représentations
Figure 7 compare les coefficients de corrélation de Pearson (PCC) latents au niveau des échantillons pour l'ancrage CLIP brut et la prédiction CLIP fusionnée figée, sur 200 conditions de test sub-01. Les estimations de densité par noyau gaussien utilisent la largeur de bande de Scott, et les lignes pointillées verticales indiquent les moyennes des échantillons. La distribution fusionnée présente une augmentation moyenne du PCC d'environ 0,013 par rapport à l'ancrage brut. La précision d'identification par paire au niveau des images selon CLIP est indiquée séparément dans Tableau 2.
Figure 8 compare les matrices de similarité cosinus (RSM) pour les intégrations CLIP issues des images de référence et celles prédites par EEG fusionnées. Les deux matrices partagent une même plage de données et un ordonnancement Ward dérivé des distances euclidiennes entre les intégrations CLIP de référence. Le panneau des résidus montre la différence entre la RSM prédite et la RSM de référence, sur une échelle symétrique définie par le résidu absolu maximal, offrant ainsi une visualisation de l'accord représentationnel.
Figure supplémentaire 2 présente une projection conjointe de 200 intégrations réelles (ground-truth) et de 200 intégrations prédites par EEG issues de CLIP. Cinq étiquettes sont obtenues par regroupement k-means des intégrations réelles normalisées selon la norme L2 (n_init = 50 ; seed = 7). Les caractéristiques réelles et prédites concaténées sont réduites à 50 dimensions par ACP, puis projetées conjointement par t-SNE avec une perplexité de 28, une distance euclidienne et un seed de 12. Cette projection offre une vue qualitative de l'organisation des deux ensembles de représentations.
Motif EEG et interprétabilité de l'attention spatiale
Figure supplémentaire 3 regroupe les concepts testés en trois catégories — Animaux, Concepts liés aux aliments/plantes et Autres objets — à l’aide d’une correspondance explicite entre concepts et étiquettes. Au sein de chaque groupe, les lignes sont ordonnées selon un regroupement de Ward appliqué aux vecteurs intégrés CLIP normalisés en blanchissant les données de référence, puis échantillonnées de manière uniforme pour inclure au maximum 30 concepts, afin d’en améliorer la lisibilité. La carte thermique affiche les amplitudes EEG normalisées et tronquées, après blanchiment, sur une échelle allant de -1 à 1 ; les vecteurs intégrés CLIP sont utilisés uniquement pour déterminer l’ordre des concepts au sein de chaque groupe.
Figure supplémentaire 4 affiche une topographie standard du cuir chevelu 10–20 des poids normalisés absolus des canaux du flux sémantique sur les 17 électrodes sélectionnées. La carte résume le poids relatif du modèle à travers les canaux mesurés du cuir chevelu et est interprétée comme une visualisation, au niveau des canaux, des poids du modèle.
Cette étude constitue une analyse computationnelle secondaire du jeu de données THINGS-EEG2 anonymisé. Les enregistrements EEG sources, les tableaux EEG prétraités, les métadonnées et images des stimuli, ainsi que les fichiers d’état de repos sont accessibles via le projet THINGS-EEG2 à l’adresse https://osf.io/3jk45/ et sur Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). Les logiciels originaux d’acquisition et de prétraitement sont disponibles à l’adresse https://github.com/gifale95/eeg_encoding. L’accès et la réutilisation des données EEG et des images des stimuli sont soumis aux licences et aux exigences d’attribution spécifiées par les dépôts sources.
L'implémentation de TDE-Net, incluant les scripts d'alignement, de fusion, de reconstruction, d'évaluation et de visualisation, est disponible à l'adresse suivante : https://github.com/Yuan-ui198/TDE-Net. La version correspondant à cet article est figée au commit c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). Aucune nouvelle donnée identifiable de participant n'a été recueillie pour la présente étude.
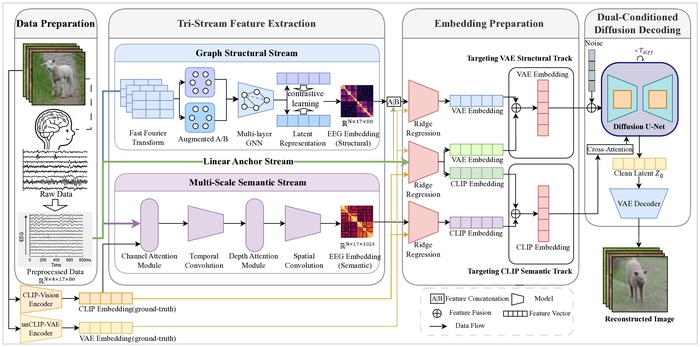
Figure 1 : Schéma du TDE-Net. Le diagramme montre l'ancre EEG brute, le flux de graphe fonctionnel spécifique à l'échantillon, le flux temporel sémantique, la cartographie dans l'espace dual vers le VAE et le CLIP, la fusion pondérée et le décodage Stable UnCLIP à double conditionnement. Les dimensions des tenseurs sont indiquées lorsqu'elles sont applicables. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
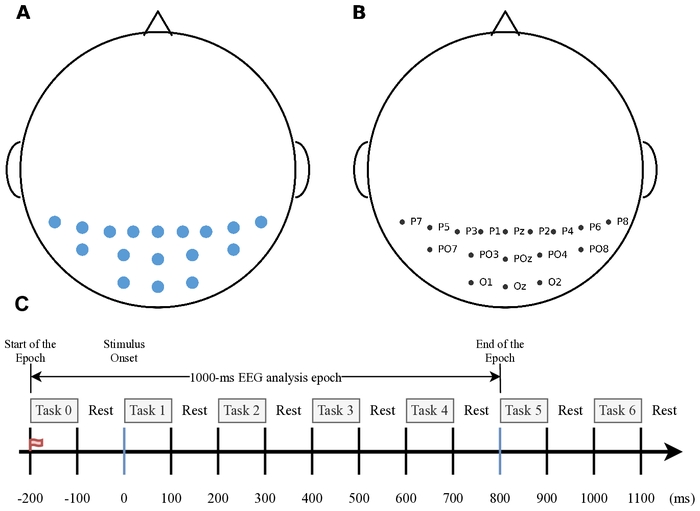
Figure 2 : Sélection des électrodes EEG et chronologie expérimentale. (A) Distribution spatiale des 17 électrodes pariéto-occipitales sélectionnées parmi les 64 canaux initialement enregistrés. (B) Désignation des électrodes : Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6 et P2. (C) Schéma du déroulement de la présentation en cascade (RSVP) et définition de l'époque EEG. Sur le schéma, « Tâche » indique un intervalle de présentation d'image, tandis que « Repos » indique l'intervalle inter-images ; les blocs numérotés « Tâche » représentent des intervalles de présentation successifs et non des conditions expérimentales différentes. Chaque image était présentée pendant 100 ms avec un asynchronisme de début de stimulus de 200 ms. L'époque EEG s'étendait de -200 à 800 ms par rapport au début du stimulus, correspondant à une époque d'analyse EEG de 1000 ms. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
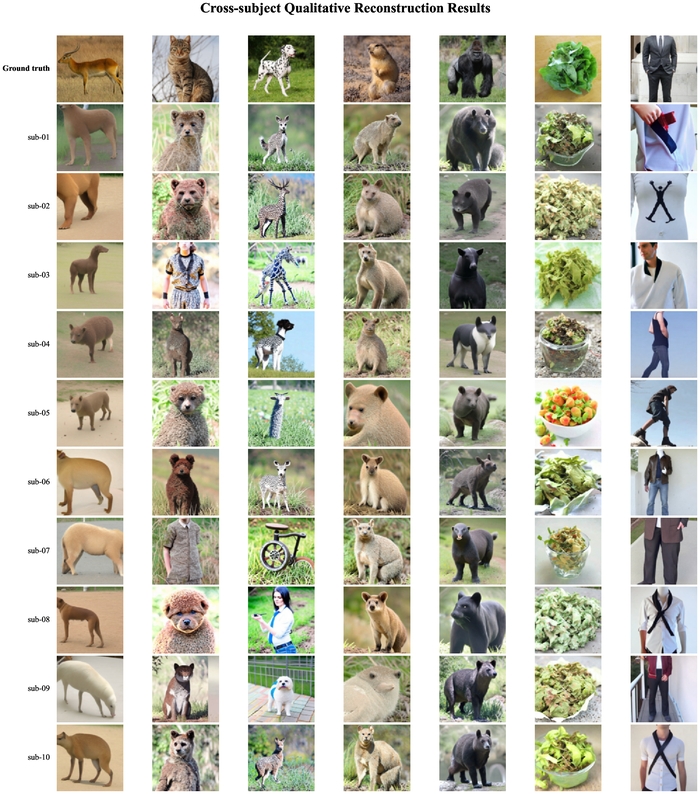
Figure 3 : Résultats qualitatifs de reconstruction inter-sujets pour sept conditions d'images exclues. Les mêmes indices de condition (1, 32, 62, 86, 87, 108 et 175) sont utilisés pour les sujets sub-01 à sub-10. La première ligne montre les échantillons d'images réelles correspondants provenant du jeu de test THINGS-EEG2, dont les images ont été extraites de la base de données d'images THINGS34, tandis que les lignes suivantes montrent les reconstructions obtenues avec TDE-Net pour chaque sujet. Cette figure illustre le contenu sémantique commun ainsi que les variations propres à chaque sujet ; les résultats quantitatifs inter-sujets sont présentés dans le Tableau 3. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
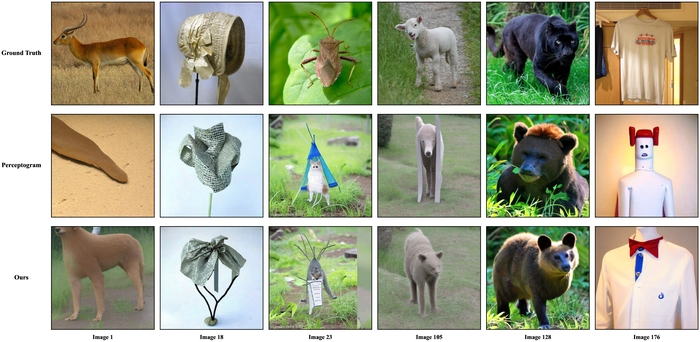
Figure 4 : Comparaison de reconstructions qualitatives pour six conditions de test sub-01 spécifiées. Les lignes montrent le stimulus de référence, une reconstruction comparative produite par l'implémentation locale et la reconstruction obtenue avec TDE-Net ; les colonnes correspondent aux indices individuels des conditions. Les échantillons d'images de référence ont été extraits de la base d'images THINGS34. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
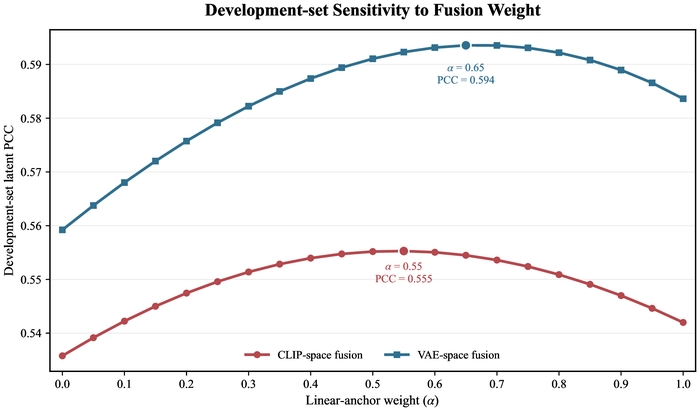
Figure 5 : Sensibilité des poids de fusion latente sur l'ensemble de développement. L'axe horizontal indique le poids linéaire d'ancrage α, le poids du flux complémentaire étant 1 - α, et l'axe vertical indique le coefficient de corrélation de Pearson (PCC) latent sur l'ensemble de développement. Les valeurs candidates varient de 0,00 à 1,00 par incréments de 0,05. Les poids dans l'espace CLIP et dans l'espace VAE sont choisis indépendamment selon la moyenne maximale de PCC par sujet, pondérée équitablement, calculée sur 10 sujets, conduisant à αCLIP = 0,55 et αVAE = 0,65. PCC, coefficient de corrélation de Pearson. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
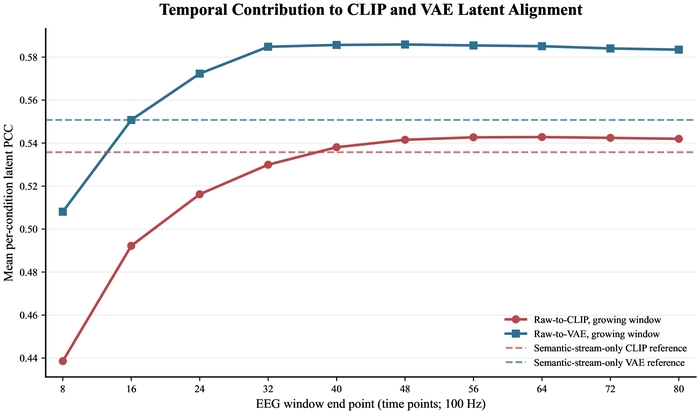
Figure 6 : Analyse temporelle de l'alignement latent chez le sujet 01 (n = 200 conditions exclues). Les courbes continues montrent la moyenne des coefficients de corrélation de Pearson (PCC) par échantillon pour les prédictions au moyen de ridge, allant du signal brut à CLIP et du signal brut à VAE, lorsque l'extrémité de la fenêtre EEG s'étend de 8 à 80 points temporels à 100 Hz. Les lignes en pointillés indiquent les valeurs de référence correspondant aux seuls flux sémantiques CLIP et VAE sur toute la fenêtre. PCC, coefficient de corrélation de Pearson. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
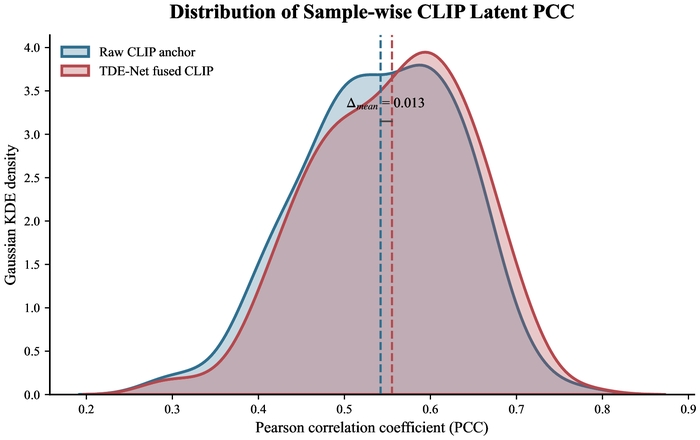
Figure 7 : Répartition de l'alignement latent selon les échantillons chez le sujet sub-01 (n = 200 conditions exclues). Les courbes représentent des estimations de densité par noyau gaussien avec une largeur de bande selon Scott pour l'ancrage CLIP brut et la prédiction CLIP issue du réseau TDE-Net figé. Les lignes pointillées verticales indiquent les moyennes par échantillon, et l'annotation précise leur différence. PCC, coefficient de corrélation de Pearson ; KDE, estimation de densité par noyau. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
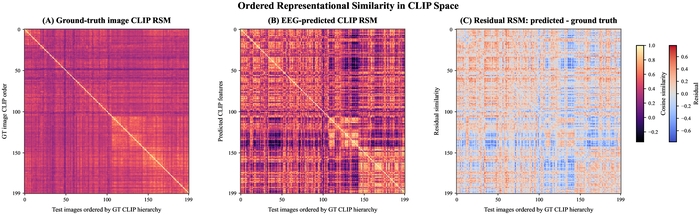
Figure 8 : Similarité représentationnelle ordonnée dans l'espace CLIP pour le sujet sub-01 (n = 200 conditions exclues). (A) Matrice de similarité par cosinus (RSM) des intégrations CLIP normalisées L2 d'images de référence. (B) Matrice de similarité par cosinus (RSM) des intégrations CLIP prédites par EEG fusionnées, affichée avec le même ordre et la même échelle de couleur que le panneau A. (C) Matrice de similarité résiduelle, calculée comme la différence entre prédiction et référence, affichée sur une échelle symétrique définie par le résidu absolu maximal. L'ordre est obtenu par distance euclidienne et liaison Ward des intégrations CLIP de référence. RSM, matrice de similarité représentationnelle. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Composant | Paramètre | Réglage |
| Données et prétraitement | Répartition du jeu de données | 16 540 conditions d'entraînement et 200 conditions de test réservées ; répartition ajustement/développement 90 %/10 % (graine 42) |
| Entrée EEG | 17 canaux pariéto-occipitaux ; 0-800 ms ; 100 Hz ; 80 points temporels | |
| Représentation spectrale | FFT à 80 points ; 40 bins de fréquences positives ; spectre d'amplitude logarithmique 0-50 Hz | |
| Flux structurel | Construction du graphe | Corrélation de Pearson absolue spécifique à l'échantillon ; k plus proches voisins pondérés = 4 par nœud ; symétrisation et boucles réflexives |
| Architecture GCN | 5 couches ; 80 unités cachées ; ReLU ; dropout 0,3 ; normalisation par degré symétrique ; moyennage (mean pooling) | |
| Objectif contrastif | Couche de projection de dimension 80 ; température InfoNCE τ = 0,5 | |
| Entraînement | Adam ; taux d'apprentissage 5 × 10⁻⁴ ; taille de lot 32 ; 20 époques ; recuit cosinus ; taux d'apprentissage minimal 10⁻⁶ ; graine 42 | |
| Flux sémantique | Architecture | Kernel temporels 5/15/31 ; profondeur 9 ; 24 canaux de caractéristiques ; dropout 0,5 ; dimension de sortie 1 024 |
| Entraînement | AdamW ; taux d'apprentissage 5 × 10⁻⁴ ; décroissance du poids 0,01 ; taille de lot 64 ; 50 époques ; recuit cosinus ; taux d'apprentissage minimal 10⁻⁶ ; graine 42 | |
| Cartographie latente | Régression ridge | Terme constant ajusté ; nombre maximal d'itérations 50 000 ; entrées standardisées à l'aide des statistiques de la partition d'ajustement |
| Régularisation | Pénalité CLIP λ = 1 000 ; pénalité VAE brute λ = 0 ; pénalité VAE structurelle λ = 1 000 | |
| Dimensions cibles | CLIP : 1 024 ; VAE : 36 864 | |
| Fusion et décodage | Poids de fusion | Poids d'ancrage CLIP α = 0,55 ; poids d'ancrage VAE α = 0,65 ; sélectionnés sur les données de développement et fixés avant les tests |
| Modèle de diffusion | sd2-community/stable-diffusion-2-1-unclip ; échelle structurelle γ = 0,02 ; pas de diffusion T = 1 000 | |
| Échantillonnage | 20 étapes de débruitage ; échelle de guidage 7,5 ; graine de diffusion 0 |
Tableau 1 : Résumé consolidé des paramètres pour TDE-Net. Ce tableau présente la répartition des données, le prétraitement, la construction de la matrice d'adjacence fonctionnelle, les paramètres des encodeurs graphique et sémantique, les pénalités de mappage latent, les poids de fusion et les paramètres de décodage par diffusion utilisés dans toutes les expériences rapportées.
| Méthode | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Référence | 0,141 | 0,321 | 0,823 | 0,878 | 0,704 | 0,739 | 0,898 | 0,564 |
| EEGImageDecode | - | 0,345 | 0,776 | 0,866 | 0,734 | 0,786 | - | 0,582 |
| Perceptogram (unCLIP) | 0,223 | 0,370 | 0,875 | 0,915 | 0,749 | 0,806 | 0,870 | 0,530 |
| TDE-Net (nôtre) | 0,253 ± 0,014 | 0,339 ± 0,003 | 0,878 ± 0,012 | 0,915 ± 0,012 | 0,761 ± 0,021 | 0,814 ± 0,007 | 0,829 ± 0,012 | 0,509 ± 0,010 |
Tableau 2 : Résultats quantitatifs de la reconstruction. Les méthodes comparatives, le modèle de base avec convolution interne et attention, ainsi que TDE-Net ont été évalués dans un cadre expérimental commun utilisant la même partition THINGS-EEG2, une entrée de 17 canaux, le même prétraitement, les mêmes conditions de test réservées et les mêmes définitions de métriques, tout en conservant les architectures spécifiques à chaque méthode. Le modèle actuel est résumé par la moyenne ± écart-type (SD) sur 10 sujets. PixCorr, SSIM, AlexNet couche 2, AlexNet couche 5, Inception-v3 et CLIP sont des mesures où une valeur plus élevée est préférable ; EffNet et SwAV sont des distances de corrélation, pour lesquelles une valeur plus faible est préférable. La colonne CLIP indique la précision d'identification par paire à l'aide du modèle OpenAI CLIP ViT-L/14.
| Sujet | PixCorr | SSIM | AlexNet L2 | AlexNet L5 | Inception | CLIP | EffNet | SwAV |
| sub-01 | 0,2260 | 0,3361 | 0,8831 | 0,9203 | 0,7533 | 0,8120 | 0,8567 | 0,5285 |
| sub-02 | 0,2488 | 0,3378 | 0,8699 | 0,9053 | 0,7268 | 0,8074 | 0,8335 | 0,5167 |
| sub-03 | 0,2564 | 0,3397 | 0,8728 | 0,9070 | 0,7658 | 0,8143 | 0,8268 | 0,5096 |
| sub-04 | 0,2420 | 0,3356 | 0,8598 | 0,9034 | 0,7854 | 0,8112 | 0,8255 | 0,5091 |
| sub-05 | 0,2499 | 0,3385 | 0,8760 | 0,8963 | 0,7251 | 0,8016 | 0,8394 | 0,5189 |
| sub-06 | 0,2621 | 0,3395 | 0,8910 | 0,9331 | 0,7818 | 0,8215 | 0,8202 | 0,5009 |
| sub-07 | 0,2489 | 0,3378 | 0,8643 | 0,9185 | 0,7704 | 0,8200 | 0,8222 | 0,5017 |
| sub-08 | 0,2786 | 0,3425 | 0,8951 | 0,9216 | 0,7524 | 0,8245 | 0,8214 | 0,5010 |
| sub-09 | 0,2609 | 0,3370 | 0,8775 | 0,9238 | 0,7662 | 0,8055 | 0,8250 | 0,5009 |
| sub-10 | 0,2571 | 0,3433 | 0,8871 | 0,9240 | 0,7792 | 0,8175 | 0,8140 | 0,4977 |
| Moyenne | 0,2531 | 0,3388 | 0,8777 | 0,9153 | 0,7606 | 0,8135 | 0,8285 | 0,5085 |
| Moyenne ± ÉT | 0,2531 ± 0,0138 | 0,3388 ± 0,0025 | 0,8777 ± 0,0115 | 0,9153 ± 0,0116 | 0,7606 ± 0,0213 | 0,8135 ± 0,0074 | 0,8285 ± 0,0122 | 0,5085 ± 0,0101 |
| IC à 95 % | 0,2432-0,2630 | 0,3370-0,3406 | 0,8695-0,8859 | 0,9070-0,9236 | 0,7454-0,7759 | 0,8082-0,8189 | 0,8198-0,8372 | 0,5013-0,5157 |
Tableau 3 : Résultats quantitatifs inter-sujets pour TDE-Net. Chaque sujet contribue à 200 conditions de test réservées. Le tableau présente les huit métriques pour les sujets de sub-01 à sub-10, suivies de la moyenne inter-sujets, de l'écart-type (SD) de l'échantillon et de l'intervalle de confiance à 95 %. CLIP indique la précision d'identification par paire de OpenAI CLIP ViT-L/14 ; EffNet et SwAV sont des distances de corrélation pour lesquelles une valeur plus faible est préférable.
| Méthode | PixCorr | SSIM | AlexNet(2) | AlexNet(5) | Inception | CLIP | EffNet | SwAV |
| Ancre linéaire | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| Linéaire + flux structuré | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| Linéaire + flux sémantique | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (nôtre) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
Tableau 4 : Résultats d'ablation rapportés comme moyennes inter-sujets selon la procédure d'évaluation décrite dans la section 6 du protocole. L'ancrage linéaire est une référence interne locale d'appariement direct des crêtes ; les configurations structurelle, sémantique et complète utilisent les mêmes indices de condition et définitions de métriques. PixCorr, SSIM, AlexNet couche 2, AlexNet couche 5, Inception-v3 et CLIP sont des mesures où une valeur plus élevée est préférable ; EffNet et SwAV sont des distances de corrélation où une valeur plus faible est préférable. Les valeurs sont indiquées avec trois décimales.
Figure suplémentaire 1 : Exemples représentatifs de cas de reconstruction couvrant l'éventail d'accord CLIP pour le sujet-01. Les 200 conditions exclues sont classées par similarité cosinus entre les intégrations prévues par EEG fusionnées et les intégrations CLIP de référence ; six cas parmi les meilleurs, six cas médians et six cas parmi les pires sont présentés. Chaque colonne associe un échantillon d'image de référence issu du jeu de test THINGS-EEG2 à sa reconstruction par TDE-Net. Les images de référence provenaient de la base d'images THINGS34. Veuillez cliquer ici pour télécharger ce fichier.
Figure suplémentaire 2 : Visualisation conjointe des représentations CLIP issues de la vérité terrain et prédites par EEG chez le sujet 01 (n = 200 conditions par représentation). (A) Représentations CLIP issues de la vérité terrain. (B) Représentations CLIP prédites par EEG. Les couleurs indiquent cinq groupes obtenus par k-moyennes appliquées aux plongements CLIP normalisés en L2 (k = 5, n_init = 50, graine = 7). Ces groupes sont déterminés à partir des données et ne correspondent pas à des catégories sémantiques prédéfinies. Les plongements vérité terrain et prédits sont concaténés, réduits à 50 dimensions par analyse en composantes principales (ACP), puis projetés conjointement par t-SNE (perplexité = 28, taux d'apprentissage = auto, métrique euclidienne, graine = 12). ACP, analyse en composantes principales ; t-SNE, embedding stochastique t-distribué des voisins les plus proches. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 3 : Motifs EEG regroupés par catégorie large de concept d'image pour le sujet-01. Les concepts sont attribués aux catégories Animaux, Aliments/plantes ou Autres objets. Au sein de chaque catégorie, les lignes suivent l'ordre hiérarchique de Ward appliqué aux embeddings CLIP blancs du modèle de référence et sont échantillonnées uniformément à raison d'au plus 30 concepts pour des raisons de lisibilité. Les colonnes montrent 17 canaux EEG, avec 80 points temporels par canal. L'échelle de couleur (-1 à 1) représente l'amplitude EEG blanchie, normalisée et tronquée. Veuillez cliquer ici pour télécharger ce fichier.
Figure 4 supplémentaire : Topographie de l'attention aux électrodes du cuir chevelu dans le flux sémantique. Les couleurs indiquent les amplitudes relatives normalisées des paramètres de pondération appris pour les canaux parmi les 17 électrodes sélectionnées dans une projection standard du cuir chevelu 10–20 ; les points et étiquettes des électrodes identifient les positions de mesure. L'échelle varie de 0 à 1 et résume la pondération relative des canaux apprise par le modèle. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Cette étude présente un flux de travail computationnel modulaire qui sépare le prétraitement des EEG, l'apprentissage des représentations structurelles et sémantiques, la cartographie latente CLIP/VAE, la fusion et le décodage par diffusion. Cette organisation en étapes permet d'examiner séparément les sorties intermédiaires des images générées et suit l'évolution plus large allant des encodeurs EEG compacts aux méthodes de reconstruction multimodales et basées sur la diffusion6,11,12,13,14,15,16,,17,18,19,20,21,22. L'analyse inter-sujets rapporte les valeurs au niveau des sujets ainsi que la moyenne et l'écart-type (SD) échantillonnal entre les sujets pour l'évaluation tenue à l'écart portant sur dix sujets. Conjointement avec l'ablation pas à pas présentée dans le tableau 4, cette analyse quantifie les effets spécifiques à chaque flux ainsi que la variation entre les sujets au sein du pipeline rapporté.
Étapes critiques et dépannage
Les contrôles d'implémentation les plus importants sont l'isolation par partition, la normalisation cohérente, la préservation de l'indice de condition et les mappages séparés pour CLIP et VAE. Les poids de fusion doivent être choisis selon les conditions d'apprentissage et figés avant la reconstruction sur les données de test. Lorsque les performances sont anormalement faibles, vérifiez d'abord l'ordre et les dimensions des tableaux, puis examinez le coefficient de corrélation de Pearson (PCC) latent brut et spécifique à chaque branche, les métadonnées de fusion, ainsi que les sorties des métriques au niveau des images. Un échec d'alignement latent indique un problème de mappage en amont, tandis que des images variables avec des latents stables peuvent refléter un comportement stochastique ou dépendant du décodeur14,21,22,29.
Changer la configuration des électrodes, la fréquence d'échantillonnage ou la fenêtre temporelle nécessite des modifications correspondantes de la construction du graphe, des caractéristiques spectrales et des noyaux temporels. La qualité de la reconstruction doit être évaluée à l’aide de mesures complémentaires de bas niveau et sémantiques, car aucune mesure unique ne capture fidèlement la justesse au niveau des pixels, la structure et l’accord au niveau des objets6,11,21,22,23. La mesure CLIP utilisée ici correspond à la précision d'identification par paire, tandis que Figure 7 et Figure 8 utilisent le CCC au niveau latent ; ces quantités ne sont pas interchangeables.
L'organisation modulaire du TDE-Net fournit un cadre permettant d'examiner si des représentations complémentaires de l'EEG contribuent différemment aux aspects structurels et sémantiques de la reconstruction visuelle. Cette approche pourrait faciliter la comparaison systématique des représentations de caractéristiques de l'EEG, des cibles latentes et des décodeurs génératifs, sans dépendre uniquement des images reconstruites finales. Parmi les approches alternatives figurent le mappage linéaire direct entre l'EEG et l'espace latent, les encodeurs à flux unique de type convolutionnel ou basés sur l'attention, les représentations fondées sur des graphes, ainsi que les cadres de décodage neuronal de bout en bout6,7,8,9,10,11,17,18,19,20,21,22. Le flux de travail présenté pourrait être particulièrement utile pour la recherche sur le décodage de la perception visuelle, l'analyse des représentations neuronales et les interfaces cerveau-ordinateur non invasives, où la séparation des prédictions intermédiaires de l'EEG vers l'espace latent peut aider à caractériser les composantes qui contribuent à la performance de reconstruction.
Limites
Les principales limitations sont l'acquisition fixe THINGS-EEG2 RSVP, les 17 canaux pariéto-occipitaux sélectionnés, les cartographies spécifiques à chaque sujet, un seul décodeur de diffusion et des analyses d'interprétabilité qualitative21,22,23. Le résumé portant sur 10 sujets tient compte de la variabilité inter-sujets au sein du jeu de données, mais n'établit pas de transfert entre jeux de données ou entre paradigmes. Les images générées peuvent contenir des détails plausibles non soutenus par l'entrée EEG, et les visualisations RSM, t-SNE, des motifs EEG et de l'attention ne permettent pas d'établir de mécanismes neuronaux causaux. L'analyse par suppression progressive caractérise les contributions du flux structural, du flux sémantique et de la fusion dans un espace dual, sous une ancre commune de signal EEG brut, des cibles latentes, un décodeur de diffusion et un protocole d'évaluation.
Directions futures
Dans ces limites, les résultats soutiennent l'évaluation de représentations EEG complémentaires dans des espaces sémantiques et latents d'image distincts avant le décodage par diffusion. Les travaux futurs devraient tester des jeux de données indépendants, l'adaptation aux sujets, les estimations d'incertitude, des montages de canaux alternatifs, ainsi que des décodeurs dotés de contrôles plus stricts sur les détails visuels non fondés14,15,16,17,18,19,20,21,22,23. De telles études sont nécessaires avant d'étendre les résultats actuels à des contextes plus larges en neurosciences ou en interface cerveau-ordinateur.
Conclusion :
TDE-Net combine un ancrage EEG brut avec des représentations structurelles et sémantiques de l'EEG, les aligne séparément avec les espaces latents du VAE et du CLIP, puis intègre les prédictions résultantes avant le décodage par diffusion. Chez 10 participants à THINGS-EEG2, les images reconstruites conservaient une correspondance mesurable au niveau des pixels, structurelle et sémantique avec les stimuli observés, tandis qu'une ablation progressive permettait de distinguer les effets du flux structurel, du flux sémantique et de la fusion dans les deux espaces. En exposant les caractéristiques intermédiaires de l'EEG, les prédictions latentes, les sorties de fusion et les reconstructions finales, le protocole fournit un cadre reproductible pour étudier la reconstruction visuelle basée sur l'EEG et pour évaluer son extension future à des jeux de données indépendants et à différents paramètres d'acquisition.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun intérêt financier concurrent ni aucune relation personnelle susceptible d’avoir influencé ce travail. Les auteurs déclarent qu’aucun outil d’intelligence artificielle générative n’a été utilisé dans la rédaction du manuscrit, du code, de l’analyse des données ou de la préparation des figures.
Remerciements
Cette recherche a été financée par la Fondation nationale des sciences naturelles de Chine (subvention no 62433002) et (subvention no 62476014), le projet majeur national de science et technologie (no 2021ZD0113703), le projet annuel de planification de la Fondation municipale des sciences sociales de Pékin (no 23GLB014), le projet de construction et de soutien pour des équipes innovantes de haut niveau des institutions municipales de Pékin (subvention no BPHR20220104), et le programme Beijing Scholars (subvention no 099).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Accélérer | Hugging Face | 0.30.1 | Gestion du périphérique pour le pipeline de diffusion ; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14 ; openai-clip 1.0.1 | Encodeur de caractéristiques d'image utilisé pour les cibles sémantiques et l'identification par paire CLIP ; https://github.com/openai/CLIP |
| Diffuseurs | Hugging Face | 0.32.2 | Implémentation du pipeline Stable UnCLIP ; https://github.com/huggingface/diffusers |
| Matplotlib | Équipe de développement de Matplotlib | 3.10.6 | Génération de figures scientifiques ; https://matplotlib.org/ |
| MNE-Python | Développeurs de MNE | 1.11.0 | Montage standard 10-20 et topographie des canaux du cuir chevelu ; https://mne.tools/ |
| NumPy | Développeurs de NumPy | 2.3.4 | Tableaux EEG, intégrations latentes, fusion et agrégation de métriques ; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 Go ; pilote 595.97 | GPU utilisé pour l'entraînement local de l'encodeur et la reconstruction par diffusion. |
| Pillow | Fork de la bibliothèque d'images Python | 11.1.0 | Chargement, redimensionnement et exportation d'images ; https://python-pillow.org/ |
| Python | Fondation logicielle Python | 3.12.12 | Environnement d'exécution principal ; https://www.python.org/ |
| PyTorch | Fondation PyTorch | 2.9.1+cu128 | Entraînement de l'encodeur EEG et inférence par réseau neuronal ; https://pytorch.org/ |
| scikit-image | Développeurs de scikit-image | 0.25.2 | Utilitaires SSIM et de traitement d'images ; https://scikit-image.org/ |
| scikit-learn | Développeurs de scikit-learn | 1.7.2 | Régression ridge, k-moyennes, ACP et t-SNE ; https://scikit-learn.org/ |
| SciPy | Développeurs de SciPy | 1.16.3 | Corrélation, distance statistique et regroupement hiérarchique ; https://scipy.org/ |
| Seaborn | Développeurs de Seaborn | 0.13.2 | Visualisation de densité par noyau gaussien ; https://seaborn.pydata.org/ |
| Encodeur EEG du flux sémantique | Auteurs de TDE-Net ; adapté de LMDA-Net | Validation du dépôt c99325d | Représentation sémantique temporelle multi-échelle ; l'implémentation et les métadonnées du point de contrôle sont fournies dans le dépôt de code. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / Communauté SD2 | sd2-community/stable-diffusion-2-1-unclip | Décodeur de diffusion figé ; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Encodeur EEG du flux structurel | Auteurs de TDE-Net | Validation du dépôt c99325d | Représentation auto-supervisée de graphe ; les signaux EEG bruts et les caractéristiques de graphe sont concaténés uniquement pour la cartographie structurelle dans l'espace VAE. |
| Scripts d'alignement, de fusion, d'évaluation et de visualisation de TDE-Net | Yuan-ui198 | validation c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| Base de données THINGS | Hebart et al. | doi:10.1371/journal.pone.0223792 | Source de stimuli d'objets naturalistes ; https://things-initiative.org/ |
| Jeu de données THINGS-EEG2 | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | EEG à 64 canaux provenant de 10 sujets ; cette étude sélectionne 17 canaux pariéto-occipitaux ; https://osf.io/anp5v/ |
| timm | Ross Wightman et contributeurs | 1.0.22 | Utilitaires de modèles de vision pré-entraînés utilisés pour l'évaluation des caractéristiques ; https://github.com/huggingface/pytorch-image-models |
| torchvision | Fondation PyTorch | 0.24.1+cu128 | Architectures d'évaluation AlexNet, Inception-v3 et EfficientNet ; https://pytorch.org/vision/ |
| tqdm | Développeurs de tqdm | 4.67.1 | Indication de progression pour l'extraction de caractéristiques, la reconstruction et l'évaluation ; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | Interfaces pour les composants de modèles pré-entraînés ; https://github.com/huggingface/transformers |
Références
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
Réimpressions et autorisations
Cet article a été publié
Vidéo bientôt disponible