Ce protocole présente un flux de travail reproductible pour élaborer, évaluer et interpréter des modèles d'intelligence artificielle explicables dans le domaine de la santé. Il intègre une préparation standardisée des données, le développement de modèles, des techniques d'explicabilité, une évaluation quantitative et des pratiques de reproductibilité afin d'améliorer la transparence, la fiabilité et l'applicabilité clinique.
Article de méthode
Un protocole expérimental reproductible pour le développement et l'évaluation de modèles d'intelligence artificielle explicable dans les systèmes de santé
Dans cet article
Résumé
Résumé
L'intelligence artificielle (IA) est de plus en plus adoptée comme outil précieux pour la prise de décision clinique, la prédiction de maladies, le diagnostic médical et les soins personnalisés. Toutefois, le manque de transparence, la mise en œuvre incohérente des méthodes d'intelligence artificielle explicative (XAI) et la reproductibilité limitée restent des obstacles majeurs à un déploiement fiable des modèles d'IA dans les environnements cliniques. Cet article propose un protocole systématique, reproductible et transparent pour développer, évaluer et interpréter des modèles d'IA explicatifs destinés aux applications en santé. Le flux de travail commence par la configuration de l'environnement informatique, suivie de l'acquisition et de la caractérisation des données, du prétraitement, de l'ingénierie des caractéristiques, du développement du modèle, de l'optimisation des hyperparamètres, de l'évaluation des performances prédictives, de l'analyse d'explicabilité, de la validation statistique et de l'évaluation de la reproductibilité. Le protocole intègre des méthodes XAI telles que les explications additives de Shapley (SHAP), les explications locales interprétables indépendantes du modèle (LIME), la cartographie d'activation par classe pondérée par le gradient (Grad-CAM), les gradients intégrés, la visualisation de l'attention et les explications contrefactuelles afin de produire des interprétations globales et locales du modèle. Le protocole met l'accent sur plusieurs composantes clés, notamment la préparation de jeux de données standardisés en santé, le développement de modèles stables d'apprentissage automatique, l'évaluation des performances prédictives, la génération d'explications cliniquement pertinentes et l'évaluation statistique de la reproductibilité à travers des expériences répétées. En intégrant le développement du modèle, l'explicabilité, l'évaluation quantitative et qualitative, la validation statistique et l'évaluation de la reproductibilité dans un flux de travail unifié, ce protocole fournit un cadre complet pour concevoir des modèles d'IA transparents et reproductibles destinés aux applications en santé.
Introduction
L'intelligence artificielle est devenue un élément fondamental des soins de santé modernes en permettant une analyse intelligente de données cliniques complexes et en soutenant la prise de décisions médicales fondées sur des preuves1. La numérisation rapide du secteur de la santé grâce aux dossiers de santé électroniques, aux systèmes d'imagerie médicale, aux dispositifs portables et aux technologies génomiques a généré d'importantes quantités de données hétérogènes nécessitant des approches informatiques avancées pour une interprétation efficace2.
Les algorithmes d'apprentissage automatique (ML) et d'apprentissage profond (DL) ont démontré des capacités remarquables à extraire des motifs significatifs à partir de jeux de données multidimensionnels en santé, améliorant ainsi la précision du diagnostic, la prédiction des maladies et l'évaluation des résultats chez les patients3. Les modèles basés sur l'intelligence artificielle ont été appliqués avec succès en radiologie, en pathologie, en cardiologie, en oncologie, en ophtalmologie et dans d'autres spécialités médicales afin d'aider les cliniciens à détecter les maladies à un stade précoce et à recommander des stratégies de traitement personnalisées4. Ces technologies ont également contribué à l'optimisation des flux de travail, à la réduction de la variabilité des diagnostics et à une meilleure utilisation des ressources de santé5.
Les récents progrès réalisés dans le matériel informatique, le calcul en nuage et les frameworks open source d'intelligence artificielle ont accéléré le développement et le déploiement d'applications intelligentes en santé6. Par conséquent, l'intelligence artificielle est devenue une technologie clé permettant la médecine de précision et les systèmes d'aide à la décision clinique7. Malgré ces avancées, l'adoption généralisée de l'intelligence artificielle dans la pratique clinique courante reste limitée, car de nombreux modèles performants offrent peu d'informations sur la manière dont leurs prédictions sont générées8.
La plupart des algorithmes d'apprentissage profond fonctionnent comme des modèles complexes de type « boîte noire », dont le processus interne de prise de décision est difficile à comprendre pour les cliniciens et les chercheurs9. Bien que ces modèles atteignent souvent des performances prédictives excellentes, leur manque de transparence mine la confiance des utilisateurs et pose des difficultés en matière de validation clinique, d'approbation réglementaire et de sécurité des patients10. Les professionnels de santé doivent être en mesure de justifier les décisions assistées par l'intelligence artificielle avant de les intégrer dans la pratique clinique courante, particulièrement dans les environnements médicaux à haut risque11.
L'IA explicable (XAI) s'est imposée comme une approche efficace pour améliorer la transparence et l'interprétabilité des modèles d'apprentissage automatique12. Plutôt que de considérer les modèles de prédiction comme des systèmes opaques, les techniques d'IA explicable fournissent des informations sur les caractéristiques, les régions d'image ou les variables cliniques qui contribuent à des prédictions individuelles13. Ces explications permettent aux cliniciens de mieux comprendre le comportement du modèle, d'identifier d'éventuels biais et de déterminer si les décisions générées par l'IA sont conformes aux connaissances médicales établies14.
Plusieurs techniques d'explicabilité ont été introduites pour les applications en santé. Les explications basées sur la valeur de Shapley (SHAP) mesurent la contribution de chaque caractéristique à la prédiction du modèle sur la base de la théorie des jeux coopératifs15. Les explications locales interprétables indépendantes du modèle (LIME) créent un modèle simplifié et expliquent les prédictions d'un modèle boîte noire16. Pour les tâches d'imagerie médicale utilisant des modèles d'apprentissage profond, les cartes de activation pondérées par le gradient (Grad-CAM) produisent des cartes thermiques qui indiquent visuellement les régions d'une image contribuant aux décisions de classification17. La combinaison de ces méthodes a considérablement amélioré la transparence des systèmes d'intelligence artificielle dans divers domaines de la santé18.
Malgré l'attention croissante portée aux méthodes d'explicabilité dans les contextes de soins de santé, leur utilisation reste variable dans la littérature. Les chercheurs divergent non seulement dans le choix des stratégies de prétraitement, mais aussi dans la conception de l'architecture du modèle, les métriques d'évaluation et même les techniques d'explication19. De plus, de nombreux articles rapportent une précision prédictive élevée, mais ne parviennent pas à fournir une évaluation approfondie de la qualité des explications ou de leur reproductibilité20.
La reproductibilité est l'un des principaux goulots d'étranglement en science moderne de l'intelligence artificielle. Les articles ne divulguent souvent ni la version du logiciel, ni l'environnement de calcul, ni le pipeline de prétraitement, ni les réglages des hyperparamètres, ni l'initialisation de la graine aléatoire, ni les configurations matérielles21. Pour cette raison, les chercheurs indépendants échouent fréquemment à reproduire les résultats publiés ou à vérifier les méthodes publiées à l'aide d'autres ensembles de données ou plateformes logicielles22. Le manque de documentation détaillée constitue l'un des facteurs qui entravent les études de référence, la recherche collaborative et la traduction clinique des systèmes d'intelligence artificielle23.
Face à ces défis, plusieurs organisations et agences de réglementation ont souligné l'importance d'une intelligence artificielle transparente, fiable et reproductible pour les applications en santé24. Les lignes directrices existantes en matière de rapport ont amélioré la description des méthodologies, mais décrivent principalement ce qui devrait être rapporté, sans fournir de procédures expérimentales normalisées directement applicables par les chercheurs25. Par conséquent, il demeure nécessaire de disposer d'un protocole complet intégrant la préparation des jeux de données, le développement du modèle, l'analyse de l'explicabilité, l'évaluation statistique et les pratiques de reproductibilité au sein d'un flux de travail expérimental unique26.
Un protocole expérimental normalisé offre plusieurs avantages pour la communauté de l’intelligence artificielle en santé. En outre, il favorise la cohérence méthodologique, facilite la comparaison d’études indépendantes, accroît la transparence des expériences informatiques et permet une validation fiable des résultats publiés27. Les flux de travail normalisés aident également à l’éducation/formation, à la recherche collaborative et à l’évaluation réglementaire grâce à des procédures clairement documentées qui peuvent être reproduites dans différents laboratoires et établissements de santé28.
Un protocole expérimental reproductible pour l'entraînement et l'évaluation des modèles d'intelligence artificielle dans les systèmes de santé a été élaboré et testé. Ce protocole définit des normes pour la configuration de l'environnement informatique, le prétraitement des ensembles de données médicales, le développement de modèles d'apprentissage automatique, l'application de méthodes d'IA explicable (XAI), l'évaluation des performances prédictives, la validation statistique et l'analyse de la reproductibilité29. L'intégration de ces composants en un flux de travail cohérent devrait améliorer la transparence, la fiabilité et la reproductibilité de la recherche en intelligence artificielle appliquée à la santé, tout en contribuant au développement de systèmes de santé intelligents fiables30.
Protocole
L'expérience de validation réalisée a utilisé le jeu de données publiquement disponible et anonymisé sur le diabète chez les Indiens Pima, sans impliquer d'archives de patients identifiables ni de recrutement nouveau de patients. Par conséquent, aucun consentement éclairé ni approbation éthique par un comité d'éthique institutionnel (IRB) n'était requis, et toutes les analyses ont été menées conformément aux conditions d'utilisation du jeu de données et aux politiques de recherche institutionnelles.
L'exemple validé présenté utilise le jeu de données publiquement accessible sur le diabète des Indiens Pima, qui contient 768 enregistrements destinés à la prédiction binaire du diabète. Le flux de travail complet en neuf étapes a été appliqué à ce jeu de données. Ces neuf étapes fondamentales comprenaient la sélection et la validation du jeu de données, la configuration de l'environnement informatique, le prétraitement des données, la partition du jeu de données, le développement et l'entraînement du modèle, l'évaluation des performances prédictives et informatiques, l'analyse d'explicabilité, la validation statistique et l'évaluation de la reproductibilité. La validation externe et l'évaluation par un expert clinique ont été conservées comme modules de validation facultatifs et n'ont pas été réalisées dans le présent exemple illustré. Figure 1 illustre le flux de travail du protocole principal, et Table 1 résume uniquement les neuf étapes fondamentales mises en œuvre dans la présente validation illustrée ; la validation externe facultative et l'évaluation par un expert clinique sont décrites séparément dans le Protocole et ne figurent pas parmi les neuf étapes expérimentales.
1. Sélectionner et valider le jeu de données de santé
- Sélectionnez le jeu de données Pima Indians Diabetes comme jeu de données principal pour l'exemple de validation travaillé. Vérifiez la source du jeu de données, la taille de l'échantillon, l'objectif de prédiction, la distribution des classes et la structure des données.
- Appliquez les critères prédéfinis d'inclusion, d'exclusion et de qualité des données. Supprimez les enregistrements en double et non valides avant le développement du modèle.
- Enregistrez la source du jeu de données, ses caractéristiques, la tâche de prédiction, la distribution des classes, les critères d'inclusion et d'exclusion, ainsi que la stratégie de partitionnement dans Tableau 2.
- Appliquez les critères de décision pour la sélection du jeu de données et du modèle
- Définissez l'objectif de prédiction avant de choisir le jeu de données, l'architecture du modèle, la stratégie de prétraitement ou la méthode d'explicabilité.
- Appariez la modalité du jeu de données à l'objectif de prédiction. Sélectionnez des données tabulaires pour des variables cliniques structurées, des données d'imagerie pour des images médicales, des données de séries temporelles pour des signaux physiologiques, des données textuelles pour des récits cliniques, ou des données multimodales lorsqu'il existe des modalités complémentaires disponibles pour le même patient ou unité d'étude.
- Évaluez les jeux de données candidats selon la taille de l'échantillon, la disponibilité du résultat, la distribution des classes, les valeurs manquantes, la qualité des annotations, la pertinence clinique, l'intégralité des données et l'accessibilité. Sélectionnez le jeu de données qui satisfait aux exigences prédéfinies.
- Sélectionnez des modèles conventionnels d'apprentissage automatique pour des données tabulaires structurées lorsque la taille de l'échantillon, les ressources de calcul ou les exigences d'interprétabilité limitent l'utilisation d'architectures complexes. Choisissez des architectures d'apprentissage profond lorsque des données d'entraînement suffisantes et des entrées de haute dimension, telles que des images médicales, des signaux physiologiques ou du texte clinique, sont disponibles.
- Sélectionnez des architectures multimodales uniquement lorsque plusieurs modalités sont disponibles pour le même patient ou unité d'étude et peuvent être alignées de manière fiable sans introduire de fuite d'information. Choisissez les opérations de prétraitement en fonction des caractéristiques de la modalité de données sélectionnée.
- Sélectionnez les méthodes d'explicabilité en fonction du modèle et de la modalité des données. Utilisez des méthodes agnostiques au modèle telles que SHAP ou LIME pour des modèles tabulaires appropriés, et des méthodes spécifiques à la modalité telles que Grad-CAM pour les modèles basés sur l'image, lorsque cela s'applique.
- Documentez les raisons ayant conduit à la sélection du jeu de données, de la stratégie de prétraitement, du modèle et de la méthode d'explicabilité. Conservez ces décisions dans le cadre du dossier de reproductibilité.
2. Configurer l'environnement informatique pour le développement d'un modèle d'IA explicable
- Configurez le système d'exploitation, l'UC, la mémoire vive, le stockage et le GPU selon les exigences du modèle sélectionné. Créez un environnement Python isolé et installez les bibliothèques nécessaires en apprentissage automatique, apprentissage profond, statistiques, visualisation et XAI.
- Enregistrez l'environnement computationnel réel, l'architecture du modèle et les hyperparamètres utilisés pour la validation effectuée dans Tableau 3. Précisez l'optimiseur, le taux d'apprentissage, la taille du lot, le nombre maximal d'époques, la fonction de perte, les paramètres de régularisation, la stratégie de validation, la configuration de l'arrêt précoce, la configuration de la graine aléatoire, les méthodes d'explicabilité, le matériel, le système d'exploitation, la version de Python et les versions des bibliothèques logicielles pertinentes. Faites la distinction entre ces paramètres utilisés expérimentalement et les paramètres de protocole généraux ou recommandés.
- Utilisez la configuration indiquée dans Tableau 3 lors de la reproduction de la validation du jeu de données Pima Indians Diabetes Dataset et des résultats prédictifs, explicatifs, statistiques et de reproductibilité correspondants.
- Exécutez un script de validation pour confirmer l'importation réussie des packages, le chargement du jeu de données, l'exécution du modèle et la génération des sorties. Conservez la configuration finale de l'environnement pour assurer la reproductibilité.
3. Préparer et caractériser les ensembles de données de santé pour le développement de modèles d'IA explicable
- Sélectionner et acquérir le jeu de données de soins de santé
- Sélectionnez un jeu de données de soins de santé adapté à la tâche de prédiction clinique définie. Évaluez les jeux de données candidats selon l'objectif de recherche, le type de données, la taille de l'échantillon, la qualité des annotations, l'équilibre des classes et la pertinence clinique.
- Privilégiez les jeux de données de référence publiquement disponibles lorsqu'ils répondent adéquatement à la tâche de prédiction et facilitent la validation indépendante.
- Obtenez les approbations éthiques requises, les autorisations institutionnelles et l'autorisation d'accès aux données avant d'acquérir des jeux de données institutionnels ou internes. Obtenez le jeu de données sélectionné à partir d'un référentiel vérifié ou d'une base de données institutionnelle autorisée.
- Conservez les fichiers du jeu de données d'origine sans modification et enregistrez le fournisseur du jeu de données, la version, les informations d'acquisition, les conditions de licence, les critères d'inclusion, les critères d'exclusion et les métadonnées accompagnantes. Organisez le jeu de données en répertoires distincts pour les données brutes, les annotations, les métadonnées et les informations supplémentaires.
- Caractériser le jeu de données de soins de santé
- Identifiez les variables prédictives, les étiquettes de résultat, les types de caractéristiques, les modalités des données et les distributions des classes. Déterminez le nombre de sujets, d'échantillons, de dimensions de caractéristiques et d'annotations disponibles.
- Vérifiez que les caractéristiques du jeu de données sont compatibles avec la méthode d'IA choisie.
- Utilisez uniquement le jeu de données Pima Indians Diabetes comme jeu de données expérimental pour valider le protocole central en neuf étapes. Incluez uniquement les jeux de données supplémentaires listés dans Tableau 2 afin de démontrer l'applicabilité du protocole général à divers types de données cliniques tabulaires, dossiers médicaux électroniques, images dermoscopiques, données temporelles physiologiques et imagerie médicale. N'utilisez pas ces jeux de données supplémentaires pour l'entraînement du modèle, les tests, la validation statistique ou la génération des résultats expérimentaux rapportés.
- Évaluer la qualité du jeu de données
- Inspectez le jeu de données à la recherche d'enregistrements en double, de fichiers corrompus, de valeurs manquantes, d'erreurs d'annotation et d'entrées de données irrégulières. Supprimez les enregistrements en double confirmés et corrigez les irrégularités de formatage vérifiées. Documentez toutes les procédures de contrôle qualité du jeu de données.
- Vérifiez la correspondance entre les données d'imagerie, cliniques, de laboratoire et physiologiques à l'aide des identifiants des sujets lorsque vous utilisez des jeux de données multimodaux.
- Supprimez les enregistrements en double ou incohérents, gérez les valeurs manquantes, standardisez les caractéristiques numériques, codez les variables catégorielles et appliquez un prétraitement spécifique à chaque modalité. Répartissez le jeu de données en ensembles d'entraînement, de validation et de test indépendants. Reportez-vous à Figure 2 pour le flux de travail de préparation, de prétraitement, de partitionnement et d'évaluation de la qualité du jeu de données de soins de santé.
- Garantir la confidentialité des données et la conformité éthique
- Supprimez les identifiants directs des données de soins de santé. Appliquez des procédures d'anonymisation ou de pseudonymisation lorsque requis. Traitez les informations de santé des patients conformément aux exigences éthiques, de protection des données, de consentement éclairé et institutionnelles applicables.
- Enregistrez l'approbation éthique applicable, les dérogations, les procédures de gouvernance des données, les méthodes d'anonymisation et le flux de travail de préparation du jeu de données.
- Évaluez les biais algorithmiques potentiels en comparant les performances du modèle entre les sous-groupes démographiques ou cliniques pertinents, lorsque ces informations sont disponibles et autorisées sur le plan éthique.
- Documentez l'utilisation prévue, la population cible, les limites du modèle, les modes de défaillance potentiels, les exigences de supervision humaine, ainsi que les exigences éthiques, de protection des données et réglementaires en matière de soins de santé applicables.
- Enregistrez les limites identifiées en matière d'équité et les considérations relatives à l'IA responsable dans la documentation finale du modèle.
NOTE : Obtenez un jeu de données de soins de santé standardisé et documenté, adapté au développement de modèles d'IA, conforme aux exigences éthiques et exempt d'incohérences majeures identifiées.
4. Prétraiter et partitionner les données de santé pour l'apprentissage du modèle d'intelligence artificielle
- Effectuer le contrôle de qualité
- Examiner le jeu de données pour détecter les doublons, les valeurs manquantes, les valeurs non valides, les étiquettes incohérentes, les valeurs aberrantes et les fichiers corrompus.
- Supprimer ou corriger les observations non valides conformément à des critères prédéfinis et consigner toutes les exclusions. Vérifier la cohérence des variables prédictives et des étiquettes de résultat.
- Gérer les données manquantes
- Quantifier le taux de données manquantes pour chaque variable. Appliquer la stratégie prédéfinie d'imputation ou d'exclusion.
- Estimer les paramètres d'imputation à l'aide uniquement des données d'apprentissage et appliquer la transformation ajustée aux données de validation et de test.
- Normaliser et transformer les données
- Appliquer la mise à l'échelle des caractéristiques, la normalisation, le codage, la réduction de dimensionnalité ou d'autres transformations requises par le modèle sélectionné. Ajuster toutes les transformations dépendant des données en utilisant uniquement les données d'apprentissage.
- Appliquer les transformations ajustées sans modification aux données de validation et de test.
- Quantifier le déséquilibre des classes dans les données d'apprentissage. Appliquer le pondération des classes, SMOTE, le sur-échantillonnage ou l'augmentation uniquement au jeu de données d'apprentissage. Préserver la distribution d'origine des jeux de données de validation et de test.
- Vérifier qu'aucun sujet, observation en double, échantillon augmenté, statistique de prétraitement, critère de sélection de caractéristiques ou échantillon synthétique n'est partagé entre les partitions d'apprentissage et d'évaluation.
5. Développer et configurer le modèle d'IA explicable
- Définir l'architecture du modèle en précisant les modalités des données d'entrée, les opérations de prétraitement, les encodeurs de caractéristiques spécifiques à chaque modalité, le mécanisme de fusion des caractéristiques, la couche de prédiction et le module d'explicabilité.
- Sélectionner l'architecture d'apprentissage automatique ou d'apprentissage profond en fonction de la tâche de prédiction et de la modalité d'entrée. Configurer la couche d'entrée, les composants d'extraction de caractéristiques, les couches cachées, la couche de sortie et les fonctions d'activation. Définir l'optimiseur, le taux d'apprentissage, la taille du lot, la fonction de perte, le nombre d'époques, la régularisation, le dropout, l'arrêt précoce et le programme d'ajustement du taux d'apprentissage.
- Optimiser les hyperparamètres en utilisant uniquement les données d'entraînement et de validation.
- Enregistrer l'architecture finale et la configuration des hyperparamètres dans Tableau 3.
- Vérifier la compatibilité des dimensions entre les entrées et les sorties avant l'entraînement.
NOTE : Mettre en place un modèle XAI entièrement configuré, comprenant une architecture adaptée, des hyperparamètres définis et des techniques d'explicabilité intégrées.
6. Entraîner, optimiser et préserver le modèle XAI
- Chargez les jeux de données d'apprentissage et de validation prédéfinis ainsi que la configuration finale du modèle. Initialisez le modèle à l'aide de la graine aléatoire prédéfinie et des paramètres d'apprentissage.
- Entraînez le modèle en utilisant l'optimiseur spécifié, la fonction de perte, la taille du lot et les critères d'arrêt.
- Surveillez les performances sur l'ensemble de validation et conservez le point de contrôle correspondant au critère de sélection de modèle prédéfini. Évaluez le point de contrôle sélectionné sur le jeu de test indépendant sans optimisation supplémentaire.
- Enregistrez le modèle entraîné, la configuration de prétraitement, les hyperparamètres, la graine aléatoire et le journal d'apprentissage.
REMARQUE : Obtenez un modèle XAI optimisé entraîné et validé à l'aide du jeu de données de santé préparé. Conservez le modèle offrant les meilleures performances, les hyperparamètres, les journaux d'apprentissage, la configuration de prétraitement et l'environnement informatique afin d'assurer la reproductibilité.
7. Évaluer la performance prédictive et computationnelle
- Évaluer la performance prédictive
- Charger le modèle optimisé et le jeu de données de test indépendant après avoir terminé l'entraînement du modèle et l'optimisation des hyperparamètres. Conserver les paramètres du modèle entraîné et le pipeline de prétraitement inchangés pendant le test.
- Générer des prédictions pour tous les échantillons du jeu de données de test. Comparer les sorties prédites avec les étiquettes de référence correspondantes.
- Calculer les métriques de performance
- Sélectionner les métriques d'évaluation en fonction du type de tâche de prédiction.
- Calculer l'exactitude, la précision, le rappel, la spécificité, le score F1, l'exactitude équilibrée, le coefficient de corrélation de Matthews (MCC) et l'aire sous la courbe caractéristique de fonctionnement du récepteur (AUC-ROC) pour les tâches de classification, selon les cas. Calculer l'erreur absolue moyenne (MAE), l'erreur quadratique moyenne (RMSE), le coefficient de détermination (R2) et d'autres mesures pertinentes pour les tâches de régression, selon les cas.
- Évaluer la généralisation et la robustesse du modèle
- Évaluer le modèle à l'aide d'un jeu de données externe collecté indépendamment du jeu de données de développement, chaque fois que de telles données sont disponibles.
- Privilégier les jeux de données externes provenant d'un établissement de santé différent, d'une région géographique distincte ou d'une population de patients différente afin d'évaluer la transportabilité.
- Effectuer une validation temporelle à l'aide de données recueillies pendant une période ultérieure lorsque des jeux de données longitudinaux sont disponibles.
- Effectuer une validation multicentrique en évaluant le modèle finalisé séparément dans les différents établissements participants lorsque des données multicentriques sont disponibles.
- Effectuer une validation géographique à l'aide d'une population indépendante provenant d'une région géographique différente, lorsque cela est réalisable.
- Signaler les différences de performance et les intervalles de confiance entre les jeux de données de développement et externes.
- Évaluer la performance informatique
- Mesurer le temps d'entraînement du modèle dans l'environnement informatique prédéfini, le temps d'inférence et de test dans des conditions informatiques identiques, ainsi que la consommation de mémoire, la taille du modèle et l'utilisation du matériel.
- Répéter les mesures informatiques sur plusieurs exécutions indépendantes.
- Calculer le temps d'exécution moyen afin de réduire l'effet de la variabilité expérimentale.
- Comparer la performance des modèles
- Sélectionner des méthodes conventionnelles appropriées d'apprentissage automatique ou d'apprentissage profond pour l'évaluation comparative.
- Évaluer le modèle XAI proposé et les modèles comparateurs à l'aide du même jeu de données. Appliquer des procédures de prétraitement et des métriques d'évaluation identiques à tous les modèles comparatifs.
- Effectuer toutes les expériences comparatives dans le même environnement informatique.
NOTE : Obtenir des preuves expérimentales de la stabilité prédictive et de la reproductibilité dans les conditions informatiques et le jeu de données testés.
8. Générer et évaluer les sorties XAI
- Générer des explications du modèle
- Charger le modèle XAI optimisé. Sélectionner des échantillons d'évaluation qui n'ont pas été utilisés pour l'entraînement du modèle. Appliquer les méthodes d'explicabilité prédéfinies sans modifier le modèle entraîné ni le pipeline de prétraitement.
- Générer des explications globales et locales du modèle
- Générer des explications globales afin de caractériser le comportement global du modèle prédictif.
- Générer des explications locales afin de caractériser les prédictions individuelles du modèle.
- Appliquer SHAP au jeu de données Pima Indians Diabetes afin de générer des explications globales et locales des prédictions du modèle tabulaire.
- Générer un graphique récapitulatif SHAP pour visualiser la direction générale et l'ampleur des contributions des caractéristiques.
- Générer un graphique d'importance des caractéristiques SHAP utilisant les valeurs absolues moyennes de SHAP afin de classer les caractéristiques selon leur contribution globale aux prédictions du modèle.
- Générer un graphique en cascade SHAP pour une prédiction représentative de l'ensemble de test afin d'illustrer les contributions spécifiques aux caractéristiques du patient.
- Générer un graphique de dépendance des caractéristiques SHAP afin d'examiner la relation entre une caractéristique sélectionnée et sa contribution à la sortie du modèle.
- Appliquer LIME à des prédictions représentatives de l'ensemble de test afin de générer des explications locales des prédictions individuelles du modèle.
- Générer une explication contrefactuelle spécifique à un patient afin d'illustrer les changements de caractéristiques associés à un changement du résultat prédit.
- Sélectionner des techniques d'explicabilité supplémentaires selon la modalité des données et l'architecture du modèle.
- Utiliser Grad-CAM ou des cartes de saillance pour les modèles basés sur les images compatibles, des visualisations d'attention pour les architectures basées sur les transformeurs, et les gradients intégrés pour les modèles différentiables, le cas échéant.
- Considérer Grad-CAM, la cartographie de saillance, la visualisation d'attention et les gradients intégrés comme des options générales d'explicabilité dépendant de la modalité, et ne pas les interpréter ni les rapporter comme des résultats expérimentaux issus de la validation sur le jeu de données Pima Indians Diabetes, sauf si les analyses correspondantes ont effectivement été réalisées.
- Appliquer les méthodes d'explicabilité à la validation Pima traitée
- Appliquer SHAP et LIME au jeu de données Pima Indians Diabetes afin de générer des explications globales et locales des prédictions du modèle tabulaire.
- Générer des visualisations SHAP récapitulatives, d'importance des caractéristiques, en cascade et de dépendance des caractéristiques à partir des résultats de la validation Pima.
- Générer une explication locale LIME pour des prédictions représentatives de l'ensemble de test.
- Générer une explication contrefactuelle spécifique à un patient afin d'illustrer les changements de caractéristiques associés à un changement de la prédiction du modèle.
- Considérer Grad-CAM, la visualisation d'attention, la cartographie de saillance et les gradients intégrés comme des options d'explicabilité dépendant de la modalité, destinées à d'autres types de données de santé et architectures de modèles.
- Ne pas rapporter Grad-CAM, la visualisation d'attention, la cartographie de saillance ou les gradients intégrés comme des résultats expérimentaux issus de la validation Pima traitée, sauf si les analyses correspondantes ont effectivement été réalisées.
- Évaluer la qualité des explications
- Évaluer si les explications générées reflètent le processus de prédiction du modèle. Évaluer la stabilité des explications au cours d'exécutions expérimentales répétées et la cohérence des sorties d'explication dans des conditions computationnelles identiques.
- Évaluer la sensibilité des sorties d'explication aux changements dans les données d'entrée, le cas échéant. Comparer les explications générées avec les connaissances disponibles dans le domaine ou les interprétations d'experts.
- Identifier les caractéristiques prédictives ou régions anatomiques qui correspondent aux connaissances médicales établies, lorsque de telles comparaisons sont disponibles.
- Enregistrer le niveau d'accord ou de désaccord entre les explications générées et l'interprétation clinique disponible.
- Quantifier l'incertitude des prédictions
- Générer des estimations de confiance des prédictions pour les échantillons évalués, en utilisant une méthode d'estimation de l'incertitude adaptée à l'architecture du modèle sélectionné et à l'application en santé.
- Appliquer le dropout de Monte Carlo, la prédiction par ensemble, l'inférence bayésienne, la prédiction conforme ou une autre approche validée d'estimation de l'incertitude, selon le cas.
- Répéter plusieurs passes de prédiction stochastique lors de l'utilisation du dropout de Monte Carlo et calculer la prédiction moyenne et la variance prédictive pour chaque échantillon d'évaluation.
- Rapporter les intervalles de confiance ou d'incertitude des prédictions conjointement avec les prédictions du modèle correspondantes.
- Évaluer si les estimations d'incertitude identifient les prédictions associées à une fiabilité moindre ou à une erreur de prédiction accrue. Conserver la méthode d'estimation de l'incertitude, les paramètres, les graines aléatoires et les sorties d'incertitude générées afin d'assurer la reproductibilité.
- Documenter et conserver les sorties d'explicabilité
- Enregistrer tous les scores d'importance des caractéristiques générés, les cartes thermiques, les cartes de saillance, les visualisations d'attention et les interprétations spécifiques aux patients. Stocker les sorties d'explicabilité en utilisant des formats de fichiers normalisés. Archiver les sorties conjointement avec le modèle entraîné et la configuration de prétraitement.
- Enregistrer les paramètres informatiques, les paramètres d'explication, le temps d'exécution et les versions des logiciels utilisés pour la génération des explications. Conserver toute la documentation d'explicabilité afin de faciliter l'examen indépendant et la reproductibilité.
- Évaluer quantitativement la qualité des explications
- Évaluer la fidélité des explications en perturbant ou masquant systématiquement les caractéristiques identifiées comme importantes et en mesurant le changement correspondant de la sortie du modèle. Calculer un score de fidélité des explications en comparant l'ampleur de l'attribution avec le changement résultant de la prédiction du modèle.
- Évaluer la stabilité des explications en générant des explications pour des exécutions répétées, des entrées perturbées ou des échantillons cliniquement similaires, et en calculant la similarité entre les profils d'attribution résultants. Calculer l'infidélité en mesurant l'écart entre le changement de sortie prédit et le changement estimé à partir de l'attribution de l'explication sous des perturbations contrôlées des entrées.
- Pour les explications basées sur des images médicales, évaluer la précision de la localisation à l'aide d'une région d'intérêt définie par un expert, lorsque des annotations de référence sont disponibles. Évaluer l'utilité clinique en obtenant des évaluations indépendantes d'experts cliniques qualifiés selon des critères d'interprétation prédéfinis.
- Calculer le kappa de Cohen ou le kappa de Fleiss lorsque plusieurs experts évaluent indépendamment la pertinence ou l'accord concernant les explications.
NOTE : Générer des explications globales et locales qui caractérisent le comportement prédictif du modèle d'IA entraîné. Conserver les sorties d'explicabilité et les configurations correspondantes pour une interprétation transparente et une évaluation reproductible.
9. Réaliser la validation statistique et l'évaluation de la reproductibilité
- Réaliser la validation statistique
- Sélectionner les méthodes statistiques en fonction de l'objectif de l'étude, du plan expérimental, de la distribution des données et des caractéristiques des variables évaluées.
- Présenter les variables continues sous forme de moyenne ± écart-type ou de médiane et intervalle interquartile, selon le cas, et les variables catégorielles sous forme d'effectifs et de pourcentages.
- Effectuer une validation croisée en cinq parties sur l'ensemble d'apprentissage afin d'évaluer la stabilité des performances du modèle, et rapporter la précision, l'AUC-ROC, la justesse, le rappel et le score F1 sous la forme moyenne ± écart-type sur les différentes parties. Estimer les intervalles de confiance à 95 % pour les métriques de performance sur l'ensemble de test indépendant à l'aide de 1 000 rééchantillonnages bootstrap.
- Comparer le modèle proposé aux modèles de référence CNN, forêt aléatoire et SVM à l'aide du test de McNemar pour les comparaisons appariées de précision, du test de DeLong pour les comparaisons d'AUC-ROC corrélées, et de tests bootstrap appariés avec 1 000 rééchantillonnages pour les comparaisons de score F1.
- Rapporter la statistique de test correspondante et la valeur-p exacte pour chaque comparaison, et utiliser un seuil de significativité bilatéral de α = 0,05.
- Comparer statistiquement les performances des modèles
- Comparer le modèle d'intelligence artificielle explicatif proposé aux modèles de référence sélectionnés issus de l'état de l'art en apprentissage automatique et en apprentissage profond.
- Appliquer le test t de Student ou le test de Mann-Whitney U lors de la comparaison de deux groupes, selon le cas. Appliquer une ANOVA à un facteur pour les comparaisons paramétriques impliquant plus de deux groupes. Appliquer le test de Kruskal-Wallis pour les comparaisons non paramétriques impliquant plus de deux groupes.
- Considérer que p < 0,05 est statistiquement significatif, comme indiqué dans le manuscrit original.
- Utiliser un seuil de significativité bilatéral de α = 0,05 pour toutes les comparaisons statistiques prédéfinies, et rapporter les statistiques de test et les valeurs-p correspondantes.
- Rapporter les intervalles de confiance à 95 % pour les métriques principales de performance prédictive.
- Utiliser le rééchantillonnage bootstrap pour estimer les intervalles de confiance des mesures de performance lorsque cela est approprié. Utiliser le test de DeLong pour comparer des valeurs d'AUC-ROC corrélées lorsque les mêmes sujets sont évalués par deux modèles. Utiliser le test de McNemar pour comparer des résultats de classification catégorielle appariés obtenus pour les mêmes sujets. Utiliser des procédures bootstrap appariées pour comparer le score F1 ou d'autres métriques de performance dérivées lorsque cela est approprié.
- Évaluer la calibration à l'aide de graphiques de calibration, de la pente/intercept de calibration et du score de Brier lorsque des prédictions probabilistes sont disponibles.
- Pour la validation réalisée sur le jeu de données Pima Indians Diabetes, utiliser la comparaison statistique appariée prédéfinie entre le modèle proposé et les modèles de référence. Appliquer le test sélectionné de manière cohérente aux prédictions sur l'ensemble de test apparié ou aux mesures de performance issues de plusieurs exécutions, selon le type de comparaison. Utiliser un seuil de significativité bilatéral de α = 0,05 et rapporter la statistique de test et la valeur-p exacte. Ne pas indiquer que d'autres tests statistiques ont été réalisés à moins que leurs résultats soient présentés dans la section Résultats.
- Appliquer des tests bilatéraux et interpréter la significativité statistique à l'aide d'un seuil prédéfini de p < 0,05.
- Évaluer la robustesse du modèle
- Répéter la procédure complète d'apprentissage et d'évaluation 10 fois en utilisant différentes graines aléatoires, tout en conservant le partitionnement prédéfini du jeu de données, les procédures de prétraitement, l'architecture du modèle, les hyperparamètres, l'environnement logiciel et le protocole d'évaluation.
- Enregistrer l'AUC-ROC, la précision et le score F1 pour chaque exécution indépendante, et rapporter la moyenne ± écart-type sur les 10 exécutions.
- Comparer les valeurs de performance obtenues au cours des exécutions répétées afin d'évaluer la stabilité prédictive et la reproductibilité sous différentes initialisations aléatoires.
- Évaluer la reproductibilité de l'explicabilité
- Générer les attributions de caractéristiques, les cartes d'attention ou d'autres sorties explicatives sur plusieurs exécutions expérimentales lorsque l'évaluation de la stabilité des explications est incluse. Comparer quantitativement les sorties explicatives entre les exécutions répétées à l'aide d'une mesure appropriée de similarité ou d'accord basée sur les rangs.
- Pour la validation réalisée sur le jeu de données Pima Indians Diabetes, ne pas rapporter de métriques quantitatives de stabilité des explications à moins que les sorties explicatives répétées et les analyses correspondantes aient été effectuées.
- Évaluer l'accord entre les explications générées par le modèle et les interprétations des cliniciens lorsque des évaluations cliniques appropriées sont disponibles. Calculer le kappa de Cohen ou le kappa de Fleiss, selon le cas, pour évaluer l'accord entre les évaluateurs.
- Documenter la reproductibilité
- Conserver les données brutes, les procédures de prétraitement, le code source, les modèles entraînés, les configurations d'hyperparamètres, les sorties d'explicabilité, les scripts d'analyse statistique et les résultats générés.
- Enregistrer l'environnement logiciel et la configuration matérielle utilisés tout au long du flux de travail. Réexécuter indépendamment l'ensemble du flux de travail à l'aide des fichiers et configurations archivés.
- Comparer les performances prédictives reproduites avec les résultats expérimentaux initiaux, et les explications du modèle reproduites avec les sorties d'explicabilité initiales.
- Noter toute différence observée lors de la réplication. Mettre à jour la documentation expérimentale afin de refléter les observations de reproductibilité identifiées lors de l'exécution indépendante.
NOTE : Obtenir des résultats de performance prédictive et d'explicabilité validés statistiquement, évaluables sur des expériences répétées. Conserver une documentation suffisante sur les aspects computationnels, analytiques et méthodologiques afin de permettre la vérification indépendante de l'ensemble du flux de travail.
- Liste de contrôle de la reproductibilité
- Noter le nom du jeu de données, sa version, la date d'acquisition, sa source, les critères d'inclusion, les critères d'exclusion et le nombre final d'échantillons. Enregistrer toutes les opérations de prétraitement, les paramètres de transformation, les réglages de normalisation, les procédures de sélection de caractéristiques et les règles de partitionnement des données.
- Noter le système d'exploitation, le processeur (CPU), le processeur graphique (GPU), la mémoire vive (RAM), la version de Python, les versions des frameworks et des bibliothèques. Enregistrer toutes les spécifications architecturales du modèle et les hyperparamètres.
- Noter l'optimiseur, le taux d'apprentissage, la taille du lot, le nombre d'époques, la fonction de perte, la régularisation et les critères d'arrêt précoce. Enregistrer toutes les graines aléatoires et les réglages du générateur de nombres aléatoires.
- Conserver les poids des modèles entraînés et les configurations de prétraitement. Préserver les journaux d'apprentissage, les scripts d'évaluation, les scripts d'analyse statistique et les sorties d'explicabilité. Noter les versions du modèle et des logiciels utilisées pour les expériences finales.
- Conserver l'environnement computationnel complet nécessaire à la réplication indépendante.
- Documenter la disponibilité du code source, des jeux de données, des poids des modèles et des matériaux complémentaires, sous réserve des restrictions éthiques, légales, de licence et de confidentialité.
- Réexécuter indépendamment le flux de travail archivé et comparer les résultats reproduits avec les résultats initiaux.
- Documenter l'ensemble des exigences de reproductibilité à l'aide de la liste de contrôle standardisée.
Résultats
Le cadre XAI proposé a été mis en œuvre en utilisant le jeu de données sur le diabète des Indiens Pima comme ensemble de données représentatif dans le domaine des soins de santé. Ce jeu de données a été utilisé comme unique ensemble de validation expérimentale. Tous les résultats prédictifs, d'interprétabilité, statistiques et de reproductibilité rapportés ont été générés à partir de ce jeu de données. Les jeux de données TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM et BraTS 2021 n'ont pas été évalués expérimentalement et sont inclus uniquement comme exemples illustrant l'applicabilité du protocole général à différentes modalités de données en santé. L'intégralité du jeu de données a été utilisée après suppression des enregistrements non valides et des doublons, et les opérations de prétraitement spécifiées ont été effectuées avant le développement du modèle. Le jeu de données a été divisé en sous-ensembles d'entraînement, de validation et de test indépendants selon une stratégie de fractionnement stratifiée prédéfinie. L'indépendance des échantillons entre les trois sous-ensembles a été préservée afin de minimiser le risque de fuite de données.
Le modèle prédictif a été configuré à l'aide de l'architecture et des hyperparamètres prédéfinis. L'entraînement du modèle a été effectué à l'aide de l'optimiseur Adam, avec un taux d'apprentissage et une taille de lot prédéfinis, pendant un maximum de 100 époques. Un arrêt précoce basé sur la perte de validation a été appliqué, et le modèle correspondant aux meilleures performances de validation a été conservé. Des graines aléatoires ont été fixées pour la partition du jeu de données, l'initialisation du modèle et les expériences répétées afin d'améliorer la reproductibilité.
Le modèle entraîné a été évalué sur l'ensemble de test indépendant à l'aide de l'exactitude, de la précision, du rappel, de la spécificité, du score F1, du coefficient de corrélation de Matthews (MCC), de la surface sous la courbe caractéristique de fonctionnement du récepteur (AUC-ROC) et de la précision moyenne (AP). Le modèle proposé a été comparé aux modèles de référence prédéfinis en utilisant des procédures de prétraitement identiques, des partitions de données identiques et des protocoles d'évaluation identiques. Les courbes caractéristiques de fonctionnement du récepteur (ROC), les courbes précision-rappel et une matrice de confusion ont été générées à partir des prédictions sur l'ensemble de test indépendant.
Une validation croisée à cinq plis a été effectuée sur les données d'entraînement afin d'évaluer la stabilité des performances. Des intervalles de confiance à 95 % ont été estimés pour les principales métriques de performance, et des comparaisons statistiques prédéfinies ont été réalisées entre le modèle proposé et les modèles de référence.
La validation croisée à cinq plis a produit une exactitude de 93,01 ± 0,48 %, une AUC-ROC de 0,954 ± 0,007, une précision de 92,42 ± 0,87 %, un rappel de 93,02 ± 0,45 % et un score F1 de 92,72 ± 0,62 %. Les intervalles de confiance bootstrap à 95 %, estimés à partir de 1 000 rééchantillonnages, étaient de 0,897 à 0,973 pour l'exactitude, de 0,890 à 0,970 pour la précision, de 0,880 à 0,963 pour le rappel, de 0,887 à 0,965 pour le score F1 et de 0,931 à 0,984 pour l'AUC-ROC. Des comparaisons statistiques avec les modèles de base CNN, forêt aléatoire et SVM ont été effectuées à l’aide du test de McNemar pour l'exactitude, du test de DeLong pour l'AUC-ROC et de tests bootstrap appariés avec 1 000 rééchantillonnages pour le score F1.
La procédure complète d'apprentissage et d'évaluation a été répétée sur 10 exécutions indépendantes en utilisant différentes graines aléatoires. Les exécutions répétées ont donné une AUC-ROC de 0,957 ± 0,008, une exactitude de 93,24 ± 0,74 % et un score F1 de 92,35 ± 0,92 %, indiquant une variabilité relativement faible entre les exécutions répétées. Les métriques de performance obtenues lors des exécutions répétées ont été résumées à l'aide de la moyenne et de l'écart type. La variabilité entre les exécutions a été examinée afin de déterminer si la performance prédictive restait stable lors d'exécutions répétées.
Aucune validation externe n'a été effectuée dans le présent exemple travaillé, car aucun jeu de données externe indépendant n'a été utilisé. Par conséquent, tous les résultats relatifs à la prédiction, aux statistiques et à la reproductibilité ont été obtenus à partir du jeu de données sur le diabète chez les Indiens Pima, en utilisant les partitions prédéfinies d'apprentissage, de validation et de test indépendant. La validation externe a été conservée dans le protocole comme procédure facultative pour les applications dans lesquelles un jeu de données indépendant provenant d'une institution, d'une population, d'une région géographique ou d'une période temporelle différente est disponible.
Les explications du modèle ont été générées à l'aide de techniques d'interprétabilité applicables au jeu de données tabulaires sur le diabète des Indiens Pima, notamment SHAP et LIME. L'importance globale des caractéristiques a été évaluée, et des explications locales spécifiques à chaque patient ont été produites à partir d'échantillons de test réservés. Les sorties d'explication ont été enregistrées conjointement avec les prédictions correspondantes du modèle et les valeurs des caractéristiques afin de faciliter la reproductibilité et l'interprétation ultérieure.
Par souci de clarté, l'exemple traité dans cet article comprenait les neuf étapes fondamentales du flux de travail identifiées dans le Tableau 1. La validation externe et l'évaluation par des experts cliniciens ont été conservées comme modules facultatifs de validation du protocole général. La validation externe n'a pas été réalisée, car aucune base de données externe indépendante n'a été utilisée, et l'évaluation par des experts cliniciens n'a pas été effectuée, car aucun comité formel d'évaluation par des experts n'était inclus dans le présent exemple traité. En conséquence, ces modules facultatifs ne sont pas considérés comme faisant partie du flux de travail expérimental en neuf étapes et ne sont pas rapportés comme résultats expérimentaux.
Les procédures de prétraitement et de partitionnement du jeu de données ont produit un ensemble normalisé adapté au développement du modèle. Les enregistrements en double et incohérents ont été supprimés, les valeurs manquantes ont été traitées selon la stratégie prédéfinie, les caractéristiques numériques ont été standardisées, et le jeu de données a été divisé en sous-ensembles d'entraînement, de validation et de test indépendants. Les caractéristiques du jeu de données obtenu et les procédures de prétraitement sont résumées dans Tableau 2. Le flux de travail général de préparation et de prétraitement du jeu de données en matière de santé est illustré dans Figure 2, tandis que le flux de travail expérimental de préparation, de prétraitement, de partitionnement et d'évaluation de la qualité, appliqué spécifiquement au jeu de données sur le diabète des Indiens Pima, est présenté dans Figure 3. L'environnement informatique final, l'architecture du modèle et la configuration des hyperparamètres utilisés pour produire les résultats rapportés sont résumés dans Tableau 3.
L'exécution des sections 3 et 4 a produit un jeu de données de soins de santé normalisé, adapté au développement du modèle. Les procédures de prétraitement ont supprimé les enregistrements en double et incohérents, imputé les valeurs manquantes, normalisé les caractéristiques numériques, encodé les variables catégorielles lorsque cela s'appliquait, et divisé le jeu de données en sous-ensembles d'apprentissage, de validation et de test. Les données obtenues ont fourni l'entrée normalisée nécessaire au développement ultérieur du modèle.
Après l'achèvement des sections 5 et 6, le modèle configuré a montré une convergence stable durant l'apprentissage. Les courbes d'apprentissage ont révélé une diminution simultanée des pertes d'entraînement et de validation, ainsi qu'une augmentation de la précision d'entraînement et de validation. L'optimisation des hyperparamètres a amélioré la généralisation du modèle, sans signe d'un surajustement important. Afin de faciliter la reproductibilité, le modèle optimisé a été archivé conjointement avec l'architecture finale, les réglages des hyperparamètres, les versions des logiciels, les graines aléatoires et les poids du modèle entraîné. Les spécifications d'apprentissage du modèle et les résultats de l'optimisation sont résumés dans le Tableau 4, et les courbes d'apprentissage correspondantes pour l'entraînement et la validation sont présentées dans la Figure 4.
La section 7 a évalué les performances prédictives du modèle à l'aide de métriques de performance standardisées. Les métriques de classification évaluées comprenaient l'exactitude, la précision, le rappel, la spécificité, le score F1, le coefficient de corrélation de Matthews (MCC), l'AUC-ROC et la précision moyenne (AP). Le modèle proposé a été comparé aux modèles de référence prédéfinis en utilisant les mêmes partitions de jeu de données, les mêmes procédures de prétraitement et le même protocole d'évaluation. La comparaison des performances prédictives est présentée dans le tableau 5, tandis que les courbes ROC, les courbes précision-rappel, la matrice de confusion et les métriques de performance comparatives sont illustrées dans la figure 5.
Après la section 8, des explications globales et locales des prédictions du modèle ont été générées afin d'évaluer son interprétabilité. Les explications du modèle ont été produites à l'aide de SHAP et de LIME pour le jeu de données tabulaires sur le diabète chez les Indiens Pima, et une explication contrefactuelle spécifique à un patient a été générée pour illustrer un changement dans la prédiction. SHAP a été utilisé pour produire l'importance globale des caractéristiques, des visualisations en cascade spécifiques à un patient et des dépendances entre caractéristiques, tandis que LIME a été utilisé pour générer des explications locales à partir d'échantillons de test mis de côté. Les résultats correspondants en matière d'explicabilité sont présentés dans Figure 6.
La dernière étape du protocole a évalué la fiabilité statistique et la reproductibilité du flux de travail. L'ensemble du flux de travail a été répété sur 10 exécutions indépendantes en utilisant différentes graines aléatoires, tout en conservant la même stratégie de partitionnement des données, les paramètres de prétraitement, l'architecture du modèle, les hyperparamètres, l'environnement logiciel et les procédures d'évaluation. Les exécutions répétées ont donné un AUC-ROC de 0,957 ± 0,008, une exactitude de 93,24 ± 0,74 % et un score F1 de 92,35 ± 0,92 %, indiquant une variabilité relativement faible entre les exécutions répétées.
La stabilité des explications n'a pas été évaluée de manière quantitative dans cette validation réalisée. Bien que des explications SHAP et LIME aient été générées pour le jeu de données sur le diabète chez les Indiens Pima, aucune analyse distincte de corrélation de rang ou de chevauchement des caractéristiques entre les exécutions n'a été effectuée. Par conséquent, aucune métrique numérique relative à l'explication, à la stabilité ou à l'accord des attributions n'est rapportée. L'évaluation quantitative de la stabilité des explications est conservée dans le protocole général comme procédure facultative de reproductibilité pour les applications dans lesquelles des sorties d'explication répétées sont disponibles.
Les comparaisons statistiques ont été évaluées à l'aide d'un seuil de significativité prédéfini de p < 0,05. Des tests statistiques bilatéraux ont été utilisés lorsque cela était applicable, et les statistiques de test correspondantes, les valeurs de p et les intervalles de confiance à 95 % ont été indiqués afin de quantifier la significativité statistique et l'incertitude liées aux différences de performance observées. Les résultats expérimentaux de validation statistique et de reproductibilité, incluant la performance de la validation croisée, les intervalles de confiance, les comparaisons statistiques et la variabilité des répétitions, sont résumés dans Tableau 6. Les analyses correspondantes de test statistique et de reproductibilité sont illustrées dans Figure 7.
Ces résultats ont fourni une preuve expérimentale de la stabilité prédictive et de la reproductibilité dans les conditions de calcul et le jeu de données testés. L'environnement de calcul, les caractéristiques du jeu de données, les procédures de prétraitement, la configuration du modèle, les analyses statistiques et les paramètres d'explicabilité nécessaires à la réplication indépendante ont été documentés conformément à la liste de contrôle de reproductibilité présentée dans Tableau 7. Une évaluation par des experts cliniciens des sorties XAI générées n'a pas été réalisée dans l'exemple validé traité dans le présent travail.
Dans l'ensemble, l'application du protocole a produit un jeu de données de santé normalisé, adapté au développement de modèles d'intelligence artificielle, ainsi qu'un modèle optimisé utilisant des paramètres prédéfinis. Le flux de travail a permis une évaluation systématique des performances prédictives, la génération d'explications du modèle à l'aide de techniques XAI appropriées, et une évaluation statistique de la robustesse et de la reproductibilité du modèle. Ensemble, les résultats ont démontré la mise en œuvre et la reproductibilité du flux de travail XAI proposé dans les conditions expérimentales évaluées dans l'exemple de validation traité.
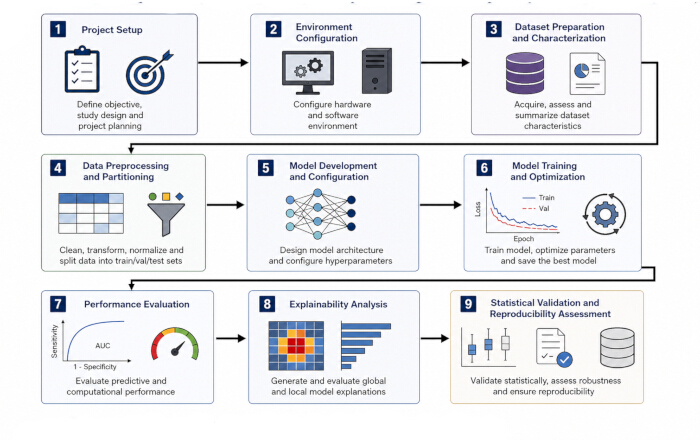
Figure 1 : Workflow central en neuf étapes pour le développement de modèles d'intelligence artificielle reproductibles et explicables en santé. Le workflow comprend (1) la définition de la tâche de prédiction en santé, (2) la configuration de l'environnement informatique, (3) l'acquisition et la validation du jeu de données, (4) le prétraitement des données, (5) la partition du jeu de données, (6) l'entraînement du modèle prédictif, (7) l'évaluation des performances prédictives, (8) l'analyse d'explicabilité et (9) l'évaluation statistique et de la reproductibilité. La validation externe et l'évaluation par des experts cliniciens sont considérées comme des extensions facultatives du protocole et ne sont pas incluses dans le workflow central en neuf étapes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
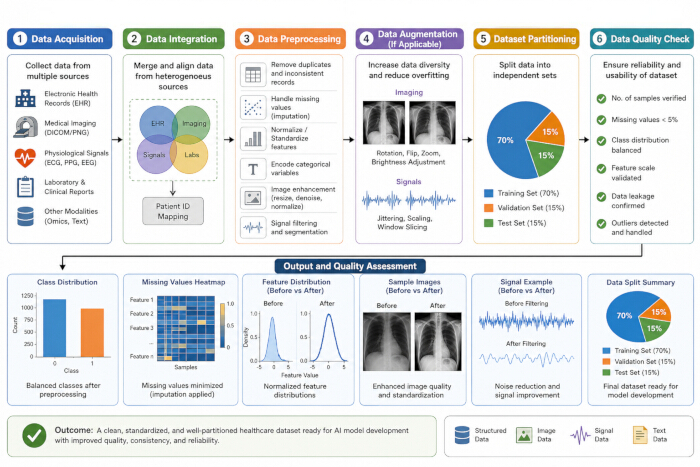
Figure 2 : Flux de travail pour la préparation et le prétraitement des ensembles de données de santé. (A) Acquisition de données de santé à partir de dossiers cliniques, d'images médicales, de signaux physiologiques et de sources de données multimodales. (B) Intégration et prétraitement des données, incluant la gestion des valeurs manquantes, la normalisation, la suppression du bruit et l'augmentation des données. (C) Partitionnement de l'ensemble de données en sous-ensembles d'apprentissage, de validation et de test. (D) Évaluation de la qualité montrant la répartition des classes, la normalisation des caractéristiques et les résultats du prétraitement avant le développement du modèle. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
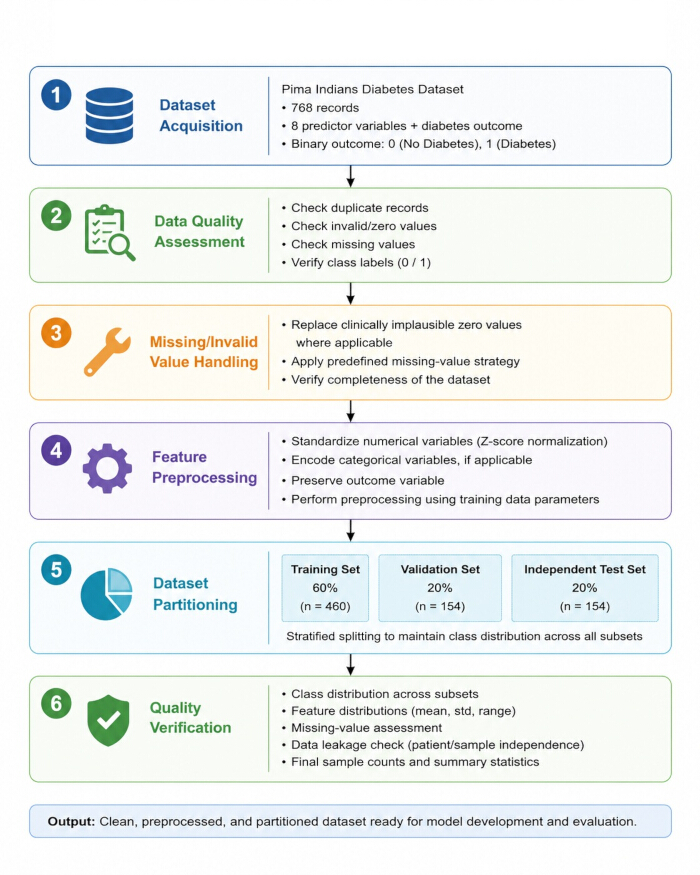
Figure 3 : Flux expérimental pour la préparation, le prétraitement, la partition et l'évaluation de la qualité du jeu de données sur le diabète chez les Indiens Pima. Le flux comprend l'acquisition du jeu de données, l'évaluation de la qualité des données, la gestion des valeurs invalides et manquantes, la standardisation des caractéristiques numériques, la partition du jeu de données en sous-ensembles d'entraînement, de validation et de test indépendant, ainsi que la vérification finale de la qualité avant le développement du modèle. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
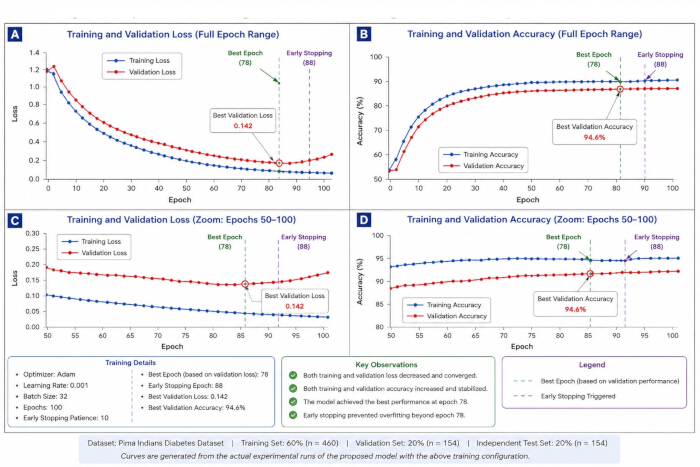
Figure 4 : Courbes d'apprentissage expérimentales de formation et de validation du modèle proposé, utilisant le jeu de données sur le diabète des Indiens Pima. (A) Perte de formation et de validation au cours de la période complète d'apprentissage. (B) Précision de formation et de validation au cours de la période complète d'apprentissage. (C) Vue agrandie de la perte pendant les époques 50 à 100. (D) Vue agrandie de la précision pendant les époques 50 à 100. La meilleure performance de validation a été obtenue à l'époque 78, avec une perte de validation de 0,142 et une précision de validation de 94,6 %. L'arrêt prématuré a été déclenché à l'époque 88, avec une tolérance de 10 époques. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
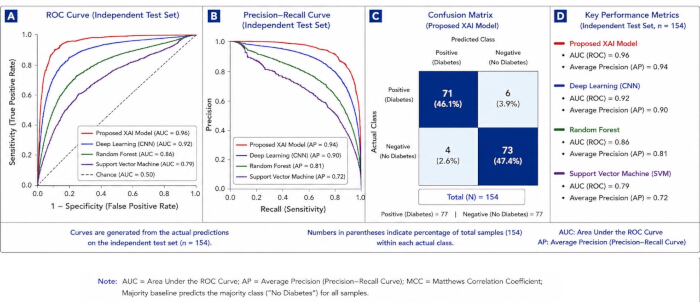
Figure 5 : Évaluation des performances prédictives expérimentales du cadre XAI proposé à l'aide du jeu de test indépendant (n = 154). (A) Courbe caractéristique de fonctionnement du récepteur (ROC) illustrant les performances de discrimination du modèle XAI proposé et des modèles de référence. (B) Courbes précision-rappel (PR) illustrant les performances en termes de précision et de rappel du modèle XAI proposé et des modèles de référence. (C) Matrice de confusion du modèle XAI proposé sur le jeu de test indépendant, avec les valeurs correspondantes d'exactitude, de sensibilité (rappel) et de spécificité. (D) Comparaison de l'exactitude, de la précision, du rappel, de la spécificité, du score F1, du coefficient de corrélation de Matthews (MCC), de l'aire sous la courbe ROC (AUC) et de la précision moyenne (AP) entre les modèles évalués. Tous les résultats quantitatifs présentés dans cette figure correspondent à l'expérience de validation sur le jeu de données Pima Indians Diabetes Dataset. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
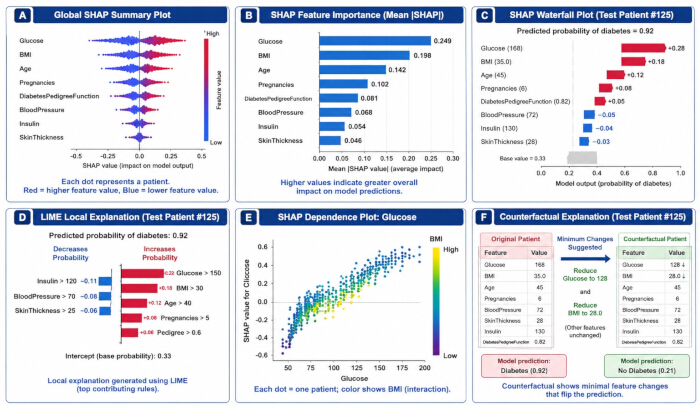
Figure 6: Sorties d'interprétabilité générées à partir des prédictions sur un ensemble de test indépendant du modèle proposé entraîné sur le jeu de données Pima Indians Diabetes. (A) Graphique résumé global de SHAP montrant la distribution des contributions des caractéristiques sur l'ensemble de test. (B) Graphique d'importance des caractéristiques SHAP basé sur les valeurs absolues moyennes de SHAP.C) Graphique en cascade SHAP spécifique au patient montrant la contribution des caractéristiques individuelles à la probabilité prédite de diabète. (D) Explication locale LIME montrant les contributions des caractéristiques pour le patient test n°125. (E) Graphique de dépendance SHAP illustrant la relation entre les valeurs de glucose et leurs contributions SHAP. (F) Explication contrefactuelle spécifique au patient montrant les changements minimaux des caractéristiques associés à une modification de la prédiction du modèle. Abréviations : SHAP = Shapley Additive exPlanations ; LIME = Local Interpretable Model-agnostic Explanations. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
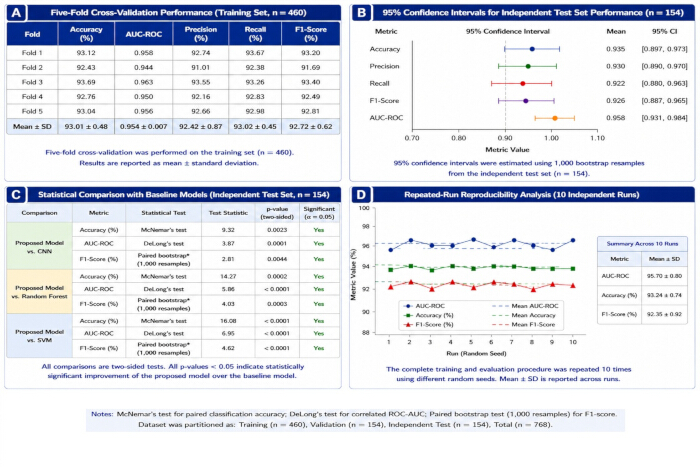
Figure 7 : Validation statistique expérimentale et analyse de reproductibilité du modèle proposé à l'aide du jeu de données sur le diabète chez les Indiens Pima. (A) Performances de la validation croisée en cinq parties sur l'ensemble d'apprentissage. (B) Intervalles de confiance bootstrap à 95 % pour les performances sur l'ensemble de test indépendant. (C) Comparaisons statistiques avec les modèles de référence, incluant le test statistique, la statistique du test, la valeur-p et la significativité. (D) Cohérence des performances sur 10 exécutions indépendantes utilisant différentes graines aléatoires. Le test de McNemar a été utilisé pour comparer les précisions de classification appariées, le test de DeLong pour les AUC-ROC corrélées, et un test bootstrap apparié avec 1 000 rééchantillonnages pour la comparaison des scores F1. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Étape | Activité du protocole | Résultat attendu | État de mise en œuvre |
| 1 | Sélectionner et valider le jeu de données de santé | Données vérifiées, objectif de prédiction, distribution des classes et informations sur la qualité des données | Réalisé |
| 2 | Configurer l’environnement informatique | Matériel, logiciels, bibliothèques, versions et configuration informatique vérifiés | Réalisé |
| 3 | Prétraiter les données de santé et en contrôler la qualité | Jeu de données nettoyé, transformé et normalisé | Réalisé |
| 4 | Partitionner le jeu de données | Jeux de données d’entraînement, de validation et de test indépendants | Réalisé |
| 5 | Développer et optimiser le modèle prédictif/XAI | Architecture finale du modèle et hyperparamètres | Réalisé |
| 6 | Entraîner et conserver le modèle | Modèle entraîné, point de contrôle, configuration d’entraînement et journaux | Réalisé |
| 7 | Évaluer les performances prédictives et informatiques | Mesures de performance sur le jeu de test et comparaisons des performances | Réalisé |
| 8 | Générer et évaluer les sorties d’explicabilité | Sorties d’explication SHAP/LIME et autres pertinentes | Réalisé |
| 9 | Effectuer la validation statistique et l’évaluation de la reproductibilité | Intervalles de confiance, tests statistiques, résultats de répétitions et mesures de reproductibilité | Réalisé |
Tableau 1 : Résumé du flux de travail en neuf étapes du protocole de base appliqué lors de la validation illustrée utilisant le jeu de données sur le diabète chez les Indiens Pima. Le tableau distingue les neuf étapes mises en œuvre dans l'exemple traité sur le jeu de données sur le diabète chez les Indiens Pima, par rapport à la validation externe et à l'évaluation par un expert clinicien, qui restent des composantes facultatives du protocole général.
| Ensemble de données | Source des données | Application clinique | Modalité des données | Sujets/Enregistrements | Échantillons | Classes | Répartition des classes | Entraînement/Validation/Test | Rôle dans la présente étude | Statut de la validation | URL source |
| Ensemble de données sur le diabète des Indiens Pima | Référentiel d'apprentissage automatique UCI | Prédiction du diabète | Données cliniques tabulaires | 768 enregistrements | 768 | 2 | 500 non diabétiques ; 268 diabétiques | 60 % / 20 % / 20 % | Ensemble de données principal pour la validation expérimentale | Réalisée – workflow complet en neuf étapes | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), projet TCGA-BRCA | Classification du cancer du sein | Clinique + histopathologie | 1 098 cas | Dépendant de l'ensemble de données selon le type de données | Dépendant du critère d'évaluation | Aucune répartition unique des classes à l'échelle de l'ensemble de données | Non applicable – aucune division expérimentale effectuée | Exemple d'application du protocole uniquement | Non utilisé pour la validation expérimentale | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), projet TCGA-UCEC | Classification du cancer de l'endomètre | Clinique + histopathologie | Cohorte du projet ; taille dépendant du type de données et des filtres sélectionnés | Dépendant de l'ensemble de données selon le type de données | Dépendant du critère d'évaluation | Aucune répartition unique des classes à l'échelle de l'ensemble de données | Non applicable – aucune division expérimentale effectuée | Exemple d'application du protocole uniquement | Non utilisé pour la validation expérimentale | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, base de données cliniques MIMIC-III v1.4 | Prédiction d'issues cliniques | Séries temporelles cliniques | 46 520 patients | 58 976 admissions en soins intensifs | Dépendant de la tâche | Aucune répartition unique des classes à l'échelle de la base de données | Non applicable – aucune division expérimentale effectuée | Exemple d'application du protocole uniquement | Non utilisé pour la validation expérimentale | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | Compétition International Skin Imaging Collaboration (ISIC) | Classification des lésions cutanées | Images dermoscopiques | Non applicable – ensemble de données d'images | 25 331 images d'entraînement | 8 catégories d'entraînement | AKIEC 867 ; BCC 3 323 ; BKL 2 624 ; DF 239 ; MEL 4 522 ; NV 12 875 ; VASC 253 ; SCC 628 | Non applicable – aucune division expérimentale effectuée | Exemple d'application du protocole uniquement | Non utilisé pour la validation expérimentale | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / Archives ISIC | Classification des lésions cutanées | Images dermoscopiques | 7 470 lésions uniques | 10 015 images | 7 | AKIEC 327 ; BCC 514 ; BKL 1 099 ; DF 115 ; MEL 1 113 ; NV 6 705 ; VASC 142 | Non applicable – aucune division expérimentale effectuée | Exemple d'application du protocole uniquement | Non utilisé pour la validation expérimentale | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | Ensemble de données OhioT1DM, distribué publiquement à des fins de recherche | Surveillance/prédiction du diabète | Séries temporelles cliniques | 12 participants | 24 fichiers XML répartis entre les données d'entraînement/développement et de test | Prédiction de la glycémie continue ; pas une tâche de classification fixe | Non applicable | Fichiers d'entraînement/développement et de test définis par l'ensemble de données ; aucune division expérimentale effectuée ici | Exemple d'application du protocole uniquement | Non utilisé pour la validation expérimentale | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021 ; CBICA/Université de Pennsylvanie | Segmentation/classification des tumeurs cérébrales | IRM | 2 040 cas dans la cohorte du défi | 1 251 cas annotés pour l'entraînement ; quatre modalités IRM par cas | Dépendant de la tâche | Aucune répartition unique des classes à l'échelle de l'ensemble de données | Cohortes définies par le défi ; aucune division expérimentale effectuée ici | Exemple d'application du protocole uniquement | Non utilisé pour la validation expérimentale | https://www.med.upenn.edu/cbica/brats2021/ |
Tableau 2 : Caractéristiques des ensembles de données médicales et applicabilité du protocole proposé. Ce tableau résume les sources de données, les applications cliniques, les modalités, les caractéristiques des échantillons, les répartitions des classes, les stratégies de partitionnement des ensembles de données, le statut de validation et les informations sur les sources pour les ensembles de données médicales pris en compte dans le protocole. L'ensemble de données sur le diabète des Indiens Pima sert d'exemple principal pour la validation du protocole.
| Élément de configuration | Valeur utilisée lors de la validation expérimentale | État / Interprétation |
| Jeu de données | Pima Indians Diabetes Dataset | Jeu de données expérimental utilisé pour la validation |
| Algorithme / Modèle | Modèle prédictif tabulaire pour la classification binaire du diabète | Utiliser le nom exact de l'architecture indiqué dans le compte rendu expérimental, s'il est documenté séparément |
| Taux d'apprentissage | 0,001 | Valeur expérimentale |
| Optimiseur | Adam | Valeur expérimentale |
| Taille du lot | 32 | Valeur expérimentale |
| Nombre maximal d'époques | 100 | Valeur expérimentale |
| Fonction de perte | Cross-Entropy | Valeur expérimentale |
| Fonction d'activation | ReLU | Valeur expérimentale |
| Dropout | 0,5 | Valeur expérimentale |
| Décroissance des poids | 1e-4 | Valeur expérimentale |
| Normalisation par lot | Activée | Valeur expérimentale |
| Augmentation des données / Équilibrage des classes | Activée | Ne préciser SMOTE que si cette méthode a effectivement été appliquée lors de l'exécution rapportée |
| Stratégie de validation | Validation croisée en 5 parties | Valeur expérimentale |
| Arrêt précoce | Patience = 10 époques | Valeur expérimentale |
| Graine aléatoire | 42 | Utiliser la graine exacte enregistrée pour l'expérience |
| Exécutions répétées | 10 exécutions indépendantes avec différentes graines aléatoires | Analyse de reproductibilité expérimentale |
| Taille de l'image en entrée | Non applicable | Le jeu de données Pima est de type tabulaire |
| Dimension des caractéristiques | 512 | À utiliser uniquement si cette représentation finale des caractéristiques a effectivement été mise en œuvre |
| Explicabilité | SHAP + LIME ; explication contrefactuelle présentée dans la Figure 6 | Analyse XAI réellement rapportée |
| Métriques d'évaluation | Précision, exactitude, rappel, spécificité, score F1, MCC, AUC-ROC, AP | Métriques expérimentales rapportées |
| Matériel | NVIDIA GPU | Remplacer par le modèle exact du GPU si enregistré |
| Logiciel / Framework | Python 3.11 ; Scikit-learn ; composants du framework utilisés par l'implémentation | Utiliser les versions exactes des packages si enregistrées |
Tableau 3 : Environnement de calcul, architecture du modèle et configuration des hyperparamètres utilisés pour la mise en œuvre du protocole. Le tableau précise la plateforme de calcul, l'environnement logiciel, l'architecture du modèle, la configuration des entrées, les paramètres d'optimisation, les réglages de régularisation et les paramètres de reproductibilité utilisés pour mettre en œuvre le flux de travail XAI proposé.
| Paramètre | Spécification ou résultat représentatif |
| Optimiseur | Adam |
| Taux d'apprentissage | 0,001 |
| Taille du lot | 32 |
| Nombre maximal d'époques | 100 |
| Patiences pour l'arrêt précoce | 10 époques |
| Meilleure époque | 78 |
| Époque d'arrêt précoce | 88 |
| Meilleure perte de validation | 0,142 |
| Meilleure précision de validation | 94,6 % |
| Résultat de l'entraînement | La perte d'entraînement et de validation a diminué et convergé |
| Résultat de la validation | La précision d'entraînement et de validation a augmenté et s'est stabilisée |
| Résultat de l'optimisation | Les meilleures performances du modèle ont été atteintes à l'époque 78 |
| Contrôle du surapprentissage | L'arrêt précoce a empêché toute optimisation supplémentaire au-delà de l'époque sélectionnée comme la meilleure |
Tableau 4 : Spécifications de l'entraînement du modèle et résultats de l'optimisation. Ce tableau résume l'optimiseur, le taux d'apprentissage, la taille du lot, le nombre maximal d'époques d'entraînement, les performances de validation, la convergence de l'entraînement, le résultat de l'optimisation et la stratégie de contrôle du surapprentissage utilisés lors du développement du modèle.
| Modèle | Précision (%) | Exactitude (%) | Rappel (%) | Spécificité (%) | Score F1 (%) | MCC | AUC (ROC) | AP (PR) |
| Modèle XAI proposé | 93,5 | 94,5 | 92,4 | 94,6 | 93,4 | 0,87 | 0,96 | 0,94 |
| Apprentissage profond (CNN) | 89,1 | 89,8 | 88,1 | 90 | 88,9 | 0,78 | 0,92 | 0,9 |
| Forêt aléatoire | 84,3 | 85 | 83,2 | 85,7 | 84,1 | 0,67 | 0,86 | 0,81 |
| Machines à vecteurs de support (SVM) | 78,6 | 79,3 | 77,1 | 80 | 78,2 | 0,54 | 0,79 | 0,72 |
| Ligne de base (classe majoritaire) | 62,1 | 62,1 | 100 | 0 | 76,6 | 0 | 0,5 | 0,5 |
Tableau 5 : Comparaison des performances prédictives des modèles évalués. Le tableau compare le modèle XAI proposé avec les modèles de référence évalués à l’aide de l’exactitude, de la précision, du rappel, de la spécificité, du score F1, du coefficient de corrélation de Matthews, de la surface sous la courbe caractéristique de fonctionnement du récepteur et de la précision moyenne.
| Analyse de validation | Comparaison / Métrique | Test statistique | Statistique du test | p-valeur | Résultat expérimental / IC à 95 % |
| Validation croisée en cinq parties | Précision | Descriptif (moyenne ± écart-type) | — | — | 93,01 ± 0,48 % |
| Validation croisée en cinq parties | AUC-ROC | Descriptif (moyenne ± écart-type) | — | — | 0,954 ± 0,007 |
| Validation croisée en cinq parties | Exactitude | Descriptif (moyenne ± écart-type) | — | — | 92,42 ± 0,87 % |
| Validation croisée en cinq parties | Rappel | Descriptif (moyenne ± écart-type) | — | — | 93,02 ± 0,45 % |
| Validation croisée en cinq parties | Score-F1 | Descriptif (moyenne ± écart-type) | — | — | 92,72 ± 0,62 % |
| Intervalle de confiance bootstrap à 95 % | Précision | Bootstrap (1 000 rééchantillonnages) | — | — | 0,935 [0,897 ; 0,973] |
| Intervalle de confiance bootstrap à 95 % | Exactitude | Bootstrap (1 000 rééchantillonnages) | — | — | 0,930 [0,890 ; 0,970] |
| Intervalle de confiance bootstrap à 95 % | Rappel | Bootstrap (1 000 rééchantillonnages) | — | — | 0,922 [0,880 ; 0,963] |
| Intervalle de confiance bootstrap à 95 % | Score-F1 | Bootstrap (1 000 rééchantillonnages) | — | — | 0,926 [0,887 ; 0,965] |
| Intervalle de confiance bootstrap à 95 % | AUC-ROC | Bootstrap (1 000 rééchantillonnages) | — | — | 0,958 [0,931 ; 0,984] |
| Modèle proposé vs. CNN | Précision (%) | Test de McNemar | 9,32 | 0,0023 | Significatif (α = 0,05) |
| Modèle proposé vs. CNN | AUC-ROC | Test de DeLong | 3,87 | 0,0001 | Significatif (α = 0,05) |
| Modèle proposé vs. CNN | Score-F1 | Bootstrap apparié (1 000 rééchantillonnages) | 2,81 | 0,0044 | Significatif (α = 0,05) |
| Modèle proposé vs. Forêt aléatoire | Précision (%) | Test de McNemar | 14,27 | 0,0002 | Significatif (α = 0,05) |
| Modèle proposé vs. Forêt aléatoire | AUC-ROC | Test de DeLong | 5,86 | <0,0001 | Significatif (α = 0,05) |
| Modèle proposé vs. Forêt aléatoire | Score-F1 | Bootstrap apparié (1 000 rééchantillonnages) | 4,03 | 0,0003 | Significatif (α = 0,05) |
| Modèle proposé vs. SVM | Précision (%) | Test de McNemar | 16,08 | <0,0001 | Significatif (α = 0,05) |
| Modèle proposé vs. SVM | AUC-ROC | Test de DeLong | 6,95 | <0,0001 | Significatif (α = 0,05) |
| Modèle proposé vs. SVM | Score-F1 | Bootstrap apparié (1 000 rééchantillonnages) | 4,62 | <0,0001 | Significatif (α = 0,05) |
| Reproductibilité sur plusieurs exécutions (10 exécutions indépendantes) | AUC-ROC | Descriptif (moyenne ± écart-type) | — | — | 0,957 ± 0,008 |
| Reproductibilité sur plusieurs exécutions (10 exécutions indépendantes) | Précision (%) | Descriptif (moyenne ± écart-type) | — | — | 93,24 ± 0,74 % |
| Reproductibilité sur plusieurs exécutions (10 exécutions indépendantes) | Score-F1 (%) | Descriptif (moyenne ± écart-type) | — | — | 92,35 ± 0,92 % |
Tableau 6 : Résultats de validation statistique et de reproductibilité obtenus à partir de la mise en œuvre expérimentale utilisant le jeu de données sur le diabète chez les Indiens Pima. Le tableau résume les performances de la validation croisée en cinq parties, les intervalles de confiance à 95 % fondés sur le bootstrap, les comparaisons statistiques du modèle proposé avec les modèles de référence, ainsi que la reproductibilité obtenue sur 10 exécutions indépendantes avec des graines aléatoires différentes. La validation externe et l'évaluation par un expert clinique n'ont pas été réalisées dans le cadre de cette validation exemplifiée.
| No. | Élément de la liste de vérification | Documentation requise | Enregistrement ou vérification recommandé |
| 1 | Environnement logiciel | Système d'exploitation, langage de programmation et environnement logiciel | Enregistrer les versions exactes du système d'exploitation et du langage de programmation. |
| 2 | Versions des logiciels et bibliothèques | Versions des principales bibliothèques et paquets logiciels | Enregistrer les noms et versions exacts des paquets et bibliothèques. |
| 3 | Spécifications du matériel | Spécifications du processeur, du GPU, de la mémoire vive, du stockage et des accélérateurs | Enregistrer le matériel informatique utilisé. |
| 4 | Identification du jeu de données | Nom, source, version et informations d'accès du jeu de données | Enregistrer la source et la version exactes du jeu de données, ainsi que la date d'accès le cas échéant. |
| 5 | Caractéristiques du jeu de données | Taille de l'échantillon et répartition des classes | Enregistrer le nombre total d'échantillons et la répartition des classes pour chaque sous-ensemble. |
| 6 | Partitionnement du jeu de données | Stratégie de division en ensemble d'entraînement, de validation et de test indépendant | Documenter les proportions ou effectifs des sous-ensembles et la stratification. |
| 7 | Prévention des fuites de données | Procédure utilisée pour éviter les fuites d'information | Documenter la séparation des sujets ou échantillons et l'estimation des paramètres de prétraitement sur l'ensemble d'entraînement uniquement. |
| 8 | Paramètres de prétraitement | Paramètres de nettoyage, gestion des valeurs manquantes, normalisation, encodage et transformations | Enregistrer toutes les opérations de prétraitement et les valeurs des paramètres. |
| 9 | Augmentation des données | Méthodes et paramètres d'augmentation, le cas échéant | Documenter les méthodes, probabilités et plages de paramètres. |
| 10 | Architecture du modèle | Architecture et configuration finales du modèle | Documenter le type de modèle, les couches ou composants, les dimensions et les fonctions d'activation. |
| 11 | Hyperparamètres | Hyperparamètres d'entraînement et d'optimisation | Enregistrer le taux d'apprentissage, la taille du lot, l'optimiseur, le nombre d'époques, l'arrêt précoce et les paramètres ajustés. |
| 12 | Graines aléatoires | Graines aléatoires utilisées pour une exécution reproductible | Enregistrer les graines utilisées pour la division, l'initialisation et les exécutions répétées. |
| 13 | Configuration de l'entraînement | Procédure d'entraînement et stratégie de sélection du modèle | Documenter la validation, la sauvegarde des points de contrôle et les critères de sélection du modèle. |
| 14 | Métriques d'évaluation | Métriques prédictives et statistiques prédéfinies pour l'évaluation | Enregistrer toutes les mesures de performance rapportées. |
| 15 | Intervalles de confiance | Intervalles d'incertitude pour les mesures de performance | Documenter la méthode d'estimation des intervalles de confiance et les rééchantillonnages bootstrap le cas échéant. |
| 16 | Tests statistiques | Procédures statistiques pour la comparaison des modèles | Documenter le test, la statistique, la valeur-p, le seuil de significativité et les hypothèses. |
| 17 | Analyse sur exécutions répétées | Exécutions indépendantes utilisant différentes graines aléatoires | Enregistrer le nombre d'exécutions et la moyenne ± écart-type des métriques clés. |
| 18 | Configuration de l'explicabilité | Méthodes et paramètres d'explicabilité | Documenter les paramètres applicables de SHAP, LIME, Grad-CAM, attention, contre-factuels, etc. |
| 19 | Évaluation de l'explicabilité | Évaluation objective de la fiabilité et de l'utilité des explications | Documenter la fidélité, la stabilité, l'infidélité, la localisation et l'évaluation par des experts le cas échéant. |
| 20 | Artéfacts du modèle | Poids du modèle entraîné et fichiers de configuration | Archiver le modèle entraîné final, l'architecture ou la configuration, et les informations de sélection. |
| 21 | Disponibilité du code | Code nécessaire pour le prétraitement, l'entraînement, l'évaluation et la génération d'explications | Enregistrer les informations sur le dépôt ou l'accès contrôlé au code, le cas échéant. |
| 22 | Documentation de l'exécution | Commandes, scripts, fichiers de configuration et instructions | Enregistrer les commandes et configurations nécessaires pour reproduire le flux de travail. |
| 23 | Documentation des sorties | Prédictions, résultats d'évaluation, figures et sorties d'explication | Archiver les sorties générées et les relier à l'expérience ou exécution correspondante. |
| 24 | Vérification de la reproductibilité | Vérification de la cohérence entre exécutions indépendantes | Comparer les résultats d'exécutions répétées et rapporter les mesures de variabilité prédéfinies. |
Tableau 7 : Liste de contrôle de reproductibilité pour la réplication indépendante du flux de travail XAI proposé. Cette liste précise les exigences en matière de calcul, de jeu de données, de prétraitement, de développement de modèles, d'évaluation, de validation statistique, d'explicabilité et de documentation nécessaires pour reproduire le protocole expérimental.
Discussion
Les résultats démontrent l'utilité du protocole proposé en tant que flux de travail normalisé et reproductible pour développer et évaluer des systèmes d'IA explicable (XAI) sur des ensembles de données de santé variés. Comme indiqué dans Tableau 2 et Figure 3, un prétraitement systématique a permis d'obtenir des données normalisées et d'améliorer la qualité des données grâce à la gestion des valeurs manquantes, à la normalisation des données, à la mise à l'échelle des caractéristiques et à la partition des ensembles de données. Ces étapes de prétraitement sont essentielles, car une variabilité dans la préparation des données pourrait introduire des biais, réduire la performance prédictive et compromettre la fiabilité des analyses d'explicabilité. Par conséquent, des procédures de prétraitement cohérentes doivent être appliquées sur les ensembles de données d'apprentissage, de validation et de test afin de favoriser la reproductibilité et d'éviter les fuites de données19,20.
Les résultats de l'apprentissage du modèle présentés dans la Figure 4 et le Tableau 4 démontrent un comportement d'apprentissage cohérent et stable. La diminution simultanée des pertes d'apprentissage et de validation, ainsi que l'augmentation de la précision prédictive, indiquent une convergence appropriée du modèle sans surapprentissage significatif. L'optimisation des hyperparamètres, l'arrêt précoce, le dropout et la régularisation contribuent également à un apprentissage de modèle stable et reproductible. Une instabilité des courbes d'apprentissage peut indiquer un taux d'apprentissage inadéquat, un volume de données d'entraînement insuffisant ou une complexité excessive du modèle. Par conséquent, la convergence du modèle doit être surveillée tout au long de l'apprentissage afin d'identifier et de corriger ces problèmes potentiels.
Tableau 5 et Figure 5 illustrent les performances prédictives à l’aide de plusieurs métriques d’évaluation, notamment la précision, le rappel, la spécificité, le score F1, le coefficient de corrélation de Matthews et l’aire sous la courbe caractéristique de fonctionnement du récepteur (ROC). Les courbes ROC et les courbes précision-rappel fournissent des mesures de la performance discriminante, tandis que la matrice de confusion illustre la répartition des classifications correctes et incorrectes entre les classes. L’évaluation à l’aide de plusieurs métriques de performance est particulièrement importante pour les jeux de données médicaux déséquilibrés, car la précision globale seule peut ne pas suffire à caractériser adéquatement les performances du modèle.
Figure 6 illustre les résultats d'explicabilité obtenus à partir du jeu de données sur le diabète chez les Indiens Pima et démontre les rôles complémentaires des méthodes d'explicabilité appliquées dans la validation détaillée. L'analyse SHAP globale caractérise la contribution générale et l'importance relative des variables d'entrée pour les prédictions du modèle, tandis que les graphiques en cascade et les tracés de dépendance SHAP fournissent des interprétations spécifiques à un patient et au niveau des caractéristiques du comportement du modèle. LIME offre une explication locale supplémentaire en identifiant les caractéristiques contribuant à une prédiction individuelle sur l'ensemble de test. L'explication contrefactuelle spécifique à un patient illustre en outre les changements minimaux des caractéristiques associés à une modification du résultat prédit. Ensemble, ces approches offrent des perspectives complémentaires, globales et locales, sur le comportement du modèle et améliorent la transparence et l'interprétabilité du modèle prédictif tabulaire. Grad-CAM, la visualisation de l'attention, la cartographie de saillance et les gradients intégrés n'ont pas été appliqués dans la validation détaillée sur les données Pima et sont conservés uniquement comme options dépendant de la modalité au sein du protocole général.
La validation statistique (Tableau 6 et Figure 7) et les évaluations de reproductibilité démontrent la stabilité des performances prédictives entre différentes séries d'expériences. La combinaison de la validation croisée, de l'estimation des intervalles de confiance, des tests d'hypothèses et de l'évaluation de la reproductibilité par répétition des essais fournit un cadre systématique permettant d'évaluer la robustesse du modèle. Une telle validation est particulièrement importante dans les applications de santé, car la reproductibilité entre expériences indépendantes constitue une preuve de la fiabilité et de la généralisabilité des modèles d'intelligence artificielle avant leur mise en œuvre dans des environnements cliniques21,23.
Plusieurs étapes sont cruciales pour la mise en œuvre réussie de ce protocole. Effectuez le nettoyage des données avant l'extraction des caractéristiques et l'entraînement du modèle afin de minimiser les biais potentiels découlant de données incomplètes, incohérentes ou erronées. Réalisez l'optimisation des hyperparamètres en utilisant uniquement les données d'entraînement et de validation, et maintenez le jeu de données de test indépendant tout au long du développement et de l'optimisation du modèle. Documentez clairement les états des générateurs de nombres aléatoires, les versions des logiciels, les configurations matérielles et les paramètres de prétraitement afin de faciliter la reproductibilité entre différentes plates-formes informatiques. En outre, choisissez des méthodes d'explicabilité en fonction du modèle prédictif et du type de données en santé afin d'obtenir des explications interprétables et cliniquement pertinentes20,29,30.
Le protocole présente plusieurs limites. La précision et la fiabilité des prédictions et des explications du modèle dépendent fortement de la disponibilité de jeux de données de santé suffisamment vastes, représentatifs et de haute qualité. La sous-représentation de certaines populations de patients, les erreurs de mesure, les variables manquantes et l'hétérogénéité entre les sources de données peuvent nuire à la fois à la performance prédictive et à la stabilité des explications du modèle. De plus, les approches actuelles d'explicabilité permettent de caractériser le comportement du modèle, mais n'établissent pas nécessairement les mécanismes causaux. Par conséquent, les résultats de l'IA explicable (XAI) doivent être interprétés en conjonction avec une expertise clinique pertinente.
Dans l'ensemble, ce protocole fournit une approche normalisée pour le développement reproductible de modèles, leur évaluation et l'analyse de leur explicabilité dans différents domaines de la santé. En intégrant un prétraitement standardisé, une optimisation des hyperparamètres, une évaluation à l'aide de plusieurs métriques de performance, des approches complémentaires d'explicabilité et une validation statistique, le flux de travail offre un cadre transparent et traçable pour la recherche en intelligence artificielle appliquée à la santé.
Les résultats indiquent en outre qu'un développement transparent et cohérent de modèles d'IA peut être soutenu par la combinaison d'un prétraitement systématique des données, de procédures standardisées de développement de modèles, d'une évaluation complète des performances, de plusieurs méthodes d'explicabilité et d'une validation statistique rigoureuse. Le protocole peut être adapté à des bases de données cliniques, des images médicales, des signaux physiologiques et des données de santé multimodales, tout en conservant un cadre expérimental reproductible dans différents environnements informatiques. Grâce à une mise en œuvre standardisée, à des techniques complémentaires d'explicabilité et à une évaluation de la reproductibilité, le protocole fournit un cadre pour le développement de modèles d'IA explicables et fiables et peut servir de fondement méthodologique pour de futures recherches biomédicales ainsi que pour des validations externes et cliniques ultérieures.
Déclarations de divulgation
Les auteurs déclarent qu'ils n'ont aucun intérêt financier concurrent, aucune relation commerciale ou relation personnelle pouvant avoir influencé le travail rapporté dans cette étude. Les auteurs n'ont aucun conflit d'intérêt à divulguer.
Remerciements
Les auteurs reconnaissent le soutien institutionnel fourni par leurs établissements respectifs durant le développement et la validation expérimentale de ce protocole de XAI en santé. Les auteurs reconnaissent également les infrastructures de calcul et les ressources logicielles utilisées pour mener les analyses expérimentales. Cette recherche n’a reçu aucun financement externe. Les auteurs reconnaissent l’utilisation de Python 3.11, Matplotlib 3.9 et SciPy 1.13 pour l’analyse computationnelle, la visualisation des données et la génération des figures présentées dans cette étude.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Captum | Meta AI | Dernière version stable | Expliquabilité PyTorch |
| CUDA Toolkit | NVIDIA | 12.2 | Accélération GPU |
| cuDNN | NVIDIA | 9.x | Moteur pour apprentissage profond |
| Git | Git SCM | Dernière version stable | Contrôle de version |
| GitHub | GitHub Inc. | Plateforme web | Référentiel de code source |
| Grad-CAM | jacobgil | Dernière version publiée | Visualisation CNN |
| Jupyter Notebook | Projet Jupyter | Dernière version stable | Développement interactif |
| LightGBM | Microsoft | 4.x | Boosting par gradient |
| LIME | Communauté LIME | 0.2.0 | Expliquabilité locale |
| Matplotlib | Développeurs Matplotlib | 3.9 | Visualisation |
| Microsoft Excel | Microsoft | Microsoft 365 | Organisation des données |
| NumPy | Développeurs NumPy | 1.26 | Calcul numérique |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 Go de VRAM | Entraînement du modèle |
| OpenCV | Organisation OpenCV | 4.10 | Prétraitement d'images |
| Pandas | Équipe de développement Pandas | 2.2 | Prétraitement des données |
| Pillow (PIL) | Bibliothèque d'images Python | 10.x | Traitement d'images |
| Plotly | Plotly Technologies | 5.x | Visualisation interactive |
| Python | Fondation logicielle Python | 3.11 | Environnement de programmation |
| PyTorch | Fondation PyTorch | 2.3 | Apprentissage profond |
| Scikit-learn | Développeurs Scikit-learn | 1.5 | Apprentissage automatique |
| SciPy | Développeurs SciPy | 1.13 | Calcul scientifique |
| Seaborn | Développeurs Seaborn | 0.13 | Graphiques statistiques |
| SHAP | Communauté SHAP | 0.46 | Expliquabilité globale |
| SimpleITK | Consortium logiciel Insight | 2.x | Traitement d'images médicales |
| Statsmodels | Développeurs Statsmodels | 0.14 | Analyse statistique |
| RAM système | Tout fabricant | 32 Go ou plus | Mémoire |
| TensorBoard | 2.15 | Surveillance de l'entraînement | |
| TensorFlow | 2.15 | Apprentissage profond | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 22.04 LTS / 11 | Système d'exploitation |
| Visual Studio Code | Microsoft | Dernière version stable | Développement de code |
| XGBoost | Développeurs XGBoost | 2.1 | Boosting par gradient |
Références
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.