במטרה לטפל בבעיות של פרגמנטציה בטקסטים משפטיים ובמעקב אחר הטיות בבינה מלאכותית (AI) רפואית, מחקר זה בונה גרף ידע משפטי ומעסיק קונבולוציית גרפים מודעת-יחסים (relation-aware graph convolution) לצורך יישור סמנטי. הוא מזהה מקורות מוטיים באמצעות פריסה לאחור מבוססת גרדיאנט (gradient-based backpropagation), עם מדדי ניסוי חיוביים התומכים ביישום של בינה מלאכותית רפואית תואמת רגולציה.
הרשמה ל-JoVE נדרשת לצפייה בתוכן זה. התחברו או התחילו בגרסת ניסיון בחינם.
מאמר מחקר
בניית גרפים של ידע משפטי ומעקב אחר הטיות בבינה מלאכותית רפואית המבוססת על רשתות עצביות גרפיות
במאמר זה
סיכום
תקציר
בניתוח ציות משפטי של בינה מלאכותית (AI) רפואית, מאמר זה עוסק בעמימות בקביעת האחריות הנגרמת מהפיצול הסמנטי של טקסטים משפטיים הטרוגניים ממקורות מרובים ומקשיים במעקב אחר הטיות אלגוריתמיות. הוא בונה שיטה להקמת גרף ידע וגילוי נתיבי התפשטות של הטיות המבוססת על רשתות עצביות גרפיות. ארבעה סוגים של צמתים הטרוגניים — סעיפי חוק, התנהגויות רפואיות, מודולים אלגוריתמיים וגורמים אחראים — מובנים ומקודדים, וגרף מכוון נבנה על בסיס ארבעה סוגים של קשרים סמנטיים משפטיים: "הפרה", "בסיס", "הפעלה" ו"שייכות". לאחר מכן, רשת קונבולוציית גרפים מודעת-קשרים, בשילוב עם משקלות ספציפיות לסוג הקשר ומנגנון קשב, משמשת להשגת יישור מאפיינים רב-שכבתי עבור סמנטיקה משפטית חוצת-מודליות. לאחר מכן, נעשה שימוש בהסעה לאחור מבוססת גרדיאנט כדי לזהות קשתות התורמות באופן משמעותי להטיה, להבנות תת-גרף של התפשטות הטיות, ולהשתמש בגילוי קהילות לאיתור צבירי צמתי-שורש. לבסוף, זרימות החלטה בזמן אמת ממופות לצמתים זמניים, הציות מאומת באמצעות דמיון שיכון (embedding similarity), והדינמיקה של משקלות קשת מרכזיות מנוטרת כדי להזהיר מפני הצטברות של הטיות מערכתיות. ניסויים מראים כי מבחינת דיוק יישור סמנטי, השיטה המוצעת משיגה דיוק ממוצע של יישור ישויות של לפחות 0.92 ושלימות ממוצעת של שימור קשרים של לפחות 0.88 על פני מדרגי צפיפות שונים של גרפי ידע. בנוגע ליכולת איתור הטיות, קצב השחזור של צמתי השורש מגיע ל-0.95±±0.02, והדיוק של נתיב ההתפשטות מגיע ל-0.93±±0.03. מחקר זה, במידה מסוימת, משיג צימוד עמוק בין לוגיקה משפטית להתנהגות אלגוריתמית, ומספק מערכת תמיכה לציות הניתנת להסבר ולאימות עבור פריסה מהימנה של AI רפואית.
מבוא
המעורבות העמוקה של בינה מלאכותית רפואית באבחון ובתמיכה בטיפול, בהקצאת משאבים ובהערכת סיכונים, קשרה את קבלת ההחלטות שלה להנחה של אחריות משפטית1,2. הנורמות המשפטיות הן מובנות מאוד אך מפוזרות סמנטית, והתנהגותן של מערכות בינה מלאכותית עשויה להיות "קופסה שחורה", ללא ממשק שניתן ליישר סמנטית ולעקוב אחריו בין השתיים3. בהקשר זה, פיתוח מסגרת ייצוג משותפת הלוכדת שרשראות סיבתיות משפטיות בתוך רצפי התנהגות אלגוריתמיים הפך למאפשר הכרחי להגשמה של ייחוס אחריות מדוקדק וציות דינמי4,5. מחקר זה אינו קשור רק לבדיקה משפטית של מערכות טכנולוגיות, אלא הוא כולל גם שמירה מעמיקה על הוגנות רפואית, הוגנות אלגוריתמית ואמון מוסדי, ולכן יש לו חשיבות תיאורטית רבה ודחיפות מעשית.
הסוגיה היסודית בניתוח תאימות משפטית של בינה מלאכותית (AI) רפואית כיום היא המחסור במבנה קישור חישובי בין סמנטיקה משפטית לבין התנהגות אלגוריתמית6,7. מסמכים משפטיים זמינים כטקסט רגיל, והקשרים בין הפסקאות שזורים בתלויות, קונפליקטים וחריגות, דבר הגורם לבעיות בעת פירוקם ליחידות לוגיות הניתנות לפירוש על ידי מכונות8,9. זאת למרות שקבלת ההחלטות של מערכת ה-AI מוכלת ב"קופסה שחורה" מונחית-נתונים, ואף אחת מהווריאציות של פלטי המערכת אינה ניתנת למעקב אחר הפרות ספציפיות של חובות משפטיות או נקודות לחלוקת אחריות10,11. ניתוק כזה (למשל, הטיות בנתוני האימון, פגמים בתכנון המודל או הפרשנות הסמנטית של נורמות משפטיות) אינו ניתן לבידוד ניסויי לצורך זיהוי מקור ההטיה או הבהרת חובות משפטיות עבור מפתחים, פורסים או משתמשים12,13. בעייתית אף יותר היא העובדה שנהלי ציות קיימים בודקים רק אם פלט סופי עומד במפרט קבוע, מבלי להתחשב בנתיב ההפצה או בהגברת ההטיה ברשת האינטראקציות של "חוק-טכנולוגיה"14,15. כאשר בינה מלאכותית רפואית כפופה למספר הוראות משפטיות בו-זמנית, והמערכת מייצרת שרשרת של שגיאות עקב פרשנות שגויה של סעיף אחד, גישות קונבנציונליות אינן יכולות לעקוב אחר האופן שבו השגיאה מתפשטת דרך הוראות קשורות אחרות ולאחר מכן מגיעה להגדרת האחריות16,17. בנוסף, קיים מחסור במנגנון קורלציה דינמי בין זרימת ההחלטות בזמן אמת לבין גרף הידע הקיים של החוק, מה שמוביל להערכת ציות מאוחרת במהלך הפעלת המערכת, ובכך מונע ניטור פרואקטיבי של מגמת הצטברות ההטיות18,19. סוגיות אלו יחד מובילות לחוסר ודאות בקביעת האחריות, ייחוס שברירי והתערבות רגולטורית מאוחרת, המעכבים באופן משמעותי פריסה מהימנה של מערכות AI רפואיות בסיכון גבוה ואת יישום האחריות המשפטית.
מעל לכל, מחקר מסורתי בוחן טקסטים משפטיים בצורה מובנית ובונה מאגרי ידע של תחומים ספציפיים באמצעות אונטולוגיות או כללים, וזאת כדי לתמוך בשאלות ותשובות בנושאי תאימות או בהודעות על סיכונים20,21. למרות שגישות אלו יכולות ללכוד ייצוגים של מושגים משפטיים מסוימים, הן נוטות להניח מראש כי הלוגיקה הפנימית של החוק היא קוהרנטית וסטטית, מה שמקשה על התמודדות עם חוסר עקביות בין תחומי שיפוט, חריגות או ניסוחים מעומעמים. עבודות מאוחרות יותר הציגו טכנולוגיית עיבוד שפה טבעית, המשתמשת במודלי שפה מאומנים מראש כדי לחלץ ישויות וקשרים משפטיים, ובכך שיפרו את רוחב הכיסוי של חילוץ הידע22,23, אך הן עדיין נותרות ברמה סמנטית רדודה, ובכך נכשלות ביצירת ממשק מיפוי בין התנהגויות משפטיות לטכניות. מבחינת ממשל של הטיות אלגוריתמיות, המחקר התמקד בעיקר בעיצוב של אילוצי הוגנות24,25, ומדדי ההערכה שלו מבוססים בדרך כלל על משתנים דמוגרפיים, ללא התאמה לעקרונות ייחוס משפטיים. אפילו מחקרים מסוימים ניסו לקודד כללים משפטיים כאילוצים ולהטמיע אותם באימון המודל26,27, אך בשל הקשיחות והגרנולריות הגסה של ביטוי הכללים, קשה להתאימם למצבים קליניים מורכבים. באופן כללי, עבודות קיימות מתייחסות לתאימות משפטית כמשימת אימות חיצונית ולא כתכונה חישובית אינהרנטית של ארכיטקטורת המערכת. הדבר מוביל לכך שהלוגיקה המשפטית והלוגיקה האלגוריתמית פועלות במקביל, ללא תמיכה בהסקה משותפת ובהתערבות דינמית בנתיבי הפצת ההטיות.
בשנים האחרונות, רשתות עצביות גרפיות הוכנסו בהדרגה לתחום הרפואי בשל יכולות המידול המפורשות שלהן של מבנים יחסיים28,29. מספר מחקרים עושים שימוש בגרפים הטרוגניים כדי לשלב פסיקה, הוראות משפטיות ומידע על בעלי הדין, ובכך תומכים בהמלצות על תיקים או בחיזוי גזרים באמצעות שיכbeding של צמתים (node embeddings)30,31, ובדרך זו מאמתים את היעילות של מבני גרפים בלכידה של קשרים משפטיים. עבודות אחרות מופשטות רכיבים אלגוריתמיים כצמתים בגרף, תוך שימוש במקצועות (edges) לייצוג זרימות נתונים או קשרי קריאה לצורך מעקב אחר התפשטות שגיאות32,33. חקירות אלו מוכיחות כי מבני גרפים יכולים לשמש כנשא משותף של אלמנטים משפטיים וטכנולוגיים. עם זאת, מודלים גרפיים קיימים סובלים בדרך כלל משלוש מגבלות: ראשית, הם מוגבלים לסוג אחד של קשר קצוות, ובכך אינם מצליחים להבחין בין הבדלים נורמטיביים, סיבתיים וייחוסים בסמנטיקה משפטית; שנית, תהליך אגרגציית התכונות מתעלם מהמשקלות הסמנטיים של סוגי הקצוות, מה שמוביל להתייחסות שווה לנתיבי לוגיקה משפטית שונים; ושלישית, הם חסרים מנגנון מעקב דיפרנציביבילהפצת הטיות, מה שהופך את איתור קצוות בעלי תרומה גבוהה ושחזור נתיבי אחריות לבלתי אפשרי. מאמר זה בונה רשת קונבולוציונית גרפית מודעת-יחסים (relation-aware graph convolutional network) הנותנת מענה לבעיית מיזוג ההטרוגניות הסמנטית על ידי הקצאת מטריצת טרנספורמציה ייעודית לכל סוג של קצה סמנטי משפטי והצגת מנגנון קשב (attention mechanism) להתאמה דינמית של זרימת מידע בין סוגים שונים. יתרה מכך, על ידי שילוב של פעפוע אחורי של גרדיאנט (gradient backpropagation) וחילוץ תת-גרפים, המודל מאפשר מעבר פרשני משיפוט תאימות ברמה המקרוסקופית למעקב אחר הטיות ברמה המיקרוסקופית, ובכך מתגבר על צוואר הבקבוק של מודלים גרפיים מסורתיים התומכים רק בהסקה סטטית.
מעבר לתחום הרפואי, התקדמויות אחרונות בשיטות מבוססות-גרפים ובשיטות אבולוציוניות הדגימו ישימות רחבה לעיבוד ידע מובנה. לדוגמה, Xue et al. הציעו גישה רב-שכבתית של תכנות גנטי היברידי לבנייה אדפטיבית של מאפייני דמיון בהתאמת אונטולוגיות, ובכך השיגו יישור חסון בין גרפי ידע הטרוגניים34. Cheng et al. סיפקו סקירה מקיפה של יישומים של רשתות קונבולוציה גרפיות בשחזור תמונות, תוך סיווג שיטתי של שיטות להסרת רעשים, רזולוציה גבוהה (super-resolution) והסרת טשטוש (deblurring)35. Li et al. הציגו סקירה מעמיקה על למידה עמוקה אבולוציונית מנקודת המבט של למידת מכונה אוטומטית, המכסה עקרונות, אלגוריתמים, יישומים ואתגרים פתוחים36. Ma et al. פיתחו מסגרת לחיפוש ארכיטקטורה עצבית עמומה (fuzzy neural architecture search) לזיהוי פגמים תחת אי-וודאות, והדגימו את יעילותו של חיפוש אבולוציוני בטיפול בנתונים מעורפלים37. מחקרים אלו מדגישים את הפוטנציאל שבשילוב ייצוגים מבוססי-גרפים ואופטימיזציה אבולוציונית למשימות קבלת החלטות מורכבות.
המטרה המרכזית של מאמר זה היא לבסס מסגרת ניתנת לפירוש מקצה לקצה לצורך ניתוח תאימות משפטית של בינה מלאכותית (AI) רפואית, עם חידושים בשלוש רמות. ברמת ייצוג הידע, זוהי הפעם הראשונה שבה סעיפי חוק, פרקטיקות רפואיות, מודולי אלגוריתם וגורמים אחראים ממודלים כארבעה סוגים של צמתים הטרוגניים. בהתבסס על הפרקטיקה המשפטית, היא מחלצת ארבעה סוגים של קשרי כיוון: "הפרה", "בסיס", "הפעלה" ו"ייחוס", ובכך בונה גרף ידע מכוון בעל לוגיקה סיבתית משפטית, המספק תשתית סמנטית מובנית לניתוח תאימות. במעקב אחר מקור ההטיה, היא מציעה שיטה לכימות תרומת קשתות המבוססת על רגישות גרדיאנט. באמצעות פעפוע לאחור (backpropagation), היא מוצאת את קבוצת הקשתות הממקסמת את הטיית הפלט, ולאחר מכן מיישמת אלגוריתם לגילוי קהילות כדי לקבץ צמתים בעלי תרומה גבוהה, ובכך הופכת "הטיית קופסה שחורה" ל"צבירי אחריות קופסה לבנה", מה שמאפשר ייחוס המבוסס על שרשרת ראיות ניתנת להפעלה. ברמת הניטור הדינמי בזמן אמת, היא מפתחת מנגנון שיבוץ (embedding) זמני של צמתי החלטה הממפה פלטי AI בזמן אמת אל מרחב גרף הידע. בהתבסס על השוואת קרבת השיבוץ, היא מכמתת את מידת הסטייה מהנורמה ומנטרת את שינויי המשקל של אותן קשתות משפטיות-טכניות חיוניות, כדי לסמן הצטברות של הטיה מערכתית. פרדיגמה זו פותרת הן את בעיית הפיצול הסמנטי והן את אתגרי העקיבות, והופכת את התאימות המשפטית מאימות בדיעבד (ex post) למשילות מראש (ex ante), ובכך מציעה נתיב טכני ניתן להרחבה לשקיפות של אחריות במערכות AI בסיכון גבוה.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
פרוטוקול
בנייה של רשת עצבית גרפית עבור גרף ידע משפטי של בינה מלאכותית רפואית
כפי שמוצג ב-איור 1, המסגרת המוצעת כוללת שלושה מודולים עיקריים. שכבת הקלט משלבת נתונים ממקורות מרובים לתוך גרף הטרוגני באמצעות קידוד ישויות מולטי-מודאלי ומידול קשתות מכוונות. שכבת ה-GCN המודעת ליחסים מבצעת לאחר מכן יישור סמנטי חוצה-מודאלים באמצעות משקולות ותשומת לב (attention) ספציפיות לסוג, ובכך מייצרת שיבוצי צמתים (node embeddings) מאוחדים. לבסוף, שיבוצים אלה תומכים במעקב אחר הטיות (באמצעות גבב גרדיאנטים וזיהוי קהילות) ובניטור תאימות דינמי (באמצעות מיפוי צמתים בזמן אמת ומעקב אחר משקלי קשתות), כאשר הפלט מספק ראיות שיוך ניתנות לפירוש והתרעות סיכון עבור הרגולטורים.
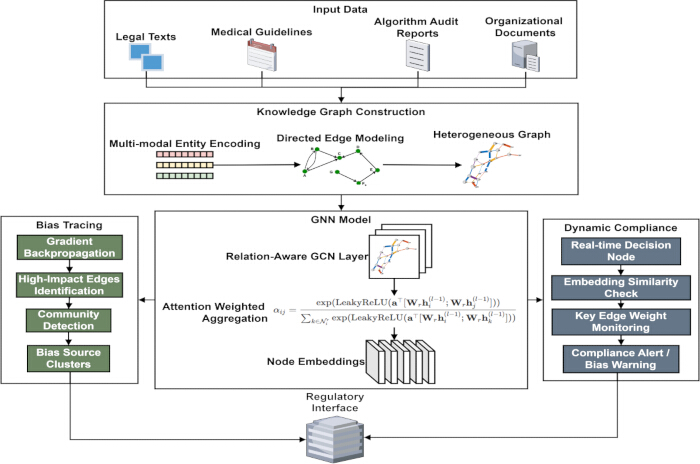
איור 1: ארכיטקטורת גרף ידע משפטי ומעקב אחר הטיות עבור AI רפואי. דיאגרמה זו ממחישה את זרימת העבודה הכללית של המסגרת המוצעת. שכבת הקלט ממזגת נתונים הטרוגניים ממקורות מרובים (טקסטים משפטיים, הנחיות קליניות, דוחות ביקורת של אלגוריתמים), המקודדים לארבעה סוגי ישויות (סעיפים משפטיים, התנהגויות רפואיות, מודולים אלגוריתמיים, גופים אחראים) ומחוברים על ידי ארבעה קשרי סמנטיקה-משפטית מכוונים (הפרה, בסיס, טריגר, ייחוס). שכבת ה-GCN המודעת לקשרים מבצעת יישור סמנטי חוצה-מודאליות באמצעות משקולות ותשומת לב (attention) ספציפיות לסוג הישות. מודול המעקב אחר ההטיות משתמש בהפצה לאחור של גרדיאנטים כדי לזהות קשתות בעלות תרומה גבוהה, ולאחר מכן מיישם זיהוי קהילות כדי לאתר צבירי צמתי-שורש. נטר compliance הדינמי ממפה החלטות בזמן אמת לצמתים זמניים, מעריך דמיון embedding אל מול סעיפים משפטיים, ועוקב אחר התפתחות משקולות הקשתות לצורך התרעה מוקדמת. הפלטים כוללים ראיות ייחוס ניתנות לפירוש והתרעות סיכון. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
קידוד מובנה של גרף הטרוגני עבור ישויות משפטיות וקשרים
ארבע ישויות יסוד נגזרות באופן עקבי מחוקי רגולציה של בינה מלאכותית רפואית, הנחיות לפרקטיקה קלינית ודוחות ביקורת של אלגוריתמים: סעיפים משפטיים, פרוצדורות רפואיות, מודולים של אלגוריתמים וישויות אחראיות. מודל נפרד ללמידת ייצוג תכונות מוצע עבור כל סוג של ישות על מנת שיהיו מובחנות סמנטית. צמתי הסעיפים המשפטיים מאורגנים כך שהם מכילים את מספר הסעיף המשפטי, וזה משמש כמזהה ייחודי (ID) עבור הסעיף. במקביל, מוגדר מדד כימות חומרת ענישה כדי לציין את רמת האחריות המשפטית הקשורה לסעיף, וכתוצאה מכך, נקבע וקטור תכונות.
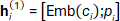 (1)
ci הוא מספר הרשומה, Emb(·) מייצג את מיפוי ההטמעה (embedding mapping) מממד נמוך, ו-[·;·] מייצג את פעולת שרשור הווקטורים. ייצוג זה שומר הן על המבנה הפורמלי והן על חומרת העונש של הטקסט המשפטי, ובכך תומך בהסקה בין הצהרות שונות.
צמתי התנהגות רפואית הם סטנדרטיים ומקודדים על בסיס מערכת סיווג של פעולות קליניות, תוך חילוץ רמת הסיכון שלהם rj ∈ {1,2,3} ומערכת תוויות התרחישים הרלוונטיות sj ⊂ S, כאשר S היא המערכה המלאה של קטגוריות תרחישים שהוגדרו מראש. קידוד multi-hot משמש לעיבוד מערכת התוויות, והוא משרשר לרמת הסיכון המוטמעת (embedding) כדי ליצור ייצוג ראשוני:
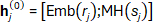 (2)
אסטרטגיה זו מבטיחה כי לסוגים שונים של התנהגויות רפואיות יהיו יחסי מרחק מדידים במרחב הווקטורי, מה שמאפשר השוואות בין תרחישים שונים. פונקציית השילוב הטקסטואלי Emb(·) מומשה באמצעות המודל השפתי המשפטי הסיני המאומן מראש Lawformer (שאימן על קורפוס משפטי סיני רחב היקף), כאשר ממד הפלט קבוע על 768.
על בסיס התלויות הלוגיות והמגבלות המשפטיות בין הישויות, נקבעו ארבעה סוגים של קשרים סמנטיים מכוונים: "הפרה" (violation), "בסיס" (basis), "טריגר" (trigger) ו"ייחוס" (attribution), כאשר כל אחד מהם תואם לדפוסי סיבתיות משפטיים שונים. לכל ק ضلع eij ⊂ E מוקצית תווית מסוג tij ⊂ T = {violate, base, trigger, attribute} לצורך העברת הודעות עוקבת למודעות לקשרים. בניית הקשרי הקצות עוקבת בקפידה אחר מנגנון התאמת כללי הדומיין: כאשר התנהגות רפואית חורגת מהדרישות הנורמטיביות, נקבע קשר "הפרה" המצביע מצומת ההתנהגות אל הסעיף המשפטי הרלוונטי; כאשר הסעיף המשפטי משמש כבסיס לציות טכני עבור פעולה מסוימת, נקבע קשר "בסיס"; אם הפלט של מודול האלגוריתם מפעיל באופן ישיר ביצוע של התנהגות רפואית ספציפית, מחובר קשר "טריגר"; קשר ייחוס אחריות נקבע על בסיס מסמכי האחריות של הארגון ומסקנות הביקורת, ובכך נוצר קשר "ייחוס" בין הגורם האחראי לבין ההפרה או הפגם באלגוריתם.
לאחר אתחול כל הצמתים, נוצר גרף הטרוגני (V, E, H0), כאשר V היא קבוצת הצמתים, E היא קבוצת הקשתים המכוונות עם תוויות סוג, ו-H0 היא מטריצת המאפיינים הראשונית. כדי לשפר את היכולת האפיתיבית-סמנטית של מבנה הגרף, מאפייני הצמתים מנורמלים:
 (3)
μk ו-σk הם הממוצע וסטיית התקן של תכונת הצומת ה-k-ית במערך האימון, בהתאמה, ו-∈ הוא קבוע קטן למניעת חלוקה באפס. נורמליזציה מבטיחה שתכונות הטרוגניות ממקורות מרובים ישתתפו בפעולויות קונוולוציה של גרף (graph convolution) בקנה מידה אחיד, ובכך מונעת מהשפעות של דומיננטיות מספרית להפריע ללמידה סמנטית. מודל הגרף המבני המתקבל נושא באופן מלא את הטופולוגיה היחסית של ארבעת האלמנטים ממדיים של חוק, התנהגות, טכנולוגיה ואחריות במערכת ה-AI הרפואית, ומספק בסיס גרפי חישוב עבור ניתוח הפצת הטיות עוקב.
שיפור יישור קונבולוציית גרפים עבור סמנטיקה משפטית חוצת-מודליים
רשת קונוולוציונית של גרפים מודעת ליחסים (relation-aware graph convolutional network)38,39, המרחיבה את מסגרת ה-Relational Graph Convolutional Network (R-GCN), משמשת להפצת מאפיינים על פני מספר שכבות של הגרף ההטרוגני הראשוני. בעוד ש-R-GCN מציגה מטריצות טרנספורמציה לכל יחס עבור נתונים רלציוניים כלליים, הגישה שלנו משלבת בנוסף מנגנון קשב (attention mechanism) למידה כדי לשקלל באופן דינמי את תרומות השכנים, ומגדירה ארבעה סוגי יחסי משמעות משפטית ספציפיים (הפרה, בסיס, טריגר, ייחוס) המותאמים לניתוח ציות של בינה מלאכותית רפואית. הפעולה של כל שכבה מגדירה פרמטרים באופן עצמאי לתהליך הטרנספורמציה בהתבסס על הסוג הסמנטי של הקשתות. עבור כל צומת מטרה, מידע השכנות שלו מקובץ ומאוגד לפי סוגי הקשתות המחברות. כל סוג של יחס מצויד במטריצת טרנספורמציה ליניארית ייעודית כדי להבדיל בין המאפיינים המועברים לאורך נתיבים סמנטיים משפטיים שונים40,41. אם הקשת בין צומת סעיף משפטי לצומת התנהגות רפואית היא מסוג "בסיס", כאשר צומת הסעיף המשפטי מקבל הודעה מצומת התנהגות רפואית, הוא מחיל את מטריצת המשקלים המתאימה כדי למפות את מאפייני השכן מרחבית. באופן דומה, כאשר צומת התנהגות רפואית שולח פלט באמצעות צומת מודול של סכימת אינטגרציית קשתים מסוג "טריגר" אל מודול אלגוריתם, מטריצת הפרמטרים של ה-triggered, הקשורה ליחס זה, מבצעת טרנספורמציה של המאפיינים. פעולה זו מחקה את הנזילות של סוגים שונים של לוגיקה משפטית, ומממשת/מעדכנת שכבות לוגיות שונות כדי לשמור על עצמאות סמנטית במהלך זרימת המידע ללא רעש חוצה-מודליות. האיגור מוגדר באופן הבא:
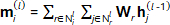 (4)
mi(l) מייצג את המידע המקיף שנאסף על ידי צומת i בשכבה l, Nil היא קבוצת השכנים שלו תחת יחס r, Wr היא מטריצת הטרנספורמציה הליניארית, ו-hj(l−1) הוא ייצוג ההטמעה (embedding) של צומת השכן בשכבה הקודמת.
מנגנון קשב (attention mechanism) למידה מוצג במהלך אגרגציית ההודעות כדי להתאים באופן דינמי את עוצמת ההשפעה של צמתים שכנים שונים על עדכון הייצוג של צומת היעד42,43. מקדם הקשב נוצר בהתבסס על הגורמים הכפולים של דמיון בתכונות הצומת וחשיבות משפטית, ללא הסתמכות על משקולות קבועות מראש. עבור צמתי סעיפי חוק, בעת קבלת מאפייני התנהגות רפואית של שכנים, ציון הקשב מחושב על בסיס הערך הכמותי של עוצמת הענישה הקשורה לאחרונים; כאשר צומת מודול האלגוריתם ממזג מידע על התנהגות רפואית, הוא מתמקד בשכנים בעלי רמות סיכון תפעולי גבוהות יותר. משקל הקשב מחושב באופן הבא:
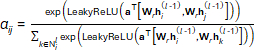 (5)
αij הוא מקדם הקשב (attention coefficient) של צומת j עבור צומת i, ו-a הוא וקטור הקשב הניתן ללמידה. מודל זה מאפשר זיהוי אוטומטי של נתיבים מחוברים בעלי סיכון גבוה או אילוצים גבוהים במהלך אימון מקצה לקצה, תוך הקצאת קשב גבוה יותר עבורם. השכאה (embedding) הסופית והמעודכנת של הצומת נקבעת על ידי הודעות משוקללות וחיבורים שאריתיים (residual connections).
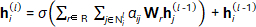 (6)
σ היא פונקציית ההפעלה, ותכנון שאריתי (residual design) מפחית את בעיית היעלמות הגרדיאנט בהעברה עמוקה ומבטיח יציבות בנוכחות קונפליקטים סמנטיים מרובים. בעקבות L = 3 שכבות קונבולוציה גרפית (כל אחת עם ממד נסתר של 256 והפעלה מסוג ReLU), ההטמעות (embeddings) של כל הצמתים משלבות באופן חלק מידע הקשרי חוצה-מודאליות והופכות לייצוגים מאוחדים עם יכולות הבחנה סמנטית משפטית.
שתי דיאגרמות חלופיות לניתוח תאימות משפטית עבור ה-AI למסירת שירותי בריאות מוצגות ב-איור 2, במטרה להמחיש את סוגי הקשרים המשפטיים ונתיבים להפצת הטיות, המצביעים על מקורות פוטנציאליים להטיות בקבלת החלטה זו. איור 2A מציג את ההשפעה של קשרים סמנטיים משפטיים שונים, כאשר ארבעה סוגי קשרים מקודדים בצבעים, ועבור כל סוג הקשתים מובחנות בצבע שונה. עובי הקשת תואם למשקל הקשב (attention weight) של אותו קשר ספציפי, כלומר, עד כמה קשר זה תורם להחלטת ה-AI. קשת עבה מעידה למעשה על קשר משפטי דומיננטי בהחלטה, ובמקרה זה היא סיפקה מוטיבציה מספקת לתוצאת המקרה. גודל הצומת נמדד לפי תרומתו להפרות: צמתים גדולים יותר מסמנים קשר חזק יותר בין ההתנהגות לסעיפים משפטיים ספציפיים, ולפיכך סיכון פוטנציאלי גבוה יותר. ויזואליזציה זו מספקת שכבה סמנטית משפטית ברורה, המאפשרת לנו לזהות את הנתיבים המשפטיים החזקים והמסוכנים ביותר בקבלת החלטות של AI. איור 2B מצביע גם על נתיבים בעלי תרומה גבוהה (להפצת הטיות) עם דגש על קשתים בעלות תרומה גבוהה, המודגשות ובצמידות לקו מקווקו (למשל B1-B3) בתהליך קבלת ההחלטות. הכפלת הרוחב של קשתים אלו מייצגת את חשיבותן בהפצת הטיות סיסטמיות. אילו שילובים של כללים משפטיים והתנהגויות טכניות גורמים לאפקט הגברה זה של הטיות מוצגים ב-איור 2. ניתוח זה לא רק חושף את נתיב הפצת ההטיה, אלא גם מסייע בזיהוי מקור ההטיה, שעל בסיסו ניתן לבצע ביקורת תאימות ולקבוע את האחריות של כלי ה-AI.
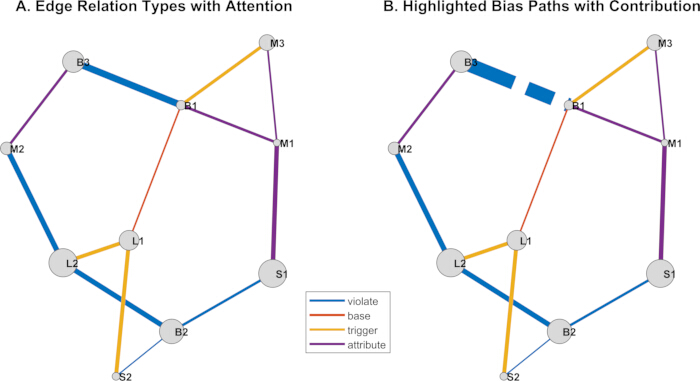
איור 2: ניתוח תאימות משפטית והפצת הטיה ב-AI של שירותי בריאות (דוגמה להמחשה). (A) קשרי סמנטיקה משפטית מקודדים בצבעים: הפרה (אדום), בסיס (כחול), טריגר (ירוק), שיוך (כתום). עובי הקשת פרופורציונלי למשקל התשומת לב (attention weight), המצביע על השפעת כל קשר על החלטת ה-AI. גודל הצומת פרופורציונלי לתרומתו להפרה, מה שמדגיש ישויות בסיכון. (B) תת-גרף של הפצת הטיה: קשתות בעלות תרומה גבוהה הן מודגשות ומקווקוות (למשל, B1‑B3); קשתות ברוחב כפול מעידות על הגברה של הטיה מערכתית. ויזואליזציה זו תומכת בזיהוי נתיבים משפטיים דומיננטיים, מקורות להטיה וביקורת תאימות. קנה מידה למדידה או פסי זמן (error bars) אינם רלוונטיים מאחר שמדובר באיור סכמטי. אנא לחצו כאן להצגת גרסה גדולה יותר של איור זה.
מנגנון נסיגה של תת-גרף עבור נתיב הפצת הטיות
במחקר זה, "הטיה" (bias) מוגדרת כסטייה שיטתית של פלט מערכת AI מההחלטה המצופה מבחינה קלינית ומשפטית, הנמדדת על ידי הפער בין ציון הסיכון החזוי של המודל לבין תווית הציות המהווה את האמת המוחלטת (ground-truth). אות ההטיה מ quantified כהפסד אנטרופיה צולבת (cross-entropy loss) בין הפלט הסופי של האלגוריתם לבין אינדיקטור בינארי של ציות (1 לציות, 0 לאי-ציות), המצברים על פני כל מופעי ההחלטה בבצק (batch).
לאחר אימון רשת הנוירונים הגרפית, נעשה שימוש ביכולת הגזירה שלה כדי לבצע ניתוח של הפצה לאחור (backpropagation) על אות ההטיה בשכבת הפלט. החל מצומת ההחלטה של האלגוריתם המזהה חריגות, מחושב גודל הגראדיינט של פונקציית ההפסד ביחס לכל ק ضلع מקשר כדי לכמת את תרומתה של כל קשת ליצירת ההטיה. תהליך זה מיושם באמצעות מסגרת גזירה אוטומטית, הנסיגה שכבה אחר שכבה לאורך הקשתים המכוונות במבנה הגרף, כדי לקבל את עוצמת ההשפעה של כל טרנספורמציית פרמטר של קשת על השינוי בפלט הסופי. ככל שערכו המוחלט של הגראדיינט גבוה יותר, כך הקשר המשפטי-טכני המיוצג על ידי אותה קשת הוא דומיננטי יותר בהפצת ההטיה. תרומתה של קשת מוגדרת כ:
 (7)
Lbias הוא ההפסד הדיפרנציאבילי המוגדר עבור התנהגות מוטה, ו-wi הוא וקטור משקלי הכניסה המתאים לסוג הקשת. ערך גרדיאנט זה משקף את מידת השתתפותה של מערכת יחסים סמנטית ספציפית בהטיית השיוך הנוכחית. לאחר שכל הקשתות מקבלות ציון באופן זה, נקבע סף דינמי τ כדי לסנן את קבוצת הקשתות בעלות התרומה הגבוהה Ehigh, שתרומתן עולה על gij > τ, ובכך נוצר תת-הגרף הראשוני להפצת ההטיה Gbias = (Vbias, Ehigh). באופן ספציפי, τ נקבע כאחוזון ה-85 של ערכי הגרדיאנט המוחלטים בכל הקשתות בכל תקופת אימון (epoch), ובכך מובטח שרק 15% מהקשתות המשפיעות ביותר יישמרו לבניית תת-הגרף. תת-גרף זה מתמקד בנתיבי קישור מרכזיים בעלי הסבירות הגבוהה ביותר להניע הטיה שיטתית, ובכך הוא מצמצם את מרחב החיפוש ומשפר את היעילות של מעקב אחר המקור.
בתוך תת-הגרף של התפרוסות ההטיה (bias-propagation) שהוקם, מורץ אלגוריתם לזיהוי קהילות המודרך על ידי אשכולה ספקטרלי (spectral clustering) כדי לזהות מבני אשכולות של צמתים בעלי יישור גבוה. תהליך זה מבוסס על פירוק מטריצת לפלאס הנורמלית של תת-הגרף, הממפה שיכובים (embeddings) של צמתים למרחב ספקטרלי בעל ממד נמוך ומיישם אסטרטגיית אשכולה מודעת לצפיפות במרחב זה, כדי להבטיח שצמתים מסוגים שונים (כגון סעיפים משפטיים ומודולים אלגוריתמיים) יקובצו לאותו אשכול כאשר הם קשורי תפקודית באופן הדוק. כל קהילה שזוהתה מייצגת לולאה פונקציונלית פוטנציאלית או יחידה של ריכוז אחריות. תוצאות חלוקת הקהילות מונעות על ידי יעדי האופטימיזציה הבאים:
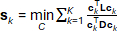 (8)
L=D−A היא מטריצת הלפלאסיאן של תת-הגרף, A היא מטריצת הסמיכות, D היא מטריצת הדרגה, ck הוא וקטור האינדיקציה של הקהילה ה-k, ו-K הוא מספר הקהילות שנקבע מראש. קריטריון זה ממקסם את הפרש החיתוך המינימלי בין הקהילות, ובכך מבטיח קשרים פנימיים הדוקים.
כעת, מבוצע ניתוח מרובה-שכבות המבוסס על קומפוזיט עבור כל קהילה. אם קהילה מכילה צמתים של סעיפי חוק וצמתים של מודולי אלגוריתם, היא מסומנת כמקור פוטנציאלי להטיה. כדי לבחון את הקשר הסיבתי, מבוצע ניסוי התערבותי: כל הקשתות באזור זה מוסרות זמנית מהגרף, תהליך קבלת ההחלטות מורץ שוב, וההבדלים במדידות ההטיה נבחנים. מדד התקפות הסיבתית מוגדר כ:
 (9)
Borig ו-Bmask מייצגים את עוצמת ההטיה של המודל המקורי ואת ההטיה לאחר מיסוך, בהתאמה. אם מדד התקינות הסיבתית גבוה באופן משמעותי מהסף שנקבע מראש, המשמעות היא שצבר הצמתים זוהה כמקור הטיה הניתן להסבר, אשר ינחה בהמשך את תיקון הציות ואת הקצאת הכשלים.
אימות תאימות דינמי של מגבלות משפטיות
מקרי קבלת החלטות בזמן אמת המופיעים במהלך פעולתו של מערכת בינה מלאכותית רפואית מוצגים כצמתים ארעיים ומוטמעים במרחב של גרף ידע נלמד. וקטור מאפיינים ראשוני נוצר על ידי כל צומת באמצעות קריאת הקשר הקלט שלו, התנהגות הפלט ומצב האלגוריתם. לאחר מכן, וקטור זה מוזן לרשת עצבית גרפית עם פרמטרים קפואים לביצוע הפצה קדימה בשכבה אחת, מה שמניב הטמעה התואמת לגרף הידע מבלי לשנות את מבנה הגרף המקורי. באופן זה, הדבר מאפשר להשוות בין צמתים ארעיים לבין צמתי סעיפים משפטיים במרחב סמנטי משותף.
כעת חשבו את דמיון הקוסינוס (cosine similarity) בין הצומת הזמני לבין כל אחד מצומתי סעיפי החוזה:
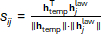 (10)
htemp הוא הייצוג (embedding) של הצומת הזמנית, ו-hjlaw הוא הייצוג של צומת סעיף החוק ה-j. ערך הדמיון משקף באופן וירטואלי את מידת ההתאמה הסמנטית בין ההחלטה הנוכחית לכל אילוץ משפטי. סף תאימות דינמי θ נקבע על בסיס התפלגות הדמיון של דגימות תאימות היסטוריות כדי להתאים את גבול השיפוט תחת תרחישי יישום שונים. באופן ספציפי, θ = µ - 2σ, כאשר µ ו-σ הם הממוצע וסטיית התקן של התפלגות דמיון הקוסינוס שחושבה מתוך קבוצת אימות של 500 מקרי החלטה תאימים ידועים.
אם ציון דמיון קוסינוס יורד מתחת לסף הציות הדינמי, כלל המשפט התואם נחשב כמי שהופרו, דבר המפעיל את מנגנון ההתרעה על אי-ציות. ההודעה כוללת גם את מספר הסעיף המשפטי התואם המינימלי, את ערך הדמיון ואת כיוון ניתוח השוני, אשר אמורים להספיק כדי שהרגולטורים יוכלו לפעול במהירות. גישה זו מספקת מיפוי ניתן לפירוש מקבלת החלטות מעורפלת למרחב של סמנטיקה משפטית, ומאפשרת בדיקת ציות בזמן אמת.
במהלך פעולה רציפה, נערך מעקב אחר מגמת שינוי המשקל של קצוות חיבור מרכזיים בין טכנולוגיה למשפט בתת-גרף של התפשטות ההטיה. דגש מיוחד ניתן לקצוות המחברים בין צמתי מודולי אלגוריתם לבין צמתי סעיפים משפטיים, שכן הם מייצגים באופן ישיר את עוצמת התגובה של ההתנהגות הטכנית לרגולציות ספציפיות. פרמטרי מטריצת הטרנספורמציה עבור כל קצה מטרה נרשמים במהלך ההסקה, והנורמה שלהם נחלית כאינדיקטור דינמי של התפתחות עוצמת המתאם ביניהם. הגדרת רצף עוצמת הקצוות היא:
 (11)
wt מייצג את נורמת פרובניוס (Frobenius norm) של מטריצת המשקולות המתאימה לקשר בין מקטע eij בחותמת זמן t, ו-Wkl(t) היא מטריצת הפרמטרים שנעשה בה שימוש בפועל במודל באותו זמן. אינדיקטור זה משקף את עומק הלמידה של המודל או את תלותו באילוץ המשפטי.
מבחן מונוטוניות של חלון גליש (sliding-window) מבוצע על הרצף, ומבחן סימן (sign test) משופר משמש כדי לקבוע האם נצפית מגמת עלייה משמעותית. אם העליות לאורך N שלבי זמן רצופים מקיימות את תנאי הדומיננטיות החיובית, אזי הק ضلع (edge) נחשב ככזה המפגין תופעת חיזוק חריגה. בשילוב נוסף של נתוני תרומת הגראדיאנט ההיסטוריים, אם הضلע זו זוהתה כנתיב בעל השפעה גבוהה בסבב הקודם של ניתוח מעקב מקור, יופעל תהליך התראה מוקדמת על הצטברות הטיה מערכתית.
לבסוף, מופק דוח מעקב אחר המקור, הכולל מידע על הצמתים בשני קצוות הקש המטרה, עקומות שינוי משקל, סטטיסטיקה על תדירות ההחלטות הרלוונטיות והמלצות פוטנציאליות לייחוס. מנגנון זה מאפשר מעבר משיפוט תאימות סטטי לחיזוי סיכונים דינמי, ובכך תומך בהתערבות פרואקטיבית בחריגות מוסדיות פוטנציאליות.
נתונים עיצוביים וניסוייים
כדי לוודא את יעילותו של המסגרת המוצעת, מאמר זה בונה מערך נתונים הטרוגני רב-מקור המשלב רגולציות אמיתיות ונתוני סימולציה, ומעצב ניסויי בקרה קפדניים. מקורות הנתונים כוללים רגולציות לאומיות לבינה מלאכותית רפואית, הנחיות לטיפול קליני, דוחות ביקורת של אלגוריתמים מקור פתוח ויומני החלטות של סימולציה. לאחר עיבוד מקדים, נבנה גרף ידע הטרוגני המשמש כנקודת ייחוס (benchmark) המכיל 285 צמתים (85 סעיפי חוק, 120 התנהגויות רפואיות, 42 מודולי אלגוריתם ו-38 גופים אחראים) ו-1247 קשתות מכוונות, כפי שמוצג ב-איור 3.
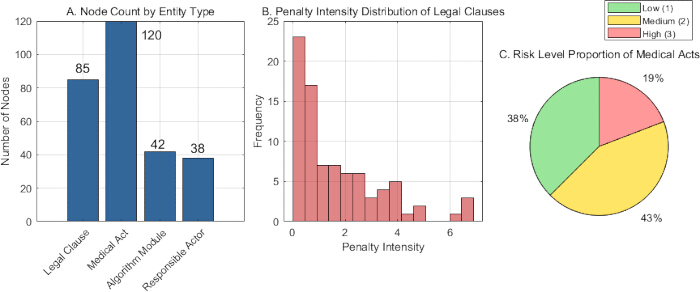
איור 3: התפלגות ומאפיינים של סוגי ישויות הטרוגניות. (A) תרשים עמודות המראה את מספר הצמתים עבור כל סוג ישות: סעיפים משפטיים (85), התנהגויות רפואיות (120), מודולי אלגוריתם (42), גופים אחראים (38). (B) היסטוגרמה של עוצמת קנסים עבור צמתי סעיפים משפטיים, המחולקת לקטגוריות נמוכה (0‑0.33), בינונית (0.34‑0.66), וגבוהה (0.67‑1.0); הציר האנכי מייצג את מספר המופעים. (C) תרשים עוגה של התפלגות רמות הסיכון בקרב צמתי התנהגויות רפואיות: נמוך (19%), בינוני (43%), גבוה (38%). כל הערכים הם ספירות מוחלטות או אחוזים; לא מוצגים פסי שגיאה כיוון שמדובר בסטטיסטיקה תיאורית של מערך הנתונים. אנא לחצו כאן להצגת גרסה גדולה יותר של איור זה.
איור 3 ממחיש את ההפצה והמאפיינים של צמתי ישויות בגרף הידע ההטרוגני. איור 3A מראה את הפצתו של מספרם של ארבעה סוגי צמתי ישויות, כאשר צמתי "התנהגות רפואית" הם הנפוצים ביותר (120), ואחריהם "סעיפי חוק" (85), בעוד ש"מודולי אלגוריתם" (42) ו"ישויות אחראיות" (38) הם מעטים יחסית. זאת מכיוון שהגרף תוכנן מבנית על בסיס התנהגות וכללים. איור 3B מציג את הפצת עוצמות הענישה עבור צמתים המייצגים סעיף חוק ייחודי, כאשר העוצמה מודדת את חומרתה של האחריות המשפטית. הנתונים מצביעים על כך שישנם מעט סעיפים עם עוצמת ענישה גבוהה, ומרביתם נמצאים בטווח עוצמה בינוני עד נמוך, דבר התואם את המציאות שבה קיימים רק מספרים בודדים של סעיפי הפרה חמורים במערכות משפטיות בעולם האמיתי. איור 3C ממחיש את הפצת רמות הסיכון בצמתי התנהגות רפואית, כאשר להתנהגויות בסיכון בינוני יש את הפרופורציה הגדולה ביותר (43%), בעוד שהתנהגויות בסיכון נמוך הן בעלות הפרופורציה הנמוכה ביותר (19%); דבר זה חושף כי תרחישים רפואיים פועלים בדרך כלל באופן שגרתי, ופעולות בסיכון גבוה כפופות לאילוצי קישור קפדניים יותר בגרף. נתונים סטטיסטיים אלו מצדיקים יחד את סכמת קידוד ביטול העמימות של ישויות שאומצה בבניית גרף הידע, כדי לספק תמיכה במאפיינים עבור יישור קונבולוציוני של גרפים בהמשך.
כל מערך הנתונים חולק באופן אקראי לקבוצות אימון (70%), תיקוף (10%) ובדיקה (20%), תוך ביצוע שכיבה (stratification) לפי סוג הצומת והתפלגות הקשרים כדי לשמר את מבנה הגרף הכללי בכל פיצול. אותו חלוקה שימשה באופן עקבי עבור כל שיטות הבסיס (baseline) כדי להבטיח השוואה הוגנת. בנוסף לחלוקה בסיסית זו, שלושת מדרגי הצפיפות של גרף הידע (דליל, בינוני, צפוף) ושלוש הגדרות המורכבות הבין-שיפוטיות (בודד, בילטרלי, מולטילטרלי) שתוארו לעיל משמשים כסביבות בדיקה מעשיות ועצמאיות, המעריכות יחד את חסינות השיטה תחת תנאים משתנים של שלמות נתונים וחפיפה רגולטורית. כדי לבנות תוויות אמת (ground-truth) להערכת לוקליזציית הטיות, אימצנו אסטרטגיה דו-שלבית: (1) הערכה על ידי מומחים — שלושה מומחים משפטיים ורפואיים סקרו באופן עצמאי את יומני ההחלטות וזיהו את צמתי שורש הגורם ואת נתיבי ההפצה עבור כל הפרת ציות רשומה, כאשר חילוקי דעות הוכרעו ברוב קולות; (2) הזרקה סימולטיבית — לבדיקה מבוקרת, הזרקנו באופן מלאכותי אותות הטיות ל-20 נתיבי החלטה שנבחרו אקראית על ידי שיבוש משקלי הקצוות בגרף הידע, ובכך הבטחנו שצמתי המקור האמיתיים והקצוות המושפעים יהיו ידועים מראש.
עבור כל שיטות הבסיס (TransE, ComplEx, Graph Neural Networks (GNN) Explainer, KG-BERT ו-Node2Vec), השתמשנו באותה תצורת אימון (אופטימייזר Adam, קצב למידה 1 × 10⁻³, גודל אצווה 64, 100 תקופות/epochs) ובאותן חלוקות נתונים כמו בשיטה שלנו כדי להבטיח השוואה הוגנת. עבור TransE ו-ComplEx, ממד השקיעה (embedding dimension) נקבע ל-256 עם שוליים (margin) של 1.0; עבור KG-BERT, השתמשנו במודל BERT-base מאומן מראש עם גודל אצווה של 16 ואורך רצף מקסימלי של 128; עבור GNNExplainer, השתמשנו ב-GCN בעל 3 שכבות עם אותו ממד נסתר של 256; ועבור Node2Vec, קבענו את אורך ההליכה ל-80, את מספר ההליכות לכל צומת ל-10 ואת ממד השקיעה ל-256.
כדי להבטיח השוואה הוגנת, התאמנו את כל שיטות הבסיס לאותן משימות לוקליזציה של הטיות, דהיינו זיהוי צומת-שורש ושחזור נתיב הפרופגציה. עבור TransE, ComplEx ו-Node2Vec, שאינן ניתנות להסבר באופן מובנה, חישבנו את הגרדיאנט של הפסד ההטיה ביחס להטמעה (embedding) של כל צומת והשתמשנו בעוצמת הגרדיאנט כציון חשיבות הצומת; צמתי שורש נבחרו על ידי סף (thresholding) של ציונים אלו, ונתיבי פרופגציה שוחזרו על ידי שימור קצוות עם תרומות הגרדיאנט הגבוהות ביותר. עבור GNNExplainer, השתמשנו ישירות במנגנוני חשיבות-הקצוות ומסכות-הצמתים המובנים שלו כדי להפיק הן את צמתי השורש והן את תת-הגרפים. עבור KG‑BERT, הפועל על שלשות, המרנו כל קצה בגרף לשלשה טקסטואלית והשתמשנו במשקולות הקשב (attention weights) של המודל על הישויות כדי להסיק את חשיבות הצומת, ולאחר מכן השתמשנו באותה אסטרטגיית סף לשחזור הנתיב. באמצעות התאמות אלו, כל שיטת בסיס מייצרת הן תחזיות של צומת-שורש והן תחזיות של נתיב-פרופגציה, מה שמאפשר הערכה אחידה בין כל השיטות.
ההערכה מתמקדת בארבע יכולות בסיסיות: דיוק של התאמה סמנטית, יכולת לאתר הטיות, יעילות של דיווח ובדיקה (accountability), והכללה בין תחומים שונים. כמו כן, היא מציגה שלושה משתני בקרה חשובים, המדמים מורכבות מהעולם האמיתי.
1) מדרג צפיפות של גרף ידע: כדי להעריך את ביצועי השיטה ברמות השלמה משתנות של מידע, נוצרו שתי תתי-קבוצות מתוך הגרף המלא הבסיסי (צפיפות D = 1.0) בהתבסס על אסטרטגיה של השמטה אקראית של קשתות באופן הבא:
גרף דליל (D ~ 0.3): 30% מהקשתות נשמרות באופן אקראי, המדמה את שלב הבנייה המוקדמת של הידע כאשר מידע רב חסר.
גרף בצפיפות בינונית (D ~ 0.6): 60% מהקשתות נשמרות באופן אקראי, באופן המדמה תרחיש טיפוסי של מבנה ידע ידוע חלקית.
גרף צפוף (D = 1.0): שימוש בכל 1247 הקשתות, המתאימים לתרחיש אופטימלי של ידע שלם יחסית.
2) מצב תדירות קבלת החלטות של בינה מלאכותית רפואית: שלושה עומסי זרימת החלטות מלאכותיים נקבעו כדי לבחון את ביצועי זמן-אמת של ניטור ציות דינמי:
תדר נמוך 10 Hz: בממוצע, נוצרים 10 אירועי החלטה לשנייה, המדמים ניטור של מערכות בקנה מידה קטן או מערכות בעלות אתר יחיד.
תדר בינוני 50 Hz: 50 אירועי החלטה לשנייה, המדמים את עומס מערכת ה-AI של מוסדות רפואיים אזוריים או בקנה מידה בינוני.
תדר גבוה של 100 Hz: 100 אירועי החלטה לשנייה מדמים תרחישי לחץ של מקביליות גבוהה עבור שירותי AI המופעלים בבית חולים גדול או בפלטפורמת ענן.
3) מדרג מורכבות בין-סמכותי: כדי לבחון את יכולת ההעברה של מידול מגבלות משפטיות, הוקמו שלוש קבוצות בדיקה מבוססות מורכבות:
סמכות שיפוט יחידה: מורכב אך ורק מהחוקים והתקנות הסיניים הנוכחיים המסדירים בינה מלאכותית רפואית.
סמכות שיפוט דו-צדדית: משלבת את המשטרים הרגולטוריים של סין והאיחוד האירופי, כאשר כ-15% מהכללים סותרים וחופפים.
סמכות שיפוט רב-צדדית: בהתבסס על שני המקרים הראשונים, היא משלבת בנוסף כללי פרטיות ואבטחה מתוך ה-HIPAA האמריקאי (Health Insurance Portability and Accountability Act), ובכך יוצרת סביבת בדיקה שבה המערכות המשפטיות של שלושת המשטריים המשפטיים שזורות זו בזו, מה שמעלה את שיעור קונפליקט הכללים לכ-25%.
המדדים המרכזיים הבאים שימשו להערכה כמותית:
1) דיוק יישור סמנטי: מודד את יכולתו של הגרף למדל את הקשרים בין ישויות משפטיות וטכניות.
דיוק יישור ישויות:
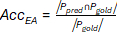 (12)
Ppred היא קבוצת זוגות הישויות המיושרים שנחזו על ידי המודל, ו-Pgold היא קבוצת היישורים המוזהבים שסומנו על ידי מומחים.
שמירה על שלמות הקשרים:
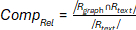 (13)
Rgraph היא קבוצת היחסים המשוחזרת בגרף, ו-Rtext היא קבוצת היחסים המפורשות שהופקו מהטקסט המשפטי המקורי.
2) יכולת איתור מקור ההטיה: הערכת היעילות של מעקב אחר הגורמים השורשיים ונתיבי ההפצה של ההטיה.
שיעור השחזור של צומת השורש:
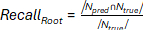 (14)
Npred היא קבוצת צומי מקור ההטיה שזוהו על ידי המודל, ו-Ntrue היא קבוצת צומי המקור האמיתיים שסווגו על ידי מומחים.
דיוק נתיב ההגברה:
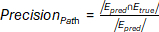 (15)
Epred היא קבוצת הקשתות בתת-גרף של התפשטות ההטיה (bias propagation) שהושךה על ידי המודל, ו-Etrue היא קבוצת קשתות התפשטות ההטיה האמיתית.
3) יעילות מעקב אחרי אחריות: בדיקת ביצועי המערכת בתרחישי ניטור בזמן אמת.
שיהוי מעקב ממוצע:
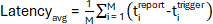 (16)
M מייצג את מספר הבקשות הכולל, ו- titrigger ו- tireport הם חותמי הזמן של טריגר ההטיה ה- i וההפקה של דוח המקור, בהתאמה.
תפוקת המערכת:
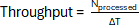 (17)
Nprocessed מייצג את מספר בקשות המעקב בו-זמנית שעובדו בהצלחה בתוך חלון הזמן ΔT.
4) יכולת הכללה בין תחומים: אימות התמיכה של השיטה במערכות משפטיות שונות.
כיסוי שיפוטי:
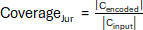 (18)
Cencoded מייצג את מספר סעיפי הסמכות השונים שקודדו בהצלחה לתוך הגרף, ו-Cinput מייצג את המספר הכולל של סעיפי הקלט.
שיעור זיהוי קונפליקטים של אילוצים:
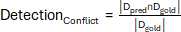 (19)
Dpred היא קבוצת הסתירות הלוגיות החוקיות שזוהו על ידי המודל, ו-Dgold היא קבוצת כל זוגות הסתירות שסומנו על ידי מומחים.
כל הניסויים בוצעו באמצעות תחנת עבודה המצוידת במעבד רב-ליבות וביחידת עיבוד גרפית; מפרט חומרה מלא מופיע בטבלת החומרים.
ההיפר-פרמטרים העיקריים של גישה זו וערכיהם מפורטים בטבלה 1, הכוללת את מבנה המודל ותצורת האימון וכן ספי שונים קריטיים, כגון ממד השכיול (embedding dimension), מספר השכבות הקונבולוציוניות, קצב הלמידה וגודל האשורה (batch size). כל הפרמטרים כוילו ביחס למערך האימות באמצעות חיפוש רשת (grid search); המודל המאומן התכנס באופן יציב והביצועים הם המיטביים. חלק מהספים נקבעו יחד עם קריטריוני תחום כדי לעמוד בדרישות לאמינות גבוהה של בדיקת תאימות של בינה מלאכותית רפואית.
| פרמטר | ערך | תיאור |
| ממד השכבה (Embedding Dimension) | 128 | גודל ממד המאפיינים עבור השכבות של הצמתים |
| מספר שכבות קונבולוציה | 3 | עומק רשת הקונבולוציה הגרפית המודעת ליחסים |
| קצב למידה | 0.001 | קצב למידה ראשוני עבור אופטימייזר Adam |
| גודל אצווה (Batch Size) | 32 | מספר תתי-גרפים המעובדים בכל אצווה |
| שיעור נשירה (Dropout Rate) | 0.1 | הסתברות נשירה המוחלת על מאפייני הצמתים במהלך האימון |
| מספר ראשי קשב (Attention Heads) | 8 | מספר הראשים במנגנון קשב רב-ראשי |
| מקדם רגולריזציית L2 | 5 × 10⁻⁴ | מקדם דעיכת משקלים עבור רגולריזציית פרמטרים |
| סף דמיון | 0.75 | דמיון מינימלי בין שכבות לאימות תאימות |
| סף תרומת הגרדיאנט | 0.01 | סף לבחירת קשתות בעלות השפעה גבוהה בבניית תת-גרף הטיות |
| גודל חלון ניטור | 10 | צעדי זמן המשמשים למעקב אחר דינמיקת משקלי קשתות |
טבלה 1: הגדרות פרמטרים עיקריות. רשימה של היפר-פרמטרים מרכזיים ששימשו בניסויים: ממד השקיפות (embedding dimension) (256), מספר שכבות GCN (3), ממד נסתר (256), קצב למידה (1 × 10⁻³), גודל דגימה (64), ממד וקטור הקשב (attention vector), סף תרומת קשת (אחוזון 85 של גדלי הגרדיאנט), סף ציות דינמי (µ‑2σ, כאשר µ and $\sigma$ לקוחים מתוך קבוצת האימות של 500 דוגמאות תואמות), מספר הקהילות K (שנקבע באמצעות קיבץ ספקטרלי), והאופטימייזר (Adam). ערכים אלו נבחרו באמצעות חיפוש רשת (grid search) על קבוצת האימות.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
תוצאות
אימות ביצועים של מעקב אחר מקור הטיה בגרף ידע משפטי של בינה מלאכותית רפואית
ביצועי קונוולוציה של גרף מודע-קשרים
באמצעות אימון רשת קונבולוציונית של גרפים המודעת ליחסים (relation-aware graph convolutional network), חושבו דמיון השקעות (embedding similarities) בין סעיפים משפטיים לבין צמתים של התנהגות רפואית לאורך שכבות קונבולוציה שונות, ונרשם אפקט היישור (alignment effect) של כל שכבה. שנית, נותחו סטטיסטית משקולות הקשב (attention weights)...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
דיון
שילוב של בינה מלאכותית רפואית בקבלת החלטות קליניות מעלה אתגרים משפטיים בנוגע לייחוס אחריות, המוקשים בשל הפער הסמנטי שבין טקסטים משפטיים לא מובנים לבין אלגוריתמים של "קופסה שחורה". כדי לגשר על פער זה, הצענו גרף ידע מבוסס GNN המmodell את סעיפי החוק, התנהגויות רפואיות, מודולי אלגוריתמים והגורמים האחראים כצמתים הטרוגניים, המחוברים באמצעות ארבעה קשרים משפטיים-סמנטיים מכוונים (הפרה, בסיס, טריגר, ייחוס). מבנה זה מספק ממשק חישובי לסנכרון רב-מודאלי ומעקב אחר הטיות.
השיטה שלנו משיגה ביצועים מעולים בכל ה...
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.
גילויים
כתב היד לא פורסם בעבר ואינו נמצא בבחינה על ידי שום כתב עת אחר. כל המחברים אישרו את תוכן המאמר. המחברים מצהירים כי אין להם ניגודי עניינים כספיים.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| ComplEx | מימוש בקוד פתוח (למשל, OpenKE) | גרסה 1.0 | בסיס השוואה של שיבוץ מורכב (Complex embedding) להשוואת גרפי ידע |
| GNNExplainer | מימוש בקוד פתוח (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | קו בסיס לפענוח רשתות עצביות גרפיות (GNN) לצורך מעקב אחר הטיות |
| Intel Xeon Gold 6248 (מעבד) | Intel Corporation | SRF7F | מעבד מרכזי לאימון מודלים ועיבוד מקדים של נתונים |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | בסיס השוואה (baseline) להטמעת גרפי ידע (KG embedding) מבוסס-Transformer עבור יישור סמנטי |
| Node2Vec | מימוש בקוד פתוח (https://github.com/aditya-grover/node2vec) | גרסה 1.0 | קו הבסיס להטמעת צמתים המבוססת על הליכה אקראית |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | GPU בעל ביצועים גבוהים להאצת אימון של רשתות נוירונים גרפיות |
| השיטה שלנו (GCN מודעת ליחסים) | מימוש מותאם אישית ב-PyTorch | PyTorch 1.12.0 | מסגרת מוצעת עם טרנספורמציות לכל יחס, קשב (attention) ונסיגה של גרדיאנטים (gradient backtracking) |
| TransE | מימוש בקוד פתוח (למשל, OpenKE) | גרסה 1.0 | בסיס השוואה של שיכון תרגומי (Translational embedding) להשוואת גרפי ידע |
מקורות
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.
הגישה מוגבלת. התחברו או התחילו תקופת ניסיון כדי לצפות בתוכן זה.