פרוטוקול זה מציג את ה-Tri-stream Disentangled Network (TDE-Net), מסגרת לשחזור תמונה מ-EEG המשלבת ייצוגי EEG משלימים, יישור חזותי במרחב כפול ופענוח דיפוזיה.
מאמר שיטה
רשת משולשת מופרדת עם היתוך דו-מרחבי אדפטיבי לשחזור תמונות המבוסס על אלקטרואנצפלוגרפיה ב-THINGS-EEG2
במאמר זה
סיכום
תקציר
שחזור גירויים חזותיים מנתוני אלקטרואנצפלוגרפיה (EEG) לא פולשנית דורש מיפוי של תגובות עצביות קצרות ורועשות לייצוגים חזותיים משמעותיים, למרות דגימה מרחבית מוגבלת. גישות קיימות להמרת EEG לתמונה משתמשות בייצוגים עצביים ובאסטרטגיות גנרטיביות מגוונות, דבר המצריך תהליכי עבודה ניתנים לשחזור המפרידים בין תרומות מבניות לסמנטיות. פרוטוקול זה מציג את רשת ה-Tri-stream Disentangled Network (TDE-Net), מסגרת חישובית לשחזור תמונות מבוסס EEG. הפרוטוקול משתמש בהקלטות THINGS-EEG2 שעברו עיבוד מקדים ומארגן את מידע ה-EEG לעוגן EEG גולמי, זרם גרף פונקציונלי ספציפי לדגימה, וזרם סמנטי זמני רב-קנה מידה. זרם הגרף לוכד קשרים במרחב התדרים בין ערוצי ה-EEG באמצעות קונוולוציית גרפים ולמידה ניגודית בין ניסויים (cross-trial contrastive learning), בעוד שהזרם הסמנטי מחלץ מאפיינים רלוונטיים למשימה באמצעות שקלול מרחבי אדפטיבי וקונוולוציות זמניות רב-קנה מידה. מאפיינים מבניים וסמנטיים ממופים בנפרד למרחבים לטנטיים של variational autoencoder (VAE) ושל Contrastive Language-Image Pre-training (CLIP), משולבים באמצעות משקלי מיזוג שנבחרו מתוך סט הפיתוח, ומפוענחים באמצעות Stable UnCLIP. בקרב 10 משתתפים, TDE-Net השיגה דיוק זיהוי זוגי ממוצע של 0.8135 ב-CLIP, כאשר מדדים משלימים הדגימו התאמה במרחב המבני ובמרחב המאפיינים. ניתוחי Ablation וניתוחים ברמת הייצוג אפיינו עוד יותר את התרומות של הזרמים הבודדים. פרוטוקול זה מספק מסגרת ניתנת לשחזור לחקירת ייצוגי EEG משלימים ושחזור חזותי מבוסס דיפוזיה.
מבוא
פענוח של תפיסה חזותית הוא תחום מחקר רב-תחומי בממשקים מוח-מחשב (BCIs) ובמדעי המוח הקוגניטיביים. דימות תהודה מגנטית תפקודי (fMRI) אפשר שחזור תמונות ריאליסטי1,2,3,4, אך עלותו, הניידות המוגבלת שלו והעיכוב ההמודינמי מגבילים חלק מהיישומים. אלקטרואנצפלוגרפיה (EEG) מספקת מדידות זמניות ברזולוציה של מילישניות עם ציוד נגיש יחסית, אך יחס אות לרעש נמוך ודגימה מרחבית מוגבלת הופכים את השחזור מתצלומי EEG לתמונה למאתגר.
יש לפרש את מורכבות השיטה לאור הטרייד-אוף הכללי בין הטיה לשונות (bias-variance trade-off)5. שיטות פענוח חזותי מוקדמות השתמשו בייצוגים רדודים או ליניאריים, בעוד שמחקרים מאוחרים יותר הציגו מקודדים קומפקטיים מבוססי קונבולוציה, גרפים וקשב (attention)6,7,8,9,10,11. גם יישור בין-מודאלי (Cross-modal alignment) התקדם מלמידת מאפיינים מולטי-מודאלית12,13 למודלי דיפוזיה חבויים ומקודדי ראייה גדולים14,15,16. גישות אלו מבססות קווי בסיס (baselines) שימושיים, אך ייצוגי הקלט, היעדים החבויים והמפענחים שלהן שונים, ולכן יש לפרש את התוצאות במסגרת התנאים הניסיוניים הרלוונטיים לכל אחת מהן.
מטרתו של TDE-Net היא לספק מסגרת מודולרית לשחזור תמונות מ-EEG, המפרידה בין ייצוגי EEG מבניים וסמנטיים, מיישרת אותם עם מרחבים חבויים (latent spaces) חזותיים משלימים, וממזגת תחזיות אלו לצורך שחזור תמונות מבוסס דיפוזיה. מחקרים אחרונים בפענוח EEG-חזותי הציגו יצירה מונחית EEG מבוססת transformer ב-EEG-CLIP17, יישור מודע לרקע עם רשתות מוחיות דינמיות ב-FSDBN18, טשטוש אדפטיבי מונחה קוגניטיבית עם יישור מוגבל מידע19, ולמידה ביומימטית דו-כיוונית רב-שכבית20. תהליכי עבודה (pipelines) קשורים של EEG-לתמונה, כולל Perceptogram ודיפוזיה מונחית המבוססת על שיבודי (embeddings) EEG, מספקים מראים נוספים לחיזוי מרחבים חבויים21,22. TDE-Net נבדל בארגון המודל שלו: הוא מפריד באופן מפורש בין עוגן EEG גולמי, ייצוג גרף פונקציונלי ספציפי לדגימה, וייצוג סמנטי זמני, ולאחר מכן מבצע יישור אסימטרי למרחבי VAE ו-CLIP לפני המיזוג. ארגון זה מאפשר לבחון את התרומות המבניות והסמנטיות בנפרד באמצעות ניתוחים של המרחב החבוי ושל רמת התמונה. בהשוואה לגישות EEG-לתמונה בעלות ייצוג יחיד או יישור ישיר, עיצוב מודולרי זה מספק נתיבים מבניים וסמנטיים נפרדים, שומר על רפרנס EEG לינארי במהלך החיזוי של המרחב החבוי, ומאפשר הערכה עצמאית של תרומתו של כל ייצוג באמצעות ניתוחי השהה (ablation) וניתוחי מרחב חבוי.
TDE-Net תוכנן עבור ניסויים הכוללים תגובות EEG צמודות לגירויים ויזואליים, תנאי אימון מספיקים וחלון זמן קצר לאחר הגירוי שבו השחזור הסמנטי הוא היעד העיקרי. הארגון השביתי שלו מאפשר בחינה נפרדת של חילוץ מאפיינים, יישור חבוי (latent alignment), מיזוג ופענוח דיפוזיה. מיפויים ליניאריים נותרים מתאימים למסדי נתונים קטנים מאוד או להגדרות המתעדפות מורכבות מודל מינימלית, בעוד שמפענחים עצביים מקצה לקצה עשויים להיות מועדפים כאשר זמינים מסדי נתונים גדולים הספציפיים למשימה ופריסה בזמן אמת.
הפרוטוקול הנוכחי מעריך את התצורה המוצעת במסגרת הצגת גירויים חזותיים מהירה ורצפית (RSVP) של מאגר ה-THINGS-EEG2. התרומות העיקריות כוללות סכימת ייצוג EEG תלת-זרמית המורכבת מעגן לינארי גולמי, זרם גרף פונקציונלי ספציפי לדגימה, וזרם סמנטי זמני רב-קנה. ייצוגים משלימים אלו ממופים למרחבי latent של VAE ו-CLIP, והתחזיות המתאימות משולבות לפני פענוח דיפוזיה. המסגרת מוערכת על פני כל 10 הנבדקים ב-THINGS-EEG2 באמצעות מדדי שחזור ברמת הנבדק, ניתוחי ablation וניתוחי חלון זמני, וויזואליזציות ברמת הייצוג, כאשר מפות קשב מרחביות מפורשות כניתוחי ערוצי קרקפת (טופוגרפיים).
פרוטוקול
הפרוטוקול כולל שישה שלבים עוקבים: הכנת ניסויי EEG וטביעות תמונה (image latents); בניית זרם מבני של הגרף; אימון של מקודד EEG סמנטי; התאמה של מיפיומי CLIP/VAE; מיזוג של תחזיות מרחבי הטביעות, ולאחריו פענוח תמונה; והערכה של תוצאות ברמת התמונה וברמת הייצוג (איור 1).
1. הכנת ניסויי EEG ושיכובים של תמונות (image embeddings)
- תעדו את קוהורט המקור ואת פרוטוקול הרכישה.
הערה: קוהורט המקור כלל 10 מבוגרים בריאים (גיל ממוצע 28.5 שנים, SD 4.0; שמונה נשים ושני גברים) עם ראייה נורמלית או מתוקנת לנורמלית. המשתתפים סיפקו הסכמה מודעת בכתב, קיבלו פיצוי כספי, והשלימו את הפרוטוקול המקורי באישור ועדת האתיקה של המחלקה לחינוך ופסיכולוגיה באוניברסיטה החופשית בברלין (Freie Universität Berlin), בהתאם להצהרת הלסינקי23.- השתמשו במערך הנתונים THINGS-EEG2 הזמין לציבור כמשאב לניתוח משני.
- השתמשו בחלוקת המקור של 1,654 מושגי אימון ו-200 מושגי בדיקה שאינם חופפים שנלקחו מ-THINGS, כאשר הפרופורציות של 27 קטגוריות ברמה גבוהה מאוזנות בין החלוקות. בחרו עשר תמונות עם רקע טבעי עבור כל מושג אימון ותמונה אחת עבור כל מושג בדיקה, כדי להניב 16,540 תנאי אימון ו-200 תנאי בדיקה נשמרים.
הערה: במחקר הנוכחי, משימת זיהוי המטרה השתמשה בתמונות תפיסה נפרדות של באז לייטייר אשר הוצאו מניתוח השחזור הנוכחי23. - עקבו אחר התזמון של פרוטוקול הצגת הגירויים החזותית הסדרתית המהירה המקורי בעת פירוש האפוקים (epochs).
הערה: כל רצף התחיל במרווח ריק של 750 ms, ולאחריו 20 תמונות שהוצגו במרכז. כל תמונה תמכה ב-7 מעלות של זווית ראייה, נשארה על המסך למשך 100 ms, והייתה בעלת אסינכרוניות של התחלת גירוי (stimulus-onset asynchrony) של 200 ms, המקבילה ל-5 תמונות לשנייה. מרווח ריק שני של 750 ms קדם לתקופת תגובה של עד 2 s, שבמהללה המשתתפים קודם כל מצמצו ולאחר מכן דיווחו האם תמונת מטרה הופיעה. מטרה מרכזית של קיבוע למבט (bull's-eye fixation target) נשארה גלויה לאורך כל הרצף23. - התחשבו במבנה המקורי של מפגשי ההקלטה בעת ארגון מערך הנתונים. השתמשו בנתונים מארבעת מפגשי ההקלטה שהשלים כל משתתף, כאשר כל מפגש כלל ארבע הרצות בדיקה ו-15 הרצות אימון של כ-5 min כל אחת. שמרו ארבע חזרות עבור כל תנאי אימון ו-80 חזרות עבור כל תנאי בדיקה, המקבילים ל-82,160 ניסיונות של תמונות שאינן מטרה שנותחו לכל משתתף23.
- השתמשו בנתוני ה-EEG שנרכשו בתצורת ההקלטה המקורית של THINGS-EEG2. הקלטות אלו בוצעו בתדר של 1,000 Hz באמצעות EASYCAP בעל 64 אלקטרודות המסודר לפי מערכת 10-10 הבינלאומית ומגבר BrainVision actiCHamp, כאשר Fz שימש כרפרנס מקוון (online reference) ופילטר פס-מעבר מקוון של 0.1–100 Hz.
- השתמשו בנתונים המעובדים מראש שפורסמו, אשר חולקו לאפוקים מ-200- עד 800 ms ביחס לתחילת התמונה, תוקנו לבסיס (baseline-corrected) באמצעות מרווח טרום-הגירוי, דגימתו הופחתה ל-100 Hz, הוגבלו ל-17 ערוצים פריאטו-אוקסיפיטליים, נוקו מניסיונות מטרה, ועברו נורמליזציה רב-משתנית של רעש באופן עצמאי בתוך כל מפגש הקלטה23.
- הכינו טנזורי ניסיוני EEG
- טענו את טנזורי THINGS-EEG2 המעובדים מראש שפורסמו עבור כל 10 המשתתפים. מכל אפוק מקור, בחרו את מרווח לאחר-הגירוי של 0–800 ms ואת 17 הערוצים הפריאטו-אוקסיפיטליים, תוך שמירה על קצב דגימה של 100 Hz כדי לקבל 80 נקודות זמן לניסוי. שמרו את חלוקת המקור של 16,540 תנאי תמונות אימון ו-200 תנאי תמונות בדיקה נשמרים עבור כל משתתף23 (איור 2).
- עבור קדם-אימון של זרם גרפים, שמרו את ארבע חזרות האימון העצמאיות עבור כל תנאי תמונה ודגמו שתי חזרות כדי ליצור זוג חיובי. עבור הזרמים הגולמיים והסמנטיים, חשבו ממוצע של ארבע חזרות האימון וממוצע של 80 חזרות הבדיקה הזמינות עבור כל תנאי.
- השתמשו בטנזורי THINGS-EEG2 המעובדים מראש שהופקו על ידי צינור ה-MVNN המקורי; בתוך כל מחלץ מאפיינים שיוטמע, בצעו Z-scoring ברמת הקובץ המתועד לפני חישוב המאפיינים.
הערה: שימוש אסימטרי זה בחזרות הוא מכוון: ניסיונות חוזרים מספקים זוגות חיוביים לקדם-אימון ניגודי (contrastive pre-training) של זרם הגרפים, בעוד שהזרמים הגולמיים והסמנטיים משתמשים בממוצעים ברמת התנאי עבור מיפוי מודרך. התכנון הנובע מכך משלב למידת אי-תלות (invariance learning) ברמת החזרה בזרם המבני עם חיזוי לטנטי ברמת התנאי בזרמים הגולמיים והסמנטיים.
- הכינו לטנטים זוגיים של תמונות
- השתמשו במקודד חזותי CLIP במימד 1,024 ובמקודד VAE המשויך ל-sd2-community/stable-diffusion-2-1-unclip כדי לחלץ מטרות תמונה זוגיות. שנו את גודל תמונת הקלט של VAE ל-768 x 768 פיקסלים, שמרו את ה-posterior mode של VAE כווקטור במימד 36,864 (4 x 96 x 96), ושמרו את סדר התמונה-תנאי.
- שמרו שלוש צורות קלט: טנזורי ניסיונות חוזרים ללמידה ניגודית גרפית, טנזורי EEG ממוצעים עבור הזרמים הגולמיים והסמנטיים, ולטנטים זוגיים של תמונות CLIP/VAE עבור מיפוי מודרך.
- נרמלו ושמרו במטמון (cache) את הקלטים
- שמרו במטמון את טנזורי ה-EEG המעובדים מראש, המאפיינים הגרפיים והסמנטיים שחולצו, והלטנטים הזוגיים של התמונות עם סדר תנאים קבוע.
- במהלך מיפוי ridge, העריכו את פרמטרי הסטנדרטיזציה לכל מאפיין מקלטי האימון והחילו פרמטרים אלו על קלטי הפיתוח והבדיקה.
2. בניית זרם המבנה הגרפי
- בנו את זרם הגרף (graph stream) מניסויי אימון חוזרים וייצאו מאפייני רמת-צומת (node-level features) לאחר קדם-אימון ניגודי (contrastive pre-training). השתמשו באותו כלל בניית גרף עבור חילוץ מאפייני בדיקה, ללא שימוש בלוטנטים (latents) של תמונות הבדיקה במהלך חישוב המאפיינים.
- המירו ניסויי EEG לקלטי גרף במישור התדר
- המירו כל ניסוי באמצעות התמרה מהירה של פורייה (FFT) בעלת 80 נקודות ושמרו את 40 סלילי התדרים (bins) הראשונים שאינם שליליים, המקיפים 0 Hz–48.75 Hz בקצב דגימה של 100 Hz. השתמשו בספקטרום האמפליטודה הלוגריתמי כמטריצת מאפייני צומת 17 x 40 המסומנת כ-X. עבור כל דגימת EEG, חשבו את C_ij = |corr(X_i, X_j)| בין כל זוג וקטורי מאפייני הערוצים (17 ערוצים).
- בכל שורה, שמרו את המתאם העצמי באלכסון ואת שלושת המתאמים החזקים ביותר מחוץ לאלכסון (k = 4 ערכים שנשמרו כולל העצמי), ולאחר מכן בצעו סימטריזציה למטריצה שנשמרה כדי להגדיר את הסמיכות הפונקציונלית המשוקללת (weighted functional adjacency A) הספציפית לדגימה. החילו נרמול דרגה סימטרי לפני קונבולוציית גרף.
- השתמשו בבנייה זו במהלך האימון והבדיקה; קואורדינטות פיזיות של אלקטרודות אינן משמשות להגדרת גרף קבוע.
הערה: שמירה על קישוריות עצמית משמרת את האות של כל צומת, בעוד שהגבלת חיבורים בין-ערוציים ל-3 לשורה שולטת בצפיפות הגרף לפני הסימטריזציה. הייצוג במישור התדר מספק תיאור תמציתי מבוסס-אמפליטודה לבניית הגרף, אך אינו משמר פאזה או את כל התזמון המדויק של ERP נעול-פאזה; היבטים זמניים אלו נותרים זמינים בזרמים הזמניים הגולמיים והסמנטיים.
- אגדו את טופולוגיית האלקטרודות באמצעות קונבולוציית גרף ספקטרלית
- החילו רשת קונבולוציית גרפים (GCN)24 בעלת חמישה שכבות עם 80 יחידות נסתרות לכל שכבה, הפעלות ReLU, dropout של 0.3, נרמול דרגה סימטרי ואיגור גרף ממוצע (mean graph pooling).
- השתמשו בראש השלכה (projection head) דו-שכבתי בעל 80 ממדים עבור המטרה הניגודית, וייצאו את הייצוג ברמת-צומת של 17 x 80 למיזוג מבני. החילו קונבולוציית גרף ספקטרלית על מטריצת הסמיכות התלויה בקלט; אל תשתמשו באופרטור קונבולוציה דינמי נפרד.
- אמנו את זרם הגרף באמצעות למידה ניגודית בין-ניסויית (cross-trial contrastive learning)
- בתוך חלוקת האימון, בחרו אקראית שתי חזרות מאותו תנאי תמונה כזוג חיובי והתייחסו לייצוגים מתנאים אחרים ב-batch כשליליים. אופטימיזציה של מטרת InfoNCE הניגודית25 עם טמפרטורה τ = 0.5, גודל batch של 32, Adam עם קצב למידה של 5 x 10⁻⁴, 20 תקופות (epochs), cosine annealing ל-eta_min = 10–6, וגרעין אקראי (random seed) 42.
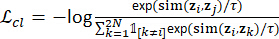 (1)
- הגדירו דמיות קוסינוס במטרה הניגודית והשתמשו בפונקציית אינדיקטור כדי לזהות חזרות זוגיות. שמרו על ממד ההשלכה ב-80 והחילו את אותה טמפרטורה על שני הכיוונים של ההפסד הניגודי.
- בתוך חלוקת האימון, בחרו אקראית שתי חזרות מאותו תנאי תמונה כזוג חיובי והתייחסו לייצוגים מתנאים אחרים ב-batch כשליליים. אופטימיזציה של מטרת InfoNCE הניגודית25 עם טמפרטורה τ = 0.5, גודל batch של 32, Adam עם קצב למידה של 5 x 10⁻⁴, 20 תקופות (epochs), cosine annealing ל-eta_min = 10–6, וגרעין אקראי (random seed) 42.
- ייצאו מאפייני גרף ברמת-צומת עבור מיזוג מוקדם
- הקפיאו את מקודד הגרף לאחר הקדם-אימון וייצאו את מאפייני הצמתים של 17 הערוצים עם 80 ממדים לכל צומת. שרשרו מאפיינים אלו עם EEG גולמי ממוצע לאורך ממד המאפיינים כדי לקבל את הקלט המבני של "גולמי-בתוספת-גרף" עבור מיפוי VAE.
- שמרו את טנזור המאפיינים שהתקבל של "גולמי-בתוספת-גרף" והשתמשו בו אך ורק כקלט מבני לענף הרגרסיה של ה-VAE.
3. אימון המקודד הסמנטי של ה-EEG
- אמן את מקודד ה-EEG הסמנטי על טנזורי EEG ממוצעים בעלי 17 ערוצים ו-80 נקודות.
- בצע אופטימיזציה של loss של cosine embedding באמצעות AdamW (קצב למידה 5 x 10⁻⁴; דעיכת משקלים 0.01), גודל batch של 64, 50 תקופות (epochs), cosine annealing עד ל-eta_min = 10–6, seed אקראי 42, ופלט במימד של 1,024.
- החל סינון מרחבי אדפטיבי מונחה-נתונים
- החל פעולת שקלול ערוצים של tensor-product הניתנת ללמידה על טנזור ה-EEG הקלט והרחב את הייצוג לעומק של 9. התייחס לפעולה זו כשכבת שקלול ערוצים מונחית-נתונים ולא כמימוש של מסנן מרחבי קלאסי מסוג Common Spatial Pattern (CSP)26.
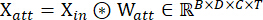 (2)
- השתמש בפעולת שקלול הערוצים הנלמדת כדי להפיק תשע מפות מאפיינים, ולאחר מכן העבר אותן לבלוק הקונבולוציה הטמפורלית רב-קנה-מידה.
- החל פעולת שקלול ערוצים של tensor-product הניתנת ללמידה על טנזור ה-EEG הקלט והרחב את הייצוג לעומק של 9. התייחס לפעולה זו כשכבת שקלול ערוצים מונחית-נתונים ולא כמימוש של מסנן מרחבי קלאסי מסוג Common Spatial Pattern (CSP)26.
- מידול שדות קליטה טמפורליים במספר קני מידה
- החל שלוש קונבולוציות טמפורליות מקבילות עם גודלי גרעין (kernel sizes) של 5, 15 ו-31 דגימות, תוך שימוש ב-padding באורך זהה. שרשר את שלושת הפלטים כדי לקבל 24 ערוצי מאפיינים טמפורליים והחל נורמליזציית batch והפעלת GELU.
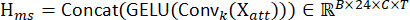 (3)
הערה: הקונבולוציות מספקות שדות קליטה טמפורליים רב-קני מידה בתוך מסגרת רחבה יותר של מידול קונבולוציוני טמפורלי27. - השתמש בשלושת גדלי הגרעין כמסננים טמפורליים רב-קני מידה; פרש את הפלט שלהם כייצוגי אות נלמדים ולא כהקצאות ישירות לרכיבי ERP ספציפיים.
- החל שלוש קונבולוציות טמפורליות מקבילות עם גודלי גרעין (kernel sizes) של 5, 15 ו-31 דגימות, תוך שימוש ב-padding באורך זהה. שרשר את שלושת הפלטים כדי לקבל 24 ערוצי מאפיינים טמפורליים והחל נורמליזציית batch והפעלת GELU.
- כיול מחדש של ערוצי מאפיינים רלוונטיים למשימה
- החל depth attention עם average pooling אדפטיבי על הממד הטמפורלי וקונבולוציה עם גרעין בגודל 7, ולאחריה נורמליזציית Softmax, בהתאם לעקרונות של כיול מחדש של ערוצים28. הכפל את משקולות הקשב (attention weights) המתקבלות באופן אלמנטרי בטנזור המאפיינים רב-קני המידה.
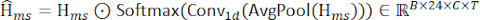 (4)
- השתמש בפלט הקשב כקלט לבלוק הקונבולוציה המרחבית ואל תפרש את המשקולות הנלמדות כמיקום עצבי סיבתי.
- החל depth attention עם average pooling אדפטיבי על הממד הטמפורלי וקונבולוציה עם גרעין בגודל 7, ולאחריה נורמליזציית Softmax, בהתאם לעקרונות של כיול מחדש של ערוצים28. הכפל את משקולות הקשב (attention weights) המתקבלות באופן אלמנטרי בטנזור המאפיינים רב-קני המידה.
- ייצוא המאפיין הסמנטי הגלובלי של ה-EEG
- החל קונבולוציה של 1 x 1 ולאחריה קונבולוציה מסוג depthwise המקיפה את 17 ערוצי האלקטרודות, נורמליזציית batch, הפעלת GELU, average pooling עם פקטור 2, ו-dropout p = 0.5. שטח את התוצאה והשלכי אותה לווקטור מאפיינים סמנטי במימד של 1,024.
- שמור ווקטור מאפיינים סמנטי אחד במימד של 1,024 עבור כל דגימת EEG ממוצעת.
4. מיפוי מאפייני EEG למרחבים לטנטיים של CLIP ו-VAE
- הצמד כל טנזור של מאפייני EEG עם ה-latent של התמונה בעל אינדקס התנאי התואם. התאם מיפויים נפרדים עבור יעדי CLIP ו-VAE, ושמור על כך שכל תנאי התמונה במחיצת האימון יהיו נפרדים מאלה שבמחיצת הבדיקה המושבתת.
- בצע רגרסיית ridge29 עם נקודת חיתוך (intercept) ומקסימום של 50,000 איטרציות. השתמש ב-λCLIP = 1,000 עבור מיפויי raw-to-CLIP ו-semantic-to-CLIP, ב-λVAE = 0 עבור עוגן ה-raw-to-VAE, וב-λVAE, struct = 1,000 עבור מיפוי ה-structural-stream-to-VAE. בצע סטנדרטיזציה לקלטי המיפוי באמצעות סטטיסטיקות של מחיצת ההתאמה.
הערה: הזרם המבני (structural stream) הוא שרשור של EEG גולמי ומאפייני גרף; הזרם הסמנטי מכיל את פלט המקודד הסמנטי ללא שרשור של מאפיינים גולמיים. - מיפוי מאפיינים מבניים למרחב ה-latent של ה-VAE
- התאם את מיפוי ה-ridge של structural-stream-to-VAE עם λVAE,struct = 1,000 וחזה את ה-VAE latent בעל 36,864 ממדים. ענף זה מקבל את הייצוגים המשורשרים של EEG גולמי וגרף; זהו הענף הבלתי-ליניארי היחיד המשרשר במפורש מאפיינים גולמיים.
- מיפוי מאפיינים סמנטיים למרחב ה-latent של CLIP
- התאם את מיפוי ה-ridge של semantic-stream-to-CLIP עם λCLIP = 1,000 וחזה את ייצוג ה-CLIP בעל 1,024 ממדים. הקלט הסמנטי אינו משורשר עם EEG גולמי.
הערה: במאמר זה, λ מסמנת רגולריזציית ridge ו-α מסמנת משקל של היתוך latent (latent-fusion weight). - הערך את היישור של מרחב ה-latent באמצעות מקדם מתאם פירסון (PCC) ברמת הדגימה. השתמש בתנאי פיתוח לבחירת משקלי ההיתוך, והערך את 200 תנאי הבדיקה המושבתים רק לאחר שהמיפויים ומשקלי ההיתוך הוקפאו.
- התאם את מיפוי ה-ridge של semantic-stream-to-CLIP עם λCLIP = 1,000 וחזה את ייצוג ה-CLIP בעל 1,024 ממדים. הקלט הסמנטי אינו משורשר עם EEG גולמי.
5. מיזוג תחזיות חבויות והרצת שחזור דיפוזיה
- בחר αVAE ו- αCLIP תוך שימוש במערך פיתוח (development split) ברמת תנאי, שנגזר אך ורק מ-16,540 תנאי האימון. עם זרע אקראי (random seed) 42, השתמש באותם מדדי התאמה (fit indices) של 90% ומדדי פיתוח של 10% עבור כל 10 הנבדקים; 200 תנאי הבדיקה שהופרשו נשארים מחוץ להליך זה.
הערה: עונשי הרידג' (ridge penalties) ומקדם השימור המבני נקבעו כערכי קונפיגורציה לפני ההערכה הסופית על קבוצת הבקרה (held-out evaluation), ולא כווננו עבור 200 תנאי הבדיקה. - עבור כל נסיינ וכל מועמד α ב{0.00, 0.05, ..., 1.00}, התאם את המקדד תחת פיקוח יעד (target-supervised encoder) ואת מיפויי הרידג' (ridge mappings) על תת-קבוצת ההתאמה, וחשב את ה-PCC החבוי הממוצע לכל דגימה על תת-קבוצת הפיתוח.
- חשבו ממוצע של ערכי ה-PCC ברמת הנבדק במשקל שווה עבור 10 הנבדקים, ובחרו משקולות במרחבי CLIP ו-VAE באופן בלתי תלוי לפי הממוצע הבין-נבדקי המקסימלי. הקפיאו את שני הערכים לפני התאמה מחדש (refitting) של מודלי האימון הסופיים והערכת תנאי הבדיקה המופרדים (held-out test conditions).
הערה: הליך זה נבחר αCLIP = 0.55 ו- αVAE = 0.65. - עבור מרחב ה-VAE, הגדירו את התחזית המאוחדת (fused prediction) כסכום משוקלל של עוגן ה-raw-to-VAE ושל תחזית ה-VAE של זרם המבנה (structural-stream):
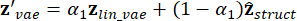 (5)
- סט αVAE = 0.65, כך שהעוגן raw-to-VAE תורם 0.65 והניבוי של זרם המבנה (structural-stream) תורם 0.35. שמרו על ערך זה קבוע עבור כל נבדק ומצב ניסויי.
- עבור מרחב ה-CLIP, הגדר את התחזית הממוזגת כסכום משוקלל של עוגן ה-raw-to-CLIP ושל תחזית ה-CLIP של זרם הסמנטיקה:
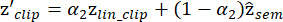 (6)
- קבוצה αCLIP = 0.55, כך שהעוגן של raw-to-CLIP תורם 0.55 והחיזוי של זרם הסמנטיקה (semantic-stream) תורם 0.45. השאירו ערך זה קבוע עבור כל נבדק ותנאי בדיקה.
הערה: יש לפרש את פעולת המיזוג כעתרון משוקלל קבוע של תחזיות סמויות (latent predictions) במובן הכללי של שילוב אנסמבלים (ensemble combination)30אין לתאר זאת כהפחתה מובטחת של התאמת-יתר (overfitting) או כפתרון אופטימלי באופן אחיד בכל המדדים. - טען את צינור העיבוד (pipeline) הקפוא של Stable UnCLIP להמרת תמונה לתמונה מ-sd2-community/stable-diffusion-2-1-unclip עם משקולות וריאציה ב-fp16. השתמש בשיבוץ (embedding) המאוחד של CLIP כתנאי הסמנטי ובמרחב החבוי (latent) המאוחד של VAE כאתחול המבני.
הערה: המפענח פועל לפי עקרונות של דיפוזיה להסרת רעשים (denoising diffusion) והנחיה ללא מסווג (classifier-free guidance)31,32. - החילו אתחול מבני רועש (noisy structural initialization) על לטנטים של הדיפוזיה. שנו את צורתו של כל חיזוי VAE בעל 36,864 ממדים ל-4 x 96 x 96, בהתאם לניסוח הלטנטים של האוטו-אנקודר הווריאציוני (variational autoencoder).33, והוסף רעש גאוסי לאחר הכפלת הלטנט המבני (structural latent) בקנה מידה מבני gamma = 0.02. השתמש בצעדי זמן של אימון דיפוזיה T_diff = 1,000 ובזרע (seed) דיפוזיה קבוע של 0 עבור הליך השחזור המדווח.
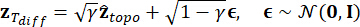 (7)
- הגדירו את מקדם שימור המבנה gamma ל-0.02 באתחול הרועש (noisy initialization) והשאירו ערך זה קבוע עבור כל תנאי הבדיקה. העבירו את הווקטור החבוי (latent) המתקבל למפענח (decoder) ללא שימוש במידע של תמונת האמת (ground-truth).
- יש להחיל הנחיית קשב-מצלב (cross-attention guidance) ולפענח את הפוטנציאל של התמונה (image latent). יש לשרשר את וקטור ה-CLIP המאוחד בן 1,024 הממדים עם הרחבת ההתנייה (conditioning extension) בן 1,024 הממדים המשמשת את הצינור (pipeline), להוסיף לפני כן וקטור תנאי-שלילי אפס עבור הנחיה ללא מסווג (CFG), ולפענח עם קנה מידה של הנחיה (guidance scale) של 7.5. יש להשתמש בברירת המחדל של הצינור של 20 שלבי הסרת רעשים (denoising steps) ולשמור תמונת PNG אחת לכל תנאי בדיקה.
- שמרו את התמונה המשוחזרת עם האינדקס המקורי של תנאי הבדיקה, ושמרו על אותו אינדקס עבור כל חישובי המדדים הבאים.
הערה: טבלה 1 מסכם את הגדרות חלוקת הנתונים, עיבוד המקדמים, בניית הגרף, אימון המודל, המיפוי הסמוי (latent mapping), האיחוד והפענוח ששימשו בזרימת העבודה המדווחת. גיליון העבודה המצורף מספק את אותו סיכום פרמטרים בפורמט קריא למכונה.
6. הערכת השחזור והיישור ברמת הייצוג
- חשבו נאמנות ברמה נמוכה באמצעות קורלציית פיקסלים (PixCorr) ודמיון מבני (SSIM). חשבו דיוקי זיהוי זוגיים עבור AlexNet Layer 2, AlexNet Layer 5, Inception-v3 ו-OpenAI CLIP ViT-L/14; חשבו מרחקי קורלציה עבור EfficientNet (EffNet) ו-SwAV, כאשר ערכים נמוכים יותר מעידים על ייצוגי תכונות קרובים יותר.
- עבור ניתוח ה-CLIP, צרו מטריצת קורלציה בין תכונות שחולצו מ-200 תמונות ששוחזרו לבין 200 תמונות המקור (ground-truth) התואמות. עבור כל שחזור, השוו את הקורלציה של התמונה הנכונה לקורלציות עם 199 התמונות האחרות, והוציאו ממוצע של 200 x 199 ההשוואות הבינאריות שהתקבלו כדי להשיג את דיוק הזיהוי הזוגי של CLIP.
- עבור חלונות מתרחבים המסתיימים בנקודות זמן 8, 16, ..., 80, התאימו מיפויי ridge של EEG גולמי וחשבו את ה-PCC הממוצע לכל דגימה בין מרחבי המאפיינים (latents) של CLIP ו-VAE החזויים לאלה של ה-ground-truth על פני 200 תנאי הבדיקה של sub-01. השתמשו בתחזיות CLIP ו-VAE של זרם סמנטי בלבד עבור החלון המלא כרמות ייחוס מקווקוות.
- בנו מטריצות דמיון ייצוגי (RSMs) מתכונות CLIP שנורמלו לפי L2 באמצעות דמיון קוסינוס (cosine similarity). סדרו את שתי המטריצות באמצעות קיבוץ היררכי של Ward של הטמעות CLIP של ה-ground-truth תוך שימוש במרחק אוקלידי.
- עבור הוויזואליזציה הדו-ממדית, גזרו חמישה אשכולות k-means מהטמעות ה-ground-truth והפילו הקרנה משותפת אחת של PCA-50 בתוספת t-distributed stochastic neighbor embedding (t-SNE) על תכונות ה-ground-truth והתכונות החזויות; השתמשו ב-t-SNE לוויזואליזציה איכותנית בלבד.
- הציגו ויזואלית תבניות EEG מולבנות (whitened) ומשקולות מודל של ערוצי קרקפת עם ערוצים מסומנים, סבילי צבע מפורשות וכללי סדר הניתנים לשחזור. פרשו גרפים אלו כניתוחים עזריים של אותות קרקפת נמדדים ופרמטרי מודל, ולא כראיה למיקום מקור קורטיקלי, הפעלה אנטומית או סיבתיות.
תוצאות
TDE-Net הוערכה משישה נקודות מבט משלימות: ביצועי שחזור, תוצאות חזותיות מייצגות, תרומת רכיבים, תלות זמנית, מבנה ייצוגי סמנטי ותשומת לב לערוצי הקרקפת. נאמנות ברמה נמוכה נבחנה באמצעות PixCorr ו-SSIM, התאמה במרחב המאפיינים נבחנה באמצעות מדדי AlexNet, Inception-v3, CLIP, EffNet ו-SwAV, וביצועים ברמת הנבדק נבחנו באמצעות תוצאות מכל 10 הנבדקים של THINGS-EEG2. אלא אם צוין אחרת, כל איור איכותני מזהה את הנבדק ואת תת-קבוצת תנאי הבדיקה המתאימים.
ביצועי השחזור ותוצאות מייצגות
כמודל ייחוס פנימי, יישמנו בנוסף baseline של מקודד EEG מבוסס קונבולוציה-אטנשן קל. מודל זה מחלץ ייצוג EEG יחיד בעל 1024 ממדים מכל ניסוי וממפה אותו באופן עצמאי למרחבי החביון של CLIP ו-VAE, תוך שימוש באותו פרוטוקול של רגרסיית ridge ופענוח דיפוזיה כפי שנעשה בשיטה המוצעת. בסעיפים הבאים, מודל זה יסומן כ-Baseline. המקודד הוא הייחוס הסמנטי מבוסס קונבולוציה-אטנשן בסגנון LMDA ששימש במימוש המקומי, עם 373,950 פרמטרים הניתנים לאימון ופלט בעל 1,024 ממדים.
טבלה 2 משווה את TDE-Net למודל הבסיס הפנימי של קונבולוציה-קשב (convolutional-attention) ולשיטות נציגות לשחזור תמונות מבוסס EEG על פני המדדים המדווחים. לצורך הערכה עקבית, השיטות הוטמעו במסגרת ניסויית מאוחדת תוך שימוש באותה חלוקה של THINGS-EEG2, קלט של 17 ערוצים, עיבוד מקדים, תנאי בדיקה נפרדים (held-out) והגדרות מדדים, תוך שמירה על הארכיטקטורות הספציפיות לכל שיטה. בסיכום של עשרת הנבדקים, TDE-Net השיג ערכי ממוצע ± SD של 0.2531 ± 0.0138 עבור PixCorr, 0.3388 ± 0.0025 עבור SSIM, 0.8777 ± 0.0115 עבור AlexNet Layer 2, 0.9153 ± 0.0116 עבור AlexNet Layer 5, 0.7606 ± 0.0213 עבור Inception-v3, 0.8135 ± 0.0074 עבור דיוק זיהוי זוגי של CLIP, 0.8285 ± 0.0122 עבור מרחק EffNet, ו-0.5085 ± 0.0101 עבור מרחק SwAV. הסיכום ברמת הנבדק משלים את הדוגמאות האיכותניות של נבדק בודד.
ערך ה-CLIP מציין דיוק זיהוי זוגי ולא דמיון קוסינוס או ציון תכונה גנרי של CLIP. מכיוון שזרם הסמנטיקה מאומן לעבר יעד במרחב CLIP, מדד זה משקף הן שחזור סמנטי והן יישור עם יעד של ענף אחד. לכן, הוא נבחן יחד עם PixCorr, SSIM, AlexNet, Inception-v3, EffNet ו-SwAV, המאפיינים היבטים משלימים של נאמנות ברמה נמוכה והסכמה במרחב התכונות.
כדי לאפיין את הביצועים ברמת הנבדק, החלנו את הליך הבדיקה המלא של TDE-Net על נבדקים sub-01 עד sub-10, תוך שימוש באותם 200 תנאי תמונות ששומרו בנפרד עבור כל נבדק. Table 3 מציג את כל שמונת מדדי ההערכה עבור כל נבדק, יחד עם הממוצע בין הנבדקים וסטיית התקן (SD) של המדגם. דיוק הזיהוי הזוגי הממוצע של CLIP היה 0.8135 (SD, 0.0074). הממוצעים של PixCorr ו-SSIM היו 0.2531 ו-0.3388, בהתאמה. דיוקי השכבה 2 והשכבה 5 של AlexNet עמדו בממוצע על 0.8777 ו-0.9153, ודיוק Inception-v3 עמד בממוצע על 0.7606. מרחקי EffNet ו-SwAV, שבהם ערך נמוך יותר מעיד על ביצועים טובים יותר, עמדו בממוצע על 0.8285 ו-0.5085, בהתאמה. הפיזור המוגבל ברמת הנבדק במדדים אלו מצביע על התנהגות שחזור כמותית דומה בין 10 הנבדקים של THINGS-EEG2.
איור 3 מציג שחזורים עבור אותם שבעה מדדי תנאים שהושמטו (1, 32, 62, 86, 87, 108 ו-175; מספור קבצים המתחיל באפס) עבור כל 10 הנבדקים. השורה העליונה מציגה את גירויי האמת (ground-truth), והשורות הבאות מציגות את השחזורים המתאימים עבור נבדק 01 עד נבדק 10. השחזורים שומרים על קטגוריות סמנטיות משותפות ועל מאפיינים חזותיים אופייניים של הגירויים, בעוד שזהות אובייקטים מפורטת, צורה ומרקם מקומי משתנים בין הנבדקים. פריסה זו מספקת מקבילה איכותנית לתוצאות בין-נבדקיות המסוכמות ב- טבלה 3.
איור 4 מציג שחזורים איכותניים עבור שש תנאי בדיקה מוגדרים של sub-01. השורות מראות את גירוי האמת (ground-truth), משווה Perceptogram שנוצר על ידי המימוש המקומי שלנו21, ואת השחזור של TDE-Net. הדוגמאות מדגישות את השימור של קטגוריית האובייקט, הצורה, הצבע ומאפייני הרקע, בעוד שפרטי זהות ורקע דקים משתנים בין השיטות.
איור משלים 1 מציג את קבוצות השחזור הטובות ביותר, החציוניות והגרועות ביותר שנבחרו מתוך 200 תנאי הבדיקה של sub-01 ב-THINGS-EEG223. התנאים מדורגים לפי הסכמת קוסינוס (cosine agreement) בין ה-CLIP embedding שנחזה על ידי EEG מותוך ומומס (frozen fused) לבין ה-CLIP embedding של תמונת ה-ground-truth התואמת. הקבוצות המוצגות ממחישות את טווח ההסכמה הסמנטית שנצפתה עבור נבדק זה.
תרומת הרכיבים והתנהגות ההיתוך
טבלה 4 מציגה אבליציה (ablation) מדורגת של זרמי המבנה והסמנטיקה, המבוססת על ערכי ממוצע בין נבדקים שהתקבלו תחת אותו הליך הערכה. העוגן הליניארי (Linear Anchor) חוזה ישירות את ה-CLIP וה-VAE latents מנתוני EEG שעברו עיבוד מקדים באמצעות רגרסיית רידג' (ridge regression), ומשמש כנקודת המוצא המבוקרת למחקר האבליציה. הוא עוקב אחר העיקרון הכללי של מיפוי ליניארי של מרחב חבוי (latent-mapping) שנעשה בו שימוש במחקרי EEG-to-image קודמים, כולל Perceptogram21, תוך שימוש בהגדרות העיבוד המקדים, הרגולריזציה, הפענוח וההערכה של הצינור (pipeline) הנוכחי. תכנון זה מאפשר לבחון את זרם המבנה, זרם הסמנטיקה והמיזוג של המרחבים הכפולים ביחס למסגרת ייחוס ליניארית משותפת.
החל מה-Linear Anchor, הוספת הזרם המבני (structural stream) העלתה את ה-SSIM מ-0.331 ל-0.339 ואת הדיוק של AlexNet Layer 5 מ-0.913 ל-0.932, על אף שהדיוק של AlexNet Layer 2 ירד מעט מ-0.889 ל-0.886. הוספת הזרם הסמנטי (semantic stream) במקום זאת הניבה את ה-PixCorr הגבוה ביותר (0.237), תוך שמירה על דיוק גבוה ב-AlexNet Layer 2 (0.888) והפחתה של מרחקי ה-EffNet וה-SwAV ל-0.865 ו-0.531, בהתאמה. כאשר שני הזרמים שולבו באמצעות היתוך מרחב כפול (dual-space fusion), TDE-Net השיג את דיוקי הזיהוי הזוגיים הגבוהים ביותר עבור Inception-v3 (0.761) ו-CLIP (0.814), יחד עם מרחקי EffNet (0.829) ו-SwAV (0.509) הנמוכים ביותר. הדיוק שלו ב-AlexNet Layer 2 (0.878) נשאר נמוך מזה של ה-Linear Anchor, וה-SSIM שלו (0.339) נשאר נמוך מעט מזה של תצורת הזרם המבני. באופן כללי, תוצאות האבליציה (ablation) בין נבדקים מראות כי הזרמים המבני והסמנטי משפיעים על היבטים שונים של השחזור, בעוד שההיתוך שלהם מחזק בעיקר את הזיהוי הסמנטי ואת העקביות במרחב המאפיינים העמוק (deep feature-space consistency).
איור 5 מציג את הרגישות של סט הפיתוח לשני משקלי החיבור בטווח של α = 0.00–1.00 במרווחים של 0.05. העקומה של מרחב ה-CLIP מגיעה למקסימום ב-αCLIP = 0.55, בעוד שהעקומה של מרחב ה-VAE מגיעה למקסימום ב-αVAE = 0.65. ערכי PCC דומים נצפו עבור מועמדים שכנים, בעוד שהמקסימומים הופיעו במשקלים שונים עבור שני המרחבים הלטנטיים.
תרומה זמנית של אותות EEG
איור 6 מציג את ה-PCC החבוי הממוצע לכל תנאי עבור חלונות EEG גולמיים המסתיימים ב-8, 16, ..., 80 נקודות זמן בנבדק 01 (n = 200 תנאי בדיקה). עקומות ה-CLIP וה-VAE עולות ככל שחלון הניתוח מתרחב ומגיעות לרמה קבועה בחלונות מאוחרים יותר. קוים מקווקווים מציינים את ערכי הייחוס המתאימים של זרם סמנטי בלבד עבור חלון מלא. ניתוח זה מאפיין את התלות בחלון הזמן תחת פרוטוקול המיפוי המדווח.
יישור סמנטי וניתוח ברמת הייצוג
איור 7 משווה את ה-PCC (מקדם מתאם פירסון) של המרחב החבוי (latent) ב-CLIP עבור כל דגימה, בין עוגן CLIP הגולמי לבין תחזית CLIP הממוזגת והקפואה, על פני 200 תנאי בדיקה מסוג sub-01. הערכות צפיפות הגרעין הגאוסיאני משתמשות ברוחב פס של Scott, וקווים מקווקווים אנכיים מציינים את ממוצעי הדגימות. ההתפלגות הממוזגת מראה עלייה ממוצעת ב-PCC של כ-0.013 ביחס לעוגן הגולמי. דיוק הזיהוי הזוגי של CLIP ברמת התמונה מדווח בנפרד ב- טבלה 2.
איור 8 משווה בין RSMs של דמיון קוסינוס (cosine-similarity) עבור שימועי CLIP של תמונות האמת (ground-truth) לבין שימועי CLIP מחוזיים שנחזו באמצעות EEG. שתי המטריצות חולקות טווח נתונים משותף וסדר Ward הנגזר ממרחקים אוקלידיים בין שימועי CLIP של האמת. פאנל השאריות מציג את ה-RSM החזוי פחות ה-RSM של האמת על סולם סימטרי המוגדר על ידי השארית המוחלטת המקסימלית, ובכך מספק ויזואליזציה של ההסכמה הייצוגית.
איור משלים 2 מציג השלכה משותפת של 200 וקטורי CLIP embedding של אמת קרקע (ground-truth) ו-200 וקטורי CLIP embedding שנחזו מ-EEG. חמישה תוויות הושגו באמצעות צבירת k-means של וקטורי אמת קרקע בנורמליזציית L2 (n_init = 50; seed = 7). תכונות אמת קרקע ותכונות חזויות שורשרו הופחרו ל-50 ממדים באמצעות PCA והושלכו במשותף על ידי t-SNE עם perplexity 28, מרחק אוקלידי (Euclidean distance) ו-seed 12. ההשלכה מספקת מבט איכותני על הארגון של שתי קבוצות הייצוגים.
דפוסי EEG ויכולת פירוש של קשב מרחבי
איור משלים 3 מקבץ מושגי בדיקה לקטגוריות של בעלי חיים, מושגים הקשורים למזון/צמחים וחפצים אחרים, תוך שימוש במיפוי מפורש של מושג-תווית. בתוך כל קבוצה, השורות מסודרות לפי מקבץ Ward של CLIP embeddings שעברו הלבנה (whitened ground-truth) ונדגמו באופן אחיד לעד 30 מושגים לצורך קריאות. מפת החום מציגה אמפליטודות EEG מולבנות, מנורמלות וקטומות (clipped) על סולם של 1- עד 1; ה-CLIP embeddings משמשים אך ורק לקביעת הסדר בתוך הקבוצה.
איור משלים 4 מציג טופוגרפיה סטנדרטית של הקרקפת בטווח של 10–20 עבור משקולות ערוצים מנורמליות של זרם סמנטי מוחלט על פני 17 האלקטרודות שנבחרו. המפה מסכמת את שקלול המודל היחסי בערוצי הקרקפת שנמדדו ומפורשת כוויזואליזציה של משקולות מודל ברמת הערוץ.
מחקר זה הוא ניתוח חישובי משני של מאגר הנתונים הבלתי-מזוהה THINGS-EEG2. הקלטות ה-EEG המקוריות, מערכי ה-EEG שעברו עיבוד מקדים, מטא-נתוני תמריצים ותמונות, וקבצי מצב מנוחה זמינים באמצעות פרויקט THINGS-EEG2 בכתובת https://osf.io/3jk45/ וב-Figshare+ (https://doi.org/10.25452/figshare.plus.18470912). התוכנה המקורית לרכישה ולעיבוד מקדים זמינה בכתובת https://github.com/gifale95/eeg_encoding. הגישה והשימוש החוזר בנתוני ה-EEG ובתמונות התמריצים כפופים לרישיונות לדרישות השייכות המפורטות במאגרי המקור.
מימוש TDE-Net, כולל סקריפטים ליישור, מיזוג, שחזור, הערכה וויזואליזציה, זמין בכתובת https://github.com/Yuan-ui198/TDE-Net. הגרסה התואמת למאמר זה מקובעת בקומיט c99325d7f9e090ddd7cd5816aeabda7a9b9364da (https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e090ddd7cd5816aeabda7a9b9364da). לא נאספו נתוני משתתפים מזהים חדשים עבור מחקר זה.
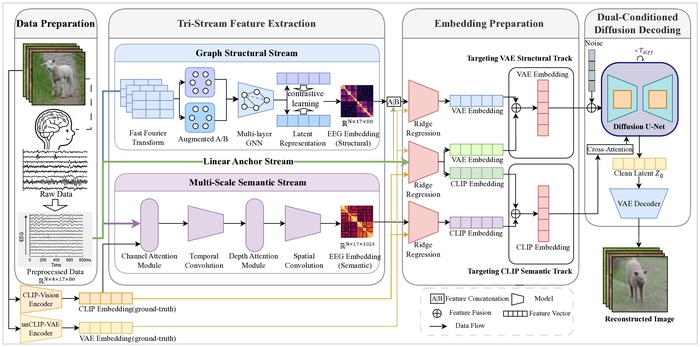
איור 1סכימה של TDE-Net. התרשים מציג את עוגן ה-EEG הגולמי, את זרם הגרף הפונקציונלי הספציפי לדגימה, את הזרם הטמפורלי הסמנטי, מיפוי של מרחב כפול ל-VAE ול-CLIP, מיזוג משוקלל, ופענוח Stable UnCLIP המותנה באופן כפול. ממדי הטנזור מצוינים היכן שרלוונטי. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
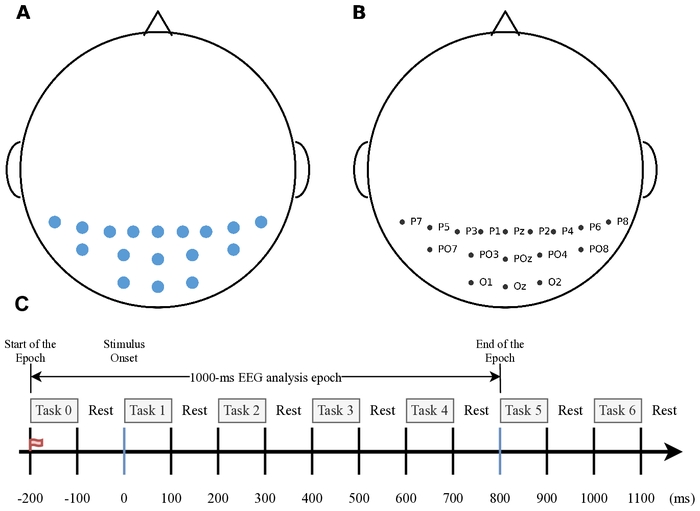
איור 2: בחירת אלקטרודות EEG ותזמון ניסויי. (A) התפלגות מרחבית של 17 האלקטרודות הפריאטליות-אוקסיפיטליות שנבחרו מתוך רכישת הנתונים המקורית של 64 ערוצים. (B) סימוני האלקטרודות: Pz, P3, P7, O1, Oz, O2, P4, P8, P1, P5, PO7, PO3, POz, PO4, PO8, P6, ו-P2. (C) תרשים של תזמון ה-RSVP והגדרת תקופת ה-EEG (epoch). בתרשים, "Task" מציין מרווח הצגת תמונה, בעוד ש-"Rest" מציין את המרווח שבין התמונות; בלוקי ה-Task הממוספרים מציינים מרווחי הצגה עוקבים ולא תנאים ניסוייים שונים. כל תמונה הוצגה למשך 100 ms עם אסינכרוניות של התחלת גירוי (stimulus-onset asynchrony) של 200 ms. תקופת ה-EEG נפרשה מ-200- עד 800 ms ביחס להתחלת הגירוי, מה שמתאים לתקופת ניתוח EEG של 1000 ms. אנא לחצו כאן להצגת גרסה גדולה יותר של איור זה.
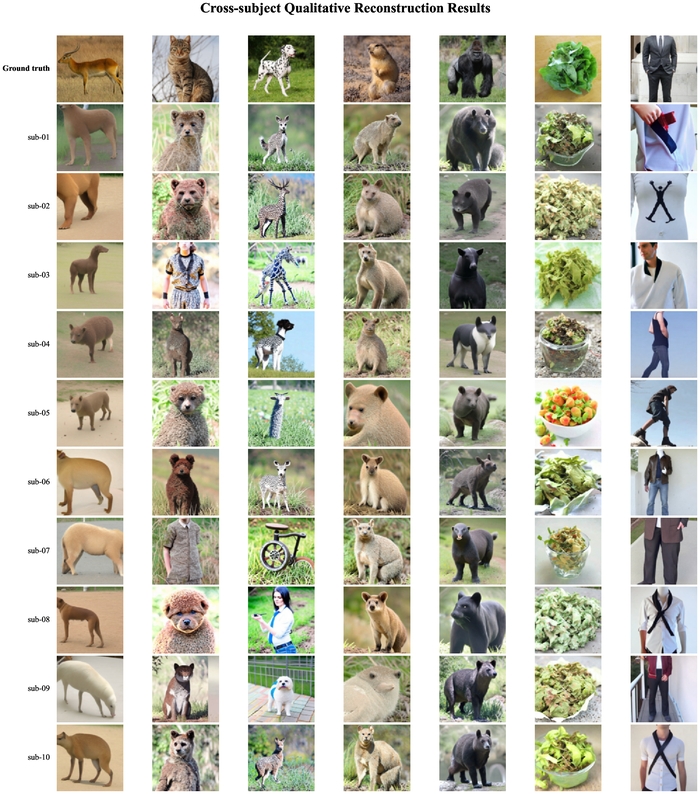
איור 3: תוצאות שחזור איכותניות בין-נבדקים עבור שבעה תנאי תמונה שהושארו בחוץ. נעשה שימוש באותם מדדי תנאים המבוססים על אפס (1, 32, 62, 86, 87, 108, ו-175) עבור נבדקים sub-01 עד sub-10. השורה העליונה מציגה את דגימות תמונות ה-ground-truth התואמות מתוך סט הבדיקה של THINGS-EEG2, שתמונותיהם נלקחו ממאגר התמונות THINGS34, בעוד שהשורות הנותרות מציגות שחזורי TDE-Net עבור כל נבדק. האיור מדגים תוכן סמנטי משותף ושונות ברמת הנבדק; תוצאות כמותיות בין-נבדקים מדווחות בטבלה 3. אנא לחצו כאן כדי להציג גרסה מוגדלת של איור זה.
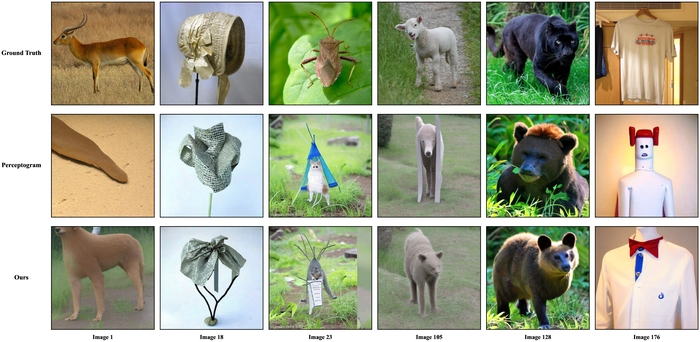
איור 4: השוואת שחזור איכותית עבור שישה תנאי בדיקה מוגדרים של sub-01. השורות מציגות את גירוי ה-ground-truth, שחזור השוואתי שהופק על ידי המימוש המקומי, ושחזור של TDE-Net; העמודות תואמות למדדי תנאים אינדיבידואליים. דגימות תמונות ground-truth נלקחו ממאגר התמונות THINGS34. נא ללחוץ כאן כדי להציג גרסה גדולה יותר של איור זה.
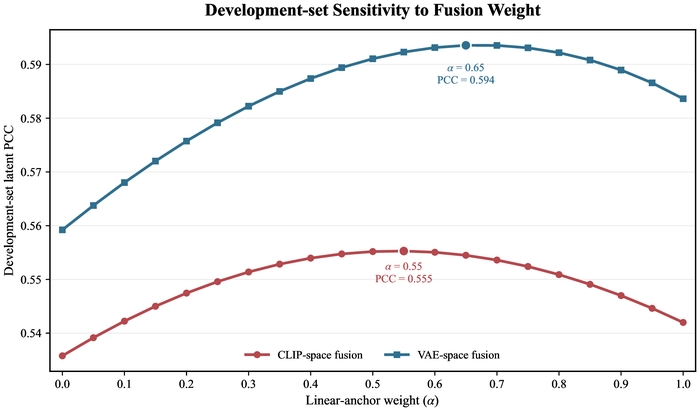
איור 5: רגישות של משקלי איחוד-סמוי (latent-fusion weights) עבור סט הפיתוח. הציר האופקי מציין את משקל העוגן הליניארי α, משקל הזרם המשלים הוא 1 - α, והציר האנכי מציין את ה-PCC הסמוי של סט הפיתוח. ערכי המועמדים נעים בין 0.00 ל-1.00 במרווחים של 0.05. משקלי מרחב ה-CLIP וה-VAE נבחרים באופן בלתי תלוי על פי הממוצע המקסימלי של PCC ברמת הנבדק (עם משקל שווה) עבור 10 נבדקים, מה שנותן αCLIP = 0.55 ו-αVAE = 0.65. PCC, מקדם המתאם של פירסון. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
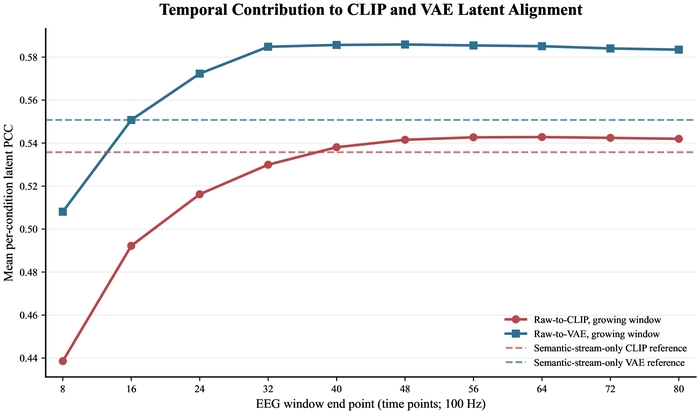
איור 6: ניתוח חלון זמני של יישור חבוי ב-sub-01 (n = 200 תנאים שהוצאו מהמדגם). עקומות רציפות מראות את ה-PCC הממוצע לכל דגימה עבור תחזיות ridge של raw-to-CLIP ו-raw-to-VAE כאשר נקודת הסיום של חלון ה-EEG מתרחבת מ-8 ל-80 נקודות זמן ב-100 Hz. קווים מקווקווים מציינים ערכי ייחוס של CLIP ו-VAE עבור זרם סמנטי בלבד בחלון מלא. PCC, מקדם מתאם פירסון. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
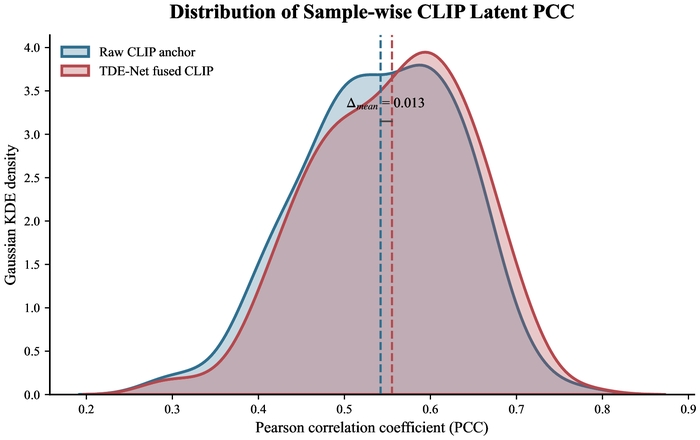
איור 7: התפלגות יישור CLIP לטנטי עבור כל דגימה ב-sub-01 (n = 200 תנאים שנסתרו). העקומות הן הערכות צפיפות גרעין גאוסיאני עם רוחב פס של Scott עבור עוגן ה-CLIP הגולמי ועבור תחזית ה-CLIP הממזגת של TDE-Net-fused קפוא. קווים מקווקווים אנכיים מציינים את ממוצעי הדגימות, וההערה מציינת את ההפרש ביניהם. PCC, מקדם מתאם פירסון; KDE, הערכת צפיפות גרעין. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
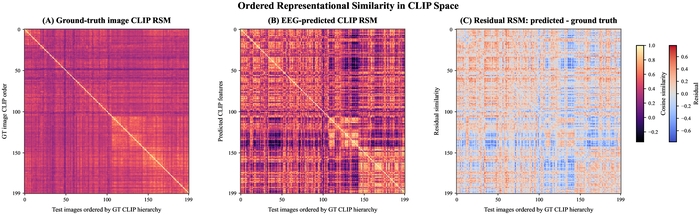
איור 8דמיון ייצוגי מסודר במרחב CLIP עבור sub-01 (n = 200 תנאים שהושארו בחוץ). (A(RSM של דמיון קוסינוס (Cosine-similarity) עבור שיכbols של תמונות אמת (ground-truth) מנורמליזים ל-L2 של CLIP. (B) מפת התגובה (RSM) של דמיות קוסינוס (Cosine-similarity) עבור שימועי CLIP שנובאו מ-EEG ממוזגים, המוצגת באמצעות אותו סדר ואותו סולם צבעים כמו בפאנל A. (CRSM שאריות, שחושב כערך החזוי פחות ערך האמת (ground truth), מוצג במقياس סימטרי המוגדר על ידי השארית המוחלטת המקסימלית. הסדר נקבע על ידי מרחק אוקלידי וקישור Ward של קידודי CLIP של ערכי האמת. RSM, מטריצת דמיון ייצוגי (representational similarity matrix). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
| רכיב | פרמטר | מסגרת |
| נתונים ועיבוד מקדמי | חלוקת מערך נתונים | 16,540 תנאי אימון ו-200 תנאי בדיקה נפרדים; פיצול של 90%/10% להתאמה/פיתוח (seed 42) |
| קלט EEG | 17 ערוצים פריאטו-אוקסיפיטליים; 0-800 מילי-שנייה; 100 הרץ; 80 נקודות זמן | |
| ייצוג ספקטרלי | FFT בעל 80 נקודות; 40 סלילי תדר חיוביים; ספקטרום אמפליטודה לוגריתמי בטווח של 0-50 הרץ | |
| זרם מבני | בניית גרף | מתאם פירסון מוחלט ספציפי לדגימה; שקלול של k=4 השכנים הקרובים ביותר לכל צומת; סימטריזציה ולולאות עצמיות |
| ארכיטקטורת GCN | 5 שכבות; 80 יחידות נסתרות; ReLU; dropout 0.3; נורמליזציה סימטרית של דרגות; איחוד ממוצע (mean pooling) | |
| פונקציית מטרה ניגודית | ראש הקרנה בן 80 ממדים; טמפרטורת InfoNCE τ = 0.5 | |
| הכשרה | Adam; קצב למידה 5 × 10⁻⁴; גודל אצווה 32; 20 תקופות (epochs); cosine annealing; קצב למידה מינימלי 10⁻⁶; זרע 42 | |
| זרם סמנטי | ארכיטקטורה | גרעינים זמניים 5/15/31; עומק 9; 24 ערוצי תכונות; נשירה (dropout) 0.5; ממד פלט 1,024 |
| הכשרה | AdamW; קצב למידה 5 × 10⁻⁴; דעיכת משקולות (weight decay) 0.01; גודל אצווה (batch size) 64; 50 תקופות אימון (epochs); הקטנה קוסינוסית (cosine annealing); קצב למידה מינימלי 10⁻⁶; זרע 42 | |
| מיפוי חבוי | רגרסיית רידג' (Ridge regression) | החיתוך (Intercept) הותאם; מספר איטרציות מקסימלי 50,000; הקלטים נסטנדרו באמצעות סטטיסטיקות של חלוקת התאמה (fitting-partition statistics) |
| רגולריזציה | קנס CLIP λ = 1,000; קנס VAE גולמי λ = 0; עונש VAE מבני λ = 1,000 | |
| מימדי המטרה | CLIP: 1,024; VAE: 36,864 | |
| היתוך ופענוח | משקולות היתוך | משקל עיגון של CLIP α = 0.55; משקל עוגן של VAE α = 0.65; נבחר על סמך נתוני הפיתוח ונקבע לפני הבדיקה |
| מודל דיפוזיה | sd2-community/stable-diffusion-2-1-unclip; קנה מידה מבני γ = 0.02; צעדי זמן דיפוזיה T = 1,000 | |
| דגימה | 20 שלבי הסרת רעשים; קנה מידה של הנחיה 7.5; זרע דיפוזיה 0 |
טבלה 1: סיכום פרמטרים מאוחד עבור TDE-Net. הטבלה מפרטת את חלוקת הנתונים, עיבוד מקדימה, בניית סמיכות פונקציונלית, הגדרות מקודד גרפים ומקודד סמנטי, עונשי מיפוי מרחב חבוי, משקלי מיזוג והגדרות פענוח דיפוזיה ששימשו לאורך הניסויים המדווחים.
| שיטה | PixCorr | מדד דמיון מבני (SSIM) | AlexNet(2) | AlexNet(5) | התחלה | CLIP | EffNet | SwAV |
| קו בסיס | 0.141 | 0.321 | 0.823 | 0.878 | 0.704 | 0.739 | 0.898 | 0.564 |
| פענוח תמונות באמצעות EEG | - | 0.345 | 0.776 | 0.866 | 0.734 | 0.786 | - | 0.582 |
| פרספטוגרמה (unCLIP) | 0.223 | 0.370 | 0.875 | 0.915 | 0.749 | 0.806 | 0.870 | 0.530 |
| TDE-Net (שלנו) | 0.253 ± 0.014 | 0.339 ± 0.003 | 0.878 ± 0.012 | 0.915 ± 0.012 | 0.761 ± 0.021 | 0.814 ± 0.007 | 0.829 ± 0.012 | 0.509 ± 0.010 |
טבלה 2: תוצאות שחזור כמותיות. שיטות ההשוואה, Baseline של קונבולוציה-קשב פנימי ו-TDE-Net, הוערכו במסגרת ניסויית משותפת תוך שימוש באותה חלוקה של THINGS-EEG2, קלט של 17 ערוצים, עיבוד מקדים, תנאי בדיקה נפרדים (held-out) והגדרות מדדים, תוך שמירה על ארכיטקטורות ספציפיות לכל שיטה. המודל הנוכחי מסוכם כממוצע ± SD עבור 10 נבדקים. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 ו-CLIP הם מדדים שבהם ערך גבוה יותר הוא טוב יותר; EffNet ו-SwAV הם מרחקי מתאם, שעבורם ערך נמוך יותר הוא טוב יותר. עמודת CLIP מדווחת על דיוק זיהוי זוגי באמצעות מודל OpenAI CLIP ViT-L/14.
| נושא | PixCorr | SSIM (מדד דמיון מבני) | AlexNet L2 | AlexNet L5 | התחלה | CLIP | EffNet | SwAV |
| תת-01 | 0.2260 | 0.3361 | 0.8831 | 0.9203 | 0.7533 | 0.8120 | 0.8567 | 0.5285 |
| תת-02 | 0.2488 | 0.3378 | 0.8699 | 0.9053 | 0.7268 | 0.8074 | 0.8335 | 0.5167 |
| תת-03 | 0.2564 | 0.3397 | 0.8728 | 0.9070 | 0.7658 | 0.8143 | 0.8268 | 0.5096 |
| תת-04 | 0.2420 | 0.3356 | 0.8598 | 0.9034 | 0.7854 | 0.8112 | 0.8255 | 0.5091 |
| תת-05 | 0.2499 | 0.3385 | 0.8760 | 0.8963 | 0.7251 | 0.8016 | 0.8394 | 0.5189 |
| תת-06 | 0.2621 | 0.3395 | 0.8910 | 0.9331 | 0.7818 | 0.8215 | 0.8202 | 0.5009 |
| תת-07 | 0.2489 | 0.3378 | 0.8643 | 0.9185 | 0.7704 | 0.8200 | 0.8222 | 0.5017 |
| תת-08 | 0.2786 | 0.3425 | 0.8951 | 0.9216 | 0.7524 | 0.8245 | 0.8214 | 0.5010 |
| תת-09 | 0.2609 | 0.3370 | 0.8775 | 0.9238 | 0.7662 | 0.8055 | 0.8250 | 0.5009 |
| פחות מ-10 | 0.2571 | 0.3433 | 0.8871 | 0.9240 | 0.7792 | 0.8175 | 0.8140 | 0.4977 |
| ממוצע | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7606 | 0.8135 | 0.8285 | 0.5085 |
| ממוצע ± סטיית תקן | 0.2531 ± 0.0138 | 0.3388 ± 0.0025 | 0.8777 ± 0.0115 | 0.9153 ± 0.0116 | 0.7606 ± 0.0213 | 0.8135 ± 0.0074 | 0.8285 ± 0.0122 | 0.5085 ± 0.0101 |
| רווח סמך של 95% | 0.2432-0.2630 | 0.3370-0.3406 | 0.8695-0.8859 | 0.9070-0.9236 | 0.7454-0.7759 | 0.8082-0.8189 | 0.8198-0.8372 | 0.5013-0.5157 |
טבלה 3: תוצאות כמותיות בין-נבדקים עבור TDE-Net. כל נבדק תורם 200 תנאי בדיקה נשמרים (held-out). הטבלה מציגה את שמונת המדדים עבור sub-01 עד sub-10, ולאחריהם הממוצע בין-נבדקים, סטיית תקן של המדגם (SD) ורווח ברטחון של 95% (CI). CLIP מציין את דיוק הזיהוי הזוגי של OpenAI CLIP ViT-L/14; EffNet ו-SwAV הם מרחקי מתאם שבהם ערך נמוך יותר מעיד על ביצועים טובים יותר.
| שיטה | PixCorr | מדד דמיון מבני (SSIM) | AlexNet(2) | AlexNet(5) | התחלה | CLIP | EffNet | SwAV |
| עוגן ליניארי | 0.2157 | 0.3309 | 0.8891 | 0.9128 | 0.7493 | 0.7967 | 0.8683 | 0.5394 |
| זרם מבני + ליניארי | 0.2318 | 0.3393 | 0.8861 | 0.9319 | 0.7439 | 0.7996 | 0.8657 | 0.5359 |
| ליניארי + Sem-Stream | 0.2372 | 0.3382 | 0.8879 | 0.9228 | 0.7447 | 0.8026 | 0.8655 | 0.5307 |
| TDE-Net (שלנו) | 0.2531 | 0.3388 | 0.8777 | 0.9153 | 0.7607 | 0.8135 | 0.8285 | 0.5085 |
טבלה 4: תוצאות אבלציה המדווחות כערכי ממוצע בין-נבדקים תחת הליך ההערכה המתואר בסעיף 6 של הפרוטוקול. ה-Linear Anchor הוא רפרנס למיפוי רכס ישיר פנימי המוערך באופן מקומי; התצורות המבנית, הסמנטית והמלאה משתמשות באותם מדדי תנאי והגדרות מטריקה. PixCorr, SSIM, AlexNet Layer 2, AlexNet Layer 5, Inception-v3 ו-CLIP הם מדדים שבהם ערך גבוה יותר הוא טוב יותר; EffNet ו-SwAV הם מרחקי קורלציה שבהם ערך נמוך יותר הוא טוב יותר. הערכים מוצגים עד שלוש ספרות אחרי הנקודה.
איור משלים 1: מקרי שחזור מייצגים המקיפים את טווח ההסכמה של CLIP עבור sub-01. 200 התנאים שהושארו בחוץ מדורגים לפי דמיון קוסינוס בין ייצוגי CLIP שנחזו מ-EEG ממוזג לבין ייצוגי האמת (ground-truth); מוצגים שישה מהמקרים הטובים ביותר, שישה מהמקרים הממוצעים ושישה מהמקרים הגרועים ביותר. כל עמודה מזווגת דגימת תמונת אמת מסט הבדיקה של THINGS-EEG2 עם שחזור TDE-Net שלה. תמונות האמת נלקחו ממאגר התמונות של THINGS34. אנא לחצו כאן כדי להוריד קובץ זה.
איור משלים 2: ויזואליזציה משותפת של ייצוגי CLIP של אמת הקרקע (ground-truth) ושל ייצוגי CLIP שנחזו מ-EEG בנבדק 01 (n = 200 תנאים לכל ייצוג). (A) ייצוגי CLIP של אמת הקרקע. (B) ייצוגי CLIP שנחזו מ-EEG. הצבעים מציינים חמישה אשכולות k-means שהותאמו לשיבוצי CLIP של אמת הקרקע שנורמלו לפי L2 (k = 5, n_init = 50, seed = 7). האשכולות הם קבוצות מונחות נתונים ואינם תואמים לקטגוריות סמנטיות שהוגדרו מראש. שיבוצי אמת הקרקע והשיבוצים החזויים שורשרו, הופחתו ל-50 ממדים באמצעות PCA, והושלכו במשותף על ידי t-SNE (perplexity = 28, learning rate = auto, Euclidean metric, seed = 12). PCA, ניתוח רכיבים ראשיים; t-SNE, השבחה סטוכסטית של שכנים מפוצלים לפי t. אנא לחץ כאן להורדת קובץ זה.
איור משלים 3: תבניות EEG מקובצות לפי קטגוריית מושג-תמונה רחבה עבור נבדק sub-01. מושגים משויכים לבעלי חיים, מושגים הקשורים למזון/צמחים, או חפצים אחרים. בתוך כל קטגוריה, השורות עוקבות אחר הסדר ההיררכי של Ward עבור השכבות (embeddings) המולבנות (whitened) של CLIP המהוות את ערכי האמת (ground-truth), ונדגמות באופן אחיד לעד 30 מושגים לצורך קריאות. העמודות מציגות 17 ערוצי EEG, עם 80 נקודות זמן לכל ערוץ. סולם הצבעים (1- עד 1) מייצג אמפליטודת EEG מולבנת, מנורמלת וקצוצה (clipped). אנא לחץ כאן להורדת קובץ זה.
איור משלים 4: טופוגרפיית קשב של ערוצי קרקפת עבור זרם סמנטי. הצבעים מראים גדלים יחסיים מנורמלים של פרמטרי משקלי-ערוץ נלמדים עבור 17 האלקטרודות שנבחרו בהטלה סטנדרטית של קרקפת לפי מערכת 10–20; נקודות ואיתורי האלקטרודות מזהים את מיקומי המדידה. הסקאלה נעה בין 0 ל-1 ומסכמת את שקלול הערוצים היחסי שנלמד על ידי המודל. אנא לחצו כאן להורדת קובץ זה.
דיון
מחקר זה מציג תזרים עבודה חישובי מודולרי המפריד בין עיבוד מקדים של EEG, למידה של ייצוגים מבניים וסמנטיים, מיפוי מרחב חבוי (latent mapping) של CLIP/VAE, היתוך (fusion) ופענוח באמצעות דיפוזיה (diffusion decoding). ארגון מדורג זה מאפשר לבחון פלטים ביניים בנפרד מהתמונות הנוצרות, ועוקב אחר ההתפתחות הרחבה יותר ממקודדי EEG קומפקטיים לשיטות שחזור חוצות-מודליות ומבוססות דיפוזיה6,11,12,13,14,15,16,,17,18,19,20,21,22. ניתוח חוצה-נבדקים מדווח על ערכים ברמת הנבדק יחד עם הממוצע בין-נבדקי וסטיית תקן (SD) של המדגם עבור הערכה של עשרה נבדקים שהושארו בחוץ (held-out evaluation). יחד עם ניתוח האבלאציה (ablation) השלבי בטבלה 4, ניתוח זה מכמת השפעות ספציפיות לזרם ושונות בין-נבדקית בתוך צינור העיבוד (pipeline) המדווח.
שלבים קריטיים ופתרון בעיות
בקרות היישום המשמעותיות ביותר הן בידוד המחיצות (partition isolation), נורמליזציה עקבית, שימור מדד-תנאי (condition-index preservation), ומיפויים נפרדים של CLIP/VAE. יש לבחור את משקולות היתוך (fusion weights) על סמך תנאי הפיתוח ולהקפיא אותן לפני שחזור הבדיקה. כאשר הביצועים נמוכים באופן בלתי צפוי, יש לאמת תחילה את סדר המערך ואת הממדים, ולאחר מכן לבחון את ה-PCC החבוי (latent PCC) הגולמי והספציפי לענף, את מטא-נתוני היתוך ואת פלטי המדדים ברמת התמונה. כשל ביישור החבוי (latent-alignment) מעיד על בעיית מיפוי במעלה הזרם, בעוד שתמונות משתנות עם ערכי חבוי יציבים עשויות לשקף התנהגות סטוכסטית או תלוית-מפענח (decoder-dependent)14,21,22,29.
שינוי של סידור האלקטרודות (montage), קצב הדגימה או החלון הזמני מחייב שינויים תואמים בבניית הגרף, בתכונות הספקטרליות ובגרעינים הזמניים (temporal kernels). יש להעריך את איכות השחזור באמצעות מדדים משלימים ברמה נמוכה ומדדים סמנטיים, כיוון ששום ציון בודד אינו משקף את הנאמנות לפיקסלים, את המבנה ואת ההסכמה ברמת האובייקט.6,11,21,22,23מדד ה-CLIP המשמש כאן הוא דיוק זיהוי זוגי (pairwise identification accuracy), בעוד ש- איור 7 ו- איור 8 השתמש ב-PCC ברמת המשתנה החבוי (latent-level); כמויות אלו אינן ניתנות להחלפה.
הארגון המודולרי של TDE-Net מספק מסגרת לבחינה של השאלה האם ייצוגי EEG משלימים תורמים באופן שונה להיבטים מבניים וסמנטיים של שחזור חזותי. גישה זו עשויה להקל על השוואה שיטתית של ייצוגי תכונות EEG, מטרות חבויות (latent targets) ומפענחים גנרטיביים, מבלי להסתמך אך ורק על התמונות המשוחזרות הסופיות. גישות חלופיות כוללות מיפוי ליניארי ישיר מ-EEG ל-latent, מקודדים קונבולוציוניים או מבוססי קשב (attention) בעלי זרם יחיד, ייצוגים מבוססי גרפים ומסגרות פענוח עצבי מקצה לקצה6,7,8,9,10,11,17,18,19,20,21,22. זרימת העבודה הנוכחית עשויה להיות שימושית במיוחד למחקר על פענוח תפיסה חזותית, ניתוח ייצוגים עצביים וממשקי מוח-מחשב לא פולשניים, שבהם הפרדה של תחזיות ביניים מ-EEG ל-latent יכולה לסייע באפיון הרכיבים התורמים לביצועי השחזור.
מגבלות
המגבלות העיקריות הן רכישת ה-RSVP הקבועה של THINGS-EEG2, 17 הערוצים הפריאטלי-אוקסיפיטליים הנבחרים, מיפויים ספציפיים לנבדקים, דקודר דיפוזיה יחיד ואנליזות פרשנות איכותיות21,22,23. הסיכום עבור 10 הנבדקים נותן מענה לשונות בין-נבדקית בתוך מערך הנתונים, אך הוא אינו מבסס העברה בין-מערכי נתונים או בין-פרדיגמות. תמונות שנוצרו עשויות להכיל פרטים סביריים שאינם נתמכים על ידי קלט ה-EEG, ותצוגות של RSM, t-SNE, תבנית EEG ותשומת לב אינן מבססות מנגנונים עצביים סיבתיים. האבלציה השלבית מאפיינת את התרומות של זרם המבנה, הזרם הסמנטי ומיזוג המרחב הכפול תחת עגן EEG גולמי משותף, יעדים לטנטיים, דקודר דיפוזיה ופרוטוקול הערכה.
כיוונים עתידיים
במסגרת מגבלות אלו, התוצאות תומכות בהערכה של ייצוגי EEG משלימים במרחבים סמנטיים ומרחבי תמונה-חבויים (image-latent spaces) נפרדים לפני פענוח דיפוזיה. עבודות עתידיות צריכות לבחון מערכי נתונים עצמאיים, התאמה לנבדקים, הערכות אי-ודאות, סידורי אלקטרודות (channel montages) חלופיים, ומפענחים בעלי בקרות חזקות יותר על פרטים חזותיים שאינם נתמכים14,15,16,17,18,19,20,21,22,23. מחקרים כאלו נחוצים לפני הרחבת הממצאים הנוכחיים להקשרי מדעי המוח רחבים יותר או למסגרות של ממשק מוח-מחשב.
סיכום:
TDE-Net משלב עוגן EEG גולמי עם ייצוגי EEG מבניים וסמנטיים, מיישר אותם בנפרד עם מרחבי החסר (latent spaces) של VAE ו-CLIP, וממזג את התחזיות המתקלות לפני פענוח הדיפוזיה. בקרב 10 משתתפי THINGS-EEG2, התמונות השוחזרות שמרו על התאמה מדידה ברמת הפיקסל, ברמה המבנית וברמה הסמנטית עם הגירויים שנצפו, בעוד שההסרה השלבית (stepwise ablation) בידלה בין ההשפעות של המסלול המבני, המסלול הסמנטי ומיזוג מרחבי הכפול. על ידי חשיפת מאפייני EEG ביניים, תחזיות חסר, פלטי מיזוג ושחזורים סופיים, הפרוטוקול מספק מסגרת הניתנת לשחזור לחקירת שחזור חזותי מבוסס EEG ולהערכת הרחבתו העתידית למסדי נתונים ולהגדרות רכישה עצמאיות.
גילויים
המחברים מצהירים כי אין ניגודי עניינים כספיים או מערכות יחסים אישיות שעלולות היו להשפיע על עבודה זו. המחברים מצהירים כי לא נעשה שימוש בכלי בינה מלאכותית גנרטיבית בכתיבת כתב היד, בקוד, בניתוח הנתונים או בהכנת האיורים.
תודות
מחקר זה מומן על ידי הקרן הלאומית למדעים טבעיים של סין תחת (Grant No. 62433002) ו-(Grant No. 62476014), הפרויקט הלאומי הגדול למדע וטכנולוגיה (No. 2021ZD0113703), פרויקט התכנון השנתי של קרן המדעים החברתיים של עיריית בייג'ינג (No. 23GLB014), הפרויקט להקמה ותמיכה בצוותים חדשניים ברמה גבוהה של מוסדות עיריית בייג'ינג תחת (Grant No. BPHR20220104), ותוכנית מלגאי בייג'ינג תחת (Grant No. 099).
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Accelerate | Hugging Face | 0.30.1 | ניהול התקנים של pipeline לדיפוזיה; https://github.com/huggingface/accelerate |
| CLIP ViT-L/14 | OpenAI | ViT-L/14; openai-clip 1.0.1 | מקודד תכונות תמונה המשמש למטרות סמנטיות וזיהוי זוגי ב-CLIP; https://github.com/openai/CLIP |
| Diffusers | Hugging Face | 0.32.2 | מימוש של pipeline עבור Stable UnCLIP; https://github.com/huggingface/diffusers |
| Matplotlib | Matplotlib Development Team | 3.10.6 | יצירת איורים מדעיים; https://matplotlib.org/ |
| MNE-Python | MNE Developers | 1.11.0 | מונטאז' 10-20 סטנדרטי וטופוגרפיה של ערוצי קרקפת; https://mne.tools/ |
| NumPy | NumPy Developers | 2.3.4 | מערכי EEG, שיכנונים לטנטיים (latent embeddings), מיזוג ואגרגציה של מדדים; https://numpy.org/ |
| NVIDIA GeForce RTX 4070 Laptop GPU | NVIDIA | 8 GB; driver 595.97 | GPU המשמש לאימון מקודד מקומי ושחזור דיפוזיה. |
| Pillow | Python Imaging Library Fork | 11.1.0 | טעינת תמונות, שינוי גודל וייצוא; https://python-pillow.org/ |
| Python | Python Software Foundation | 3.12.12 | סביבת ההרצה הראשית; https://www.python.org/ |
| PyTorch | PyTorch Foundation | 2.9.1+cu128 | אימון מקודד EEG והסקה של רשת עצבית; https://pytorch.org/ |
| scikit-image | scikit-image Developers | 0.25.2 | SSIM וכלי עזר לעיבוד תמונות; https://scikit-image.org/ |
| scikit-learn | scikit-learn Developers | 1.7.2 | רגרסיית Ridge, k-means, PCA ו-t-SNE; https://scikit-learn.org/ |
| SciPy | SciPy Developers | 1.16.3 | קורלציה, מרחק סטטיסטי ואשכולה היררכית; https://scipy.org/ |
| Seaborn | Seaborn Developers | 0.13.2 | ויזואליזציה של צפיפות גרעין גאוסיאנית; https://seaborn.pydata.org/ |
| Semantic-stream EEG encoder | TDE-Net authors; adapted from LMDA-Net | Repository commit c99325d | ייצוג סמנטי זמני רב-קנה; מימוש ומטא-נתונים של נקודת ביקורת (checkpoint) מסופקים במאגר הקוד. |
| Stable Diffusion 2.1 UnCLIP | Stability AI / SD2 Community | sd2-community/stable-diffusion-2-1-unclip | מפענח דיפוזיה קפוא; https://huggingface.co/sd2-community/stable-diffusion-2-1-unclip |
| Structural-stream EEG encoder | TDE-Net authors | Repository commit c99325d | ייצוג גרף בפיקוח עצמי; נתוני EEG גולמיים ותכונות גרף שורשרו רק עבור מיפוי מבני במרחב ה-VAE. |
| TDE-Net alignment, fusion, evaluation, and visualization scripts | Yuan-ui198 | commit c99325d7f9e090ddd7cd581 6aeabda7a9b9364da | https://github.com/Yuan-ui198/TDE-Net/tree/c99325d7f9e0 90ddd7cd5816aeabda7a9b9364da |
| THINGS database | Hebart et al. | doi:10.1371/journal.pone.0223792 | מקור גירויי עצמים נטורליסטיים; https://things-initiative.org/ |
| THINGS-EEG2 dataset | Gifford et al. | doi:10.1016/j.neuroimage.2022.119754 | EEG של 64 ערוצים מ-10 נבדקים; מחקר זה בוחר 17 ערוצים פריאטו-אוקסיפיטליים; https://osf.io/anp5v/ |
| timm | Ross Wightman and contributors | 1.0.22 | כלי עזר למודלי ראייה מאומנים מראש המשמשים להערכת תכונות; https://github.com/huggingface/pytorch-image-models |
| torchvision | PyTorch Foundation | 0.24.1+cu128 | שלד הערכה עבור AlexNet, Inception-v3 ו-EfficientNet; https://pytorch.org/vision/ |
| tqdm | tqdm Developers | 4.67.1 | דיווח התקדמות עבור חילוץ תכונות, שחזור והערכה; https://tqdm.github.io/ |
| Transformers | Hugging Face | 4.37.2 | ממשקים עבור רכיבי מודלים מאומנים מראש; https://github.com/huggingface/transformers |
מקורות
- Shen G, Horikawa T, Majima K, Kamitani Y. Deep image reconstruction from human brain activity. PLoS Comput Biol. 2019;15(1):e1006633. doi:10.1371/journal.pcbi.1006633.
- Chen Z, Qing J, Xiang T, Yue W, Zhou JH. Seeing beyond the brain: conditional diffusion model with sparse masked modeling for vision decoding. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 22710-22720. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Chen_Seeing_Beyond_the_Brain_Conditional_Diffusion_Model_With
_Sparse_Masked_Modeling_CVPR_2023_paper.html - Takagi Y, Nishimoto S. High-resolution image reconstruction with latent diffusion models from human brain activity. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023. p. 14453-14463. Available from: https://openaccess.thecvf.com/content/CVPR2023/html/Takagi_High-Resolution_Image_Reconstruction_With_Latent_Diffusion_Models_
From_Human_Brain_CVPR_2023_paper.html - Scotti PS et al. Reconstructing the mind's eye: fMRI-to-image with contrastive learning and diffusion priors. Adv Neural Inf Process Syst. 2023;36:24705-24728. doi:10.52202/075280-1073.
- Geman S, Bienenstock E, Doursat R. Neural networks and the bias/variance dilemma. Neural Comput. 1992;4(1):1-58. doi:10.1162/neco.1992.4.1.1.
- Lawhern VJ et al. EEGNet: a compact convolutional neural network for EEG-based brain-computer interfaces. J Neural Eng. 2018;15(5):056013. doi:10.1088/1741-2552/aace8c.
- Kostas D, Aroca-Ouellette S, Rudzicz F. BENDR: using transformers and a contrastive self-supervised learning task to learn from massive amounts of EEG data. Front Hum Neurosci. 2021;15:653659. doi:10.3389/fnhum.2021.653659.
- Song Y, Zheng Q, Liu B, Gao X. EEG Conformer: convolutional transformer for EEG decoding and visualization. IEEE Trans Neural Syst Rehabil Eng. 2023;31:710-719. doi:10.1109/TNSRE.2022.3230250.
- Cui CM et al. "Pre-Train, Prompt" framework to boost graph neural networks performance in EEG analysis. IEEE J Biomed Health Inform. 2025;29(7):4847-4860. doi:10.1109/JBHI.2025.3541058.
- Meng X, Qiu S, Wan S, Cheng K, Cui L. A motor imagery EEG signal classification algorithm based on recurrence plot convolution neural network. Pattern Recognit Lett. 2021;146:134-141. doi:10.1016/j.patrec.2021.03.023.
- Miao Z, Zhao M, Zhang X, Ming D. LMDA-Net: a lightweight multi-dimensional attention network for general EEG-based brain-computer interfaces. Neuroimage. 2023;276:120209. doi:10.1016/j.neuroimage.2023.120209.
- Zhang S, Tang C, Guan C. Visual-to-EEG cross-modal knowledge distillation for continuous emotion recognition. Pattern Recognit. 2022;130:108833. doi:10.1016/j.patcog.2022.108833.
- Palazzo S et al. Decoding brain representations by multimodal learning of neural activity and visual features. IEEE Trans Pattern Anal Mach Intell. 2021;43(11):3833-3849. doi:10.1109/TPAMI.2020.2995909.
- Rombach R, Blattmann A, Lorenz D, Esser P, Ommer B. High-resolution image synthesis with latent diffusion models. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022. p. 10684-10695. Available from: https://openaccess.thecvf.com/content/CVPR2022/html/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR
_2022_paper.html - Radford A et al. Learning transferable visual models from natural language supervision. In: Proceedings of the 38th International Conference on Machine Learning. PMLR. 2021;139:8748-8763. Available from: https://proceedings.mlr.press/v139/radford21a.html
- Bai Y et al. DreamDiffusion: high-quality EEG-to-image generation with temporal masked signal modeling and CLIP alignment. In: Computer Vision - ECCV 2024. Cham: Springer; 2024. p. 472-488. doi:10.1007/978-3-031-72751-1_27.
- Cao X, Gong P, Zhang L, Zhang D. EEG-CLIP: a transformer-based framework for EEG-guided image generation. Neural Netw. 2026;194:108167. doi:10.1016/j.neunet.2025.108167.
- Liu Y et al. FSDBN: foreground-aware EEG-visual alignment via dynamic brain networks. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2607.18344
- Yin F, Zheng C, Gong P, Guan D, Zhu Q. Neural visual decoding via cognitive-guided adaptive blurring and information-constrained alignment. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.16418
- Liu J, Gong P, Zheng C, Liu Y, Zhu Q. Multi-level bidirectional biomimetic learning for EEG-based visual decoding. arXiv [Preprint]. 2026. Available from: https://arxiv.org/abs/2605.04680
- Fei T et al. Perceptogram: reconstructing visual percepts and presumptive electrode preference from EEG. arXiv [Preprint]. 2024. Available from: https://arxiv.org/abs/2404.01250
- Li D, Wei C, Li S, Zou J, Liu Q. Visual decoding and reconstruction via EEG embeddings with guided diffusion. Adv Neural Inf Process Syst. 2024;37:102822-102864. doi:10.52202/079017-3266.
- Gifford AT, Dwivedi K, Roig G, Cichy RM. A large and rich EEG dataset for modeling human visual object recognition. Neuroimage. 2022;264:119754. doi:10.1016/j.neuroimage.2022.119754.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. In: International Conference on Learning Representations. 2017. Available from: https://openreview.net/forum?id=SJU4ayYgl
- Chen T, Kornblith S, Norouzi M, Hinton G. A simple framework for contrastive learning of visual representations. In: Proceedings of the 37th International Conference on Machine Learning. PMLR. 2020;119:1597-1607. Available from: https://proceedings.mlr.press/v119/chen20j.html
- Ramoser H, Muller-Gerking J, Pfurtscheller G. Optimal spatial filtering of single trial EEG during imagined hand movement. IEEE Trans Rehabil Eng. 2000;8(4):441-446. doi:10.1109/86.895946.
- Bai S, Kolter JZ, Koltun V. An empirical evaluation of generic convolutional and recurrent networks for sequence modeling. arXiv [Preprint]. 2018. Available from: https://arxiv.org/abs/1803.01271
- Woo S, Park J, Lee JY, Kweon IS. CBAM: convolutional block attention module. In: European
Conference on Computer Vision. Cham: Springer; 2018. p. 3-19. Available from:
https://doi.org/10.1007/978-3-030-01234-2_1 - Hoerl AE, Kennard RW. Ridge regression: biased estimation for nonorthogonal problems. Technometrics. 1970;12(1):55-67. doi:10.1080/00401706.1970.10488634.
- Zhou ZH. Ensemble Methods: Foundations and Algorithms. Boca Raton: Chapman and Hall/CRC; 2012.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models. Adv Neural Inf Process Syst. 2020;33:6840-6851. Available from: https://proceedings.neurips.cc/paper/2020/hash/4c5bcfec8584af0d967f1ab10179ca4b-Abstract.html
- Ho J, Salimans T. Classifier-free diffusion guidance. arXiv [Preprint]. 2022. Available from: https://arxiv.org/abs/2207.12598
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: International Conference on Learning Representations. 2014. Available from: https://openreview.net/forum?id=33X9fd2-9FyZd
- Hebart MN et al. THINGS: a database of 1,854 object concepts and more than 26,000 naturalistic object images. PLoS One. 2019;14(10):e0223792. doi:10.1371/journal.pone.0223792.
הדפסות חוזרות והרשאות
מאמר זה פורסם
הסרטון יגיע בקרוב