מאמר זה מציג תהליך עבודה (workflow) בביואינפורמטיקה הניתן לשחזור, המשלב מאגרי נתונים טרנסקריפטומיים ציבוריים, למידה חישובית (machine learning), תיקוף חיצוני, quantitative reverse transcription PCR, סריקת Connectivity Map וסימולציית docking מולקולרי, במטרה לזהות סממנים ביולוגיים (biomarkers) ותאי תרופה פוטנציאליים עבור יתר לחץ דם ריאתי.
מאמר מחקר
זיהוי של סמנים ביולוגיים ותרכובות טיפוליות פוטנציאליות עבור יתר לחץ דם ריאתי באמצעות ביואינפורמטיקה ולמידה חישובית
במאמר זה
סיכום
תקציר
מחקר זה נועד לזהות ביומרקרים מולקולריים ותרכובות מולקולות קטנות מועמדות הקשורות ליתר לחץ דם ריאתי (PH) באמצעות נתונים טרנסקריפטומיים ציבוריים ומשאבי תיקוף עצמאיים. שלושה מאגרי נתונים מ-Gene Expression Omnibus (מספריהם GSE22356, GSE33463, ו-GSE48149) שולבו לאחר נורמליזציה, אנוטציה של גששים ותיקון אפקט-אצווה באמצעות ComBat. לצורך זיהוי גני מאפיין מרכזיים, נעשה שימוש בניתוח ביטוי דיפרנציאלי, ניתוח רשתות ביטוי גנים משותף משוקלל (WGCNA), ניתוח העשרה פונקציונלית, ניתוח רשתות אינטראקציית חלבון-חלבון ושלושה אלגוריתמים של למידת מכונה. הביצועים האבחנאיים הוערכו באמצעות עקומות ROC (Receiver Operating Characteristic). התיקוף החיצוני כלל קוהורט עצמאי של רקמת ריאה (GSE117261), מאגר נתונים של ריצוף RNA של תא בודד (single-cell RNA-sequencing) מעורק ריאתי (GSE210248), ותיקוף באמצעות qRT-PCR בדגימות עצמאיות של רקמת ריאה. לצורך סריקת תרכובות מועמדות, נעשה שימוש במיפוי תרופות מבוסס Connectivity Map ובעגינה מולקולרית (molecular docking). זוהו שבעים ושמונה גנים עם ביטוי דיפרנציאלי, והגנים CXCL10, JUN, IFIH1, MX1 ו-TLR7 נבחרו כגני מאפיין מרכזיים. בקוהורט העצמאי של רקמת ריאה GSE117261, הגן JUN הראה את התמיכה החיצונית החזקה ביותר, בעוד שהשחזור של שאר הגנים היה משתנה. בדיקת qRT-PCR ב-20 דגימות של יתר לחץ דם עורקי ריאתי בלתי תלויות ביולוגית וב-20 דגימות ביקורת איששה את העלייה בביטוי של כל חמשת הגנים. מודל ה-qRT-PCR של חמשת הגנים וניתוחי תיקוף צולב מחומש עם 100 חזרות מרובד הניבו שניהם שטח תחת העקומה (AUC) של 1.000, אם כי גודל הקוהורט הקטן מחייב פרשנות זהירה ותיקוף פרוספקטיבי עצמאי. ניתוח תאים בודדים של GSE210248 תמך בתקשורת משובשת בין תאי מערכת החיסון לתאים מבניים ובשינוי פנוטיפי של תאי שריר חלק. התרכובת BRD-K91900765/VX-745 דורגה במקום הגבוה ביותר בסריקת ה-Connectivity Map. החלבון MAPK14/p38α, שהווה את המטרה הפרמקולוגית המוכרת שלו, נכלל כחלבון עגינה לצורכי ייחוס חיובי, בעוד שהעגינה מול חמשת החלבונים הקשורים לביומרקרים נחשבה כשלב גשש. ממצאים אלו תומכים בחמישה הגנים כביומרקרים מועמדים ל-PH וב-VX-745 כהיפותזה של מיקום תרופתי מחדש מבוסס חישוב, הדורשת תיקוף ניסויי.
מבוא
יתר לחץ דם ריאתי (PH) הוא תסמונת קרדיופולמונרית פרוגרסיבית המאופיינת בלחץ עורקי ריאתי גבוה באופן מתמיד, עלייה בהתנגדות הווסקולרית הריאתית, ובסופו של דבר כשל של החדר הימני. הקריטריונים ההמודינמיים הנוכחיים מגדירים PH כלחץ עורקי ריאתי ממוצע במנוחה של >20 mmHg, כפי שנמדד באמצעות קטטריזציה של הלב הימני1. בין תתי-הסוגים הקליניים השונים, יתר לחץ דם עורקי ריאתי (PAH) הוא אחת הצורות החמורות ביותר והוא מאופיין במידול (remodeling) וסקולרי ריאתי פרוגרסיבי. המאפיינים הפתולוגיים שלו כוללים דיספונקציה אנדותליאלית, התרבות ונדידה חריגה של תאי שריר חלק בעורקים הריאתיים, הפעלת פיברובלסטים באדוונטיציה, השקעת מטריקס חוץ-תאי, חדירה של תאי דלקת, והיצרות או חסימה של העורקים הריאתיים הדיסטליים2. שינויים אלו מעידים כי PH/PAH אינו רק הפרעה של כיווץ כלי דם (vasoconstriction), אלא מחלה מורכבת של מידול וסקולרי המונעת על ידי מנגנונים מולקולריים, תאיים ואימונו-דלקתיים מתואמים.
הטיפולים הנוכחיים ב-PAH מתמקדים בעיקר במסלולי הפרוסטציקלין, האנדותלין, תחמוצת החנקן–סולובל גואנילט ציקלאז, והפוספודיאסטראז מסוג 53˒4. למרות שטיפולים אלו משפרים את התסמינים, את יכולת הפעילות הגופנית ואת הפרמטרים ההמודינמיים, השפעותיהם נשארות במידה רבה וזודילטוריות (מרחיבות כלי דם) והמודינמיות. יכולתם להפוך רמודלינג וסקולרי ריאתי קיים היא מוגבלת, ומטופלים רבים ממשיכים לחוות התקדמות של המחלה למרות טיפול משולב. לפיכך, זיהוי ביומרקרים מולקולריים חדשים ומועמדים טיפוליים המשקפים את תהליך הרמודלינג מהווה צורך ממשי שטרם נענה. בפרט, אקטיבציה אימונו-דלקתית, סיגנלינג הקשור לאינטרפרון, מסלולי קולטני Toll-like, גיוס חיסוני המתווך על ידי כימוקינים, ומעבר פנוטיפי של תאי שריר חלק עלו כגורמים פוטנציאליים להתקדמות PH/PAH5˒6.
מאגרי נתונים טרנסקריפטומיים בעתקת תפוקה גבוהה מספקים משאבים בעלי ערך לזיהוי חתימות מולקולריות הקשורות למחלות ב-PH/PAH. עם זאת, מחקרים המבוססים על מאגר נתונים בודד מוגבלים לעיתים קרובות על ידי גודלי מדגם קטנים, אפקטים של סדרות (batch effects), הטרוגניות של פלטפורמות ואי-ספיקות של תיקוף. ניתוח ביטוי דיפרנציאלי יכול לזהות גנים עם ביטוי משתנה, אך עשוי שלא ללכוד באופן מלא מודולים של ביטוי משותף הקשורים למחלה או אינטראקציות ברמת הרשת. ניתוח רשת ביטוי משותף משוקלל של גנים (WGCNA) יכול לזהות מודולים של גנים הקשורים למאפייני המחלה, בעוד שניתוח רשת אינטראקציות חלבון-חלבון (PPI) יכול לחשוף גנים בעלי קישוריות גבוהה בתוך רשתות ביולוגיות. שיטות למידה חישובית יכולות גם לתעדף גנים בעלי ערך אבחנתי או סיווגי. עם זאת, הסתמכות על אלגוריתם בודד עלולה להכניס הטיות ספציפיות למודל. לפיכך, שילוב של ניתוח ביטוי דיפרנציאלי, WGCNA, ניתוח רשת PPI ומספר אלגוריתמים של למידה חישובית עשוי לשפר את החוסן של גילוי סממנים ביולוגיים.
אתגר מרכזי נוסף במחקרי סמנים ביולוגיים טרנסקריפטומיים הוא הפרשנות הביולוגית. אותות מרקמה כוללת (Bulk-tissue) עשויים לשקף שינויים בביטוי גנים בתוך תאי כלי דם תושבים, חדירה של תאי מערכת החיסון, או שינויים בפרופורציות של אוכלוסיות תאים מרובות. ריצוף RNA של תא בודד (Single-cell RNA sequencing) מספק הזדמנות להציב גנים מועמדים שזוהו בריצוף כולל בתוך הקשר תאי. ב-PH/PAH, עיצוב מחדש של כלי הדם הריאתיים מערב תאי אנדותל, תאי שריר חלק, פיברובלסטים, מונוציטים/מקרופגים, לימפוציטים ותאים חיסוניים או מבניים אחרים. התקדמות המחלה קשורה גם לשינוי בתקשורת בין תאים ולמעבר פנוטיפי של תאי שריר חלק. לכן, שילוב של סריקה טרנסקריפטומית כוללת יחד עם תיקוף של תא בודד עשוי לסייע בקביעה האם הסמנים הביולוגיים המועמדים קשורים להפעלה חיסונית, לעיצוב מבני של כלי הדם, או לחוסר איזון בתקשורת רב-תאית.
בנוסף לגילוי סמנים ביולוגיים, ניתן להשתמש בחתימות טרנסקריפטומיות למיקום מחדש של תרופות בשיטות חישוביות. ה-Connectivity Map (CMap) מקשר בין פרופילים של ביטוי גנים הקשורים למחלות לבין מולקולות קטנות שעשויות להפוך או לווסת חתימות אלו7. כאשר אסטרטגיה זו משולבת עם אוצרות של תרכובות ועגינה מולקולרית (molecular docking), היא יכולה להניב היפותזות טיפוליות הניתנות לבדיקה ניסיונית. למרות שחיזוי באמצעות CMap ועגינה מולקולרית אינם יכולים לקבוע את יעילות התרופה, הם יכולים לתעדף תרכובות מועמדות עבור בדיקות קישור למטרה, ניסויים מבוססי תאים ותיקוף במודלים של בעלי חיים בעתיד.
פותח תהליך עבודה (workflow) משולב וניתן לשחזור לזיהוי ביומרקרים של PH/PAH ותרכובות טיפוליות פוטנציאליות. שלושה מאגרי נתונים טרנסקריפטומיים ציבוריים מ-Gene Expression Omnibus שולבו לאחר נורמליזציה ותיקון אפקט-סדרה (batch-effect correction). לצורך סינון גנים בעלי מאפיינים חסונים, נעשה שימוש בניתוח ביטוי דיפרנציאלי, WGCNA, ניתוח העשרה תפקודי, ניתוח רשת PPI ושלושה אלגוריתמים של למידת מכונה. לצורך הערכה נוספת של הגנים שנבחרו, נעשה שימוש בניתוח עקומת ROC, קוהורט תיקוף עצמאי של רקמת ריאה, ראיות מריצוף RNA של תאים בודדים (single-cell RNA-sequencing) בעורקי הריאה, ותיקוף באמצעות quantitative reverse transcription PCR במדגמים עצמאיים. לבסוף, יושמו תהליכי מיקום מחדש של תרופות (drug repositioning) מבוססי CMap וסימולציית עגינה מולקולרית (molecular docking) כדי לזהות תרכובות מועמדות. החדשנות של המחקר טמונה במסגרת התיקוף רב-שכבתית שלו, המקשרת בין גילוי טרנסקריפטומי ב-bulk, תעדוף באמצעות למידת מכונה, תיקוף עצמאי, אישור ניסיוני באמצעות quantitative reverse transcription PCR, פרשנות מכניסטית ברמת התא הבודד וסינון חישובי של תרכובות. השערת המחקר הייתה כי PH/PAH מונעים על ידי תוכנית מתואמת של דלקת-חיסונית ועיצוב מחדש של כלי הדם (vascular remodeling), וכי גנים חסונים בתוך תוכנית זו עשויים לשמש כביומרקרים מועמדים ולספק הזדמנויות למיקום מחדש של תרופות.
פרוטוקול
מאגרי הנתונים הציבוריים של Gene Expression Omnibus (GEO) שנותחו במחקר זה הכילו נתונים טרנסקריפטומיים שעברו דה-אידנטיפיקציה ממחקרים שפורסמו בעבר, ולא דרשו אישור אתי נוסף. ועדת האתיקה של אוניברסיטת Huaihua אישרה את מחקר התיקוף העצמאי של רקמות ריאה אנושיות באמצעות PCR עם שעתוק הפוך כמותי (qRT-PCR) (מספר אישור 2024(A05112)). הסכמה מדעת בכתב התקבלה מכל המשתתפים או מנציגיהם המורשים על פי חוק לפני איסוף הדגימות. הליכי האישור וההסכמה חלו על כל 20 דגימות רקמת הריאה של חולי יתר לחץ דם رئתי (PAH) ו-20 דגימות הביקורת שנכללו בתיקוף ה-qRT-PCR. כלי המחקר ששימשו לפרוטוקול זה מפורטים ב- טבלת חומרים.
1. איסוף ועיבוד מקדים של מאגרי נתונים טרנסקריפטומיים ציבוריים
מאגרי נתוני מיקרו-מערך (microarray) GSE22356, GSE33463 ו-GSE48149 הקשורים ליתר לחץ דם ריאתי (PH) הופקו ממאגר הנתונים GEO. דגימות של PH/יתר לחץ דם עורקי ריאתי (PAH) ודגימות ביקורת חולצו בהתאם להערות הפנוטיפ המקוריות. מטריצות ביטוי וקבצי הערות פלטפורמה הורדו באמצעות סקריפטים של R הניתנים לשחזור ובאמצעות חבילת GEOquery.
ביצוע השרויות הפרובים (Probe annotation) ומיפוי סמלי הגנים בוצעו באופן עקבי בכל מערכי הנתונים. כאשר מספר פרובים מופו לאותו גן, חושב ערך הביטוי הממוצע. הוחל נורמליזציית קוונטילים (Quantile normalization), וגנים עם ביטוי נמוך או שונות נמוכה הוסרו. מערכי הנתונים מוזגו, והשפעות אלומה (batch effects) תוקנו באמצעות אלגוריתם ה-ComBat בחבילת ה-sva8. התיקון הוערך באמצעות תרשימי קופסה (boxplots) וניתוח רכיבים ראשיים (principal component analysis).
2. זיהוי גנים המבטאים ביטוי דיפרנציאלי
חבילת limma שימשה להשוואת רמות הביטוי בין דגימות PH לדגימות ביקורת במטריצת הביטוי המתוקנת עבור אפקטי batch9. הותאמה מודל ליניארי, ויושמו סטטיסטיקות Bayes אמפיריות. גנים בעלי ביטוי דיפרנציאלי הוגדרו באמצעות ערך P מתוקנן <0.05 ושינוי קיפול (fold change) מוחלט של log2 > 0.585. התוצאות הוצגו באופן ויזואלי באמצעות volcano plots ומפות חום (heatmaps).
3. בניית רשת ביטוי גנים משותף משוקללת
רשת ביטוי גנים משותף משוקללת נבנתה באמצעות חבילת WGCNA10. ביצוע אשכולות לדגימות (Sample clustering) בוצע כדי לזהות ערכים חריגים. עוצמת הסף הרך (soft-thresholding power) נבחרה על בסיס מדד התאמה לטופולוגיה חסרת קנה מידה (scale-free topology fit index). מודולי גנים זוהו באמצעות אלגוריתם חיתוך עץ דינמי. ביצעו מתאם בין ה-eigengenes של המודולים לבין הפנוטיפ של PH, והמודול הקשור למחלה בעל המתאם החזק ביותר נבחר. הגנים במודול המרכזי הושוו לגנים בעלי ביטוי Differentially Expressed כדי להגיע לגנים בהסכמה (consensus genes).
4. ניתוח העשרה פונקציונלית
קטגוריות של תהליכים ביולוגיים, רכיבים תאיים ותפקודים מולקולריים מ-Gene Ontology נותחו באמצעות clusterProfiler11. ניתוח העשרה של מסלולים מ-Kyoto Encyclopedia of Genes and Genomes בוצע כדי לזהות מסלולי איתות12. ערך P < 0.05 וערך q < 0.2 שימשו כספי העשרה, ומונחים מועשרים הוצגו חזותית באמצעות תרשימי בועות (bubble plots)11.
5. בניית רשת אינטראקציות בין חלבונים וזיהוי גנים מרכזיים (hub-genes)
רשימת הגנים המוסכמת הוגשה למסד הנתונים STRING, כאשר Homo sapiens נבחר כמין וסף ביטחון לאינטראקציה היה > 0.413. קובץ האינטראקציות יובא ל-Cytoscape, והתוסף CytoHubba שימש לדירוג הגנים לפי דרגת הצומת (node degree). גנים בעלי קישוריות גבוהה הוגדרו כגני מפתח (hub genes).
6. בחירת גנים בעלי מאפיינים אבחנתיים באמצעות למידה חישובית
יושמנו שלושה אלגוריתמים עצמאיים לבחירת מאפיינים. ראשית, בוצע רגרסיה לוגיסטית בשיטת LASSO (least absolute shrinkage and selection operator) באמצעות חבילת glmnet ואימות צולב של 10 קיפולים (10-fold cross-validation) כדי לזהות גנים עם מקדמים שאינם אפס14. שנית, יושמה שיטת סילוק מאפיינים רקורסיבי (RFE) עם מכונות וקטור תמיכה (SVM) כדי להסיר מאפיינים עודפים ולבחור את תת-קבוצת המאפיינים שהשיגה את הדיוק הגבוה ביותר באימות הצולב15. שלישית, נבנה מודל יער אקראי (random forest), והמאפיינים דורגו לפי הירידה הממוצעת בטומאת גיני (Gini impurity)16. חיתוך קבוצות הגנים שהתקבלו משלושת האלגוריתמים שימש להגדרת קבוצתו הסופית של גני המאפייני-ליבה. חבילת pROC שימשה ליצירת עקומות מאפייני תפעול של מקלט (ROC) ולחישוב ערכי השטח תחת העקומה (AUC)17.
7. תיקוף של גנים מרכזיים באמצעות מאגרי נתונים בלתי תלויים של bulk ושל תא בודד (single-cell)
GSE117261 שימש כעקבה חיצונית בלתי תלויה לתיקוף של רקמות ריאה, הכוללת 58 דגימות PAH ו-25 דגימות ביקורת של תורמים שנפסלו18. מערך נתונים זה לא שימש בניתוח הביטוי הדיפרנציאלי של שלב הגילוי, בבניית רשת ביטוי גנים משותף משוקללת (weighted gene co-expression network), או בבחירת מאפיינים באמצעות למידת מכונה. מטריצת הביטוי עברה נורמליזציה ואנוטציה, והביטוי הדיפרנציאלי נותח באמצעות limma v3.68.0. תיקון שיעור גילויים שגויים (FDR) לפי Benjamini-Hochberg הוחל על כל התסריפטום שעבר אנוטציה. עקומות מאפיינים של תפעול מקבל (ROC) עבור גנים בודדים חושבו באמצעות pROC v1.19.0.1, רווחי סמך של 95% לפי DeLong, ונקודות חיתוך לפי מדד Youden. מודל רגרסיה לוגיסטית גשש של חמישה גנים הותאם בתוך GSE117261, וביצועיו הפנימיים הוערכו בנוסף באמצעות תיקוף צולב מקונן חוזר (repeated nested cross-validation).
GSE210248 (טבלה 1) שימשה כסט נתונים לאימות של עורק ריאתי ברמת התא הבודד, הכולל דגימות משלושה מטופלים עם PAH ושלושה תורמים בריאים19הנתונים עובדו באמצעות Seurat v5.5.1 לצורך בקרת איכות, נורמליזציה, הפחתת ממדים, מקבץ (clustering) ואנוטציה של תאים.20זוהו אוכלוסיות תאים עיקריות, כולל תאי אנדותל, תאי שריר חלק, פיברובלאסטים, מונוציטים/מקרופאגים ותאי T/NK. תקשורת בין-תאית נותחה באמצעות CellChat v2.1.2 ומסד הנתונים של ליגנד-רספטור CellChatDB.human.21אובייקט CellChat נוצר ממטריצת הביטוי המנורמלת של Seurat וממטא-נתונים של סוגי התאים. זוהו גנים בעלי ביטוי יתר ואינטראקציות ליגנד-רצפטור; חושבו הסתברויות תקשורת; אינטראקציות המערבות קבוצות תאים עם פחות מ-10 תאים הוסרו; ורשתות תקשורת ברמת מסלול הוסקו וסוכמו. מערך נתונים זה שימש אך ורק לצורך תיקוף מכניסטי חיצוני ולא לאימון המודל.
| פריט | תיאור |
| ערכת נתונים | GSE210248 |
| סוג נתונים | ריצוף RNA של תא בודד מבוסס טיפות של 10x Genomics; פרופיל טרנסקריפטומי בעלת תפוקה גבוהה |
| דגימות אנושיות | שלוש דגימות של עורק ריאתי מחולי PAH ושלוש דגימות של עורק ריאתי מתורמים בריאים |
| מקור הרקמה | רקמת עורק ריאתי ex vivo, המשקפת בעיקרה את האקולוגיה התאית של דופן כלי הדם הריאתיים ואת תהליך עיצוב התבניות הווסקולרי (vascular remodeling) |
| מטרה אנליטית עיקרית | לוקליזציה של סוגי תאים, מעבר פנוטיפי של תאי שריר חלק, תקשורת בין תאים חיסוניים למבניים תאיים, ותיקוף של עקביות מכניסטית של גנים מועמדים |
טבלה 1: מידע בסיסי עבור מערך נתוני התיקוף של תאי בודדים GSE210248. הטבלה מסכמת את מספר הגישה למערך הנתונים, פלטפורמת הריצוף, מקור הרקמה, הרכב הדגימות והמטרה האנליטית של ניתוח התיקוף של עורקי הריאה ברמה של תאים בודדים.
8. תיקוף של ביטוי גנים באמצעות qRT-PCR
תיקוף ה-qRT-PCR כלל 20 דגימות רקמת ריאה PAH בלתי תלויות ביולוגית מחולים עם PH/PAH ו-20 דגימות רקמת ריאה של ביקורת בלתי תלויות ביולוגית. RNA כולל הופק באמצעות Total RNA Extraction Kit. ריכוז ה-RNA ודרגת הניקיון שלו נבחנו באמצעות ספקטרופוטומטר, ושלמות ה-RNA הוערכה באמצעות אלקטרופורזה של ג'ל אגרוזה. רק דגימות RNA עם ערכי A260/280 שבין 1.8 ל-2.1 וללא פירוק נראה לעין נכללו בניסוי.
כמויות שוות של RNA עברו תעתוק הפוך ל-DNA משלים באמצעות Solarbio Universal RT-PCR Kit (AMV; מספר קטלוג RP1200). PCR כמותי עבור CXCL10, JUN, IFIH1, MX1 ו-TLR7 בוצע באמצעות SYBR Green PCR Master Mix במערכת Real-Time PCR. כל דגימה ביולוגית נותחה בשלוש חזרות טכניות, יחד עם בקרות ללא תבנית (no-template) וללא תעתוק הפוך (no-reverse-transcription). ערך ה-Ct הממוצע של שלוש החזרות הטכניות שימש לניתוחים הבאים; חזרות טכניות לא נחשבו כתצפיות בלתי תלויות. נעשה שימוש בפריימרים המגשרים על חיבורי אקסון-אקסון ומפיקים אמפליקונים של 80–200 bp (טבלה 2). ספציפיות הפריימרים אומתה באמצעות NCBI Primer-BLAST וניתוח עקומת התכה22.
β-actin (ACTB) שימש כגן הייחוס הפנימי לנרמול רמות הביטוי של גני המטרה. הביטוי היחסי חושב באמצעות שיטת 2-ΔΔCt23. מבחני Mann-Whitney U דו-זנביים שימשו להשוואות בין קבוצות בהתבסס על התפלגות הנתונים, ותיקון Benjamini-Hochberg לקצב התגליות השגויות (FDR) הוחל על חמשת הגנים. עקומות ROC לגן בודד הופקו עם רווחי סמך של 95% לפי DeLong, ונקודות חיתוך אופטימליות נבחרו באמצעות מדד Youden. מודל רגרסיה לוגיסטית של חמישה גנים הותאם והוערך תחילה על אותן 40 דגימות ביולוגיות; לכן, הערכה זו הוגדרה כביצועי הדגימה הגלויים (apparent in-sample performance). כדי להעריך התאמת-יתר (overfitting) פוטנציאלית, בוצעו 100 חזרות של ולידציה צולבת מחומש (five-fold cross-validation) בשכבות באמצעות מודל רגרסיה לוגיסטית עם רגולריזציית L2, וחושב ביצוע ROC המאוחד של הדגימות שאינן חלק מאימון המודל (out-of-fold).
| Gene | RefSeq accession | Forward primer (5′–3′) | Reverse primer (5′–3′) | Product size (bp) | Tm (°C) | Exon-spanning |
| CXCL10 | NM_001565.4 | GTCAAGCCAT AATTGTTC | ATAGTGCCAG GGTAGAGT | 141 | 46.1 | Yes |
| JUN | NM_002228.4 | ACAAGTGGCA GAGTCCCG | CGCCCAAGTT CAACAACC | 152 | 54.5 | Yes |
| IFIH1 | NM_022168 | GCACAGAGCG GTAGACCCT | GCCCTGAAGC ACGAGATG | 182 | 54.7 | Yes |
| MX1 | NM_002462.5 | TTAGCCGTGG TGATTTAGC | CAAGGTGGAG CGATTCTG | 156 | 52.3 | Yes |
| TLR7 | NM_016562.4 | ATTGCCCTCGT TGTTATA | TTCCTGGAGTT TGTTGAT | 179 | 48.1 | Yes |
| ACTB | NM_001101.3 | CTCACCATGGAT GATGATATCGC | AGGAATCCTTCT GACCCATGC | 194 | 56.2 | Yes |
טבלה 2: רצפי פריימרים ששימשו ל-quantitative reverse transcription PCR. הטבלה מפרטת את הגנים המטרים, מספרי הגישה של RefSeq, רצפי הפריימרים הקדמיים וההפוכים, גדלי המוצרים, טמפרטורות ההמסה, והמעמד של הפריימרים כחוצים אקסונים (exon-spanning) ששימשו ל-qRT-PCR.
9. סריקת תרכובות מועמדות ועגינה מולקולרית
חתימות הגנים המרכזיים שהראו ביטוי מוגבר (upregulated) או מופחת (downregulated) הוגשו למסד הנתונים Connectivity Map כדי לזהות מולקולות קטנות שנחזו כי הן מסוגלות להפוך את פרופיל הביטוי הקשור ל-PH7. המועמדים דורגו לפי מדד Logit והסתברות לחיזוי.
המבנה התלת-ממדי של BRD-K91900765/VX-745 התקבל מ-PubChem תחת CID 303852524. מידע פרמקולוגי הקשור לתרכובת נאסף ממאגרי מידע ציבוריים של תרופות, ודסקריפטורים מבניים חושבו באמצעות DrugBank ו-SwissADME25,26. מבני חלבונים התקבלו מ-RCSB Protein Data Bank באמצעות מזהי ה-PDB הבאים: CXCL10, 1LV9; JUN, 1JUN; IFIH1, 3B6E; MX1, 5GTM; TLR7, 7CYN; ו-MAPK14/p38α, 1OUK27. זיהוי חללי קישור (blind cavity detection) ועגינה מולקולרית (molecular docking) בוצעו באמצעות CB-Dock2 v2.0 עם מנוע הניקוד AutoDock Vina v1.2.028,29. קבצי החלבון והליגנד הועלו ל-CB-Dock2, חללים פוטנציאליים זוהו באופן אוטומטי, והעגינה בוצעה בתוך תיבות ספציפיות לחללים שהופקו על ידי השרת. עבור כל חלבון, נרשמו מזהה החלל, ציון ה-Vina, נפח החלל, מרכז תיבת העגינה, ממדי תיבת העגינה וקובץ קומפלקס החלבון-ליגנד. הפוזה בעלת ציון ה-Vina השלילי ביותר נבחרה כקונפורמציה החזויה בעלת הדירוג הגבוה ביותר. MAPK14/p38α נכלל כמטרה הפרמקולוגית המוכרת וכחלבון עגינה המשמש כביקורת חיובית עבור VX-745. עגינה מול CXCL10, JUN, IFIH1, MX1 ו-TLR7 הייתה לצורכי מחקר ראשוני ולא פורשה כראיה למיקוד פרמקולוגי ישיר, קישור, עיכוב או יעילות.
10. ניתוח סטטיסטי ובקרת הדירות
כל הניתוחים הסטטיסטיים בוצעו ב-R אלא אם צוין אחרת. ערכי P דו-זנביים < 0.05 נחשבו למשמעותיים סטטיסטית. תיקון לבדיקות מרובות הוחל על ניתוחי הביטוי הדיפרנציאלי, ההעשרה, התיקוף החיצוני ו-qRT-PCR כפי שפורט לעיל. תיקוף צולב (Cross-validation) שימש להערכת היציבות של מודלי הלמידה השמישית ומודלי ה-qRT-PCR המשולבים.
תוצאות
עיבוד מקדים של נתונים טרנסקריפטומיים ציבוריים וזיהוי גנים בעלי ביטוי דיפרנציאלי
אינטגרציה ותיקון ComBat של GSE2356, GSE33463 ו-GSE48149 הפחיתו הבדלים סיסטמטיים בין מערכי הנתונים. תרשימי קופסה הראו כי התפלגויות הביטוי של הדגימות הפכו לעקביות יותר לאחר התיקון. ניתוח רכיבים ראשיים העיד כי הדגימות התקבצו בעיקר לפי מקור מערך הנתונים לפני התיקון, אך הפכו למעורבבות יותר לאחר התיקון, מה שמעיד על הפחתה יעילה של אפקט הסדרה (איור 1).
תוך שימוש בסף של שינוי מקפל (fold change) מוחלט ב-log2 >0.585 וערך P מתוקנן < 0.05, זוהו 78 גנים עם ביטוי דיפרנציאלי, כולל 4 גנים עם ביטוי מוגבר (upregulated) ו-34 גנים עם ביטוי מופחת (downregulated) (איור 2A). מפת החום (heatmap) הראתה כי גנים הקשורים לאינטרפרון, כולל XAF1, MX1, IFI4L, EPSTI1, PARP9, IFIH1, CXCL10, GBP1, STAT1, SAMHD1, TNFSF10 ו-TLR7, הראו בדרך כלל ביטוי מוגבר בדגימות הקשורות ל-PH. לעומת זאת, גנים הקשורים לאריתרוציתים, כולל HBG1, HBD, ALAS2, CA1 ו-SLC4A1, נטו להראות ביטוי מופחת (איור 2B).
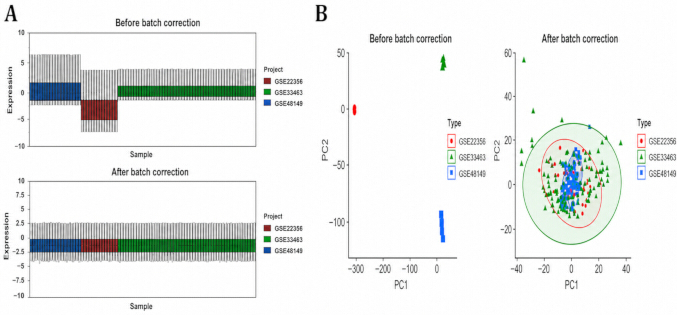
איור 1תיקון אפקט-סדרה (Batch-effect correction). (A) תרשימי קופסה של מטריצת הביטוי הממוזגת לפני ואחרי תיקון ComBat. (B) תרשימי ניתוח רכיבים ראשיים (PCA) המראים את התפלגויות הדגימות לפני ואחרי תיקון אפקט-סב (batch-effect correction). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
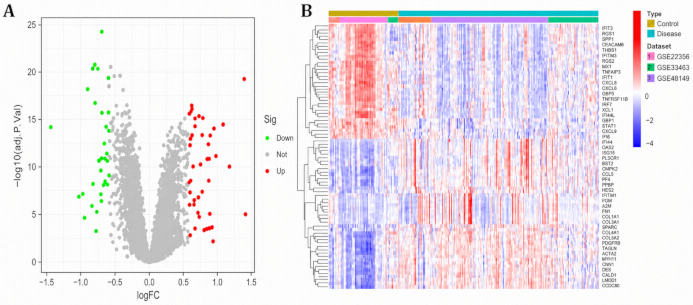
איור 2גנים המבטאים ביטוי דיפרנציאלי. (A(תרשים געש (Volcano plot) המראה גנים בעלי ביטוי מוגבר (upregulated) וביטוי מופחת (downregulated) בדגימות הקשורות ל-PH. (B) מפת חום (Heatmap) המציגה גנים בעלי ביטוי דיפרנציאלי בין קבוצת הביקורת לקבוצת המחלה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
בניית רשת ביטוי גנים משותף משוקללת והעשרה פונקציונלית
הצמצום (clustering) של הדגימות הראה מקבצים כלליים יציבים ללא חריגים בולטים (איור 3A). מדד התאמה של טופולוגיה חסרת קנה מידה (scale-free topology fit index) התקרב ל-0.8 בחזקה של 9, ו-β = 9 נבחר לבניית הרשת (איור 3B). צמצום גנים וזיהוי מודולים דינמיים הניבו מספר מודולי ביטוי משותף (איור 3C). המודול הכחול הראה את הקשר החזק ביותר למצב PH (r = 0.5, P = 1 × 10⁻¹⁹), בעוד שהמודולים הטורקיז והאפור הראו אף הם קורלציות עם PH (איור 3D).
גנים של קונסנזוס, שהתקבלו על ידי חיתוך הגנים של מודול ניתוח רשתות ביטוי משותף שקולות של גנים (WGCNA) עם הגנים בעלי ביטוי Differentially Expressed, היו מועשרים בתחומי הגנה חיסונית אנטי-ויראלית, ויסות NF-κB ו-JAK-STAT, תגובות לגורמי דלקת, קישור לקולטני ציטוקינים וכימוקינים, וויסות שעתוקי (איור 4A). ניתוח העשרה באמצעות Kyoto Encyclopedia of Genes and Genomes זיהה אינטראקציה בין ציטוקינים לקולטני ציטוקינים, סיגנלינג של כימוקינים, סיגנלינג של קולטנים דמויי NOD, סיגנלינג של קולטנים דמויי Toll, סיגנלינג של גורם נמק גידולי (TNF), וסיגנלינג של אינטרלוקין-17 (איור 4B), מה שתומך בשיבוש ויסות חיסוני-דלקתי כבסיס מולקולרי לשחזור כלי דם ריאתיים.
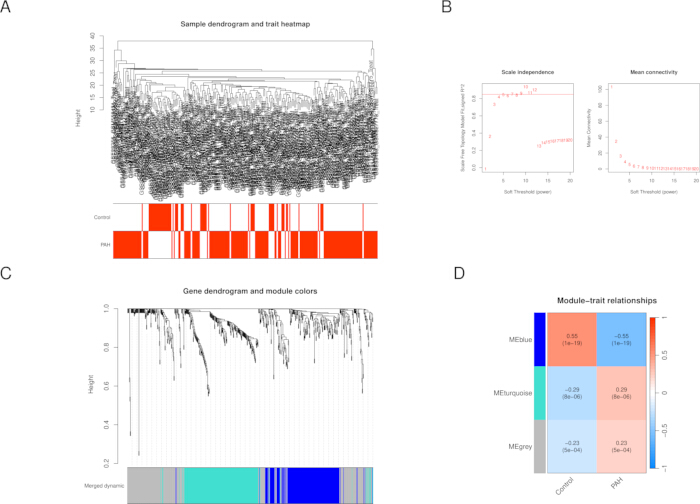
איור 3ניתוח רשת ביטוי גנים משותף משוקל. (A) עץ מקבצי דגימות ומפת חום של תכונות. (B) תרשים בחירת סף רך. (C) דנדרוגרמה של גנים וצבעי מודולים. (דמפת חום של קשרי מודול-תכונה. אנא לחצו כאן כדי להציג גרסה מורחבת של איור זה.
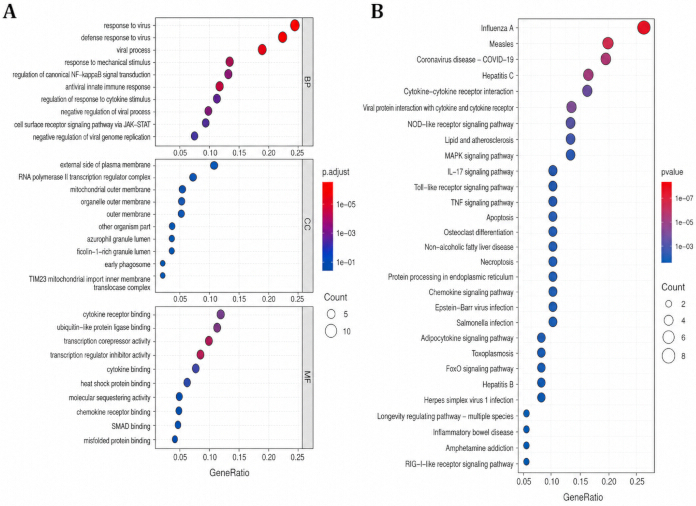
איור 4ניתוח העשרה פונקציונלית. (A(תוצאות העשרה של Gene Ontology עבור הגנים המוסכמים.)Bתוצאות העשרה של נתיבים ממאגר ה-Kyoto Encyclopedia of Genes and Genomes עבור הגנים המוסכמים. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
רשת אינטראקציות חלבון-חלבון וסריקת גנים מרכזיים (hub-genes)
רשת האינטראקציות בין חלבונים של STRING, שנבנתה מהגנים המוסכמים, חשפה רשת אימונו-דלקתית מקושרת (איור 5A). דירוג CytoHubba מבוס-דרגה הראה כי ל-FN1, CD4, JUN, TGFB1, CXCL8 ו-BCL2 הייתה קישוריות גבוהה (איור 5B). גני מפתח (hub genes) אלו עשויים להשתתף באיתות דלקתי, בהיצמדות תאים, בעיצוב מחדש של המטריקס החוץ-תאי ובעיצוב מחדש של המבנה הווסקולרי הריאתי.
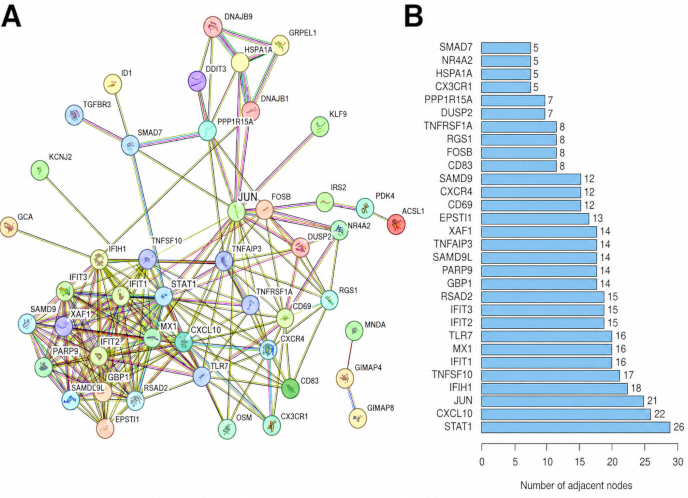
איור 5רשת אינטראקציה בין חלבונים וגנים מרכזיים (hub genes). (A) רשת אינטראקציות בין חלבונים של STRING עבור הגנים המוסכמים. (B) גנים מרכזיים (hub genes) המדורגים לפי דרגה (degree), אשר זוהו באמצעות CytoHubba. אנא לחצו כאן כדי להציג גרסה מוגדלת של איור זה.
בחירת מאפיינים באמצעות למידת מכונה וביצועים דיאגנוסטיים
רגרסיית LASSO (Least absolute shrinkage and selection operator) זיהתה שישה גנים מועמדים עם מקדמים שאינם אפס לאחר תיקוף צולב (איור 6A, B). שיטת SVM-RFE (Support vector machine-recursive feature elimination) השאירה שמונה גנים והניבה דיוק של 0.883 ותשואה של 0.17 בתיקוף צולב (איור 7A). שגיאת ה-out-of-bag של יער מקרי (random forest) התייצבה כאשר מספר העצים היה ≥10, והגנים IFIH1, JUN ו-TLR7 דורגו בין הגנים המובילים על פי מדד החשיבות (איור 7B).
חיתוך התוצאות של LASSO (least absolute shrinkage and selection operator), SVM-RFE (support vector machine-recursive feature elimination) ויער אקראי (random forest) זיהה חמישה גנים מרכזיים: CXCL10, JUN, IFIH1, MX1 ו-TLR7 (איור 8A). ניתוח ROC (receiver operating characteristic) של גן בודד הראה הבחנה אבחנתית בינונית עד טובה, עם ערכי AUC (area under the curve) של 0.842 עבור IFIH1, 0.83 עבור JUN, 0.827 עבור TLR7, 0.814 עבור CXCL10 ו-0.759 עבור MX1 (איור 8B).
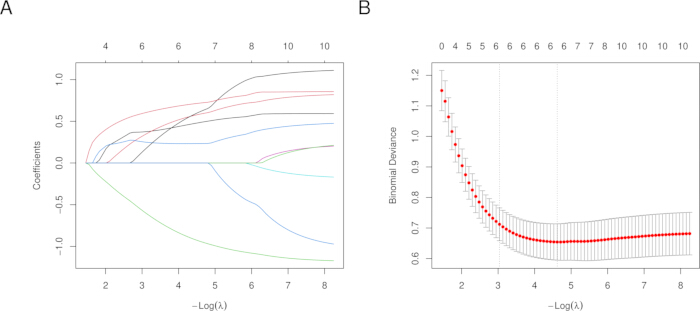
איור 6ניתוח רגרסיה באמצעות LASSO (Least Absolute Shrinkage and Selection Operator). (Aמסלול מקדמים שהופק באמצעות רגרסיית LASSO (least absolute shrinkage and selection operator).B) תרשים שגיאת תיקוף צולב. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
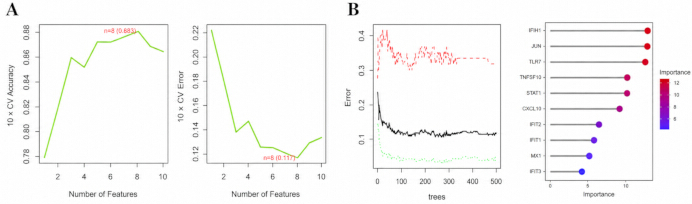
איור 7ניתוחי מכונת וקטורים תומכים עם סילוק תכונות רקורסיבי ויערים אקראיים. (A) תרשים בחירת תכונות באמצעות השמטת תכונות רקורסיבית במכונת וקטורים תומכים. (B) מודל Random forest ודירוג חשיבות גנים. אנא לחץ כאן כדי להציג גרסה מוגדלת של איור זה.
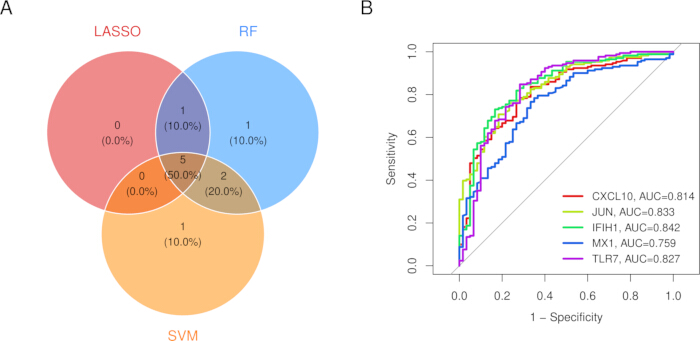
איור 8סיכום למידת מכונה. (A(דיאגרמת ון המראה את החפיפה בין שלושת האלגוריתמים לבחירת מאפיינים. (B(עקומות מאפייני תגובה של המקלט (ROC) עבור חמשת הגנים המרכזיים. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
תיקוף חיצוני ב-GSE17261
GSE117261 שימש כעקובא ולידציה עצמאית של רקמת ריאה ולא נכלל בסריקת ביטוי דיפרנציאלי, בבניית רשת גנים שיתופית משוקללת (weighted gene co-expression network) או בבחירת מאפיינים באמצעות למידת מכונה (Table 3). תוצאות הוולידציה המלאות הראו שחזור הטרוגני בקרב חמשת הגנים (Table 4). CXCL10 היה מוגבר (log₂ fold change = 0.67; P = 0.0410; FDR = 0.14) והניב AUC של 0.639 (95% CI, 0.491–0.786), עם ערך סף (cutoff) של 6.245, רגישות של 0.724 וסגוליות של 0.600. JUN היה מוגבר (log₂ fold change = 0.463; P = 0.00248; FDR = 0.0194) והניב AUC של 0.714 (95% CI, 0.593–0.835), עם ערך סף של 8.708, רגישות של 0.707 וסגוליות של 0.720.
הגנים IFIH1 (log2 fold change = 0.107; P = 0.371; FDR = 0.591; AUC = 0.543, 95% CI, 0.398–0.687), MX1 (log2 fold change = 0.109; P = 0.488; FDR = 0.690; AUC = 0.475, 95% CI, 0.37–0.614), ו-TLR7 (log2 fold change = -0.050; P = 0.543; FDR = 0.73; AUC = 0.546, 95% CI, 0.414–0.679) לא עמדו בקריטריונים שהוגדרו מראש לתמיכה חיצונית. TLR7 הראה גם כיוון הפוך לתוצאות ה-qRT-PCR. מודל חקורי של חמישה גנים, אשר הותאם והוערך במסגרת GSE17261, הניב AUC נראה של 0.740, בעוד שתיקוף צולב מקונן חוזר (repeated nested cross-validation) הניב AUC של 0.656. לפיכך, JUN קיבל את התמיכה העצמאית החזקה ביותר, CXCL10 הראה ראיות מוגבלות בעלות עקביות כיוונית, והשחזור של IFIH1, MX1 ו-TLR7 היה חלש או סותר.
| פריט | תיאור |
| גישה למסד הנתונים | GSE17261 |
| מקור נתונים | Gene Expression Omnibus (GEO) |
| סוג הדגימה | נתוני מערך מיקרו-שבבים (Microarray) של טרנסקריפטומיקה מרקמת ריאה אנושית |
| גודל מדגם | 58 דגימות PAH ו-25 דגימות ביקורת של תורמים שנפסלו |
| פלטפורמה | GPL624 / Affymetrix Human Gene 1.0 ST Array |
| מטרת התיקוף | הבדלי ביטוי, ניתוח ROC של גן בודד, ומידול ROC משולב חוקר של חמישה גנים עבור CXCL10, JUN, IFIH1, MX1 ו-TLR7 |
| תפקיד במחקר זה | סט נתונים חיצוני ועצמאי לתיקוף; לא נכלל בניתוחי האימון המקוריים, ב-WGCNA או בניתוחי בחירת המאפיינים |
טבלה 3: מידע בסי עבור מערך הנתונים GSE17261 לתיקוף חיצוני עצמאי. הטבלה מסכמת את מקור מערך הנתונים, סוג הדגימה, גודל המדגם, הפלטפורמה, מטרות התיקוף ותפקידו של GSE17261 במחקר.
| גֵן/מודל | PAH n | ביקורת n | שינוי קיפול לוגיטמי (log2 fold change) | ערך p | FDR (שיעור התגליות השגויות) | שטח תחת העקומה (AUC) | AUC 95% CI | נקודת החיתוך של יודן (Youden cutoff) | רגישות | ספציפיות |
| CXCL10 | 58 | 25 | 0.677 | 0.041 | 0.144 | 0.639 | 0.491–0.786 | 6.245 | 0.724 | 0.6 |
| JUN | 58 | 25 | 0.463 | 0.00248 | 0.019 | 0.714 | 0.593–0.835 | 8.708 | 0.707 | 0.72 |
| IFIH1 | 58 | 25 | 0.107 | 0.371 | 0.591 | 0.543 | 0.398–0.687 | 5.3 | 0.759 | 0.44 |
| MX1 | 58 | 25 | 0.109 | 0.488 | 0.69 | 0.475 | 0.337–0.614 | 6.833 | 0.724 | 0.4 |
| TLR7 | 58 | 25 | -0.05 | 0.543 | 0.733 | 0.546 | 0.414–0.679 | 4.065 | 0.138 | 1 |
| מודל חמישה גנים (נראה/בתוך המדגם) | 58 | 25 | / | / | / | 0.74 | 0.621–0.859 | 0.613 | 0.845 | 0.6 |
| מודל חמישה גנים (CV מקנן חוזר) | 58 | 25 | / | / | / | 0.656 | 0.517–0.795 | 0.655 | 0.845 | 0.52 |
טבלה 4: הבדלי ביטוי בפועל ותוצאות תיקוף ROC עבור GSE17261. הטבלה מציגה את גדלי המדגמים של PAH והביקורת, שינויי קיפול של log₂, ערכי P, ערכים מותאמים לשיעור התגליות השגויות, AUCs, רווחי סמך של 95%, נקודות חיתוך לפי מדד Youden, רגישויות, סגוליות ופירושים עבור חמשת הגנים והמודלים המשולבים לסריקה.
תיקוף של PCR עם שעתוק הפוך כמותי
תיקוף באמצעות PCR עם שעתוק הפוך כמותי כלל 20 דגימות רקמת ריאה ביולוגית עצמאיות של PAH ו-20 דגימות ביקורת ביולוגיות עצמאיות, כאשר עבור כל דגימה ביולוגית חושבה הממוצע של שלושה שחזורים טכניים. CXCL10, JUN, IFIH1, MX1 ו-TLR7 הראו ביטוי מוגבר באופן מובהק ב-PAH (טבלה 5; איור 9A). ערכי הביטוי היחסי הממוצעים היו בערך 3.470 עבור CXCL10, 2.560 עבור JUN, 2.760 עבור IFIH1, 2.650 עבור MX1, ו-2.580 עבור TLR7. ערכי ה-P/FDR המתאימים היו בהתאמה 1.43 × 10⁻7/7.15 × 10⁻7, 4.17 × 10⁻5/4.17 × 10⁻5, 1.10 × 10⁻5/1.38 × 10⁻5, 1.58 × 10⁻6/2.63 × 10⁻6, ו-1.37 × 10⁻6/2.63 × 10⁻6.
ניתוח ROC של גן בודד המבוס על ביטוי qRT-PCR הראה AUC של 0.98 עבור CXCL10 (95% CI, 0.961–1.0), 0.80 עבור JUN (95% CI, 0.758–1.0), 0.908 עבור IFIH1 (95% CI, 0.820–0.995), 0.945 עבור MX1 (95% CI, 0.874–1.0), ו-0.948 עבור TLR7 (95% CI, 0.886–1.0) (איור 9B; טבלה 5). מודל רגרסיה לוגיסטית של חמישה גנים השיג AUC נראה של 1.0 (DeLong 95% CI: 1.0–1.0), עם רגישות וסגוליות של 1.0 (איור 9C). עקביות כיוון הביטוי בין תיקוף של quantitative reverse transcription PCR לבין GSE17261 הודגמה באמצעות מפת חום (איור 9D). מכיוון שאותם 40 דגימות שימשו הן להתאמה והן להערכה, הדבר שיקף את הביצועים הנראים בתוך המדגם. ב-100 חזרות של אימות צולב חומס-שכבתי (stratified five-fold cross-validation) באמצעות מודל רגרסיה לוגיסטית עם רגולריזציית L2, ה-AUC המאוחד מחוץ למדגם (out-of-fold AUC) נשאר גם הוא 1.0 (95% CI, 1.0–1.0), וכל חזרה הניבה AUC של 1.0. למרות יציבות פנימית זו, когоרט המדגם הייתה קטנה ותיקוף פרוספקטיבי עצמאי נותר נחוץ. השוואה כיוונית עם GSE17261 הראתה עליות תואמות עבור CXCL10, JUN, IFIH1 ו-MX1, אך כיוון שונה עבור TLR7 (איור 9D).
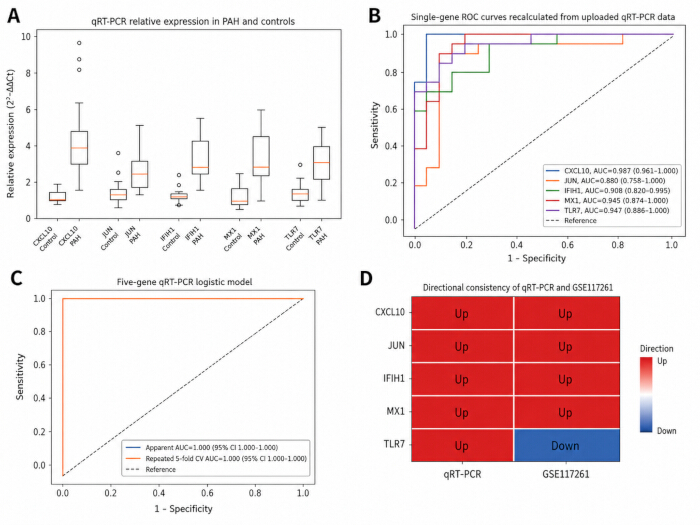
איור 9תיקוף של PCR עם תמלול הפוך כמותי. (Aתרשימי קופסה (Boxplots) המראים את הביטוי היחסי של CXCL10, JUN, IFIH1, MX1 ו-TLR7 ב-20 דגימות רקמת ריאה של חולי PAH בלתי תלויות ביולוגית וב-20 דגימות ביקורת בלתי תלויות ביולוגית. כל דגימה ביולוגית נמדדה בשלוש חזרות טכניות, והערך הממוצע של ה-Ct שימש לניתוח. בכל תרשים קופסה, הקו המרכזי מייצג את החציון, הקופסה מייצגת את הטווח הבין-רבעוני, השפנים נמתחים עד ל-1.5 פעמים הטווח הבין-רבעוני, ונקודות בודדות מעבר לשפנים מייצגות ערכי קיצון (outliers).B) עקומות ROC לגן בודד המבוסות על ערכי ביטוי של qRT-PCR; מוצגים ערכי AUC ומרווחי ביטחון של 95% לפי שיטת DeLong. (Cעקומות ROC עבור מודל הרגרסיה הלוגיסטית של חמישה גנים, המראות הן את הביצועים הגלויים/בתוך המדגם (in-sample) והן את הביצעים המאוחדים מחוץ לקיפול (out-of-fold) מ-100 ניתוחי תיקוף צולב (cross-validation) מחומשים ומרובדים שחזרו על עצמם.ד'מפת חום (Heatmap) המראה עקביות בכיוון הביטוי בין qRT-PCR ל-GSE17261; CXCL10, JUN, IFIH1 ו-MX1 הראו עלייה תואמת, בעוד ש-TLR7 היה לא תואם. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
| גן/מודל | PAH n | ביקורת n | ביקורת 2^-ΔCt, ממוצע ± SD | PAH 2^-ΔCt, ממוצע ± SD | כיוון | ערך P | FDR | AUC | AUC 95% CI | נקודת חיתוך Youden | רגי- שות | סגול- יות | סוג תיקוף | ||||
| CXCL10 | 20 | 20 | 1.09 ± 0.502 | 3.470 ± 1.043 | מגובה (Upregulated) | 1.43E-07 | 7.15E-07 | 0.987 | 0.961–1.0 | 2.028 | 1 | 0.95 | ניתוח qRT-PCR של גן בודד | ||||
| JUN | 20 | 20 | 1.158 ± 0.738 | 2.560 ± 1.609 | מגובה (Upregulated) | 4.17E-05 | 4.17E-05 | 0.8 | 0.758–1.0 | 1.423 | 0.85 | 0.9 | ניתוח qRT-PCR של גן בודד | ||||
| IFIH1 | 20 | 20 | 1.091 ± 0.440 | 2.760 ± 1.398 | מגובה (Upregulated) | 1.10E-05 | 1.38E-05 | 0.908 | 0.820–0.95 | 1.579 | 0.8 | 0.85 | ניתוח qRT-PCR של גן בודד | ||||
| MX1 | 20 | 20 | 1.132 ± 0.582 | 2.650 ± 1.085 | מגובה (Upregulated) | 1.58E-06 | 2.63E-06 | 0.945 | 0.874–1.0 | 1.79 | 0.9 | 0.9 | ניתוח qRT-PCR של גן בודד | ||||
| TLR7 | 20 | 20 | 1.080 ± 0.44 | 2.580 ± 1.284 | מגובה (Upregulated) | 1.37E-06 | 2.63E-06 | 0.947 | 0.886–1.0 | 1.764 | 0.85 | 0.9 | ניתוח qRT-PCR של גן בודד | ||||
| מודל חמישה גנים (ניכר/בדגימה) | 20 | 20 | לא רלוונטי | לא רלוונטי | לא רלוונטי | / | / | 1 | 1.00–1.0 | 0.98 | 1 | 1 | אותן 40 דגימות ביולוגיות ששימשו להתאמת המודל ולהערכתו | ||||
| מודל חמישה גנים (10× חזרות CV של 5-fold) | 20 | 20 | לא רלוונטי | לא רלוונטי | לא רלוונטי | / | / | 1 | 1.0–1.00 | 0.716 | 1 | 1 | תיקוף צולב פנימי באמצעות רגרסיה לוגיסטית עם רגולריזציית L2 | ||||
טבלה 5: תוצאות ביטוי מלאות של qRT-PCR ותוצאות ROC עבור CXCL10, JUN, IFIH1, MX1 ו-TLR7, כולל ניתוחים של מודל משולב של חמישה גנים. הטבלה מדווחת על גדלי המדגמים של PAH ושל קבוצת הביקורת, ערכי ביטוי יחסיים, כיווני ביטוי, ערכי P, ערכים מותאמים לשיעור התגליות השגויות (FDR), AUC, רווחי סמך של 95%, נקודות חיתוך לפי מדד Youden, רגישויות, סגוליות וסוגי תיקוף עבור הגנים הבודדים והמודלים המשולבים.
תיקוף טרנסקריפטומי של תאים בודדים ב-GSE210248
GSE210248 סיפק תמיכה מכניסטית ברמת התא על ידי כך שהראה כי שחזור עורקי ריאתי ב-PAH לווה בשינוי בתקשורת בין תאי מערכת החיסון לבין תאים מבניים של כלי דם. תצפית זו הייתה עקבית עם העשרה טרנסקריפטומית ב-bulk של תגובות דלקתיות, סיגנל של כימוקינים, סיגנל של קולטני Toll-like וסיגנל של גורם נמק גידולי (tumor necrosis factor).
ראיות ברמה של תא בודד הצביעו על כך שרשת האיתות של העורק הריאתי ב-PAH נסגעה לכיוון תאים מבניים, כולל תאי שריר חלק ופיברובלסטים. תאי שריר חלק הראו מצבים מרובים, כולל מצבים דמויי פריסייט/חיישני חמצן, מכווצים, סינתטיים ודמויי פיברובלסטים. תוצאות אלו תומכות במודל מחלה שבו הפעלה אימונו-דלקתית ובנייה מחדש של תאים מבניים וסקולריים מניעים יחד את התקדמות ה-PH/PAH.
סריקת תרכובות מועמדות ועגינה מולקולרית
סריקה של מפת הקישוריות (Connectivity Map) זיהתה את BRD-K9190765 כתרכבת המועמדת בעלת הדירוג הגבוה ביותר מבין 10 הפגיעות (hits) המובילות, עם ציון Logit של 10.13 והסתברות חוזה של 0.085 (איור 10). אוצרות של התרכובות הראתה כי BRD-K91900765 תואמת ל-VX-745/neflamapimod, מעכב סלקטיבי של p38α/MAPK14 עם מזהה תרכובת ב-PubChem של 3038525 ומסה מולקולרית של 436.27 g/mol (טבלה 6).
עגינה (docking) חקרנית של BRD-K9190765/VX-745 עם חמשת החלבונים הקשורים לסמנים ביולוגיים הניבה ציוני Vina עליונים של -7.5 kcal/mol עבור CXCL10, -7.6 kcal/mol עבור JUN, -7.5 kcal/mol עבור IFIH1, -8.7 kcal/mol עבור MX1, ו-8.1- kcal/mol עבור TLR7 (טבלאות 7–1; איור 1A–E). תוצאות אלו הצביעו על תאימות מבנית חזויה בלבד ולא ביסו את חמשת החלבונים כמטרות פרמקולוגיות ישירות. תחזיות ראשוניות של ספיגה, התפלגות, מטבוליזם, הפרשה ורעילות (ADMET) העלו כי לתרכובת יש מספר תכונות דמויות-תרופה, אם כי ה-cLogP המחושב הגבוה יחסית דורש הערכה נוספת (טבלה 12). עגינה מול המטרה המוכרת של VX-745, MAPK14/p38α (PDB ID: 1OUK), נכללה כניתוח ייחוס חיובי. חלול ה-MAPK14 העליונה, C1, הניבה ציון Vina של -7.9 kcal/mol, נפח חלול של 3560 Å3, מרכז תיבת עגינה של (2, 2, 34), וממדים של (2, 31, 31) (טבלה 13; איור 1F).
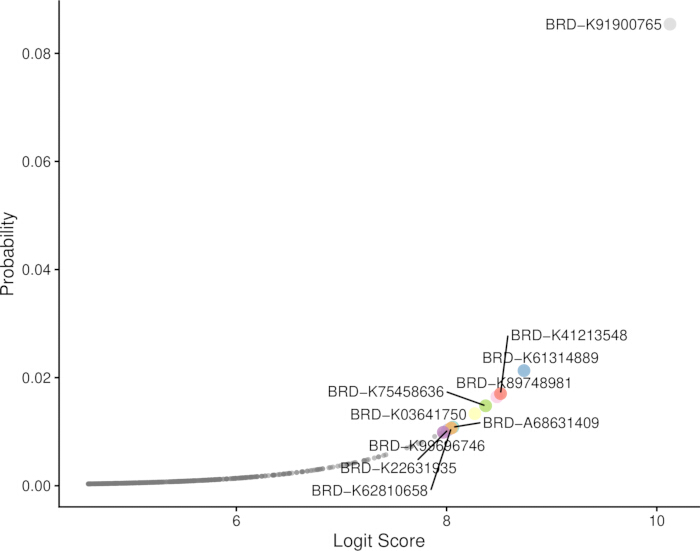
איור 10דירוג תרכובות מועמדות ממפת קישוריות (Connectivity Map). דירוג התרכובות המועמדות שזוהו באמצעות סריקת Connectivity Map. התרכובת BRD-K9190765 דורגה במקום הגבוה ביותר, עם ציון Logit של 10.13 והסתברות נחזית של 0.085. אנא לחץ כאן כדי לצפות בגרסה מורחבת של איור זה.
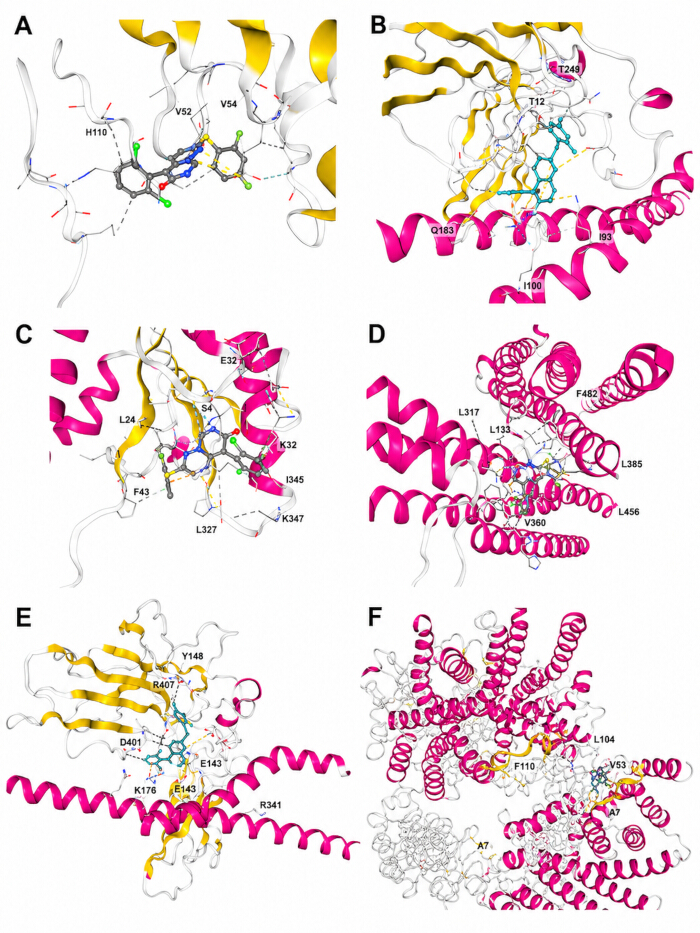
איור 11דיאגרמות עגינה מולקולרית תלת-מדיות עבור BRD-K9190765/VX-745. (A) עגינה גששית (Exploratory docking) עם CXCL10. (B( עקיבה חוקרת (Exploratory docking) עם JUN. (C( דקינג (docking) גשש עם IFIH1. (Dעגינה (docking) חוקרת עם MX1.הסימולציית עגינה (Docking) גששית עם TLR7.פעגינה (docking) עם רפרנס חיובי למטרה הפארמקולוגית המוכרת MAPK14/p38α (PDB ID: 1OUK). פאנלים א–ה מעיד על תאימות מבנית חזויה ואינו מבס התמקדות פרמקולוגית ישירה. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
| פריט | תיאור |
| CMap/Broad ID | BRD-K9190765 (פורמט סב נפוץ: BRD-K9190765-01-xx-x) |
| שם נפוץ/שמות חלופיים | VX-745; neflamapimod; VRT-031745; VD-31745 |
| שם כימי | 5-(2,6-dichlorophenyl)-2-(2,4-difluorophenyl)sulfanylpyrimido[1,6-b]pyridazin-6-one |
| PubChem CID | 3038525 |
| מספר CAS | 209410-46-8 |
| נוסחה מולקולרית / מסה מולקולרית יחסית | C19H9Cl2F2N3OS; 436.27 g/mol |
| SMILES קנוני | C1=CC(=C(C(=C1)Cl)C2=C3C=CC(=NN3C=NC2=O)SC4=C(C=C(C=C4)F)F)Cl |
| InChIKey | VEPKQEUBKLEPRA-UHFFFAOYSA-N |
| מטרה פרמקולוגית מרכזית מבוססת | דווח כי עיכוב של MAPK14/p38α הוביל גם לעיכוב של p38β, עם סלקטיביות נמוכה יותר מזו של p38α |
טבלה 6: מידע כימי ופרמקולוגי עבור BRD-K9190765/VX-745. הטבלה מסכמת את מזהי התרכובת, שמות חלופיים, שם כימי, נוסחה מולקולרית, מסה מולקולרית, מתארים מבניים ומטרה פרמקולוגית מוגדרת של BRD-K9190765/VX-745.
| מזהה CurPocket | ציון Vina (kcal/mol) | נפח חלל (ų) | מרכז (x, y, z) | גודל עגינה (x, y, z) |
| C1 | -7.5 | 7568 | 49, 15, 4 | 34, 3, 35 |
| C4 | -7 | 160 | 46, 0, 4 | 2, 22, 2 |
| C3 | -6 | 208 | 34, 15, 9 | 2, 22, 2 |
| C2 | -5.8 | 465 | 45, -6, 19 | 2, 2, 2 |
| C5 | -5.1 | 150 | 63, 0, 20 | 22, 2, 22 |
טבלה 7: כיסי עגינה חזויים עבור BRD-K9190765/VX-745 עם CXCL10 (מזהה PDB: 1LV9). הטבלה מציגה את מזהי החללים בדירוג, ציוני Vina, נפחי החללים, מרכזי תיבת העגינה וממדי תיבת העגינה שנוצרו על ידי CB-Dock2.
| זיהוי CurPocket | מדד וינה (Vina score) (kcal/mol) | נפח חל (ų) | מרכז (x, y, z) | גודל עגינה (x, y, z) |
| C3 | -7.6 | 1593 | 26, 35, 70 | 22, 22, 22 |
| C2 | -7.5 | 1927 | 25, 21, 60 | 35, 22, 22 |
| C1 | -7.4 | 5420 | 32, 37, 48 | 35, 22, 31 |
| C5 | -6 | 464 | 26, 5, 48 | 22, 22, 22 |
| C4 | -5.3 | 683 | 59, 32, 39 | 22, 22, 22 |
טבלה 8: כיסי עגינה (docking pockets) חזויים עבור BRD-K9190765/VX-745 עם JUN (PDB ID: 1JUN). הטבלה מפרטת את מזהי החללים בדירוג, ציוני Vina, נפחי החללים, מרכזי תיבת העגינה וממדי תיבת העגינה שנוצרו על ידי CB-Dock2.
| CurPocket ID | ציון Vina (קקאל/מול) | נפח חל (ų) | מרכז (x, y, z) | גודל עגינה (x, y, z) |
| C1 | -7.5 | 583 | 15, 4, 17 | 22, 22, 22 |
| C3 | -7.2 | 146 | 19, 21, 24 | 22, 22, 22 |
| C4 | -6.6 | 141 | 31, 19, 15 | 22, 22, 22 |
| C2 | -6.2 | 273 | 38, 9, 24 | 22, 22, 22 |
| C5 | -6.2 | 125 | 27, -7, 10 | 22, 22, 22 |
טבלה 9: כיסי עגינה חזויים עבור BRD-K9190765/VX-745 עם IFIH1 (PDB ID: 3B6E). הטבלה מציגה את מזהי החלליים בדירוג, ציוני Vina, נפחי החללים, מרכזי תיבת העגינה וממדי תיבת העגינה שנוצרו על ידי CB-Dock2.
| מזהה CurPocket | ציון Vina (kcal/mol) | נפח חלל (ų) | מרכז (x, y, z) | גודל עגינה (x, y, z) |
| C1 | -8.7 | 523 | -18, -14, -5 | 2, 2, 2 |
| C4 | -7.3 | 262 | -13, -6, -9 | 22, 22, 2 |
| C3 | -7 | 306 | 12, 12, -7 | 2, 22, 2 |
| C2 | -6.9 | 408 | -3, 1, -12 | 2, 2, 2 |
| C5 | -6.2 | 179 | 24, 25, 13 | 2, 2, 2 |
טבלה 10: כיסי עגינה (docking pockets) חזויים עבור BRD-K9190765/VX-745 עם MX1 (PDB ID: 5GTM). הטבלה מציגה את מזהי החללים בדירוג, ציוני Vina, נפחי החללים, מרכזי תיבת העגינה וממדי תיבת העגינה שהופקו על ידי CB-Dock2.
| מזהה CurPocket | ציון Vina (kcal/mol) | נפח חל (ų) | מרכז (x, y, z) | גודל עגינה (Docking size) (x, y, z) |
| C2 | -8.1 | 7347 | 12, 137, 148 | 3, 28, 35 |
| C3 | -8.1 | 2604 | 124, 124, 176 | 30, 2, 2 |
| C1 | -8 | 7676 | 137, 12, 148 | 34, 29, 35 |
| C5 | -6.9 | 1976 | 17, 157, 8 | 2, 2, 2 |
| C4 | -6.6 | 2040 | 132, 92, 91 | 2, 2, 2 |
טבלה 1: כיסי עגינה (docking pockets) חזויים עבור BRD-K9190765/VX-745 עם TLR7 (מזהה PDB: 7CYN). הטבלה מציגה את מזהי החללים בדירוג, ציוני Vina, נפחי החללים, מרכזי תיבת העגינה וממדי תיבת העגינה שהופקו על ידי CB-Dock2.
| קטגוריה | פרמטר | תוצאה | פירוש תוצאות |
| תכונה פיזיקו-כימית | מסה מולקולרית | 436.27 g/mol | נמוך מ-50 Da, ועומד בסף המשקל המולקולרי של Lipinski |
| תכונה פיזיקו-כימית | cLogP | בערך 5.49 | גבוה במעט מ-5, מה שמרמז על ליפופיליות גבוהה ועל הצורך לשקול מסיסות וקישור לא ספציפי |
| תכונה פיזיקו-כימית | שטח פולרי כולל (TPSA) | בערך 47.26 Ų | שטח פנים קוטבי נמוך, העולה בקנה אחד עם חדירות ממברנה פוטנציאלית נוחה |
| דמיון לתרופה | HBA/HBD | מאי-0 | עומד בספי סף של ליפינסקי (Lipinski) עבור מקבלים ותורמים של קשרי מימן |
| דמיון לתרופה (Drug-likeness) | קשרים סיבובים | 3 | גמישות קונפורמציונית נמוכה, המגבירה קשירה למבני קישור יציבים |
| התרעות מבניות | התרעות PAINS/Brenk | לא זוה | לא זוהו הפרעות נפוצות של בדיקה רחבה (pan-assay interference) או התראות מבניות ריאקטיביות |
| חיזוי רעילות | מוטגניות איימס (Ames mutagenicity) | חזוי כרעיל שאינו מסוג Ames | מעיד על סיכון מוטגני חזוי נמוך; עדיין נדרשת תיקוף ניסויי |
| ניבוי רעילות | מסרטנות | נחזה כבלתי קרצינוגני | מצביע על סיכון קרצינוגני ארוך-טווח חזוי הנמוך יחסית; עדיין נדרש תיקוף ניסויי |
| הערה פרמקוקינטית | זמינות ביולוגית פומית/חדירה למוח | הספרות ומסדי הנתונים מצביעים על מולקולה קטנה, בעלת זמינות ביואבליבילית דרך הפה, החודרת למערכת העצבים המרכזית. | בעקביות עם רקע הפיתוח שלו כמעכב p38α; עדיין נדרשת הערכה מחדש עבור התוויות של PH |
טבלה 12: תחזיות פיזיקו-כימיות, דמיון לתרופה, ADMET ורעילות ראשוניות עבור BRD-K91900765/VX-745. הטבלה מסכמת תכונות פיזיקו-כימיות חזויות, מדדי דמיון לתרופה, התראות מבניות, נקודות קצה של רעילות ומאפיינים פרמקוקינטיים. תחזיות חישוביות אלו הן ראשוניות ואינן מחליפות תיקוף פרמקוקינטי או רעילתני ניסיוני.
| מזהה CurPocket | ציון Vina (kcal/mol) | נפח חל (ų) | מרכז (x, y, z) | גודל עגינה (x, y, z) |
| C1 | -7.9 | 3560 | 2, 2, 34 | 2, 31, 31 |
| C5 | -7.5 | 254 | -9, 28, 60 | 2, 22, 2 |
| C3 | -7.4 | 351 | 12, 7, 37 | 2, 2, 2 |
| C2 | -6.3 | 827 | 18, 5, 28 | 2, 22, 2 |
| C4 | -6.3 | 34 | -16, 17, 38 | 22, 2, 22 |
טבלה 13: כיסי עגינה (docking pockets) חזויים עבור BRD-K9190765/VX-745 עם המטרה הפרמקולוגית המוכרת שלו MAPK14/p38α (מזהה PDB: 1OUK), אשר נכלל כניתוח ייחוס חיובי. הטבלה מציגה את מזהי החללים בדירוג, ציוני Vina, נפחי החללים, מרכזי תיבת העגינה וממדי תיבת העגינה שנוצרו באמצעות אותו תהליך עבודה של עגינה שהוחל על חמשת החלבונים הקשורים לסמנים ביולוגיים.
בסך הכל, ניתוחי הגילוי ותוצאות ה-qRT-PCR תומכים ב-CXCL10, JUN, IFIH1, MX1 ו-TLR7 כביומרקרים מועמדים ל-PH/PAH הקשורים לדיסרגולציה אימונו-דלקתית ולremodeling של כלי הדם הריאתיים, אם כי שכפול עצמאי של GSE17261 היה החזק ביותר עבור JUN ומשתנה עבור הגנים האחרים. BRD-K9190765/VX-745 הוא מועמד למיקום תרופתי מחדש (drug-repositioning) שתועדף חישובית עם מנגנון סביר של עיכוב MAPK14/p38α; נדרשים תיקוף של קישור למטרה, תיקוף תאי, פרמקוקינטי, רעילות ותיקוף במודל חיות לפני פרשנות טיפולית.
זמינות נתונים:
כל מערכי הנתונים הטרנסקריפטומיים הציבוריים ששימשו במחקר זה זמינים במאגר הנתונים Gene Expression Omnibus תחת מספרי גישה GSE2356, GSE3463, GSE48149, GSE17261, ו-GSE210248. כל קבצי הקוד, מערכי הנתונים המעובדים, נתוני הגלם והנתונים המנותחים של qRT-PCR לאחר הסרת פרטים מזהים, פלטי המודלים וקבצי הקלט/פלט של עגינה מולקולרית (molecular docking) רוכזו במאגר Zenodo מובנה. המאגר כולל קובץ README המתאר כל קובץ, גרסאות של תוכנות וחבילות, סדר הרצת הסקריפטים ושלבי שחזור מלאים - https://zenodo.org/records/21682282
דיון
פותח תהליך עבודה (workflow) אינטגרטיבי וניתן לשחזור לזיהוי סמנים ביולוגיים מולקולריים ותהליכים תרופתיים מועמדים הקשורים ל-PH/PAH, וזאת באמצעות שילוב של נתוני טרנסקריפטומיקה פומביים, ניתוח רשתות ביטוי גנים משוקלל (WGCNA), העשרה תפקודית, ניתוח רשתות אינטראקציה בין חלבונים, שלושה אלגוריתמים של למידת מכונה, תיקוף חיצוני, פרשנות טרנסקריפטומית ברמת התא הבודד, אישור באמצעות quantitative reverse transcription PCR, סריקת Connectivity Map ועגינה מולקולרית (molecular docking). הגנים CXCL10, JUN, IFIH1, MX1 ו-TLR7 תועדפו באופן עקבי כגנים המהווים מאפייני ליבה, ומופו יחד לציר מולקולרי תלוי-אינטרפרון ודלקתי-חיסוני. ממצאים אלה תומכים בתפיסה ש-PH/PAH אינה רק הפרעה המודינמית, אלא גם מחלה מורכבת של עיצוב מחדש של כלי הדם (vascular remodeling), הכוללת הפעלה חיסונית, סיגנל דלקתי, חישה מולדת של חומצות גרעין ושינויים פנוטיפיים מבניים ותאיים2,5,6.
הפוטנציאל האבחנתי של חמשת הגנים נתמך על ידי בחירת תכונות באמצעות ריבוי אלגוריתמים וניתוח ROC של קבוצת גילוי. תיקוף עצמאי ב-GSE117261 היה הטרוגני ולא אחיד: JUN עמד בקריטריונים שנקבעו מראש של FDR ו-AUC, CXCL10 הראה עלייה נומינלית עקבית בכיוונה אך ללא מובהקות FDR ברמת התסריפטום כולו, IFIH1 ו-MX1 הראו רפליקציה מוגבלת, ו-TLR7 הראה כיוון סותר. תוצאות אלו אינן תומכות בטענה שכל חמשת הגנים תוקפו באופן עצמאי ומצביעות על השפעות אפשריות של הרכב הקבוצה, הטרוגניות רקמות, הבדלים בפלטפורמה וחומרת המחלה. לעומת זאת, qRT-PCR ב-20 דגימות רקמת ריאה של חולי PAH ו-20 דגימות ביקורת אישש עלייה משמעותית בביטוי (upregulation) של כל חמשת הגנים וביצועי ROC חיוביים עבור כל גן בנפרד.
מודל הלוגיסטי של qRT-PCR המבוסס על חמישה גנים השיג AUC נראה של 1.000 (95% CI, 1.000–1.000), וה-AUC המאוחד של ה-out-of-fold נשאר 1.000 ב-100 ניתוחים חוזרים של אימות צולב (cross-validation) מחומש מרובד. עם זאת, המודל פותח על בסיס 40 דגימות ביולוגיות בלבד, והפרדה מלאה בקוהורט רטרוספקטיבי קטן עלולה להוביל להערכות ביצועים אופטימיות ולא יציבות. לכן, יש להתייחס לפאנל כחתימה מולקולרית גששית ולא ככלי אבחנתי שעבר תיקוף קליני. נדרשים קוהורטים רב-מרכזיים גדולים יותר, מקדמי מודל קבועים שהוגדרו מראש, תיקוף ברמת החלבון, אימונוהיסטוכימיה ובדיקות פרוספקטיביות לפני יישום קליני.
מבין חמשת הגנים המרכזיים, CXCL10 עשוי לקדם גיוס תאי חיסון והגברה של דלקת מקומית בתוך המיקרו-סביבה של כלי הדם הריאתיים. IFIH1 ו-TLR7 מעורבים בזיהוי מולד של חומצות גרעין ועשויים לשקף הפעלה של מסלולי דלקת דמויי-אנטי-ויראליים. MX1 הוא גן קלאסי המופעל על ידי אינטרפרון ועשוי לייצג סמן במורד המסלול להפעלת מסלול אינטרפרון מסוג I. JUN הוא פקטור שעתוק המגיב למעיכה (stress-responsive transcription factor) המקשר בין גרייה דלקתית לבין שגשוג תאים, אפופטוזיס ושחזור רקמות. יחד, גנים אלו מרמזים על מודל ביולוגי קוהרנטי שבו הפעלה של מערכת החיסון המולדת ואותות הקשורים לאינטרפרון מקיימים אינטראקציה עם תהליכי שחזור כלי דם ב-PH/PAH. פרשנות זו עולה בקנה אחד עם ראיות קודמות לכך שדלקת, חיסון ומסלולים הקשורים לאינטרפרון תורמים לפתופיביולוגיה של PAH2,5,6.
תיקוף ברמת התא הבודד סיפק הקשר מכניסטי לממצאים שהופקו מניתוח ה-bulk. נתוני GSE210248 הצביעו על כך שעיצוב מחדש (remodeling) של העורקים הריאתיים ב-PAH לווה בשינוי בתקשורת בין תאי מערכת החיסון לתאים מבניים של כלי הדם, כולל תאי שריר חלק, פיברובלסטים, תאי אנדותל ומונוציטים/מקרופאגים. נוכחותם של מצבים פנוטיפיים מרובים של תאי שריר חלק, כולל מצבים כיווציים (contractile), סינתטיים, תחושתיים לחמצן/דמויי פריסייט (pericyte-like), ודמויי פיברובלסט, תומכת במודל מחלה שבו הפעלה חיסונית ועיצוב מחדש מבני של תאים מתרחשים בו-זמנית. ראיה תאית זו היא חשובה מכיוון שאותות טרנסקריפטומיים של bulk עשויים לנבוע משינויים בפרופורציות של התאים, חדירה של תאי מערכת החיסון או שינויים טרנסקריפציונליים בתאי כלי דם תושבי הרקמה. לפיכך, ניתוח התא הבודד מציב את CXCL10, JUN, IFIH1, MX1 ו-TLR7 בתוך מערכת אקולוגית רב-תאית של עיצוב מחדש של כלי הדם הריאתיים, ולא כחלק מתהליך של סוג תא בודד18,19,20,21.
ניתוח התאמת התרופות (drug-repositioning) זיהה את BRD-K91900765, המקביל ל-VX-745/neflamapimod, כמועמד החישוב בעל הדירוג הגבוה ביותר. VX-745 הוא מעכב סלקטיבי של p38α/MAPK14, והקשרו למסלולי עקה דלקתית הופך אותו לפlausible מבחינה מכניסטית בהקשר של דלקת הקשורה ל-PH/PAH30. לפיכך, עיגון (docking) מול MAPK14/p38α נכלל כניתוח רפרנס חיובי רלוונטי מבחינה מכניסטית. לעומת זאת, עיגון מול CXCL10, JUN, IFIH1, MX1 ו-TLR7 היה חקרני והצביע רק על תאימות מבנית חזויה; הוא לא הדגים שחלבונים אלו הקשורים לסמנים ביולוגיים הם מטרות ישירות של VX-745 או ביסס קישור ישיר, עיכוב של המטרה או יעילות טיפולית. היפותזה סבירה יותר מבחינה ביולוגית היא ש-VX-745 עשוי לווסת בעקיפין את החתימה השעתוקית המזוהה הקשורה למערכת החיסון, לדלקת ולאינטרפרון על ידי עיכוב של MAPK14. תחזיות של Connectivity Map, ציוני עיגון והערכות ADMET נותרים ראיות חישוביות. עבודה עתידית צריכה לכלול בדיקות קישור למטרה ביוכימית, ניסויים בתאי אנדותל ותאי שריר חלק של העורקים הריאתיים, מודלים של גירוי דלקתי, הערכות פרמקוקינטיות וטוקסיקולוגיות, ותיקוף במודלים של בעלי חיים.
מחקרים ניסיוניים אחרונים ביתר לחץ דם ריאתי היפוקסי הדגישו גם את חשיבות התקשורת בין נויטרופילים לתאי כלי הדם הריאתיים. אינטראקציות המתווכות על ידי HCK בין נויטרופילים לתאי שריר חלק של העורקים הריאתיים, ואינטראקציות המתווכות על ידי SERPINB3 בין נויטרופילים לתאי אנדותל, דווחו כגורמים התורמים לעיצוב מחדש (remodeling) של כלי הדם הריאתיים31˒32. ציר ה-SERPINB3–STAT1/3 רלוונטי במיוחד לממצאים הנוכחיים מכיוון שסיגנלים הקשורים לאינטרפרון, STAT1 ו-JAK–STAT זוהו בניתוחים הטרנסקריפטומיים. יחד, תצפיות אלו תומכות בפרשנות לפיה הפעלת תאי מערכת החיסון ותקשורת עם תאים מבניים של כלי הדם עשויות לתרום להתקדמות של PH/PAH.
למחקר מספר נקודות חוזק. נעשה שימוש במספר מאגרי נתונים ציבוריים ובתיקון השפעות אצווה (batch-effect correction) כדי להפחית הטיות הספציפיות למאגרי הנתונים. ניתוח ביטוי דיפרנציאלי, ניתוח רשתות ביטוי גנים משותף משוקלל (WGCNA), ניתוח אינטראקציות חלבון-חלבון ושלושה אלגוריתמים של למידת מכונה שולבו יחד כדי לשפר את חסונו של המאפיין. תיקוף עצמאי בשיטת bulk, אישור באמצעות qRT-PCR וראיות ברמה של תא בודד סיפקו שכבות ראיות משלימות אך לא זהות. הממצאים ההטרוגניים של GSE117261 והקוהורט הקטן של ה-qRT-PCR מדגישים גם מגבלות חשובות, הכוללות שחזור חיצוני חלקי, השפעות פוטנציאליות הספציפיות לרקמה ולפלטפורמה, וסיכון להתאמת יתר (overfitting). גילוי הביומרקרים הורחב גם לסריקת תרכובות מועמדות, אך ניתוחי העגינה (docking) נותרים בשלב של יצירת השערות. מחקרים עתידיים צריכים לתקף את חמשת הגנים בקוהורטים עצמאיים גדולים יותר באמצעות טרנסקריפטומיקה מרחבית, פרוטאומיקה, אימונוהיסטוכימיה ומודלים של אורגנוידים או שבבי כלי דם (vascular-on-chip). באופן כללי, CXCL10, JUN, IFIH1, MX1 ו-TLR7 נותרים ביומרקרים מועמדים ל-PH/PAH הקשורים לעיצוב מחדש של כלי דם תלוי-אינטרפרון ותהליכים אימנו-דלקתיים, בעוד ש-BRD-K91900765/VX-745 הוא מועמד חישובי למיקום תרופתי מחדש (drug-repositioning) שרלוונטיות טיפולית שלו דורשת תיקוף ניסויי.
גילויים
המחברים מצהירים כי אין להם ניגודי אינטרסים.
תודות
מחקר זה נתמך על ידי פרויקט בניית המחוז החדשני של Hunan (מס' 2022JJ30465).
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| 2× SYBR Green PCR Mastermix | Beijing Solarbio Science & .Technology Co., Ltd | מספר קטלוג SR1110 | הגברה וגילוי פלואורסצנציה ב-PCR כמותי בזמן אמת מבוסס צבע |
| AI21.msvmRFE.R ו-e1071 | סקריפט R מותאם אישית עם חבילת e1071 מ-CRAN | AI21.msvmRFE.R; e1071 v1.7-17 | סילוק תכונות רקורסיבי באמצעות מכונת וקטורים תומכים |
| אגרוז | Beijing Solarbio Science & .Technology Co., Ltd | מספר קטלוג A8201; CAS 9012-36-6 | הערכת שלמות ה-RNA הכולל באמצעות אלקטרופורזה של ג'ל אגרוזה |
| מכשיר לאלקטרופורזה של ג'ל אגרוזה | Beijing Liuyi Biotechnology Co., Ltd. | דגם DYCZ-24DN | הערכה אלקטרופורטית של שלמות ה-RNA |
| מנוע הניקוד של AutoDock Vina | המרכז לביולוגיה מבנית חישובית, Scripps Research | v1.2.0; RRID: SCR_011958 | דירוג תנוחות של חלבון-ליגנד במסגרת זרימת העבודה של CB-Dock2 |
| CB-Dock2 | מעבדת Cao, שרת האינטרנט CB-Dock2 | גרסה 2.0; נגישה מיולי 2026 | זיהוי חללים עיוור (Blind cavity detection) ועגינה מולקולרית (molecular docking) של VX-745 עם מבני החלבון שנבחרו |
| CellChat | חבילת ה-R CellChat | v2.1.2 | הסקה וויזואליזציה של תקשורת בין תאים מתוך מטריצת ביטוי של תא בודד |
| CellChatDB.human | מופץ באמצעות חבילת ה-R בשם CellChat | CellChatDB.human; תת-קבוצה של איתות מופרש; סף תאים מינימלי = 10 | מאגר נתוני אינטראקציות ליגנד-רספטור אנושי עבור CellChat |
| clusterProfiler | חבילת R של Bioconductor | v4.20.0; גרסת Bioconductor 3.23 | ניתוחי העשרה של Gene Ontology ושל Kyoto Encyclopedia of Genes and Genomes |
| מפת קישוריות (CMap/CLUE) | Broad Institute | משאב L1000/CLUE; RRID: SCR_016204; נגישה ביולי 2026 | ניתוח חישובי לאיתור שימושים חדשים לתרופות (drug-repositioning) |
| פריימרים של אוליגונוקלאוטידים בהתאמה אישית | Beijing Solarbio Science & .Technology Co., Ltd | סנתזה מותאמת אישית; רצפי הפריימרים מופיעים בטבלה 2 | הגברה של ACTB, CXCL10, JUN, IFIH1, MX1 ו-TLR7 |
| cytoHubba | חנות האפליקציות של Cytoscape | גרסה 0.1 | דירוג גנים מרכזיים (hub genes) מבוסס דרגה ברשת אינטראקציות חלבון-חלבון |
| Cytoscape | קונסורציום Cytoscape | v3.10.4; RRID: SCR_003032 | ויזואליזציה ואנליזה של רשתות אינטראקציית חלבון-חלבון |
| DrugBank | מאגר הידע DrugBank | v6.0; RRID: SCR_002700 | זיהוי תרכובות ואוצרות מידע פרמקולוגי |
| מערכת לתיעוד ג'לים | Beijing Liuyi Biotechnology Co., Ltd. | דגם WO-9413B | ויזואליזציה ותיעוד של תוצאות שלמות ה-RNA בג'ל אגרוז |
| Gene Expression Omnibus (GEO) | המרכז הלאומי למידע בביוטכנולוגיה | GSE22356, GSE33463, GSE48149, GSE117261, ו-GSE210248; RRID: SCR_005012 | שליפה של מאגרי נתונים טרנסקריפטומיים ברמה של אוכלוסיית תאים (bulk) וברמה של תא בודד (single-cell) |
| GEOquery | חבילת R של Bioconductor | v2.80.0; גרסת Bioconductor 3.23 | הורדה וייבוא תכנותיים של נתוני ביטוי ופנוטיפ מ-GEO |
| glmnet | חבילת R של CRAN | גרסה 5.0 | רגרסיה לוגיסטית בשיטת LASSO (מפעיל בחירה וכיווץ מוחלט מינימלי) ומידול לוגיסטי רגולריזציוני |
| limma | חבילת R של Bioconductor | v3.68.0; Bioconductor release 3.23; RRID: SCR_010943 | ניתוח ביטוי דיפרנציאלי וסטטיסטיקה של בייס אמפירי (Empirical Bayes) |
| ספקטרופוטומטר NanoDrop | Thermo Fisher Scientific | NanoDrop ND-1000; גרסת תוכנה 3.8 | מדידת ריכוז RNA ויחסי טוהר של A260/280 ו-A260/230 |
| NCBI Primer-BLAST | המרכז הלאומי למידע בביוטכנולוגיה | כלי רשת; RRID: SCR_003095; נגישה ביולי 2026 | אימות ספציפיות של הפריימרים |
| pROC | חבילת R של CRAN | v1.19.0.1; RRID: SCR_024286 | ניתוח עקומת מאפייני הפעלה של מקלט (ROC), רווחי סמך של DeLong ונקודות חיתוך לפי מדד Youden |
| מאגר נתוני החלבונים (Protein Data Bank - PDB) | RCSB Protein Data Bank | CXCL10: 1LV9; JUN: 1JUN; IFIH1: 3B6E; MX1: 5GTM; TLR7: 7CYN; MAPK14/p38α: 1OUK; RRID: SCR_012820 | שליפת מבני חלבונים שנקבעו ניסויית עבור עגינה מולקולרית |
| PubChem | המרכז הלאומי למידע ביוטכנולוגי | PubChem CID 3038525; RRID: SCR_004284 | שחזור המבנה התלת-ממדי ומזהים כימיים של BRD-K91900765/VX-745 |
| R | R Foundation for Statistical Computing | v4.6.1; RRID: SCR_001905 | חישוב סטטיסטי, עיבוד נתונים, למידת מכונה והדמיה ויזואלית |
| יער אקראי (randomForest) | חבילת R של CRAN | v4.7-1.2 | בחירת תכונות ודירוג חשיבות משתנים באמצעות יער אקראי (Random forest) |
| מערכת PCR בזמן אמת | Stratagene, כיום Agilent Technologies | מערכת Mx3000P ל-PCR בזמן אמת | הגברה ב-qRT-PCR, רכישת פלואורסצנציה, ניתוח עקומת התכה וייצוא ערכי Ct |
| Seurat | חבילת R של CRAN; מעבדת Satija | v5.5.1; RRID: SCR_016341 | בקרת איכות, נורמליזציה, הפחתת ממדיים, אשכול (clustering) ואנוטציה של רצף RNA של תא בודד (scRNA-seq) |
| נא לספק את הטקסט המקור באנגלית לתרגום. | קונסורציום STRING | v12.0; RRID: SCR_005223 | בניית רשת אינטראקציות חלבון-חלבון |
| sva (ComBat) | חבילת R של Bioconductor | v3.60.0; גרסת Bioconductor 3.23 | תיקון אפקטים של אצווה (batch effects) בין מאגרי נתונים |
| SwissADME | המכון השוויצרי לביואינפורמטיקה | שרת אינטרנט; נגישה ביולי 2026 | סינון מקדים של דמיון לתרופה, תכונות פיזיקכימיות ו-ADME |
| ערכה למיצוי RNA כולל | Beijing Solarbio Science & .Technology Co., Ltd | מספר קטלוג R1200 | מיצוי וטיהור של RNA כולל מדגימות רקמת ריאה |
| ערכה אוניברסלית ל-RT-PCR (AMV) | Beijing Solarbio Science & .Technology Co., Ltd | מספר קטלוג RP1200 | שעתוק הפוך של RNA כולל ל-DNA משלים |
| WGCNA | חבילת R של CRAN | v1.74 | בניית רשת ביטוי גנים משותף משוקללת ואנליזה של קשרי מודולים-תכונות |
מקורות
- Simonneau G, et al. Haemodynamic definitions and updated clinical classification of pulmonary hypertension. Eur Respir J. 2019;53(1):1801913. doi: 10.1183/13993003.01913-2018.
- Rabinovitch M, Guignabert C, Humbert M, Nicolls MR. Inflammation and immunity in the pathogenesis of pulmonary arterial hypertension. Circ Res. 2014;115(1):165–175.
- Humbert M, et al. 2022 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2022;43(38):3618–3731.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Respir J. 2015;46(4):903–975.
- Soon E, et al. Elevated levels of inflammatory cytokines predict survival in idiopathic and familial pulmonary arterial hypertension. Circulation. 2010;122(9):920–927.
- George PM, et al. Evidence for the involvement of type I interferon in pulmonary arterial hypertension. Circ Res. 2014;114(4):677–688.
- Subramanian A, et al. A next-generation Connectivity Map: L1000 platform and the first 1,000,000 profiles. Cell. 2017;171(6):1437–1452.e17.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi: 10.1093/nar/gkv007.
- Langfelder P, Horvath S. WGCNA: an R package for weighted correlation network analysis. BMC Bioinformatics. 2008;9:559. doi: 10.1186/1471-2105-9-559.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–287.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Szklarczyk D, et al. The STRING database in protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Friedman J, Hastie T, Tibshirani R. Regularization paths for generalized linear models via coordinate descent. J Stat Softw. 2010;33(1):1–22.
- Guyon I, Weston J, Barnhill S, Vapnik V. Gene selection for cancer classification using support vector machines. Mach Learn. 2002;46:389–422.
- Breiman L. Random forests. Mach Learn. 2001;45(1):5–32.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. doi: 10.1186/s12859-011-0077-8.
- Stearman RS, et al. Systems analysis of the human pulmonary arterial hypertension lung transcriptome. Am J Respir Cell Mol Biol. 2019;60(6):637–649.
- Crnkovic S, et al. Single-cell transcriptomics reveals skewed cellular communication and phenotypic shift in pulmonary artery remodeling. JCI Insight. 2022;7(20):e153471. doi: 10.1172/jci.insight.153471.
- Hao Y, et al. Integrated analysis of multimodal single-cell data. Cell. 2021;184(13):3573–3587.e29.
- Jin S, et al. Inference and analysis of cell–cell communication using CellChat. Nat Commun. 2021;12(1):1088. doi: 10.1038/s41467-021-21246-9.
- Bustin SA, et al. MIQE 2.0: revision of the Minimum Information for Publication of Quantitative Real-Time PCR Experiments guidelines. Clin Chem. 2025;71(6):634–651.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2−ΔΔCt method. Methods. 2001;25(4):402–408.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51(D1):D1373–D1380.
- Knox C, et al. DrugBank 6.0: the DrugBank Knowledgebase for 2024. Nucleic Acids Res. 2024;52(D1):D1265–D1275.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi: 10.1038/srep42717.
- Burley SK, et al. RCSB Protein Data Bank: powerful new tools for exploring 3D structures of biological macromolecules for basic and applied research and education. Nucleic Acids Res. 2021;49(D1):D437–D451. doi: 10.1093/nar/gkaa1038.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898. doi: 10.1021/acs.jcim.1c00203.
- Liu Y, et al. CB-Dock2: improved protein-ligand blind docking by integrating cavity detection, docking, and homologous template fitting. Nucleic Acids Res. 2022;50(W1):W159–W164. doi: 10.1093/nar/gkac394.
- Duffy JP, et al. The discovery of VX-745: a novel and selective p38α kinase inhibitor. ACS Med Chem Lett. 2011;2(10):758–763.
- Sheng Y, et al. Crocin inhibits neutrophil migration and activation to treat hypoxic pulmonary hypertension through targeting HCK. Phytomedicine. 2025;148:157334. doi: 10.1016/j.phymed.2025.157334.
- Cui H, et al. Leonurine ameliorates hypoxic pulmonary hypertension by inhibiting cross-talk between neutrophils and endothelial cells via SERPINB3 targeting. Int Immunopharmacol. 2026;176:116467. doi: 10.1016/j.intimp.2026.116467.