Questo protocollo guida i principianti della bioinformatica attraverso una pipeline introduttiva di analisi CUT&RUN che consente agli utenti di completare un'analisi iniziale e la convalida dei dati di sequenziamento CUT&RUN. Il completamento delle fasi di analisi qui descritte, in combinazione con l'annotazione dei picchi a valle, consentirà agli utenti di trarre informazioni meccanicistiche sulla regolazione della cromatina.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Analisi introduttiva e convalida dei dati di sequenziamento CUT&RUN
In questo articolo
Sommario
Abstract
La tecnica CUT&RUN facilita il rilevamento delle interazioni proteina-DNA in tutto il genoma. Le applicazioni tipiche di CUT&RUN includono la profilazione delle modifiche della coda degli istoni o la mappatura dell'occupazione della cromatina del fattore di trascrizione. L'adozione diffusa di CUT&RUN è guidata, in parte, dai vantaggi tecnici rispetto al ChIP-seq convenzionale, che includono minori requisiti di input cellulare, minori requisiti di profondità di sequenziamento e una maggiore sensibilità con un segnale di fondo ridotto a causa della mancanza di agenti reticolanti che altrimenti mascherano gli epitopi anticorpali. L'adozione diffusa di CUT&RUN è stata raggiunta anche attraverso la generosa condivisione di reagenti da parte del laboratorio Henikoff e lo sviluppo di kit commerciali per accelerare l'adozione da parte dei principianti. Con l'aumento dell'adozione tecnica di CUT&RUN, l'analisi e la convalida del sequenziamento CUT&RUN diventano colli di bottiglia critici che devono essere superati per consentire la completa adozione da parte di team di laboratorio prevalentemente umidi. L'analisi CUT&RUN inizia in genere con controlli di qualità sulle letture di sequenziamento grezze per valutare la profondità di sequenziamento, la qualità di lettura e le potenziali distorsioni. Le letture vengono quindi allineate a un assemblaggio di sequenze genomiche di riferimento e successivamente vengono impiegati diversi strumenti bioinformatici per annotare le regioni genomiche dell'arricchimento proteico, confermare l'interpretabilità dei dati e trarre conclusioni biologiche. Sebbene siano state sviluppate più pipeline di analisi in silico per supportare l'analisi dei dati CUT&RUN, la loro complessa struttura multi-modulo e l'utilizzo di più linguaggi di programmazione rendono le piattaforme difficili per i principianti della bioinformatica che potrebbero non avere familiarità con più linguaggi di programmazione ma desiderano comprendere la procedura di analisi CUT&RUN e personalizzare le loro pipeline di analisi. Qui, forniamo un protocollo di pipeline di analisi CUT&RUN passo-passo in un'unica lingua, progettato per utenti con qualsiasi livello di esperienza bioinformatica. Questo protocollo include il completamento di controlli di qualità critici per convalidare che i dati di sequenziamento siano adatti all'interpretazione biologica. Ci aspettiamo che seguire il protocollo introduttivo fornito in questo articolo, combinato con l'annotazione dei picchi a valle, consentirà agli utenti di trarre informazioni biologiche dai propri set di dati CUT&RUN.
Introduzione
La capacità di misurare le interazioni tra proteine e DNA genomico è fondamentale per comprendere la biologia della regolazione della cromatina. I saggi efficaci che misurano l'occupazione della cromatina per una data proteina forniscono almeno due informazioni chiave: i) localizzazione genomica e ii) abbondanza proteica in una data regione genomica. Il monitoraggio dei cambiamenti di reclutamento e localizzazione di una proteina di interesse nella cromatina può rivelare loci bersaglio diretti della proteina e rivelare ruoli meccanicistici di quella proteina nei processi biologici basati sulla cromatina come la regolazione della trascrizione, la riparazione del DNA o la replicazione del DNA. Le tecniche oggi disponibili per profilare le interazioni proteina-DNA stanno consentendo ai ricercatori di esplorare la regolazione con una risoluzione senza precedenti. Tali progressi tecnici sono stati resi possibili grazie all'introduzione di nuove tecniche di profilazione della cromatina che includono lo sviluppo di Cleavage Under Targets e Release Using Nuclease (CUT&RUN) da parte del laboratorio Henikoff. CUT&RUN offre diversi vantaggi tecnici rispetto all'immunoprecipitazione convenzionale della cromatina (ChIP), tra cui minori requisiti di input cellulare, minori requisiti di profondità di sequenziamento e maggiore sensibilità con un segnale di fondo ridotto a causa della mancanza di agenti reticolanti che altrimenti mascherano gli epitopi anticorpali. L'adozione di questa tecnica per studiare la regolazione della cromatina richiede una comprensione approfondita del principio alla base della tecnica e una comprensione di come analizzare, convalidare e interpretare i dati CUT&RUN.
La procedura CUT&RUN inizia con il legame delle cellule alla concanavalina A coniugata a perline magnetiche per consentire la manipolazione di un basso numero di cellule durante tutta la procedura. Le cellule isolate vengono permeabilizzate utilizzando un detergente delicato per facilitare l'introduzione di un anticorpo che prende di mira la proteina di interesse. La nucleasi micrococcica (MNasi) viene quindi reclutata nell'anticorpo legato utilizzando un tag di proteina A o proteina A/G legato all'enzima. Il calcio viene introdotto per avviare l'attività enzimatica. La digestione della MNasi produce complessi DNA-proteina mononucleosomiali. Il calcio viene successivamente chelato per terminare la reazione di digestione e brevi frammenti di DNA dalla digestione della MNasi vengono rilasciati dai nuclei, quindi sottoposti a purificazione del DNA, preparazione della libreria e sequenziamento ad alto rendimento1 (Figura 1).
Gli approcci in silico per mappare e quantificare l'occupazione delle proteine in tutto il genoma si sono sviluppati in parallelo con gli approcci di laboratorio utilizzati per arricchire tali interazioni DNA-proteina. L'identificazione delle regioni dei segnali arricchiti (picchi) è uno dei passaggi più critici nell'analisi bioinformatica. I metodi iniziali di analisi ChIP-seq utilizzavano algoritmi come MACS2 e SICER3, che impiegavano modelli statistici per distinguere i siti di legame proteina-DNA dal rumore di fondo. Tuttavia, il rumore di fondo inferiore e la maggiore risoluzione dei dati CUT&RUN rendono alcuni programmi di chiamata di picco impiegati nell'analisi ChIP-seq inadatti per l'analisi CUT&RUN4. Questa sfida evidenzia la necessità di nuovi strumenti più adatti all'analisi dei dati CUT&RUN. SEACR4 rappresenta uno di questi strumenti recentemente sviluppato per consentire la chiamata di picco dai dati CUT&RUN, superando al contempo le limitazioni associate agli strumenti tipicamente impiegati per l'analisi ChIP-seq.
Le interpretazioni biologiche dei dati di sequenziamento CUT&RUN sono tratte dagli output a valle della chiamata dei picchi nella pipeline di analisi. Diversi programmi di annotazione funzionale possono essere implementati per prevedere la potenziale rilevanza biologica dei picchi chiamati dai dati CUT&RUN. Ad esempio, il progetto Gene Ontology (GO) fornisce un'identificazione funzionale ben consolidata dei geni di interesse 5,6,7. Vari strumenti software e risorse facilitano l'analisi OB per rivelare geni e set di geni arricchiti tra i picchi CUT&RUN 8,9,10,11,12,13,14. Inoltre, software di visualizzazione come Deeptools15, Integrative genomics viewer (IGV)16 e UCSC Genome Browser17 consentono la visualizzazione della distribuzione del segnale e dei modelli nelle regioni di interesse del genoma.
La capacità di trarre interpretazioni biologiche dai dati CUT&RUN dipende in modo critico dalla convalida della qualità dei dati. I componenti critici da convalidare includono la valutazione di: i) qualità del sequenziamento della libreria CUT&RUN, ii) somiglianza della replica e iii) distribuzione del segnale nei centri di picco. Il completamento della convalida di tutti e tre i componenti è fondamentale per garantire l'affidabilità dei campioni della libreria CUT&RUN e dei risultati delle analisi a valle. Pertanto, è essenziale stabilire guide introduttive all'analisi CUT&RUN per consentire ai principianti della bioinformatica e ai ricercatori di laboratorio di condurre tali fasi di convalida come parte delle loro pipeline di analisi CUT&RUN standard.
Oltre allo sviluppo dell'esperimento CUT&RUN in wet lab, sono state sviluppate varie pipeline di analisi CUT&RUN in silico, come CUT&RUNTools 2.018,19, nf-core/cutandrun20 e CnRAP21, per supportare l'analisi dei dati CUT&RUN. Questi strumenti forniscono approcci efficaci all'analisi di set di dati CUT&RUN e CUT&Tag a cella singola e in blocco. Tuttavia, la struttura del programma modulare relativamente complessa e la familiarità richiesta con più linguaggi di programmazione per condurre queste pipeline di analisi possono ostacolare l'adozione da parte dei principianti della bioinformatica che cercano di comprendere a fondo le fasi di analisi CUT&RUN e personalizzare le proprie pipeline. L'elusione di questa barriera richiede una nuova pipeline introduttiva di analisi CUT&RUN fornita in semplici script passo-passo codificati utilizzando un semplice linguaggio di programmazione singolo.
In questo articolo, descriviamo un semplice protocollo di pipeline di analisi CUT&RUN in un unico linguaggio che fornisce script passo-passo supportati da descrizioni dettagliate per consentire agli utenti nuovi e inesperti di condurre analisi di sequenziamento CUT&RUN. I programmi utilizzati in questa pipeline sono disponibili pubblicamente dai gruppi di sviluppatori originali. Le fasi principali descritte in questo protocollo includono l'allineamento di lettura, la chiamata dei picchi, l'analisi funzionale e, soprattutto, le fasi di convalida per valutare la qualità del campione per determinare l'idoneità e l'affidabilità dei dati per l'interpretazione biologica (Figura 2). Inoltre, questa pipeline offre agli utenti l'opportunità di incrociare i risultati dell'analisi con i set di dati CUT&RUN disponibili pubblicamente. In definitiva, questo protocollo di pipeline di analisi CUT&RUN funge da guida introduttiva e riferimento per i principianti dell'analisi bioinformatica e per i ricercatori di laboratorio umido.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
NOTA: Le informazioni per i file fastq CUT&RUN in GSE126612 sono disponibili nella Tabella 1. Le informazioni relative alle applicazioni software utilizzate in questo studio sono elencate nella Tabella dei materiali.
1. Download della pipeline Easy-Shells_CUTnRUN dalla sua pagina Github
- Aprire il terminale dal sistema operativo.
NOTA: Se l'utente non è sicuro di come aprire il terminale in macOS e Windows, riview questa pagina web (https://discovery.cs.illinois.edu/guides/System-Setup/terminal/). Per Linux, consulta questa pagina Web (https://www.geeksforgeeks.org/how-to-open-terminal-in-linux/). - Scarica la pipeline di analisi compressa da Github digitando wget https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/archive/refs/heads/main.zip -O ~/Desktop/Easy-Shells_CUTnRUN.zip nel terminale.
- Dopo aver scaricato il file zip, decomprimi il file zip scaricato digitando unzip ~/Desktop/Easy-Shells_CUTnRUN.zip -d ~/Desktop/ nel terminale.
- Dopo la decompressione, eliminare il file zip digitando rm ~/Desktop/Easy-Shells_CUTnRUN.zip nel terminale e modificare il nome della cartella digitando mv ~/Desktop/Easy-Shells_CUTnRUN-master ~/Desktop/Easy-Shells_CUTnRUN.
- Dopo aver rimosso il file zippato, digita chmod +x ~/Desktop/Easy-Shells_CUTnRUN/script/*.sh nel terminale per impostare l'autorizzazione eseguibile per tutti gli script di shell all'interno della directory di lavoro. D'ora in poi, basta digitare il percorso e il nome di questi script di shell nel terminale o trascinare gli script nel terminale e inviare per eseguire questi script di shell nel terminale.
NOTA: la shell Bash è in genere preinstallata sulla maggior parte delle distribuzioni Linux. Tuttavia, le versioni recenti di macOS non forniscono più la shell Bash preinstallata. Se il sistema non dispone di Bash, installare prima la shell Bash. Visita i link sottostanti per istruzioni che descrivono come installare la shell Bash in Linux OS (https://ioflood.com/blog/install-bash-shell-linux/) e macOS (https://www.cs.cornell.edu/courses/cs2043/2024sp/styled-3/#:~:text=The first thing you will,you will see the following:). Questi script di shell passo-passo sono scritti per creare una cartella ~/Desktop/GSE126612 per eseguire la maggior parte di questa analisi CUT&RUN all'interno di questa directory senza alcuna necessità di modifiche. Se l'utente comprende come utilizzare questi script di shell, gli utenti possono rivedere e personalizzare questi script di shell per analizzare altri set di dati CUT&RUN e modificare le opzioni in base alle esigenze specifiche del progetto. Per leggere e modificare questi script della shell, è consigliabile utilizzare Visual Studio Code (https://code.visualstudio.com/) come opzione per un programma di facile utilizzo disponibile per i principali sistemi operativi.
2. Installazione dei programmi necessari per Easy Shells CUTnRUN
- Tra gli script di shell con il nome di Script_01_installation_***.sh, scopri lo script di shell il cui nome include il tipo di sistema operativo del sistema dell'utente. Attualmente, Easy Shells CUTnRUN supporta lo script di installazione per i sistemi basati su macOS, Debian/Ubuntu e CentOS/RPM.
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Nel terminale, azionare lo script della shell di installazione digitando ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_01_installation_***.sh o trascinare il file dello script della shell nel terminale e inserire.
- Leggi il file Test_README.md nella cartella /path/to/SEACR-1.3/Testfiles. Seguire le istruzioni all'interno del file README per chiarire se il SEACR nel sistema dell'utente funziona correttamente.
NOTA: È fondamentale convalidare la funzione SEACR con i file di test forniti dalla pagina Github di SEACR per ottenere risultati di chiamata di picco corretti dai dati CUT&RUN. Pertanto, seguire le istruzioni di Test_README.md in /path/to/SEACR-1.3/Testfiles subito dopo l'installazione di SEACR. Sebbene Easy Shells CUTnRUN fornisca script di shell di installazione per alcuni sistemi operativi, questi script potrebbero non funzionare nel sistema di alcuni utenti per installare tutti i programmi necessari per Easy Shells CUTnRUN. In caso di problemi durante l'installazione, consultare il sito Web originale del programma disinstallato o richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
3. Scaricare il set di dati CUT&RUN disponibile pubblicamente da Sequence Read Archive (SRA)
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_02_download-fastq.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA:Questo script: (i) creerà una cartella (~/Desktop/GSE126612/fastq) e scaricherà un elenco di file SRA scritti in un file di testo (~/Desktop/Easy-Shells_CUTnRUN/sample_info/SRR_list.txt) all'interno della cartella fastq. Ad esempio, il SRR_list.txt include i file fastq di un sottoinsieme di campioni CUT&RUN GSE126612. (ii) Scaricare i file fastq grezzi all'interno della cartella fastq. (iii) Creare una cartella (~/Desktop/GSE126612/log/fastq) e annotare un file di registro (download-fastq_log.txt) e un file di informazioni di esempio scaricato (SRR_list_info.txt) all'interno di questa cartella di registro. - Dopo aver eseguito lo script, controllare il file di registro. Se viene visualizzato un messaggio di errore all'interno del file di registro, correggere l'errore e riprovare il passaggio 3.3. Se c'è qualche problema per risolvere il problema, chiedi aiuto nella pagina web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Per facilitare la pratica di questa pipeline di analisi CUT&RUN, vengono recuperati dall'SRA i seguenti campioni pubblicamente disponibili: un campione dal controllo simulato (IgG), tre campioni di una proteina dell'architettura della cromatina e del fattore di trascrizione (CTCF), quattro campioni corrispondenti a un segno istonico "attivo" (H3K27Ac) e tre campioni corrispondenti a regioni di inizio trascrizionale contrassegnate dalla RNA polimerasi II (RNAPII-S5P). Il sequenziamento è stato eseguito come paired-end, pertanto vengono accoppiati due file per campione.
4. Controllo di qualità iniziale per i file di sequenziamento grezzi
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_03_fastQC.sh nel terminale o trascina lo script della shell nel terminale e invio.
NOTA: Questo script di shell: (i) Eseguirà il programma FastQC per tutti i file fastq grezzi nella cartella ~/Desktop/GSE126612/fastq e salverà i file del rapporto di controllo qualità nella cartella ~/Desktop/GSE126612/fastqc.1st . (ii) Annotare un file di registro (fastqc.1st.log.SRR-number.txt) per un'esecuzione di FastQC in una cartella di registro (~/Desktop/GSE126612/log/fastqc.1st). - Al termine dell'esecuzione dello script della shell, esaminare il file di log per chiarire il successo dell'esecuzione. Se è presente un messaggio di errore all'interno del file di registro, correggere l'errore e ripetere il passaggio 4.3. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Tra i file di output, fastqc.html file includono risultati di controllo qualità di facile utilizzo. In caso di gravi problemi di qualità, discutere con i colleghi di bioinformatica per determinare l'idoneità dei dati per l'analisi a valle. Rapporti di controllo qualità simili vengono utilizzati per confermare il miglioramento della qualità dei dati dopo il taglio dell'adattatore. Per utilizzare questo script per altri set di dati, modificare il percorso delle directory di lavoro e di output per soddisfare le esigenze dell'utente. Una differenza notevole nell'interpretazione del controllo qualità di CUT&RUN rispetto alle letture ChIP-seq è che le letture duplicate in CUT&RUN non indicano necessariamente duplicati PCR. Questo perché la MNasi reclutata digerisce nelle stesse posizioni o in posizioni simili all'interno di gruppi sperimentali.
5. Qualità e ritaglio dell'adattatore per i file di sequenziamento non elaborati
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_04_trimming.sh nel terminale o trascina lo script Script_04_trimming.sh nel terminale e inserisci.
NOTA: Questo script di shell: (i) Eseguirà il programma Trim-Galore per tutti i file fastq grezzi in ~/Desktop/GSE126612/fastq per eseguire il ritaglio dell'adattatore e della qualità. (ii) Creare una cartella (~/Desktop/GSE126612/trimmed) e salvare i file di output di Trim-Galore all'interno della cartella tagliata. (iii) Creare una cartella di log (~/Desktop/GSE126612/log/trim_galore) e annotare un file di log trim_galore_log_RSS-number.txt per ogni esecuzione di Trim-Galore. - Al termine dell'esecuzione, esaminare attentamente il file di registro. Se è presente un messaggio di errore all'interno del file di registro, correggere l'errore e ripetere il passaggio 5.3. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
- Al termine di questo processo, confrontare i file di output .html con i file fastqc.html creati nella versione 4.3. Rivedere il percorso delle directory di input e output per eseguire il passaggio di taglio per tutti i file fastq che si trovano altrove.
6. Download dell'indice bowtie2 per i genomi di riferimento per i campioni di controllo effettivi e spike-in
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_05_bowtie2-index.sh nel terminale o trascina lo script della shell nel terminale e invio.
NOTA: Questo script: (i) Scaricherà gli indici Bowtie2 per i genomi di riferimento del campione effettivo (umano; hg19; utilizzato nella pubblicazione originale22) e i genomi di riferimento di controllo Spike-in (lievito in gemmazione; R64-1-1) nella cartella bowtie2-index (~/Desktop/Easy-Shells_CUTnRUN/bowtie2-index). (iii) Annota un file di log (bowtie2-index-log.txt) in una directory di log (~/Desktop/GSE126612/log/bowtie2-index). - Al termine dell'esecuzione, controllare il file di registro. Se viene visualizzato un messaggio di errore, correggere l'errore e ripetere il passaggio 6.3. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Attualmente, gli indici Bowtie2 per vari genomi di riferimento sono forniti nel sito web di Bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml). Gli utenti possono modificare Script_05_bowtie2-index.sh per scaricare qualsiasi indice Bowtie2 per soddisfare le esigenze dell'utente. Se l'utente non riesce a individuare l'indice Bowtie2 del genoma di riferimento di interesse, individuare i file fasta della sequenza del genoma di riferimento da:- Ensembl ftp (https://ftp.ensembl.org/pub/current_fasta/)
- Pagina web dell'UCSC (https://hgdownload.soe.ucsc.edu/downloads.html)
- o altre banche dati specie-specifiche.
Dopo aver individuato i file fasta della sequenza del genoma di riferimento, creare un indice Bowtie2 per il genoma di riferimento scaricato seguendo la sezione "The bowtie2-build indexer" (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-build-indexer) del sito Web Bowtie2.
7. Mappatura delle letture di sequenziamento CUT&RUN tagliate sui genomi di riferimento
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_06_bowtie2-mapping.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script di shell: (1) Eseguirà il programma bowtie2 per mappare tutti i file fastq tagliati di qualità e adattatore sia al controllo sperimentale (umano; hg19) che al controllo spike-in (lievito in gemmazione; R64-1-1) fanno riferimento ai genomi in modo indipendente. (ii) Eseguire la funzione di visualizzazione samtools per comprimere i file di coppie di lettura mappati in formato bam. (iii) Creare una cartella (~/Desktop/GSE126612/bowtie2-mapped) e salvare il file di coppie di lettura mappato compresso all'interno della cartella bowtie2-mapped. (iv) Creare una cartella (~/Desktop/GSE126612/log/bowtie2-mapped) e annotare il registro del processo di mappatura come file di testo bowtie2_log_hg19_SRR-number.txt per le coppie di lettura mappate sul genoma di riferimento hg19 e bowtie2_log_R64-1-1_SRR-number.txt per le coppie di lettura mappate su R64-1-1) per indicare l'efficienza della mappatura all'interno della cartella del registro di mappatura bowtie2. - Al termine dell'esecuzione, controllare il file di registro. Se è presente un messaggio di errore all'interno del file di registro, correggere l'errore ed eseguire nuovamente lo script della shell. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Questo script di shell esegue bowtie2 con opzioni per mappare i file di sequenziamento paired-end per trovare coppie di lettura mappate in modo concorde con lunghezze di frammento da 10 bp-700 bp. Scopri le descrizioni delle opzioni digitando bowtie2 --help nel terminale o visitando il sito web di bowtie2 (https://bowtie-bio.sourceforge.net/bowtie2/manual.shtml#the-bowtie2-aligner) per capire e modificare le opzioni secondo necessità. Utilizzare questo script di shell per mappare qualsiasi altro file fastq modificando il percorso e il formato del nome dei file fastq e degli indici Bowtie2.
8. Ordinamento e filtraggio dei file delle coppie di lettura mappati
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando "chsh -s $(which bash)" nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_07_filter-sort-bam.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script: (i) Eseguirà la funzione di visualizzazione samtools per tutti i file di coppie di lettura mappati compressi nella cartella ~/Desktop/GSE126612/bowtie2-mapped per filtrare le coppie di lettura mappate in regioni cromosomiche non canoniche, blacklist annotate pubblicamente e regioni di ripetizione TA. (ii) Eseguire la funzione di ordinamento samtools per ordinare i file bam filtrati in base ai nomi dei frammenti o alle coordinate all'interno della stessa directory. (iii) Annotare un file di log per un file bam di input nella directory ~/Desktop/GSE126612/log/filter-sort-bam . - Al termine dell'esecuzione, esaminare attentamente i file di registro. Se viene visualizzato un messaggio di errore nei file di registro, correggere l'errore e provare a eseguire nuovamente lo script della shell. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: I file bam (output) risultanti ordinati in base ai nomi dei frammenti serviranno come file di input per creare file bedGraph BED e readcount grezzi dei frammenti. I file bam ordinati per coordinate serviranno come file di input per generare file BEDPE di frammenti. Tutti i BED, bedGraph e BEDPE verranno utilizzati per la chiamata e la visualizzazione dei picchi nell'analisi a valle. Tutti i file del letto di annotazione per le regioni cromosomiche canoniche (chr1~22, chrX, chrY e chrM), le regioni blacklistannotate pubblicamente 23 e le regioni di ripetizione TA18 si trovano nella directory ~/Desktop/Easy-Shells_CUTnRUN/blacklist . Se necessario, utilizzare questa directory per aggiungere ulteriori file di blacklist. Utilizzare questo script di shell per eseguire le stesse funzioni per altri file bam di coppie di lettura mappate modificando il percorso e il nome dei file bam. Digita samtools view --help e samtools sort --help nel terminale per ulteriori descrizioni su queste funzioni.
9. Converti le coppie di lettura mappate in file bedGraph di frammenti BEDPE, BED e conteggi di lettura grezzi bedGraph
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_08_bam-to-BEDPE-BED-bedGraph.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script: (i) Eseguirà la funzione filterdup e awk di macs3 per convertire i file bam ordinati per coordinate in file BEDPE frammentati la cui lunghezza dei frammenti è inferiore a 1kb, e salverà i file BEDPE in ~/Desktop/GSE126612/BEDPE. (ii) Creare una directory di log (~/Desktop/GSE126612/log/bam-to-BEDPE) e annotare un file di log per ogni file di frammenti di letture mappate. (iii) Eseguire le funzioni bamtobed e awk, cut, sort di bedtools per convertire i file bam ordinati per nome dei frammenti in file BED di frammenti la cui lunghezza dei frammenti è inferiore a 1 kb. (iv) Creare una cartella (~/Desktop/GSE126612/bam-to-bed) e salvare i file BED del frammento all'interno della cartella bam-to-bed. (v) Annotare un file di log per ogni file BED di frammenti di letture mappate in una directory di log (~/Desktop/GSE126612/log/bam-to-bed). (vi) Eseguire la funzione genomecov di bedtools per generare i file bedGraph di readcount grezzi utilizzando i file BED di frammento in una cartella (~/Desktop/GSE126612/bedGraph). - Al termine dell'esecuzione, controllare attentamente i file di registro. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: I file bedGraph dei conteggi di lettura grezzi di output verranno utilizzati come file di input per il programma di chiamata di picco SEACR con l'opzione di normalizzazione nella sezione 12 e la normalizzazione SFRC (Scaled Fractional Readcount)22 nella sezione 10. I file BED dei frammenti serviranno come file di input per le letture normalizzate Spike-in per milione di letture mappate nella normalizzazione del controllo negativo (SRPMC)24,25 nella sezione 10.To acquisire frammenti brevi (>100 bp) solo per i dati CUT&RUN dei fattori associati alla cromatina, modificare il passaggio di filtrazione dei frammenti in questo script e procedere con la fase di normalizzazione. Per confrontare i segnali CUT&RUN tra frammenti di dimensioni corte e regolari all'interno dello stesso campione, la normalizzazione SFRC può essere utile per ridurre il potenziale effetto di downsampling causato dall'acquisizione solo di frammenti corti. Utilizzare questo script di shell per eseguire gli stessi processi per altri file bam ordinati in sequenza paired-end modificando il percorso e il formato del nome dei file bam e bed.
10. Conversione dei file bedGraph rawcount in file bedGraph e bigWig normalizzati
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SFRC.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire for-loop con la funzione awk per creare file bedGraph normalizzati SFRC utilizzando i file bedGraph rawcounts readcounts all'interno di ~/Desktop/GSE126612/bedGraph. (ii) Eseguire la funzione bedGraphToBigWig per creare il formato compresso (.bw) dei file bedGraph normalizzati SFRC in ~/Desktop/GSE126612/bigWig. (iii) Annotare un file di log per registrare il fattore di normalizzazione utilizzato per il calcolo SFRC per un'esecuzione e salvare il file di log all'interno di ~/Desktop/GSE126612/log/SFRC. - Al termine dell'esecuzione, controllare i file di registro. Se viene visualizzato un messaggio di errore, correggere l'errore ed eseguire nuovamente lo script della shell. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: La normalizzazione del conteggio dei readcount frazionari in scala è stata utilizzata nella pubblicazione originale22 del set di dati CUT&RUN GSE126612. La formula della normalizzazione in bin i è la stessa di seguito: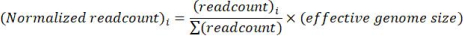
Poiché questo metodo di normalizzazione non include la normalizzazione con controllo negativo (ad esempio, campione IgG) né il controllo spike-in, questo approccio potrebbe non essere l'ideale per osservare la differenza di segnale a livello di genoma tra i campioni. Tuttavia, poiché questo metodo è teoricamente simile ad altre normalizzazioni basate su readcount totali (ad esempio, conteggio per milione), sarebbe sufficiente osservare la differenza di segnale locale tra i campioni. - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_09_normalization_SRPMC.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script: (i) Eseguirà for-loop con la funzione genomecov di bedtools per creare file bedgraph normalizzati SRPMC in ~/Desktop/GSE126612/bedGraph utilizzando i file BED di frammento in ~/Desktop/GSE126612/bam-to-bed. (ii) Annotare un file di registro per registrare i fattori di normalizzazione utilizzati per la normalizzazione SRPMC per un'esecuzione in ~/Desktop/GSE126612/log/SRPMC. (iii) Eseguire la funzione bedGraphToBigWig per creare il formato compresso (.bw) dei file bedGraph normalizzati e salvare i file bigWig normalizzati nella cartella ~/Desktop/GSE126612/bigWig . - Al termine dell'esecuzione, esaminare attentamente i file di registro. Se è presente un messaggio di errore all'interno dei file di registro, correggere l'errore ed eseguire nuovamente lo script della shell. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: La formula della normalizzazione SRPMC è stata sviluppata per normalizzare i conteggi effettivi dei campioni di lettura sia con controllo negativo (campione IgG, ad esempio) che con controllo spike-in combinando il fattore di normalizzazione RPM (letture per milione di letture mappate), RPS (rapporto letture per lettura spike-in) e rapporto del segnale relativo per controllare24,25. La definizione di RPS è la stessa di seguito:
Applicando RPS sia per il campione effettivo che per il campione di controllo negativo, il rapporto del segnale relativo (RS) al controllo del campione effettivo può essere calcolato come segue: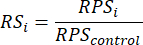
E la definizione del fattore di normalizzazione RPM (RPM:NF) è la stessa di seguito: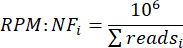
Da qui, il fattore di normalizzazione SRPMC (SRPMC:NF) è emerso combinando insieme RS e RPM:NF: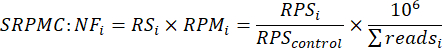
E questa formula può essere semplificata come di seguito:
Pertanto, il metodo SRPMC normalizza le letture in base al rapporto (1) tra le letture di picco tra il controllo e il campione e (2) le letture di controllo normalizzate RPM. Poiché questo fattore di normalizzazione considera le letture spike-in e rende le letture di controllo comparabili tra i campioni, questo metodo sarebbe appropriato per osservare la differenza a livello di genoma tra i campioni e ridurre l'effetto batch nelle letture totali dei campioni effettivi e dei controlli in diversi esperimenti batch. Questi file bedGraph normalizzati diventeranno file di input per chiamare i picchi utilizzando SEACR nella sezione 11. E questi file bigWig normalizzati verranno utilizzati nella visualizzazione dei loci tramite IGV e nella creazione di mappe di calore e grafici medi tramite Deeptools. Si consiglia vivamente di utilizzare un browser genomico per visualizzare il modello del panorama del set di dati CUT&RUN utilizzando i file bigWig normalizzati in regioni genomiche rappresentative per valutare la qualità dei dati. I campioni CUT&RUN che mostrano modelli di segnale di fondo rumorosi che assomigliano al controllo IgG sono probabilmente appropriati da omettere per le analisi a valle. Utilizzare questi script di shell per normalizzare altri file bed di lettura e i file bedGraph di readcount non elaborati modificando il percorso e i nomi dei file per i file bed e bedgraph di input e output. Modificare questi script per applicare altri calcoli di normalizzazione modificando i fattori e la formula all'interno di questo script.
11. Convalida della distribuzione delle dimensioni dei frammenti
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_10_insert-size-analysis.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script viene scritto per: (i) Eseguire picard.jar funzione CollectInsertSizeMetrics utilizzando i file bam delle coppie di lettura mappate nella cartella ~/Desktop/GSE126612/filtered-bam per identificare la distribuzione delle dimensioni dell'inserto. (ii) Creare una cartella (~/Desktop/GSE126612/insert-size-distribution) e salvare i risultati dell'analisi della distribuzione delle dimensioni dell'inserto nella cartella creata. (iii) Annotare un file di log per un file bam di input nella cartella ~/Desktop/GSE126612/log/insert-size-distribution . - Al termine dell'esecuzione, controllare attentamente i file di registro. Se viene visualizzato un messaggio di errore all'interno dei file di registro, correggere l'errore e provare a eseguire nuovamente lo script della shell. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: In generale, l'analisi delle dimensioni dell'inserto (Output) per i campioni CUT&RUN mostra picchi importanti a intervalli di dimensioni nucleosomiali mono- (100-300 bp) e di- (300-500 bp). Errori/limitazioni tecniche (come la sovra/sottodigestione della MNasi durante la preparazione del campione CUT&RUN o la selezione impropria delle dimensioni durante la preparazione della libreria) possono causare l'arricchimento di frammenti trinucleosomici uguali o più grandi (500-700 bp) e uguali o più corti di frammenti subnucleosomici (<100 bp). A volte l'assenza di picchi di dimensioni mononucleosomiche con l'arricchimento dei frammenti lunghi (>500 bp) e corti (<100 bp) può essere dovuta a intervalli di selezione delle dimensioni della libreria scelti nella fase di laboratorio umido o a una bassa profondità di sequenziamento. Confronta la profondità di sequenziamento ("basi sequenziate totali" / "dimensione totale del genoma di riferimento"), la panoramica del panorama genomico utilizzando i file bigWig readcount normalizzati nella sezione 10 e il modello di distribuzione delle dimensioni degli inserti per chiarire la qualità dei campioni CUT&RUN elaborati. Le linee tratteggiate negli istogrammi rappresentano la "frazione cumulativa" di letture con una dimensione dell'inserto maggiore o uguale al valore sull'asse x. Questa linea tratteggiata consente l'identificazione della distribuzione delle dimensioni degli inserti nel file di lettura mappato in input. La progressione lungo l'asse x è associata all'aumento delle dimensioni dell'inserto. La linea tratteggiata identifica la proporzione di coppie di lettura mappate nel file bam di input che hanno una dimensione di inserimento almeno pari a quella indicata nella posizione dell'asse x intersecante. Pertanto, l'interpretazione inizia da 1 a sinistra, indicando che tutte le letture hanno una dimensione dell'inserto maggiore o uguale alla dimensione più piccola, e diminuisce verso 0 all'aumentare della dimensione dell'inserto.
12. Chiamare i picchi utilizzando MACS2, MACS3 e SEACR
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_MACS.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire le funzioni macs2 callpeak e macs3 callpeak con e senza controllo IgG utilizzando i file BEDPE di frammento per chiamare i picchi e salvare i risultati delle chiamate di picco nelle directory di output (~/Desktop/GSE126612/MACS2 e ~/Desktop/GSE126612/MACS3). (ii) Annotare il log di queste chiamate di picco come file di testo nella directory dei log (~/Desktop/GSE126612/log/MACS2 e ~/Desktop/GSE126612/log/MACS3) - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_11_peak-calling_SEACR.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire SEACR_1.3.sh script con e senza controllo IgG, con opzioni rigorose e rilassate utilizzando i file bedGraph e bedGraph normalizzati per chiamare i picchi. (ii) Creare una directory di output (~/Desktop/GSE126612/SEACR-peaks) e salvare i risultati della chiamata dei picchi da parte di SEACR. (iii) Annotare il registro di queste chiamate di picco come file di testo nella directory del registro (~/Desktop/GSE126612/log/SEACR). - Dopo aver completato l'esecuzione degli script della shell, controllare attentamente i file di registro. Se nei file di registro è presente un messaggio di errore, correggere prima l'errore. Alcuni programmi potrebbero non chiamare insieme i picchi per il campione di controllo IgG con l'opzione di controllo IgG, quindi omettono il messaggio di errore relativo al campione di controllo IgG con l'opzione di controllo IgG. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Questi due script di shell eseguono la chiamata di picco per campioni CUT&RUN utilizzando tre chiamanti di picco (MACS2, MACS3 e SEACR) con varie opzioni: con/senza opzione di controllo IgG, utilizzando i file bedGraph di readcount grezzi con l'opzione di normalizzazione del chiamante di picco o i file bedGraph readcount normalizzati senza l'opzione di normalizzazione del chiamante di picco e opzioni di chiamata di picco SEACR rigorose e rilassate. Poiché i file di output di chiamata dei picchi non sono sufficienti per essere utilizzati direttamente nelle analisi a valle, CUTnRUN di Easy Shells include uno script per elaborare questi file di output chiamati picchi per creare nuovi file di picco che includono cromosoma, inizio, fine e nome dei picchi. Attraverso approcci intensivi di chiamata di picco, Easy Shells CUTnRUN offre l'opportunità di scegliere il programma di chiamata di picco più adatto per il progetto CUT&RUN di un utente, confrontando i picchi chiamati tra tre chiamanti di picco. Inoltre, questa pipeline di analisi CUT&RUN offre anche l'opportunità di selezionare le opzioni di peak calling più adatte per il progetto CUT&RUN di un utente. Questi confronti saranno effettuati tramite diagramma di Venn e visualizzazione come mappa di calore e grafico medio.
13. Creazione di file di picco chiamati
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_12_make-peak-bed.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script è scritto per: (i) Eseguire la funzione awk utilizzando i file bed nella cartella ~/Desktop/GSE126612/SEACR per creare due tipi di file peak bed SEACR ~/Desktop/GSE126612/peak-bed_SEACR cartella. I file del letto di picco includono l'inizio e la fine di ciascun picco, mentre i file del letto di picco focalizzati includono l'inizio e il letto del contenitore del segnale più alto all'interno di ciascun picco. (ii) Eseguire la funzione awk utilizzando i file _peaks.xls nelle cartelle ~/Desktop/GSE126612/MACS2 e ~/Desktop/GSE126612/MACS3 per creare interi file peak bed che includono l'inizio e la fine di ogni picco chiamato da MACS2 e MACS3 nelle cartelle ~/Desktop/GSE126612/peak-bed_MACS2 e ~/Desktop/GSE126612/peak-bed_MACS3 . (iii) Eseguire la funzione awk utilizzando i file _summits.bed nelle cartelle ~/Desktop/GSE126612/MACS2 e ~/Desktop/GSE126612/MACS3 per creare file di peak bed focalizzati che includono l'inizio e la fine del bin più significativo all'interno di ciascun picco. (iv) I file di registro sono scritti in formato di file di testo nella cartella ~/Desktop/GSE126612/log/peak-bed . - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_13_filter-peaks.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script è scritto per: (i) Eseguire la funzione di intersezione dei bedtools utilizzando i file del letto di picco che vengono chiamati senza l'opzione di controllo IgG per rimuovere i picchi sovrapposti ai picchi di controllo IgG. (ii) I file filtrati del peak bed vengono salvati nelle cartelle ~/Desktop/GSE126612/peak-bed-filtered_MACS2, ~/Desktop/GSE126612/peak-bed-filtered_MACS3 e ~/Desktop/GSE126612/peak-bed-filtered_SEACR . (iii) Viene creato un file di registro log_filter-peaks.txt nella cartella ~/Desktop/GSE126612/log/filter-peaks . - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_MACS.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script è scritto per: (i) Eseguire le funzioni cat e sort per concatenare i file MACS2 e MACS3 interi peak bed delle repliche come un unico file peak bed e ordinare il file peak bed concatenato nella cartella ~/Desktop/GSE126612/bed-for-comparison . (ii) Eseguire la funzione di unione bedtools utilizzando i file interi del letto di picco concatenati per unire i picchi che si sovrappongono l'uno all'altro. (iii) Un file di registro log_cat-merged-peak-bed_MACS.txt viene scritto nella cartella di registro ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_14_cat-merge-peak-bed_SEACR.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire le funzioni cat e sort per concatenare i file SEACR interi peak bed delle repliche come un unico file peak bed e ordinare il file peak bed concatenato nella cartella ~/Desktop/GSE126612/bed-for-comparison . (ii) Eseguire la funzione di unione bedtools utilizzando i file interi del letto di picco concatenati per unire i picchi che si sovrappongono l'uno all'altro. (iii) Un file di registro log_cat-merged-peak-bed_SEACR.txt è scritto nella cartella di registro ~/Desktop/GSE126612/log/cat-merged-peak-bed. - Dopo aver completato l'esecuzione degli script della shell, esaminare attentamente i file di registro. Se viene visualizzato un messaggio di errore nei file di registro, correggere l'errore ed eseguire nuovamente gli script. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: I file del letto di picco di intere regioni di picco verranno utilizzati come file di input dell'analisi del diagramma di Venn per confrontare la somiglianza tra le opzioni di richiamo dei picchi, i metodi di chiamata dei picchi, le repliche e le osservazioni del paesaggio genomico vicino alle regioni di picco. I file del letto di picco delle regioni di picco unite verranno utilizzati per l'analisi dei componenti principali (PC) e l'analisi della correlazione dei coefficienti di Pearson utilizzando deeptools. I file del letto di picco focalizzati verranno utilizzati per l'analisi della mappa di calore e del grafico medio utilizzando Deeptools.
14. Convalida della somiglianza tra le repliche utilizzando la correlazione di Pearson e l'analisi delle componenti principali (PC).
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, gli utenti potrebbero vedere quanto segue: /path/to/bash (o un messaggio simile come /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come impostazione predefinita, ignorare questo passaggio.
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotCorrelation.sh nel terminale o trascina il file di script della shell nel terminale e inserisci.
NOTA: Questo script è scritto per: (i) Eseguire la funzione multiBamSummary BED-file utilizzando i file bam delle repliche, che sono stati ordinati per coordinata, e unire interi file di picco per CTCF, H3K27Ac e RNAPII-S5P per generare file matrice per l'analisi della correlazione Pearson nella cartella Desktop/GSE126612/deeptools_multiBamSummary . (ii) Eseguire la funzione plotCorrelation utilizzando i file matrice per eseguire il calcolo del coefficiente di correlazione Pearson e il clustering della mappa di calore e salvare il risultato nella cartella ~/Desktop/GSE126612/deeptools_plotCorrelation . (iii) Annotare un file di registro log_plotCorrelation.txt nella cartella ~/Desktop/GSE126612/log/correlation . - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_15_correlation_plotPCA.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire la funzione multiBamSummary BED-file utilizzando i file bam, che sono stati ordinati per coordinate, e unire interi file del letto di picco, che includono tutti i picchi CTCF, H3K27ac e RNAPII-S5P, per generare file matrice per l'analisi dei componenti principali (PCA) nella cartella Desktop/GSE126612/deeptools_multiBamSummary . (ii) Eseguire la funzione plotPCA utilizzando i file matrice per eseguire la PCA e salvare il risultato nella cartella ~/Desktop/GSE126612/deeptools_plotPCA . (iii) Annotare un file di registro log_plotPCA.txt nella cartella ~/Desktop/GSE126612/log/correlation . - Dopo aver completato l'esecuzione degli script della shell, controllare i file di registro. Se viene visualizzato un messaggio di errore, correggere l'errore ed eseguire nuovamente gli script della shell. In caso di problemi per risolvere il problema, richiedere assistenza utilizzando la pagina Web dei problemi di github CUTnRUN di Easy Shells (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: In linea di principio, le repliche adeguatamente preparate ed elaborate mostrano valori del coefficiente di correlazione di Pearson più elevati all'interno dello stesso gruppo di clustering e un posizionamento ravvicinato nell'analisi delle componenti principali. Qualsiasi replica, che mostra un coefficiente di correlazione di Pearson più basso e una lunga distanza da altre repliche nel grafico della componente principale, può rappresentare un potenziale valore anomalo tra le repliche. Questo script di shell è applicabile a qualsiasi formato bam mappato di dati di lettura. Modifica il percorso e il nome del file dei file bigwig per soddisfare i requisiti specifici del progetto.
15. Convalida della somiglianza tra repliche, metodi di chiamata di picco e opzioni utilizzando il diagramma di Venn
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, potrebbe esserci qualcosa come /path/to/bash (ad esempio, /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come predefinita, considera di saltare questo passaggio
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_methods.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire la funzione interviene venn utilizzando i file del letto di picco dell'intera regione di picco per trovare sovrapposizioni tra i picchi chiamati da varie opzioni (con/senza opzione di controllo IgG, con/senza normalizzazione e opzioni di chiamata dei picchi rigorose/rilassate per SEACR). (ii) Creare una cartella (~/Desktop/GSE126612/intervene_methods) e salvare i risultati dell'analisi del diagramma di Venn in questa cartella. (iii) Annotare un file di registro log_intervene_methods.txt nella cartella ~/Desktop/GSE126612/log/intervene . - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_16_venn-diagram_replicates.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire la funzione interviene venn utilizzando i file del letto di picco dell'intera regione di picco per trovare sovrapposizioni tra i picchi delle repliche. (ii) Creare una cartella (~/Desktop/GSE126612/intervene_replicates) e salvare i risultati dell'analisi del diagramma di Venn in questa cartella. (iii) Annotare un file di registro log_intervene_replicates.txt nella cartella ~/Desktop/GSE126612/log/intervene . - Al termine dell'esecuzione degli script della shell, esaminare i file di registro. Se viene visualizzato un messaggio di errore, correggere l'errore ed eseguire nuovamente gli script della shell. In caso di problemi nell'utilizzo della pipeline di analisi CUTnRUN di Easy Shells, chiedi aiuto nella pagina web dei problemi di github di Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Questi risultati dell'analisi del diagramma di Venn forniscono informazioni per scegliere le opzioni, i metodi e le repliche di chiamata dei picchi più appropriati con un'elevata riproducibilità per l'analisi a valle. Si può preferire scegliere le opzioni di richiamo di picco e i metodi che mostrano i numeri di picco più alti con una buona sovrapposizione con altri metodi e opzioni di richiamo di picco.
16. Analisi delle mappe di calore e dei grafici medi per visualizzare i picchi chiamati.
- Apri il terminale e digita echo $SHELL per controllare la shell predefinita nel terminale attivo. Se la shell Bash è la shell predefinita nel terminale corrente, potrebbe esserci qualcosa come /path/to/bash (ad esempio, /bin/bash) nel terminale.
- Se la shell predefinita non è Bash, imposta la shell Bash come shell predefinita digitando chsh -s $(which bash) nel terminale. Se il terminale utilizza la shell Bash come predefinita, considera di saltare questo passaggio
- Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_focused.sh nel terminale o trascina il file di script della shell nel terminale e invio.
NOTA: Questo script è scritto per: (i) Eseguire la funzione del punto di riferimento computeMatrix utilizzando i file bigWig normalizzati e i file del letto di picco focalizzato per creare matrici di conteggio dei readcount normalizzate al centro dei picchi focalizzati nella cartella ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Eseguire la funzione plotHeatmap utilizzando la matrice di readcount normalizzata per generare heatmap e grafici medi che visualizzano il modello di distribuzione dei readcount normalizzati nelle posizioni di picco focalizzate. (iii) Creare una cartella (~/Desktop/GSE126612/deeptools_plotHeatmap) e salvare i file di output di plotHeatmap all'interno di questa cartella. (iv) Annotare un file di registro log_plotHeatmap_focused.txt nella cartella ~/Desktop/GSE126612/log/plotHeatmap . - Digita ~/Desktop/Easy-Shells_CUTnRUN/scripts/Script_27_plotHeatmap_whole.sh nel terminale o trascina il file di script della shell nel terminale e invio.
Questo script è scritto per: (i) Eseguire la funzione del punto di riferimento computeMatrix utilizzando file bigWig normalizzati e interi file peak bed per creare matrici di readcount normalizzate al centro di tutti i picchi nella cartella ~/Desktop/GSE126612/deeptools_computeMatrix . (ii) Eseguire la funzione plotHeatmap utilizzando la matrice di readcount normalizzata per generare heatmap e grafici medi che visualizzano il modello di distribuzione dei readcount normalizzati in tutte le posizioni di picco. (iii) Creare una cartella (~/Desktop/GSE126612/deeptools_plotHeatmap) e salvare i file di output plotHeatmap all'interno di questa cartella. (iv) Annotare un file di registro log_plotHeatmap_whole.txt nella cartella ~/Desktop/GSE126612/log/plotHeatmap . - Al termine dell'esecuzione degli script della shell, esaminare i file di registro. Se viene visualizzato un messaggio di errore, correggere l'errore ed eseguire nuovamente gli script della shell. In caso di problemi nell'utilizzo della pipeline di analisi CUTnRUN di Easy Shells, chiedi aiuto nella pagina web dei problemi di github di Easy Shells CUTnRUN (https://github.com/JunwooLee89/Easy-Shells_CUTnRUN/issues).
NOTA: Idealmente, le posizioni dei picchi sommitali dei picchi MACS2/3 e le posizioni dei picchi focalizzati di quelli SEACR mostrano una distribuzione del segnale nitida e focalizzata al centro dei grafici. Tuttavia, se l'algoritmo di chiamata dei picchi non funziona correttamente per i dati CUT&RUN, nei grafici potrebbe apparire una distribuzione del segnale "rumorosa" meno focalizzata. Pertanto, l'utilizzo del numero di picchi chiamati e dei modelli di distribuzione del segnale di picco dei grafici di output guiderà la determinazione della validità del picco per ulteriori analisi CUT&RUN che includono l'annotazione del picco a valle.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
La qualità e la rifinitura dell'adattatore mantengono le letture con un'elevata qualità di sequenziamento
Le tecniche di sequenziamento ad alto rendimento sono soggette a generare errori di sequenziamento come "mutazioni" di sequenza nelle letture. Inoltre, i dimeri dell'adattatore di sequenziamento possono essere arricchiti nei set di dati di sequenziamento a causa della scarsa rimozione dell'adattatore durante la preparazione della libreria. Errori di sequenziamento eccessivi, come le mutazioni di l...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
La capacità di mappare l'occupazione delle proteine sulla cromatina è fondamentale per condurre studi meccanicistici nel campo della biologia della cromatina. Man mano che i laboratori adottano nuove tecniche di laboratorio umido per profilare la cromatina, la capacità di analizzare i dati di sequenziamento di questi esperimenti di laboratorio umido diventa un collo di bottiglia comune per gli scienziati di laboratorio umido. Pertanto, descriviamo un protocollo introduttivo passo-passo p...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non divulgare.
Ringraziamenti
Tutte le figure illustrate sono state create con BioRender.com. CAI riconosce il supporto fornito attraverso un Ovarian Cancer Research Alliance Early Career Investigator Award, un Forbeck Foundation Accelerator Grant e il Minnestoa Ovarian Cancer Alliance National Early Detection Research Award.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| bedGraphToBigWig | ENCODE | https://hgdownload.soe.ucsc.edu/admin/exe/ | Software per comprimere e convertire i conteggi delle letture bedGraph in bigWig |
| bedtools-2.31.1 | The Quinlan Lab @ the U. of Utah | https://bedtools.readthedocs.io/en/latest/index.html | Software per elaborare i file bam/bed/bedGraph |
| bowtie2 2.5.4 | Università | Johns Hopkinshttps://bowtie-bio.sourceforge.net/bowtie2/index.shtml | Software per costruire l'indice del papillon ed eseguire l'allineamento |
| CollectInsertSizeMetrics (Picard) | Broad institute | https://github.com/broadinstitute/picard | Software per eseguire l'analisi della distribuzione delle dimensioni degli inserti |
| Cutadapt | NBIS | https://cutadapt.readthedocs.io/en/stable/index.html | Software per eseguire la rifilatura |
| dell'adattatoreDeeptoolsv3.5.1 | Max Planck Institute | https://deeptools.readthedocs.io/en/develop/index.html | Software per eseguire l'analisi di correlazione del coefficiente di Pearson, l'analisi dei componenti principali e l'analisi della mappa di calore/grafico medio |
| FastQC Versione 0.12.0 | Babraham Bioinformatics | https://github.com/s-andrews/FastQC | Software per controllare la qualità del file fastq |
| Intervenev0.6.1 | Biologia Computazionale & Regolazione genica - Mathelier group | Software per eseguire l'analisi del diagramma di Venn utilizzando i file di picco | |
| MACSv2.2.9.1 | Chan Zuckerberg initiative | https://github.com/macs3-project/MACS/tree/macs_v2 | Software per chiamare i picchi |
| MACSv3.0.2 | Chan Zuckerberg initiative | https://github.com/macs3-project/MACS/tree/master | Software per chiamare i picchi |
| Samtools-1.21 | Wellcome Sanger Institute | https://github.com/samtools/samtools | Software per elaborare i file sam / bam |
| SEACRv1.3 | Howard Hughes Medial Institute | https://github.com/FredHutch/SEACR | Software per chiamare i picchi |
| SRA Toolkit Release 3.1.1 | NCBI | https://github.com/ncbi/sra-tools | Software per scaricare SRR da GEO |
| Trim_Galore v0.6.10 | Babraham Bioinformatics | https://github.com/FelixKrueger/TrimGalore | Software per eseguire rifiniture di qualità e atapter |
Riferimenti
- Hainer, S. J., Fazzio, T. G. High-resolution chromatin profiling using CUT&RUN. Curr Protoc Mol Biol. 126 (1), e85(2019).
- Zhang, Y., et al. Model-based analysis of ChiP-Seq (MACS). Genome Biology. 9 (9), R137(2008).
- Xu, S., Grullon, S., Ge, K., Peng, W. Stem cell transcriptional networks: Methods and Protocols. , Springer. New York, NY. (2014).
- Meers, M. P., Tenenbaum, D., Henikoff, S. Peak calling by sparse enrichment analysis for cut&run chromatin profiling. Epigenetics Chromatin. 12 (1), 42(2019).
- Ashburner, M., et al. Gene ontology: Tool for the unification of biology. The gene ontology consortium. Nat Genet. 25 (1), 25-29 (2000).
- Harris, M. A., et al. The gene ontology (GO) database and informatics resource. Nucleic Acids Res. 32 (Database issue), D258-D261 (2004).
- The Gene Ontology Consortium. The gene ontology resource: 20 years and still going strong. Nucleic Acids Res. 47 (D1), D330-D338 (2019).
- Conesa, A., et al. Blast2go: A universal tool for annotation, visualization and analysis in functional genomics research. Bioinformatics. 21 (18), 3674-3676 (2005).
- Carbon, S., et al. AmiGO: Online access to ontology and annotation data. Bioinformatics. 25 (2), 288-289 (2009).
- Eden, E., Navon, R., Steinfeld, I., Lipson, D., Yakhini, Z. Gorilla: A tool for discovery and visualization of enriched go terms in ranked gene lists. BMC Bioinformatics. 10, 48(2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Bioinformatics enrichment tools: Paths toward the comprehensive functional analysis of large gene lists. Nucleic Acids Res. 37 (1), 1-13 (2009).
- Huang Da, W., Sherman, B. T., Lempicki, R. A. Systematic and integrative analysis of large gene lists using david bioinformatics resources. Nat Protoc. 4 (1), 44-57 (2009).
- Ge, S. X., Jung, D., Yao, R. ShinyGO: A graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Tang, D., et al. SRplot: A free online platform for data visualization and graphing. PLoS One. 18 (11), e0294236(2023).
- Ramírez, F., et al. Deeptools2: A next generation web server for deep-sequencing data analysis. Nucleic Acids Res. 44 (W1), W160-W165 (2016).
- Robinson, J. T., et al. Integrative genomics viewer. Nat Biotechnol. 29 (1), 24-26 (2011).
- Kent, W. J., et al. The human genome browser at ucsc. Genome Res. 12 (6), 996-1006 (2002).
- Yu, F., Sankaran, V. G., Yuan, G. -C. CUT&RUNTools 2.0: A pipeline for single-cell and bulk-level CUT&RUN and CUT&Tag data analysis. Bioinformatics. 38 (1), 252-254 (2021).
- Zhu, Q., Liu, N., Orkin, S. H., Yuan, G. -C. CUT&RUNTools: A flexible pipeline for CUT&RUN processing and footprint analysis. Genome Biol. 20 (1), 192(2019).
- Chris Cheshire, C. -W., et al. Nf-core/cutandrun: Nf-core/cutandrun v3.2.2 iridium ibis. , At https://github.com/nf-core/cutandrun/tree/3.2.2 (2024).
- Kong, N. R., Chai, L., Tenen, D. G., Bassal, M. A. A modified CUT&RUN protocol and analysis pipeline to identify transcription factor binding sites in human cell lines. STAR Protoc. 2 (3), 100750(2021).
- Meers, M. P., Bryson, T. D., Henikoff, J. G., Henikoff, S. Improved CUT&RUN chromatin profiling tools. eLife. 8, e46314(2019).
- Amemiya, H. M., Kundaje, A., Boyle, A. P. The encode blacklist: Identification of problematic regions of the genome. Sci Rep. 9 (1), 9354(2019).
- Deberardine, M. BRgenomics for analyzing high-resolution genomics data in R. Bioinformatics. 39 (6), btad331(2023).
- Deberardine, M., Booth, G. T., Versluis, P. P., Lis, J. T. The nelf pausing checkpoint mediates the functional divergence of cdk9. Nat Commun. 14 (1), 2762(2023).
- Andrews, S. Fastqc: A quality control tool for high throughput sequence data. , At http://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Krueger, F., James, F. O., Ewels, P. A., Afyounian, E., Schuster-Boeckler, B. FelixKrueger/TrimGalore: v0.6.7 - DOI via Zenodo. , (2021).
- Mcgaughey, D. Easy bam downsampling. , Available from: https://davemcg.github.io/post/easy-bam-downsampling/ (2018).
- Positionbaseddownsamplesam (picard). , GATK Team. At https://gatk.broadinstitute.org/hc/en-us/articles/360041850311-PositionBasedDownsampleSam-Picard (2020).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Ristampe e permessi
