Questa analisi bibliometrica ha utilizzato CiteSpace, VOSviewer e Scimago Graphica per valutare le tendenze di pubblicazione, le reti di collaborazione e i punti di riferimento emergenti nella ricerca sulla riprogrammazione metabolica dei linfociti T dal 2016 al 2025.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
L'analisi bibliometrica della riprogrammazione metabolica nei linfociti T rivela tendenze di ricerca e emergenti punti caldi, 2016-2025
* These authors contributed equally
In questo articolo
Sommario
Abstract
I linfociti T sono regolatori centrali delle risposte immunitarie e studi recenti hanno dimostrato che i processi metabolici influenzano l'attivazione, la differenziazione e la funzione degli effettori dei linfociti T nel cancro e nelle malattie autoimmuni. Questo studio ha effettuato un'analisi bibliometrica delle pubblicazioni dal 1° gennaio 2016 al 31 dicembre 2025, recuperate dalla Web of Science Core Collection. CiteSpace è stato utilizzato per analisi di co-occorrenza, co-citazione e clustering di riferimenti e parole chiave. VOSviewer è stato applicato per analizzare riviste, autori, riferimenti, paesi e istituzioni, mentre Scimago Graphica visualizzava reti di collaborazione nazionale ed Excel veniva utilizzato per valutare le tendenze annuali delle pubblicazioni. Sono state incluse in totale 1.882 pubblicazioni. La produzione annuale di pubblicazioni è aumentata costantemente, con una crescita significativa osservata nel 2021 e nel 2025. La Cina ha contribuito con il volume più alto di pubblicazioni, mentre gli Stati Uniti hanno mostrato un impatto maggiore sulle citazioni. Frontiers in Immunology fu la rivista più produttiva, mentre Nature mostrò la maggiore influenza sulle citazioni. Le analisi di clustering e citazione di parole chiave hanno identificato punti caldi di ricerca in evoluzione focalizzati sulla riprogrammazione metabolica dei linfociti T, il metabolismo del glucosio e degli amminoacidi, e l'interesse emergente per le interazioni metaboliche delle cellule immunitarie. Nel complesso, questa analisi bibliometrica dimostra la continua espansione della ricerca sull'immunometabolismo dei linfociti T e mette in evidenza direzioni tematiche emergenti, tra cui la regolazione metabolica intercellulare e il metabolismo lipidico.
Introduzione
I linfociti T naïvi si basano principalmente sulla fosforilazione ossidativa mitocondriale (OXPHOS) per mantenere il loro stato metabolico quiescente e a bassaenergia 1. Con la stimolazione antigenica, tuttavia, i linfociti T attivati subiscono uno spostamento metabolico verso la glicolisi aerobica per supportare una rapida proliferazione e la funzione deglieffettori 2. I linfociti T effettori, in particolare i sottoinsiemi citotossici, dipendono dalla glicolisi per soddisfare le maggiori esigenze bioenergetiche e biosintetiche associate alla produzione di citochine e all'espansionecellulare 3. Sebbene la glicolisi produca meno adenosina trifosfato (ATP) per molecola di glucosio rispetto all'OXPHOS, il suo rapido metabolismo supporta le esigenze funzionali delle cellule immunitarieattivate 4. Un'attività glicolitica eccessiva può anche contribuire a effetti negativi all'interno del microambiente immunitario. L'accumulo di lattato può compromettere la sintesi della serina derivata dal glucosio e alterare l'equilibrio redox intracellulare, sopprimendo così la proliferazione e la funzione dei linfocitiT 5. Inoltre, livelli elevati di lattato interrompono le vie migratorie dipendenti dalla glicolisi e riducono la motilità dei linfociti T CD4⁺ eCD8⁺ 6,7.
Il metabolismo cellulare si adatta dinamicamente agli stimoli ambientali e fisiologici attraverso un processo noto come riprogrammazionemetabolica 8,9. Evidenze crescenti indicano che la riprogrammazione metabolica svolge un ruolo centrale nella regolazione dell'attivazione, differenziazione e plasticità funzionale dei linfocitiT 10,11. Queste alterazioni metaboliche sono particolarmente rilevanti nel cancro e nelle malattie autoimmuni, dove i cambiamenti nel microambiente immunitario influenzano la funzione dei linfociti T e la regolazioneimmunitaria 12,13. Sebbene diversi studi bibliometrici abbiano valutato l'immunometabolismo in contesti più ampi, inclusi l'immunometabolismo del cancro e il metabolismo immunitario associato a malattie, queste analisi si concentrano principalmente sulle interazioni immuno-metaboliche generalizzate piuttosto che sulla riprogrammazione metabolica specifica dei linfocitiT 14,15. Una valutazione bibliometrica completa dedicata specificamente all'immunometabolismo dei linfociti T rimane limitata, in particolare per quanto riguarda le tendenze di ricerca, le reti di collaborazione e i punti caldi tematici in evoluzione all'interno di questo campo.
Per colmare questa lacuna, questo studio ha effettuato un'analisi bibliometrica delle pubblicazioni indicizzate nella Web of Science Core Collection (WOScc) dal 1° gennaio 2016 al 31 dicembre 2025. CiteSpace, VOSviewer e Scimago Graphica sono stati utilizzati per analizzare quantitativamente l'output delle pubblicazioni, i modelli di collaborazione, le relazioni di co-citazione e l'evoluzione tematica nella ricerca sulla riprogrammazione metabolica dei linfociti T. A differenza delle tradizionali revisioni narrative, l'analisi bibliometrica offre una panoramica strutturata e basata sui dati sul panorama scientifico attraverso citazioni, clustering e analisi delle parole chiave. L'obiettivo di questo studio era caratterizzare sistematicamente le tendenze globali della ricerca e i punti caldi emergenti nell'immunometabolismo dei linfociti T e fornire una panoramica organizzata del panorama attuale delle conoscenze in questo campo in rapida evoluzione.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio ha analizzato esclusivamente dati bibliografici recuperati da database accessibili al pubblico e non ha coinvolto partecipanti umani, animali o dati personali identificabili; Pertanto, non era richiesta l'approvazione etica istituzionale e il consenso informato.
Strategia di raccolta dati e ricerca
I dati sono stati estratti dal WoSCC (https://www.webofscience.com/wos/woscc/) il 27 gennaio 2026. Le edizioni del database selezionate sono state il Science Citation Index Expanded (SCI-EXPANDED) e il Social Sciences Citation Index all'interno di WoSCC. La ricerca è stata condotta utilizzando l'interfaccia Advanced Search. La strategia di ricerca è stata applicata nel campo "Topic (TS)" e la query completa e i record risultanti sono presentati nella Tabella 1. Il periodo di ricerca è stato limitato alle pubblicazioni indicizzate tra il 1° gennaio 2016 e il 31 dicembre 2025 utilizzando il filtro "Timespan" di WoSCC. Solo gli articoli di ricerca originali e gli articoli di revisione venivano inclusi utilizzando il filtro "Tipi di documenti". La lingua era limitata all'inglese e non venivano applicate restrizioni riguardo al paese, all'istituzione o all'area di ricerca. Tutti i record sono stati esportati in formato testo semplice con "Record completo e riferimenti citati" selezionati durante l'esportazione. Quando il numero di record recuperati ha superato i 500, i record sono stati scaricati in più lotti e successivamente fusi in un unico dataset prima dell'analisi. Dopo il recupero, tutti i record venivano importati in CiteSpace per la pre-elaborazione e l'analisi bibliometrica. I record duplicati venivano identificati e rimossi utilizzando la funzione di deduplicazione integrata in CiteSpace basata sui metadati bibliografici, inclusi titolo, autori, anno di pubblicazione e rivista di origine. Quando venivano identificate potenziali incongruenze o record bibliografici incompleti, veniva inoltre effettuata una verifica manuale per garantire accuratezza e coerenza dei dati prima dell'analisi.
| Set | Risultati | Query di ricerca |
| #1 | 252,461 | TS=("Cellula T*" O "Cellula T*" O "Linfocita T*" O "Linfociti T*" O "Linfociti T*" O "Cellula T CD4+*" O "Cellula T CD8+*" O "cellula T citotossica*" O "cellula T regolatoria*" O "Treg*" O "cellula T helper*" O "cellula Th*" O "cellula T ingenua*" O "cellula T della memoria*" OPPURE "cellula T effettrice*") |
| #2 | 13,799 | TS=("riprogrammazione metabolica*" O "rimodellazione metabolica*" O "riorganizzazione metabolica") |
| #3 | 1,882 | #1 E #2 |
Tabella 1: Strategia di ricerca Web of Science Core Collection utilizzata per il recupero dei dati bibliometrici. La tabella riassume la strategia di ricerca dettagliata, le combinazioni di parole chiave, gli operatori booleani e i conteggi finali di recupero utilizzati per la raccolta della letteratura dal WoSCC. Le ricerche venivano effettuate utilizzando il campo "Topic (TS)" nell'interfaccia di Ricerca Avanzata. I jolly (*) venivano usati per recuperare le desinenze di più parole e la terminologia correlata. Il dataset finale era costituito da pubblicazioni indicizzate tra il 1° gennaio 2016 e il 31 dicembre 2025 dopo l'applicazione di filtri linguistici e di tipo di documento.
Approcci analitici
Un approccio bibliometrico multitool è stato implementato sistematicamente per l'analisi dei dati. L'analisi è stata condotta in un ambiente di sistema operativo Windows 10. CiteSpace (v.5.7.R2) è stato utilizzato per analizzare riferimenti e parole chiave elaborando dati in formato TXT esportati da WoSCC. I parametri di CiteSpace sono stati configurati come segue: (1) il time slicing è stato impostato dal 2016 al 2025 con un anno per slice; (2) i criteri di selezione sono stati configurati utilizzando l'indice g (k = 25); (3) i metodi di potatura includevano Pathfinder, Pruning Sliced Networks e Pruning the Merged Network per semplificare le strutture di rete preservando le relazioni chiave; e (4) l'analisi di clustering è stata effettuata utilizzando l'algoritmo log-verosimiglianza16. Questa analisi ha generato reti di co-citazione, mappe di clustering, visualizzazioni di timeline e mappe di rilevamento burst sia per riferimenti che per parole chiave. Nelle mappe di visualizzazione, la dimensione dei nodi rappresentava la frequenza, lo spessore del collegamento indicava la forza di co-incidenza e gli anelli viola rappresentavano un'alta centralità tra le mezze. I nodi burst riflettevano un improvviso aumento della frequenza di citazioni o parole chiave nel tempo.
Successivamente, i file esportati sono stati nuovamente salvati in codifica UTF-8 usando Windows Notepad e importati in VOSviewer (versione 1.6.20) per la mappatura bibliometrica, inclusa analisi di co-autoria, co-citazione e co-occorrenza tra autori, riviste, istituzioni epaesi 17. È stato applicato il metodo del conteggio completo e la normalizzazione è stata eseguita utilizzando il metodo della forza associativa. Le soglie minime di occorrenza sono state stabilite in base alla dimensione del dataset (autori ≥ 5 pubblicazioni; parole chiave ≥ 5 occorrenze; istituzioni ≥ 3 pubblicazioni). La visualizzazione della rete si basava sul peso dell'oggetto e sulla forza totale del legame. Per l'analisi di collaborazione a livello di paese, i file GML esportati da VOSviewer venivano importati in Scimago Graphica (versione 1.0.53), dove i nodi rappresentavano i paesi. La visualizzazione e il clustering della rete sono stati generati utilizzando l'algoritmo predefinito di layout guidato dalla forza per rappresentare relazioni spaziali e modelli di collaborazione tra i paesi. WPS Excel veniva utilizzato per l'analisi statistica descrittiva delle tendenze annuali delle pubblicazioni e per la sintesi di base dei dati. I risultati sono stati visualizzati utilizzando grafici a barre, diagrammi a colonne e grafici a linee.
Un'analisi supplementare a intervalli temporali è stata effettuata utilizzando la stessa strategia di ricerca descritta sopra, con la ricerca limitata alle pubblicazioni indicizzate tra il 1° gennaio 2025 e il 31 dicembre 2025. All'interno dello stesso quadro di query e ambiente analitico WoSCC, sono state recuperate pubblicazioni recenti e output relativi a conferenze per scopi contestuali e descrittivi. Questa procedura è stata condotta interamente all'interno dell'interfaccia analitica integrata del WoSCC. Non è stato creato alcun dataset indipendente e le informazioni recuperate non sono state integrate nel dataset bibliometrico primario né utilizzate per analisi quantitative. Il design complessivo dello studio e il flusso di lavoro dell'analisi bibliometrica sono riassunti in un diagramma di flusso (Figura 1).
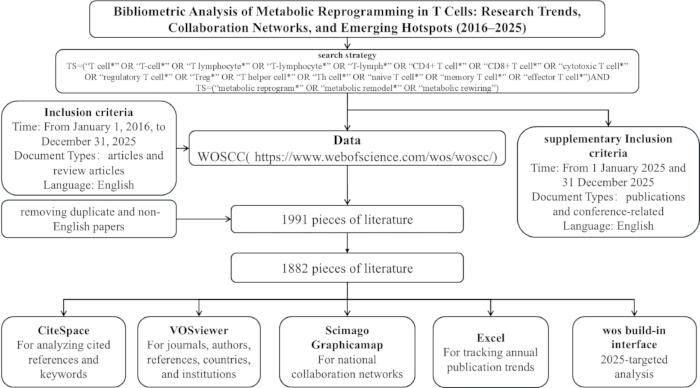
Figura 1. Flusso di lavoro dell'analisi bibliometrica della ricerca sulla riprogrammazione metabolica dei linfociti T. Panoramica schematica del disegno dello studio e del flusso di lavoro analitico utilizzato in questa analisi bibliometrica. Le pubblicazioni sono state recuperate dalla Web of Science Core Collection (WoSCC) utilizzando strategie di ricerca predefinite e criteri di inclusione. I record recuperati venivano esportati in formato testo semplice e sottoposti a pre-elaborazione, inclusa la rimozione dei duplicati e la standardizzazione dei dati bibliografici. Analisi bibliometriche sono state condotte utilizzando CiteSpace per analisi di co-citazione, co-occorrenza di parole chiave, clustering e rilevamento burst, e VOSviewer per analisi di rete collaborativa tra autori, istituzioni, paesi e riviste. Scimago Graphica veniva utilizzato per visualizzare le reti di collaborazione internazionale, mentre WPS Excel veniva impiegato per analizzare le tendenze annuali delle pubblicazioni e le statistiche descrittive. Clicca qui per visualizzare una versione più grande di questa figura.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Produzione di pubblicazioni e tendenze temporali
Per caratterizzare l'evoluzione temporale dell'attività di ricerca in questo campo, è stata effettuata un'analisi bibliometrica utilizzando pubblicazioni indicizzate nel WoSCC. Un totale di 1.991 record sono stati inizialmente recuperati nell'ultimo decennio. Dopo la rimozione di documenti duplicati e non in inglese, furono incluse e analizzate 1.882 pubblicazioni, inclusi 1.046 articoli di ricerca originali e 836 artic...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
La nostra analisi bibliometrica della riprogrammazione metabolica nelle cellule T ha rivelato un aumento sostenuto della produzione di ricerca nel tempo. Nel 2020 si è verificato un aumento significativo del numero di pubblicazioni e citazioni, con 40 pubblicazioni aggiuntive e 1.989 citazioni aggiuntive rispetto al 2019. Questo aumento ha coinciso temporalmente con diverse pubblicazioni molto citate, tra cui Glutamine blockade induces programmi metabolici divergenti per superare l'e...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Conflitti di Interesse:
Gli autori dichiarano che non ci sono conflitti di interesse relativi a quest'opera.
Contusioni dell'autore:
La raccolta dati e il recupero della letteratura sono stati eseguiti da Yi Liu. La preelaborazione dei dati e le analisi bibliometriche sono state condotte da Yinping Yang. La visualizzazione e la preparazione della figura sono state eseguite da Xinyue Yang e Jinquan Li. La prima bozza del manoscritto fu scritta da Yi Liu e Weihong Li. Tutti gli autori hanno contribuito alla revisione del manoscritto e approvato la versione finale inviata.
Ringraziamenti
Gli autori riconoscono con gratitudine il sostegno finanziario dei Fondi di Ricerca Fondamentale per le Università Centrali (2022-JYB-JBZR-037).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| CiteSpace | Drexel University | v.5.7.R2 | SCR_025121 |
| Microsoft Excel | Microsoft Corporation | v.2604 Build 16.0.19929.20136 | SCR_016137 (Microsoft Excel) |
| WPS Excel | Kingsoft Office | v.12.1.0.26375 | |
| Scimago Graphica | Scimago Lab | v.1.0.53 | Non disponibile |
| VOSviewer | Leiden University | v.1.6.20 | SCR_023516 |
| Web of Science Core Collection | Clarivate Analytics | consultato il 27 gennaio 2026; versione non applicabile | Non disponibile |
| Windows Operating System | Microsoft Corporation | Windows 10 | Non disponibile |
Riferimenti
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
- Wang R, et al. The transcription factor Myc controls metabolic reprogramming upon T-lymphocyte activation. Immunity. 2011;35(6):871-82.
- Shyer JA, et al. Metabolic signaling in T cells. Cell Res. 2020;30(8):649-59.
- Gubser PM, et al. Rapid effector function of memory CD8+ T cells requires an immediate-early glycolytic switch. Nat Immunol. 2013;14(10):1064-72.
- Yuan Q, et al. Enhancing intracellular NADPH bioavailability through improving pentose phosphate pathway flux and its application in biocatalysis asymmetric reduction reaction. J Biosci Bioeng. 2022;134(6):528-33.
- Quinn WJ III, et al. Lactate limits T-cell proliferation via the NAD(H) redox state. Cell Rep. 2020;33(11):108500.
- Pucino V, et al. Lactate buildup at the site of chronic inflammation promotes disease by inducing CD4+ T-cell metabolic rewiring. Cell Metab. 2019;30(6):1055-74.e8.
- O'Neill LAJ, et al. A guide to immunometabolism for immunologists. Nat Rev Immunol. 2016;16(9):553-65.
- Almeida L, et al. Metabolic pathways in T-cell activation and lineage differentiation. Semin Immunol. 2016;28(5):514-24.
- Haas R, et al. Lactate regulates metabolic and pro-inflammatory circuits in control of T-cell migration and effector functions. PLoS Biol. 2015;13(7):e1002202.
- Chang CH, Pearce EL. Emerging concepts of T-cell metabolism as a target of immunotherapy. Nat Immunol. 2016;17(4):364-68.
- Ho PC, et al. Reenergizing T-cell anti-tumor immunity by harnessing immunometabolic checkpoints and machineries. Curr Opin Immunol. 2017;46:38-44.
- Von Meyenn L, et al. Targeting T-cell metabolism in inflammatory skin disease. Front Immunol. 2019;10:2285.
- Zhu H, et al. Trends and hotspots in research related to tumor immune escape: bibliometric analysis and future perspectives. Front Immunol. 2025;16:1604216.
- Zhang B, et al. Mapping research trends in immune-cell metabolic reprogramming in breast cancer: a parallel dual-database bibliometric study. Discov Oncol. 2026;17:724.
- Chen G, et al. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-27.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-71.
- Leone RD, et al. Glutamine blockade induces divergent metabolic programs to overcome tumor immune evasion. Science. 2019;366(6468):1013-21.
- Watson MJ, et al. Metabolic support of tumour-infiltrating regulatory T cells by lactic acid. Nature. 2021;591(7851):645-51.
- Xia L, et al. The cancer metabolic reprogramming and immune response. Mol Cancer. 2021;20(1):28.
- Miao S, et al. tRNA m1A modification regulates cholesterol biosynthesis to promote antitumor immunity of CD8+ T cells. J Exp Med. 2025;222(3):e20240559.
- Angelin A, et al. Foxp3 reprograms T-cell metabolism to function in low-glucose, high-lactate environments. Cell Metab. 2017;25(6):1282-93.e7.
- Huang SC, et al. Metabolic reprogramming mediated by the mTORC2-IRF4 signaling axis is essential for macrophage alternative activation. Immunity. 2016;45(4):817-30.
- Nakaya M, et al. Inflammatory T-cell responses rely on amino acid transporter ASCT2 facilitation of glutamine uptake and mTORC1 kinase activation. Immunity. 2014;40(5):692-705.
- Ma EH, et al. Serine is an essential metabolite for effector T-cell expansion. Cell Metab. 2017;25(2):345-57.
- Pearce EL, et al. Fueling immunity: insights into metabolism and lymphocyte function. Science. 2013;342(6155):1242454.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.