Questo protocollo descrive un flusso di lavoro basato sull'apprendimento profondo per la segmentazione semantica, la ricostruzione e la sintesi stilistica artistica di motivi del patrimonio culturale immateriale, utilizzando l'estrazione di caratteristiche basata su trasformatori, la ricostruzione avversaria e la generazione adattativa spaziale delle immagini, al fine di supportare la conservazione digitale e applicazioni creative nel campo del patrimonio culturale.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Ricostruzione guidata dalla segmentazione semantica e sintesi di stile artistico di pattern del patrimonio culturale immateriale tramite un framework di deep learning
In questo articolo
Sommario
Abstract
La conservazione digitale e la ricostruzione dei modelli del patrimonio culturale immateriale (ICH) hanno attirato un'attenzione crescente con il progresso delle tecniche di sintesi delle immagini basate sull'apprendimento profondo. Gli approcci esistenti basati su SegCycle-SPADE hanno dimostrato un potenziale per la segmentazione strutturale e la ricostruzione artistica dei modelli artigianali tradizionali; tuttavia, permangono alcune limitazioni, tra cui la scarsa diversità dei dataset, l'insufficiente integrazione delle semantica culturale e la preservazione inadeguata delle caratteristiche strutturali dei modelli durante la ricostruzione. Per affrontare queste sfide, questo studio propone un framework SegCycle-SPADE migliorato per la segmentazione semantica e la ricostruzione artistica dei tipi di modelli ICH. Viene impiegato un modello di segmentazione basato su Transformer, SegFormer, per identificare con precisione i confini dei motivi e le regioni del modello. Inoltre, viene introdotto un modulo di fusione delle caratteristiche culturali basato sull'attenzione incrociata (Cross-Attention Cultural Feature Fusion Module) per potenziare i motivi culturalmente significativi e migliorare la rappresentazione delle caratteristiche. La traduzione e la ricostruzione del modello vengono eseguite utilizzando CycleGAN, mentre la denormalizzazione spazialmente adattativa (SPADE) viene utilizzata per la sintesi dello stile artistico al fine di mantenere la coerenza semantica tra le mappe di segmentazione e le immagini generate. Per migliorare la generalizzazione del modello e la diversità artistica, il framework viene addestrato utilizzando sia il dataset dei motivi culturali Miao Batik sia il dataset WikiArt. I risultati sperimentali dimostrano che il framework SegCycle-SPADE proposto, guidato dall'attenzione, migliora l'accuratezza della segmentazione e le prestazioni di ricostruzione dei modelli del patrimonio rispetto ai metodi esistenti di ricostruzione basati su reti avversarie generative (GAN). Il framework proposto fornisce una soluzione scalabile per la documentazione assistita dall'intelligenza artificiale, la ricostruzione e la rivitalizzazione artistica dei disegni tradizionali dei modelli.
Introduzione
Il patrimonio culturale, che comprende elementi immateriali come usanze, lingue e credenze, e elementi materiali come opere d'arte, edifici e documenti scritti, è una manifestazione fondamentale della storia, della creatività e dell'identità umana1. La conservazione del patrimonio mira a permettere alle comunità di riconnettersi con le proprie origini e consente alle generazioni future di trarre beneficio dalla memoria culturale collettiva. Promuove inoltre la comprensione interculturale, l'apprezzamento di tradizioni e usanze diverse e il riconoscimento di differenti narrazioni storiche. Queste risorse culturali ci aiutano a comprendere i valori, i punti di vista e le esperienze delle generazioni passate e contribuiscono alla formazione delle identità sociali contemporanee e alla continuità culturale. I principi fondamentali della conservazione del patrimonio culturale sono illustrati nella Figura 1.
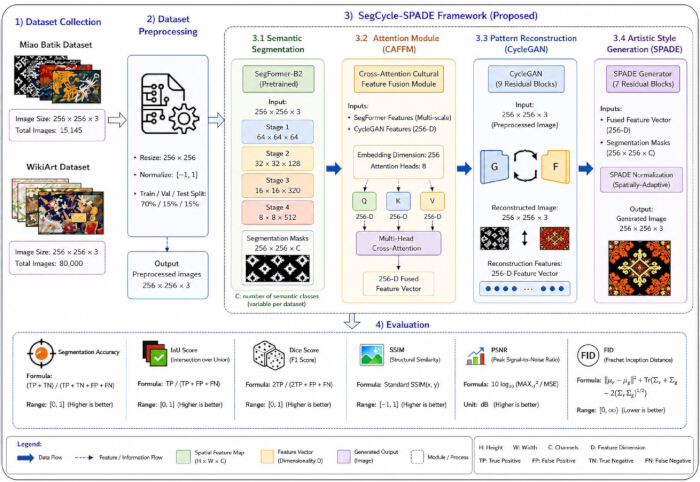
Figura 1. Panoramica concettuale della ricostruzione di motivi del patrimonio culturale mediante il framework SegCycle-SPADE. Illustrazione schematica dell'approccio proposto per la ricostruzione e il miglioramento di motivi appartenenti al patrimonio culturale immateriale. Il flusso di lavoro comprende la raccolta del dataset dai dataset Miao Batik e WikiArt, la pre-elaborazione delle immagini, la segmentazione semantica mediante SegFormer-B2, la fusione di caratteristiche tramite il modulo Cross-Attention Cultural Feature Fusion Module (CAFFM), la ricostruzione dei motivi mediante CycleGAN, la sintesi dello stile artistico mediante SPADE e la valutazione finale tramite metriche di segmentazione e ricostruzione. Le frecce indicano il flusso dei dati e delle rappresentazioni delle caratteristiche all'interno del framework. Cliccare qui per visualizzare una versione ingrandita di questa figura.
La memoria collettiva e l'eredità culturale della società umana sono incarnate nel patrimonio culturale immateriale (ICH), che svolge un ruolo fondamentale come mezzo di espressione artistica e identità culturale. Tuttavia, l'ICH affronta sfide significative a causa degli effetti della globalizzazione e della digitalizzazione2,3,4. Molte pratiche ICH a rischio richiedono nuovi approcci alla conservazione e allo sviluppo, a causa del calo del numero di artigiani qualificati e della limitata adattabilità ai mercati moderni5,6. Come settore importante della ricerca sull'ICH, il design sostenibile enfatizza lo sviluppo integrato di cultura, società e ambiente, offrendo una via pratica per la conservazione continua dell'ICH. Attraverso approcci di design sostenibile, l'ICH può essere rivitalizzato adattandosi alle esigenze della società contemporanea7,8.
In questo studio, il termine «modelli di patrimonio culturale immateriale» si riferisce a rappresentazioni di motivi visivi che comunicano e preservano valori culturali immateriali sottostanti. Di conseguenza, il framework proposto mira a preservare e documentare le informazioni culturali associate a questi motivi, ricostruendone al contempo le forme visive.
Il ricamo Miao e il batik sono forme significative del patrimonio culturale immateriale cinese, che riflettono la storia, le credenze e le tradizioni della comunità Miao attraverso motivi simbolici come uccelli, farfalle e totem ancestrali9. Questi motivi sono profondamente radicati negli abiti rituali e nelle pratiche festive e contribuiscono allo sviluppo culturale ed economico locale10,11. I progressi nelle tecnologie digitali, in particolare nell'intelligenza artificiale (AI) e nell'apprendimento profondo (DL), hanno creato nuove opportunità per la conservazione, l'analisi, la ricostruzione e la documentazione del patrimonio culturale. Il batik Miao del Guizhou, una delle tradizioni di batik meglio conservate in Cina, rappresenta un mezzo importante per trasmettere il sapere culturale, le credenze, le usanze e i rituali del popolo Miao12,13,14,15,16.
Studi recenti hanno dimostrato il potenziale del deep learning (DL) nella conservazione del patrimonio culturale e nella ricostruzione di motivi, ottenendo un'accuratezza di segmentazione migliore (accuratezza a livello di pixel = 88,6%, media dell'intersezione rispetto all'unione [IoU] = 78,1%) e prestazioni di ricostruzione superiori rispetto a U-Net e DeepLabV3+. Tuttavia, permangono diverse sfide. Gli attuali approcci basati su reti avversarie generative (GAN) spesso incontrano difficoltà nel preservare i dettagli strutturali fini nei motivi complessi.17, mentre la limitata diversità dei dataset ne restringe la generalizzazione attraverso diversi domini culturali18Inoltre, modelli di traduzione da immagine a immagine come CycleGAN possono non mantenere la coerenza semantica tra mappe di segmentazione e immagini generate19e l'assenza di meccanismi attentivi può provocare la perdita di dettagli di motivi culturalmente significativi durante la ricostruzione20Pertanto, è necessario un framework avanzato che integri la segmentazione basata su trasformatori, l'apprendimento delle caratteristiche guidato dall'attenzione e l'addestramento su multi-dataset per una ricostruzione efficace dei pattern di emorragia cerebrale (ICH).
Nuove opportunità per la conservazione del patrimonio culturale sono emerse grazie alla digitalizzazione del ricamo Miao e al rapido sviluppo dell'intelligenza artificiale generativa. I modelli di diffusione, una classe emergente di modelli generativi profondi, hanno dimostrato prestazioni notevoli nei compiti di visione artificiale grazie alle loro potenti capacità di generazione dei contenuti21,22,23,24,25. Durante il processo di diffusione inversa, il modello impara gradualmente a ricostruire i dati originali a partire da rappresentazioni rumorose26,27,28. Studi precedenti hanno inoltre esplorato l'applicazione di tecnologie di ricostruzione tridimensionale e di progettazione assistita da computer (CAD) per la conservazione e la diffusione del patrimonio culturale.
Anche se le reti neurali convoluzionali (CNN) e i GAN offrono prestazioni elevate nella generazione di immagini e nella conservazione delle caratteristiche, presentano ancora sfide legate a campi recettivi limitati, al collasso delle modalità e all'instabilità durante l'addestramento29. Le architetture basate sui trasformatori, come SegFormer e Segmenter, eccellono nel catturare il contesto globale e le relazioni semantiche; tuttavia, richiedono un'elevata potenza computazionale e possono avere difficoltà a gestire dettagli fini. Sebbene i modelli di diffusione come Stable Diffusion dimostrino solide capacità di generazione di immagini, spesso mancano di un controllo preciso sulle caratteristiche strutturali e artistiche dei disegni generati. Inoltre, la maggior parte degli approcci esistenti impiega strategie di addestramento indipendenti che limitano la condivisione efficace delle informazioni e l'ottimizzazione collaborativa tra i componenti di segmentazione e generazione, determinando un compromesso tra accuratezza strutturale e autenticità artistica30.
I recenti modelli basati sulla diffusione, come la diffusione latente e la Stable Diffusion, raggiungono una sintesi di immagini di alta qualità ma richiedono un denoising iterativo, il che comporta un aumento del costo computazionale e del tempo di inferenza. Inoltre, mantenere motivi culturali fini e una coerenza strutturale rimane una sfida senza meccanismi di condizionamento specializzati. I modelli generativi basati su Transformer catturano efficacemente le relazioni contestuali globali ma spesso necessitano di dataset su larga scala e di risorse computazionali sostanziali. Al contrario, il framework proposto SegCycle-Spatially Adaptive Denormalization (SegCycle-SPADE) combina la segmentazione basata su SegFormer, la fusione di caratteristiche mediante cross-attenzione, la ricostruzione mediante CycleGAN e la sintesi guidata da SPADE per fornire un orientamento strutturale esplicito, migliorando così il mantenimento dei motivi, la coerenza semantica e la ricostruzione controllabile dei pattern del patrimonio culturale.
La maggior parte delle moderne tecniche di segmentazione semantica si basa su reti neurali convoluzionali completamente connesse (FCNN) con architetture a forma di U31. Durante la fase di codifica, vengono estratte caratteristiche profonde con ampi campi recettivi attraverso una serie di operazioni di convoluzione e sottocampionamento. La fase di decodifica ripristina progressivamente la risoluzione spaziale mediante operazioni di sovracampionamento, consentendo infine una previsione semantica a livello di pixel. Grazie ai collegamenti diretti (skip connections), che compensano la perdita di informazioni spaziali durante il sottocampionamento e migliorano le prestazioni di segmentazione in un'ampia gamma di applicazioni, è possibile integrare direttamente nel decodificatore informazioni ad alta risoluzione provenienti da diversi livelli del codificatore32.
Sebbene i recenti metodi basati su GAN, CNN e diffusione abbiano mostrato risultati promettenti nella generazione di immagini e nel restauro del patrimonio culturale, spesso incontrano difficoltà nel mantenere la coerenza semantica, preservare i dettagli strutturali fini e garantire una ricostruzione riproducibile attraverso diversi motivi culturali. La maggior parte degli approcci esistenti tratta la segmentazione, la ricostruzione e la sintesi dello stile come processi separati, il che può portare alla perdita di elementi culturalmente significativi e a risultati incoerenti. Per colmare questa lacuna metodologica, questo studio propone un framework unificato SegCycle-SPADE che integra la segmentazione semantica basata su SegFormer, un nuovo modulo di fusione delle caratteristiche culturali con attenzione incrociata (CAFFM), la ricostruzione basata su CycleGAN e la sintesi dello stile guidata da SPADE. Integrando esplicitamente le informazioni di segmentazione strutturale con l'apprendimento generativo delle caratteristiche, il framework proposto consente una ricostruzione più affidabile, semanticamente coerente e riproducibile dei motivi del patrimonio culturale immateriale, preservando al contempo l'autenticità culturale e la qualità artistica.
In questo studio vengono identificate tre limitazioni principali degli attuali approcci alla ricostruzione del patrimonio culturale: (i) insufficiente preservazione dei motivi strutturali fini nei metodi di ricostruzione basati su GAN; (ii) generalizzazione limitata derivante dall'addestramento su dataset ridotti o specifici per dominio; e (iii) inadeguata coerenza semantica tra gli output della segmentazione e le immagini generate nei framework di traduzione da immagine a immagine. Inoltre, segmentazione, ricostruzione e sintesi dello stile sono comunemente trattate come processi separati, portando alla perdita di elementi culturalmente importanti durante la ricostruzione. Combinando segmentazione semantica basata su transformer, fusione di caratteristiche con cross-attenzione, ricostruzione CycleGAN e sintesi artistica guidata da SPADE all'interno di un'architettura unificata, il framework proposto SegCycle-SPADE affronta queste limitazioni e migliora la preservazione dei motivi, la coerenza semantica e l'autenticità artistica nella ricostruzione di pattern del patrimonio culturale immateriale (ICH).
L'obiettivo principale di questo studio è sviluppare un framework SegCycle-SPADE avanzato per la ricostruzione artistica guidata dalla segmentazione semantica di motivi ICH. Il framework integra SegFormer per una segmentazione precisa dei motivi culturali, CycleGAN per la ricostruzione dei motivi e SPADE per una sintesi artistica coerente nello stile. Per migliorare la rappresentazione delle caratteristiche e preservare i dettagli strutturali fini, viene introdotto un CAFFM per facilitare un'efficace interazione tra le caratteristiche di segmentazione e quelle generative. Addestrato sui dataset Miao Batik e WikiArt, il framework proposto migliora l'autenticità della ricostruzione, la coerenza stilistica e la preservazione di motivi culturalmente significativi.
Combinando segmentazione semantica, fusione guidata dall'attenzione delle caratteristiche, ricostruzione di pattern e sintesi stilistica all'interno di un'architettura unificata, questo studio presenta un nuovo framework SegCycle-SPADE per la ricostruzione artistica di pattern ICH. I principali contributi di questo lavoro sono i seguenti. Primo, viene sviluppato un nuovo framework di ricostruzione guidato dalla segmentazione semantica mediante l'integrazione di SegFormer, che consente l'estrazione accurata e la conservazione di motivi culturali complessi ed elementi strutturali. Secondo, viene introdotto un nuovo CAFFM per fondere efficacemente le caratteristiche di segmentazione con rappresentazioni generative, consentendo al modello di catturare relazioni a lungo raggio tra motivi culturali e pattern stilistici artistici. Terzo, il CAFFM proposto migliora la conservazione di elementi culturalmente significativi, aumentando al contempo il realismo visivo e la coerenza strutturale dei pattern del patrimonio ricostruiti. Quarto, integrando CycleGAN per la ricostruzione di pattern culturali e SPADE per la sintesi artistica guidata dalla segmentazione, il framework garantisce sia accuratezza semantica sia autenticità stilistica nelle uscite generate. Quinto, al fine di migliorare la capacità di generalizzazione e la diversità artistica, il modello viene addestrato utilizzando il dataset di motivi culturali del Batik Miao per l'apprendimento dei pattern culturali e il dataset WikiArt per la rappresentazione dello stile artistico. WikiArt funge da dataset ausiliario per valutare la capacità di generalizzazione del framework, la robustezza nell'apprendimento delle caratteristiche e l'efficacia del controllo stilistico in diversi contesti visivi, piuttosto che come stile target per un'applicazione diretta nei prodotti del patrimonio culturale Miao. Infine, rispetto ai metodi esistenti basati su GAN per la ricostruzione del patrimonio culturale, i risultati sperimentali dimostrano che il framework proposto SegCycle-SPADE raggiunge una maggiore accuratezza di segmentazione, qualità di ricostruzione e coerenza stilistica.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Il framework proposto, SegCycle-SPADE, è stato progettato per ricostruire e migliorare i motivi tradizionali del patrimonio culturale attraverso la segmentazione semantica, il potenziamento delle caratteristiche mediante meccanismi di attenzione, la ricostruzione generativa e la sintesi di stili artistici. Questo studio ha utilizzato dataset pubblici di immagini artistiche e del patrimonio culturale, inclusi il dataset Miao Batik e il dataset WikiArt. La ricerca non ha coinvolto partecipanti umani, dati di pazienti, informazioni personali, soggetti animali o cartelle cliniche; pertanto, non è stata richiesta l'approvazione del comitato etico istituzionale né il consenso informato. Inizialmente, il dataset dei motivi culturali Miao Batik e il dataset WikiArt sono stati utilizzati per la valutazione. Il dataset Miao Batik è stato descritto in Quan et al. (2024)32 ed è composto da 15.148 immagini annotate di motivi tradizionali di batik Miao. Le annotazioni esistenti fornite dagli autori del dataset sono state utilizzate direttamente, senza generare ulteriori annotazioni manuali in questo studio. Successivamente, è stato effettuato il pre-elaborazione delle immagini mediante ridimensionamento, normalizzazione, riduzione del rumore e creazione di una maschera di segmentazione. I parametri esatti del pre-elaborazione sono descritti nella sottosezione Pre-elaborazione dei dati. Il framework proposto utilizza un modello basato su trasformatori, denominato SegFormer-B2, per la segmentazione semantica dei dati. Il metodo è progettato per rilevare le regioni chiave dei motivi culturali e apprenderne la struttura. Le caratteristiche segmentate vengono quindi potenziate attraverso un meccanismo di attenzione, in cui le informazioni rilevanti relative ai motivi culturali sono enfatizzate e quelle irrilevanti sono scartate. La configurazione del meccanismo di attenzione è descritta nella sottosezione CAFFM. Le caratteristiche potenziate vengono poi elaborate da CycleGAN, dove le strutture danneggiate sono ricostruite mediante apprendimento ciclico. Durante l'addestramento, campioni di motivi incompleti sono stati artificialmente creati applicando operazioni di mascheratura casuale e occlusione parziale alle immagini originali di batik Miao. Queste procedure di degrado hanno simulato la perdita di regioni del motivo e danni strutturali comunemente osservati in manufatti del patrimonio culturale deteriorati. Le immagini risultanti, incomplete, sono state utilizzate come input per il modulo di ricostruzione di CycleGAN, mentre le immagini originali corrispondenti sono state utilizzate come obiettivi di ricostruzione. I motivi del patrimonio culturale ricostruiti vengono quindi potenziati tramite SPADE, dove il miglioramento artistico è eseguito sulla base delle mappe di segmentazione generate. Le prestazioni del framework proposto sono state valutate mediante metriche quantitative di segmentazione e qualità dell'immagine, mentre l'autenticità visiva dei motivi culturali ricostruiti è stata valutata qualitativamente. L'autenticità visiva è stata valutata mediante ispezione visiva dei motivi culturali generati e non è stata utilizzata come metrica quantitativa indipendente. La valutazione si è concentrata sulla conservazione del motivo, coerenza semantica, caratteristiche culturali, coerenza strutturale e aspetto artistico rispetto ai corrispondenti motivi culturali di riferimento. La valutazione quantitativa delle prestazioni del modello è stata effettuata utilizzando Accuratezza di Segmentazione, Indice di Intersezione rispetto all'Unione (IoU), Coefficiente di Dice, Structural Similarity Index Measure (SSIM), Peak Signal-to-Noise Ratio (PSNR) e Fréchet Inception Distance (FID). Figura 2 illustra il flusso di lavoro complessivo del framework proposto SegCycle-SPADE e riassume le metriche di valutazione utilizzate in questo studio.
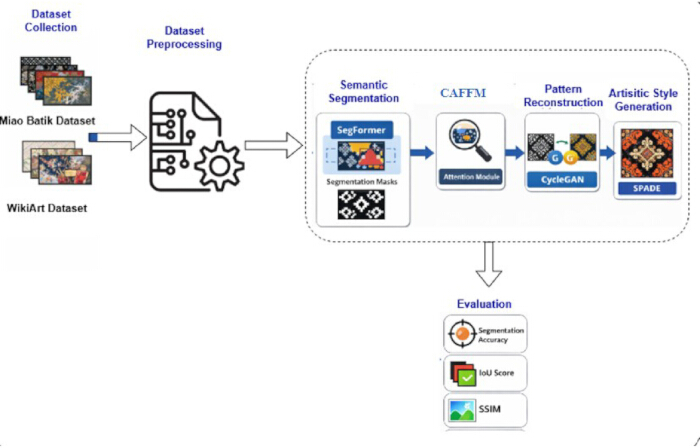
Figura 2. Flusso Architetturale Generale del Framework Proposto SegCycle-SPADE. Panoramica dell'intero flusso di lavoro di SegCycle-SPADE. Le immagini provenienti dai set di dati Miao Batik e WikiArt vengono preelaborate prima di essere sottoposte a segmentazione semantica mediante SegFormer-B2, potenziamento delle caratteristiche tramite CAFFM, ricostruzione del pattern mediante CycleGAN e generazione dello stile artistico tramite SPADE. Le prestazioni del modello vengono valutate utilizzando l'accuratezza della segmentazione, l'Intersection over Union (IoU), il coefficiente di Dice, l'indice di similarità strutturale (SSIM), il PSNR e la Fréchet Inception Distance (FID), mentre l'autenticità visiva viene valutata in modo qualitativo. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Il framework SegCycle-SPADE per la ricostruzione di motivi del patrimonio culturale è progettato per integrare diversi componenti di apprendimento profondo (DL) al fine di ottenere una segmentazione precisa dei motivi, una loro ricostruzione e un miglioramento artistico, come illustrato nella Figura 2. Vengono utilizzate immagini dal dataset dei motivi culturali del Batik Miao e dal dataset WikiArt per fornire una varietà di pattern culturali e stili artistici. Inizialmente, le immagini vengono elaborate tramite un modulo di segmentazione semantica basato su SegFormer, per identificare e delimitare i motivi culturali rispetto allo sfondo. L'architettura complessiva comprende quattro fasi principali. In primo luogo, il modello SegFormer estrae mappe di segmentazione semantica dalle immagini dei pattern culturali. In secondo luogo, il CAFFM integra le caratteristiche di segmentazione con rappresentazioni generative per potenziare l'apprendimento delle caratteristiche. In terzo luogo, il modulo CycleGAN ricostruisce i pattern culturali utilizzando le rappresentazioni di caratteristiche fuse. Infine, il modulo SPADE genera output artisticamente migliorati preservando la coerenza strutturale attraverso una sintesi guidata dalla segmentazione. Le mappe di caratteristiche affinate vengono successivamente elaborate dal modulo di ricostruzione CycleGAN, che apprende a ripristinare i motivi culturali incompleti mappando i pattern degradati alle loro forme complete corrispondenti. Campioni di motivi incompleti sono stati generati applicando operazioni casuali di mascheramento e occlusione parziale alle immagini originali del Batik Miao, simulando così regioni di pattern mancanti e degrado strutturale comunemente osservati in manufatti culturali danneggiati. Ogni immagine degradata è stata abbinata all'immagine originale corrispondente, che ha funto da obiettivo di ricostruzione durante l'addestramento. Questa strategia ha permesso al modulo CycleGAN di apprendere il ripristino delle strutture dei motivi mancanti preservando coerenza semantica e caratteristiche culturalmente significative. Infine, il generatore SPADE produce output artistici visivamente migliorati condizionando la sintesi dell'immagine sulle mappe di segmentazione generate, mantenendo così l'integrità strutturale dei motivi culturali durante tutto il processo di miglioramento artistico.
Nei passaggi seguenti sono descritti i componenti del framework proposto SegCycle-SPADE.
Passaggio 1: Raccolta del dataset
Per raggiungere gli obiettivi di apprendimento dei modelli culturali e di generazione dello stile artistico, sono stati utilizzati due dataset. Il Miao Batik Cultural Motif Dataset è stato impiegato per fornire informazioni sui modelli culturali tradizionali. Il dataset è disponibile pubblicamente su Zenodo (https://doi.org/10.5281/zenodo.20807658) e contiene 15.148 immagini annotate di motivi tradizionali di batik Miao. Le annotazioni esistenti fornite dagli autori del dataset sono state utilizzate direttamente, senza generare ulteriori annotazioni manuali in questo studio. Il dataset WikiArt è stato utilizzato per fornire informazioni diversificate sullo stile artistico, necessarie alla generazione dello stile artistico, ed è stato ottenuto dal repository pubblico WikiArt (https://www.wikiart.org/).
Passaggio 2: Preelaborazione dei dati
Tutte le immagini sono state preelaborate mediante ridimensionamento, normalizzazione e riduzione del rumore. Le annotazioni esistenti relative ai motivi culturali, ottenute dalle fonti originali del set di dati, sono state utilizzate per supportare la fase di segmentazione semantica. Non sono state eseguite ulteriori procedure di annotazione o ri-etichettatura nell'ambito di questo studio.
Passaggio 3: Segmentazione dei Motivi Semantici mediante SegFormer
Il modello SegFormer è stato utilizzato per la segmentazione dei motivi culturali. Il backbone esatto di SegFormer e la strategia di inizializzazione sono descritti nel sottosezione Semantic Pattern Segmentation Using SegFormer. In particolare, è stata impiegata l'architettura SegFormer-B2 con un backbone MIT-B2 preaddestrato su ImageNet per la segmentazione semantica dei motivi. Questo modello cattura efficacemente le informazioni contestuali globali preservando al contempo i dettagli strutturali complessi dei pattern culturali tradizionali.
Passaggio 4: CAFFM
Il CAFFM combina caratteristiche di segmentazione semantica con rappresentazioni generative, consentendo al framework di apprendere sia le caratteristiche dei motivi strutturali sia le informazioni relative allo stile artistico. I dettagli dell'integrazione del CAFFM sono forniti nel sottosezione CAFFM. Il modulo è posizionato tra la fase di segmentazione semantica basata su SegFormer e la fase di ricostruzione generativa, dove fonde le caratteristiche strutturali derivate dalla segmentazione con le caratteristiche di ricostruzione attraverso un'attenzione incrociata multi-testa. Questo processo migliora la preservazione dei motivi culturali e aumenta il realismo degli output ricostruiti.
Passaggio 5: Ricostruzione del Modello (CycleGAN)
Le caratteristiche fuse vengono successivamente elaborate dal modulo CycleGAN per ricostruire le strutture dei modelli culturali. L'architettura CycleGAN e la configurazione di addestramento sono descritte nel sottosezione Ricostruzione del Modello Mediante CycleGAN. Il modulo di ricostruzione è composto da due generatori e due discriminatori, utilizza un'architettura di generatore basata su rete residua con nove blocchi residui, impiega un discriminatore PatchGAN e viene addestrato utilizzando perdite avversarie e di coerenza ciclica. Questa configurazione consente una mappatura bidirezionale tra domini e facilita la ricostruzione di strutture di modelli culturali incomplete.
Passaggio 6: Generazione di Stile Artistico (SPADE)
I modelli ricostruiti vengono quindi elaborati attraverso il modulo SPADE per eseguire una sintesi stilistica artistica guidata dalla segmentazione. La configurazione del generatore SPADE è descritta nel sottosezione Artistic Style Generation Using SPADE. Il modulo utilizza blocchi residui SPADE, strati di normalizzazione adattiva spaziale e condizionamento semantico derivati dalle mappe di segmentazione di SegFormer e dalle rappresentazioni delle caratteristiche CAFFM. Condizionando la generazione delle immagini sulle mappe di segmentazione, gli output sintetizzati mantengono un allineamento strutturale con i motivi culturali originali, integrando al contempo caratteristiche stilistiche artistiche.
Passaggio 7: Valutazione delle Prestazioni
Il framework proposto è stato valutato utilizzando diverse metriche di segmentazione e di valutazione della qualità delle immagini, tra cui Accuratezza di Segmentazione, IoU, Coefficiente di Similarità di Dice (Dice), SSIM, PSNR e FID. Per valutare la coerenza sperimentale, tutti gli esperimenti sono stati ripetuti cinque volte utilizzando diversi semi casuali, e i risultati sono riportati come media ± deviazione standard. La significatività statistica è stata valutata mediante test t appaiati, con una soglia di significatività di p < 0,05.
Raccolta del dataset
Nel framework proposto di SegCycle-SPADE, vengono utilizzati due dataset per la comprensione dei modelli culturali e l'apprendimento dello stile. Il primo dataset impiegato nel framework proposto è il dataset dei motivi culturali del Batik Miao. Questo dataset contiene motivi culturali del Batik Miao, generalmente immagini tradizionali del Batik Miao che raffigurano elementi come animali, piante e forme geometriche, utilizzati nell'arte dell'etnia Miao. Il dataset comprende immagini ricche di informazioni testurali, generalmente importanti per la conservazione del patrimonio culturale. Il secondo dataset impiegato nel framework proposto di SegCycle-SPADE è il dataset WikiArt. Questo dataset contiene un elevato numero di opere d'arte, provenienti generalmente da stili diversi. Il dataset viene utilizzato per l'apprendimento di stili complessi, utile in generale per migliorare le opere artistiche. Il dataset comprende 80.000 opere d'arte in alta definizione, con 27 design differenti, risultando particolarmente adatto per compiti di generazione o trasformazione dello stile basati su reti neurali profonde (DL).
Dataset Miao Batik:
Il dataset Miao Batik (https://doi.org/10.5281/zenodo.20807658) comprende 15.148 immagini di motivi batik che raffigurano elementi culturalmente significativi. Le immagini includono una varietà di disegni tradizionali, come motivi animali (ad esempio farfalle e pesci), pattern a base vegetale e motivi geometrici portatori di simbolismo culturale. Questo dataset rappresenta un componente fondamentale del framework proposto poiché fornisce strutture culturali autentiche che permettono al modulo di segmentazione di identificare e preservare con precisione i confini dei motivi durante la ricostruzione del pattern (Tabella 1). In questo studio, i motivi culturalmente importanti si riferiscono a elementi visivi simbolici comunemente documentati nella letteratura sul patrimonio culturale Miao e rappresentati nelle annotazioni del dataset, inclusi uccelli, farfalle, motivi floreali e totem ancestrali. Tali motivi sono stati selezionati sulla base della loro documentata rilevanza culturale e della loro ricorrenza nei tradizionali disegni Miao di batik e ricami, piuttosto che esclusivamente sulla frequenza di occorrenza o sulla composizione spaziale. Le annotazioni dei motivi guidate da esperti e le etichette di segmentazione sono state ottenute dalla fonte originale del dataset Miao Batik e sono state utilizzate direttamente in questo studio. Gli autori non hanno effettuato ulteriori annotazioni manuali, ripetizioni dell'etichettatura o procedure di annotazione guidate da esperti. Le annotazioni esistenti fornite dai creatori del dataset sono state impiegate per l'addestramento e la valutazione della segmentazione semantica.
| Parametro | Descrizione |
| Nome del dataset | Miao Batik Cultural Pattern Dataset |
| Fonte del dataset | Archivio Zenodo (DOI: 10.5281/zenodo.20807658) |
| Ambito | Patrimonio Culturale Imateriale (ICH) / Analisi dei Motivi Tessili |
| Numero totale di immagini | 15.148 immagini |
| Tipo di immagine | Immagini digitali di motivi tradizionali tessili batik Miao |
| Categorie di motivi | Motivi animali, motivi vegetali e motivi geometrici |
| Origine culturale | Cultura etnica Miao, Provincia di Guizhou, Cina |
| Risoluzione originale delle immagini | Immagini ad alta risoluzione (tipicamente ≥ 1.000 pixel sul lato più corto) acquisite come scansioni o fotografie grezze prima della pre-elaborazione |
| Risoluzione per l'addestramento | Immagini ridimensionate a 256 × 256 pixel durante la pre-elaborazione |
| Disponibilità di annotazioni | Le annotazioni di segmentazione esistenti fornite dai creatori del dataset sono state utilizzate senza modifiche per l'addestramento e la valutazione. Nessuna ulteriore annotazione manuale, ri-etichettatura o procedura di verifica da esperti è stata effettuata in questo studio. |
| Applicazione in questo studio | Segmentazione dei motivi culturali, estrazione delle caratteristiche, conservazione dei motivi e ricostruzione dei pattern |
Tabella 1: Caratteristiche del Dataset dei Motivi Culturali del Batik Miao. Sintesi del dataset di motivi culturali del batik Miao utilizzato per la segmentazione semantica, l'analisi dei pattern culturali e la ricostruzione dei motivi. La tabella descrive la provenienza del dataset, le caratteristiche delle immagini, le categorie di motivi, l'origine culturale, la risoluzione delle immagini e il ruolo all'interno del framework proposto SegCycle-SPADE.
Dataset WikiArt:
Il dataset WikiArt [https://www.wikiart.org/] è un ampio archivio digitale di arte molto utilizzato, composto da oltre 80.000 immagini appartenenti a 27 stili artistici diversi riportati nella Tabella 2. Gli stili includono l'arte rinascimentale, l'impressionismo, il cubismo e il surrealismo. Il dataset riveste un'importanza fondamentale nel framework proposto, poiché fornisce le conoscenze necessarie affinché il modulo SPADE possa generare motivi arricchiti culturalmente mantenendo al contempo le informazioni strutturali ottenute dal processo di segmentazione. Il dataset comprende 56.000 immagini per l'apprendimento e 12.000 immagini destinate sia alla validazione che ai test. Le immagini presenti nel dataset contribuiscono in modo efficace all'addestramento del modello di apprendimento profondo (DL).
| Parametro | Descrizione |
| Nome del dataset | Dataset WikiArt |
| Fonte del dataset | Archivio WikiArt (https://www.wikiart.org/) |
| Dominio | Arte digitale e dipinti |
| Numero totale di immagini | Circa 80.000 opere d'arte |
| Immagini di addestramento | 56.000 |
| Immagini di validazione | 12.000 |
| Immagini di test | 12.000 |
| Stili artistici | 27 stili artistici, tra cui Rinascimento, Impressionismo, Cubismo, Surrealismo, Espressionismo, Realismo e Arte astratta |
| Risoluzione originale delle immagini | Le risoluzioni originali delle immagini variano a seconda delle opere e delle fonti. Le immagini sono state ridimensionate a una risoluzione uniforme di 256 × 256 pixel durante la fase di preelaborazione. |
| Risoluzione di addestramento | Le immagini sono state ridimensionate a 256 × 256 pixel durante la preelaborazione, prima dell'apprendimento dello stile artistico e della sintesi guidata dalla segmentazione. |
| Partizionamento del dataset | Partizionamento casuale stratificato (70% addestramento, 15% validazione e 15% test) utilizzando un seme casuale fisso pari a 42 |
| Strategia di campionamento degli stili | È stato adottato un campionamento proporzionale stratificato per preservare la distribuzione dei 27 stili artistici nei sottoinsiemi di addestramento, validazione e test |
| Applicazione in questo studio | Apprendimento dello stile artistico, rappresentazione dello stile e sintesi artistica guidata dalla segmentazione |
Tabella 2: Caratteristiche del Dataset WikiArt. Riepilogo del dataset WikiArt utilizzato per l'apprendimento dello stile artistico e la sintesi di immagini guidata dallo stile. La tabella descrive la provenienza del dataset, la distribuzione delle immagini, la copertura degli stili artistici, la suddivisione del dataset, la risoluzione delle immagini e la sua applicazione all'interno del framework proposto SegCycle-SPADE.
Il dataset Miao Batik contiene 15.148 immagini rappresentative di motivi culturali tradizionali Miao.32 Il dataset è disponibile pubblicamente tramite Zenodo (https://doi.org/10.5281/zenodo.20807658). Prima dell'addestramento del modello, tutte le immagini sono state ispezionate visivamente, ridimensionate a 256 × 256 pixel, normalizzate e verificate per individuare campioni corrotti o duplicati. Il controllo di qualità non ha portato all'esclusione di alcuna immagine; pertanto, tutte le 15.148 immagini sono state mantenute per le analisi successive. Il dataset è stato suddiviso casualmente in sottoinsiemi di addestramento (70%), validazione (15%) e test (15%) utilizzando un seme casuale fisso pari a 42, al fine di garantire la riproducibilità delle suddivisioni. Il dataset WikiArt è stato ottenuto tramite il repository ufficiale WikiArt (https://www.wikiart.org/) e contiene oltre 80.000 opere d'arte appartenenti a 27 stili artistici differenti. Per gli esperimenti di apprendimento dello stile, sono state utilizzate 56.000 immagini per l'addestramento, 12.000 per la validazione e 12.000 per il test.
Preelaborazione dei dati
Prima di addestrare il framework proposto SegCycle-SPADE, il dataset dei motivi culturali del Batik Miao e il dataset WikiArt sono stati sottoposti a diverse fasi di preelaborazione per garantire una qualità dell'immagine coerente e una rappresentazione precisa delle caratteristiche. La stessa pipeline fondamentale di preelaborazione, inclusa la riduzione del rumore mediante filtro gaussiano, la normalizzazione, il ridimensionamento a una risoluzione di ingresso uniforme e la verifica della qualità delle immagini, è stata applicata a entrambi i dataset. Tuttavia, i dataset hanno svolto ruoli distinti all'interno del framework. Il dataset WikiArt è stato utilizzato per l'apprendimento e la sintesi dello stile artistico, mentre il dataset Batik Miao è stato impiegato principalmente per la segmentazione e la ricostruzione dei motivi culturali. Non sono state apportate modifiche specifiche ai dataset al di là di questi ruoli specifici del compito. Per garantire un'elaborazione coerente da parte del modello di apprendimento profondo (DL), le immagini sono state innanzitutto ridimensionate a una risoluzione fissa. Questo passaggio era necessario poiché le immagini nei due dataset presentavano risoluzioni diverse a seconda della fonte. Il ridimensionamento ha migliorato l'efficienza computazionale e ha impedito che inconsistenze dimensionali influenzassero l'addestramento. Il secondo passaggio di preelaborazione è stato quello della normalizzazione, in cui i valori dei pixel sono stati scalati a un intervallo standardizzato per stabilizzare gli aggiornamenti del gradiente durante l'addestramento. Successivamente, le immagini sono state elaborate mediante filtraggio gaussiano per ridurre il rumore che avrebbe potuto interferire con le strutture dei motivi culturali. Per il dataset Batik Miao, le maschere di segmentazione esistenti dei motivi culturali, ottenute direttamente dalla fonte originale del dataset, sono state utilizzate senza modifiche per l'addestramento e la valutazione della segmentazione semantica. Non sono state generate nuove maschere di segmentazione specificamente per questo studio.
Salvo diversa indicazione, le equazioni che descrivono metodi consolidati sono state adattate da studi precedenti e citate di conseguenza. Le equazioni che descrivono il CAFFM proposto e il framework composito di ottimizzazione SegCycle-SPADE sono state sviluppate dagli autori per questo studio.
Si consideri un'immagine di input del dataset rappresentata come Equazione 1:
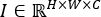 (1)
Qui, H, W e C indicano rispettivamente l'altezza dell'immagine, la larghezza e il numero di canali colore. Tutte le immagini vengono ridimensionate a una dimensione fissa H′ × W′, come mostrato nella Equazione 2:
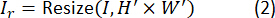
Qui, Ir è l'immagine ridimensionata. I valori normalizzati dei pixel sono calcolati secondo la Equazione 3:
 (3)
Ciò contribuisce a stabilizzare la procedura di addestramento. La filtrazione del rumore viene eseguita utilizzando un filtro gaussiano come mostrato nella Equazione 4:
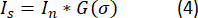
Qui, G(σ) è un filtro gaussiano e * rappresenta la convoluzione. È stato utilizzato un filtro gaussiano con kernel 5 × 5 e deviazione standard σ = 1.0. È stato applicato un padding riflettente ai pixel dei bordi al fine di ridurre gli artefatti ai margini. Prima della riduzione di scala e della normalizzazione, il processo di denoising è stato eseguito immediatamente dopo il caricamento dell'immagine. Per garantire una pre-elaborazione uniforme durante l'intero studio, la stessa configurazione del filtro è stata applicata a ogni immagine nei dataset Miao Batik e WikiArt. Per il dataset Miao Batik, le maschere di segmentazione sono create in base all'Equazione 5:

In questo caso, M è una maschera di segmentazione utilizzata per guidare il modello SegFormer.
La pipeline di preelaborazione inizia con l'acquisizione di immagini dal dataset Miao Batik e dal dataset WikiArt, come mostrato in Figura 3. Durante l'addestramento non sono state impiegate tecniche di aumento dei dati. Dopo la preelaborazione, che includeva ridimensionamento, normalizzazione, denoising gaussiano e preparazione delle maschere di segmentazione, le immagini sono state utilizzate direttamente per l'addestramento, la validazione e il test del framework proposto SegCycle-SPADE. Il primo passaggio della pipeline di preelaborazione consiste nel ridimensionare le immagini a una dimensione fissa, consentendo al modello di apprendimento profondo di elaborarle in modo più efficiente. Il secondo passaggio riguarda la normalizzazione, che converte i valori dei pixel in un intervallo numerico standardizzato e facilita la convergenza del modello. Il terzo passaggio prevede la rimozione del rumore, mediante il quale le immagini vengono ripulite da rumori indesiderati per migliorare il riconoscimento dei pattern. Inoltre, per il dataset Miao Batik, le regioni dei motivi culturali vengono annotate, consentendo la generazione di maschere utilizzate nel modulo di segmentazione del modello proposto, garantendo così che i motivi culturali siano preservati durante la generazione. L'output finale di questa fase è un dataset pulito, pronto per l'addestramento dei moduli di segmentazione e generazione del modello proposto.
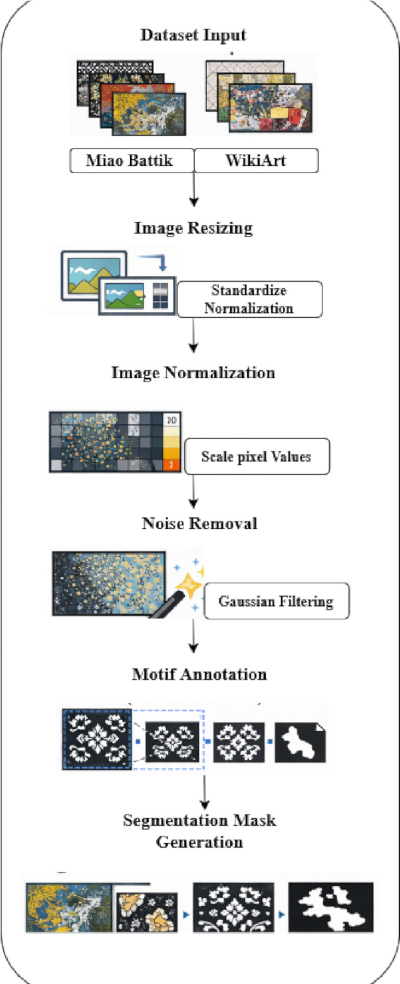
Figura 3. Pipeline di pre-elaborazione dei dati per immagini del patrimonio culturale. Flusso di lavoro che illustra le procedure di pre-elaborazione delle immagini applicate prima dell'addestramento del modello. La pipeline include l'acquisizione del dataset, il ridimensionamento delle immagini, la normalizzazione, la riduzione del rumore gaussiano, le annotazioni esistenti dei motivi culturali e la preparazione delle maschere di segmentazione. Le immagini e le maschere risultanti vengono utilizzate come input per la segmentazione semantica e la ricostruzione dei pattern. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Ogni immagine è stata sottoposta a un processo di controllo qualità prima dell'addestramento del modello. Il dataset Miao Batik conteneva 15.148 immagini. Campioni corrotti, duplicati e di bassa qualità erano già stati gestiti dai creatori originali del dataset; pertanto, nessun'ulteriore immagine è stata esclusa durante il controllo qualità in questo studio. Di conseguenza, tutte le 15.148 immagini sono state mantenute per l'analisi. Le immagini sono state caricate in formato RGB durante il pre-elaborazione e ridimensionate a 256 × 256 pixel utilizzando l'interpolazione bilineare. I valori dei pixel sono stati scalati dall'intervallo [0, 255] a [0, 1] dividendo per 255. Successivamente è stata applicata una normalizzazione per canale utilizzando valori medi di [0,485, 0,456, 0,406] e valori di deviazione standard di [0,229, 0,224, 0,225] per i canali rosso, verde e blu, rispettivamente. La pipeline di pre-elaborazione includeva il caricamento delle immagini, la conversione in RGB, il ridimensionamento, la scalatura dei valori dei pixel, la normalizzazione e la conversione in tensori. Quando necessario, le immagini in scala di grigi sono state convertite in formato RGB a tre canali per mantenere la compatibilità con i modelli di apprendimento profondo. Dopo il pre-elaborazione, le immagini sono state suddivise in sottoinsiemi di addestramento, validazione e test. Tutte le fasi del framework SegCycle-SPADE—compresa la segmentazione semantica, la fusione di caratteristiche, la ricostruzione del motivo e la sintesi artistica basata su SPADE—hanno utilizzato una risoluzione di ingresso costante di 256 × 256 pixel.
Segmentazione Semantica mediante SegFormer
Dopo questa fase di preelaborazione, le immagini pulite e normalizzate del dataset dei motivi culturali del Batik Miao e del dataset WikiArt vengono inserite nel modulo di segmentazione semantica basato sul framework proposto di SegFormer-B2. Lo scopo di questo passaggio è identificare correttamente e separare i motivi culturali presenti nei modelli del patrimonio. Il framework proposto di SegFormer si basa su un'architettura transformer che incorpora un codificatore Transformer gerarchico e un decoder MLP leggero per catturare con precisione informazioni contestuali globali e informazioni strutturali dettagliate da complessi modelli del patrimonio. Il modello estrae innanzitutto rappresentazioni delle caratteristiche a diverse scale dall'immagine in ingresso, seguite da una fusione di queste rappresentazioni attraverso il decoder per generare modelli segmentati accurati. Ciò garantisce che i modelli nell'immagine del patrimonio vengano segmentati correttamente in motivi come pattern geometrici, pattern floreali e pattern simbolici, separandoli così dallo sfondo mantenendone l'integrità strutturale. Queste informazioni strutturali vengono successivamente utilizzate nelle fasi successive di generazione del modello all'interno del framework SegCycle-SPADE.
Si indichi l'immagine in ingresso preelaborata con Equazione 6:
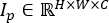 (6)
L'encoder SegFormer suddivide l'immagine in porzioni ed estrae caratteristiche gerarchiche utilizzando strati transformer, come mostrato nella Equazione 71:
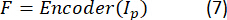
Qui, F indica le mappe di caratteristiche multiscala ottenute dall'encoder transformer. Queste caratteristiche codificano sia i pattern locali di texture sia le relazioni contestuali globali tra le regioni del motivo. Il modello SegFormer estrae le mappe di caratteristiche a diverse scale come definito nella Equazione 8:
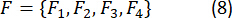
L'uso di rappresentazioni multiscala facilita il rilevamento di schemi di dimensioni diverse all'interno di motivi culturali. Infine, le caratteristiche vengono combinate utilizzando il decodificatore MLP come mostrato nella Equazione 91:
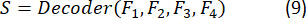
Qui, S indica la mappa finale di segmentazione predetta.
Il modello SegFormer-B2 è stato inizializzato utilizzando pesi preaddestrati su ImageNet e successivamente affinato sul dataset Miao Batik per la segmentazione di motivi culturali. Il checkpoint preaddestrato è stato ottenuto dall'implementazione ufficiale di SegFormer. In particolare, il checkpoint MIT-B2 preaddestrato su ImageNet-1K (mit_b2.pth) fornito dal repository ufficiale di SegFormer è stato utilizzato per inizializzare il modello SegFormer-B2 prima dell'affinamento. I pesi preaddestrati corrispondono al modello MIT-B2 rilasciato dagli autori di SegFormer e sono stati impiegati come modello iniziale per l'addestramento alla segmentazione semantica. I restanti strati specifici per il compito sono stati inizializzati utilizzando le procedure di inizializzazione dei pesi predefinite di PyTorch prima dell'addestramento.
Viene utilizzato un codificatore Transformer gerarchico a quattro stadi con incorporamenti di patch sovrapposti. Nella fase iniziale, la dimensione della patch è stata impostata a 7 × 7 con uno stride di 4. Per ciascuno dei quattro stadi del codificatore, le dimensioni degli incorporamenti erano rispettivamente 64, 128, 320 e 512. Nei quattro stadi erano presenti 1, 2, 5 e 8 testine di attenzione multi-testa, e le profondità corrispondenti del codificatore erano rispettivamente di 3, 4, 6 e 3 livelli. Le caratteristiche multiscala recuperate dal codificatore sono state aggregate utilizzando un decoder completamente basato su MLP leggero. Prima di generare la mappa finale di segmentazione, il decoder ha proiettato le caratteristiche di ogni stadio del codificatore in un singolo spazio di incorporamento. Tutti i blocchi Transformer hanno utilizzato la funzione di attivazione Gaussian Error Linear Unit (GELU). Durante l'addestramento è stato applicato un tasso di dropout pari a 0,1 per migliorare la capacità di generalizzazione e ridurre l'overfitting.
Durante la fase di addestramento, il framework SegFormer riceve le immagini preelaborate da entrambi i dataset. Le immagini del dataset Miao Batik contengono regioni di motivi che fungono da etichette per l'apprendimento supervisionato del modello di segmentazione. L'encoder Transformer elabora l'intera immagine e cattura le relazioni a lungo raggio tra i componenti dell'immagine, aspetto particolarmente importante per i motivi tradizionali del batik che presentano elementi distribuiti spazialmente. Il meccanismo gerarchico di estrazione delle caratteristiche cattura contemporaneamente strutture locali, come texture geometriche ripetute. Il decoder MLP elabora queste caratteristiche estratte e produce una maschera di segmentazione che evidenzia le regioni dei motivi. Le mappe di segmentazione generate in questa fase vengono successivamente utilizzate come input strutturali per il modulo di attenzione e per la fase di ricostruzione del motivo, contribuendo così a preservare l'autenticità dei pattern generati.
I motivi culturali sono stati suddivisi in diverse classi per la segmentazione semantica in base alle loro caratteristiche visive e culturali. La tassonomia di segmentazione comprendeva motivi animali (ad esempio, farfalle, pesci, uccelli e altre fauna simboliche), motivi vegetali (ad esempio, fiori, foglie, rampicanti e motivi botanici), motivi geometrici (ad esempio, forme ripetute, bordi e strutture geometriche astratte) e aree di sfondo che rappresentano zone prive di motivi. Per assegnare ogni pixel a una delle classi predefinite sono state utilizzate maschere di segmentazione a livello di pixel. Le etichette intere sono state codificate come segue: Etichetta 0 = sfondo, Etichetta 1 = motivi animali, Etichetta 2 = motivi vegetali ed Etichetta 3 = motivi geometrici. Le annotazioni di segmentazione e le etichette dei motivi sono state ottenute direttamente dalla fonte originale del dataset Miao Batik. In questo studio non sono state eseguite ulteriori annotazioni manuali, modifiche delle etichette, verifiche dei contorni o procedure di conferma da esperti. Le annotazioni esistenti fornite dai creatori del dataset sono state utilizzate senza modifiche per l'addestramento e la valutazione.
Il modello SegFormer per la segmentazione di motivi culturali elabora le immagini preelaborate del dataset Miao Batik e del dataset WikiArt mediante un meccanismo basato su trasformatori per una rilevazione accurata delle aree di motivi culturali, come mostrato in Figura 4. In primo luogo, l'immagine in ingresso contenente motivi culturali tradizionali viene fornita al modello SegFormer. L'encoder basato su trasformatori estrae sia informazioni contestuali globali sia caratteristiche strutturali locali da porzioni dell'immagine. Le caratteristiche risultanti multiscala vengono fornite al decoder di segmentazione, che utilizza una rete feed-forward ibrida per affinare le rappresentazioni delle caratteristiche e migliorare il rilevamento dei motivi. L'uscita del modello SegFormer è una maschera di segmentazione che evidenzia i pixel corrispondenti ai motivi culturali, sopprimendo al contempo le informazioni di sfondo irrilevanti. I motivi culturali isolati fungono quindi da guida strutturale per le fasi successive del framework SegCycle-SPADE.
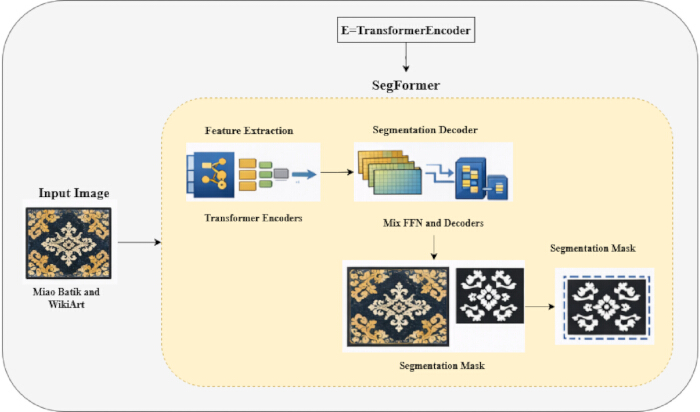
Figura 4. Segmentazione semantica basata su SegFormer-B2 dei motivi culturali. Architettura del modulo di segmentazione semantica SegFormer-B2 utilizzato per l'estrazione dei motivi culturali, addestrato esclusivamente sul dataset Miao Batik. Il framework è composto da un encoder basato su trasformatori per l'estrazione di caratteristiche multiscala e da un decoder leggero per la generazione di maschere dei motivi. Il modello predice quattro classi semantiche—animale, vegetale, geometrico e sfondo—dove le maschere di segmentazione risultanti identificano le regioni dei motivi culturalmente significativi sopprimendo le informazioni di sfondo irrilevanti. Questi output di segmentazione forniscono un orientamento strutturale per le fasi successive di fusione delle caratteristiche, ricostruzione e sintesi artistica del framework proposto SegCycle-SPADE. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Non è necessario creare nuove annotazioni per la segmentazione nel framework proposto. Il dataset Miao Batik è stato ottenuto da una fonte pubblica già esistente e il modello è stato addestrato utilizzando le informazioni sui motivi fornite dagli autori del dataset. Durante il processo di apprendimento, il modello SegFormer ha prodotto mappe di segmentazione semantica. Di conseguenza, lo studio attuale non ha richiesto alcun software aggiuntivo per l'annotazione manuale, linee guida per l'annotazione o procedure di controllo della qualità delle annotazioni.
CAFFM
Per migliorare l'interazione tra le caratteristiche della segmentazione semantica e le rappresentazioni della ricostruzione generativa, lo studio ha proposto anche un CAFFM. L'encoder SegFormer-B2 fornisce mappe di caratteristiche semantiche al modulo CAFFM, mentre il passaggio di ricostruzione CycleGAN fornisce mappe di caratteristiche generative. In primo luogo, vengono utilizzati strati di proiezione lineare per proiettare entrambi i flussi di caratteristiche in uno spazio di embedding comune. Per il calcolo dell'attenzione incrociata, vengono create rappresentazioni di query (Q), chiave (K) e valore (V) utilizzando i tensori di caratteristiche generati. Le relazioni tra le informazioni sui motivi strutturali e gli elementi dello stile artistico vengono quindi modellate mediante attenzione incrociata multi-testa. Successivamente, vengono applicate normalizzazione dello strato, connessioni residue e strati feed-forward con attivazione GELU alle rappresentazioni di caratteristiche fuse. Lo stadio di sintesi basato su SPADE riceve l'output del modulo CAFFM, consentendo la preservazione di temi culturalmente significativi senza compromettere la coerenza artistica.
Per garantire la compatibilità delle caratteristiche, le caratteristiche di ingresso vengono inizialmente proiettate, mediante strati di proiezione lineare, in uno spazio di incorporamento condiviso con una dimensione di incorporamento pari a 256. Le interconnessioni tra le informazioni strutturali semantiche e le rappresentazioni stilistiche generative vengono quindi modellate utilizzando un meccanismo di attenzione incrociata MultiHead con otto testine di attenzione. Il calcolo dell'attenzione incrociata utilizza i vettori Query (Q), Key (K) e Value (V), prodotti da specifici strati di trasformazione lineare. Per aumentare la stabilità dell'addestramento e mantenere l'integrità delle caratteristiche, vengono impiegate connessioni residue e la normalizzazione del livello (Layer Normalization) per migliorare ulteriormente le rappresentazioni delle caratteristiche fuse. L'apprendimento non lineare delle caratteristiche viene quindi potenziato applicando una rete feed-forward con la funzione di attivazione Gaussian Error Linear Unit (GELU). Il modulo genera una rappresentazione delle caratteristiche in uscita di dimensione 256, che viene inviata ad altre fasi per la sintesi creativa. Il CAFFM combina con successo i dati dello stile artistico con le strutture dei motivi culturali mediante una tecnica di fusione basata sull'attenzione incrociata, migliorando così la preservazione dei motivi e la coerenza visiva nei modelli del patrimonio culturale ricostruiti.
Nel sistema proposto, le caratteristiche strutturali sono derivate dal dataset Miao Batik, mentre le caratteristiche stilistiche sono apprese dal dataset WikiArt. Sia la mappa delle caratteristiche ottenuta dalla rete di segmentazione SegFormer utilizzando immagini del dataset Miao Batik indicata con Fs, mentre la mappa delle caratteristiche derivata dal ramo di estrazione delle caratteristiche stilistiche utilizzando immagini WikiArt è indicata con Fa. Il CAFFM proposto combina i due domini delle caratteristiche mediante un meccanismo di cross-attenzione per apprendere sia le dipendenze strutturali che quelle stilistiche dei motivi culturali. Tabella 3 riporta tutte le caratteristiche architetturali, inclusi le dimensioni degli embedding, i livelli di normalizzazione, le funzioni di attivazione e la configurazione delle testine di attenzione. Per una dimensione dell'immagine in ingresso di 256 × 256 pixel, l'encoder SegFormer-B2 ha prodotto mappe delle caratteristiche semantiche di dimensione 64 × 64 × 128, mentre il ramo di estrazione delle caratteristiche stilistiche ha prodotto mappe delle caratteristiche di dimensione 64 × 64 × 128. Entrambe le mappe delle caratteristiche sono state proiettate attraverso strati lineari apprendibili in uno spazio di embedding condiviso di dimensione 256 prima della fusione mediante cross-attenzione.
| Parametro | Configurazione |
| Framework proposto | SegCycle-SPADE |
| Modello di segmentazione semantica | SegFormer-B2 |
| Stadi dell'encoder SegFormer | 4 |
| Inizializzazione dei pesi | SegFormer-B2 preaddestrato su ImageNet-1K (backbone MIT-B2) |
| Origine del checkpoint | Repository ufficiale NVIDIA SegFormer (https://github.com/NVlabs/SegFormer); checkpoint: segformer.b2.512x512.ade.160k |
| Strategia di fine-tuning | Finetuning end-to-end sul dataset Miao Batik |
| Dimensione dell'embedding delle patch | 7 × 7 |
| Passo delle patch | 4 |
| Dimensioni dell'embedding | 64, 128, 320 e 512 |
| Profondità dell'encoder | 3, 4, 6 e 3 |
| Teste di attenzione | 1, 2, 5 e 8 |
| Tipo di decoder | Decoder completamente MLP |
| Funzione di attivazione | GELU |
| Tasso di dropout | 0,1 |
| Modulo di potenziamento delle caratteristiche | Modulo di fusione delle caratteristiche culturali con attenzione incrociata (CAFFM) |
| Dimensione dell'embedding CAFFM | 256 |
| Teste di attenzione CAFFM | 8 |
| Scale di fusione CAFFM | 4 |
| Modello di ricostruzione | CycleGAN |
| Modello di generazione dello stile | SPADE |
| Dataset culturale | Dataset Miao Batik |
| Dataset di stile | Dataset WikiArt |
| Immagini Miao Batik | 15.148 |
| Immagini WikiArt | Circa 80.000 |
| Risoluzione dell'immagine in ingresso | 256 × 256 pixel |
| Formato colore | RGB |
| Metodo di interpolazione | Interpolazione bilineare |
| Metodo di denoising | Filtraggio gaussiano |
| Dimensione del kernel gaussiano | 5 × 5 |
| Sigma gaussiana (σ) | 1 |
| Intervallo di normalizzazione | [0, 1] |
| Dimensione del batch | 16 |
| Numero di epoche | 100 |
| Ottimizzatore | Adam |
| Tasso di apprendimento | 0,0002 |
| Parametri Adam | β₁ = 0,5, β₂ = 0,999, ε = 1 × 10⁻⁸, weight decay = 0 |
| Funzioni di perdita | Perdita di segmentazione, perdita avversaria, perdita di coerenza ciclica, perdita di ricostruzione, perdita di preservazione del motivo e perdita di coerenza stilistica |
| Strategia di suddivisione del dataset | Addestramento / Validazione / Test |
| Set di addestramento | 70% |
| Set di validazione | 15% |
| Set di test | 15% |
| Seed casuale | 42 |
| Metriche di valutazione | Accuratezza di segmentazione, IoU, coefficiente Dice, SSIM, PSNR e FID |
| Linguaggio di programmazione | Python 3.8.10 |
| Framework di deep learning | PyTorch 1.10.0 |
| Piattaforma hardware | GPU NVIDIA RTX 3090 (24 GB VRAM), Intel Core i7 (11ª generazione), 32 GB RAM |
| Ambiente operativo | Ubuntu 20.04 LTS |
Tabella 3: Impostazione Sperimentale e Configurazione del Modello. Sintesi dei componenti architetturali, della configurazione di addestramento, delle impostazioni di preelaborazione, dei set di dati, dei parametri di ottimizzazione, delle metriche di valutazione e dell'ambiente computazionale utilizzati per l'implementazione e la valutazione del framework proposto SegCycle-SPADE.
Il modulo di attenzione mappa innanzitutto la mappa delle caratteristiche in rappresentazioni di query, chiave e valore utilizzando Equazione 10:
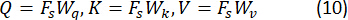
Qui, Wq, Wk e Wv sono matrici di pesi apprendibili. I pesi dell'attenzione vengono calcolati in base alla similarità tra il vettore query e il vettore chiave utilizzando l'Equazione 1117:
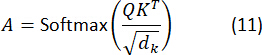
Qui, dk è la dimensione del vettore chiave. La rappresentazione delle caratteristiche migliorata viene calcolata moltiplicando i pesi dell'attenzione con la matrice dei valori utilizzando l'Equazione 12:
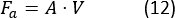
Qui, Fa è la rappresentazione migliorata della mappa delle caratteristiche. La rappresentazione migliorata delle caratteristiche viene calcolata combinando le caratteristiche originali di segmentazione con le caratteristiche potenziate ottenute mediante il meccanismo di attenzione utilizzando l'Equazione 13:
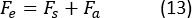
Qui, Fe è la mappa delle caratteristiche potenziata utilizzata per la ricostruzione del pattern. Il CAFFM viene esteso con un meccanismo di attenzione incrociata multiscala per estrarre caratteristiche relative a motivi culturali a diverse scale. Sia Fsi a indicare le caratteristiche di segmentazione alla scala i, mentre Faj indica le caratteristiche dello stile artistico alla stessa scala. La rappresentazione finale delle caratteristiche è definita mediante la Equazione 14:
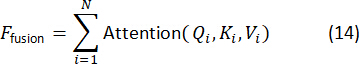
Qui, Qi, Ki e Vi rappresentano rispettivamente la matrice di query, la matrice di chiavi e la matrice dei valori alla scala i, mentre N indica il numero di scale delle caratteristiche. In questo studio, N = 4, corrispondente alle mappe delle caratteristiche estratte a risoluzioni spaziali di 1/4, 1/8, 1/16 e 1/32 rispetto alla dimensione dell'immagine in ingresso. Queste rappresentazioni multiscala delle caratteristiche sono state fuse utilizzando pesi di attenzione apprendibili prima della ricostruzione e della sintesi artistica. Questa estensione consente al metodo di estrarre motivi culturali e texture globali per ricostruire pattern culturali. CAFFM si colloca tra la fase di segmentazione basata su SegFormer e la fase di sintesi creativa basata su SPADE all'interno del sistema proposto SegCycle-SPADE. Inizialmente, mentre CycleGAN genera contemporaneamente caratteristiche di ricostruzione contenenti informazioni stilistiche e relative ai pattern, SegFormer-B2 recupera mappe di caratteristiche semantiche che descrivono le proprietà strutturali dei motivi culturali. Il modulo CAFFM riceve questi due flussi di caratteristiche e utilizza una fusione basata sull'attenzione incrociata per identificare le relazioni tra rappresentazioni strutturali e artistiche. Al fine di creare pattern culturalmente autentici mantenendo coerenza semantica e caratteristiche strutturali, le mappe di caratteristiche fuse risultanti vengono quindi inviate al modulo SPADE per la sintesi creativa guidata dalla segmentazione.
Ricostruzione del Modello mediante CycleGAN
Una volta completata la fase di potenziamento delle caratteristiche basata sull'attenzione, le mappe delle caratteristiche conterranno le strutture dei motivi culturali potenziate. Tuttavia, le mappe delle caratteristiche potrebbero ancora presentare regioni di motivi incompleti o danneggiate. Pertanto, per affrontare il problema della ricostruzione dei modelli, il framework proposto utilizzerà il modello CycleGAN. Nel framework proposto, i due domini saranno i modelli originali dei motivi culturali e i modelli ricostruiti dei motivi culturali. Utilizzando le caratteristiche potenziate ottenute dalle fasi precedenti, il modello CycleGAN ricostruirà i modelli culturali mantenendo la coerenza strutturale. Ciò garantirà che i modelli culturali, come quelli geometrici, floreali e simbolici, conservino la loro disposizione spaziale. Le immagini originali di Miao Batik sono state sottoposte a mascheratura casuale e operazioni di occlusione parziale per generare motivi culturali incompleti o danneggiati. Queste procedure di degrado hanno simulato regioni di modelli mancanti e danni strutturali comunemente osservati in reperti del patrimonio culturale deteriorati. Le immagini degradate sono state utilizzate come input per il modulo di ricostruzione, mentre le corrispondenti immagini originali sono servite come immagini di riferimento per la valutazione delle prestazioni e della qualità della ricostruzione. Questa strategia ha permesso al modello di apprendere il ripristino delle strutture dei motivi mancanti preservando al contempo la coerenza semantica e le caratteristiche culturali.
Lasciare X essere il dominio di modelli culturali incompleti e Y essere il dominio di schemi culturali ricostruiti. I due generatori apprendono a eseguire una mappatura bidirezionale utilizzando Equazione 15:
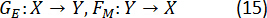
Qui, GE viene utilizzato per ricostruire le strutture dei motivi e FM viene utilizzato per mappare nuovamente i modelli al dominio originale. La perdita avversaria viene utilizzata per garantire che i modelli ricostruiti siano realistici (Equazione 16)30
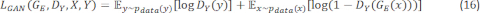
Qui, DY è il discriminatore utilizzato per distinguere i modelli reali da quelli ricostruiti, e GE(x) indica il modello ricostruito generato. CycleGAN impone inoltre la coerenza ciclica per preservare la disposizione strutturale dei motivi culturali (Equazione 17)30.
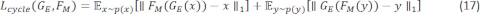
La funzione di perdita finale è definita utilizzando Equazione 1830:
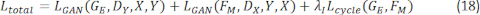
Qui, λi indica il coefficiente di ponderazione per la perdita di coerenza ciclica ed è stato impostato a 10 durante l'addestramento, in linea con la formulazione originale di CycleGAN. Questo valore è stato scelto per bilanciare l'apprendimento avversario e la coerenza di ricostruzione tra i domini sorgente e target.
Il modulo di ricostruzione CycleGAN è composto da due generatori e due discriminatori per la traduzione bidirezionale delle immagini. Ogni generatore segue un'architettura a rete residua costituita da un livello iniziale di convoluzione 7 × 7, seguito da due livelli di convoluzione di sottocampionamento, nove blocchi residui e due livelli di sovracampionamento. Tutte le operazioni di convoluzione utilizzano una dimensione del kernel pari a 3 × 3, ad eccezione del livello di ingresso, che impiega un kernel 7 × 7 per un'estrazione avanzata delle caratteristiche. Dopo ogni livello convoluzionale viene applicata la Normalizzazione per Istanza per migliorare la stabilità dell'addestramento, mentre l'attivazione ReLU viene utilizzata in tutta la rete del generatore. Il livello di uscita impiega una funzione di attivazione Tanh per generare uscite immagine normalizzate. Il discriminatore segue un'architettura PatchGAN 70 × 70, costituita da una serie di livelli convoluzionali con dimensioni del kernel pari a 4 × 4 e canali delle caratteristiche progressivamente crescenti. Nel discriminatore vengono impiegate la Normalizzazione per Istanza e l'attivazione LeakyReLU (pendenza negativa = 0,2) per migliorare la discriminazione delle caratteristiche e l'apprendimento avversario. Il modulo CycleGAN riceve in ingresso immagini preelaborate di motivi culturali e genera rappresentazioni di pattern ricostruiti, che vengono successivamente inviate al CAFFM per l'integrazione con le caratteristiche di segmentazione. L'addestramento del CycleGAN è stato eseguito utilizzando l'ottimizzatore Adam (β₁ = 0,5, β₂ = 0,999) con un tasso di apprendimento iniziale pari a 0,0002. Il tasso di apprendimento è stato mantenuto costante per le prime 100 epoche e successivamente ridotto linearmente a zero per il resto del periodo di addestramento. Per stabilizzare l'addestramento del discriminatore è stato utilizzato un buffer di riproduzione contenente 50 immagini precedentemente generate. I generatori e i discriminatori sono stati aggiornati con un rapporto di aggiornamento 1:1, con un aggiornamento del generatore seguito da un aggiornamento del discriminatore in ogni iterazione di addestramento.
Il processo di ricostruzione del CycleGAN si basa sulle mappe delle caratteristiche potenziate ottenute utilizzando il meccanismo CAFFM mostrato in Figura 5. Le mappe delle caratteristiche contengono motivi culturali potenziati provenienti dalle fasi precedenti di segmentazione e CAFFM. Tali mappe vengono utilizzate come ingresso per il primo generatore GE. Il primo generatore GE apprende la mappatura necessaria per ricostruire i modelli culturali. Gli output vengono quindi inviati al discriminatore DY per distinguere tra modelli culturali reali e modelli ricostruiti. Il discriminatore DY aiuta il generatore GE a produrre output realistici. Per garantire che i modelli culturali non vengano distorti durante la ricostruzione, il secondo generatore FM esegue una mappatura di coerenza ciclica. Il secondo generatore FM riconverte gli output nel dominio originale. Gli output vengono quindi valutati dal discriminatore per verificarne il realismo. Gli output finali vengono successivamente inviati al modulo SPADE per la generazione dello stile artistico nella fase successiva del framework proposto SegCycle-SPADE.
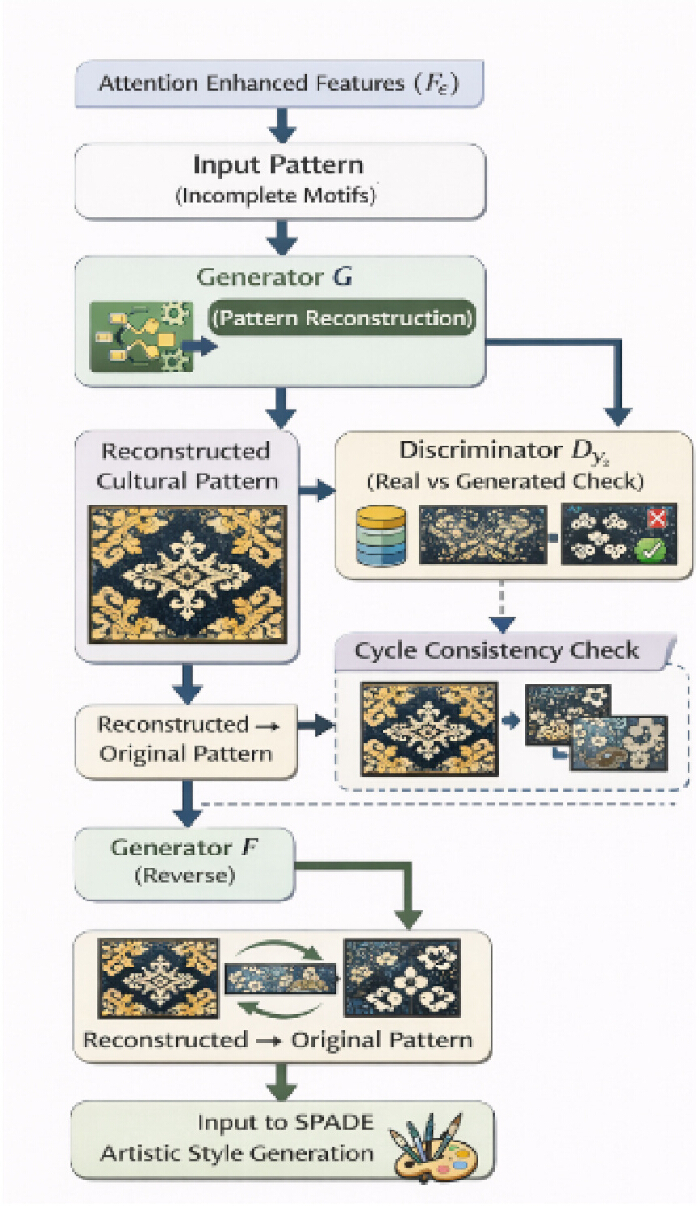
Figura 5. Flusso di lavoro per la ricostruzione dei modelli basato su CycleGAN. Flusso di lavoro del modulo di ricostruzione CycleGAN. Rappresentazioni delle caratteristiche potenziate dall'attenzione vengono fornite come input alla rete generatrice per ricostruire motivi culturali incompleti. Il discriminatore valuta gli output ricostruiti rispetto ai modelli di riferimento, mentre il mapping di coerenza ciclica preserva l'integrità strutturale durante la traduzione bidirezionale delle immagini. I motivi ricostruiti vengono successivamente inviati al modulo SPADE per la sintesi dello stile artistico. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Generazione di stili artistici utilizzando SPADE
Successivamente, i motivi culturali ricostruiti vengono sottoposti al modulo SPADE per la generazione di uno stile artistico. L'obiettivo principale del modulo SPADE è aggiungere texture visivamente più ricche di stile artistico ai motivi culturali ricostruiti, senza compromettere la disposizione strutturale dei motivi stessi. Il modulo SPADE è una tecnica di generazione condizionata di immagini che utilizza il concetto di segmentazione dell'immagine per la creazione di immagini. Mappe semantiche multicanale corrispondenti alle classi di motivi predeterminate sono state codificate a partire dalle maschere di segmentazione semantica prodotte da SegFormer-B2. Queste mappe codificate sono state fornite al generatore SPADE come input condizionanti. I parametri di scala spazialmente adattativa (γ) e di bias (β) sono stati generati elaborando le mappe semantiche attraverso strati convoluzionali all'interno di ciascun livello SPADE. Il generatore è stato quindi in grado di mantenere i contorni dei motivi, le disposizioni strutturali e le informazioni semantiche durante la sintesi artistica applicando questi parametri alle attivazioni delle caratteristiche normalizzate. La guida semantica ha potuto influenzare sia la ricostruzione strutturale a livello alto sia la sintesi delle texture a livello basso, poiché il processo di condizionamento è stato eseguito in diversi strati del generatore SPADE. Di conseguenza, i motivi artistici generati incorporano tratti stilistici derivati dal dataset WikiArt, mantenendo al contempo le strutture dei motivi culturali identificate durante la fase di segmentazione.
Il dataset WikiArt, che comprende opere di 27 diverse categorie artistiche — come Rinascimento, Impressionismo, Cubismo, Espressionismo, Surrealismo, Realismo e Arte Astratta — è stato utilizzato come risorsa principale per comprendere gli stili artistici. Per esporre il modello a una varietà di tratti creativi e migliorare la generalizzazione dello stile, durante l'addestramento sono state selezionate casualmente immagini di stile dalle diverse categorie. Il dataset è stato suddiviso in sottoinsiemi di addestramento, validazione e test, con una rappresentazione bilanciata delle categorie artistiche, al fine di ridurre il bias legato allo stile. Per garantire una rappresentazione equilibrata di tutte e 27 le categorie artistiche, è stato impiegato un campionamento stratificato. I campioni di ciascuna categoria sono stati assegnati in modo proporzionale ai sottoinsiemi di addestramento, validazione e test, mantenendo la distribuzione originale delle classi. Il modulo CAFFM è stato utilizzato per fondere gli aspetti stilistici derivati dalle immagini di WikiArt con le caratteristiche di ricostruzione prodotte da CycleGAN. Le rappresentazioni risultanti, una volta fuse, sono state fornite come informazione condizionante al generatore SPADE, consentendo alla rete di sintesi di trasferire qualità artistiche mantenendo al contempo la struttura semantica e i confini dei motivi culturali derivati dalle mappe di segmentazione. Grazie a questa tecnica di condizionamento stilistico, il framework proposto è stato in grado di produrre pattern artistici culturalmente autentici con rappresentazioni strutturali e stilistiche coerenti.
SPADE introduce anche parametri adattivi spazialmente che dipendono dalla mappa di segmentazione. I parametri possono essere definiti come mostrato nella Equazione 191:
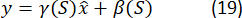
Qui, γ(S) è il parametro di scala variabile nello spazio e β(S) è il parametro di bias variabile nello spazio. Tali parametri possono aiutare il generatore a creare diverse texture e stili in base alla regione semantica presente nelle immagini. L'opera d'arte culturale finale può essere definita come mostrato nella Equazione 20:
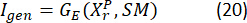
Qui, GE è il generatore SPADE, XrP è il pattern ricostruito e SM è la mappa di segmentazione. L'opera finale mantiene l'integrità strutturale dei motivi culturali migliorando al contempo l'aspetto artistico. Per ottimizzare l'architettura proposta SegCycle-SPADE, è stata utilizzata una funzione di perdita composita che bilancia accuratezza della segmentazione semantica, preservazione dei motivi culturali, qualità della ricostruzione del pattern e coerenza dello stile artistico. Per definire l'obiettivo complessivo di addestramento, si è impiegata una combinazione pesata di perdita di segmentazione (Lseg), perdita avversaria (Ladv), perdita di coerenza ciclica (Lcycle), perdita di ricostruzione (Lrecon), perdita di preservazione del motivo (Lmotif) e perdita di coerenza stilistica (Lstyle). La funzione di perdita totale è definita nella Equazione 21:
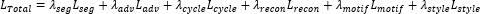 (21)
Al fine di garantire la coerenza strutturale tra i motivi culturali in ingresso e quelli ricostruiti, il coefficiente della perdita di coerenza ciclica è stato impostato a 10. Per mantenere le caratteristiche finemente dettagliate dei motivi e migliorare l'accuratezza visiva, il coefficiente della perdita di ricostruzione è stato fissato a 5. Per evidenziare la preservazione di schemi strutturali culturalmente essenziali durante la sintesi artistica, è stato utilizzato un coefficiente pari a 2 per la perdita di preservazione del motivo. Per favorire il trasferimento dello stile artistico senza distorcere eccessivamente le strutture semantiche del motivo, il coefficiente della perdita di coerenza stilistica è stato regolato a 1. Per mantenere un contributo bilanciato tra la produzione di immagini realistiche e la segmentazione precisa dei motivi, sono stati assegnati pesi uguali alle perdite di segmentazione e avversaria. Le rappresentazioni stilistiche basate sulle caratteristiche del dataset WikiArt sono state utilizzate per calcolare la perdita di coerenza stilistica. In particolare, le caratteristiche stilistiche artistiche sono state catturate mediante correlazioni di matrici di Gram ottenute da mappe di caratteristiche profonde. La differenza in norma di Frobenius tra le matrici di Gram dell'immagine dello stile target e dell'immagine generata è stata utilizzata per calcolare la perdita stilistica, come mostrato nella Equazione 22:
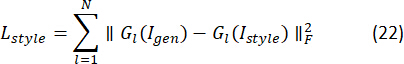
Qui, Gl è la matrice di Gram calcolata a partire dal lesimo livello di caratteristiche, Igen indica l'immagine artistica generata, Istyle indica l'immagine dello stile obiettivo del dataset WikiArt e F indica la norma di Frobenius. Questa formulazione consente al framework proposto di preservare le caratteristiche artistiche mantenendo al contempo l'integrità strutturale e semantica dei motivi culturali.
Le rappresentazioni di caratteristiche fuse prodotte dal modulo CAFFM vengono utilizzate come ingressi condizionanti per il modulo SPADE, che svolge il ruolo di componente di sintesi artistica nell'architettura proposta. Il generatore SPADE comprende sette blocchi residui SPADE con una dimensione latente delle caratteristiche di 256 canali e genera immagini in uscita con una risoluzione di 256 × 256 pixel. Le mappe di segmentazione semantica ottenute dal modulo SegFormer–CAFFM vengono utilizzate come ingressi condizionanti in tutti i livelli residui SPADE. I livelli SPADE vengono applicati prima delle funzioni di attivazione all'interno di ciascun blocco residuo, consentendo una condizionatura semantica guidata dalla segmentazione. Mediante operazioni successive di upsampling e convoluzionali, la rappresentazione latente delle caratteristiche viene progressivamente affinata per generare pattern artistici ad alta risoluzione, preservando al contempo la coerenza semantica e la struttura dei motivi. Vengono utilizzate funzioni di attivazione LeakyReLU in tutto il generatore, mentre all'ultimo livello viene applicata una funzione di attivazione Tanh per produrre immagini normalizzate.
Algoritmo e Flusso di Lavoro
Il framework SegCycle-SPADE integra segmentazione semantica, fusione di caratteristiche, ricostruzione di pattern e sintesi di stile artistico all'interno di una pipeline di addestramento unificata. Il flusso di lavoro inizia con l'acquisizione e la pre-elaborazione del dataset, inclusi ridimensionamento delle immagini, normalizzazione, rimozione del rumore e preparazione delle maschere di segmentazione. Le immagini pre-elaborate vengono successivamente elaborate mediante la rete di segmentazione SegFormer-B2 per estrarre rappresentazioni semantiche dei motivi. Le caratteristiche di segmentazione risultanti vengono fuse con le caratteristiche di ricostruzione attraverso il modulo CAFFM, consentendo l'interazione tra informazioni strutturali sui motivi e rappresentazioni di caratteristiche artistiche. Le mappe di caratteristiche fuse vengono quindi fornite al modulo di ricostruzione CycleGAN, che ripristina le strutture incomplete dei motivi culturali mantenendo la coerenza semantica. I pattern ricostruiti vengono successivamente inviati al generatore SPADE per la sintesi artistica guidata dalla segmentazione, consentendo un miglioramento stilistico pur preservando i contorni dei motivi e l'autenticità strutturale. Durante l'addestramento, i parametri del modello vengono ottimizzati utilizzando la funzione di perdita composita descritta nelle Equazioni 21 e 22, che bilancia accuratezza della segmentazione, preservazione dei motivi, qualità della ricostruzione e coerenza dello stile artistico. Un flusso di implementazione dettagliato passo dopo passo, compreso il caricamento del dataset, la pre-elaborazione, l'inizializzazione del modello, le iterazioni di addestramento, le procedure di validazione, la selezione dei checkpoint e la valutazione finale, è fornito nel File Supplementare 1 (Algoritmo 1). L'intero flusso di lavoro algoritmico è stato implementato con una dimensione del batch pari a 16, una velocità di apprendimento di 0,0002 e 100 epoche di addestramento. È stato utilizzato un seme casuale fisso pari a 42 per la suddivisione del dataset, l'inizializzazione del modello e tutti gli esperimenti di addestramento. Il seme è stato applicato in modo coerente ai generatori di numeri casuali di Python, NumPy e PyTorch per garantire la riproducibilità. L'ottimizzatore Adam è stato configurato con β₁ = 0,5, β₂ = 0,999 e senza decadimento del peso (weight decay = 0). I checkpoint del modello sono stati selezionati in base al punteggio IoU di validazione più alto ottenuto sul dataset di validazione.
Ottimizzazione della Funzione di Perdita
Per preservare le strutture dei motivi culturali durante la ricostruzione e la sintesi artistica, il framework proposto utilizza un obiettivo di ottimizzazione composito che combina perdite di segmentazione, avversariale, di coerenza ciclica, di ricostruzione, di preservazione del motivo e di coerenza stilistica. La formulazione matematica completa, i coefficienti di pesatura e la definizione della perdita stilistica sono forniti nelle Equazioni 21 e 22 all'interno del sottosezione Generazione di Stile Artistico mediante SPADE. Il componente di preservazione del motivo penalizza le deviazioni strutturali tra le regioni del motivo previste e le maschere di segmentazione reali corrispondenti, incoraggiando così il mantenimento delle strutture di pattern culturalmente significative durante tutto il processo di ricostruzione.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Il framework proposto SegCycle-SPADE è stato valutato utilizzando due dataset: il dataset dei motivi culturali del batik Miao e il dataset WikiArt. Il dataset del batik Miao contiene immagini del patrimonio culturale tradizionale ed è stato utilizzato principalmente per compiti di segmentazione semantica e ricostruzione strutturale, mentre il dataset WikiArt contiene stili artistici diversificati ed è stato impiegato per l'apprendimento e la generazione di stili artistici. Le immagini provenienti da entrambi i dataset so...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
La conservazione e la ricostruzione digitale dei modelli del patrimonio culturale immateriale (ICH) hanno ricevuto un'attenzione crescente negli ultimi anni a causa della progressiva scomparsa delle arti tradizionali. Studi precedenti hanno cercato di affrontare la perdita del patrimonio culturale attraverso tecniche di elaborazione delle immagini basate sul DL. Ad esempio, Quan et al.32 hanno proposto un framework per la conservazione del patrimonio culturale basato su grafi della conoscenza e DL...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Conflitto di interessi:
Gli autori dichiarano di non avere interessi concorrenti.
Ringraziamenti
Gli autori ringraziano il supporto accademico e istituzionale fornito dal Guangdong Engineering Polytechnic e dalla South China Normal University durante lo svolgimento di questa ricerca. Questa ricerca è stata sostenuta dal Progetto Generale del Fondo Nazionale per le Scienze Sociali 2023 (n. 23BH161), intitolato “Museo di Rigenerazione Digitale: Ricerca sull’Attivazione e sulla Comunicazione dei Reperti Culturali Classici Cinesi di Calligrafia e Pittura”.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Adam Optimizer | PyTorch Optimizer Library | Adam | Algoritmo di ottimizzazione utilizzato durante l'addestramento del modello. |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.3 | Accelerazione GPU per i calcoli di deep learning. |
| cuDNN | NVIDIA Corporation | cuDNN 8.2 | Libreria di accelerazione per reti neurali profonde utilizzata per velocizzare l'addestramento e l'inferenza. |
| CycleGAN | University of California, Berkeley / Open Source | Implementazione ufficiale PyTorch (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Rete avversaria generativa utilizzata per la ricostruzione di motivi culturali. |
| Pesi Pre-addestrati su ImageNet | ImageNet / Open Source | mit_b2.pth (Punto di controllo pre-addestrato su ImageNet-1K) | Utilizzati per inizializzare il backbone SegFormer-B2 prima del fine-tuning sul dataset Miao Batik. |
| Processore Intel | Intel Corporation | Intel Core i7 (11ª generazione) | CPU utilizzata per la pre-elaborazione delle immagini, il supporto all'addestramento del modello e l'inferenza. |
| Matplotlib | Matplotlib Development Team | Matplotlib 3.5.1 | Visualizzazione delle curve di addestramento e dei risultati di valutazione. |
| Dataset Miao Batik | Zenodo Repository | DOI: 10.5281/zenodo.20807658 | Dataset di motivi culturali contenente 15.148 immagini, utilizzato per la segmentazione semantica e la ricostruzione di pattern. |
| NumPy | NumPy Developers | NumPy 1.21.5 | Calcolo numerico ed elaborazione del dataset. |
| GPU NVIDIA | NVIDIA Corporation | NVIDIA RTX 3090 (24 GB VRAM) | Piattaforma hardware utilizzata per l'addestramento e l'inferenza del modello. |
| OpenCV | OpenCV Foundation | OpenCV 4.5.5 | Pre-elaborazione delle immagini, ridimensionamento, interpolazione e denoising gaussiano. |
| Sistema Operativo | Canonical Ltd. | Ubuntu 20.04 LTS | Ambiente sperimentale di esecuzione. |
| Pillow (PIL) | Python Imaging Library | Pillow 8.4.0 | Caricamento e manipolazione delle immagini. |
| Python | Python Software Foundation | Python 3.8.10 | Linguaggio di programmazione utilizzato per l'implementazione e gli esperimenti. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Framework di deep learning utilizzato per l'addestramento e l'inferenza del modello. |
| Random Seed | Experimental Setting | 42 | Seed fisso utilizzato per la partizione del dataset, l'inizializzazione del modello e la riproducibilità sperimentale. |
| Scikit-learn | Scikit-learn Developers | Scikit-learn 1.0.2 | Partizione del dataset, analisi statistica e metriche di valutazione. |
| Seaborn | Open Source Community | Seaborn 0.11.2 | Visualizzazione statistica dei dati. |
| SegFormer-B2 | NVIDIA Research / Open Source | SegFormer-B2 (Backbone MIT-B2) | Modello di segmentazione semantica basato su Transformer utilizzato per la segmentazione di motivi culturali. |
| Maschere di Segmentazione / Annotazioni | Miao Batik Dataset | Incluso con il Dataset | Etichette di segmentazione semantica a livello di pixel utilizzate per la classificazione dei motivi e l'addestramento. |
| SPADE | NVIDIA Research / Open Source | Implementazione ufficiale PyTorch (https://github.com/NVlabs/SPADE) | Modello di sintesi guidata da segmentazione utilizzato per la generazione artistica di pattern. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Utilità per l'elaborazione delle immagini e trasformazioni del dataset utilizzate con PyTorch. |
| Dataset WikiArt | WikiArt | https://www.wikiart.org/ | Dataset di stili artistici contenente oltre 80.000 opere d'arte appartenenti a 27 stili artistici, utilizzato per l'apprendimento e la sintesi dello stile. |
Riferimenti
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.