Affrontando la frammentazione del testo giuridico e i problemi di tracciamento dei bias nell'intelligenza artificiale (AI) medica, questo studio costruisce un grafo della conoscenza giuridica e impiega una convoluzione su grafi con attenzione alle relazioni per l'allineamento semantico. Identifica le fonti di bias tramite retropropagazione basata sui gradienti, con metriche sperimentali favorevoli a sostegno di un'applicazione medica basata sull'AI conforme alle normative.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Costruzione di grafi di conoscenza legale e tracciamento dei bias nell'intelligenza artificiale medica basata su reti neurali a grafo
In questo articolo
Sommario
Abstract
Nell'analisi della conformità legale dell'intelligenza artificiale (AI) in ambito medico, questo articolo affronta l'ambiguità nella determinazione della responsabilità causata dalla frammentazione semantica di testi giuridici eterogenei provenienti da più fonti e dalle difficoltà nel rintracciare i bias algoritmici. Viene proposto un metodo per la costruzione di un grafo della conoscenza e il rilevamento dei percorsi di propagazione dei bias basato su reti neurali su grafi. Quattro tipi di nodi eterogenei—clausole giuridiche, comportamenti medici, moduli algoritmici e parti responsabili—vengono strutturati e codificati, e viene costruito un grafo diretto sulla base di quattro tipi di relazioni semantiche giuridiche: «violazione», «fondamento», «attivazione» e «attribuzione». Successivamente, viene utilizzata una rete convoluzionale su grafi consapevole delle relazioni, combinata con pesi specifici per tipo di arco e un meccanismo di attenzione, per realizzare un allineamento multi-livello delle caratteristiche semantiche giuridiche cross-modali. Quindi, tramite retropropagazione basata sul gradiente, vengono identificati gli archi che contribuiscono in modo significativo ai bias, viene costruito un sottografo di propagazione dei bias e vengono individuati cluster di nodi radice mediante scoperta di comunità. Infine, i flussi decisionali in tempo reale vengono mappati su nodi temporanei, la conformità viene verificata tramite similarità degli embedding e viene monitorata la dinamica dei pesi degli archi chiave per segnalare l'accumulo di bias sistemici. Gli esperimenti mostrano che, in termini di accuratezza nell'allineamento semantico, il metodo proposto raggiunge un'accuratezza media nell'allineamento delle entità di almeno 0,92 e una completezza media nella conservazione delle relazioni di almeno 0,88, considerando diversi gradienti di densità del grafo della conoscenza. Per quanto riguarda la capacità di localizzazione dei bias, il tasso di richiamo dei nodi radice raggiunge 0,95±±0,02 e la precisione del percorso di propagazione raggiunge 0,93±±0,03. Questa ricerca, in una certa misura, realizza un forte accoppiamento tra logica giuridica e comportamento algoritmico, fornendo un sistema di supporto alla conformità spiegabile e verificabile per il deployment affidabile dell'AI medica.
Introduzione
Il coinvolgimento profondo dell'intelligenza artificiale medica nel supporto alla diagnosi e al trattamento, nell'allocazione delle risorse e nella valutazione del rischio ha legato le sue decisioni all'assunzione di responsabilità giuridica1,2. Le norme giuridiche sono altamente strutturate ma semanticamente distribuite, mentre il comportamento dei sistemi di intelligenza artificiale può risultare una "scatola nera", priva di un'interfaccia semanticamente allineabile e tracciabile tra i due domini3. In questo contesto, lo sviluppo di un framework comune di rappresentazione capace di catturare le catene causali giuridiche all'interno delle sequenze comportamentali algoritmiche si è affermato come un prerequisito necessario per realizzare un'attribuzione fine delle responsabilità e un rispetto dinamico delle normative4,5. Questo studio non riguarda soltanto la verifica legale dei sistemi tecnologici, ma coinvolge anche la tutela approfondita dell'equità medica, dell'equità algoritmica e della fiducia istituzionale, rivestendo pertanto un'importanza teorica notevole e un'urgenza pratica elevata.
Il problema fondamentale nell'analisi della conformità giuridica dell'IA medica oggi è la mancanza di una struttura connettiva computabile tra semantica giuridica e comportamento algoritmico6,7. I documenti giuridici sono disponibili come testo semplice, e le relazioni tra i paragrafi sono intrecciate da dipendenze, conflitti ed eccezioni, creando problemi quando vengono suddivisi in unità logiche interpretabili dalle macchine8,9. Sebbene il processo decisionale del sistema di IA sia racchiuso in una scatola nera basata sui dati, nessuna delle sue variazioni di output può essere ricondotta a specifiche violazioni degli obblighi legali o a nodi per l'attribuzione della responsabilità10,11. Tale disconnessione (ad esempio, bias nei dati di addestramento, difetti progettuali del modello o l'interpretazione semantica delle norme giuridiche) non può essere isolata sperimentalmente per identificare l'origine del bias o chiarire gli obblighi giuridici per sviluppatori, operatori o utilizzatori12,13. Ancora più problematico, le procedure di conformità esistenti verificano soltanto se un output finale soddisfi una specifica fissa, senza considerare il percorso di propagazione o l'amplificazione del bias nella rete di interazioni "diritto-tecnologia"14,15. Quando l'IA medica è soggetta simultaneamente a più disposizioni giuridiche, e il sistema genera una catena di errori a causa di un'errata interpretazione di una clausola, gli approcci convenzionali non possono tracciare come l'errore si diffonda attraverso altre norme correlate per poi arrivare alla responsabilità16,17. Inoltre, manca un meccanismo dinamico di correlazione tra il flusso decisionale in tempo reale e il grafo della conoscenza giuridica esistente, con conseguente ritardo nella valutazione della conformità durante il funzionamento del sistema, impedendo così un monitoraggio proattivo dell'andamento dell'accumulo del bias18,19. Questi problemi insieme portano a incertezze nella determinazione della responsabilità, a un'attribuzione fragile e a interventi regolatori tardivi, ostacolando significativamente il dispiegamento affidabile di sistemi di IA ad alto rischio nel settore sanitario e l'applicazione della responsabilità giuridica.
Prima di tutto, gli studi tradizionali di ricerca analizzano i testi giuridici in forma strutturata e costruiscono basi di conoscenza di domini specifici mediante ontologie o regole, al fine di supportare domande e risposte in materia di conformità o notifiche di rischio20,21. Sebbene questi approcci possano catturare rappresentazioni di alcuni concetti giuridici, tendono a presupporre che la logica interna del diritto sia coerente e statica, rendendo difficile affrontare incoerenze tra giurisdizioni, eccezioni o formulazioni vaghe. Lavori successivi hanno introdotto tecnologie di elaborazione del linguaggio naturale, utilizzando modelli linguistici pre-addestrati per estrarre entità e relazioni giuridiche, ampliando la copertura dell'estrazione della conoscenza22,23, ma rimangono comunque a un livello semantico superficiale, senza riuscire a stabilire un'interfaccia di mappatura tra comportamenti giuridici e tecnici. Per quanto riguarda la governance del pregiudizio algoritmico, la ricerca si è concentrata principalmente sulla progettazione di vincoli di equità24,25, i cui indicatori di valutazione si basano solitamente su variabili demografiche, mancando di allineamento con i principi giuridici di attribuzione. Anche alcuni studi hanno tentato di codificare le norme giuridiche come vincoli e integrarle nell'addestramento del modello26,27, ma a causa della rigidità e della scarsa granularità dell'espressione delle regole, risultano difficili da adattare a situazioni cliniche complesse. In generale, i lavori esistenti considerano la conformità giuridica come un compito di verifica esterna piuttosto che come un attributo intrinsecamente computabile dell'architettura del sistema. Ciò determina un funzionamento parallelo tra logica giuridica e logica algoritmica, impedendo un ragionamento congiunto e un'intervento dinamico sui percorsi di propagazione dei bias.
Negli ultimi anni, le reti neurali su grafi sono state progressivamente introdotte nel campo medico grazie alle loro capacità esplicite di modellare strutture relazionali28,29. Alcuni studi utilizzano grafi eterogenei per integrare giurisprudenza, norme giuridiche e informazioni sulle parti coinvolte, supportando raccomandazioni di casi o previsioni di sentenze attraverso l'incorporamento dei nodi30,31, dimostrando così l'efficacia delle strutture a grafo nel catturare connessioni giuridiche. Altri lavori rappresentano i componenti algoritmici come nodi del grafo, utilizzando gli archi per indicare flussi di dati o relazioni di chiamata al fine di tracciare la propagazione degli errori32,33. Queste esplorazioni mostrano che le strutture a grafo possono fungere da supporto comune per elementi giuridici e tecnologici. Tuttavia, i modelli a grafo esistenti presentano generalmente tre limiti: innanzitutto, si limitano a un singolo tipo di relazione tra archi, senza distinguere tra differenze normative, causali e attributive nella semantica giuridica; in secondo luogo, il processo di aggregazione delle caratteristiche ignora i pesi semantici dei tipi di arco, portando a trattare in modo equivalente percorsi logici giuridici differenti; in terzo luogo, manca un meccanismo differenziabile per il tracciamento della propagazione dei bias, rendendo impossibile individuare gli archi con maggiore contributo e ricostruire i percorsi di responsabilità. Questo articolo propone una rete convoluzionale su grafi consapevole delle relazioni, che affronta il problema della fusione dell'eterogeneità semantica assegnando una matrice di trasformazione dedicata a ciascun tipo di arco semantico giuridico e introducendo un meccanismo di attenzione per regolare dinamicamente il flusso di informazioni tra tipi diversi. Inoltre, combinando la retropropagazione del gradiente con l'estrazione di sottografi, il modello consente un passaggio interpretabile dal giudizio di conformità a livello macroscopico al tracciamento del bias a livello microscopico, superando il collo di bottiglia dei modelli a grafo tradizionali, che supportano soltanto un ragionamento statico.
Oltre al dominio medico, i recenti progressi nei metodi basati su grafi e nei metodi evolutivi hanno dimostrato un'ampia applicabilità nell'elaborazione della conoscenza strutturata. Ad esempio, Xue et al. hanno proposto un approccio ibrido genetico multilivello basato sulla programmazione per la costruzione adattiva di caratteristiche di similarità nell'allineamento di ontologie, ottenendo un allineamento robusto tra grafi della conoscenza eterogenei34. Cheng et al. hanno fornito una panoramica completa delle applicazioni delle reti convoluzionali su grafi nel ripristino di immagini, categorizzando sistematicamente i metodi per la riduzione del rumore, il super-risoluzione e la rimozione della sfocatura35. Li et al. hanno presentato un'analisi approfondita sull'apprendimento profondo evolutivo dal punto di vista dell'apprendimento automatico automatizzato, trattando principi, algoritmi, applicazioni e sfide aperte36. Ma et al. hanno sviluppato un framework fuzzy di ricerca di architetture neurali per il riconoscimento di difetti in condizioni di incertezza, dimostrando l'efficacia della ricerca evolutiva nel gestire dati ambigui37. Questi studi evidenziano il potenziale dell'integrazione tra rappresentazioni strutturate a grafo e ottimizzazione evolutiva per compiti decisionali complessi.
L'obiettivo principale di questo articolo è stabilire un framework interpretabile end-to-end per l'analisi della conformità legale dell'intelligenza artificiale in ambito medico, con innovazioni a tre livelli. A livello di rappresentazione della conoscenza, è il primo a modellare clausole legali, pratiche mediche, moduli algoritmici e parti responsabili come quattro tipi di nodi eterogenei. Sulla base della pratica giuridica, estrae quattro tipi di relazioni dirette: «violazione», «fondamento», «attivazione» e «attribuzione», costruendo un grafo della conoscenza diretto con logica causale giuridica, fornendo una base semantica strutturata per l'analisi della conformità. Per quanto riguarda il reperimento della fonte del bias, propone un metodo di quantificazione del contributo degli archi basato sulla sensibilità del gradiente. Mediante backpropagation, identifica l'insieme di archi che massimizza il bias in uscita, quindi applica un algoritmo di rilevamento delle comunità per raggruppare i nodi ad alto contributo, trasformando il «bias da scatola nera» in «cluster di responsabilità da scatola bianca», consentendo un'attribuzione basata su una catena di prove operativa. A livello di monitoraggio dinamico in tempo reale, sviluppa un meccanismo temporaneo di embedding dei nodi decisionali che mappa le uscite in tempo reale dell'IA nello spazio del grafo della conoscenza. Sulla base del confronto della prossimità degli embedding, quantifica il grado di deviazione dalle norme e monitora la variazione del peso di quegli archi legali-tecnici essenziali, al fine di segnalare l'accumulo di bias sistemico. Questo paradigma affronta sia i problemi di frammentazione semantica che quelli di tracciabilità, trasformando la conformità legale da verifica ex post a governance ex ante, offrendo una via tecnica scalabile per la trasparenza della responsabilità nei sistemi di intelligenza artificiale ad alto rischio.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Costruzione di una rete neurale grafica per il grafo della conoscenza giuridica nell'intelligenza artificiale medica
Come mostrato in Figura 1, il framework proposto comprende tre moduli principali. Il livello di input integra dati provenienti da più fonti in un grafo eterogeneo attraverso la codifica multimodale delle entità e la modellizzazione degli archi direzionati. Il livello GCN sensibile alle relazioni esegue quindi un allineamento semantico incrociato tra modalità diverse mediante pesi e attenzione specifici per tipo, producendo embedding unificati dei nodi. Infine, questi embedding supportano il tracciamento dei bias (mediante retropropagazione del gradiente e rilevamento delle comunità) e il monitoraggio dinamico della conformità (mediante mappatura in tempo reale dei nodi e tracciamento dei pesi degli archi), fornendo in output evidenze di attribuzione interpretabili e avvisi di rischio per i regolatori.
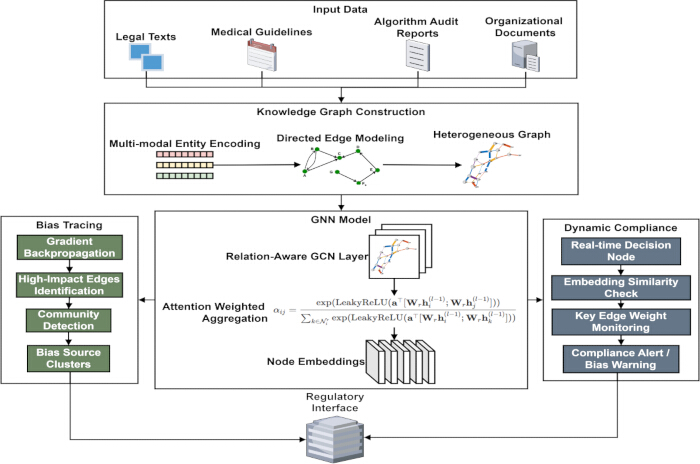
Figura 1: Grafo delle conoscenze giuridiche e architettura per il tracciamento dei bias nell'intelligenza artificiale medica. Questo diagramma illustra il flusso di lavoro generale del framework proposto. Il livello di input fonde dati eterogenei provenienti da più fonti (testi giuridici, linee guida cliniche, rapporti di audit degli algoritmi), codificati in quattro tipi di entità (clausole giuridiche, comportamenti medici, moduli algoritmici, parti responsabili) e collegati da quattro relazioni direzionali di tipo giuridico-semantico (violazione, base, attivazione, attribuzione). Il livello GCN sensibile alle relazioni esegue un allineamento semantico multimodale mediante pesi e attenzione specifici per tipo. Il modulo di tracciamento dei bias utilizza la retropropagazione del gradiente per identificare i collegamenti con contributo elevato, quindi applica il rilevamento delle comunità per localizzare i cluster di nodi principali. Il monitor dinamico della conformità mappa le decisioni in tempo reale in nodi temporanei, valuta la similarità degli embedding rispetto alle clausole giuridiche e traccia l'evoluzione dei pesi dei collegamenti per un avviso precoce. Gli output includono evidenze di attribuzione interpretabili e avvisi di rischio. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Codifica strutturata in grafi eterogenei di entità giuridiche e relazioni
Da leggi normative sull'intelligenza artificiale in ambito medico, linee guida per la pratica clinica e rapporti di audit sugli algoritmi si ricavano costantemente quattro entità fondamentali: clausole legali, procedure mediche, moduli algoritmici ed entità responsabili. Per ciascun tipo di entità viene proposto un modello distinto di apprendimento della rappresentazione delle caratteristiche, al fine di garantirne la distinzione semantica. Ai nodi corrispondenti alle clausole legali viene assegnato il numero della clausola legale, utilizzato come ID (identificatore) univoco per tale clausola. Contestualmente, viene definito un indice di quantificazione della gravità della sanzione per indicare il livello di responsabilità legale associato alla clausola, e di conseguenza viene stabilito un vettore di caratteristiche.
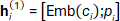 (1)
ci è il numero dell'elemento, Emb(·) rappresenta la mappatura dell'incorporamento in uno spazio a bassa dimensionalità e [·;·] rappresenta l'operazione di concatenazione dei vettori. Questa rappresentazione preserva sia la struttura formale sia la gravità della punizione del testo giuridico, supportando il ragionamento incrociato tra affermazioni.
I nodi di comportamento medico sono standardizzati e codificati in base a un sistema di classificazione delle operazioni cliniche, estraendo il loro livello di rischio rj ∈ {1,2,3} e l'insieme di etichette di scenario applicabili sj ⊂ S, dove S è l'insieme completo delle categorie di scenario predefinite. Viene utilizzata una codifica multi-hot per elaborare l'insieme delle etichette, che viene poi concatenata all'embedding del livello di rischio per formare una rappresentazione iniziale:
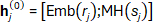 (2)
Questa strategia garantisce che diversi tipi di comportamenti medici abbiano relazioni di distanza misurabili nello spazio vettoriale, consentendo confronti tra diversi scenari. La funzione di incorporamento del testo Emb(·) è implementata utilizzando il modello linguistico giuridico cinese pre-addestrato Lawformer (pre-addestrato su un corpus giuridico cinese su larga scala), con una dimensione dell'output fissata a 768.
Sulla base delle dipendenze logiche e dei vincoli giuridici tra le entità, vengono definite quattro tipologie di relazioni semantiche direzionate: "violazione", "base", "attivazione" e "attribuzione", ciascuna corrispondente a diversi schemi causali giuridici. A ciascun arco eij ⊂ E viene assegnata una tipologia di etichetta tij ⊂ T = {violate, base, trigger, attribute} per la successiva trasmissione di messaggi finalizzata al riconoscimento delle relazioni. La costruzione degli archi segue rigorosamente il meccanismo di abbinamento delle regole del dominio: quando un comportamento medico si discosta dai requisiti normativi, viene stabilito un arco di "violazione" che va dal nodo del comportamento alla clausola giuridica pertinente; quando la clausola giuridica costituisce la base tecnica di conformità per un'operazione, viene stabilito un arco di "base"; se l'output del modulo algoritmico attiva direttamente l'esecuzione di un determinato comportamento medico, viene collegato un arco di "attivazione"; la relazione di attribuzione della responsabilità viene stabilita sulla base dei documenti organizzativi relativi alla responsabilità e delle conclusioni di audit, creando un arco di "attribuzione" tra la parte responsabile e la violazione o il difetto algoritmico.
Dopo l'inizializzazione di tutti i nodi, viene formata una rete eterogenea (V, E, H0), in cui V rappresenta l'insieme dei nodi, E l'insieme degli archi diretti con etichette di tipo e H0 la matrice iniziale delle caratteristiche. Per migliorare la capacità discriminativa semantica della struttura della rete, le caratteristiche dei nodi vengono normalizzate:
 (3)
μk e σk sono rispettivamente la media e la deviazione standard della caratteristica del k-esimo nodo nel set di addestramento, mentre ∈ è una costante piccola per evitare la divisione per zero. La normalizzazione garantisce che caratteristiche eterogenee provenienti da più fonti partecipino alle operazioni di convoluzione del grafo su una scala uniforme, prevenendo effetti di dominanza numerica che potrebbero interferire con l'apprendimento semantico. Il modello di grafo risultante rappresenta pienamente la topologia relazionale dei quattro elementi dimensionali del diritto, del comportamento, della tecnologia e della responsabilità nel sistema di intelligenza artificiale medica, fornendo una base di grafo computabile per l'analisi successiva della propagazione dei bias.
Potenziamento dell'allineamento mediante convoluzione su grafi per la semantica giuridica multimodale
Viene utilizzata una rete convoluzionale grafica con consapevolezza delle relazioni38,39, che estende il framework della Relational Graph Convolutional Network (R-GCN), per propagare le caratteristiche attraverso più livelli del grafo eterogeneo iniziale. Mentre l'R-GCN introduce matrici di trasformazione specifiche per ogni relazione nel caso di dati relazionali generici, il nostro approccio integra ulteriormente un meccanismo di attenzione apprendibile per pesare dinamicamente i contributi dei nodi adiacenti e definisce quattro tipi specifici di relazioni giuridico-semantica (violazione, base, attivazione, attribuzione), progettati appositamente per l'analisi della conformità nell'intelligenza artificiale medica. L'operazione di ciascun livello parametrizza in modo indipendente il processo di trasformazione in base al tipo semantico degli archi. Per ogni nodo target, le informazioni del suo vicinato vengono raggruppate e aggregate in base ai tipi di archi di collegamento. A ciascun tipo di relazione è associata una matrice di trasformazione lineare dedicata, al fine di differenziare le caratteristiche trasmesse lungo percorsi semantici giuridici diversi40,41. Se l'arco tra il nodo della clausola giuridica e il nodo del comportamento medico è di tipo "base", quando il nodo della clausola giuridica riceve un messaggio da un nodo di comportamento medico, applica la matrice di pesi corrispondente per mappare spazialmente le caratteristiche del nodo adiacente. Allo stesso modo, quando un nodo di comportamento medico invia un output attraverso il modulo di integrazione degli archi di tipo "attivazione" a un modulo algoritmico, viene utilizzata la matrice di parametri associata a tale relazione per eseguire la trasformazione delle caratteristiche. Questo meccanismo imita la fluidità di diversi tipi di logica giuridica, realizzando/definendo diversi livelli logici che mantengono l'indipendenza semantica durante il flusso di informazioni, evitando rumore intermodale. L'aggregazione è definita come segue:
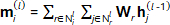 (4)
mi(l) rappresenta le informazioni complete raccolte dal nodo i nel livello l, Nil è il suo insieme di nodi adiacenti secondo la relazione r, Wr è la matrice di trasformazione lineare e hj(l−1) è la rappresentazione incorporata del nodo adiacente nel livello precedente.
Viene introdotto un meccanismo di attenzione apprendibile durante l'aggregazione dei messaggi, al fine di regolare dinamicamente l'intensità dell'influenza esercitata dai diversi nodi adiacenti sull'aggiornamento della rappresentazione del nodo bersaglio42,43. Il coefficiente di attenzione viene generato sulla base di due fattori: la similarità degli attributi dei nodi e l'importanza legale, senza fare affidamento su pesi a priori fissi. Per i nodi corrispondenti a clausole legali, quando ricevono caratteristiche di comportamenti medici dai nodi adiacenti, il punteggio di attenzione viene calcolato in base al valore quantificato dell'intensità della sanzione associata a tali comportamenti; quando il nodo del modulo algoritmico fonde informazioni relative a comportamenti medici, l'attenzione si concentra sui nodi adiacenti che presentano livelli di rischio operativo più elevati. Il peso di attenzione viene calcolato nel modo seguente:
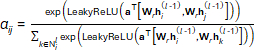 (5)
αij è il coefficiente di attenzione del nodo j verso il nodo i, e a è il vettore di attenzione apprendibile. Questo modello consente l'identificazione automatica di percorsi connessi ad alto rischio o ad alta restrizione durante l'addestramento end-to-end, assegnando loro un'attenzione maggiore. L'embedding finale del nodo aggiornato è determinato da messaggi pesati e connessioni residue.
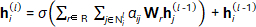 (6)
σ è la funzione di attivazione, e il design residuo attenua il problema della scomparsa del gradiente nella propagazione profonda e garantisce stabilità in presenza di multipli conflitti semantici. Dopo L = 3 strati di convoluzione su grafo (ciascuno con una dimensione nascosta di 256 e attivazione ReLU), gli embedding di tutti i nodi incorporano in modo fluido informazioni contestuali multimodali e diventano rappresentazioni unificate con capacità di discriminazione semantica conforme alle norme.
Nella Figura 2 sono raffigurati due diagrammi alternativi di analisi della conformità legale per l'intelligenza artificiale in ambito sanitario, con l'obiettivo di visualizzare i tipi di relazioni giuridiche e i percorsi di propagazione dei bias, indicando le potenziali fonti di pregiudizio in questo processo decisionale. Figura 2A mostra l'influenza delle diverse relazioni semantiche giuridiche, in cui quattro tipi di relazione sono codificati per colore e, per ciascun tipo, i collegamenti sono distinti da un colore differente. Lo spessore del collegamento corrisponde al peso dell'attenzione associato a quella particolare relazione, ovvero quanto tale relazione contribuisce alla decisione dell'IA. Un collegamento spesso indica essenzialmente una relazione giuridica dominante nella decisione e, in questo caso, ha sufficientemente motivato l'esito del caso. Le dimensioni dei nodi sono proporzionali al loro contributo alle violazioni: nodi più grandi indicano una relazione più forte tra il comportamento e specifiche clausole giuridiche, e quindi un rischio potenziale maggiore. La suddetta visualizzazione fornisce un chiaro strato semantico giuridico, che ci permette di identificare i percorsi legali più forti e più rischiosi nel processo decisionale dell'IA. Figura 2B indica inoltre i percorsi ad alto contributo (alla propagazione del bias), con particolare enfasi sui collegamenti con contributo elevato, che sono in grassetto e accompagnati da linee tratteggiate (ad esempio B1-B3) nel processo decisionale. Il raddoppio della larghezza di questi collegamenti ne rappresenta l'importanza nella diffusione del bias sistemico. Le combinazioni di norme giuridiche e comportamenti tecnici che determinano questo effetto di amplificazione del bias sono mostrate in Figura 2. Questa analisi non solo rivela il percorso di propagazione del bias, ma facilita anche l'individuazione della sua origine, sulla base della quale possono essere stabiliti il controllo della conformità e la responsabilità dello strumento di intelligenza artificiale.
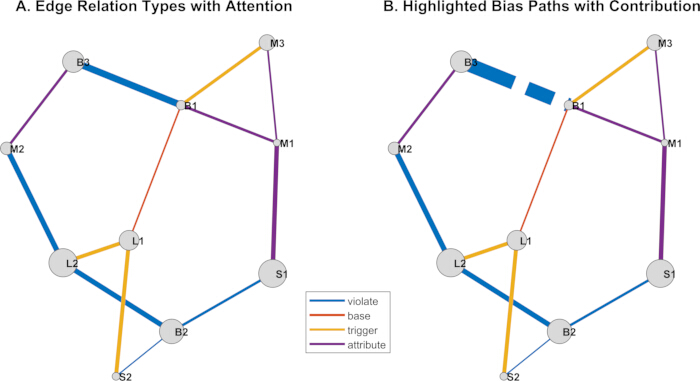
Figura 2: Analisi della conformità legale e della propagazione dei bias nell'intelligenza artificiale sanitaria (esempio illustrativo). (A) Relazioni semantiche legali codificate per colore: violazione (rosso), base (blu), attivazione (verde), attribuzione (arancione). Lo spessore dei collegamenti è proporzionale al peso dell'attenzione, indicando l'influenza di ciascuna relazione sulla decisione dell'IA. Le dimensioni dei nodi sono proporzionali al loro contributo alla violazione, evidenziando le entità a rischio. (B) Sottografo di propagazione del bias: i collegamenti con alto contributo sono in grassetto e tratteggiati (ad esempio, B1-B3); collegamenti di doppio spessore indicano un'amplificazione del bias sistemico. Questa visualizzazione facilita l'identificazione dei percorsi legali dominanti, delle origini dei bias e l'audit della conformità. Scale di misura o barre di errore non sono applicabili poiché si tratta di un'illustrazione schematica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Meccanismo di backtracking del sottografo per il percorso di propagazione del bias
In questo studio, il «bias» è definito come la deviazione sistematica dell'output di un sistema di intelligenza artificiale rispetto alla decisione clinicamente e legalmente attesa, misurata dalla discrepanza tra il punteggio di rischio predetto dal modello e l'etichetta di conformità reale. Il segnale di bias è quantificato come perdita di entropia incrociata tra l'output finale dell'algoritmo e un indicatore binario di conformità (1 per conforme, 0 per non conforme), aggregato su tutte le istanze decisionali in un batch.
Dopo che la rete neurale grafica è stata addestrata, la sua differenziabilità viene utilizzata per eseguire un'analisi di backpropagation sul segnale di bias nel livello di output. A partire dal nodo decisionale dell'algoritmo che rileva anomalie, si calcola l'entità del gradiente della funzione di perdita rispetto a ciascun arco collegato, al fine di quantificare il contributo di ogni arco alla formazione del bias. Questo processo è implementato attraverso un framework di differenziazione automatica, eseguendo un backtracking strato dopo strato lungo gli archi direzionati nella struttura del grafo per ottenere l'intensità dell'influenza di ciascuna trasformazione del parametro dell'arco sul cambiamento dell'output finale. Maggiore è il valore assoluto del gradiente, più dominante è la relazione giuridico-tecnica trasportata da quell'arco nella propagazione del bias. Il contributo di un arco è definito come:
 (7)
Lbias è la perdita differenziabile definita per il comportamento distorto e wi è il vettore dei pesi delle connessioni corrispondente al tipo di arco. Questo valore del gradiente riflette il grado di partecipazione di una specifica relazione semantica all'interno della distorsione di associazione corrente. Dopo aver assegnato un punteggio a tutti gli archi in questo modo, viene impostata una soglia dinamica τ per filtrare l'insieme degli archi ad alto contributo Ehigh il cui contributo supera gij > τ, formando il sottografo iniziale di propagazione della distorsione Gbias = (Vbias, Ehigh). In particolare, τ è determinata come il 85° percentile dei valori assoluti del gradiente su tutti gli archi in ogni epoca di addestramento, garantendo che solo il 15% degli archi più influenti venga mantenuto per la costruzione del sottografo. Questo sottografo si concentra sui percorsi di connessione chiave più probabili a generare distorsioni sistematiche, riducendo lo spazio di ricerca e migliorando l'efficienza del tracciamento delle origini.
All'interno del sottografo di propagazione del bias costruito, viene eseguito un algoritmo di rilevamento delle comunità guidato dal clustering spettrale per identificare strutture di cluster di nodi altamente coerenti. Questo processo si basa sulla fattorizzazione della matrice di Laplace normalizzata del sottografo, mappando gli embedding dei nodi in uno spazio spettrale a bassa dimensionalità e applicando una strategia di clustering sensibile alla densità in questo spazio, al fine di garantire che nodi di tipo diverso (ad esempio clausole legali e moduli algoritmici) vengano raggruppati nello stesso cluster quando sono funzionalmente strettamente correlati. Ogni comunità identificata rappresenta un potenziale ciclo funzionale o un'unità di aggregazione di responsabilità. I risultati della partizione in comunità sono guidati dai seguenti obiettivi di ottimizzazione:
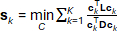 (8)
L=D−A è la matrice laplaciana del sottografo, A è la matrice di adiacenza, D è la matrice dei gradi, ck è il vettore indicatore della k-esima comunità e K è il numero prestabilito di comunità. Questo criterio massimizza la differenza minima del taglio tra le comunità, garantendo connessioni interne strette.
Ora viene eseguita un'analisi basata su compositi incrociati per ogni comunità. Se una comunità presenta nodi di clausole legali e nodi di moduli algoritmici, viene etichettata come potenziale fonte di bias. Per verificarne la causalità, si effettua un test d'intervento: tutti gli archi in questa regione vengono temporaneamente rimossi dal grafo, lo stesso processo decisionale viene eseguito nuovamente e si osservano le differenze nelle misurazioni del bias. La misura della validità causale è definita come:
 (9)
Borig e Bmask rappresentano rispettivamente l'intensità del bias del modello originale e del bias dopo la mascheratura. Se la misura della validità causale è notevolmente superiore alla soglia predeterminata, ciò implica che il gruppo di nodi è stato identificato come una fonte spiegabile di bias, il che guiderà successivamente la correzione della conformità e l'assegnazione dei guasti.
Verifica dinamica della conformità ai vincoli legali
Le istanze di decisione in tempo reale che si verificano durante il funzionamento di un sistema di intelligenza artificiale medica vengono introdotte come nodi transitori e incorporate in uno spazio di grafo conoscitivo appreso. Ogni nodo genera un vettore caratteristico iniziale leggendo il proprio contesto in ingresso, il comportamento in uscita e lo stato dell'algoritmo. Successivamente, questo vettore viene inserito in una rete neurale grafica con parametri congelati per eseguire una propagazione in avanti a un solo strato, producendo un'incorporazione allineata al grafo conoscitivo senza alterare la struttura originale del grafo. In questo modo, è possibile confrontare i nodi transitori e i nodi corrispondenti a clausole legali in uno spazio semantico comune.
Quindi calcolare la similarità coseno tra il nodo transitorio e ciascuno dei nodi delle clausole legali:
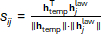 (10)
htemp è l'incorporamento del nodo temporaneo e hjlaw è l'incorporamento del nodo della j-esima clausola legale. Il valore di similarità riflette virtualmente il grado di corrispondenza semantica tra la decisione corrente e ciascun vincolo legale. Viene impostata una soglia dinamica di conformità θ in base alla distribuzione della similarità dei campioni storici di conformità, per adattare il limite di giudizio a diversi scenari applicativi. In particolare, θ = µ - 2σ, dove µ e σ sono rispettivamente la media e la deviazione standard della distribuzione della similarità coseno calcolata a partire da un insieme di validazione composto da 500 istanze di decisioni note conformi.
Se un punteggio di similarità coseno scende al di sotto della soglia dinamica di conformità, si ritiene che la corrispondente regola di diritto sia stata violata, innescando il meccanismo di segnalazione della non conformità. La notifica include inoltre il numero minimo della clausola giuridica corrispondente, il valore di similarità e la direzione dell'analisi di divergenza, informazioni che dovrebbero essere sufficienti per consentire ai regolatori di intervenire tempestivamente. Questo approccio fornisce una mappatura interpretabile dal processo decisionale opaco allo spazio della semantica giuridica e facilita il controllo della conformità in tempo reale.
Durante il funzionamento continuo, viene monitorata l'evoluzione del peso dei collegamenti chiave tra tecnologia giuridica nel sottografo di propagazione del bias. Particolare enfasi è posta sui collegamenti tra i nodi del modulo algoritmico e i nodi delle clausole giuridiche, poiché rappresentano direttamente l'intensità della risposta del comportamento tecnico a specifiche normative. I parametri della matrice di trasformazione per ciascun collegamento target vengono registrati durante l'inferenza, e la loro norma è estratta come indicatore dinamico dell'evoluzione dell'intensità di correlazione tra i due. Definendo la sequenza di intensità del collegamento come:
 (11)
wt rappresenta la norma di Frobenius della matrice dei pesi corrispondente alla relazione tra l'arco eij al tempo t, e Wkl(t) è la matrice dei parametri effettivamente utilizzata nel modello in quel momento. Questo indicatore riflette la profondità di apprendimento del modello o la sua dipendenza dal vincolo legale.
Viene eseguito un test di monotonicità a finestra mobile sulla sequenza, e un test del segno migliorato viene utilizzato per determinare se è presente una tendenza crescente significativa. Se gli incrementi su N passi temporali consecutivi soddisfano la condizione di dominanza positiva, allora si ritiene che il collegamento mostri un fenomeno di rinforzo anomalo. Combinando ulteriormente i dati storici sul contributo del gradiente, se il collegamento è stato identificato come un percorso ad alto impatto nel precedente giro di analisi di tracciamento della sorgente, viene avviato un processo di preallarme per l'accumulo di bias sistemico.
Infine, viene generato un rapporto di tracciamento della fonte, che include informazioni sui nodi alle due estremità dell'arco bersaglio, curve di variazione del peso, statistiche sulla frequenza delle decisioni correlate e potenziali raccomandazioni di attribuzione. Questo meccanismo consente un salto dal giudizio statico sulla conformità alla previsione dinamica del rischio, sostenendo un intervento proattivo in caso di possibili scostamenti istituzionali.
Dati sperimentali e progettazione
Per verificare l'efficacia del framework proposto, questo articolo costruisce un dataset eterogeneo multiprovenienza che integra regolamenti reali e dati simulati, progettando esperimenti di controllo rigorosi. Le fonti dei dati includono regolamenti nazionali sull'intelligenza artificiale in ambito medico, linee guida per il trattamento clinico, rapporti di audit su algoritmi open source e log di decisioni simulate. Dopo il pre-processamento, viene costruito un grafo della conoscenza eterogeneo di riferimento contenente 285 nodi (85 clausole legali, 120 comportamenti medici, 42 moduli algoritmici e 38 entità responsabili) e 1247 archi direzionali, come mostrato in Figura 3.
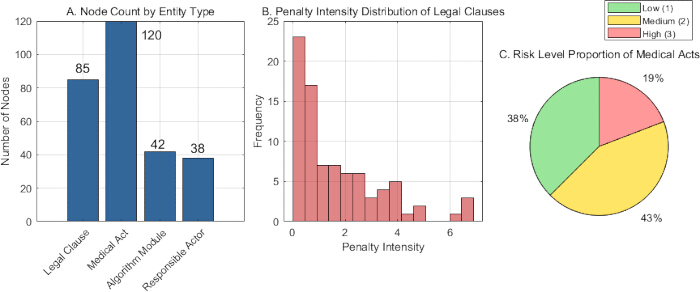
Figura 3: Distribuzione e caratteristiche dei tipi eterogenei di entità. (A) Grafico a barre che mostra il numero di nodi per ciascun tipo di entità: clausole legali (85), comportamenti medici (120), moduli algoritmici (42), parti responsabili (38). (B) Iogramma dell'intensità della penalità per i nodi delle clausole legali, raggruppati in categorie bassa (0‑0,33), media (0,34‑0,66) e alta (0,67‑1,0); l'asse verticale rappresenta il conteggio. (C) Grafico a torta della distribuzione del livello di rischio tra i nodi dei comportamenti medici: basso (19%), medio (43%), alto (38%). Tutti i valori sono conteggi assoluti o percentuali; non sono riportate barre di errore poiché si tratta di statistiche descrittive del dataset. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Figura 3 illustra la distribuzione e le caratteristiche dei nodi entità nel grafo eterogeneo della conoscenza. Figura 3A mostra la distribuzione del numero di quattro tipi di nodi entità, con i nodi "comportamento medico" che sono i più numerosi (120), seguiti dalle "clausole legali" (85), mentre "moduli algoritmici" (42) e "entità responsabili" (38) sono relativamente meno numerosi. Ciò avviene perché il grafo è strutturalmente progettato in base a comportamenti e regole. Figura 3B presenta la distribuzione delle intensità delle sanzioni per nodi che rappresentano una singola clausola legale, dove l'intensità misura la gravità della responsabilità legale. I dati indicano che esistono relativamente poche disposizioni con alta intensità di sanzione, e la maggior parte rientra in una fascia di intensità media-bassa, il che è coerente con la realtà secondo cui nei sistemi giuridici reali esistono solo poche clausole per violazioni gravi. Figura 3C illustra la distribuzione del livello di rischio nei nodi di comportamento medico, dove i comportamenti a rischio medio hanno la proporzione maggiore (43%), mentre quelli a rischio basso hanno la proporzione minore (19%), il che rivela che gli scenari medici sono normalmente gestiti e le operazioni ad alto rischio sono soggette a vincoli associativi più rigorosi nel grafo. Queste statistiche giustificano complessivamente lo schema di codifica per la disambiguazione delle entità adottato nella costruzione del grafo della conoscenza, fornendo supporto alle caratteristiche per l'allineamento successivo mediante convoluzione del grafo.
L'intero set di dati è stato suddiviso casualmente in insiemi di training (70%), validazione (10%) e test (20%), stratificati per tipo di nodo e distribuzione delle relazioni, al fine di preservare la struttura complessiva del grafo in ciascuna suddivisione. La stessa suddivisione è stata utilizzata in modo coerente per tutti i metodi di base per garantire un confronto equo. Oltre a questa suddivisione di base, i tre gradienti di densità del grafo della conoscenza (scarso, medio, denso) e le tre configurazioni di complessità transgiurisdizionale (singola, bilaterale, multilaterale) descritte in precedenza fungono da testbed pratici indipendenti, che valutano collettivamente la robustezza del metodo in condizioni variabili di completezza dei dati e sovrapposizione normativa. Per costruire etichette di verità fondamentale per la valutazione della localizzazione dei bias, abbiamo adottato una strategia in due fasi: (1) Annotazione da esperti—tre esperti in ambito legale e medico hanno esaminato in modo indipendente i log delle decisioni e identificato i nodi causa principale e i percorsi di propagazione per ciascuna violazione della conformità registrata, con le discrepanze risolte per voto maggioritario; (2) Iniezione simulata—per test controllati, abbiamo iniettato artificialmente segnali di bias in 20 percorsi decisionali selezionati casualmente modificando i pesi degli archi nel grafo della conoscenza, assicurando che i nodi sorgente reali e gli archi interessati fossero noti a priori.
Per tutti i metodi di base (TransE, ComplEx, Graph Neural Networks (GNN) Explainer, KG-BERT e Node2Vec), abbiamo utilizzato la stessa configurazione di addestramento (ottimizzatore Adam, tasso di apprendimento 1 × 10⁻³, dimensione del batch 64, 100 epoche) e le stesse partizioni dei dati del nostro metodo, per garantire un confronto equo. Per TransE e ComplEx, la dimensione dell'embedding è stata impostata a 256 con un margine di 1,0; per KG-BERT, abbiamo utilizzato il modello BERT-base pre-addestrato con una dimensione del batch di 16 e una lunghezza massima della sequenza di 128; per GNNExplainer, abbiamo utilizzato una GCN a 3 livelli con la stessa dimensione nascosta di 256; e per Node2Vec, abbiamo impostato la lunghezza della passeggiata a 80, il numero di passeggiate per nodo a 10 e la dimensione dell'embedding a 256.
Per garantire un confronto equo, abbiamo adattato tutti i metodi di base alle stesse attività di localizzazione del bias, ovvero l'identificazione del nodo radice e la ricostruzione del percorso di propagazione. Per TransE, ComplEx e Node2Vec, che non sono intrinsecamente interpretabili, abbiamo calcolato il gradiente della perdita legata al bias rispetto all'embedding di ciascun nodo e utilizzato l'ampiezza del gradiente come punteggio di importanza del nodo; i nodi radice sono stati selezionati applicando una soglia a questi punteggi, e i percorsi di propagazione sono stati ricostruiti mantenendo gli archi con il contributo maggiore in termini di gradiente. Per GNNExplainer, abbiamo utilizzato direttamente i suoi meccanismi integrati di importanza degli archi e maschera dei nodi per ottenere sia i nodi radice sia i sottografi. Per KG-BERT, che opera su triplette, abbiamo convertito ciascun arco del grafo in una tripletta testuale e utilizzato i pesi di attenzione del modello sugli enti per derivare l'importanza dei nodi, seguiti dalla stessa strategia di sogliatura per la ricostruzione del percorso. Attraverso questi adattamenti, ogni metodo di base produce sia previsioni sui nodi radice sia previsioni sui percorsi di propagazione, consentendo una valutazione uniforme di tutti i metodi.
La valutazione si concentra su quattro capacità fondamentali: accuratezza dell'allineamento semantico, capacità di localizzare il bias, efficienza della responsabilità e generalizzazione tra domini. Vengono inoltre presentate tre importanti variabili di controllo, che simulano la complessità del mondo reale.
1) Gradiente di densità del grafo della conoscenza: Per valutare le prestazioni del metodo a diversi livelli di completezza delle informazioni, vengono creati due sottoinsiemi a partire dal grafo completo di riferimento (densità D = 1,0) basati su una strategia di eliminazione casuale dei collegamenti, come segue:
Grafo sparso (D ~ 0.3): il 30% dei collegamenti viene mantenuto casualmente, simulando la fase iniziale della costruzione della conoscenza in cui manca gran parte delle informazioni.
Grafo a densità media (D ~ 0,6): il 60% dei collegamenti viene mantenuto casualmente, simulando uno scenario tipico di una struttura della conoscenza parzialmente nota.
Grafo denso (D = 1,0): utilizzo di tutti i 1247 archi, corrispondente a uno scenario ottimale con una conoscenza relativamente completa.
2) Situazione della frequenza delle decisioni mediche basate sull'IA: vengono impostati tre carichi di flusso decisionale artificiali per testare le prestazioni in tempo reale del monitoraggio dinamico della conformità:
Bassa frequenza 10 Hz: in media, vengono generati 10 eventi decisionali al secondo, simulando il monitoraggio di sistemi su piccola scala o a singolo sito.
Frequenza media di 50 Hz: 50 eventi decisionali al secondo che simulano il carico del sistema di intelligenza artificiale di istituzioni mediche regionali o di medie dimensioni.
Alta frequenza 100 Hz: 100 eventi decisionali al secondo simulano scenari di pressione concorrente elevata per i servizi di intelligenza artificiale distribuiti in un grande ospedale o su una piattaforma cloud.
3) Gradiente di complessità transgiurisdizionale: Per verificare la trasferibilità della modellizzazione dei vincoli giuridici, sono stati costruiti tre insiemi di test basati sulla complessità:
Giurisdizione singola: comprende esclusivamente le attuali leggi e regolamenti cinesi che disciplinano l'intelligenza artificiale in campo medico.
Giurisdizione bilaterale: incorpora i regimi normativi della Cina e dell'Unione Europea, con circa il 15% delle norme che risultano in conflitto e sovrapposte.
Giurisdizione multilaterale: basandosi sulle prime due, integra ulteriormente le norme sulla privacy e sulla sicurezza statunitensi del HIPAA (Health Insurance Portability and Accountability Act), creando un ambiente di prova in cui i sistemi giuridici dei tre regimi legali si intrecciano, aumentando la percentuale di conflitto normativo a circa il 25%.
I seguenti indicatori chiave sono stati utilizzati per la valutazione quantitativa:
1) Accuratezza dell'allineamento semantico: misura la capacità del grafo di modellare le relazioni tra entità giuridiche e tecniche.
Precisione dell'allineamento delle entità:
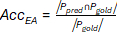 (12)
Ppred è l'insieme di coppie di entità allineate predette dal modello, e Pgold è l'insieme degli allineamenti aurei annotati dagli esperti.
Integrità della conservazione delle relazioni:
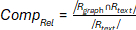 (13)
Rgraph è l'insieme ricostruito di relazioni nel grafo, e Rtext è l'insieme di relazioni esplicite estratte dal testo giuridico originale.
2) Capacità di localizzazione del bias: valutazione dell'efficacia nel rintracciare le cause profonde e i percorsi di propagazione del bias.
Tasso di richiamo del nodo radice:
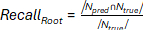 (14)
Npred è l'insieme dei nodi sorgente di bias identificati dal modello, e Ntrue è l'insieme dei nodi sorgente reali etichettati dagli esperti.
Precisione del percorso di propagazione:
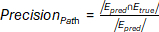 (15)
Epred è l'insieme degli archi nel sottografo di propagazione del bias inferito dal modello, e Etrue è l'insieme reale degli archi di propagazione del bias.
3) Efficienza del tracciamento della responsabilità: verifica le prestazioni del sistema in scenari di monitoraggio in tempo reale.
Latenza Media del Tracciamento:
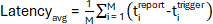 (16)
M rappresenta il numero totale di richieste, e titrigger e tireport sono rispettivamente i timestamp del i-esimo trigger di bias e della generazione del rapporto sorgente.
Prestazioni del sistema:
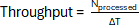 (17)
Nprocessed rappresenta il numero di richieste di tracciamento concorrenti elaborate con successo all'interno dell'intervallo di tempo ΔT.
4) Capacità di generalizzazione tra domini: verifica dell'adattabilità del metodo a diversi sistemi giuridici.
Copertura giurisdizionale:
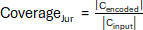 (18)
Cencoded rappresenta il numero di diverse clausole giurisdizionali codificate con successo nel grafo, e Cinput rappresenta il numero totale di clausole in ingresso.
Tasso di rilevamento dei conflitti tra vincoli:
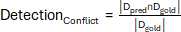 (19)
Dpred è l'insieme delle contraddizioni logiche legali rilevate dal modello, e Dgold è l'insieme di tutte le coppie di contraddizioni annotate dagli esperti.
Tutti gli esperimenti sono stati condotti utilizzando una workstation dotata di un processore multicore e di un'unità di elaborazione grafica; le specifiche hardware complete sono fornite nella Tabella dei Materiali.
Gli iperparametri principali di questo approccio e i relativi valori sono elencati nella Tabella 1, comprendendo la struttura del modello, la configurazione dell'addestramento e soglie fondamentali, come la dimensione dell'embedding, il numero di strati convoluzionali, il tasso di apprendimento e la dimensione del batch. Tutti i parametri sono stati ottimizzati rispetto al set di validazione mediante ricerca a griglia; il modello addestrato ha raggiunto una convergenza stabile e le prestazioni sono ottimali. Alcune soglie sono state definite congiuntamente secondo criteri specifici del dominio al fine di soddisfare i requisiti di elevata affidabilità nella verifica della conformità dell'intelligenza artificiale in ambito medico.
| Parametro | Valore | Descrizione |
| Dimensione dell'Incrustazione | 128 | Dimensione della caratteristica per le incrostazioni dei nodi |
| Numero di Strati di Convoluzione | 3 | Profondità della rete di convoluzione su grafi consapevole delle relazioni |
| Tasso di Apprendimento | 0.001 | Tasso di apprendimento iniziale per l'ottimizzatore Adam |
| Dimensione del Batch | 32 | Numero di sottografi elaborati per ogni batch |
| Tasso di Dropout | 0.1 | Probabilità di dropout applicata alle caratteristiche dei nodi durante l'addestramento |
| Numero di Teste di Attenzione | 8 | Numero di teste nel meccanismo di attenzione multi-testa |
| Coefficiente di Regolarizzazione L2 | 5 × 10⁻⁴ | Coefficiente di decadimento del peso per la regolarizzazione dei parametri |
| Soglia di Similarità | 0.75 | Similarità minima delle incrostazioni per la validazione della conformità |
| Soglia di Contributo del Gradiente | 0.01 | Soglia per selezionare gli archi ad alto impatto nella costruzione del sottografo di bias |
| Dimensione della Finestra di Monitoraggio | 10 | Passi temporali utilizzati per tracciare la dinamica dei pesi degli archi |
Tabella 1: Impostazioni principali dei parametri. Elenco degli iperparametri chiave utilizzati negli esperimenti: dimensione dell'embedding (256), numero di strati GCN (3), dimensione nascosta (256), tasso di apprendimento (1 × 10⁻³), dimensione del batch (64), dimensione del vettore di attenzione, soglia di contributo del collegamento (percentile 85 delle grandezze del gradiente), soglia dinamica di conformità (µ‑2σ, dove µ e σ provengono dal set di validazione di 500 istanze conformi), numero di comunità K (determinato tramite clustering spettrale) e ottimizzatore (Adam). Questi valori sono stati selezionati mediante ricerca a griglia sul set di validazione.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Verifica delle prestazioni del tracciamento dell'origine dei bias nel grafo della conoscenza legale dell'IA medica
Prestazioni della convoluzione grafica consapevole delle relazioni
Addestrando una rete convoluzionale su grafi consapevole delle relazioni, sono state calcolate le somiglianze di embedding tra nodi di clausole legali e comportamenti medici attraverso diversi strati convoluzionali, registrando l'effetto di allineamento ...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
L'integrazione dell'intelligenza artificiale in ambito medico nelle decisioni cliniche solleva sfide giuridiche relative all'attribuzione della responsabilità, ostacolate dal divario semantico tra testi legali non strutturati e algoritmi di tipo "black-box". Per colmare questa lacuna, abbiamo proposto un grafo della conoscenza basato su GNN che modella clausole legali, comportamenti medici, moduli algoritmici e parti responsabili come nodi eterogenei, collegati tramite quattro relazioni dirette di tipo legale-semantico (...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Il manoscritto non è stato precedentemente pubblicato né è attualmente in esame da parte di un'altra rivista. Tutti gli autori hanno approvato il contenuto dell'articolo. Gli autori dichiarano di non avere conflitti di interessi di natura finanziaria.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| ComplEx | Implementazione open-source (ad esempio, OpenKE) | Versione 1.0 | Modello di riferimento basato su embedding complessi per il confronto di grafi della conoscenza |
| GNNExplainer | Implementazione open-source (https://github.com/RexYing/gnn-explainer) | Commit 7a3b6a2 (2021) | Modello di riferimento per l'interpretabilità delle GNN, utilizzato per il tracciamento dei bias |
| Intel Xeon Gold 6248 (CPU) | Intel Corporation | SRF7F | Processore centrale per l'addestramento del modello e la pre-elaborazione dei dati |
| KG-BERT | HuggingFace Transformers + BERT-base | BERT-base-uncased (HuggingFace) | Modello di riferimento basato su trasformatori per l'allineamento semantico nei grafi della conoscenza |
| Node2Vec | Implementazione open-source (https://github.com/aditya-grover/node2vec) | Versione 1.0 | Modello di riferimento basato su embedding dei nodi tramite camminate casuali |
| NVIDIA Tesla V100 (GPU) | NVIDIA Corporation | 900-2G500-0010-000 | GPU ad alte prestazioni per l'accelerazione dell'addestramento delle reti neurali su grafi |
| Nostra (GCN con attenzione alle relazioni) | Implementazione personalizzata in PyTorch | PyTorch 1.12.0 | Framework proposto con trasformazioni per relazione, attenzione e retropropagazione del gradiente |
| TransE | Implementazione open-source (ad esempio, OpenKE) | Versione 1.0 | Modello di riferimento basato su embedding traslazionali per il confronto di grafi della conoscenza |
Riferimenti
- Wang Y, Ma Z. Ethical and legal challenges of medical AI on informed consent: China as an example. Dev World Bioeth. 2025;25(1):46-54.
- Sand M, Durán JM, Jongsma KR. Responsibility beyond design: Physicians' requirements for ethical medical AI. Bioethics. 2022;36(2):162-169.
- Schultz MD, Seele P. Towards AI ethics' institutionalization: knowledge bridges from business ethics to advance organizational AI ethics. AI Ethics. 2023;3(1):99-111.
- Magesh V, et al. Hallucination-Free? Assessing the reliability of leading AI legal research tools. J Empir Leg Stud. 2025;22(2):216-242.
- Patil S, Shankar H. Transforming healthcare: harnessing the power of AI in the modern era. Int J Multidiscip Sci Arts. 2023;2(2):60-70.
- Birkstedt T, Minkkinen M, Tandon A, Mäntymäki M. AI governance: themes, knowledge gaps and future agendas. Internet Res. 2023;33(7):133-167.
- Mohammad Amini M, et al. Artificial intelligence ethics and challenges in healthcare applications: a comprehensive review in the context of the European GDPR mandate. Mach Learn Knowl Extr. 2023;5(3):1023-1035.
- Pasham SD. Opportunities and difficulties of artificial intelligence in medicine existing applications, emerging issues, and solutions. The Metascience. 2023;1(1):67-80.
- Vearrier L, et al. Artificial intelligence in emergency medicine: benefits, risks, and recommendations. J Emerg Med. 2022;62(4):492-499.
- Peng Y, Rousseau JF, Shortliffe EH, Weng C. AI-generated text may have a role in evidence-based medicine. Nat Med. 2023;29(7):1593-1594.
- Alam MN, Kaur M, Kabir MS. Explainable AI in healthcare: enhancing transparency and trust upon legal and ethical consideration. Int Res J Eng Technol. 2023;10(6):1-9.
- Sorantin E, et al. The augmented radiologist: artificial intelligence in the practice of radiology. Pediatr Radiol. 2022;52(11):2074-2086.
- Borger JG, et al. Artificial intelligence takes center stage: exploring the capabilities and implications of ChatGPT and other AI-assisted technologies in scientific research and education. Immunol Cell Biol. 2023;101(10):923-935.
- Chikhaoui E, Alajmi A, Larabi-Marie-Sainte S. Artificial intelligence applications in healthcare sector: ethical and legal challenges. Emerg Sci J. 2022;6(4):717-738.
- Kerasidou CX, Kerasidou A, Buscher M, Wilkinson S. Before and beyond trust: reliance in medical AI. J Med Ethics. 2022;48(11):852-856.
- Polineni TNS, Maguluri KK, Yasmeen Z, Edward A. AI-driven insights into end-of-life decision-making: ethical, legal, and clinical perspectives on leveraging machine learning to improve patient autonomy and palliative care outcomes. Migr Lett. 2022;19(6):1159-1172.
- Galiana LI, Gudino LC, González PM. Ethics and artificial intelligence. Rev Clin Esp (Engl Ed). 2024;224(3):178-186.
- Paladugu PS, et al. Generative adversarial networks in medicine: important considerations for this emerging innovation in artificial intelligence. Ann Biomed Eng. 2023;51(10):2130-2142.
- Harris E. Large language models answer medical questions accurately, but can't match clinicians' knowledge. JAMA. 2023;330(9):792-794.
- İpek ZH, Gözüm AIC, Papadakis S, Kallogiannakis M. Educational applications of the ChatGPT AI system: a systematic review research. Educ Process Int J. 2023;12(3):26-55.
- Kim C, et al. Transparent medical image AI via an image-text foundation model grounded in medical literature. Nat Med. 2024;30(4):1154-1165.
- Wang YH, Lin GY. Exploring AI-healthcare innovation: natural language processing-based patents analysis for technology-driven road mapping. Kybernetes. 2023;52(4):1173-1189.
- Pruneski JA, et al. Natural language processing: using artificial intelligence to understand human language in orthopedics. Knee Surg Sports Traumatol Arthrosc. 2023;31(4):1203-1211.
- Chen RJ, et al. Algorithmic fairness in artificial intelligence for medicine and healthcare. Nat Biomed Eng. 2023;7(6):719-742.
- Yang Y, et al. The limits of fair medical imaging AI in real-world generalization. Nat Med. 2024;30(10):2838-2848.
- Almarshadi NF, et al. Clinical and medical coding: a new pathway for automation—an updated review. J Med Life Sci. 2024;6(4):633-651.
- Osifowokan AS, Agbadamasi TO, Adukpo TK, Mensah N. Regulatory and legal challenges of artificial intelligence in the US healthcare system: liability, compliance, and patient safety. World J Adv Res Rev. 2025;25(3):949-955.
- Hasan MT. Graph neural network models for detecting fraudulent insurance claims in healthcare systems. Am J Adv Technol Eng Solut. 2022;2(01):88-109.
- Johnson R, Li MM, Noori A, Zitnik M. Graph artificial intelligence in medicine. Annu Rev Biomed Data Sci. 2024;7:345-368.
- Lettieri N, Guarino A, Malandrino D, Zaccagnino R. Knowledge mining and social dangerousness assessment in criminal justice: metaheuristic integration of machine learning and graph-based inference. Artif Intell Law. 2023;31(4):653-702.
- Ma Y, et al. Incorporating structural information into legal case retrieval. ACM Trans Inf Syst. 2023;42(2):1-28.
- Jin Z, et al. GNNLens: a visual analytics approach for prediction error diagnosis of graph neural networks. IEEE Trans Vis Comput Graph. 2022;29(6):3024-3038.
- Shen Y, Zhang J, Song SH, Letaief KB. Graph neural networks for wireless communications: from theory to practice. IEEE Trans Wirel Commun. 2022;22(5):3554-3569.
- Xue X, et al. Adaptive similarity feature construction for ontology matching via multi-layer hybrid genetic programming. IEEE Transactions on Evolutionary Computation, 2025;30(2):519-533.
- Cheng T, et al. Graph convolutional network for image restoration: A survey. Mathematics, 2024;12(13): 2020.
- Li N, et al. Survey on evolutionary deep learning: Principles, algorithms, applications, and open issues. ACM Computing Surveys, 2023; 56(2): 1-34.
- Ma L, et al. A novel fuzzy neural network architecture search framework for defect recognition with uncertainties. IEEE Transactions on Fuzzy Systems, 2024; 32(5): 3274-3285.
- Fang Y, et al. Relation-aware graph convolutional networks for multi-relational network alignment. ACM Trans Intell Syst Technol. 2023;14(2):1-23.
- Schlichtkrull M, et al. Modeling relational data with graph convolutional networks//European semantic web conference. Cham: Springer International Publishing, 2018; 593-607.
- Ariai F, Mackenzie J, Demartini G. Natural language processing for the legal domain: a survey of tasks, datasets, models, and challenges. ACM Comput Surv. 2025;58(6):1-37.
- Xu Y, et al. BNet: batch normalization with enhanced linear transformation. IEEE Trans Pattern Anal Mach Intell. 2023;45(7):9225-9232.
- Guo MH, et al. Attention mechanisms in computer vision: a survey. Comput Vis Media. 2022;8(3):331-368.
- Guo MH, et al. Visual attention network. Comput Vis Media. 2023;9(4):733-752.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.